火山方舟
火山方舟


文档指南

请输入


- 文档首页
 火山方舟调用领域模型向量化
 复制全文
 下载 pdf
向量化
 文档反馈
 问问助手
Doubao-embedding-vision 是由字节跳动研发的多模态向量化模型。它能将文本、图片以及视频等混合输入内容转换为统一的向量表示,从而帮助您更高效地处理跨模态数据,实现精准的文搜图、图搜图和图文混合搜索。
当前模型支持以下几种向量输出类型:
- 稠密向量 (Dense Embedding):所有版本均默认支持。
- 稀疏向量 (Sparse Embedding):从 doubao-embedding-vision-250615 版本起支持,且仅支持文本输入。
- 多向量 (Multi Embedding):从 doubao-embedding-vision-251215 版本起支持。
-
快速开始
多模态向量模型支持接受和处理视频、图像和文本输入并转换为向量。以下示例均显式配置 instructions,使向量表示与目标检索场景保持一致。
说明
- doubao-embedding-vision-250615 及后续版本支持 不限数量的视频、文本和图片混合 输入。
curl https://ark.cn-beijing.volces.com/api/v3/embeddings/multimodal \
-H "Content-Type: application/json" \
-H "Authorization: Bearer $ARK_API_KEY" \
-d '{
"model": "doubao-embedding-vision-251215",
"instructions": "Target_modality: text and image and video.\nInstruction:Represent the mixed content for multimodal semantic retrieval\nQuery:",
"encoding_format": "float",
"input": [
{
"type": "video_url",
"video_url": {
"url": "https://ark-project.tos-cn-beijing.volces.com/doc_video/ark_vlm_video_input.mp4"
}
},
{
"type": "image_url",
"image_url": {
"url": "https://ark-project.tos-cn-beijing.volces.com/doc_image/tower.png"
}
},
{
"type": "text",
"text": "视频和图片里有什么"
}
]
}'
- doubao-embedding-vision-251215 及后续版本支持多向量。
- 支持文本、图片、视频及混合输入类型。
curl https://ark.cn-beijing.volces.com/api/v3/embeddings/multimodal \
-H "Content-Type: application/json" \
-H "Authorization: Bearer $ARK_API_KEY" \
-d '{
"model": "doubao-embedding-vision-251215",
"instructions": "Target_modality: text.\nInstruction:Compress the text into one word.\nQuery:",
"encoding_format": "float",
"input": [
{
"type": "text",
"text": "天很蓝"
}
],
"multi_embedding": {
"type": "enabled",
"compression": "blosc2"
}
}'
- doubao-embedding-vision-251215 及后续版本支持视频自定义抽帧。
- 支持通过 video_url 内字段自定义视频抽帧策略。
- 可综合控制抽帧频率、单帧 token 和整段视频 token 上限。
curl https://ark.cn-beijing.volces.com/api/v3/embeddings/multimodal \
-H "Content-Type: application/json" \
-H "Authorization: Bearer $ARK_API_KEY" \
-d '{
"model": "doubao-embedding-vision-251215",
"instructions": "Target_modality: text and image and video.\nInstruction:Represent the mixed content for multimodal semantic retrieval\nQuery:",
"encoding_format": "float",
"input": [
{
"type": "video_url",
"video_url": {
"url": "https://ark-project.tos-cn-beijing.volces.com/doc_video/ark_vlm_video_input.mp4",
"fps": 1,
"max_video_tokens": 120000,
"min_frame_tokens": 32,
"max_frame_tokens": 640,
"min_frames": 10
}
},
{
"type": "image_url",
"image_url": {
"url": "https://ark-project.tos-cn-beijing.volces.com/doc_image/tower.png"
}
},
{
"type": "text",
"text": "视频和图片里有什么"
}
]
}'
- doubao-embedding-vision-250615及后续版本支持。
- 支持纯文本输入。
curl https://ark.cn-beijing.volces.com/api/v3/embeddings/multimodal \
-H "Content-Type: application/json" \
-H "Authorization: Bearer $ARK_API_KEY" \
-d '{
"model": "doubao-embedding-vision-251215",
"instructions": "Target_modality: text and video.\nInstruction:Compress the text/video into one word.\nQuery:",
"encoding_format": "float",
"input": [
{
"type": "text",
"text": "天很蓝"
}
],
"dimensions": 1024,
"sparse_embedding": {
"type": "enabled"
}
}'
模型回复示例:
说明
sparse_embedding 字段在开启稀疏向量时返回。
{
"created": 1752133360,
"data": {
"embedding": [
-0.046875,-0.048828125,0.02001953125,0.064453125,
.....
0.003143310546875
],
"sparse_embedding":[
{
"index": 1,
"value": 0.0887451171875
},
{
"index": 13,
"value": 0.0887451171875
},
{
"index": 149,
"value": 0.0887451171875
}
],
"object": "embedding"
},
"id": "021752133359863906427fb4b36437c414d645f52206dfc398f85",
"model": "doubao-embedding-vision-251215",
"object": "list",
"usage": {
"prompt_tokens": 25,
"prompt_tokens_details": {
"image_tokens": 0,
"text_tokens": 25
},
"total_tokens": 25
}
}
支持模型
不同模型版本的功能对比如下:
注意
【重要】instructions 字段的配置直接决定模型推理效果。为了显著提升向量表示的精度,您需要根据具体的业务场景来定制该指令。请勿直接使用系统默认值。详情请参考设置 instructions 字段(推荐)。
使用说明
说明
推荐使用方舟推出的多模态向量化模型在处理完图像后,图像会从方舟服务器删除。方舟不会保留您提交的视频、图片以及文本信息等用户数据来训练模型。
开启稀疏向量(Sparse Embedding)
仅 doubao-embedding-vision-250615 及后续版本支持。
稀疏向量仅支持纯文本输入。
通过独立的 sparse_embedding 字段控制,与多向量配置互不影响,示例:
说明
sparse_embedding.type 默认值为 disabled,设置为 enabled 开启稀疏向量。
{
"model": "doubao-embedding-vision-251215",
"input": [
{
"type":"text",
"text":"天很蓝"
}
],
"sparse_embedding": {
"type":"enabled"
},
"encoding_format":"float"
}
开启多向量(Multi Embedding)
仅 doubao-embedding-vision-251215 及后续版本支持。
支持文本、图片、视频及混合输入;可通过 compression 控制返回格式,dimensions 会同步影响多向量子向量的列数。
通过独立的 multi_embedding 字段控制,与稀疏向量配置互不影响;可单独开启,或文本场景下与稀疏向量同时开启,示例:
说明
multi_embedding.type 默认值为 disabled,设置为 enabled 开启多向量。
{
"model": "doubao-embedding-vision-251215",
"instructions":"Target_modality: text and video.\nInstruction:Compress the text/video into one word.\nQuery:",
"input": [
{
"type":"text",
"text":"天很蓝"
}
],
"multi_embedding": {
"type":"enabled",
"compression":"blosc2"
},
"sparse_embedding": {
"type":"enabled"
},
"encoding_format":"float"
}
开启 multi_embedding.type="enabled" 后,响应中的 data.multi_embedding 会额外返回 token 级别的子向量:
- 不传 compression 时,返回 float[][]。
- 传入 compression="blosc2" 或 compression="zstd" 时,返回压缩并 Base64 编码后的字符串。
- 压缩返回场景下,客户端需依次执行 Base64 解码、按压缩算法解压、按 fp16(2 字节小端序)解析,再按 [num_tokens, dimensions] 重塑为二维数组。
- multi_embedding 不允许传空对象 {},否则会报错。
- multi_embedding 与 sparse_embedding 可同时开启,但 sparse_embedding 仍只支持纯文本输入。
自定义视频抽帧
仅 doubao-embedding-vision-251215 及后续版本支持。可在 input[].video_url 内配置抽帧参数,自定义视频理解的速度、成本与效果平衡。
以下字段均为可选;不传时,使用模型默认抽帧策略。
字段 | 类型 | 取值范围 | 说明 |
fps | float | [0.2, 5] | 抽帧频率,单位“帧/秒” |
max_video_tokens | integer | [10240, 204800] | 整段视频最多送入模型的 token 数 |
min_frame_tokens | integer | [16, 128] | 单帧最少 token 数 |
max_frame_tokens | integer | [128, 640],且 >= min_frame_tokens | 单帧最多 token 数 |
min_frames | integer | [5, 16] | 整段视频最少抽帧数 |
{
"model": "doubao-embedding-vision-251215",
"input": [
{
"type": "video_url",
"video_url": {
"url": "https://ark-project.tos-cn-beijing.volces.com/doc_video/ark_vlm_video_input.mp4",
"fps": 1,
"max_video_tokens": 120000,
"min_frame_tokens": 32,
"max_frame_tokens": 640,
"min_frames": 10
}
}
],
"encoding_format": "float"
}
使用这些字段时,抽帧策略会综合生效:按 fps 抽帧后,每帧按 max_frame_tokens 控制 token 上限,总 token 数不超过 max_video_tokens,实际抽帧数不低于 min_frames。若视频很短且 fps 过低导致抽帧数为 0,则会以 min_frames 兜底。
设置 instructions 字段(推荐)
instructions 字段是影响模型效果的关键。为了显著提升向量表示的精度,您需要根据具体的业务场景来定制该指令。请勿直接使用系统默认值。
通过合理设置 instructions,您可以引导模型更准确地聚焦输入内容的关键信息,从而适配特定的任务需求。这在跨模态检索、特定领域数据处理等场景中尤其有效。
注意:仅 doubao-embedding-vision-251215 及后续版本支持 instructions 字段。
配置规则
构建指令前需明确两种核心角色,二者在不同任务中的配置规则差异显著:
- Query(查询侧):发起检索 / 查询的主体,如用户输入的问题、检索关键词、待匹配的图片/视频等。
- Corpus(语料侧):被查询的对象,如文档库、图片库、视频库中的单条数据样本。
根据任务类型不同,Instructions 字段分为 召回 / 排序类 和 聚类 / 分类 / 语义文本相似度(STS)类 两大场景,具体配置模板如下表:
任务类型 | 是否区分 Query/Corpus | 核心配置模板 |
召回、排序类 | 是 | Query:Target_modality: {}.\nInstruction:{}\nQuery: Corpus:Instruction:Compress the {} into one word.\nQuery: |
聚类、分类、STS 类 | 否 | 所有数据:Target_modality: {}.\nInstruction:{}\nQuery: |
通用要求:所有模板仅需填充 {} 部分,其余固定内容禁止修改。
召回、排序类任务配置规则
此类任务用于根据 Query 计算与 Corpus 的相似度,实现目标内容的召回或排序,Query 和 Corpus 需分别配置 Instruction。
Query 查询侧配置
Target_modality: {}.\nInstruction:{}\nQuery:
字段填写说明
- Target_modality 填充规则
- 填写依据:与 Query 自身模态无关,完全取决于待召回的 Corpus 底库的模态类型。
- 多模态混合场景:
- 若 Corpus 库中存在多种独立模态样本(如部分为 text、部分为 image、部分为 video、部分为 text and video),需用 / 分隔所有模态;
- 若 Corpus 库中每条样本均包含多种模态(如每条样本都有 text + video),则用 and 连接。
- 常见示例
Corpus 库模态情况 | Target_modality 填写值 |
所有样本均为纯文本 | text |
所有样本均为图片 + 文本组合 | text and image |
所有样本均为纯视频 | video |
所有样本均为文本 + 视频组合 | text and video |
样本包含 text、image、video 三类 | text/image/video |
样本包含 text、video、text and video 三类 | text/video/text and video |
注意
Target_modality的填写错误会直接导致检索精度下降,请严格匹配 Corpus 库或数据集的模态。
- Instruction 填充规则
- 核心原则:禁止使用默认值 Compress the text into one word,需根据业务场景定制。
- 推荐示例
- 文本检索:为这个句子生成表示以用于检索相关文章
- 跨模态问答:根据这个问题,找到能回答这个问题的相应文本或图片
Corpus 语料侧配置
Instruction:Compress the {} into one word.\nQuery:
字段填写说明
- 填充依据:仅需匹配 当前单条 Corpus 数据的模态,无需考虑整个 Corpus 库的模态分布。
- 常见示例:text、image、video、text and image、text and video、image and video
聚类、分类、STS 类任务配置规则
此类任务不区分 Query 和 Corpus,所有数据采用完全相同的 Instruction 配置。
Target_modality: {}.\nInstruction:{}\nQuery:
字段填写说明
- Target_modality 填充规则
- 填写依据:整个数据集的统一模态类型,所有数据的该字段值保持一致。
- 填写格式:与召回类任务的 Target_modality 格式一致(单模态填对应值,多模态组合用 and)。
- Instruction 填充规则
- 核心原则:禁止使用默认值,需贴合具体任务场景。
- 典型示例
- STS 语义相似度任务:Retrieve semantically similar text
高级用法
典型场景配置示例
纯文本任务
场景 1:对称检索(STS 语义相似度匹配)
- 场景描述:检索语义相似句子,如对比 “一只熊猫正从滑梯上滑下来” 和 “熊猫从滑梯上滑下来”。
- 配置规则:两条样本的 Instruction 完全一致。
- Instruction 字段示例
- Target_modality: text.\nInstruction:Retrieve semantically similar text\nQuery:
- Input 字段:填写样本正文(如上述两个句子)。
场景 2:非对称检索(问答、摘要搜全文)
- 场景描述:用短 Query(问题 / 摘要)检索长 Corpus(答案 / 全文)。
- 配置示例
角色 | Instruction 字段配置 |
Query | Target_modality: text.\nInstruction:为这个句子生成表示以用于检索相关文章\nQuery: |
Corpus | Instruction:Compress the text into one word.\nQuery: |
多模态任务
场景 1:对称检索(文 / 图 / 视频互搜)
- 通用前提:当文本为图片 / 视频的完整描述时(例如“蓝色的天空下,一只狗在草坪上奔跑,草坪上还有一些帐篷”),可使用默认指令配置。
- 配置示例
检索类型 | Query 侧 Instruction 配置 | Corpus 侧 Instruction 配置 |
文搜图 | Target_modality: image.\nInstruction:Compress the text into one word.\nQuery: | Instruction:Compress the image into one word.\nQuery: |
文搜视频 | Target_modality: video.\nInstruction:Compress the text into one word.\nQuery: | Instruction:Compress the video into one word.\nQuery: |
图搜文 | Target_modality: text.\nInstruction:Compress the image into one word.\nQuery: | Instruction:Compress the text into one word.\nQuery: |
视频搜文 | Target_modality: text.\nInstruction:Compress the video into one word.\nQuery: | Instruction:Compress the text into one word.\nQuery: |
图搜图(整体内容匹配) | Target_modality: image.\nInstruction:Compress the image into one word.\nQuery: | Instruction:Compress the image into one word.\nQuery: |
- 特殊提示:若 Query 为短词文搜图(如 “蓝色海景”),建议替换 Query 侧 Instruction 为:Find me an everyday image that matches the given caption。
- 注意:图片局部截取检索原图,不属于对称检索,需按非对称检索配置。
场景 2:非对称检索
- 通用规则:仅在 Query 侧定制指令,Corpus 侧使用默认模板;指令需明确匹配规则。
- 典型场景示例
业务场景 | Query 侧 Instruction 配置 | Corpus 侧 Instruction 配置 |
跨模态问答(Query:文本问题;Corpus:文本 / 图片) | Target_modality: text/image.\nInstruction:根据这个问题,找到能回答这个问题的相应文本或图片\nQuery: | 文本 Corpus:Instruction:Compress the text into one word.\nQuery: 图片 Corpus:Instruction:Compress the image into one word.\nQuery: |
原图检索(忽略 PS 处理) | Target_modality: image.\nInstruction:查找与本图完全相同的图片,可能经过了ps处理,包含缩放、裁剪和水印,请忽略PS处理痕迹\nQuery: | Instruction:Compress the image into one word.\nQuery: |
电商服装检索(忽略背景 / 人物) | Target_modality: image.\nInstruction:忽略背景以及人物主体并查找这张图片中出现的同款商品图片\nQuery: | Instruction:Compress the image into one word.\nQuery: |
电商商品检索(文本描述搜图) | Target_modality: image.\nInstruction:根据下面的文本中对商品的描述,找到对应的符合条件的商品图片\nQuery: | Instruction:Compress the image into one word.\nQuery: |
菜品检索(文本描述搜图) | Target_modality: image.\nInstruction:根据这段文本中提到的有关的菜品,找到相关的菜品的图片\nQuery: | Instruction:Compress the image into one word.\nQuery: |
设置向量维度 dimensions
向量化是通过向量来表征文本、图像等非结构化数据的过程,让计算机能理解语言、图像等的含义。其中,向量维度是描述向量化后向量中元素的个数(标注词义/图像特征的维度)。在多模态向量化场景,每个维度对应文本的一个特征或者是对应图像的像素、色彩等视觉特征。
doubao-embedding-vision-250615及后续版本支持通过dimensions 参数指定稠密向量的输出维度,对输出的data.embedding 字段生效。
注意
稀疏向量为固定维度,不支持单独设置维度。开启多向量后,data.multi_embedding 中每个子向量的列数与请求中的 dimensions 保持一致;未传 dimensions 时使用模型默认维度。
{
"model": "doubao-embedding-vision-251215",
"input": [
{
"type":"text",
"text":"天很蓝"
}
],
"dimensions": 1024, #设置向量维度
"encoding_format":"float"
}
图片格式说明
图片传入方式
图片 URL 或图片 Base64 编码。用图片 URL 方式时,需确保图片 URL 可被访问。
图片文件容量
单张图片小于 10 MB。
使用 base64 编码,请求中请求体大小不可超过 64 MB。
图片像素说明
模型能够支持尺寸更加灵活的图片,传入图片满足下面条件:
- 图片宽高长度(单位 px):大于 14。
*图片像素(宽*高,单位 px):小于 3600万。
图片数量说明
- 支持不限数量的视频、文本和图片混合输入。
token 用量说明
模型理解图片,会将图片转化为 token ,再进行推理计算。token 用量,根据图片宽高像素计算可得。图片转化 token 的公式为:
min(图片宽 * 图片高/784, 单图 token 限制)
*图片尺寸为 1280 px * 720 px,即宽为 1280 px,高为 720 px,传入模型图片 token 限制为 1312,则理解这张图消耗的 token 为1280*720/784=1176,因为小于 1312,消耗 token 数为 1176 。
*图片尺寸为 1920 px * 1080 px,即宽为 1920 px,高为 1080 px,传入模型图片 token 限制为 1312,则理解这张图消耗的 token 为1920*1080/784=2645,因为大于 1312,消耗 token 数为 1312 。这时会压缩 token,即图片的细节会丢失部分,譬如字体很小的图片,模型可能就无法准确识别文字内容。
图片文件格式
支持的图片格式如下表,需注意文件后缀和图片格式需要匹配,即图片文件扩展名(URL 传入)、编码中图片格式声明(Base64 编码传入)需要与图片实际信息一致。
图片格式 | 文件扩展名 | 内容格式 Content Type
|
JPEG | .jpg, .jpeg | image/jpeg |
PNG | .apng, .png | image/png |
GIF | .gif | image/gif |
WEBP | .webp | image/webp |
BMP | .bmp | image/bmp |
TIFF | .tiff, .tif | image/tiff |
ICO | .ico | image/x-icon |
DIB | .dib | image/bmp |
ICNS | .icns | image/icns |
SGI | .sgi | image/sgi |
JPEG2000 | .j2c, .j2k, .jp2, .jpc, .jpf, .jpx | image/jp2 |
说明
TIFF、 SGI、ICNS、JPEG2000 几种格式图片,需要保证和元数据对齐如在对象存储中正确设置文件元数据,否则会解析失败。
视频输入说明
对视频按固定间隔抽取画面后,交由模型进行理解。
仅 doubao-embedding-vision-250615及后续版本支持视频输入。
视频文件格式
视频格式 | 文件扩展名 | 内容格式 Content Type |
MP4 | .mp4 | video/mp4 |
AVI | .avi | video/avi |
MOV | .mov | video/quicktime |
视频文件容量
单视频文件需在 50MB 以内。
不支持音频理解
暂不支持对视频文件中的音频信息进行理解。
用量说明
单视频 token 用量范围在[10k, 80k] ,单次请求视频最大 token 量还受模型的最大上下文窗口以及最大输入长度(当启用深度推理模式)限制,超出则请调整传入视频数量或视频长度。
方舟根据帧图像(指输入给模型的帧图像)张数(视频时长 * fps ),对帧图像进行压缩,以平衡对于视频的理解精度和 token 用量。帧图像会被等比例压缩至 [128 token, 640 token] ,对应像素范围在 [10万 像素, 50万像素]。
如fps过高或视频长度过长,需要处理的帧图像数量超出 640 帧(80×1024 token ÷ 128 token / 帧 = 640 帧),则按帧图像 128 token 视频时长/640 时间间隔均匀抽取 640帧。此时与请求中的配置不符,建议评估输出效果,按需调整视频时长或 fps 字段配置。
如fps过小或视频长度过短,需要处理的帧图像数量不足16帧(10×1024 token ÷ 640 token / 帧 = 16 帧),则按帧图像 640 token 视频时长/16 时间间隔均匀抽取 16帧。
自定义抽帧参数
仅 doubao-embedding-vision-251215 及后续版本支持。
可通过 input[].video_url 中的以下字段自定义抽帧策略:
- fps:控制抽帧频率,值越大,对画面变化的理解越精细,但 token 消耗更高。
- max_video_tokens:控制整段视频可消耗的最大 token 数。
- min_frame_tokens / max_frame_tokens:共同控制单帧的 token 下限与上限,平衡单帧质量与总体成本。
- min_frames:保证极短视频也能抽到足够帧数。
这些参数会协同生效。若按 fps 计算出的抽帧数量小于 min_frames,则优先满足 min_frames;若视频时长极短导致抽帧数为 0,则也会用 min_frames 兜底。
最佳实践:多模态相似度匹配示例
场景概述
下述程序展示如何通过文本描述检索图片库中的相关素材。
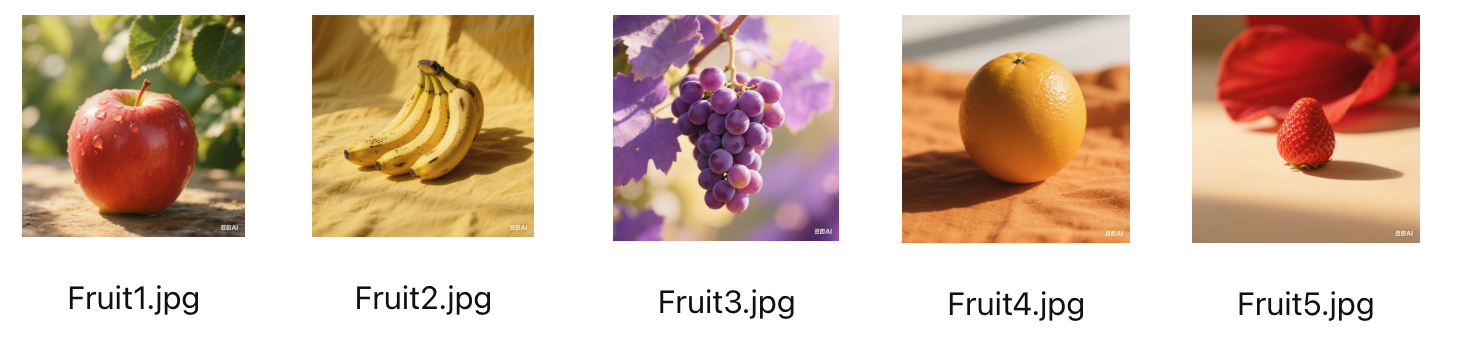
程序读取包含 5 张水果图片 URL 的列表,调用 Doubao-embedding-vision 模型为每张图片生成向量表示。当用户输入查询文本“草莓”时,程序将其转换为向量,并通过余弦相似度与图片向量库匹配,并输出最相似图片和相似度分数。图片 Corpus 和文本 Query 分别使用与角色匹配的 instructions,使生成的向量适用于以文搜图。该流程可用于电商商品检索、媒体素材管理等场景。
第一步:导入库包
导入所需的库包,并设置 API Key,为后续的数据处理和分析做准备。
...
import math
import os
from arkruntime import Ark
from arkruntime.types.multimodal_embedding import MultiModalEmbeddingResponse
IMAGE_CORPUS_INSTRUCTIONS = (
"Instruction:Compress the image into one word.\nQuery:"
)
TEXT_QUERY_INSTRUCTIONS = (
"Target_modality: image.\n"
"Instruction:根据水果名称检索匹配的图片\n"
"Query:"
)
...
第二步:获取向量
定义一个函数将单个文本或图片转换为向量表示。支持文本和图片 URL 两种输入类型:图片使用 Corpus 侧指令,文本使用目标模态为图片的 Query 侧指令。函数调用 doubao-embedding-vision-251215 模型获取 float 格式向量。
...
def get_embedding(input_data, input_type="text"):
"""调用火山引擎API获取单个文本或图片的向量表示"""
client = Ark(
api_key=os.environ.get("ARK_API_KEY"),
base_url="https://ark.cn-beijing.volces.com/api/v3",
)
if input_type == "text":
input_item = {"type": "text", "text": input_data}
instructions = TEXT_QUERY_INSTRUCTIONS
elif input_type == "image_url":
input_item = {"type": "image_url", "image_url": {"url": input_data}}
instructions = IMAGE_CORPUS_INSTRUCTIONS
else:
raise ValueError("输入类型仅支持'text'或'image_url'")
try:
resp = client.post(
"/embeddings/multimodal",
cast_to=MultiModalEmbeddingResponse,
body={
"model": "doubao-embedding-vision-251215",
"encoding_format": "float",
"input": [input_item],
"instructions": instructions,
},
)
embedding = resp.data.embedding
if not isinstance(embedding, list):
raise TypeError("API 未返回 float 格式向量")
return embedding
except Exception as e:
print(f" 获取向量失败,输入类型: {input_type}, 错误: {str(e)}")
raise
...
第三步:生成向量库
批量处理图片 URL 列表,生成对应的向量表示,并构建向量库。
...
def generate_image_embeddings(image_urls):
"""批量生成图片向量并构建向量库"""
print(f"[1/3] 开始生成 {len(image_urls)} 张图片的向量...")
embeddings = []
for i, url in enumerate(image_urls):
try:
embedding = get_embedding(url, "image_url")
embeddings.append({
"image_url": url,
"embedding": embedding
})
print(f" [{i+1}/{len(image_urls)}] 成功: {url}")
except Exception as e:
print(f" [{i+1}/{len(image_urls)}] 失败: {url} - {str(e)}")
continue
if not embeddings:
raise ValueError("所有图片向量生成失败")
print(f"[2/3] 完成: {len(embeddings)} 个有效向量")
return embeddings
...
第四步:图片相似度计算
利用余弦相似度来度量文本与图片之间的相似性,实现了一个基于内容的图片搜索功能。用户可以通过输入文本描述,检索与该描述最相关的图片。
...
def cosine_similarity(left, right):
"""计算两个等长向量的余弦相似度。"""
if len(left) != len(right):
raise ValueError("向量维度不一致")
dot_product = sum(a * b for a, b in zip(left, right))
left_norm = math.sqrt(sum(value * value for value in left))
right_norm = math.sqrt(sum(value * value for value in right))
if left_norm == 0 or right_norm == 0:
raise ValueError("向量模长不能为 0")
return dot_product / (left_norm * right_norm)
def search_similar_images(query_embedding, embeddings, top_n=1, query_type="文本"):
"""搜索与查询向量最相似的图片"""
print(f"\n[3/3] 开始搜索与{query_type}最相似的图片...")
results = []
for item in embeddings:
similarity = cosine_similarity(
query_embedding,
item["embedding"],
)
results.append({
"image_url": item["image_url"],
"similarity": similarity
})
results.sort(key=lambda x: x["similarity"], reverse=True)
print(f" - 相似度计算完成,共 {len(results)} 个结果")
return results[:top_n]
...
第五步:示例用法
测试搜索功能,调用generate_image_embeddings函数生成图片向量库,使用文本查询搜索相似图片,并返回最相似的结果。示例代码如下:
...
if __name__ == "__main__":
image_urls = [
"https://ark-project.tos-cn-beijing.volces.com/doc_image/Fruit1.jpg",
"https://ark-project.tos-cn-beijing.volces.com/doc_image/Fruit2.jpg",
"https://ark-project.tos-cn-beijing.volces.com/doc_image/Fruit3.jpg",
"https://ark-project.tos-cn-beijing.volces.com/doc_image/Fruit4.jpg",
"https://ark-project.tos-cn-beijing.volces.com/doc_image/Fruit5.jpg"
]
query_text = "草莓"
try:
# 生成图片向量
image_embs = generate_image_embeddings(image_urls)
# 生成文本向量
text_emb = get_embedding(query_text, "text")
print(f"文本向量维度: {len(text_emb)}")
# 搜索相似图片
similar_images = search_similar_images(text_emb, image_embs)
print(f"最相似图片: {similar_images[0]['image_url']}")
print(f"相似度分数: {similar_images[0]['similarity']:.4f}")
except Exception as e:
print(f"程序失败: {e}")
...
运行结果示例
以下结果基于 doubao-embedding-vision-251215 和本示例的 Query/Corpus 指令生成。不同模型版本或 instructions 会改变向量空间和相似度分数,不应直接比较不同配置下的绝对分数;检索效果应以同一配置下的相对排序为准。
- 开始生成 5 张图片的向量,依次对 5 个图片 URL发起请求,均返回 “成功”,表明 API 调用正常且图片链接可访问、格式合规。
- 完成处理,生成 5 个有效向量,文本向量维度为 2048,与模型输出维度一致,向量数量与输入图片数量匹配,无数据丢失。
- 开始相似度匹配,对文本向量与 5 个图片向量进行相似度计算,最终返回最相似图片为 Fruit5.jpg,表明两者在特征空间中具有较强相关性。
[1/3] 开始生成 5 张图片的向量...
[1/5] 成功: https://ark-project.tos-cn-beijing.volces.com/doc_image/Fruit1.jpg
[2/5] 成功: https://ark-project.tos-cn-beijing.volces.com/doc_image/Fruit2.jpg
[3/5] 成功: https://ark-project.tos-cn-beijing.volces.com/doc_image/Fruit3.jpg
[4/5] 成功: https://ark-project.tos-cn-beijing.volces.com/doc_image/Fruit4.jpg
[5/5] 成功: https://ark-project.tos-cn-beijing.volces.com/doc_image/Fruit5.jpg
[2/3] 完成: 5 个有效向量
文本向量维度: 2048
[3/3] 开始搜索与文本最相似的图片...
- 相似度计算完成,共 5 个结果
最相似图片: https://ark-project.tos-cn-beijing.volces.com/doc_image/Fruit5.jpg
相似度分数: 0.4515
相关技术
相似度计算
不同类型向量需使用对应的相似度计算方法,错误使用会导致结果偏差。核心计算逻辑:余弦相似度 = 向量L2归一化后做点积。
向量类型 | 支持版本 | 计算方法 | 说明 |
稠密向量(Dense Embedding) | 所有版本 | 余弦相似度 | 先对向量做 L2 归一化,再计算点积 |
稀疏向量(Sparse Embedding) | 250615及后续版本 | 余弦相似度 | 仅计算非零元素的点积,效率更高;仅支持文本输入场景 |
Base64 编码输入
如果你要传入的视频/图片在本地,你可以将这个视频/图片转化为 Base64 编码,然后提交给大模型。下面是一个简单的转换示例代码。
注意
传入 Base64 编码格式时,请遵循以下规则:
- 传入的是图片:
- 格式遵循data:image/<图片格式>;base64,<Base64编码>,其中,
- 图片格式:jpeg、png、gif等,支持的图片格式详细见图片格式说明。
- Base64 编码:图片的 Base64 编码。
- 传入的是视频:
- 格式遵循data:video/<视频格式>;base64,<Base64编码>,其中,
- 视频格式:MP4、AVI等,支持的视频格式详细见 视频格式说明。
- Base64 编码:视频的 Base64 编码。
# 定义方法将指定路径图片转为Base64编码
def encode_image(image_path):
with open(image_path, "rb") as image_file:
return base64.b64encode(image_file.read()).decode('utf-8')
# 需要传给大模型的图片
image_path = "path_to_your_image.jpg"
# 将图片转为Base64编码
base64_image = encode_image(image_path)
转换后,图片的url格式参考如下:
{
"type": "image_url",
"image_url": {
"url": f"data:image/<IMAGE_FORMAT>;base64,{base64_image}"
}
},
应用场景
您可以在以下场景中使用模型的多模态向量化能力。
附:向量批量处理的解决方案
针对 API 仅支持单次传入单张图片的限制,本代码通过异步并发 + 批量分组策略提升图片向量化的批量处理效率:利用 asyncio 创建异步任务,将图片按设定批次分组后并发调用 API;采用 “全组失败回滚” 模式确保每组任务结果一致,支持失败重试,且单独保存成功 / 失败结果(包含向量详情、错误信息和图片输入 URL)。
import asyncio
import os
from pathlib import Path
from arkruntime import AsyncArk
class MultimodalEmbedder:
"""多模态向量化批量处理工具(全组失败模式)"""
def __init__(self, api_key: str, model: str = "doubao-embedding-vision-241215",
batch_size: int = 10, retries: int = 2):
self.api_key = api_key
self.model = model
self.batch_size = batch_size # 批量大小配置(可扩展分片逻辑)
self.retries = retries # 批量请求重试次数
async def batch_process(self, items_list):
"""核心:异步批量处理向量任务(全组失败)"""
# 1. 初始化批量客户端
async with AsyncArk(
max_retries=self.retries,
base_url="https://ark.cn-beijing.volces.com/api/v3",
) as client:
# 2. 批量创建异步任务(按输入列表分片)
batch_tasks = [
asyncio.create_task(client.multimodal_embeddings.create(multi_embedding={"type": "disabled"}, model=self.model, input=items))
for items in items_list
]
try:
# 3. 批量等待任务完成(任一失败则全组终止)
batch_results = await asyncio.gather(*batch_tasks)
return batch_results
except Exception:
# 4. 批量清理未完成任务
for task in batch_tasks:
if not task.done():
task.cancel()
raise # 抛出异常,保持全组失败语义
def batch_save(self, batch_results, output_dir: str = "embedding_results"):
"""核心:批量保存向量结果"""
# 1. 初始化输出目录
Path(output_dir).mkdir(exist_ok=True)
# 2. 批量写入结果文件
with open(f"{output_dir}/batch_embeddings.txt", "w", encoding="utf-8") as f:
for idx, result in enumerate(batch_results, 1):
embedding = result.data.embedding
f.write(f"批量项 #{idx} | 向量长度: {len(embedding)} | 前20维: {embedding[:20]}...\n")
print(f"批量结果已保存:{output_dir}/batch_embeddings.txt")
if __name__ == "__main__":
# 1. 配置初始化
api_key = os.environ.get("ARK_API_KEY") or input("输入API密钥: ").strip()
if not api_key:
raise ValueError("API密钥不能为空")
# 2. 初始化批量处理器
embedder = MultimodalEmbedder(api_key=api_key, batch_size=10, retries=2)
# 3. 构造批量输入数据
batch_inputs = [
[{"type": "text", "text": "天很蓝,海很深"}, {"type": "image_url", "image_url": {"url": "https://example.com/image1.jpg"}}],
[{"type": "text", "text": "阳光明媚的沙滩"}, {"type": "image_url", "image_url": {"url": "https://example.com/image2.jpg"}}]
]
# 4. 执行批量处理+结果保存
try:
batch_results = asyncio.run(embedder.batch_process(batch_inputs))
embedder.batch_save(batch_results)
print(f"批量处理完成,共生成 {len(batch_results)} 个向量")
except Exception as e:
print(f"批量处理失败: {str(e)}")
最近更新时间:2026.09.08 01:14:45
这个页面对您有帮助吗?
有用
有用
无用
无用