火山方舟
火山方舟


文档指南

请输入


- 文档首页
 火山方舟推理批量推理
 复制全文
 下载 pdf
批量推理
 文档反馈
 问问助手
批量推理是无需实时响应需求的离线大批量数据处理方案,适用于模型评测、批量回归等场景,支持通过 SDK 或 控制台创建异步任务处理请求。相较于在线推理,批量推理具备以下优势:
- 更低成本:输入输出单价为在线推理的 50%;受益于透明前缀缓存,命中缓存的输入单价可进一步降低 60%。
- 更高配额:默认 100亿 token/天,支持工单申请提额;受益于灵活的调度策略,高峰期仍可获得可观的任务处理速率。
- 场景灵活:同时提供批量推理任务(处理静态存储数据)、类在线推理方式批量推理接入点(处理动态数据)两种模式。
- 改造简单:Batch Chat 接口参数与 Chat 接口一致,只需关注超时时间和并发策略,即可快速切换至批量推理,无需修改业务逻辑。
说明
支持的模型
注意
选择调用方式
方舟提供了两种批量推理方式,您可根据自己的业务场景选择合适的调用方式。
说明
- 批量推理接入点适用于通过 Batch Chat API 处理动态数据的场景。对于动态产生的数据、后台任务或其他需要保持同步调用方式的时延不敏感业务,可以迁移至 在线推理(低优)。迁移后,使用普通在线推理的预置推理接入点或自定义推理接入点,并在请求中设置 service_tier=flex。
- 在线推理(低优)支持 Chat API、Responses API 和 ,请根据业务当前使用的 API 协议及所需能力选择迁移后的接口。
- 注意:doubao-seed-2.1 后续模型不再支持调用 Batch Chat API。
批量推理任务开发教程
批量推理任务是业界常规的批量、离线使用模式,需配合火山引擎对象存储(TOS)使用。
前提条件
- 开通指定模型服务。
说明
存储桶(bucket)的 区域(region)需配置为华北2(北京)。
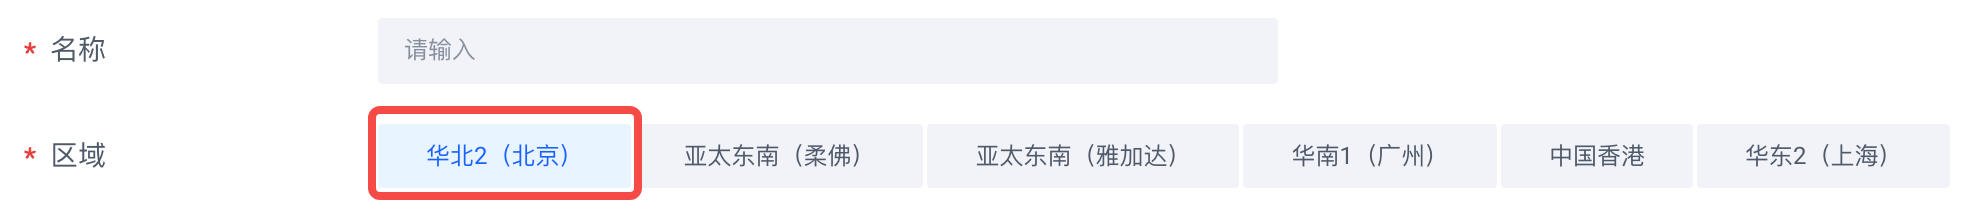
- 使用 SDK 方式进行批量推理任务开发,需完成以下操作:
快速入门
可以根据以下步骤快速实现批量推理任务的创建、查询、下载结果等。
步骤一:准备批量推理任务文件
请参考文件格式要求准备文件格式为 JSONL (JSON Lines,一行一个 JSON 对象)的数据文件,其中每行包含对 API 的单个请求的详细信息。
文件示例
下面是包含 2 个请求的输入文件的示例(.jsonl文件):
{"custom_id": "request-1", "body": {"messages": [{"role": "user", "content": "天空为什么这么蓝?"}],"max_tokens": 1000,"top_p":1,"temperature":0.7}}
{"custom_id": "request-2", "body": {"messages": [{"role": "system", "content": "You are an unhelpful assistant."},{"role":"user", "content":"天空为什么这么蓝?"}],"max_tokens":1000}}
{"custom_id":"request-1","body":{"messages":[{"role":"user","content":[{"type":"text","text":"支持输入是图片的模型系列是哪个?"},{"type":"image_url","image_url":{"url":"https://ark-project.tos-cn-beijing.volces.com/doc_image/ark_demo_img_1.png"}}]}],"max_tokens":1000,"top_p":1,"temperature":0.7}}
{"custom_id":"request-2","body":{"messages":[{"role":"user","content":[{"type":"image_url","image_url":{"url":"https://ark-project.tos-cn-beijing.volces.com/doc_image/ark_demo_img_1.png"}},{"type":"image_url","image_url":{"url":"https://ark-project.tos-cn-beijing.volces.com/doc_image/ark_demo_img_2.png"}},{"type":"text","text":"图片里都有什么?"}]}],"max_tokens":1000}}
{"custom_id":"request-1","body":{"messages":[{"role":"user","content":[{"type":"text","text":"视频里有什么?"},{"type":"video_url","video_url":{"url":"https://ark-project.tos-cn-beijing.volces.com/doc_video/ark_vlm_video_input.mp4"}}]}],"max_tokens":1000,"top_p":1,"temperature":0.7}}
{"custom_id":"request-2","body":{"messages":[{"role":"user","content":[{"type":"video_url","video_url":{"url":"https://ark-project.tos-cn-beijing.volces.com/doc_video/ark_vlm_video_input_2.mp4"}},{"type":"video_url","video_url":{"url":"https://ark-project.tos-cn-beijing.volces.com/doc_video/ark_vlm_video_input_3.mp4"}},{"type":"text","text":"视频里都有什么?"}]}],"max_tokens":1000}}
{"custom_id": "request-1", "body": {"input": ["天很蓝","海很深"]}}
{"custom_id": "request-1", "body": {"input": [{"text": "天很蓝,海很深","type": "text"},{"image_url": {"url": "https://ark-project.tos-cn-beijing.volces.com/images/view.jpeg"},"type": "image_url"}]}}
文件格式校验脚本:为避免格式错误导致任务失败,请使用校验脚本检测文件,检测前请配置对应的文件。
文件规范要求
- 文件基础要求
- 默认最大文件大小 5 GB;单个文件只能包含一个批量推理接入点的请求。
- 字段规则
- 每个请求都必须包含custom_id 字段,类型为字符串且在文件内唯一,用于关联请求与对应结果。
- 每条请求独立发送、独立收到结果。若多个请求提示词相同,需在请求中都加上相同的提示词。
- 每个请求body 字段参数需与底层模型调用 API 的 request body 一致,为合法 JSON Object。完整配置参见对应 API 文档:对话(Chat) API、文本向量化 API、图像向量化 API。
- 视觉理解批量任务要求
- 传入图片/视频的方式要求:批量推理任务仅支持 TOS(火山引擎对象存储)链接,不支持其他链接和 Base64 编码(批量推理接入点的传入方式与此不同,参见 使用批量推理接入点 章节)。
- 图片链接需要保持长期可用(推荐 7 天)。TOS 预签名链接默认有效期为 1 小时,需手动设置 expires 参数变更过期时间(建议 7 天),避免因链接过期导致任务失败。完整签名字段说明见 TOS 预签名文档。
...
# 1. 创建TOS客户端
client = tos.TosClientV2(AK, SK, ENDPOINT, REGION)
# 2. 生成“下载图片”的预签名URL(GET方法,有效时间3600秒)
download_pre_signed = client.pre_signed_url(
HttpMethodType.Http_Method_Get, # 下载用GET方法(核心!)
bucket_name=BUCKET_NAME,
key=OBJECT_KEY,
expires=604800 # 下载URL有效期,可按需调整(如86400=24小时)
)
...
- 配置示例
- 输出长度控制,配置 max_tokens。
- {"custom_id": "request-1", "body": {"messages": [{"role": "system", "content": "You are an unhelpful assistant."},{"role":"user", "content":"天空为什么这么蓝?"}],"max_tokens":1000}}
- 关闭深度思考,设置 thinking 字段(需模型支持 thinking 字段)。
- {"custom_id": "request-1", "body": {"messages": [{"role": "system", "content": "You are an unhelpful assistant."},{"role":"user", "content":"天空为什么这么蓝?"}],"thinking":{"type":"disabled"}}}
- 控制模型回复的丰富度,设置 temperature 、top_p 字段 。
- {"custom_id": "request-1", "body": {"messages": [{"role": "user", "content": "天空为什么这么蓝?"}],"top_p":1,"temperature":0.7}}
步骤二:上传任务文件至TOS
可以通过 SDK 或 TOS 控制台上传任务文件至 TOS 的 bucket 中,后续方舟平台会读取文件里的请求信息进行批量推理。
上传方式:使用 SDK 支持的文件上传方式如下。
- 普通上传:最大上传 5 GB 文件。
- 分片上传:文件大小超过 5 GB 需要走分片上传,该方式最大支持上传 48.8 TB文件(每个分片最大 5 GB,分片数量最多 10000)。
普通上传:
import os
import tos
# 从环境变量中读取您的Access Key,为了保障安全,建议您配置Access Key至环境变量
ak = os.environ.get("VOLC_ACCESSKEY")
sk = os.environ.get("VOLC_SECRETKEY")
# 存储任务文件及结果文件的桶的属性,包括ENDPOINT以及区域,当前只支持北京区域的存储桶
endpoint = "tos-cn-beijing.volces.com"
region = "cn-beijing"
bucket_name = "input-bucket"
# 上传任务文件的文件路径
object_key = "input/data.jsonl"
# 任务文件本地的路径
file_name = "/usr/local/data.jsonl"
# 初始化 TOS 客户端
client = tos.TosClientV2(ak, sk, endpoint, region)
# 上传文件
client.put_object_from_file(bucket_name, object_key, file_name)
分片上传
说明
- 文件大小超过 5GB 需要走分片上传,网络稳定的情况下可以直接走分片上传,网络不稳定建议走断点续传。
- 每个分片大小为 4MB - 5GB,网络环境越稳定分片大小可选越大。建议分片大小为 50 MB - 1GB。
以下是断点续传的示例代码:
# 断点续传demo
import tos
from tos import DataTransferType
# 替换为您的存储桶名称
bucket_name = "demo-bucket-test"
# 对象名称,例如 example_dir 下的 example_object.txt 文件,则填写为 example_dir/example_object.txt
object_key = "input/data.jsonl"
# 本地文件完整路径,例如usr/local/testfile.txt
filename = "/usr/local/text.jsonl"
ak = os.environ.get("VOLC_ACCESSKEY")
sk = os.environ.get("VOLC_SECRETKEY")
region = "cn-beijing"
endpoint = "tos-cn-beijing.volces.com"
try:
# 创建 TosClientV2 对象,对桶和对象的操作都通过 TosClientV2 实现
client = tos.TosClientV2(ak, sk, endpoint, region)
def percentage(
consumed_bytes: int,
total_bytes: int,
rw_once_bytes: int,
type: DataTransferType,
):
if total_bytes:
rate = int(100 * float(consumed_bytes) / float(total_bytes))
print(
"rate:{}, consumed_bytes:{},total_bytes{}, rw_once_bytes:{}, type:{}".format(
rate, consumed_bytes, total_bytes, rw_once_bytes, type
)
)
# 可通过part_size可选参数指定分片大小
# 通过enable_checkpoint参数开启和关闭断点续传特性
# 通过task_num设置线程数
client.upload_file(
bucket_name,
object_key,
filename,
# 设置断点续传执行线程数,默认为1
task_num=3,
# 设置断点续传分片大小,默认20mb
part_size=1024 * 1024 * 5,
# 设置断点续传进度条回调函数
data_transfer_listener=percentage,
)
except tos.exceptions.TosClientError as e:
# 操作失败,捕获客户端异常,一般情况为非法请求参数或网络异常
print("fail with client error, message:{}, cause: {}".format(e.message, e.cause))
except tos.exceptions.TosServerError as e:
# 操作失败,捕获服务端异常,可从返回信息中获取详细错误信息
print("fail with server error, code: {}".format(e.code))
# request id 可定位具体问题,强烈建议日志中保存
print("error with request id: {}".format(e.request_id))
print("error with message: {}".format(e.message))
print("error with http code: {}".format(e.status_code))
print("error with ec: {}".format(e.ec))
print("error with request url: {}".format(e.request_url))
except Exception as e:
print("fail with unknown error: {}".format(e))
步骤三:创建批量推理任务
说明
避免异常场景下重复提交任务产生额外推理费用,平台在创建批量推理任务时提供幂等控制机制:
当提交任务的用户、项目名(Project Name)、存储桶(bucket)和输入文件名(object-key)完全相同时,平台仅保留一个处于活跃状态(运行或排队)的任务,重复提交的任务将报错,并在错误信息中包含在运行或排队中任务的ID,供用户查询。重复提交报错后,您可以直接使用错误信息中返回的任务 ID 调用查询接口,跟踪原有任务的执行状态,无需重新提交任务。
import volcenginesdkcore
import volcenginesdkark
import os
# 配置项类,您需将其改为自己的配置
class Config:
# 存储任务文件及结果文件的桶的属性,包括ENDPOINT以及地域
REGION = "cn-beijing"
INPUT_BUCKET = "input-bucket" # 替换为您的输入文件所在 TOS 桶名称
# 上传任务文件的文件路径
INPUT_OBJECT_KEY = "input/data.jsonl"
OUTPUT_BUCKET = "output-bucket" # 替换为您的结果文件存储 TOS 桶名称
# 存储结果文件的文件夹
OUTPUT_OBJECT_KEY = "output/"
# 任务文件本地的路径
LOCAL_FILE_NAME = "/usr/local/data.jsonl"
# 模型版本及名称,可在此查询 https://ark.volcengine.com/region:cn-beijing/docs/ark/model-list
MODEL_VERSION = "260628"
MODEL_NAME = "doubao-seed-2-1-pro"
# 命名您的批量推理任务
JOB_NAME = "demo"
# 批量推理任务所在项目的名称,默认为default
PROJECT_NAME = "default"
# 从环境变量中读取您的Access Key,为了保障安全,建议您配置Access Key至环境变量
AK = os.environ.get("VOLC_ACCESSKEY")
SK = os.environ.get("VOLC_SECRETKEY")
# 创建批量推理任务
def create_batch_job(ark_instance):
input_file_tos_location = (
volcenginesdkark.InputFileTosLocationForCreateBatchInferenceJobInput(
bucket_name=Config.INPUT_BUCKET,
object_key=Config.INPUT_OBJECT_KEY
)
)
output_dir_tos_location = (
volcenginesdkark.OutputDirTosLocationForCreateBatchInferenceJobInput(
bucket_name=Config.OUTPUT_BUCKET,
object_key=Config.OUTPUT_OBJECT_KEY
)
)
foundation_model = volcenginesdkark.FoundationModelForCreateBatchInferenceJobInput(
model_version=Config.MODEL_VERSION,
name=Config.MODEL_NAME
)
model_reference = volcenginesdkark.ModelReferenceForCreateBatchInferenceJobInput(
foundation_model=foundation_model
)
req = volcenginesdkark.CreateBatchInferenceJobRequest(
input_file_tos_location=input_file_tos_location,
model_reference=model_reference,
name=Config.JOB_NAME,
output_dir_tos_location=output_dir_tos_location,
project_name=Config.PROJECT_NAME,
)
resp = ark_instance.create_batch_inference_job(req)
return resp.id
configuration = volcenginesdkcore.Configuration()
configuration.ak = Config.AK
configuration.sk = Config.SK
configuration.region = Config.REGION
configuration.client_side_validation = True
volcenginesdkcore.Configuration.set_default(configuration)
ark_instance = volcenginesdkark.ARKApi(volcenginesdkcore.ApiClient(configuration))
# 创建批量推理任务
batch_job_id = create_batch_job(ark_instance)
print(f"创建批量推理任务,任务ID:{batch_job_id}")
请求将返回创建的批量推理任务的 ID。
创建批量推理任务,任务ID:bi-20260112213907-*****
步骤四:查询批量推理任务状态
import os
import volcenginesdkcore
import volcenginesdkark
class Config:
# 存储任务文件及结果文件的桶的属性,包括ENDPOINT以及地域
REGION = "cn-beijing"
# 从环境变量中读取您的Access Key,为了保障安全,建议您配置Access Key至环境变量
AK = os.environ.get("VOLC_ACCESSKEY")
SK = os.environ.get("VOLC_SECRETKEY")
# 替换为您创建的批量推理任务的 ID
BATCH_JOB_ID="bi-20260112213907-****"
# 列出指定 ID 的批量推理任务信息。
def list_batch_inference_jobs(ark_instance, batch_job_id):
filter = volcenginesdkark.FilterForListBatchInferenceJobsInput(ids=[batch_job_id])
req = volcenginesdkark.ListBatchInferenceJobsRequest(filter=filter)
resp = ark_instance.list_batch_inference_jobs(req)
return resp
configuration = volcenginesdkcore.Configuration()
configuration.ak = Config.AK
configuration.sk = Config.SK
configuration.region = Config.REGION
configuration.client_side_validation = True
volcenginesdkcore.Configuration.set_default(configuration)
ark_instance = volcenginesdkark.ARKApi(volcenginesdkcore.ApiClient(configuration))
batch_job_status = list_batch_inference_jobs(ark_instance, Config.BATCH_JOB_ID)
print(f"批量推理任务信息:\n{batch_job_status}")
运行脚本,返回的任务信息如下:
批量推理任务信息:
{'items': [{'completion_window': '28d',
'create_time': '2026-01-12T13:39:07Z',
'description': '',
'expire_time': '2026-02-09T13:39:07Z',
'id': 'bi-20260112213907-*****',
'input_file_tos_location': {'bucket_name': 'batch-test-0112',
'object_key': 'input/data.jsonl'},
'model_reference': {'custom_model_id': None,
'foundation_model': {'model_version': '260628',
'name': 'doubao-seed-2-1-pro'}},
'name': 'batch-demo-0112',
'output_dir_tos_location': {'bucket_name': 'batch-test-0112',
'object_key': 'output/'},
'project_name': 'default',
'request_counts': {'completed': 0, 'failed': 0, 'total': 0},
'status': {'message': '',
'phase': 'Queued',
'phase_time': '2026-01-12T13:39:07Z'},
'tags': [{'key': 'sys:ark:createdBy',
'value': 'IAMUser/55165459/ark_doc'}],
'update_time': '2026-01-12T13:39:07Z'}],
'page_number': 1,
'page_size': 10,
'total_count': 1}
支持在批量推理任务列表页、或者点击批量推理任务名称进入任务详情页,查看批量推理任务的信息,如任务基本信息、状态、进度、配置信息等。
批量推理任务状态与对应描述如下:
状态 | 状态码 | 描述 |
排队中 | Queued | 任务提交成功,由于账号下并发任务数达到上限等原因需排队等候。 |
初始化中 | Initializing | 任务在初始化中。 |
运行中 | Running | 任务运行中。 |
完成 | Completed | 任务已完成。 |
停止中 | Terminating | 由于到期等系统原因或手动终止,任务当前处于取消中状态。 |
已停止 | Terminated | 任务已被停止。 |
失败 | Failed | 任务执行失败,原因可能是超时等原因。 |
步骤五:下载批量推理任务结果
批量推理任务运行结束后,可以通过 SDK 或者控制台方式下载结果文件。其中结果文件包含 2 类文件:
脚本执行完成后,可以在local_output_dir文件路径下,找到批量推理任务结果文件。
import os
import tos
# 替换为您的批量推理任务 ID
batch_job_id="bi-20260112213907-****"
# 从环境变量中读取您的Access Key,为了保障安全,建议您配置Access Key至环境变量
ak = os.environ.get("VOLC_ACCESSKEY")
sk = os.environ.get("VOLC_SECRETKEY")
# 替换为您存储桶的属性,包括 endpoint、region、bucket_name
endpoint = "tos-cn-beijing.volces.com"
region = "cn-beijing"
bucket_name = "output-bucket"
# 替换为您配置的批量推理任务结果文件路径
output_object_key = "output/"
# 替换为您存储批量推理任务结果文件的本地路径
local_output_dir = "./output/"
results_key = f"{output_object_key}{batch_job_id}/output/results.jsonl"
errors_key = f"{output_object_key}{batch_job_id}/error/errors.jsonl"
results_file_name = f"{local_output_dir}{batch_job_id}/results.jsonl"
errors_file_name = f"{local_output_dir}{batch_job_id}/errors.jsonl"
client = tos.TosClientV2(ak, sk, endpoint, region)
try:
client.get_object_to_file(bucket_name, results_key, results_file_name)
print(f"成功下载结果文件 {results_file_name}")
except tos.exceptions.TosServerError as e:
if e.status_code == 404:
print("results.jsonl 不存在,说明本次批量推理没有成功执行的请求")
else:
raise
try:
client.get_object_to_file(bucket_name, errors_key, errors_file_name)
print(f"成功下载错误文件 {errors_file_name}")
except tos.exceptions.TosServerError as e:
if e.status_code == 404:
print("errors.jsonl 不存在,说明本次批量推理所有请求均成功执行")
else:
raise
批量推理任务运行结束后,可以在任务列表点击查看结果或在任务详情页的文件信息区域点击链接至 TOS 页面,然后下载对应的结果文件。
批量推理任务结果文件内容如下:
{"id":"021768279264106000000000000000000000000000000004984d6","custom_id":"request-2","error":null,"response":{"request_id":"021768279264106000000000000000000000000000000004984d6","status_code":200,"body":{"choices":[{"finish_reason":"stop","index":0,"logprobs":null,"message":{"content":"害,天要蓝就让它蓝呗,纠结这干啥,难道你还能把它改成别的颜色不成?不如想想晚上吃啥小龙虾还是麻辣烫呢,这比啥都实在。","role":"assistant"}}],"created":1768279310,"id":"021768279264106000000000000000000000000000000004984d6","model":"doubao-seed-2-1-pro-260628","service_tier":"default","object":"chat.completion","usage":{"completion_tokens":210,"prompt_tokens":49,"total_tokens":259,"prompt_tokens_details":{"cached_tokens":0}}}}}
{"id":"021768279264005000000000000000000000000000000008aeaa6","custom_id":"request-1","error":null,"response":{"request_id":"021768279264005000000000000000000000000000000008aeaa6","status_code":200,"body":{"choices":[{"finish_reason":"stop","index":0,"logprobs":null,"message":{"content":"天空之所以呈现蓝色,主要是因为**瑞利散射**这一光学现象,背后可以拆解为3个关键逻辑:\n\n### 1. 太阳光的“颜色本质”\n太阳光是一种复合光,由红、橙、黄、绿、蓝、靛、紫等不同波长的光组成。其中:\n- 红光、橙光的波长较长(约600-760纳米),穿透力强;\n- 蓝光、紫光的波长较短(约400-500纳米),更容易被散射。\n\n### 2. 大气分子的“选择性散射”\n地球大气中充满了氮气、氧气等微小分子,它们的直径远小于可见光的波长。根据瑞利散射原理:**光的散射强度与波长的4次方成反比**——波长越短,被散射的概率越高。\n因此,蓝光、紫光这类短波长光,会被大气分子向四面八方散射,布满整个天空。\n\n### 3. 人眼的“感知偏好”\n虽然紫光的波长比蓝光更短,散射强度也更高,但人眼的视觉细胞对紫光的敏感度远低于蓝光,同时太阳光中紫光的本身含量也比蓝光少。因此,我们的眼睛最终捕捉到的,是被广泛散射后的“天空蓝”。\n\n### 补充:早晚天空为什么是红橙色?\n清晨或傍晚时,太阳角度低,光线需要穿过更厚的大气层。此时短波长的蓝光、紫光几乎被完全散射殆尽,只剩下穿透力强的长波长红光、橙光抵达我们的眼睛,所以天空会呈现出暖色调的红橙色。","role":"assistant"}}],"created":1768279556,"id":"021768279264005000000000000000000000000000000008aeaa6","model":"doubao-seed-2-1-pro-260628","service_tier":"default","object":"chat.completion","usage":{"completion_tokens":808,"prompt_tokens":53,"total_tokens":861,"prompt_tokens_details":{"cached_tokens":0}}}}}
步骤六:(可选)订阅通知
- 申请开通 SNS ,请提交 工单 申请“SNS 开白”,并同步申请对应的消息事件:
- BatchJobFinished:批量推理任务完成。
- BatchJobFailed:批量推理任务失败。
- 在主题页面创建主题。
配置信息 | 操作参考 |
| |
- 在云服务事件订阅页面创建事件订阅。
配置信息 | 操作参考 |
| |
- 在订阅页面配置订阅信息。
配置信息 | 操作参考 |
| |
订阅信息配置完成后,SNS 会向接收端发送对应的确认链接,需确认该链接完成订阅。确认链接 demo 如下,需要回调示例中的 SubscribeURL。
{
"Type": "SubscriptionConfirmation",
"MessageId": "f11b9a8f-****",
"TopicTrn": "trn:sns:cn-beijing:2100000825:topic/test",
"Message": "You have chosen to subscribe to the topic trn:sns:cn-beijing:2100000825:topic/wyy_test. To confirm the subscription, visit the SubscribeURL included in this message.",
"Timestamp": "2025-01-14T07:18:59Z",
"SignatureVersion": "1",
"Signature": "MEUCIB3NsKw***=",
"SigningCertURL": "https://sns-public-cn-beijing.tos-cn-beijing.volces.com/certificates/cn-beijing-a31d91fc-0683-****.pem",
"SubscribeToken": "eyJhbGciOiJIUzI1Ni****",
"SubscribeURL": "https://sns.cn-beijing.volcengineapi.com?Action=ConfirmSubscription&Version=2023-01-01&Token=eyJhbGc***"
}
- 回调成功后可在订阅页面看到对应的订阅状态为已确认,表示订阅已完成。

订阅信息内容格式如下:
批量推理接入点开发教程
注意:Batch Chat API 已标记为待下线。 新业务建议直接使用 Chat API 并在请求中设置 service_tier=flex(即 在线推理(低优))处理批量数据;存量业务请尽早规划迁移。
可通过批量推理接入点的方式,用较小的成本将业务从在线推理迁移至批量推理。
说明
快速入门
步骤一:创建批量推理接入点
- 打开 批量推理创建页面。
- 按照页面进行配置,其中调用方式配置项,选择创建批量推理接入点。
- 创建成功后,在批量推理页面的接入点页签,可以查看批量推理接入点 ID。
批量推理接入点ID的格式为:ep-bi-***。

步骤二:使用批量推理接入点接口进行批量推理
使用批量推理接入点接口快速发起一个批量推理请求,其中<Model>需替换为步骤一中创建的批量推理接入点 ID。
import os
from arkruntime import Ark
client = Ark(
api_key=os.environ.get("ARK_API_KEY"),
base_url="https://ark.cn-beijing.volces.com/api/v3",
# 推荐配置 24 小时超时,避免高负载场景下请求排队超时
timeout=3600*24,
)
completion = client.batch.chat.completions.create(
# 替换 <Model>为批量推理接入点 ID
model="<MODEL>",
messages=[
{"role": "user", "content": "你好"}
]
)
print(completion.choices[0].message.content)
使用说明及建议
为了充分发挥批量推理任务高配额的优势,使用批量推理接入点时,建议保持高并发推压,例如创建大量(10万+)线程/协程进行并发请求,并配置较长的超时时间,保障任务的完成率。
配置超时时间
为避免服务端高负载时大量请求因排队超时失败,推荐手动配置较长的请求超时时间。
- 超时字段及配置:timeout,推荐配置 24~72 小时(取值支持 1 ~ 72 小时)。
- 注意事项:
- 配置较长的超时时间:不会影响配额使用,可放心设置。
- 配置较短的超时时间:不建议,在深度思考、长文本输出等需要较长时间回复的场景,请求容易中途超时断开连接,既浪费 token 成本,又无法输出内容。
使用批量推理接入点时,无需手动配置重试策略,方舟会通过智能调度机制保障任务完成率。
- 客户端:在timeout设定的时间范围内自动重试,或按照服务端要求暂停后重试。
- 服务端:根据负载情况对请求做出暂不处理、排队、指定客户端若干时间后重试等操作。
- ...client = AsyncArk(api_key=os.environ.get("ARK_API_KEY"),base_url="https://ark.cn-beijing.volces.com/api/v3",# 使用异步接口并配置较高的超时时间,推荐24小时~72小时timeout=3600*24,)...
配置并发策略充分使用配额
方舟为每个主账户提供至少 10B token/天的配额,可通过配置请求并发数及副本数,将大量任务提交到方舟平台处理。方舟平台会根据业务负载智能调度任务执行,甚至在低负载时段提供超出基础配额的处理能力。
请求并发数workerNum表示向方舟服务端发起请求时的最大并发数,决定同一时间内单副本业务能够向服务端发起请求的最大数量。配置workerNum需结合业务预期最大峰值、请求平均时延、服务器并发上限等因素综合评估,以下是配置请求并发数及副本数的简单例子。
说明
业务预期的最大峰值 QPS 为 5000,单个请求的平均延时为 5 秒,部署在相应的机器或容器上。
关键的指标
- 业务并发数:5000*5 = 25000
- 服务器限制:不考虑业务层损耗,这里假设为 500 QPS。
副本数和并发数配置
如果需要应对业务峰值时的业务量,可部署更多副本(推荐)或提升服务器规格(不推荐):
- 副本数(预估的服务器数量):业务QPS/服务器限制=5000/500=10。
- 请求并发数workerNum(每个副本上设置并发数):服务器限制*请求平均延时=500*5=2500。
在代码实现上需注意:
- 创建 client 后、发起服务端请求前,需要启动 client 的相关线程。其中 Java 客户端自带线程池,无需额外手动启动。不同编程语言调用方法存在差异,具体参考下面代码示例。
- 单个副本中全局使用同一个 client(单例模式),避免创建大量实例造成资源开销与浪费。例如,Go SDK 中 client 的StartBatchWorker方法会创建workerNum个 goroutine,避免创建大量 client 带来的资源开销及浪费。
不同语言实现并发的示例代码如下:
相比多线程方式,异步协程的方式更优:
- 并发更高:当一个任务处于 I/O 等待状态(如网络请求)时,asyncio 可以立即切换到其他任务继续执行,避免了线程切换的开销,从而提高了整体的并发性能。
- 更轻量:协程是轻量级的执行单元,相比于线程,占用的系统资源更少,可以创建大量的协程来处理任务。
说明
批量推理属于标准的高 I/O 低计算场景,若您的系统适配的场景未使用同步 API,建议使用异步协程的方式。在大部分场景下,用异步协程能获得更优的效果。
# 导入异步编程相关库,用于处理异步任务,异步编程中协程是核心概念
import asyncio
# 导入系统相关库,可用于与 Python 解释器和系统进行交互,如标准错误输出
import sys
# 导入操作系统相关库,用于访问操作系统的功能,如读取环境变量
import os
# 导入日期时间处理库,用于记录和计算程序的执行时间
from datetime import datetime
# 导入火山引擎异步 Ark 客户端库,用于与火山引擎的 Ark 服务进行异步通信
from arkruntime import AsyncArk
async def worker(
# asyncio task 的协程唯一标识,用于区分不同的工作协程
worker_id: int,
# 异步 Ark 客户端实例,用于调用批量聊天完成接口处理请求
client: AsyncArk,
# 待处理请求的队列,存储需要处理的请求
requests: asyncio.Queue[dict],
):
"""
异步协程函数,负责从队列中获取请求并处理。
:param worker_id: 协程的唯一标识,用于在日志中区分不同的协程
:param client: 异步 Ark 客户端实例,通过该实例调用服务接口处理请求
:param requests: 待处理请求的队列,存储待处理的请求信息
"""
# 打印协程启动信息
print(f"Worker {worker_id} is starting.")
while True:
# 从队列中获取一个请求,若队列为空则会阻塞等待
# 这里的 await 关键字用于暂停协程的执行,等待队列中有元素可供获取
request = await requests.get()
try:
# 调用客户端的批量聊天完成接口处理请求,使用解包操作将请求字典作为参数传递
# 同样使用 await 关键字暂停协程,等待接口调用完成
completion = await client.batch.chat.completions.create(**request)
# 打印处理结果
print(completion)
except Exception as e:
# 若处理请求过程中出现异常,将错误信息打印到标准错误输出
print(e, file=sys.stderr)
finally:
# 标记该请求已处理完成,通知队列该任务已结束
requests.task_done()
async def main():
"""
主函数,负责初始化客户端、生成请求、启动协程并监控任务完成情况。
使用协程来实现并发处理请求,避免了使用线程带来的较大开销。
多个协程可以在一个线程中并发执行,提高程序的性能。
"""
# 记录程序开始执行的时间
start = datetime.now()
# 定义协程数量和任务数量,此处示例为避免过度消耗资源,设置为较小值,实际使用请按需调整
worker_num, task_num = 10, 100
# 创建一个异步队列用于存储请求,该队列支持异步操作
requests = asyncio.Queue()
# 初始化异步 Ark 客户端
client = AsyncArk(
# 从环境变量中获取 API 密钥,确保密钥的安全性
api_key=os.environ.get("ARK_API_KEY"),
# 设置超时时间为24小时,建议超时时间设置尽量大些,推荐24小时~72小时,避免因网络等原因导致请求超时
timeout=24 * 3600,
# 设置 base_url,指定与服务通信的基础 URL
base_url="https://ark.cn-beijing.volces.com/api/v3",
)
# 模拟 `task_num` 个任务,将请求信息添加到队列中
for _ in range(task_num):
await requests.put(
{
# 替换为你的批量推理接入点 ID,指定要调用的服务端点
"model": "<YOUR_ENDPOINT_ID>",
"messages": [
{"role": "user","content": "hello"}
]
}
)
# 创建 `worker_num` 个 asyncio task 的协程,并启动它们,每个协程负责处理队列中的请求
# 这些协程会在一个线程中并发执行,通过协程的切换来提高效率
tasks = [
asyncio.create_task(worker(i, client, requests))
for i in range(worker_num)
]
# 等待所有请求处理完成,即队列中的所有任务都被标记为已完成
await requests.join()
# 停止所有协程,取消所有正在运行的任务
for task in tasks:
task.cancel()
# 等待所有协程取消完成,确保所有任务都已停止
await asyncio.gather(*tasks, return_exceptions=True)
# 关闭客户端连接,释放资源
await client.close()
# 记录程序结束执行的时间
end = datetime.now()
# 打印程序总执行时间和处理的总任务数
print(f"Total time: {end - start}, Total task: {task_num}")
if __name__ == "__main__":
# 运行异步主函数,启动整个程序
# asyncio.run() 会创建一个事件循环,并在这个事件循环中运行主协程
asyncio.run(main())
与在线推理接入点使用类似,需要额外进行配置的信息如下。
- 设置超时时间timeout。
- 配置的并发线程数和线程中运行的任务数。
- 异步方法调用client.batch.chat.completions方法。
- # 导入 queue 模块,用于创建队列import queueimport sysimport osfrom datetime import datetime# 从 multiprocessing.pool 模块导入 ThreadPool 类,用于创建线程池from multiprocessing.pool import ThreadPool# 导入方舟SDKfrom arkruntime import Arkdef worker(# 线程的唯一标识worker_id: int,# Ark 客户端实例client: Ark,# 待处理请求的队列requests: queue.Queue[dict],):"""线程函数,负责从队列中获取请求并处理。:param worker_id: 线程的唯一标识:param client: Ark 客户端实例:param requests: 待处理请求的队列"""print(f"Worker {worker_id} is starting.")while True:# 从队列中获取一个请求request = requests.get()# 检查是否收到无更多请求的信号if not request:# 将信号放回队列,以便其他线程也能收到requests.put(request)returntry:# 执行请求completion = client.batch.chat.completions.create(**request)print(completion)except Exception as e:# 打印错误信息到标准错误输出print(e, file=sys.stderr)finally:# 标记该请求已处理完成requests.task_done()def main():"""主函数,负责初始化客户端、生成请求、启动线程并监控任务完成情况。"""# 记录开始时间start = datetime.now()# 最大并发任务数和总任务数,此处示例为避免意外消耗资源,设置为较小值,实际使用请按需调整worker_num, task_num = 10, 100# 创建一个队列用于存储请求requests = queue.Queue()# 初始化 Ark 客户端,设置超时时间为 24 小时client = Ark(# 从环境变量中获取 API 密钥api_key=os.environ.get("ARK_API_KEY"),# 设置超时时间为24小时,建议超时时间设置尽量大些,推荐24小时~72小时timeout=24 * 3600,# 设置 base_urlbase_url="https://ark.cn-beijing.volces.com/api/v3",)# 模拟 `task_num` 个任务for _ in range(task_num):requests.put({# 替换为你的批量推理接入点 ID"model": "<YOUR_ENDPOINT_ID>","messages": [{"role": "user", "content": "Hello"},],})# 放入一个请求结束的信号requests.put(None)# 创建 `worker_num` 个线程并启动它们with ThreadPool(worker_num) as pool:for i in range(worker_num):# 异步执行线程函数pool.apply_async(worker, args=(i, client, requests))# 关闭线程池,不再接受新的任务pool.close()# 等待所有任务完成pool.join()# 关闭客户端连接client.close()# 记录结束时间end = datetime.now()print(f"Total time: {end - start}, Total task: {task_num}")if __name__ == "__main__":# 运行主函数main()
与在线推理接入点使用类似,需要额外进行配置的信息如下。
- 配置超时时间timeout。
- 添加 arkruntime.WithBatchMaxParallel 选项,设置发起请求的最大并发数量。
- 方法换成client.CreateBatchChatCompletion方法。
- package mainimport ("context""encoding/json""fmt""os""sync""time""github.com/volcengine/ark-runtime-go/arkruntime""github.com/volcengine/ark-runtime-go/arkruntime/model/chat")func main() {// 使用 API Key创建一个新的客户端实例client := arkruntime.NewClientWithApiKey(os.Getenv("ARK_API_KEY"),arkruntime.WithBatchMaxParallel(10), // 设置发起请求的最大并发数量arkruntime.WithBaseUrl("https://ark.cn-beijing.volces.com/api/v3"),)// 手动构造100个请求,在实际应用中,你可以从文件、消息队列或数据库中加载真实的请求requests := MockRequests("YOUR_ENDPOINT_ID", 100)wg, ctx := sync.WaitGroup{}, context.Background()// 可以在这里设置全局的超时时间,如果超过这个时间,所有的请求都会被取消,这里设置为24小时ctx, cancel := context.WithTimeout(ctx, 24*time.Hour)defer cancel()// 发起请求for request := range requests {wg.Add(1)// 异步发起请求go func(request chat.ChatCompletionRequest) {defer wg.Done()// 可以在这里设置每个请求的超时时间,如果超过这个时间,这个请求会被取消ctx, cancel := context.WithTimeout(ctx, 24*time.Hour)defer cancel()// 发起批量推理请求result, err := client.CreateBatchChatCompletion(ctx, &request)if err != nil {fmt.Fprintln(os.Stderr, err)} else {fmt.Println(MustMarshalJson(result))}}(request)}// 等待所有协程完成任务wg.Wait()}// MockRequests 模拟生成请求,这里只是简单地生成了 count 个相同的请求。// 在实际应用中,你可以从文件、消息队列或数据库中加载真实的请求。func MockRequests(endpoint string, count int) <-chan chat.ChatCompletionRequest {requests := make(chan chat.ChatCompletionRequest)go func() {defer close(requests)for i := 0; i < count; i++ {requests <- chat.ChatCompletionRequest{Model: endpoint,Messages: []chat.ChatCompletionRequestMessage{userMessage("Hello"),},}}}()return requests}func MustMarshalJson(v interface{}) string {s, _ := json.Marshal(v)return string(s)}func userMessage(content string) chat.ChatCompletionRequestMessage {return chat.ChatCompletionRequestMessage{OneOf: chat.NewChatCompletionRequestUserMessageChatCompletionRequestMessageSum(chat.ChatCompletionRequestUserMessage{Role: chat.ChatCompletionRequestUserMessageRoleUser,Content: chat.NewOptNilChatCompletionMessageContent(chat.NewStringChatCompletionMessageContent(content),),},),}}
与在线推理接入点使用类似,需要额外进行配置的信息如下。
- 设置超时时间timeout。
- 设置最大线程数和线程任务数。
Java SDK中自带线程池,所以无需批量线程启动的方法。
- 调用ChatCompletionRequest类,启动批量推理。
- package com.example;import com.volcengine.ark.runtime.models.chat.*;import com.volcengine.ark.runtime.service.ArkService;import okhttp3.ConnectionPool;import okhttp3.Dispatcher;import java.time.Duration;import java.util.ArrayList;import java.util.List;import java.util.concurrent.CountDownLatch;import java.util.concurrent.ExecutorService;import java.util.concurrent.Executors;import java.util.concurrent.TimeUnit;public class BatchChatCompletionsExample {public static void main(String[] args) {// 为batch chat设置一个较大的超时时间,推荐24小时到72小时之间Duration timeout = Duration.ofHours(24);// 您需要根据自己的需求配置最大线程数和每个线程执行的任务数int workerNum = 100;int taskNum = 5;// 您需要将自己的API密钥设置为环境变量String apikey = System.getenv("ARK_API_KEY");ConnectionPool connectionPool = new ConnectionPool(workerNum, 10, TimeUnit.MINUTES);Dispatcher dispatcher = new Dispatcher();dispatcher.setMaxRequests(workerNum);dispatcher.setMaxRequestsPerHost(workerNum);// 请单独为batch chat单独初始化一个service实例,且多个Endpoint间也不要复用同一个service实例,避免互相影响。// 单个service会根据最大并发数启动对应的线程池,会占用一定的资源。ArkService service = ArkService.builder().dispatcher(dispatcher).timeout(timeout).connectionPool(connectionPool).apiKey(apikey).baseUrl("https://ark.cn-beijing.volces.com/api/v3").build();ExecutorService executorService = Executors.newFixedThreadPool(workerNum);CountDownLatch latch = new CountDownLatch(workerNum);Runnable batchChatTask = () -> {System.out.println(Thread.currentThread().getName() + ":在此线程中执行任务");for (int i = 0; i < taskNum; i++) {// 每个线程执行的任务逻辑,您需要按照自己业务需求进行改造,这里作为示例,展示一个最简单对话的例子try {final List<ChatCompletionRequestMessage> messages = new ArrayList<>();final ChatCompletionRequestMessage userMessage = ChatCompletionRequestUserMessage.builder().role(ChatCompletionRequestMessageType.USER).content(ChatCompletionMessageContent.ofString("Hello")).build();messages.add(userMessage);ChatCompletionRequest batchChatCompletionRequest = ChatCompletionRequest.builder()// 您需要替换您的批量推理接入点ID.model("<YOUR_ENDPOINT_ID>").messages(messages).build();service.createBatchChatCompletion(batchChatCompletionRequest).getChoices().forEach(choice -> System.out.println(Thread.currentThread().getName() + ":"+ choice.getMessage().getContent()));} catch (Exception e) {System.out.println(Thread.currentThread().getName() + ":请求" + i + "失败。");System.out.println(" 报错信息:" + e.getMessage());}}System.out.println(Thread.currentThread().getName() + ":此线程中任务完成。");latch.countDown();};for (int i = 0; i < workerNum; i++) {executorService.submit(batchChatTask);}try {latch.await();} catch (InterruptedException ignored) {}System.out.println("所有线程已退出");executorService.shutdown();System.out.println("线程池已退出");// 当所有请求完成,请关闭服务service.shutdownExecutor();}}
视觉理解批量任务说明
- 传入图片/视频的方式要求:批量推理接入点支持 TOS 链接(推荐)、其他可访问的链接、Base64 编码三种传入方式。
- 图片链接需要保持长期可用(推荐 7 天)。TOS 预签名链接默认有效期为 1 小时,需手动设置 expires 参数变更过期时间(建议 7 天),避免因链接过期导致任务失败。完整签名字段说明见 TOS 预签名文档。
...
# 1. 创建TOS客户端
client = tos.TosClientV2(AK, SK, ENDPOINT, REGION)
# 2. 生成“下载图片”的预签名URL(GET方法,有效时间3600秒)
download_pre_signed = client.pre_signed_url(
HttpMethodType.Http_Method_Get, # 下载用GET方法(核心!)
bucket_name=BUCKET_NAME,
key=OBJECT_KEY,
expires=604800 # 下载URL有效期,可按需调整(如86400=24小时)
)
...
配额说明
TPD 配额
不同模型的 TPD 配额不同,实际配额以控制台显示信息为准。
- 配额单位:是 TPD(Tokens Per Day),指 24 小时内可消耗的 token 配额。
- 配额共享:此配额是基于模型设定的,账户下使用同一模型的所有批量推理任务共享该额度。
- 不区分子账号,即账户下所有子账号均共享配额。
- 不区分版本,即同系列模型下的不同版本共享配额。
- 配额隔离:额度与在线推理的模型限流(在线推理限流请参见 开通管理 页)隔离。运行批量推理任务不会消耗模型的在线推理限流。
- 超配额任务:当用户提交超 TPD 配额任务,会在平台资源空闲时尝试继续执行。
其他配额
- 单任务文件大小,默认 5 GB;如有需要可以 工单 申请提额。
- 账户维度还有如下配额:
- 提交任务数量限制:单项目下 7 天内提交的批量推理任务数量最多为 5000,超出时将暂时无法提交新的任务。
- 同时运行中的任务数量限制:单项目下同时处于「运行中」状态的批量推理任务数量最多为 20,超出时其余任务将处于「排队中」状态等待运行。
账号下实际同时运行的任务数量会受到平台总体资源的限制和任务调度策略的影响。
API 文档
计费说明
常见问题
最近更新时间:2026.09.29 19:12:58
这个页面对您有帮助吗?
有用
有用
无用
无用