火山方舟
火山方舟


文档指南

请输入


- 文档首页
 火山方舟调用进阶使用GUI Agent 能力
 复制全文
 下载 pdf
GUI Agent 能力
 文档反馈
 问问助手
本文介绍如何使用方舟接口调用模型,构建 GUI Agent 应用,实现基于界面截图和提示词解析出可执行的动作意图。本文提供两种用法:GUI Agent 输出离散动作、纯 Grounding 单步定位,其中调用使用原生 OpenAI SDK(不传 tools),动作解析使用 ui-tars 官方解析器。
说明
支持模型
Doubao Seed 系列模型。
任务流程:观察-决策-动作的回环
任务流程图
让模型像人一样操作图形界面:看屏幕截图 → 想下一步做什么 → 动手执行 → 再看新的屏幕……如此循环,直到任务完成。

任务结束:输出纯文本且不含 <seed:tool_call> 时,视为任务完成并结束回环,该纯文本即为最终答案。
本文给到的两种用法:
- GUI Agent(方式一):会执行上述步骤1-4,其中步骤4会解析成可执行动作,未将动作打到真实设备。
- 纯 Grounding(方式二):只执行上述步骤1-3,输出 click 坐标。
关键约定
不传 tools
调用 chat.completions.create 时 不要 传 tools 参数。
原理:模型经训练会按 system prompt 里的动作说明,把动作块 直接写进 message.content,形如:
思维链在独立字段 message.reasoning_content(content 里没有 <think> 外壳)。若你传了 tools,会走 OpenAI function calling,输出格式完全不同,与本指南不兼容。
坐标转换
所有点击 / 拖拽类坐标都是 0–1000 的相对坐标,与截图分辨率无关。
原理:模型输出 <point>x y</point>,其中 x、y 都在 [0, 999] 归一化空间内。相对坐标映射回真实像素的公式:
使用方式及选型
快速上手
代码示例
下面是本文用到的代码示例,可下载到本地按运行步骤快速体验。
运行步骤
- 安装依赖
-
- 配置凭证
-
- 编辑 .env 文件,填写以下信息:
- ARK_API_KEY:获取 API Key
- ARK_MODEL:选择 Doubao Seed 系列模型
- 运行示例
-
方式一:GUI Agent - 纯 GUI
模型根据 system prompt(任务框架 / 动作定义)、界面截图,对输出信息通过用官方解析器解析出动作。
任务 | 输出 |
Open the Firefox browser and navigate to github.com. Complete the task step by step using the available GUI functions. | 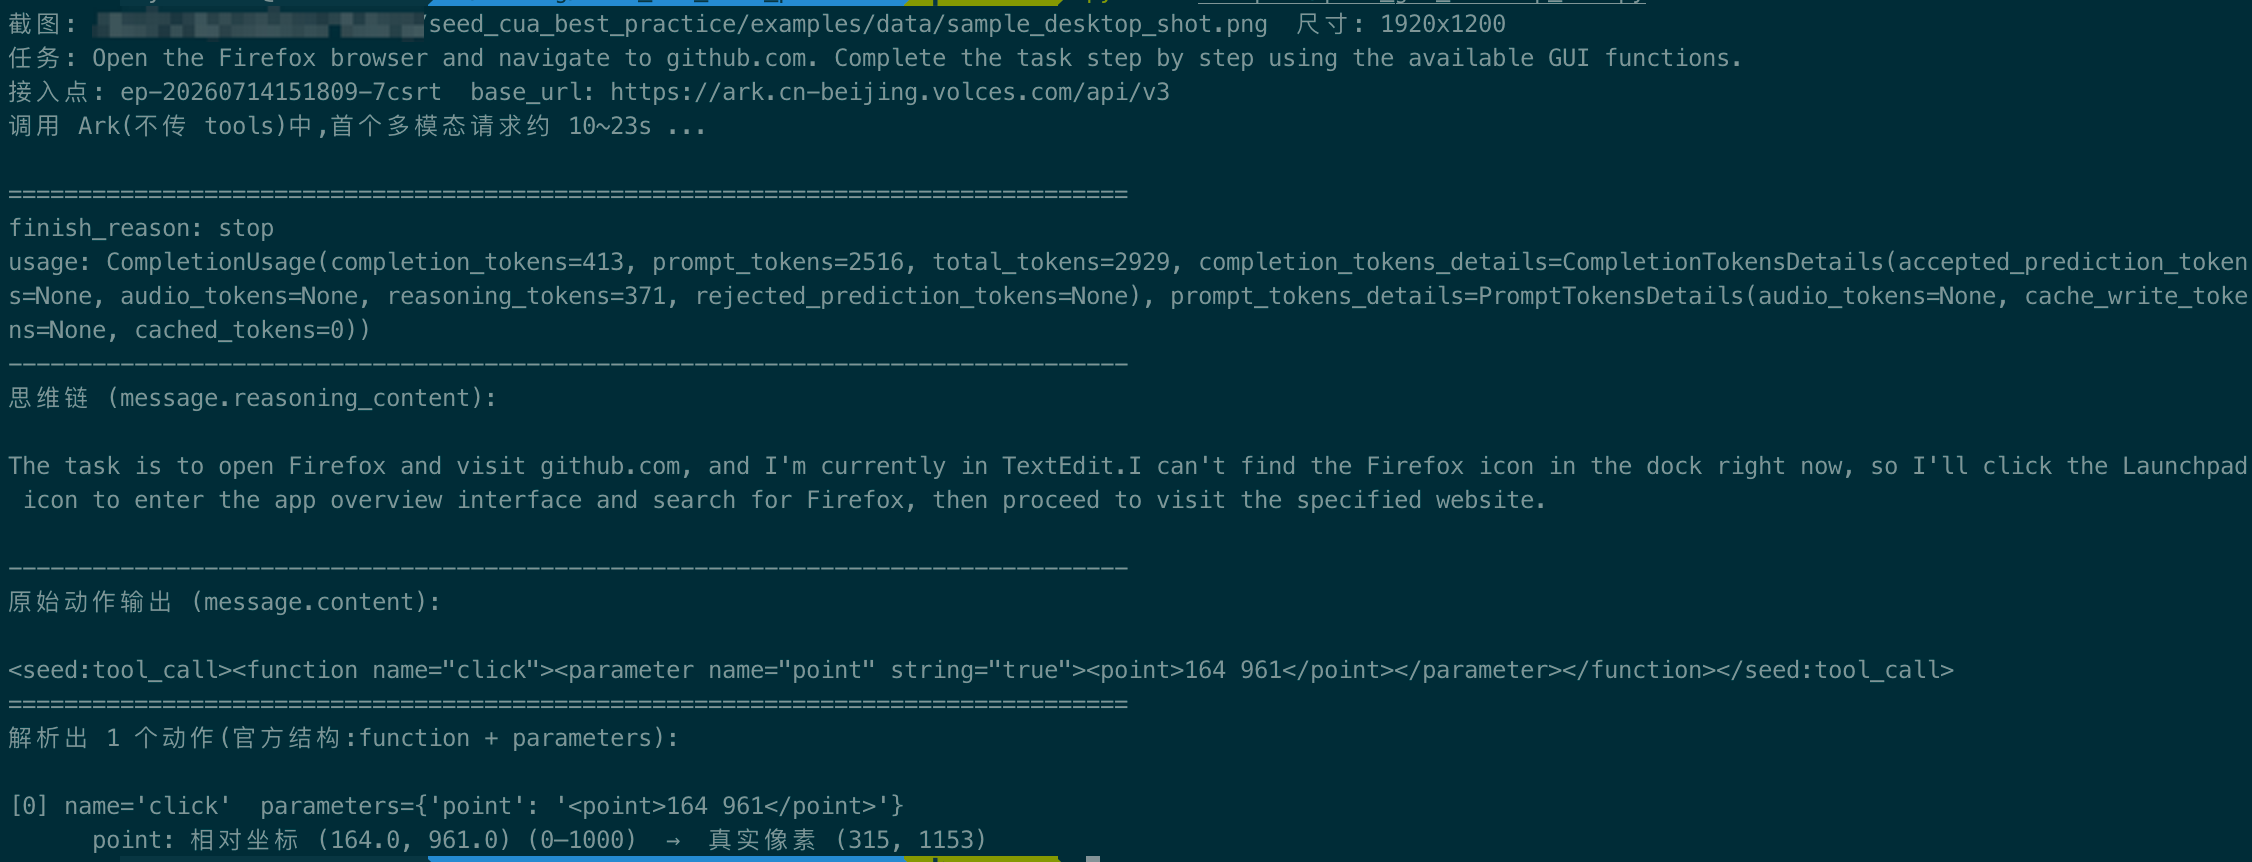 |
1. 图片读取与Base64编码
读取界面截图,并将其转换为Base64字符串格式,以便通过 API 传输。同时返回图片原始尺寸 size=(img.width, img.height),供后续步骤做像素映射。
2. 构造对话信息(系统提示词 + 用户信息)
- system prompt 如下:
- TASK_SP(任务框架):任务描述、历史动作、截图,请输出下一动作。
- FUNCTION_SP(动作定义):把 8 个离散动作(click / drag / hotkey / left_double / right_single / scroll / type / wait)以 JSON 格式列出,并给出 <seed:tool_call> 的调用格式。
- 用户信息:构造包含text、image_url 的多模态 user 消息。
需要构造的 message 如下:
核心代码
3. 调用模型推理(不传 tools)
调用模型(不传 tools):模型会按 system prompt 把动作块写进message.content(如<seed:tool_call>),思维链放在message.reasoning_content。
核心代码:
4. 解析动作
动作解析
动作解析直接调 ui-tars 包的官方解析器,返回官方结构 [{"function":..., "parameters":...}],按出现顺序排列,自动兼容多个 <seed:tool_call> 块、单块多 <function>(串行 / 并行 / 多动作预测)。
注意
返回空列表(没有任何 <function> 动作块):表示模型以纯文本收尾,交互结束。
动作坐标映射
遍历每个动作,逐个打印 name 与 parameters。将模型返回的相对坐标映射回真实像素坐标。
核心代码
方式二:纯 Grounding (单步定位)
不跑回环,只做单步定位:一条指令 + 一张截图 → 模型输出一个 <seed:tool_call> 的 click 动作,坐标是 0–1000 相对坐标,按截图宽高换算成像素,即定位到目标元素。示例脚本是批量评测, 用一批带标注的样本跑分做接入对齐校验,单样本处理在 process_item。
与 GUI Agent 的本质区别:Grounding 是单步定位,输入端就给定了截图、输出端只给一个坐标, 没有多轮回环、不判结束、也不真正执行动作。它回答的是给定意图,目标元素在屏幕上的哪个坐标, 而不是自主一步步把任务做完。拿到坐标后要不要点、点了之后怎么办,由用户自己的逻辑决定。
针对方式二的步骤不详细介绍,您可以查看代码示例。下面重点介绍一下构造对话信息。
动作空间只保留 click:
- build_click_function_prompt(decimals):system prompt,含 click 定义 + <seed:tool_call> 调用格式 + 坐标精度说明。
- build_user_prompt_template(decimals):user 模板。
核心代码
核心代码
参考对齐分数
用一批带标注 bbox 的 grounding 样本跑分,拿到一个对齐分数做健康校验 —— 分数落在参考区间,即说明你的接入点 / 环境与我们跑分口径一致,可以放心接入。
以下分数使用 doubao-seed-2.1-turbo(火山 Ark 推理接入点)跑出,换用其他模型/版本分数会不同,对齐时请确认接入点对应的是同一模型。
单档 3000×3000 分辨率、temperature=0、整数坐标下的参考分数:
数据集 | Accuracy | 命中 / 样本 |
sspro | ~54–56% | 27–28 / 50 |
osworld-g | ~84–86% | 42–43 / 50 |
总体 | ~69–71% | 69–71 / 100 |
如何跑(在 examples/data/grounding_samples/ 目录下):
使用说明
- reasoning_content vs content:
- message.content:动作块(<seed:tool_call>...)就在这里,没有<think> 外壳。
- message.reasoning_content:思维链。
- 手动拼<think> 外壳:
- 如果你的下游解析 / 训练数据期望<think>思考</think>{动作}这种单字符串格式,手动拼接如下,具体可参考代码示例中ModelReply.content_with_think()。
-
- 多模态与超时:
- 图片放 content 数组的 image_url。
- RGBA 图片建议先 convert("RGB") 再编码。
- 首个多模态请求约 10~23s,timeout设置≥ 120。
- 限流与并发:Ark 有并发限制,Grounding 批量评测并发建议 4–8,--max-retries ≥ 3;首个多模态请求较慢,--timeout 默认 300s。
最近更新时间:2026.09.08 01:17:52
这个页面对您有帮助吗?
有用
有用
无用
无用