火山方舟
火山方舟


文档指南

请输入


- 文档首页
 火山方舟推理在线推理(低延迟)
 复制全文
 下载 pdf
在线推理(低延迟)
 文档反馈
 问问助手
在线推理(低延迟) 通过按需付费的方式,为延迟敏感场景提供更优的输出 token 生成速率(TPOT)体验。在请求中指定 service_tier=fast,即可降低延迟;当触发限流或突增流量保护时,请求将自动降级为 在线推理(常规)。
主要优势
- 低接入成本:无需购买保障包即可使用,按 token 计费。
- 更低的输出延迟(TPOT):适用于外呼、智能硬件、实时交互等对输出生成速度敏感的场景。
- 自动降级:当超出 fast 限流或命中 QoS 防护时,系统会将请求降级到在线推理(常规),保证请求尽可能可用。
适用场景
- 对交互延迟高度敏感:语音外呼、客服助手、智能硬件、实时陪伴类应用。
- 请求流量有一定波动,希望按需付费,同时在高峰时保持较好延迟体验。
- 已有保障包,但仍希望在保障包外溢出流量上获得更好延迟体验。
支持范围
支持模型
- doubao-seed-2-1-lite-260915
- doubao-seed-2-1-turbo-260628
- doubao-seed-2-0-pro-260215
- doubao-seed-2-0-lite-260428
- doubao-seed-2-0-lite-260215
- doubao-seed-2-0-mini-260428
说明
不支持精调模型与分支模型。实际可用模型以控制台与接口返回为准。
支持 API
- Responses API:注意 tools 仅支持自定义工具(Function Calling);上下文缓存仅支持隐式缓存。
使用流程
准备工作
开通服务及获取 API Key
- 开通模型及低延迟推理服务:在 开通管理 页面,选择目标模型,在 操作 列,开通模型服务;并打开对应模型的 低延迟 列开关。
说明
开通模型的低延迟服务后,该模型对应的所有推理接入点级别的低延迟开关将默认打开。如果某个推理接入点不希望使用低延迟推理,可手动关闭低延迟开关。
- 在 API Key 管理 页,创建/获取 API Key ,并将其配置为环境变量 ARK_API_KEY(详情参见 环境变量配置指南)。
可通过以下任一方式使用在线推理(低延迟)。
方式一:在 API 请求中指定服务档位
预置推理接入点和自定义推理接入点均支持此方式,适合在同一推理接入点上按请求切换服务档位。
- 使用预置推理接入点,通过 Model ID 调用即可。
- 使用自定义推理接入点,请先 创建推理接入点 ,获取 Endpoint ID。注意保持 低延迟(Fast)推理 开关处于开启状态,否则将无法使用低延迟推理。
Chat API
配置 service_tier 为 fast。
# 安装 sdk 参见 https://ark.volcengine.com/region:cn-beijing/docs/ark/install-and-upgrade-sdk
import os
from arkruntime import Ark
client = Ark(
api_key=os.environ.get("ARK_API_KEY"),
# The base URL for model invocation
base_url="https://ark.cn-beijing.volces.com/api/v3",
)
completion = client.chat.completions.create(
# 自定义推理接入点需配置为 Endpoint ID
model="doubao-seed-2-1-turbo-260628",
messages=[
{"role": "user", "content": "Hello"},
],
service_tier="fast", # 默认auto,需手动配置为 fast。
)
print(completion.choices[0].message)
Responses API
配置 service_tier 为 fast。
# 安装 sdk 参见 https://ark.volcengine.com/region:cn-beijing/docs/ark/install-and-upgrade-sdk
import os
from arkruntime import Ark
client = Ark(
api_key=os.environ.get("ARK_API_KEY"),
# The base URL for model invocation
base_url="https://ark.cn-beijing.volces.com/api/v3",
)
response = client.responses.create(
# 自定义推理接入点需配置为 Endpoint ID
model="doubao-seed-2-1-turbo-260628",
input="hello",
service_tier="fast", # 默认 default,需手动配置为 fast。
)
print(response)
方式二:在推理接入点配置默认服务档位
仅自定义推理接入点支持此方式,适合整条业务链路默认使用在线推理(低延迟)、但不希望修改调用代码的场景。
- 创建推理接入点 ,获取 Endpoint ID。
- 保持 低延迟(Fast)推理 开关处于开启状态。
- 找到 默认参数 配置,将 service_tier 配置为 fast。
-
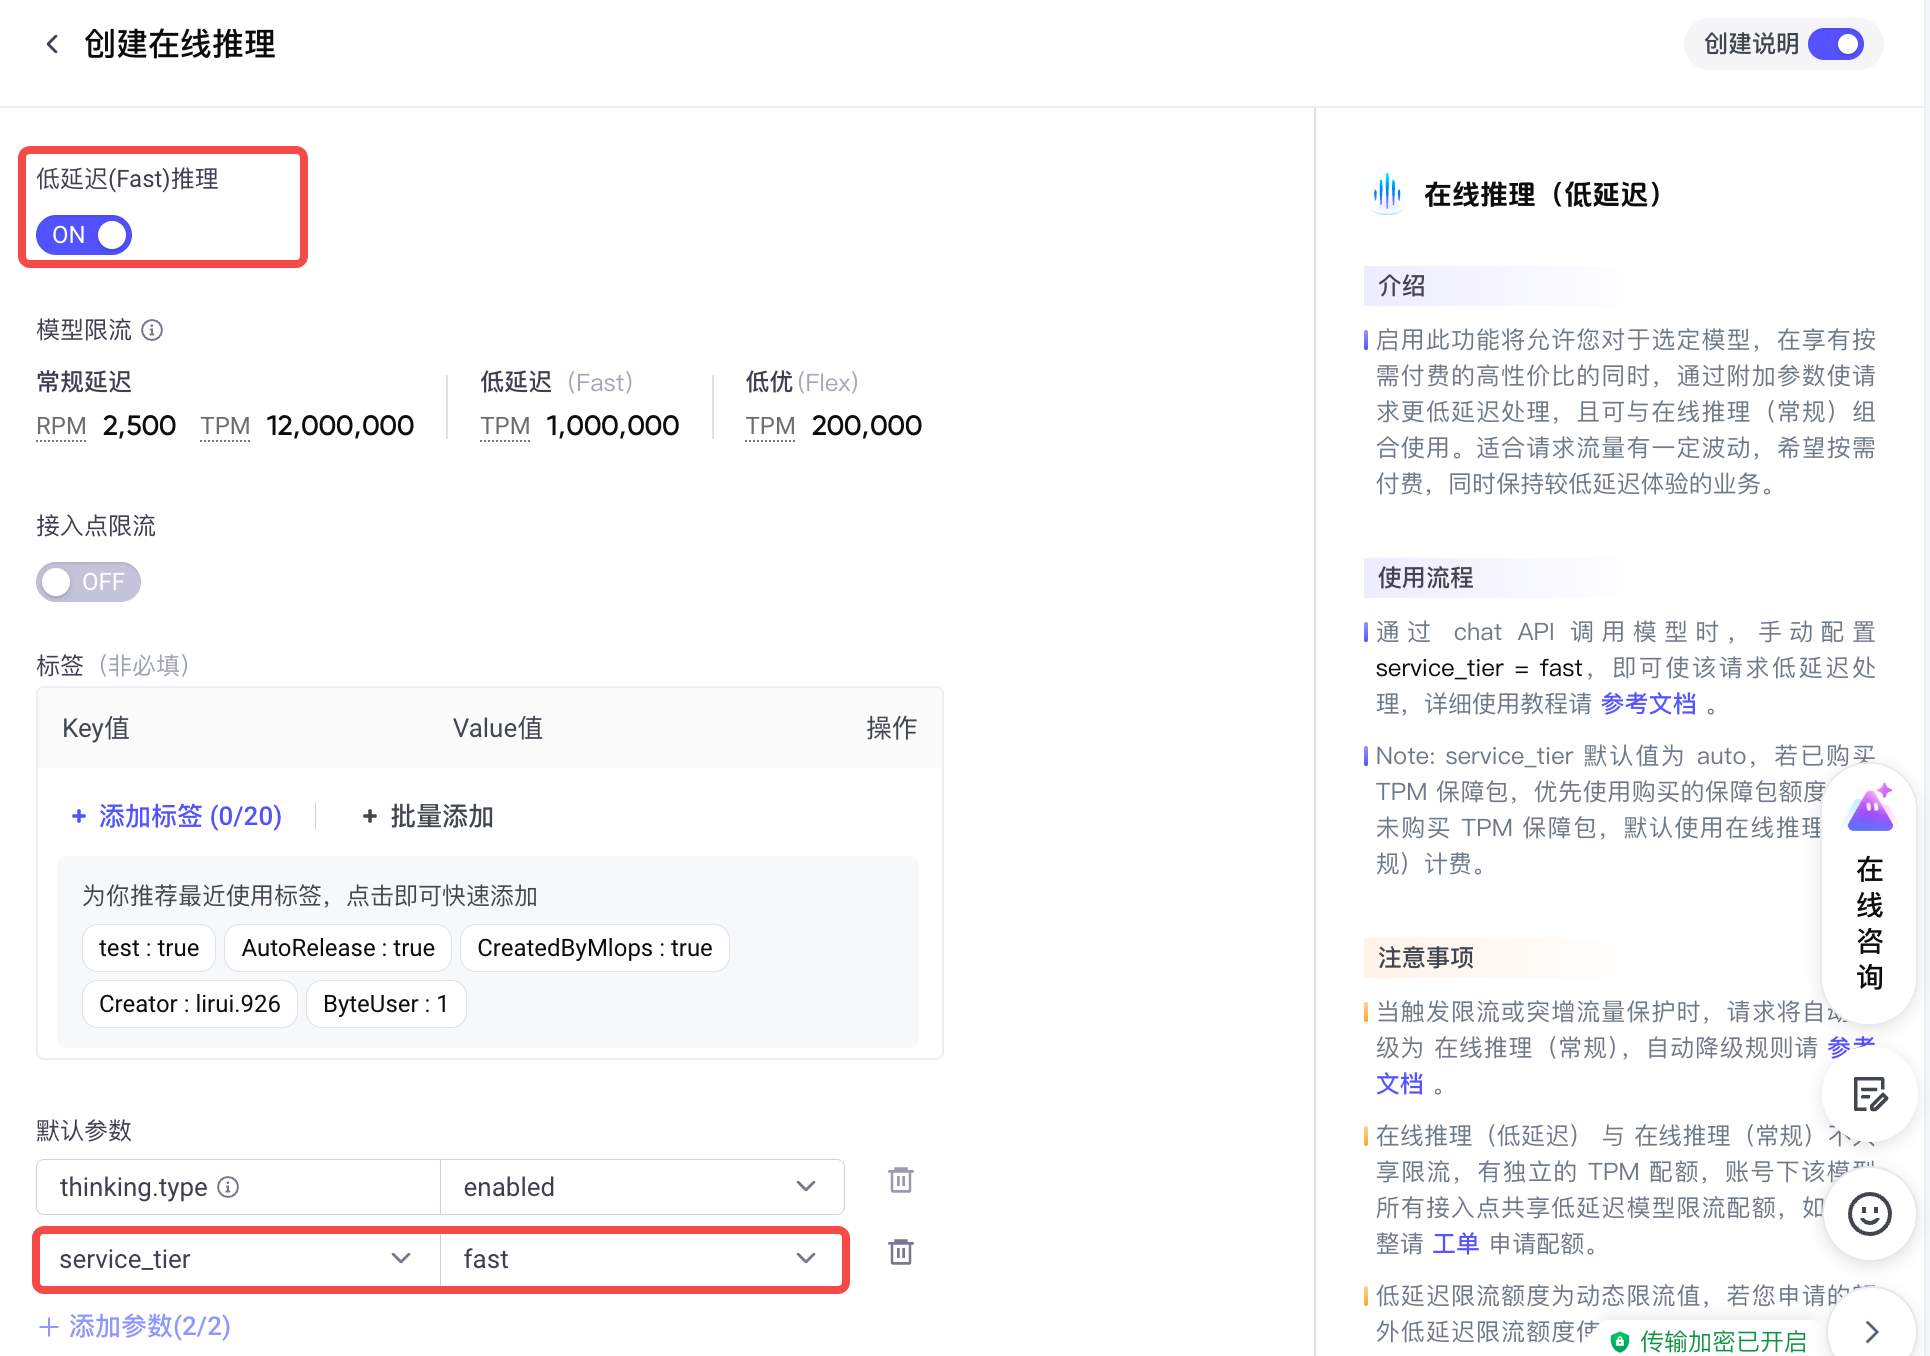
- 保存配置后,通过该推理接入点的 Endpoint ID 调用模型。未显式传入 service_tier 的请求默认使用在线推理(低延迟)。
注意
请求中显式指定的 service_tier 优先级高于推理接入点的默认服务档位。
计费说明
token 价格
token 统计口径
- 限流单位为 TPM(Tokens Per Minute),不拆分输入/输出。
- 不同输入长度区间的单价差异以对应模型的按 token 定价为准。
- 缓存命中部分的扣减限流逻辑与 在线推理(常规) 一致。
限流与降级
限流隔离与共享
- 在线推理(低延迟) 限流配额由推理接入点共享,即主账号下同模型的推理接入点共享 TPM 限流配额。可在推理接入点详情页为推理接入点单独配置低延迟限流 TPM 配额(默认不设限制,各接入点均可占满全部限流配额,超出限流将随机做降级处理)。
动态限流
为保障公平性,对超出模型默认低延迟 TPM 配额的账号,平台会实施动态限流,对长时间使用率过低的配额进行自动回收。详细规则如下:
- 若该模型过去 14 天 P95 低延迟 TPM 小于已分配低延迟限流额度的 1/3 且该模型过去 14 天峰值低延迟 TPM 小于已分配低延迟限流额度的 1/2,平台将回收低延迟限流额度到已分配额度的 1/3,最低回收到默认低延迟限流额度。
- 若该模型过去 14 天未使用低延迟推理,平台将回收低延迟限流额度到默认低延迟限流额度。
自动降级行为
- 限流限制:
- 计算限流时会按照设定预估输出长度,并进行预扣。当请求超过限流,请求将自动降级为 在线推理(常规)。
- 计算周期:10~15秒/周期。如15秒周期下,业务流量(15秒)超过 TPM/4 部分会降级为 在线推理(常规) 模式。请结合峰值 TPM 来评估 在线推理(低延迟) 限流配额,而非仅看分钟平均流量。
- 斜率限制:平台负载高时,为保证全局用户体验,每分钟超过20%(阈值可能随资源负载与请求长度调整)增长速度的流量将会被降级到 在线推理(常规) 模式。
- 降级处理:降级后会再次按 在线推理(常规) 的限流规则扣减(即: 超限的低延时请求不一定能请求成功,仍可能受默认限流影响)。
- 攻击/长请求防护:当检测到异常高并发或超长请求等风险时,平台会将请求降级到 在线推理(常规) 模式,以保护服务稳定。
监控与告警
建议重点关注以下指标(以控制台与监控面板实际展示为准)。
- fast 模式 TPM、错误率
- 延迟(TPOT)曲线
- 降级量(fast -> default)与降级比例
使用限制
在线推理(低延迟)不支持:
- 协作奖励计划
- 配置模型和接入点用量上限
- 安心体验:无法同时开启,即开启 在线推理(低延迟) 后,无法开启安心体验模式,反之亦然。
- 批量推理:在批量推理请求体中配置 service_tier 不生效。
错误码
最近更新时间:2026.09.30 16:16:44
这个页面对您有帮助吗?
有用
有用
无用
无用