火山方舟
火山方舟


文档指南
请输入


调用
视频生成
工具调用
使用 Responses API
推理
训练
模型精调
Managed Agents
配置 Agent 环境
管理 Agent 上下文
高级能力
- 文档首页
 火山方舟调用使用 Responses API多模态理解
 复制全文
 下载 pdf
多模态理解
 文档反馈
 问问助手
视觉模型支持传入图片、视频和文档,完成图像描述、视觉问答、内容审核等视觉相关任务。
支持模型
API文档
完整教程
Responses API 支持多种文件输入方式:Files API 上传文件、Base64 编码输入和文件 URL 传入。
本文重点介绍 Files API 上传文件方式。如需了解其他文件输入方式,以及图片/视频/文档格式要求、文件大小限制、视频抽帧策略等详情,请查看以下教程:
- 图片理解
- 视频理解
- 文档理解
图片理解
建议优先使用 Files API 上传本地文件,适用于图片文件较大,或者需要在多个请求中重复使用图片的场景。
该方式支持最大 512MB 的文件,默认存储 7 天,存储有效期取值范围为1-30天。
示例中用到的图片文件及提示词如下:
图片文件 | 提示词 |
图片文件 | 提示词 |
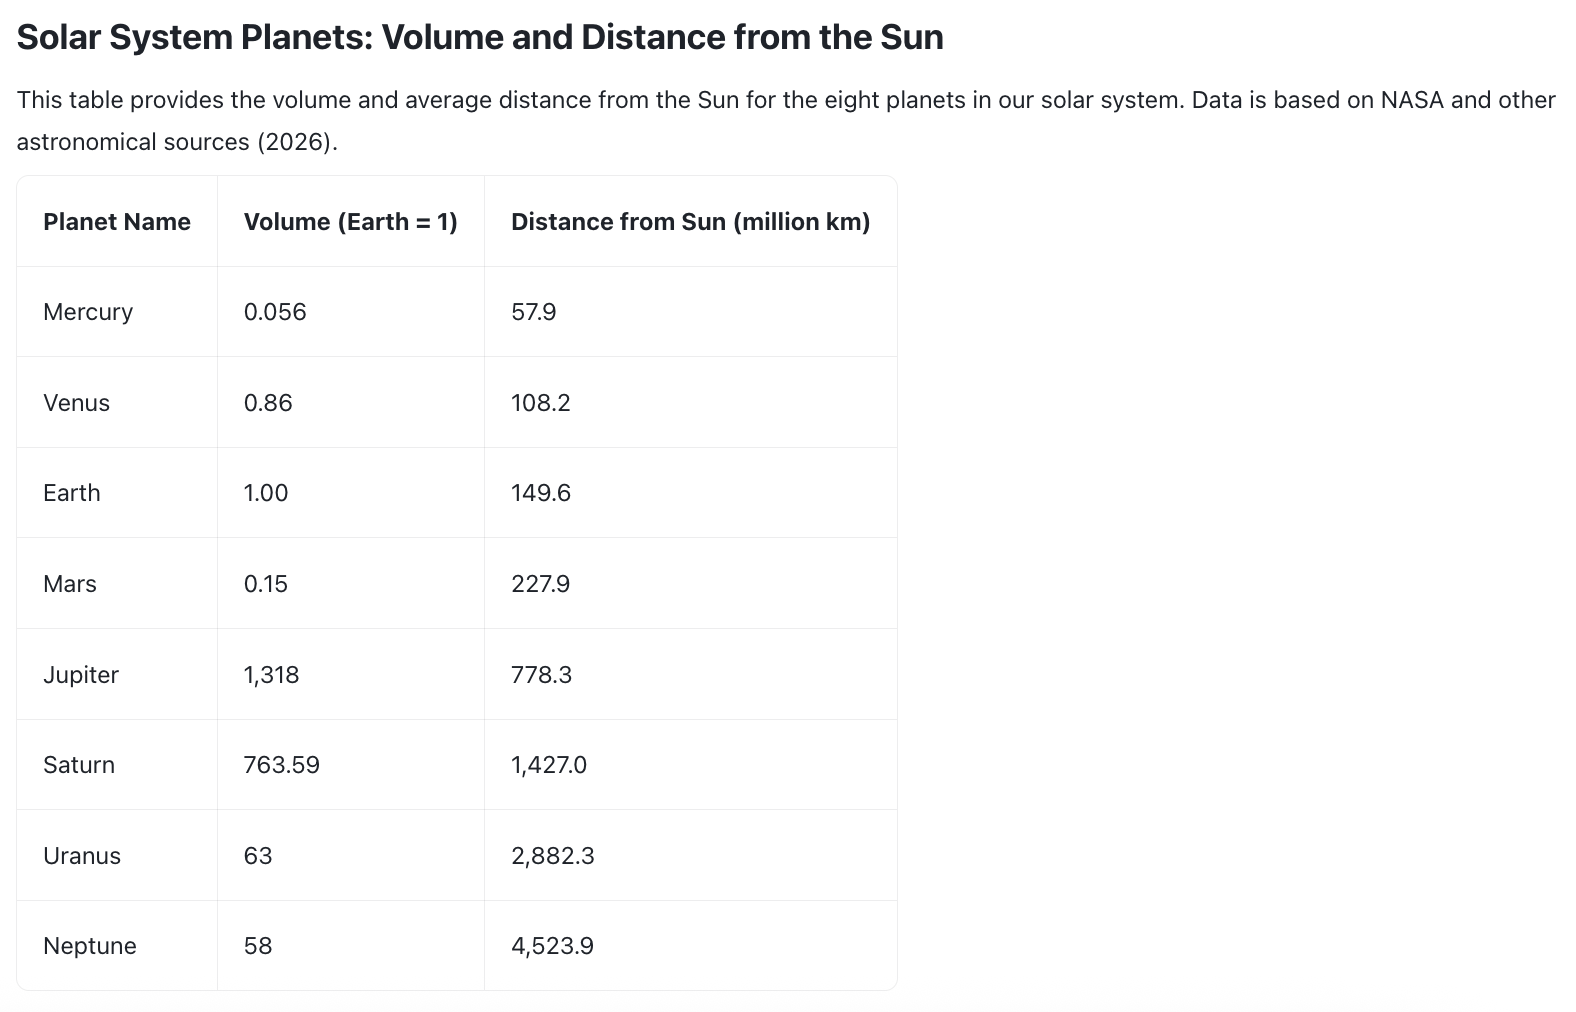 | 根据图片,表格中列出了多少颗行星,地球位于哪一行? |
代码示例:
Curl
Python SDK
Go SDK
Java SDK
兼容 OpenAI SDK
- 上传图片文件获取File ID。
- curl https://ark.cn-beijing.volces.com/api/v3/files \-H "Authorization: Bearer $ARK_API_KEY" \-F "purpose=user_data" \-F "file=@/path/to/your/image.png"
- 在Responses API中引用File ID。
- curl https://ark.cn-beijing.volces.com/api/v3/responses \-H "Authorization: Bearer $ARK_API_KEY" \-H "Content-Type: application/json" \-d '{"model": "doubao-seed-2-1-pro-260915","input": [{"role": "user","content": [{"type": "input_image","file_id": "file-20251018****"},{"type": "input_text","text": "根据图片,表格中列出了多少颗行星,地球位于哪一行?"}]}]}'
import asyncio
import os
from arkruntime import AsyncArk
from arkruntime.types.responses.response_completed_event import ResponseCompletedEvent
from arkruntime.types.responses.response_reasoning_summary_text_delta_event import ResponseReasoningSummaryTextDeltaEvent
from arkruntime.types.responses.response_output_item_added_event import ResponseOutputItemAddedEvent
from arkruntime.types.responses.response_text_delta_event import ResponseTextDeltaEvent
from arkruntime.types.responses.response_text_done_event import ResponseTextDoneEvent
client = AsyncArk(
base_url='https://ark.cn-beijing.volces.com/api/v3',
api_key=os.getenv('ARK_API_KEY')
)
async def main():
# upload an image file
print("Upload picture file")
file = await client.files.create(
# replace with your local picture path
file=open("/Users/doc/planet_comparison.png", "rb"),
purpose="user_data"
)
print(f"File uploaded: {file.id}")
# Wait for the file to finish processing
await client.files.wait_for_processing(file.id)
print(f"File processed: {file.id}")
stream = await client.responses.create(
model="doubao-seed-2-1-pro-260915",
input=[
{"role": "user", "content": [
{
"type": "input_image",
"file_id": file.id # ref pdf file id
},
{
"type": "input_text",
"text": "根据图片,表格中列出了多少颗行星,地球位于哪一行?"
}
]},
],
caching={
"type": "enabled",
},
store=True,
stream=True
)
async for event in stream:
if isinstance(event, ResponseReasoningSummaryTextDeltaEvent):
print(event.delta, end="")
if isinstance(event, ResponseOutputItemAddedEvent):
print("\noutPutItem " + event.type + " start:")
if isinstance(event, ResponseTextDeltaEvent):
print(event.delta,end="")
if isinstance(event, ResponseTextDoneEvent):
print("\noutPutTextDone.")
if isinstance(event, ResponseCompletedEvent):
print("Response Completed. Usage = " + event.response.usage.model_dump_json())
if __name__ == "__main__":
asyncio.run(main())
package main
import (
"context"
"fmt"
"io"
"os"
"time"
"github.com/volcengine/ark-runtime-go/arkruntime"
"github.com/volcengine/ark-runtime-go/arkruntime/model/file"
"github.com/volcengine/ark-runtime-go/arkruntime/model/responses"
)
func main() {
client := arkruntime.NewClientWithApiKey(
// Get API Key: https://ark.volcengine.com/region:cn-beijing/apikey
os.Getenv("ARK_API_KEY"),
arkruntime.WithBaseUrl("https://ark.cn-beijing.volces.com/api/v3"),
)
ctx := context.Background()
fmt.Println("----- upload image data -----")
data, err := os.Open("/Users/doc/planet_comparison.png")
if err != nil {
fmt.Printf("read file error: %v\n", err)
return
}
fileInfo, err := client.UploadFile(ctx, &file.FileCreateRequest{
Purpose: file.PurposeUserData,
}, data)
if err != nil {
fmt.Printf("upload file error: %v", err)
return
}
// Wait for the file to finish processing
for fileInfo.Status == file.StatusProcessing {
fmt.Println("Waiting for image to be processed...")
time.Sleep(2 * time.Second)
fileInfo, err = client.RetrieveFile(ctx, fileInfo.ID) // update file info
if err != nil {
fmt.Printf("get file status error: %v", err)
return
}
}
fmt.Printf("Image processing completed: %s, status: %s\n", fileInfo.ID, fileInfo.Status)
inputMessage := responses.InputItem{
OneOf: responses.NewItemEasyMessageInputItemSum(
responses.ItemEasyMessage{
Role: responses.NewOptMessageRole(responses.MessageRoleUser),
Content: responses.NewContentItemArrayMessageContent(
[]responses.ContentItem{
responses.ContentItem{OneOf: responses.NewContentItemImageContentItemSum(responses.ContentItemImage{Type: responses.ContentItemImageTypeInputImage, FileID: responses.NewOptString(fileInfo.ID)})},
responses.ContentItem{OneOf: responses.NewContentItemTextContentItemSum(responses.ContentItemText{Type: responses.ContentItemTextTypeInputText, Text: "根据图片,表格中列出了多少颗行星,地球位于哪一行?"})},
},
),
},
),
}
createResponsesReq := &responses.ResponsesRequest{
Model: "doubao-seed-2-1-pro-260915",
Input: responses.NewInputItemArrayResponsesInput([]responses.InputItem{inputMessage}),
}
resp, err := client.CreateResponsesStream(ctx, createResponsesReq)
if err != nil {
fmt.Printf("stream error: %v\n", err)
return
}
var responseId string
for {
event, err := resp.Recv()
if err == io.EOF {
break
}
if err != nil {
fmt.Printf("stream error: %v\n", err)
return
}
handleEvent(event)
if event.OneOf.Type == responses.ResponseCreatedEventResponseStreamEventSum {
responseId = event.OneOf.ResponseCreatedEvent.Response.ID
fmt.Printf("Response ID: %s", responseId)
}
}
}
func handleEvent(event *responses.ResponseStreamEvent) {
switch event.OneOf.Type {
case responses.ResponseReasoningSummaryTextDeltaEventResponseStreamEventSum:
print(event.OneOf.ResponseReasoningSummaryTextDeltaEvent.Delta.Or(""))
case responses.ResponseReasoningSummaryTextDoneEventResponseStreamEventSum:
fmt.Printf("\nAggregated reasoning text: %s\n", event.OneOf.ResponseReasoningSummaryTextDoneEvent.Text.Or(""))
case responses.ResponseTextDeltaEventResponseStreamEventSum:
print(event.OneOf.ResponseTextDeltaEvent.Delta.Or(""))
case responses.ResponseTextDoneEventResponseStreamEventSum:
fmt.Printf("\nAggregated output text: %s\n", event.OneOf.ResponseTextDoneEvent.Text.Or(""))
}
}
package com.ark.example;
import com.volcengine.ark.runtime.models.file.*;
import com.volcengine.ark.runtime.service.ArkService;
import com.volcengine.ark.runtime.models.responses.*;
import java.io.File;
import java.util.concurrent.TimeUnit;
public class demo {
public static void main(String[] args) {
String apiKey = System.getenv("ARK_API_KEY");
ArkService service = ArkService.builder().apiKey(apiKey)
.baseUrl("https://ark.cn-beijing.volces.com/api/v3")
.build();
System.out.println("===== Upload File Example=====");
// upload an image for responses
FileObject fileMeta;
fileMeta = service.uploadFile(FileCreateRequest.builder() // replace with your image file path
.purpose(Purpose.USER_DATA)
.build(), new File("/Users/doc/planet_comparison.png"));
System.out.println("Uploaded file Meta: " + fileMeta);
System.out.println("status:" + fileMeta.getStatus());
try {
while ("processing".equalsIgnoreCase(fileMeta.getStatus().toString())) {
System.out.println("Waiting for image to be processed...");
TimeUnit.SECONDS.sleep(2);
fileMeta = service.retrieveFile(fileMeta.getId());
}
} catch (Exception e) {
System.err.println("get file status error:" + e.getMessage());
}
System.out.println("Uploaded file Meta: " + fileMeta);
ResponsesRequest request = ResponsesRequest.builder()
.model("doubao-seed-2-1-pro-260915")
.stream(true)
.input(ResponsesInput.ofList(java.util.Arrays.asList(ItemEasyMessage.builder().role(MessageRole.USER).content(
MessageContent.ofList(java.util.Arrays.asList(ContentItemImage.builder().fileId(fileMeta.getId()).build(), ContentItemText.builder().text("根据图片,表格中列出了多少颗行星,地球位于哪一行?").build()))
).build())))
.build();
service.streamResponse(request)
.doOnError(Throwable::printStackTrace)
.blockingForEach(event -> {
if (event instanceof ResponseReasoningSummaryTextDeltaEvent) {
System.out.print(((ResponseReasoningSummaryTextDeltaEvent) event).getDelta());
}
if (event instanceof ResponseOutputItemAddedEvent) {
System.out.println("\nOutputItem " + (((ResponseOutputItemAddedEvent) event).getItem().getType()) + " Start: ");
}
if (event instanceof ResponseTextDeltaEvent) {
System.out.print(((ResponseTextDeltaEvent) event).getDelta());
}
if (event instanceof ResponseTextDoneEvent) {
System.out.println("\nOutputText End.");
}
if (event instanceof ResponseOutputItemDoneEvent) {
System.out.println("\nOutputItem " + ((ResponseOutputItemDoneEvent) event).getItem().getType() + " End.");
}
if (event instanceof ResponseFunctionCallArgumentsDoneEvent) {
System.out.println("\nFunctionCall Arguments: " + ((ResponseFunctionCallArgumentsDoneEvent) event).getArguments());
}
if (event instanceof ResponseCompletedEvent) {
System.out.println("\nResponse Completed. Usage = " + ((ResponseCompletedEvent) event).getResponse().getUsage());
}
});
service.shutdownExecutor();
}
}
import os
import time
from openai import OpenAI
api_key = os.getenv('ARK_API_KEY')
client = OpenAI(
base_url='https://ark.cn-beijing.volces.com/api/v3',
api_key=api_key,
)
file = client.files.create(
file=open("/Users/doc/planet_comparison.png", "rb"),
purpose="user_data"
)
# Wait for the file to finish processing
while (file.status == "processing"):
time.sleep(2)
file = client.files.retrieve(file.id)
print(f"File processed: {file}")
response = client.responses.create(
model="doubao-seed-2-1-pro-260915",
input=[
{
"role": "user",
"content": [
{
"type": "input_image",
"file_id": file.id,
},
{
"type": "input_text",
"text": "根据图片,表格中列出了多少颗行星,地球位于哪一行?",
},
]
}
],
stream=True
)
for event in response:
if event.type == "response.reasoning_summary_text.delta":
print(event.delta, end="")
if event.type == "response.output_item.added":
print("\noutPutItem " + event.type + " start:")
if event.type == "response.output_text.delta":
print(event.delta,end="")
if event.type == "response.output_item.done":
print("\noutPutTextDone.")
if event.type == "response.completed":
print("\nResponse Completed. Usage = " + event.response.usage.model_dump_json())
输出示例:
表格中列出了 8 颗行星。地球位于第 3 个数据行;如果把表头算作第 1 行,则地球位于第 4 行。
视频理解
建议优先使用 Files API 上传本地视频文件,适用于视频文件较大,或者需要在多个请求中重复使用视频的场景。
该方式支持最大 512MB 的文件,默认存储 7 天,存储有效期取值范围为1-30天。
示例中用到的视频文件及提示词如下:
视频文件 | 提示词 |
视频文件 | 提示词 |
Play
00:00
Fullscreen
Cssfullscreen
1x
Click and hold to drag
| 请你描述下视频中的人物的一系列动作,以JSON格式输出开始时间(start_time)、结束时间(end_time)、事件(event)、是否危险(danger),请使用HH:mm:ss表示时间戳。 |
示例代码:
Curl
Python SDK
Go SDK
Java SDK
兼容 OpenAI SDK
- 上传视频文件获取File ID。
- curl https://ark.cn-beijing.volces.com/api/v3/files \-H "Authorization: Bearer $ARK_API_KEY" \-F "purpose=user_data" \-F "file=@/Users/doc/demo.mp4" \-F "preprocess_configs[video][fps]=0.3"
- 在Responses API中引用File ID。
- curl https://ark.cn-beijing.volces.com/api/v3/responses \-H "Authorization: Bearer $ARK_API_KEY" \-H 'Content-Type: application/json' \-d '{"model": "doubao-seed-2-1-pro-260915","input": [{"role": "user","content": [{"type": "input_video","file_id": "file-20251018****"},{"type": "input_text","text": "请你描述下视频中的人物的一系列动作,以JSON格式输出开始时间(start_time)、结束时间(end_time)、事件(event)、是否危险(danger),请使用HH:mm:ss表示时间戳。"}]}]}'
import asyncio
import os
from arkruntime import AsyncArk
from arkruntime.types.responses.response_completed_event import ResponseCompletedEvent
from arkruntime.types.responses.response_reasoning_summary_text_delta_event import ResponseReasoningSummaryTextDeltaEvent
from arkruntime.types.responses.response_output_item_added_event import ResponseOutputItemAddedEvent
from arkruntime.types.responses.response_text_delta_event import ResponseTextDeltaEvent
from arkruntime.types.responses.response_text_done_event import ResponseTextDoneEvent
client = AsyncArk(
base_url='https://ark.cn-beijing.volces.com/api/v3',
api_key=os.getenv('ARK_API_KEY')
)
async def main():
# upload video file
print("Upload video file")
file = await client.files.create(
# replace with your local video path
file=open("/Users/doc/demo.mp4", "rb"),
purpose="user_data",
preprocess_configs={
"video": {
"model": "doubao-seed-2-1-pro-260915",
"fps": 0.3, # define the sampling fps of the video, default is 1.0
}
}
)
print(f"File uploaded: {file.id}")
# Wait for the file to finish processing
await client.files.wait_for_processing(file.id)
print(f"File processed: {file.id}")
stream = await client.responses.create(
model="doubao-seed-2-1-pro-260915",
input=[
{"role": "user", "content": [
{
"type": "input_video",
"file_id": file.id # ref video file id
},
{
"type": "input_text",
"text": "请你描述下视频中的人物的一系列动作,以JSON格式输出开始时间(start_time)、结束时间(end_time)、事件(event)、是否危险(danger),请使用HH:mm:ss表示时间戳。"
}
]},
],
caching={
"type": "enabled",
},
store=True,
stream=True
)
async for event in stream:
if isinstance(event, ResponseReasoningSummaryTextDeltaEvent):
print(event.delta, end="")
if isinstance(event, ResponseOutputItemAddedEvent):
print("\noutPutItem " + event.type + " start:")
if isinstance(event, ResponseTextDeltaEvent):
print(event.delta,end="")
if isinstance(event, ResponseTextDoneEvent):
print("\noutPutTextDone.")
if isinstance(event, ResponseCompletedEvent):
print("Response Completed. Usage = " + event.response.usage.model_dump_json())
if __name__ == "__main__":
asyncio.run(main())
package main
import (
"context"
"fmt"
"io"
"os"
"time"
"github.com/volcengine/ark-runtime-go/arkruntime"
"github.com/volcengine/ark-runtime-go/arkruntime/model/file"
"github.com/volcengine/ark-runtime-go/arkruntime/model/responses"
)
func main() {
client := arkruntime.NewClientWithApiKey(
// Get API Key: https://ark.volcengine.com/region:cn-beijing/apikey
os.Getenv("ARK_API_KEY"),
arkruntime.WithBaseUrl("https://ark.cn-beijing.volces.com/api/v3"),
)
ctx := context.Background()
fmt.Println("----- upload video data -----")
data, err := os.Open("/Users/doc/demo.mp4")
if err != nil {
fmt.Printf("read file error: %v\n", err)
return
}
fileInfo, err := client.UploadFile(ctx, &file.FileCreateRequest{
Purpose: file.PurposeUserData,
PreprocessConfigs: file.NewOptPreprocessConfigs(file.PreprocessConfigs{
Video: file.NewOptVideo(file.Video{
Model: file.NewOptString("doubao-seed-2-1-pro-260915"),
Fps: file.NewOptFloat64(0.3),
}),
}),
}, data)
if err != nil {
fmt.Printf("upload file error: %v", err)
return
}
// Wait for the file to finish processing
for fileInfo.Status == file.StatusProcessing {
fmt.Println("Waiting for video to be processed...")
time.Sleep(2 * time.Second)
fileInfo, err = client.RetrieveFile(ctx, fileInfo.ID) // update file info
if err != nil {
fmt.Printf("get file status error: %v", err)
return
}
}
fmt.Printf("Video processing completed: %s, status: %s\n", fileInfo.ID, fileInfo.Status)
inputMessage := responses.InputItem{
OneOf: responses.NewItemEasyMessageInputItemSum(
responses.ItemEasyMessage{
Role: responses.NewOptMessageRole(responses.MessageRoleUser),
Content: responses.NewContentItemArrayMessageContent(
[]responses.ContentItem{
responses.ContentItem{OneOf: responses.NewContentItemVideoContentItemSum(responses.ContentItemVideo{Type: responses.ContentItemVideoTypeInputVideo, VideoURL: "", FileID: responses.NewOptString(fileInfo.ID)})},
responses.ContentItem{OneOf: responses.NewContentItemTextContentItemSum(responses.ContentItemText{Type: responses.ContentItemTextTypeInputText, Text: "请你描述下视频中的人物的一系列动作,以JSON格式输出开始时间(start_time)、结束时间(end_time)、事件(event)、是否危险(danger),请使用HH:mm:ss表示时间戳。"})},
},
),
},
),
}
createResponsesReq := &responses.ResponsesRequest{
Model: "doubao-seed-2-1-pro-260915",
Input: responses.NewInputItemArrayResponsesInput([]responses.InputItem{inputMessage}),
}
resp, err := client.CreateResponsesStream(ctx, createResponsesReq)
if err != nil {
fmt.Printf("stream error: %v\n", err)
return
}
var responseId string
for {
event, err := resp.Recv()
if err == io.EOF {
break
}
if err != nil {
fmt.Printf("stream error: %v\n", err)
return
}
handleEvent(event)
if event.OneOf.Type == responses.ResponseCreatedEventResponseStreamEventSum {
responseId = event.OneOf.ResponseCreatedEvent.Response.ID
fmt.Printf("Response ID: %s", responseId)
}
}
}
func handleEvent(event *responses.ResponseStreamEvent) {
switch event.OneOf.Type {
case responses.ResponseReasoningSummaryTextDeltaEventResponseStreamEventSum:
print(event.OneOf.ResponseReasoningSummaryTextDeltaEvent.Delta.Or(""))
case responses.ResponseReasoningSummaryTextDoneEventResponseStreamEventSum:
fmt.Printf("\nAggregated reasoning text: %s\n", event.OneOf.ResponseReasoningSummaryTextDoneEvent.Text.Or(""))
case responses.ResponseTextDeltaEventResponseStreamEventSum:
print(event.OneOf.ResponseTextDeltaEvent.Delta.Or(""))
case responses.ResponseTextDoneEventResponseStreamEventSum:
fmt.Printf("\nAggregated output text: %s\n", event.OneOf.ResponseTextDoneEvent.Text.Or(""))
}
}
package com.ark.example;
import com.volcengine.ark.runtime.models.file.*;
import com.volcengine.ark.runtime.service.ArkService;
import com.volcengine.ark.runtime.models.responses.*;
import java.io.File;
import java.util.concurrent.TimeUnit;
public class demo {
public static void main(String[] args) {
String apiKey = System.getenv("ARK_API_KEY");
ArkService service = ArkService.builder().apiKey(apiKey)
.baseUrl("https://ark.cn-beijing.volces.com/api/v3")
.build();
System.out.println("===== Upload File Example=====");
// upload a video for responses
FileObject fileMeta;
fileMeta = service.uploadFile(FileCreateRequest.builder() // replace with your video file path
.purpose(Purpose.USER_DATA)
.preprocessConfigs(PreprocessConfigs.builder().video(Video.builder().model("doubao-seed-2-1-pro-260915").fps(0.3).build()).build())
.build(), new File("/Users/doc/demo.mp4"));
System.out.println("Uploaded file Meta: " + fileMeta);
System.out.println("status:" + fileMeta.getStatus());
try {
while ("processing".equalsIgnoreCase(fileMeta.getStatus().toString())) {
System.out.println("Waiting for video to be processed...");
TimeUnit.SECONDS.sleep(2);
fileMeta = service.retrieveFile(fileMeta.getId());
}
} catch (Exception e) {
System.err.println("get file status error:" + e.getMessage());
}
System.out.println("Uploaded file Meta: " + fileMeta);
ResponsesRequest request = ResponsesRequest.builder()
.model("doubao-seed-2-1-pro-260915")
.stream(true)
.input(ResponsesInput.ofList(java.util.Arrays.asList(ItemEasyMessage.builder().role(MessageRole.USER).content(
MessageContent.ofList(java.util.Arrays.asList(ContentItemVideo.builder().fileId(fileMeta.getId()).build(), ContentItemText.builder().text("请你描述下视频中的人物的一系列动作,以JSON格式输出开始时间(start_time)、结束时间(end_time)、事件(event)、是否危险(danger),请使用HH:mm:ss表示时间戳。").build()))
).build())))
.build();
service.streamResponse(request)
.doOnError(Throwable::printStackTrace)
.blockingForEach(event -> {
if (event instanceof ResponseReasoningSummaryTextDeltaEvent) {
System.out.print(((ResponseReasoningSummaryTextDeltaEvent) event).getDelta());
}
if (event instanceof ResponseOutputItemAddedEvent) {
System.out.println("\nOutputItem " + (((ResponseOutputItemAddedEvent) event).getItem().getType()) + " Start: ");
}
if (event instanceof ResponseTextDeltaEvent) {
System.out.print(((ResponseTextDeltaEvent) event).getDelta());
}
if (event instanceof ResponseTextDoneEvent) {
System.out.println("\nOutputText End.");
}
if (event instanceof ResponseOutputItemDoneEvent) {
System.out.println("\nOutputItem " + ((ResponseOutputItemDoneEvent) event).getItem().getType() + " End.");
}
if (event instanceof ResponseFunctionCallArgumentsDoneEvent) {
System.out.println("\nFunctionCall Arguments: " + ((ResponseFunctionCallArgumentsDoneEvent) event).getArguments());
}
if (event instanceof ResponseCompletedEvent) {
System.out.println("\nResponse Completed. Usage = " + ((ResponseCompletedEvent) event).getResponse().getUsage());
}
});
service.shutdownExecutor();
}
}
import os
import time
from openai import OpenAI
api_key = os.getenv('ARK_API_KEY')
client = OpenAI(
base_url='https://ark.cn-beijing.volces.com/api/v3',
api_key=api_key,
)
file = client.files.create(
file=open("/Users/doc/demo.mp4", "rb"),
purpose="user_data",
extra_body={
"preprocess_configs": {
"video": {
"model": "doubao-seed-2-1-pro-260915",
"fps": 0.3,
}
}
},
)
# Wait for the file to finish processing
while (file.status == "processing"):
time.sleep(2)
file = client.files.retrieve(file.id)
print(f"File processed: {file}")
response = client.responses.create(
model="doubao-seed-2-1-pro-260915",
input=[
{
"role": "user",
"content": [
{
"type": "input_video",
"file_id": file.id,
},
{
"type": "input_text",
"text": "请你描述下视频中的人物的一系列动作,以JSON格式输出开始时间(start_time)、结束时间(end_time)、事件(event)、是否危险(danger),请使用HH:mm:ss表示时间戳。",
},
]
}
],
stream=True
)
for event in response:
if event.type == "response.reasoning_summary_text.delta":
print(event.delta, end="")
if event.type == "response.output_item.added":
print("\noutPutItem " + event.type + " start:")
if event.type == "response.output_text.delta":
print(event.delta,end="")
if event.type == "response.output_item.done":
print("\noutPutTextDone.")
if event.type == "response.completed":
print("\nResponse Completed. Usage = " + event.response.usage.model_dump_json())
输出示例:
{
"text": [
{
"start_time": "00:00:00",
"end_time": "00:00:03",
"event": "将黄色积木堆叠到红黄绿相间的积木塔顶端",
"danger": false
},
{
"start_time": "00:00:05",
"end_time": "00:00:07",
"event": "拿起蓝色积木放入口中啃咬后取出",
"danger": false
},
{
"start_time": "00:00:08",
"end_time": "00:00:12",
"event": "用手推动黄色和蓝色的玩具卡车在地面移动",
"danger": false
},
{
"start_time": "00:00:12",
"end_time": "00:00:24",
"event": "双手扶着木质抽屉柜边缘,尝试将右脚踩在下方抽屉把手上向上攀爬",
"danger": true
}
]
}
文档理解
建议优先选择 Files API 上传的方式,适用于文件较大,或者需要在多个请求中重复使用文件的场景。
该方式支持最大 512MB 的文件,默认存储 7 天,存储有效期取值范围为1-30天。
示例中用到的PDF文件及提示词如下:
PDF文件 | 提示词 |
PDF文件 | 提示词 |
| 按段落给出文档中的文字内容,以JSON格式输出,包括段落类型(type)、文字内容(content)信息。 |
代码示例:
Curl
Python SDK
Go SDK
Java SDK
兼容 OpenAI SDK
- 上传PDF文件获取File ID。
- curl https://ark.cn-beijing.volces.com/api/v3/files \-H "Authorization: Bearer $ARK_API_KEY" \-F "purpose=user_data" \-F "file=@/Users/doc/demo.pdf"
- 在Responses API中引用File ID。
- curl https://ark.cn-beijing.volces.com/api/v3/responses \-H "Authorization: Bearer $ARK_API_KEY" \-H 'Content-Type: application/json' \-d '{"model": "doubao-seed-2-1-pro-260915","input": [{"role": "user","content": [{"type": "input_file","file_id": "file-20251018****"},{"type": "input_text","text": "按段落给出文档中的文字内容,以JSON格式输出,包括段落类型(type)、文字内容(content)信息。"}]}]}'
import asyncio
import os
from arkruntime import AsyncArk
from arkruntime.types.responses.response_completed_event import ResponseCompletedEvent
from arkruntime.types.responses.response_reasoning_summary_text_delta_event import ResponseReasoningSummaryTextDeltaEvent
from arkruntime.types.responses.response_output_item_added_event import ResponseOutputItemAddedEvent
from arkruntime.types.responses.response_text_delta_event import ResponseTextDeltaEvent
from arkruntime.types.responses.response_text_done_event import ResponseTextDoneEvent
client = AsyncArk(
base_url='https://ark.cn-beijing.volces.com/api/v3',
api_key=os.getenv('ARK_API_KEY')
)
async def main():
# upload pdf file
print("Upload pdf file")
file = await client.files.create(
# replace with your local pdf path
file=open("/Users/doc/demo.pdf", "rb"),
purpose="user_data"
)
print(f"File uploaded: {file.id}")
# Wait for the file to finish processing
await client.files.wait_for_processing(file.id)
print(f"File processed: {file.id}")
stream = await client.responses.create(
model="doubao-seed-2-1-pro-260915",
input=[
{"role": "user", "content": [
{
"type": "input_file",
"file_id": file.id # ref pdf file id
},
{
"type": "input_text",
"text": "按段落给出文档中的文字内容,以JSON格式输出,包括段落类型(type)、文字内容(content)信息。"
}
]},
],
caching={
"type": "enabled",
},
store=True,
stream=True
)
async for event in stream:
if isinstance(event, ResponseReasoningSummaryTextDeltaEvent):
print(event.delta, end="")
if isinstance(event, ResponseOutputItemAddedEvent):
print("\noutPutItem " + event.type + " start:")
if isinstance(event, ResponseTextDeltaEvent):
print(event.delta,end="")
if isinstance(event, ResponseTextDoneEvent):
print("\noutPutTextDone.")
if isinstance(event, ResponseCompletedEvent):
print("Response Completed. Usage = " + event.response.usage.model_dump_json())
if __name__ == "__main__":
asyncio.run(main())
package main
import (
"context"
"fmt"
"io"
"os"
"time"
"github.com/volcengine/ark-runtime-go/arkruntime"
"github.com/volcengine/ark-runtime-go/arkruntime/model/file"
"github.com/volcengine/ark-runtime-go/arkruntime/model/responses"
)
func main() {
client := arkruntime.NewClientWithApiKey(
os.Getenv("ARK_API_KEY"),
arkruntime.WithBaseUrl("https://ark.cn-beijing.volces.com/api/v3"),
)
ctx := context.Background()
fmt.Println("----- upload file data -----")
data, err := os.Open("/Users/doc/demo.pdf")
if err != nil {
fmt.Printf("read file error: %v\n", err)
return
}
fileInfo, err := client.UploadFile(ctx, &file.FileCreateRequest{
Purpose: file.PurposeUserData,
}, data)
if err != nil {
fmt.Printf("upload file error: %v", err)
return
}
// Wait for the file to finish processing
for fileInfo.Status == file.StatusProcessing {
fmt.Println("Waiting for file to be processed...")
time.Sleep(2 * time.Second)
fileInfo, err = client.RetrieveFile(ctx, fileInfo.ID) // update file info
if err != nil {
fmt.Printf("get file status error: %v", err)
return
}
}
fmt.Printf("Video processing completed: %s, status: %s\n", fileInfo.ID, fileInfo.Status)
inputMessage := responses.InputItem{
OneOf: responses.NewItemEasyMessageInputItemSum(
responses.ItemEasyMessage{
Role: responses.NewOptMessageRole(responses.MessageRoleUser),
Content: responses.NewContentItemArrayMessageContent(
[]responses.ContentItem{
responses.ContentItem{OneOf: responses.NewContentItemFileContentItemSum(responses.ContentItemFile{Type: responses.ContentItemFileTypeInputFile, FileID: responses.NewOptString(fileInfo.ID)})},
responses.ContentItem{OneOf: responses.NewContentItemTextContentItemSum(responses.ContentItemText{Type: responses.ContentItemTextTypeInputText, Text: "按段落给出文档中的文字内容,以JSON格式输出,包括段落类型(type)、文字内容(content)信息。"})},
},
),
},
),
}
createResponsesReq := &responses.ResponsesRequest{
Model: "doubao-seed-2-1-pro-260915",
Input: responses.NewInputItemArrayResponsesInput([]responses.InputItem{inputMessage}),
}
resp, err := client.CreateResponsesStream(ctx, createResponsesReq)
if err != nil {
fmt.Printf("stream error: %v\n", err)
return
}
var responseId string
for {
event, err := resp.Recv()
if err == io.EOF {
break
}
if err != nil {
fmt.Printf("stream error: %v\n", err)
return
}
handleEvent(event)
if event.OneOf.Type == responses.ResponseCreatedEventResponseStreamEventSum {
responseId = event.OneOf.ResponseCreatedEvent.Response.ID
fmt.Printf("Response ID: %s", responseId)
}
}
}
func handleEvent(event *responses.ResponseStreamEvent) {
switch event.OneOf.Type {
case responses.ResponseReasoningSummaryTextDeltaEventResponseStreamEventSum:
print(event.OneOf.ResponseReasoningSummaryTextDeltaEvent.Delta.Or(""))
case responses.ResponseReasoningSummaryTextDoneEventResponseStreamEventSum:
fmt.Printf("\nAggregated reasoning text: %s\n", event.OneOf.ResponseReasoningSummaryTextDoneEvent.Text.Or(""))
case responses.ResponseTextDeltaEventResponseStreamEventSum:
print(event.OneOf.ResponseTextDeltaEvent.Delta.Or(""))
case responses.ResponseTextDoneEventResponseStreamEventSum:
fmt.Printf("\nAggregated output text: %s\n", event.OneOf.ResponseTextDoneEvent.Text.Or(""))
}
}
package com.ark.example;
import com.volcengine.ark.runtime.models.file.*;
import com.volcengine.ark.runtime.service.ArkService;
import com.volcengine.ark.runtime.models.responses.*;
import java.io.File;
import java.util.concurrent.TimeUnit;
public class demo {
public static void main(String[] args) {
String apiKey = System.getenv("ARK_API_KEY");
ArkService service = ArkService.builder().apiKey(apiKey)
.baseUrl("https://ark.cn-beijing.volces.com/api/v3")
.build();
System.out.println("===== Upload File Example=====");
// upload a file for responses
FileObject fileMeta;
fileMeta = service.uploadFile(FileCreateRequest.builder() // replace with your file path
.purpose(Purpose.USER_DATA)
.build(), new File("/Users/doc/demo.pdf"));
System.out.println("Uploaded file Meta: " + fileMeta);
System.out.println("status:" + fileMeta.getStatus());
try {
while ("processing".equalsIgnoreCase(fileMeta.getStatus().toString())) {
System.out.println("Waiting for file to be processed...");
TimeUnit.SECONDS.sleep(2);
fileMeta = service.retrieveFile(fileMeta.getId());
}
} catch (Exception e) {
System.err.println("get file status error:" + e.getMessage());
}
System.out.println("Uploaded file Meta: " + fileMeta);
ResponsesRequest request = ResponsesRequest.builder()
.model("doubao-seed-2-1-pro-260915")
.stream(true)
.input(ResponsesInput.ofList(java.util.Arrays.asList(ItemEasyMessage.builder().role(MessageRole.USER).content(
MessageContent.ofList(java.util.Arrays.asList(ContentItemFile.builder().fileId(fileMeta.getId()).build(), ContentItemText.builder().text("按段落给出文档中的文字内容,以JSON格式输出,包括段落类型(type)、文字内容(content)信息。").build()))
).build())))
.build();
service.streamResponse(request)
.doOnError(Throwable::printStackTrace)
.blockingForEach(event -> {
if (event instanceof ResponseReasoningSummaryTextDeltaEvent) {
System.out.print(((ResponseReasoningSummaryTextDeltaEvent) event).getDelta());
}
if (event instanceof ResponseOutputItemAddedEvent) {
System.out.println("\nOutputItem " + (((ResponseOutputItemAddedEvent) event).getItem().getType()) + " Start: ");
}
if (event instanceof ResponseTextDeltaEvent) {
System.out.print(((ResponseTextDeltaEvent) event).getDelta());
}
if (event instanceof ResponseTextDoneEvent) {
System.out.println("\nOutputText End.");
}
if (event instanceof ResponseOutputItemDoneEvent) {
System.out.println("\nOutputItem " + ((ResponseOutputItemDoneEvent) event).getItem().getType() + " End.");
}
if (event instanceof ResponseFunctionCallArgumentsDoneEvent) {
System.out.println("\nFunctionCall Arguments: " + ((ResponseFunctionCallArgumentsDoneEvent) event).getArguments());
}
if (event instanceof ResponseCompletedEvent) {
System.out.println("\nResponse Completed. Usage = " + ((ResponseCompletedEvent) event).getResponse().getUsage());
}
});
service.shutdownExecutor();
}
}
import os
import time
from openai import OpenAI
api_key = os.getenv('ARK_API_KEY')
client = OpenAI(
base_url='https://ark.cn-beijing.volces.com/api/v3',
api_key=api_key,
)
file = client.files.create(
file=open("/Users/doc/demo.pdf", "rb"),
purpose="user_data"
)
# Wait for the file to finish processing
while (file.status == "processing"):
time.sleep(2)
file = client.files.retrieve(file.id)
print(f"File processed: {file}")
response = client.responses.create(
model="doubao-seed-2-1-pro-260915",
input=[
{
"role": "user",
"content": [
{
"type": "input_file",
"file_id": file.id,
},
{
"type": "input_text",
"text": "按段落给出文档中的文字内容,以JSON格式输出,包括段落类型(type)、文字内容(content)信息。",
},
]
}
],
stream=True
)
for event in response:
if event.type == "response.reasoning_summary_text.delta":
print(event.delta, end="")
if event.type == "response.output_item.added":
print("\noutPutItem " + event.type + " start:")
if event.type == "response.output_text.delta":
print(event.delta,end="")
if event.type == "response.output_item.done":
print("\noutPutTextDone.")
if event.type == "response.completed":
print("\nResponse Completed. Usage = " + event.response.usage.model_dump_json())
输出示例:
{
"text": [
{
"type": "heading",
"content": "1 Introduction"
},
{
"type": "paragraph",
"content": "Diffusion models [3–5] learn to reverse a process that incrementally corrupts data with noise, effectively decomposing a complex distribution into a hierarchy of simplified representations. This coarse-to-fine generative approach has proven remarkably successful across a wide range of applications, including image and video synthesis [6] as well as solving complex challenges in natural sciences [7]."
},
...
{
"type": "heading",
"content": "3 Seed Diffusion"
},
{
"type": "paragraph",
"content": "As the first experimental model in our Seed Diffusion series, Seed Diffusion Preview is specifically focused on code generation, thus adopting the data pipeline (code/code-related data only) and processing methodology of the open-sourced Seed Coder project [20]. The architecture is a standard dense Transformer, and we intentionally omit complex components such as LongCoT reasoning in this initial version to first establish a strong and efficient performance baseline. This section introduces its key components and training strategies."
}
]
}
最近更新时间:2026.10.09 14:36:34
这个页面对您有帮助吗?
有用
有用
无用
无用