火山方舟
火山方舟


文档指南

请输入


- 文档首页
 火山方舟调用进阶使用上下文缓存
 复制全文
 下载 pdf
上下文缓存
 文档反馈
 问问助手
在多轮对话、工具调用及角色扮演等存在大量重复上下文输入的场景中,利用上下文缓存机制复用计算结果,避免模型对相同内容的重复处理。这将有效消除重复加载带来的开销,显著降低 Token 成本。
说明
缓存模式
上下文缓存支持两种工作模式,可根据便捷性、确定性及成本需求进行选择。
- 隐式缓存:自动启用,用户无需额外配置,且无法关闭,适合更关注接入便捷性、难以显式管理或固定前缀的场景。系统会自动识别请求中的公共前缀并进行缓存。
- 显式缓存:需要主动开启的缓存模式。需要主动配置创建缓存,且支持缓存确定性命中。
注意
隐式缓存无需配置,系统自动开启。当请求使用显式缓存时,隐式缓存不生效。
对比项 | 隐式缓存 | 显式缓存 |
适用场景 | 适合追求接入便捷、无需显式创建与管理缓存的通用场景,尤其适用于多轮对话、工具调用等公共前缀会随交互持续增长、难以稳定固化前缀的场景。系统会自动识别公共前缀并进行缓存。 | 适合需要配置创建缓存、稳定复用某段固定前缀并具备更强可控性的场景,例如角色扮演、固定指令模板等前缀稳定且工具调用较少或结构稳定的多轮对话。 |
配置方式 | 无需配置,不可关闭 | 需要手动配置 |
是否影响回复质量 | 不影响 | 不影响 |
支持模型 | ||
支持 API | ||
缓存命中 | 无法保证命中率,受多因素影响,具体命中概率由系统判定 | 确定性命中(缓存命中率更高) |
缓存有效期 | 动态变化,系统会定期清理长时间未使用的缓存数据 | 支持配置缓存过期时间 |
缓存最少 Token 数 |
| |
命中缓存的输入 Token 计费 | 根据模型输入长度分段计费 | |
缓存存储计费 | 不计费 | 计费 |
隐式缓存
支持模型
- 在线推理场景下,doubao-seed-code 模型、doubao-seed-2.0 及之后系列模型支持隐式缓存,且不可关闭。
- 批量推理场景下,支持的模型会开启隐式缓存,且不可关闭。
提升缓存命中率
隐式缓存为自动模式,用户无需额外配置且无法关闭。命中与否由系统判定,不保证命中。
建议:
- 保持前缀稳定。 将固定角色设定、背景资料、长文本等稳定内容放在前部;将当轮问题、时间戳、请求 ID 等变化内容放在后部。同类请求尽量保持请求结构与前缀内容一致,减少前缀频繁变化带来的命中波动。
- 保持工具定义、工具顺序、结构化输出方案等保持一致。
- 监控命中情况并迭代优化。 可通过记录响应中的 Token 统计信息,持续观察命中 Token 的变化趋势,并据此优化提示词组织方式与前缀稳定性。
- 通过 Prompt Cache Key 配置稳定的缓存路由标识,提升缓存复用概率。具体配置方式见下文。
使用 Prompt Cache Key
Prompt Cache Key 是提示词缓存能力上的路由亲和策略。通过在请求中设置稳定的缓存路由标识,系统会尽量将共享相同前缀的请求路由到缓存命中率更高的服务,从而提升隐式缓存的复用概率。
支持模型与 API
- 支持模型:doubao-seed-2.0 及之后系列模型。
- 支持 API:
- Chat API:在请求参数中设置 prompt_cache_key。
- Responses API:在请求参数中设置 prompt_cache_key。
工作原理
说明
工作机制:系统将请求中的缓存路由标识作为会话级路由提示,并按 Endpoint、模型与该取值隔离路由映射。该能力采用尽力而为的亲和策略,不承诺固定实例,也不保证每次请求都能命中缓存。
- 首次请求:系统按常规路由策略选择可用服务,并建立缓存路由标识取值对应的路由映射。
- 后续请求:相同 Endpoint、模型与缓存路由标识取值的请求会优先路由到已映射的服务,以提高相同前缀的缓存复用概率。
- 自动回退:当已映射服务不可用、请求速率超过保护阈值或其他保护条件触发时,请求会回退到常规路由。
使用限制
- 流量限制:同一缓存路由标识对应的请求总流量应控制在每分钟 15 个请求以内。速率过高时,部分请求可能回退到常规路由,从而无法复用原服务上的前缀缓存。高流量工作负载建议将流量稳定地分散到更多取值上。
- 保持稳定:上下文连续的请求建议使用同一取值,避免在同一会话中频繁更换。
- 隔离会话:不同用户或并行会话应使用不同取值,避免无关请求共享路由映射并形成热点。
- 避免敏感信息:建议使用不可读的内部 Session ID,不要使用手机号、邮箱、访问凭证或 Prompt 原文。
- 非强一致保证:服务扩缩容、发布、故障切换、映射过期或保护策略触发时,请求可能被重新路由。
使用方式
调用模型时,Chat API 和 Responses API 可在请求参数中设置 prompt_cache_key,并确保上下文连续的请求使用同一取值,以提升缓存命中率。
以 Responses API 为例,示例如下:
计费说明
当请求命中隐式缓存时,计费信息如下:
- 命中的输入 Tokens(cached_tokens):按缓存命中输入单价计费。
- 未命中的输入 Tokens:按正常输入单价计费。
- 输出 Tokens:按正常输出单价计费。
- 缓存存储:不计费。
注意
- 与显式缓存相比,隐式缓存存储不计费。
- 缓存命中输入单价可能会随上下文输入长度区间变化。如 Seed 2.0 系列模型在输入长度为 [0, 32k]、[32k, 128k]、[128k, 256k] 时,缓存命中输入单价不同。
工作原理
向支持隐式缓存的模型发送请求时,该功能会自动开启,工作原理如下。
- 缓存创建:系统会基于请求输入的公共前缀进行缓存。当某次请求完成推理后,系统可能将其输入中可复用的前缀片段写入缓存,以便后续请求在相同前缀出现时复用。
- 缓存命中:当后续请求的输入在开头部分与已有缓存条目存在相同前缀时,系统会尝试复用这段前缀对应的缓存结果,从而减少重复计算。
- 不保证命中:缓存容量有限,旧缓存可能被淘汰;分布式路由也会影响命中概率。
- 不保证最长前缀命中:系统会综合考虑可用资源与命中收益,命中长度可能不是全局最长命中的那一段。
- 缓存命中条件:缓存块达到对应模型的最小门槛后,才可能会被系统识别并参与命中匹配。
- 默认:缓存块最少为 1024 tokens。即请求输入最少为 1024 tokens,才有可能触发缓存命中。
- 部分模型:缓存块最少为 2048 tokens。即请求输入最少为 2048 tokens,才有可能触发缓存命中。适用模型:doubao-seed-2-1-turbo-260628、glm-5-2-260617、deepseek-v4-pro-ga-260813、deepseek-v4-flash-ga-260731、deepseek-v4-pro-260425。
- glm-5-3-flash-260828:缓存块最少为 8960 tokens。即请求输入最少为 8960 tokens,才有可能触发缓存命中。
说明
通过 API 响应字段 usage.prompt_tokens_details 判断是否命中隐式缓存:
- 命中:cached_tokens > 0
- 未命中:cached_tokens = 0
显式缓存
与隐式缓存相比,显式缓存需要显式创建并承担相应开销,但能实现更高的缓存命中率和更强的可控性。当前显式缓存支持 Session 缓存和前缀缓存两种类型。
支持模型
使用限制
为避免因使用方式不当导致缓存失效,需满足显式缓存使用的基础限制:
- store:写入缓存的前提是存储已开启,即手动配置 store 为 true 或保持缺省(默认为 true)。
- caching:
- 前一轮对话请求开启了缓存写入,当前轮次对话才能写入缓存。 以此类推,当某轮次请求需写入缓存,则需保证所有前置轮次请求的缓存写入状态开启,即前置所有轮次均有"caching": {"type": "enabled"}。
- 前面轮次只要存在"caching": {"type": "enabled"},则不支持使用 json_schema,但支持使用 json_object。
注意
- instructions:若想写入缓存,instructions 字段应为空。若在本轮请求里设置了 instructions,该轮对话不能调用已有缓存,也无法将本轮信息写入缓存。
- thinking:请求中 thinking 字段的赋值应与前一轮保持一致,才可使用缓存或写入缓存。
- 当第 1 轮设定 "thinking":{"type":"auto"},则后续如需使用或写入缓存,均需保持同样赋值。
- 当第 1 轮未设置 thinking 字段,后续请求如需写入缓存或者调用已有缓存,也需保持不设置 thinking 字段。
- tools:仅在首轮请求时可以设置 tools 字段,后续所有对话将默认携带 tools 字段信息的缓存输入。
- 不支持在后续轮次对话请求中再次设置 tools 字段,否则会冲突并报错。
- 若首轮对话信息被删除,则后续所有轮次对话都不再携带 tools 字段信息的缓存输入,也无法再配置 tools 字段。
快速使用
前提条件
前缀缓存
前缀缓存适用于固定前缀与动态后缀相结合的场景。
说明
首轮输入时,需设置 "store": true(默认 true)、"caching": {"type": "enabled", "prefix": true},以创建前缀缓存。后续轮次即可通过 previous_response_id 引用缓存信息。
创建前缀缓存场景限制:Input Tokens 需要大于等于 256 Tokens,否则会报错;stream 参数不能设置为 true。
创建前缀缓存时,返回的 usage 中 total_tokens = input_tokens,output_tokens 始终为 0。
- 创建缓存,并将内容写入。
说明
输入内容必须超过 256 tokens,否则无法创建前缀缓存。
-
- 在第二轮请求中,通过第一轮返回 id,来读取并使用缓存。
-
- 在第三轮请求中,还是通过第一轮返回 id,来读取并使用缓存。
-
Session 缓存
Responses API 支持自动储存历史上下文对话并保持缓存,通过调用 previous_response_id 在多轮对话等场景中使用缓存输入并降低推理成本。
- 创建缓存,并将内容写入。
-
- 在第二轮请求中,通过第一轮返回 id,来读取并使用缓存。
如需更新缓存,配置 "caching":{"type":"enabled"},并使用返回的请求的 id。
-
- 在第三轮请求中,通过第二轮返回 id,来读取并使用缓存。
-
管理缓存
控制存储 / 缓存生命周期
支持通过 expire_at 字段指定上下文存储(store)及上下文缓存(caching)过期时刻。当前最大可存储时间为 7 天,即当前 UTC Unix 时间戳 + 604800。当当前时刻超过过期时刻,则存储过期;不会随着缓存 / 存储的使用而重置缓存生命周期。
删除缓存
Responses API 支持根据 ID 删除缓存,与删除历史对话一致,便于根据业务自主控制缓存信息量,如删除不必要的缓存信息,减少冗余输入并降低成本。
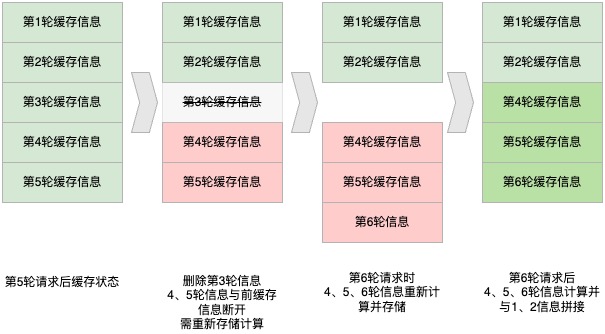
需注意,删除某轮缓存后,后续轮次缓存的信息在下次请求时会重新计算和存储。如下图所示(图中场景为第 5 轮请求后调用接口删除第 3 轮对话信息)。
注意
删除某轮缓存后,后续轮次缓存的信息会在下一次请求时重新计算并重新存储。
第 6 轮请求时,4、5 轮信息将重新计算并缓存,此时其信息将作为输入,而非缓存输入进行计费。
计费说明
- 输入(元/千 Token):正在进行的对话中的新增文本,即在删除场景后,需重新计算和缓存的历史对话信息。
- 缓存输入(元/千 Token):输入为预先处理和缓存的内容,计费费率会显著低于新输入内容。
- 存储(元/千 Token/小时):历史对话存储在缓存中,会产生存储费用;按每个自然小时使用缓存的量乘以单价进行累加。
注意
- 存储费用在缓存创建时即产生,直到该缓存被手动删除或过期后停止计费。
- 存储费用在每个自然小时整点出账,不足 1 小时按 1 小时计算。
- 输出(元/千 Token):模型根据输入信息生成的内容。计费方式与未使用 Session 缓存的调用方式一致。
输入 Token 量
可以通过 input_tokens - cached_tokens 获得。
说明
模型的输入内容会包含上一轮的思维链内容,输入 Tokens 量会增加。可以通过开启上下文编辑功能管理思维链内容和工具调用内容,控制输入 Tokens,其中命中的缓存为输入内容与上下文编辑后缓存内容的交集。
存储费用
在请求中开启缓存后才会产生存储费用,即参数配置为 "caching": {"type": "enabled"}。按自然小时计算,该小时内每一轮请求产生的新增缓存 Token 量累加计算存储费用。
存储按自然小时计算,不足 1 小时会按 1 小时计算。
维度 | 说明 |
缓存内容 | 缓存输入的内容。 |
请求示意图 |  |
单次请求计算逻辑 |
|
费用计算
开启缓存后,一次请求 1 个小时的费用包含:请求产生的 Token 费用和缓存存储费用。计算公式如下。
工作原理
显式缓存支持两种类型,分别为前缀缓存和 Session 缓存。
前缀缓存
存储初始信息,在每次对话时无需更新。可预先将角色设定、背景知识等初始化信息存入缓存,后续调用时通过缓存引用直接复用,无需重复发送相同内容,从而减少重复计算、降低使用成本。适用于标准化对话开场白、特定任务指令、规则化模板、超长文本深度分析等静态 Prompt 模板的反复使用场景。
原理图 | 说明 |
 |
|
Session 缓存
存储初始信息,同时随每一轮对话动态更新缓存。在新一轮请求,将缓存信息与输入信息一起输入给模型进行推理。适合在多轮对话、多轮工具调用等场景使用。
原理图 | 说明 |
 |
|
说明
缓存内容仅为本轮请求的输入内容,模型回复不会直接写入缓存。上一轮的模型回复及思维链内容会作为下一轮请求输入的一部分,随该轮开启缓存写入后进入缓存,因此输入 Tokens 量会增加。可通过上下文编辑功能管理思维链内容和工具调用内容,详见 输入 Token 量。
常见问题
显式缓存和隐式缓存能否同时生效?
不能。显式缓存与隐式缓存互斥;当请求使用显式缓存时,隐式缓存不生效。
前缀缓存创建失败常见原因有哪些?
最常见的原因有三类:一是首轮未按要求配置 "caching": {"type": "enabled", "prefix": true};二是输入 Tokens 小于 256;三是请求中设置了 stream=true。此外,前缀缓存的首轮默认依赖 store=true(缺省即为 true)。
删除某轮缓存后会发生什么?
删除某轮缓存后,后续轮次缓存的信息会在下一次请求时重新计算并重新存储。对应内容将按输入而非缓存输入进行计费,直到新的缓存再次建立。
如何判断隐式缓存是否命中?
查看响应中的 usage.prompt_tokens_details.cached_tokens 字段即可。大于 0 表示命中;等于 0 表示未命中。
最近更新时间:2026.10.09 14:36:33
这个页面对您有帮助吗?
有用
有用
无用
无用