火山方舟
火山方舟


文档指南

请输入


- 文档首页
 火山方舟调用视频生成Doubao Seedance 2.0 系列提示词指南
 复制全文
 下载 pdf
Doubao Seedance 2.0 系列提示词指南
 文档反馈
 问问助手
Doubao Seedance 2.0 系列(下文简称 Seedance 2.0 系列)模型原生支持音频与视频联合生成,拥有卓越的语义理解与全模态交互能力。本文介绍 Seedance 2.0 系列模型的提示词(Prompt)使用方法和相关技巧,帮助您更高效地利用该模型生成符合需求的优质视频作品。
注意
本指南中呈现的所有视觉(图片、视频)及音频素材,均由 Seedance/Seedream 系列视觉生成模型自主生成。
基础公式
Seedance 2.0 系列模型支持同时参考视频、图片、音频等全模态素材,能精准锁定人物样貌、动作特效、视觉风格、配音音色等特征,大幅降低提示词编写门槛。基于这一优势,我们可以通过简单的基础公式来引导模型,利用全模态素材的特点,快速生成满足特定需求的视频。
参考生视频可细分为三类任务:全模态参考、编辑视频和延长视频。您可根据任务类型选择提示词基础公式。
全模态参考
从素材中提取部分元素(如主体、风格、场景、音效),生成一个全新视频。
- 适用场景:动作迁移、主体复用、氛围借鉴等
- 推荐句式:
- 图片参考:参考<图片N>中的<主体N>,生成...
- 视频参考:参考<视频N>中的<动作/运镜/风格/音效>,生成...
- 音频参考:参考<音频N>中的音色,生成...
编辑视频
在原视频基础上进行局部或全局修改。未提及的部分,默认保持不变。
- 适用场景:局部替换、主体抹除、属性修改等
- 推荐句式:
- 增加元素:清晰描述<元素特征> + <出现时机> + <出现位置>
- 修改元素:严格编辑<视频N>,将其中的<原特征>修改为<新特征>
- 删除元素:点明需要删除的元素,对于保持不变的元素,在提示词中加以强调,表现更佳
延长视频
在时间维度上延续原视频,要求音视频风格、主体与叙事保持一致。
- 适用场景:续写剧情、延展动作、补全片段等
- 推荐句式:
- 延长视频:向前/向后延长<视频N>,生成...
- 轨道补全:<视频1> + <过渡画面描述> + 接 <视频2> + <过渡画面描述> +接 <视频3>
注意
编辑 / 延长视频任务,直接使用“<视频N>” 指代视频,请勿使用“参考<视频N>”,以免被误判为参考任务。
组合任务
上述3种任务也支持组合使用。
- 适用场景:参考某个素材,编辑另一个素材。
- 推荐句式:
- 参考<图片/视频N>的[参考维度],严格编辑<视频X>,[具体编辑内容]
进阶公式
Seedance 2.0 本质上是一个全模态 AI 导演:同时读取你的文字提示词、图片、视频、音频,并在内部拆成 “空间层”(画面里有什么)和 “时间层”(事情如何随时间变化)两个维度来理解和生成画面。
因此,好的提示词不是单纯的 “文案型形容”,而是 “工程型指令”:谁、在什么场景、做什么动作、镜头如何运动、按怎样的时间顺序发生,分别投递给空间层和时间层。具体公式如下:
提示词进阶公式:精准主体 + 动作细节 + 场景环境 + 光影色调 + 镜头运镜 + 视觉风格 + 画质 + 约束条件


简单说就是,先锁定“谁”在“干什么”,再交代“在哪”,“什么氛围”,然后告诉模型“怎么拍”,最后用风格、画质和约束条件把结果收紧。下面详细拆解各要素。
1 定义主体
实际参考的素材,一张图片中往往存在多个主体,为了精准引用素材中的特定对象,必须进行明确的主体定义。主体可以是人物、道具、场景等。
- 推荐句式: 将<图片/视频N>中的[主体核心特征]定义为<主体N>
- 核心特征要求:使用 2–3 个清晰、稳定的静态特征(如服饰、发型、外观、类别)进行描述,确保唯一可识别性
- 示例:
- 将图片1中穿红色连衣裙、戴草帽的女人定义为主体1
- 将图片1中穿红色连衣裙、戴草帽的女人定义为张红
当多个素材中的对象指向同一主体时,应统一绑定:
- 推荐句式: 将图片1中的[...]、图片2中的[...]定义为**<主体N>**
当视频中存在多个主体时,需要分别定义,并使用标签区分。标签应具备唯一性与稳定性,后续描述中需持续使用对应标签,避免指代混乱。
- 推荐句式: 将<图片/视频N>中的[主体1核心特征]定义为<主体1>,将<图片/视频N>中的[主体2核心特征]定义为<主体2>...
- 示例: 将视频1中的高个子男人定义为警察,将另一个矮个子男人定义为小偷。场景设定为拥挤的白天集市,阳光明媚,周围有许多水果摊位和密集的行人,充满市井生活气息。小偷在拥挤的集市人群中惊慌失措地向前狂奔, 警察在后方紧随其后全速追赶,两人快速穿梭在各个摊位之间。手持镜头向前快速跟拍,画面带有轻微真实的晃动感,营造追逐的紧张氛围。
注意
- 每次涉及主体时需明确指代,避免省略。支持以下两种用法:
- 对于未定义主体的简单场景,每次提到主体时,都要使用<主体N>@<图片N>,强调主体和素材的绑定关系。例如:张三@图片1。
- 对于已提前定义主体的场景,每次提到主体时,都应使用同一标签。例如:将视频1中的高个子男人定义为警察,将另一个矮个子男人定义为小偷。后续描述涉及到高个子男人持续使用“警察”指代,涉及到矮个子男人持续使用“小偷”指代。
- 使用素材库(Asset ID)时,仍需使用<图片/视频N>指代主体。因模型无法直接关联 Asset ID 与参考内容,故不得直接以 Asset ID 替代<图片/视频N>。
- 描述尽量简洁,避免冗余,避免语义冲突(如同一主体出现矛盾特征)。
- 空间关系建议优先通过参考图表达,减少复杂文字描述。
2 使用分镜时序
模型的内部建模是空间和时间解耦的。因此,一个复杂视频的提示词,最理想的形态是时间轴化分镜:把视频拆成几个分镜,按事件发生顺序动态描述每个分镜: 谁 + 在哪 + 做什么 + 镜头怎么动。
实操建议
使用镜头顺序,对每一段视频都写一个简单的 “镜头 1 / 镜头 2 / 镜头 3” 分镜,再合并成完整的提示词。
- 反面案例:“男人在街头紧张地奔跑,画面很有电影感。”
- 正面案例:
- 镜头 1:街巷侧拍,男人缓慢起跑,带有急促的呼吸感。
- 镜头 2:男人撞翻水果摊,镜头快速摇动并给到男人惊恐的特写。
- 镜头 3:男人翻过矮墙消失,镜头缓慢拉远定格在空荡的街道。
具体规则
- 使用镜头1、镜头2、镜头3等标识,按事件发生顺序(先主后次)组织内容。不强制限制每段时长,优先让模型根据剧情自然生成节奏。
说明
模型对精确时间(如 0–3 秒)的支持不稳定,强行限制时长可能导致生成结果异常。
- 每个镜头推荐按以下逻辑组织:
- 运镜或镜头切换方式:如 “全景缓慢推近”“固定机位”“镜头切至…” 等。
- 主体动作与表情:描述核心角色 / 物体的关键动作、神态变化。
- 位置或空间变化:说明主体所处的场景、位置或空间关系。
- 音频信息:描述对应镜头的音效、人声或背景音乐等。
3 动作描述要求
- 肢体细化 + 程度量化
- 动作需具体到手、腿、头部、肩背等肢体部位,同时补充幅度、速度、力度描述;
- 示例:缓慢抬手、快速转头、用力蹬地、微微低头。
- 优先低缓连续小动作
- 优先选用缓慢、轻柔、连贯的细微动作,尽量规避狂奔、大跳、剧烈翻滚等高爆发、大动态动作。
- 示例:缓慢行走、轻轻抬手、微微低头、顺势坐下
- 补充动作过渡衔接
- 写明前后动作的惯性与承接关系,保证画面动作连贯自然。
- 示例:借着转身惯性顺势抬手、从停顿状态自然过渡到举手。
- 情绪具象外化表达
- 用具体的身体细节表现情绪,替代 “很悲伤”“非常愤怒” 这类抽象词汇。
- 具体示例参见下表:
- 抽象情绪外化为动作与细节悲伤低头、肩膀微微颤抖、眼眶泛红、手指无意识地攥紧衣角、泪水在眼眶里打转但没有落下喜悦嘴角抑制不住地上扬、眉眼舒展、脚步变得轻快、下意识地哼起小曲、忍不住原地转个圈紧张 / 焦虑频繁地看手表、手指不停敲击桌面、呼吸急促、眼神闪躲、无意识地啃咬指甲愤怒双拳紧握、下颌线紧绷、胸口剧烈起伏、眼神如刀般锐利、从牙缝里挤出话语释然长长地舒了一口气、紧绷的肩膀完全放松下来、脸上露出久违的、淡淡的微笑、抬头望向远方
4 运镜写法
注意
一个镜头里尽量只指定 1 种运镜方式,不要同时要求推拉摇移,会增加画面的不稳定性。
5 画质、风格与约束词
画质、风格与约束词是把控视频生成效果的关键,能够为模型划定创作边界、统一画质与美术调性,同时规避画面瑕疵与随机偏差,是保障成片效果稳定合规的必要配置。
1 画质
定义画面清晰度、细节纹理与光影质感,提升成片基础画质。
示例:高清,细节丰富,电影质感,色彩自然,光影柔和
2 风格
设定整体美术画风与视觉调性,统一画面艺术氛围。
示例:赛博朋克冷蓝紫色调、复古胶片、日系清新
3 约束词
约束词十分重要,可有效规避画面瑕疵、畸形崩坏及不合理元素,约束生成边界与稳定性。
常用约束词模板:
- 避免生成字幕:“保持无字幕”、“避免生成任何文字或字幕”
- 避免生成 Logo:“不要生成Logo”
- 避免生成水印:“不要生成水印”
6 实战案例
展示如何使用上文介绍的进阶公式和各要素来编写提示词。
素材准备:
- @图片 1:女主半身照
- @图片 2:宿舍场景参考图
- @视频 1:室内对话运镜参考(中景推拉或轻微摇移)
- @音频 1:室内环境声或轻音乐
提示词:
@图片 1 中的女孩作为主角,@图片 2 作为宿舍场景风格参考,参考 @视频 1 的运镜方式。
镜头 1:傍晚时分,女孩 @图片 1 脚步轻快地走到宿舍门口 @图片 2,镜头中景平稳跟拍,暖黄色日光从窗外洒进走廊,她在门口停顿一下,深呼吸,表情略带紧张。
镜头 2:女孩 @图片 1 推开门走进宿舍,镜头切到室内中景,舍友们一边整理书本一边抬头看向她,其中一人笑着问 {考得怎么样呀,过了吗},镜头在几人之间缓慢切换半身特写。
镜头 3:女孩 @图片 1 先低头露出落寞表情,镜头给到她的近景,随后她抬头憋不住笑意,哈哈大笑说 {骗你们的},舍友们追着打闹起来,镜头缓慢拉远,定格在宿舍内一片欢声笑语的全景画面。
全程画面高清电影纪实风,色调温暖,光影柔和;人物面部稳定不变形,动作自然流畅,无卡顿无闪烁;环境音效与 @音频 1 自然融合。
素材准备:
- @图片 1:红衣女主
- @图片 2:黑衣刺客(对手)
- @图片 3:悬崖竹林场景图
- @视频 1:武打对决运镜参考
- @音频 1:紧凑的鼓点或打斗音效
提示词:
@图片 1 的红衣女子作为女主,@图片 2 的黑衣女子作为对手,场景参考 @图片 3 的悬崖竹林环境,整体运镜和动作节奏参考 @视频 1,背景音效与 @音频 1 同步。
镜头 1:傍晚,镜头从红衣女子 @图片 1 侧面中景缓慢推进,她站在悬崖边拿起酒壶喝酒,衣袂在山风中轻轻摆动,镜头环绕她半圈,从正面推到背影,远处隐约可见竹林中的黑衣人影。
镜头 2:镜头变焦渐隐到远景,无人机视角俯瞰整片悬崖和竹林,两人分立山崖两端,山风卷起衣摆和尘土,节奏随鼓点略微加快。
镜头 3:镜头切回地面近景,二人缓慢拔剑对峙,红衣女子@图片 1 神情从漫不经心转为冷冽,黑衣女子@图片 2 目光坚毅,剑尖微微颤动,镜头平稳跟随两人绕圈移动,最后定格在两剑相交前一瞬间的特写。
整体画面烟雨江湖电影感,冷调低饱和,电影胶片质感,光影层次丰富;人物面部和身体比例稳定不变形,动作连贯自然,不僵硬,无穿模无卡顿。
其他技巧
文字生成
Seedance 2.0 系列模型支持生成常用文字。模型能根据情境自动匹配合适的风格与颜色,也支持在提示词中指定文字的颜色、风格、出现方式、出现时机、出现位置。编写时请优先使用常用字,避免生僻字与特殊符号,以确保最佳呈现效果。当前支持广告语、字幕、气泡等场景,具体写法和案例请参见文字生成。
视频延长 vs 分段拼接
- 连续长镜头(视频延长):适用于单一场景内的 “文戏”,如长对话、情绪递进、单一路径移动,以实现沉浸式、连贯的一镜到底效果。
- 场景 / 动作转折(分段拼接):适用于剧情转折或复杂、快速的 “武戏”,如追逐、打斗、蒙太奇等,可通过独立生成片段再剪辑组合,保证节奏与视觉冲击力。
实际制作中通常结合两种方式,例如先用延长生成连贯对话,再拼接空镜或转场片段,兼顾沉浸感与节奏变化。
素材配置策略
通常把素材分成四种 “功能角色”:
- 角色锚定:锁定角色外观
- 场景定调:锁定环境与风格
- 运镜参考:锁定镜头语言与动作节奏
- 节奏氛围:用音频控制情绪、音色
推荐配置(总计 4-5 个素材):角色图 1-2 张(面部特写 / 全身)+ 场景图 1 张 + 运镜视频 1 段 + 音频 1 段。
说明
不建议用满素材上限,过多素材会导致模型难以判断特征优先级,易出现风格冲突、主体识别模糊、生成效果偏离预期等问题。
注意事项
语言规范
台词语言需统一,避免中英文混用(专有名词除外)。
特殊字符规范
提示词中合理使用符号有助于模型准确理解不同信息类型:
信息类型 | 符号 | 示例 |
音乐 | () | (背景中播放着快节奏的摇滚乐) |
音效 | <> | <远处传来狗叫声> |
台词 | {} | {你好,世界}。如果台词为小语种(非中英文),需标注语种,如:用日语说道{こんにちは}。 |
字幕 | 【】 | 【第一章:启程】 |
常见问题
人脸参考不准确
典型现象
生成的角色形象与参考图不一致,或在视频中途发生“换脸”,导致视频中人物撞脸明星被审核拦截。
根因分析
人脸参考图的有效性不足
- 参考图混用:将人脸参考图与全身/半身姿态图、服装参考图、细节图等合并在同一张图片中提供给模型。
- 人脸占比过小:在混用参考图中,人脸区域占整张图的比例过小,模型在提取人脸特征时权重不够,容易被背景或其他元素干扰。
解决方案
强化人脸参考的独立性和权重:
- 准备人脸特写图:在原有全身照之外,额外准备一张只包含角色头部的人脸特写图(大头照,仅保留面部,无表情最佳,尽量减少肩颈、背景等干扰元素)。
- 提示词中主体定义清晰:<主体1> 的面部特征参考图片1(大头照),妆造参考图片2(全身照)。
- 重要素材前置:越需要精准参考的素材,放在提示词中越靠前的位置。
注意
人物参考使用大头照 + 全身照即可,不建议使用人物多视图。多视图素材包含同一人物的不同角度,模型易将其识别为多个不同主体,反而加剧人脸参考不准确的问题。
优化前 | 优化后 |
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
视频中人物中途“换脸”,撞脸明星 | Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
人脸与参考图全程保持一致 |
视频中包含字幕
典型现象
提示词中未要求生成字幕,生成的视频中包含字幕。
解决方案
说明
目前无法直接做到 100% 避免生成字幕,只能通过以下方法降低其出现概率、提升抽卡成功率。
- 在提示词中加入明确的约束指令:“保持无字幕”、“避免生成任何文字或字幕”。
- 如果参考的图片/视频中包含的文字并非必要信息,建议先通过工具去除文字(例如使用 Seedream/ Seedance 模型的图片/视频编辑能力),再使用无文字素材作为输入。
- 在业务允许的前提下,优先选择横屏尺寸生成视频(横屏生成字幕的概率明显低于竖屏),后续可通过剪辑软件裁剪为竖屏。
视频中有 Logo / 水印
典型现象
提示词中未提及水印相关内容,生成的视频包含其他视频平台的 Logo / 水印。
解决方案
在提示词中加入明确的约束指令:“不要生成水印”、“不要生成Logo” 。
风格漂移
典型现象
期望生成 2D 或者 3D 动漫风格,但输入的参考图片的风格比较写实,并且提示词中未强调视频风格,生成的视频有概率漂移成真人写实风格。
解决方案
在提示词中加入明确的风格约束词,例如“2D日漫风格”、“3D国风漫画”。如果需要更精准的风格控制,建议将参考图先变为目标风格再进行生视频。
优化前 | 优化后 |
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
仙侠风格漂移成真人风格 | Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
保持 3D 国漫 CG 仙侠风格 |
延长视频衔接处跳变
典型现象
使用视频延长功能生成新视频后,将新视频与原视频进行拼接,在衔接处可能出现画面跳变、回退的问题。
解决方案
当前建议通过后期剪辑修补,对齐关键帧,后续将依托模型迭代进行根本性优化。
- 将待拼接的视频导入剪映或其他专业视频剪辑软件。
- 在第一个衔接处,将前一段视频的末尾删减 6 帧。
- 同时,将后一段视频的开头删减 1 帧。
- 对所有的拼接点重复以上操作。
- 导出并检查拼接后视频的流畅度。
说明
视频帧对齐后,仍可能存在细微跳变,建议在续写生成视频的时候以转场切镜的时刻结尾,下一段视频以结尾切镜后的新场景为起始。
优化前 | 优化后 |
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
在衔接处(第 5s,第20s)出现画面瞬间跳动或内容回退 | Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
衔接处更加平滑 |
双胞胎问题
典型现象
在画面人物较多且传入人物三视图作为参考素材的场景下,生成视频同一画面中易出现两个完全相同的人物。
根因分析
- 提示词中对人物主体的定义不清晰,模型无法精准区分不同人物角色;
- 以人物三视图 / 多视图作为参考素材时,易造成模型人物识别混淆,从而生成重复同款人物。
解决方案
说明
目前无法直接做到 100% 避免双胞胎问题,只能通过以下方法降低其出现概率、提升抽卡成功率。
- 明确人物主体关联
在提示词中清晰定义每个人物角色,明确角色与参考图的对应关系。建议在人物名称后标注对应参考图,并保持格式统一。
示例:张三(对应图片 1)将绿色存折扔向站立的李四(对应图片 2)。
2. 添加全局约束指令
在提示词末尾增加固定约束:视频全程禁止出现外形、着装、配饰完全一致的人物,禁止生成同款分身、双胞胎效果,同一画面中仅保留单个对应人物,不出现人物重复复刻。
3. 优化参考素材
人物参考图优先使用单人独立照片,不建议使用三视图、多视图素材。
4. 精简优化提示词
请勿直接将完整剧本作为提示词使用,文案内容过度冗余易造成模型理解混乱,需精简无关表述、保证指令清晰聚焦。
优化前 | 优化后 |
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
画面第8秒出现“双胞胎” | Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
|
视频延长画质劣化
典型现象
将模型生成的视频作为输入素材进行延长续写时,会出现画质劣化。多次续写会叠加劣化效果,尤其人物人脸区域易出现斑驳色块。
解决方案
当前可通过以下方式缓解画质劣化,后续将依托模型迭代进行根本性优化:
- 将原始视频通过 Seedance 2.0 转为白模视频,再作为续写输入素材。
- 参考提示词:将视频转为白色 3D 模型,人物统一为纯白 3D 模型,无色彩、无纹理、无阴影,纯白背景,结构稳定、运动流畅。
- 优先选用高清图片作为参考素材。
- 合理控制视频续写次数,避免多次叠加续写。
优化前 | 优化后 |
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
直接对模型产物进行续写 | Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
将模型产物转化为白模视频后再进行续写 |
特效效果不符合预期
典型现象
通过提示词文字描述特定特效时,可能会出现特效效果与预期不符的情况,例如:提示词指定「数字“2999”以倒计时动画出场」,实际生成的数字滚动特效出现无序跳变,不符合标准倒计时逻辑。
解决方案
建议采用参考视频定义特效:将目标特效视频作为参考素材输入模型,让模型精准理解特效形态与运动逻辑,生成效果更贴合预期。例如:数字“2999”出场方式参考视频1。
优化前 | 优化后 |
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
数字滚动特效有明显的无序跳变感 | Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
增加正确的数字滚动特效视频后,特效结果符合预期 Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
特效动画 |
参考人物过多
典型现象
当参考人物数量超过 4 人时,模型输出稳定性下降,生成的视频可能出现人物数量不符(如少人、多人)或人物重复等问题。
解决方案
当前可通过以下方式缓解,后续将依托模型迭代进行根本性优化:
- 分步生成图片:将人物分组,确保每组生成的图片中人物数量不超过 4 人。例如,6 个人可分成 2 组,每组 3 人,分别生成图片。
- 图片生成视频:使用第一步生成的多张分组图片作为参考素材,再生成最终视频。
优化前 | 优化后 |
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
输入 8 个参考角色,输出视频有 9 人 | Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
将 8 个角色生成 2 张图后,再使用图生视频 |
视频结尾有噪音
典型现象
视频中包含旁白时,视频片尾容易出现突兀咔哒声、截断杂音。
解决方案
重新生成视频,或使用剪映等剪辑工具,对片尾音轨通过音量包络线做音频淡出处理,消除截断噪音。
具体步骤 (使用剪映):
- 将生成的视频导入剪映。
- 在时间轴上选中视频轨道,点击工具栏中的音频。
- 选择音量包络线功能(部分版本位于基础 / 调节菜单内),并选择关键点。此时音频轨道上会出现一条代表音量的线以及关键点。
- 在视频临近结尾处,将末尾音量关键点下拉至音量为 0,形成一个向下的斜坡。
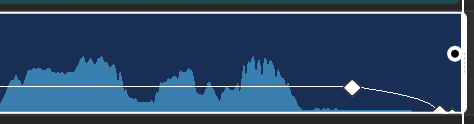
- 预览确认片尾音频自然淡出,无突然截断与杂音即可。
优化前 | 优化后 |
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
结尾有噪音 | Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
结尾无噪音 |
中文发音不准
典型现象
模型对多音字、生僻字、形近字容易读错。
解决方案
可将易读错文字替换为发音一致的常用同音字,规避发音偏差,还原预期音频效果。注意该方案仅为优化手段,无法完全规避所有发音问题。
示例:可将提示词中“螭龙山”改写为同音字“吃龙山”。
优化前 | 优化后 |
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
"螭龙山"的“螭”发音不对 | Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
改成“吃龙山”后发音正确 |
音色参考不准
典型现象
使用参考音频指定音色时,最终生成视频的音频音色与参考音色存在明显偏差。
解决方案
- 在提示词中补充细致的音色特征描述。
- 保持视频台词风格与参考音频的语气、表述风格相近,有助于提升音色还原度与稳定性。
附录:提示词案例
文字生成
广告语(Slogan)
提示词参考模板:
「文字内容」+「出现时机」+「出现位置」+「出现方式」,「文字特征(颜色、风格)」
说明
Seedance2.0 能根据情境匹配合适的文字风格,如果对文字表现效果的要求较为严格,可参考下文中的多图参考 > Logo 参考。
参考案例:
[成品效果]
Replay
00:00
/
00:00
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
[提示词]
手绘漫画风格,三个人围坐在一起吃图片1中的炸鸡,气氛友好愉悦,后画面逐渐模糊,画面中部显示文字“快乐尽在 Seedance”。
[参考素材]
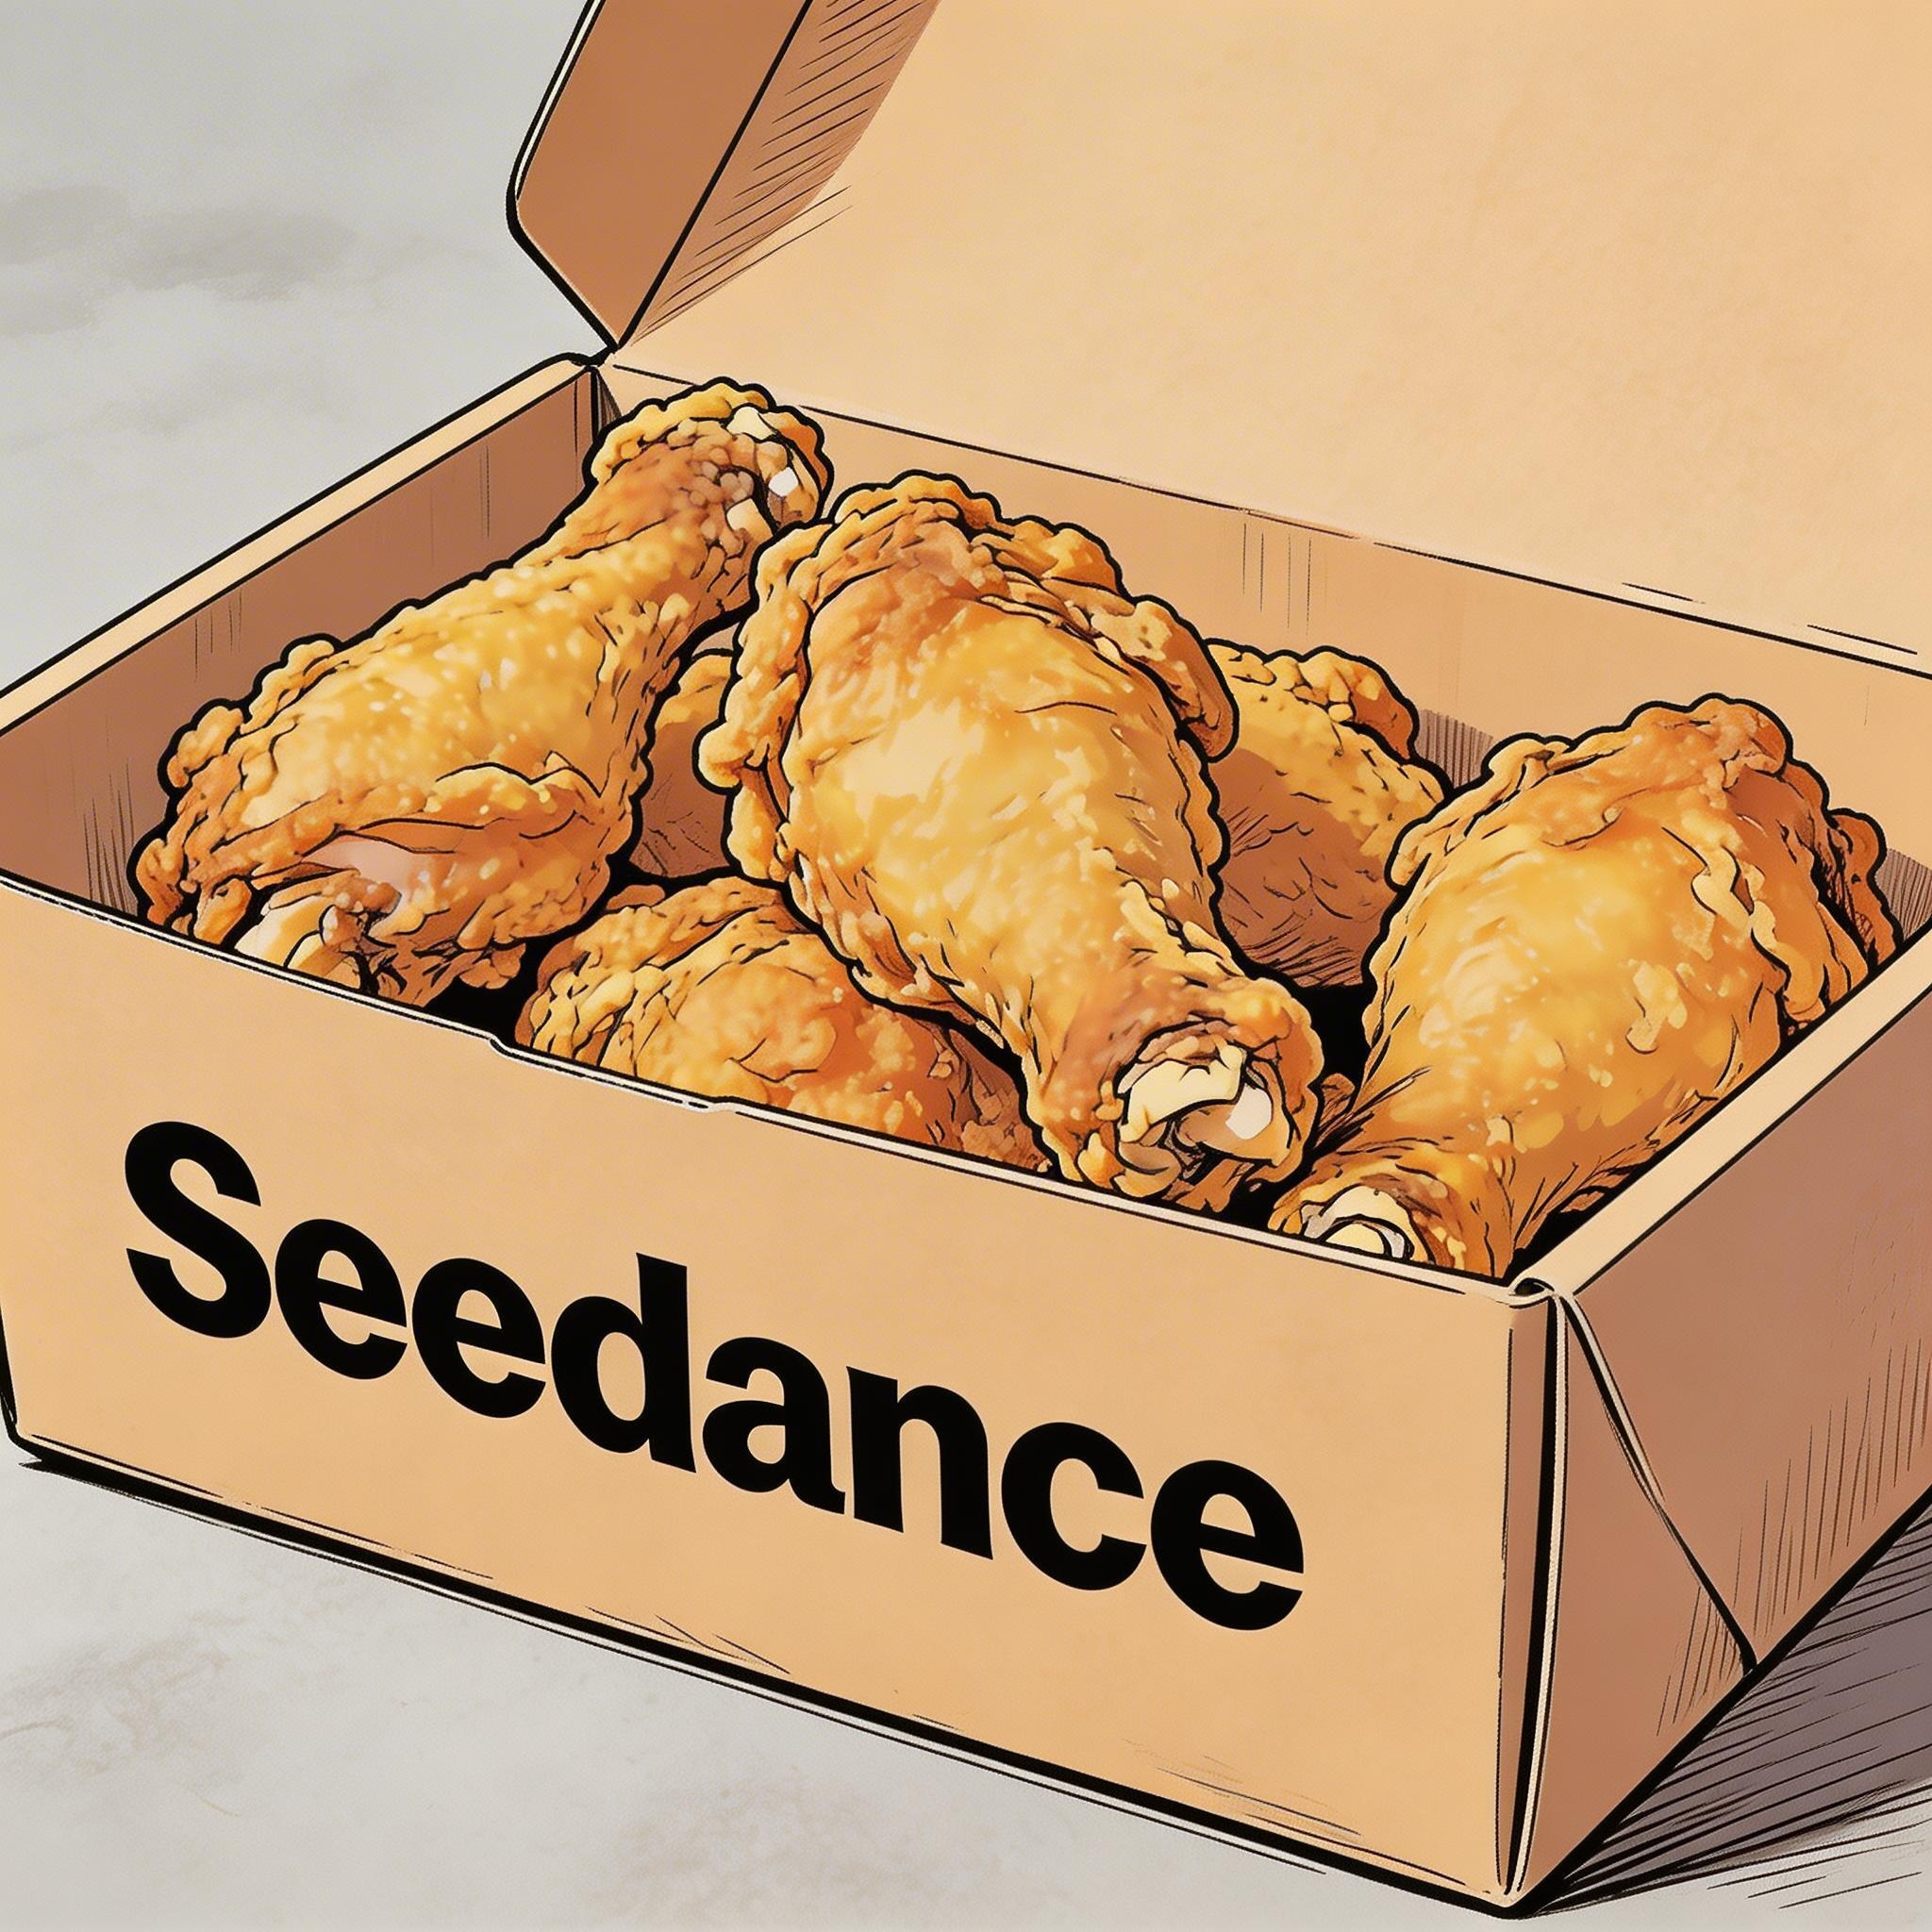
▲ 图片 1
字幕
提示词参考模板:
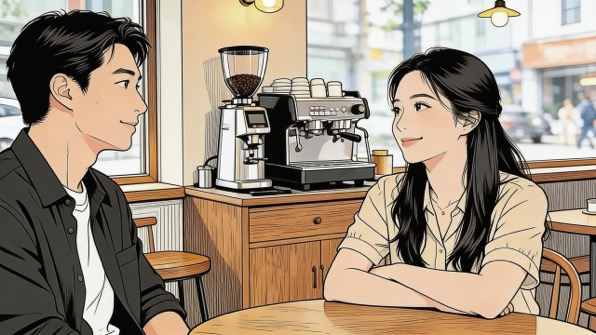
画面底部出现字幕,字幕内容为“……”,字幕需与音频节奏完全同步。
参考案例:
[成品效果]
Replay
00:00
/
00:00
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
[参考素材]
[提示词]
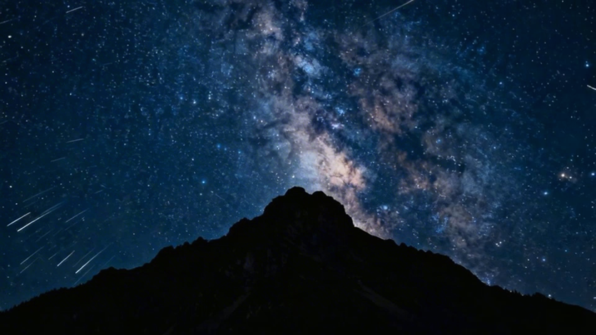
生成带有画外音的视频。一个深沉、平静的男声说:“在宏大的宇宙中,我们的世界不过是一个短暂的瞬间。然而,在其中,生命不顾一切地繁荣。”场景应从夜晚缓慢过渡到黎明,星星逐渐消失,太阳从山后升起。画面底部按照台词出现字幕。
[成品效果]
Replay
00:00
/
00:00
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
[参考素材]
[提示词]
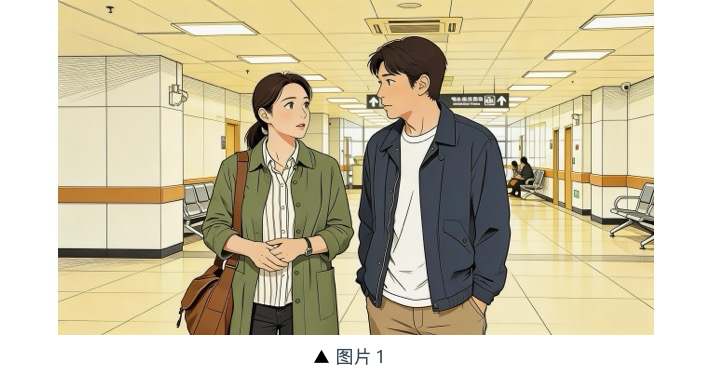
图片中的两人在办公室聊天,女性先说话,她说道:“你每次卡点到,是不是很享受这种刚刚好的感觉?”男性笑着回应:“我有我的节奏”角色说话时,对话随意自然,画面底部出现对应台词字幕。
气泡台词
提示词参考模板:
「角色」说:“……”,角色说话时周围出现气泡,气泡里写着台词。
参考案例:
[成品效果]
Replay
00:00
/
00:00
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
[参考素材]
[提示词]
图片1中的两人穿着运动服在学校的操场跑步,女孩看向男孩,自信地笑着说:“We can definitely do it! ”镜头切到男孩的近景,他犹豫地回答:“Are you sure? ”镜头切回女孩的中近景,她语气轻快地说:“Yes! ”情绪明亮而坚定。说话的角色周边出现气泡,气泡里是对应台词。
[成品效果]
Replay
00:00
/
00:00
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
[参考素材]
[提示词]
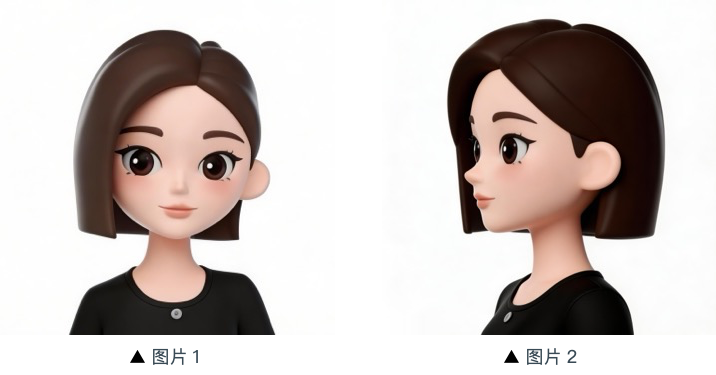
参考图片1、图片2中的女孩形象,女孩在一个草莓园里,摘下一颗,吃了一口,笑着说:“This is the real deal! ”女孩周围出现一个气泡,气泡里面写着台词。
图片参考
Seedance 2.0 系列模型既支持主体多视角参考,也支持场景图、分镜图等多图参考。
使用过程中,如对图片顺序有要求,应按顺序上传,提示词中可使用图片1、图片2……图片n进行准确指代。
主体多视角图参考
指代清楚参考对象即可,模型能够响应的指令包括但不限于以下示例。
商品:
3C 数码
[成品效果]
Replay
00:00
/
00:11
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
[参考素材]
[提示词]
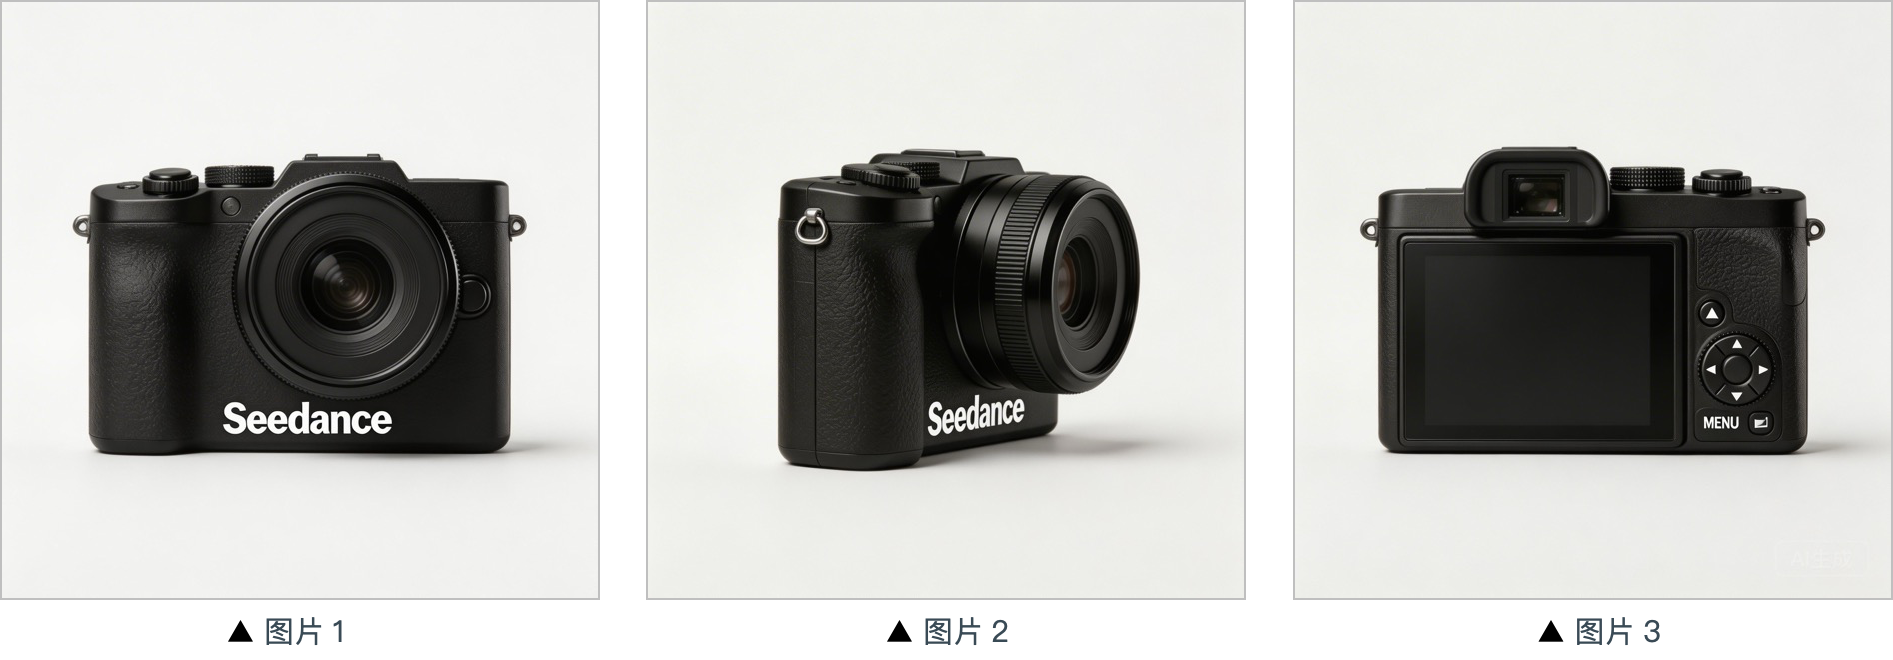
提取图片1、图片2、图片3的相机,把背景换成白色,相机在一个白色桌子上,镜头以特写的形式聚焦相机,然后以相机为主体缓慢旋转,清晰展示相机的正面侧面以及背面。
家居物品
[成品效果]
Replay
00:00
/
00:08
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
[参考素材]
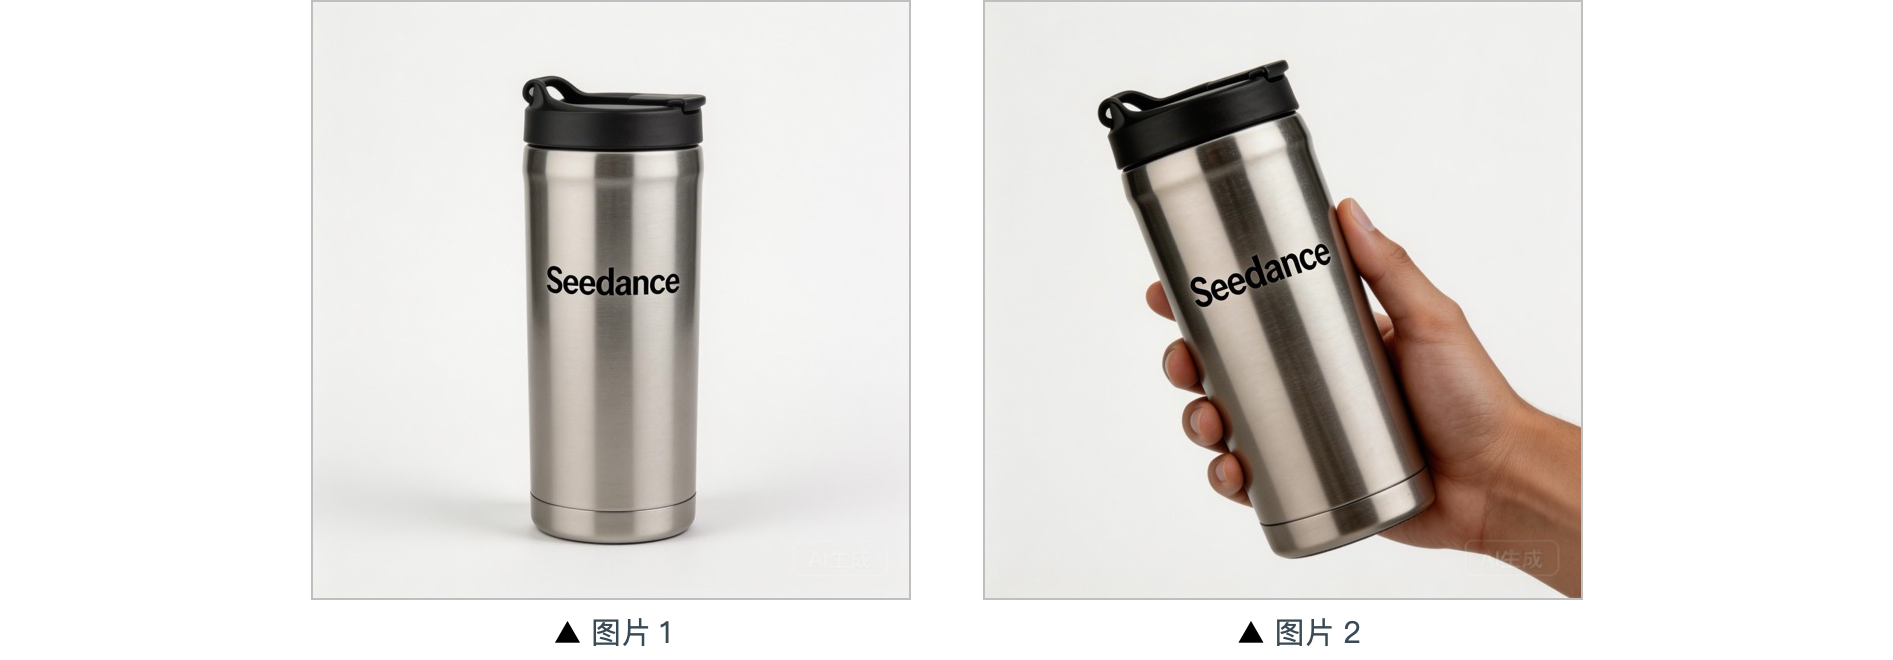
[提示词]
背景为暖调居家场景,中景呈现参考图中的保温杯,镜头平稳推近至保温杯近景,镜头外一只手自然入镜轻握杯身拿起保温杯,镜头跟拍手部微微旋转动作展示。
角色:
[成品效果]
Replay
00:00
/
00:07
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
[提示词]
参考图片1、图片2、图片3中的女子形象,生成她在一家咖啡店吃蛋糕的画面。
[参考素材]
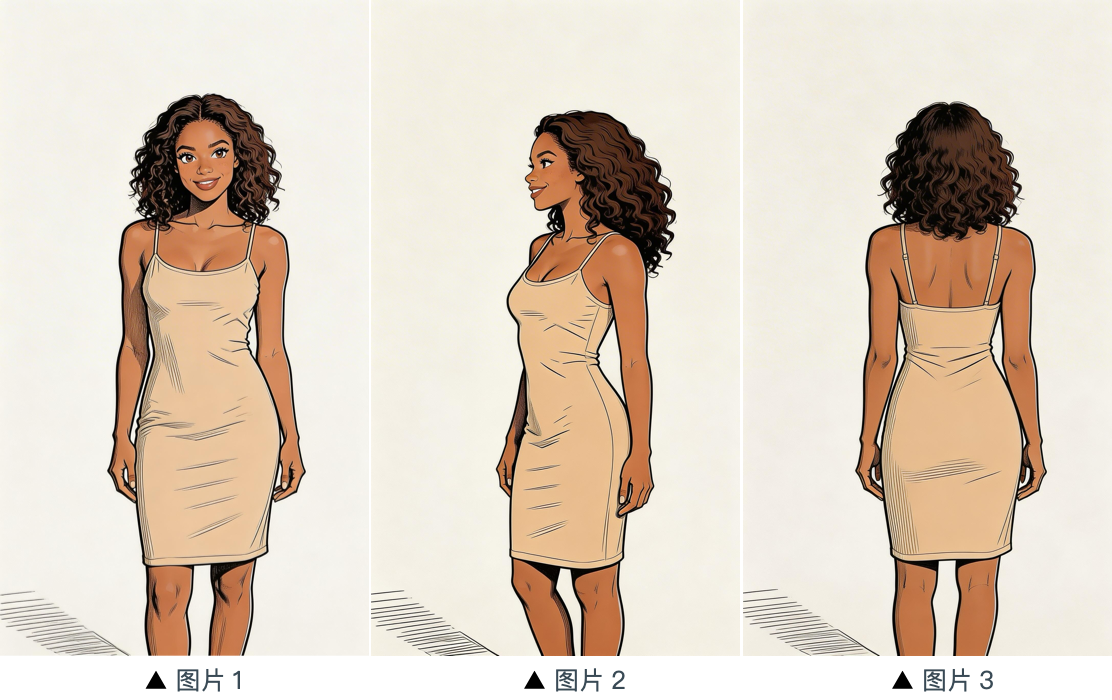
多图参考
Logo 参考
[成品效果]
Replay
00:00
/
00:12
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
[参考素材]
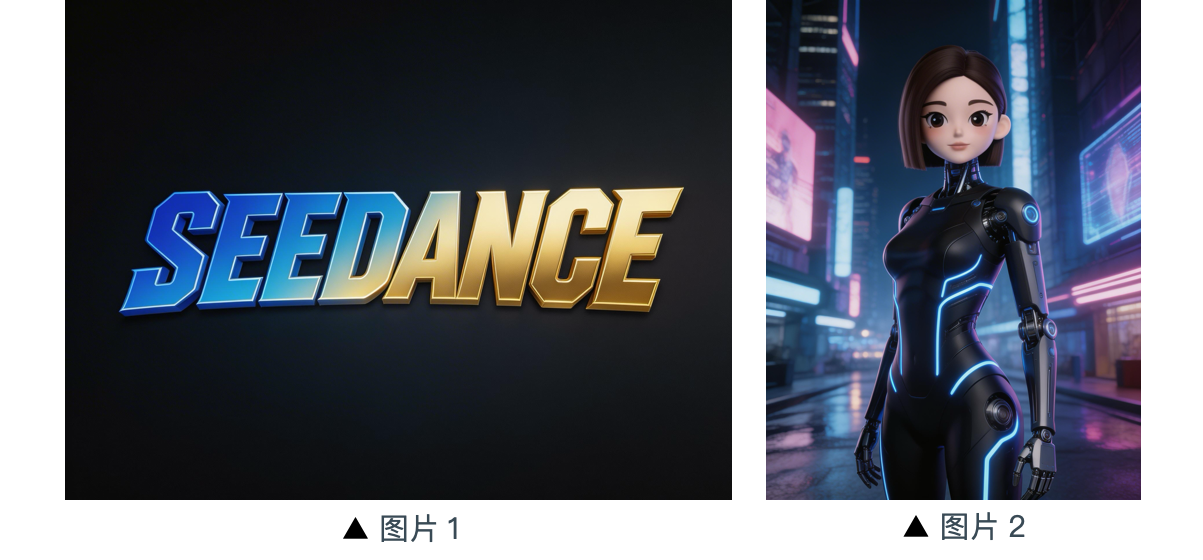
[提示词]
背景是霓虹闪烁的未来都市空中廊道,飞行器与全息广告交织,参考图片2中的女孩,先用中景展示女孩放飞带有全息投影的银色悬浮灯,再镜头拉远展现漫天悬浮灯,画面逐渐模糊,后出现图片1的 Logo,整体风格为 3D 赛博朋克科幻动画风格。
多主体参考
[成品效果]
Replay
00:00
/
00:12
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
[参考素材]
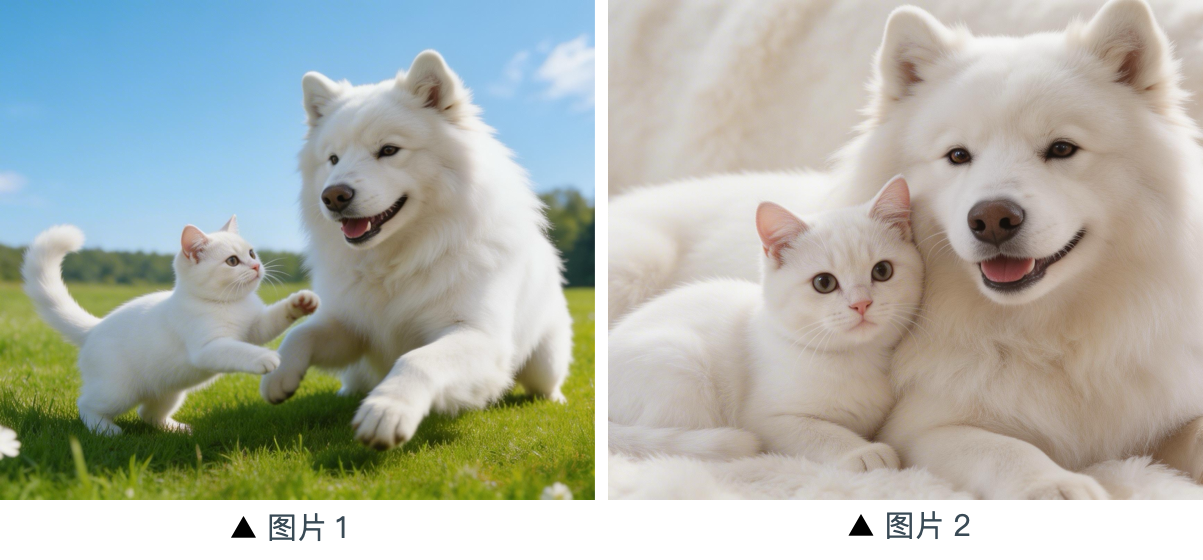
[提示词]
参考图片中的猫猫和狗狗,在一个温馨的公寓里,狗狗在趴着吃狗粮,猫猫走过来,伸出爪子碰了碰狗狗,狗狗看到猫猫后停下吃饭,猫猫依偎在狗狗身边。画面采用暖色调。
多元素参考
[成品效果]
Replay
00:00
/
00:00
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
[参考素材]
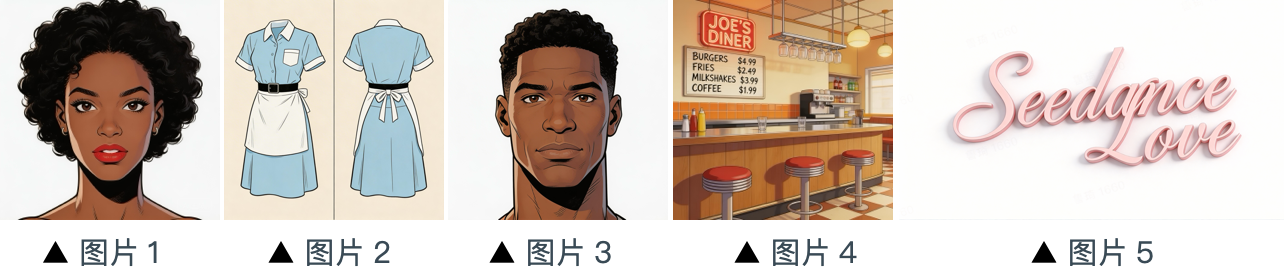
[提示词]
场景设定在图片4中的餐厅内,店内人来人往。图片1里的女孩身着图片2中的服装,正在整理柜台上的物品。图片3中的男孩是一位顾客,他走上前,想要向女孩索要联系方式。图片5中的标识始终显示在画面的右下角。
多宫格分镜图参考
[成品效果]
Replay
00:00
/
00:14
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
[参考素材]
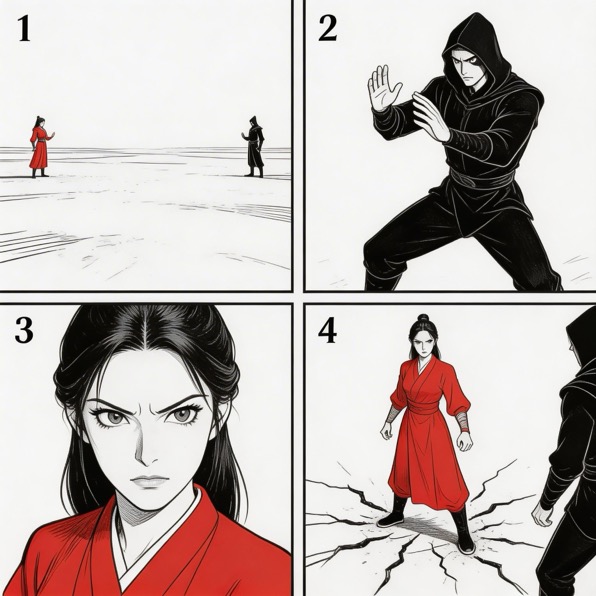
[提示词]
参考图片中的分镜图,生成打斗激烈的打斗场面。图片中的各个分镜构图要按照顺序出现,之后二人激烈打斗。
分镜图参考
[成品效果]
Replay
00:00
/
00:12
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
[参考素材]
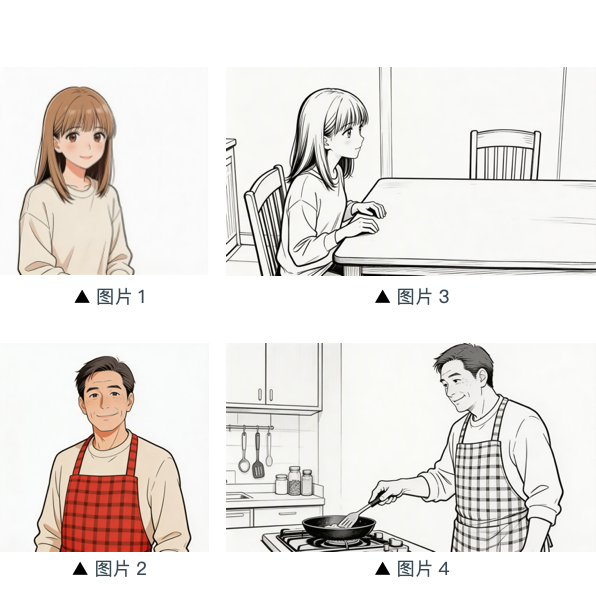
[提示词]
参考图片3中的分镜构图,女孩正在等爸爸做好饭,她说:“아빠, 배고파요! 밥 다 됐어요?”,女孩形象参考图片1。接着镜头向右横摇,切换至图片4的画面和构图,爸爸形象参考图片2,爸爸回答她:“거의 다 됐어, 조금만 기다려!“,接着镜头切换回女儿略显失落的面部表情特写,她说:“아직 멀었어요? 맛있는 냄새 나는데……”,接着切换成爸爸的面部特写,他说:“이제 진짜 금방이야。 "빨리빨리" 하지 말고 손부터 씻고 와!”。
视频参考
Seedance 2.0 系列模型支持视频参考,使用时指代清楚生成内容和参考对象即可。
使用过程中,如对视频顺序有要求,应按顺序上传,提示词中可使用视频1、视频2……视频n进行准确指代。
动作参考
影视
[成品效果]
Replay
00:00
/
00:00
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
[参考素材]
Replay
00:00
/
00:00
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
▲ 视频 1
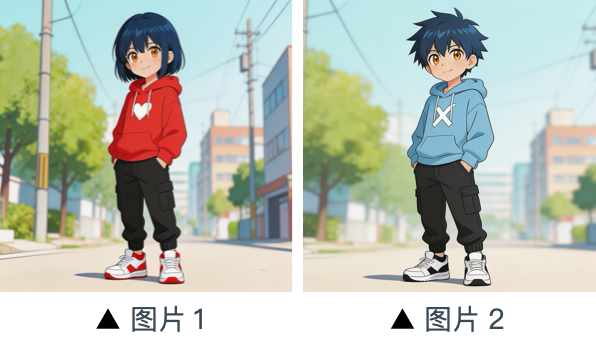
[提示词]
参考视频1的人物动作和镜头语言,生成图片2和图片1的打斗场面,图片2是左边人物,图片1是右边人物。有激烈的背景音乐。
营销
[成品效果]
Replay
00:00
/
00:05
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
[参考素材]
Replay
00:00
/
00:12
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
▲ 视频 1
[提示词]
参考视频1中马的奔跑形态,生成一匹金色的骏马在草原上奔跑,随即定格其奔跑的华丽姿态,变成一个马形的金吊坠。
运镜参考
[成品效果]
Replay
00:00
/
00:08
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
[提示词]
参考视频1的运镜,做一个科技园区的概念视频,以图片1中的高楼为视觉中心,同为第一视角俯冲,体现出图片1中园区的科技感。
[参考素材]
Replay
00:00
/
00:00
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
▲ 视频 1
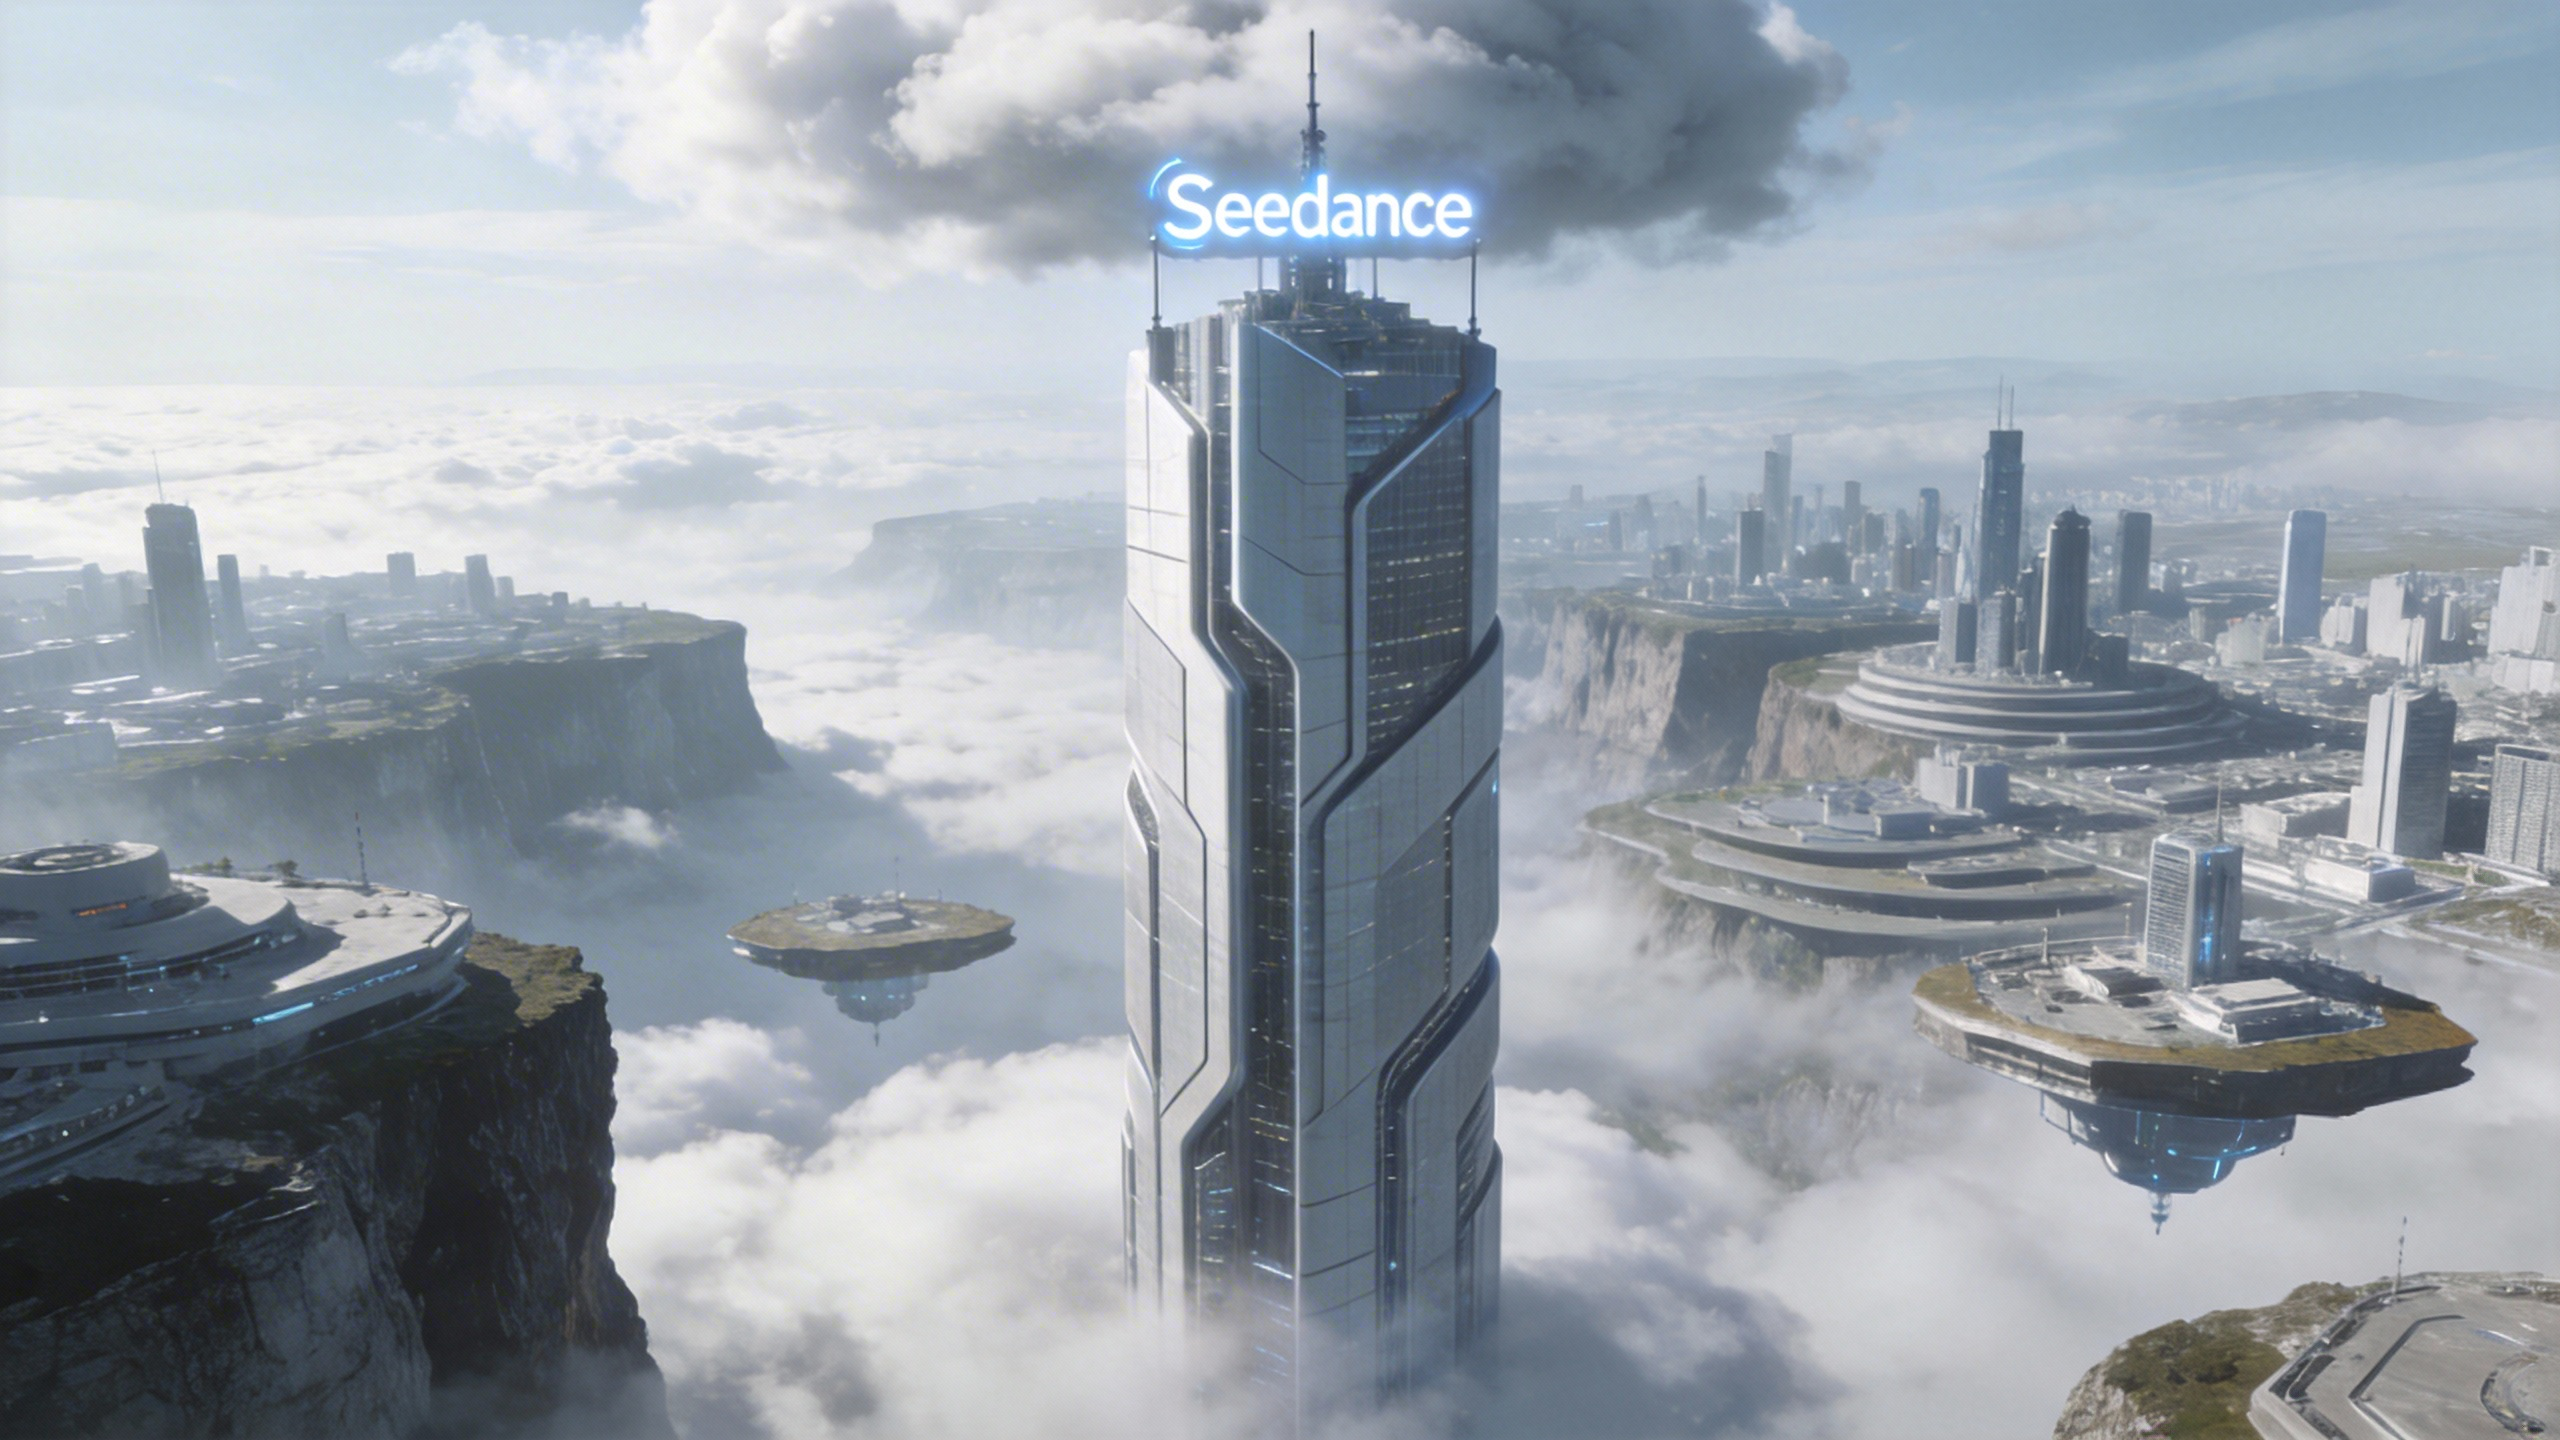
▲ 图片 1
特效参考
影视
[成品效果]
Replay
00:00
/
00:05
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
[参考素材]
Replay
00:00
/
00:00
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
▲ 视频 1
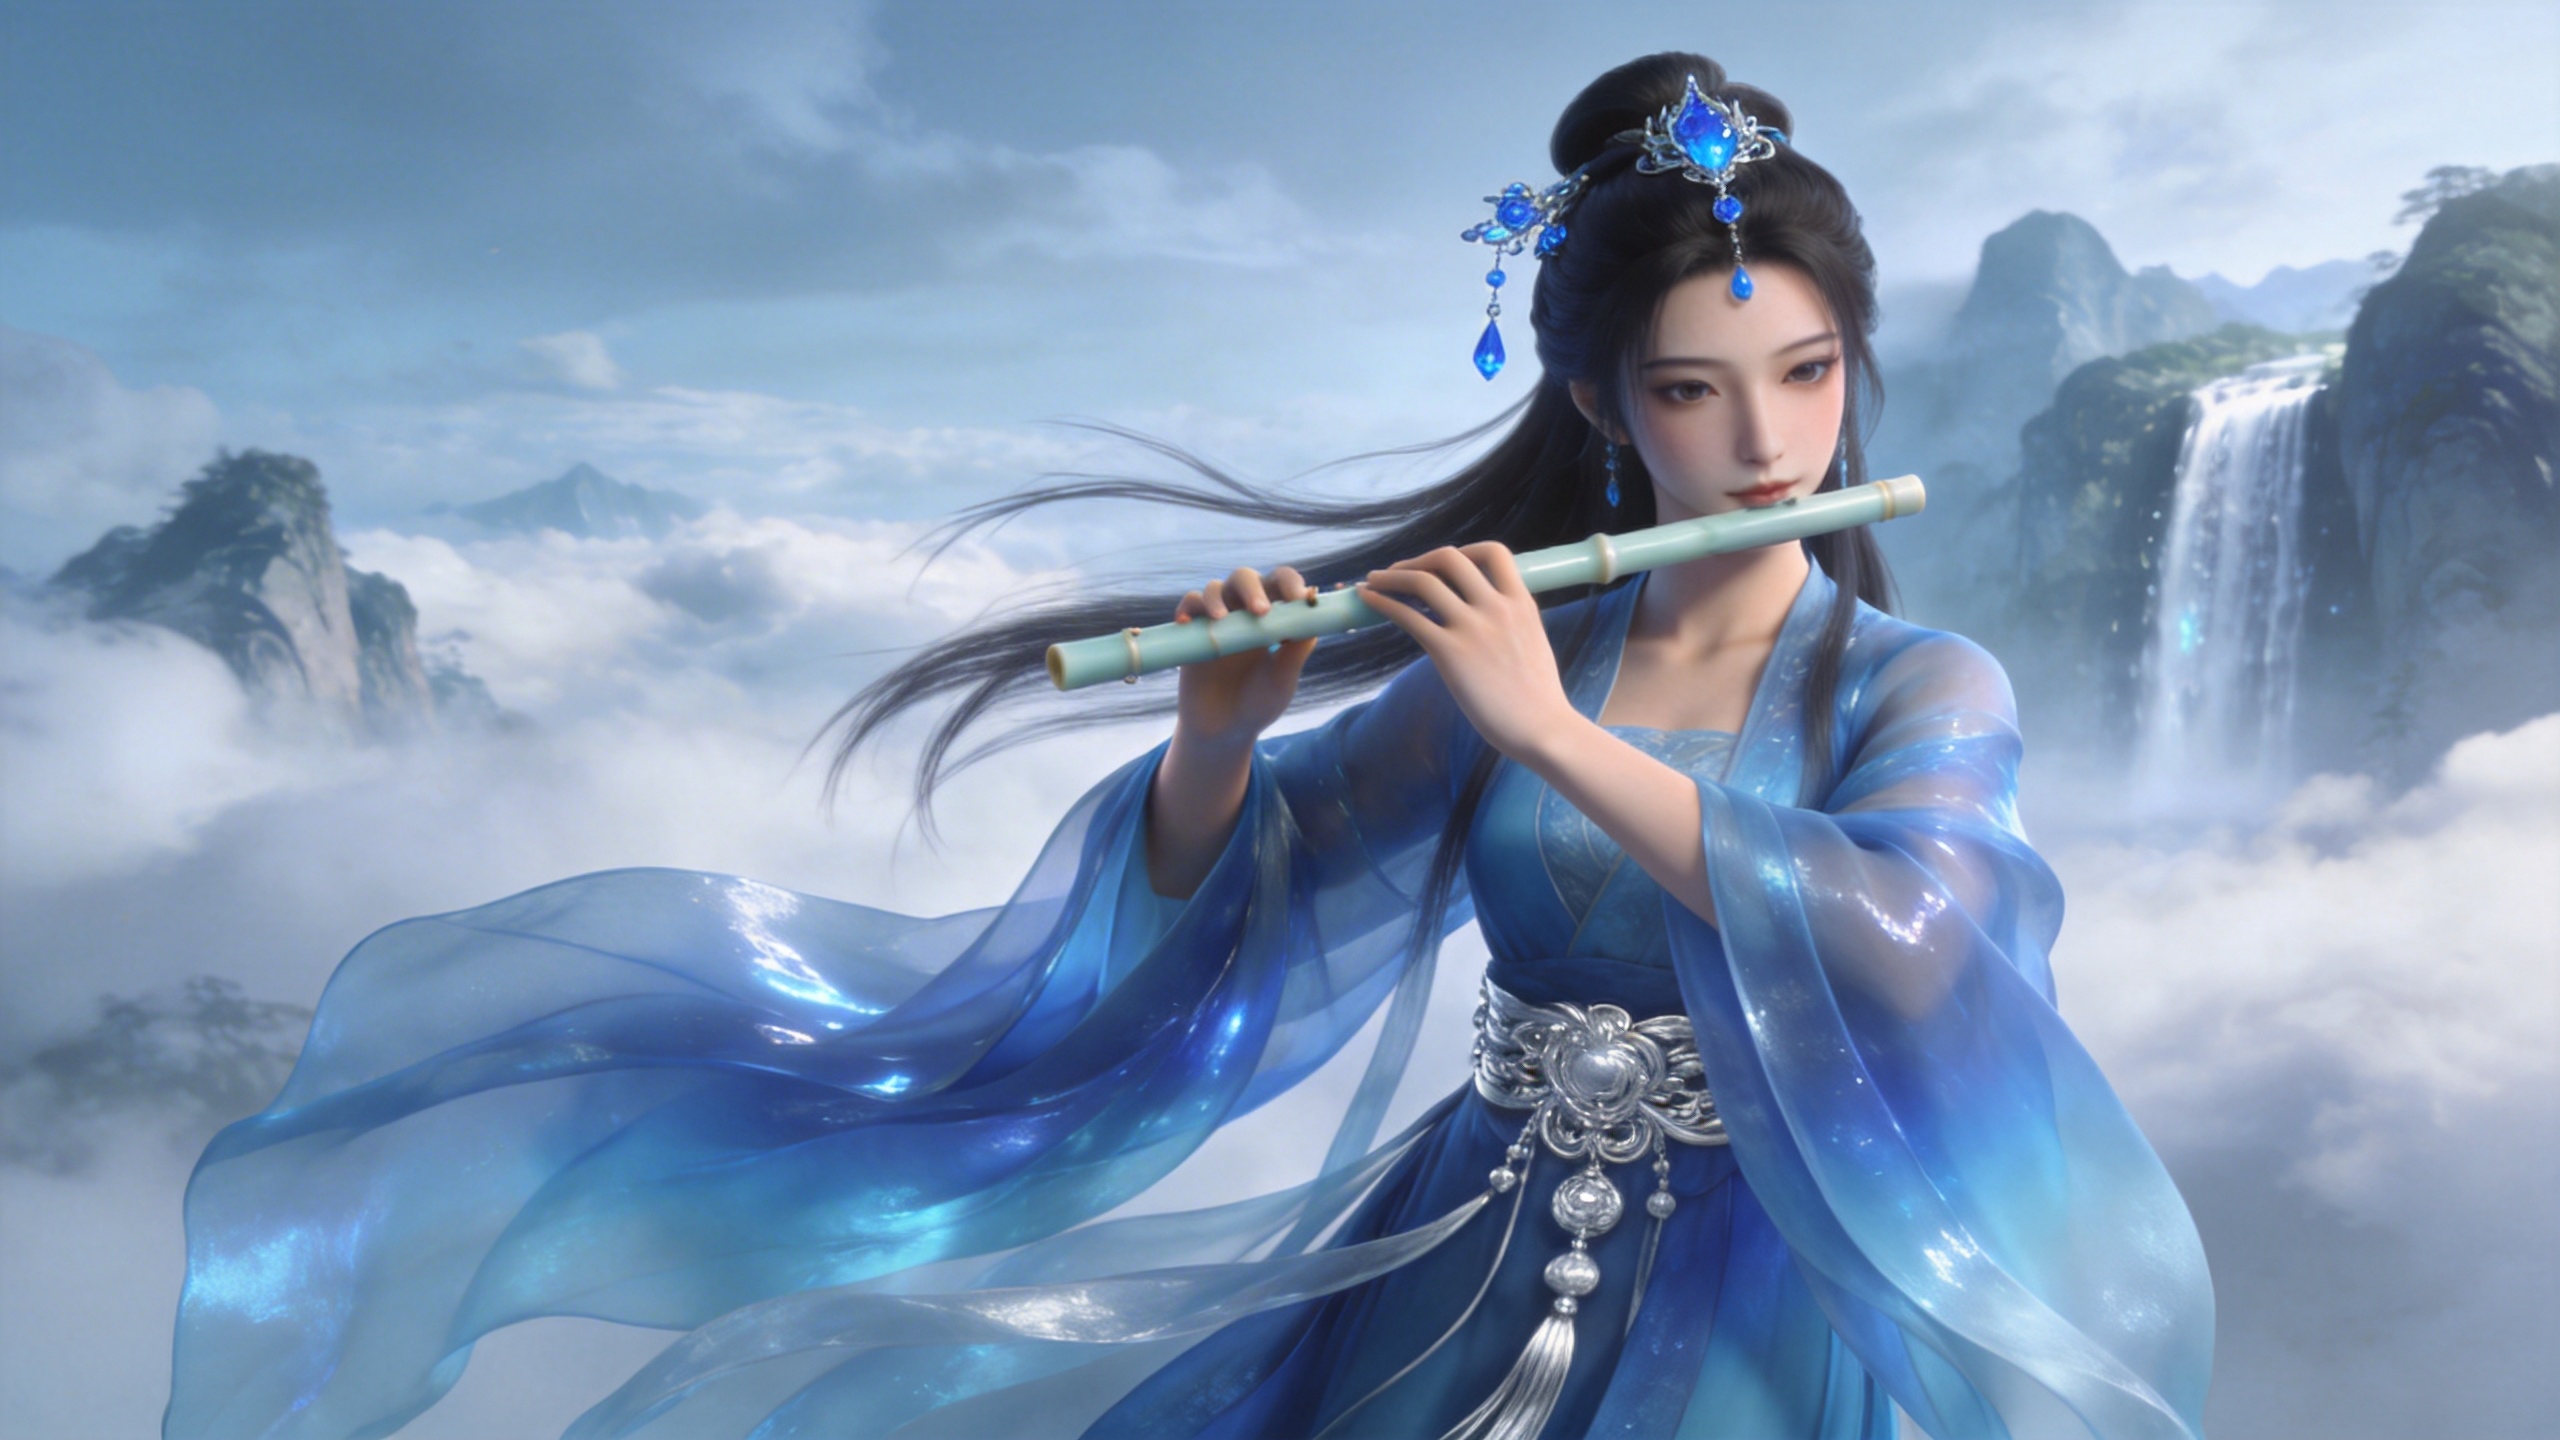
▲ 图片 1
[提示词]
参考视频1的金色粒子特效,让图片2中的人物吹笛子的同时,身边环绕一样的粒子特效。
玩法特效
[成品效果]
Replay
00:00
/
00:08
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
[参考素材]
Replay
00:00
/
00:00
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
▲ 视频 1
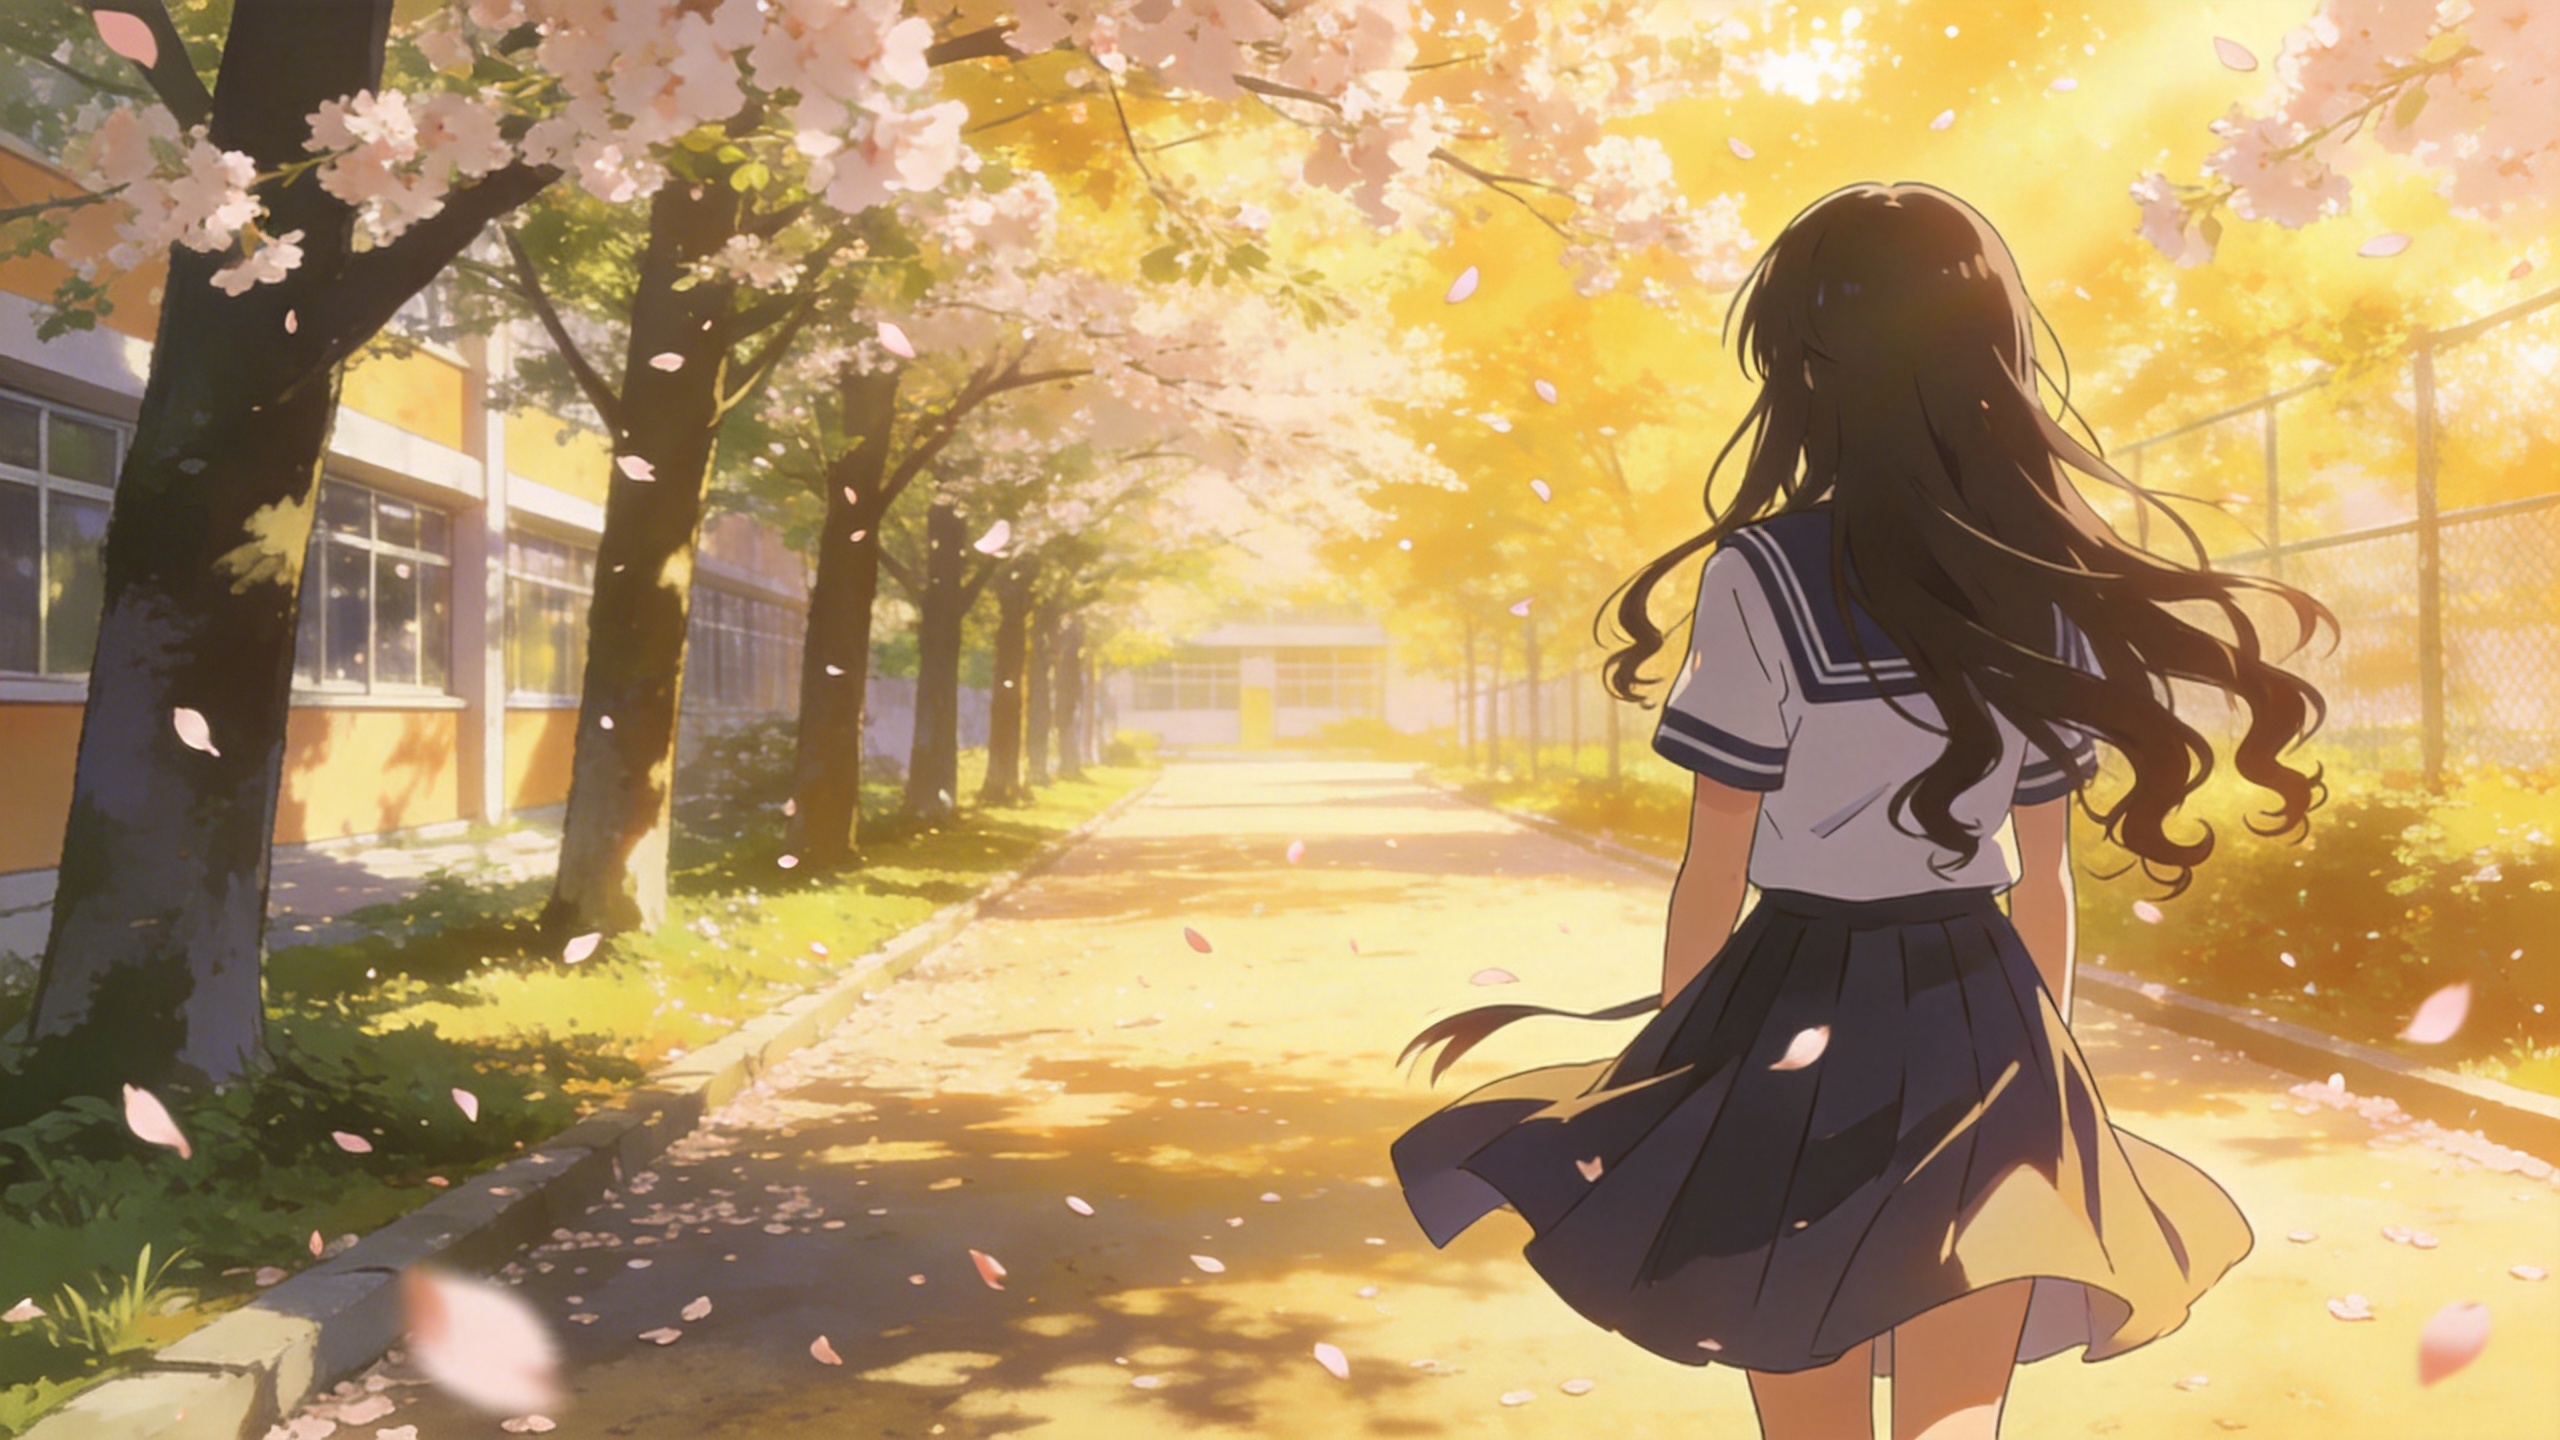
▲ 图片 1
[提示词]
参考视频1的特效,让图片1中的女生长出相同的翅膀,翅膀生成轨迹一致。
视频编辑
Seedance 2.0 系列模型支持视频编辑,支持增加、删除或修改元素,视频的向前或向后延长,以及轨道补齐。
使用过程中,如对视频顺序有要求,应按顺序上传,提示词中可使用视频1、视频2……视频n进行准确指代。
元素增删改
增加元素
[成品效果]
Replay
00:00
/
00:08
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
[参考素材]
Replay
00:00
/
00:08
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
▲ 视频 1
[提示词]
在视频1的台面上添加炸鸡、披萨等小吃。
删除元素
[成品效果]
Replay
00:00
/
00:12
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
[参考素材]
Replay
00:00
/
00:12
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
▲ 视频 1
[提示词]
清除视频1桌面上的其他零件和工具,保持桌面整洁干净,桌面上只有他俩手里的。
修改元素
[成品效果]
Replay
00:00
/
00:06
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
[参考素材]
Replay
00:00
/
00:06
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
▲ 视频 1
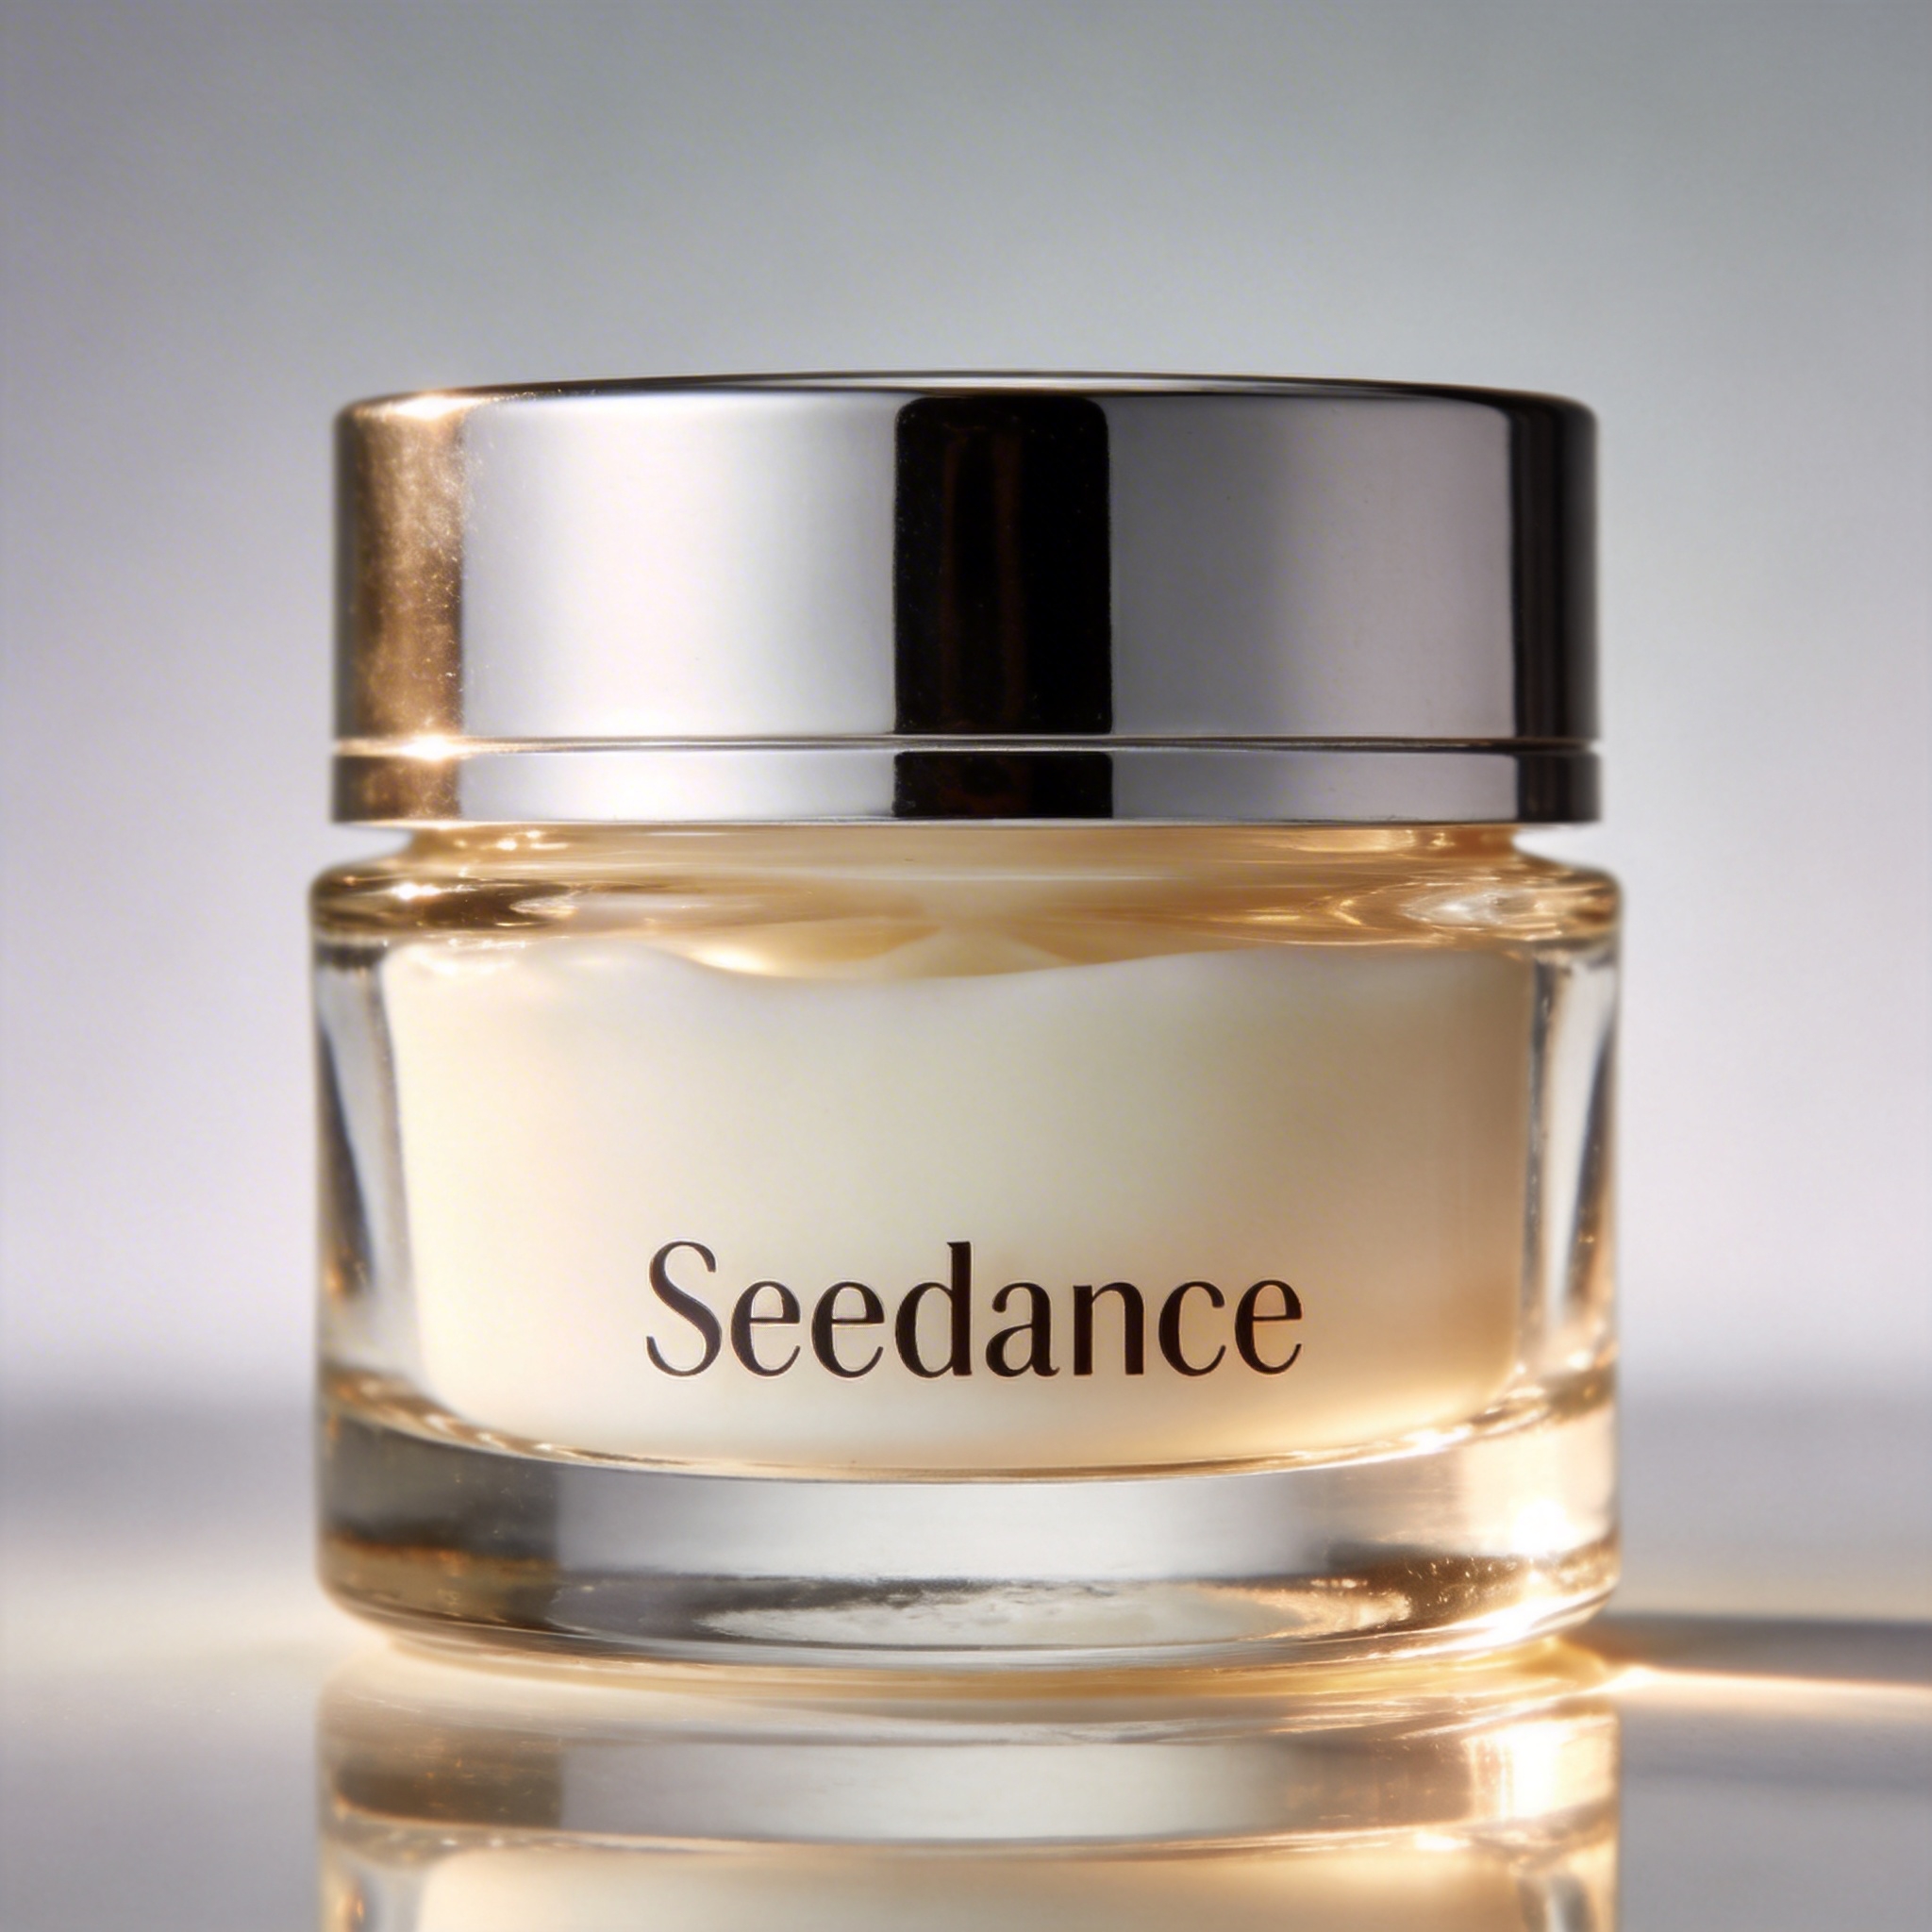
▲ 图片 1
[提示词]
将视频1中的香水替换成图片1中的面霜,动作和运镜不变。
视频延长
注意
模型将自动截取衔接部分进行合成,输入视频原有片段,不会重复生成。
向后延长
[成品效果]
Replay
00:00
/
00:13
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
[参考素材]
Replay
00:00
/
00:12
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
▲ 视频 1
[提示词]
生成视频1之后的内容,迟到的两个男士跑向他们,五个人终于见面,友好聊天。
向前延长
[成品效果]
Replay
00:00
/
00:08
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
[参考素材]
Replay
00:00
/
00:06
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
▲ 视频 1
[提示词]
向前延长视频1,给白衣男子过肩镜头,白衣男子说:“It’s not that bad. You're just stressed. Everyone goes through this, you just need to keep going.”
轨道补齐
说明
- Seedance 2.0 系列模型最多支持 3 段视频输入,总时长不得超过 15 秒。
- 生成时将自动截取首尾视频的衔接部分,仅保留必要片段参与合成。
参考案例:
[成品效果]
Replay
00:00
/
00:00
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
[提示词]
视频1,树叶落地的瞬间,激起金色粒子特效,一阵风吹过,接视频2。
[参考素材]
Replay
00:00
/
00:00
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
▲ 视频 1
Replay
00:00
/
00:00
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
▲ 视频 2
最近更新时间:2026.09.22 15:05:37
这个页面对您有帮助吗?
有用
有用
无用
无用