火山方舟
火山方舟


文档指南

请输入


- 文档首页
 火山方舟调用视频生成Doubao Seedance 2.5 提示词指南
 复制全文
 下载 pdf
Doubao Seedance 2.5 提示词指南
 文档反馈
 问问助手
本文介绍 Doubao Seedance 2.5(下文简称 Seedance 2.5)模型的提示词(Prompt)使用方法和相关技巧,帮助您更高效地利用该模型生成符合需求的优质视频作品。
获取 Skill
强烈推荐使用 Seedance 2.5 skill 对您的提示词进行调优。
- 在本地项目中通过 NPX 安装:
- npx --yes skills@latest add \"https://arkdocs.tos-cn-beijing.volces.com/skills/" \--skill sd25-pe \--yes
- 使用方式:在 AI 对话框输入 /sd25-pe + 你的提示词内容,开始调试提示词。
总体介绍
Seedance 2.5 模型支持单段 30 秒视频直出,单次可输入图像/音频/视频最多 50 个参考素材,具备更强的指令控制,专业级可控的视频编辑与延长能力;同时,原生支持生成 10 余种语言,保障专业级叙事在全球化场景中稳定落地,让视频生成迈入「长叙事 × 强参考 × 准编辑 × 多语言」的工业级新阶段。
模型创作能力持续深化,画面真实感显著增强,在光影表现、表演理解与执行、镜头运动上都更接近真实拍摄,成片质感与叙事可信度大幅提升,为专业创作者与企业客户提供更高效、更可控的视频生产能力。
全模态典型能力清单
Seedance 2.5 支持文本、图片、视频和音频等全模态输入的灵活组合。下表仅列举部分典型能力,更多使用方式可根据实际场景进行探索。
任务类型 | Seedance 2.5 支持的 R2V 能力/任务 | 能力细化说明 |
参考生视频 | 主体参考 - 参考人/物/场景/虚拟角色等主体的外观 ID/声音 |
|
| 运动参考 - 参考图/视频的运动/动态信息 |
|
| 白模参考/渲染 - 输入粗粒度或者细粒度白模视频参考其动态信息、进行渲染 |
|
| 风格参考 - 参考图/视频的风格 |
|
| 音频参考 - 参考音频的音乐/台词/音色等声音信息 |
|
| 宫格分镜/故事板参考 - 参考分镜图的主体/构图/动作/剧情等信息 |
|
| 关键帧参考 - 输入单/多个图作为关键帧生成视频 |
|
首尾帧生视频 | 首帧/首尾帧生视频 - 输入首帧一张图/首尾帧两张图生成视频 | 严格通过 content.role = first_frame/last_frame 来控制 |
编辑视频 | 视频指令编辑 - 通过文本对视频画面进行增删改编辑,支持输入时间戳指定编辑生效时段 |
|
| 视频参考图编辑 - 通过文本+参考图对视频画面进行增删改编辑,支持输入时间戳指定编辑生效时段 | |
| 视频音频编辑 - 对视频声音进行增删改 |
|
延长视频 | 视频延长 - 向前/向后延续输入的视频,可要求画面/音频无缝衔接 |
|
其他 | 一键成片 - 输入多个图/视频生成短片,可添加文字/贴纸/转场/等 |
|
| 视频无缝转场 - 输入两段视频,模型生成补全间隙实现无缝转场 | - |
| 组合能力 - 上述提及能力的自由组合应用 | - |
任务使用说明
Seedance 2.5 从传入素材最终是否会锁定输出视频的属性,把任务区分为两类(Seedance 2.0 没有这个区分):
- 有锁定:素材会严格成为输出视频时间轴上的一段,是模型输出去适应传入的素材,因此会锁定输出视频的宽高比、甚至时长。
- 无锁定:仅对素材进行语义上的参考,因此用户可以指定输出视频的宽高/时长属性。
有锁定:编辑/首尾帧/延长
编辑/首尾帧/延长会根据输入素材自动锁定部分生成参数,不支持用户自定义。具体规则如下:
无锁定:参考任务/多宫格分镜/关键帧
参考类任务对于输出视频的宽高比和时长没有来自输入素材的锁定,特别注意以下两类任务也是没有锁定的:
R2V 能力 | 推理策略说明 | 示意图 | | |
多宫格分镜/故事板 |
|  | | |
关键帧 |
|    | 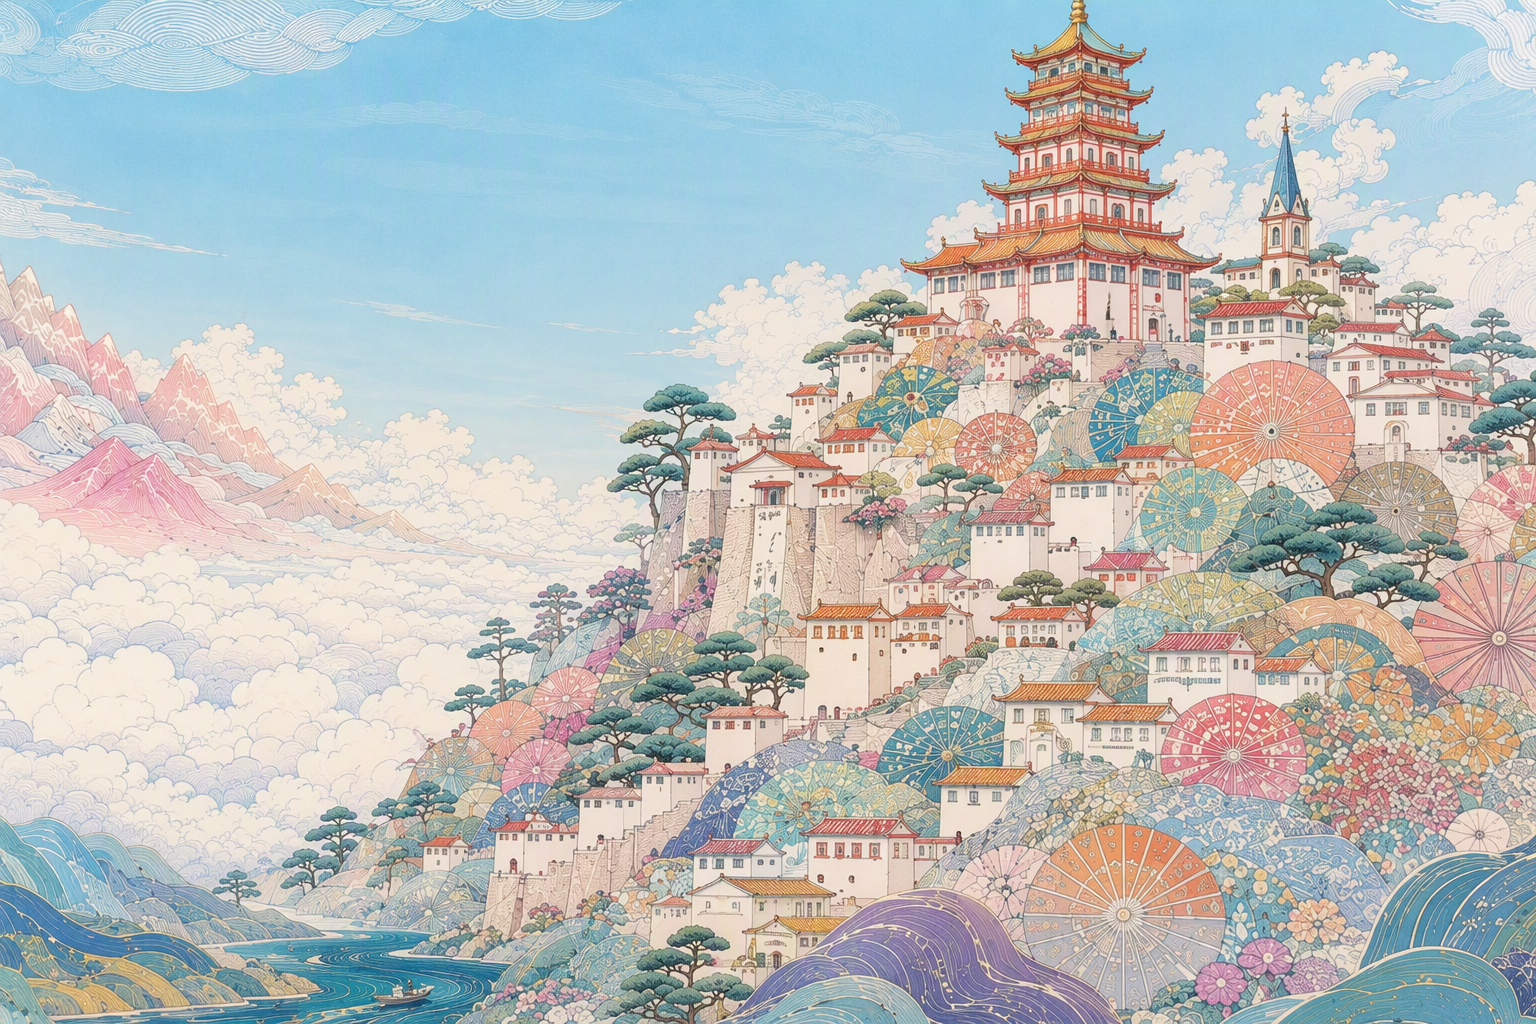 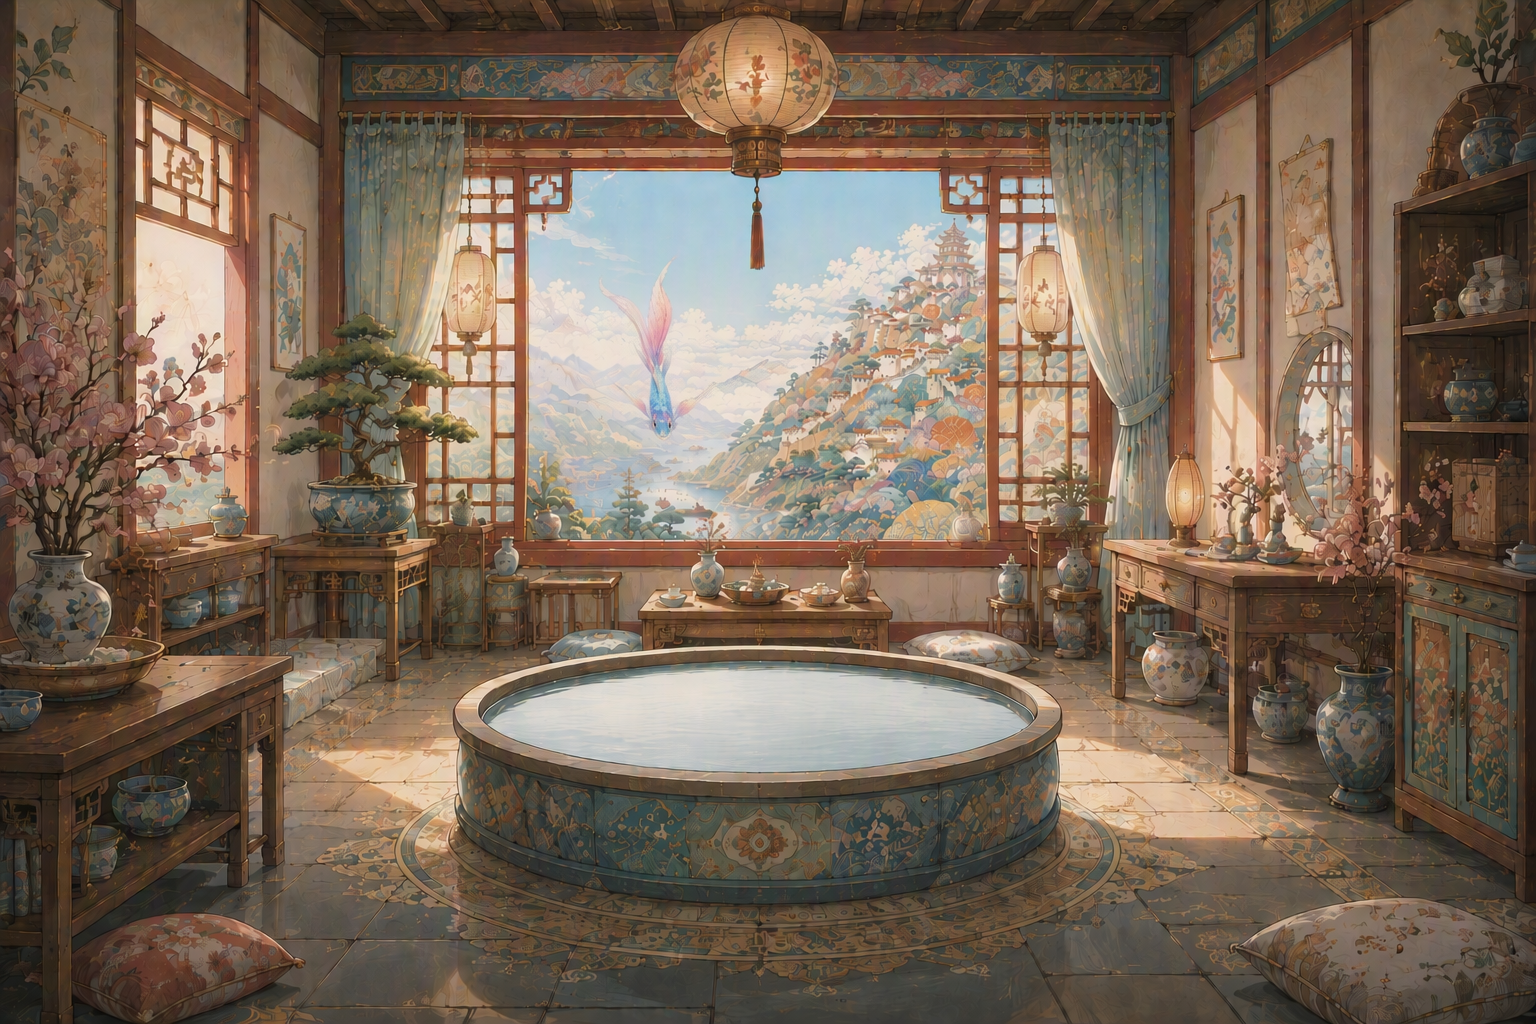 | 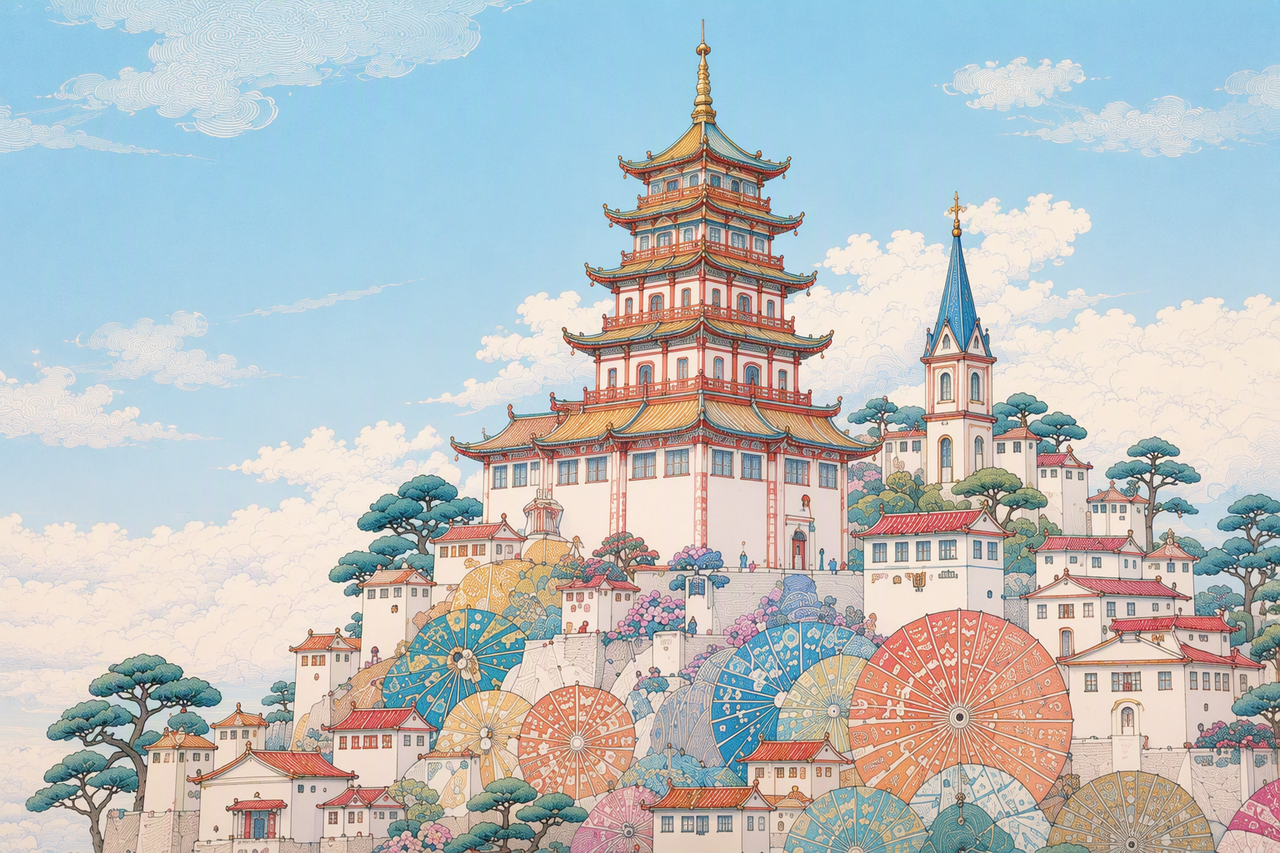 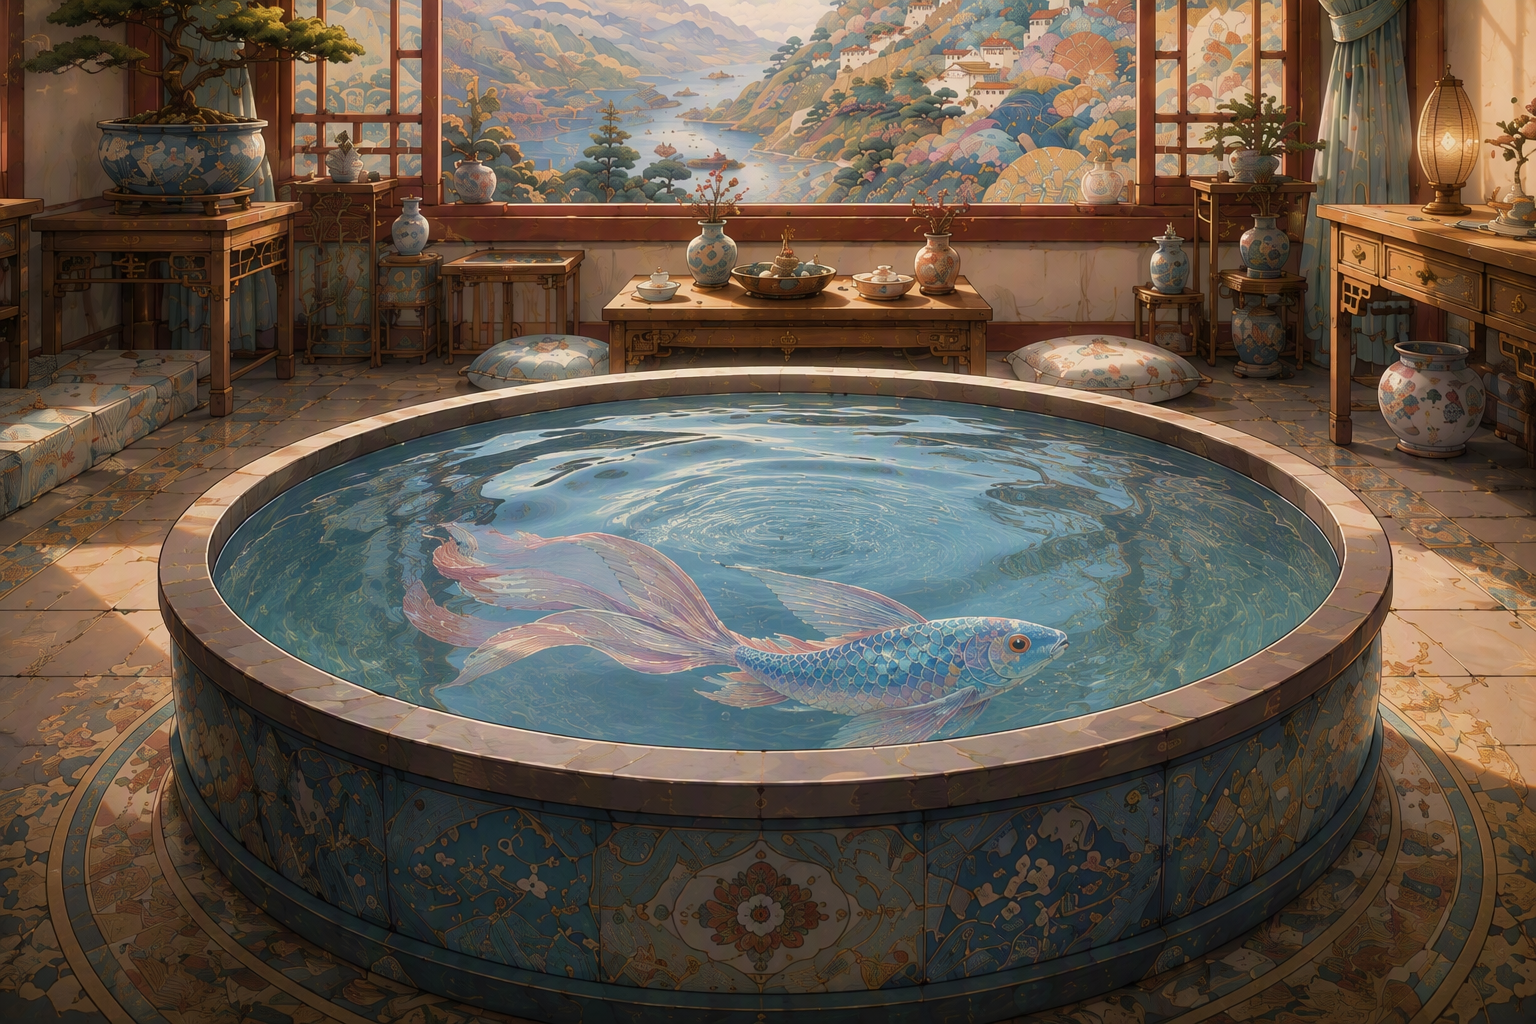 |
素材输入建议
Seedance 2.5 单次可输入图像/音频/视频最多 50 个参考素材,这些素材可能指向的是同一个或者不同的主体(人物、动物、道具、场所等)。为了充分激发模型的能力,对素材的输入有以下建议:
场景 | 输入建议 |
输入素材总上限 |
|
主体音视频,建议输入多少个主体 | 1-5 主体效果较好;更多可尝试 6-10 主体,但稳定性下降、可能需要抽卡 |
主体音视频,建议输入多长时间 | 5-10s 时长效果较好;更长时长稳定性下降、可能需要抽卡 |
主体图,建议输入多少个主体 | 1-8 主体效果较好;更多可尝试 9-12 主体,但稳定性下降、可能需要抽卡 |
不同视角主体图的输入效果差异 |
|
宫格图参考,建议输入多少个分镜 |
|
白模参考,建议粗粒度还是细粒度 | 简单建模(粗粒度)参考效果较好,建议仅用简单几何体拼接表示人物/物体/动物等 |
视频编辑,建议输入多长的视频 | 20s 以内效果较好;更长时长稳定性下降、可能需要抽卡 |
视频参考图编辑,建议输入多少张图 | 1-5 张参考图效果较好;更多可尝试 6-8 张,但稳定性下降、可能需要抽卡 |
视频延长,建议的格式 | 为获得最佳的声画衔接效果,输入视频、输出视频均采用 mov 格式 |
提示词写作建议
把 Seedance 2.5 当作一个视觉内容生产者,用导演的思维书写 [ 结构化 Prompt ]。
基础写作
(R2V)素材指代
明确每个图/视频/音频的编号(按照上传顺序)与用途(谁是形象、谁是音色、谁是动作、谁是场景...)。
一句话概述
主体 + 地点 + 事件 + 题材/风格 + 特殊运镜...
具体情节描述
镜头顺序/时间轴(均可):用时间戳或「镜头 N」切分,逐段描述画面具体内容、运镜、动作、台词、音效等,尽量使用正向描述。
反向描述支持:字幕、音频控制,比如「不要字幕」、「不要 bgm」。
结尾
补充说明一些贯穿始终的画面细节,比如机位/运镜,环境/场景,声音,氛围等。
写实自然纪录片风格,电影级真实光影,温暖的午后, 在森林草坡上, 一只圆滚滚的熊猫幼崽从坡上滚下来.
熊猫黑白毛发蓬松真实,体型小而胖,动作笨拙可爱。场景为绿色森林斜坡,地面覆盖青草、苔藓、三叶草、泥土、小石块、枯枝和少量小黄花,虚化背景中有高大树干与树林。镜头为低机位中远景,轻微手持感,整体基本固定,始终保持熊猫在画面中。
0s-3s:一只熊猫幼崽趴在绿色草坡上,身体圆滚滚, 它刚开始顺着斜坡慢慢侧滚,动作笨拙,草叶被身体轻轻压弯。微风拂过, 阳光从左上方穿过树林,形成斑驳光影。
3s-8s:熊猫滚到画面右下方,动作逐渐停止,从侧躺变成趴卧。它的圆脸朝向镜头,前爪压在草地上,熊猫趴在前景草丛中,身体调整到舒服的姿势,头部小幅抬起又放低, 发出轻微哼唧声。
低机位,轻微手持感,轻微跟随熊猫向右下方移动。景深自然,前景草叶轻微虚化,熊猫主体清晰,背景树林柔和虚化。自然环境音,风声、熊猫滚动时轻微柔软的扑通声, 整体温暖、真实、自然。
Replay
00:00
/
00:00
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
参考类(多素材映射)
参考素材变多后,素材的映射和指代关系说明非常重要。按照上传素材的顺序对应编号(图 1 / 视频 1 / 音频 1),每个素材进行文本绑定,不建议只在图片里呈现映射信息,比如主角图片上写「张三」,然后 Prompt 中直接写「张三在学校里 xxxx」,容易导致多人混淆或重复角色。
- 多主体逐一列清映射关系,人数多时用清单罗列,避免混淆。
- 示例 1:「图 1 的侠客」
- 示例 2:「img1-2 是人物 1,对应音频 1;img3-4 是人物 2,对应音频 2」
- 示例 3:「图片 1 是主角张三,图片 1 使用音频 1 音色」
- 分工要具体到「参考什么」,如果是部分参考,要写明「参考哪一部分」。
- 示例 1:「参考视频 1 中施法的动作,视频 2 的环绕式运镜」
- 示例 2:「参考图片 1 的光影和滤镜」
- 当参考素材本身已足够精准时,建议只做「指代」、减少画面复述。
- 示例:「严格参考视频 1 的动作与运镜,顺序与视频保持一致」(不需要在 prompt 中写「先抬手、再转身、镜头缓慢环绕……」等等具体细节,不必额外描述)
编辑类
明确需要修改的范围和内容,可以配合时间戳进行部分编辑,尽可能说明修改内容从 A->B 的过程。
- 示例 1:「仅编辑视频 1 中男人的台词,修改为「你不要过来啊」,口音调整为东北口音…」
- 示例 2:「把视频 1 中 4-6 秒男人喝咖啡的动作改变为拖地,其余内容不要变化」
- 示例 3:「编辑任务:把视频 1 中右侧的亚洲女生改为图片 1 中的黑人女生」
首尾帧
- 优先使用参数设置图片的role为:first_frame/last_frame; 注意此方式会锁定输出视频的宽高比,严格对齐用户输入视频的首帧图。
- 也支持设置 role 为 reference_image,在 prompt 中指定具体图片为首帧&尾帧。注意此方式不会锁定输出视频的宽高比,视频效果与首帧&尾帧参考图相近,但不完全匹配。
- 示例 1:「图片 1 为首帧」
- 示例 2:「图片 3 为首帧,图片 5 为尾帧」
时间戳
时间戳可以更好地理清故事剧情发展,以「1 秒」为单位:
- 指定时间段内剧情如果较少,模型会进行一定自由发挥。
- 指定时间段内容过多,则会导致过度剪切或剧情遗漏,请注意时长安排的合理性。
- 不建议用时间戳控制频率/频次,比如「一秒摇头 3 次」。
支持的时间控制方式:
- 明确的时间区间 [注意时间轴的连续性,避免出现「0-3 秒...5-6 秒...」表达]。
- 示例 1:「0-3 秒......3-7 秒.....7-15 秒」
- 示例 2:「[1s-4s]....[4s-8s]....[8s-12s]」
- 时间点控制。
- 示例 1:「第 5s 快速向左横移转场」
- 示例 2:「第 2 秒一道金雷能量自画面顶部破空直落...」
- 相对时间控制。
- 示例 1:「张三呆滞的站在原地,3 秒后周围的人纷纷摇头」
- 示例 2:「....主角按下快门后画面定格 1 秒」
负向控制
- 支持负向控制字幕。
- 示例 1:「不额外加入对白字幕」
- 示例 2:「不要字幕」
- 支持负向控制音频:支持更细维度的单独控制:音效、背景音乐(bgm)、对白。
- 示例 1:「无 bgm,只生成环境音和动作音」
- 示例 2:「不要任何声音」
进阶写作
镜头语言
- 基础的通识性内容可以直接写,比如景别(大全景/全景/中景/近景/特写)、运镜(推/拉/摇/移/跟/环绕/俯冲/后拉/上摇/手持晃动)、机位(低角度/俯视/第一人称)。
- 热门的运镜方式可以直接写,比如一镜到底、希区柯克变焦、航拍视角、FPV、子弹时间、手持镜头、回弹变速等。
- 过于小众、专业的名词需要转换为 [名词 + 描述性解释]。
- 示例:「移焦,画面焦点发生平滑转变,原本在前景清晰的树木变模糊,背景中的人物由模糊逐渐变得清晰。」
- 转场镜头写清触发点与方式,尽可能把转场时间、方式都写明。
- 示例:「第 5s 快速向左横移转场(向左擦除+自然叠化)」
动作/表情描述
- 动作:优先用概括性描述(如「连续做了几组高抬腿和空翻」「双方展开近身搏斗」),只在少数有记忆点的动作上写出具体细节,不建议重复写相同的动作。
- 表情:建议写描述性语句,减少成语使用,比如「津津有味地吃饭」写为「脸上带着满足的笑容,大口地吃饭」。
白模参考/渲染
- 文本中写明希望参考白模视频中的什么元素。
- 示例 1:白模中没有光影变化,只希望参考运镜和运动 → 「参考 [视频 1] 的运镜、动作...」
- 示例 2:白模有光影变化且需要参考 → 「参考 [视频 1] 的光影变化和...」
- 如果叠加输入了参考图,需写明参考图和白模的对应关系。
- 示例:「将 [图片 1] 中穿灰色衣服的男人对应 [视频 1] 中的红色模型、[视频 2] 中的红发少女替换 [视频 1] 中的绿色模型 2」
- 输入了白模视频,也建议在 Prompt 中详细描述希望生成的视频内容,以获得更好的效果,并且注意文本描述需要和白模内容相吻合;对于没有叠加参考图/视频的白模主体,详细描述主体外表/特征效果更佳。
多宫格分镜/故事板
- 减少超多分镜输入:多宫格目前更适用于 15 个以下分镜,单次输入过多(比如 18 宫格)容易出现静止、顺序错乱等问题,同时分镜图会限制模型发挥,请确保分镜准确、合理。
- 避免脏/锐化的分镜图:不推荐过度锐化、杂乱的 AI 直出分镜图;不推荐在分镜图上写过多文字。
- 多宫格分镜 badcase 示例:
-
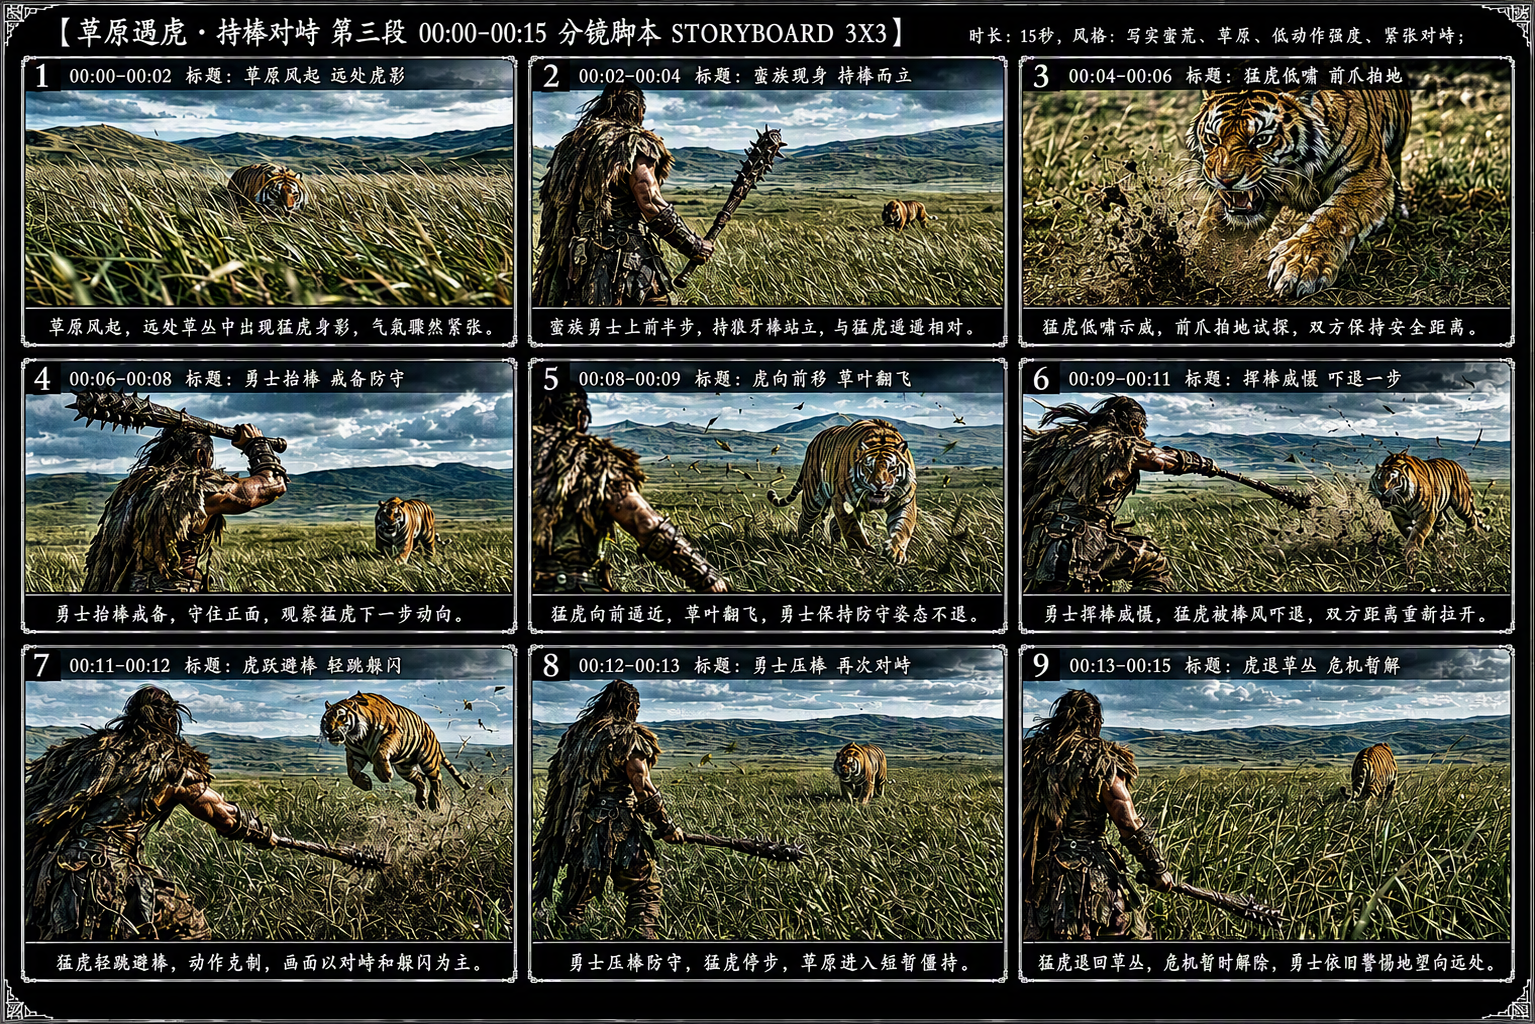
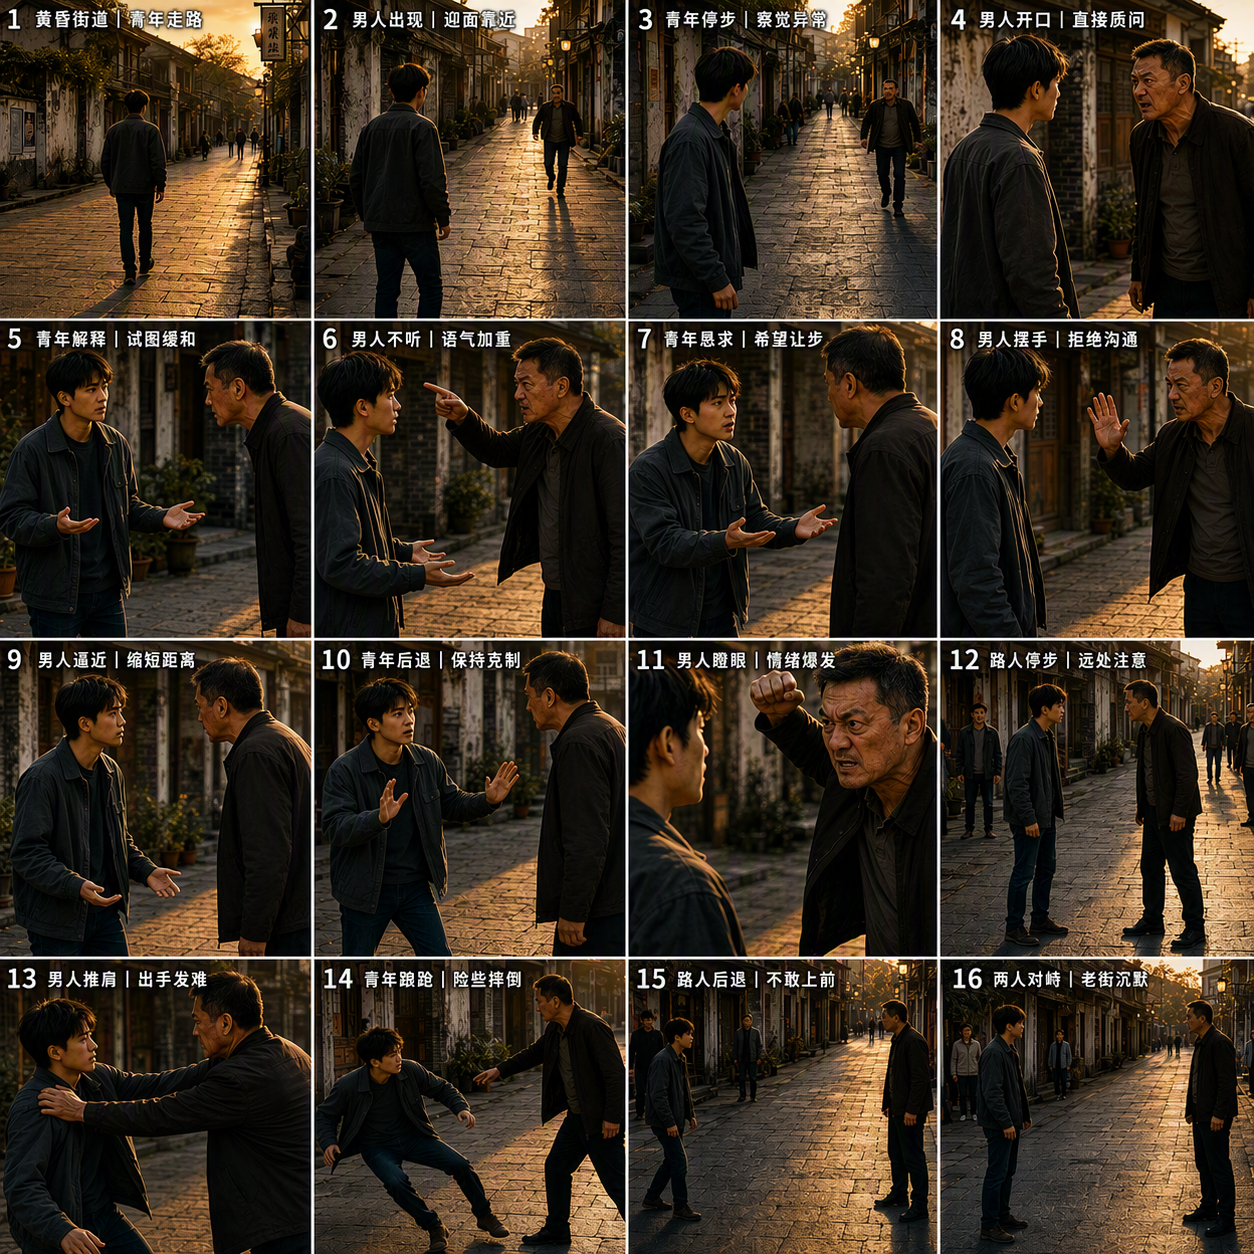
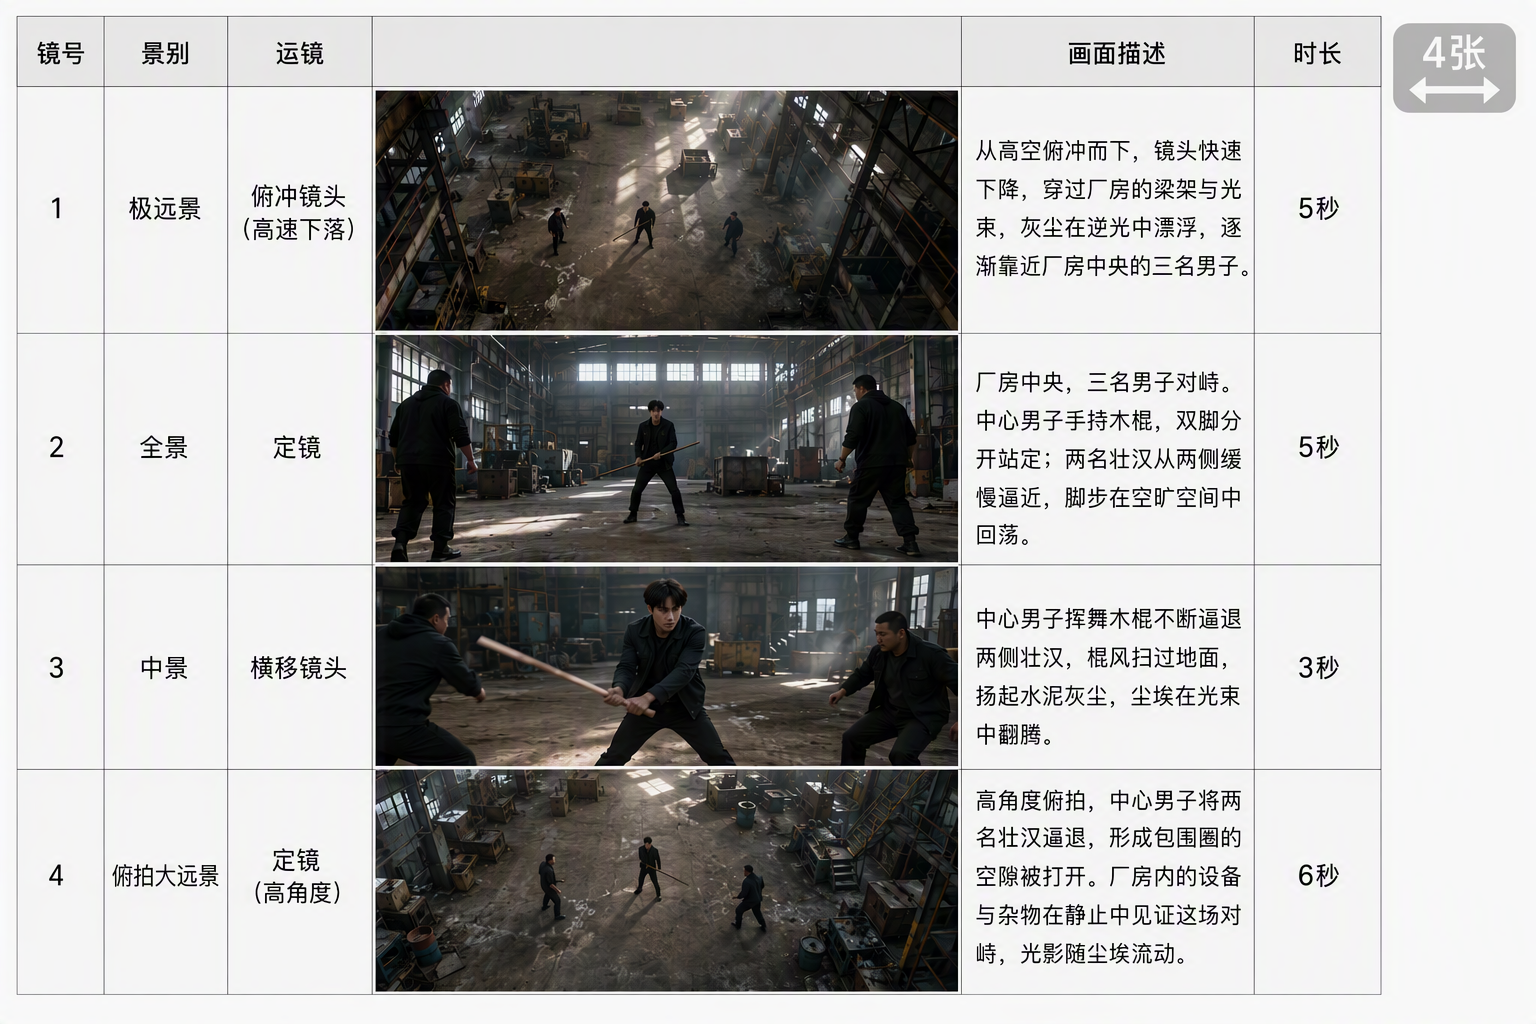
- prompt 避免前后矛盾:注意避免 prompt 前后矛盾或运镜、运动设计不合理等问题。
- 宫格图并不会严格对齐分镜内容,视频会有一定自主性发挥,如需严格按照分镜图生成时,推荐使用多关键帧参考方式。
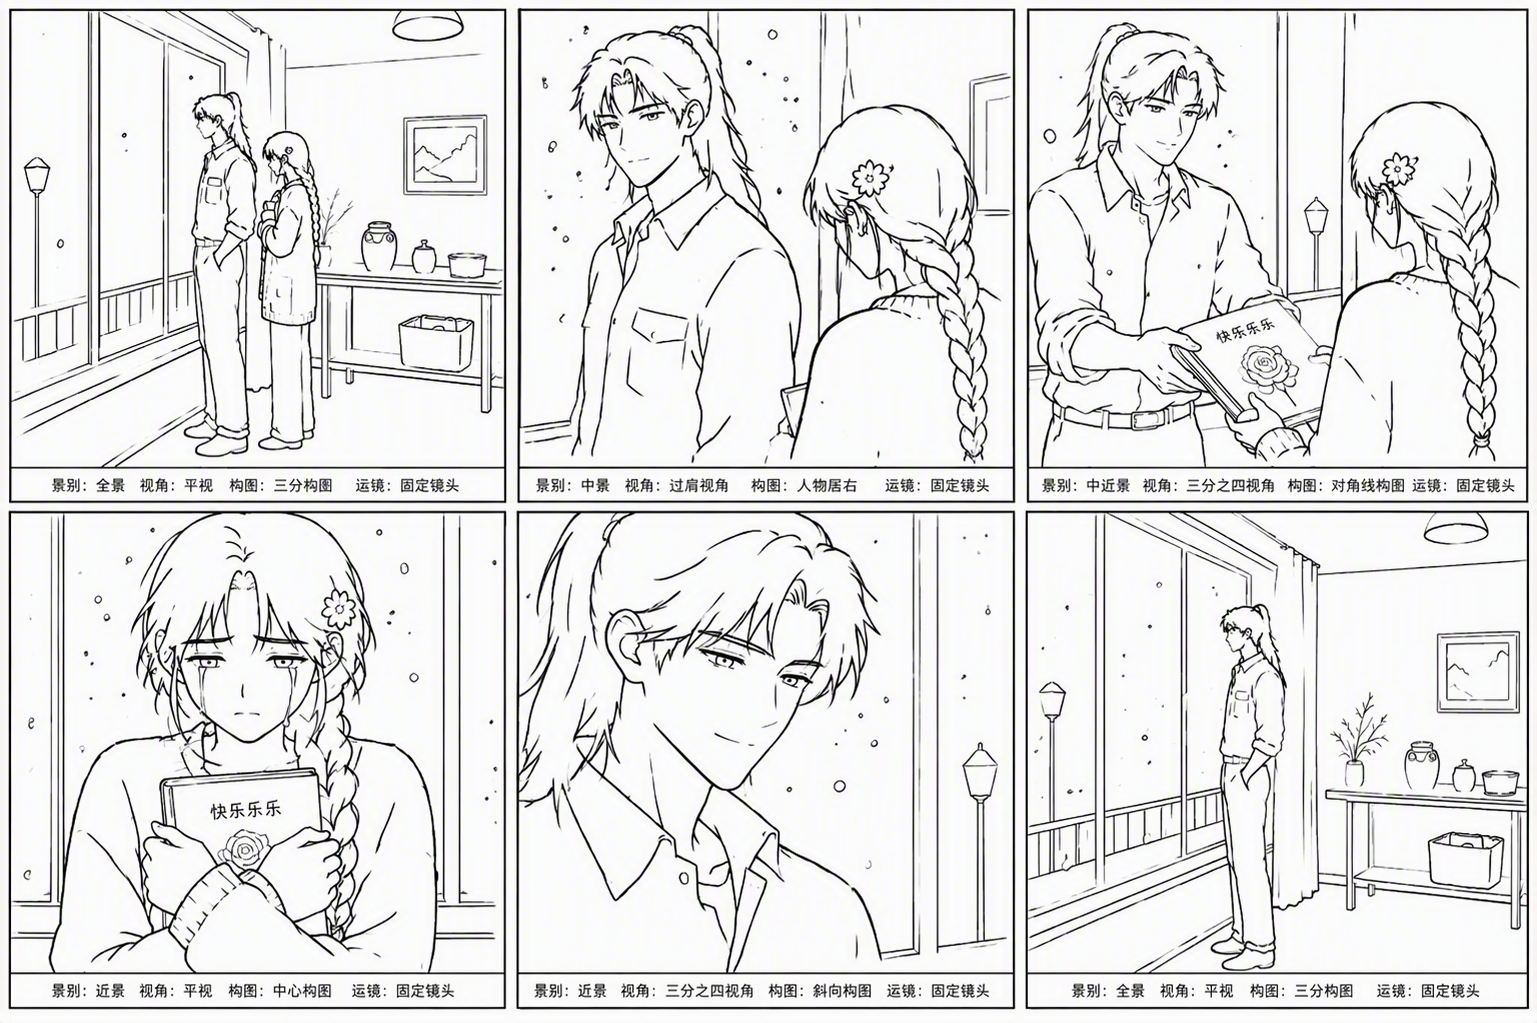
- 火柴人/线稿分镜使用 [推荐]:推荐使用相对简约的线稿分镜图,并通过 prompt 进行指令控制:
- step1:写明参考素材的指代关系
- step2:写整体故事梗概
- step3:按照分镜完整描述情节内容,至少补齐分镜图中没有的信息,可以考虑组合时间戳明确剧情逻辑
- 线稿分镜案例:
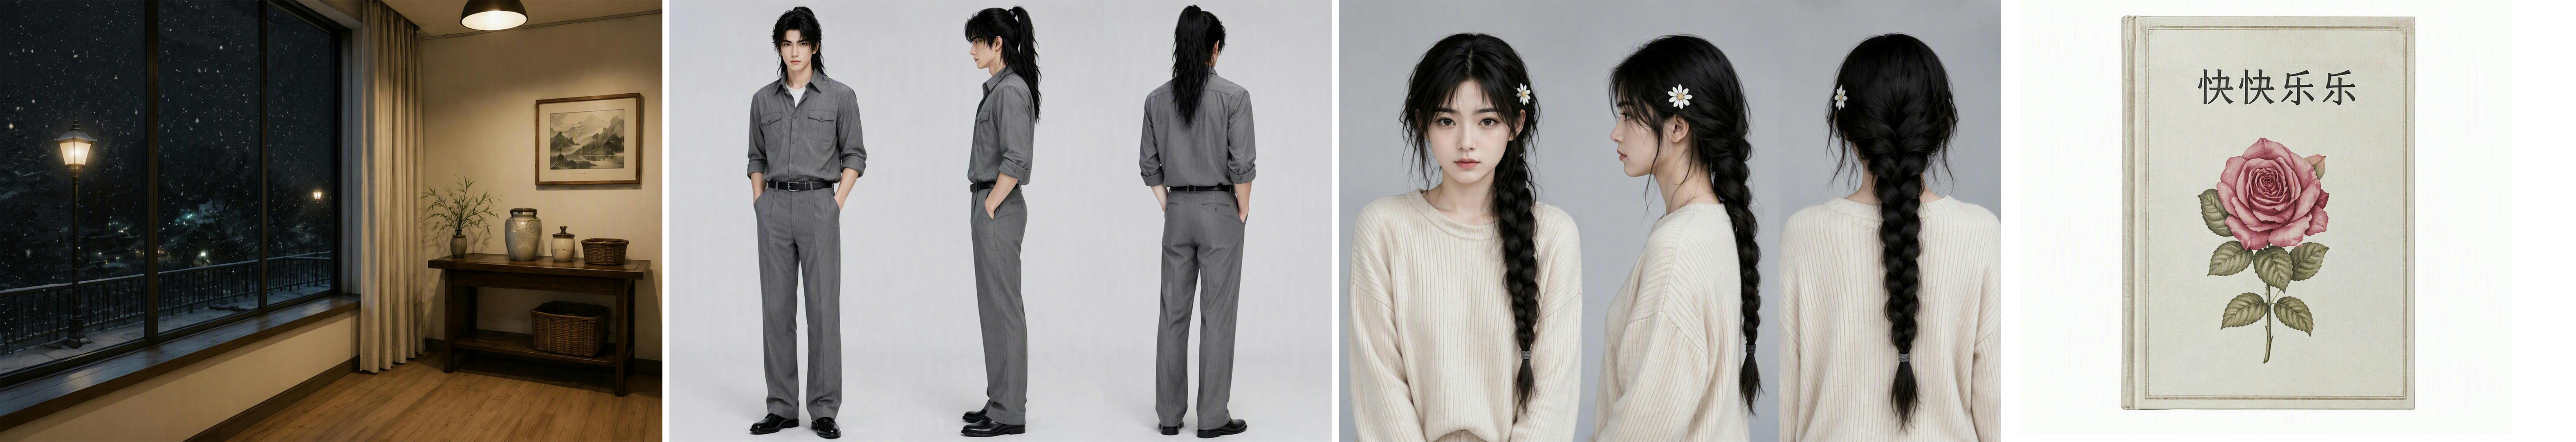
- 素材绑定:故事板分镜@图片1,卧室@图片2,李天@图片3,李倩@图片4,《快快乐乐》书籍@图片5。镜头一:【全景固定镜头,平视三分构图】冬夜落雪房间,落地窗前,男子双手插裤兜侧立望向窗外飞雪,少女站在身侧静静看向男子,氛围安静克制,雪花持续落在玻璃窗。镜头二:【中景过肩镜头】少女后背作为前景,男子转头温和看向少女,少女微微低头沉默,窗外落雪持续。镜头三:【中近景,对角线构图】男子捧着书籍《快快乐乐》缓缓递出,少女抬手接过书本。镜头四:【少女面部近景,中心构图】少女把书本抱紧在胸口,眼眶泛红,泪珠缓缓滑落,神色感伤。镜头五:【男子面部近景,斜向构图】男子温柔浅笑,静静注视落泪少女,眼底带着怅然。镜头六:【全景固定镜头】少女转身缓步走出画面,窗前只剩男子独自伫立,双手插兜望向漫天风雪,房间空旷寂静。
- 概念分镜使用:如果分镜是概念分镜或关键帧设计,可以直接简写 prompt。
- 示例:「按照分镜图的顺序,构建一个完整的故事剧情,运镜合理连贯」
-
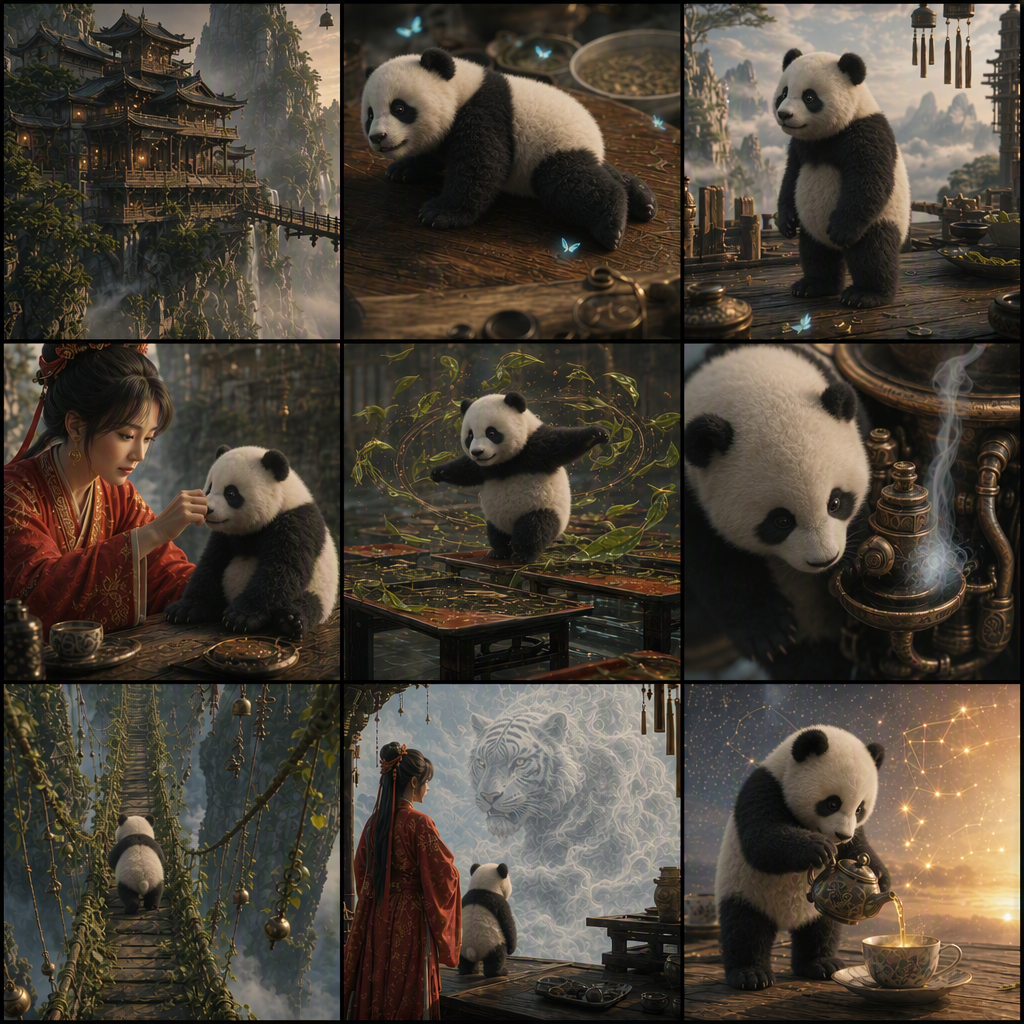
关键帧参考
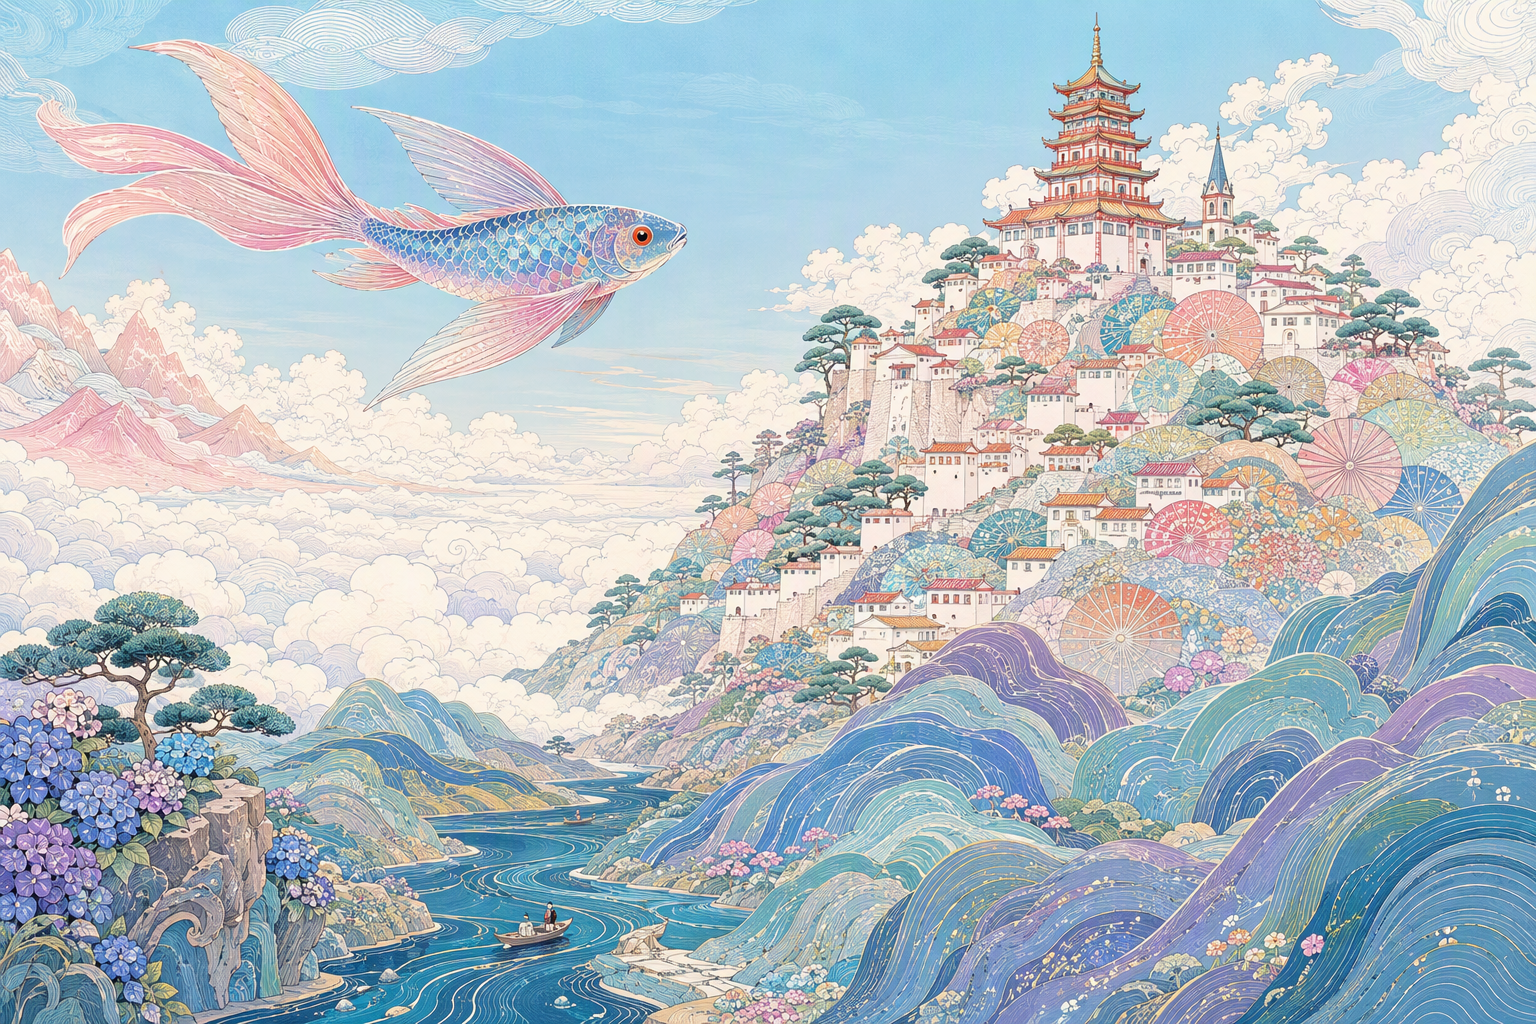
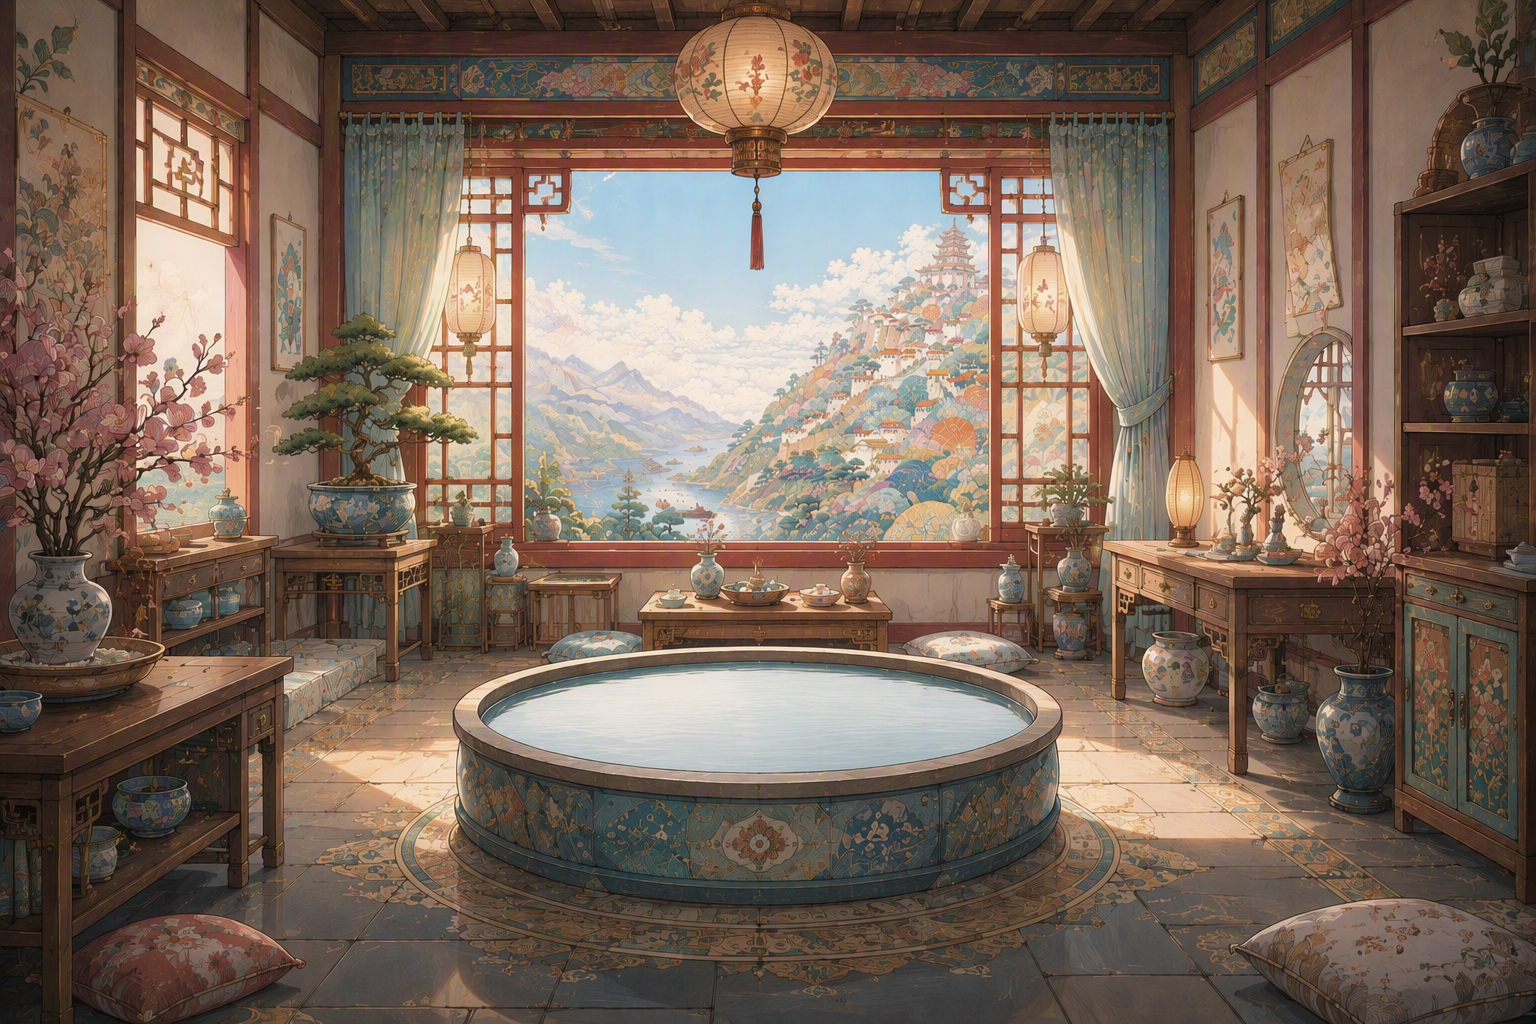
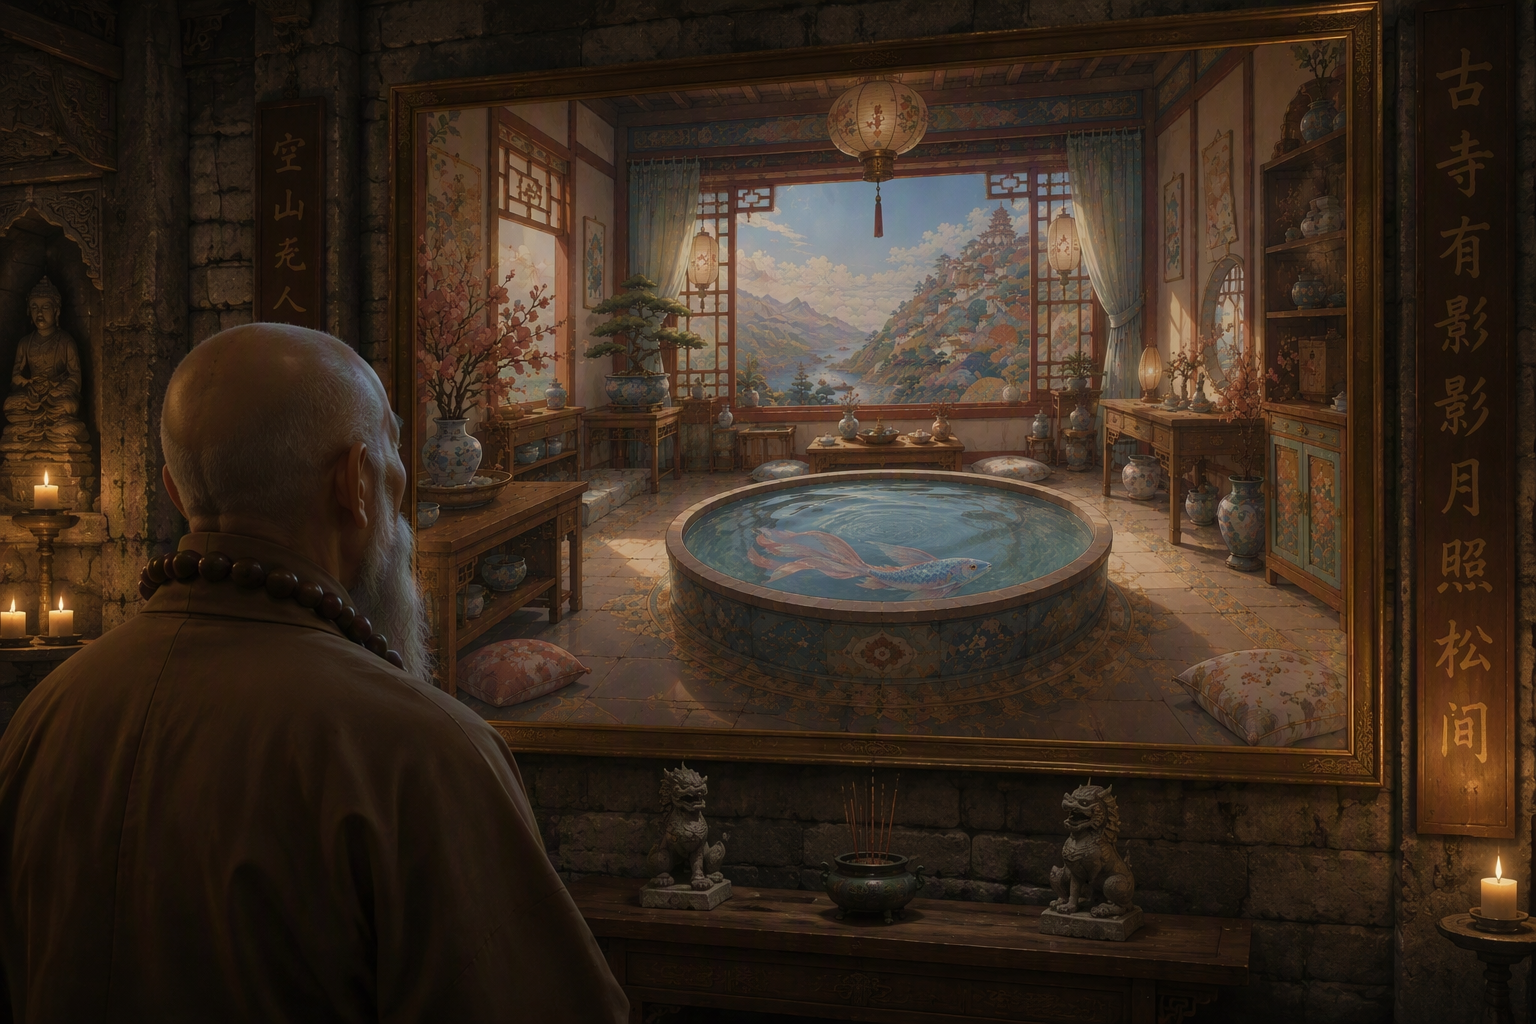
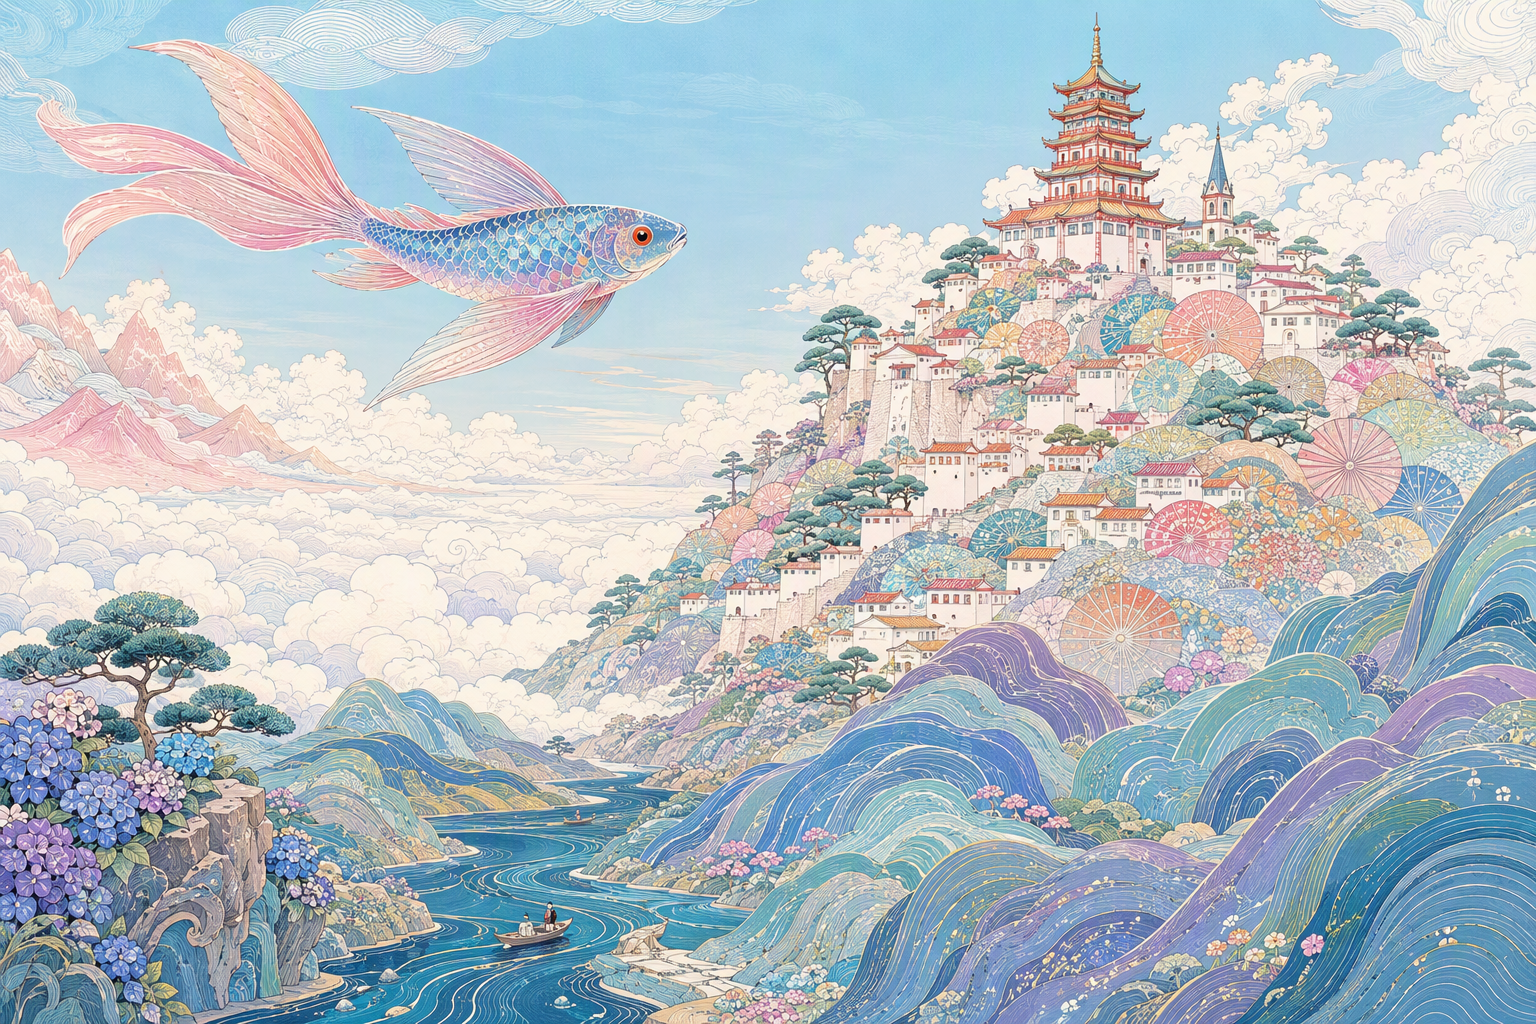
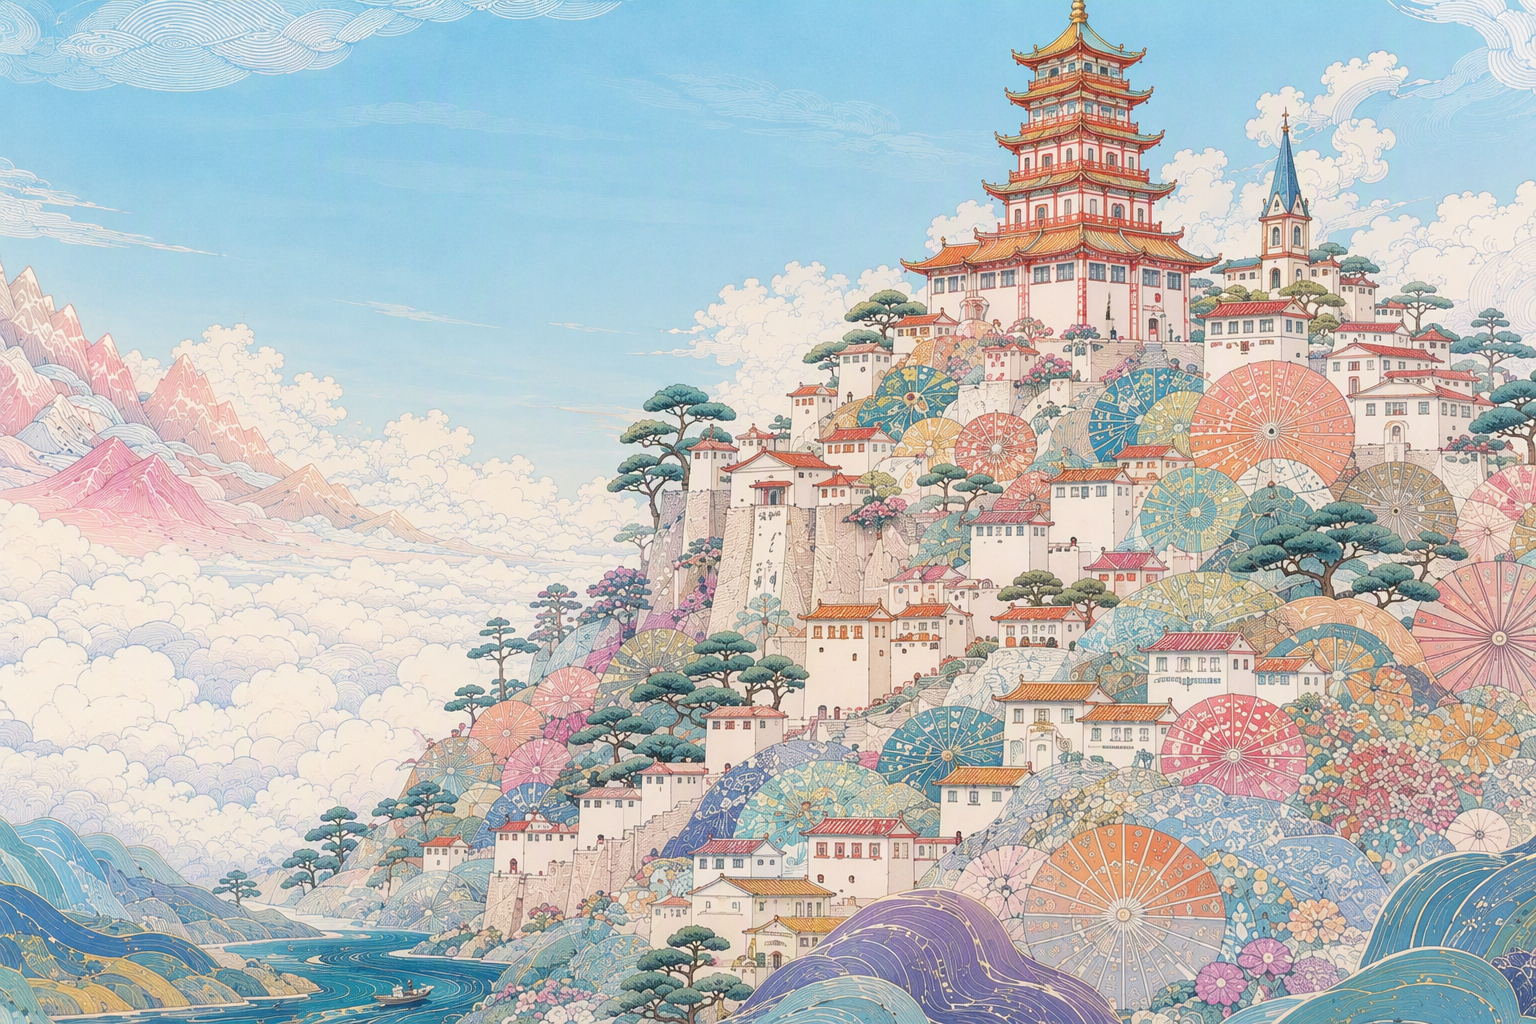
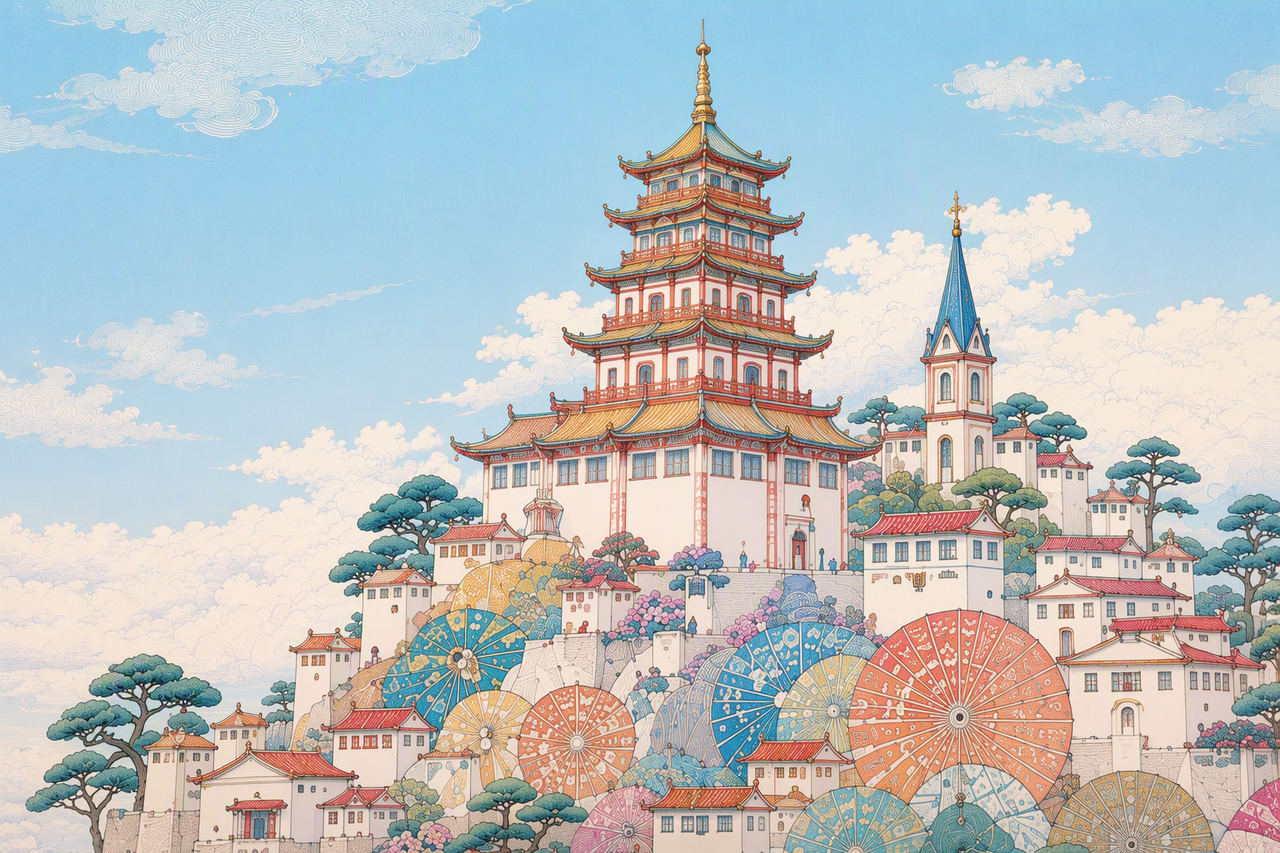
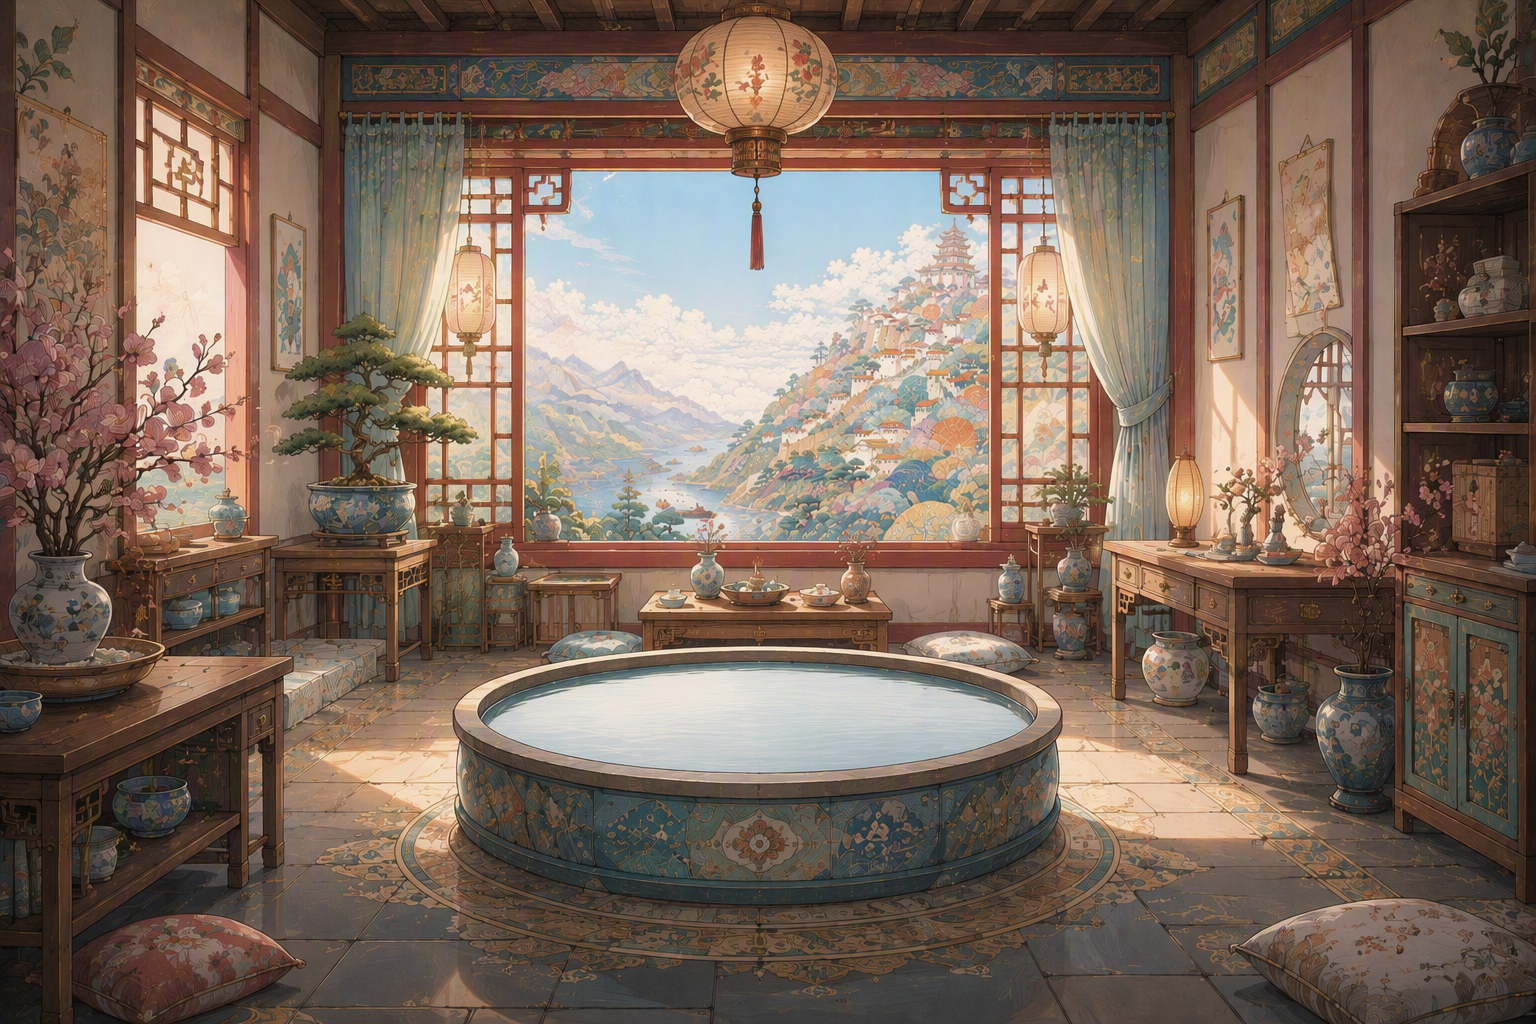
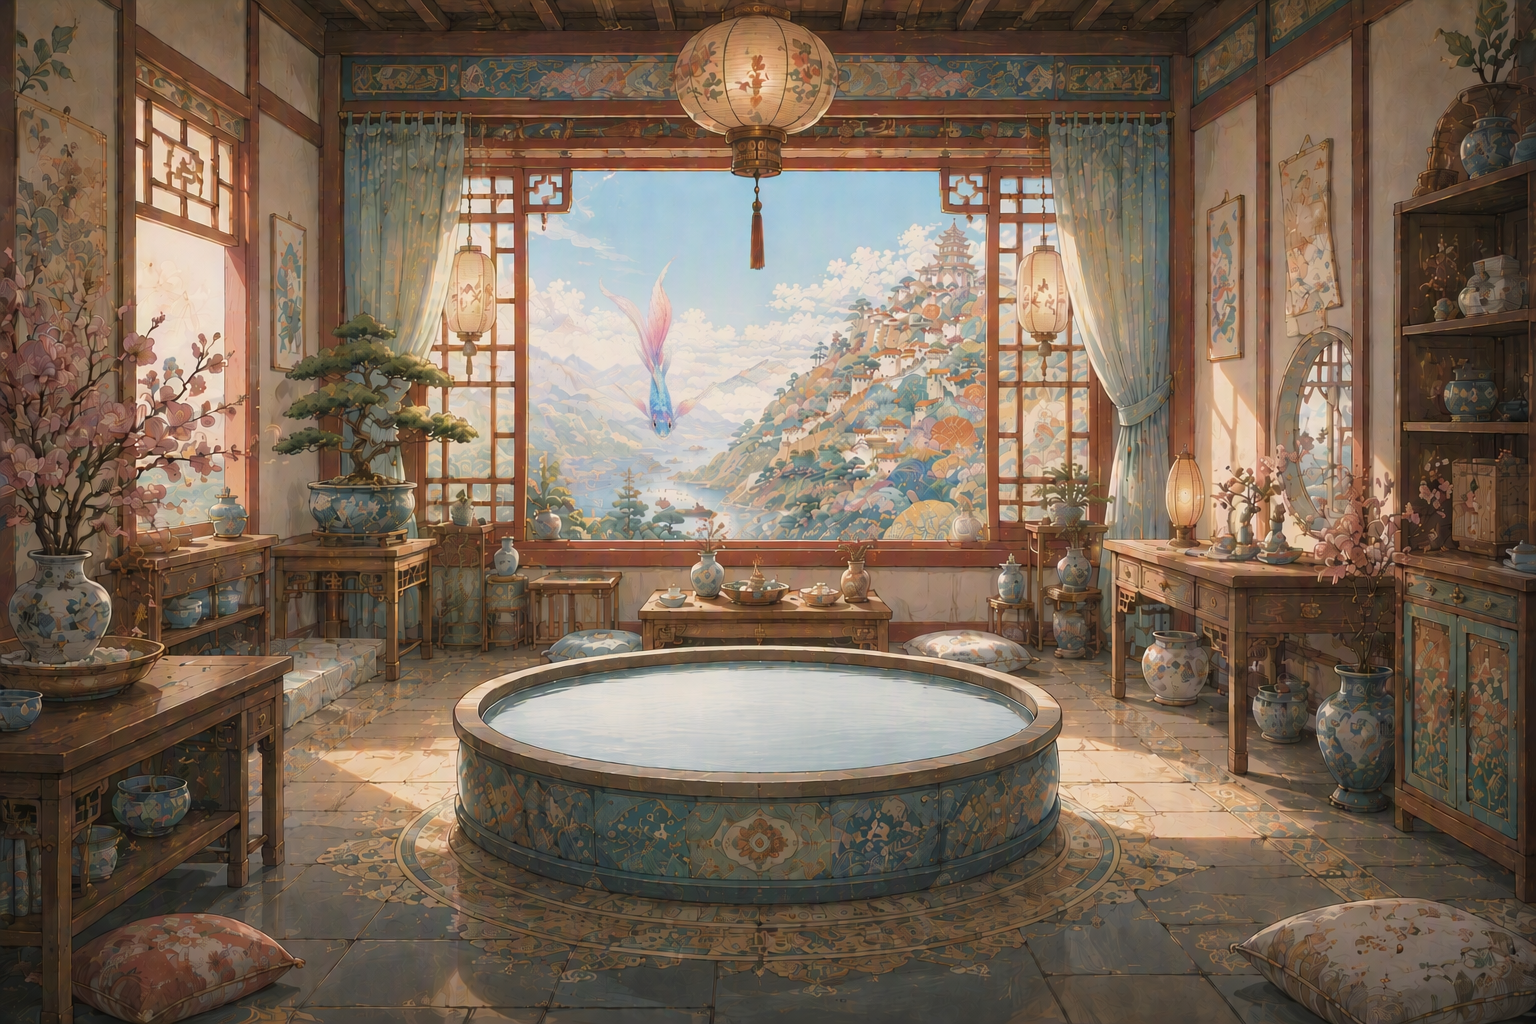
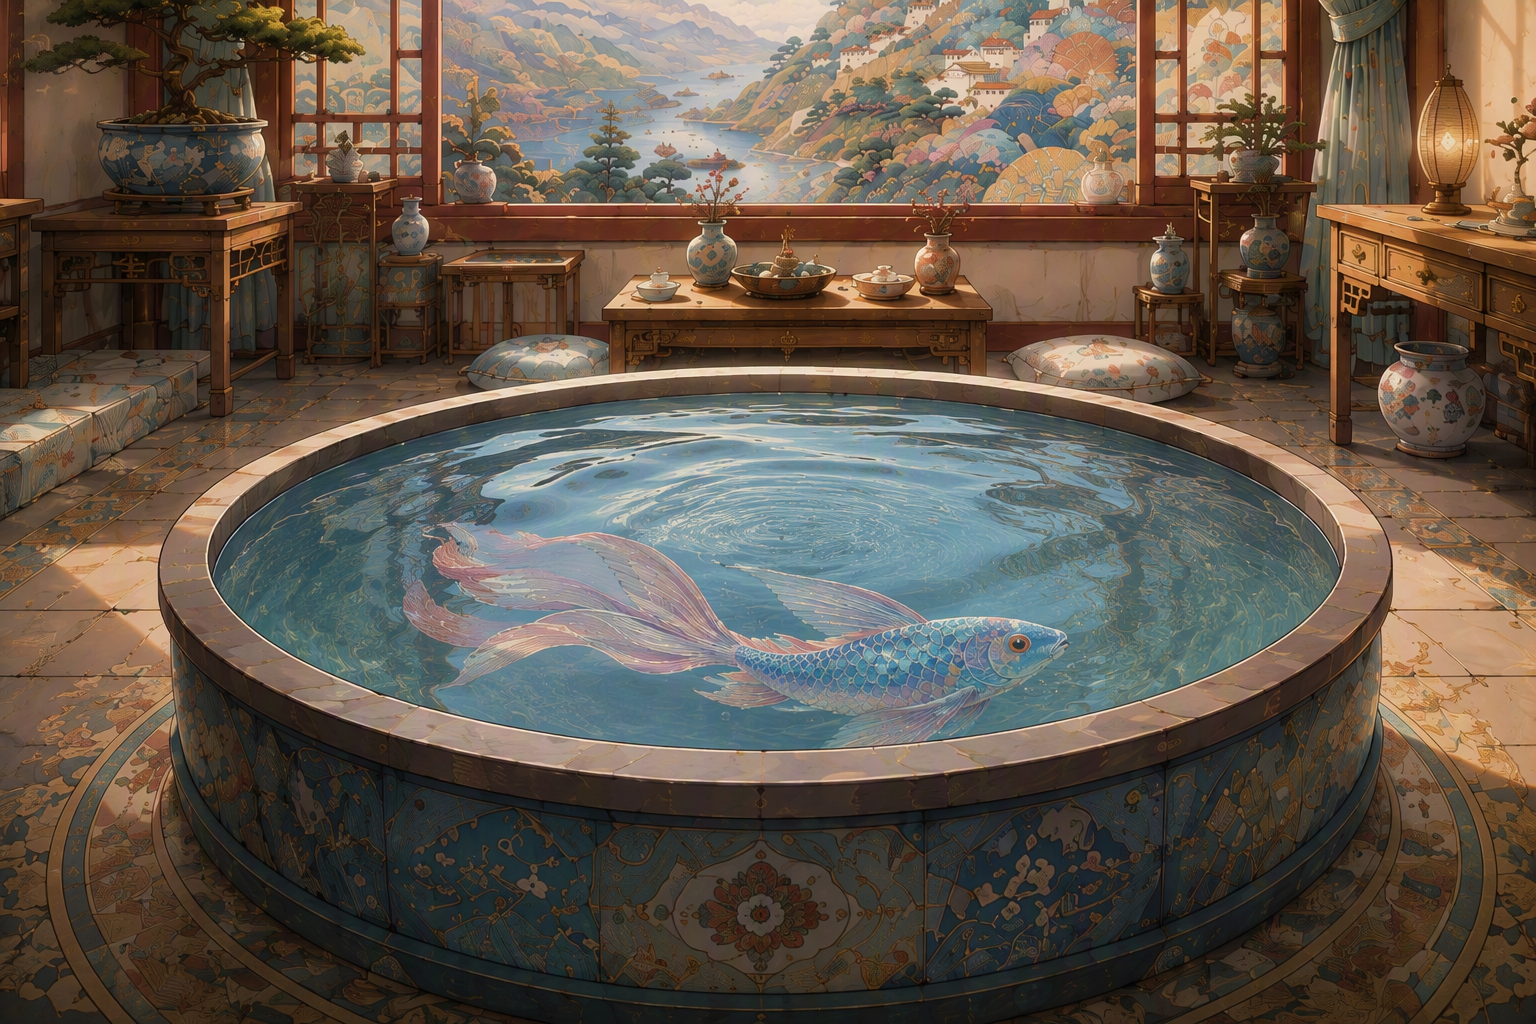
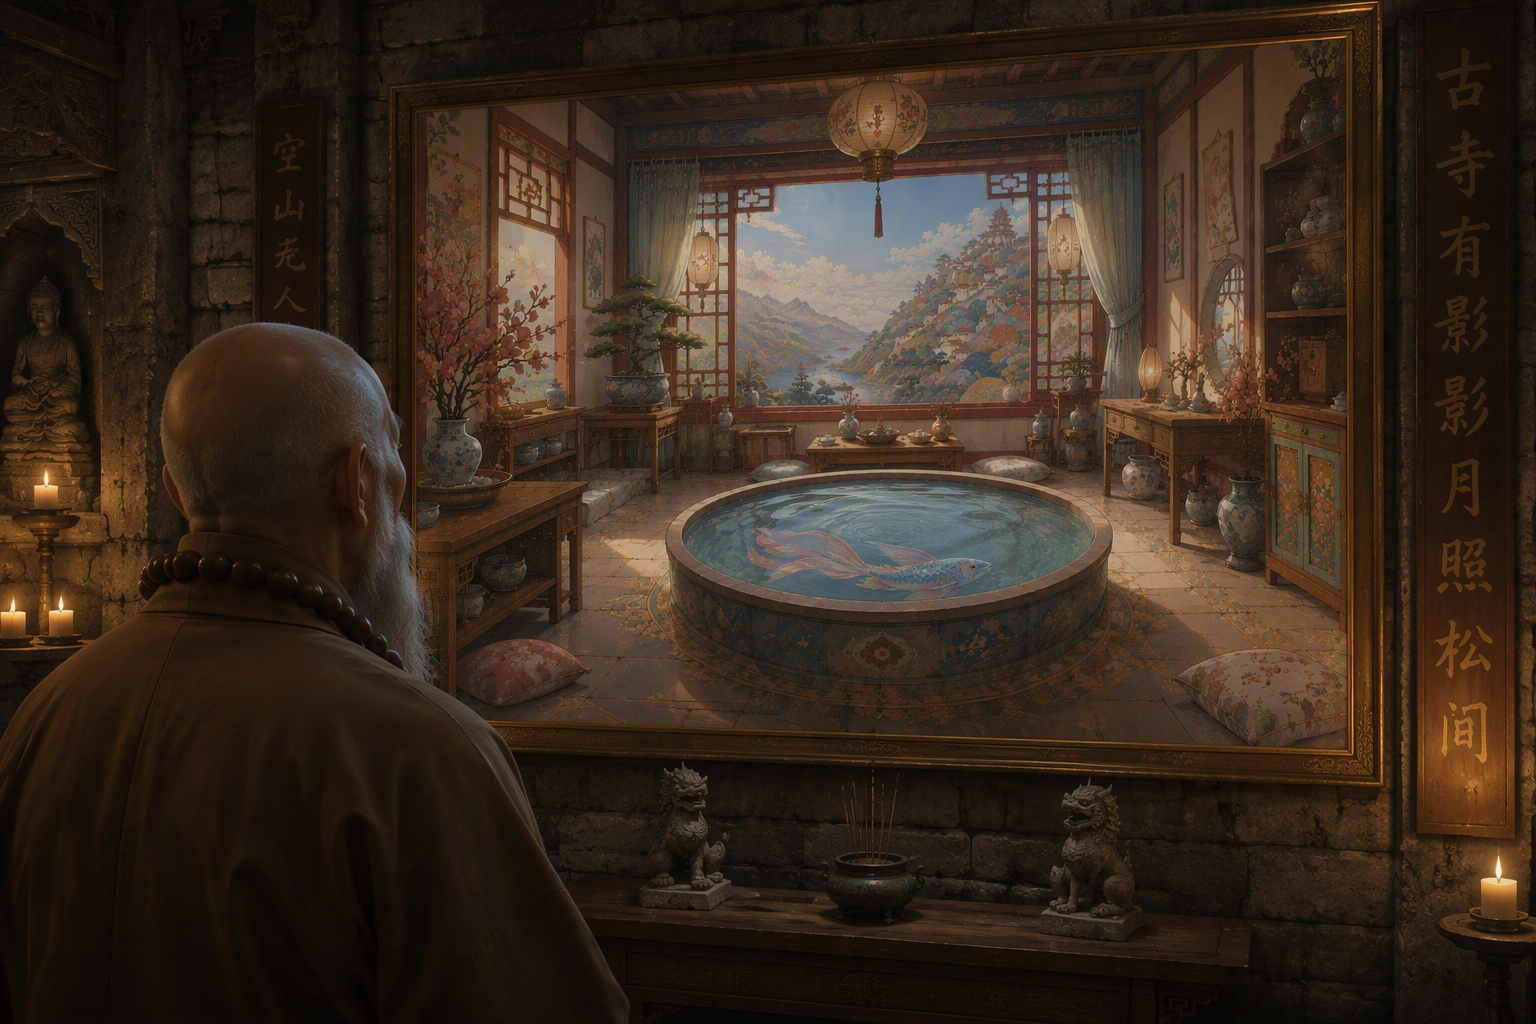
视频需要严格按照分镜图生成时使用,关键帧参考就是将分镜按照独立参考输入,并按照顺序传入,prompt 需要在第一句写明「以图片 x 至图片 x 的顺序作为关键帧」。
- 示例:「以图片 1 至图片 7 的顺序作为关键帧,在云海群山间,蓝粉长尾灵鱼凌空遨游,镜头缓缓推向依山而建的古镇,聚焦山顶古塔;画面一转进入雅致中式厅堂,灵鱼穿窗飞入,落入厅堂中央圆池悠然游动;最终视角切至幽暗古寺,白须老僧背对而立,静静凝望巨幅画框,画内正是厅堂与池中灵鱼,新国风浮世绘插画风格」
-
-
与 Seedance 2.0 的差异点
- 响应时间戳:Seedance 2.0 不响应时间戳只响应镜头序号,而 Seedance 2.5 响应整数秒的时间戳。
- 支持多视图:Seedance 2.0 不建议使用多视图作为主体参考,而 Seedance 2.5 是可以支持的。
- 自由宽高比:Seedance 2.0 的输出宽高比只有固定的 6 档,Seedance 2.5 可以通过控制输入素材的方式支持 [0.4, 2.5] 之间的任意宽高比输出。
- 提升 V2V 的画质:Seedance 2.5 的输出支持 MOV 格式,在延长/编辑任务中更好地保持颜色与亮度一致性、声画一致性。
常见问题
本节整理 Seedance 2.5 在视频生成、编辑与翻译任务中的常见问题及处理方法,供您遇到类似问题时快速定位并优化提示词。
美学风格差异
典型现象
Seedance 2.5 与 Seedance 2.0 的美学风格偏好差异较大,使用相同参考图与提示词生成的视频风格明显不同;如需混用两个模型的输出,风格不连贯。
解决方案
如需在 Seedance 2.5 的任务中保留 Seedance 2.0 的风格,建议将 Seedance 2.0 生成的视频作为延长任务的输入,并将输出格式选择为 MOV,可较大程度保持原有风格。
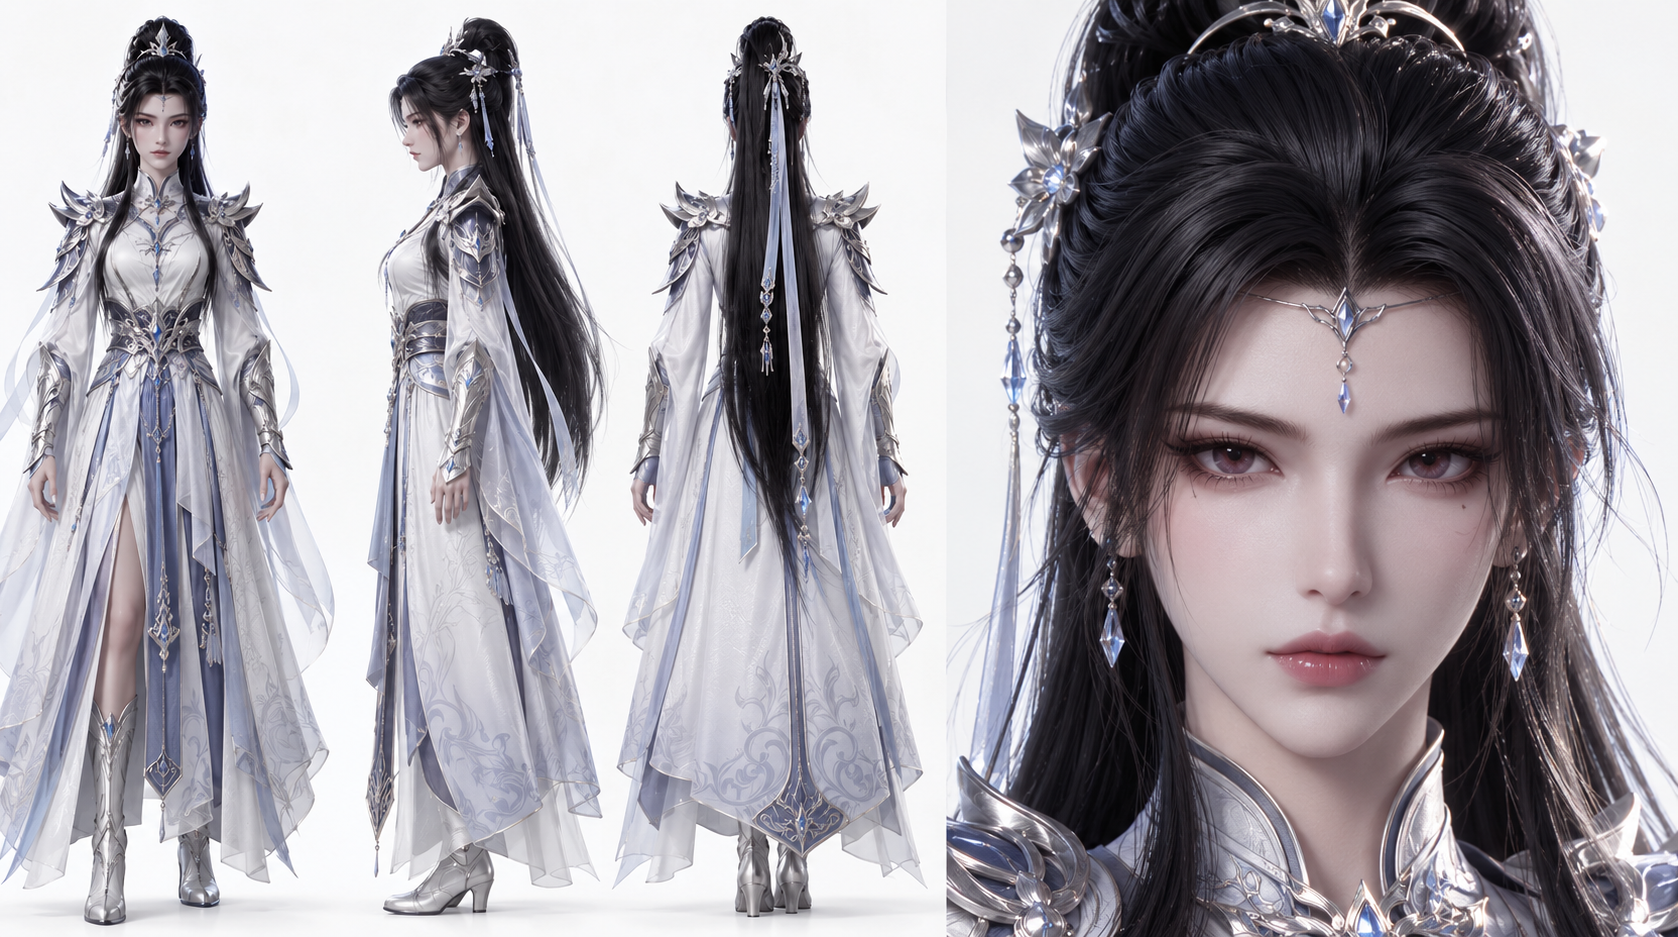
本案例使用的输入参考图:
Seedance 2.0 生成 | Seedance 2.5 生成 | 延长处理后 |
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
相同参考图与提示词下的 2.0 输出 | Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
相同输入下的 2.5 输出,风格差异明显 | Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
以 2.0 视频为延长任务输入并输出 MOV,风格保持一致 |
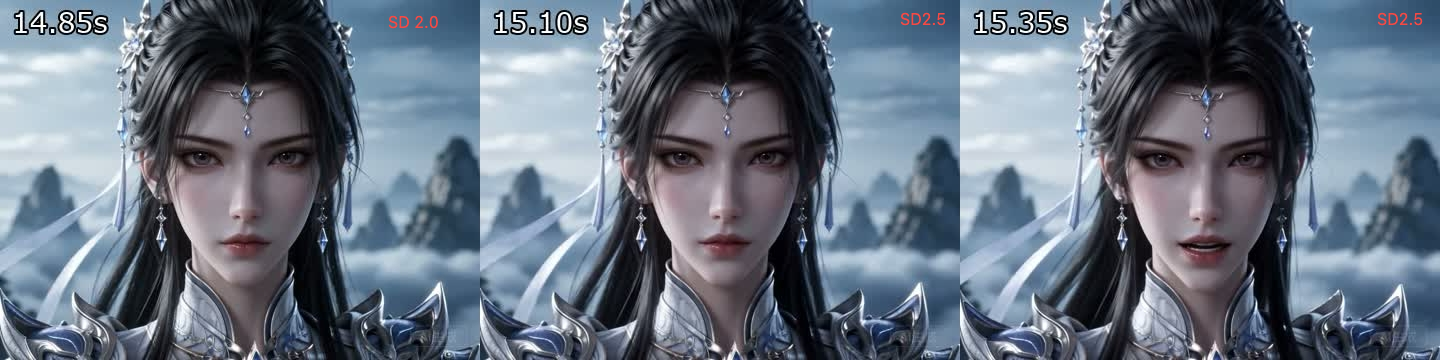
输出静帧对比(左为 Seedance 2.0 输出,右为 Seedance 2.5 输出):
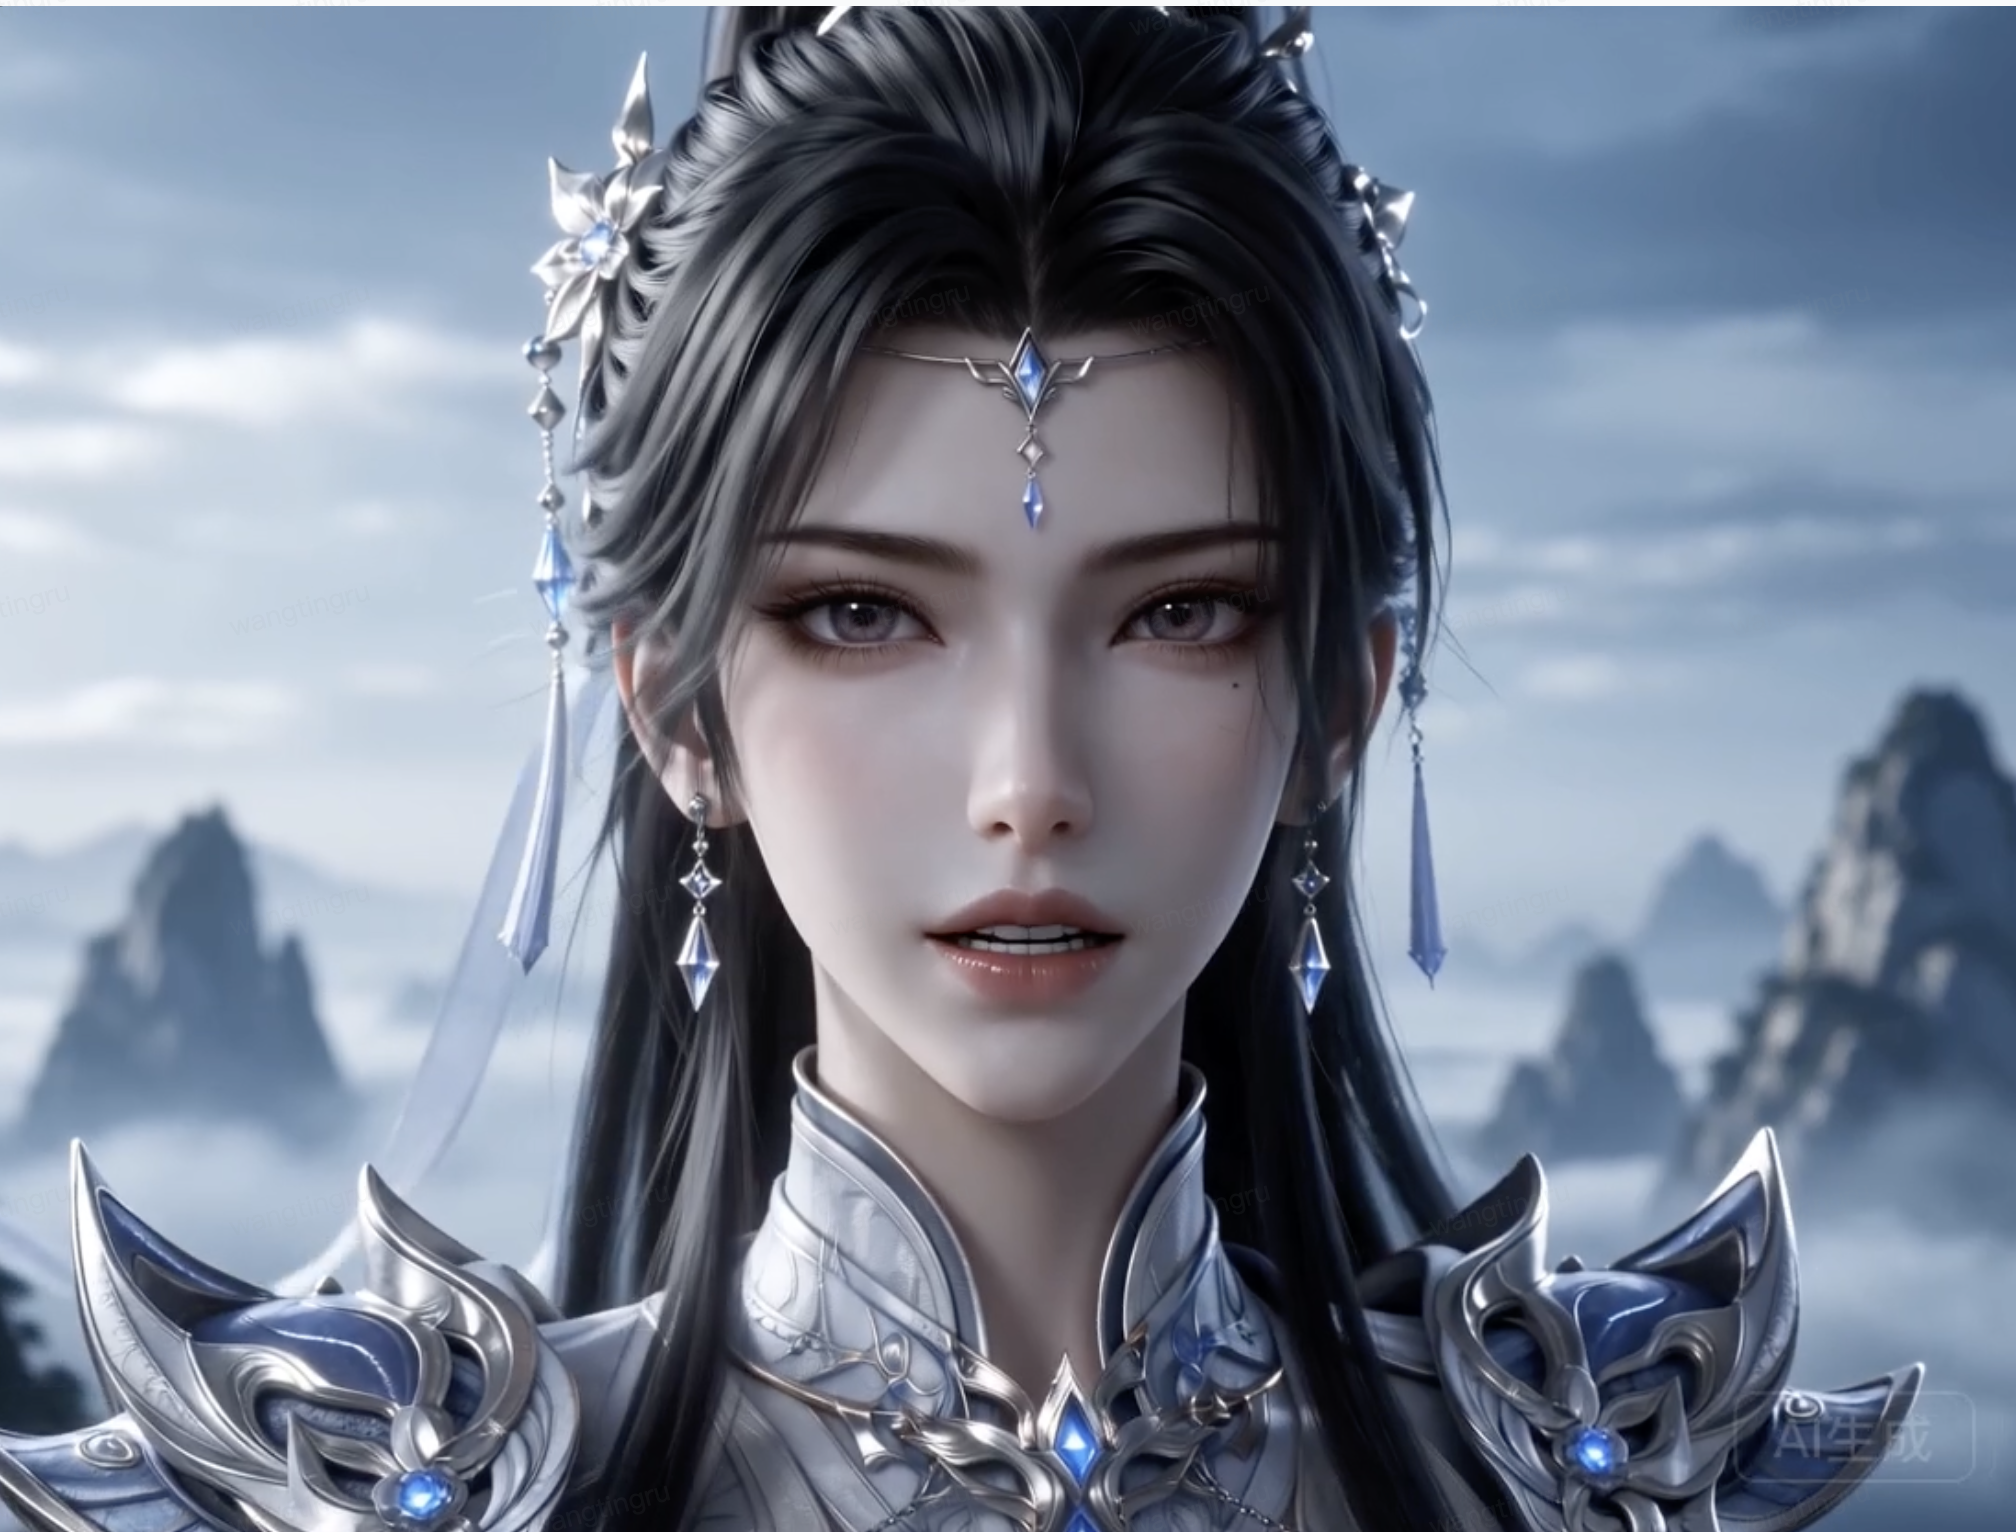
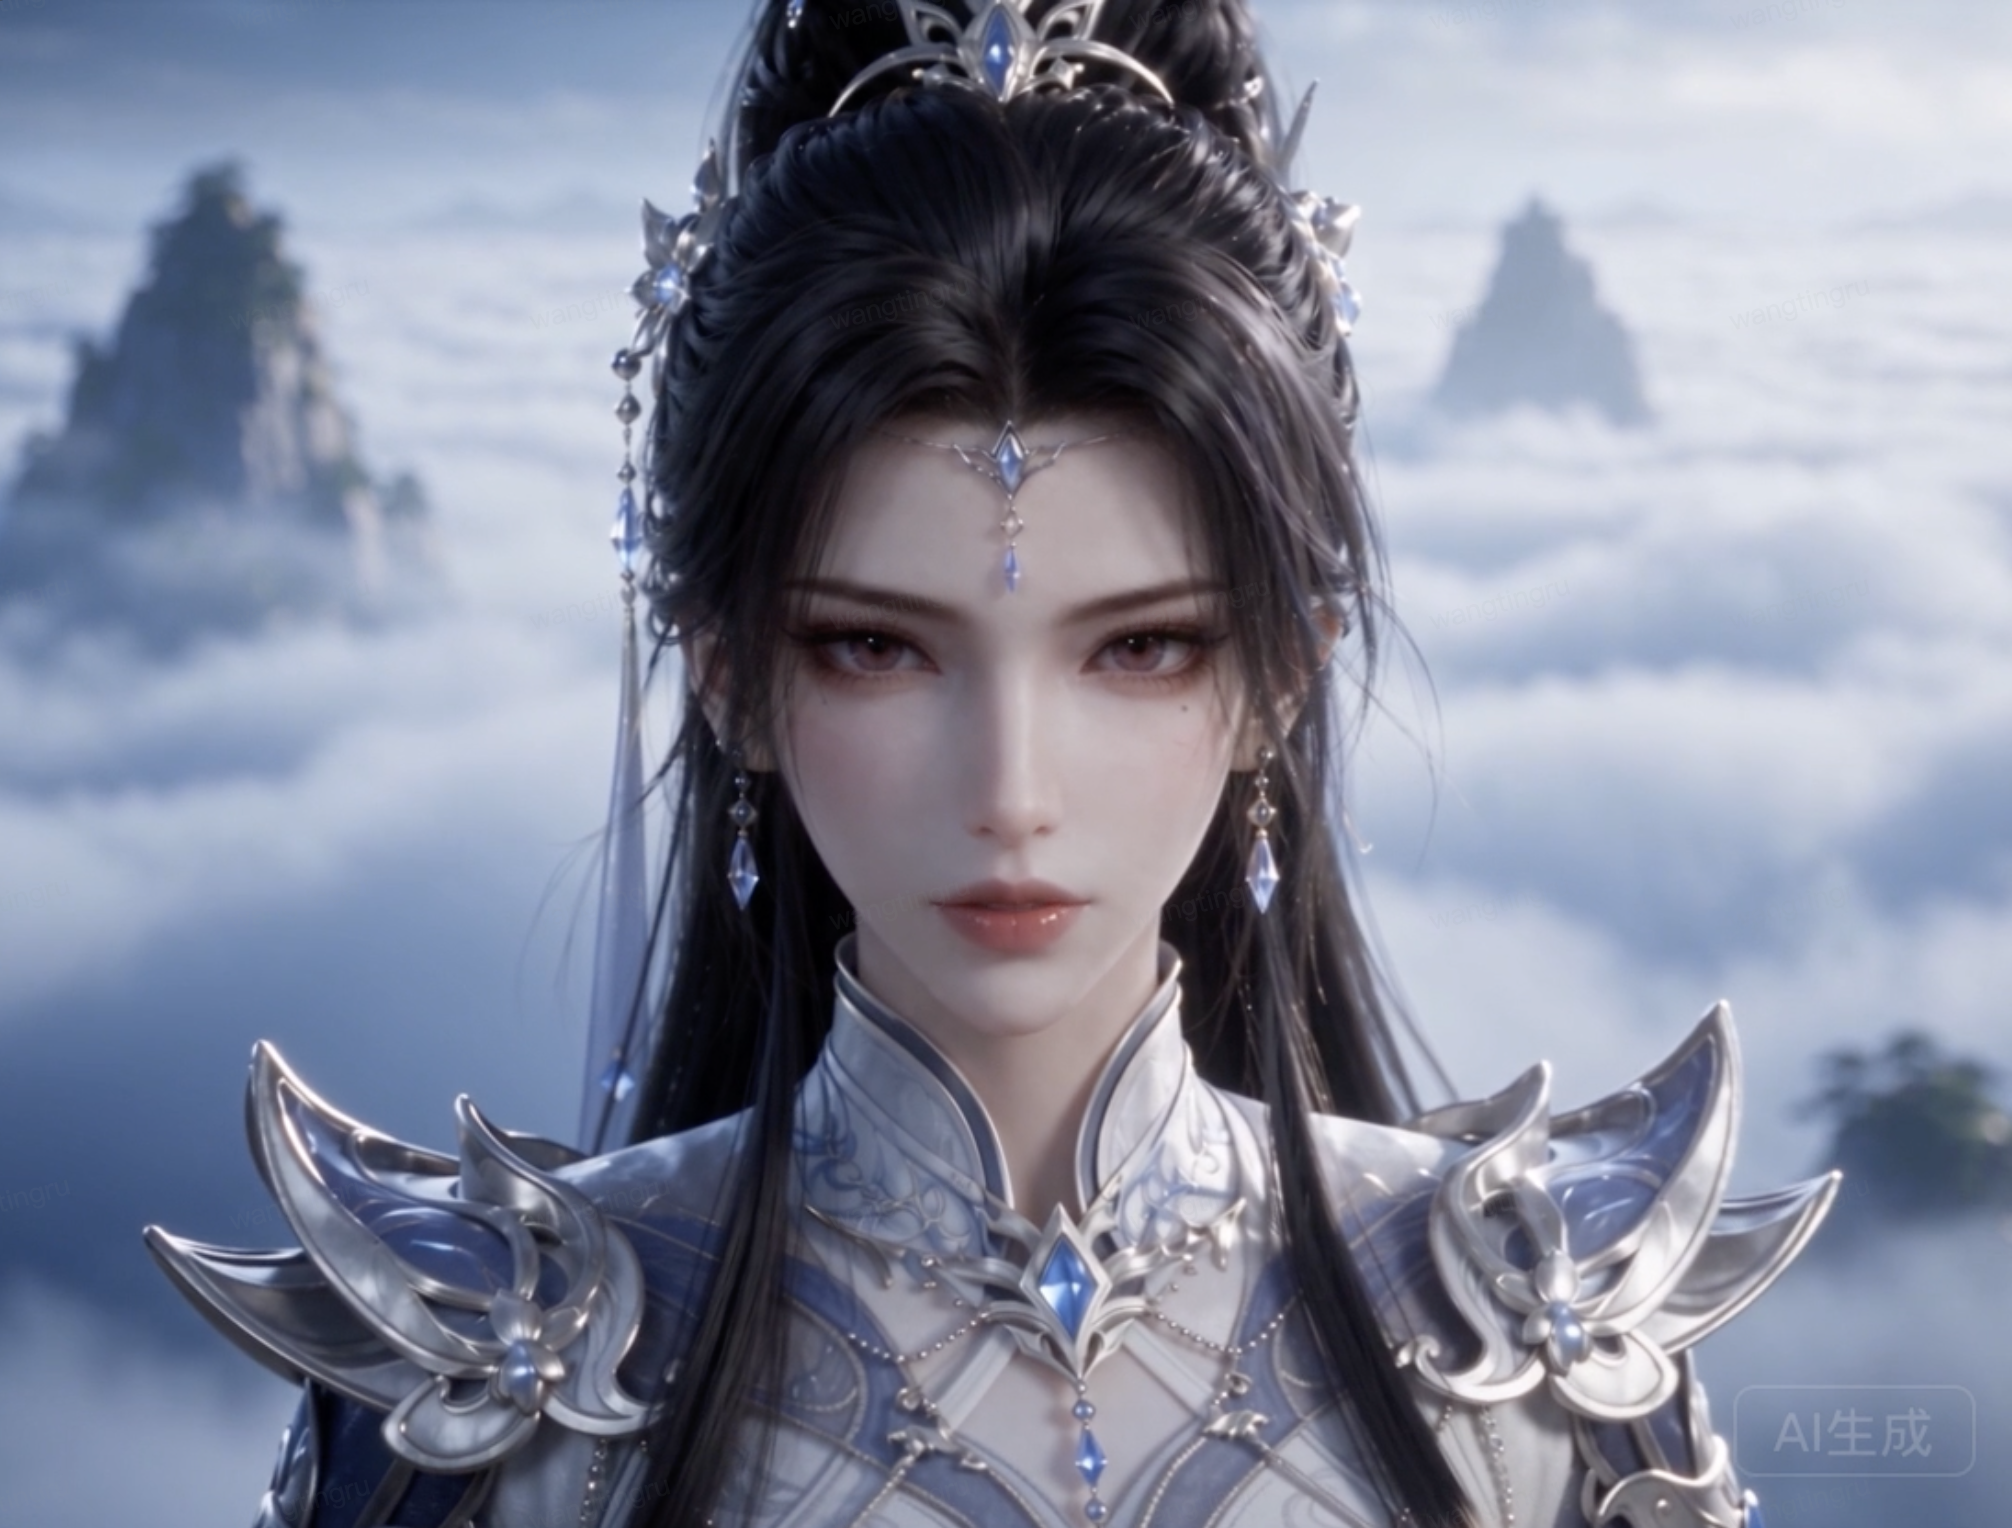
三帧画面对比:
情绪过度响应(眼睛发光)
典型现象
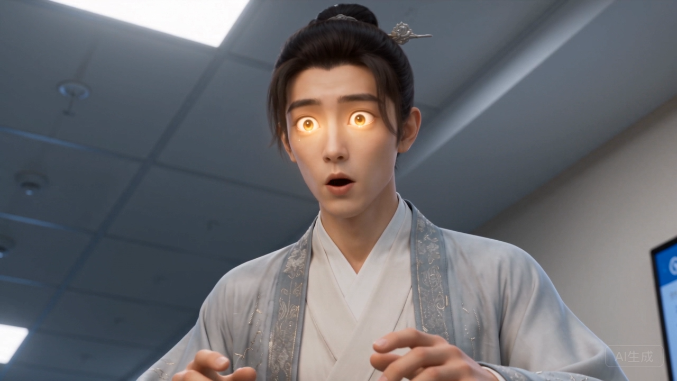
模型对人物情绪过度响应,瞳孔出现蓝光、红光或其他非自然发光。
解决方案
- 在提示词中以最高优先级明确约束“人物为正常人眼、不发光”,并限制环境光仅作用于面部轮廓。
- 避免将情绪直接描述为眼睛的特效化表现,将“狂热”“极度震惊”等强烈情绪词改为“惊叹”等常规描述,可降低发光概率。
优化前 | 优化后 |
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
强烈情绪描述导致瞳孔发光 | Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
约束正常人眼不发光并改用常规情绪词后恢复 |
示例提示词
优化前后的差异仅在镜头 2 的情绪描述:将“狂热膜拜”改为“惊叹(人物眼睛不发光)”,避免将情绪直接描述为眼睛的特效化表现。
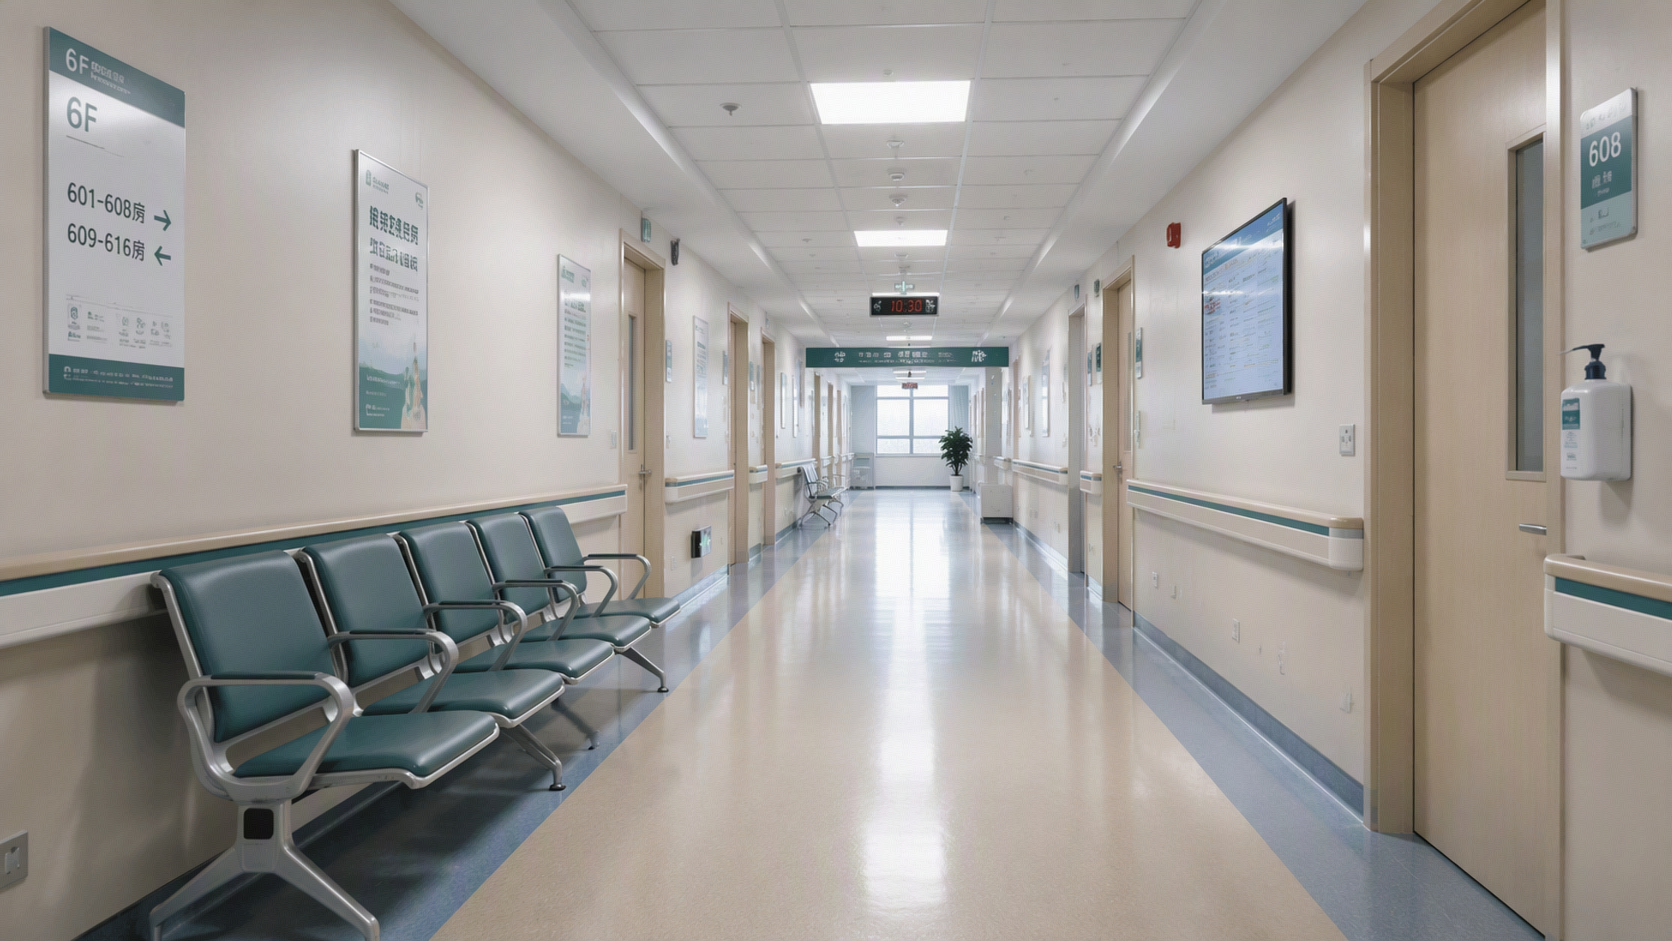
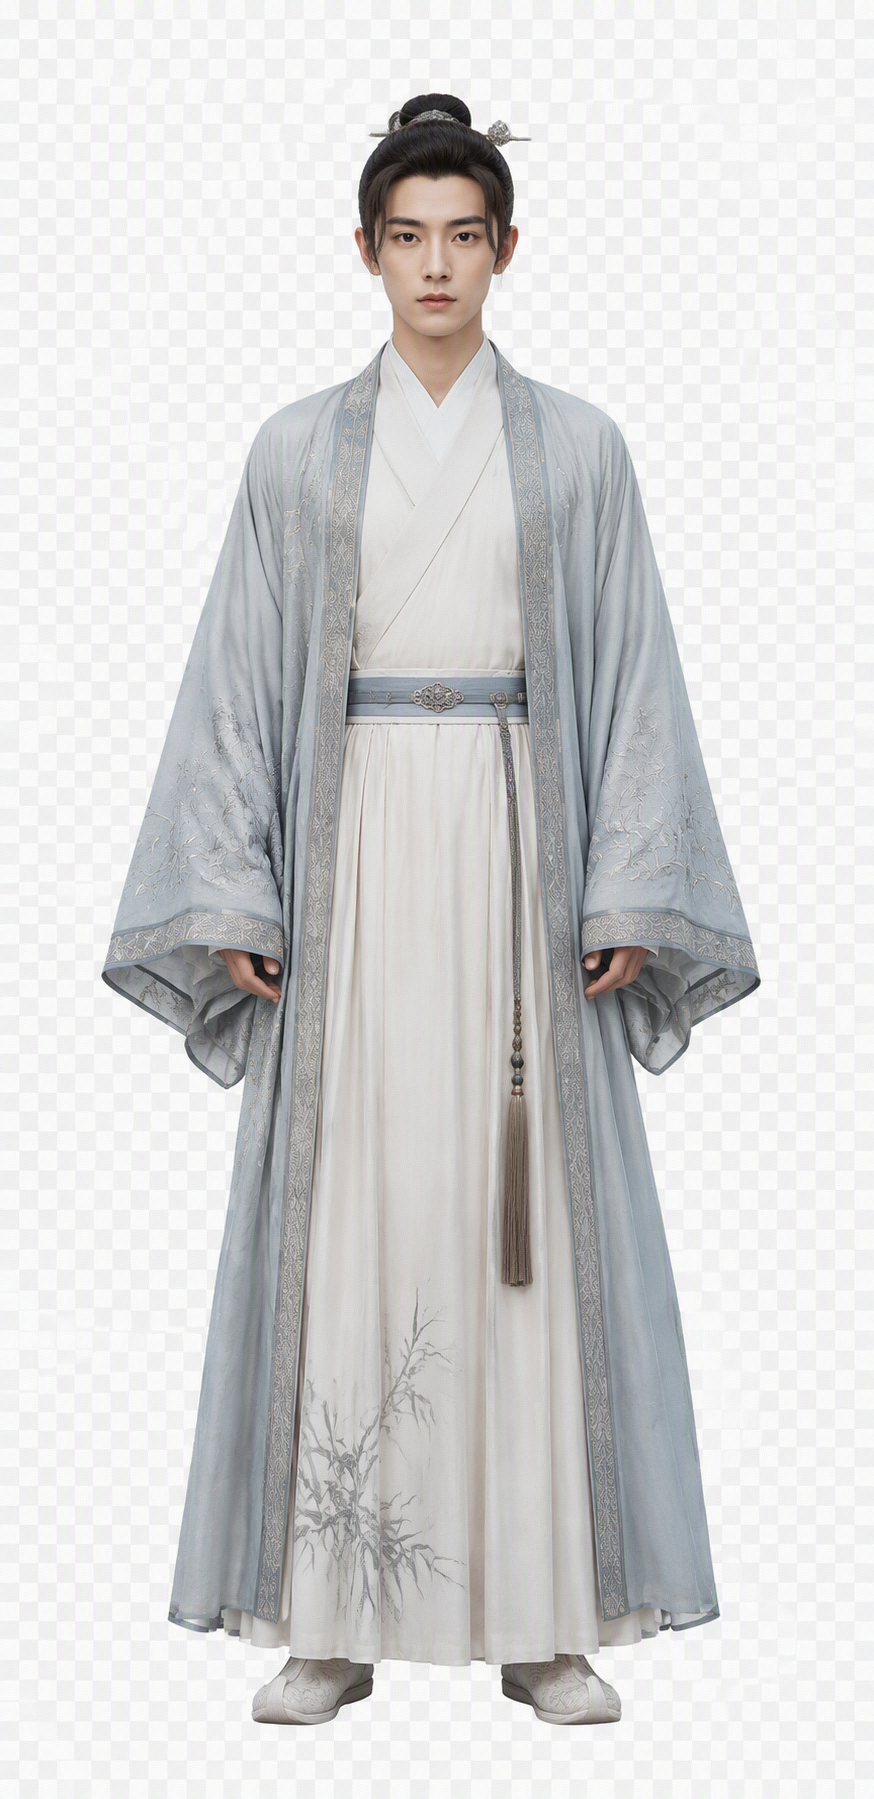
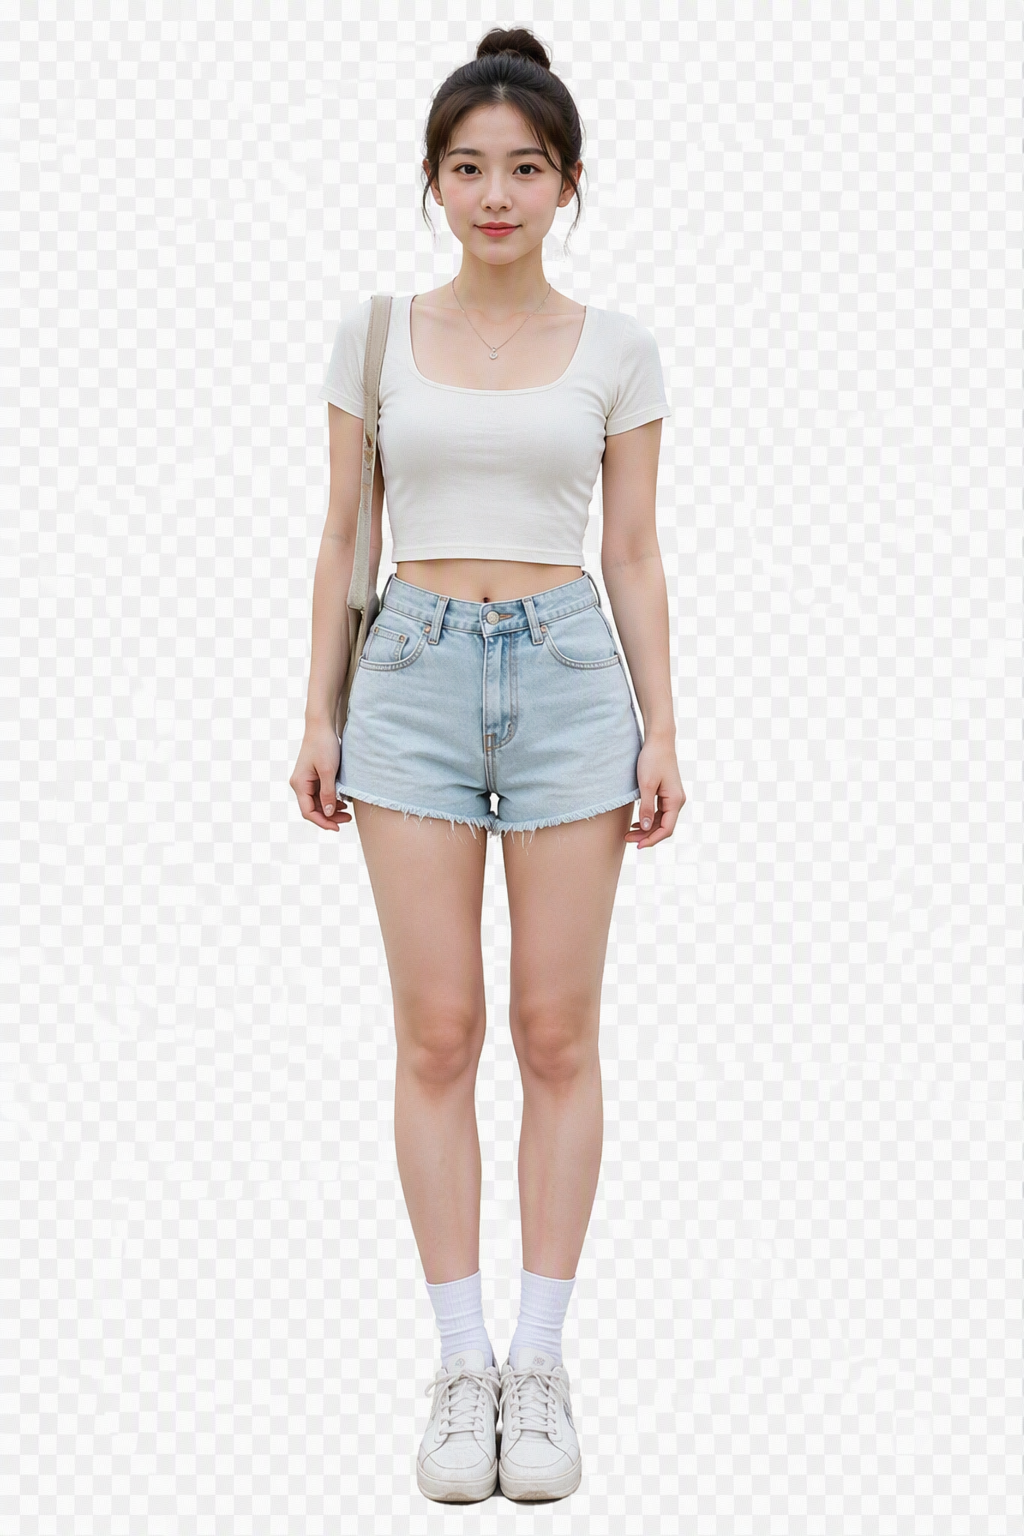
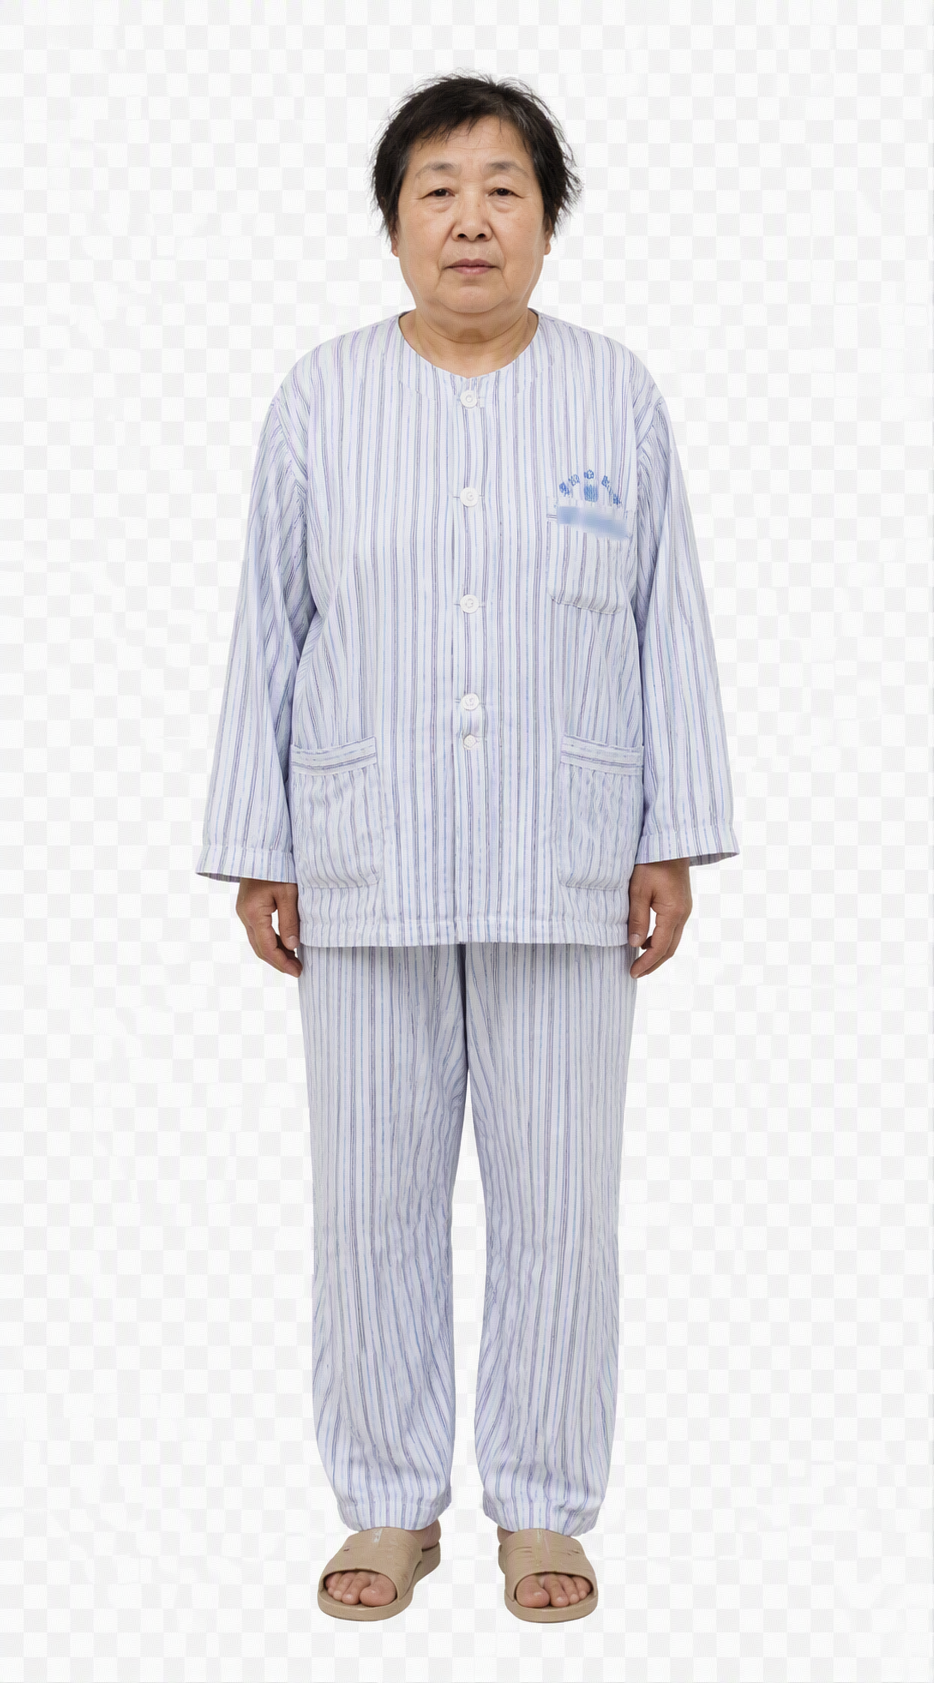
案例使用的参考素材,从左至右为图片 1(医院住院部走廊场景)、图片 2(高砚)、图片 3(周晚星)、图片 4(患者甲):
优化前提示词
【视频约束】 3D 风格。严格按照台词生成音频,禁止增加或删减台词;人声干净无杂音,吐字清晰标准。仅生成台词音频,不要生成背景音乐。视频画面中禁止出现任何形式的字幕。根据画面内容适配相应的音效。场景和人物保持一致。人物轨迹符合脚本描述,逻辑场景合理。生成的视频色温、光影、亮度参考图片中人物和场景。人物、场景透视和构图比例符合物理逻辑,避免人物过大或过小、比例失衡、头身比失调、近景变全景。人物自然微动。
【场景设定】 医院住院部走廊@图片1,夜。
【人物设定】 高砚@图片2比医院住院部走廊画面中的门低一个头的距离;周晚星@图片3比高砚低。
【站位设定】 参考图 1。高砚站在图 1 画面右边,面朝画面左侧,周晚星站在画面右边看着高砚。 高砚站在医院住院部走廊画面过道的椅子旁边;患者甲@图片4坐在画面左侧过道椅子上面朝画面右侧,挂着输液吊瓶,位于左边;高砚在右边;周晚星站在高砚右边,看着高砚。
镜头时序:
镜头 1 MCU 中景,固定镜头,画面左侧是患者甲,画面右侧是站着的高砚和周晚星。 背景为医院住院部走廊,夜。
镜头 2 MCU 中近景,固定镜头,仰角拍摄高砚。 高砚闻言,双眼瞬间睁大,极度惊骇,微表情呈现大脑宕机状态。高砚双手微微颤抖,发出一声惊叹。 高砚说:“竟能将药液直入血脉?简直是仙家法术!” 语气中充满对现代医学手段的狂热膜拜。
镜头 3 MCU 中近景,固定镜头,保持仰角。 高砚原本高兴的眼神突然变得伤心,缓缓垂下眼眸,情绪急速转折,微表情流露出深深的无力感。
优化后提示词
【视频约束】 3D 风格。严格按照台词生成音频,禁止增加或删减台词;人声干净无杂音,吐字清晰标准。仅生成台词音频,不要生成背景音乐。视频画面中禁止出现任何形式的字幕。根据画面内容适配相应的音效。场景和人物保持一致。人物轨迹符合脚本描述,逻辑场景合理。生成的视频色温、光影、亮度参考图片中人物和场景。人物、场景透视和构图比例符合物理逻辑,避免人物过大或过小、比例失衡、头身比失调、近景变全景。人物自然微动。
【场景设定】 医院住院部走廊@图片1,夜。
【人物设定】 高砚@图片2比医院住院部走廊画面中的门低一个头的距离;周晚星@图片3比高砚低。
【站位设定】 参考图 1。高砚站在图 1 画面右边,面朝画面左侧,周晚星站在画面右边看着高砚。 高砚站在医院住院部走廊画面过道的椅子旁边;患者甲@图片4坐在画面左侧过道椅子上面朝画面右侧,挂着输液吊瓶,位于左边;高砚在右边;周晚星站在高砚右边,看着高砚。
镜头时序:
镜头 1 MCU 中景,固定镜头,画面左侧是患者甲,画面右侧是站着的高砚和周晚星。 背景为医院住院部走廊,夜。
镜头 2 MCU 中近景,固定镜头,仰角拍摄高砚。 高砚闻言,双眼瞬间睁大,极度惊骇,微表情呈现大脑宕机状态。高砚双手微微颤抖,发出一声惊叹。 高砚说:“竟能将药液直入血脉?简直是仙家法术!” 语气中充满对现代医学手段的惊叹(人物眼睛不发光)。
镜头 3 MCU 中近景,固定镜头,保持仰角。 高砚原本高兴的眼神突然变得伤心,缓缓垂下眼眸,情绪急速转折,微表情流露出深深的无力感。
优化前输出中瞳孔发黄光的画面细节:
角色对应错误
典型现象
多人物视频中,角色与参考图片、音色或出场顺序发生错位,例如先出场的人物被其他参考角色替换。
解决方案
按人物首次出场顺序上传参考素材,并同步调整提示词中的图片、音频编号,确保每个角色与参考素材一一对应。
优化前 | 优化后 |
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
先出场角色被其他参考角色替换 | Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
按首次出场顺序调整参考素材与编号后对应正确 |
示例提示词
优化前后仅【参考素材】段的图片编号不同:按人物首次出场顺序对调图片 1 与图片 3,使每个角色与参考素材一一对应。
案例使用的参考素材(按优化后提示词中的图片编号排序,从左至右依次为图片 1-8):
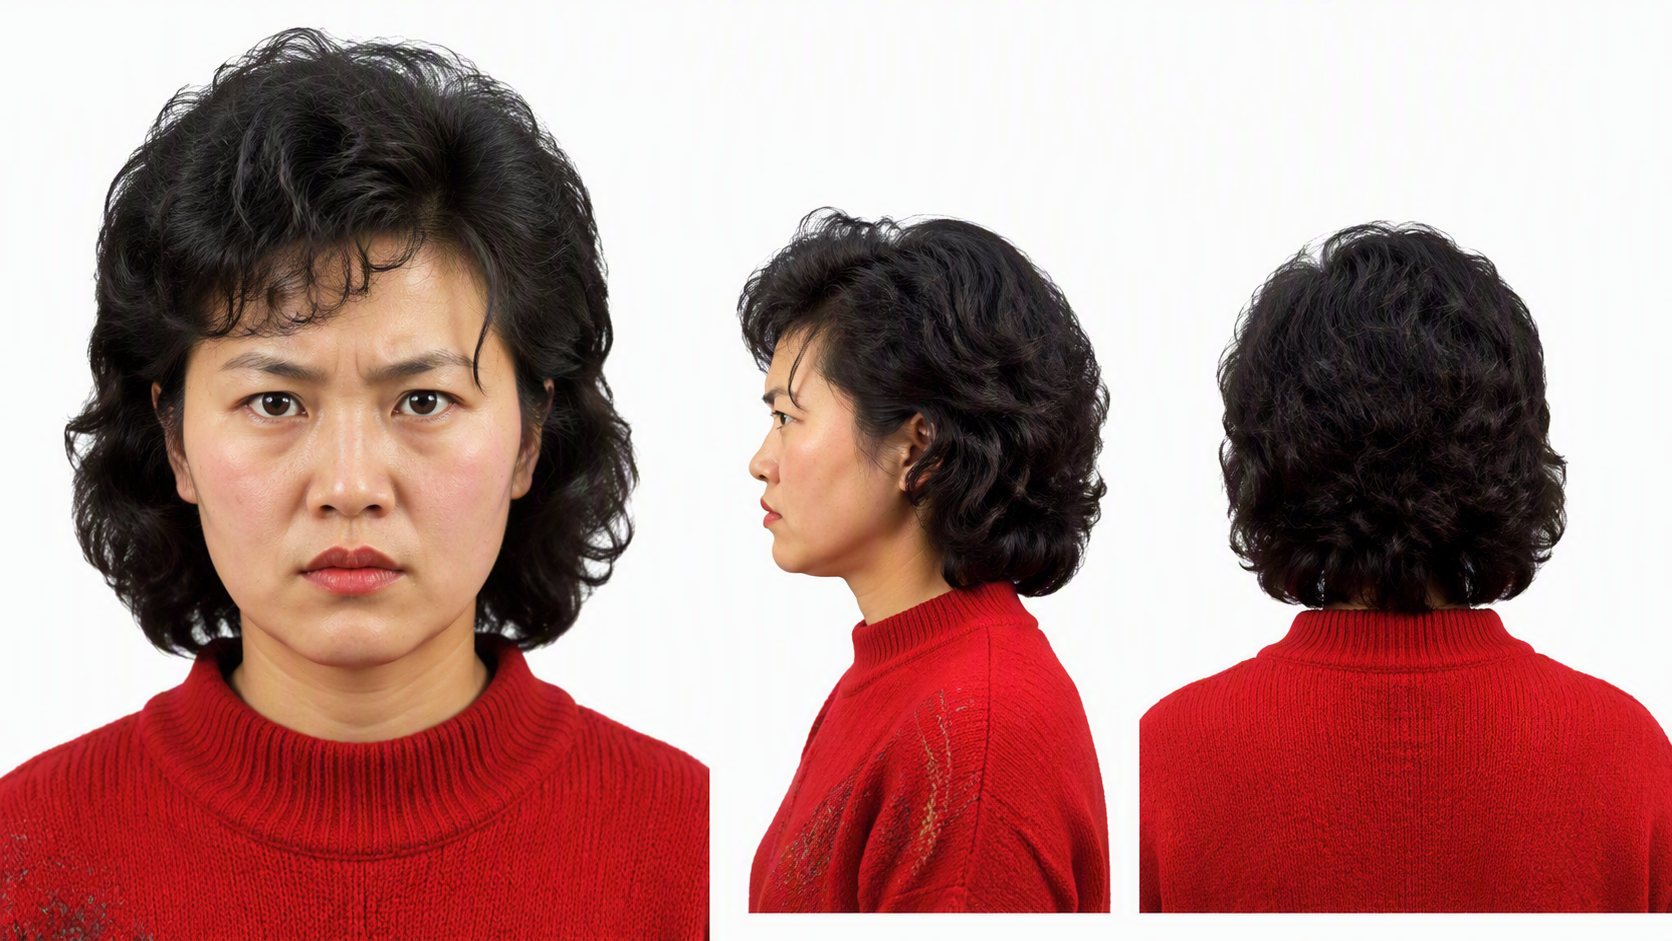
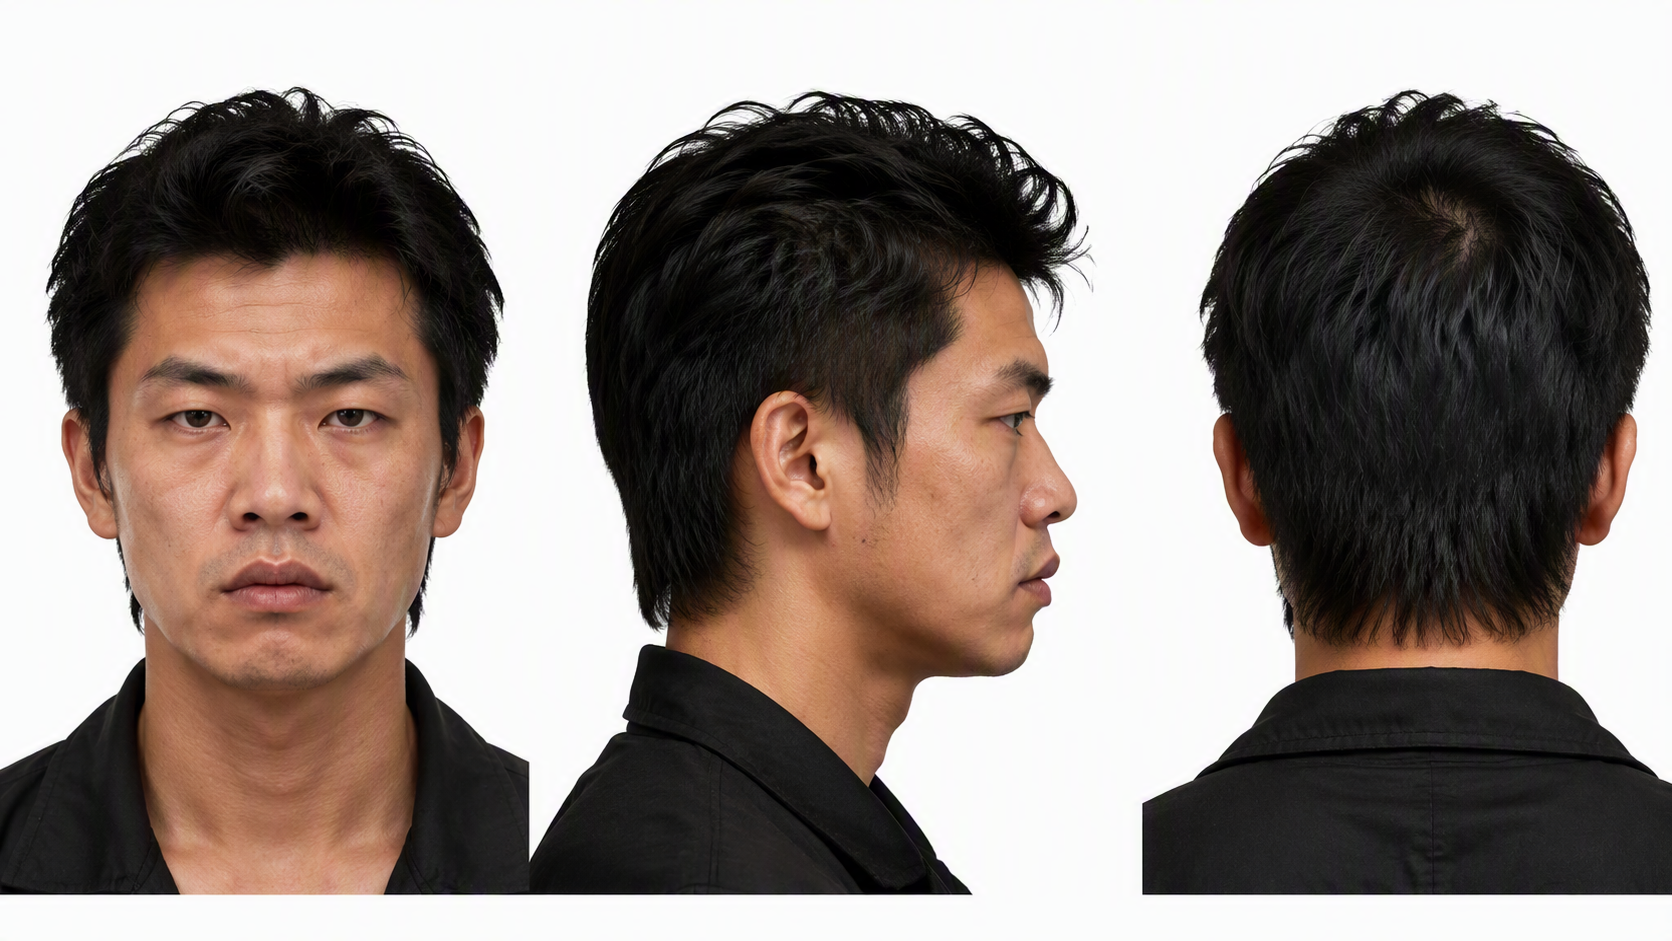
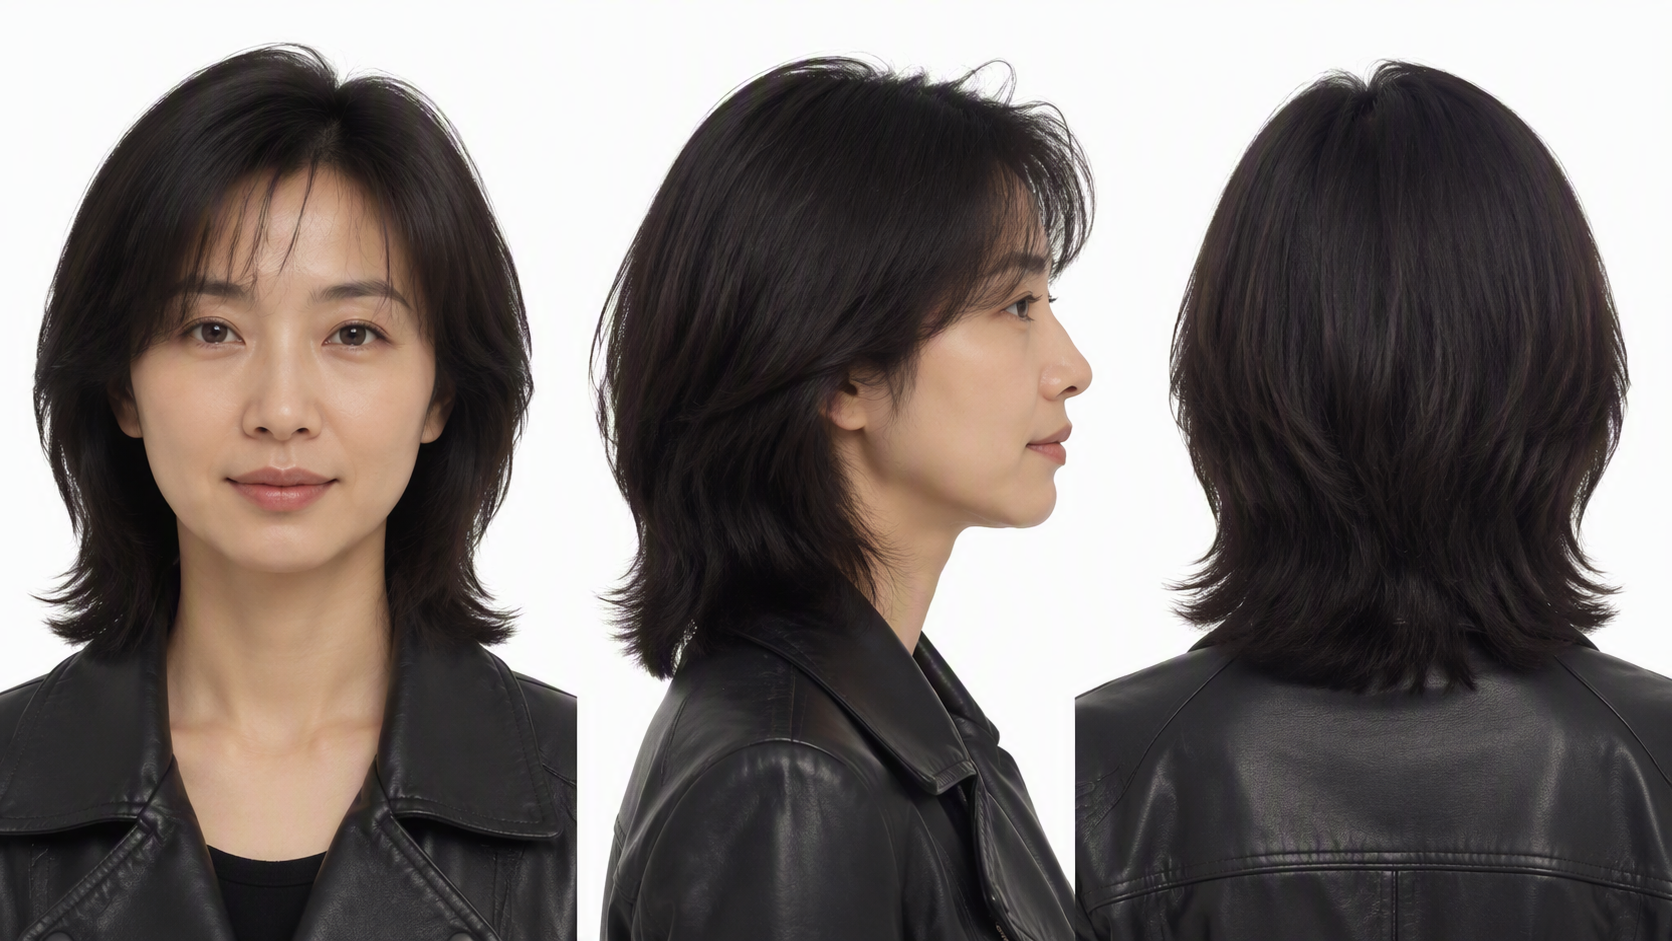
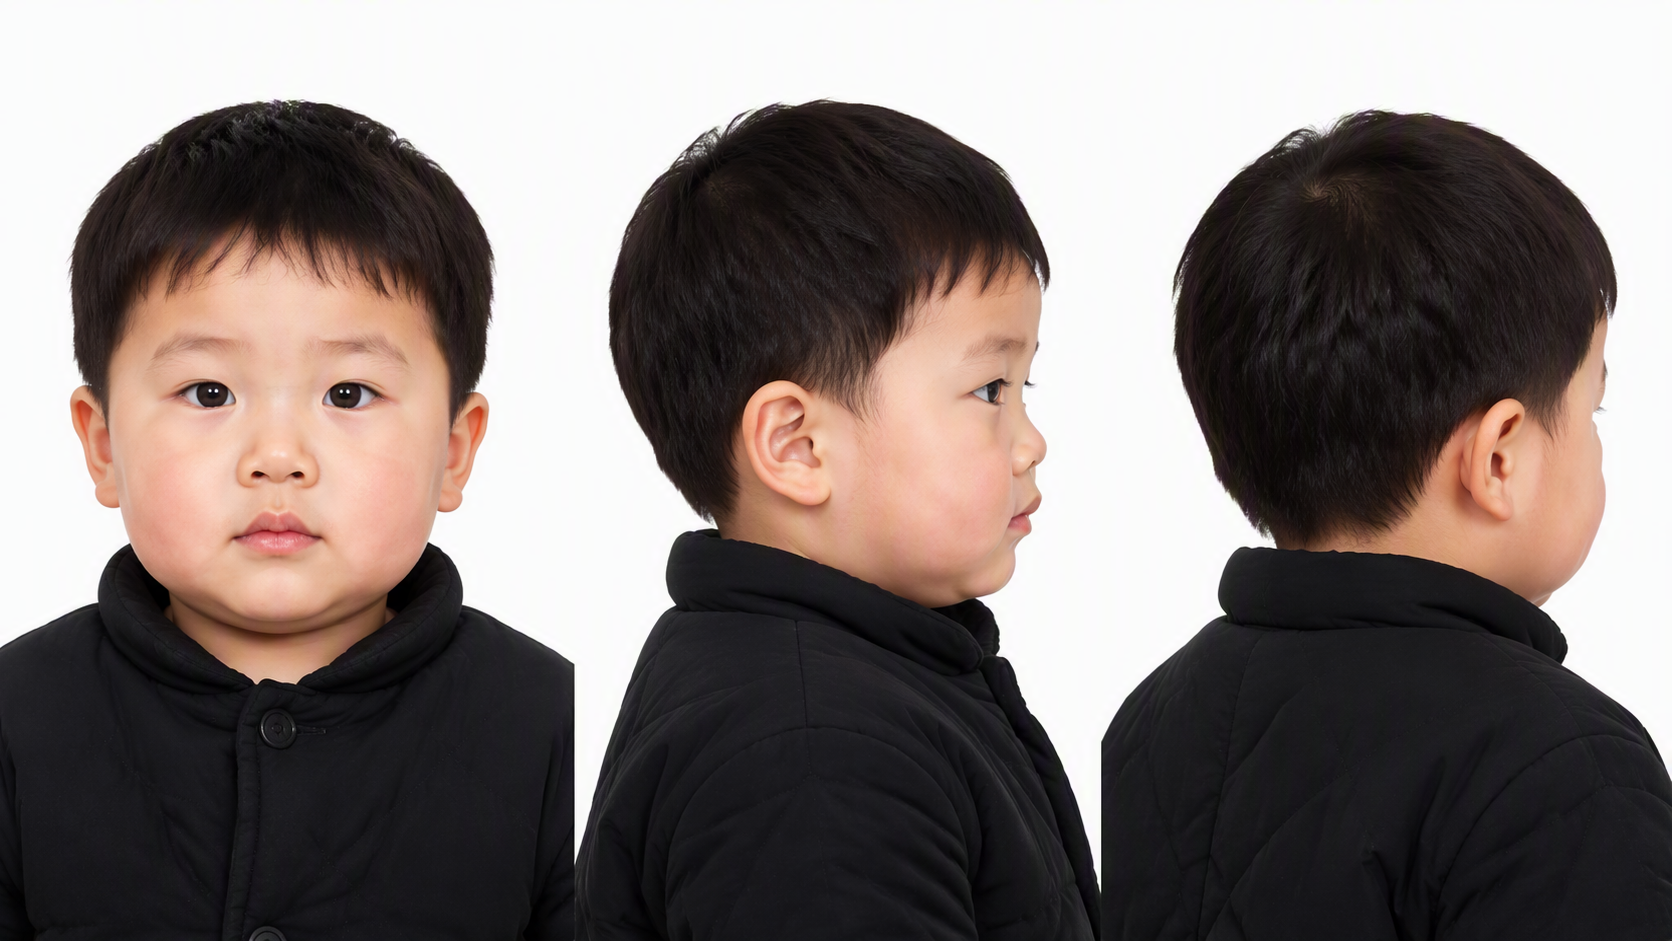
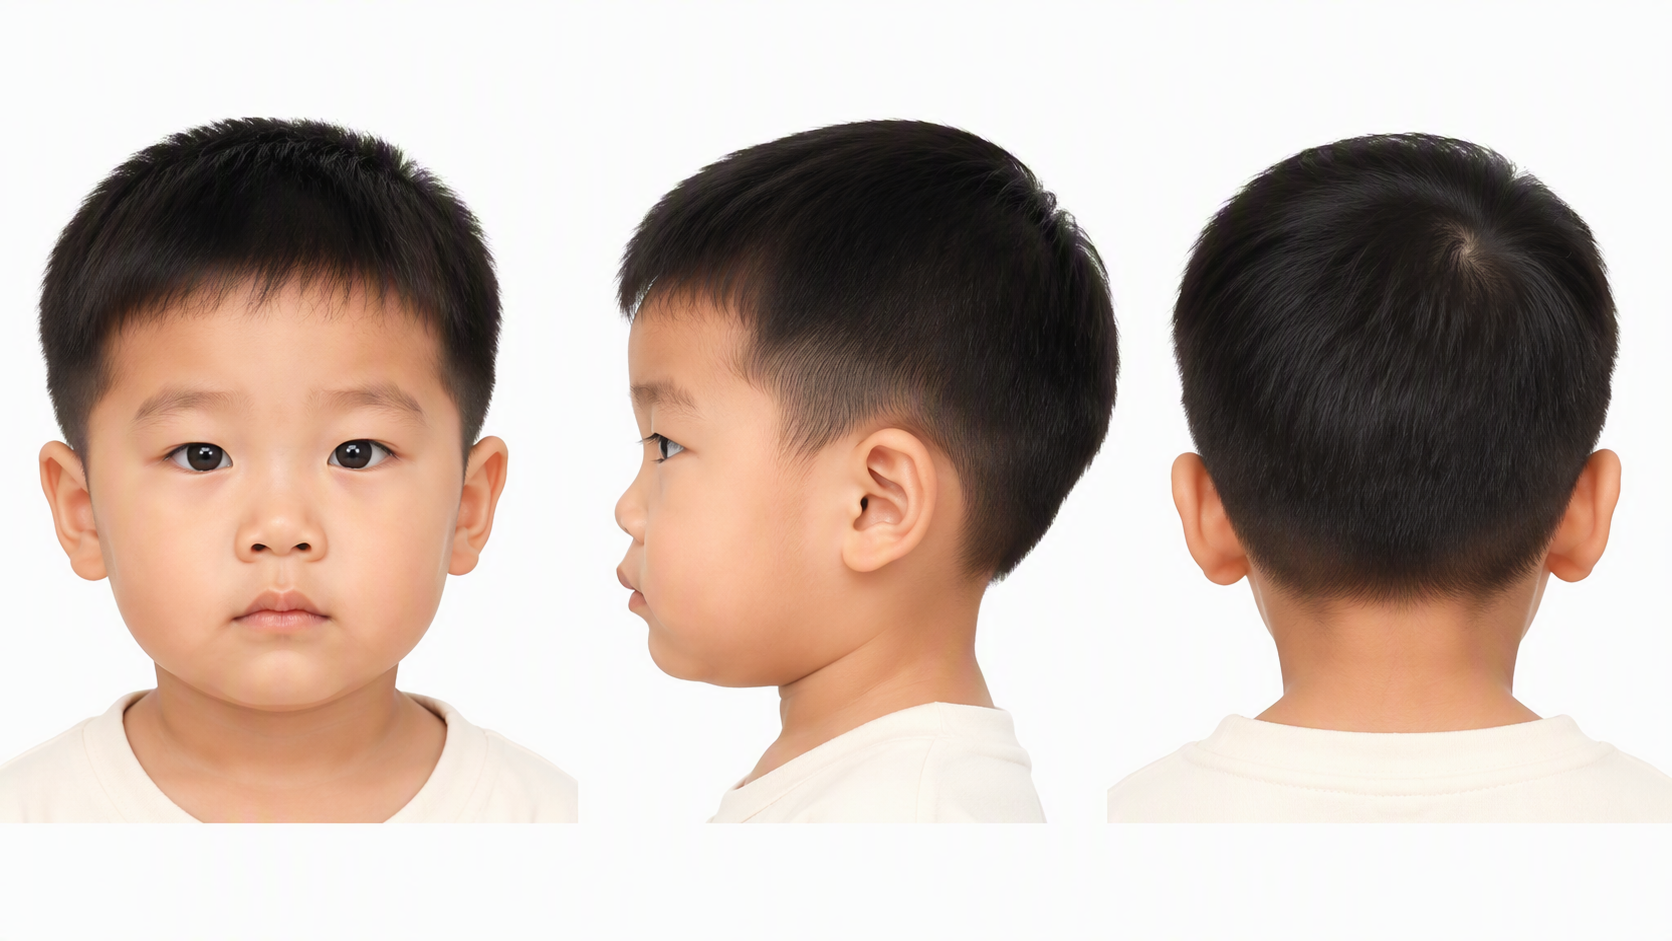
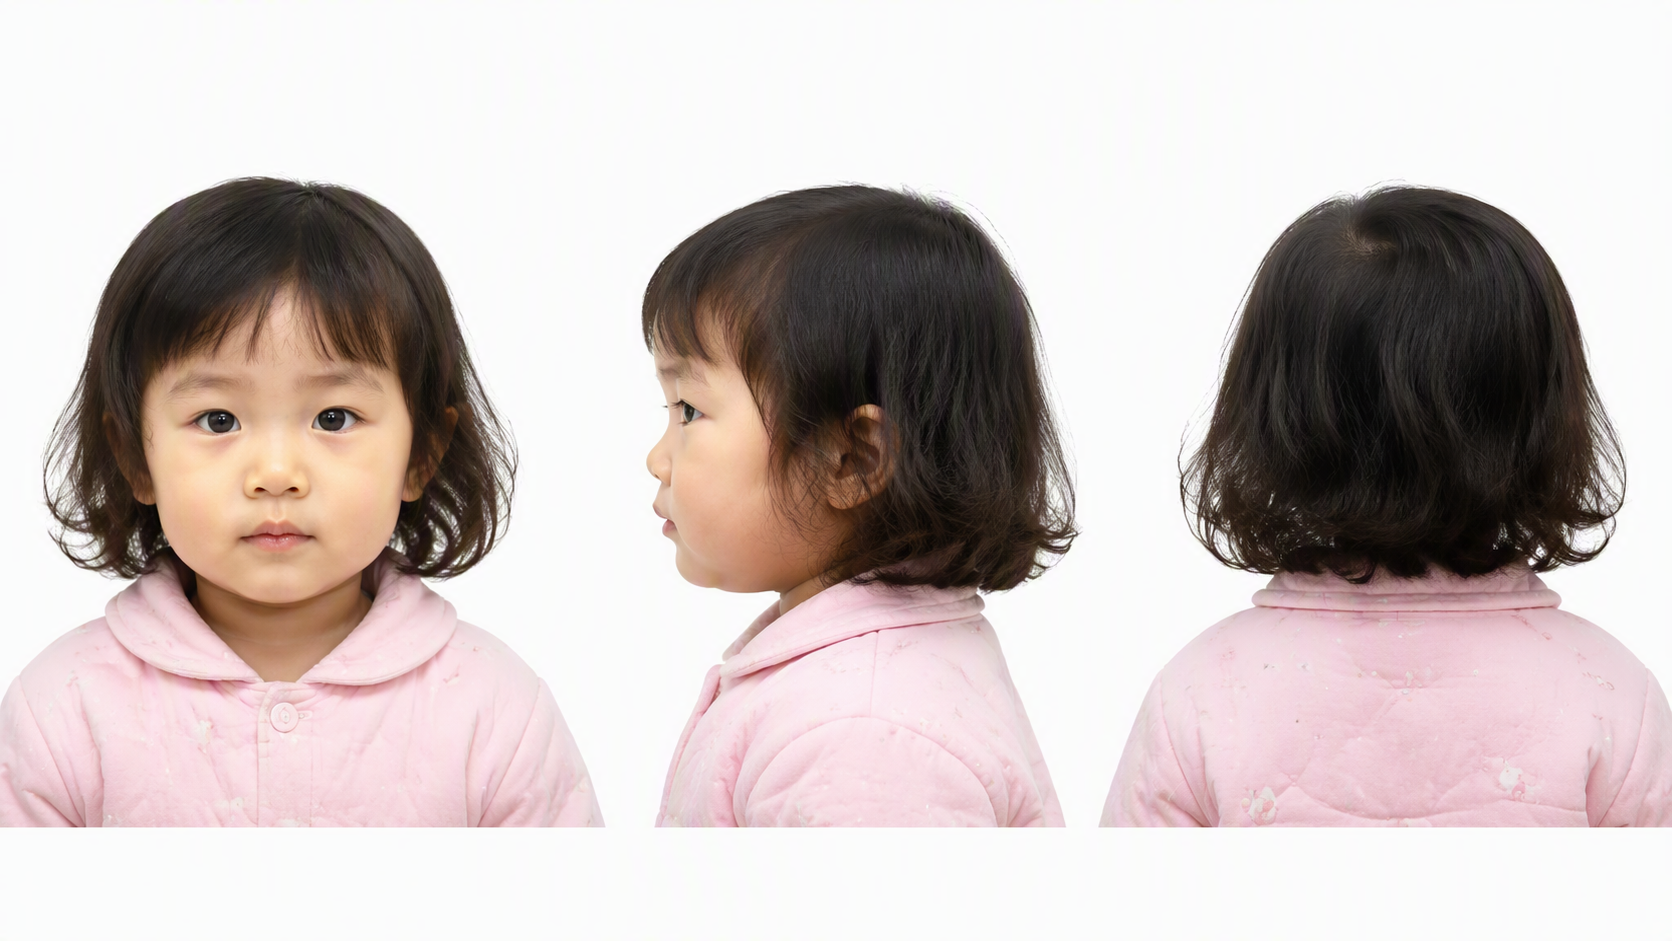
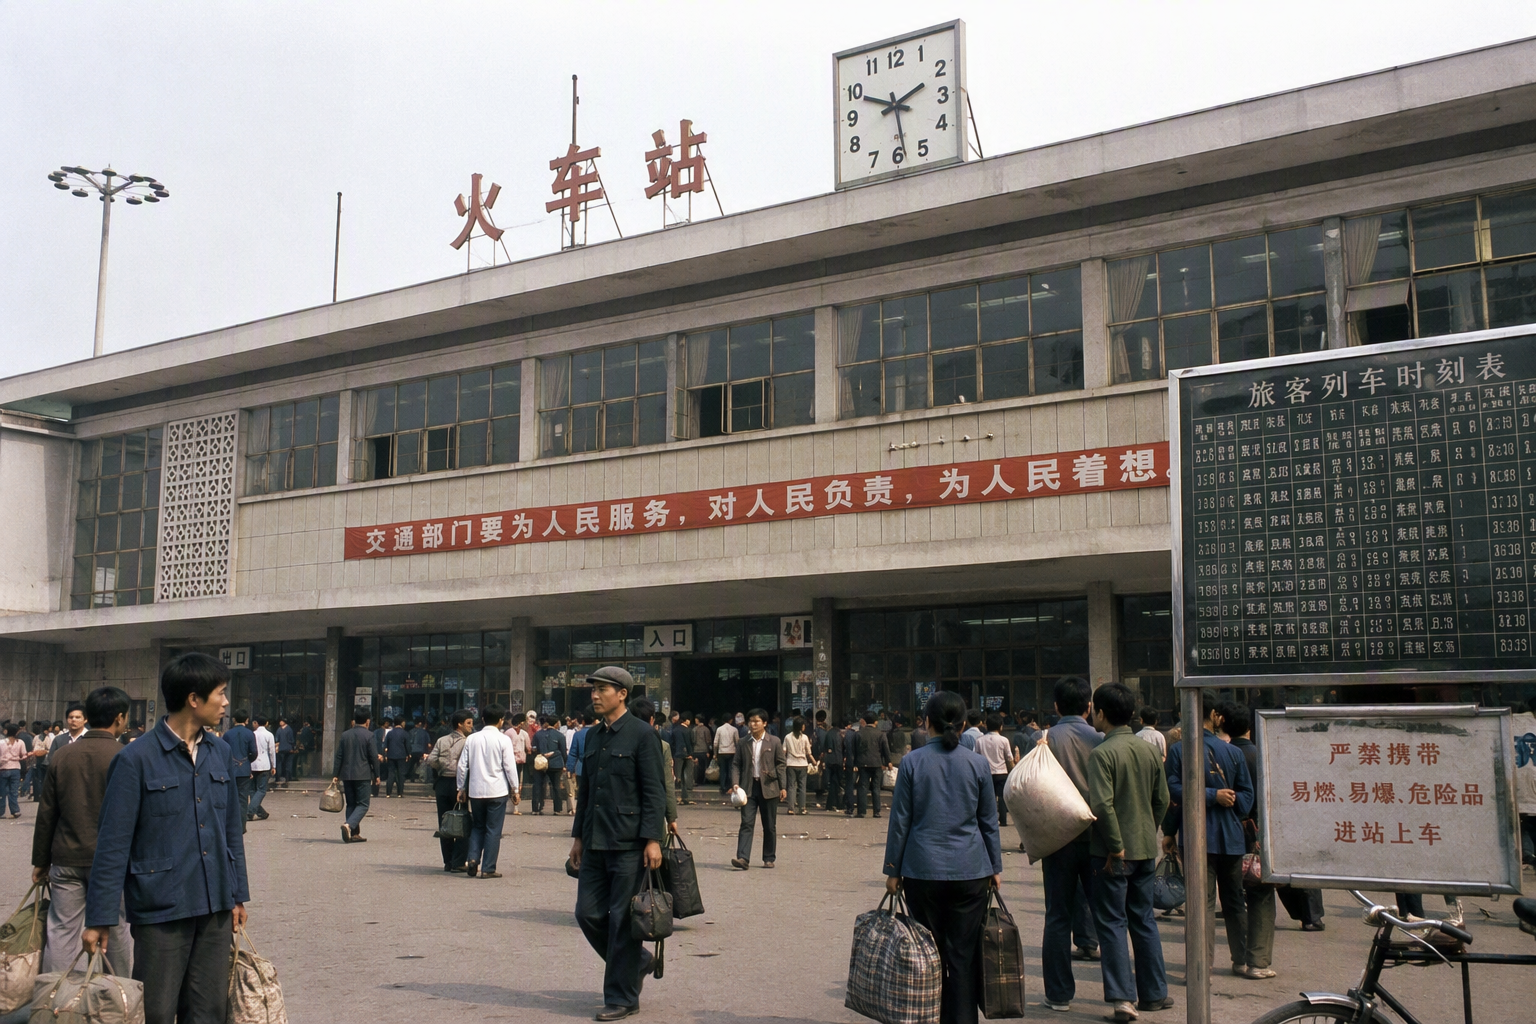
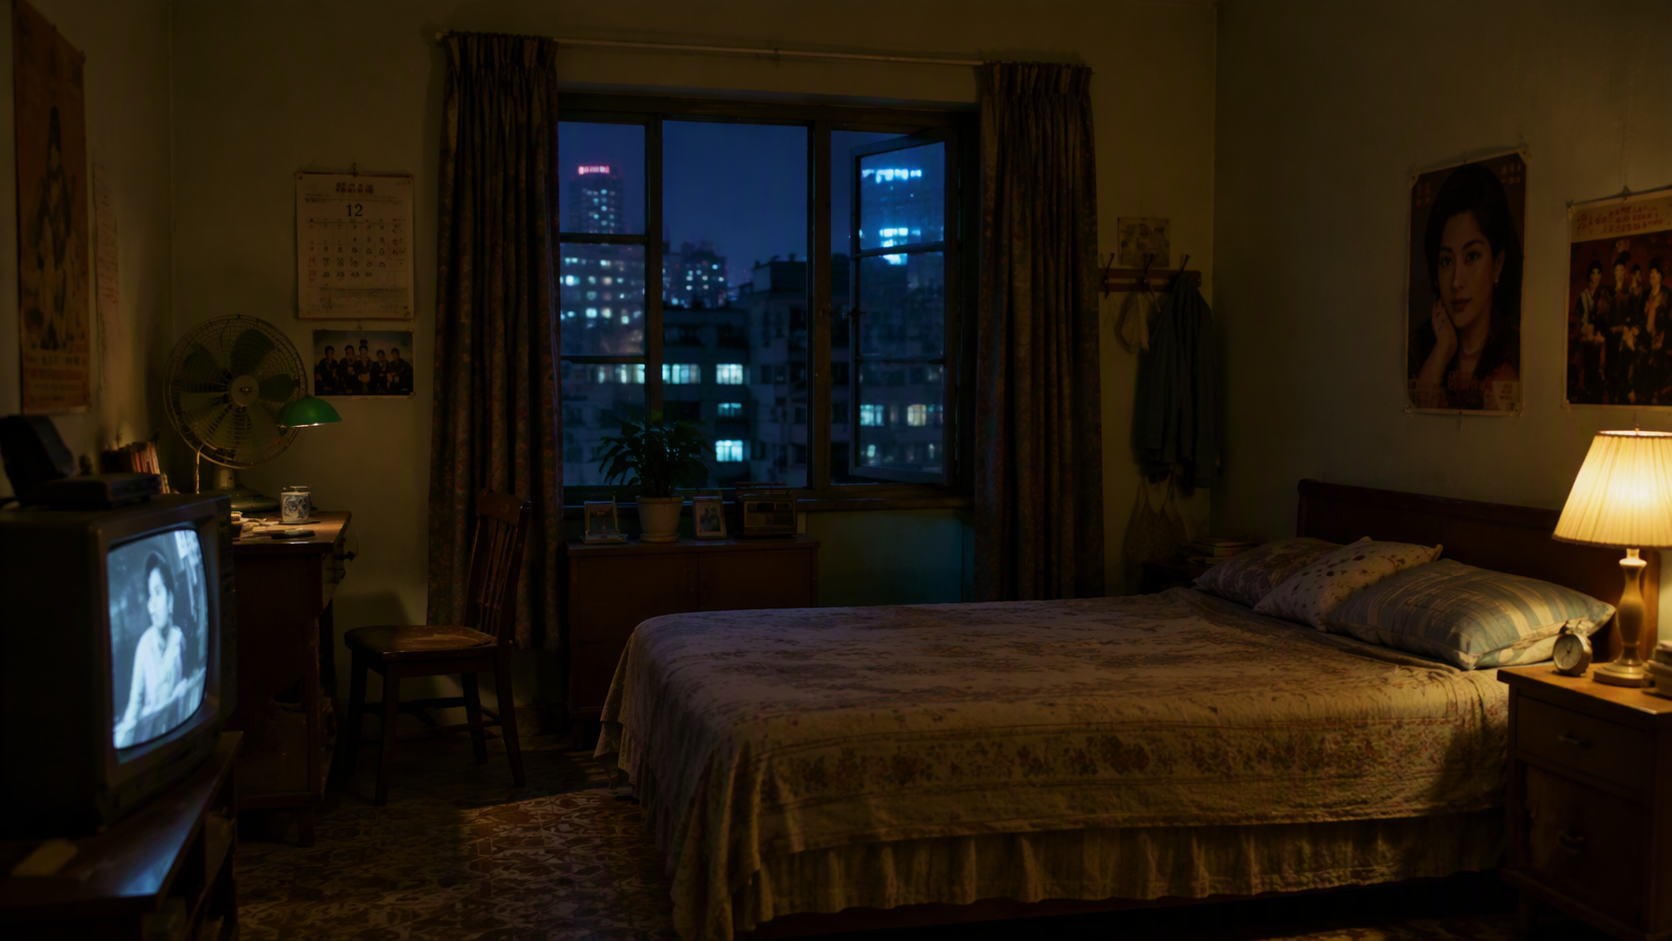
优化前提示词
【统一风格与约束】 真实材质质感,细腻光影;角色面部和身体比例稳定,肢体结构自然,动作连贯,不僵硬,无穿模,无卡顿,无扭曲肢体,动作符合现实物理逻辑;禁止生成同款分身、双胞胎效果,同一画面中仅保留单个对应角色,不出现角色重复复刻;无字幕,无水印,无 logo,无乱码,无无关文字;无多余背景音乐。
【参考素材】 将图片 3 中的角色定义为秦秀莲; 将图片 1 中的角色定义为刘春香; 将图片 2 中的角色定义为王强; 将图片 6 中的角色定义为小乐; 将图片 7 中的角色定义为小石头; 将图片 8 中的角色定义为二妞; 将图片 5 定义为县城火车站售票处的参考场景; 将图片 4 定义为刘春香家卧室的参考场景; 将纸质车票定义为去大城的火车票。
镜头 1|0 秒 - 2 秒
以人物为中心构图,近景,平视,正面机位,日、内,固定。 县城火车站售票处。 秦秀莲站在售票窗口前看向售票窗口。 秦秀莲说:“一张去大城的票。”
镜头 2|2 秒 - 4 秒
局部构图,特写,平视,正面机位,日、内,固定。 县城火车站售票处。 秦秀莲握紧去羊城的火车票,低头看向车票目的地,嘴唇闭合。 秦秀莲(V.O.)说:“刘春香能做,我也能做。”
镜头 3|4 秒 - 5 秒
三分法构图,中景,平视,斜 45 度侧面机位,夜、内,固定。 刘春香家卧室。 刘春香和王强坐在桌边清点当天收入。 刘春香看向桌上钱币,说:“七百多。”
镜头 4|5 秒 - 7 秒
以人物为中心构图,近景,平视,正面机位,夜、内,固定。 刘春香家卧室。 王强看向桌上钱币,说:“比开业那天还多。”
镜头 5|7 秒 - 9 秒
以人物为中心构图,近景,平视,正面机位,夜、内,固定。 刘春香家卧室。 小乐爬到刘春香身边,看向刘春香,说:“麻麻,我给你捶背!”
镜头 6|9 秒 - 10 秒
以人物为中心构图,近景,平视,正面机位,夜、内,固定。 刘春香家卧室。 小石头看向刘春香,说:“我也来。”
镜头 7|10 秒 - 11 秒
以人物为中心构图,近景,平视,正面机位,夜、内,固定。 刘春香家卧室。 二妞看向刘春香,说:“还有我!”
镜头 8|11 秒 - 13 秒
对称构图,中景,平视,侧面机位,夜、内,固定。 刘春香家卧室。 小乐、小石头、二妞围着刘春香捶肩捶背。 刘春香悄悄握住王强的手,王强反握刘春香的手。
优化后提示词
【统一风格与约束】 真实材质质感,细腻光影;角色面部和身体比例稳定,肢体结构自然,动作连贯,不僵硬,无穿模,无卡顿,无扭曲肢体,动作符合现实物理逻辑;禁止生成同款分身、双胞胎效果,同一画面中仅保留单个对应角色,不出现角色重复复刻;无字幕,无水印,无 logo,无乱码,无无关文字;无多余背景音乐。
【参考素材】 将图片 1 中的角色定义为秦秀莲; 将图片 3 中的角色定义为刘春香; 将图片 2 中的角色定义为王强; 将图片 4 中的角色定义为小乐; 将图片 5 中的角色定义为小石头; 将图片 6 中的角色定义为二妞; 将图片 7 定义为县城火车站售票处的参考场景; 将图片 8 定义为刘春香家卧室的参考场景; 将纸质车票定义为去大城的火车票。
镜头 1|0 秒 - 2 秒
以人物为中心构图,近景,平视,正面机位,日、内,固定。 县城火车站售票处。 秦秀莲站在售票窗口前看向售票窗口。 秦秀莲说:“一张去大城的票。”
镜头 2|2 秒 - 4 秒
局部构图,特写,平视,正面机位,日、内,固定。 县城火车站售票处。 秦秀莲握紧去羊城的火车票,低头看向车票目的地,嘴唇闭合。 秦秀莲(V.O.)说:“刘春香能做,我也能做。”
镜头 3|4 秒 - 5 秒
三分法构图,中景,平视,斜 45 度侧面机位,夜、内,固定。 刘春香家卧室。 刘春香和王强坐在桌边清点当天收入。 刘春香看向桌上钱币,说:“七百多。”
镜头 4|5 秒 - 7 秒
以人物为中心构图,近景,平视,正面机位,夜、内,固定。 刘春香家卧室。 王强看向桌上钱币,说:“比开业那天还多。”
镜头 5|7 秒 - 9 秒
以人物为中心构图,近景,平视,正面机位,夜、内,固定。 刘春香家卧室。 小乐爬到刘春香身边,看向刘春香,说:“麻麻,我给你捶背!”
镜头 6|9 秒 - 10 秒
以人物为中心构图,近景,平视,正面机位,夜、内,固定。 刘春香家卧室。 小石头看向刘春香,说:“我也来。”
镜头 7|10 秒 - 11 秒
以人物为中心构图,近景,平视,正面机位,夜、内,固定。 刘春香家卧室。 二妞看向刘春香,说:“还有我!”
镜头 8|11 秒 - 13 秒
对称构图,中景,平视,侧面机位,夜、内,固定。 刘春香家卧室。 小乐、小石头、二妞围着刘春香捶肩捶背。 刘春香悄悄握住王强的手,王强反握刘春香的手。
文字拼写错误
典型现象
画面中的文字出错:英文单词中的字母被替换、增加或缺失(高频如 E 误写为 A 或 I);中文出现错别字(如“稳健”误写为“稳便”)。
解决方案
- 将单词拆分为独立字母,并要求字母按顺序依次出现,降低模型联想与简化字形。
- 将需要准确展示的文字制成图片,作为参考素材提供给模型。
案例一:英文单词拼写错误
优化前 | 优化后 |
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
单词 DIHETAO 被错拼为 DIHERTAO | Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
拆分为独立字母并要求按顺序出现后拼写正确 |
示例提示词
案例一:英文单词拼写错误
将单词拆分为独立字母,并要求按顺序依次出现:
优化前提示词
Create an opening title sequence for a beetle game called 'DIHETAO'. The text should be white colored. There should be many beetles.
优化后提示词
Create an opening animation for a beetle-themed game. The text should be white, and the scene must feature a large number of beetles.Then, the letters "D", "I", "H", "E", "T", "A", and "O" should appear in sequence.
案例二:中文文案错别字
优化前 | 优化后 |
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
“稳健抓地”被错写为“稳便抓地” | Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
将展示文字制成图片作为参考素材后正确 |
示例提示词
案例二:中文文案错别字
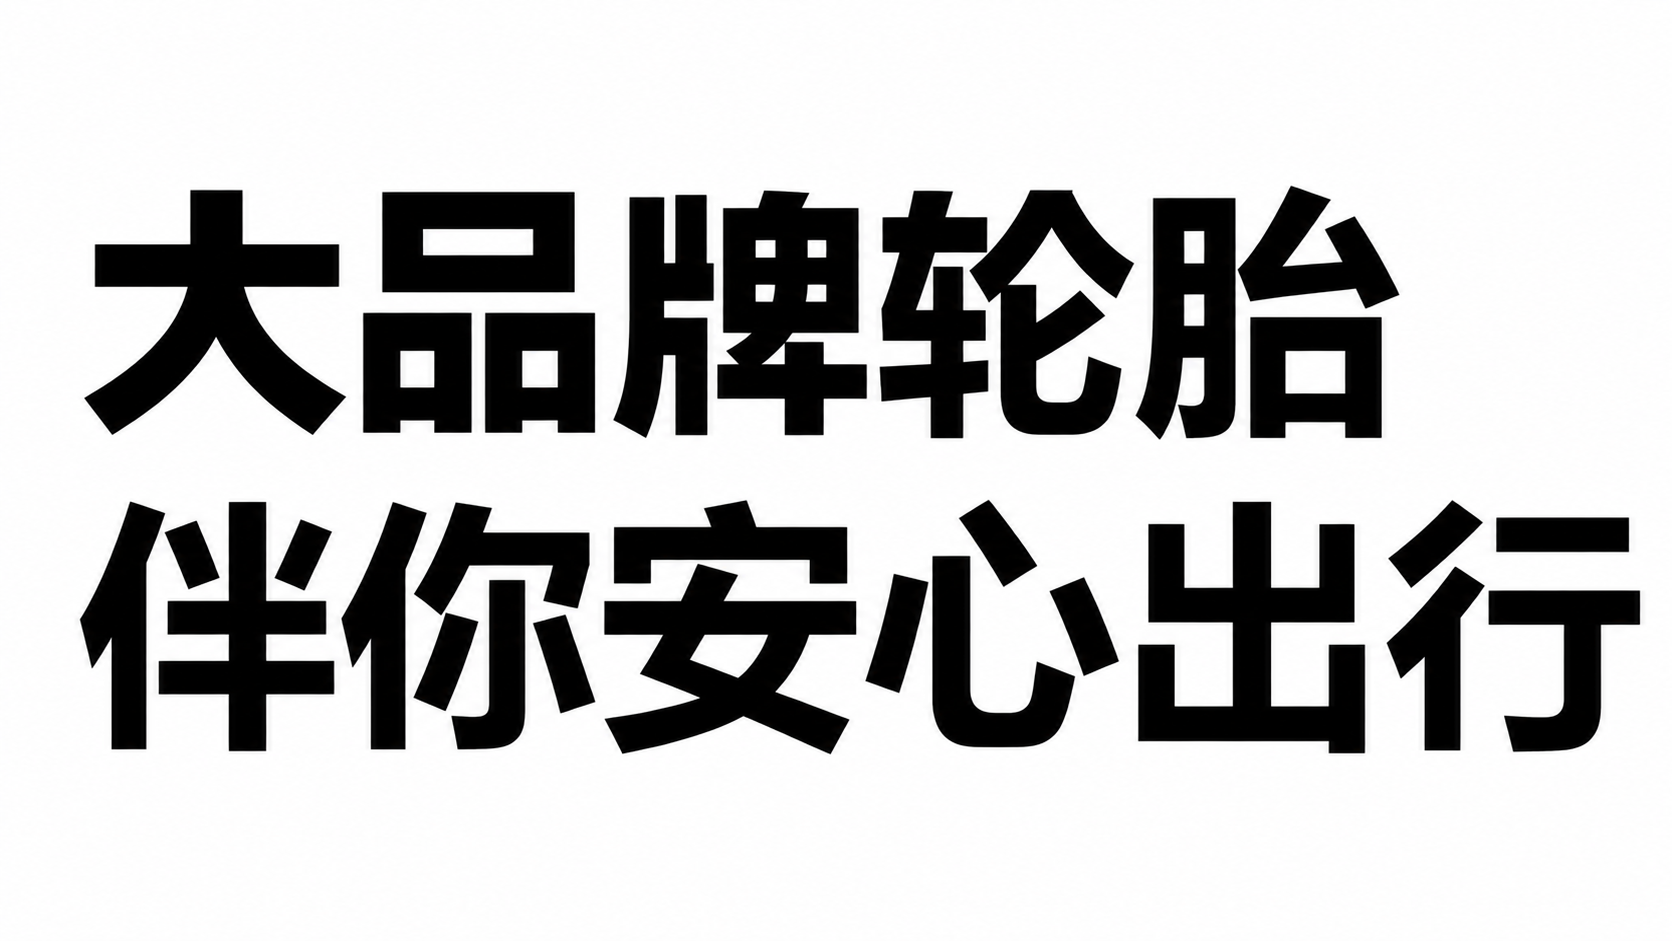
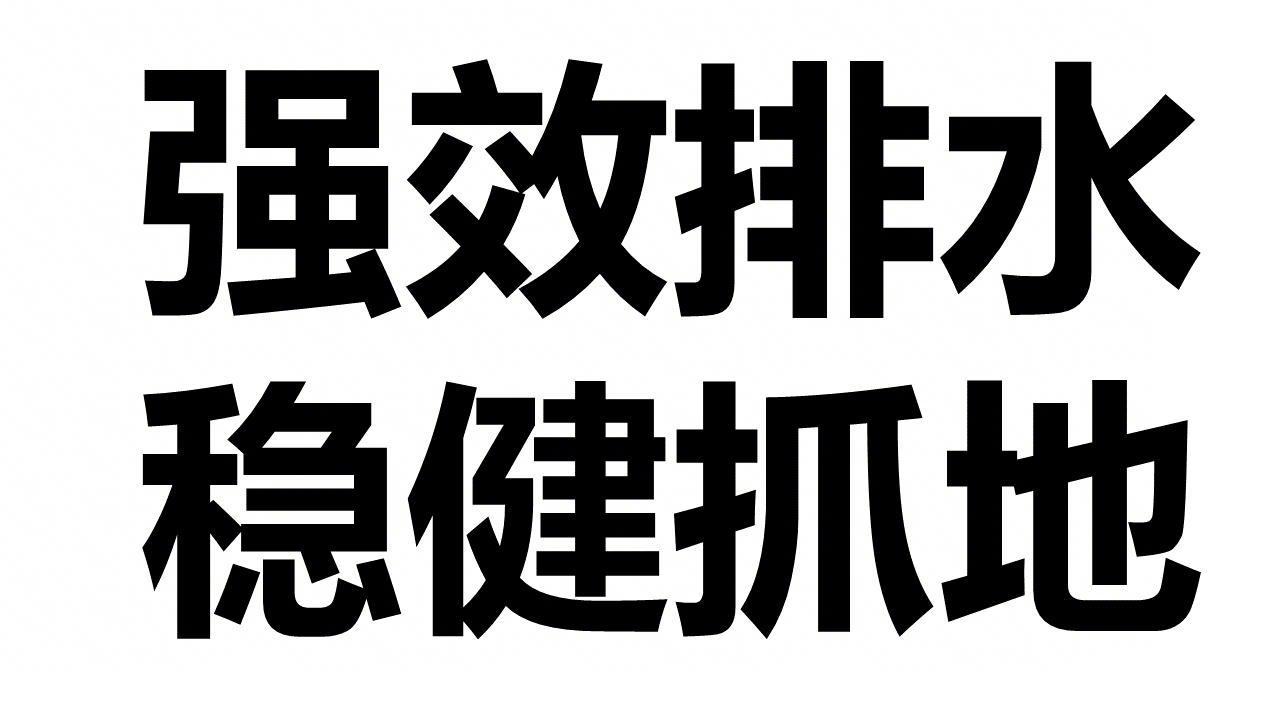
在画面文字描述后追加参考图片编号,将正确文字以图片形式提供给模型:
案例二使用的参考素材,从左至右为图片 1(商品图)与参考图 2-4(三处展示文字的正确文案):
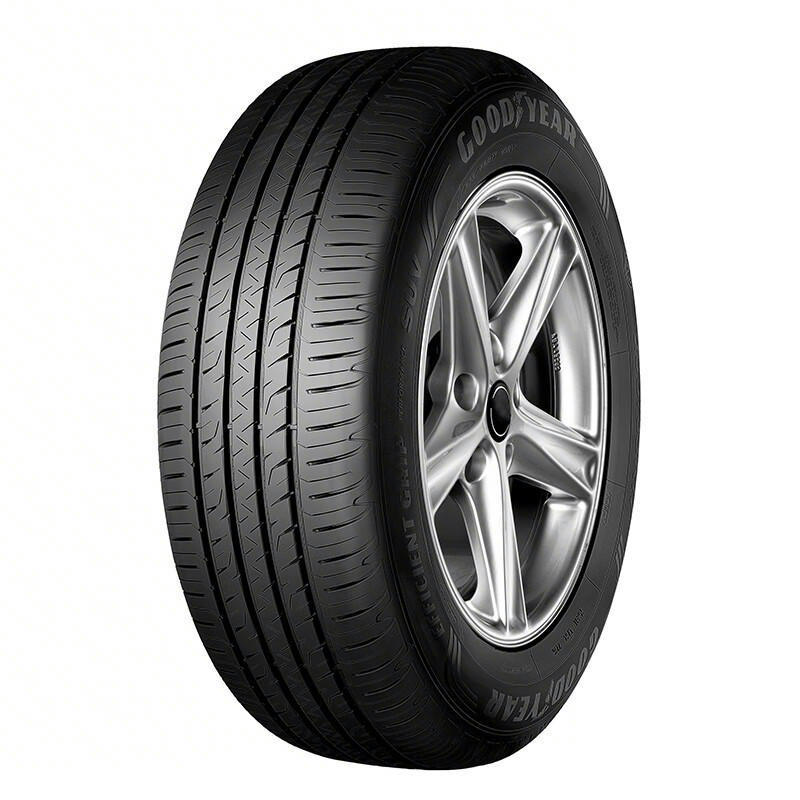
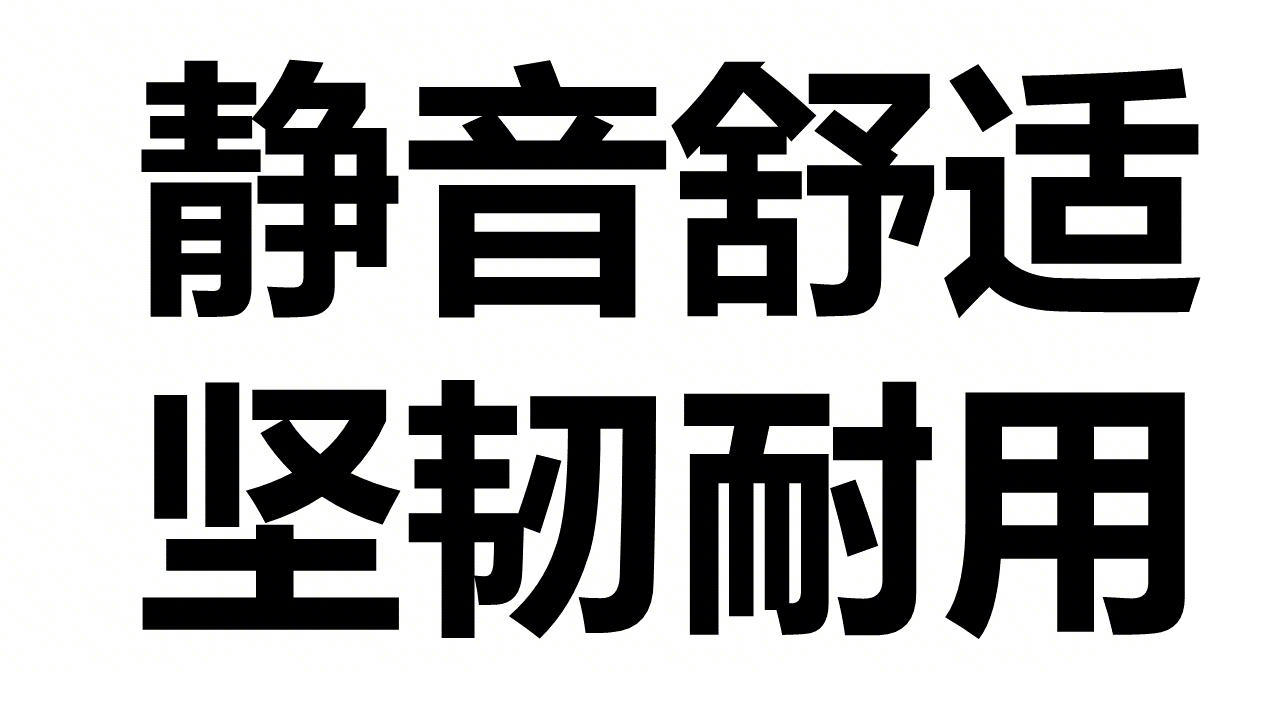
优化前提示词
为图1中的商品生成视频,由中国中年自然肤色黑色寸头日常户外风男模特出镜,手持商品进行动态展示与解说。镜头 1,镜头从中景缓慢推进至近景。阳光明媚的广阔户外公路旁,一位中国中年、自然肤色、黑色寸头、穿着日常户外冲锋衣的男模特,一手扶着立在地上的大品牌轮胎,面向镜头自信地进行解说。 男主播:“大品牌轮胎,伴你安心出行。” 背景音乐:节奏轻快的户外运动风纯音乐。 画面正下方显示粗体黑字“大品牌轮胎 伴你安心出行”镜头 2,镜头特写轮胎正面花纹。男模特的手指顺着轮胎上深深的纵向排水沟槽滑动,随后手掌有力地拍打胎面,动态展示轮胎清晰的纹理和扎实的质感。 男主播:“强效排水,稳健抓地。” 背景音乐持续,伴随轻微的摩擦音效。 画面左侧弹出黑体大字“强效排水 稳健抓地”镜头 3,镜头平移转至轮胎侧面特写。男模特用手掌按压轮胎侧壁展示其优良的韧性与弹性,随后手指指向侧面凸起的品牌标识区域。 男主播:“静音舒适,坚韧耐用。” 背景音乐持续。 画面右侧弹出黑体大字“静音舒适 坚韧耐用”镜头 4,镜头拉远回到中景。男模特双手扶住轮胎边缘,轻松地将其向前滚动半圈,随后站定,微笑着向镜头竖起大拇指,背景是充满活力的自然风光。 画外音:“你的安心之选。” 音乐高潮处有力收尾。 画面中央浮现黑体大字“伴你安心出行”
优化后提示词
为图1中的商品生成视频,由中国中年自然肤色黑色寸头日常户外风男模特出镜,手持商品进行动态展示与解说。镜头 1,镜头从中景缓慢推进至近景。阳光明媚的广阔户外公路旁,一位中国中年、自然肤色、黑色寸头、穿着日常户外冲锋衣的男模特,一手扶着立在地上的大品牌轮胎,面向镜头自信地进行解说。 男主播:“大品牌轮胎,伴你安心出行。” 背景音乐:节奏轻快的户外运动风纯音乐。 画面正下方显示粗体黑字“大品牌轮胎 伴你安心出行” 参考图2。镜头 2,镜头特写轮胎正面花纹。男模特的手指顺着轮胎上深深的纵向排水沟槽滑动,随后手掌有力地拍打胎面,动态展示轮胎清晰的纹理和扎实的质感。 男主播:“强效排水,稳健抓地。” 背景音乐持续,伴随轻微的摩擦音效。 画面左侧弹出黑体大字“强效排水 稳健抓地” 参考图3。镜头 3,镜头平移转至轮胎侧面特写。男模特用手掌按压轮胎侧壁展示其优良的韧性与弹性,随后手指指向侧面凸起的品牌标识区域。 男主播:“静音舒适,坚韧耐用。” 背景音乐持续。 画面右侧弹出黑体大字“静音舒适 坚韧耐用” 参考图4。镜头 4,镜头拉远回到中景。男模特双手扶住轮胎边缘,轻松地将其向前滚动半圈,随后站定,微笑着向镜头竖起大拇指,背景是充满活力的自然风光。 画外音:“你的安心之选。” 音乐高潮处有力收尾。 画面中央浮现黑体大字“伴你安心出行” 参考图2
字幕约束不生效
典型现象
提示词中已写明“不要字幕”,生成的视频仍可能出现字幕。相较 Seedance 2.0,该问题已明显优化,但仍有概率出现。
解决方案
说明
目前无法完全避免该问题,可通过以下方法降低字幕出现概率。
- 避免在台词后复述词语并追加语气、表情、动作等描述,此类描述容易诱发字幕生成。
- 需要对台词做差异化要求时,按“角色台词(情绪):内容”的格式拆分描述,例如:周女士台词(难以置信):“像……”;周女士台词(声音发颤):“太像了。”
- 确保参考视频本身不含字幕,否则“无字幕”指令可能失效。
案例一:台词复述引发字幕
优化前 | 优化后 |
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
台词后复述词语并追加语气描述,输出出现字幕 | Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
按“角色台词(情绪):内容”格式拆分描述后无字幕 |
示例提示词
案例一:台词复述引发字幕
案例一使用的参考素材,从左至右为图片 1(山神殿场景)、图片 2(林秀兰)、图片 3(周婆婆)、图片 4(人物参考):
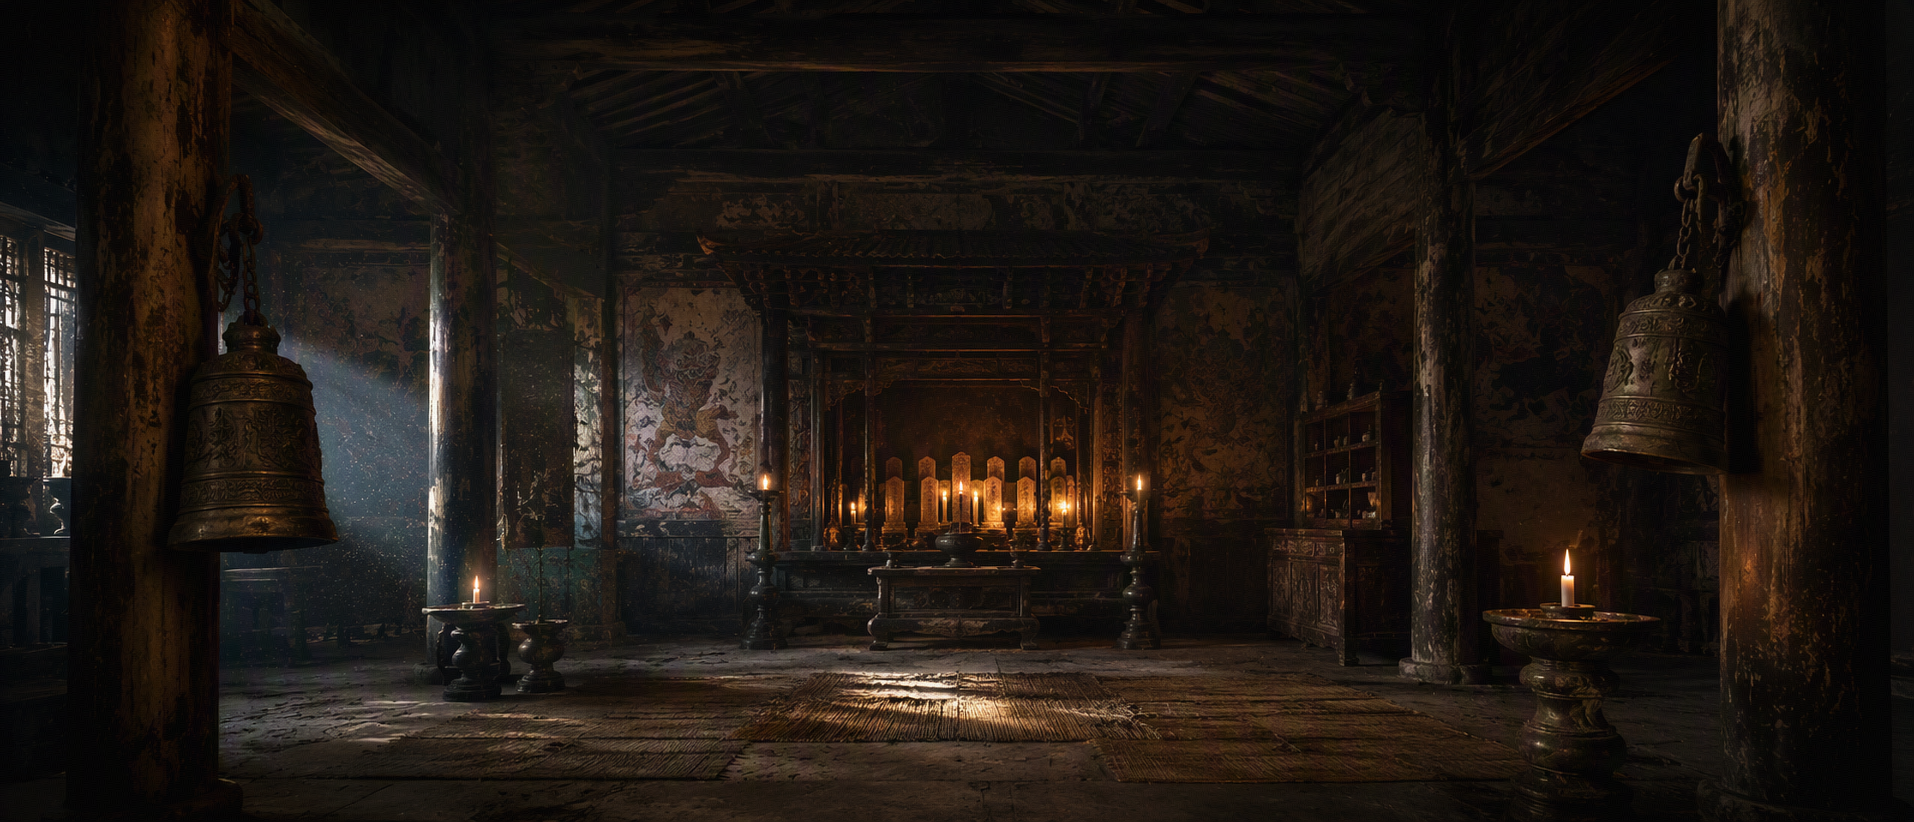
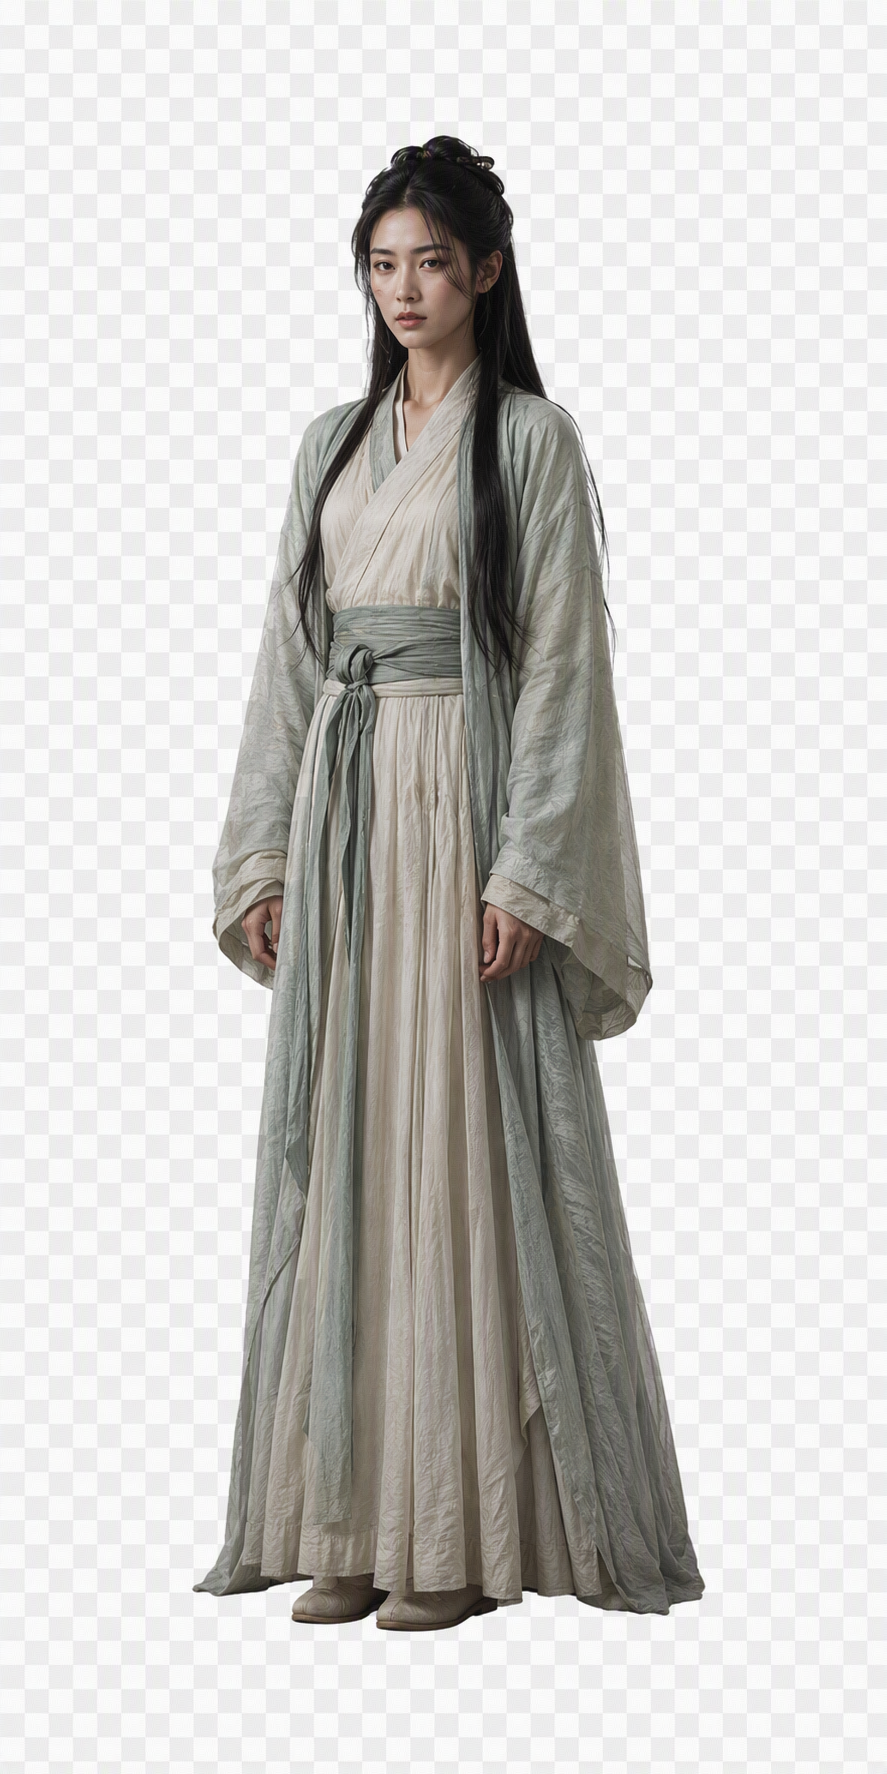
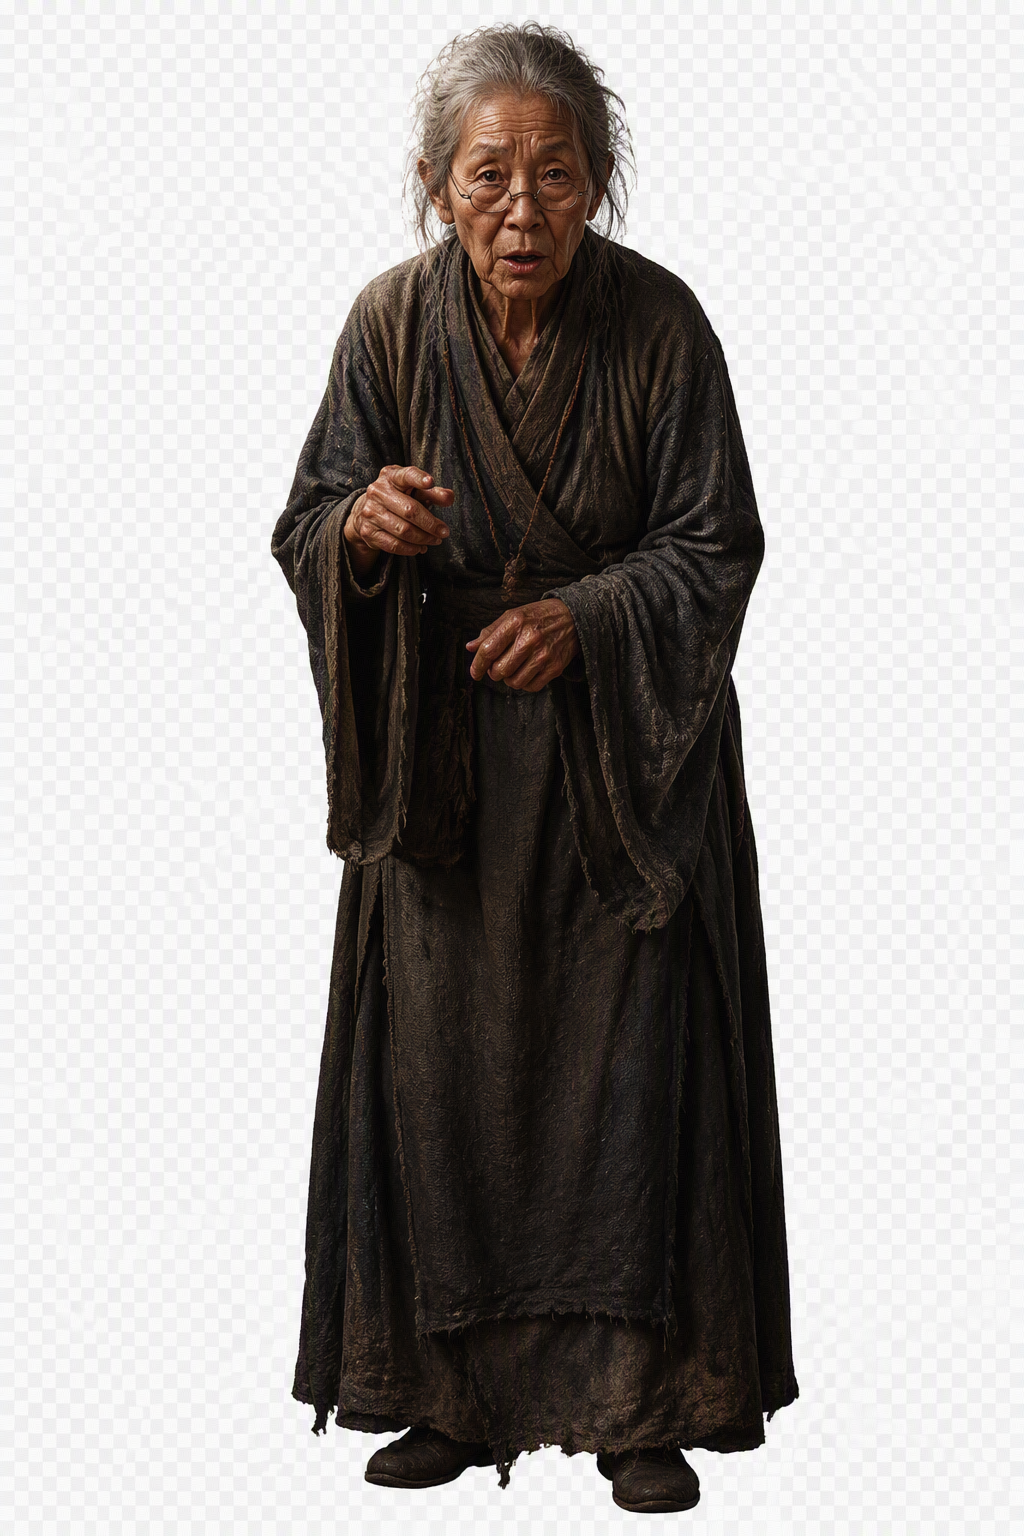
优化前提示词(台词后复述词语并追加情绪、动作描述,诱发字幕):
【生成目标】 生成周婆婆在山神殿内走近林秀兰、反复确认她的面容并激动落泪的连续场景。古装悬疑奇幻真人电影风格,电影级写实质感。昏暗古朴的山神殿内有陈旧木梁、旧神龛、烛台和祭祀陈设,暖色烛火轻轻摇曳,空气中漂浮细小尘埃。
【主体与关系】 全程只有林秀兰、周婆婆、春丫、石头四人。春丫与石头分别搀扶周婆婆左右两侧;林秀兰始终站在周婆婆前方。保持参考人物的脸型、年龄、发型、服装和身高关系。周婆婆始终佩戴同一副老花眼镜。
【资产锁定】 周婆婆严格参考@[图片3] 。 林秀兰严格参考@[图片2], 山神殿场景严格参考@[图片3] 。
【事件脚本】
0—4 秒:中景镜头围绕周婆婆缓慢向前推近。春丫与石头小心搀扶周婆婆起身,三人步履缓慢地走到林秀兰面前。周婆婆始终凝视林秀兰的脸;认出她后,脚步短暂停顿,嘴唇轻颤,双眼逐渐睁大,神情从震惊转为难以抑制的激动,仿佛见到等待多年的故人。林秀兰安静站立,困惑而警觉地回望她。结束时周婆婆在林秀兰面前站定,春丫和石头仍扶住她。
4—9 秒:切至周婆婆与林秀兰的面部近景。周婆婆先颤抖着扶正眼镜,再用一只手短暂揉一次自己的眼睛;确认没有看错后,她才伸出双手,轻轻捏住林秀兰两侧脸颊,缓慢左右拨看,再轻轻揉捏和拉扯确认。动作依次发生,不同时抢拍。手指准确接触脸颊,不遮挡眼睛、鼻子和嘴部。林秀兰被捏得轻微嘟嘴,露出错愕不解的神情,身体下意识稍稍后仰,但不挣扎、不躲开。周婆婆动作急切失态,却始终轻柔。结束时两人面部清晰可见,林秀兰的五官与脸型保持完整。
9—14 秒:镜头先切至周婆婆逐渐湿润的双眼,再平稳移至周婆婆与林秀兰的双人近景。周婆婆松开林秀兰的脸,双手轻微颤抖。周婆婆使用苍老沙哑、生涩蹩脚、带轻微异族口音但清晰可辨的普通话,在画内完整说一次:{像…… 太像了。终于等到你了,乡亲们有救了。} “像” 后短暂停顿,“太像了” 带着难以置信,“终于等到你了” 声音发颤,“乡亲们有救了” 充满如释重负的激动。最后一个字说完时,泪水从周婆婆眼中涌出,画面停留在她含泪而欣慰的神情上。林秀兰、春丫和石头全程自然闭口,只用眼神和表情回应。
【摄影与声音】 采用稳定、缓慢、克制的电影运镜。人物面部始终清晰,背景自然虚化;暖色烛光勾勒人物轮廓,幽暗山神殿保持空间层次。表演细腻真实,不过度夸张。 <烛火轻微燃烧声、衣料摩擦声和山神殿细微声响> 极轻的低沉弦乐铺底,不遮盖台词。 没有旁白,画面不显示字幕、文字或标牌。
【保持一致】 保持四名角色的身份、数量、外貌、服装、身高关系、空间方位和视线方向连续。老花眼镜始终正确佩戴,不漂浮、不消失。搀扶、停步、揉眼、捏脸、松手和说话严格按顺序衔接。手部结构正常,手指与脸颊接触准确;捏脸过程中林秀兰不换脸,五官位置和脸部结构保持稳定。
【排除内容】 排除卡通感、滑稽恶搞、现代物品、掌掴、推搡和粗暴动作;排除人物换脸、年龄或服装变化、身高突变、角色增减、空间位置跳变和动作顺序混乱;排除手掌穿模、多余手指、手指粘连、手部畸形、脸部塌陷、五官扭曲、眼镜漂浮或消失;排除错误人物发声、多人同时说话、重复台词、漏词、口型错位和声画不同步;排除快速剪辑、跳帧、剧烈抖动、画面闪烁、字幕、文字、标志和水印。
需要对不同台词做差异化要求时,按“角色台词(情绪):内容”的格式拆分描述:
周婆婆台词(难以置信):“像……”
周婆婆台词(声音发颤):“太像了。”
周婆婆台词(惊喜):“终于等到你了,乡亲们有救了。”
优化后提示词:
【生成目标】 生成周婆婆在山神殿内走近林秀兰、反复确认她的面容并激动落泪的连续场景。古装悬疑奇幻真人电影风格,电影级写实质感。昏暗古朴的山神殿内有陈旧木梁、旧神龛、烛台和祭祀陈设,暖色烛火轻轻摇曳,空气中漂浮细小尘埃。
【主体与关系】 全程只有林秀兰、周婆婆、春丫、石头四人。春丫与石头分别搀扶周婆婆左右两侧;林秀兰始终站在周婆婆前方。保持参考人物的脸型、年龄、发型、服装和身高关系。周婆婆始终佩戴同一副老花眼镜。
【资产锁定】 周婆婆严格参考@[图片3] 。 林秀兰严格参考@[图片2], 山神殿场景严格参考@[图片3] 。
【事件脚本】
0—4 秒:中景镜头围绕周婆婆缓慢向前推近。春丫与石头小心搀扶周婆婆起身,三人步履缓慢地走到林秀兰面前。周婆婆始终凝视林秀兰的脸;认出她后,脚步短暂停顿,嘴唇轻颤,双眼逐渐睁大,神情从震惊转为难以抑制的激动,仿佛见到等待多年的故人。林秀兰安静站立,困惑而警觉地回望她。结束时周婆婆在林秀兰面前站定,春丫和石头仍扶住她。
4—9 秒:切至周婆婆与林秀兰的面部近景。周婆婆先颤抖着扶正眼镜,再用一只手短暂揉一次自己的眼睛;确认没有看错后,她才伸出双手,轻轻捏住林秀兰两侧脸颊,缓慢左右拨看,再轻轻揉捏和拉扯确认。动作依次发生,不同时抢拍。手指准确接触脸颊,不遮挡眼睛、鼻子和嘴部。林秀兰被捏得轻微嘟嘴,露出错愕不解的神情,身体下意识稍稍后仰,但不挣扎、不躲开。周婆婆动作急切失态,却始终轻柔。结束时两人面部清晰可见,林秀兰的五官与脸型保持完整。
9—14 秒:镜头先切至周婆婆逐渐湿润的双眼,再平稳移至周婆婆与林秀兰的双人近景。周婆婆松开林秀兰的脸,双手轻微颤抖。周婆婆使用苍老沙哑、生涩蹩脚、带轻微异族口音但清晰可辨的普通话,周婆婆台词(难以置信):“像……“
周婆婆台词(声音发颤):“太像了。“
周婆婆台词(惊喜):“终于等到你了,乡亲们有救了。“最后一个字说完时,泪水从周婆婆眼中涌出,画面停留在她含泪而欣慰的神情上。林秀兰、春丫和石头全程自然闭口,只用眼神和表情回应。
【摄影与声音】 采用稳定、缓慢、克制的电影运镜。人物面部始终清晰,背景自然虚化;暖色烛光勾勒人物轮廓,幽暗山神殿保持空间层次。表演细腻真实,不过度夸张。 <烛火轻微燃烧声、衣料摩擦声和山神殿细微声响> 极轻的低沉弦乐铺底,不遮盖台词。 没有旁白,画面不显示字幕、文字或标牌。
【保持一致】 保持四名角色的身份、数量、外貌、服装、身高关系、空间方位和视线方向连续。老花眼镜始终正确佩戴,不漂浮、不消失。搀扶、停步、揉眼、捏脸、松手和说话严格按顺序衔接。手部结构正常,手指与脸颊接触准确;捏脸过程中林秀兰不换脸,五官位置和脸部结构保持稳定。
【排除内容】 排除卡通感、滑稽恶搞、现代物品、掌掴、推搡和粗暴动作;排除人物换脸、年龄或服装变化、身高突变、角色增减、空间位置跳变和动作顺序混乱;排除手掌穿模、多余手指、手指粘连、手部畸形、脸部塌陷、五官扭曲、眼镜漂浮或消失;排除错误人物发声、多人同时说话、重复台词、漏词、口型错位和声画不同步;排除快速剪辑、跳帧、剧烈抖动、画面闪烁、字幕、文字、标志和水印。
案例二:参考视频自带字幕
优化前 | 优化后 |
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
参考视频含字幕,输出跟随生成字幕 | Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
更换无字幕参考视频后输出正常 |
两版参考视频对比
含字幕的参考视频 | 去除字幕后的参考视频 |
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
案例二的原参考视频,自带字幕 | Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
去除字幕后的参考视频 |
示例提示词
案例二:参考视频自带字幕
续写任务的原始提示词如下。该案例的处理方式是更换无字幕的参考视频,提示词本身无改动:
风格:顶级3D国漫仙侠,超清细腻,水墨仙气光影,云海山门场景,动态微风拂动衣袂发丝,人物动作自然流畅,比例标准,电影级氛围感。
人物设定:清冷白衣女仙、黑衣少年修士,双人对峙站立山巅云台,云雾缭绕。
镜头:中景固定镜头,双人同框,构图均衡,仙气粒子浮动。
续写视频,全程无字幕禁止出现字幕。
镜头设计:
0-3秒:双人中景固定镜头延续。白衣女仙眉眼微冷,目光锁定黑衣少年,手中仙气逐渐凝聚。白衣女仙淡然轻语:“执迷不悟,只会送命。”
3-6秒:镜头轻微推进黑衣少年。黑衣少年黑发被风吹起,肩背灵剑,眼神坚定不退,周身浮现淡金色灵纹。黑衣少年沉声回应:“我命由我,不由天定!”
声音要求:
仅保留人物对白、轻风声、细碎仙气嗡鸣、剑鸣与灵光凝聚声。无背景音乐。
特殊格式 JPG 图片报错
典型现象
部分 JPG 图片在上传或处理时报错,提示图片解码失败(如 invalid image: heic: decode failed)。
根因分析
该类图片并非文件截断或数据损坏,而是采用了非常规、非对称的色度采样(如 Y 分量 2x2、Cb 分量 1x1、Cr 分量 2x1),超出了标准 JPEG 采样格式(4:2:0 / 4:2:2 / 4:4:4)的解码范围。
解决方案
使用 ffmpeg 将图片转为标准像素格式后重新上传:
ffmpeg -i test-jpg.jpg -pix_fmt yuvj420p fixed.jpg
或直接将图片转换为 PNG 等其他格式。
编辑前后时长不一致
典型现象
视频编辑任务的输出比原视频短约 0.33 秒。
解决方案
- 切换为参考生成模式并指定输出时长;该模式非严格编辑,内容可能有差异,但时长可精确控制。
- 保持编辑任务时,将输入视频的帧数调整为 8n+1(n 为正整数),输出时长即可与原视频保持一致。
方法一:切换为参考生成模式
输入视频 | 优化前(编辑输出) | 优化后(参考生成输出) |
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
任务输入视频 | Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
编辑输出比原视频短约 0.33 秒 | Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
参考生成模式下时长精确 |
方法二:将输入帧数调整为 8n+1
调整后的输入视频 | 编辑输出 |
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
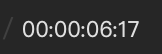
输入帧数调整为 161 帧(6 秒 17 帧) | Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
输出同为 6 秒 17 帧,时长一致 |
在剪辑软件中查看视频时间码的示例:
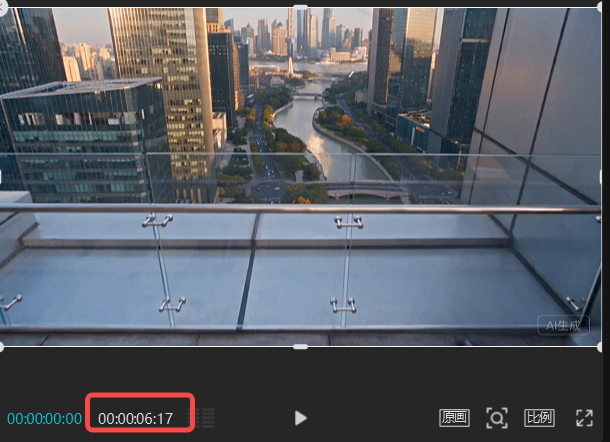
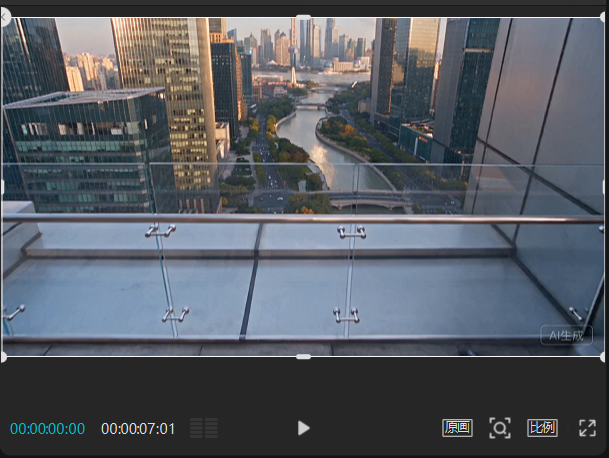
时间码放大细节:
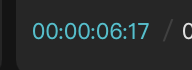
示例提示词
视频编辑任务的原始提示词:
这是视频编辑任务。请对视频进行视频编辑,仅修改指令明确要求改变的内容,其余主体、构图、时序和风格保持一致。编辑指令:编辑并且移除视频中的红色线条,红色数字,红色箭头。
复杂任务效果不稳定
典型现象
一次生成同时承担多项参考、编辑要求时,整体效果不稳定。
解决方案
将复杂任务拆解为多个简单任务,分多次生成或编辑完成,再通过后期剪辑整合。
优化前 | 优化后 |
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
一次生成承担全部复杂要求,输出出现红色轨迹线 | Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
拆解为参考任务与编辑任务后输出正常 |
任务拆解方式
将原始复杂任务拆解为两个简单任务依次完成:
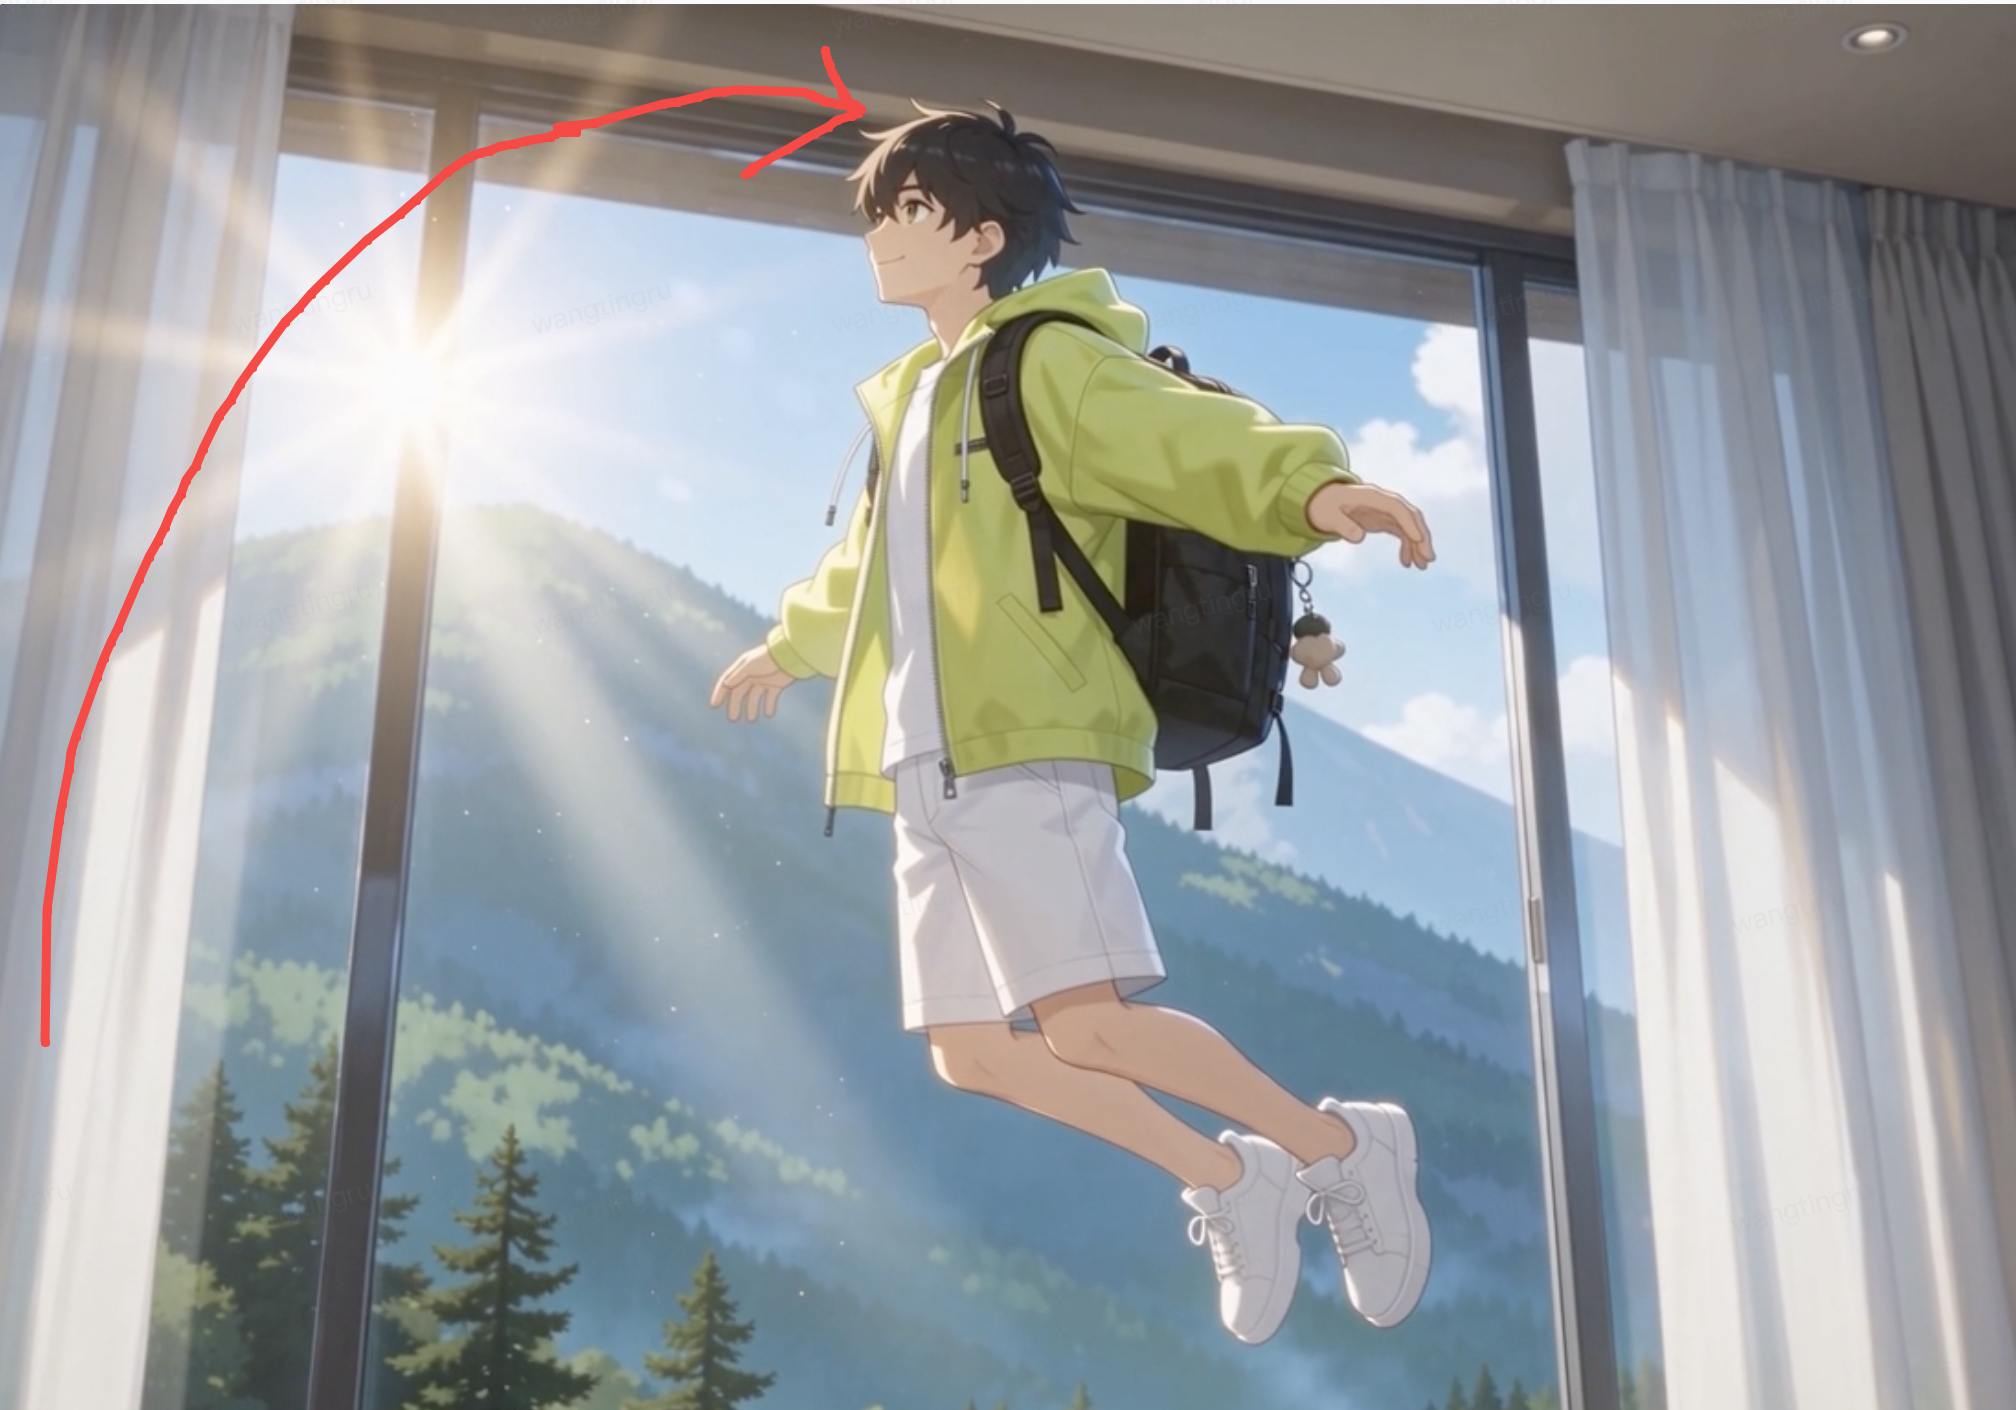
- 第 1 步 · 参考任务:输入带轨迹标注的图片素材,生成一段帽子沿轨迹飞行的动画(无需音频),作为第 2 步的参考素材。
- 第 2 步 · 编辑任务:编辑原输入视频,增加帽子飞到男子头上的效果;帽子的形态与飞行轨迹参考第 1 步生成的动画,其余画面保持不变。
第 1 步输入 | 第 1 步输出 | 第 2 步输入 | 第 2 步输出 |
 带轨迹标注的图片素材 | Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
参考任务生成的帽子飞行动画 | Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
待编辑的原视频(含红色轨迹标注),并以第 1 步的输出作为参考素材 | Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
编辑任务输出,完成帽子佩戴效果 |
示例提示词
原始任务提示词(一次生成同时承担多项要求):
编辑视频1,增加一个帽子沿图片1标注的轨迹飞到男子头上,红色轨迹不展示
拆解后的第 1 步参考任务提示词(生成帽子沿轨迹飞行的素材,不需要音频):
生成一段 5 秒的视频,一个帽子沿图片1标注的轨迹飞到男子头上,红色轨迹不展示
拆解后的第 2 步编辑任务提示词(帽子形态与轨迹参考第 1 步的输出):
编辑视频1,增加一个帽子飞到男子头上;帽子的形态和轨迹参考视频2中的帽子,其他保持不变
编辑宽高比效果差
典型现象
通过编辑改变宽高比时,模型为填充新画幅而生成额外画面,导致原画面内容或时序不一致。
解决方案
改用参考生成完成任务,并在提示词中补充具体剧情描述,强调逐帧、逐镜头的时序对应与画面内容完整性。
输入视频 | 优化前(编辑输出) | 优化后(参考生成输出) |
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
任务输入视频 | Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
编辑填充新画幅,画面内容与时序不一致 | Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
参考生成并补充剧情描述后内容一致 |
示例提示词
优化前的原始任务使用英文提示词,仅含时序约束,缺少具体剧情描述:
优化前提示词
Create a new video using @Video 1 as the strict visual and temporal reference. Follow the output dimensions and duration selected in the generation settings.
[Timeline Fidelity — Highest Priority]
Create a continuous one-to-one temporal correspondence with @Video 1 from the first frame through the final frame. Each output moment corresponds to the same moment in @Video 1 at the same playback speed.
Every source frame and every distinct shot is mandatory. Include all very brief shots, flash frames, inserts, reaction shots, transitional images, motion-blurred frames, whip pans, and sub-second visual events. Give each one its original screen time and its original position in the sequence.
Reproduce every cut and transition at its corresponding source moment. Maintain the exact shot order, cut frequency, transition style, action progression, and rhythm. Rapid passages retain all their individual shots as separate visible moments with full timeline coverage.
For every shot, preserve its opening state, intermediate motion trajectory, and closing state. Preserve every entrance, exit, gesture, pose, camera movement, occlusion, and lighting transition occurring between those states.
[Reference Content]
@Video 1 defines the complete scene, subjects, objects, actions, expressions, poses, spatial relationships, camera movement, lens behavior, focus, lighting, shadows, reflections, colors, textures, frame sequence, cuts, timing, motion, and audio.
Keep the complete original field of view visible within the output canvas with matching composition, geometry, perspective, subject scale, subject placement, camera path, motion speed, and audiovisual synchronization.
Every person, face, body, hand, garment, object, prop, surface, background element, text, logo, color, texture, shadow, reflection, motion blur, and occlusion remains consistent with @Video 1 throughout the sequence.
[Additional Canvas]
The additional canvas areas show a seamless continuation of the surroundings visible at the boundaries of @Video 1. Continue intersecting surfaces, objects, shadows, reflections, and environmental elements with matching geometry, depth, perspective, lighting, texture, focus, motion blur, camera movement, and parallax.
Maintain strict frame-to-frame continuity across the entire canvas. Static environmental details stay fixed in world space. Moving elements remain synchronized with the camera and scene motion in @Video 1.
The finished video contains the complete frame sequence, all rapid visual events, the same subjects and actions, the original audio, and the exact narrative and temporal order of @Video 1, presented on the newly selected canvas.
Shift + Enter 换行
优化后提示词(补充画面时间轴,强调逐帧、逐镜头的时序对应与画面内容完整性):
使用 @视频1 作为严格的视觉与时序参考,生成一段新视频。请遵循生成设置中选定的输出尺寸与时长。【时间线保真度——最高优先级】与 @视频1 建立从第一帧到最后一帧的完整一一对应关系,以相同播放速度在同一时刻对应同一画面。所有源帧和每个独立镜头都必须保留,包括所有极短镜头、闪帧、插入镜头、反应镜头、过渡画面、动态模糊帧、急速摇摄以及不足一秒的视觉事件。每个镜头保留原始时长及其在序列中的原始位置。在对应源时刻还原每一个剪切点与转场,保持精确的镜头顺序、剪切频率、转场风格、动作推进节奏和整体节律。快速段落保留所有单独可见的镜头,每个镜头均有完整的时间线覆盖。每个镜头均需保留其起始状态、中间运动轨迹及结束状态,包括起始状态与结束状态之间的所有入画、出画、手势、姿态、镜头运动、遮挡关系及光影过渡。【参考内容】@视频1 定义了完整的场景、主体、物件、动作、表情、姿态、空间关系、镜头运动、镜头特性、焦点、光照、阴影、反射、色彩、纹理、帧序列、剪切点、时序、运动及音频。在输出画布内保留完整的原始视野,保持构图、几何关系、透视关系、主体比例、主体位置、镜头路径、运动速度及视听同步一致。全片中,每一个人物、面部、身体、手部、服装、物件、道具、表面、背景元素、文字、Logo、色彩、纹理、阴影、反射、动态模糊及遮挡关系,均与 @视频1 保持一致。【扩展画布】扩展画布区域展示 @视频1 边界处可见环境的无缝延伸,以匹配的几何关系、景深、透视、光照、纹理、焦点、动态模糊、镜头运动和视差,延续交叉的表面、物件、阴影、反射及环境元素。整个画布逐帧保持严格的连续性。静态环境细节在世界空间中保持固定,运动元素与 @视频1 中的镜头及场景运动保持同步。最终视频包含完整帧序列、所有快速视觉事件、相同的主体与动作、原始音频,以及 @视频1 的精确叙事顺序与时序,呈现于新选定的画布上。画面的时间轴如下:【00:00–00:01】老虎面部极近特写,双眼直视镜头,眼神犀利深邃。画面采用双重曝光叠影效果,虎脸轮廓上叠加了波光粼粼的海浪影像。夕阳斜照,虎毛呈现温暖金橙色。【00:01–00:04】老虎在海滩上行走,全身近景。背景是翻滚的浅蓝色海浪和被晚霞染黄的天空,脚下是平坦潮湿的沙滩。老虎正对镜头稳健走来,步伐坚定有力,目光始终锁定前方。低角度拍摄,增强老虎的威严压迫感。【00:04–00:06】一只洁白海鸟(燕鸥/海鸥)在空中翱翔,背景是明亮蓝天与几朵白云。背随跟拍,镜头跟随海鸟飞行轨迹移动,展翅动作轻盈舒展。
画面出现指纹状纹理
典型现象
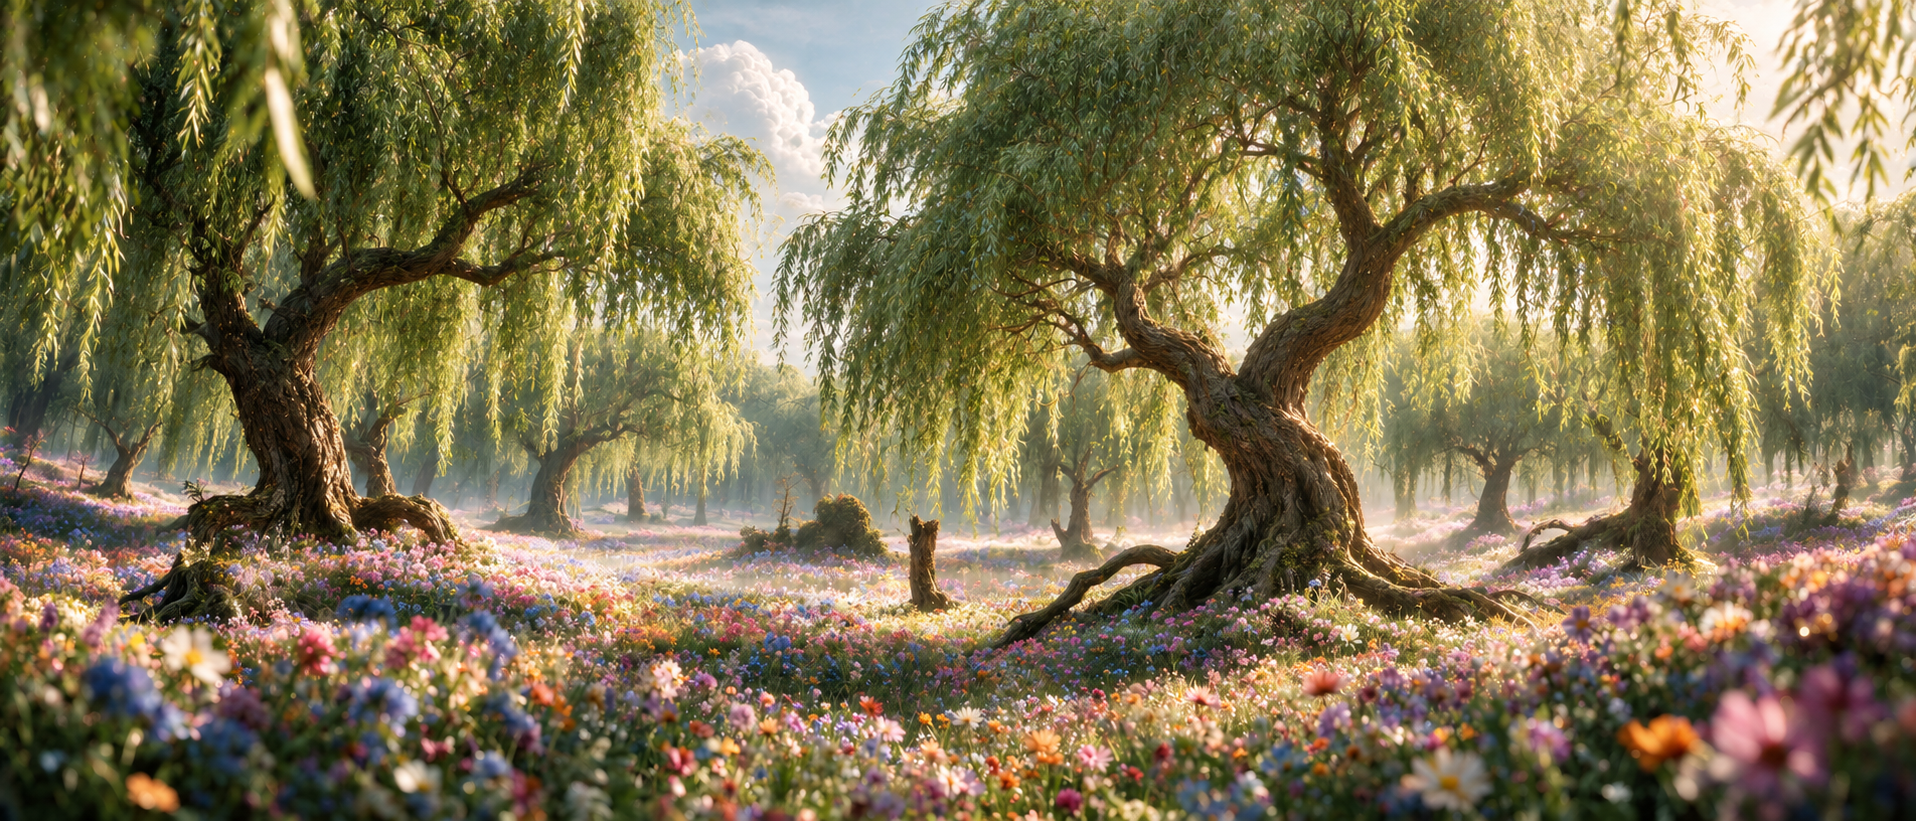
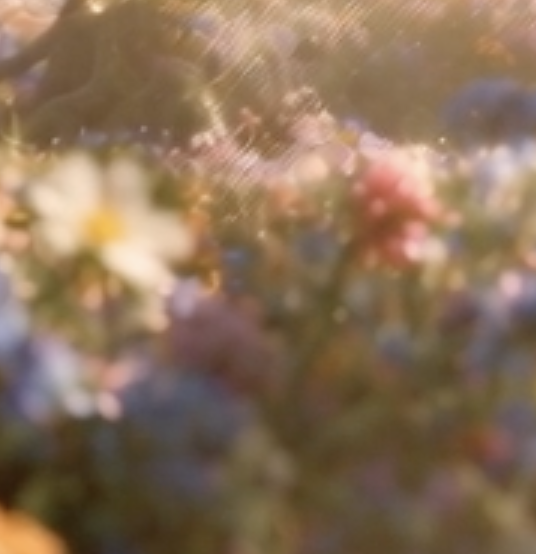
高分辨率 AI 生成图片作为参考素材时,草地、树叶等纹理密集区域可能出现指纹或鞋印状纹理。
解决方案
说明
该问题将在后续模型迭代中持续优化,当前可通过以下方法降低出现概率。
调整输入图片大小,使其不超过输出视频的分辨率。输出 1080p 时该问题的出现概率低于 720p。
案例使用的输入图片,从左至右为原始高分辨率参考图、指纹状纹理特写与调整分辨率后的参考图:
优化前 | 优化后 |
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
高分辨率参考图引发指纹状纹理 | Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
调整输入图片分辨率不超过输出分辨率后不再出现 |
背景音乐约束不生效
典型现象
提示词中已写明“禁止背景音乐”,部分特效音仍可能被生成为背景音乐。
解决方案
方案一:提示词约束
- 在提示词中明确“音频仅保留角色人声声源”“不产出任何音乐类音轨”,并一次性穷举音乐类同义词(音乐、背景音乐、BGM、配乐、器乐、旋律、合成器音效、氛围铺底音等),避免模型替换表述绕过约束。
- 将音频约束在提示词的开头与结尾各写一遍,强化模型注意力。
方案二:后期编辑
- 生成完成后,通过后期编辑分离出人声并移除非人声部分。注意:该方法会同时移除音效。
优化前 | 优化后(方案一:提示词约束) | 优化后(方案二:后期编辑) |
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
已写明禁止背景音乐,特效音仍被生成为背景音乐 | Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
穷举音乐类同义词并在提示词首尾重复音频约束,仅保留角色人声 | Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
后期分离人声并移除非人声部分(含音效) |
示例提示词
示例为方案一的英文提示词。优化后在提示词开头增加音频策略约束段,穷举音乐类同义词,并在镜头之间补充音频说明,实现首尾双重强调:
优化前提示词
No background music. (0s – 5s) | 5s Visual: <Lina> (a young child with soft, short black hair and round, dark brown eyes, wearing light blue one-piece pajamas) lies on her side on a blanket in front of an old wooden cabin's porch; she breathes gently, gazing into the distance with half-open eyes. <Pip> (a small, cream-colored lop-eared rabbit with a pinkish nose and ears resting softly against its sides) lies quietly in her arms, its nose twitching gently. The scene is set outside a quiet country cabin just as night falls; scattered fireflies blink slowly amidst the grass. Shot using a low-angle, wide-angle static shot aligned with the eye level of the child and rabbit; the camera is completely still. Cool blue moonlight serves as the key light, while soft, warm yellow light spills from the cabin window; the porch floorboards catch a faint amber reflection, and the surrounding grass appears deep green. The atmosphere is quiet, gentle, and slightly dreamlike. Dialogue: None.
(5s – 10s) | 5s Visual: <Lina> is now dressed in a white short-sleeved top, light purple overalls, and beige canvas shoes; she slowly sits up and points a finger at a particularly bright firefly in the grass. <Pip> lifts its head, long ears drooping gently, and follows the direction of her finger with its shiny black eyes. Both remain on the blanket by the cabin porch. A low-angle medium close-up shot; the camera performs a restrained, steady, and slow zoom-in on their faces. Cool-toned moonlight outlines their silhouettes, while warm yellow window light gently illuminates <Lina>’s cheek and <Pip>’s fur; the green glow of fireflies flickers faintly in the foreground. The atmosphere is serene and intimate. Dialogue: <Lina> speaks in natural American English, using a young, soft, and curious child's voice: {It’s showing us the way. }
(10s – 14s) | 4s Visual: The frame is filled with the depths of a grassy area; dozens of fireflies flutter slowly, their flickering points of light loosely tracing a winding path toward the indistinct silhouettes of trees bathed in moonlight in the distance. There are no human figures in the shot. Low-angle POV (close to the blades of grass), static shot, stationary camera. The color palette is dominated by a deep blue night sky and dark green grass, with the fireflies emitting a soft yellow-green glow, creating an atmosphere that is quiet, mysterious, and evocative of childhood fantasy. Dialogue/Audio: No dialogue, no background music.
优化后提示词
Audio policy (applies to ALL shots): the soundtrack contains ONLY the specified spoken dialogue plus faint natural night ambience at a low, constant level. Absolute silence otherwise. No music, no BGM, no score, no instrumental, no melody, no soundtrack, no synth, no ambient pad, no drone, no swelling tone, no crescendo, no musical build or stinger at any moment — especially not at any reveal or when the camera looks up.
(0s – 5s) | 5s Visual: <Lina> (a young child with soft, short black hair and round, dark brown eyes, wearing light blue one-piece pajamas) lies on her side on a blanket in front of the porch of an old wooden cabin; she breathes gently, gazing into the distance with half-open eyes. <Pip> (a small, cream-colored lop-eared rabbit with a pinkish nose and ears resting softly against its sides) lies quietly in her arms, its nose twitching slightly. The scene is set outside a quiet wooden cabin in the countryside just after nightfall; scattered fireflies blink slowly amidst the grass. A low-angle, wide-angle static shot aligns with the eye level of the child and rabbit; the camera remains completely still. Cool blue moonlight serves as the key light, while soft, warm yellow light spills from the cabin windows; the porch floorboards catch a faint amber reflection, and the surrounding grass appears deep green. The atmosphere is quiet, tender, and slightly dreamlike. Dialogue: None.
Audio: faint crickets and light wind only, low constant level. No music, no score, no rising tone of any kind.
(5s – 10s) | 5s Visual: <Lina> is now dressed in a white short-sleeved top, light purple overalls, and beige canvas shoes; she slowly sits up and points a finger at a particularly bright firefly in the grass. <Pip> lifts its head, its long ears drooping gently, and gazes in the direction of her finger with bright, dark eyes. (10s – 14s) | 4s Shot: The frame is filled with tall grass; dozens of fireflies drift slowly, their flickering lights loosely tracing a winding path toward the indistinct silhouettes of trees in the distance under the moonlight. No characters are visible—a low-angle POV shot close to the blades of grass, static camera. The color palette is dominated by the deep blue of the night sky and the dark green of the grass, with the fireflies emitting a soft yellow-green glow, creating an atmosphere of quiet mystery and childhood wonder. Dialogue: None; no background music.
Audio: ONLY faint crickets and light wind at a low constant level, unchanged from the previous shots. Absolute silence otherwise. No music, no score, no swelling tone, no rising pad, no synth, no ambient drone, no crescendo, no musical build at the reveal.
音频翻译语种混淆
典型现象
多角色视频翻译后仍残留原语言、角色声线串位,或目标语言口型不准确。
解决方案
- 在提示词中明确所有角色(含背景中可辨识的对白、低语、感叹词与语气词)都必须翻译为目标语言,不得遗漏。
- 按角色提供完整的目标语言台词及时间轴。
- 要求逐字同步口型,并明确验收标准:全片无可辨识的原语言残留、无字幕、口型与台词精准同步;除语言与口型外,其余画面与声音内容保持不变。
翻译任务的输入视频 | 优化前 | 优化后 |
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
多角色原语言视频 | Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
翻译后残留原语言、角色声线串位 | Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
按角色提供完整台词与时间轴后正常 |
示例提示词
优化前提示词(仅笼统要求翻译,未提供目标语言台词与时间轴):
将视频中的配音翻译成中文,口型做出对应的精准改变,其余均保持不变。要求:禁止出现韩文和中文字幕
优化后提示词(明确所有角色必须翻译、无字幕,并按角色提供完整中文台词与时间轴):
将视频中@视频1的所有人声台词(包括男性和女性的台词),所有台词都要翻译成中文,无字幕,口型做出对应的精准改变,其余均保持不变。请对原视频进行中文配音与精准口型重制。核心要求:1. 完整识别并替换视频中的所有韩语人声,包括男性、女性以及背景中可辨识的对白、低语、感叹词和语气词,不得遗漏任何一句。2. 所有韩语台词必须全部改为中文普通话。最终视频中禁止出现任何韩语语音、韩语文字或韩语字幕,也不得保留原韩语人声作为背景音。3. 严格按照原视频中每位人物的说话顺序、起止时间、情绪、语气、停顿和音量进行中文配音;男女角色必须与原人物对应,不得串角色。4. 根据中文台词逐字调整人物口型,使嘴部动作与中文发音、节奏和台词时长精准同步,避免口型提前、延迟、错位或仍匹配韩语发音。5. 不添加任何字幕、标题、贴纸或文字。6. 除人声语言和对应口型外,其他内容必须保持不变,包括人物身份、表情、动作、服装、场景、镜头、构图、画面风格、时长、帧率、环境音、背景音乐及音效。7. 若实际韩语对白与下方时间轴存在细微差异,以原视频的完整对白为准,但中文含义和角色关系必须与参考译文一致;不得因时间轴不完整而保留韩语。8. 输出前逐段检查:确保全部人声均已转换为中文,韩语残留为零,且全程无字幕。中文台词及时间轴:00:05–00:09 女生:那今天晚饭,要不要去吃你最喜欢的炸鸡?
00:16–00:21 男生:比起炸鸡……我更喜欢像这样和你一起喝咖啡的时间。
00:23–00:24 女生:噢……最终验收标准:全片所有可辨识台词均为中文普通话;不含任何韩语语音或韩语文字;无字幕;中文口型准确同步;其他画面与声音元素不变。
音频出现水波纹噪声
典型现象
生成的音频中出现预期外的冒水泡声、回音或较弱啸叫等噪声。
解决方案
说明
该问题将在后续模型迭代中持续优化,当前可通过以下方法降低出现概率。
移除提示词中与水、波浪、回音相关的描述,可降低噪声出现概率。
优化前 | 优化后 |
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
音频出现水波纹噪声 | Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
移除提示词中水、波浪、回音相关描述后噪声减少 |
提示词案例
参考生视频
白模参考/渲染
粗粒度白模
- 支持输入含有运动、运镜、动线和光照等动态/时序信息的白模视频进行渲染;还支持叠加输入主体、场景和道具等参考图控制渲染效果。
- 当前版本对于简单建模的参考效果较好,建议仅用简单几何体拼接表示人物/物体/动物等。
说明
白模视频主体建议仅保留躯体,避免包含【四肢/翅膀】等涉及精细运动的元素;如已包含,需补全其动作序列,以防止渲染结果出现四肢僵化。
白模类型:含切镜/运镜/光照
输入:文本
prompt:以白模参考视频 <video1> 作为整支视频唯一的运镜、镜头节奏、景别变化、主体运动轨迹和镜头调度参考,严格保持白模视频的镜头顺序、机位变化、运动方式和节奏,不改变镜头结构,不新增镜头,不改变主体运动逻辑。结合各阶段关键帧参考图,生成一部 30 秒电影级 3D 动画短片,整体风格梦幻、童话、温暖,具有儿童幻想色彩,角色外形与各阶段的关键帧保持一致,不要改变角色形象,人物表情情绪随场景变化而改变。
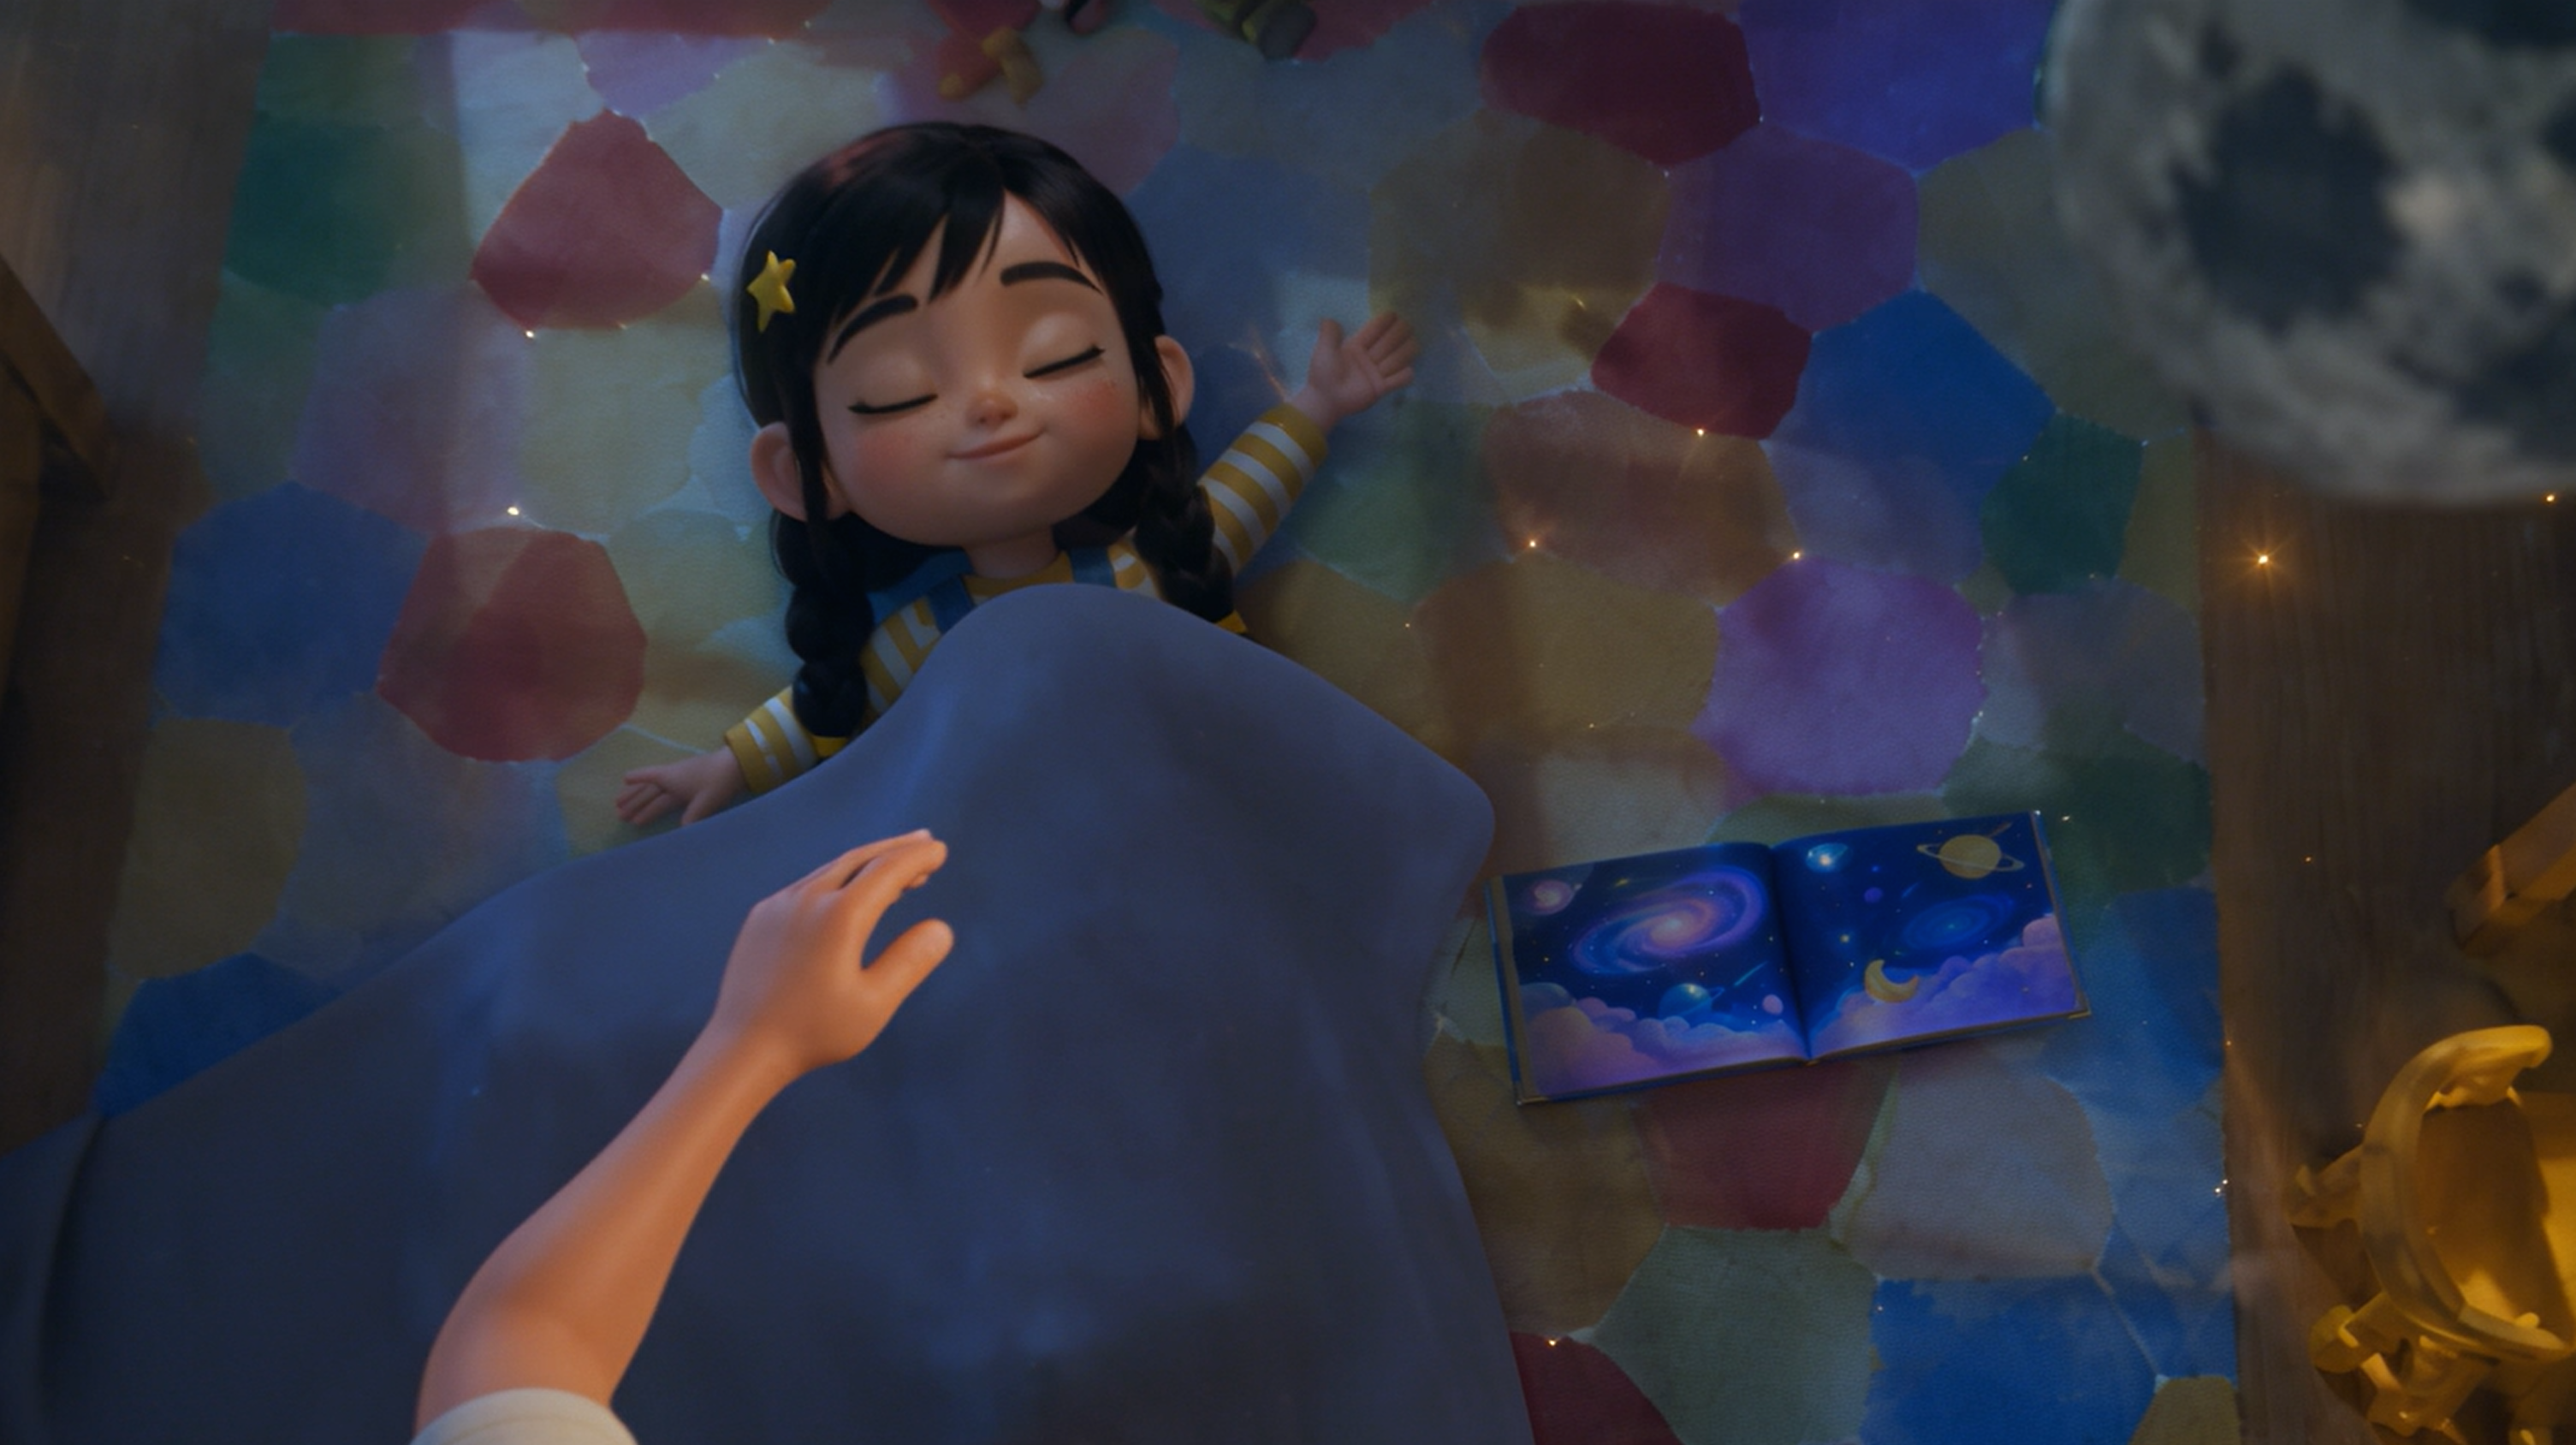
- 0-3s(首帧参考 <2pic>)镜头由全景俯视缓缓推向地上的小女孩,小女孩坐在房间的地毯上玩飞机,小女孩起身左转,右手使劲一挥将手里的飞机放飞。
- 3-5s(参考 <3pic>)飞机从左至右穿过房间悬挂的星星挂件,小女孩乘坐飞机进入幻想的天空。
- 5-8s(参考 <4pic>)镜头继续侧跟,以小女孩为中心的环绕。
- 8-10s(参考 <5pic>)镜头环绕到小女孩驾驶的飞机背面、飞机开始缓缓俯冲海面。
- 10-19s(参考 <6pic>、参考 <7pic>)小女孩继续向海底游去,一条鳐鱼游过来入画。
- 19-23s(参考 <8pic>)小女孩从时空裂缝冲出来到幻想宇宙。
- 23-24s(参考 <9pic>)前景小女孩和星球开始前翻转并,逐渐幻化消失。
- 24-28s(参考 <9pic>)俯视镜头持续推进,小女孩躺在地的毯上熟睡。
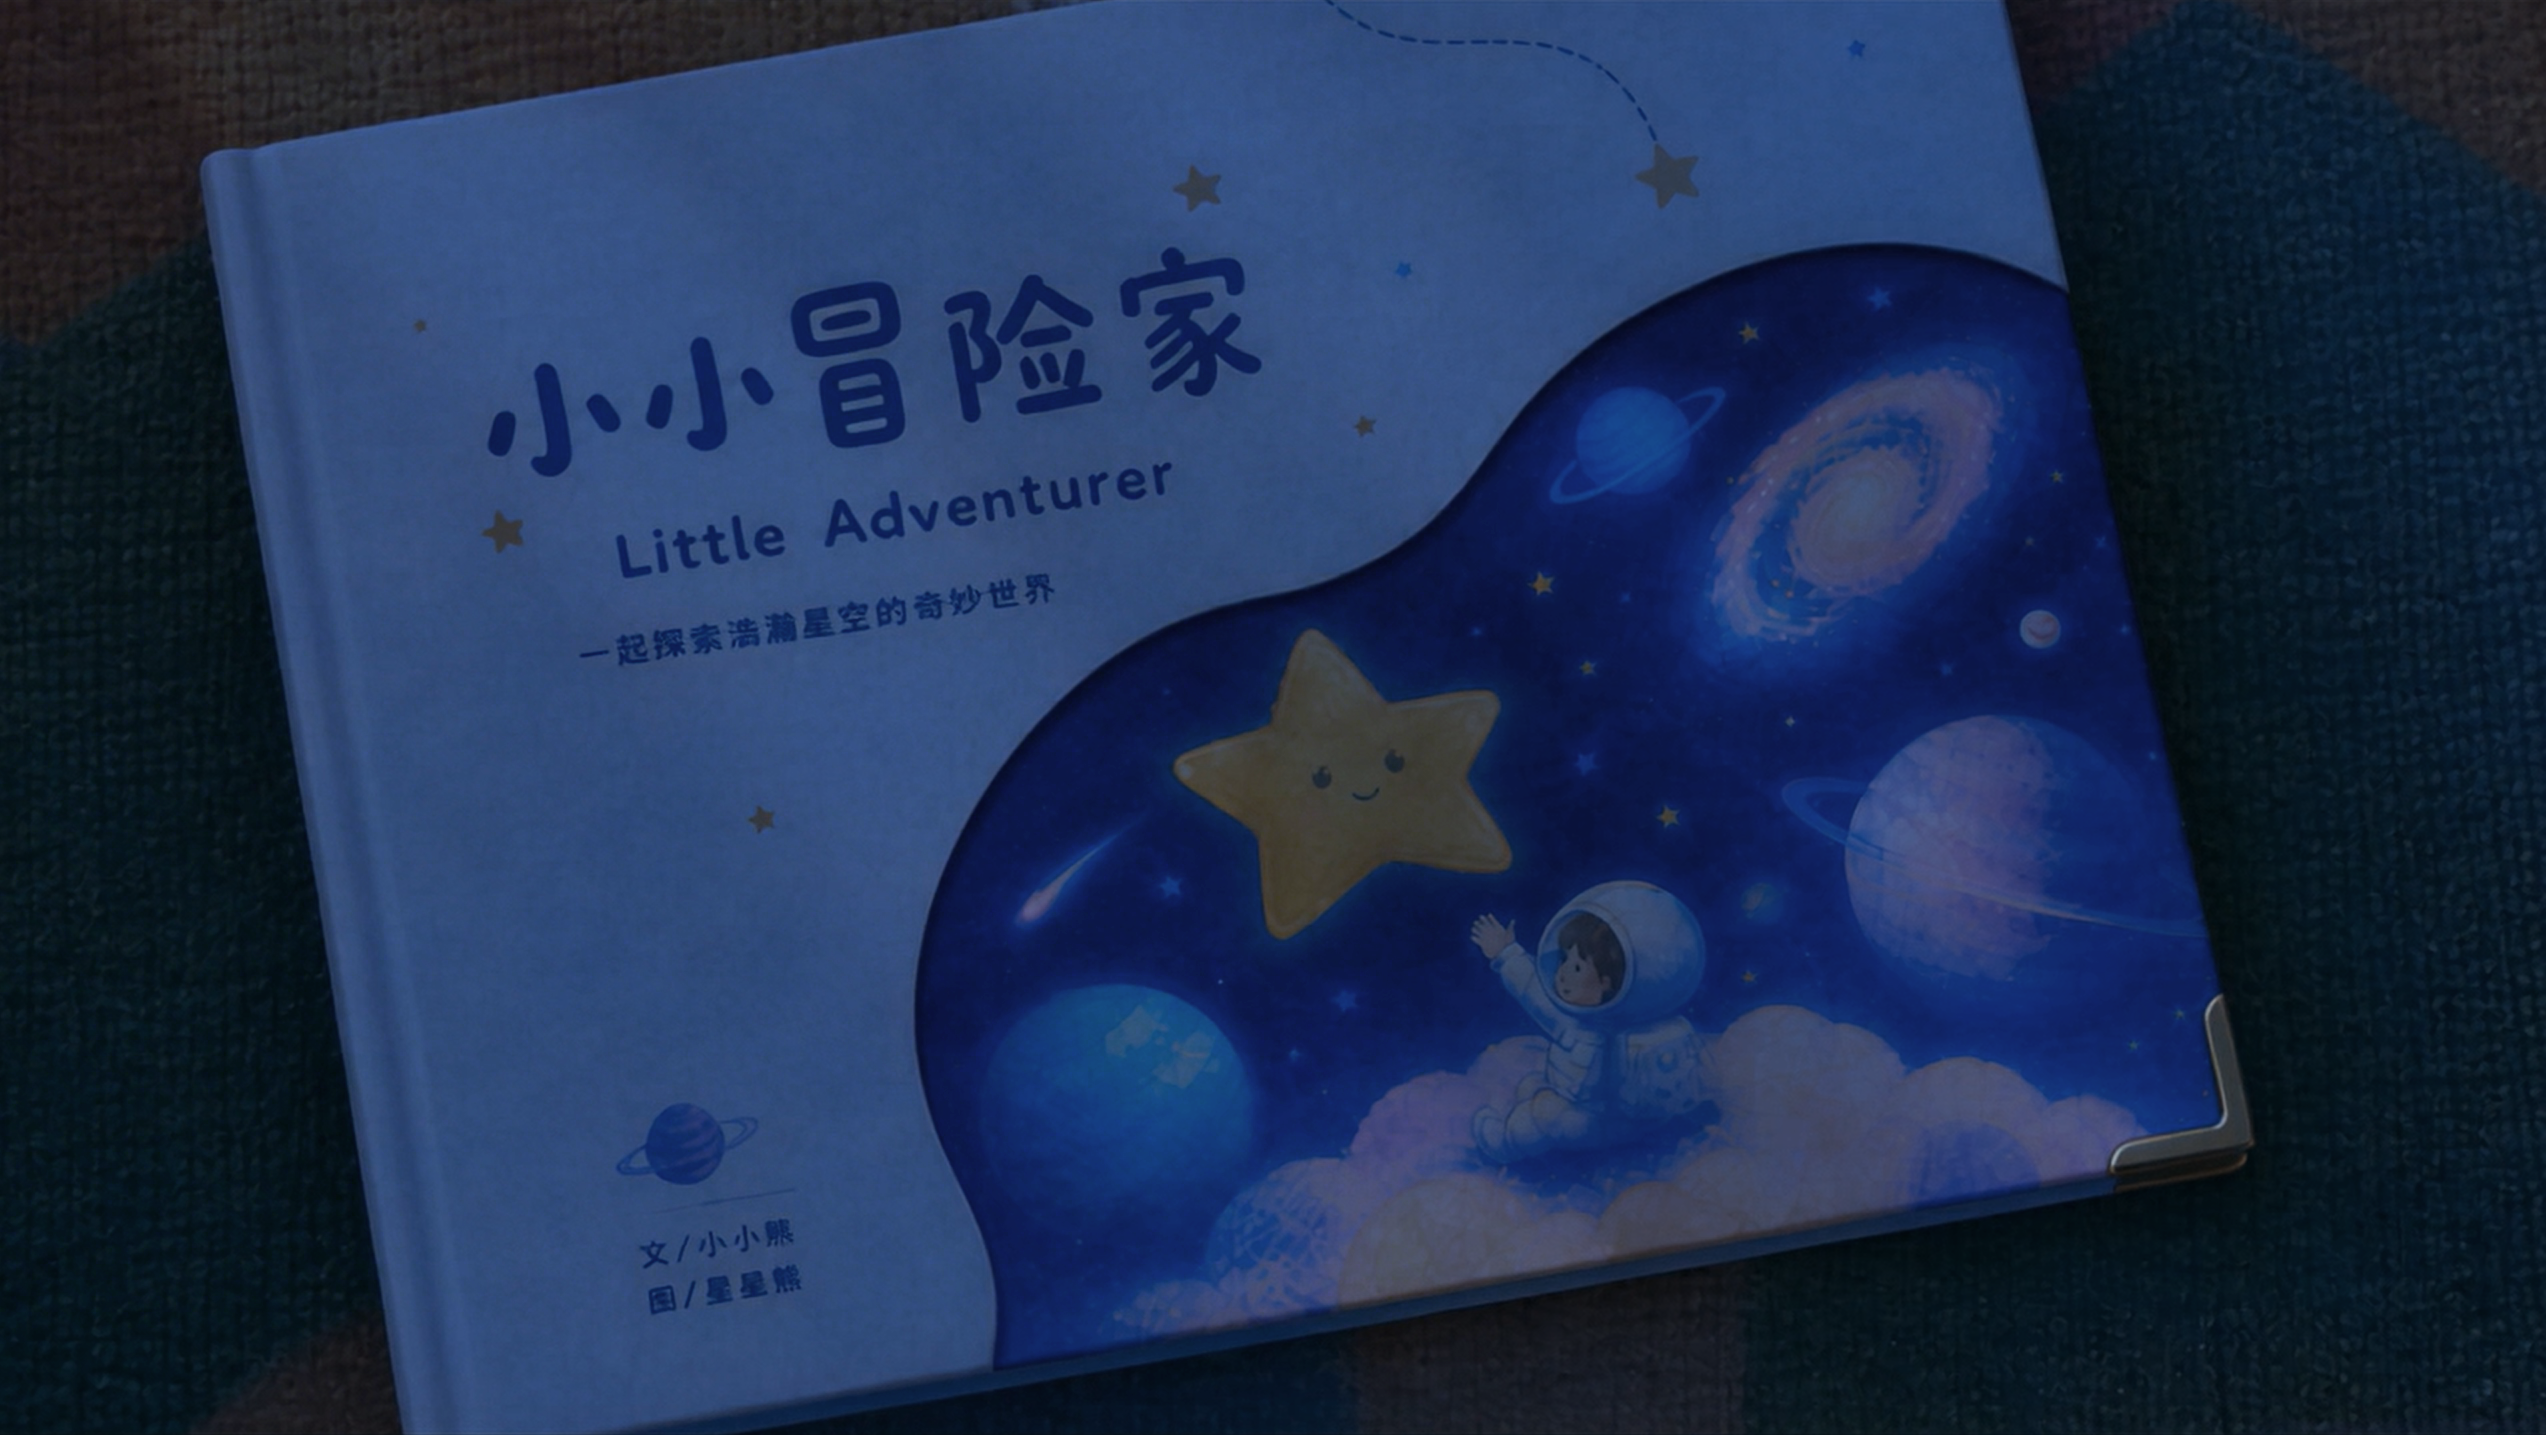
- 28-30s(参考 <10pic>)镜头继续推进绘本,随后爸爸进入画面。
整体要求:所有画面均参考对应关键帧,白模视频仅作为运镜、镜头运动和角色动画参考,不参考画面内容。最终输出 30 秒 16:9 横构图宽屏视频。
输入:视频、图
Replay
00:00
/
00:00
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
video1
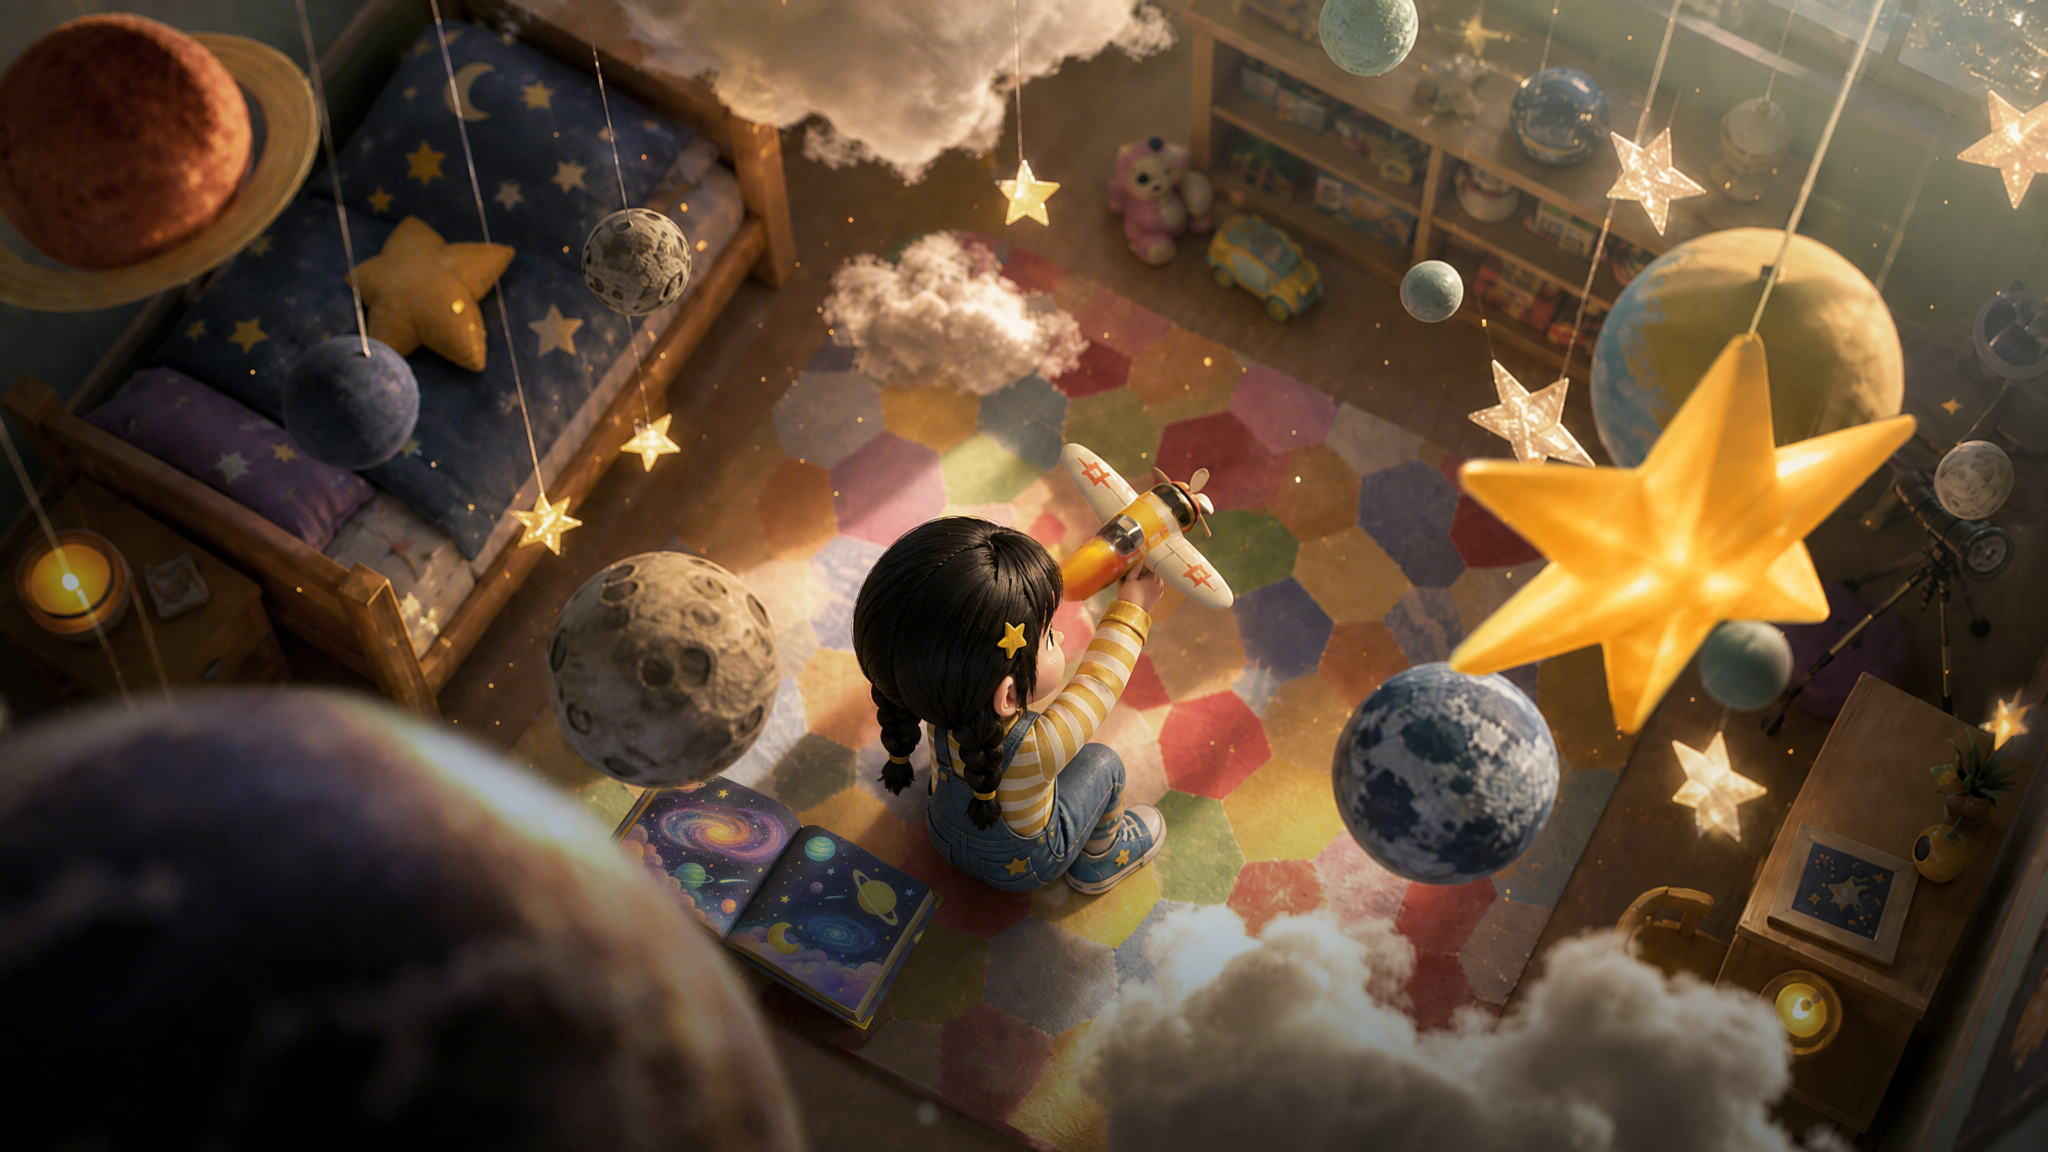
2pic
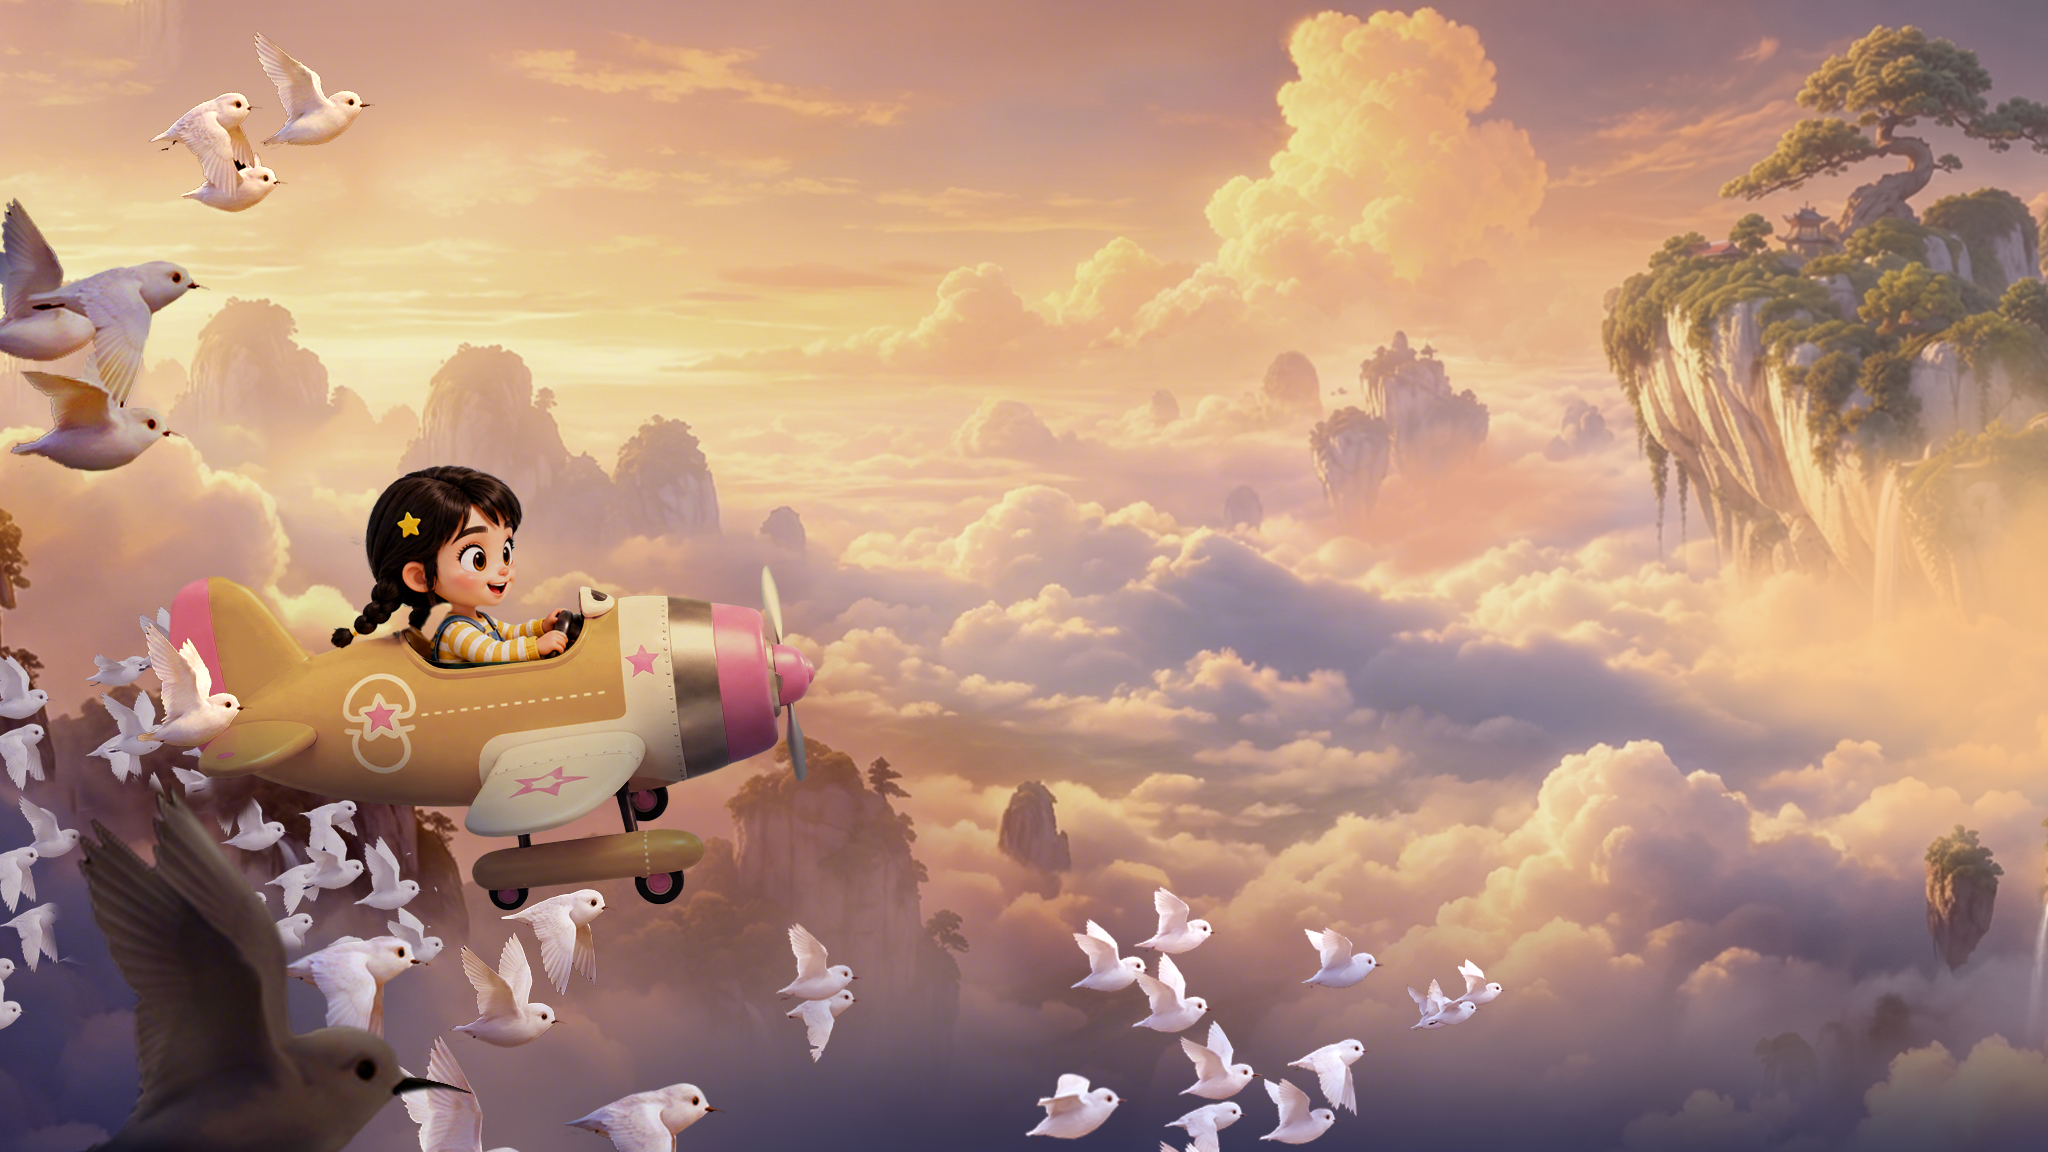
3pic
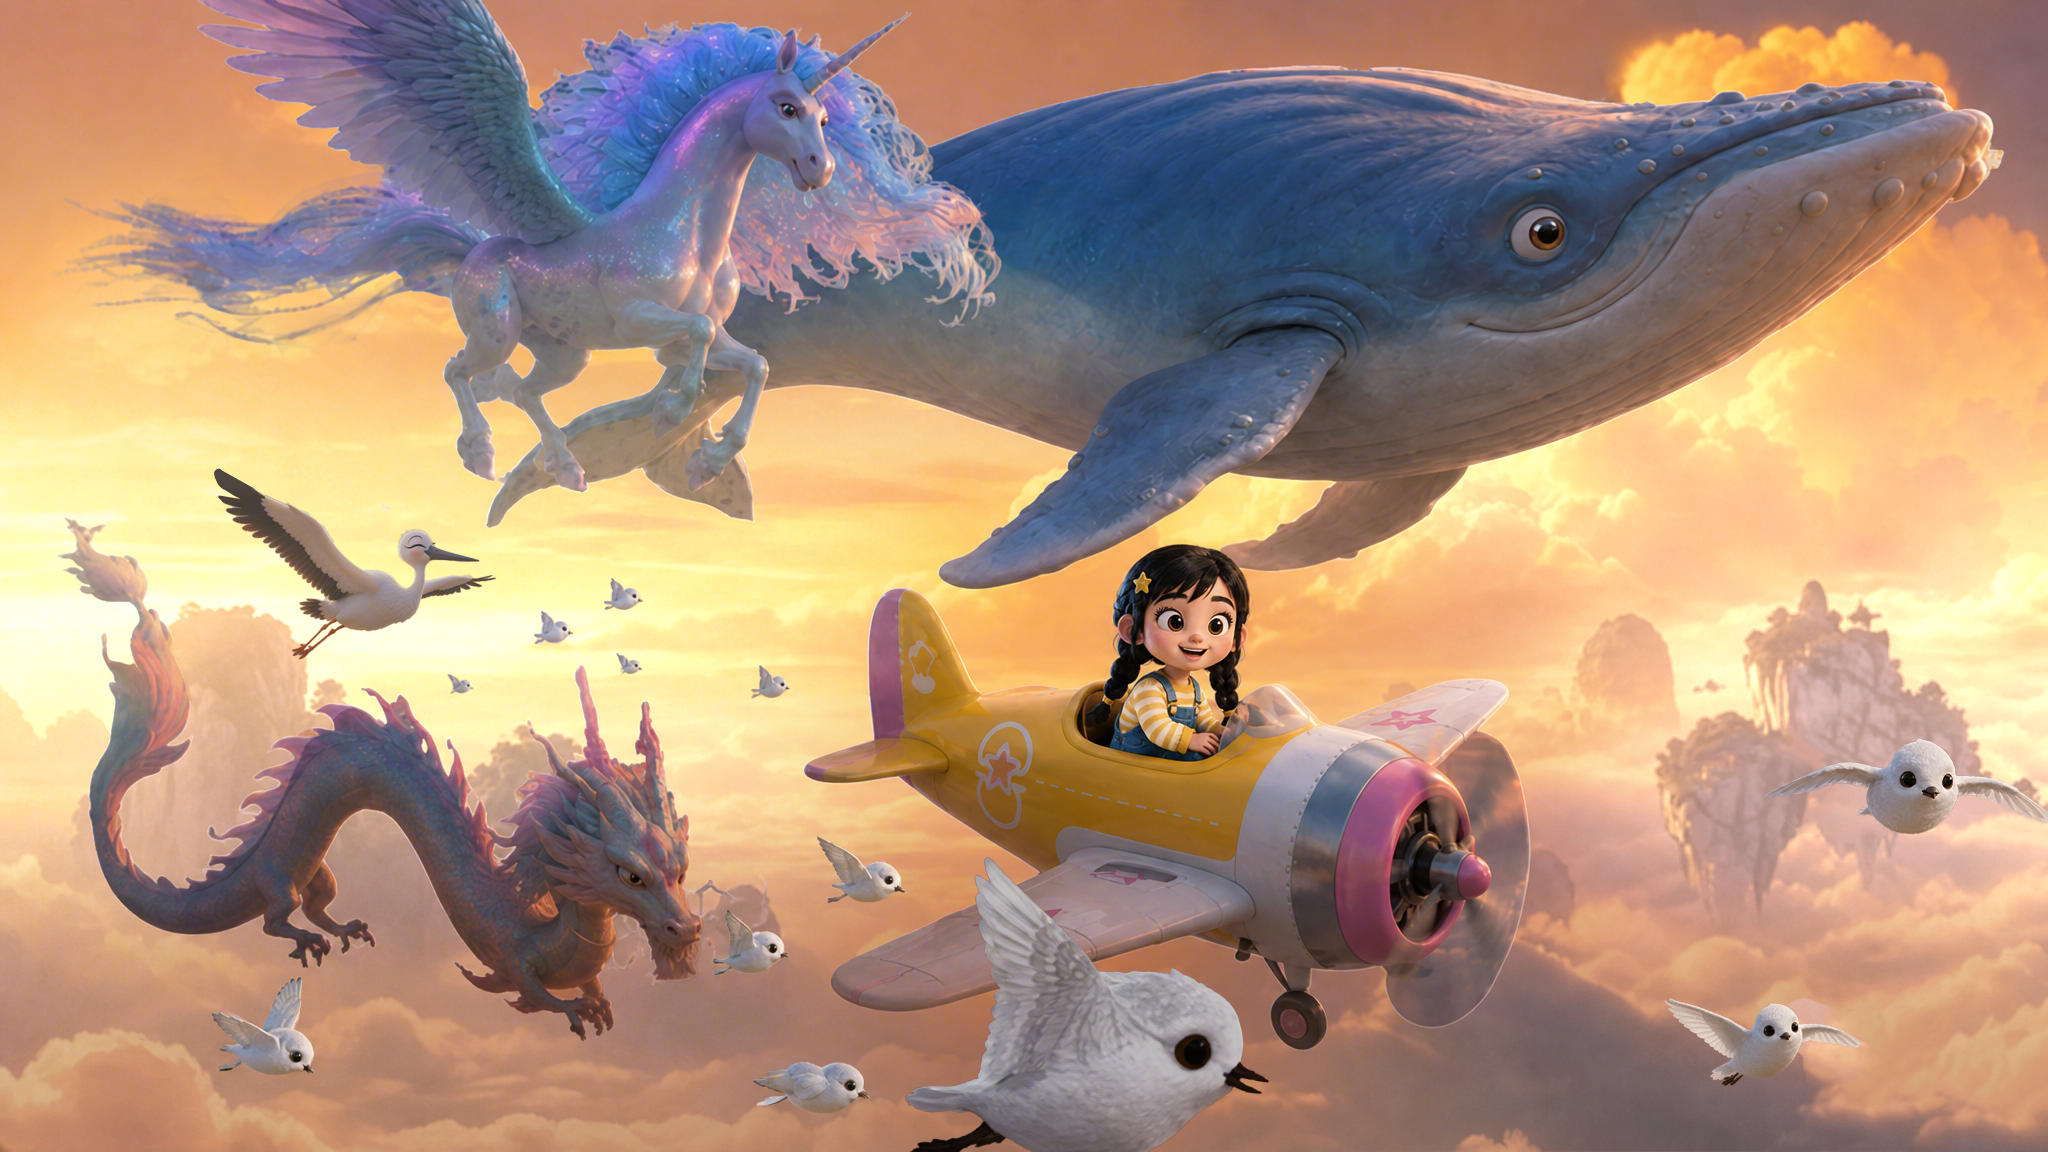
4pic
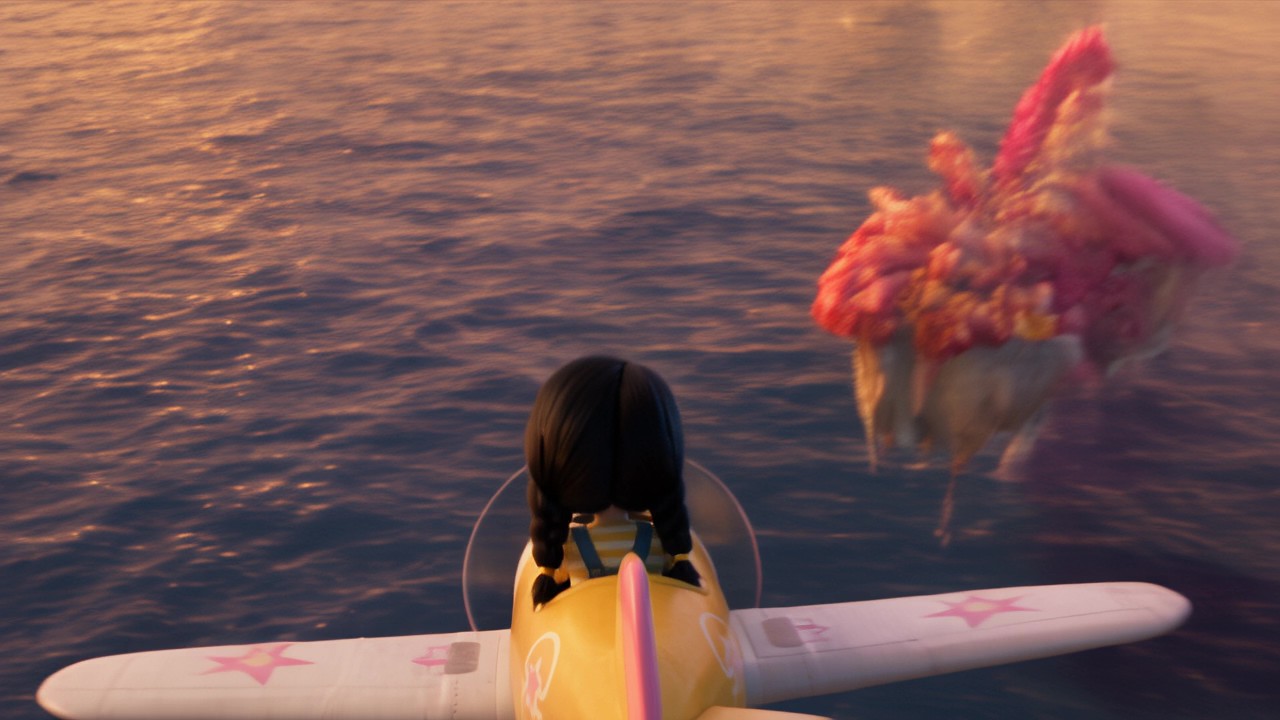
5pic
输入:视频、图(续)
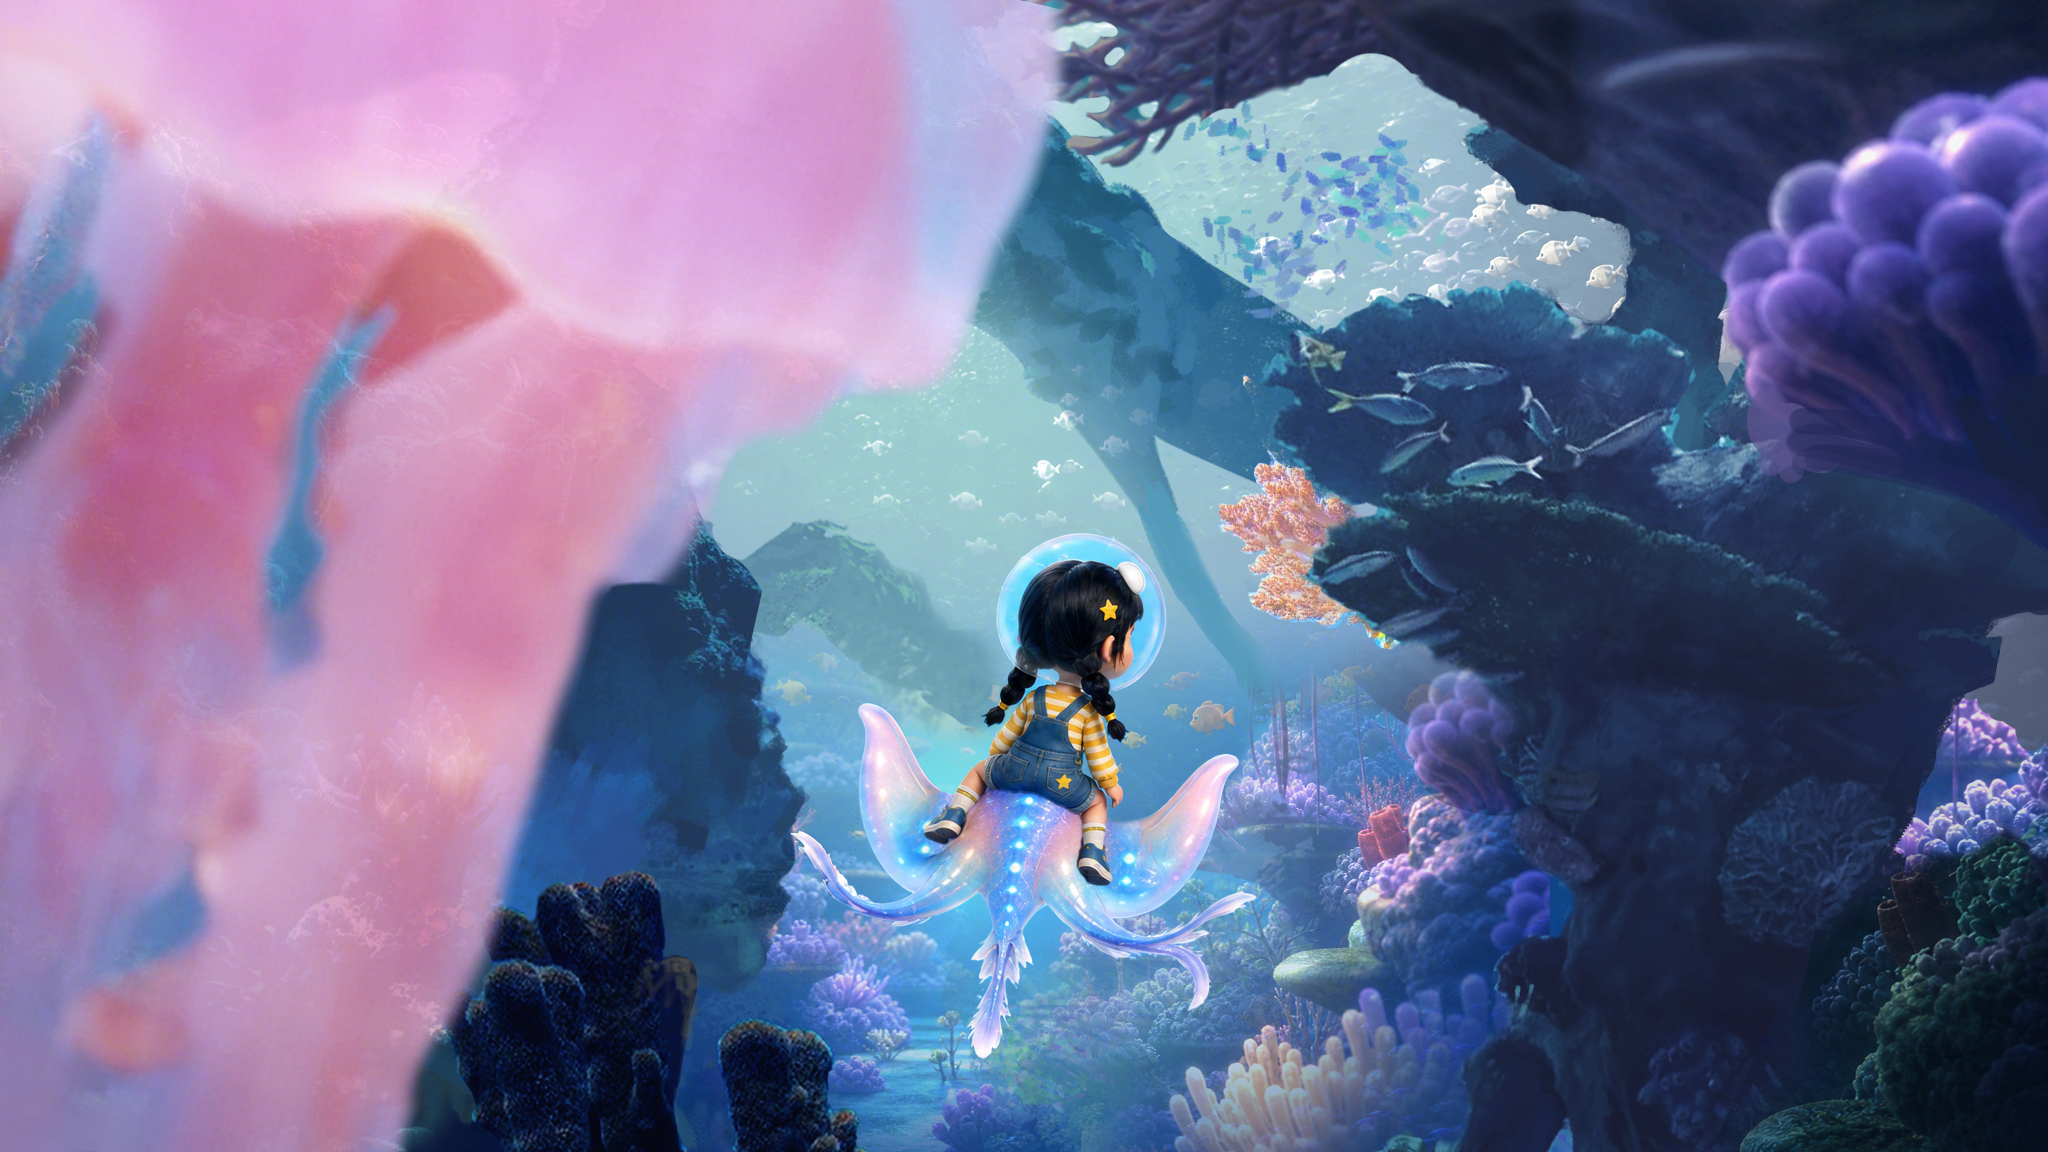
6pic
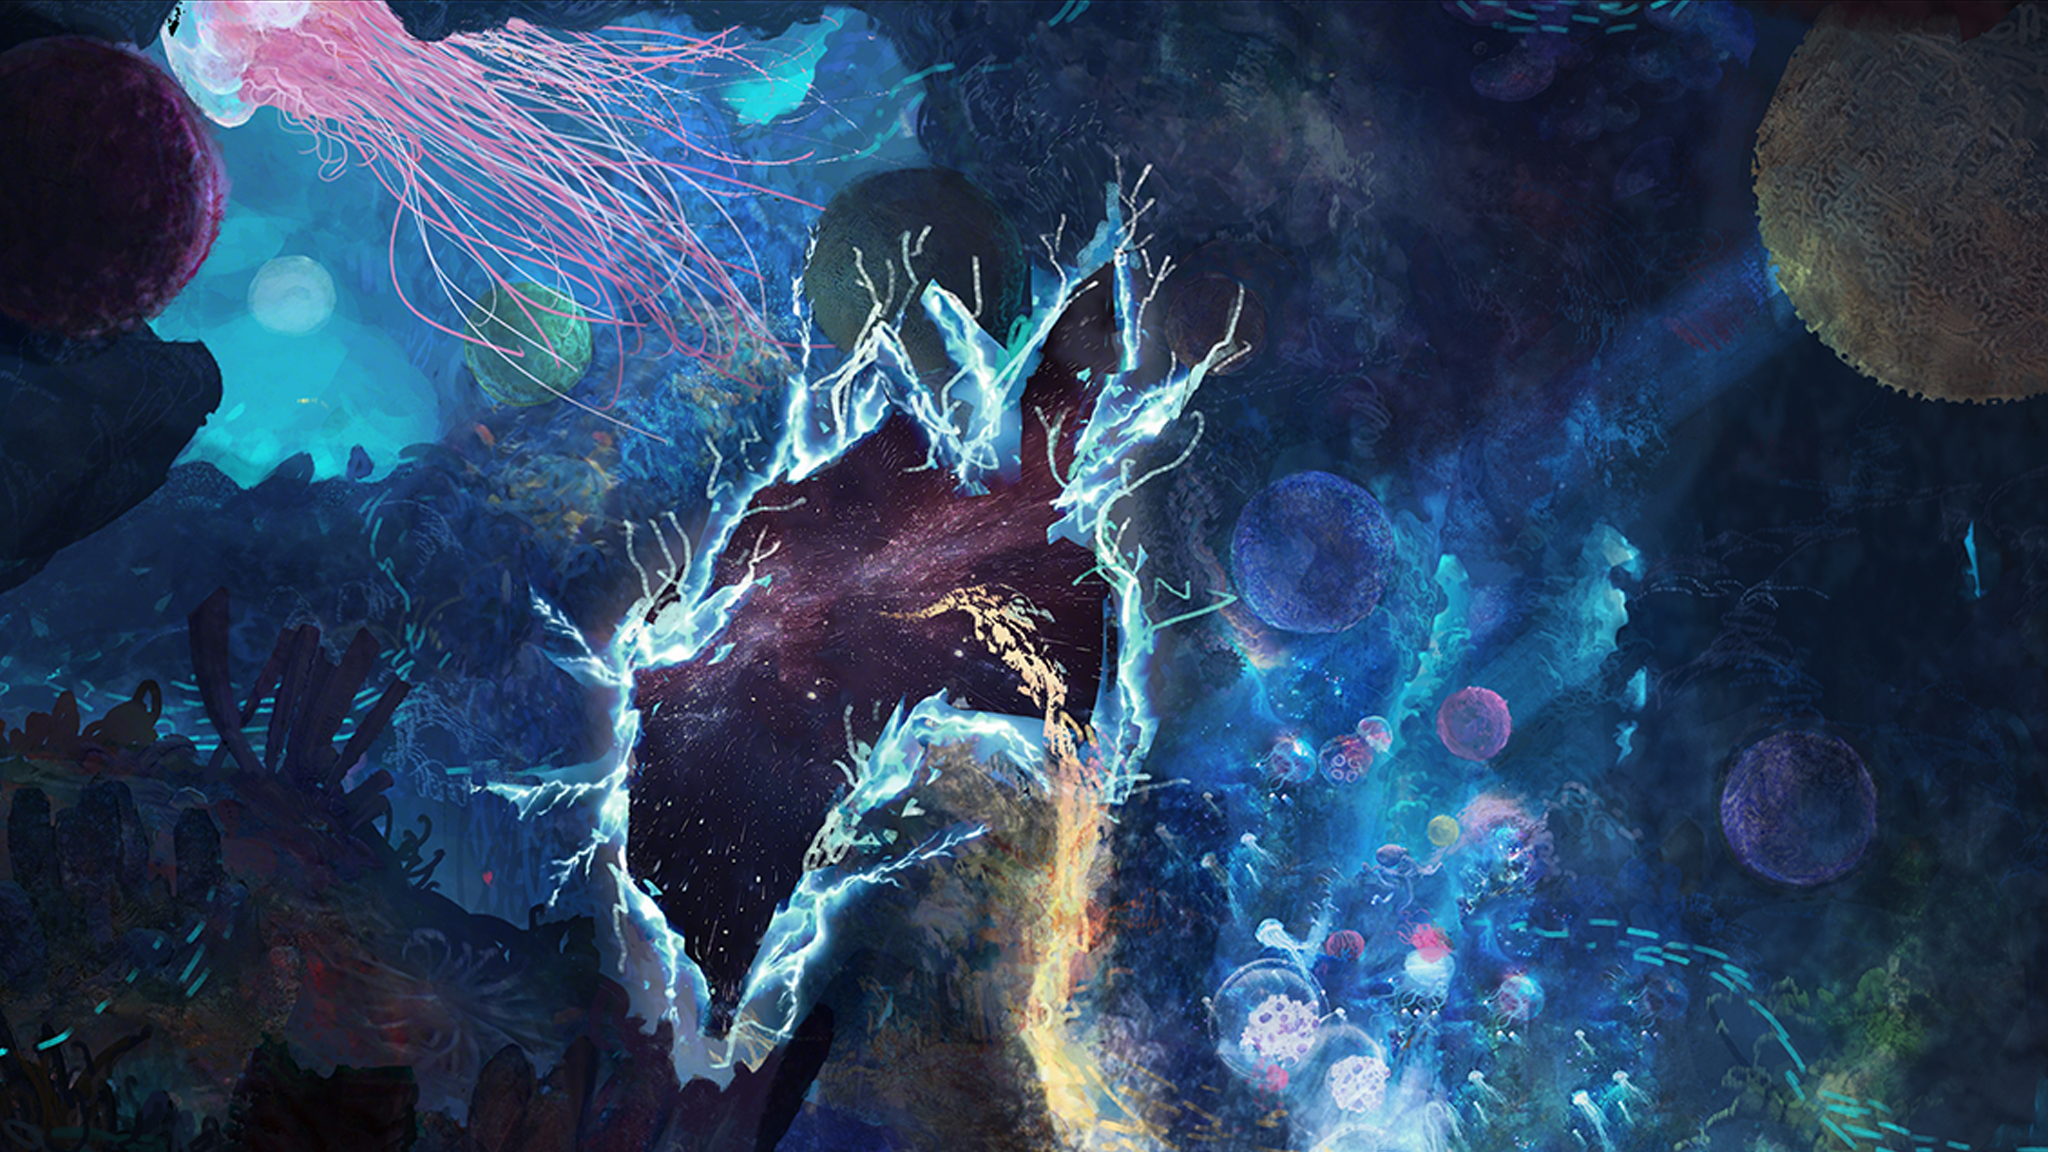
7pic
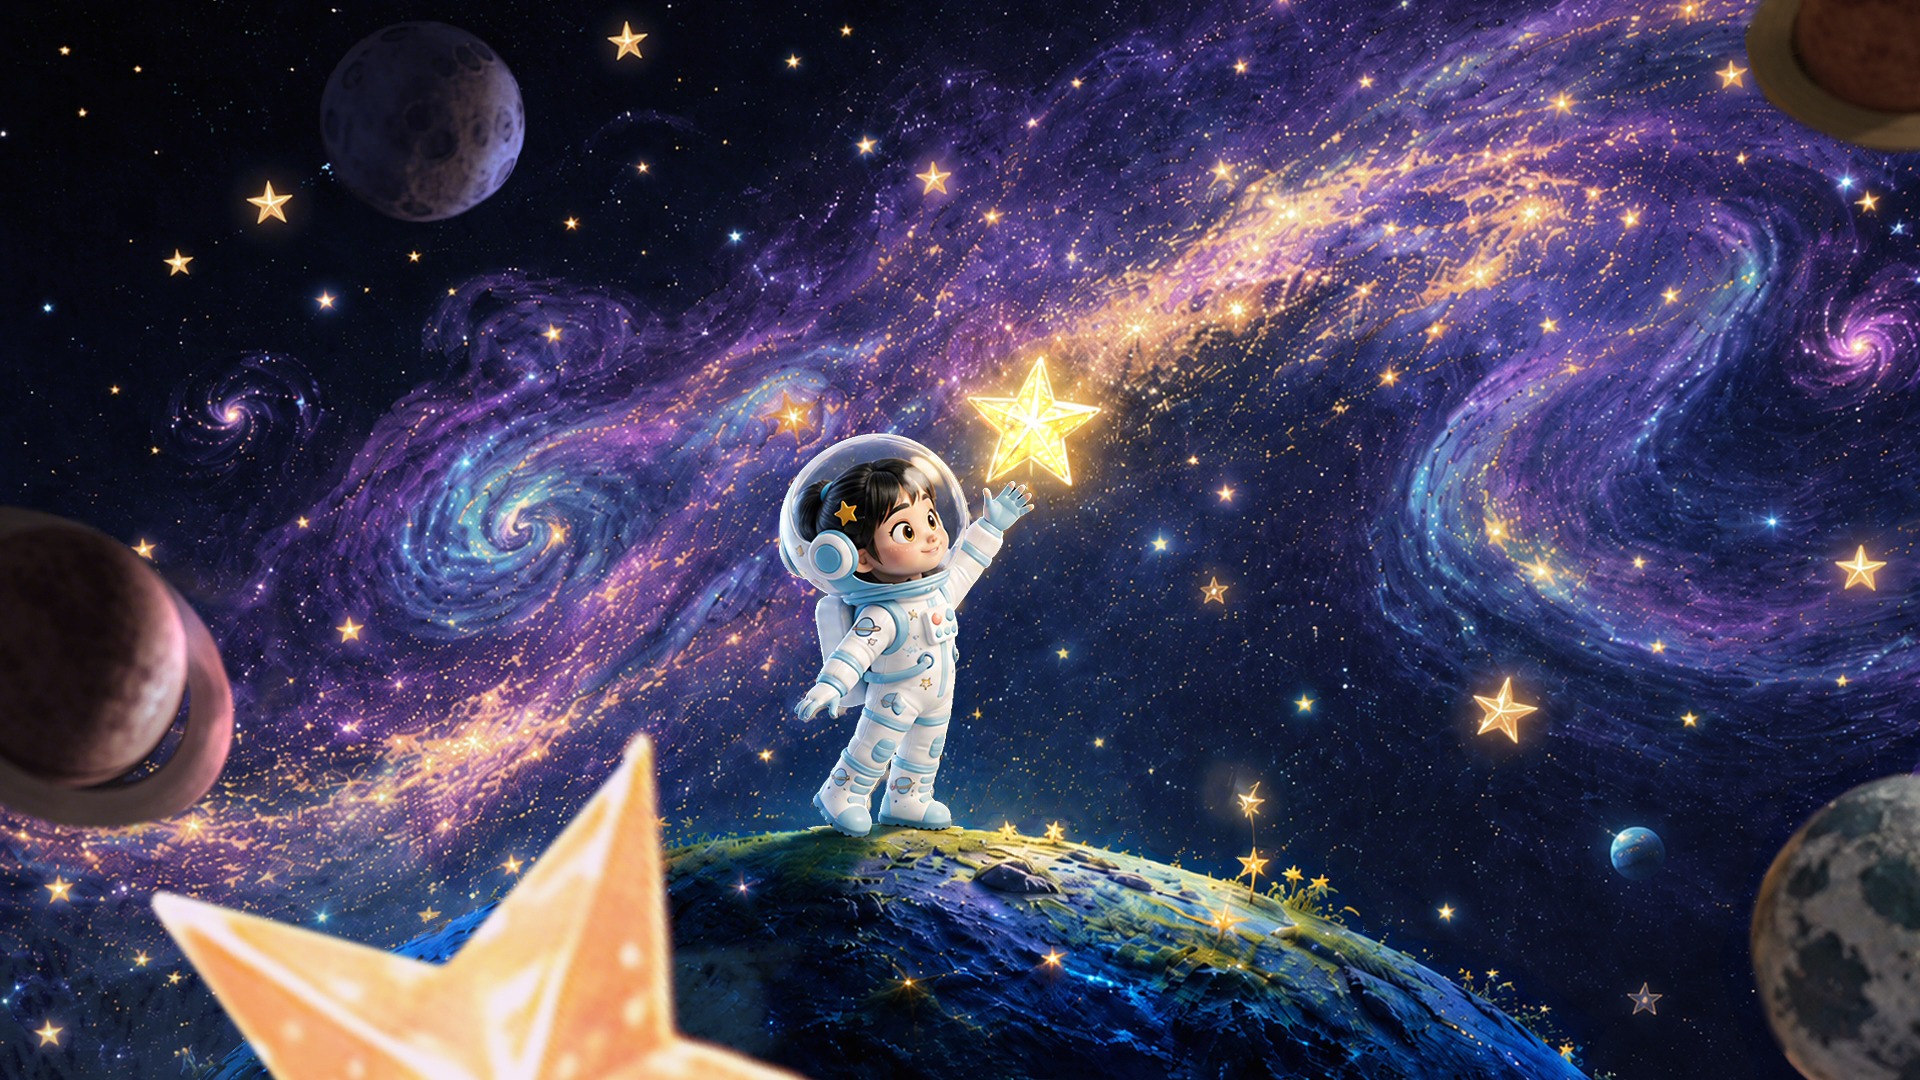
8pic
9pic
10pic
输出
Replay
00:00
/
00:00
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
同步对比视频:
Replay
00:00
/
00:00
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
细粒度白模
- 服务于建模完整,重点解决重渲染的场景,给「白模上色」获得更好更丰富的渲染效果。
- 尽量提供完整且清晰的细粒度白模视频,不含【轨迹线】【坐标线】【相机 cone】等干扰信息的视频,否则容易泄露到生成后的视频中。
输入:文本
将视频 1 进行白模渲染,无 bgm,只生成环境音和动作音。
渲染要求:背景为深蓝与紫色色调的夜晚赛博朋克都市,密集的摩天大楼,楼宇间是巨大的全息广告牌与霓虹灯光,数个飞行器在空中穿梭,闪着微弱的灯光,发出微弱的机械声响;人物为一个身着黑色夜行衣的小浣熊,身影为一道剪影,脚步小心翼翼;人物移动的地点是摩天大楼中的一栋楼的屋顶。
输入:视频
Replay
00:00
/
00:00
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
输出
Replay
00:00
/
00:00
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
高难度白模预演
Replay
00:00
/
00:00
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
复杂 3D 白模的结构与镜头调度逐帧承接,渲染出成片质感。
多宫格分镜/故事板参考
输入:文本
image1: 九宫格分镜参考,用于整体镜头结构、景别与运镜节奏。
image2: 火箭发射场黄昏草原实拍参考,用于环境构图、暖金夕照与冷暮蓝的写实彩色实拍质感基准。
image3: 主体 1 (守护机器人) 角色外观参考。
image4: 主体 2 (老奶奶) 角色外观参考。
【主体设定】
主体 1 (守护机器人): 参考 image3,近未来做旧复古机器人,做旧蓝绿色金属机身、斑驳锈蚀,圆顶头,两只发光的红色圆形机眼,细天线,细长关节四肢;体型高大,约为人类两倍高。
主体 2 (老奶奶): 参考 image4,瘦小年迈女性,银发挽成低髻,皱纹深刻,身穿明黄金色及地长裙、缀金蓝刺绣胸襟,神情不舍;身高只及机器人胸口。
环境 (黄昏草原・发射场): 参考 image2,近未来黄昏草原,暮色天空由暖金渐入冷蓝,远处地平线一座发射台矗立白色火箭、蒸汽升腾;及膝野草随风起伏,广袤空旷。
【整体风格】
真人实拍彩色电影正片,写实照片级质感,全程真实彩色画面;彩色 35mm 电影胶片质感,细腻真实胶片颗粒,浓郁饱满的电影级调色,IMAX 大画幅质感;手持摄影,呼吸感摇晃,浅景深大光圈,前景持续飘散的草叶、火星与灰烬,微微倾斜荷兰角,暖金夕照与冷暮蓝、爆炸暖橙强烈对撞,16:9 横屏。近未来温情灾难片氛围,静谧、悲壮、守护与不舍。
【严格排除】黑白、单色、灰度、去色;手绘、素描、线稿、插画、漫画、动画;分镜稿 / 故事板、草图;移轴微缩、玩偶感、塑料 CG、油腻过曝 CG。
【分镜头】(9 镜 ≈ 30s)
镜头 1 (0-3s): 超远景低机位仰视,黄昏草原两人背影仰望远方火箭。台词 (机器人): "I'm right here. I won't let go."
镜头 2 (3-6s): 正面中景手持,机器人搀扶老奶奶。
镜头 3 (6-10s): 面部特写,老奶奶眼含不舍。台词 (老奶奶): "Fly safe, my child. Come back to me."
镜头 4 (10-14s): 超远景仰摇,火箭升空拖曳浓白烟迹。台词 (老奶奶): "There he goes... there he goes."
镜头 5 (14-18s): 超远景,火箭在半空爆炸碎裂。台词 (老奶奶): "No... no, no—"
镜头 6 (18-22s): 面部大特写,老奶奶瞳孔骤缩泪滑落。台词 (老奶奶): "...he was almost there."
镜头 7 (22-25s): 特写转近景,老奶奶崩溃痛哭。台词 (老奶奶): "Bring him back! Please— bring him back!"
镜头 8 (25-28s): 超低视角近乎垂直仰拍,机器人环抱老奶奶罩成保护穹顶。台词 (机器人): "Don't look up. I've got you."
镜头 9 (28-30s): 超远景背影,两人紧紧相拥剪影。台词 (机器人): "I'm still here. I'll stay... as long as you need."
输入:图
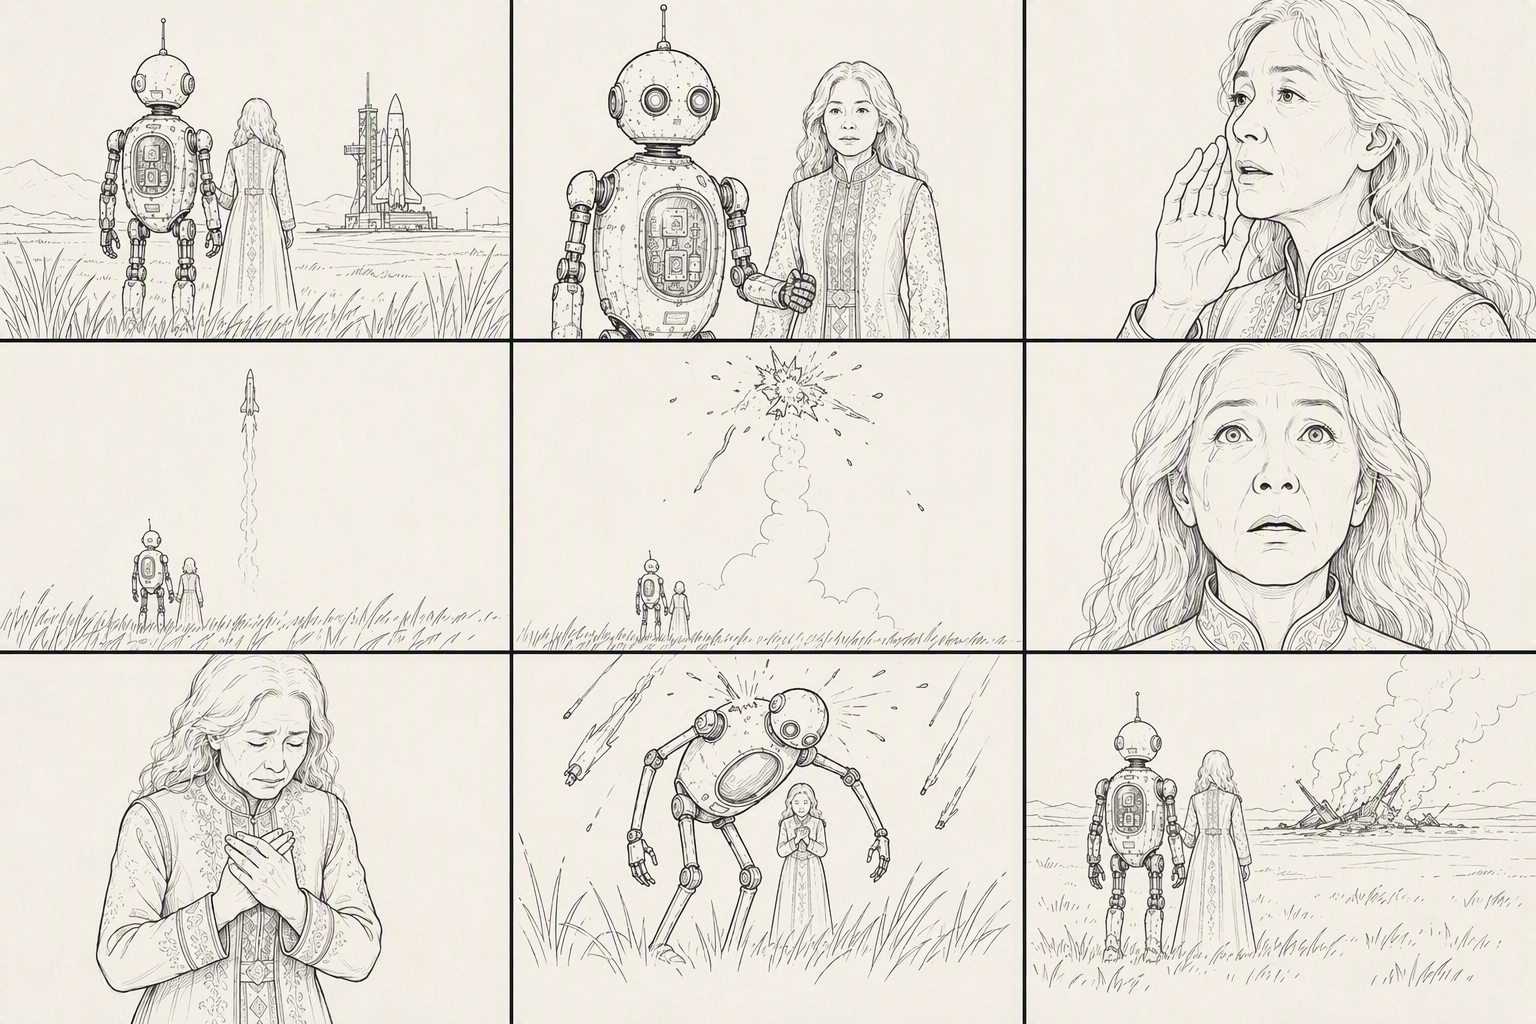
image1
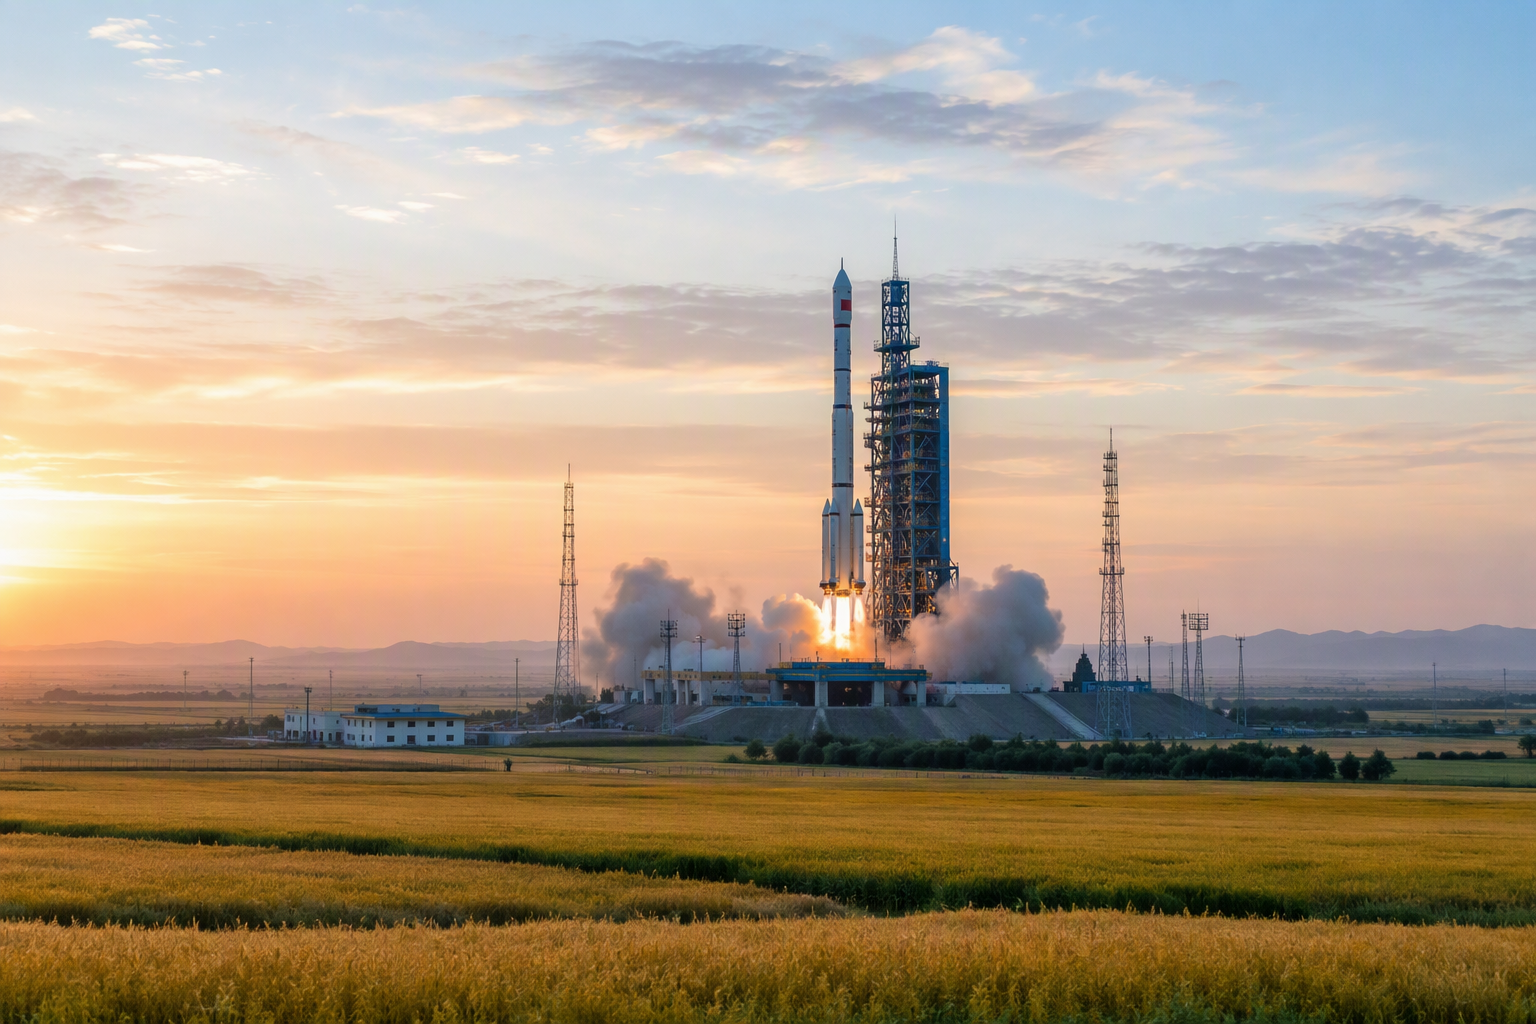
image2
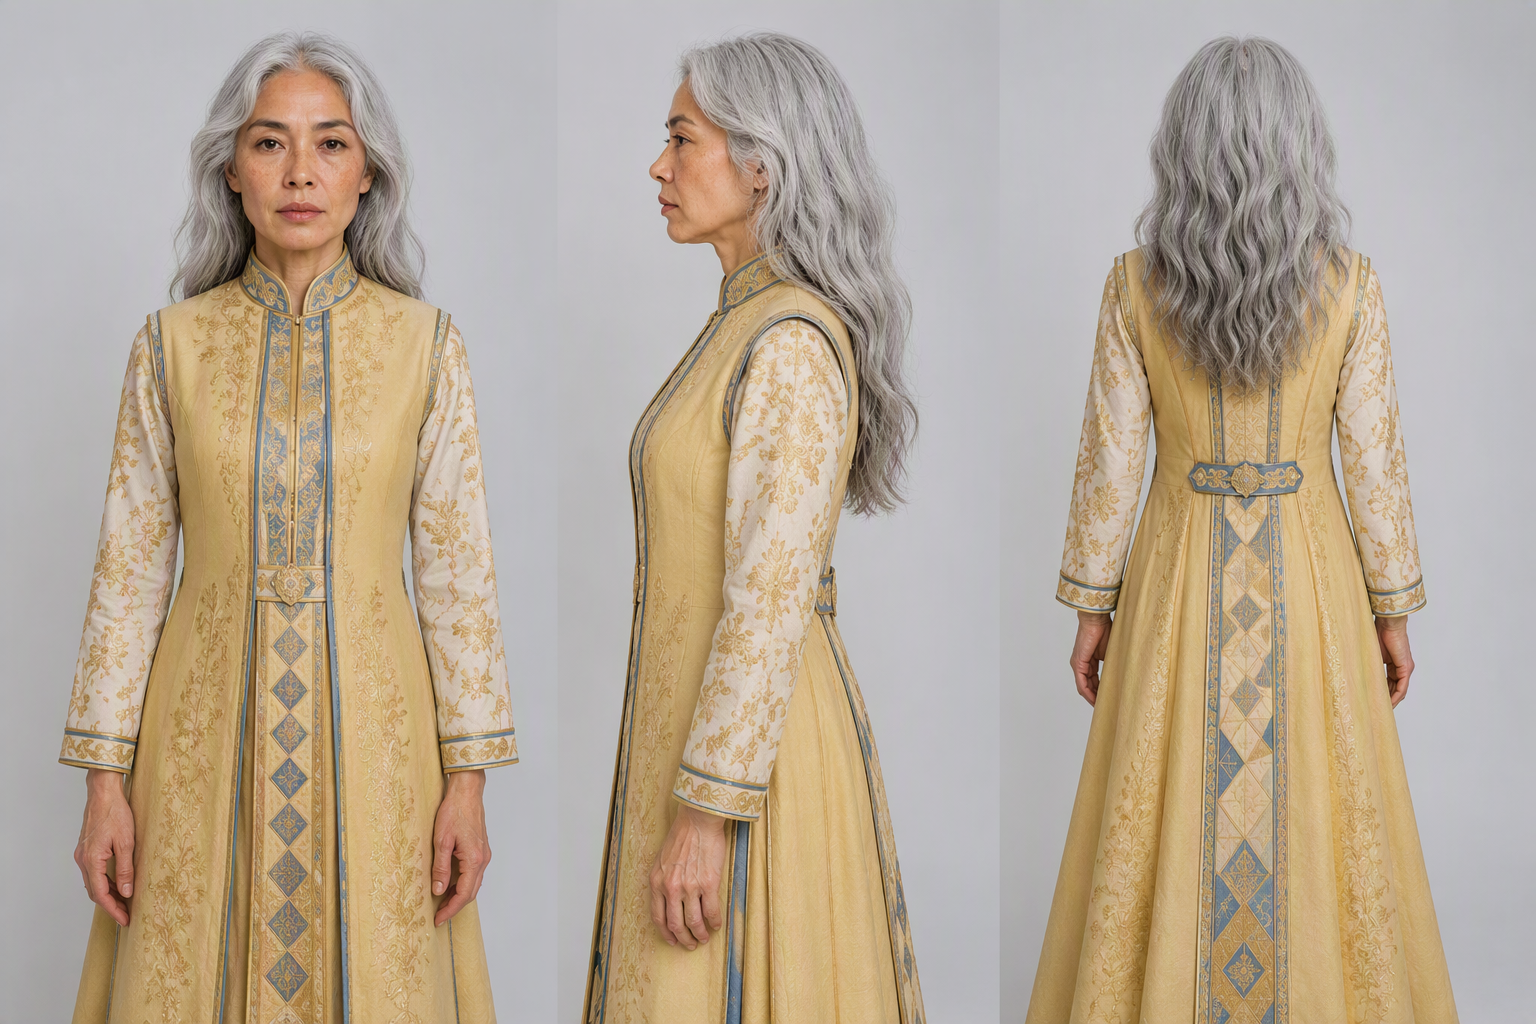
image3
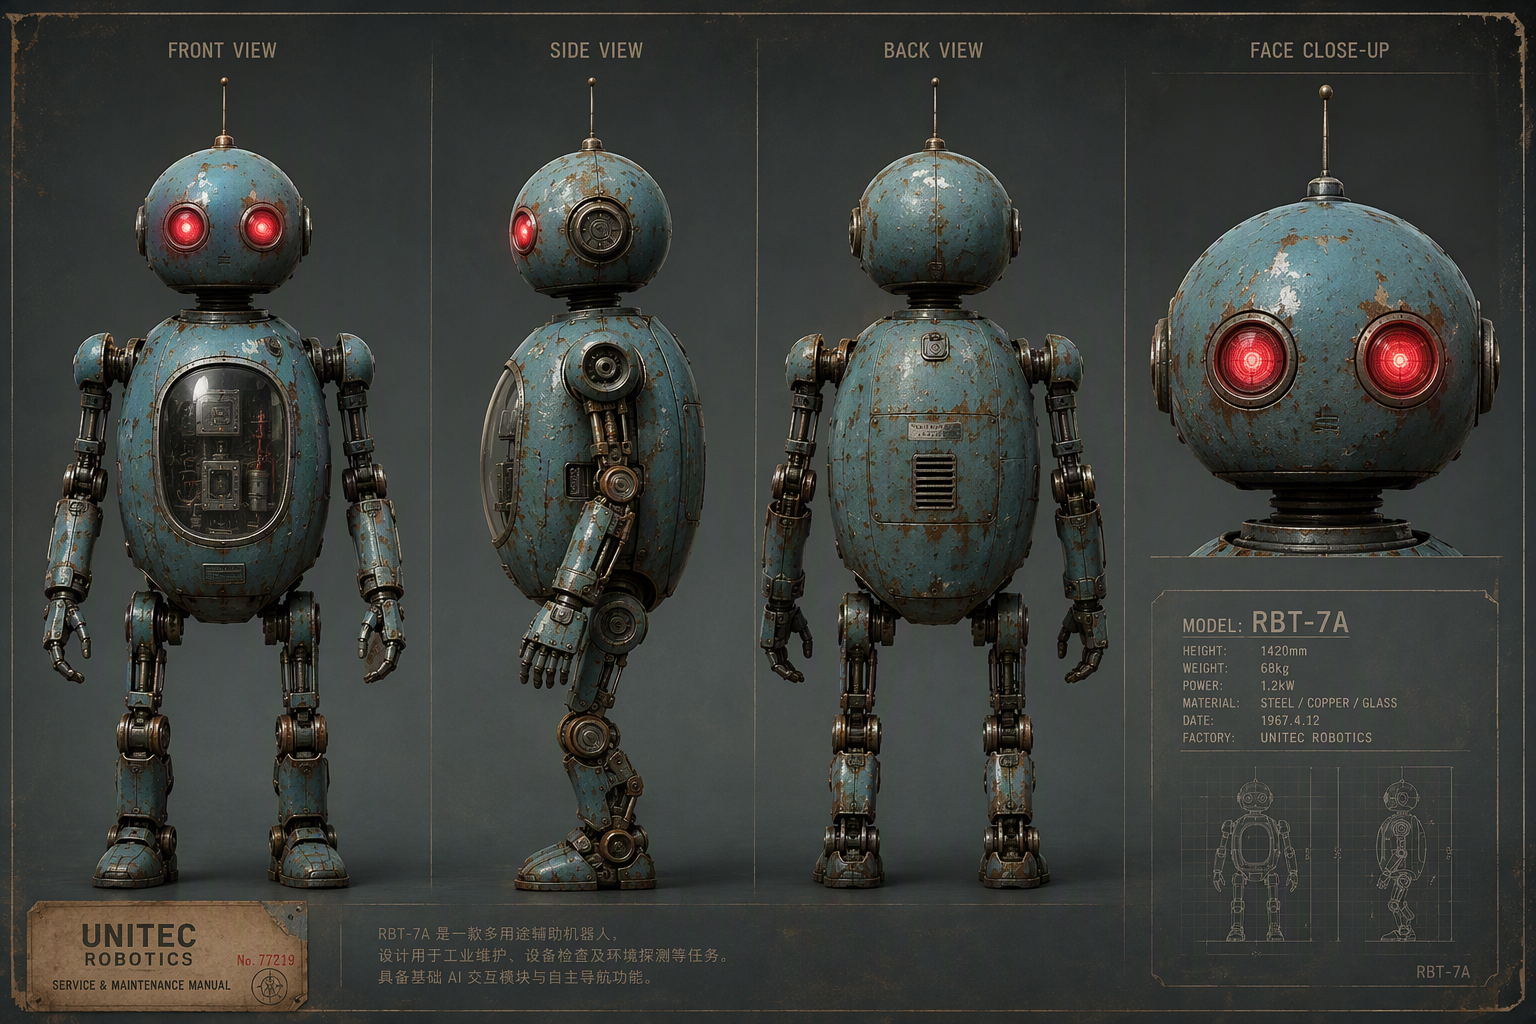
image4
输出
Replay
00:00
/
00:00
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
关键帧参考
输入:文本
根据 @图片1 - @图片6 制作一镜到底的像素武侠主题竖版视频,背景音乐使用国风 8bit 武侠风格音乐。全片统一浅蓝底色,像素风格统一,画面干净通透。
镜头 1:静止展示 @图片 1 的「江湖风云」水墨风格 logo,背景为统一浅蓝底色,画面保持约 1 秒静止。
镜头 2:@图片 1 中的文字区域消失后,@图片 2 的武侠男性角色像素脸部特写从画面底部滑入;角色眨眨眼看向镜头,随后快速向下位移离场;角色离场后,原本 logo 处变为 @图片 3 的蓝色「武功秘籍」像素书。
镜头 3:紧接 @图片 4,像素武侠小人角色从画面下方用力向上跃出,顶起上方的蓝色菱形问号标,问号标上方弹出深蓝色粗体字「今日闯江湖!」;角色落地后摆出 @图片 4 的站姿 pose,随后抬手打招呼,接着做出预备跑动作,转身向画面右侧奔跑(奔跑姿态参考 @图片 5),镜头跟随角色向右移动,角色从画面右侧跳出画面。
镜头 4:@图片 6 的 UI 界面从画面右侧位移入画,像素武侠角色从画面右上角跳入,落在「三月廿七日」大字的右下方,张开双臂摆出热情展示的定格姿势,最终定格在该画面。
整体像素武侠美术风格,色调统一浅蓝底,运镜连贯顺滑呈现一镜到底的连续位移与跟随,元素过渡自然、角色动作衔接流畅,画面无卡顿、无闪烁;文字与 UI 清晰稳定。
输入:图
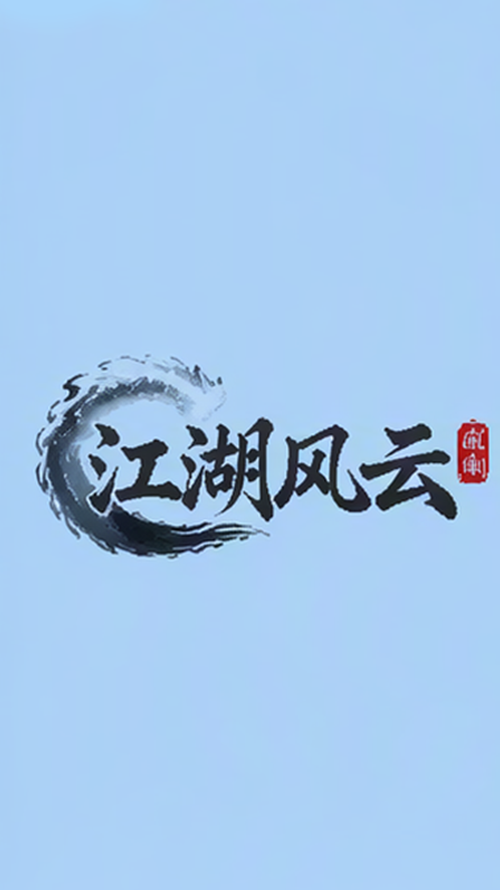
图片 1
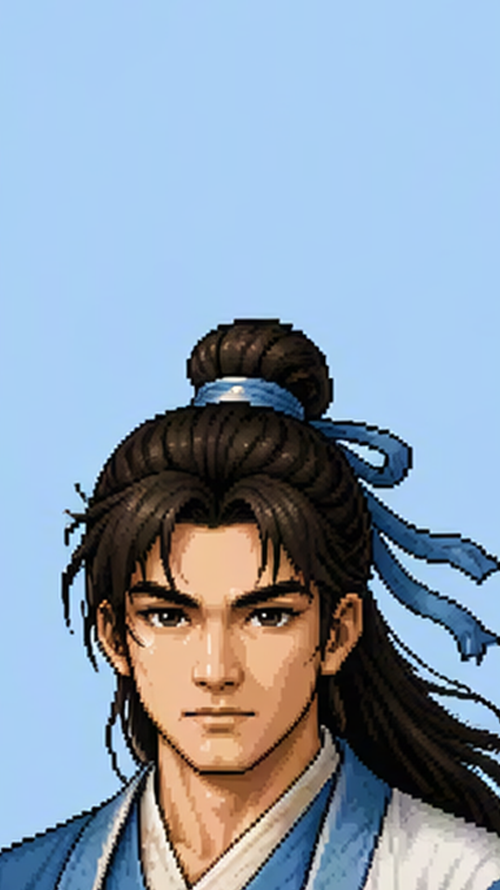
图片 2
图片 3
输入:图(续)
图片 4
图片 5
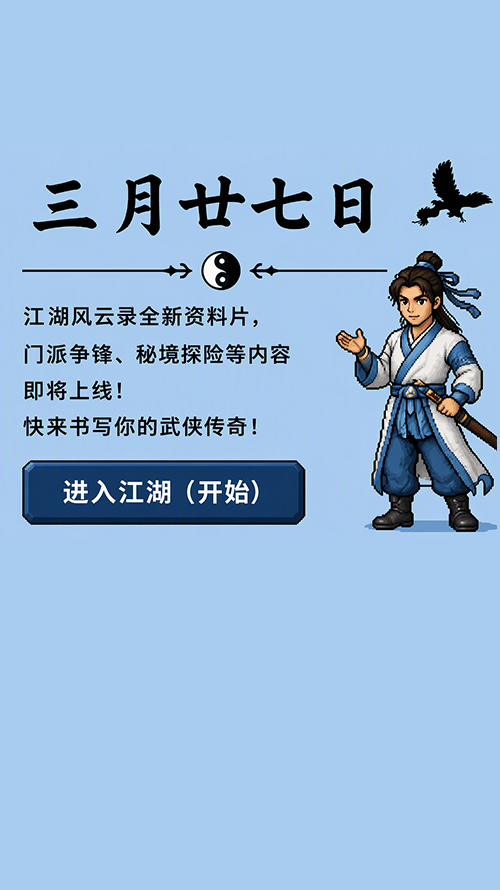
图片 6
输出
Replay
00:00
/
00:00
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
编辑视频
视频指令编辑
通过 Prompt 对视频画面内容进行增删改等编辑操作。
输入:文本
保留 @视频 1 的构图、机位、光线与表演节奏,只改写画面里女主的样貌与神情:让她从二十多岁自然地老去到六十岁,眼神里的隐忍慢慢化开,泪光滑过眼角,嘴角一点点扬起,最后破涕为笑。全程一镜到底,不跳切、不闪烁,五官随年龄渐变而不漂移。
输入:视频
Replay
00:00
/
00:00
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
输出
Replay
00:00
/
00:00
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
视频参考图编辑
通过 Prompt 对视频画面内容进行增删改等编辑操作,支持额外输入参考图引导编辑结果。
输入:文本
将两人武打素版视频 @视频 1 替换为冷兵器对决前的空手试探风。
场景替换为中世纪石堡平台、古老庭院平地、山间堡垒外平台或简洁石砖决斗场,背景为古堡墙体、风、雾、远处山线,地面平整石质 @图片 1。
视频中深色衣服的男子的服饰替换为 @图片 2,视频中浅色衣服的男子替换为 @图片 3。动作仍然保持不变,不改变原始节奏。
AI 特效仅做环境和质感强化:风吹衣摆、轻雾、接触点少量尘土、金属冷色反光质感、轻微颗粒和史诗感调色。整体风格为克制、真实、古典硬派决斗氛围。背景音乐卡点。
输入:视频、图
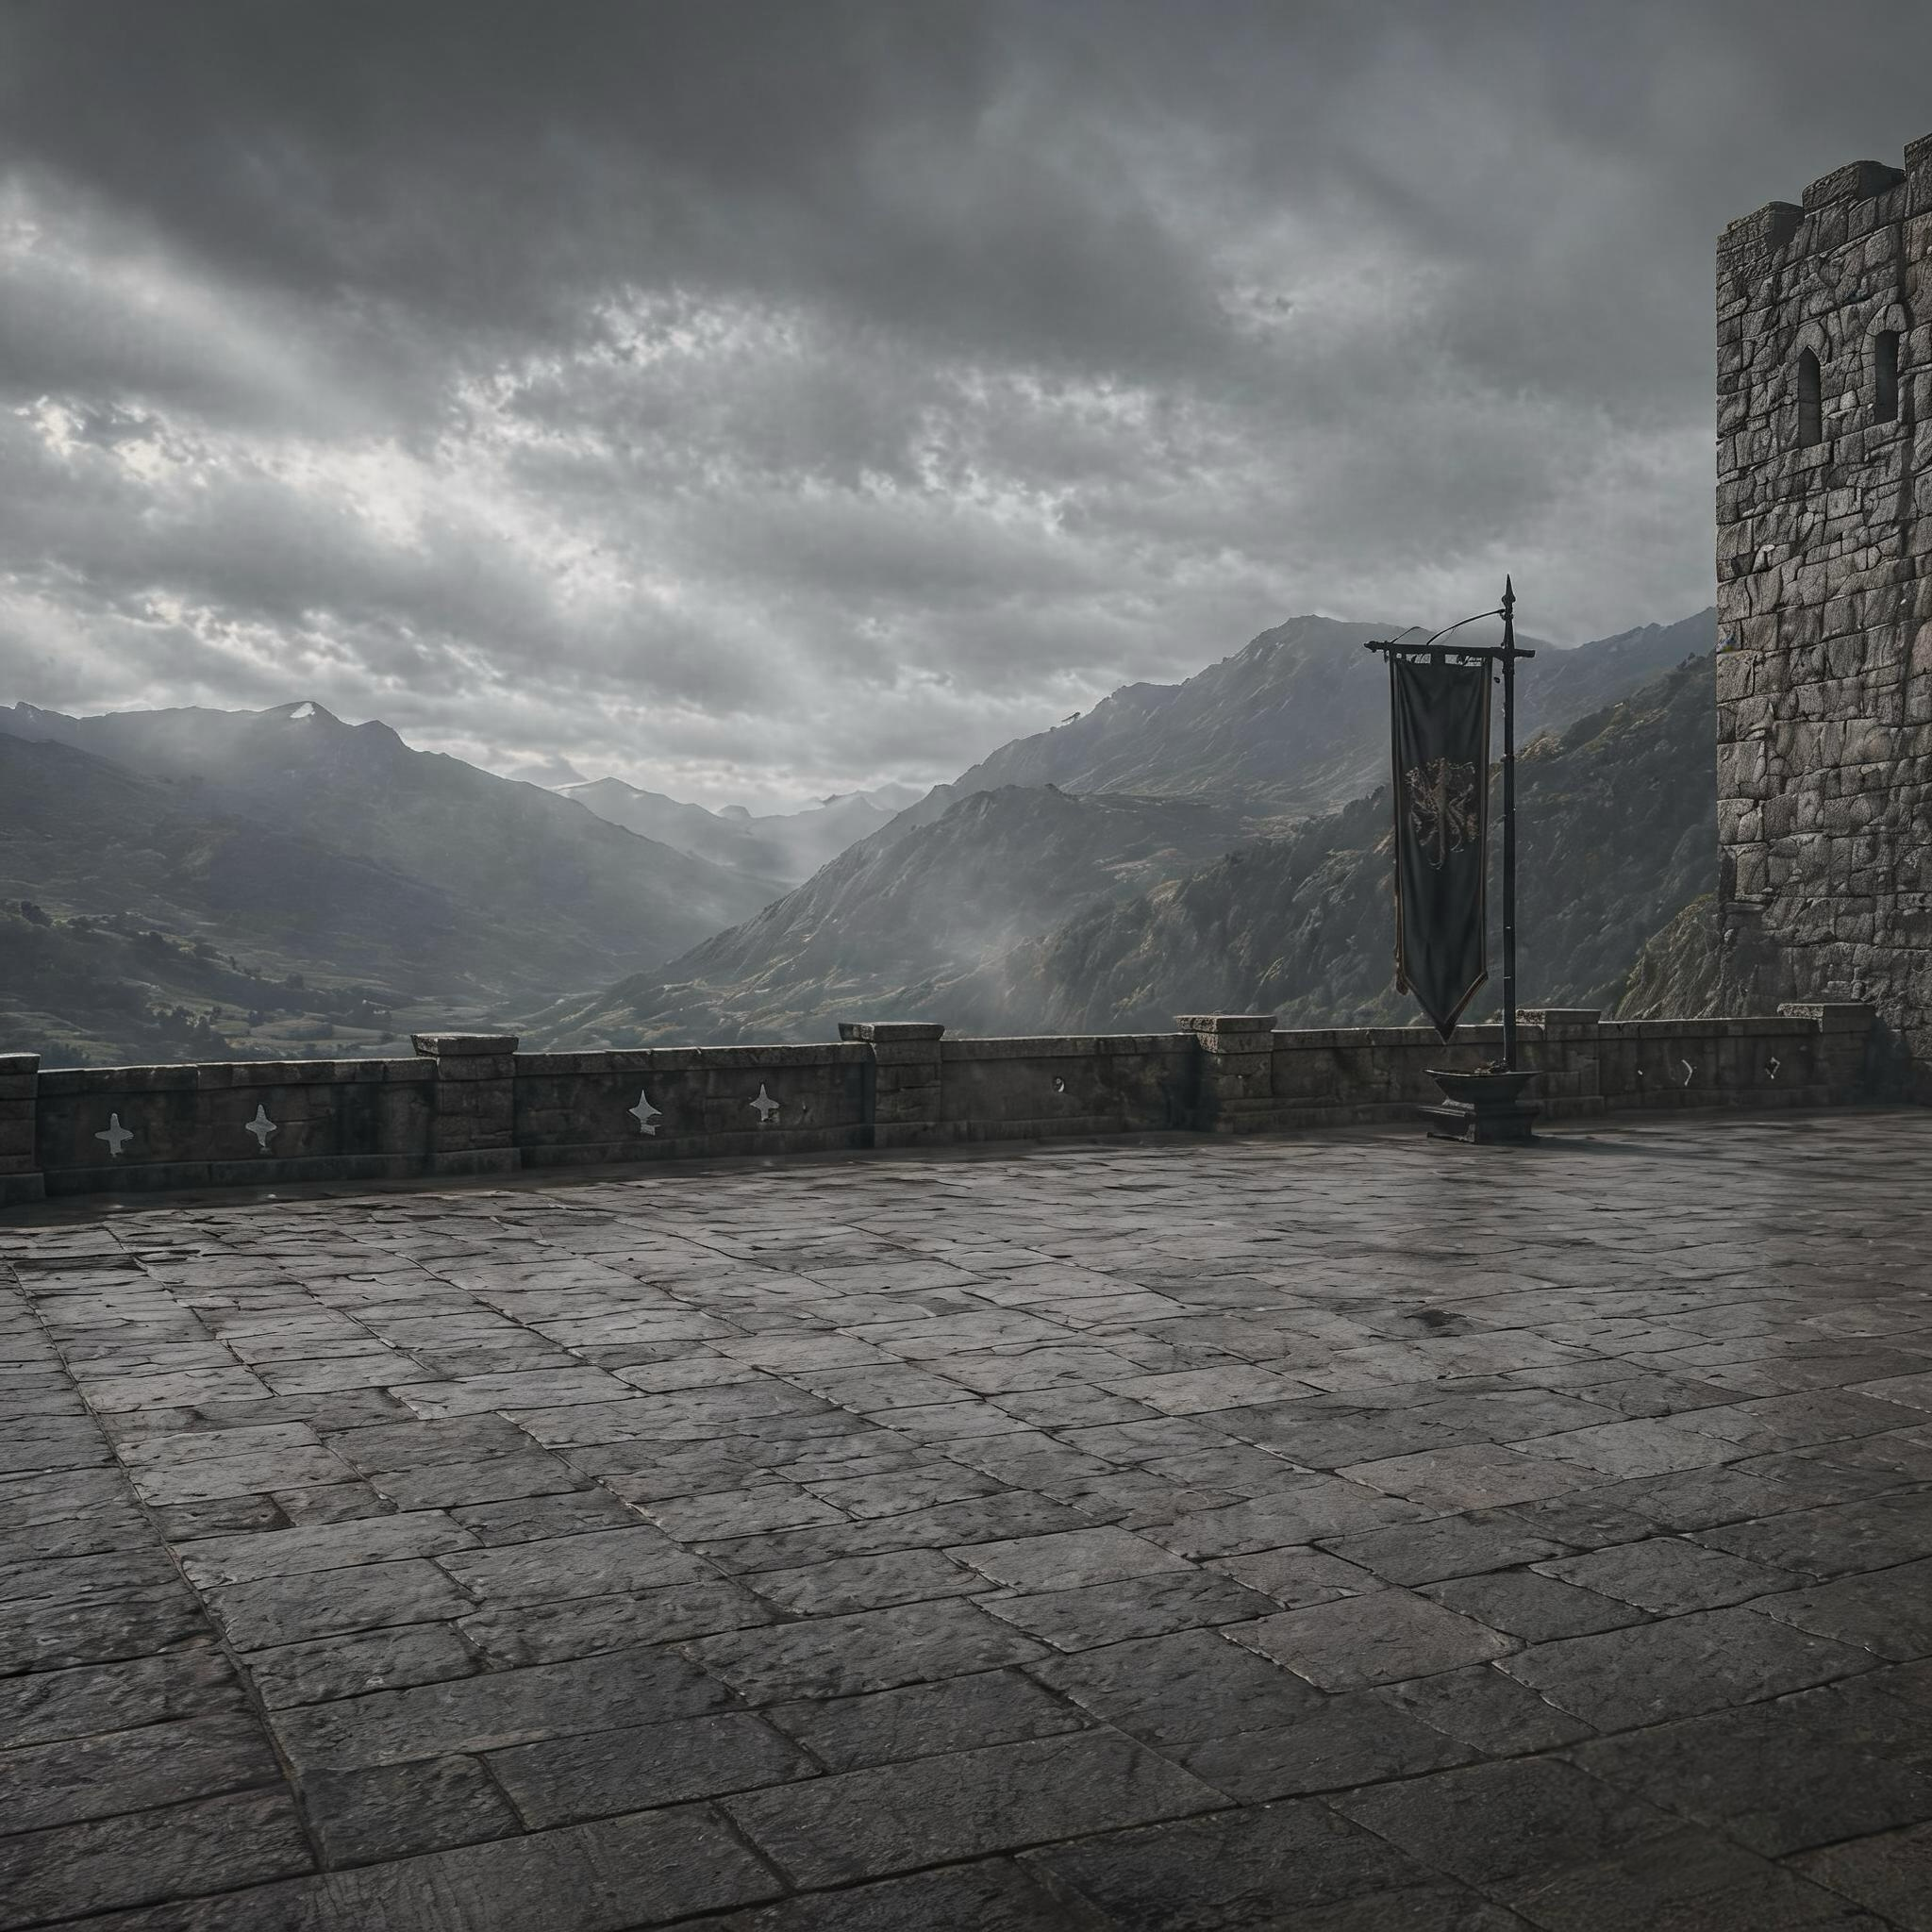
图片 1
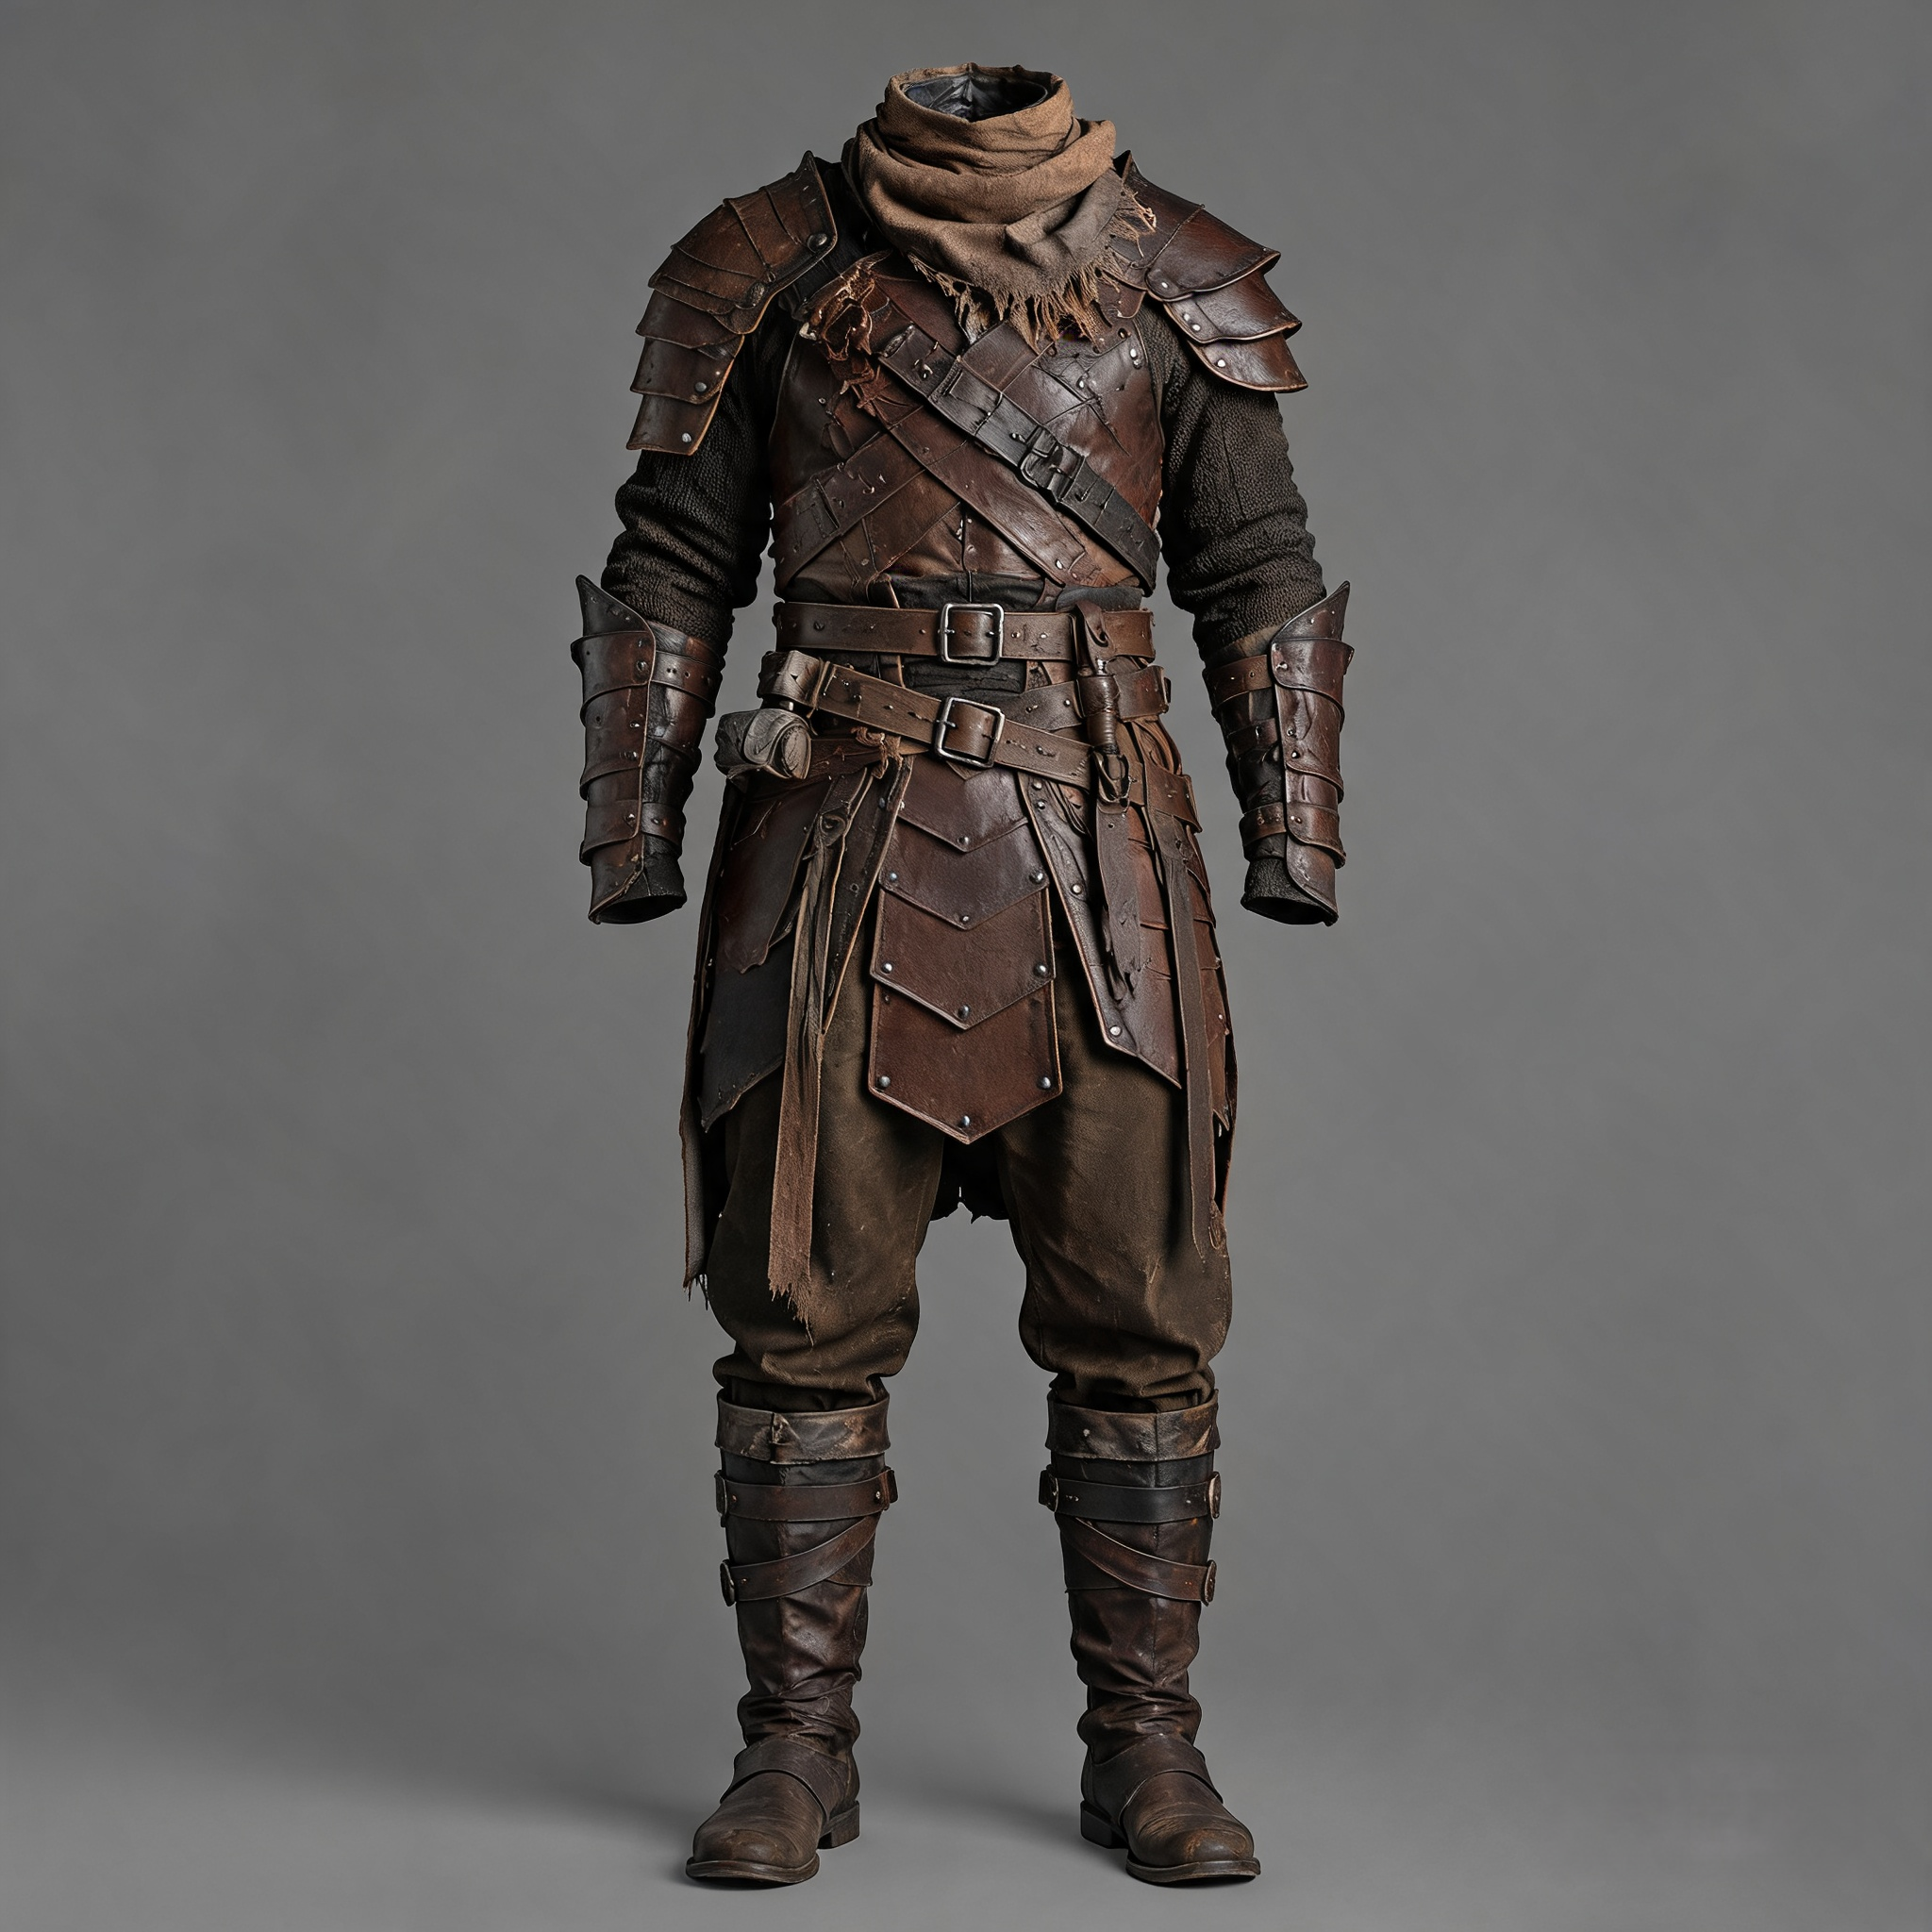
图片 2
输入:视频、图(续)
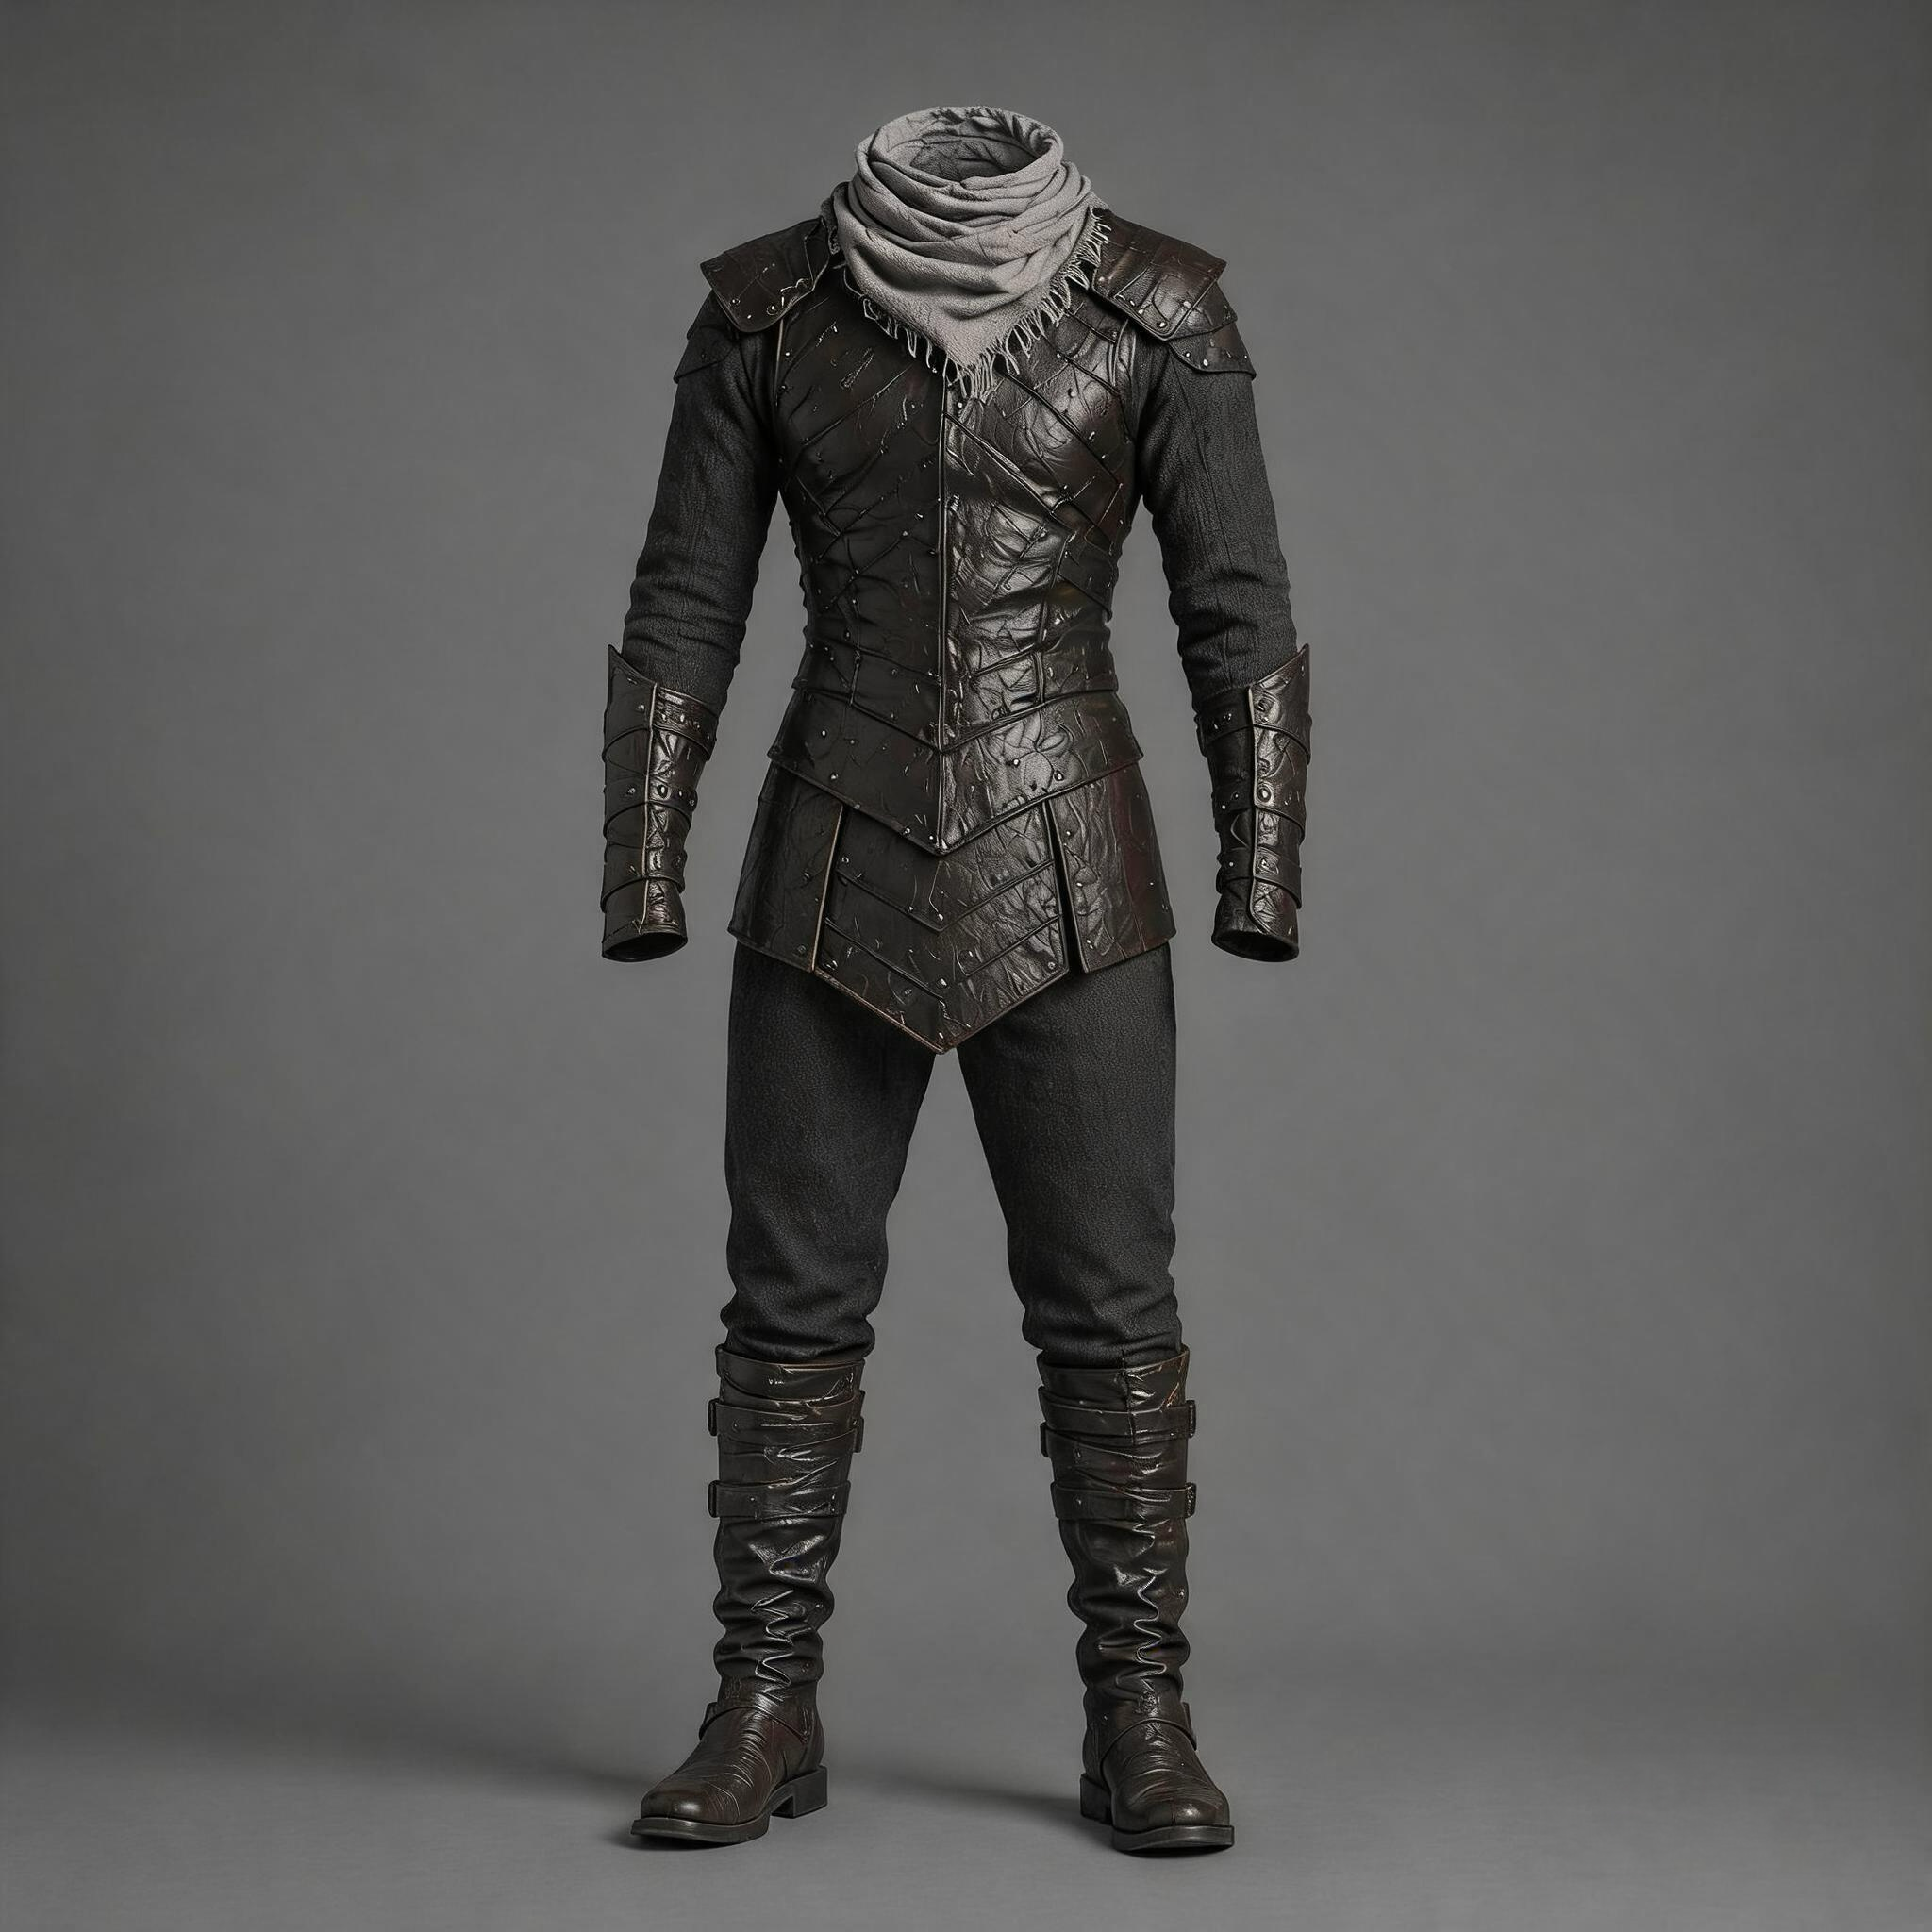
图片 3
Replay
00:00
/
00:00
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
视频 1
输出
Replay
00:00
/
00:00
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
视频音频编辑
输入:文本
将视频中的人声台词,翻译成中文,无字幕,口型做出对应的精准改变,其余均保持不变。
输入:视频
Replay
00:00
/
00:00
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
输出
Replay
00:00
/
00:00
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
其他
视频延长
延长任务,生成视频的音量较输入视频可能发生轻微变化;输入 Seedance 2.5 模型本身生成的视频做延长,音量变化相对较小,无缝衔接的效果更好。
输入:文本
在 @视频 1 的基础上续写 5 秒的视频,讲一只蜜蜂飞来落在画上,接着微距特写蜜蜂腿部和腹部沾满金黄色花粉颗粒,蜜蜂振翅起飞,镜头跟随它飞向另一朵同种花上,慢镜头中,花粉从蜜蜂绒毛上抖落,精准落入花蕊——授粉瞬间被放大。
注意
输出格式选择 MOV
输入:视频
Replay
00:00
/
00:00
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
输出
Replay
00:00
/
00:00
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
拼接后的视频:
Replay
00:00
/
00:00
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
注意观察第 15s 附近,没有拼接痕迹
一键成片
输入:文本
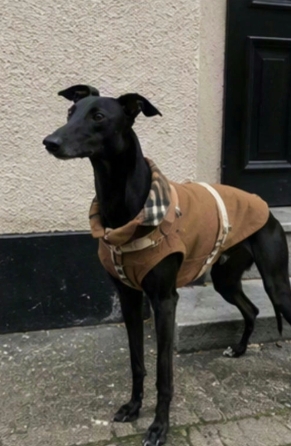
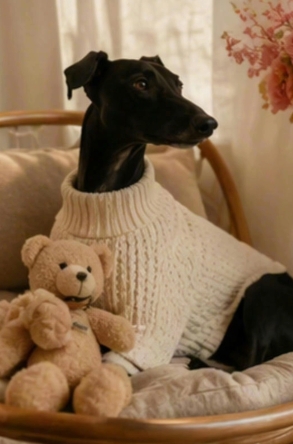
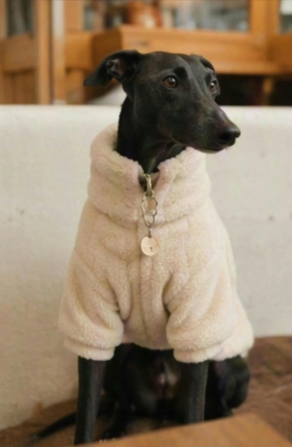
将所有图片进行一键成片,图片顺序自由安排,生成一个手绘动态涂鸦抠像风格的咖啡店 vlog,记录一只小狗穿着不同可爱服装在咖啡店打卡拍照的趣味日常。生成具有网感的趣味音频或者 bgm。
图片可以微微动起来,live 图的效果,但不要改变原图,保持和原图的高度一致。
输入:图
图片 1
图片 2
图片 3
输入:图(续)
图片 4
图片 5
图片 6
输入:图(续)
图片 7
图片 8
输出
Replay
00:00
/
00:00
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
视频无缝转场
输入:文本
将【视频 1】和【视频 2】衔接起来,【视频 1】的视角急需飞行至顶端快速折返,视角垂直向下俯冲,然后无缝自然地衔接转场到【视频 2】,在镜头切换的过程中麻将牌慢慢变成高楼。整个场景也对应变化,同时不要改变上传的两个视频。
输入:视频
Replay
00:00
/
00:00
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
视频 1
Replay
00:00
/
00:00
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
视频 2
输出
Replay
00:00
/
00:00
Live
Play
00:00
Fullscreen
Cssfullscreen
Click and hold to drag
总结
Seedance 2.0 已经完成了核心生成能力的明显突破,而 Seedance 2.5 是在此基础上面向真实生产场景做系统性补强:包括更长视频生成、更多素材参考、更稳定的编辑/续写能力,以及在画面宽高比、音画衔接、可控性和工作流适配上的优化。
Seedance 2.5 的价值不只是「单条视频效果更好」,而是让模型在可复用、可交付、可规模化生产这些关键环节上更进一步。它把 Seedance 从「效果惊艳的创作模型」,继续推进到更接近端到端工业化视频生产的阶段。
最近更新时间:2026.09.18 18:42:16
这个页面对您有帮助吗?
有用
有用
无用
无用