You need to enable JavaScript to run this app.
文档中心
火山方舟

火山方舟

复制全文
下载 pdf
推理
推理方式概述
复制全文
下载 pdf
推理方式概述
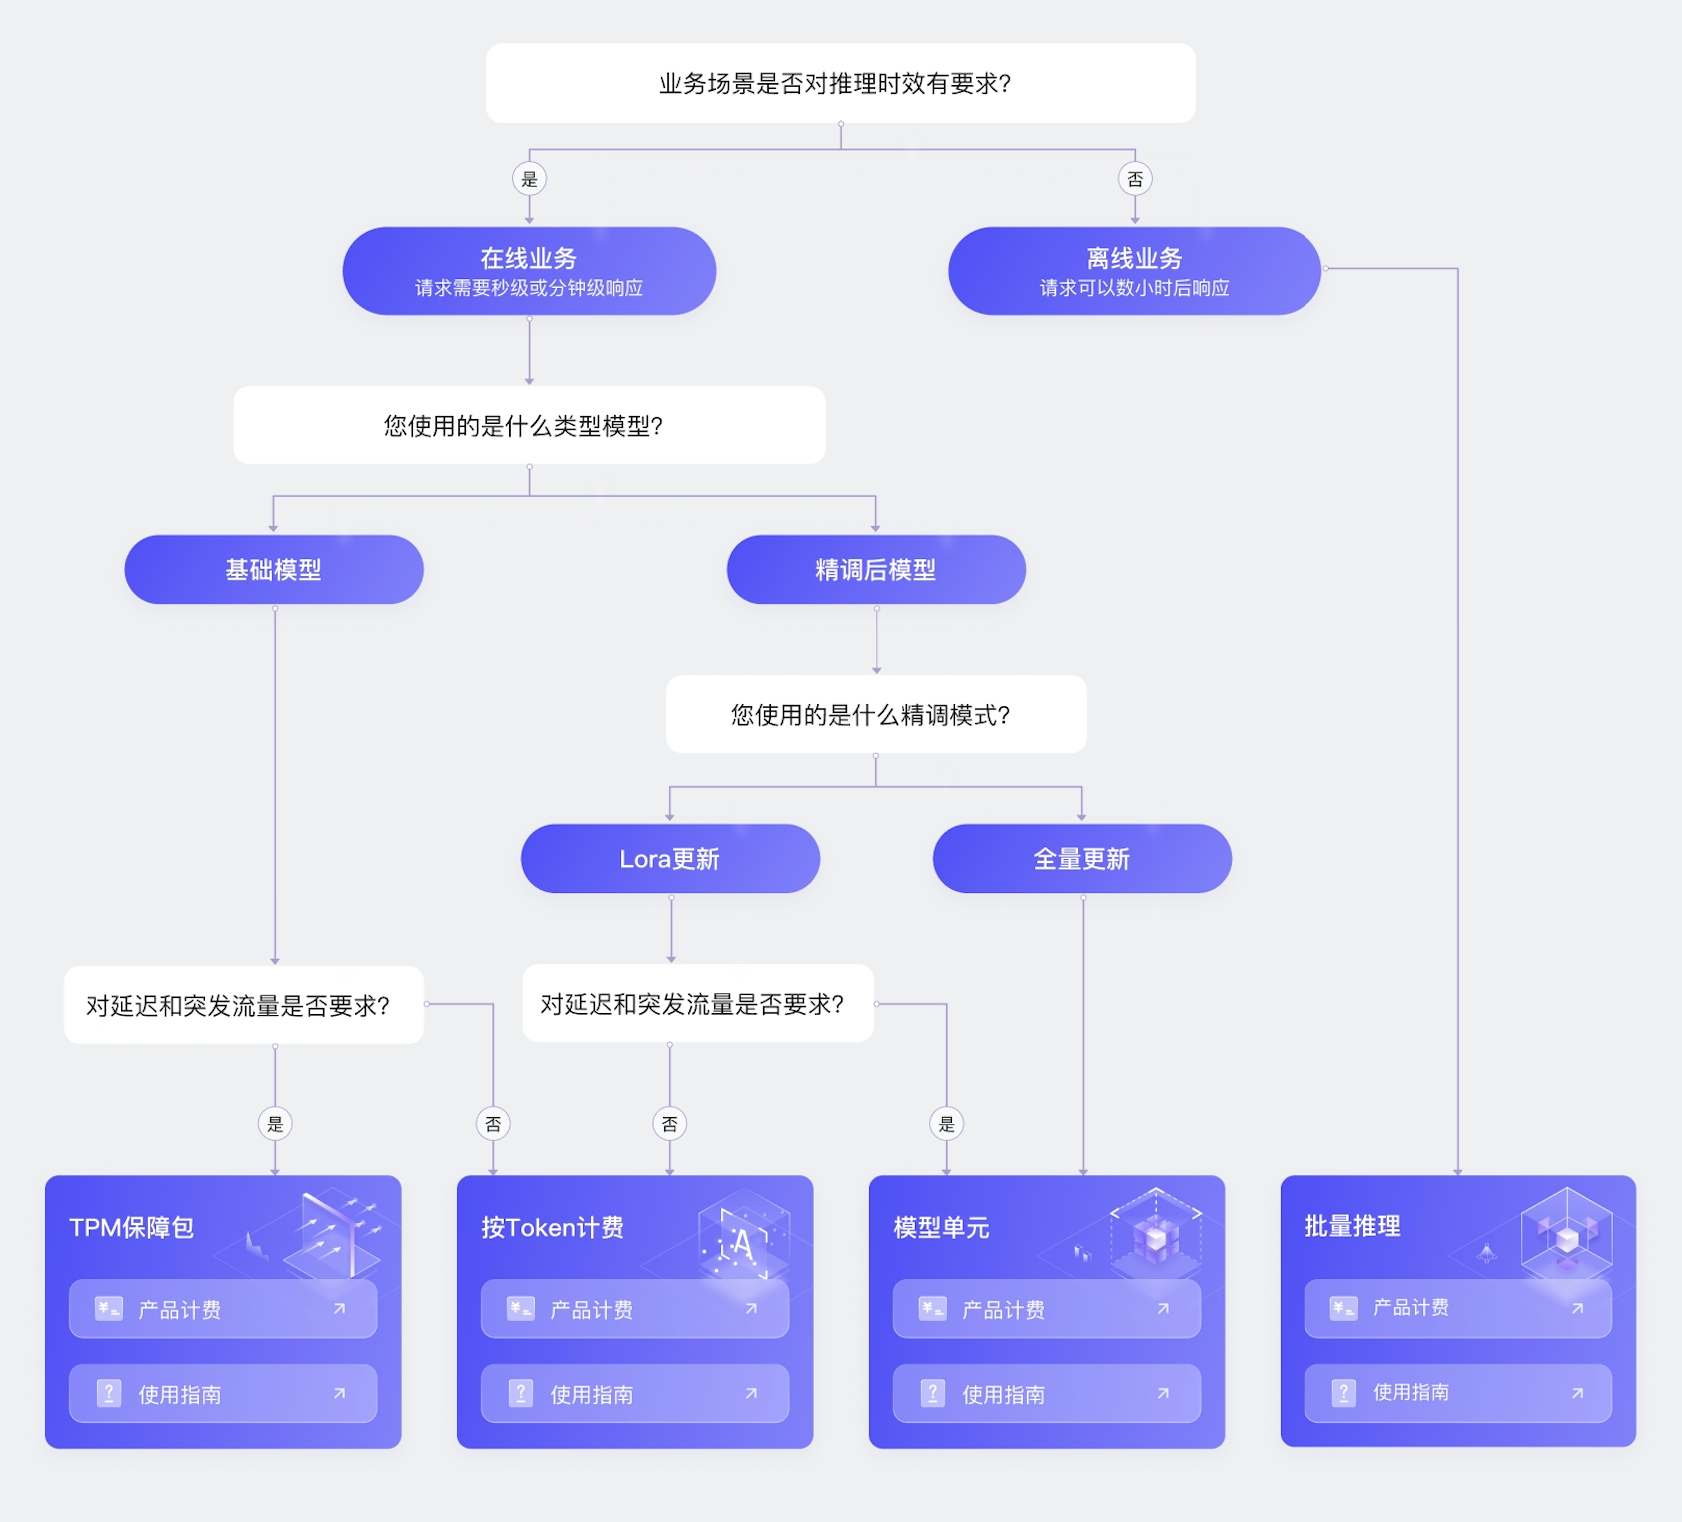
火山方舟按照业务场景、资源优先级支持多种模型推理方式,本文介绍各种推理方式的特点,方便用户进行选型。​
说明​
如果您是新用户,或者希望快速验证模型效果,直接通过 Model ID 调用方舟模型即可(方舟会自动匹配对应模型的预置推理服务,无需额外部署),详情参见 快速入门。​
推理方式对比​
​
推理方式​
在线推理(常规)​
在线推理(低延迟)​
在线推理(低优)​
在线推理(TPM保障包)​
在线推理(模型单元)​
批量推理​
智能模型路由​
简介​
部署在公共资源池,按模型调用量计费,使用受平台资源水位影响。​
部署在平台预留资源,为延迟敏感场景提供更优的输出 token 生成速率(TPOT)体验。​
使用低优资源,按 token 计费,以更优惠的价格提供尽力而为的推理服务。​
部署在平台预留资源,保障模型请求并发达到一定 TPM( Tokens Per Minute),溢出部分可叠加按 Token 计费​
独占算力资源,精调后模型在线推理的高保障方案​
请求无需实时响应,价格是常规在线推理的一半​
动态分析用户请求,根据路由策略智能选择调用的模型,适用于在线推理场景​
关键规格​
  • 通用推理方式​
  • 后付费按 token 计费​
  • 低接入成本​
  • 可与其他在线推理方式组合使用​
  • 较低输出延迟​
  • 后付费按 token 计费​
  • 低接入成本​
  • 可与在线推理(常规)组合使用​
  • 自动降级,缓冲突增流量​
  • 独立 TPM 配额​
  • 后付费按 token 计费​
  • 支持闲时段申请更高 TPM 配额​
  • 可与其他在线推理方式组合使用​
  • 极低输出延迟​
  • 资源包购买,预付费方式,溢出部分按 Token 后付费​
  • 保障以及超过默认限流额度的并发​
  • 独占算力,性能更稳定可靠​
  • 灵活度高,支持复杂场景,特殊延迟/并发需求​
  • 配额高,一次性离线处理大量数据​
  • 成本更低​
  • 简化选型:自动匹配最优模型​
  • 使用灵活:支持成本优先、效果优先等路由策略​
支持模型​
  • 平台基础模型​
  • Lora精调后模型​
  • MLP 推理服务(方舟不计费)​
平台基础模型​
平台基础模型​
平台基础模型​
  • 平台基础模型​
  • 全量/Lora精调模型​
  • 上传的自定义模型​
  • 平台基础模型​
  • 全量/Lora精调模型​
平台基础模型​
适用场景​
  • 追求高性价比,对延迟和并发要求相对较低​
  • 可接受偶发资源紧张报错或无法预估准确流量的业务​
  • 对交互延迟高度敏感​
  • 请求流量有一定波动,希望按需付费​
  • 在保障包溢出流量需获得低延迟。​
  • 时延不敏感、可重试、可等待的批量或后台任务​
  • 非关键在线链路​
  • 追求更低延迟,更高并发​
  • 可预估流量大小的高流量业务​
  • 无法接受偶发的资源紧张报错的业务​
  • 全量精调后模型的大规模推理业务​
  • 生产级高SLA要求的场景,拥有极致的灵活性和成本效益​
用户无需关注单次请求的执行情况,适合模型评测、批量回归等数据量较大的场景​
  • 希望智能选择最合适的模型​
  • 希望在保证一定效果的同时,通过部分请求路由到小模型来降低成本​
计费方式​
计算Token使用量​
不调用不计费​
计算Token使用量​
不调用不计费​
计算 token 使用量​
不调用不计费​
按输入和输出分别购买TPM额度​
  • 按天预付费​
  • 按购买时长后付费​
购买模型单元个数​
  • 按月预付费​
  • 按购买时长后付费​
计算Token使用量​
不调用不计费​
计算Token使用量​
  1. 对实际路由的模型按Token调用量计费,不调用不计费​
  1. router模型暂不收费​
价格比较​
低​
中​
较低,输入和输出 token 单价约为常规的一半​
中​
高​
较低,输入和输出 token 单价约为常规的一半​
低​
​
选择建议​
  • 对时延不敏感,可接受等待或失败重试,希望降低批量及后台任务成本,推荐使用在线推理(低优)。​
  • 企业级用户,需要更强的资源确定性保障(如更高可用性承诺、固定吞吐保障),推荐使用在线推理(TPM 保障包)。​
  • 企业级用户,希望独占算力资源,实现低成本高性能的大规模在线推理,推荐使用模型单元,请参见模型单元概述。​
  • 如需由平台托管并完成整批任务,且可接受较长完成时间,推荐使用 批量推理 Batch Job,适合超大规模刷数以及需要任务状态、结果文件和失败恢复的场景。​
  • 没有明确使用的模型,希望按照成本/性能等选择最优模型,推荐使用智能模型路由。​
  • 已在 MLP(火山机器学习平台) 部署模型服务,希望通过火山方舟平台统一调用,请参见使用 MLP 推理服务。​
​​​
附:推理接入点介绍​
推理接入点是用户调用模型进行推理的入口。按照类型分为:​
  • 预置推理接入点:当用户凭借 Model ID 调用火山方舟模型时,系统会自动匹配对应模型的预置推理服务;若不存在,则自动创建。适合新手使用、功能测试或轻量级使用场景。​
  • 自定义推理接入点:由用户主动创建。所有在线推理方式,均通过自定义推理接入点来接入。功能更强大,适合各种业务场景。​
​
类别​
功能/特性​
预置接入点​
自定义推理接入点​
推理方式​
在线推理(常规)​
√​
√​
​
在线推理(低延迟)​
√​
√​
​
在线推理(低优)​
√​
√​
​
在线推理(TPM保障包)​
×​
√​
​
模型单元​
×​
√​
​
智能模型路由​
×​
√​
​
批量推理​
×​
×​
在线推理​
API 调用​
通过 Model ID 或 Endpoint ID 调用​
通过 Endpoint ID 调用​
​
支持模型​
火山方舟基础模型​
火山方舟基础模型和精调模型​
​
模型版本平滑切换​
×​
√​
​
配置接入点限流​
√​
√​
​
开启/停用接入点​
×​
√​
​
查看监控​
√​
√​
​
安全审计(会话、传输加密)​
√​
√​
​
细粒度权限管理(项目、标签)​
√​
√​
应用实验室​
零代码应用​
√​
√​
​
高代码应用​
√​
√​
模型评测​
模型评测​
×​
√​
数据投递​
数据投递​
×​
√​
​
​
最近更新时间:2026.10.12 20:39:37
这个页面对您有帮助吗?
有用
有用
无用
无用