火山方舟
火山方舟


文档指南

请输入


- 文档首页
 火山方舟训练模型精调精调 SDK 使用指南
 复制全文
 下载 pdf
精调 SDK 使用指南
 文档反馈
 问问助手
概述
火山方舟精调 SDK 是火山方舟为开发者提供的 通过编程方式创建和管理大模型精调任务的工具包 ,旨在为需要定制化、自动化精调流程的用户提供灵活、高效的操作入口。区别于控制台的图形化操作,开发者可通过 SDK 将精调任务创建和管理流程集成至本地或第三方系统,实现精调任务的代码化管理,尤其适用于需要结合自定义函数(如奖励函数、Rollout函数)的强化学习场景。
目前精调SDK支持的模型及训练方式如下:
以下是您可以参考的精调SDK入门流程
精调 SDK安装与环境准备
前提条件
- 您已在火山方舟控制台开通目标模型服务、精调算力计费项及依赖的云产品(TOS-数据存储、KMS-数据及模型加密、TLS-日志及轨迹存储、veFaaS-运行plugin函数)。
开通模型服务、精调算力计费项 | 开通云产品及授权 |
| |
SDK 安装
您可以通过以下 pip 命令安装精调 SDK。
运行环境:python>=3.10
版本升级
自动版本检查
从 0.6.0 版本开始,SDK 自带升级通道。CLI 在常规命令运行前会顺手做一次"是否有新版"检查,发现落后会进行提醒提示;手动执行 ark upgrade 则会真正把新版本拉下来装上。
为避免每次都发网络请求,结果会写在 ~/.ark/upgrade_check.json,TTL 24 小时。所以如看到提示后来升级也不会被反复打扰;同样,版本更新后,本机最多隔一天才会感知到。
检查静音
如不想被提示升级 SDK,可设置环境变量:
配置授权信息
您需要授权将 SDK 终端关联到指定的账号和项目。授权信息来源按以下顺序解析,前者命中就不走后者:
- CLI 命令参数(-ak/-sk/-sts 或 --credential-file)
- 同名环境变量
- ark login 已落盘的 ~/.ark/authorization.json 鉴权结果
授权方式包括交互式登录、参数化登录以及单次 CLI 命令级授权。
ark login 交互式登录
使用 ark login 命令开启授权过程,适用于本地开发环境的首次配置。
- 在终端工具中,使用ark login命令开启授权过程
- 请按提示依次输入以下信息,以回车结束
- AK/SK:密钥包括 Access Key ID(简称为 AK) 和 Access Key Secret(简称为 SK),详情请参考 Access Key(密钥)管理
- Region:输入您需要访问的可用区,默认为 cn-beijing ,对应华北2(北京)
- Project:选择您的项目,默认为 default
ark login 参数化登录
如果需要在脚本或自动化环境中完成登录,可以在 ark login 命令中通过参数传入授权信息,减少人工交互。不同环境下可用参数可能随 SDK 版本变化,建议先执行 ark login --help 查看当前版本支持的参数。
CLI 命令级授权
除使用 ark login 写入默认授权信息外,您也可以在单次 CLI 命令中通过参数指定账号、项目、Region 等授权信息。该方式适用于 CI/CD、临时调试或需要在同一终端中切换多个项目的场景。
说明
命令级授权不会替代本地默认登录配置。若某个参数在命令级和默认配置中同时存在,以命令级参数为准。
创建精调任务
项目的初始化
您可通过ark init workspace <文件夹名> --template <模板名>命令,使用指定的template模板初始化一个具备基础结构和配置、可立即使用的精调项目,例如:
目前支持的模板如下:
template 模板名 | 简介 |
rl_demo | 该模板通过强化学习,使模型精准掌握自定义函数调用天气工具的时机与方式,实现更精准流畅的天气问答功能。可按需扩展至强化学习微调场景:通过强化学习微调大型语言模型(LLM),使其通过对话(Chat)API智能结合自定义工具完成特定功能。 |
rl_search_mcp_demo | 模板通过强化学习微调大型语言模型(LLM),优化其在深度搜索(Deep Search)场景下的性能。经训练后,模型增强了对复杂搜索意图的理解能力,可高效准确调用MCP/外部搜索API,进而生成高质量且精准的搜索结果与答案。 |
精调参数的配置
您可以通过 Python 对象(job.py)或 YAML 文件(job.yaml)配置精调项目相关参数。两种方式使用同一套元数据字段,适用场景如下:
- Python 对象配置:适合需要在代码中动态组装参数、复用函数逻辑或结合自定义 Plugin 开发的场景。
- YAML 文件配置:适合配置相对固定、需要在 CI/CD 或命令行中复用同一份任务配置的场景。
精调项目相关参数包括:
- 必选参数:
- customization_type:训练类型,支持 FinetuneSft / FinetuneLoRA/DPO/DPOLoRA/GRPO/GRPOLoRA/PPO
- model_reference:基础模型及其版本信息
- foundation_model: 基于模型广场模型训练
- name: 模型名
- model_version: 模型版本
- custom_model_id: 模型仓库模型 id,与foundation_model互斥(例:custom_model_id: cm-20251019092329-rxxxv)
- data:训练数据配置
- training_set: 训练集 (选择以下三种方式中的一种传入训练集)
- local_files: 一组本地文件,单个文件大小不可超过 2GB,最多传入 20 个文件
- tos_bucket、tos_paths: TOS桶名、TOS 对象列表(列表同时存在于一个桶内)
- datasets: 数据集配置
- dataset_id 数据集 id
- dataset_version_id 数据集版本 id
- multiplier 混入倍率
- sample_count 混入条数,与multiplier 互斥
- preset_dataset: 混入预置数据集配置,非必填
- dataset_version_id: 预置数据集 id
- inject_multiplier: 混入倍率,与混入样本条数互斥
- inject_sample_count: 混入样本条数
- max_invalid_records_ratio:数据集错误容忍百分比,与数据集错误容忍数量互斥(仅支持vlm模型的RL/GRPO训练方法配置错误容忍功能)
- max_invalid_records_number:数据集错误容忍数量
- validation_set: 验证集,非必填
- 支持 local_files / tos_bucket+tos_paths / datasets 形态的验证集,规范同上
- validation_percentage: 切分百分之多少的训练集作为验证集,与validation_set互斥
- 可选参数:
- custom_rl_pipeline:支持GRPOPipeline和PPOPipeline。该参数为强化学习流程配置,当训练方式为 GRPO或 PPO 时必填,详见强化学习配置。
- enable_trajectory: 是否开启记录轨迹分析功能(仅支持对 RL 训练开启)。开启此功能后,系统自动采集训练过程各样本的数据输入输出结果,记录强化学习精调轨迹,并展示于方舟控制台轨迹分析功能下。此记录有助于模型效果分析与问题排查,对强化学习至关重要,建议训练前开启。(该功能需完成日志服务配置,需先联系管理员,前往 模型精调-TLS配置 开通)
- name:任务名称
- project:任务所属的项目
- hyperparameters:超参配置,超参信息查询方法见下
- save_model_limit:保存训练产物数量上限
- 获取训练可用超参信息
不同模型版本支持的训练超参数存在差异,需通过ark命令行工具查询指定模型版本的超参信息。
- 命令语法:
-
- 示例命令:
-
- 示例命令执行结果:
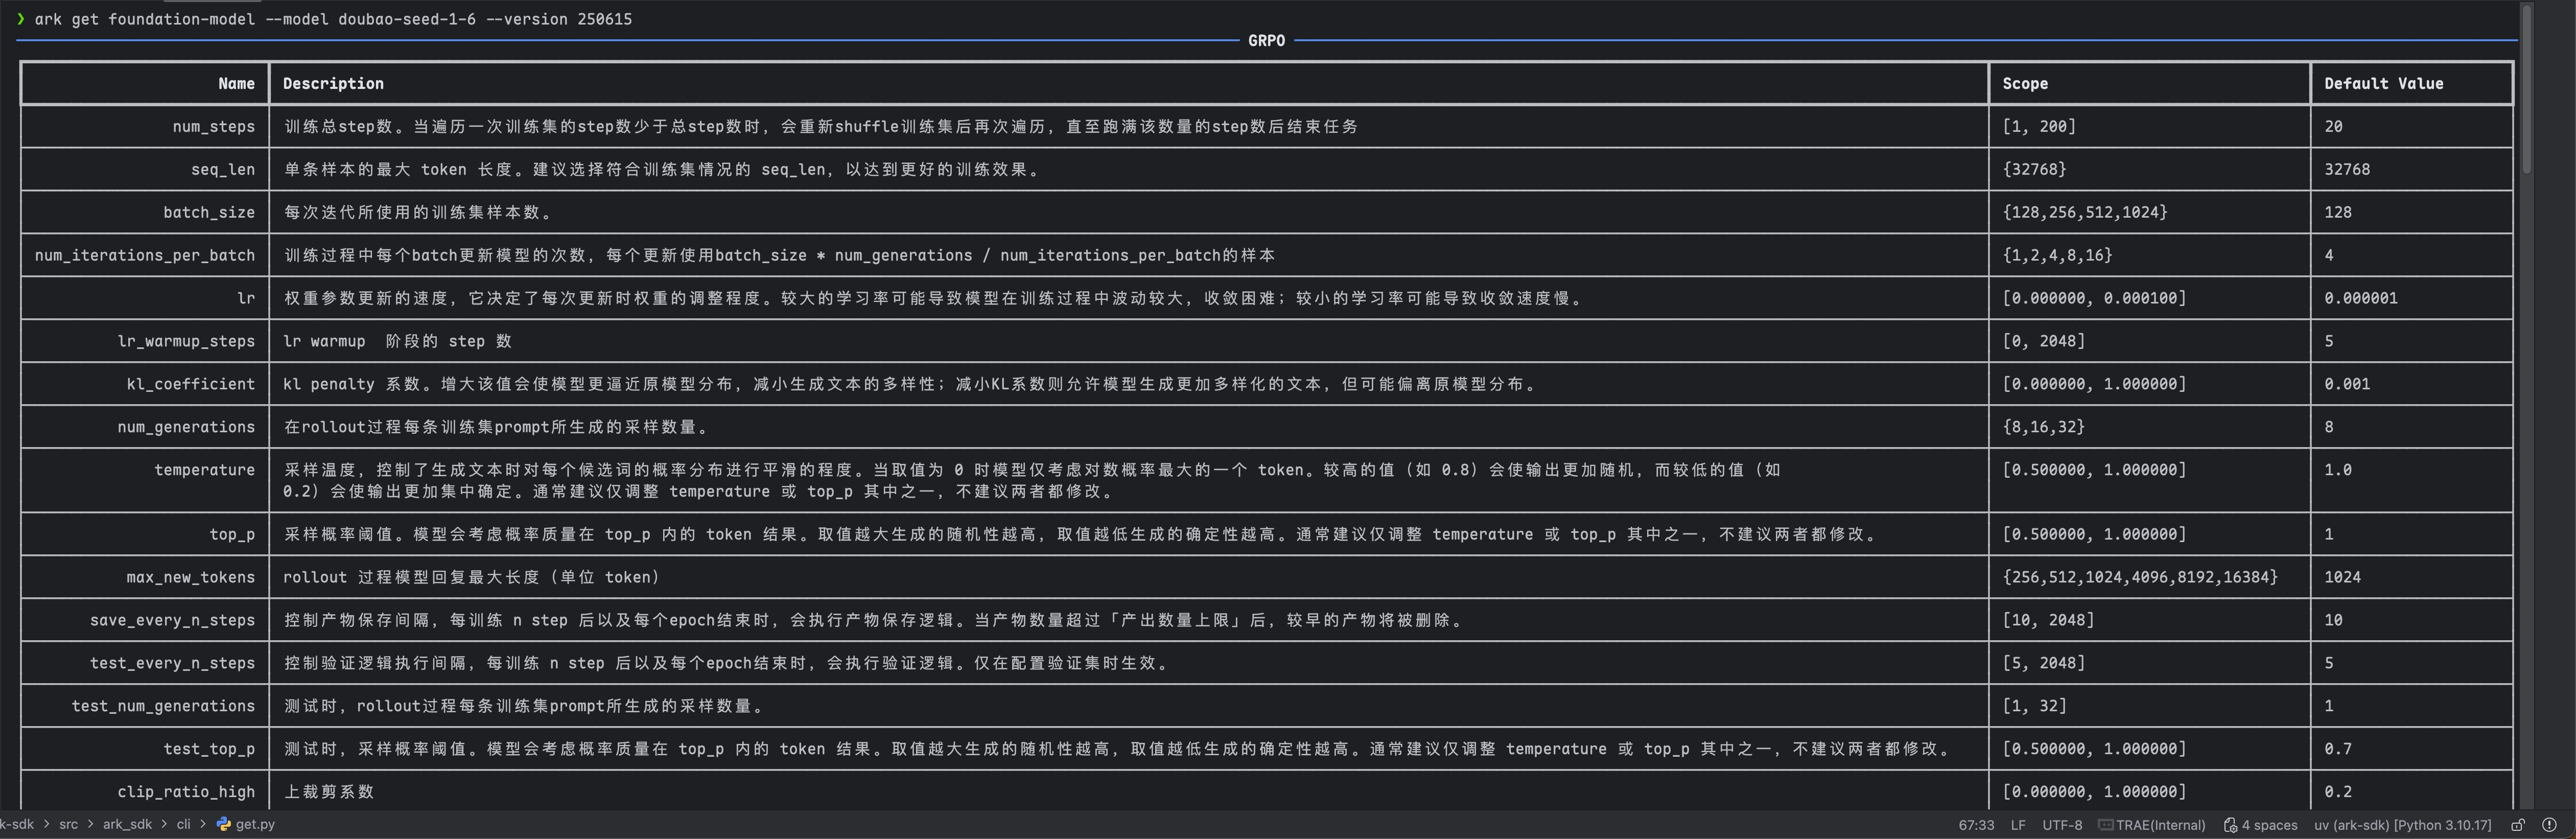
提交精调任务
- 通过 Python 对象完成上述配置后,可通过下面的命令提交精调任务。
-
- 通过 YAML 文件完成上述配置后,可通过下面的命令提交精调任务。
-
强化学习配置
强化学习流程
创建强化学习任务时,需配置强化学习流程custom_rl_pipeline,先选定 pipeline 类型,再按要求配置对应 plugin 函数。具体要求如下:
支持的 pipeline 类型 | GRPOPipeline和PPOPipeline |
rollout plugin 要求 | 仅支持填入 1 个自定义 rollout plugin,不填默认使用单轮模型推理 rollout 逻辑 |
grader plugin 要求 | 至少需要填入一个 grader plugin,支持填写多个并分别配置权重 |
强化学习插件(plugin)
目前支持以下自定义plugin类型:
- Rollout plugin函数,通过@rollout 装饰器标记,支持在函数内实现自定义Rollout逻辑(如某个特定业务场景的多轮推理、多次工具调用的agent)
- Grader plugin函数,用于计算reward奖励分数,目前支持:
- 单样本评分器(single_grader),通过@single_grader 装饰器标记。针对一条独立采样打分。平台将同一条样本的n_generation 拆解成多个请求分别独立打分。
- 多样本评分器 (group_grader),通过@group_grader装饰器标记。针对一组样本(不限定特定条数,一般为多条)打分,一次调用输入n_samples,返回一组得分
可在工作仓库任意位置实现满足规范的函数,并使用 SDK 提供的装饰器来为函数声明 plugin 相关的元信息与运行时配置。如果未填写装饰器信息,函数不能作为 plugin 函数使用。
说明
装饰器
用于标记 plugin 函数类型,声明 plugin 相关元信息与运行时配置。提交任务时将根据plugin类型校验是否满足函数签名和强化学习pipeline是否完备。
- 类型:支持@rollout/@single_grader/ @group_grader三种类型的装饰器
- 参数:
- name:可选,为 plugin 指定名字,不提供时默认使用函数名
- description:可选,为 plugin 附加描述
- runtime.instance:可选,指定 plugin 运行实例规格,当过载时可适当增加。默认值 CPU1MEM2(对应cpu1核内存2gb)、最大值CPU16MEM128,cpu核数:内存gb数=1:2、1:4、1:8
- runtime.timeout:可选,plugin 函数执行的超时秒数,默认值取决于服务端逻辑,最大值900。plugin耗时过高会导致训练资源闲置增加费用,建议尽可能优化减少耗时
- runtime.max_concurrency:可选,单 plugin 函数实例最大请求并发数,超该值触发扩容,可根据负载情况调整。默认值10,最大100,最小1
我们提供了以下Rollout plugin函数模板和Grader plugin函数模板,您可参考签名要求和函数模板实现所需函数。
Rollout函数
Rollout 函数主要实现 agent loop 的逻辑,函数提供 OpenAI 兼容的模型 API,用户完成 sample 过程。这个需用通过 @rollout这个装饰器来指定一些函数运行信息。
Rollout签名要求
入参
返回
Rollout函数模板
- ChatAPI+自定义工具
若需更底层的控制能力,可参考rl_demo中 raw_rollout.py 模板,手动调用proxy.update_state_from_messages和proxy.process_completion处理训练状态,实现同步化的底层逻辑控制。
- Arkitect框架+多轮推理+MCP
基于 Arkitect 框架与 MCP(Multi-Client Proxy)多客户端代理机制,适合融合多工具、复杂多轮推理的场景(如深度搜索、多步骤任务处理)。可参考rl_search_mcp_demo中draft_rollout_arkitect.py模板。
- Arkitect框架+functioncall+API调用插件
该方案结合 Arkitect 框架的 Function Call 能力与第三方 API 插件(如搜索 API),适合需要自定义 API 调用、严格参数校验的场景(如定制化搜索、第三方服务集成)。可参考rl_search_mcp_demo中 rolllout.py 模板。
Grader函数
Grader 函数用于计算reward奖励分数,目前支持通过@single_grader装饰器标记的单样本评分器和通过@group_grader装饰器标记的多样本评分器。
Grader签名要求
入参
返回
常用Grader函数
评分器的具体实现与效果定义和业务目标紧密相关,以下是一些常用的grader实现思路:
- 比较rollout结果和样本预设的答案(通过训练集extra字段传入)
- 全等/包含判定 可参考rl_demo中 random_reward.py
- 分别调用embedding模型计算相似度进行判定
- 使用LLM进行语义比较并打分
- RuleBase评分
- 输出格式判定
- token/字符串长度惩罚
- 根据过程耗时评分
- 调用外部服务/插件进行判定
- 调用Code sandbox运行代码,根据是否运行成功和运行结果与预设答案匹配度打分
- 创建excel/数据库表,根据是否创建成功打分
- 将输出的SQL语句用于查询指定数据库,根据是否能执行成功和结果是否符合预期打分
- 通过模型对单条样本进行打分
- LLM as a judge(基础模型 + prompt,可通过让模型在输出分值前思考并输出评分理由,提升评分准确性。同时也会增加训练服务的等待提高成本)可参考rl_search_mcp_demo中llm_grader.py
- 训练并部署GRM(可通过让模型在输出分值前思考并输出评分理由,提升评分准确性。同时也会增加训练服务的等待提高成本)
- 对多条样本排序赋分/综合打分
- 对一组样本进行排序的难度低于对多条轨迹分别打出准确分值。
可观测性配置
轨迹分析
在精调参数配置job.py文件中配置enable_trajectory=True,即可开启轨迹分析功能。开启后,系统将记录强化学习训练轨迹,可视化展示于方舟控制台模型精调的轨迹分析功能下。此记录有助于模型效果分析与问题排查,对强化学习至关重要,建议训练前开启。如需提前查看该功能效果,详见 轨迹分析 。
自定义函数日志
根据用户自定义需求记录Rollout、Reward函数执行中的关键信息,以精准定位问题、提高排查效率。
具体实现方面,在rollout.py文件内,通过logger.info、logger.error等方法完成日志记录操作。最终,这些日志将展示于方舟控制台模型精调的自定义日志功能模块下。
自定义效果指标
支持用户在 Grader 函数中自定义业务相关的评估指标,自定义后的指标将同步展示在方舟控制台模型精调的训练观测功能模块下,便于量化分析模型性能。
具体实现:在其metrics字段中补充自定义的键值对,将metrics与rewards、status、error一同封装至RewardFunctionResult对象中返回。
例如,可通过 NumPy 库计算奖励值的均值、标准差等统计指标并传入:
Tracing
为分析模型效果、定位问题,建议使用 Tracing 系统采集样本 rollout 每轮推理和工具调用的输入输出及耗时信息。
可选用任意 Tracing 系统,本文以ARK Tracing / cozeloop为例介绍使用方法,可参考示例调整。
ARK Tracing(推荐)
- 前置依赖
- 开启轨迹分析功能并开通日志服务配置,见 轨迹分析。
- 安装方舟精调 ark-sdk 0.2.17 及以上版本。
- 需要为需要上报 Trace 的函数注入 ARK_TRACE_AK、ARK_TRACE_SK 环境变量,值分别为用户的 AK、SK
-
- 为 AK、SK 对应的用户授权 TLS PutLogs 权限(具体方式参见 访问控制 文档)。
- 初始化与使用
- 对 Rollout、Grader 函数的输入输出Tracing:使用 @trace_monitor 装饰器包装 rollout、reward 函数,它基于 opentelemetry 进行数据上报,并将 trace 与轨迹关联,示例如下:
-
- 对 LLM Chat 的输入输出 Tracing:使用 wrap_inplace_trace 函数包装 LLM 客户端。示例如下:
-
- 对中间过程添加自定义Tracing:使用 @observe() 装饰器记录任意函数的输入输出。示例如下:
-
CozeLoop Tracing
- 配置与环境设置:cozeloop配置详情请参考 cozeloop SDK 使用指南。
- 本地运行配置:在终端中设置以下环境变量:
-
- 训练环境配置:需在 faas 的环境变量中添加如下内容:
-
- 使用方法:
- 对Rollout函数的输入输出Tracing:使用@coze_monitor装饰器包装 rollout 函数。该装饰器来自项目中的plugins/``coze_monitor.py文件,它基于 cozeloop 库进行数据上报,会从proxy中取出 rollout 实际的轨迹返回,并以精调任务的 ID 作为user_id(本地测试时user_id默认为test_service),方便在 cozeloop 平台上进行数据分析和筛选。示例如下:
-
- 对LLM Chat的输入输出Tracing:使用wrap_inplace_trace函数包装 LLM 客户端。示例如下:
-
- 对中间过程添加自定义Tracing:使用@observe()装饰器记录任意函数的输入输出。示例如下:
-
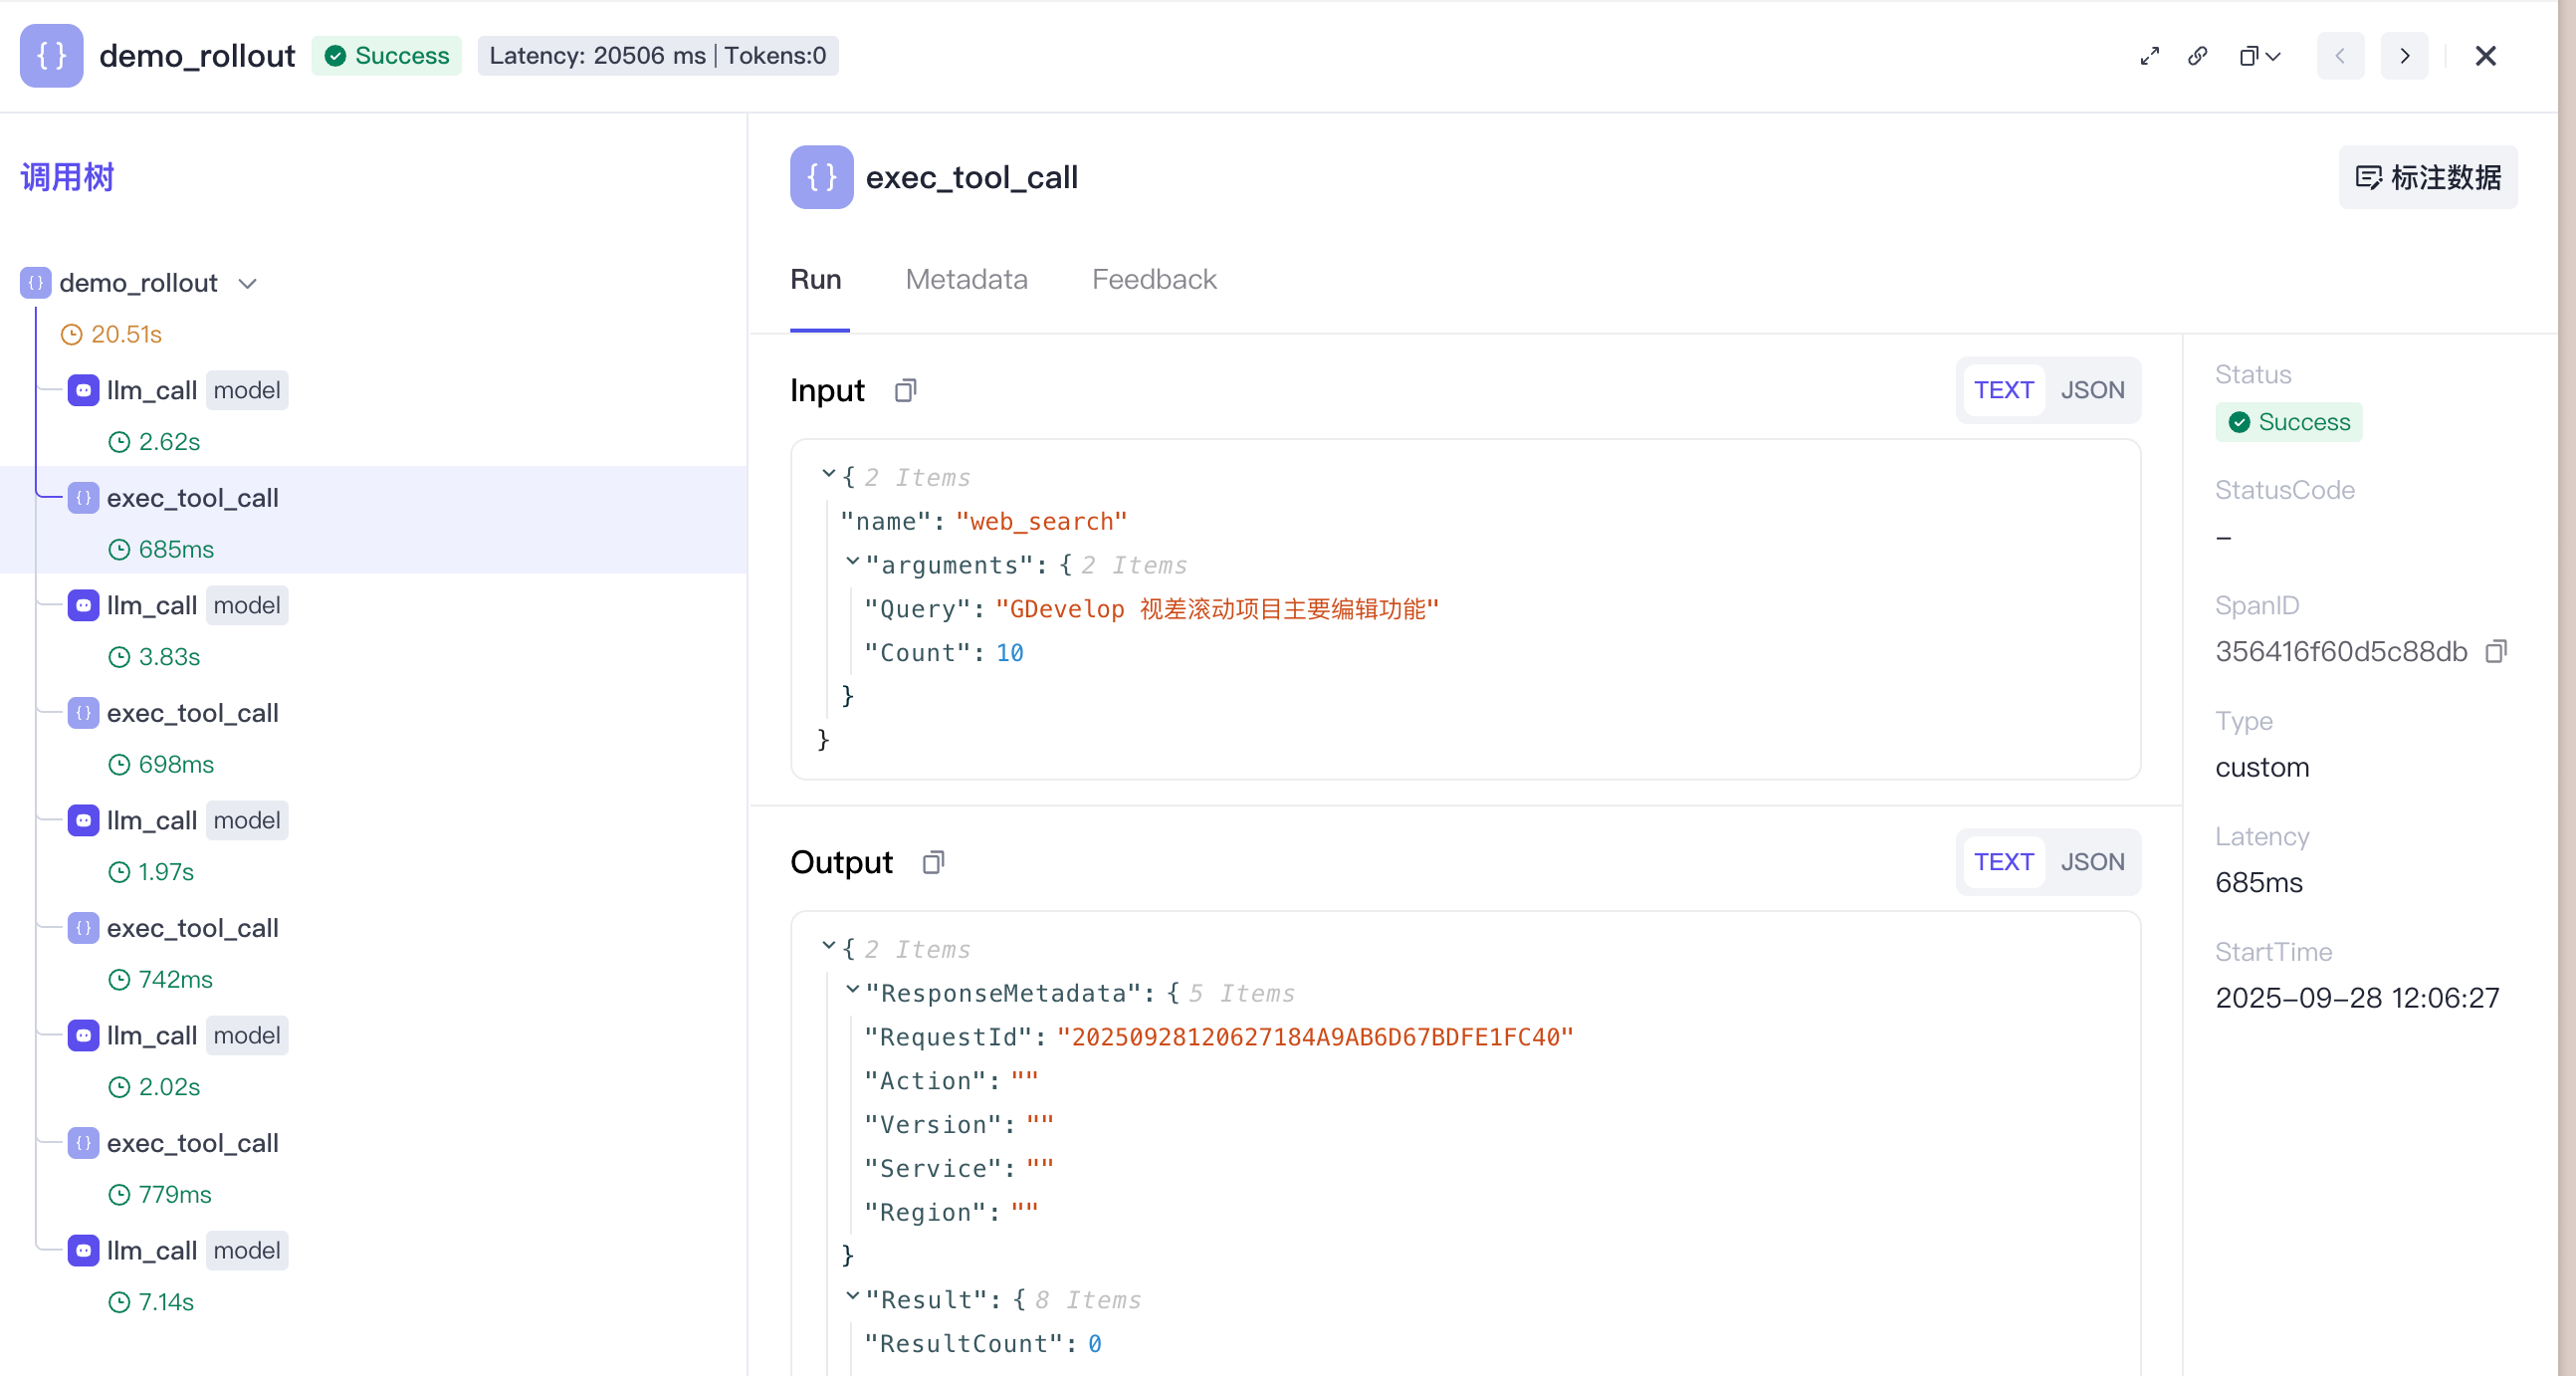
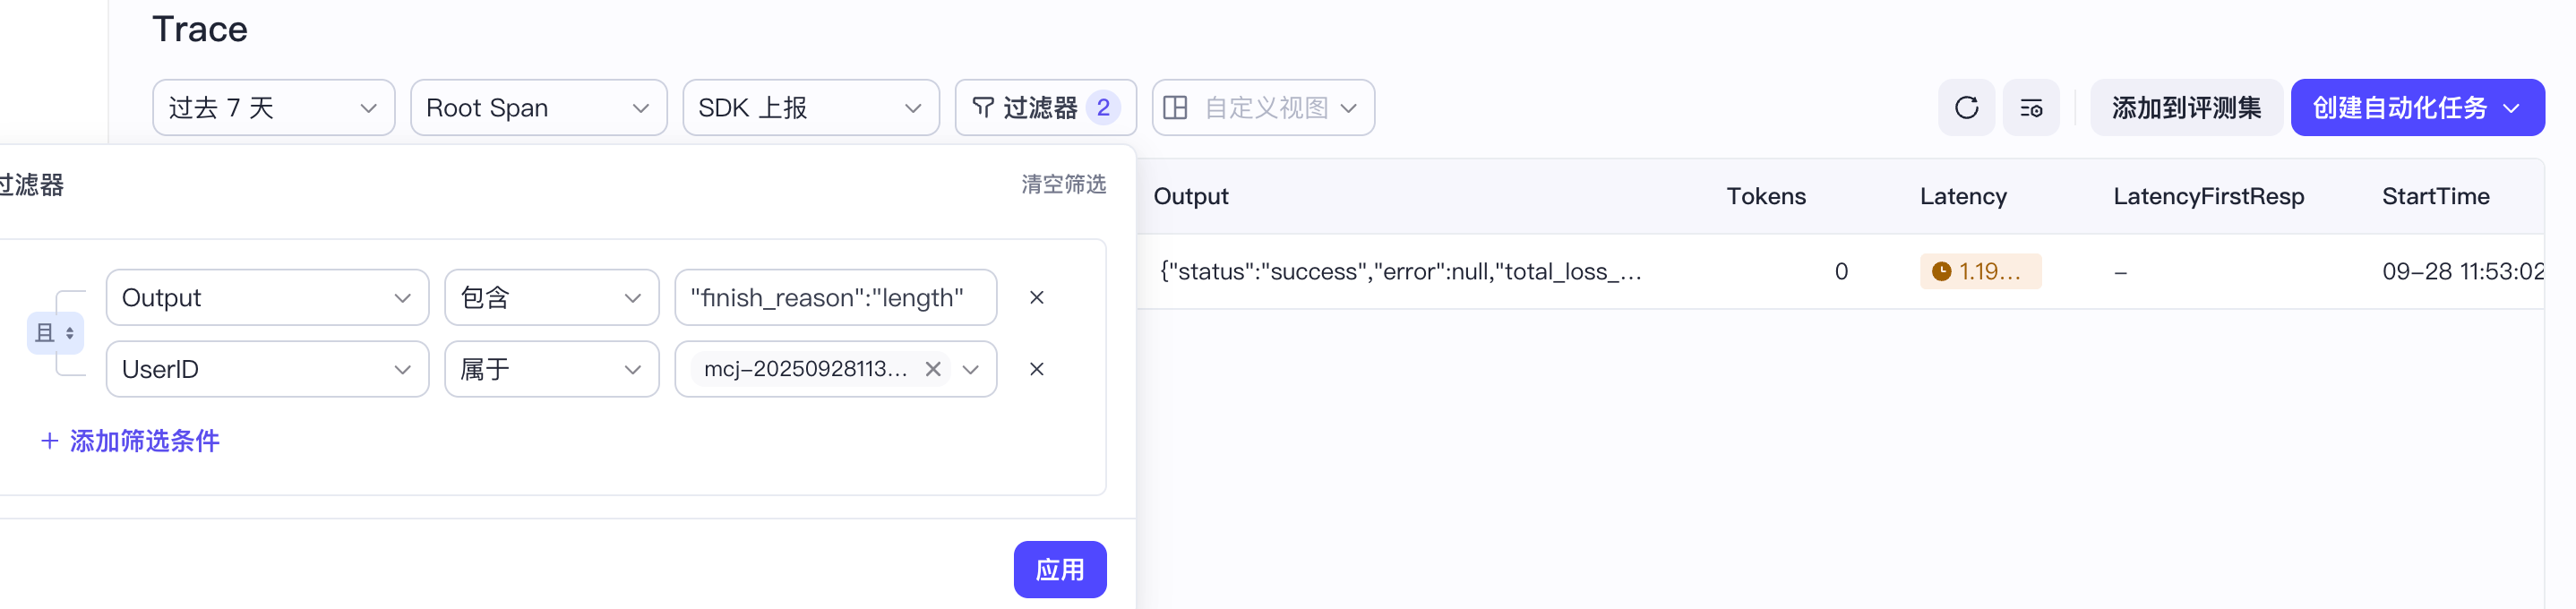
- Cozeloop 效果:若您完成了 cozeloop 配置,运行后可在 Cozeloop 平台观测 Rollout 过程,具体效果如下:
- 分析各阶段耗时,优化rollout链路
- 指定任务,筛选 结束原因为输出超长的 模型返回
Plugin函数的测试
为确保 Plugin 函数功能符合预期,在提交强化学习任务前,需先进行本地测试,再提交在线 FaaS 测试,最后提交训练任务。
本地测试
在实现 rollout 函数的文件里,main 函数展示了如何在本地测试rollout函数和grader函数的结合使用。它支持用户进行单样本调试和多样本批量调试。代码如下。
- 单样本调试:测试时会基于样本,调用 demo_rollout 执行推理,获取模型的回答;将模型的回答和原始问题、正确答案一起传递给 llm_grader 进行评估,并打印评估结果。
- 多样本调试:main 函数还展示了如何使用 test_with_dataset 函数对一个数据集中的多个样本进行批量推理和评估,以获取平均奖励分数。
在线FaaS测试
完成本地测试后,用户可采用 SDK 或 CLI 方式拉起在线运行环境对plugin函数进行测试。需先完成 requirements.txt 的更新,具体要求及测试方法如下:
- 更新requirements.txt:为避免 FaaS 环境装包时依赖自动升级引发异常,按以下规则生成requirements.txt:
- 本地环境验证通过后,推荐使用 uv 管理环境,执行uv pip freeze > requirements.txt固定间接依赖版本,过滤冗余依赖,精简依赖列表。
- SDK方式用法
运行demo中test_faas.py文件,具体代码如下:
- CLI方式用法
通过 ark test pipeline_plugin 命令,快速测试强化学习精调的自定义 Plugin 函数。
- 命令语法
-
- 关键参数
参数 | 必填 | 说明 |
--fn | 是 | 函数唯一标识,例:plugin.code_agent_grader:grader |
--request | 是 | JSON 格式请求体,具体样例可参考SDK用法。 |
--sync | 否 | 默认值为否,用于确定在执行前是否触发一次同步。 |
- 完整示例
-
提交调试任务
此功能需要使用 0.2.16 或更高版本的 SDK。
您可以提交一个调试任务,在不排队等待 GPU 资源的情况下,对数据和 plugin 进行端到端校验。在 rollout 过程中,该任务将请求您指定的 endpoint 来执行推理。
要提交调试任务,请在 ModelCustomizationJob 对象中设置 debug_config(包含 endpoint_id 和 apikey),并在调用 submit 函数时将 debug 参数设为 True。
通过 Python 脚本提交
通过 YAML 提交
执行以下命令可以完成 YAML 提交调试任务。
提交强化学习任务
完成 plugin 函数编写、测试和调试任务验证后,即可提交正式的强化学习训练任务。提交方式与普通精调任务一致,通过 Python 对象或 YAML 文件配置 custom_rl_pipeline 后执行提交命令。
- 通过 Python 对象提交:
-
- 通过 YAML 文件提交:
-
提交后,任务将进入排队调度阶段,您可通过控制台或 CLI 查看任务状态和训练进度。
使用资源组提交任务
如果您的账号或项目已经配置了专用资源组,可以在创建任务时指定资源组,让训练任务调度到对应资源池。资源组适用于资源隔离、稳定性保障或高优任务等场景。
使用资源组前,请确认:
- 目标资源组已经开通并授权给当前账号或项目。
- 当前精调任务的模型、训练方式和资源组能力匹配。
- 资源组参数名称和取值以当前 SDK / CLI 版本为准,可通过 ark create mcj --help 或 SDK 类型定义查看。
查看并管理精调任务
创建精调任务后,您可以通过控制台和 CLI 命令行两种方式查看和管理精调任务。
控制台
CLI 方式
CLI命令整体使用格式为 ark [verb] [noun] [arguments] [options] ,常用任务管理命令说明如下表所示。
功能描述 | 命令语法 | 关键参数 / 选项 | 说明 |
查看所有精调任务 | ark list mcj [选项] | --page-size/-ps:单页返回数量,默认为 10 --page-number/-pn:查询页数,默认为 1 --customization_type/-t:限制查询的任务训练方式,多个训练方式逗号分隔,默认不限制 --phase/-p:限制查询的任务的阶段,多个训练方式逗号分隔,默认不限制 | 列举账号下的精调信息,包括精调任务ID,名称,训练方式,基础模型,现处阶段等。 |
获取单个任务详情 | ark get mcj <任务ID> | 可获取精调任务详情:包括基任务的身份标识、当前状态、使用和生成模型信息、超参数、数据集位置、控制台链接 : 在网页上查看此任务的快捷入口。 | |
拉取任务配置至本地 | ark pull mcj <任务ID> [选项] | --include-data/--exclude-data:用于选择是否拉取数据,默认不拉取数据。 --include-plugin/--exclude-plugin:用于选择是否拉取plugin代码,默认拉取。 | 本地修改后重新提交将生成新任务,不影响原任务。 |
常用命令示例如下:
精调产物使用与管理
控制台
CLI 方式
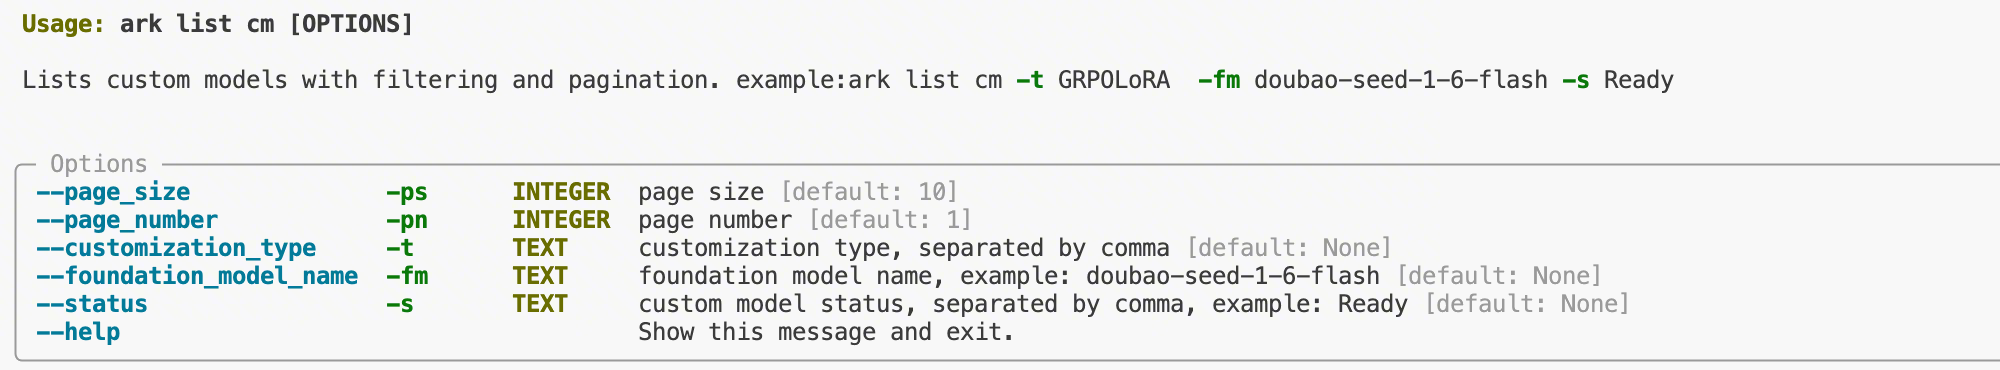
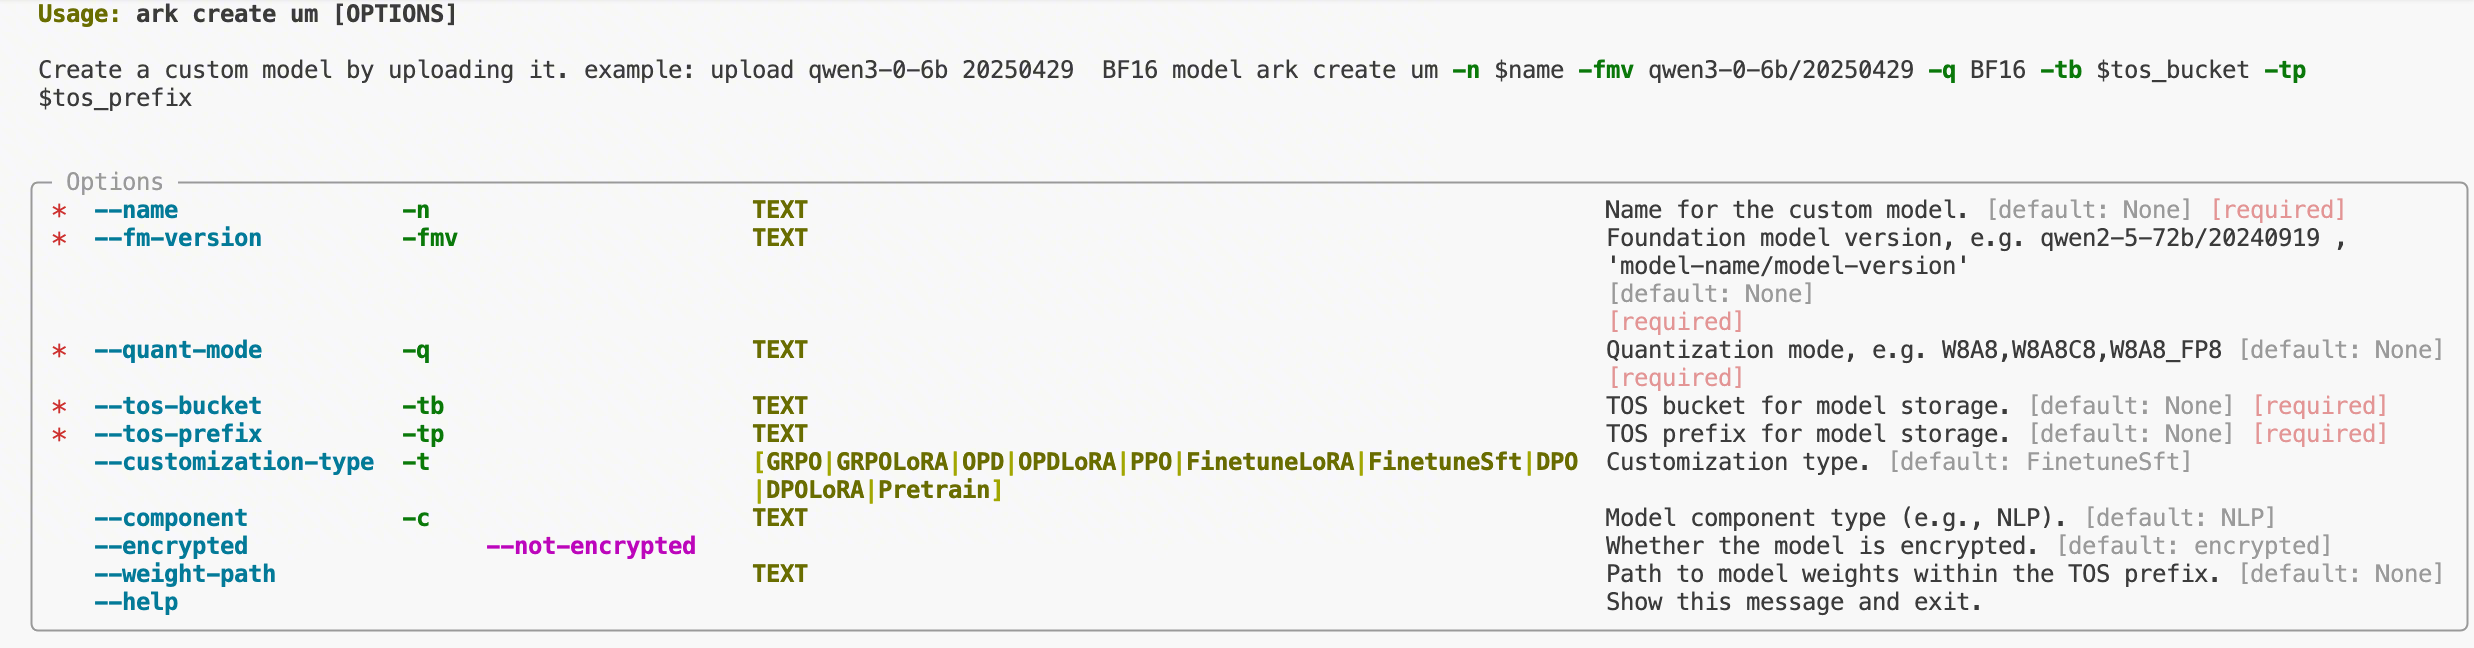
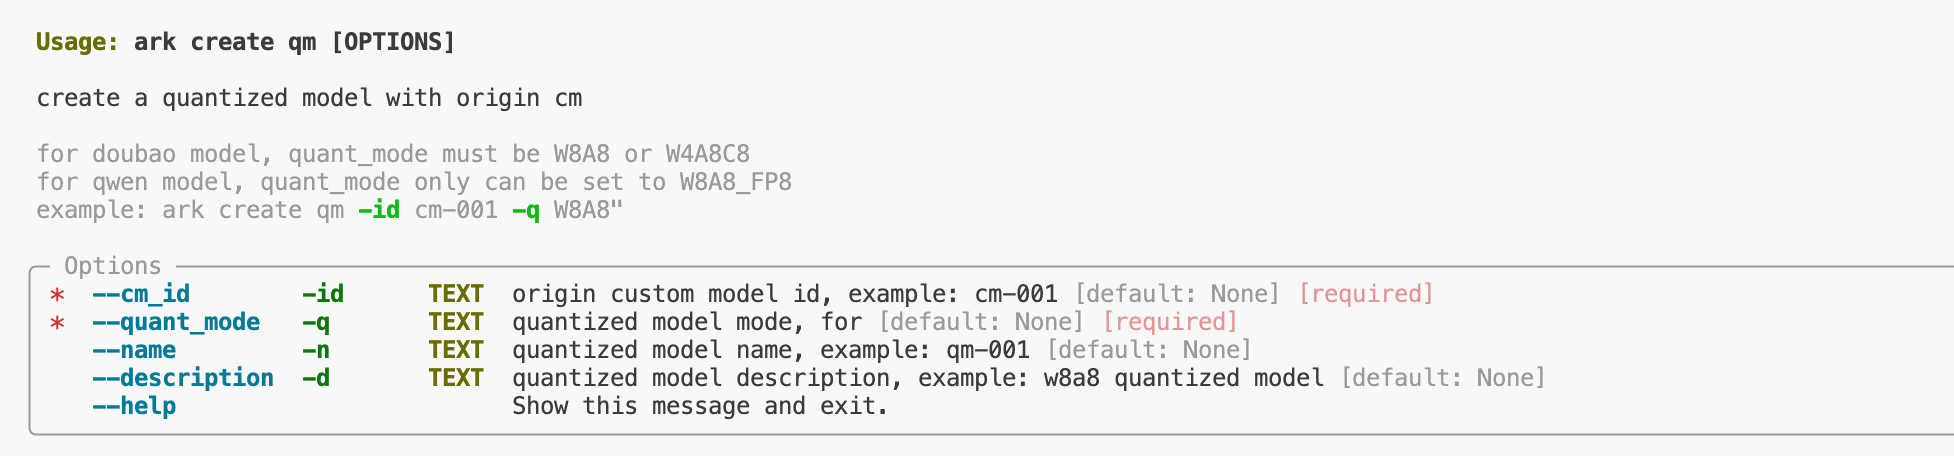
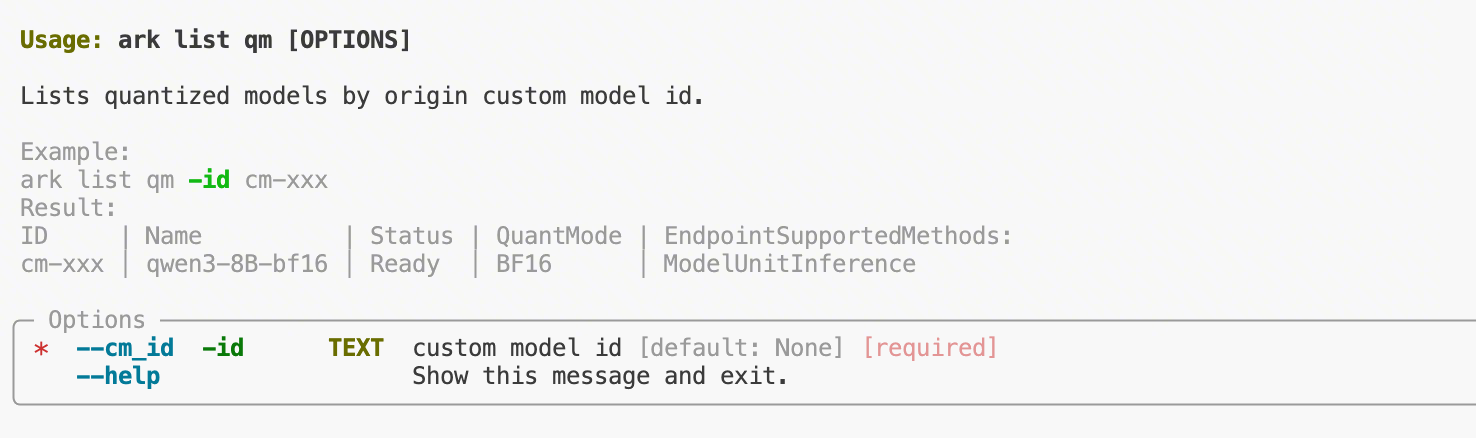
常用产物管理命令如下:
- 查看全部产物

- 上传模型
- 量化模型
- 查看指定产物的量化模型
Advanced Feature
Group Rollout
Group Rollout 用于需要在同一组样本或同一组候选输出之间共享上下文、统一采样或统一计算中间结果的强化学习场景。相比逐条样本独立执行 rollout,Group Rollout 可以帮助您在插件函数中按组处理样本,减少重复计算,并为组内相对比较类任务提供更自然的实现方式。
使用 Group Rollout 时,请重点关注以下事项:
- 确认训练任务所选择的 RL pipeline 支持组级 rollout 能力。
- 保证 rollout 函数输入输出结构与当前 SDK 版本要求一致。
- 对组内样本的顺序、数量、异常处理和返回结果一一对应关系进行显式校验。
最近更新时间:2026.09.22 15:20:22
这个页面对您有帮助吗?
有用
有用
无用
无用