火山方舟
火山方舟


文档指南

请输入


- 文档首页
 火山方舟推理在线推理(低优)
 复制全文
 下载 pdf
在线推理(低优)
 文档反馈
 问问助手
在线推理(低优) 通过独立的低优 TPM 配额与更优惠的价格,为时延不敏感的场景提供尽力而为的推理服务。在请求中指定 service_tier=flex,即可使用低优资源进行推理。
说明
- 在线推理(低优)不承诺 TTFT / TPOT / 成功率,适合可重试、可等待的批量或后台任务。若需资源确定性保障,推荐使用在线推理(TPM 保障包);若对交互延迟敏感,推荐使用在线推理(低延迟);若追求性能与成本的平衡,推荐使用常规的在线推理(常规)。
主要优势
- 更低价格:在线推理(低优)的 Input / Output Token 单价约为在线推理(常规)的 50%。Cached Input Token 单价与在线推理(常规)保持一致。
- 独立配额 + 闲时段增益:在线推理(低优)拥有账号 × 模型维度独立的 TPM 配额,且支持在闲时段申请更高的额度。
- 零改造迁移:与常规(default)档位使用同一套 Chat / Responses / Messages API 与同一批推理接入点,仅需在请求中新增 service_tier=flex,无需另建接入点或维护独立调用链。
- 与批量推理互补:适合无法改造为任务式 Batch Job(例如:客户端数据流无法上传 TOS)的批量刷数场景,可通过同步 API 承接。
适用场景
- 后台 Agent、非关键在线链路:延迟不敏感,可接受分钟级排队与高峰期超时失败,愿意用等待换价格。
- 大批量刷数与评测:模型评测、数据增强、离线打标、数据回流等可批量重试的任务。
- 闲时消费:可申请闲时段更高限流额度,运行成本敏感型批量任务。
说明
Doubao Seed 2.1 之后发布的新模型不再支持 Batch Chat(ep-bi-*)。原本通过 Batch Chat 逐条调用的批量流量,推荐迁移到在线推理接入点并在请求中指定 service_tier=flex。
支持范围
支持模型
支持以下模型版本,实际可用范围以控制台及接口返回为准。
- deepseek-v4-1-flash-261017
- doubao-seed-2-1-lite-260915
- deepseek-v4-pro-ga-260813
- deepseek-v4-flash-ga-260731
- doubao-seed-2-1-pro-260628
- doubao-seed-2-1-turbo-260628
- doubao-seed-2-0-lite-260428
说明
不支持精调模型与分支模型。
支持 API
-
支持推理接入点
- 在线推理预置推理接入点
- 在线推理自定义推理接入点
说明
不支持批量推理接入点(ep-bi-*)。在批量推理请求体中配置 service_tier=flex 不生效。
使用流程
准备工作
开通服务及获取 API Key
- 开通模型:在 开通管理 页面,选择目标模型,在 操作 列,开通模型服务。
- 在 API Key 管理 页,创建/获取 API Key,并将其配置为环境变量 ARK_API_KEY(详情参见 环境变量配置指南)。
可通过以下任一方式使用在线推理(低优)。
方式一:在 API 请求中指定服务档位
预置推理接入点和自定义推理接入点均支持此方式,适合在同一推理接入点上按请求切换服务档位。
- 使用预置推理接入点,通过 Model ID 调用即可。
- 使用自定义推理接入点,请先 创建推理接入点 ,并获取 Endpoint ID。
配置 service_tier 为 flex。
配置 service_tier 为 flex。
配置 service_tier 为 flex。
方式二:在推理接入点配置默认服务档位
仅自定义推理接入点支持此方式,适合整条业务链路默认使用在线推理(低优)、但不希望修改调用代码的场景。
- 创建推理接入点 ,找到 默认参数 配置,将 service_tier 配置为 flex。
-
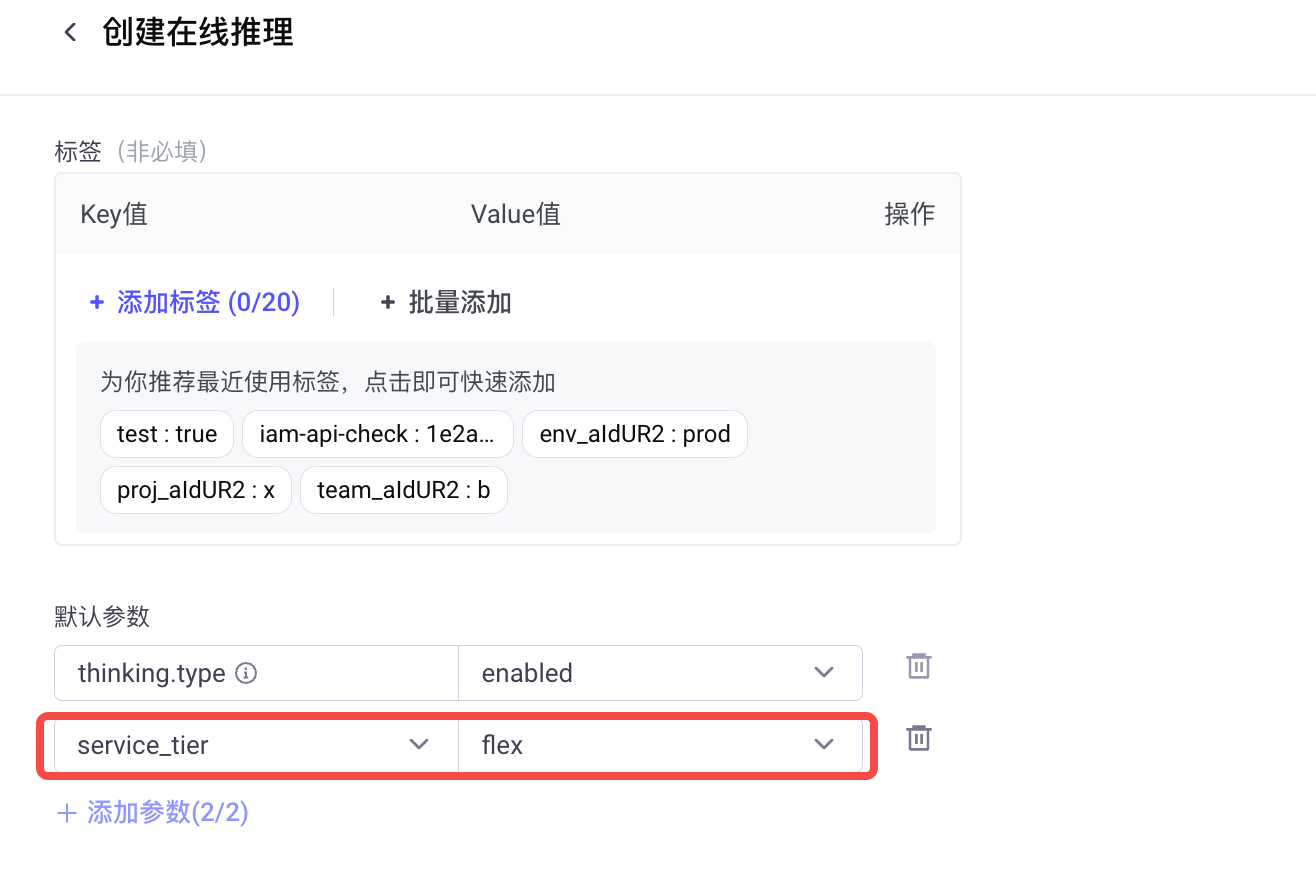
- 保存配置后,通过该推理接入点的 Endpoint ID 调用模型。未显式传入 service_tier 的请求默认使用在线推理(低优)。
注意
请求中显式指定的 service_tier 优先级高于推理接入点的默认服务档位。
计费说明
token 价格
token 统计口径
- 限流单位为 TPM(Tokens Per Minute),不拆分输入/输出。
- 不同输入长度区间的单价差异以对应模型的按 token 定价为准。
- 响应回显实际处理档位(response_service_tier),实际计费以响应回显档位为准。
限流说明
限流粒度
- 在线推理(低优)与在线推理(常规)、在线推理(低延迟)的 TPM 限流相互独立,使用在线推理(低优)不会消耗常规或低延迟的 TPM 配额。
- 在线推理(低优)的限流配额由推理接入点共享,即主账号下同模型的推理接入点共享在线推理(低优)的 TPM 限流配额。可在推理接入点详情页为推理接入点单独配置在线推理(低优)的 TPM 限流(默认不设限制,各接入点均可占满全部限流配额)。
限流值
- 默认配额:在线推理(低优)拥有独立的账号 × 模型维度 TPM 基础配额(7×24 小时生效),可在 开通管理 页面 > 语言模型 > 模型级别限流 处查询默认配额。
- 申请闲时配额:如有需求,支持提交 工单 申请闲时(例如 24:00-08:00)更高的 TPM 配额。
排队与超限
- 未超过 TPM 配额的请求由平台根据空闲算力进行调度。服务端最长等待时间为 20 分钟,超时后返回错误且不计费。
- flex 的 TPM 配额是准入上限而非保障容量,超出配额上限的请求会被限流,并返回 HTTP 429 状态码。
服务保障与运行表现
- 在线推理(低优)为尽力而为型服务,不承诺 TTFT、TPOT、成功率或完成时间等 SLA 指标。
- 平台根据空闲算力调度请求,服务延迟和可用性会随资源负载波动。高峰时段排队时间可能增加,闲时的可用性通常有所提升。
- 当 default 档位流量占用资源时,在线推理(低优)请求的准入优先级会降低;极端情况下,执行中的请求可能中断。客户端应根据错误码实施重试。
- 当请求超出配额、服务过载或模型不支持 flex 时,平台均不会将请求自动切换至 default 档位。如需切换,应由客户端显式调整 service_tier 后重试。
最佳实践
使用流式输出
推荐使用流式输出,以便逐步接收生成结果,并及时感知连接状态。
合理配置超时
平台服务端最长等待时间为 20 分钟。X-Ark-Max-Wait-Timeout-Ms 用于设置请求在服务端等待资源的最长时间,单位为毫秒(ms)。客户端和中间网关的总超时时间应覆盖服务端等待、模型生成和网络传输所需时间。
配置 | 作用 | 建议 |
X-Ark-Max-Wait-Timeout-Ms | 请求在服务端等待资源的最长时间,单位为毫秒(ms) | 根据业务时限设置,不得超过 20 分钟 |
SDK / HTTP Client Timeout | 单次调用从发出请求到接收完成的总超时时间 | 应大于服务端等待时间、预计最长生成时间与网络余量之和,建议默认设置为 30 分钟 |
例如,业务最多允许等待 10 分钟,预计最长生成时间为 3 分钟,则可将 X-Ark-Max-Wait-Timeout-Ms 设置为 600000,并将客户端和中间网关的总超时时间设置为至少 14~15 分钟。若业务最多允许等待 2 分钟,应将该请求头设置为 120000,无需沿用平台上限。
按错误类型重试
- ServerOverloaded 等临时容量错误:采用指数退避并加入随机抖动,同时限制最大重试次数和总重试时长。
- TooManyRequests.ModelAccountFlexTpmRateLimitExceeded 或 TooManyRequests.RateLimitExceeded.EndpointFlexTPMExceeded:不要立即重试,应降低并发、等待配额窗口恢复或申请提升配额。
- InvalidParameter.UnsupportedParameter:属于参数或模型能力问题,不应重试。请检查请求参数,并确认当前模型版本是否支持在线推理(低优)。
配置客户端兜底策略
对于必须完成的少量请求,可由客户端根据成本和时效要求,去掉 service_tier 或将其设置为 auto 后重新提交。平台不会自动将 flex 请求切换至 default 档位。
监控与告警
用户看板支持按 scale、fast、default 和 flex 四个档位拆分展示。建议重点关注以下指标(以控制台与监控面板实际展示为准):
- 在线推理(低优)的 TPM、RPM 用量、错误率
- 在线推理(低优)的 TTFT、TPOT、端到端延迟分位
使用限制
在线推理(低优)不支持:
- 精调模型与分支模型
- 显示缓存
- 批量推理接入点(ep-bi-*)
- 协作奖励计划采集
- Agent / Coding Plan
错误码
常见问题
在线推理(低优)和 Batch Job 应该如何选择?
- 在线推理(低优):使用同步在线 API,适合请求动态产生、逐条提交,且不便改造成文件任务的低优场景。客户端仍需负责连接、并发和重试。
- Batch Job:使用异步托管任务,适合超大规模刷数、可接受较长完成时间,或需要任务状态、结果文件和失败恢复的场景。
如需保持现有在线调用方式,建议选择在线推理(低优);如需由平台托管并完成整批任务,建议选择 Batch Job。
在线推理(低优)的 TPM 是否代表一定能达到对应吞吐?
不是。在线推理(低优)的 TPM 是账号允许提交请求的速率上限,不代表平台预留了等量资源。实际吞吐取决于当前低优资源容量、请求长度和客户端并发。
超出 TPM 配额或容量不足时,是否会自动切换到 default 档位?
不会。平台不会自动切换服务档位,以免请求在用户不知情的情况下按更高价格计费。如业务必须完成,请根据成本和时效要求在客户端显式重试。
同一个推理接入点能否同时使用在线推理(常规)、在线推理(低延迟)和在线推理(低优)?
可以。请求中显式传入的 service_tier 优先于推理接入点的默认服务档位;未传入时,使用推理接入点配置的默认值。对于不依赖服务端状态的多轮调用,每次请求均可独立选择服务档位;使用 Responses API 的 previous_response_id 串联上下文时,请遵循 Responses API 的上下文管理要求。
在线推理(低优)是否仅能在闲时使用?闲时 TPM 如何生效?
不是。在线推理(低优)全天均可使用,当前生效的 TPM 配额及时段以控制台展示为准。
最近更新时间:2026.10.22 21:20:44
这个页面对您有帮助吗?
有用
有用
无用
无用