火山方舟
火山方舟


文档指南

请输入


- 文档首页
 火山方舟训练模型精调管理自定义模型
 复制全文
 下载 pdf
管理自定义模型
 文档反馈
 问问助手
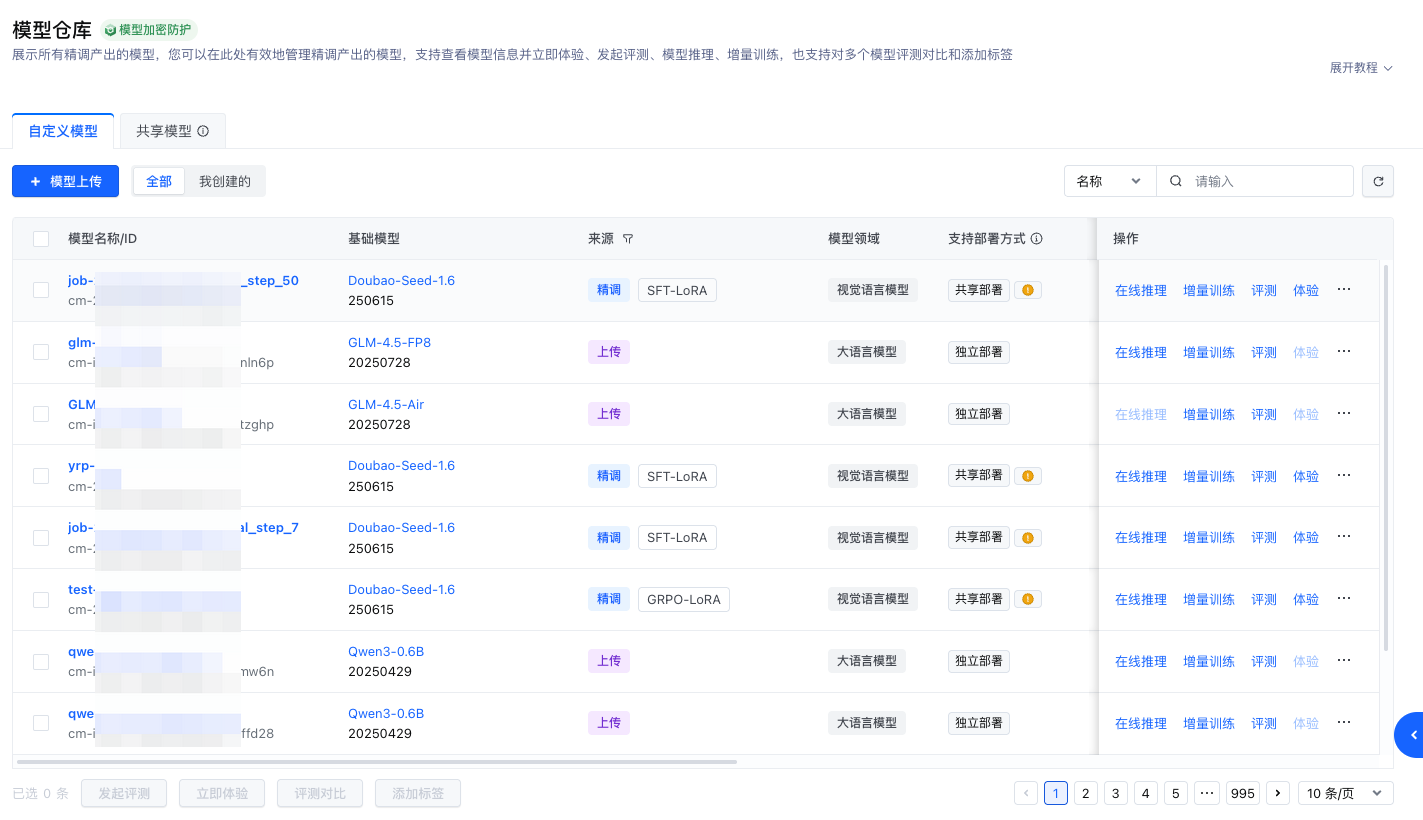
查看自定义模型信息
模型量化压缩
量化压缩是部分模型进行独立部署、推理调用的前置步骤,未压缩模型可能无法启用部分付费模式或部署能力。
量化压缩是将模型从较高精度(如 BF16 )压缩为较低比特精度(如 INT8 / FP8 )的一种推理优化技术。通过量化,可显著降低显存占用、提高吞吐,并获得更高的推理性能与性价比。
操作入口
- 在模型详情页点击 创建可部署版本 按钮,可对自定义模型执行量化压缩操作。
- 用户上传模型,在上传流程中已支持量化配置(参见 上传模型)。
- 不同量化方案会影响模型推理性能与效果,常见的量化方式包括W4A8_FP8、W8A8等。模型实际支持的量化方式可能有所不同,具体以控制台显示为准。
注意
量化压缩可能导致模型效果存在轻微差异,压缩完成后请及时开展模型评测。
上传模型
您可手动上传自定义模型至模型仓库,用于后续推理调用。
前提条件
- 待上传模型须符合 Hugging Face 格式规范。
操作步骤
- 发起模型上传 :访问方舟 模型仓库 页面,点击左侧的 + 模型上传 按钮。
- 配置基础信息 :输入模型名称,选择对应的基础开源模型。
- 上传模型文件至 TOS (或 选择 TOS 中的模型文件 ):登录对象存储 TOS 控制台,上传以下文件(参考 TOS 用户文档):
- 配置文件:1 个 config.json 文件,描述模型基础配置。
- 模型权重文件:至少 1 个,格式需为 *.safetensors / *.bin / *.ckpt。
- Tokenizer 文件:至少 1 个,包括 tokenizer.json、tokenizer_config.json、tokenizer.model 等,用于文本编解码。
- 权重索引文件(可选,推荐):*.index.json 文件,优化权重加载效率。
- 选择量化方式 :不同量化方案会影响模型推理性能与效果,选型参考模型量化压缩。
- 完成上传确认 :输入模型描述,勾选相关服务条款后,点击 确认 按钮。
注意
- 上传前系统会自动校验模型格式,您可在模型仓库中查看实时上传状态;
- 模型文件较大时,上传耗时较长,请耐心等待。
体验模型
体验自定义模型支持以下两种方式:
- 访问 模型仓库 页面,点击自定义模型页签右侧的 体验 按钮。
- 也可通过 体验中心 体验自定义模型,点击 创建新对话 。注意模型选择时勾选 模型仓库 ,并选择已经导出的自定义模型。
-
在线推理
- 创建推理接入点。
- 访问 模型仓库 页面,点击自定义模型页签右侧的 在线推理 。
- 访问 在线推理 页面创建推理接入点。模型选择时勾选 模型仓库 ,并选择已经导出的自定义模型。
- 创建完成后,可通过 推理接入点 ID 调用模型,支持 按token付费 及 模型单元 等服务模式(模型单元详情可参考模型单元概述)。创建推理接入点详细见 获取 Endpoint ID(创建自定义推理接入点)(Ark for TT)。
批量推理
注意
- 创建推理接入点。
- 访问 批量推理 控制台创建批量推理任务,注意模型选择时勾选“模型仓库”。
说明
部分模型需要压缩后才可使用“按模型单元付费”,如果您的模型未压缩控制台会有模型压缩提示,请参考提示压缩后再创建批量推理任务。
- 创建完成后,可以在详情页面参考“ 具体接入流程 ”获取相关的调用示例。
评测自定义模型
最近更新时间:2026.08.10 20:16:55
这个页面对您有帮助吗?
有用
有用
无用
无用