AI MediaKit
AI MediaKit


文档指南
请输入


开发指南
视频工具
图像工具
剪辑工具
大模型处理工具
常见问题
媒体处理(旧版)
快速入门
控制台指南
联系我们
- 文档首页
 AI MediaKit开始使用AI MediaKit 介绍
 复制全文
 下载 pdf
AI MediaKit 介绍
 文档反馈
 问问助手
AI MediaKit 是火山引擎视频云面向 AI 云原生时代推出的智能多媒体工具集。它将视频云成熟的媒体处理技术解构为细粒度的原子能力,致力于构建适配 AI Agent 的多媒体能力底座。通过 AI MediaKit,开发者无需处理底层复杂的多媒体工程细节,即可让智能体精准、高效地执行图像、视频、音频的编辑与理解任务。
产品架构
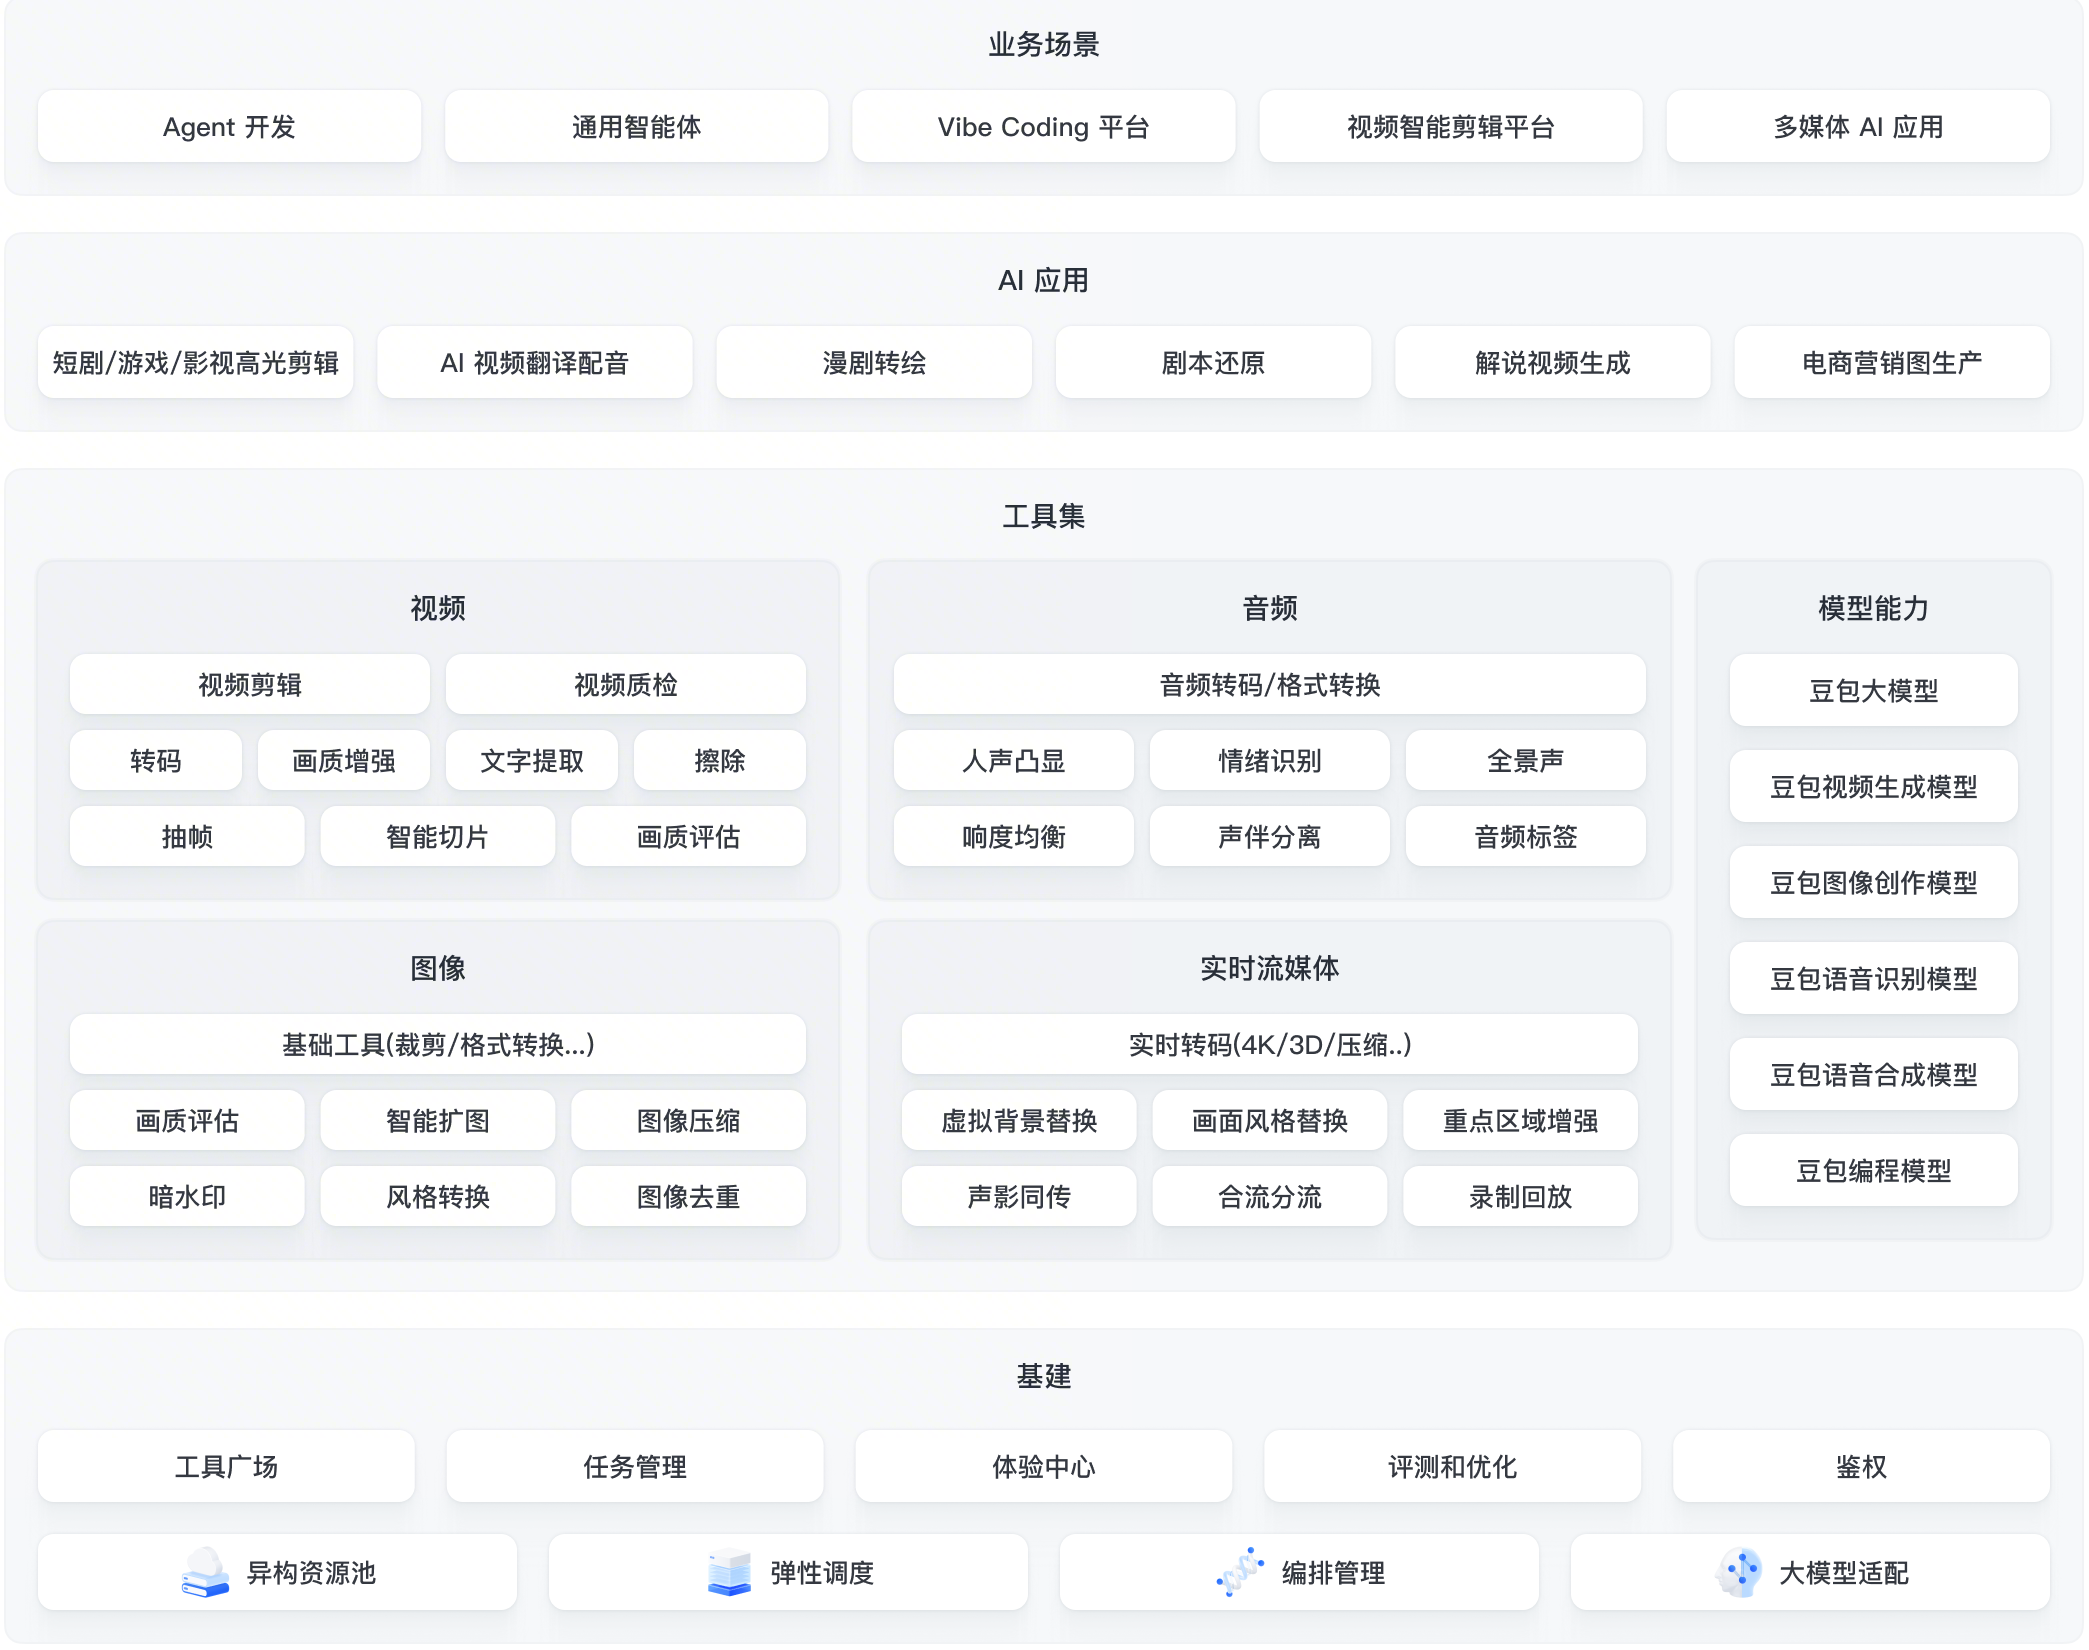
说明
产品优势
- Agent 友好设计:功能深度原子化,每个工具均搭载大模型可理解的语义描述与元数据。智能体无需额外训练即可通过描述识别工具意图,有效降低 Tool-calling 的幻觉率。
- 高性价比处理:依托云端弹性资源调度与闲时批量处理策略,为大批量媒体任务提供极具竞争力的价格,显著降低 AI 应用的整体 Token 消耗与运行成本。
- 完备的能力矩阵:覆盖视频、图像、音频等模态,提供从底层处理到上层理解的“一站式”能力,满足从预处理到成片输出的全链路需求。
- 突破大模型输入瓶颈:针对“视频理解”场景,将视频处理上限从 50 MB 提升至 5 GB,使长视频、高码率工程素材的 AI 分析成为可能。
多媒体工具集
目前 AI MediaKit 已上线以下原子工具。您可以根据业务场景对这些工具进行灵活组合与逻辑编排。
视频工具
工具名称 | 工具说明 | 接入方式 | 相关文档 |
画质增强(大模型版) | 基于 Diffusion 扩散大模型技术,提供生成式视频增强与修复能力。它不仅能修复视频在压缩或老化过程中损失的像素,更能通过深度语义理解,智能地补全和生成符合视频内容的真实细节,最终产出自然、高保真的视频画面。 | API/CLI/Skill/MCP | |
画质增强(标准版、专业版、极速版) | 标准版内置 10+ 常用算法,兼顾处理速度与视频画质;专业版内置 30+ 深度 AI 算法,面向影视级极致画质增强;极速版集成轻量级超分与智能画质增强能力,采用速度优先策略,适用于对处理时延敏感的场景。 | API/CLI/Skill/MCP | |
字幕擦除(标准版和精细化版) | 针对视频中的内嵌字幕,实现高质量的无痕擦除,最大程度还原背景画面。 | API/CLI/Skill/MCP | 字幕擦除 |
场景切分 | 识别视频场景变化自动进行视频切分,为视频编辑和内容分析提供基础。 | API/CLI/Skill/MCP | 场景切分 |
智能语义切片(基础版) | 综合分析视频画面、语音与叙事结构,将长视频切分为多个具备完整语义的片段,并输出各片段的起止时间轴信息,适用于短视频拆条、剪辑素材召回和多模态数据标注等场景。 | API/CLI/Skill/MCP | |
智能语义切片(专业版) | 结合镜头边界、场景语义、ASR/OCR 文本与时长约束,将长视频切分为语义完整、时长合适的片段,并支持短剧、影视剧、小游戏及自定义切片策略。 | API | |
语音转字幕(ASR) | 自动识别视频中的语音并转写为带时间戳的字幕文本,支持多语言和说话人识别。 | API/CLI/Skill/MCP | |
视频识别字幕(OCR) | 利用先进的视频光学字符识别(OCR)技术,精准地从视频画面中提取硬字幕(即固化在视频画面中、无法访问的文字),输出带时间戳的结构化文本数据。 | API/CLI/Skill/MCP | |
高光智剪-短剧 | 智能捕捉短剧正片中的“高燃片段”,批量生成爆款混剪视频。 | API/CLI/Skill/MCP | |
高光智剪-小游戏 | 智能定位“全屏连击与极限通关”等高燃瞬间,让海量游戏录屏秒变吸睛素材。 | API/CLI/Skill/MCP | |
高光智剪-影视拆条 | 依托先进的长视频理解算法,针对电影、电视剧、纪录片等长视频进行深度分析,自动识别并拆分出多个包含完整故事弧线的“高光拆条”片段。 | API/CLI/Skill/MCP | |
高光片段提取 | 智能识别高光片段,输出精准时间戳、打分与内容描述。适用于短剧、小游戏场景。 | API/CLI/Skill/MCP | |
视频绿幕抠图 | 针对绿幕场景进行抠像,移除背景并输出带透明通道的视频,适用于虚拟演播、合成与二次包装。 | API/CLI/Skill/MCP | 视频抠图 |
视频人像抠图 | 基于人像分割移除视频背景,输出带透明通道的视频,适用于口播、讲解与虚拟背景替换。 | API/CLI/Skill/MCP | 视频抠图 |
剧情故事线分析 | 智能解析影视剧内容,生成结构化剧情线,赋能智能剪辑、内容检索与互动播放。 | API/CLI/Skill/MCP | |
剧本还原 | 基于强大的视频理解能力,能够将真人实拍的短剧转化为结构化剧本文本。 | API/CLI/Skill/MCP | 剧本还原 |
剧本还原(重绘场景) | 面向短剧重绘场景分析多集短剧视频,输出可复用的角色、场景、预处理结果与逐集剧情分镜剧本。 | API | |
解说视频生成 | 基于您提供的原始短剧视频和创作指令,一键生成带有 AI 配音和定制字幕的全新营销或解说类视频。 | API/CLI/Skill/MCP | |
解说视频生成(短剧行业模型) | 基于对输入短剧剧集的角色和剧情故事线理解(剧本还原),自动提取高光片段并按剪辑要求(时长范围、产出条数、解说浓度、BGM 等)生成全新的解说视频(支持文字解说和旁白解说两种模式)。 | API/CLI/Skill/MCP | |
视频抽帧 | 从视频中截取一张或多张静态图片。您可以根据不同的业务场景,选择按时间间隔、按指定时间点、按指定帧(首/尾帧)或按场景变化四种策略进行抽帧。 | API/CLI/Skill/MCP | 视频抽帧 |
视频暗水印 | 在不影响视频画面视觉质量与完整性的前提下,将用户 ID、内容 ID 等数字信息隐藏式地嵌入视频文件中,并支持从处理后的视频中提取暗水印信息,用于版权保护、泄露溯源和文件真实性校验。 | API/CLI/Skill/MCP | |
视频转码 | 将一个视频码流转换成另一个视频码流的过程,通常涉及对编码格式(如 H.264、H.265)、编码参数(如分辨率、码率、帧率)、封装格式(如 MP4、FLV)等的转换。 | API/CLI/Skill/MCP | 视频转码 |
极智超清 | 基于人眼视觉系统特性,在转码过程中针对视频中的场景、动作、内容、纹理等进行智能分析,选择最优的编码参数。这使得您可以用相对更低的码率,输出主观画质更优的视频,从而在降低存储和带宽成本的同时,为用户带来更好的视觉体验。 | API/CLI/Skill/MCP | 极智超清 |
视频转封装 | 仅修改容器格式,不会重新编解码音视频码流,可在无画质损失、低成本的前提下实现 MP4、FLV、MPEGTS 等主流容器之间的互转,广泛适用于点播分发适配、流媒体切片打包与多端兼容场景。 | API/CLI/Skill/MCP | |
视频画质检测 VQScore | 集成了火山引擎自研的 VQScore(Video Quality Score)无参考视频质量评价算法,无需原始参考视频,能够直接对视频的视觉质量进行客观打分,模拟人眼主观感受,输出贴近真实观感的质量分数。 | API/CLI/Skill/MCP | |
视频人脸打码 | 自动并精准地识别视频画面中的人脸区域,并对所有人脸进行模糊或马赛克处理。 | API/CLI/Skill/MCP | |
视频人脸融合(换脸) | 将用户提供的目标人脸照片融合替换到视频中的人物上,输出高质量换脸视频,同步保持原视频的动作、背景、脸型、表情和口型。 | API/CLI/Skill/MCP | |
视频插帧 | 基于深度学习的智能补帧能力,在相邻视频帧之间智能生成过渡帧,提升视频帧率与运动连续性。 | API | 视频插帧 |
视频元信息获取 | 解析视频封装与编码信息,获取分辨率、码率、帧率、编码格式等元数据,用于媒资质检与转码策略决策。 | API/CLI/Skill/MCP | |
视频口型对齐 | 将输入视频中的人物口型与目标音频进行精准匹配,生成口型自然、音画同步的新视频,适用于视频翻译、内容本地化等场景。 | API | |
视频横转竖 | 通过逐帧主体检测、发言主体识别、主体跟踪、智能裁剪与多人布局决策,将横版视频自动转换为适合竖屏平台分发的成片。 | API | |
视频流畅度提升 | 自动识别并修复视频中的运动节奏突变和重复帧问题,改善视频的运动连续性与观看流畅度。 | API | |
深度动作捕捉 | 逐帧估计视频画面的相对空间深度,保留动作轮廓、空间位移和镜头运动,生成时间连续的深度视频。 | API |
图像工具
工具名称 | 工具说明 | 接入方式 | 相关文档 |
图像画质增强 | 基于图像内容理解智能决策,全方位提升图片分辨率、清晰度与色彩表现。 | API/CLI/Skill/MCP | |
图像画质评估 | 模拟人类视觉感受,对图像的清晰度、美学观感、噪声强度、纹理丰富度、色调均衡等维度进行多指标评估。 | API/CLI/Skill/MCP | |
图像人脸打码 | 自动检测图片中的所有人脸区域,并对检测到的人脸进行马赛克处理,实现一键人脸隐私保护。 | API/CLI/Skill/MCP | |
图像背景移除(智能抠图) | 一键抠除图片复杂背景,输出透明底主体图。 | API/CLI/Skill/MCP | |
图像擦除修复 | 智能擦除图片中的常见图标或指定文字,并以符合背景纹理的方式填充修复。 | API/CLI/Skill/MCP | |
图像文字识别(OCR) | 将图片中文字转为可编辑结构化文本的 OCR 识别能力。 | API/CLI/Skill/MCP | |
图像智能裁剪 | 自动识别图像中的人脸主体区域,并根据您指定的目标尺寸进行智能、美观的裁剪。 | API/CLI/Skill/MCP | |
智能扩图 | 利用 AI 算法对原图上、下、左、右四个方向进行内容扩展。 | API | 智能扩图 |
集智瘦身 | 在大幅优化图片体积的同时,智能修复压缩带来的毛刺、彩噪、块效应等画质问题,增强图像的边缘与纹理细节,最终输出比原图更轻量且更清晰的图像。 | API/CLI/Skill/MCP | 集智瘦身 |
图像翻译 | 能够自动识别图像中的文字内容,并将其翻译为指定的目标语言,最终生成保留原图布局和视觉风格的新图像。 | API | 图像翻译 |
电商牛皮癣擦除 | 能自动检测并擦除商品图中的平台水印、品牌 Logo、促销贴纸、价格标签和干扰性文字,输出更干净、更适合二次流转和再创作的商品图。 | API | |
电商万创(商品场景图生成) | 基于您提供的商品图,通过 AI 技术智能生成高质量的背景与营销场景。 | API | |
图像暗水印 | 在不改变图像视觉效果的前提下,将版权信息、溯源 ID 等数字信息隐藏式地嵌入到图片中;从已添加暗水印的图片中,精准提取出隐藏的数字信息。 | API | |
图像元信息获取 | 解析并返回图像的元数据,包括格式、尺寸、色彩空间、Exif 信息等,常用于媒资管理、图片质检与后续处理决策。 | API/CLI/Skill/MCP | |
图像基础编辑 | 一系列同步图像基础编辑工具,涵盖空间几何变换(旋转/翻转/裁剪)、视觉风格调整(锐化/模糊/打码)等。 | API/CLI/Skill/MCP |
剪辑工具
工具名称 | 工具说明 | 接入方式 | 相关文档 |
智能剪辑 Vibe Editing | 面向企业客户提供的视频理解剪辑工具集,致力于将复杂的视频剪辑能力封装为可组合、可调用、可对话的智能服务。用户无需理解底层复杂的剪辑参数,只需通过自然语言描述剪辑目标,系统即可自动完成意图理解、参数转换、多轨道剪辑、云端渲染与成片导出。 | API/控制台 | |
多轨道剪辑 | 通过结构化时间线对视频、音频、图片、文字、字幕等多种轨道进行组合编辑,并支持转场、特效、滤镜、裁剪、变速与音量调节等增强效果。 | API | |
音视频拼接 | 将多个视频片段或音频片段按指定顺序合并成一个新文件。 | API/CLI/Skill/MCP | |
音视频裁剪 | 根据指定时间区间截取视频或音频,生成新的视频或音频文件。 | API/CLI/Skill/MCP | |
音视频调速 | 调整视频或音频文件的播放倍速,实现快放或慢放效果,适用于内容重剪、精彩集锦、延时摄影、教学演示及播客、有声书倍速播放等场景。 | API/CLI/Skill/MCP | |
音频提取 | 将视频文件中的音频流分离并保存为独立的音频文件。 | API/CLI/Skill/MCP | 音频提取 |
音视频合成 | 将不同的视频与音频轨道进行叠加组合,生成新的视频文件。 | API/CLI/Skill/MCP | |
图片转视频 | 将多张静态图片合成为动态视频。 | API/CLI/Skill/MCP | |
音频混合 | 将多个音频文件(如背景音乐、音效、人声)进行混音,并生成一个新的音频文件。 | API/CLI/Skill/MCP | 音频混合 |
音量调节 | 调整视频音轨的整体音量,可放大、减小或静音。 | API/CLI/Skill/MCP | |
声音淡入淡出 | 为视频音轨或独立音频文件的开头和结尾添加声音渐强(淡入)或渐弱(淡出)效果。 | API/CLI/Skill/MCP | |
视频画面翻转 | 对视频画面进行上下或左右镜像翻转。 | API/CLI/Skill/MCP | |
视频画面旋转 | 将视频画面整体向左旋转 90 度、向右旋转 90 度或旋转 180 度。 | API/CLI/Skill/MCP | |
视频画面裁剪 | 根据指定的像素坐标,从视频画面中裁剪出矩形区域,生成新的视频。 | API/CLI/Skill/MCP | |
视频画面拼接 | 将多个视频在水平或垂直方向上拼接成一个新的视频。 | API/CLI/Skill/MCP | |
视频加字幕 | 将字幕文件或文本内容,以指定样式压制到视频画面中,生成带内嵌字幕的新视频。 | API/CLI/Skill/MCP | |
视频加图片 | 将静态图片(如 Logo、水印)叠加到视频画面的指定位置。 | API/CLI/Skill/MCP | |
视频添加滤镜 | 为视频添加多种预设滤镜,显著提升视频的视觉氛围与艺术质感。 | API/CLI/Skill/MCP | |
视频添加运镜 | 为静态或平稳拍摄的视频素材添加缩放、平移缩放、旋转等镜头动态效果,提升视频的视觉冲击力和节奏感。 | API/CLI/Skill/MCP | |
视频截取动图 | 从视频文件中按指定时间段截取片段,并生成高品质的动态图片(支持 GIF 或 WebP 格式)。 | API/CLI/Skill/MCP | |
视频高斯模糊 | 对视频画面中的一个或多个指定矩形区域应用高斯模糊效果。 | API | |
文字生成滚屏视频 | 将大段文本内容与背景图片、音乐相结合,快速生成一个专业、流畅的竖版(9:16)文字滚动视频。 | API/CLI/Skill/MCP | |
HyperFrames 云端渲染 | 将使用 HTML、CSS 和 JavaScript 编写的 HyperFrames 动画工程在云端稳定渲染并编码为视频,支持配置输出格式、帧率、码率、渲染质量与透明通道。 | API | |
添加 AIGC 元数据标识 | 将 AI 生成属性、服务提供者信息、内容唯一编号等标识写入视频、图片或音频文件的元数据,满足内容声明、主体留痕与合规溯源需求。 | API |
音频工具
工具名称 | 工具说明 | 接入方式 | 相关文档 |
人声背景音分离 | 对输入的音频或视频文件进行分离,输出纯净的人声干声和完整的背景伴奏两个独立音频文件。 | API/CLI/Skill/MCP | |
语音端点识别 | 自动定位您输入的音频或视频文件中有效语音的起止时间,将人声和静音、背景噪声等无效片段区分开来,返回一个包含所有有效人声片段起止时间戳的列表。 | API/CLI/Skill/MCP | |
音频内容编辑 | 根据自然语言描述自动定位目标语句,生成与上下文连贯的新语音并完成无缝替换,同时保持原有音色、情绪、韵律和时序基本一致。 | API | |
音频转码 | 将一个音频文件从一种格式转换为另一种格式。不仅包括容器格式(如 WAV 转 MP3)的转换,还支持对编码参数(如采样率、码率、声道数)和音量进行精细化调整。 | API/CLI/Skill/MCP | 音频转码 |
音频元信息获取 | 解析音频封装与编码信息,获取时长、码率、采样率、编码格式等元数据,用于媒资管理与转码参数校验。 | API/CLI/Skill/MCP |
大模型处理工具
工具名称 | 工具说明 | 接入方式 | 相关文档 |
AIGC 视频生成质量评估 | 面向 AIGC 视频生产场景,按需检查参考信息一致性、世界合理性、内容持续性与视觉保真度等质量问题,定位异常时间区间并输出问题说明和典型问题帧。 | API | |
大模型高光剪辑 | 从一个或多个输入视频中,按场景预设、评分标准或故事目标智能识别精彩片段,自动挑选、裁剪并拼接成一个或多个指定时长的高光成片。 | API | |
视频理解智能策略 | 基于火山方舟视觉大模型,接收用户输入的视频和自然语言指令(Prompt),并根据视频时长、指令内容和用户指定的偏好(如成本、质量),自动决策最优的分析链路(包括抽帧策略、是否分析音频、选择哪个模型等),最终输出视频级别的结构化理解结果。 | API/CLI/Skill/MCP | |
视频理解拓展工具 | 支持对大视频文件使用豆包视觉大模型进行理解,提供高效、精准的视频内容解析能力。支持最高 5 GB 视频 URL 传入。 | API/SDK/Skill | |
MaaS 模型代理 | 通过统一接口调用已在火山方舟、豆包语音等模型产品中开通的视频生成、图片生成、音频生成和语音识别能力,并由 AI MediaKit 统一处理异步执行、结果回调、幂等控制与队列调度。 | API |
应用场景
- 多模态数据预处理:在垂类模型训练前,对海量视频进行画质检测与增强、多策略抽帧、OCR/ASR 文本标准化提取、音频抽取、格式归一化、人声分离等操作,提升模型训练的效率与识别精度。
- AI 漫剧制作:完成从漫画素材到视频合成、配音对齐、字幕添加、视频超分增强的全流程,实现内容生产的半自动化或全自动化。
- 业务出海与视频翻译:提供多语种字幕翻译、多角色声音复刻及自然口型合成,助力视频内容低成本、高效率地实现全球化传播。
- 长视频洞察与知识提取:利用大模型对长视频进行深度多模态理解,快速提取有价值的信息,将视频从简单的数据资产转化为可支持业务决策的知识资产。
- 高光智剪与营销分发:基于智能高光识别技术从正片中准确地提取出精彩片段。切片精度能达到毫秒级,不会出现截断和吞音的问题,生成的视频质感真实流畅,有效助力内容传播。
相关文档
- 快速入门:视频理解前处理或快速入门:视频生成后处理:跟随引导,逐步完成您的第一个 AI MediaKit 任务。
- 计费说明:了解 AI MediaKit 各项功能的详细计费规则、定价和资源包信息。
- 功能发布历史:跟踪了解 AI MediaKit 的最新功能发布与文档更新动态。
最近更新时间:2026.10.27 16:09:01
这个页面对您有帮助吗?
有用
有用
无用
无用