应用性能监控全链路版
应用性能监控全链路版
应用性能监控全链路版


文档指南
请输入


产品动态
用户指南
应用性能监控
组件管理
接入指南
使用指南
最佳实践
客户端监控
App 端监控
SDK 接入
使用指南
最佳实践
常见问题
App 端监控通用
Android 端监控
iOS 端监控
WebPro 端监控
使用指南
小程序 Pro 监控
PC 端监控
API 参考
API 接口 - 应用性能监控
告警管理
指标查询
Trace 分析
API 接口 - 客户端控制台
API 接口 - App 端
事件
报警
异常和崩溃
CPU 监控
电量监控
API 接口 - WebPro 端
Action 列表
报警
JS错误监控
性能监控
请求监控
静态资源监控
API 接口 - 小程序 Pro 端
JS 错误
报警
API 接口 - PC 端
崩溃
报警
常见问题
- 文档首页
 应用性能监控全链路版产品简介应用场景
 复制全文
 下载 pdf
应用场景
 文档反馈
 问问助手
应用性能监控全链路版具有低成本接入、全链路监控、端到端监控、AI 场景全链路覆盖等优势,能够帮助您快速定位问题,优化产品品质。本文为您介绍应用性能监控全链路版的典型应用场景。
AI 云原生推理
AI 云原生推理套件(AI-ServingKit)依托字节跳动大规模 AI 实践、火山方舟海量业务经验,通过容器编排、AI 网关、推理全链路观测和分布式缓存,支持企业在大规模 GPU 集群上高效、稳定、高性价比地运行主流的推理模型。
应用性能监控全链路版凭借无侵入式 SDK、对框架自动进行埋点、自动生成的 TraceID、全量覆盖从推理引擎到 GPU 全链路的预置监控看板&告警规则等优势,在 AI-ServingKit 方案中承担全链路观测能力,支持采集 APIG、推理引擎、GPU 资源等指标,及时发现 SLO 指标波动。相较于传统观测,接入时间缩短 80%,故障排查时间缩短 70%,做到推理全链路透明埋点,推理问题分钟级定位。
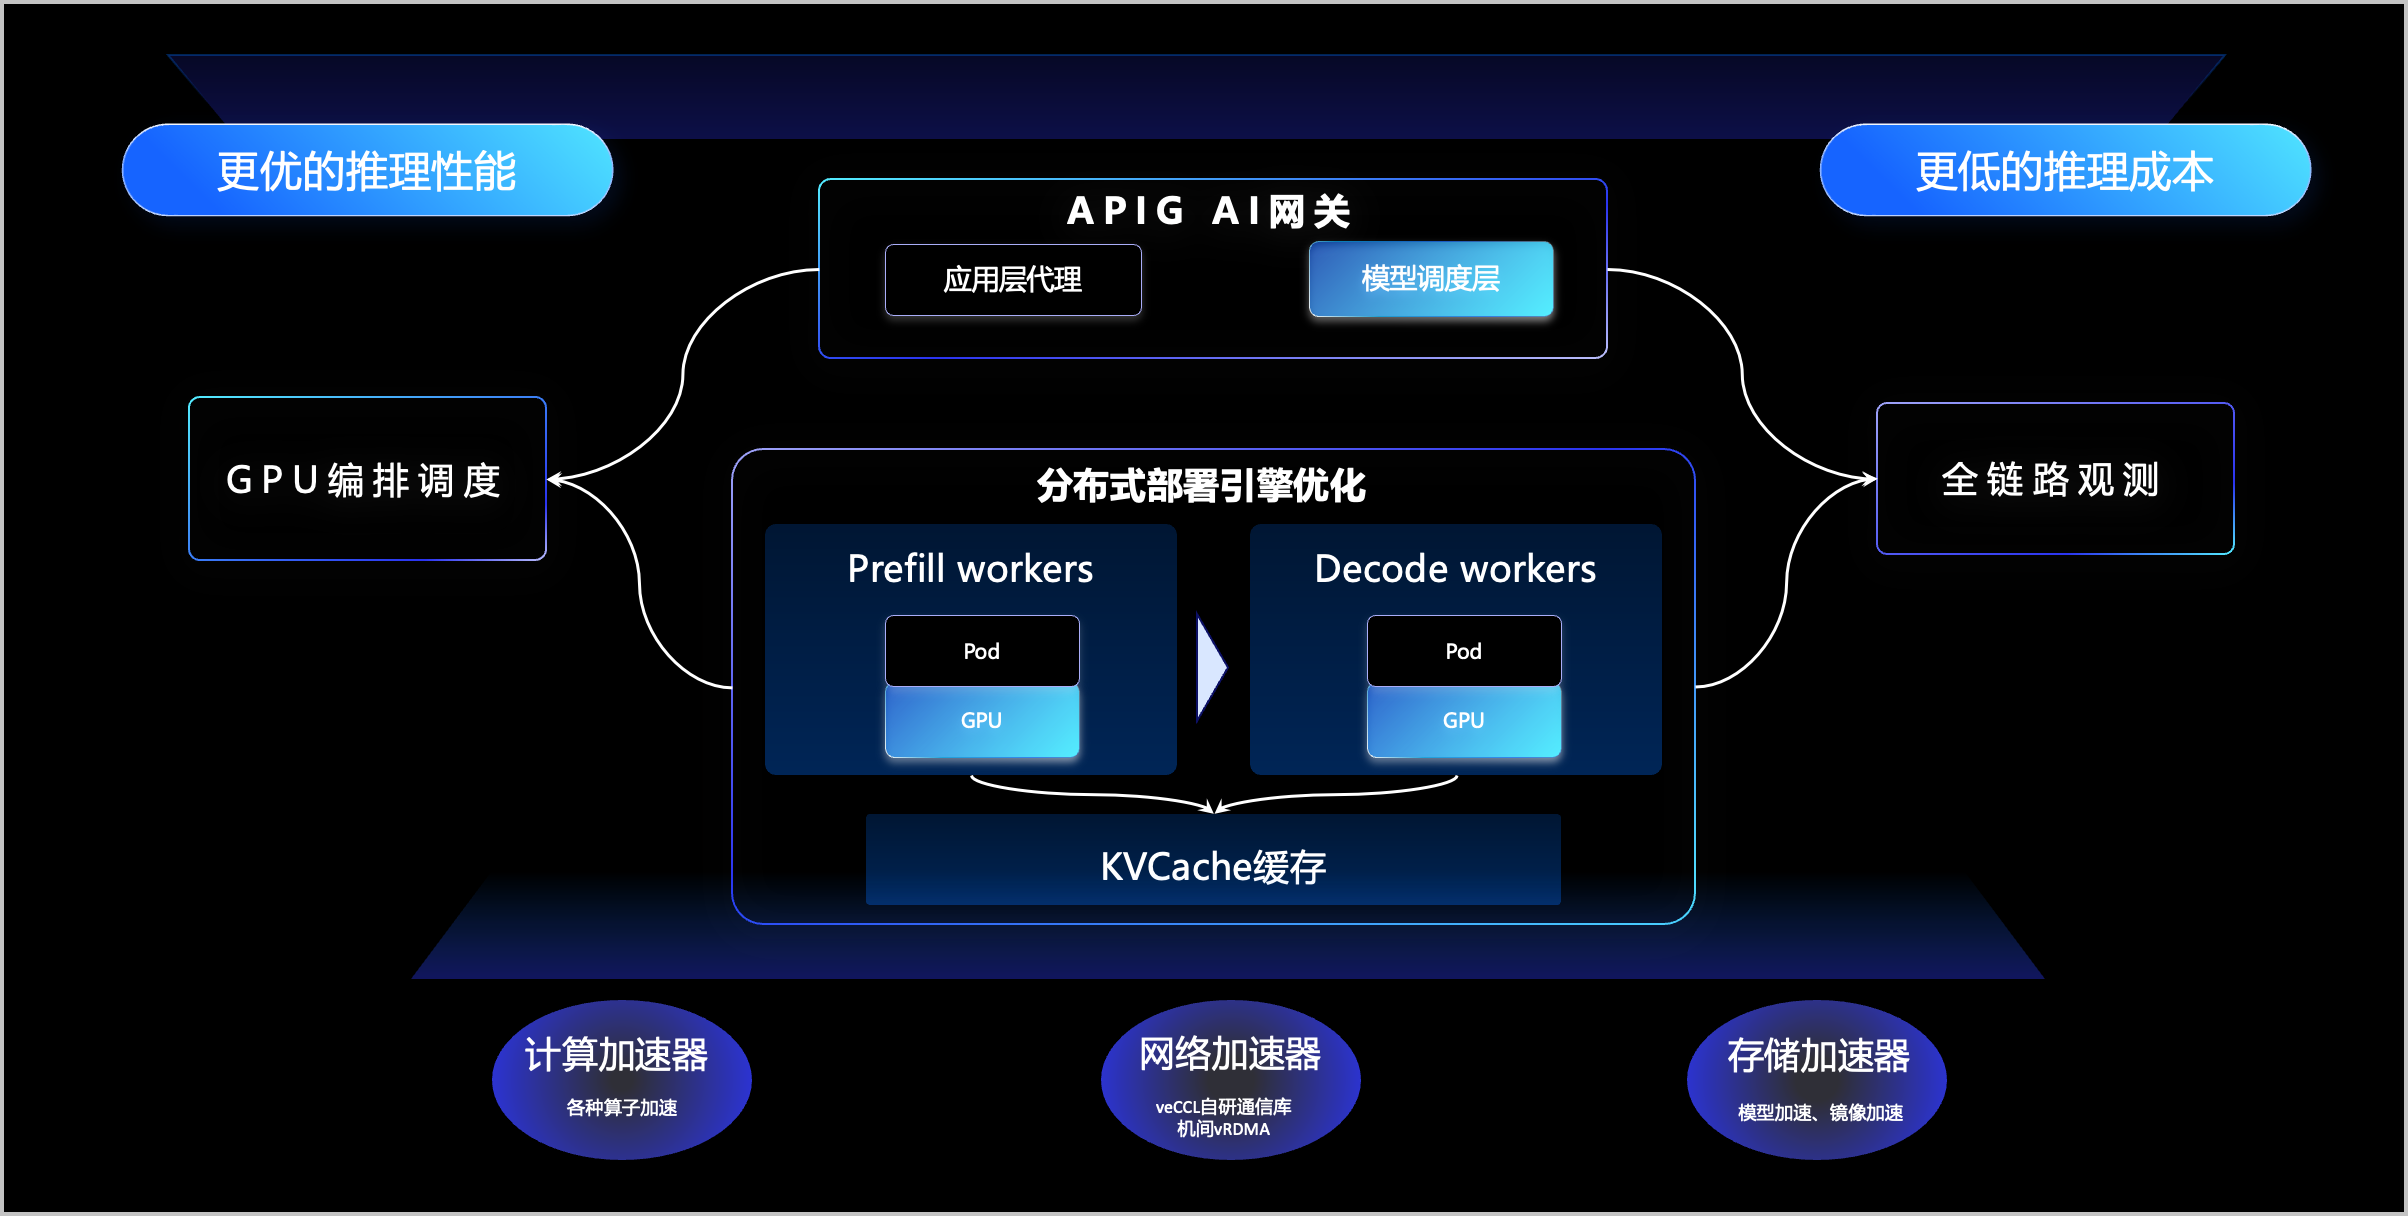
LLM 全链路监控
应用性能监控全链路版具备无需埋点透明接入、兼容主流开源框架、支持自建推理场景的全链路监控等优势,针对 LLM 提供低成本的可观测方案,并且能够满足多种部署形态下 LLM 的端到端全链路监控。
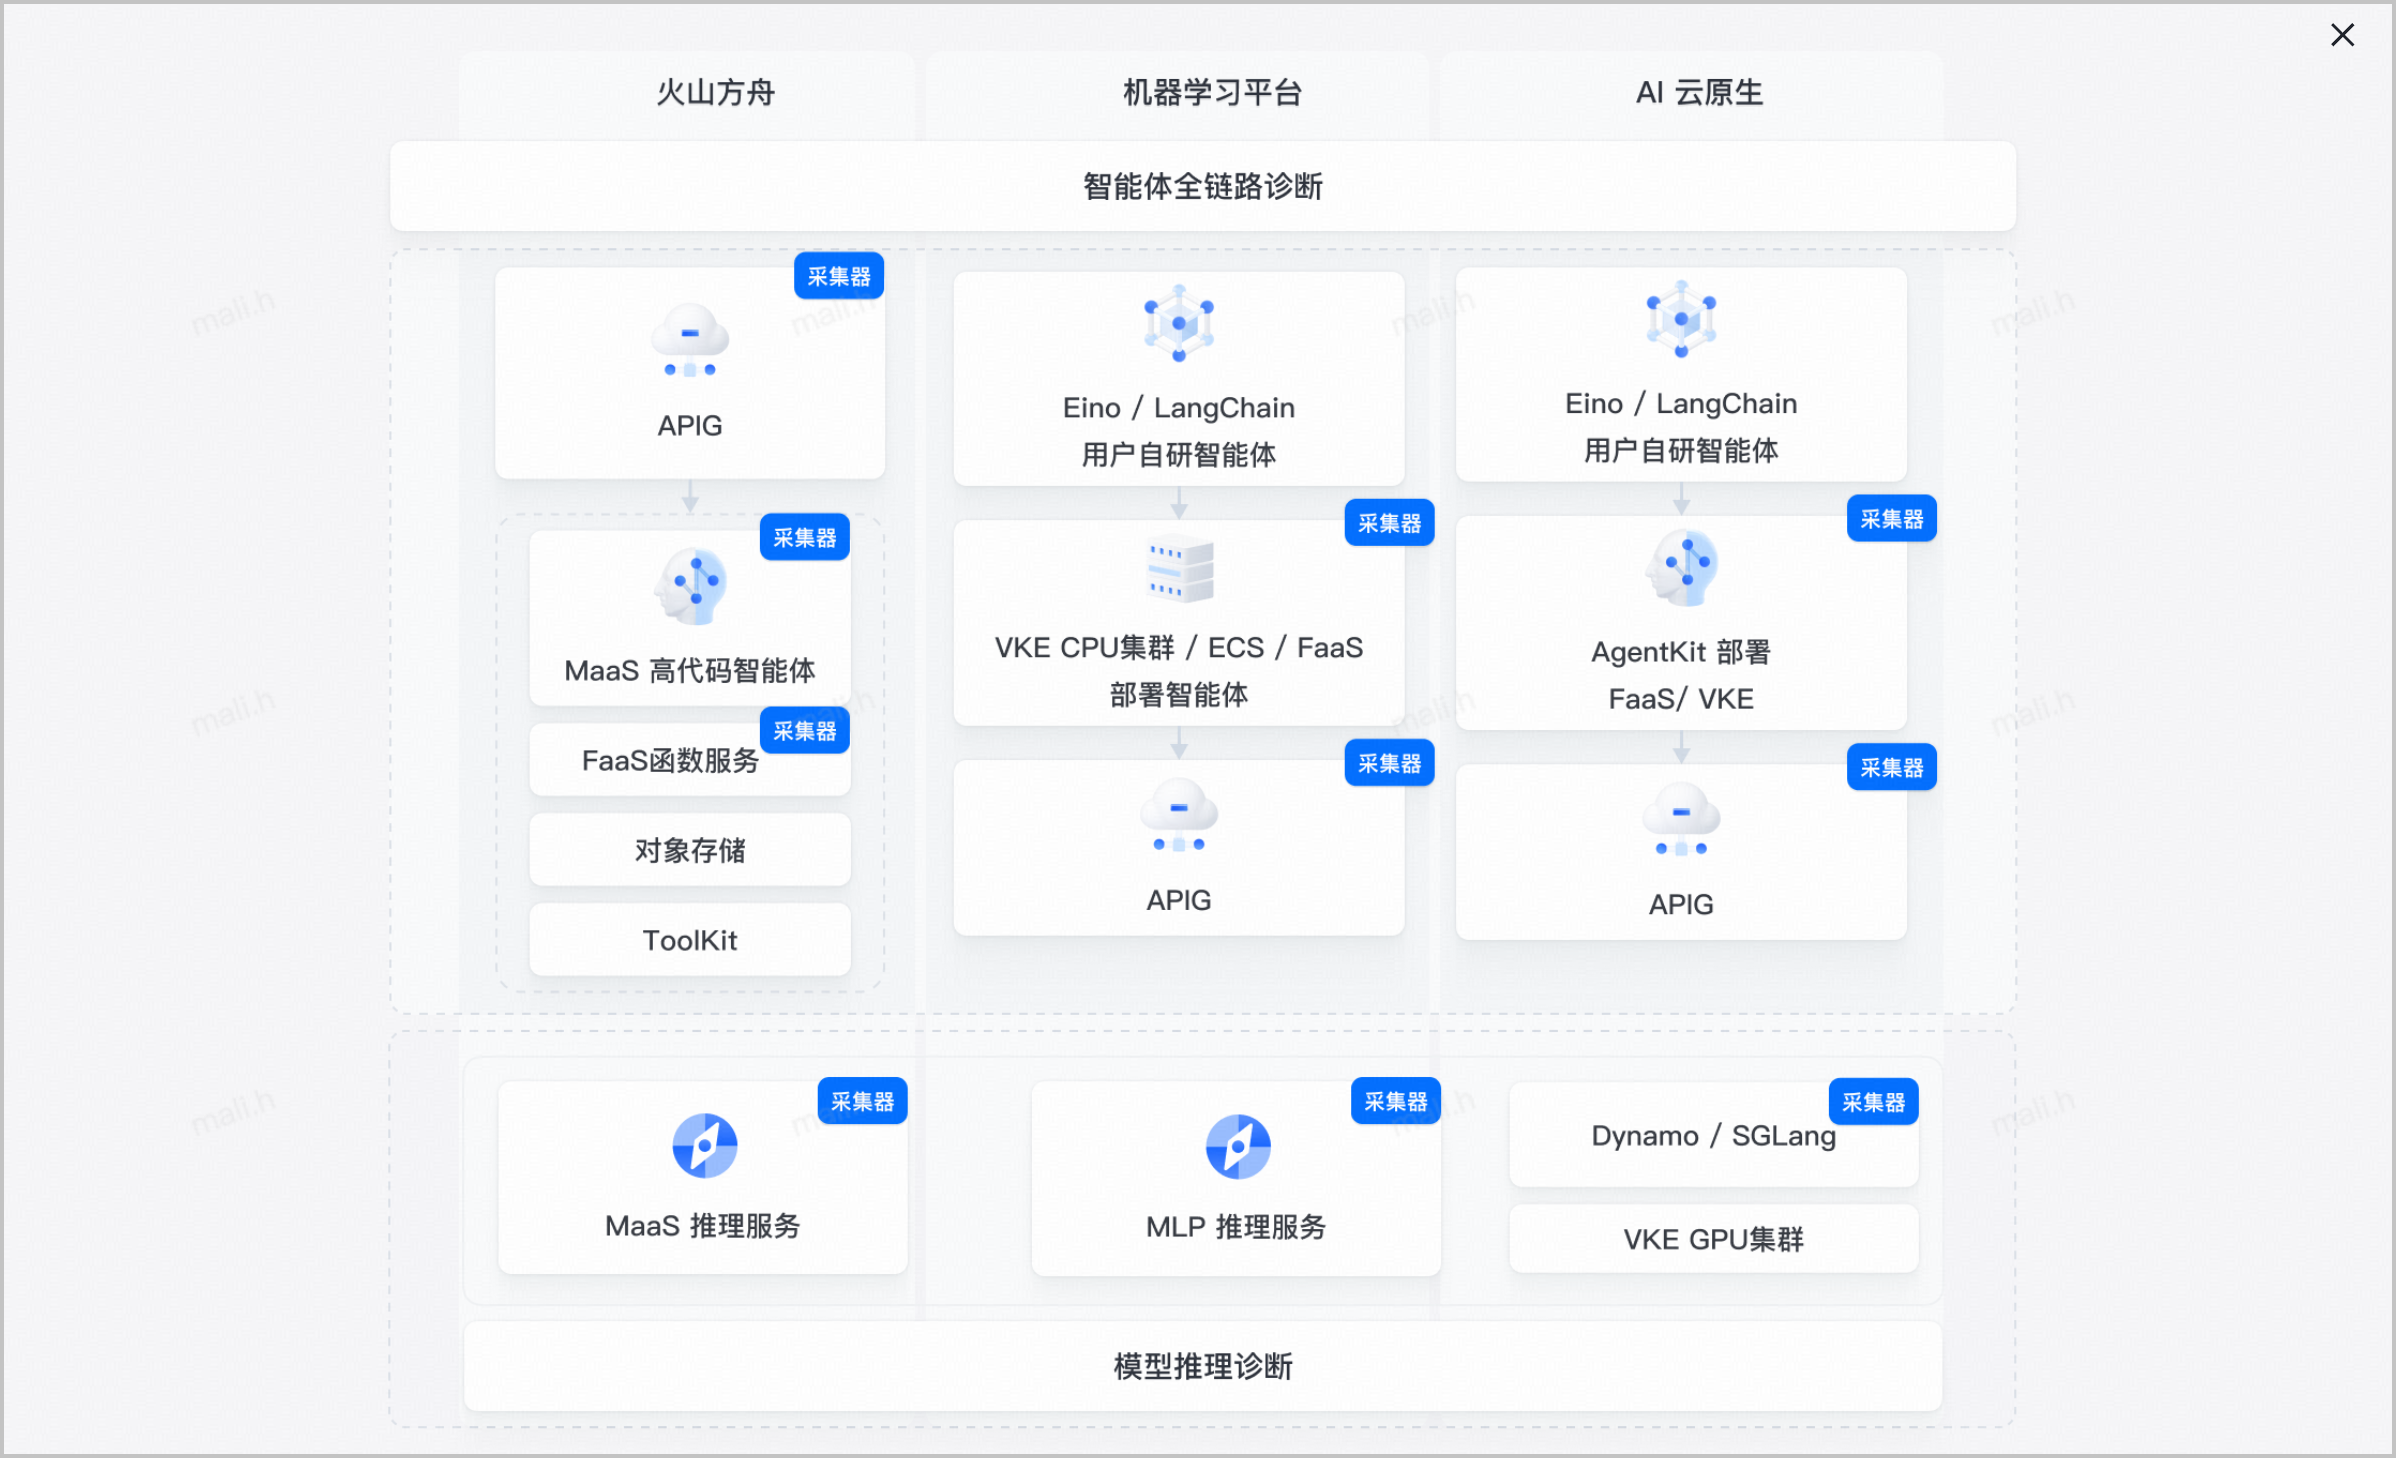
推理故障发现
通过指标及时追踪智能体和 AI 推理场景性能,一分钟发现问题,五分钟定位问题。
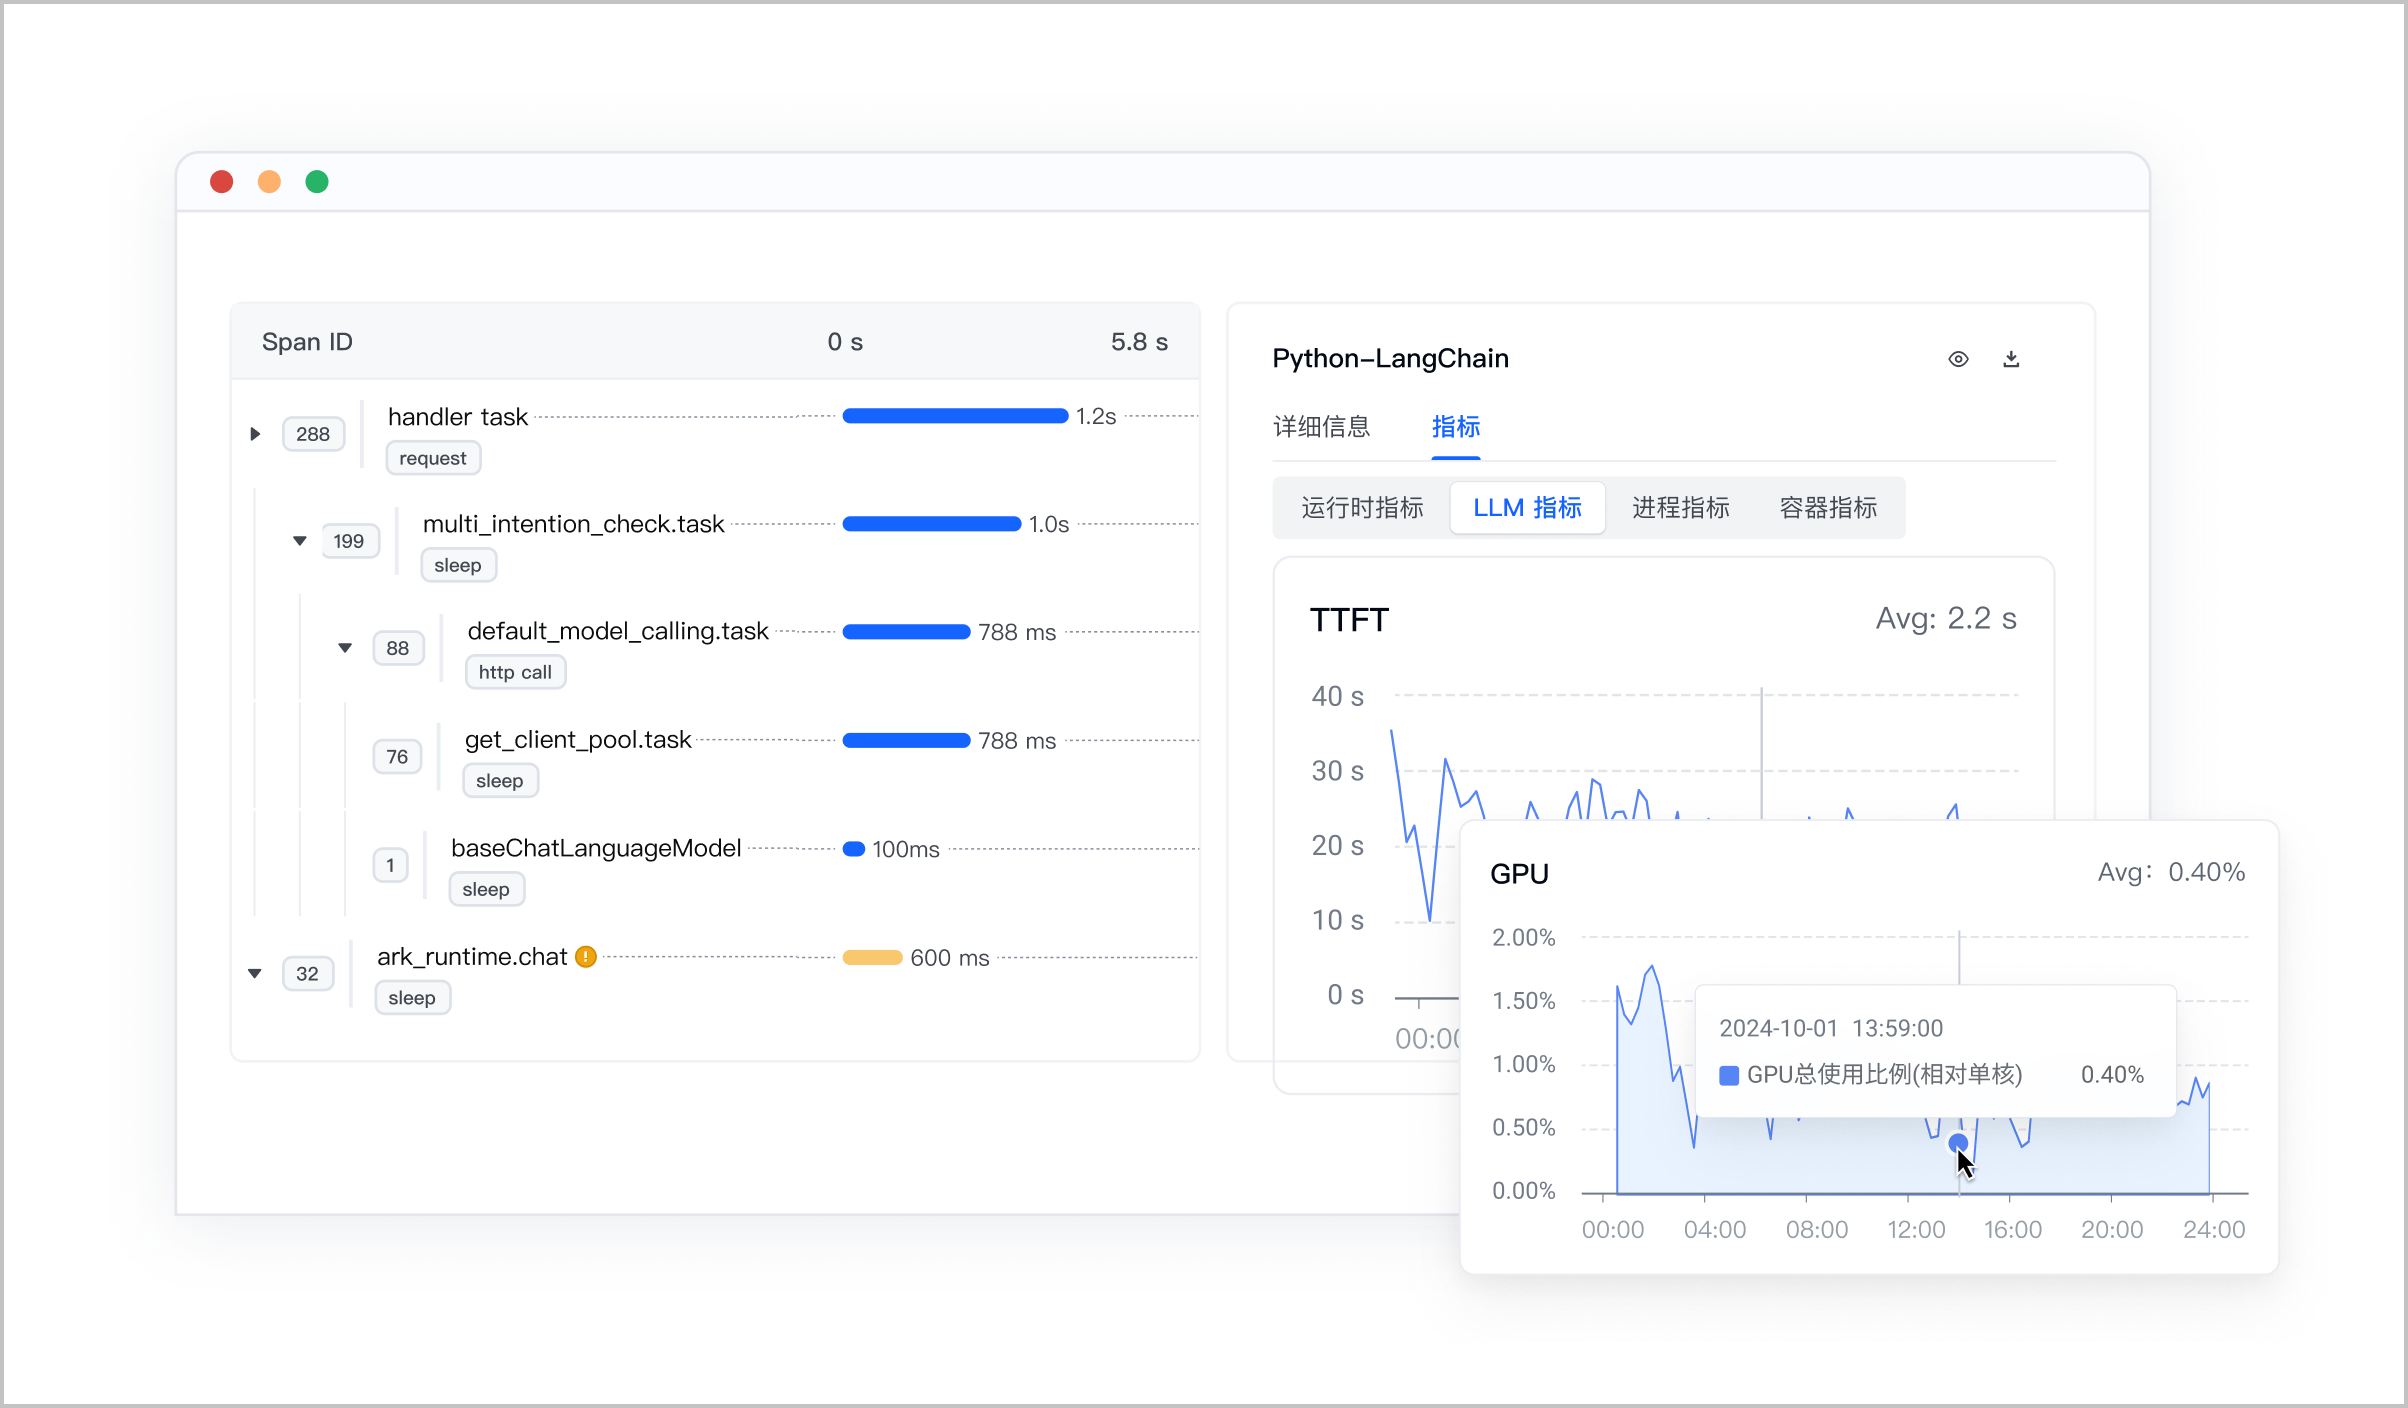
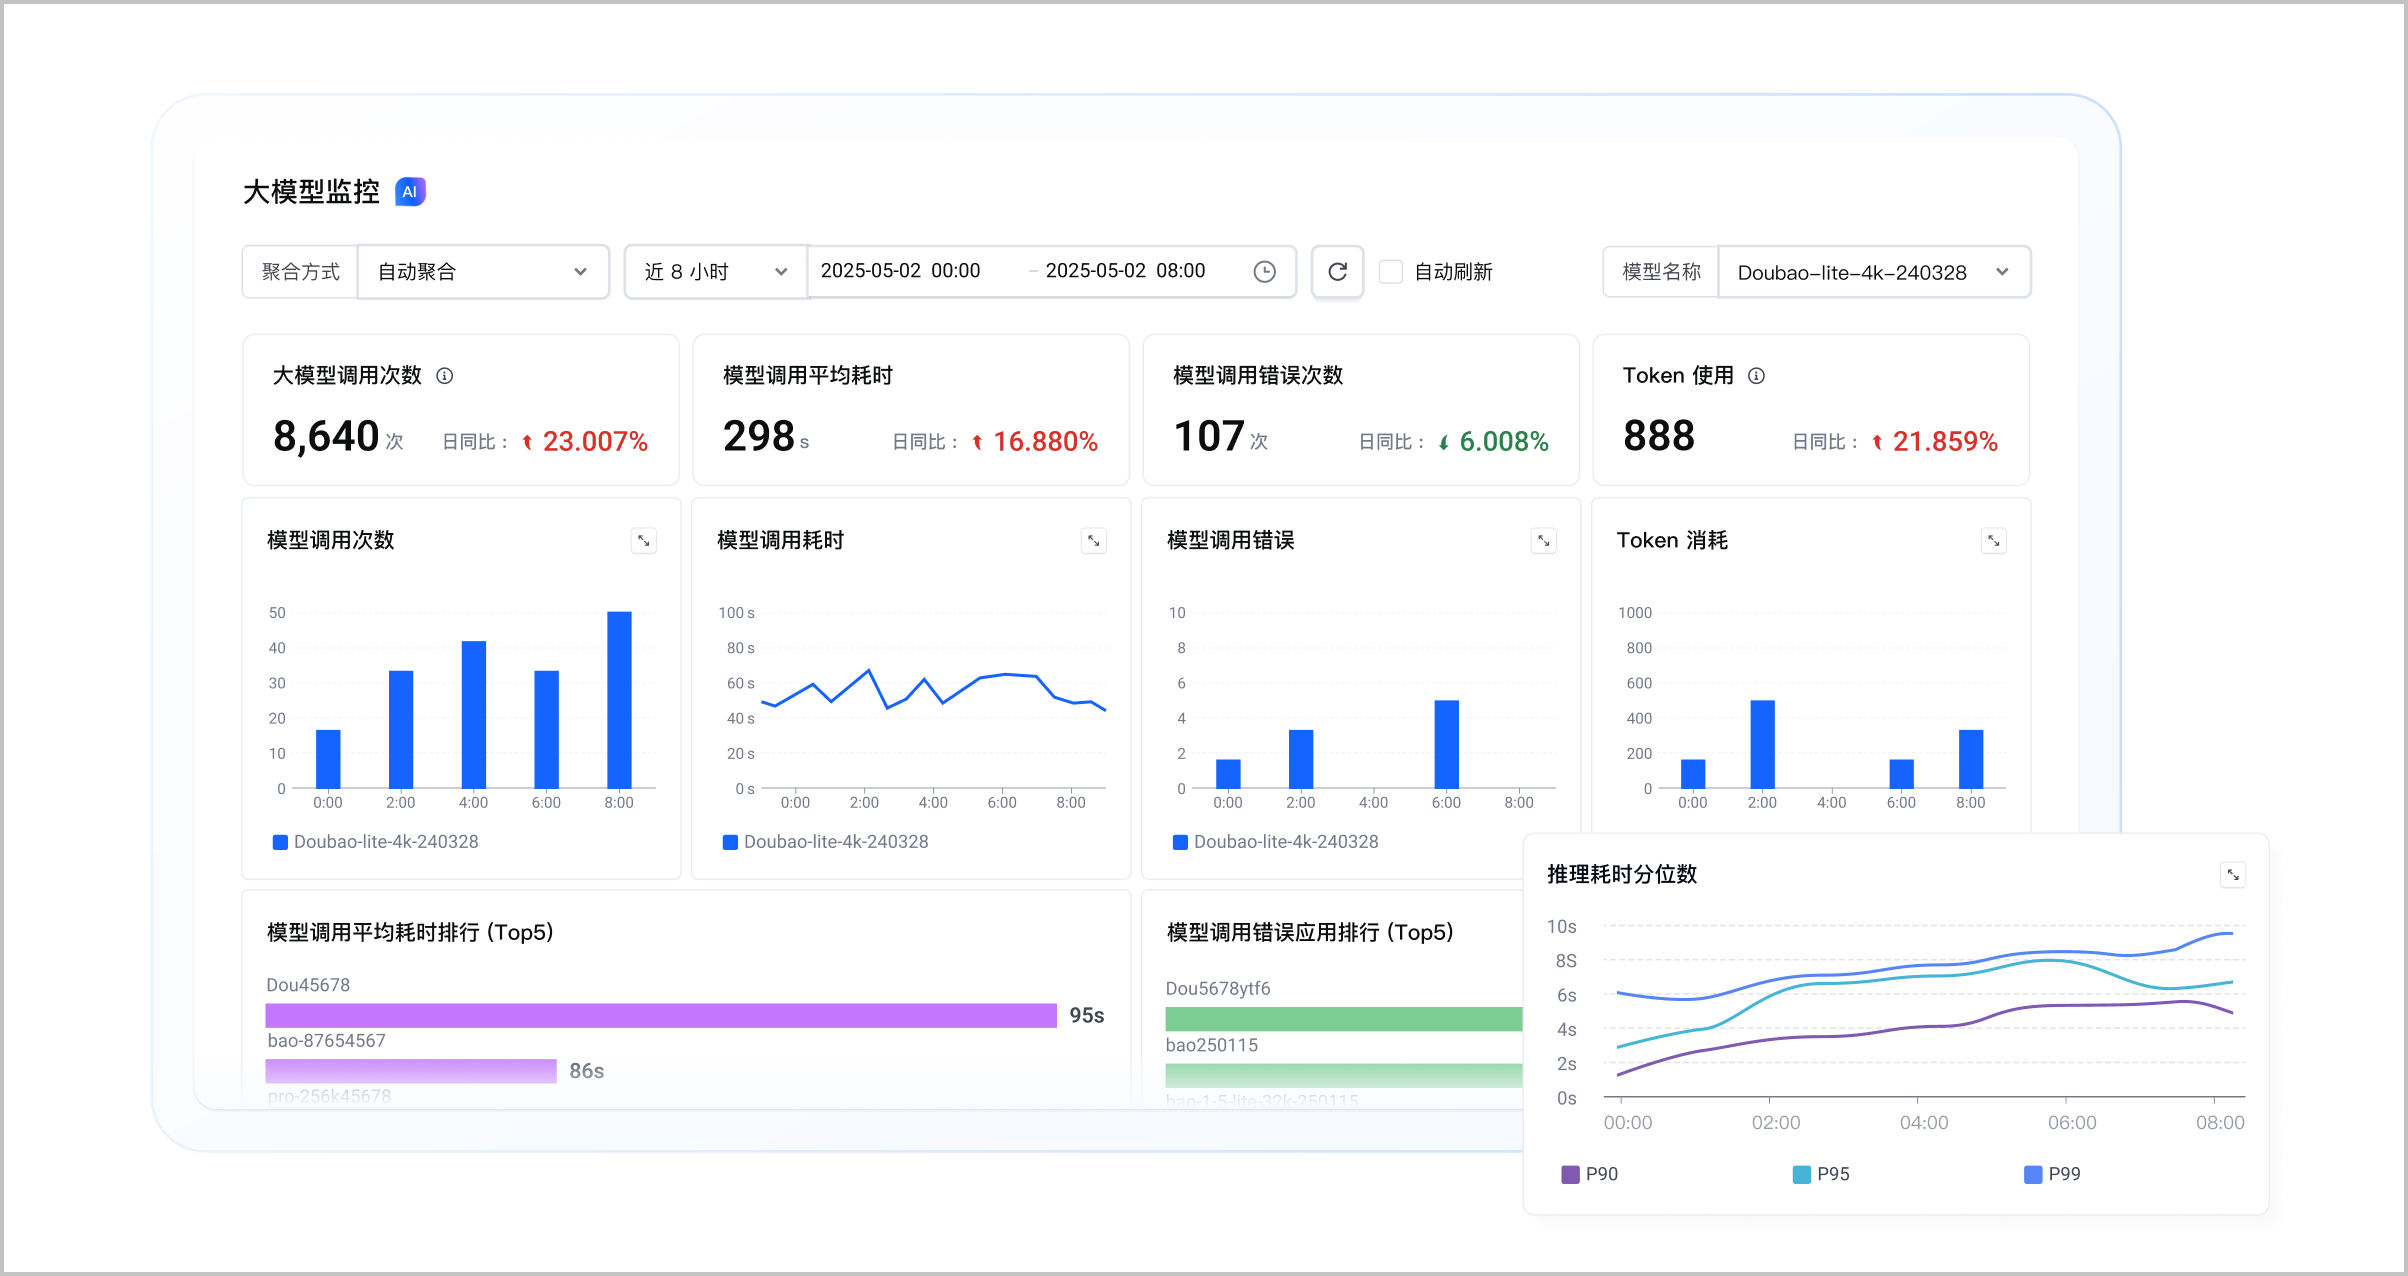
模型指标监控
以模型维度全量统计当前 AI 应用场景下的相关指标。
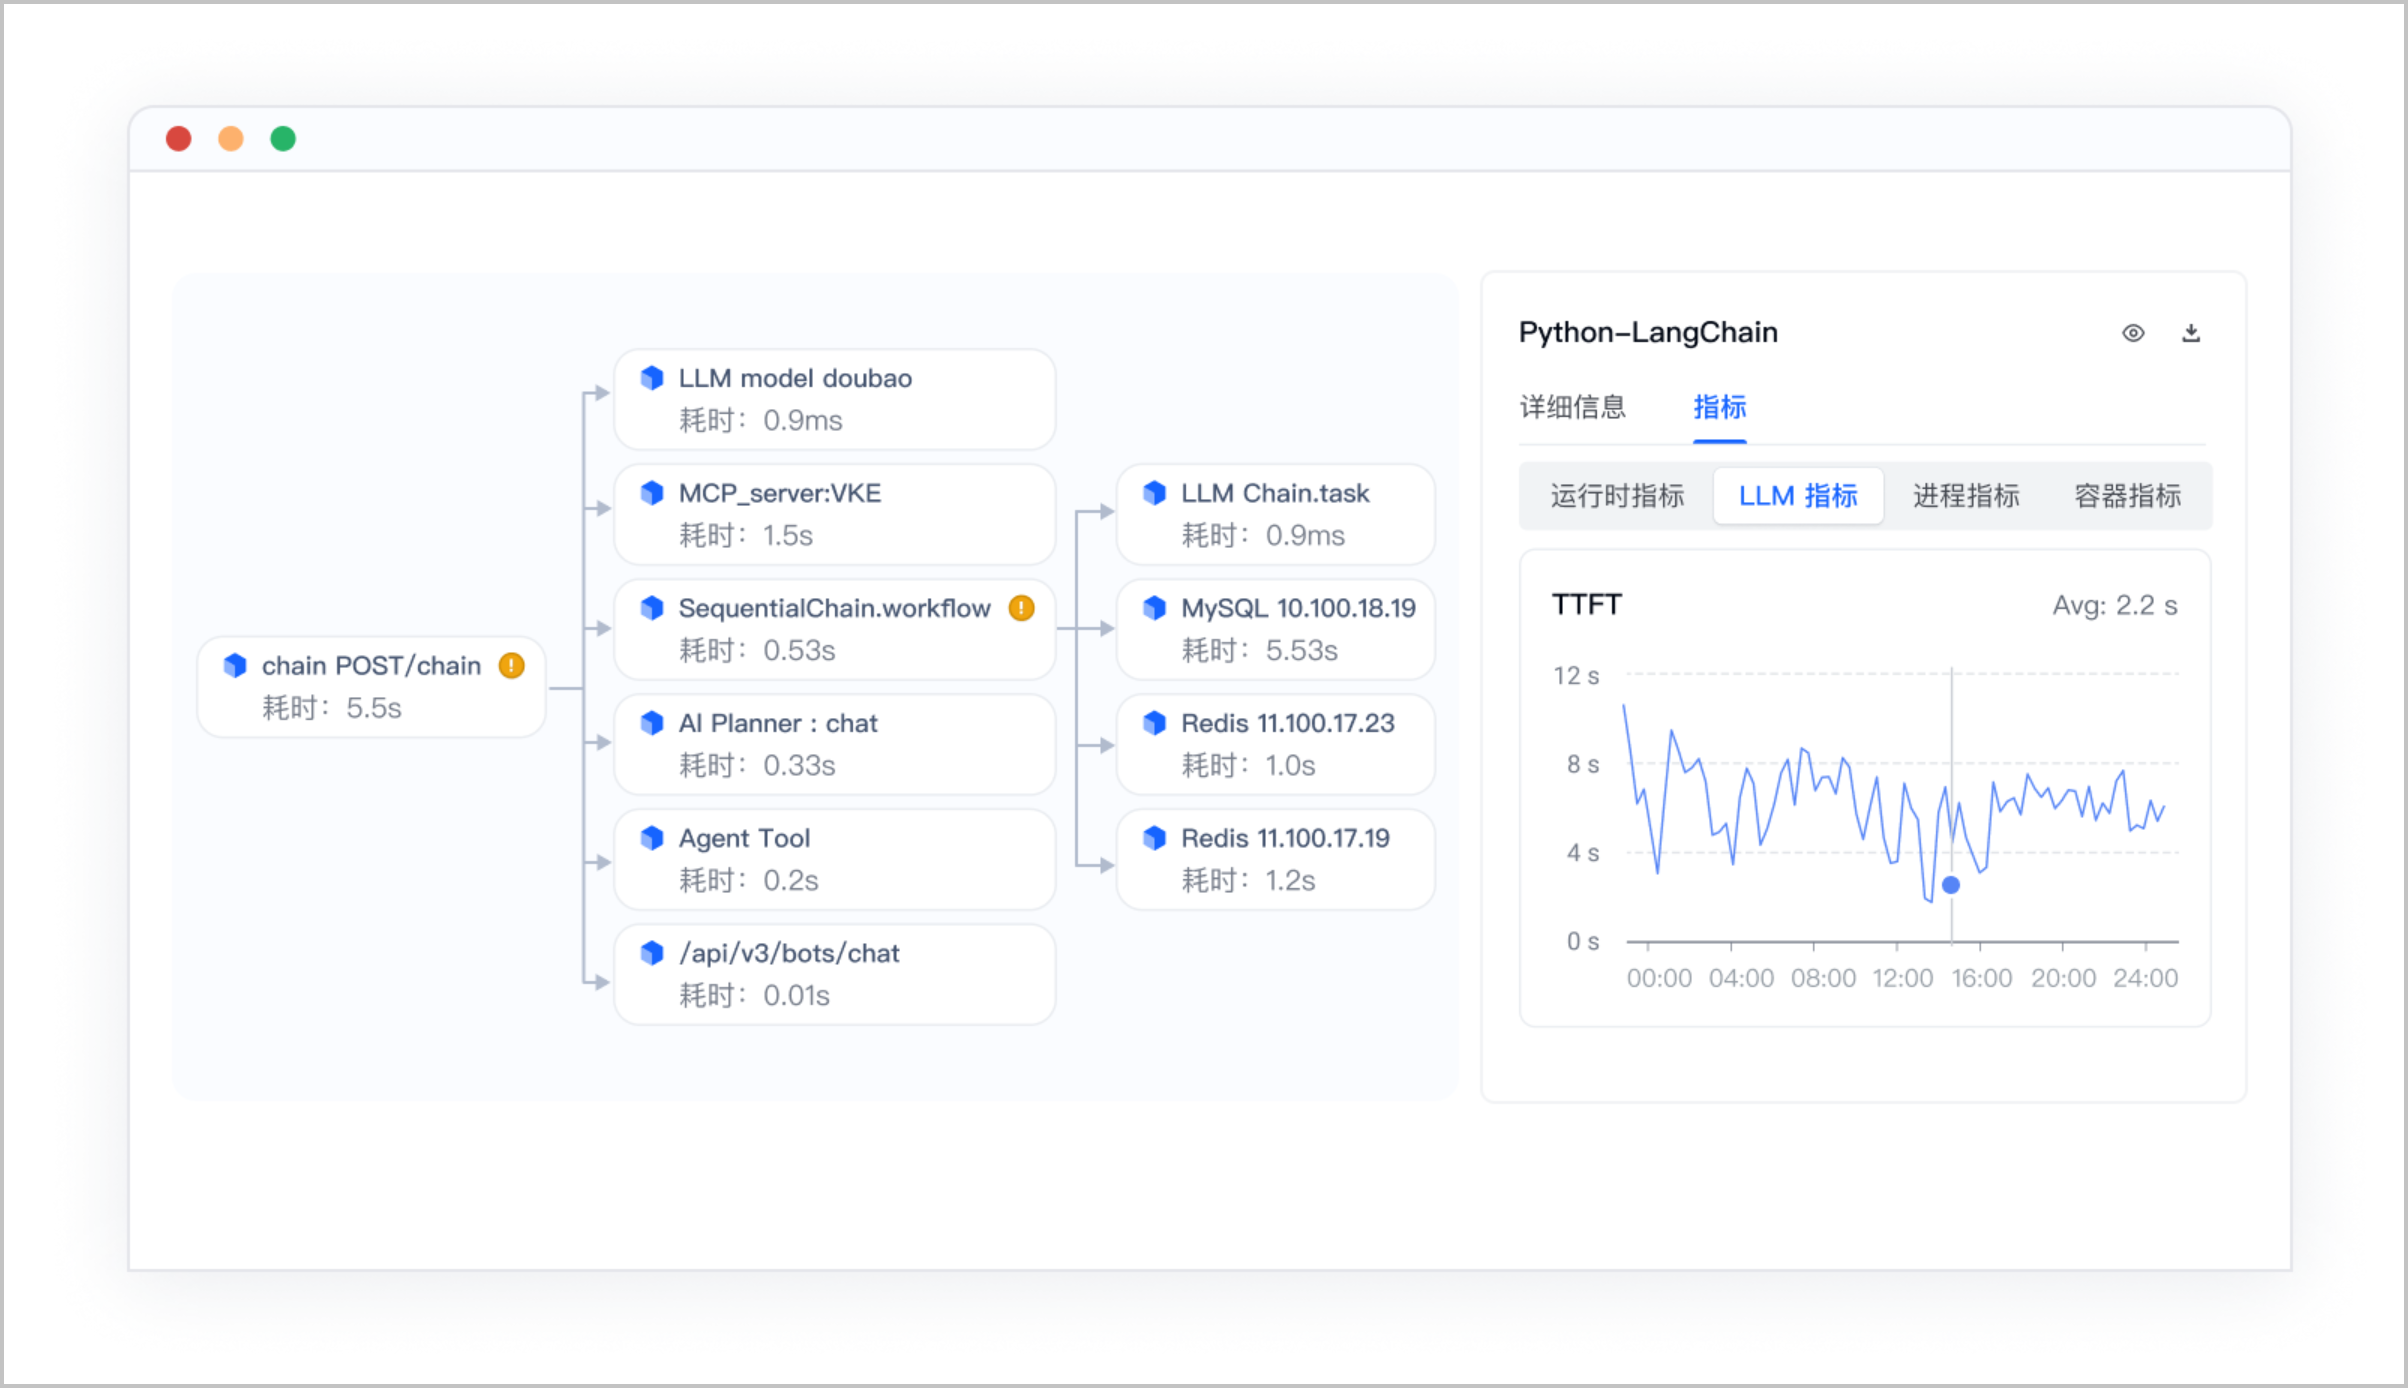
智能体拓扑图
实时展示当前 AI 业务上下游调用关系,分析热点和错误。
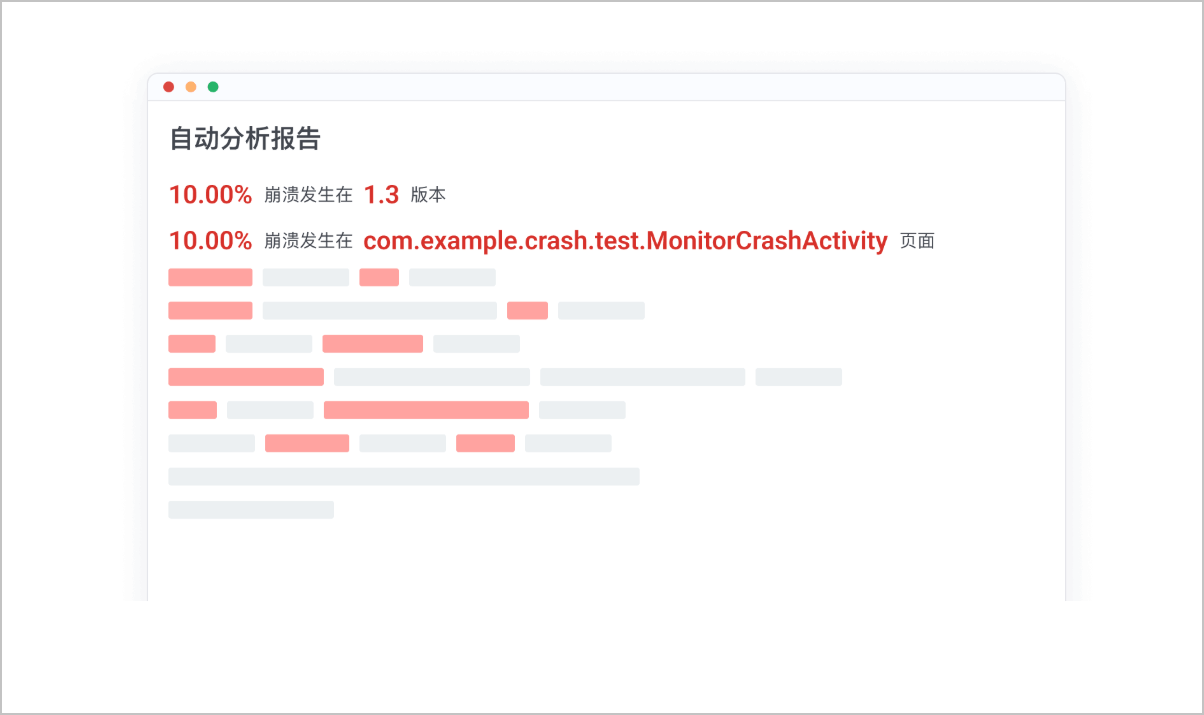
智能归因定位
支持多种智能化算法,对监控指标进行快速诊断与识别。
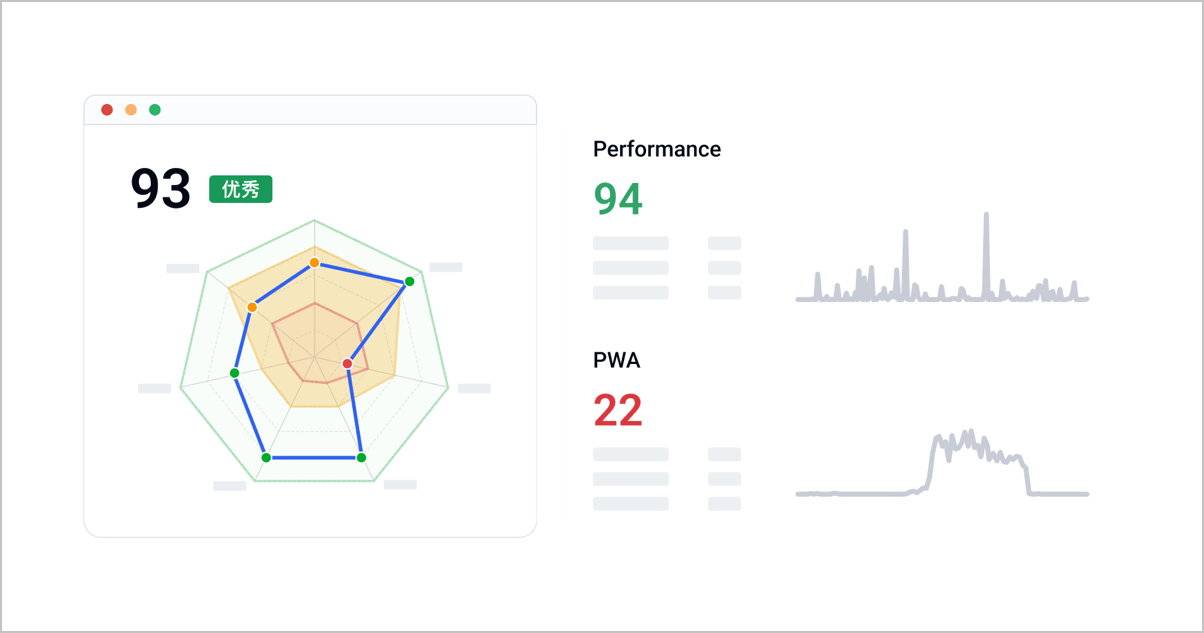
应用评价体系
基于后台系统指标,构建客观的应用运行状态评分体系。实时掌握各应用系统运行状况。
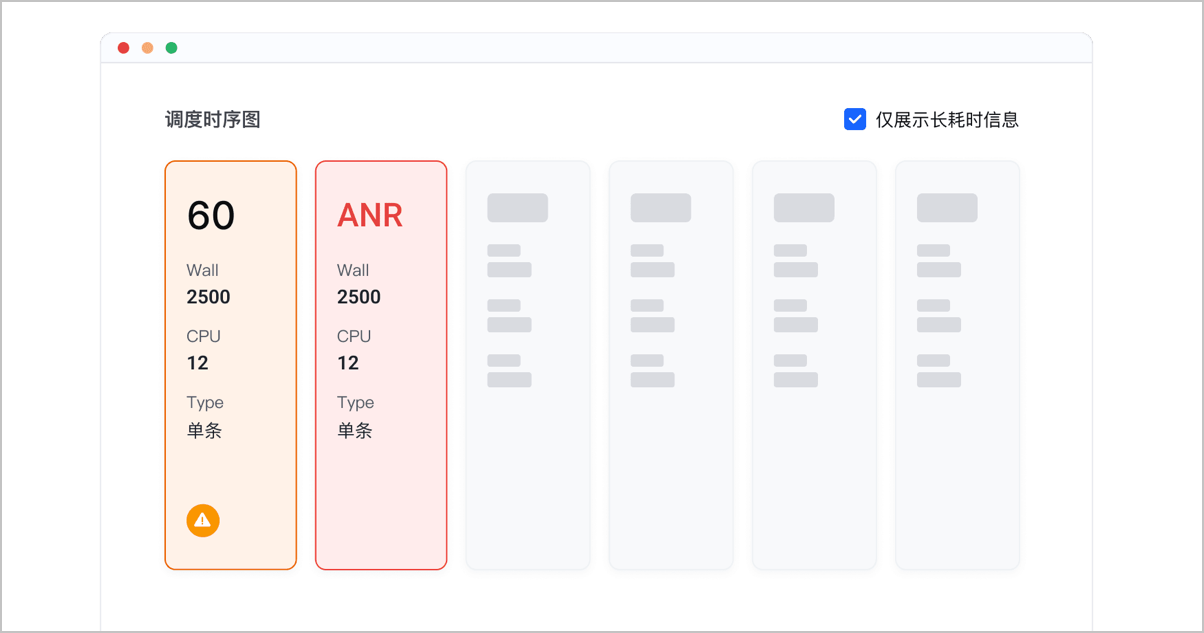
异常问题定位
针对各类形态的应用提供全链路端到端的异常问题检测和定位。
指标实时追踪
产品发版前后指标实时追踪。丰富且实时的指标帮助企业分析版本之间的数据差异。
最近更新时间:2026.02.10 19:56:32
这个页面对您有帮助吗?
有用
有用
无用
无用