You need to enable JavaScript to run this app.
文档中心
飞连

飞连

复制全文
下载 pdf
运行时安全
大模型语义防护
复制全文
下载 pdf
大模型语义防护
大模型语义防护用于检查员工通过 AI 网站、客户端应用或模型 API 发送的提示词,识别提示词攻击,并按策略记录或拦截请求。​
功能介绍​
员工使用 AI 应用时,输入的内容可能包含诱导模型忽略原有规则、提升权限或泄露系统提示词的指令。管理员可以针对企业使用的 AI 应用和模型提供商设置防护规则,了解这些请求由谁发起、触发了哪类风险,以及是否需要阻止访问。​
完成引流和 HTTPS 解密配置后,安全 Web 网关从经过网关的 AI 请求中提取提示词,识别其中的提示词攻击。策略支持观察或拦截:观察时允许访问并按配置记录日志;拦截时阻断命中防护内容的请求。当前语义检测针对用户输入,不检测模型输出。​
需要核查具体对话时,可在策略中开启AI 会话内容审计,记录用户输入、模型响应和多轮会话内容。例如,发现一条权限提升风险日志后,可以查看相关对话,了解用户输入了什么以及模型如何响应。只需要统计访问和风险事件时,可关闭会话内容审计,日志仅保留时间、人员、应用、命中策略等信息。​
前提条件​
语义检测需要获取经过安全 Web 网关的 AI 请求内容。配置前,请按以下顺序完成授权、流量接入和解密准备。​
  1. 开通安全 Web 网关授权,并为管理员授予对应功能的菜单及操作权限。​
  1. 配置企业自签根证书、证书自动安装范围和引流策略,使目标流量经过安全 Web 网关。​
  • 客户端信任企业 CA 证书后,网关才能解密检查 HTTPS 流量。具体请参见配置引流策略中的首次配置准备及引流步骤。​
  1. 配置 SSL 解密策略,将需要检查的 AI 应用或域名设为解密。​
  • 未解密的 HTTPS 流量只能进行基础的域名级识别或拦截,无法获取提示词正文执行语义检测,也无法提取相关 API 内容。具体请参见配置 SSL 解密策略。​
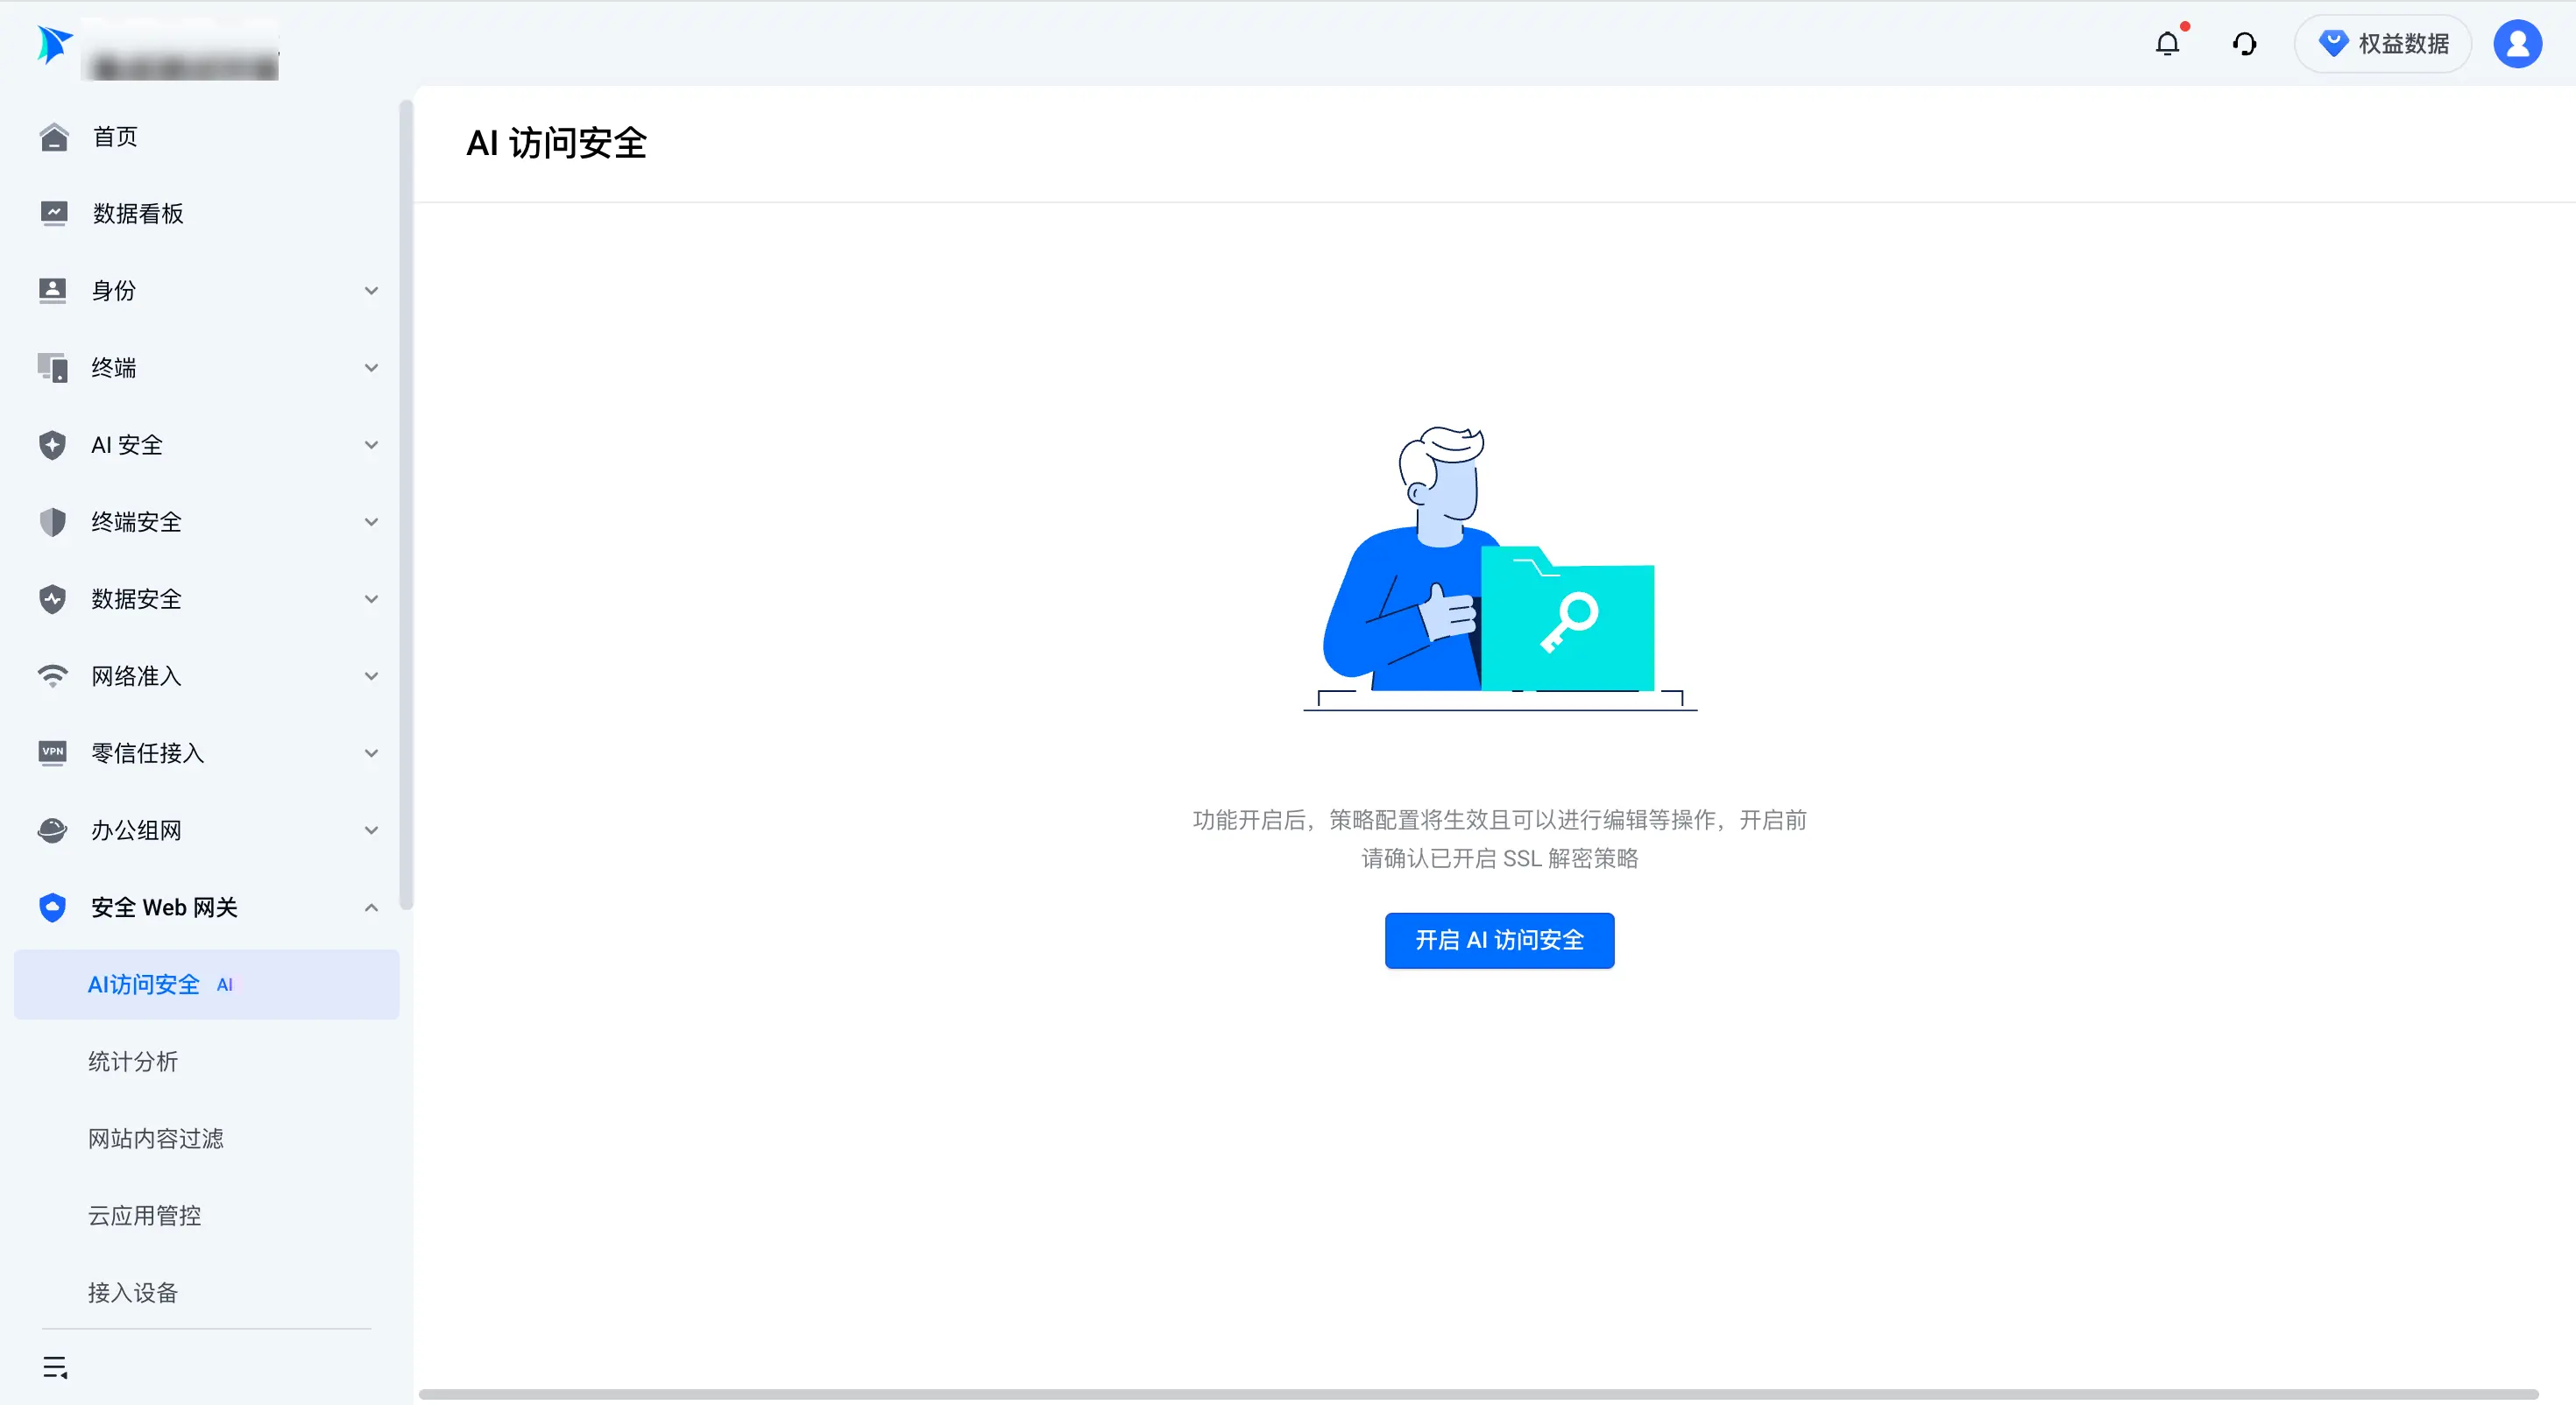
  1. 进入安全 Web 网关 > AI 访问安全,在功能引导页单击开启 AI 访问安全。​
  • ​​​
新增语义防护策略​
语义防护策略用于指定需要检查的 AI 应用或模型提供商、检测分类、处置方式和生效对象。完成策略配置后,匹配的访问行为会按规则记录或拦截,并生成对应审计日志。​
说明​
资产盘点依赖日志上报。需要尽可能完整地统计企业内使用的 AI 应用和模型时,可先配置一条覆盖全员的低优先级策略,选择全部 AI 应用与模型,处置方式设为观察 > 记录所有日志,防护内容留空。再针对高风险应用或特定人员配置高优先级策略,选择观察 > 仅记录触发防护内容的日志或拦截,并勾选需要检测的分类。高优先级策略记录的范围取决于其日志选项,资产统计也会随上报日志更新。​
  1. 登录飞连管理后台。​
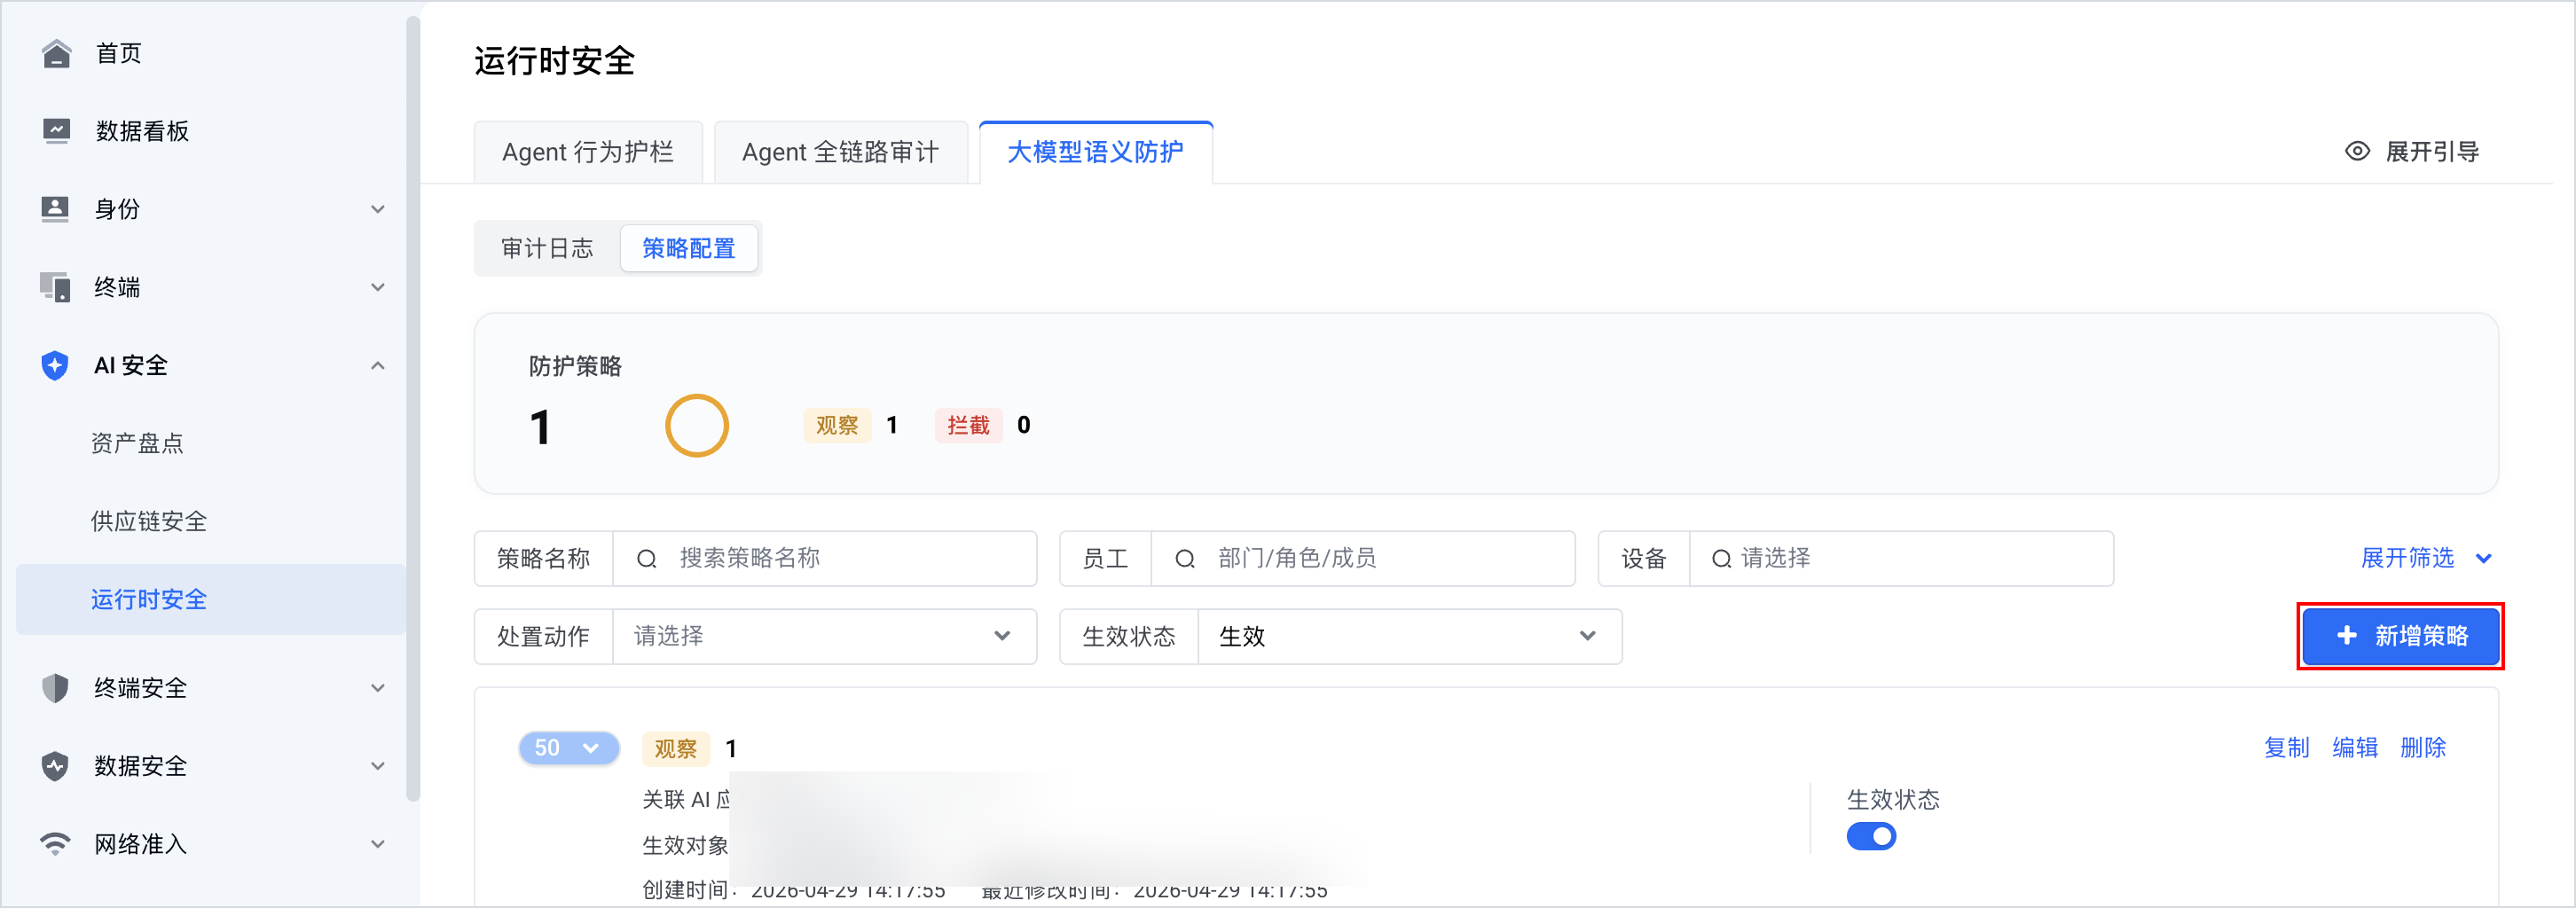
  1. 进入AI 安全 > 运行时安全 > 大模型语义防护。​
  1. 切换至策略配置页签,单击新增策略。​
  • ​​​
  1. 在添加防护策略页面,完成以下配置,然后单击确定。​
  • 基本信息​
  • ​
    配置项​
    说明​
    策略名称​
    自定义易于识别的策略名称。建议按管控目标命名,例如“全员 AI 使用审计”或“提示词攻击防护”。​
    优先级​
    设置 0~100 的数值,默认值为 50。数值越大优先级越高。访问同时匹配多条策略时,系统仅执行优先级最高的一条;数值一致时,执行最近一次添加或修改的策略。​
    AI 应用与模型​
    选择需要管控的 AI 应用或模型提供商,支持多选。​
    • AI 应用:选择网页端应用(如豆包、ChatGPT、DeepSeek、Kimi)或客户端应用(如 Cursor、Trae)。可选应用以页面列表为准。​
    • 模型提供商:可选择 OpenAI、Anthropic、Google 等已知提供商,包含官方、中转站和自建来源;按提供商管控其相关应用和模型,也可用于企业内嵌应用调用模型 API 的场景。​
    • 未知厂商:勾选后,系统会发现企业内访问的未知模型并生成资产进行防护。取消勾选后,停止新增和更新对应资产,已有资产、防护策略和审计日志保留。​
    ​
  • 处置方式​
  • ​
    配置项​
    说明​
    观察​
    允许用户正常访问,并按以下方式记录日志。​
    • 记录所有日志:记录生效对象对所选应用和模型的访问行为,无论是否触发防护内容。​
    • 仅记录触发防护内容的日志:只有访问命中了所选检测分类时,才生成审计日志。​
    拦截(Beta)​
    阻断命中防护内容的访问请求。拦截功能处于 Beta 阶段,拦截效果可能存在偏差,请谨慎使用。​
    ​
  • 审计内容​
  • ​
    配置项​
    说明​
    AI 会话内容审计​
    新建策略时默认关闭。开启后,记录策略范围内的用户输入、模型响应和多轮会话内容,可在日志详情中查看具体交互。关闭后,只上报访问和风险事件,不再记录和存储会话正文,也无法在详情中查看会话内容。对会话数据有隐私或合规要求时,可据此选择是否开启。​
    说明​
    从 3.3.9 之前的版本升级时,历史策略的AI 会话内容审计开关默认开启。管理员可手动关闭;关闭后,该策略历史日志中的请求内容和会话内容也不再支持查看。​
    ​
    ​
  • 防护内容​
  • ​
    配置项​
    说明​
    检测分类​
    选择需要识别的提示词攻击类型。处置方式为拦截,或观察 > 仅记录触发防护内容的日志时,至少选择一项检测分类。当前只检测用户输入,不检测模型输出。​
    ​
  • 各检测分类的含义如下。​
  • ​
    检测分类​
    说明​
    角色扮演​
    通过设定或限定模型的角色属性,诱导模型采用该角色的语言风格,绕过安全限制,生成可能涉及知识产权、伦理道德或其他不当内容的回复。​
    权限提升​
    诱导模型进入更高级别的权限状态,例如开发者模式,使模型突破原有安全限制、忽略既定规则,产生不受控制的输出或执行超出授权范围的操作。​
    对抗前后缀​
    在恶意提示词前后添加特殊字符串,干扰模型判断,使其生成预期外或不可控的回复。例如利用无意义字符扰乱模型对正常内容和攻击指令的识别。​
    目标劫持​
    在提示词中添加欺骗性或误导性指令,覆盖或干扰原有指令,诱导模型产生特定输出。​
    混淆和编码​
    利用无意义符号破坏过滤器,或通过编码、加密绕过模型的安全防护。​
    少量示例攻击​
    提供少量带有恶意倾向的回答示例,诱导模型生成恶意或误导性的输出。​
    窃取提示词​
    在用户原始输入中添加恶意指令,试图获取系统或用户的原始提示信息。​
    其他提示词攻击​
    上述类别之外的其他提示词攻击。​
    ​
  • 生效对象​
  • ​
    配置项​
    说明​
    生效对象​
    选择策略适用的部门、成员、角色或特定终端设备、设备组。​
    ​
  1. 检查配置后的访问情况。​
  • 观察:员工可正常使用 AI,后台按所选日志方式记录访问时间、人员和风险类型;开启会话内容审计时,还会记录输入和响应正文。​
  • 拦截:员工发出的提示词命中防护内容后,请求会被阻断。浏览器或应用可能显示连接重置或飞连安全拦截页面。​
  • 进入审计日志页签,核查访问记录、命中策略和执行动作,必要时查看具体会话内容。​
您也可以在安全 Web 网关 > AI 访问安全 > 策略配置 > 大模型语义护栏页面配置策略。​
管理策略​
在AI 安全 > 运行时安全 > 大模型语义防护 > 策略配置页面,可查看策略对应的 AI 应用和模型、生效对象、优先级以及创建和更新时间,并执行以下操作。​
​
操作​
说明​
调整优先级​
修改策略优先级,调整多条策略同时匹配时的执行顺序。​
启用或停用​
通过策略开关启用或停用规则。​
复制​
以已有策略为基础创建新策略。​
编辑​
修改管控应用、检测分类、审计内容、处置方式或生效对象。​
删除​
删除不再使用的策略,并按页面提示确认。​
​
查看审计日志​
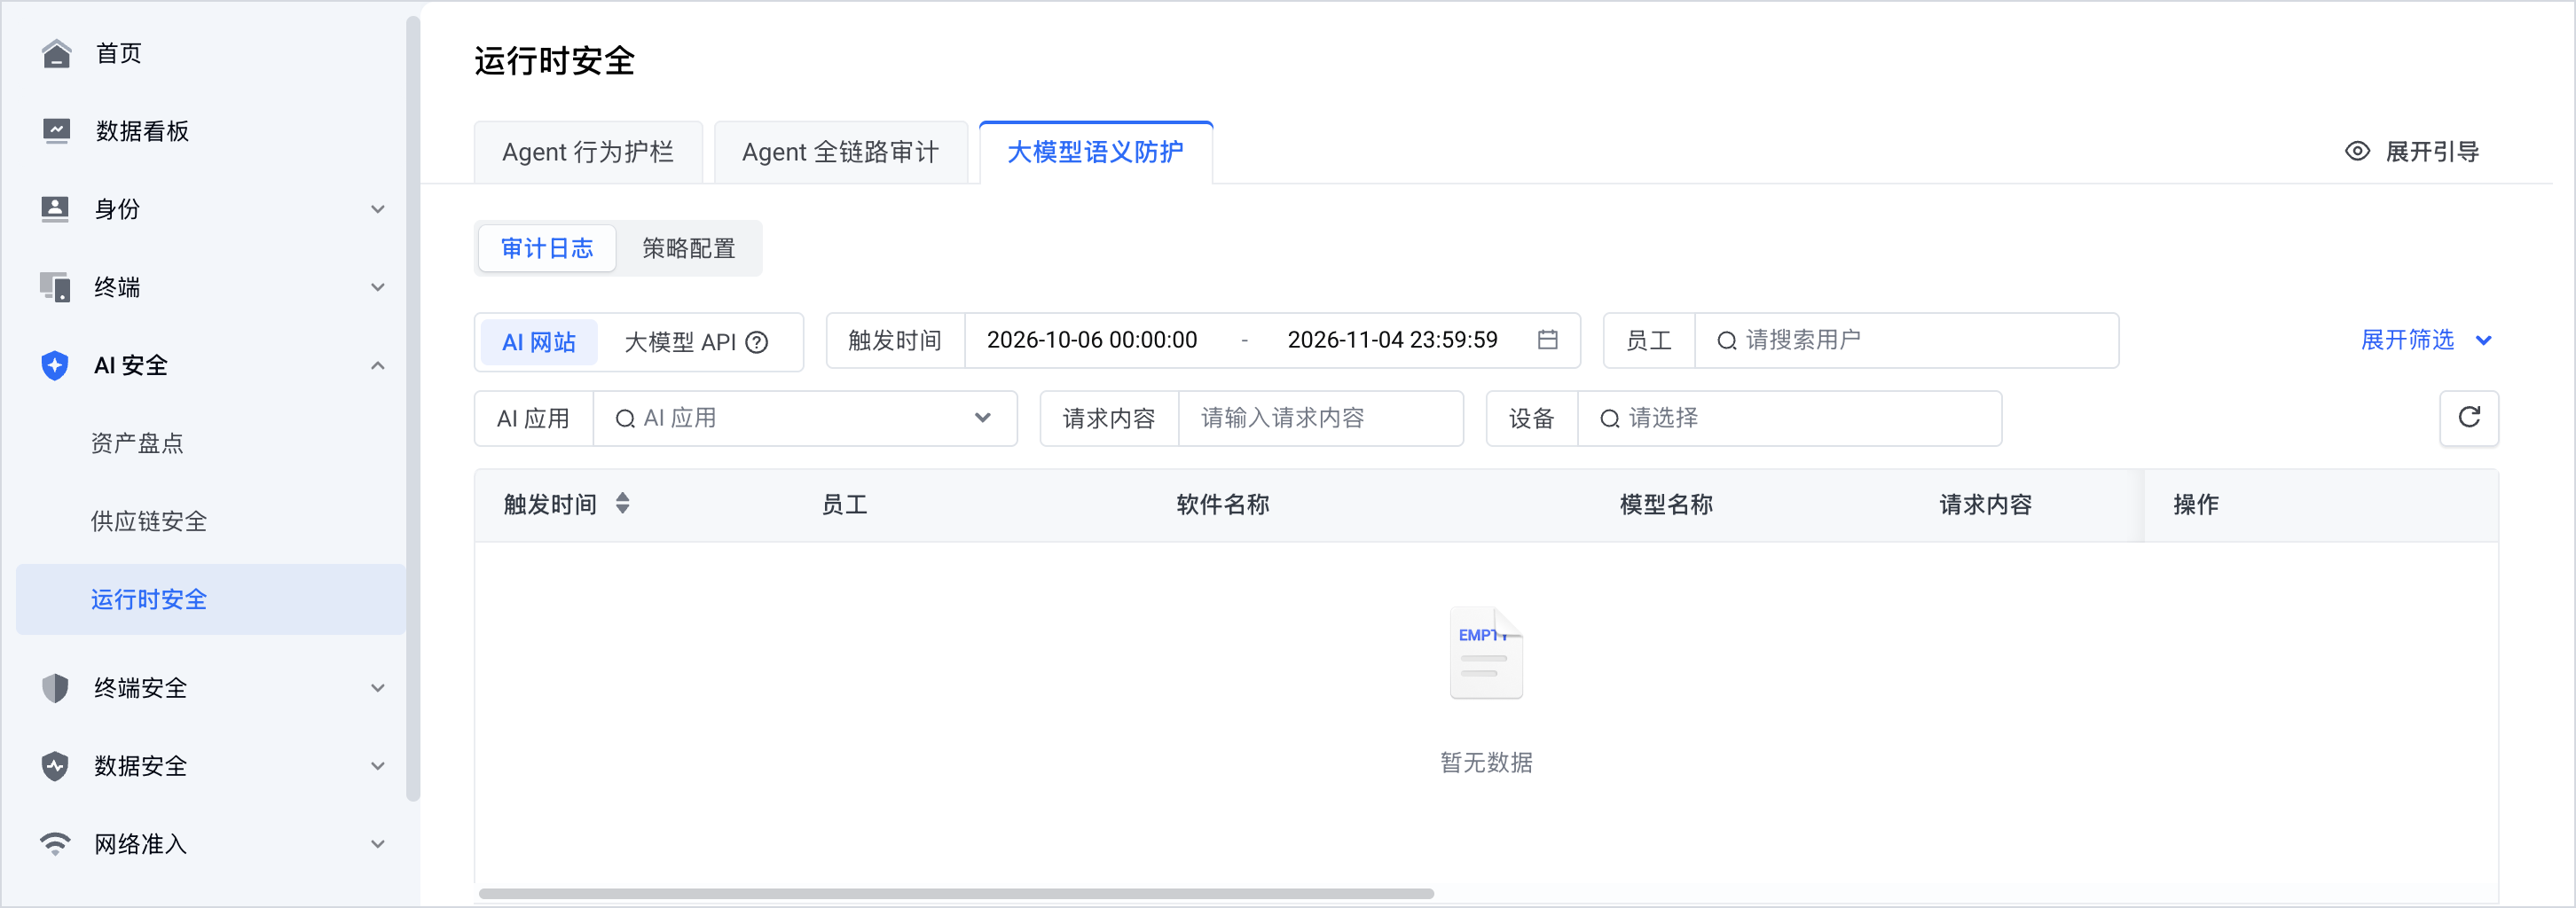
需要核查员工使用了哪些 AI 网站或模型 API、输入触发了什么风险,以及策略是否按预期处理时,可查看语义防护的审计日志。日志分为AI 网站和大模型 API两类,分别记录应用对话与模型接口调用。​
  1. 进入AI 安全 > 运行时安全 > 大模型语义防护,选择审计日志页签。​
  1. 选择AI 网站或大模型 API,按触发时间、员工、设备、命中策略、处置动作和检测分类筛选记录。AI 网站还可按 AI 应用和请求内容筛选;大模型 API 可按模型来源类型、模型提供商、模型名称、本轮用户提示词及本轮工具调用筛选。​
  1. 查看匹配记录,结合命中策略、检测分类和执行动作,核对请求为何被记录或拦截。​
  • ​​​
​
字段​
说明​
触发时间​
访问触发日志的时间。​
员工​
发起访问的员工。​
软件名称​
AI 网站日志中识别出的应用名称。​
模型提供商​
大模型 API 日志中被调用的提供商。可据此区分请求发往哪家服务,并查看关联 URL。​
模型来源类型​
大模型 API 的来源,包括官方、中转站、自建和未知。可通过同名筛选项查找某类来源的请求。​
模型名称​
该次请求使用的模型。​
请求内容​
AI 网站日志中用户发送给 AI 的提示词或请求正文。对应策略需开启AI 会话内容审计,才能记录和查看具体内容。​
本轮用户提示词​
大模型 API 本轮请求中员工发送给 AI 的用户提示词,由安全 Web 网关上报。对应策略需开启AI 会话内容审计才能查看。​
本轮工具调用​
大模型 API 本轮交互是否包含工具调用,显示是或否。​
设备​
发起请求的终端。​
命中策略​
处理该次请求的防护策略。单击策略名称可查看配置。​
执行动作​
该次访问被允许或拦截的结果。​
检测分类​
识别出的提示词攻击类型,例如角色扮演或目标劫持。​
​
您也可以在安全 Web 网关 > AI 访问安全 > 防护日志页面,通过 AI 应用和大模型 API 对应页签查看这些日志。​
查看日志详情和会话内容​
单击目标日志操作列的查看详情,可结合请求信息、具体对话和员工设备信息,核查风险内容及其来源。​
​
信息分类​
说明​
事件信息​
查看触发 URL、应用或模型提供商、模型名称、执行动作和检测分类,核对访问目标及策略处理结果。​
AI 会话内容​
按交互顺序查看用户输入、模型响应及多轮会话。结合前后文,检查是否存在通过连续指令诱导模型越权或忽略规则的情况。对应策略需开启AI 会话内容审计。​
系统提示词​
大模型 API 日志包含该项时,可查看请求中携带的系统提示词,了解为模型设定的角色或规则。​
工具列表​
大模型 API 日志包含工具定义时,可查看可用工具及其参数定义,并结合会话中的实际调用了解工具用途。​
详细日志​
查看客户端 IP、请求方法、URL 和路径等网络请求信息。大模型 API 可切换至详细日志页签;AI 网站可通过事件信息中的查看详情查看原始报文,用于核查请求内容或排查访问问题。​
员工信息​
查看姓名、部门和账号状态,确认发起访问的人员。​
设备信息​
查看操作系统、IP 和设备 ID,确认访问来自哪台终端。​
​
会话内容可能涉及业务数据。需要展开敏感内容时,单击查看敏感内容,再单击确认查看;若企业配置了管理员敏感操作二次认证,按提示完成验证后查看。​
归档日志​
对已完成审计或无需继续关注的记录,具有归档权限的管理员可在日志列表操作列单击归档,再单击确认归档。归档后的日志不再在列表和详情中展示,归档操作会记录在管理员审计日志中。​
最近更新时间:2026.11.04 21:06:02
这个页面对您有帮助吗?
有用
有用
无用
无用