GPU云服务器
GPU云服务器
GPU云服务器


文档指南
请输入


GPU云服务器
图说GPU云服务器
用户指南
安装NVIDIA驱动
安装NVIDIA GRID驱动
安装veCCL
最佳实践
AIGC实践
DeepSeek系列模型
搭建应用
性能测试/调优
故障处理
- 文档首页
 GPU云服务器GPU云服务器最佳实践AIGC实践GLM系列模型GPU-部署GLM-5.2模型
 复制全文
 下载 pdf
GPU-部署GLM-5.2模型
 文档反馈
 问问助手
本文以2台ecs.hpcpni3ln.45xlarge实例为例,介绍如何在GPU云服务器上部署GLM-5.2模型。
背景信息
GLM-5.2-FP8是最新开源的MoE大模型FP8量化版本,支持1 M上下文,模型总参数约753 B,推理激活参数约40 B。该模型是一个面向长上下文、代码生成、复杂推理与Agent场景的大规模模型,FP8量化版本进一步降低了推理显存占用,更适合高性能部署与本地化推理场景。
软件要求
- NVIDIA驱动:
- GPU驱动:用于驱动NVIDIA GPU的程序,本文以535.261.03为例。
- 运行环境:
- SGLang框架:SGLang框架是一款专为大语言模型(LLMs)及视觉语言模型打造的高性能服务框架,通过协同设计前端结构化生成语言与后端运行时系统,实现与模型的高效交互,并保障了生成过程的可控性。本文使用 v0.5.13 版本进行操作演示。
操作步骤
步骤一:准备环境
- 创建GPU计算型实例。
- 请根据通过向导购买实例指引,创建两台符合下表条件的实例。
- 配置项推荐配置配置项推荐配置基础配置计算规格ecs.hpcpni3ln.45xlarge说明镜像实例数量2台说明本文创建的两台GPU实例,分别作为“Rank 0”、“Rank 1”。存储
- 规格:吞吐型SSD TL0云盘
- 容量:不低于1024 GiB
说明本文使用的GLM-5.2-FP8模型参数量均为753 B,建议您配置云盘容量不低于1024 GiB。网络配置公网IP勾选“分配弹性公网IP”。
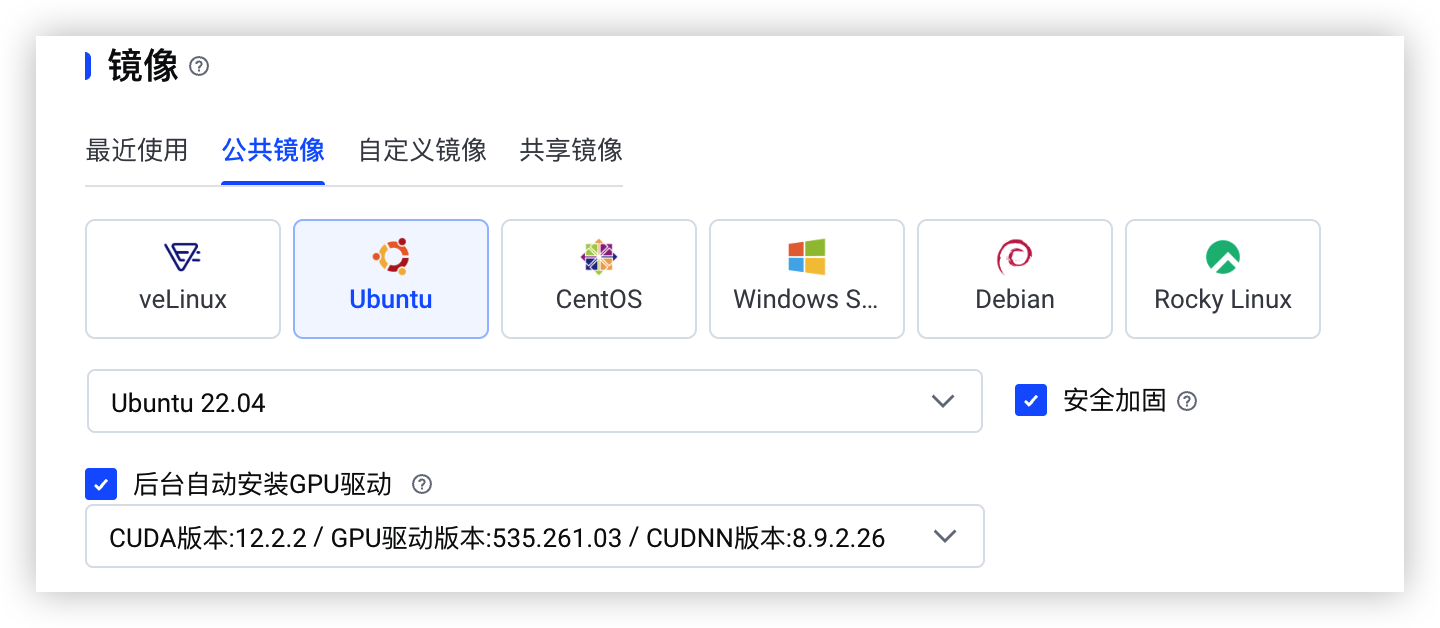
-
- 安装依赖的软件、工具。
- 登录目标实例。
- 执行如下命令,安装、配置Docker。
- sudo apt updatesudo apt install ca-certificates curl gnupg lsb-releasesudo mkdir -p /etc/apt/keyringscurl -fsSL https://mirrors.ivolces.com/docker/linux/ubuntu/gpg | sudo gpg --dearmor -o /etc/apt/keyrings/docker.gpgecho "deb [arch=$(dpkg --print-architecture) signed-by=/etc/apt/keyrings/docker.gpg] https://mirrors.ivolces.com/docker/linux/ubuntu $(lsb_release -cs) stable" | sudo tee /etc/apt/sources.list.d/docker.list > /dev/nullsudo apt updatesudo apt install docker-ce docker-ce-cli containerd.io docker-compose-plugin -y
- 执行如下命令,安装NVIDIA Container Toolkit。
- curl -s https://mirrors.ivolces.com/nvidia_all/ubuntu2204/x86_64/3bf863cc.pub | sudo apt-key add -cat <<EOF >/etc/apt/sources.list.d/nvidia.listdeb http://mirrors.ivolces.com/nvidia_all/ubuntu2204/x86_64/ /EOFapt updateapt install nvidia-container-toolkit -y
- 执行如下命令配置Docker,使容器可以使用实例的GPU资源。
- sudo nvidia-ctk runtime configure --runtime=dockersudo systemctl restart docker
- (可选)初始化本地盘。
- 若您选用的实例规格搭配有本地盘,建议您执行如下命令将本地盘挂载到存储模型的目录/data00,以提升模型加载速度。
- mkfs -t ext4 /dev/nvme0n1mount -t ext4 /dev/nvme0n1 /data00
说明
- 请将/dev/nvme0n1替换为实际本地盘名称。
- 请将ext4替换为您期望使用的文件系统。
步骤二:部署、运行模型
- 登录购买的2台GPU实例。了解更多。
- 分别在2台实例中执行如下命令,安装配置onion并下载GLM-5.2-FP8模型文件。
- 华北2(北京)华东2(上海)docker run --rm \-v /data00/:/data00 \--workdir /data00 \--entrypoint bash \ai-containers-cn-beijing.cr.volces.com/deeplearning/sglang:v0.5.13.post1.iaas.dev.202606172008 \-lc 'set -eif ! command -v oniond >/dev/null 2>&1; thenapt updateapt install -y ca-certificates curl gnupg gpgcurl -fsSL https://mirrors.ivolces.com/extra-tools/ubuntu/GPG-KEY-system | gpg --dearmor -o /etc/apt/trusted.gpg.d/volc-extra-tools.gpgecho "deb [arch=$(dpkg --print-architecture) signed-by=/etc/apt/trusted.gpg.d/volc-extra-tools.gpg] http://mirrors.ivolces.com/extra-tools/ubuntu noble main" > /etc/apt/sources.list.d/volctools.listapt updateapt install -y onion-ai-datafioniond download model GLM-5.2-FP8 --turbo --dir /data00'docker run --rm \-v /data00/:/data00 \--workdir /data00 \--entrypoint bash \ai-containers-cn-shanghai.cr.volces.com/deeplearning/sglang:v0.5.13.post1.iaas.dev.202606172008 \-lc 'set -eif ! command -v oniond >/dev/null 2>&1; thenapt updateapt install -y ca-certificates curl gnupg gpgcurl -fsSL https://mirrors.ivolces.com/extra-tools/ubuntu/GPG-KEY-system | gpg --dearmor -o /etc/apt/trusted.gpg.d/volc-extra-tools.gpgecho "deb [arch=$(dpkg --print-architecture) signed-by=/etc/apt/trusted.gpg.d/volc-extra-tools.gpg] http://mirrors.ivolces.com/extra-tools/ubuntu noble main" > /etc/apt/sources.list.d/volctools.listapt updateapt install -y onion-ai-datafioniond download model GLM-5.2-FP8 --turbo --dir /data00'
说明
您也可以执行oniond list model命令,查看支持模型列表。
- 请根据实例所在地域,分别在2台GPU实例中执行如下命令,下载Docker镜像。
- 华北2(北京)华东2(上海)docker pull ai-containers-cn-beijing.cr.volces.com/deeplearning/sglang:v0.5.13.post1.iaas.dev.202606172008docker pull ai-containers-cn-shanghai.cr.volces.com/deeplearning/sglang:v0.5.13.post1.iaas.dev.202606172008
- 请根据实例所在地域,分别在2台GPU实例中执行如下命令,启动Docker容器。
说明
- 请将命令中的/data00替换为模型实际存放的目录路径。
- 请将命令中的<rank0_private_ip>替换为Rank 0节点实例的私网IP地址。
- 请将命令中的<Port>替换为两台实例的模型服务连通端口号,可任意指定(例如20000)。
- 华北2(北京)
- Rank 0(Master 节点)Rank 1docker run \-d \--gpus all \--name sglang-glm52 \--net=host \--shm-size=100g \--ulimit memlock=-1 \--ulimit stack=67108864 \--privileged \--ipc=host \--security-opt seccomp=unconfined \--cap-add=ALL \-v /data00/:/data00/ \-v /var/run/nvidia-topologyd/:/var/run/nvidia-topologyd/ \-e GLOO_SOCKET_IFNAME=eth0 \-e MODEL_LENGTH=262144 \-e NCCL_MIN_NCHANNELS=24 \-e NCCL_IB_QPS_PER_CONNECTION=8 \-e CUDA_CACHE_MAXSIZE=2147483648 \-e SGLANG_ENABLE_SPEC_V2=1 \--entrypoint sglang \ai-containers-cn-beijing.cr.volces.com/deeplearning/sglang:v0.5.13.post1.iaas.dev.202606172008 \serve \--model-path /data00/GLM-5.2-FP8/ \--served-model-name glm-5.2 \--host 0.0.0.0 \--port 30300 \--trust-remote-code --tp 16 \--nnodes 2 \--node-rank 0 \--dist-init-addr "<rank0_private_ip>:<Port>" \--chunked-prefill-size 32768 \--enable-metrics --enable-cache-report --show-time-cost --reasoning-parser glm45 \--tool-call-parser glm47 \--speculative-algorithm EAGLE \--speculative-num-steps 3 \--speculative-eagle-topk 1 \--speculative-num-draft-tokens 4 \--cuda-graph-max-bs 8 \--mem-fraction-static 0.82 \--enable-metrics-for-all-schedulers docker run \-d \--gpus all \--name sglang-glm52 \--net=host \--shm-size=100g \--ulimit memlock=-1 \--ulimit stack=67108864 \--privileged \--ipc=host \--security-opt seccomp=unconfined \--cap-add=ALL \-v /data00/:/data00/ \-v /var/run/nvidia-topologyd/:/var/run/nvidia-topologyd/ \-e GLOO_SOCKET_IFNAME=eth0 \-e MODEL_LENGTH=262144 \-e NCCL_MIN_NCHANNELS=24 \-e NCCL_IB_QPS_PER_CONNECTION=8 \-e CUDA_CACHE_MAXSIZE=2147483648 \-e SGLANG_ENABLE_SPEC_V2=1 \--entrypoint sglang \ai-containers-cn-beijing.cr.volces.com/deeplearning/sglang:v0.5.13.post1.iaas.dev.202606172008 \serve \--model-path /data00/GLM-5.2-FP8/ \--served-model-name glm-5.2 \--host 0.0.0.0 \--port 30300 \--trust-remote-code --tp 16 \--nnodes 2 \--node-rank 1 \--dist-init-addr "<rank0_private_ip>:<Port>" \--chunked-prefill-size 32768 \--enable-metrics --enable-cache-report --show-time-cost --reasoning-parser glm45 \--tool-call-parser glm47 \--speculative-algorithm EAGLE \--speculative-num-steps 3 \--speculative-eagle-topk 1 \--speculative-num-draft-tokens 4 \--cuda-graph-max-bs 8 \--mem-fraction-static 0.82 \--enable-metrics-for-all-schedulers
- 华东2(上海)
- Rank 0(Master)Rank 1docker run \-d \--gpus all \--name sglang-glm52 \--net=host \--shm-size=100g \--ulimit memlock=-1 \--ulimit stack=67108864 \--privileged \--ipc=host \--security-opt seccomp=unconfined \--cap-add=ALL \-v /data00/:/data00/ \-v /var/run/nvidia-topologyd/:/var/run/nvidia-topologyd/ \-e GLOO_SOCKET_IFNAME=eth0 \-e MODEL_LENGTH=262144 \-e NCCL_MIN_NCHANNELS=24 \-e NCCL_IB_QPS_PER_CONNECTION=8 \-e CUDA_CACHE_MAXSIZE=2147483648 \-e SGLANG_ENABLE_SPEC_V2=1 \--entrypoint sglang \ai-containers-cn-shanghai.cr.volces.com/deeplearning/sglang:v0.5.13.post1.iaas.dev.202606172008 \serve \--model-path /data00/GLM-5.2-FP8/ \--served-model-name glm-5.2 \--host 0.0.0.0 \--port 30300 \--trust-remote-code --tp 16 \--nnodes 2 \--node-rank 0 \--dist-init-addr "<rank0_private_ip>:<Port>" \--chunked-prefill-size 32768 \--enable-metrics --enable-cache-report --show-time-cost --reasoning-parser glm45 \--tool-call-parser glm47 \--speculative-algorithm EAGLE \--speculative-num-steps 3 \--speculative-eagle-topk 1 \--speculative-num-draft-tokens 4 \--cuda-graph-max-bs 8 \--mem-fraction-static 0.82 \--enable-metrics-for-all-schedulers docker run \-d \--gpus all \--name sglang-glm52 \--net=host \--shm-size=100g \--ulimit memlock=-1 \--ulimit stack=67108864 \--privileged \--ipc=host \--security-opt seccomp=unconfined \--cap-add=ALL \-v /data00/:/data00/ \-v /var/run/nvidia-topologyd/:/var/run/nvidia-topologyd/ \-e GLOO_SOCKET_IFNAME=eth0 \-e MODEL_LENGTH=262144 \-e NCCL_MIN_NCHANNELS=24 \-e NCCL_IB_QPS_PER_CONNECTION=8 \-e CUDA_CACHE_MAXSIZE=2147483648 \-e SGLANG_ENABLE_SPEC_V2=1 \--entrypoint sglang \ai-containers-cn-shanghai.cr.volces.com/deeplearning/sglang:v0.5.13.post1.iaas.dev.202606172008 \serve \--model-path /data00/GLM-5.2-FP8/ \--served-model-name glm-5.2 \--host 0.0.0.0 \--port 30300 \--trust-remote-code --tp 16 \--nnodes 2 \--node-rank 1 \--dist-init-addr "<rank0_private_ip>:<Port>" \--chunked-prefill-size 32768 \--enable-metrics --enable-cache-report --show-time-cost --reasoning-parser glm45 \--tool-call-parser glm47 \--speculative-algorithm EAGLE \--speculative-num-steps 3 \--speculative-eagle-topk 1 \--speculative-num-draft-tokens 4 \--cuda-graph-max-bs 8 \--mem-fraction-static 0.82 \--enable-metrics-for-all-schedulers
- 参数说明
- 如上命令以部署、启动GLM-5.2模型为例,如需部署、启动其他模型,可根据下表说明替换对应环境变量和参数值。
- 参数名称参数类型说明取值示例参数名称参数类型说明取值示例sglang serve启动指令命令入口,表示通过SGLang CLI启动模型服务端。---model-path路径 / 模型 ID指定加载的LLM模型,支持:
- Hugging Face模型ID
- 本地模型路径
/data/models/GLM-5.2-FP8--tp整数配置张量并行度(Tensor Parallelism)。16--hostIP 地址指定服务绑定的主机地址。0.0.0.0--port整数指定服务监听端口,用于客户端连接。30300--dist-init-addrIP:端口 / DNS:端口分布式集群初始化地址,用于多节点通信同步。必须配置为Rank 0节点的私网IP或Service DNS,且所有节点需保持一致127.0.0:20000--nnodes整数指定分布式集群总节点数。2--node-rank整数指定当前节点在集群中的序号,从 0 开始。Rank 0:0Rank 1:1--chunked-prefill-size整数控制长上下文预填充的分块粒度,单位为Token。32768--mem-fraction-static浮点数分配给模型权重的静态显存占比,剩余显存留作运行时计算空间。0.82--cuda-graph-max-bs整数限制CUDA图捕获/重放的最大批量大小,降低显存峰值压力。8
步骤三:调用模型
- 执行如下命令,进入Docker容器。
说明
请将命令中的<CONTAINER_ID>替换为实际容器ID。
- docker exec -it <CONTAINER_ID> bash
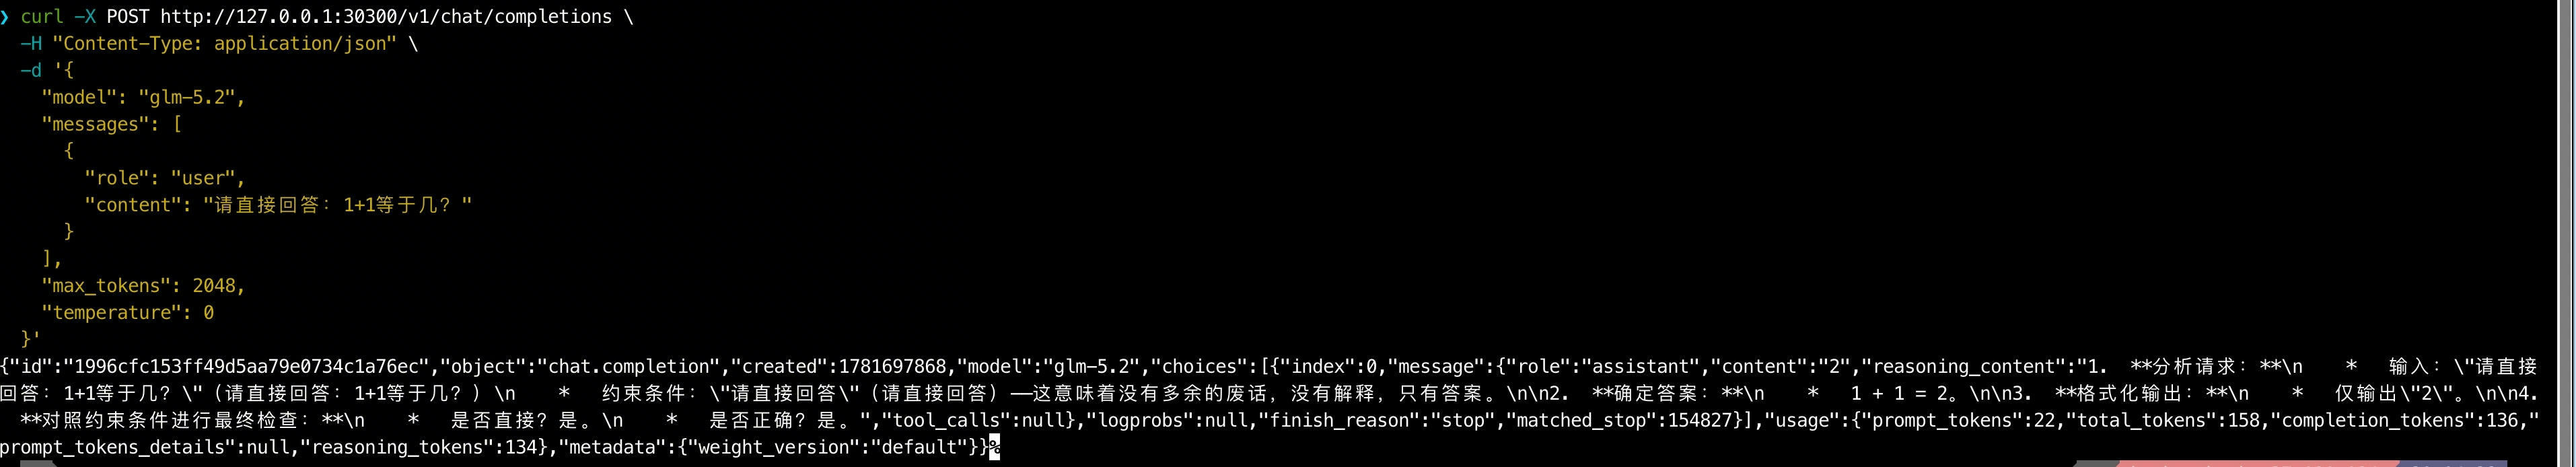
- 在容器中执行如下命令调用模型,确保部署的模型可以正常进行推理。
- curl -X POST http://127.0.0.1:30300/v1/chat/completions -H "Content-Type: application/json" -d '{"model": "glm-5.2","messages": [{"role": "user","content": "请直接回答:1+1等于几?"}],"max_tokens": 2048,"temperature": 0}'
- 若展示如下信息,则服务正常运行。
-
- 参数说明
- 本文仅说明验证使用到的参数信息。
- 参数名说明取值样例参数名说明取值样例model使用的实际模型。glm-5.2messages对话的消息列表。
- role:该消息的发起角色。
- content:消息的内容。
-max_tokens指定一次请求中模型生成Completion的最大Token数。取值:- 介于1 到 8192 间的整数。
- 默认值为 4096。
500temperature采样温度。- 取值范围:介于 0 ~ 2 之间。
- 值越高(例如1)会使输出更随机。
- 值越低(例如0.2)会使输出更加集中和确定。
0.7
最近更新时间:2026.06.23 16:25:17
这个页面对您有帮助吗?
有用
有用
无用
无用