GPU云服务器
GPU云服务器
GPU云服务器


文档指南
请输入


GPU云服务器
图说GPU云服务器
用户指南
安装NVIDIA驱动
安装NVIDIA GRID驱动
安装veCCL
最佳实践
AIGC实践
DeepSeek系列模型
搭建应用
性能测试/调优
故障处理
- 文档首页
 GPU云服务器GPU云服务器最佳实践AIGC实践HPC-VeRL Code Sandbox最佳实践
 复制全文
 下载 pdf
HPC-VeRL Code Sandbox最佳实践
 文档反馈
 问问助手
本文介绍VeRL Code Sandbox在构建高效且安全的代码生成强化学习环境方面的最佳实践方法。
背景信息
在Deepseek-R1模型之后,基于强化学习的代码生成取得了显著进步,模型能通过与代码执行环境互动实现学习和改进。但直接运行大语言模型(LLM)生成的代码存在安全隐患,因为这些代码可能包含恶意或不稳定指令,会威胁宿主系统。为解决此问题,Coding Sandbox技术应运而生,它为代码执行营造安全、隔离的环境,避免潜在危害,保证实验的可控性和可重复性。该技术不仅保障了底层系统安全,还为评估和提升模型的代码生成能力提供了可靠平台,例如在经典的Livecodebench/HumanEval这类代码能力测试基准场景中发挥作用。
在强化学习(RL)训练流程中的Rollout阶段,为收集经验,需大规模并行执行生成的代码片段。veFaaS Coding Sandbox的设计充分考虑了高并发需求,具备支持百万核超低延迟(150毫秒)的弹性伸缩能力,实现了高效的Rollout并发。这种弹性能力使得系统可以根据训练负载状况,动态地调整沙箱数量,对于加速RL训练进程、提升GPU利用率和整体训练的吞吐量有较大价值。
本文使用的训练框架是veRL(Volcano Engine Reinforcement Learning for LLMs),是云平台针对大语言模型(LLMs)的强化学习框架。它不仅具备灵活、高效且可扩展的强化学习训练,还提供了名为“HybridEngine”的框架,该框架将控制流(在单进程中运行)与计算流(在分布式多进程中运行)分离,并且可以支持多种计算后端、训练与推理并行策略和性能优化技术。
步骤一:在veFaaS上创建SandboxFusion沙箱服务
SandboxFusion是一款开源的基于HTTP协议的代码沙盒服务,支持运行23种编程语言,拥有namespace&cgroup轻隔离能力,支持部署在多样化设备上。
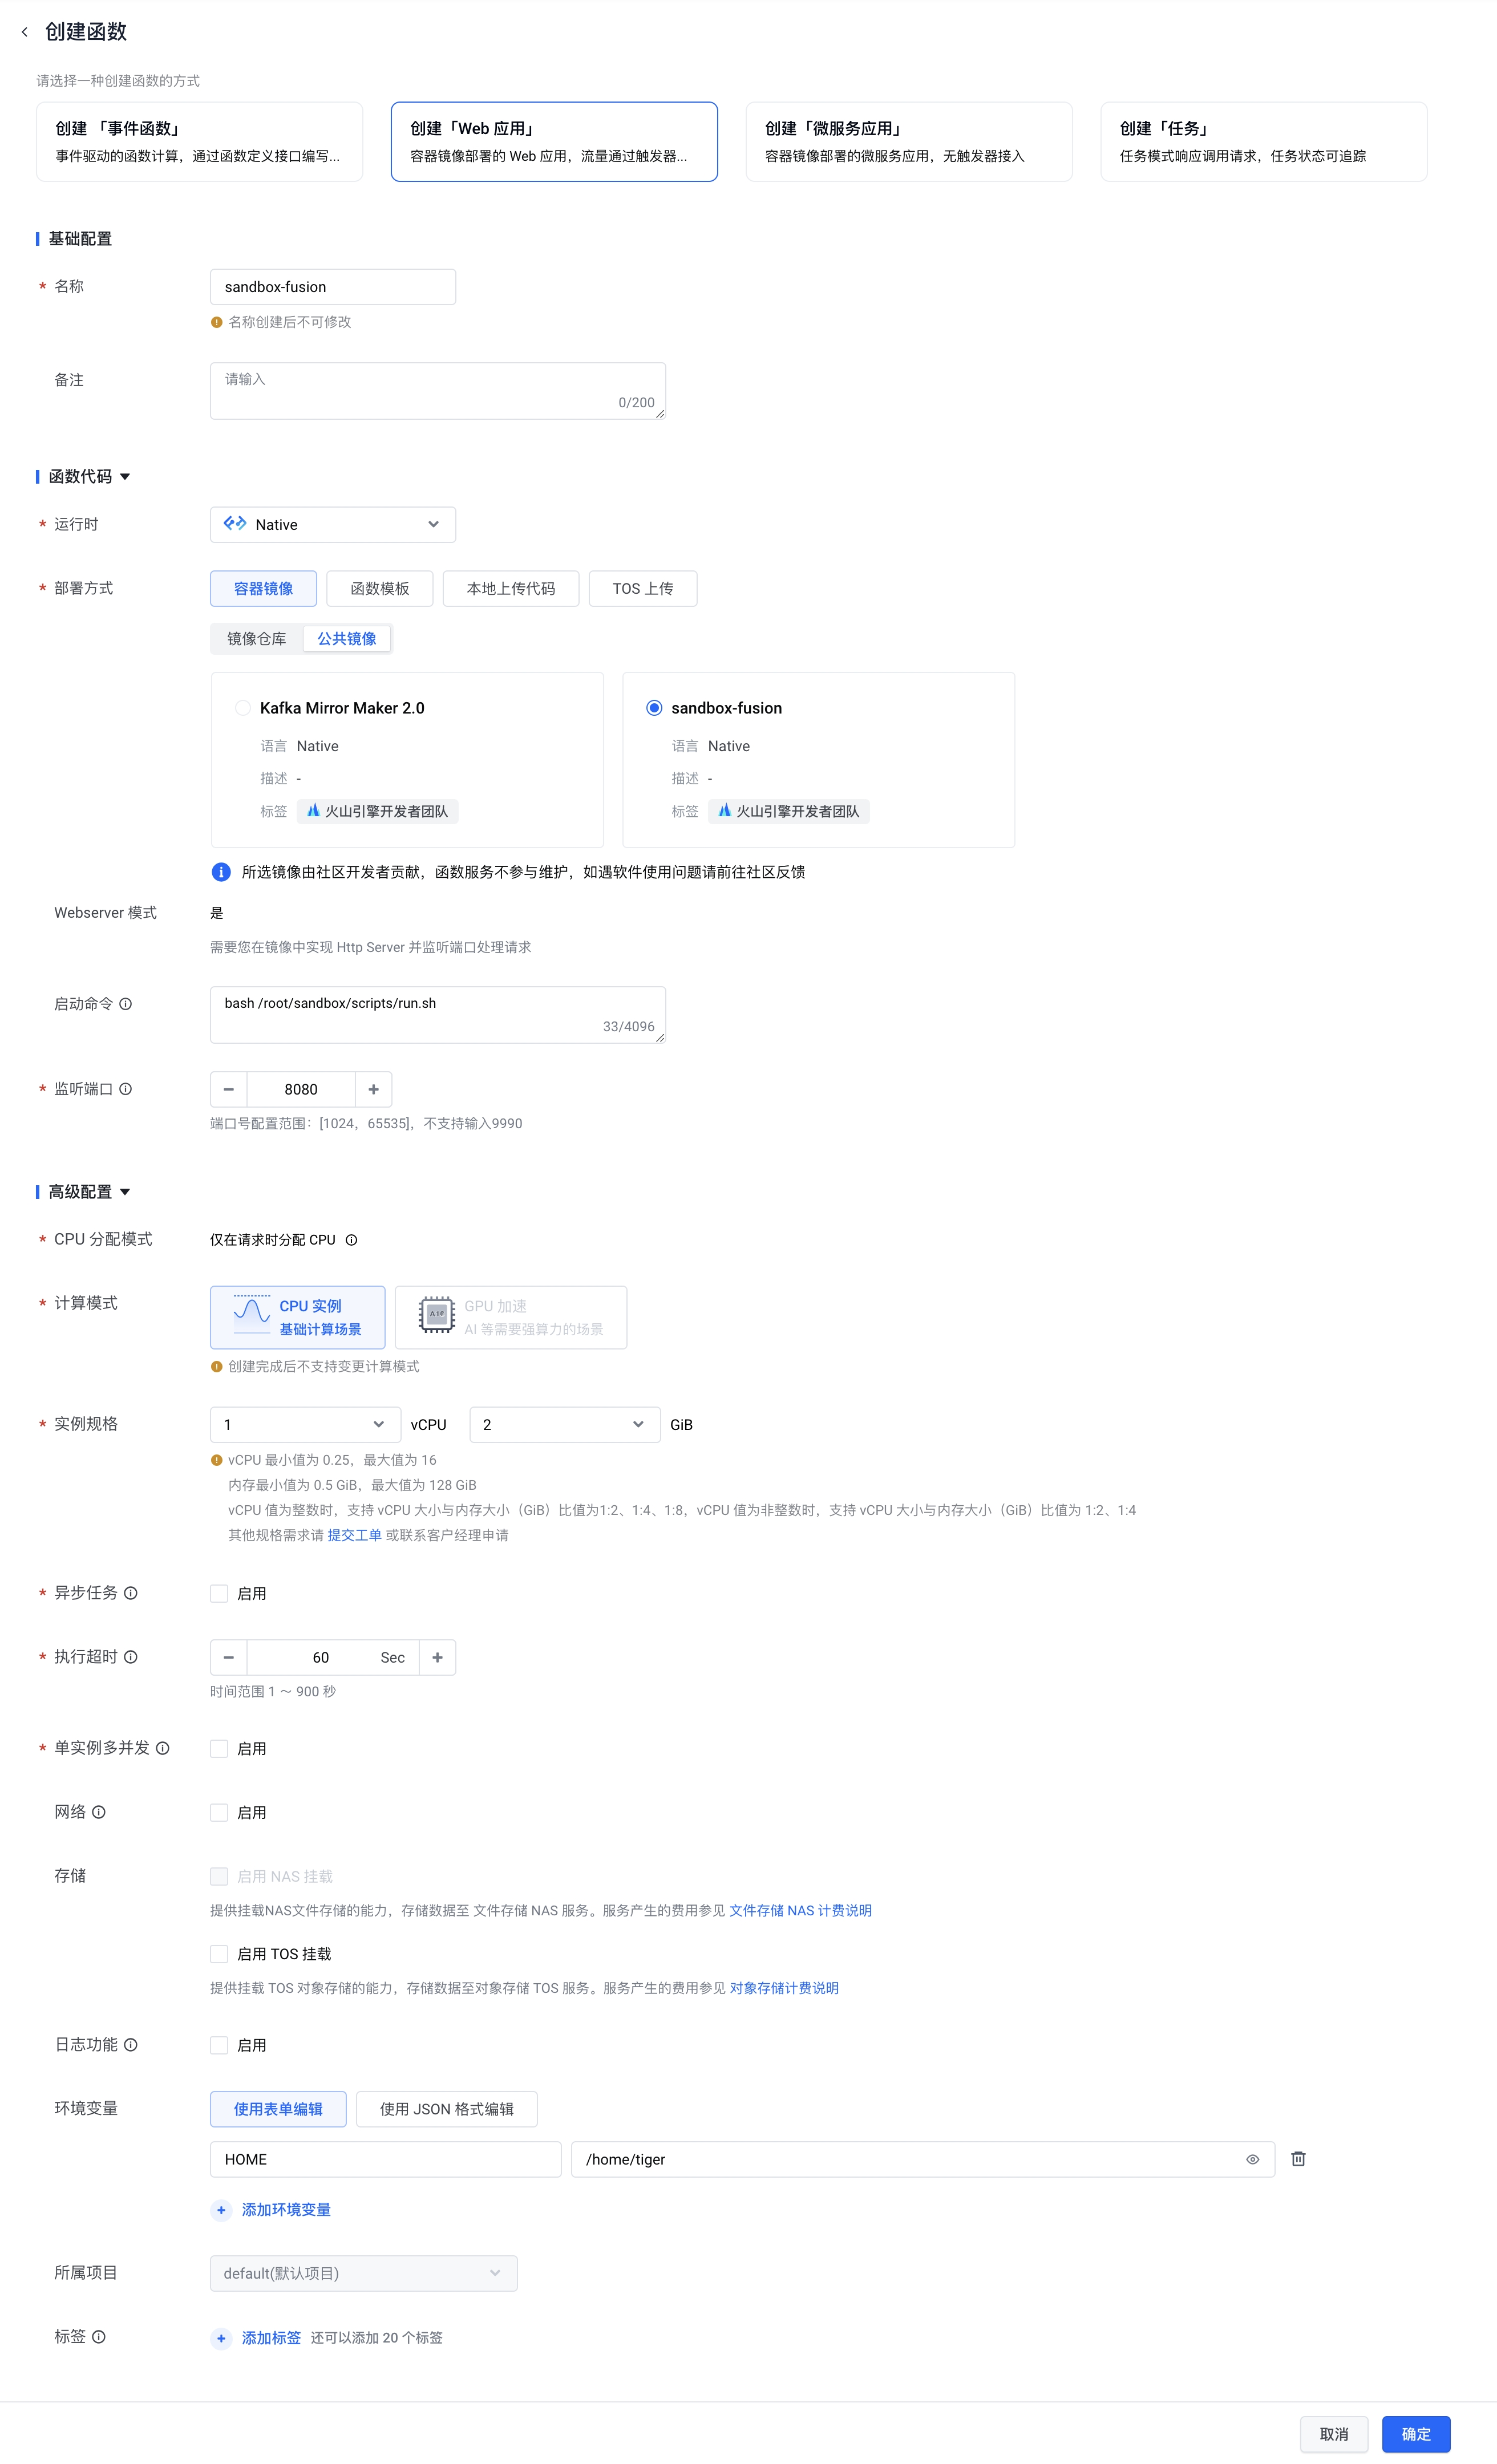
- 参考创建Web应用,在函数服务控制台创建函数。具体配置如下:
- 业务所在地域:华北2(北京)
- 创建函数的方式:创建「Web应用」
- 函数代码:
- 运行时:Native
- 部署方式:容器镜像 -> 公共镜像 -> sandbox-fusion
- 启动命令:bash /root/sandbox/scripts/run.sh
- 监听端口:8080
- 高级配置:
- 实例规格:1vCPU 2GiB
- 执行超时:60sec
- 单实例多并发:不启用(为了一次请求独占一个Sandbox,防止雪崩)
- 环境变量:使用表单编辑 -> HOME:/home/tiger
-
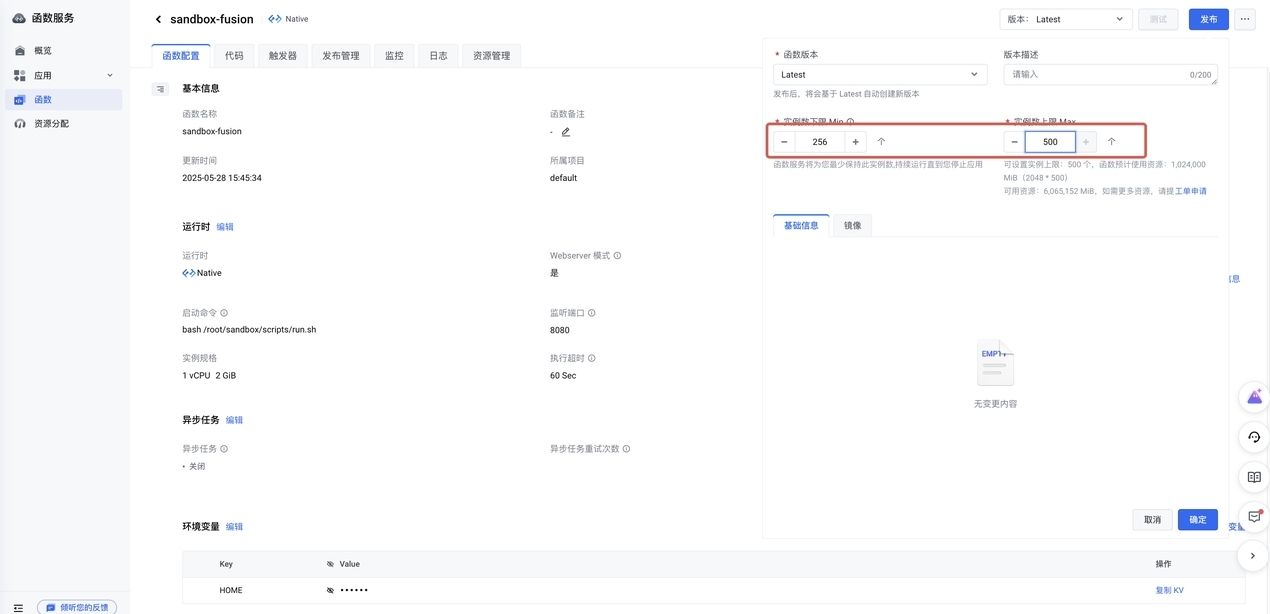
- 发布函数。单击“发布”按钮,为提升并发水平,可选择256-500个实例数量(这里的实例数量可根据后续VeRL训练设置进行灵活适配调整),确认发布。
-
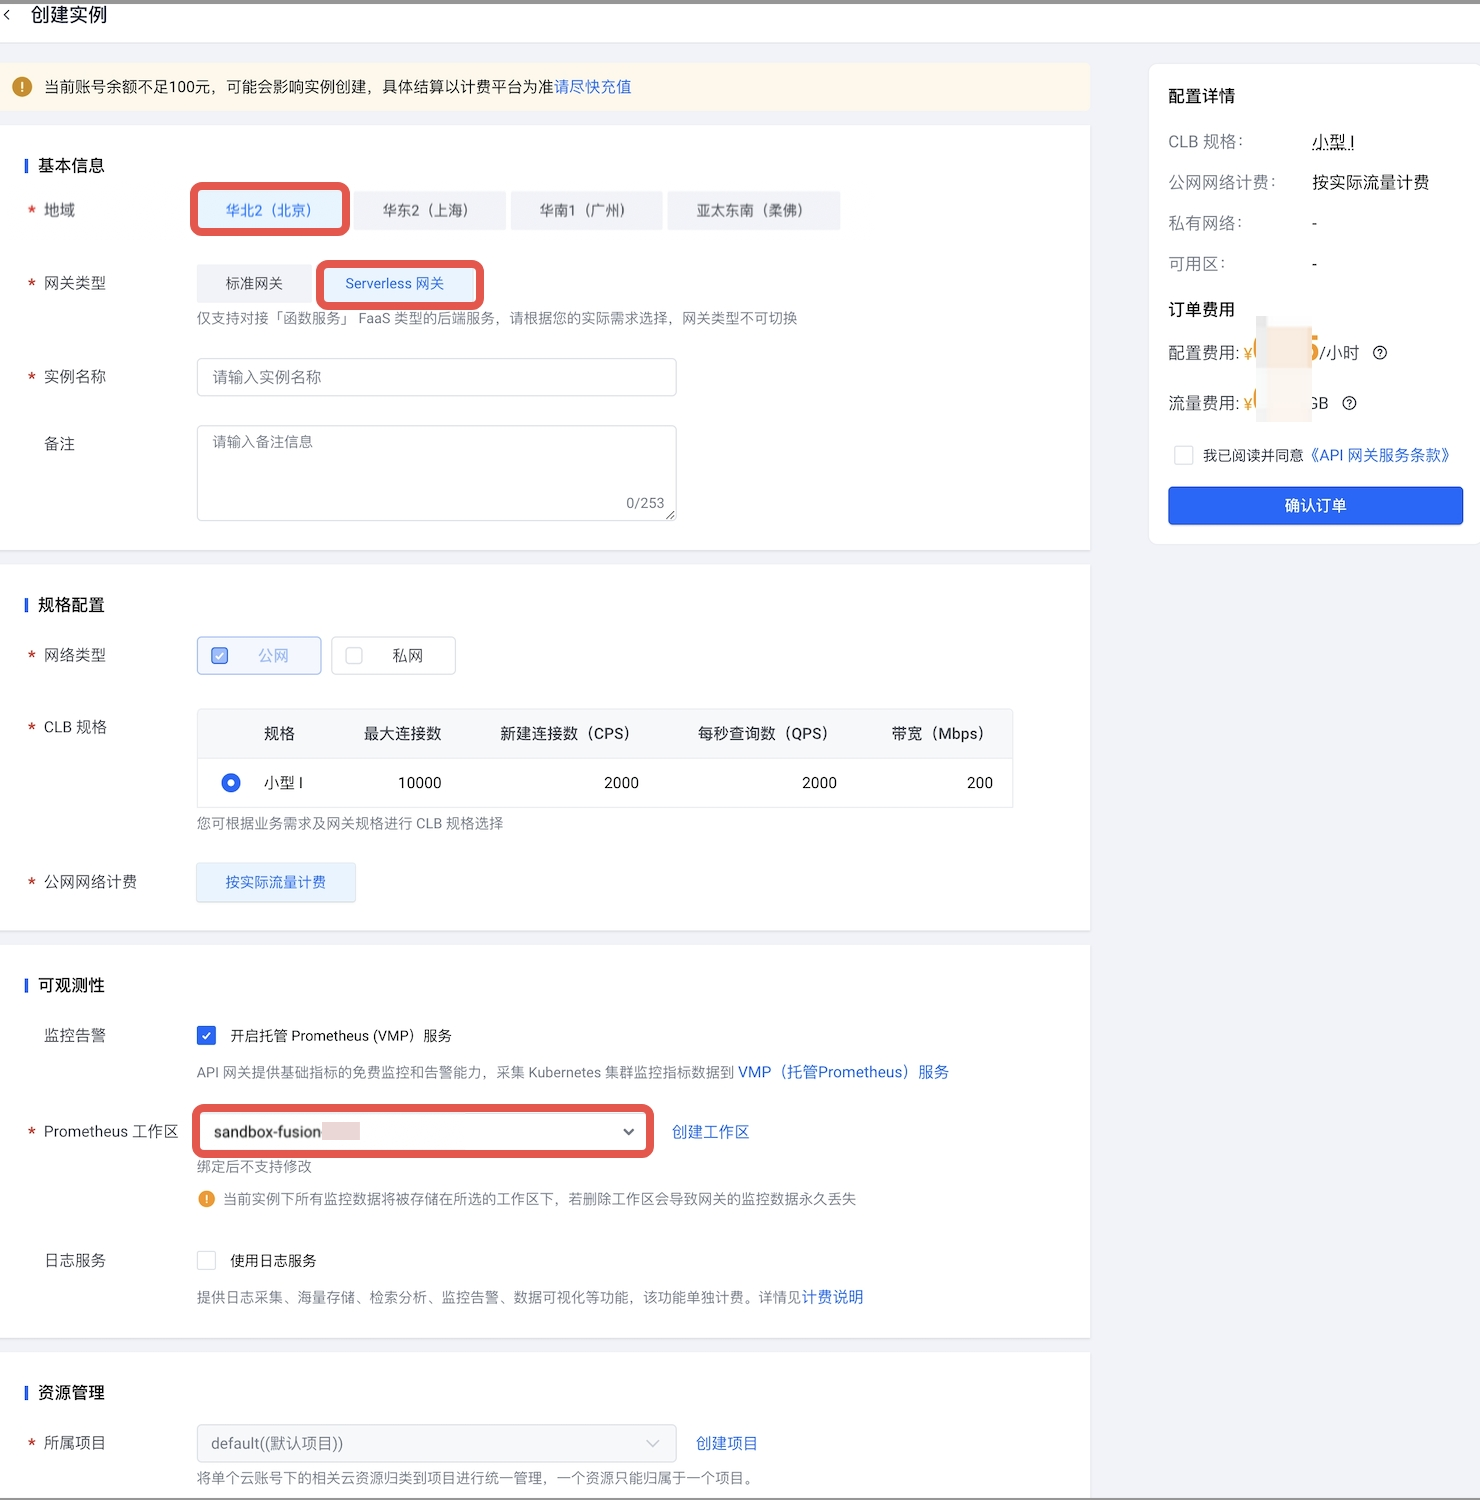
- 创建API网关实例,具体配置如下:
- 地域:选择华北2(北京)
- 网关类型:选择Serverless网关
- Prometheus 工作区:可作监控,选择自己的工作区即可,不需要的话可以不开启服务
-
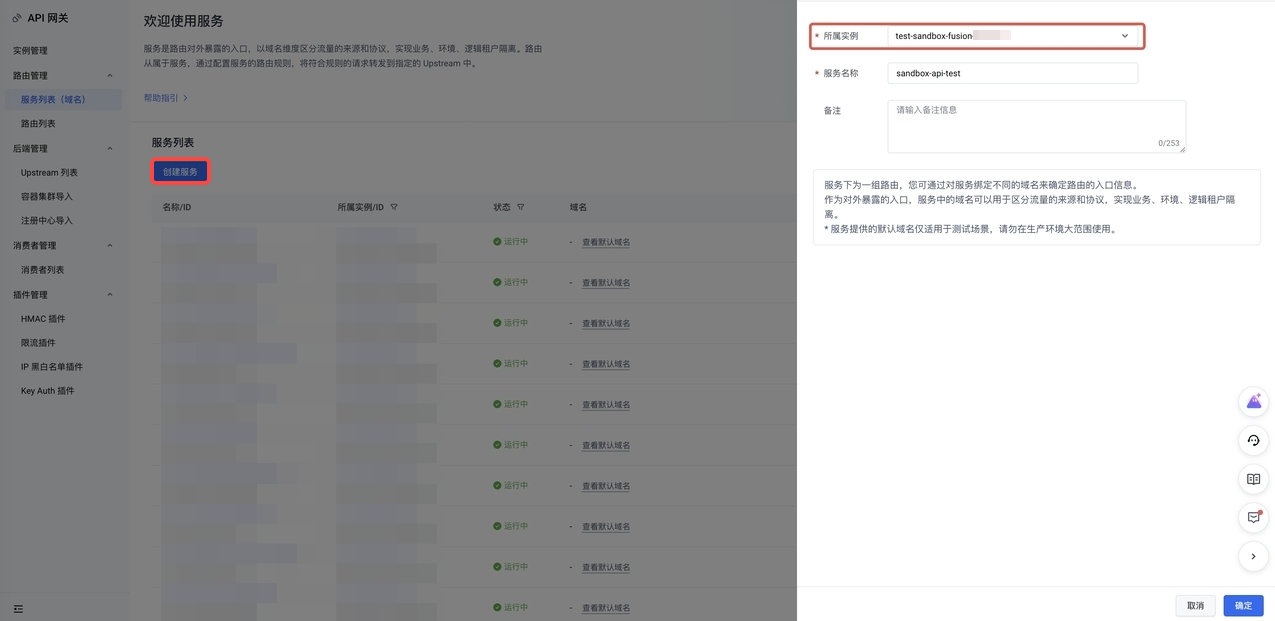
- 创建API网关服务(域名),关联第3步中创建的API网关实例。
-
- 网关实例:选择已创建的API网关实例
- 网关服务:选择已创建的API网关服务
- 跨域开关:开启
-
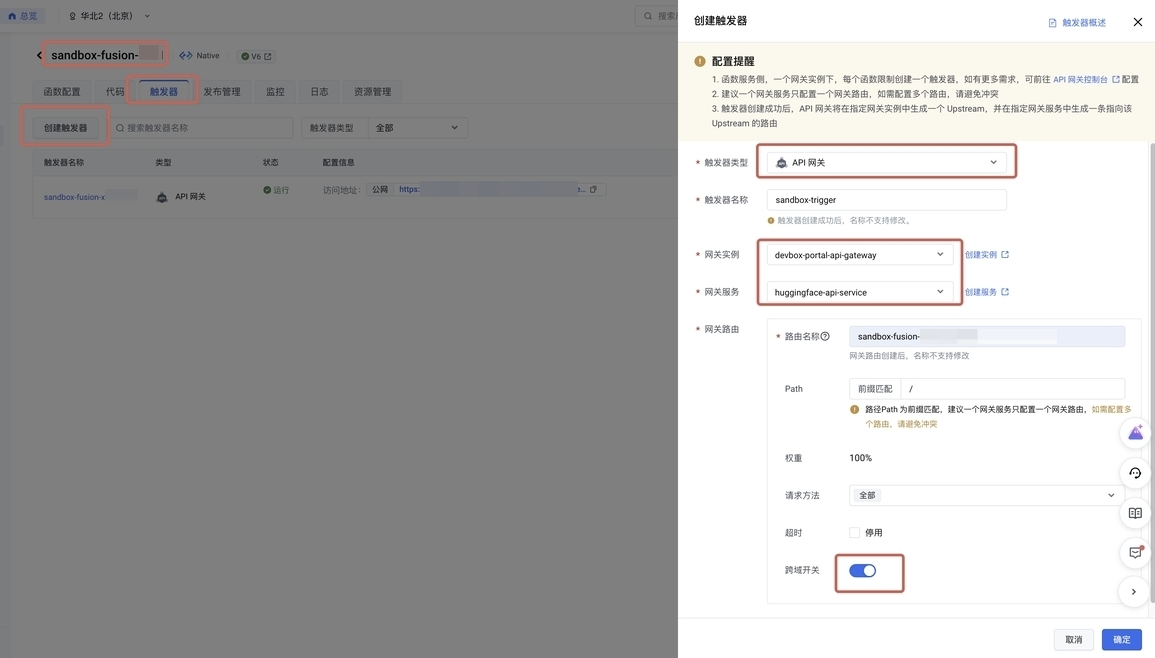
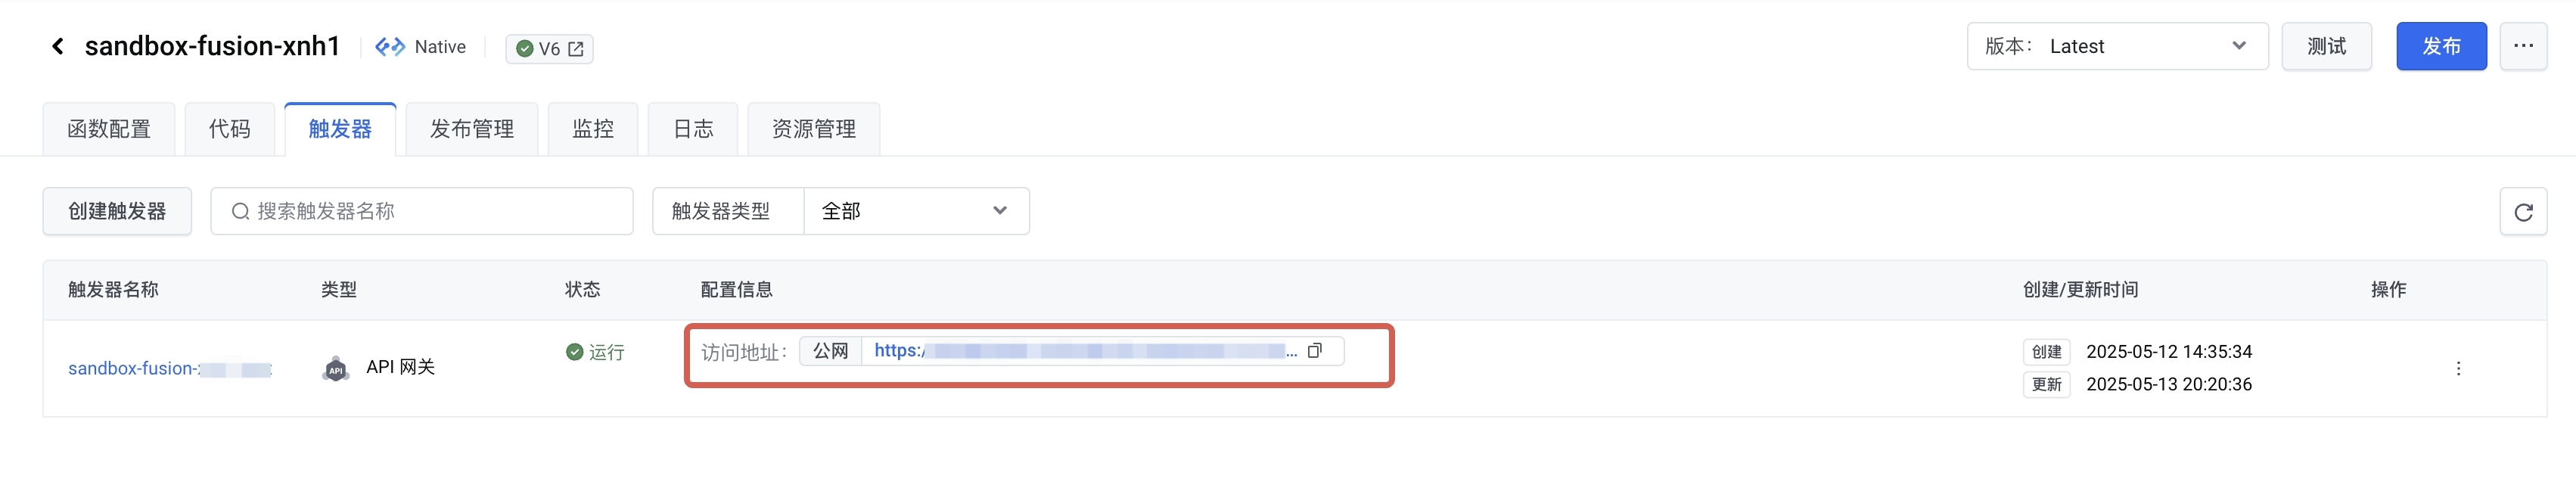
- API网关触发器创建成功后,获取触发器的 公网访问 地址,以备后续使用。
-
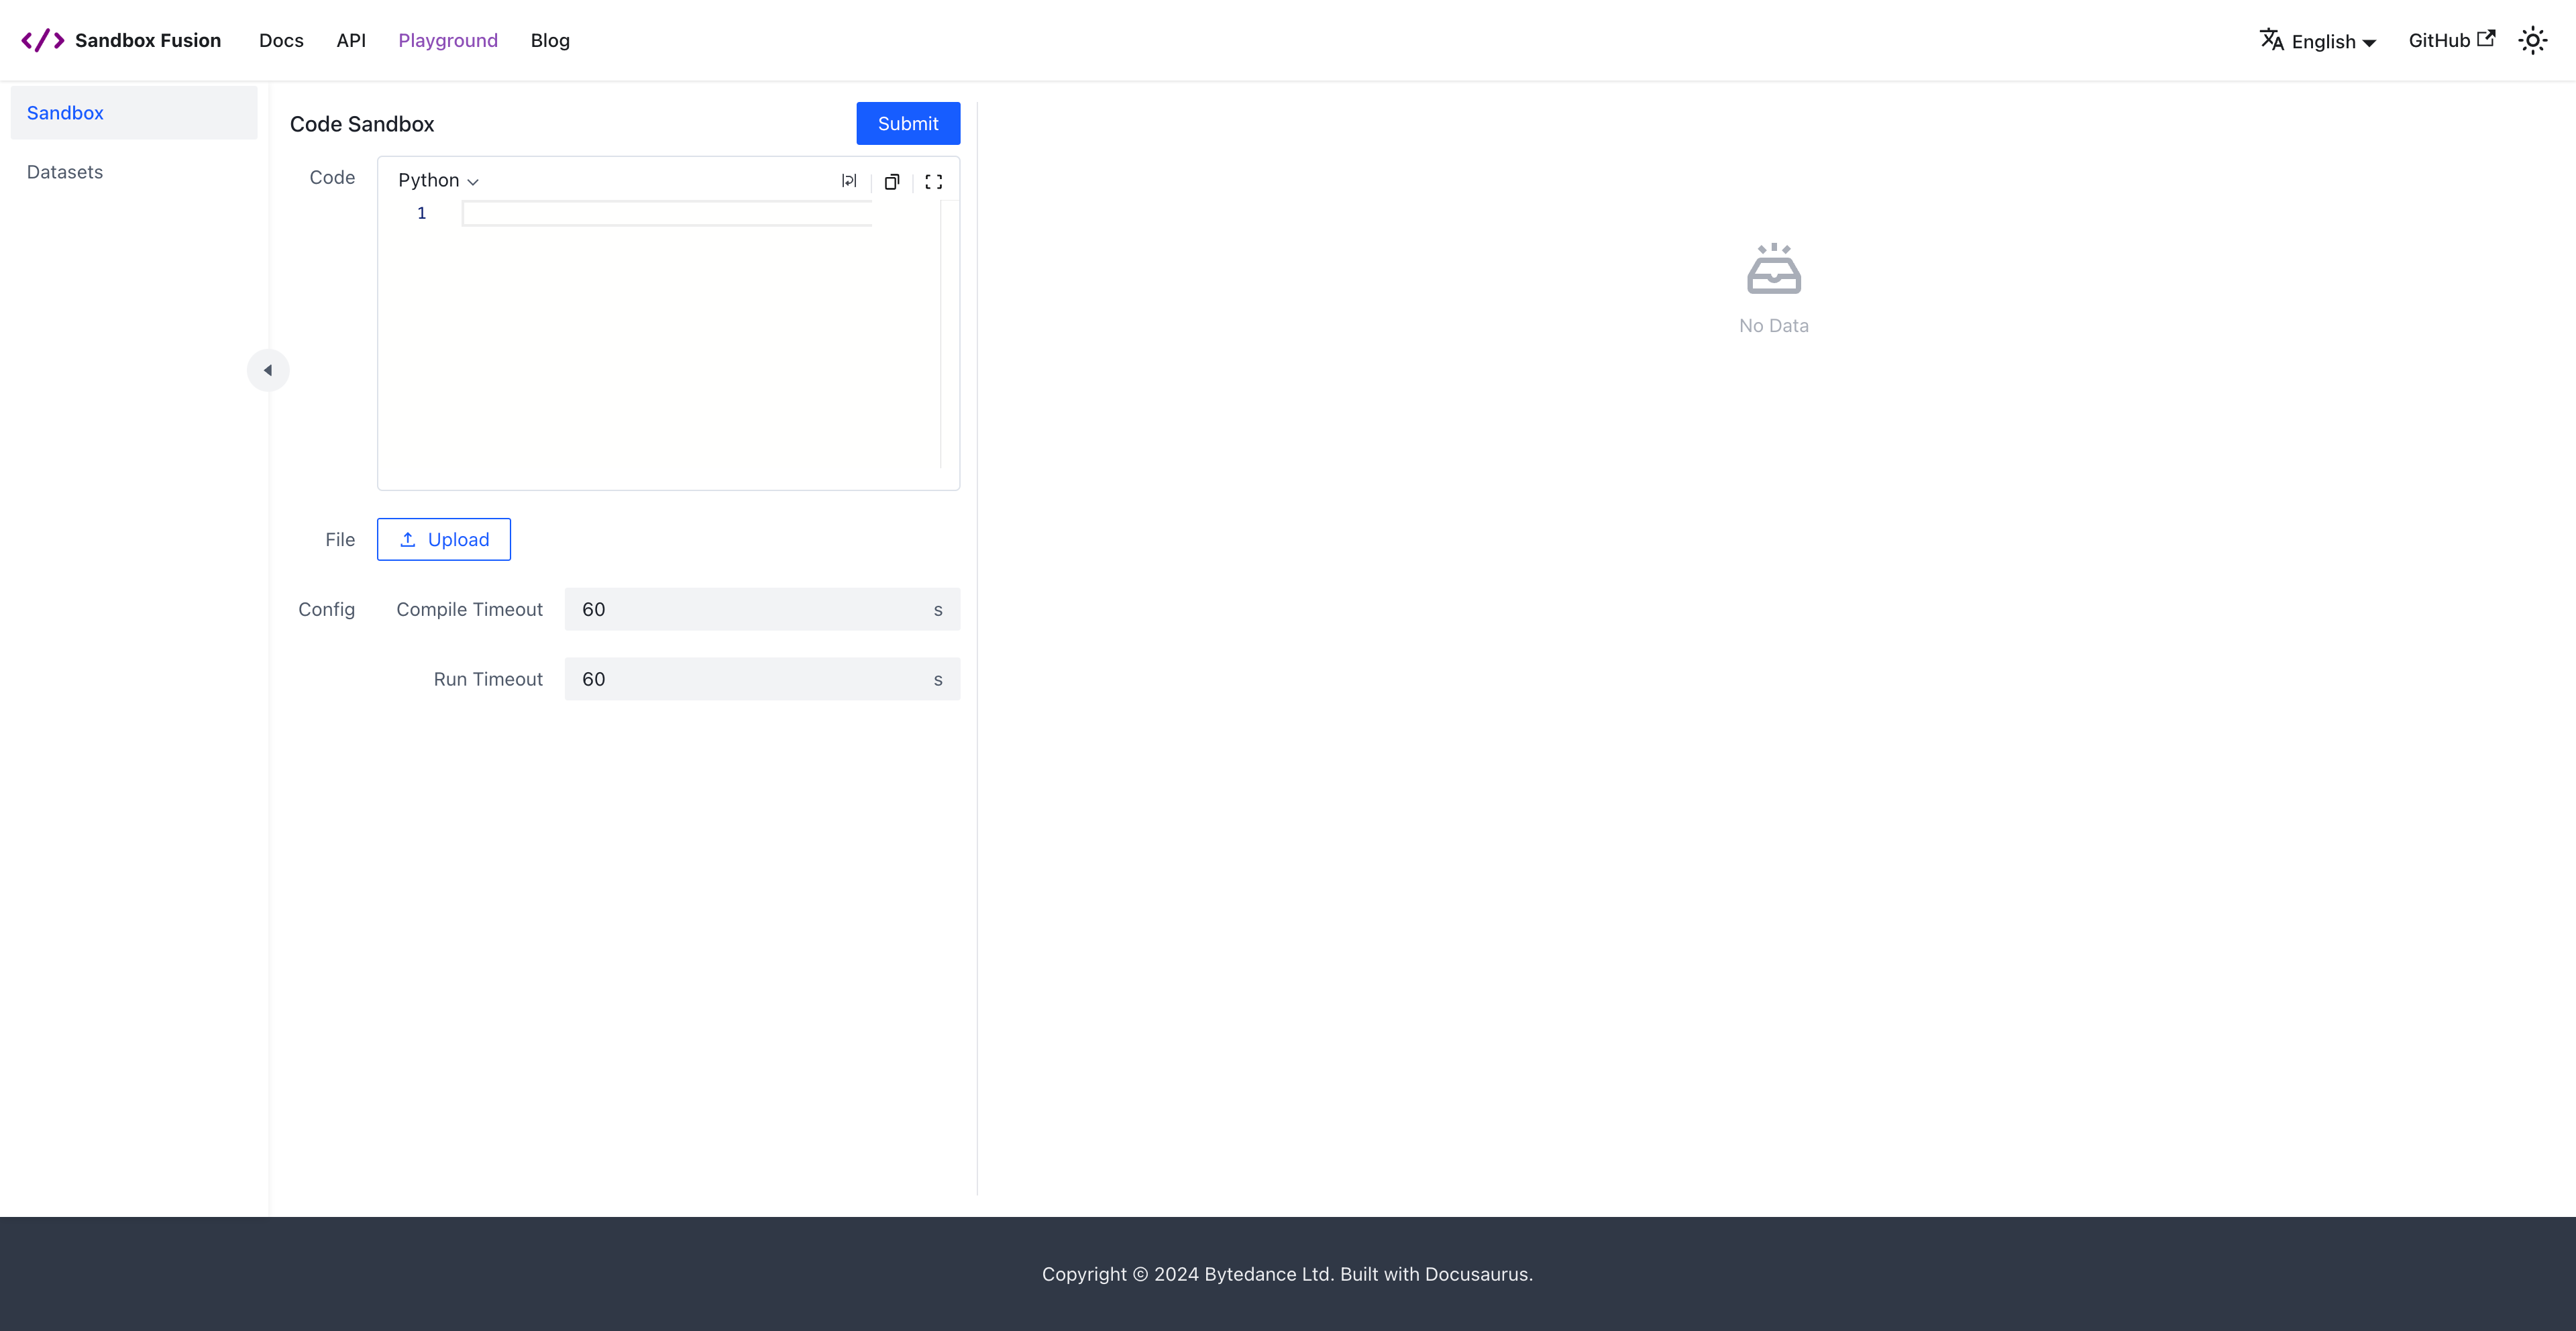
- 直接单击访问链接即可进入Playground Sandbox,开启Code Sandbox的前端代码编辑界面。
-
步骤二:使用创建的Sandbox连接VeRL训练
- 参考通过向导购买实例,创建高性能计算GPU实例。具体配置如下:
- 计算规格:ecs.hpcpni3ln.45xlarge
- 镜像:Ubuntu 22.04 with GPU Driver 535.161.08 and doca 64 bit
- 已绑定公网IP
- 登录实例。
- 进行环境搭建和模型下载。包括镜像拉取,容器创建,下载数据集Eurus-2-RL-Data(这里仅使用其中的coding数据)与预训练模型Qwen2.5-7B-Instruct-1M 。
- 执行vim install.sh命令,创建脚本文件。
- 将以下代码复制到install.sh文件中。
- #!/bin/bash# 颜色定义RED='\033[0;31m'GREEN='\033[0;32m'YELLOW='\033[0;33m'NC='\033[0m' # No Color# 错误处理函数handle_error() {echo -e "${RED}错误: 步骤 $1 失败!${NC}"exit 1}echo -e "${GREEN}===== 开始一键搭建 VeRL code Sandbox 环境&下载预训练模型和数据集 ====${NC}"# 步骤1: 拉取镜像并创建容器echo -e "${YELLOW}步骤1: 拉取镜像并创建容器...${NC}"docker run -d -itd --entrypoint /bin/bash --memory="1000g" --shm-size="256g" --privileged --runtime=nvidia --gpus all --network host --name verl_code_sandbox --cap-add=SYS_ADMIN --user=root -v /var/run/nvidia-topologyd/:/var/run/nvidia-topologyd/ -e VLLM_HOST_IP=$(hostname -I | awk '{print $1}') -e NCCL_DEBUG=INFO -e GLOO_SOCKET_IFNAME=eth0 -e CUDA_VISIBLE_DEVICES=0,1,2,3,4,5,6,7 -e NCCL_MIN_NCHANNELS=24 -e NCCL_IB_QPS_PER_CONNECTION=8 -e SWANLAB_API_KEY=<you_swanlab_api_key> iaas-gpu-cn-beijing.cr.volces.com/gpu-images/verl:torch2.6.0-cu129-vllm0.8.3-ray2.46-demo-v4 -c bash || handle_error "1"echo -e "${GREEN}步骤1完成: 容器已创建${NC}"# 步骤2: 在容器内创建数据目录echo -e "${YELLOW}步骤2: 在容器内创建数据目录...${NC}"docker exec -it verl_code_sandbox mkdir -p /data1/llm /data1/datasets || handle_error "2"echo -e "${GREEN}步骤2完成: 数据目录已创建${NC}"# 步骤3: 下载预训练模型和数据集echo -e "${YELLOW}步骤3: 下载预训练模型和数据集(这可能需要一些时间)...${NC}"docker exec -it verl_code_sandbox bash -c "export BUCKET=ai-infra && cd /data1/llm && oniond download model Qwen2.5-7B-Instruct-1M" || handle_error "4a"docker exec -it verl_code_sandbox bash -c "export BUCKET=ai-infra && cd /data1/datasets && oniond download dataset Eurus-2-RL-Data" || handle_error "4b"echo -e "${GREEN}步骤3完成: 模型和数据集下载完毕${NC}"# 环境搭建完成echo -e "${GREEN}===== VeRL code Sandbox 就绪 ====${NC}"echo -e "${YELLOW}提示: 您可以使用 'docker exec -it verl_code_sandbox bash' 命令进入容器${NC}"
其中:
- --name verl_code_sandbox 容器名称,请按需命名。
- SWANLAB_API_KEY请替换为自己的swanlab api key,方便后续观察训练过程的各种指标与log。如无账号可跟随SwanLab官网进行注册。
- CUDA_VISIBLE_DEVICES等和实例规格相关的参数,请根据实际的服务器情况进行配置。
- 按Esc退出编辑模式,输入:wq并按Enter键,保存并退出文件。
- 执行以下命令,赋予脚本可执行权限并运行脚本。
- chmod +x install.sh./install.sh
- 执行以下命令,进入容器内的VeRL中。
- docker exec -it verl_code_sandbox /bin/bashcd /root/verl
- 测试Sandbox的连通性。执行两个小的连通性测试,用于测试VeRL和步骤一中部署的Sandbox连接是否成功。
- 执行vim scripts/test_sandbox.sh命令,打开测试文件。
- 按i进入编辑模式,更改SANDBOX_FUSION_URL为步骤一中获取到的触发器的 公网访问 地址+/run_code。
- #!/bin/bash# 向环境变量中注入sandbox-url,来自于前面创建的 faas 的 Sandbox 触发器公网地址echo "正在设置环境变量 SANDBOX_FUSION_URL..."export SANDBOX_FUSION_URL="https://xxxxxxxxx.apigateway-cn-beijing.volceapi.com/run_code"echo "环境变量设置完成: SANDBOX_FUSION_URL=$SANDBOX_FUSION_URL"# 对连接进行测试echo "开始执行第一个测试..."pytest tests/sandbox/test_sandbox.pytest1_status=$?echo "第一个测试执行完毕,状态码: $test1_status"echo "开始执行第二个测试..."pytest tests/reward_score/test_sandbox_fusion.pytest2_status=$?echo "第二个测试执行完毕,状态码: $test2_status"# 输出整体执行结果echo "===== 执行结果 ====="echo "环境变量设置: 成功"echo "测试 1 状态: $([ $test1_status -eq 0 ] && echo "成功" || echo "失败")"echo "测试 2 状态: $([ $test2_status -eq 0 ] && echo "成功" || echo "失败")"# 返回总体状态码(如果任一测试失败,则返回非零状态码)exit $((test1_status || test2_status))
- 按Esc退出编辑模式,输入:wq并按Enter键,保存并退出文件。
- 执行以下命令,赋予脚本可执行权限并运行脚本。
- chmod +x scripts/test_sandbox.sh./scripts/test_sandbox.sh
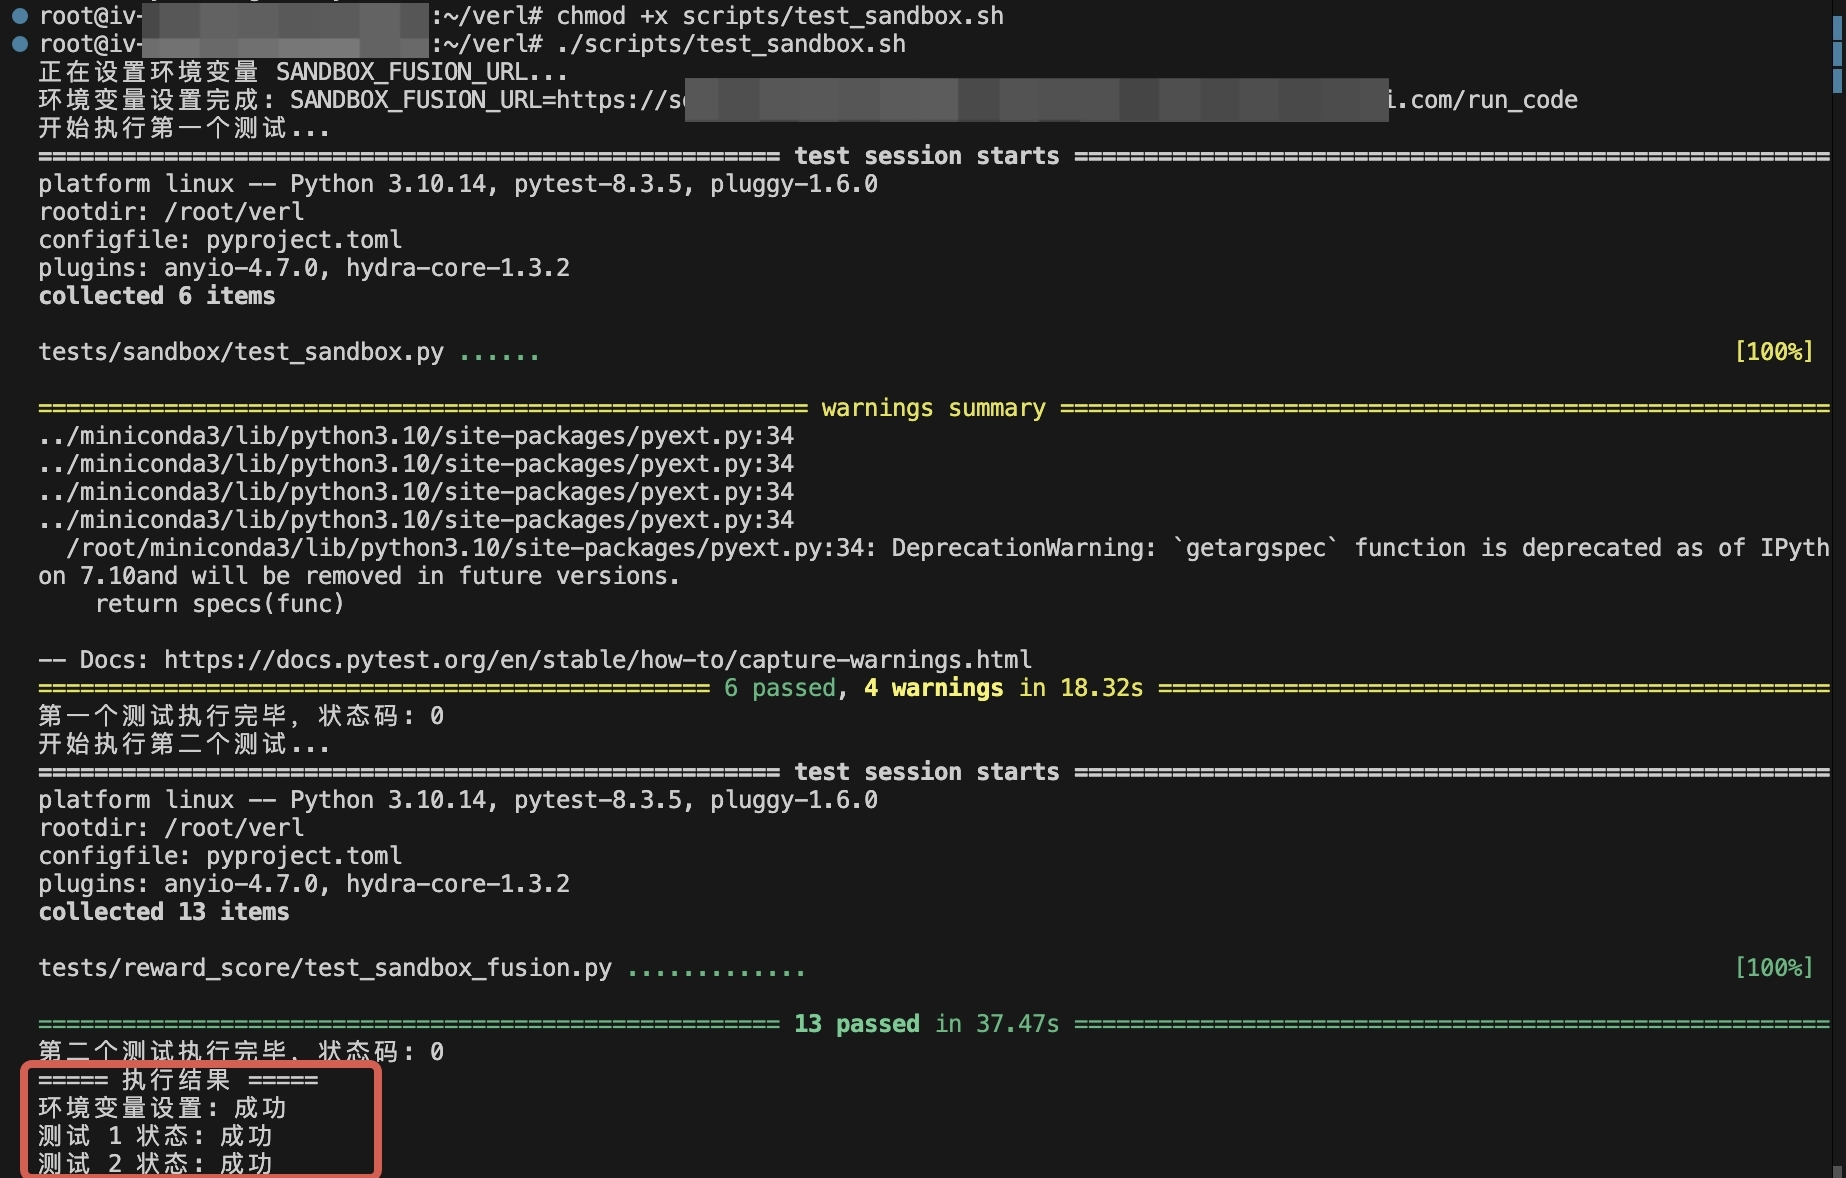
- 回显如下,表示连接通过。
-
- 基于已建立连接的Sandbox来启动训练流程。
- 执行vim scripts/train_Qwen25-7B-In-1M_code_sandbox.sh命令,打开文件。
- 按i进入编辑模式,按需修改文件内容。其中:
- reward_model.sandbox_fusion.url请替换为步骤一中获取到的触发器的 公网访问 地址+/run_code。
- actor_rollout_ref.model.path和critic.model.path替换为容器中存放Qwen2.5的路径。
- data.train_files和data.val_files替换为容器中存放数据集的路径。
- reward_model.reward_manager=prime表示每个prompt生成的多个response可并发执行。
- 其他参数,如reward_model.sandbox_fusion.max_concurrent表示sandbox的最大并发量,data.train_batch_size等等参数均可根据sandbox实例数进行设置,具体参数的含义可见VeRL参数配置说明。
- set -xpython3 -m verl.trainer.main_ppo \reward_model.sandbox_fusion.url='https://xxxxxxxxx.apigateway-cn-beijing.volceapi.com/run_code' \reward_model.sandbox_fusion.max_concurrent=256 \reward_model.reward_manager=prime \algorithm.adv_estimator=gae \data.train_files=/data1/datasets/Eurus-2-RL-Data/train.parquet \data.val_files=/data1/datasets/Eurus-2-RL-Data/validation.parquet \data.train_batch_size=128 \data.max_prompt_length=512 \data.max_response_length=512 \data.filter_overlong_prompts=True \data.truncation='error' \actor_rollout_ref.model.path=/data1/llm/Qwen2.5-7B-Instruct-1M \actor_rollout_ref.actor.optim.lr=1e-6 \actor_rollout_ref.model.use_remove_padding=True \actor_rollout_ref.actor.ppo_mini_batch_size=128 \actor_rollout_ref.actor.ppo_micro_batch_size_per_gpu=8 \actor_rollout_ref.actor.fsdp_config.param_offload=False \actor_rollout_ref.actor.fsdp_config.optimizer_offload=False \actor_rollout_ref.actor.use_kl_loss=False \actor_rollout_ref.model.enable_gradient_checkpointing=True \actor_rollout_ref.rollout.log_prob_micro_batch_size_per_gpu=16 \actor_rollout_ref.rollout.tensor_model_parallel_size=4 \actor_rollout_ref.rollout.name=vllm \actor_rollout_ref.rollout.gpu_memory_utilization=0.4 \critic.optim.lr=1e-5 \critic.model.use_remove_padding=True \critic.model.path=/data1/llm/Qwen2.5-7B-Instruct-1M \critic.model.enable_gradient_checkpointing=True \critic.ppo_micro_batch_size_per_gpu=16 \critic.model.fsdp_config.param_offload=False \critic.model.fsdp_config.optimizer_offload=False \algorithm.use_kl_in_reward=False \trainer.critic_warmup=0 \trainer.logger=['console','swanlab'] \trainer.project_name='verl_sandbox_fusion_demo_usecase' \trainer.experiment_name='qwen25instruct1m_demo_sandbox' \trainer.n_gpus_per_node=8 \trainer.nnodes=1 \trainer.save_freq=10 \trainer.test_freq=1 \trainer.total_epochs=10 $@
- 按Esc退出编辑模式,输入:wq并按Enter键,保存并退出文件。
- 执行以下命令运行脚本,使训练过程能够并发地与步骤一创建的Sandbox建立连接并执行代码。
- chmod +x scripts/train_Qwen25-7B-In-1M_code_sandbox.sh./scripts/train_Qwen25-7B-In-1M_code_sandbox.sh
- 在训练过程中,可以通过SwanLab平台查看训练的相关过程信息。
步骤三:使用本地环境进行VeRL训练
基于本地环境启动训练,按需修改scripts/train_Qwen25-7B-In-1M_code_local.sh参数配置并执行,即可使用本机CPU代替Sandbox进行代码运行,随后通过SwanLab平台进行过程查看。
- 执行vim scripts/train_Qwen25-7B-In-1M_code_local.sh命令,打开文件。
- 按i进入编辑模式,按需修改文件内容。
- set -xpython3 -m verl.trainer.main_ppo \algorithm.adv_estimator=gae \data.train_files=/data1/datasets/Eurus-2-RL-Data/train.parquet \data.val_files=/data1/datasets/Eurus-2-RL-Data/validation.parquet \data.train_batch_size=128 \data.max_prompt_length=512 \data.max_response_length=512 \data.filter_overlong_prompts=True \data.truncation='error' \actor_rollout_ref.model.path=/data1/llm/Qwen2.5-7B-Instruct-1M \actor_rollout_ref.actor.optim.lr=1e-6 \actor_rollout_ref.model.use_remove_padding=True \actor_rollout_ref.actor.ppo_mini_batch_size=128 \actor_rollout_ref.actor.ppo_micro_batch_size_per_gpu=8 \actor_rollout_ref.actor.fsdp_config.param_offload=False \actor_rollout_ref.actor.fsdp_config.optimizer_offload=False \actor_rollout_ref.actor.use_kl_loss=False \actor_rollout_ref.model.enable_gradient_checkpointing=True \actor_rollout_ref.rollout.log_prob_micro_batch_size_per_gpu=16 \actor_rollout_ref.rollout.tensor_model_parallel_size=4 \actor_rollout_ref.rollout.name=vllm \actor_rollout_ref.rollout.gpu_memory_utilization=0.4 \critic.optim.lr=1e-5 \critic.model.use_remove_padding=True \critic.model.path=/data1/llm/Qwen2.5-7B-Instruct-1M \critic.model.enable_gradient_checkpointing=True \critic.ppo_micro_batch_size_per_gpu=16 \critic.model.fsdp_config.param_offload=False \critic.model.fsdp_config.optimizer_offload=False \algorithm.use_kl_in_reward=False \trainer.critic_warmup=0 \trainer.logger=['console','swanlab'] \trainer.project_name='verl_sandbox_fusion_demo_usecase' \trainer.experiment_name='qwen25instruct1m_demo_local' \trainer.n_gpus_per_node=8 \trainer.nnodes=1 \trainer.save_freq=10 \trainer.test_freq=1 \trainer.total_epochs=10 $@
- 按Esc退出编辑模式,输入:wq并按Enter键,保存并退出文件。
- 执行以下命令启动训练。
- chmod +x scripts/train_Qwen25-7B-In-1M_code_local.sh./scripts/train_Qwen25-7B-In-1M_code_local.sh
步骤四:观察日志记录
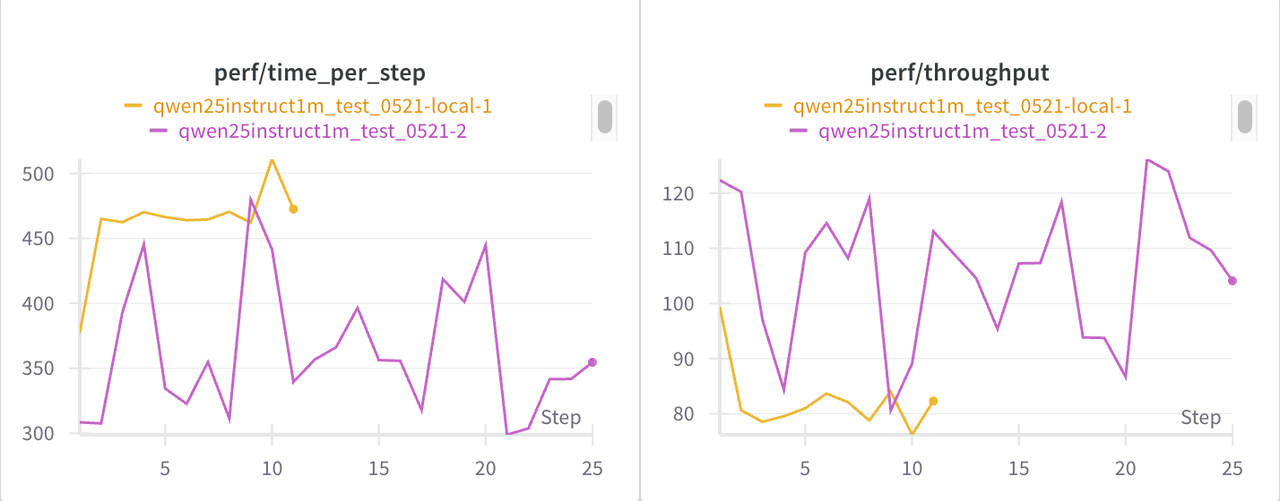
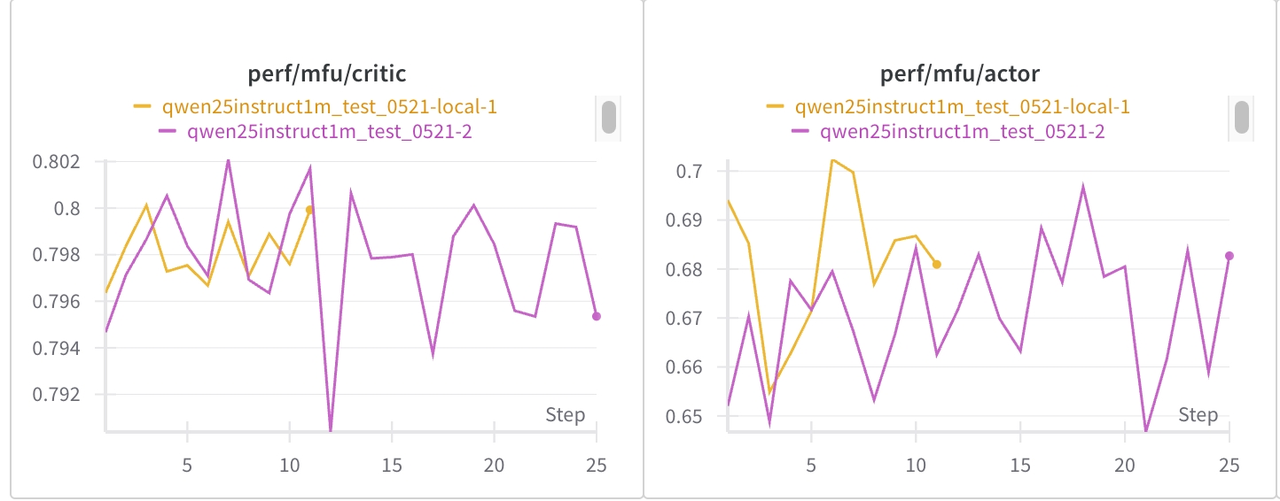
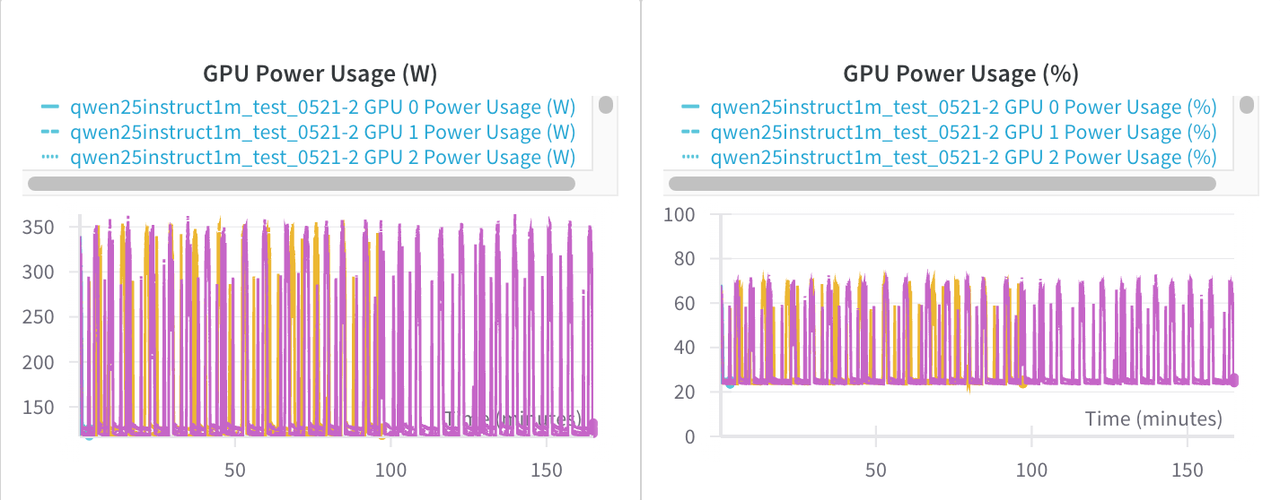
可以通过SwanLab工具观测训练过程中的日志,以此了解训练进展情况。同时该工具还能进行实验管理(w/wo vefaas-sandbox/local cpu),其中包括对使用veFaaS-Sandbox或本地CPU两种不同方式下的训练情况进行管理,包括查看性能对比、资源利用率监控等。在相同实验设置下,采用veFaaS部署的Sandbox Fusion每一个step的训练时长相较于使用本地CPU训练时长平均减少了30%,吞吐量相比本地CPU增加了30%,说明使用veFaaS部署的Sandbox Fusion在训练效率方面有显著提升。
步骤五:模型评测
- 本次评测所使用的测试项目地址为:https://github.com/modelscope/evalscope
- 评测基准(Benchmark)如下表所示。
- 评测基准评测重点题目类型难度题目数量评测基准评测重点题目类型难度题目数量代码功能正确性测试,通过单元检验Python编程题中等164题动态代码评测平台,集成竞赛新题编程题/自修复任务多样化272题(仅保留了2024-08-01到2025-01-01期间的272题)
- 评估指标(Metric):Pass@1,表示在单次尝试中模型给出的答案通过测试的比例。
- 评测基准原始 Qwen2.5-7B-Instruct-1MRL后 Qwen2.5-7B-Instruct-1M评测基准原始 Qwen2.5-7B-Instruct-1MRL后 Qwen2.5-7B-Instruct-1MHumanEval0.49390.5732LiveCodeBench 0.13240.1360
- 结论分析:
- 无论是在数据量相对较小的HumanEval测试基准场景下,还是在数据更为多样丰富的LiveCodeBench场景,模型编码能力均有提升。
- 当前基于强化学习(RL)的模型已经完成了100 steps的累计训练,且训练过程中仅采用了Eurus-2-RL-Data训练集中的1024条数据作为简单实验。理论上,如果增加模型的训练步数,并且使用全量的训练数据,该模型在性能等方面还有进一步提升的可能性。
说明
附录:case展示
下面以7道编程题为例,题目难度分布为2道简单题、2道中等题和3道困难题,且这些题目覆盖的考察点丰富多样。
随着训练过程一步步推进,模型返回的代码评分逐渐变高,这一现象体现出所采用的训练策略是有效的,同时也表明模型在处理各类编程任务时具备较强的鲁棒性,即模型能够稳定、可靠地应对不同类型和难度的编程任务,不会因任务的变化而出现较大波动或失效。
*简单题 *2
*
简单题 *2
考察点 | 题面 | 样例 | 训练过程score变化(轮数较少) |
考察点 | 题面 | 样例 | 训练过程score变化(轮数较少) |
贪心算法 | [{"content": " Whan tackling complex reasoning tasks, you have access to the following actions. Use them as needed to progress through your thought process. [ASSESS] [ADVANCE] [VERIFY] [SIMPLIFY] [SYNTHESIZE] [PIVOT] [OUTPUT] You should strictly follow the format below: [ACTION NAME] # Your action step 1 # Your action step 2 # Your action step 3 ... Next action: [NEXT ACTION NAME] ", "role": "system"},{"content": "Imagine that you have a twin brother or sister. Having another person that looks exactly like you seems very unusual. It's hard to say if having something of an alter ego is good or bad. And if you do have a twin, then you very well know what it's like. Now let's imagine a typical morning in your family. You haven't woken up yet, and Mom is already going to work. She has been so hasty that she has nearly forgotten to leave the two of her darling children some money to buy lunches in the school cafeteria. She fished in the purse and found some number of coins, or to be exact, n coins of arbitrary values a1, a2, ..., an. But as Mom was running out of time, she didn't split the coins for you two. So she scribbled a note asking you to split the money equally. As you woke up, you found Mom's coins and read her note. "But why split the money equally?" — you thought. After all, your twin is sleeping and he won't know anything. So you decided to act like that: pick for yourself some subset of coins so that the sum of values of your coins is strictly larger than the sum of values of the remaining coins that your twin will have. However, you correctly thought that if you take too many coins, the twin will suspect the deception. So, you've decided to stick to the following strategy to avoid suspicions: you take the minimum number of coins, whose sum of values is strictly more than the sum of values of the remaining coins. On this basis, determine what minimum number of coins you need to take to divide them in the described manner. Input The first line contains integer n (1 ≤ n ≤ 100) — the number of coins. The second line contains a sequence of n integers a1, a2, ..., an (1 ≤ ai ≤ 100) — the coins' values. All numbers are separated with spaces. Output In the single line print the single number — the minimum needed number of coins. Examples Input 2 3 3 Output 2 Input 3 2 1 2 Output 2 Note In the first sample you will have to take 2 coins (you and your twin have sums equal to 6, 0 correspondingly). If you take 1 coin, you get sums 3, 3. If you take 0 coins, you get sums 0, 6. Those variants do not satisfy you as your sum should be strictly more that your twins' sum. In the second sample one coin isn't enough for us, too. You can pick coins with values 1, 2 or 2, 2. In any case, the minimum number of coins equals 2. Write Python code to solve the problem. Present the code in ```python Your code ``` at the end.", "role": "user"}] | {"ground_truth": "{"inputs": ["2\n3 3\n", "3\n2 1 2\n", "100\n5 5 4 3 5 1 2 5 1 1 3 5 4 4 1 1 1 1 5 4 4 5 1 5 5 1 2 1 3 1 5 1 3 3 3 2 2 2 1 1 5 1 3 4 1 1 3 2 5 2 2 5 5 4 4 1 3 4 3 3 4 5 3 3 3 1 2 1 4 2 4 4 1 5 1 3 5 5 5 5 3 4 4 3 1 2 5 2 3 5 4 2 4 5 3 2 4 2 4 3\n", "5\n2 2 2 4 4\n", "100\n85 50 17 89 65 89 5 20 86 26 16 21 85 14 44 31 87 31 6 2 48 67 8 80 79 1 48 36 97 1 5 30 79 50 78 12 2 55 76 100 54 40 26 81 97 96 68 56 87 14 51 17 54 37 52 33 69 62 38 63 74 15 62 78 9 19 67 2 60 58 93 60 18 96 55 48 34 7 79 82 32 58 90 67 20 50 27 15 7 89 98 10 11 15 99 49 4 51 77 52\n", "5\n3 2 3 3 1\n", "7\n10 10 5 5 5 5 1\n", "3\n2 1 3\n", "6\n1 1 1 1 1 1\n", "20\n2 1 2 2 2 1 1 2 1 2 2 1 1 1 1 2 1 1 1 1\n", "7\n1 10 1 2 1 1 1\n", "20\n4 2 4 4 3 4 2 2 4 2 3 1 1 2 2 3 3 3 1 4\n", "1\n5\n", "100\n3 4 8 10 8 6 4 3 7 7 6 2 3 1 3 10 1 7 9 3 5 5 2 6 2 9 1 7 4 2 4 1 6 1 7 10 2 5 3 7 6 4 6 2 8 8 8 6 6 10 3 7 4 3 4 1 7 9 3 6 3 6 1 4 9 3 8 1 10 1 4 10 7 7 9 5 3 8 10 2 1 10 8 7 10 8 5 3 1 2 1 10 6 1 5 3 3 5 7 2\n", "4\n100 99 99 100\n", "100\n1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100\n", "4\n4 1 2 3\n", "50\n19 2 12 26 17 27 10 26 17 17 5 24 11 15 3 9 16 18 19 1 25 23 18 6 2 7 25 7 21 25 13 29 16 9 25 3 14 30 18 4 10 28 6 10 8 2 2 4 8 28\n", "100\n16 9 11 8 11 4 9 17 4 8 4 10 9 10 6 3 3 15 1 6 1 15 12 18 6 14 13 18 1 7 18 4 10 7 10 12 3 16 14 4 10 8 10 7 19 13 15 1 4 8 16 10 6 4 3 16 11 10 7 3 4 16 1 20 1 11 4 16 10 7 7 12 18 19 3 17 19 3 4 19 2 12 11 3 18 20 2 2 14 4 20 13 13 11 16 20 19 14 7 2\n", "20\n7 84 100 10 31 35 41 2 63 44 57 4 63 11 23 49 98 71 16 90\n", "20\n35 26 41 40 45 46 22 26 39 23 11 15 47 42 18 15 27 10 45 40\n", "2\n2 1\n", "100\n1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1\n", "1\n1\n", "100\n2 46 4 6 38 19 15 34 10 35 37 30 3 25 5 45 40 45 33 31 6 20 10 44 11 9 2 14 35 5 9 23 20 2 48 22 25 35 38 31 24 33 35 16 4 30 27 10 12 22 6 24 12 30 23 21 14 12 32 21 7 12 25 43 18 34 34 28 47 13 28 43 18 39 44 42 35 26 35 14 8 29 32 20 29 3 20 6 20 9 9 27 8 42 10 37 42 27 8 1\n", "70\n2 18 18 47 25 5 14 9 19 46 36 49 33 32 38 23 32 39 8 29 31 17 24 21 10 15 33 37 46 21 22 11 20 35 39 13 11 30 28 40 39 47 1 17 24 24 21 46 12 2 20 43 8 16 44 11 45 10 13 44 31 45 45 46 11 10 33 35 23 42\n", "100\n1 2 2 1 2 1 1 2 1 1 1 2 2 1 1 1 2 2 2 1 2 1 1 1 1 1 2 1 2 1 2 1 2 1 2 1 1 1 2 1 1 1 1 1 2 2 1 2 1 2 1 2 2 2 1 2 1 2 2 1 1 2 2 1 1 2 2 2 1 1 2 1 1 2 2 1 2 1 1 2 2 1 2 1 1 2 2 1 1 1 1 2 1 1 1 1 2 2 2 2\n", "100\n1 2 3 2 1 2 2 3 1 3 3 2 2 1 1 2 2 1 1 1 1 2 3 3 2 1 1 2 2 2 3 3 3 2 1 3 1 3 3 2 3 1 2 2 2 3 2 1 1 3 3 3 3 2 1 1 2 3 2 2 3 2 3 2 2 3 2 2 2 2 3 3 3 1 3 3 1 1 2 3 2 2 2 2 3 3 3 2 1 2 3 1 1 2 3 3 1 3 3 2\n", "5\n4 2 2 2 2\n", "100\n5 5 4 3 5 1 2 5 1 1 3 5 4 4 1 1 1 1 5 4 4 5 1 5 5 1 2 1 3 1 5 1 3 3 3 2 2 2 1 1 5 1 3 4 1 1 3 2 5 2 2 5 5 4 4 1 3 4 3 3 4 5 3 3 3 1 2 1 4 2 4 4 1 5 1 3 5 5 5 5 3 4 4 3 1 2 5 2 3 5 4 2 4 5 5 2 4 2 4 3\n", "5\n2 2 2 4 6\n", "100\n85 50 8 89 65 89 5 20 86 26 16 21 85 14 44 31 87 31 6 2 48 67 8 80 79 1 48 36 97 1 5 30 79 50 78 12 2 55 76 100 54 40 26 81 97 96 68 56 87 14 51 17 54 37 52 33 69 62 38 63 74 15 62 78 9 19 67 2 60 58 93 60 18 96 55 48 34 7 79 82 32 58 90 67 20 50 27 15 7 89 98 10 11 15 99 49 4 51 77 52\n", "7\n10 1 5 5 5 5 1\n", "20\n2 1 1 2 2 1 1 2 1 2 2 1 1 1 1 2 1 1 1 1\n", "7\n1 10 1 2 1 1 2\n", "100\n3 4 8 10 8 6 4 3 7 7 6 2 3 1 3 10 1 7 9 3 5 1 2 6 2 9 1 7 4 2 4 1 6 1 7 10 2 5 3 7 6 4 6 2 8 8 8 6 6 10 3 7 4 3 4 1 7 9 3 6 3 6 1 4 9 3 8 1 10 1 4 10 7 7 9 5 3 8 10 2 1 10 8 7 10 8 5 3 1 2 1 10 6 1 5 3 3 5 7 2\n", "50\n19 2 12 26 17 27 10 26 17 17 5 24 11 15 3 9 16 18 19 1 25 23 18 6 2 7 25 7 21 25 13 29 16 9 25 3 14 30 18 4 10 28 9 10 8 2 2 4 8 28\n", "100\n16 9 11 8 11 4 9 17 4 8 4 10 9 10 6 3 3 15 1 6 1 15 12 18 6 14 13 18 1 7 18 4 10 7 10 12 3 16 14 4 10 8 10 7 19 13 15 1 4 8 16 10 6 4 3 16 11 10 7 3 4 16 1 20 1 11 4 16 10 7 7 12 18 19 3 17 19 3 4 19 2 12 11 3 18 20 2 2 14 4 20 13 13 11 16 20 19 14 7 1\n", "20\n7 84 100 10 31 35 41 2 63 44 57 4 63 11 23 49 50 71 16 90\n", "20\n35 26 41 40 45 46 22 26 39 23 11 15 47 42 18 15 44 10 45 40\n", "100\n1 1 1 1 1 1 1 1 1 1 1 1 1 1 2 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1\n", "70\n2 18 18 47 25 5 14 9 19 46 36 49 33 32 38 23 32 39 8 29 31 17 24 21 10 15 33 37 46 39 22 11 20 35 39 13 11 30 28 40 39 47 1 17 24 24 21 46 12 2 20 43 8 16 44 11 45 10 13 44 31 45 45 46 11 10 33 35 23 42\n", "100\n1 2 2 1 2 1 1 2 1 1 1 2 2 1 1 1 2 2 2 1 2 1 1 1 1 1 2 1 2 1 2 1 2 1 2 1 1 1 2 1 1 1 1 1 2 2 2 2 1 2 1 2 2 2 1 2 1 2 2 1 1 2 2 1 1 2 2 2 1 1 2 1 1 2 2 1 2 1 1 2 2 1 2 1 1 2 2 1 1 1 1 2 1 1 1 1 2 2 2 2\n", "100\n1 2 3 2 1 2 2 3 1 3 3 3 2 1 1 2 2 1 1 1 1 2 3 3 2 1 1 2 2 2 3 3 3 2 1 3 1 3 3 2 3 1 2 2 2 3 2 1 1 3 3 3 3 2 1 1 2 3 2 2 3 2 3 2 2 3 2 2 2 2 3 3 3 1 3 3 1 1 2 3 2 2 2 2 3 3 3 2 1 2 3 1 1 2 3 3 1 3 3 2\n", "50\n19 2 12 26 17 27 20 26 17 17 5 24 11 15 3 9 16 18 19 1 25 23 18 6 2 7 25 1 21 25 13 29 16 9 25 3 14 30 18 4 10 28 9 10 8 2 2 4 8 28\n", "100\n1 1 1 1 1 1 1 1 1 1 1 1 1 1 2 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 0 1 1 1 0 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1\n", "20\n7 84 100 10 31 26 41 2 63 44 57 4 63 11 23 49 75 2 16 90\n", "5\n4 2 3 3 1\n", "3\n2 2 3\n", "6\n2 1 1 1 1 1\n", "20\n4 2 8 4 3 4 2 2 4 2 3 1 1 2 2 3 3 3 1 4\n", "1\n2\n", "4\n100 99 99 000\n", "100\n1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 68 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100\n", "4\n4 1 2 4\n", "2\n0 1\n", "1\n3\n", "100\n2 46 4 6 38 19 15 34 10 35 37 30 3 25 5 39 40 45 33 31 6 20 10 44 11 9 2 14 35 5 9 23 20 2 48 22 25 35 38 31 24 33 35 16 4 30 27 10 12 22 6 24 12 30 23 21 14 12 32 21 7 12 25 43 18 34 34 28 47 13 28 43 18 39 44 42 35 26 35 14 8 29 32 20 29 3 20 6 20 9 9 27 8 42 10 37 42 27 8 1\n", "5\n4 0 2 2 2\n", "2\n3 4\n", "3\n2 0 2\n", "100\n5 5 4 3 5 1 2 5 1 1 3 5 4 4 1 1 1 1 5 4 4 5 1 5 5 1 2 1 3 1 5 1 3 3 3 2 2 2 1 1 5 1 3 4 1 1 3 2 5 2 2 5 5 4 4 1 3 4 3 3 4 5 3 3 3 1 1 1 4 2 4 4 1 5 1 3 5 5 5 5 3 4 4 3 1 2 5 2 3 5 4 2 4 5 5 2 4 2 4 3\n", "5\n2 2 2 2 6\n", "100\n85 50 8 89 65 89 5 20 86 26 16 21 85 14 44 31 87 31 6 2 48 67 8 12 79 1 48 36 97 1 5 30 79 50 78 12 2 55 76 100 54 40 26 81 97 96 68 56 87 14 51 17 54 37 52 33 69 62 38 63 74 15 62 78 9 19 67 2 60 58 93 60 18 96 55 48 34 7 79 82 32 58 90 67 20 50 27 15 7 89 98 10 11 15 99 49 4 51 77 52\n", "5\n4 2 3 3 2\n", "7\n10 1 5 5 5 0 1\n", "3\n2 2 1\n", "6\n3 1 1 1 1 1\n", "20\n2 1 1 2 2 1 1 2 1 2 2 1 1 1 1 2 1 2 1 1\n", "7\n1 10 0 2 1 1 2\n", "20\n4 2 8 4 3 4 2 2 4 2 3 1 1 2 2 2 3 3 1 4\n", "1\n6\n", "100\n3 4 8 10 8 6 4 3 7 7 6 2 3 1 3 10 1 7 9 3 5 1 2 6 2 9 1 7 4 2 4 1 6 1 7 10 2 5 3 7 6 4 6 2 8 8 8 6 6 10 3 7 4 3 4 1 4 9 3 6 3 6 1 4 9 3 8 1 10 1 4 10 7 7 9 5 3 8 10 2 1 10 8 7 10 8 5 3 1 2 1 10 6 1 5 3 3 5 7 2\n", "4\n100 99 99 001\n", "4\n4 1 1 4\n", "50\n19 2 12 26 17 27 10 26 17 17 5 24 11 15 3 9 16 18 19 1 25 23 18 6 2 7 25 1 21 25 13 29 16 9 25 3 14 30 18 4 10 28 9 10 8 2 2 4 8 28\n", "100\n16 9 11 8 11 4 9 17 4 8 4 10 9 19 6 3 3 15 1 6 1 15 12 18 6 14 13 18 1 7 18 4 10 7 10 12 3 16 14 4 10 8 10 7 19 13 15 1 4 8 16 10 6 4 3 16 11 10 7 3 4 16 1 20 1 11 4 16 10 7 7 12 18 19 3 17 19 3 4 19 2 12 11 3 18 20 2 2 14 4 20 13 13 11 16 20 19 14 7 1\n", "20\n7 84 100 10 31 26 41 2 63 44 57 4 63 11 23 49 50 71 16 90\n", "20\n35 26 41 40 45 46 22 26 39 23 11 15 47 42 18 15 44 10 23 40\n", "100\n1 1 1 1 1 1 1 1 1 1 1 1 1 1 2 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 0 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1\n", "100\n2 46 4 6 38 19 15 34 10 35 37 30 3 25 5 39 40 45 33 31 6 20 10 44 11 9 2 14 35 5 9 23 20 2 48 22 25 35 38 31 24 33 35 16 4 30 27 10 12 22 6 24 12 30 23 21 14 12 32 21 7 12 19 43 18 34 34 28 47 13 28 43 18 39 44 42 35 26 35 14 8 29 32 20 29 3 20 6 20 9 9 27 8 42 10 37 42 27 8 1\n", "70\n2 18 18 47 25 5 14 9 19 46 36 49 33 15 38 23 32 39 8 29 31 17 24 21 10 15 33 37 46 39 22 11 20 35 39 13 11 30 28 40 39 47 1 17 24 24 21 46 12 2 20 43 8 16 44 11 45 10 13 44 31 45 45 46 11 10 33 35 23 42\n", "100\n1 2 2 1 2 1 1 2 1 1 1 2 2 1 1 1 2 2 2 1 2 1 1 1 1 1 2 1 2 1 2 1 2 1 2 1 1 1 2 1 1 1 1 1 2 2 2 2 1 2 1 2 2 2 1 2 1 2 2 1 1 2 2 1 1 2 2 2 1 1 2 1 1 2 2 1 2 1 1 2 2 1 2 1 1 3 2 1 1 1 1 2 1 1 1 1 2 2 2 2\n", "100\n1 2 3 2 1 3 2 3 1 3 3 3 2 1 1 2 2 1 1 1 1 2 3 3 2 1 1 2 2 2 3 3 3 2 1 3 1 3 3 2 3 1 2 2 2 3 2 1 1 3 3 3 3 2 1 1 2 3 2 2 3 2 3 2 2 3 2 2 2 2 3 3 3 1 3 3 1 1 2 3 2 2 2 2 3 3 3 2 1 2 3 1 1 2 3 3 1 3 3 2\n", "5\n4 0 2 3 2\n", "2\n3 5\n", "3\n2 1 4\n", "100\n5 5 4 3 5 1 2 5 1 1 3 5 4 4 1 1 1 1 4 4 4 5 1 5 5 1 2 1 3 1 5 1 3 3 3 2 2 2 1 1 5 1 3 4 1 1 3 2 5 2 2 5 5 4 4 1 3 4 3 3 4 5 3 3 3 1 1 1 4 2 4 4 1 5 1 3 5 5 5 5 3 4 4 3 1 2 5 2 3 5 4 2 4 5 5 2 4 2 4 3\n", "5\n2 1 2 2 6\n", "100\n85 50 8 89 65 89 5 20 86 26 16 21 85 14 44 31 87 31 6 2 48 67 8 12 79 1 48 36 97 1 5 30 79 50 78 12 2 55 76 100 54 40 26 81 97 96 68 56 87 14 51 17 54 37 52 33 69 62 38 63 74 15 62 78 9 19 67 2 60 58 93 60 16 96 55 48 34 7 79 82 32 58 90 67 20 50 27 15 7 89 98 10 11 15 99 49 4 51 77 52\n", "5\n4 2 3 3 3\n", "7\n10 1 5 4 5 0 1\n", "3\n3 2 1\n", "6\n3 1 2 1 1 1\n", "20\n2 1 1 2 2 1 1 2 1 2 2 1 1 2 1 2 1 2 1 1\n", "7\n1 10 0 1 1 1 2\n", "20\n4 2 8 4 3 4 2 2 4 2 3 1 1 2 2 2 3 3 1 2\n", "1\n4\n", "100\n3 4 8 10 8 6 4 3 7 7 6 2 3 1 3 10 1 7 9 3 5 1 2 6 2 9 1 7 4 2 4 1 6 1 7 10 2 5 3 7 6 4 6 2 8 8 7 6 6 10 3 7 4 3 4 1 4 9 3 6 3 6 1 4 9 3 8 1 10 1 4 10 7 7 9 5 3 8 10 2 1 10 8 7 10 8 5 3 1 2 1 10 6 1 5 3 3 5 7 2\n", "4\n100 99 176 001\n", "4\n4 0 1 4\n", "100\n16 9 11 8 11 4 9 17 4 8 4 10 9 19 6 3 3 15 1 6 1 15 12 18 6 14 13 18 1 7 18 4 10 7 10 12 3 16 14 4 10 8 10 7 19 13 15 1 4 8 16 10 6 4 3 16 11 10 7 3 4 16 1 20 1 11 4 16 12 7 7 12 18 19 3 17 19 3 4 19 2 12 11 3 18 20 2 2 14 4 20 13 13 11 16 20 19 14 7 1\n", "20\n7 84 100 10 31 26 41 2 63 44 57 4 63 11 23 49 75 71 16 90\n", "20\n35 26 41 40 45 46 37 26 39 23 11 15 47 42 18 15 44 10 23 40\n", "100\n2 46 4 6 38 19 15 34 10 35 37 30 5 25 5 39 40 45 33 31 6 20 10 44 11 9 2 14 35 5 9 23 20 2 48 22 25 35 38 31 24 33 35 16 4 30 27 10 12 22 6 24 12 30 23 21 14 12 32 21 7 12 19 43 18 34 34 28 47 13 28 43 18 39 44 42 35 26 35 14 8 29 32 20 29 3 20 6 20 9 9 27 8 42 10 37 42 27 8 1\n", "70\n2 18 18 47 25 5 14 9 19 46 36 49 33 15 38 23 32 39 8 29 31 17 24 21 10 15 33 37 46 39 22 11 20 35 39 13 11 30 28 40 39 47 1 17 24 24 21 46 12 2 20 43 8 16 15 11 45 10 13 44 31 45 45 46 11 10 33 35 23 42\n", "100\n1 2 2 1 2 1 1 2 0 1 1 2 2 1 1 1 2 2 2 1 2 1 1 1 1 1 2 1 2 1 2 1 2 1 2 1 1 1 2 1 1 1 1 1 2 2 2 2 1 2 1 2 2 2 1 2 1 2 2 1 1 2 2 1 1 2 2 2 1 1 2 1 1 2 2 1 2 1 1 2 2 1 2 1 1 3 2 1 1 1 1 2 1 1 1 1 2 2 2 2\n", "100\n1 2 3 2 1 3 2 3 1 3 3 3 2 1 1 2 2 1 1 1 1 2 3 3 2 1 1 2 2 2 3 3 3 2 1 3 1 3 3 2 3 1 2 2 2 3 2 1 1 3 3 3 3 2 1 1 2 3 2 2 3 2 3 2 2 3 2 2 2 2 3 3 3 1 3 3 1 1 2 3 2 2 2 2 3 3 3 2 1 2 3 1 1 2 3 3 1 3 2 2\n", "5\n3 0 2 3 2\n", "2\n3 0\n", "3\n2 1 1\n", "100\n5 5 4 3 5 1 2 5 1 1 3 4 4 4 1 1 1 1 4 4 4 5 1 5 5 1 2 1 3 1 5 1 3 3 3 2 2 2 1 1 5 1 3 4 1 1 3 2 5 2 2 5 5 4 4 1 3 4 3 3 4 5 3 3 3 1 1 1 4 2 4 4 1 5 1 3 5 5 5 5 3 4 4 3 1 2 5 2 3 5 4 2 4 5 5 2 4 2 4 3\n", "5\n3 1 2 2 6\n", "100\n85 50 8 89 65 89 5 20 86 26 16 21 85 14 44 31 87 31 6 2 48 67 8 12 79 1 48 36 97 1 5 30 79 50 78 12 2 55 76 100 54 40 26 81 97 96 68 56 87 14 51 17 54 37 52 33 69 62 38 63 74 15 62 78 9 19 67 2 60 58 93 60 16 96 55 48 10 7 79 82 32 58 90 67 20 50 27 15 7 89 98 10 11 15 99 49 4 51 77 52\n", "5\n4 3 3 3 3\n", "7\n10 1 5 8 5 0 1\n", "3\n3 2 0\n", "6\n1 1 2 1 1 1\n", "20\n2 1 1 2 2 1 1 2 1 4 2 1 1 2 1 2 1 2 1 1\n", "7\n1 3 0 1 1 1 2\n", "20\n5 2 8 4 3 4 2 2 4 2 3 1 1 2 2 2 3 3 1 2\n", "1\n8\n", "100\n3 4 8 10 8 6 4 3 7 7 6 2 3 1 3 10 1 7 9 3 5 1 2 6 2 9 1 7 4 2 4 1 6 1 7 10 2 2 3 7 6 4 6 2 8 8 7 6 6 10 3 7 4 3 4 1 4 9 3 6 3 6 1 4 9 3 8 1 10 1 4 10 7 7 9 5 3 8 10 2 1 10 8 7 10 8 5 3 1 2 1 10 6 1 5 3 3 5 7 2\n", "4\n100 99 124 001\n", "4\n1 0 1 4\n", "50\n19 2 12 26 17 27 20 26 7 17 5 24 11 15 3 9 16 18 19 1 25 23 18 6 2 7 25 1 21 25 13 29 16 9 25 3 14 30 18 4 10 28 9 10 8 2 2 4 8 28\n", "100\n16 9 11 8 11 4 9 17 4 8 4 10 9 19 6 3 3 15 1 6 1 15 12 18 6 14 13 18 1 7 18 4 10 7 10 12 3 16 14 4 10 8 10 7 19 13 15 1 4 8 16 10 6 4 3 16 11 10 6 3 4 16 1 20 1 11 4 16 12 7 7 12 18 19 3 17 19 3 4 19 2 12 11 3 18 20 2 2 14 4 20 13 13 11 16 20 19 14 7 1\n", "20\n35 26 41 40 45 46 37 26 39 23 11 15 21 42 18 15 44 10 23 40\n"], "outputs": ["2\n", "2\n", "33\n", "2\n", "29\n", "3\n", "3\n", "2\n", "4\n", "8\n", "1\n", "8\n", "1\n", "30\n", "2\n", "30\n", "2\n", "14\n", "29\n", "6\n", "8\n", "1\n", "51\n", "1\n", "30\n", "22\n", "37\n", "36\n", "3\n", "33\n", "2\n", "28\n", "3\n", "7\n", "1\n", "30\n", "14\n", "29\n", "6\n", "8\n", "50\n", "22\n", "37\n", "36\n", "15\n", "49\n", "5\n", "2\n", "2\n", "3\n", "7\n", "1\n", "2\n", "30\n", "2\n", "1\n", "1\n", "30\n", "2\n", "1\n", "2\n", "33\n", "2\n", "28\n", "3\n", "2\n", "2\n", "3\n", "8\n", "1\n", "7\n", "1\n", "30\n", "2\n", "2\n", "14\n", "29\n", "6\n", "7\n", "50\n", "30\n", "22\n", "37\n", "36\n", "2\n", "1\n", "1\n", "33\n", "2\n", "28\n", "3\n", "2\n", "2\n", "2\n", "8\n", "1\n", "7\n", "1\n", "30\n", "2\n", "2\n", "29\n", "6\n", "8\n", "30\n", "22\n", "37\n", "36\n", "2\n", "1\n", "2\n", "33\n", "2\n", "28\n", "3\n", "2\n", "1\n", "3\n", "7\n", "2\n", "7\n", "1\n", "30\n", "2\n", "1\n", "14\n", "29\n", "8\n"]}", "style": "rule"} | 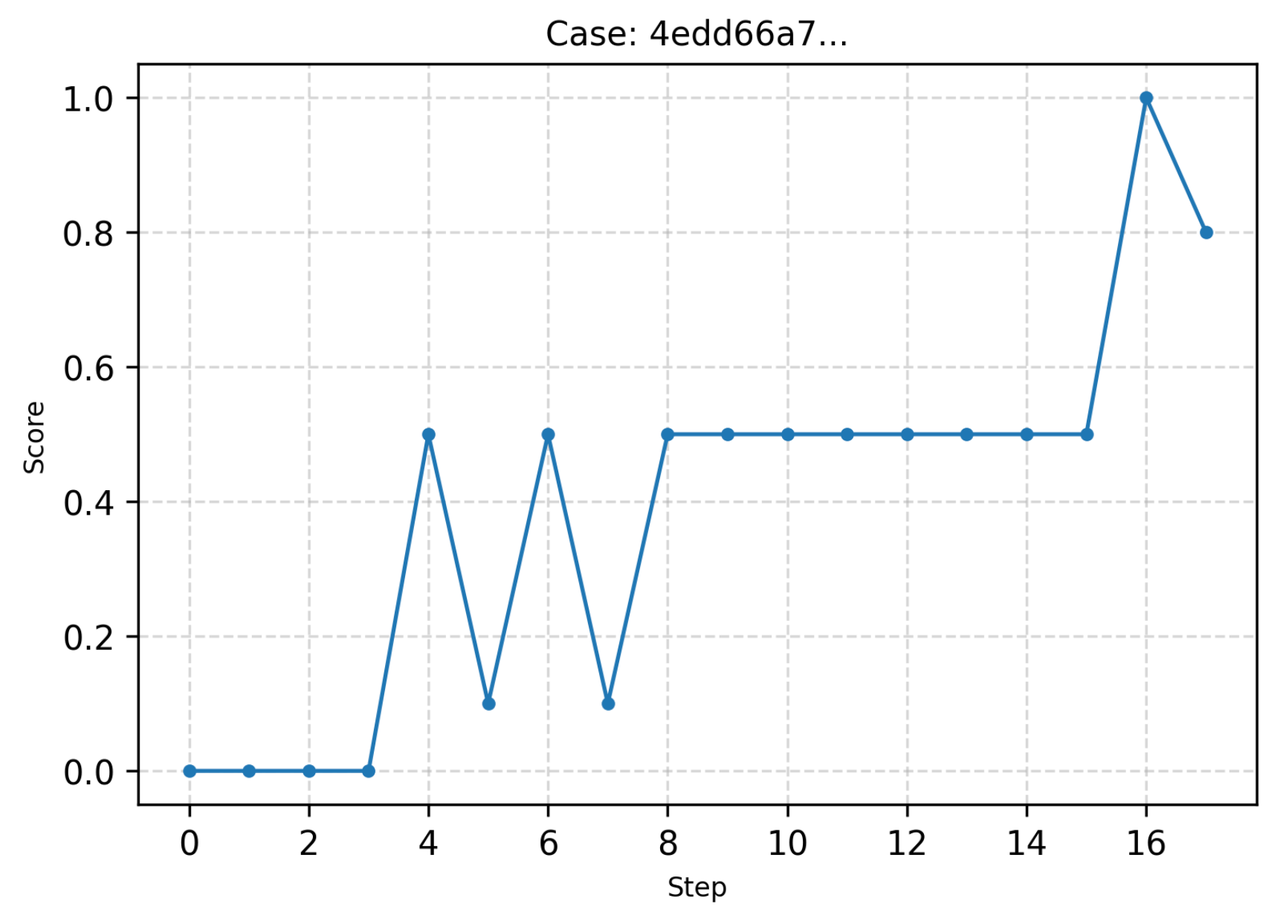 |
字符串模式匹配 | [{"content": " When tackling complex reasoning tasks, you have access to the following actions. Use them as needed to progress through your thought process. [ASSESS] [ADVANCE] [VERIFY] [SIMPLIFY] [SYNTHESIZE] [PIVOT] [OUTPUT] You should strictly follow the format below: [ACTION NAME] # Your action step 1 # Your action step 2 # Your action step 3 ... Next action: [NEXT ACTION NAME] ", "role": "system"},{"content": "Polycarp has interviewed Oleg and has written the interview down without punctuation marks and spaces to save time. Thus, the interview is now a string s consisting of n lowercase English letters. There is a filler word ogo in Oleg's speech. All words that can be obtained from ogo by adding go several times to the end of it are also considered to be fillers. For example, the words ogo, ogogo, ogogogo are fillers, but the words go, og, ogog, ogogog and oggo are not fillers. The fillers have maximal size, for example, for ogogoo speech we can't consider ogo a filler and goo as a normal phrase. We should consider ogogo as a filler here. To print the interview, Polycarp has to replace each of the fillers with three asterisks. Note that a filler word is replaced with exactly three asterisks regardless of its length. Polycarp has dealt with this problem in no time. Can you do the same? The clock is ticking! -----Input----- The first line contains a positive integer n (1 ≤ n ≤ 100) — the length of the interview. The second line contains the string s of length n, consisting of lowercase English letters. -----Output----- Print the interview text after the replacement of each of the fillers with "***". It is allowed for the substring "***" to have several consecutive occurences. -----Examples----- Input 7 aogogob Output a***b Input 13 ogogmgogogogo Output ***gmg*** Input 9 ogoogoogo Output ********* -----Note----- The first sample contains one filler word ogogo, so the interview for printing is "a***b". The second sample contains two fillers ogo and ogogogo. Thus, the interview is transformed to "***gmg***". Write Python code to solve the problem. Present the code in ```python Your code ``` at the end.", "role": "user"}] | {"ground_truth": "{ "inputs": [ "7\naogogob\n", "13\nogogmgogogogo\n", "9\nogoogoogo\n", "32\nabcdefogoghijklmnogoopqrstuvwxyz\n", "100\nggogogoooggogooggoggogggggogoogoggooooggooggoooggogoooggoggoogggoogoggogggoooggoggoggogggogoogggoooo\n", "10\nogooggoggo\n", "20\nooggooogooogooogooog\n", "30\ngoggogoooggooggggoggoggoogoggo\n", "40\nogggogooggoogoogggogooogogggoogggooggooo\n", "50\noggggogoogggggggoogogggoooggooogoggogooogogggogooo\n", "60\nggoooogoggogooogogooggoogggggogogogggggogggogooogogogggogooo\n", "70\ngogoooggggoggoggggggoggggoogooogogggggooogggogoogoogoggogggoggogoooooo\n", "80\nooogoggoooggogogoggooooogoogogooogoggggogggggogoogggooogooooooggoggoggoggogoooog\n", "90\nooogoggggooogoggggoooogggggooggoggoggooooooogggoggogggooggggoooooogoooogooggoooogggggooooo\n", "100\ngooogoggooggggoggoggooooggogoogggoogogggoogogoggogogogoggogggggogggggoogggooogogoggoooggogoooooogogg\n", "100\ngoogoogggogoooooggoogooogoogoogogoooooogooogooggggoogoggogooogogogoogogooooggoggogoooogooooooggogogo\n", "100\ngoogoggggogggoooggoogoogogooggoggooggggggogogggogogggoogogggoogoggoggogooogogoooogooggggogggogggoooo\n", "100\nogogogogogoggogogogogogogoggogogogoogoggoggooggoggogoogoooogogoogggogogogogogoggogogogogogogogogogoe\n", "5\nogoga\n", "1\no\n", "100\nogogogogogogogogogogogogogogogogogogogogogogogogogogogogogogogogogogogogogogogogogogogogogogogogogog\n", "99\nogogogogogogogogogogogogogogogogogogogogogogogogogogogogogogogogogogogogogogogogogogogogogogogogogo\n", "5\nggggg\n", "6\ngoogoo\n", "7\nooogooo\n", "8\ngggggggg\n", "9\nogggogggg\n", "10\nogogoggogo\n", "11\noooggooggog\n", "12\nogggooooggog\n", "13\nogoggogogooog\n", "15\nggooogoooggoggg\n", "14\noogooooggooggo\n", "1\na\n", "1\ng\n", "1\nz\n", "46\nsdfkogogogogergergogogergerogogogogoergoegogog\n", "86\ngdfggogogodfogogdofgoodfogodgodgfogoogdodhbofgobgbgfogoogdfogogogogogoogggsgfosogodgon\n", "83\nergegergoogogogerogoerorogroeorgefxcfgzdgawofqpwzxcvbnmsdfkfpweoriqgtogooggsdgogoog\n", "2\nog\n", "4\nogog\n", "4\nogoo\n", "29\naaaogogogogogogogogogogogobbb\n", "11\nogogogogogo\n", "9\nogogogogo\n", "3\nogo\n", "15\nogogogogogogogo\n", "25\nogogogogogogogogogogogogo\n" ], "outputs": [ "a***b\n", "***gmg***\n", "*********\n", "abcdef***ghijklmn***opqrstuvwxyz\n", "gg***oogg***oggoggoggggg******ggooooggooggooogg***ooggoggoogggo***ggogggoooggoggoggoggg***ogggoooo\n", "***oggoggo\n", "ooggoo***o***o***oog\n", "gogg***ooggooggggoggoggo***ggo\n", "oggg***oggo***oggg***o***gggoogggooggooo\n", "ogggg***ogggggggo***gggoooggoo***gg***o***ggg***oo\n", "ggooo***gg***o***oggooggggg***gggggoggg***o***ggg***oo\n", "g***ooggggoggoggggggoggggo***o***gggggoooggg*********ggogggogg***ooooo\n", "oo***ggooogg***ggoooo******o***ggggoggggg***ogggoo***oooooggoggoggogg***ooog\n", "oo***ggggoo***ggggoooogggggooggoggoggooooooogggoggogggooggggooooo***oo***oggoooogggggooooo\n", "goo***ggooggggoggoggoooogg***ogggo***gggo***gg***ggogggggogggggoogggoo***ggooogg***oooo***gg\n", "go***oggg***ooooggo***o*********oooo***o***oggggo***gg***o******oooggogg***oo***ooooogg***\n", "go***ggggogggoooggo******oggoggoogggggg***ggg***gggo***gggo***ggogg***o***oo***oggggogggogggoooo\n", "***gg***gg******ggoggooggogg******oo***oggg***gg***e\n", "***ga\n", "o\n", "***g\n", "***\n", "ggggg\n", "go***o\n", "oo***oo\n", "gggggggg\n", "ogggogggg\n", "***gg***\n", "oooggooggog\n", "ogggooooggog\n", "***gg***oog\n", "ggoo***ooggoggg\n", "o***oooggooggo\n", "a\n", "g\n", "z\n", "sdfk***gergerg***gerger***ergoeg***g\n", "gdfgg***df***gdofgoodf***dgodgf***ogdodhbofgobgbgf***ogdf***ogggsgfos***dgon\n", "ergegergo***ger***erorogroeorgefxcfgzdgawofqpwzxcvbnmsdfkfpweoriqgt***oggsdg***og\n", "og\n", "***g\n", "***o\n", "aaa***bbb\n", "***\n", "***\n", "***\n", "***\n", "***\n" ] }", "style": "rule"} | 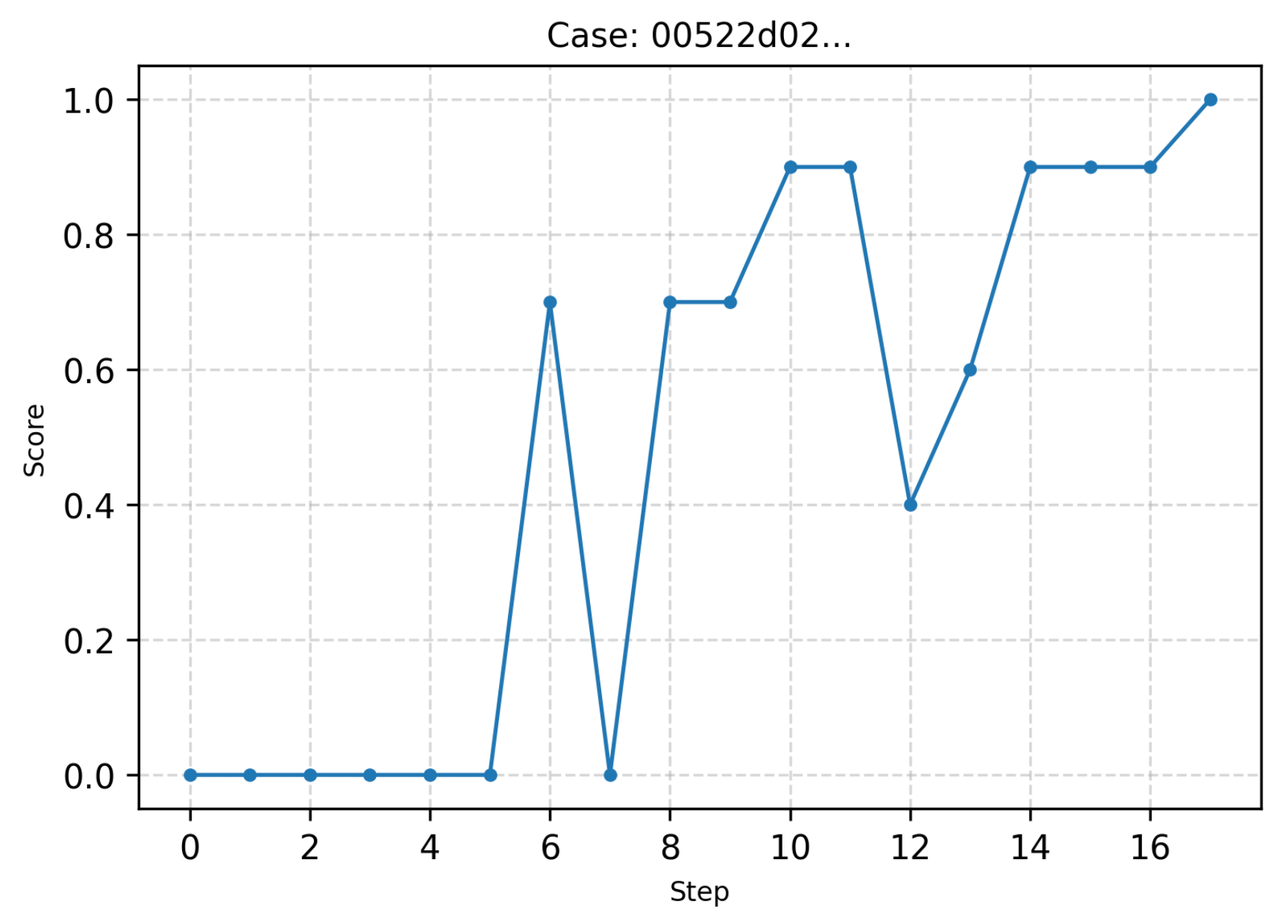 |
*中等题 *2
*
中等题 *2
考察点 | 题面 | 样例 | 训练过程score变化(轮数较少) |
考察点 | 题面 | 样例 | 训练过程score变化(轮数较少) |
动态规划 | [{"content": " When tackling complex reasoning tasks, you have access to the following actions. Use them as needed to progress through your thought process. [ASSESS] [ADVANCE] [VERIFY] [SIMPLIFY] [SYNTHESIZE] [PIVOT] [OUTPUT] You should strictly follow the format below: [ACTION NAME] # Your action step 1 # Your action step 2 # Your action step 3 ... Next action: [NEXT ACTION NAME] ", "role": "system"},{"content": "The Little Elephant from the Zoo of Lviv is going to the Birthday Party of the Big Hippo tomorrow. Now he wants to prepare a gift for the Big Hippo. He has N balloons, numbered from 1 to N. The i-th balloon has the color Ci and it costs Pi dollars. The gift for the Big Hippo will be any subset (chosen randomly, possibly empty) of the balloons such that the number of different colors in that subset is at least M. Help Little Elephant to find the expected cost of the gift. Input The first line of the input contains a single integer T - the number of test cases. T test cases follow. The first line of each test case contains a pair of integers N and M. The next N lines contain N pairs of integers Ci and Pi, one pair per line. Output In T lines print T real numbers - the answers for the corresponding test cases. Your answer will considered correct if it has at most 10^-6 absolute or relative error. Constraints 1 ≤ T ≤ 40 1 ≤ N, Ci≤ 40 1 ≤ Pi ≤ 1000000 0 ≤ M ≤ K, where K is the number of different colors in the test case. Example Input: 2 2 2 1 4 2 7 2 1 1 4 2 7 Output: 11.000000000 7.333333333 Write Python code to solve the problem. Present the code in ```python Your code ``` at the end.", "role": "user"}] | {"ground_truth": "{"inputs": ["2\n2 2\n1 4\n2 7\n2 1\n1 4\n2 7", "2\n2 2\n1 4\n2 7\n2 1\n1 4\n0 7", "2\n2 2\n1 4\n2 7\n2 1\n1 3\n0 7", "2\n2 0\n1 4\n2 7\n2 1\n1 4\n2 7", "2\n2 2\n1 4\n2 0\n2 1\n1 4\n0 7", "2\n2 1\n1 4\n2 7\n2 1\n1 4\n2 7", "2\n2 1\n1 0\n2 7\n2 1\n1 4\n2 7", "2\n2 2\n1 4\n2 7\n2 2\n1 4\n0 7", "2\n2 2\n1 4\n2 7\n2 1\n1 2\n0 7", "2\n2 2\n1 4\n4 7\n2 1\n1 0\n0 7", "2\n2 2\n1 4\n2 7\n2 1\n1 7\n2 7", "2\n2 2\n1 4\n4 1\n2 1\n0 3\n0 7", "2\n2 2\n1 4\n2 7\n2 1\n1 2\n0 0", "2\n2 2\n1 4\n4 7\n1 1\n1 0\n0 7", "2\n2 2\n1 4\n8 7\n2 1\n1 3\n-1 9", "2\n2 1\n1 4\n2 7\n2 1\n1 2\n0 0", "2\n2 2\n0 2\n2 7\n2 1\n1 7\n2 7", "2\n2 1\n1 4\n2 7\n2 0\n1 2\n0 0", "2\n2 2\n0 2\n2 4\n2 1\n1 7\n4 7", "2\n2 2\n2 4\n8 7\n1 1\n1 3\n0 9", "2\n2 2\n1 8\n2 7\n2 1\n1 3\n0 7", "2\n2 2\n1 2\n2 0\n2 1\n1 4\n0 7", "2\n2 2\n1 4\n4 4\n2 1\n0 3\n0 7", "2\n2 2\n1 4\n4 13\n2 1\n0 3\n0 7", "2\n2 2\n1 4\n4 7\n2 1\n1 3\n-1 14", "2\n2 2\n1 4\n4 10\n2 1\n1 0\n0 7", "2\n2 2\n1 4\n8 7\n2 1\n1 3\n-1 1", "2\n2 2\n1 4\n2 7\n2 2\n1 2\n0 0", "2\n4 1\n1 4\n2 7\n2 0\n1 2\n0 0", "2\n2 2\n1 4\n0 4\n2 1\n1 4\n2 7", "2\n2 2\n1 0\n4 7\n2 1\n1 4\n0 7", "2\n2 2\n1 2\n2 -1\n2 1\n1 4\n0 7", "2\n2 1\n0 0\n2 7\n2 1\n1 4\n2 6", "2\n2 2\n1 2\n0 7\n2 2\n1 4\n0 7", "2\n2 2\n1 4\n4 2\n2 1\n1 0\n0 7", "2\n2 2\n0 4\n4 7\n2 1\n1 7\n2 1", "2\n2 2\n1 7\n2 7\n2 2\n1 2\n0 0", "2\n2 0\n1 4\n3 1\n2 1\n-1 3\n-1 7", "2\n4 1\n1 4\n2 8\n2 0\n1 2\n0 0", "2\n2 2\n1 2\n2 7\n2 1\n1 6\n4 7", "2\n2 1\n1 4\n0 7\n2 0\n1 0\n-1 0", "2\n2 2\n1 4\n6 13\n2 1\n0 3\n0 0", "2\n2 1\n0 1\n2 7\n2 1\n1 4\n2 6", "2\n2 0\n1 2\n0 7\n2 2\n1 4\n0 7", "2\n2 2\n1 4\n4 2\n2 1\n1 0\n0 10", "2\n2 2\n0 4\n4 8\n2 1\n1 7\n2 1", "2\n2 2\n1 1\n2 7\n2 2\n1 2\n0 0", "2\n2 0\n1 4\n4 4\n2 0\n0 4\n0 7", "2\n2 2\n0 4\n2 7\n2 1\n1 4\n4 2", "2\n2 1\n0 1\n2 7\n2 1\n1 0\n2 6", "2\n2 0\n1 2\n0 7\n2 2\n1 4\n0 5", "2\n2 2\n1 1\n2 7\n2 2\n1 2\n0 1", "2\n2 1\n2 4\n0 7\n2 0\n1 0\n-1 1", "2\n2 0\n1 1\n4 4\n2 0\n0 4\n0 7", "2\n2 0\n0 1\n2 7\n2 1\n1 0\n2 6", "2\n2 2\n1 0\n0 7\n2 1\n3 3\n-1 14", "2\n2 0\n1 1\n0 7\n2 2\n1 4\n0 5", "2\n2 2\n1 4\n4 4\n2 2\n1 0\n0 10", "2\n2 2\n1 4\n10 14\n1 1\n1 3\n-1 10", "2\n2 2\n0 2\n4 8\n2 1\n1 7\n1 1", "2\n2 2\n1 1\n2 7\n2 2\n1 0\n0 1", "2\n4 1\n2 4\n2 8\n2 0\n2 0\n0 0", "2\n2 0\n2 4\n0 7\n2 0\n1 0\n-1 1", "2\n2 0\n1 1\n4 4\n2 0\n0 7\n0 7", "2\n2 2\n0 4\n2 6\n2 1\n1 1\n4 2", "2\n2 0\n0 1\n2 7\n2 1\n1 0\n2 7", "2\n2 2\n1 4\n4 8\n2 2\n1 0\n0 10", "2\n2 0\n1 4\n10 14\n1 1\n1 3\n-1 10", "2\n2 2\n0 2\n4 8\n1 1\n1 7\n1 1", "2\n2 2\n1 2\n2 7\n2 2\n1 0\n0 1", "2\n2 0\n0 1\n2 7\n2 1\n1 0\n2 10", "2\n2 0\n1 6\n10 14\n1 1\n1 3\n-1 10", "2\n2 0\n2 4\n0 8\n2 0\n1 0\n-2 1", "2\n2 0\n0 2\n2 7\n2 1\n1 0\n2 10", "2\n2 0\n1 1\n10 14\n1 1\n1 3\n-1 10", "2\n2 0\n0 2\n2 7\n2 1\n1 0\n2 17", "2\n2 0\n2 4\n0 8\n2 0\n1 1\n-3 1", "2\n2 2\n0 4\n12 13\n2 2\n1 0\n0 10", "2\n2 2\n0 2\n4 7\n1 1\n2 2\n1 2", "2\n2 0\n2 4\n0 10\n2 0\n1 1\n-3 1", "2\n4 1\n-1 4\n2 8\n2 -1\n3 0\n0 -1", "2\n2 0\n2 5\n0 10\n2 0\n1 1\n-3 1", "2\n2 0\n2 5\n0 19\n2 0\n1 1\n-3 1", "2\n2 0\n0 2\n2 7\n2 1\n2 -1\n1 17", "2\n4 1\n0 4\n2 1\n2 -1\n3 0\n0 -1", "2\n2 0\n0 3\n2 7\n2 1\n2 -1\n1 17", "2\n4 2\n0 4\n2 1\n2 -1\n3 0\n0 -1", "2\n2 0\n1 5\n0 19\n2 0\n1 1\n-3 2", "2\n2 0\n0 3\n2 7\n2 1\n2 -2\n1 17", "2\n4 2\n0 4\n2 1\n2 -1\n2 0\n0 -1", "2\n2 0\n1 5\n0 33\n2 0\n1 1\n-3 2", "2\n2 0\n0 3\n2 4\n2 1\n2 -2\n1 17", "2\n2 0\n0 5\n0 38\n2 0\n1 1\n-3 2", "2\n2 0\n0 7\n0 38\n2 0\n1 1\n-3 2", "2\n2 0\n0 7\n0 38\n2 0\n1 1\n-3 1", "2\n2 0\n0 7\n0 38\n1 0\n1 1\n-3 1", "2\n2 0\n0 7\n0 9\n1 0\n1 1\n-3 1", "2\n2 1\n0 7\n0 9\n1 0\n1 1\n-3 2", "2\n2 2\n-4 3\n0 9\n1 0\n0 1\n-1 2", "2\n2 2\n1 4\n2 3\n2 1\n1 3\n0 7", "2\n2 1\n1 4\n2 7\n2 2\n1 4\n2 7"], "outputs": ["11.000000000\n7.333333333", "11.0000000000\n7.3333333333\n", "11.0000000000\n6.6666666667\n", "5.5000000000\n7.3333333333\n", "4.0000000000\n7.3333333333\n", "7.3333333333\n7.3333333333\n", "4.6666666667\n7.3333333333\n", "11.0000000000\n11.0000000000\n", "11.0000000000\n6.0000000000\n", "11.0000000000\n4.6666666667\n", "11.0000000000\n9.3333333333\n", "5.0000000000\n6.6666666667\n", "11.0000000000\n1.3333333333\n", "11.0000000000\n0.0000000000\n", "11.0000000000\n8.0000000000\n", "7.3333333333\n1.3333333333\n", "9.0000000000\n9.3333333333\n", "7.3333333333\n1.0000000000\n", "6.0000000000\n9.3333333333\n", "11.0000000000\n3.0000000000\n", "15.0000000000\n6.6666666667\n", "2.0000000000\n7.3333333333\n", "8.0000000000\n6.6666666667\n", "17.0000000000\n6.6666666667\n", "11.0000000000\n11.3333333333\n", "14.0000000000\n4.6666666667\n", "11.0000000000\n2.6666666667\n", "11.0000000000\n2.0000000000\n", "6.9333333333\n0.0000000000\n", "8.0000000000\n7.3333333333\n", "7.0000000000\n7.3333333333\n", "1.0000000000\n7.3333333333\n", "4.6666666667\n6.6666666667\n", "9.0000000000\n11.0000000000\n", "6.0000000000\n4.6666666667\n", "11.0000000000\n5.3333333333\n", "14.0000000000\n2.0000000000\n", "2.5000000000\n6.6666666667\n", "7.4666666667\n0.0000000000\n", "9.0000000000\n8.6666666667\n", "7.3333333333\n0.0000000000\n", "17.0000000000\n2.0000000000\n", "5.3333333333\n6.6666666667\n", "4.5000000000\n11.0000000000\n", "6.0000000000\n6.6666666667\n", "12.0000000000\n5.3333333333\n", "8.0000000000\n2.0000000000\n", "4.0000000000\n5.5000000000\n", "11.0000000000\n4.0000000000\n", "5.3333333333\n4.0000000000\n", "4.5000000000\n9.0000000000\n", "8.0000000000\n3.0000000000\n", "7.3333333333\n0.5000000000\n", "2.5000000000\n5.5000000000\n", "4.0000000000\n4.0000000000\n", "7.0000000000\n11.3333333333\n", "4.0000000000\n9.0000000000\n", "8.0000000000\n10.0000000000\n", "18.0000000000\n3.0000000000\n", "10.0000000000\n5.3333333333\n", "8.0000000000\n1.0000000000\n", "6.4000000000\n0.0000000000\n", "5.5000000000\n0.5000000000\n", "2.5000000000\n7.0000000000\n", "10.0000000000\n2.0000000000\n", "4.0000000000\n4.6666666667\n", "12.0000000000\n10.0000000000\n", "9.0000000000\n3.0000000000\n", "10.0000000000\n7.0000000000\n", "9.0000000000\n1.0000000000\n", "4.0000000000\n6.6666666667\n", "10.0000000000\n3.0000000000\n", "6.0000000000\n0.5000000000\n", "4.5000000000\n6.6666666667\n", "7.5000000000\n3.0000000000\n", "4.5000000000\n11.3333333333\n", "6.0000000000\n1.0000000000\n", "17.0000000000\n10.0000000000\n", "9.0000000000\n2.0000000000\n", "7.0000000000\n1.0000000000\n", "5.8666666667\n0.0000000000\n", "7.5000000000\n1.0000000000\n", "12.0000000000\n1.0000000000\n", "4.5000000000\n10.6666666667\n", "2.1333333333\n0.0000000000\n", "5.0000000000\n10.6666666667\n", "2.8000000000\n0.0000000000\n", "12.0000000000\n1.5000000000\n", "5.0000000000\n10.0000000000\n", "4.0000000000\n0.0000000000\n", "19.0000000000\n1.5000000000\n", "3.5000000000\n10.0000000000\n", "21.5000000000\n1.5000000000\n", "22.5000000000\n1.5000000000\n", "22.5000000000\n1.0000000000\n", "22.5000000000\n0.5000000000\n", "8.0000000000\n0.5000000000\n", "10.6666666667\n0.5000000000\n", "12.0000000000\n0.5000000000\n", "7.0000000000\n6.6666666667\n", "7.3333333333\n11.0000000000\n"]}", "style": "rule"} | 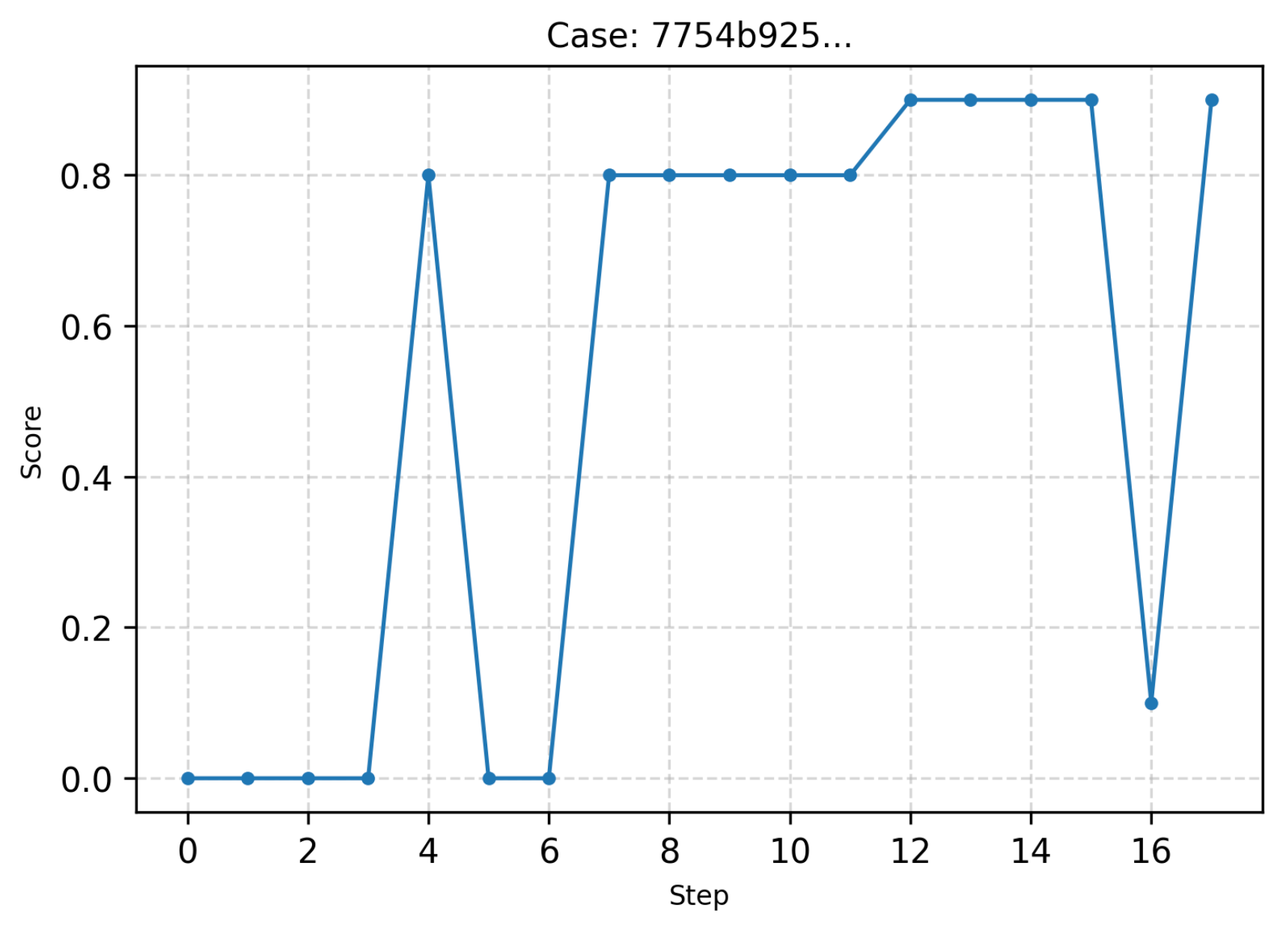 |
滑动窗口+前缀和 | [{"content": " When tackling complex reasoning tasks, you have access to the following actions. Use them as needed to progress through your thought process. [ASSESS] [ADVANCE] [VERIFY] [SIMPLIFY] [SYNTHESIZE] [PIVOT] [OUTPUT] You should strictly follow the format below: [ACTION NAME] # Your action step 1 # Your action step 2 # Your action step 3 ... Next action: [NEXT ACTION NAME] ", "role": "system"},{"content": "We get more and more news about DDoS-attacks of popular websites. Arseny is an admin and he thinks that a website is under a DDoS-attack if the total number of requests for a some period of time exceeds 100 ⋅ t, where t — the number of seconds in this time segment. Arseny knows statistics on the number of requests per second since the server is booted. He knows the sequence r_1, r_2, ..., r_n, where r_i — the number of requests in the i-th second after boot. Determine the length of the longest continuous period of time, which Arseny considers to be a DDoS-attack. A seeking time period should not go beyond the boundaries of the segment [1, n]. Input The first line contains n (1 ≤ n ≤ 5000) — number of seconds since server has been booted. The second line contains sequence of integers r_1, r_2, ..., r_n (0 ≤ r_i ≤ 5000), r_i — number of requests in the i-th second. Output Print the only integer number — the length of the longest time period which is considered to be a DDoS-attack by Arseny. If it doesn't exist print 0. Examples Input 5 100 200 1 1 1 Output 3 Input 5 1 2 3 4 5 Output 0 Input 2 101 99 Output 1 Write Python code to solve the problem. Present the code in ```python Your code ``` at the end.", "role": "user"}] | {"ground_truth": "{"inputs": ["5\n100 200 1 1 1\n", "5\n1 2 3 4 5\n", "2\n101 99\n", "1\n4657\n", "1\n4660\n", "1\n4669\n", "1\n101\n", "1\n4673\n", "40\n81 222 69 50 73 51 78 94 17 69 17 54 13 59 44 291 3 67 293 32 7 155 29 49 170 69 72 56 62 94 34 194 58 32 42 27 46 56 8 46\n", "1\n4664\n", "100\n87 56 98 29 1 51 101 7 56 65 76 31 7 24 42 42 49 43 7 94 40 19 90 36 37 83 3 13 16 0 80 61 8 12 68 261 28 61 30 57 74 13 47 38 22 71 19 7 6 19 81 9 35 8 42 80 34 6 57 21 120 36 20 85 11 2 39 72 36 210 44 72 58 97 155 71 110 89 86 83 54 82 65 55 75 95 15 84 3 48 28 98 31 83 58 270 193 13 99 65\n", "10\n33 202 11 64 5 295 34 25 89 50\n", "10\n58 10 43 61 64 6 39 199 46 29\n", "100\n23 92 34 28 215 18 48 18 72 20 118 62 32 26 20 138 32 78 31 8 30 75 18 16 25 22 56 44 97 36 89 1 61 156 296 56 7 98 51 72 38 74 19 15 75 77 239 72 69 15 62 7 27 93 48 299 25 79 33 52 103 12 71 14 24 25 83 74 46 80 151 61 33 270 2 281 28 56 92 7 46 47 227 34 89 77 85 29 63 62 292 21 59 82 35 19 27 43 81 8\n", "1\n4672\n", "1\n4675\n", "30\n67 3 99 36 53 9 17 55 63 7 42 3 42 10 67 97 65 266 65 17 52 76 17 47 269 159 24 12 64 40\n", "3\n150 1 150\n", "100\n102 0 87 79 84 62 74 66 0 16 24 67 11 42 33 67 61 81 31 79 105 87 23 13 27 51 90 93 81 70 96 34 74 28 9 41 241 79 11 41 182 68 78 55 19 52 30 33 66 41 5 94 204 67 24 78 80 178 41 266 8 242 65 2 38 28 16 61 150 97 87 87 65 55 11 37 85 62 55 36 94 68 41 86 53 84 66 60 37 8 43 87 182 5 76 97 51 27 53 37\n", "3\n101 99 101\n", "1\n4659\n", "100\n70 111 5 73 69 22 79 62 101 99 249 88 75 31 27 49 7 36 37 62 61 77 75 38 203 61 81 43 98 224 114 48 98 8 67 46 80 83 81 64 15 72 95 39 79 93 79 140 27 65 67 44 294 170 89 97 73 48 18 53 31 49 47 13 88 70 5 46 256 81 26 9 89 38 43 28 219 30 10 71 96 95 241 96 98 96 82 29 219 85 52 34 54 74 86 66 71 10 224 48\n", "100\n50 56 71 73 46 29 46 77 3 59 85 14 13 9 44 33 186 56 240 51 95 39 91 83 48 33 40 94 30 4 91 36 68 64 6 45 84 87 98 90 34 29 25 74 52 54 17 35 41 177 92 53 31 26 94 89 94 94 98 56 68 11 24 53 81 59 52 36 49 14 89 56 6 132 14 71 49 201 97 75 86 20 61 24 2 14 15 56 69 10 88 38 91 258 35 38 90 57 51 142\n", "1\n4676\n", "100\n46 46 59 0 207 29 58 56 35 43 80 26 20 199 51 200 59 73 83 62 78 37 81 44 12 193 20 55 188 34 22 59 122 80 60 47 265 29 8 49 63 2 220 283 73 3 69 30 30 23 41 47 95 58 9 79 74 65 21 61 90 11 96 21 80 242 84 9 43 90 69 108 241 21 80 148 7 76 66 6 79 99 25 71 89 80 58 17 154 84 38 29 74 257 193 39 95 91 8 23\n", "1\n41\n", "20\n46 291 21 20 60 47 47 43 243 78 75 44 41 54 11 79 47 93 268 3\n", "2\n5000 99\n", "100\n84 48 28 34 51 82 90 98 52 207 68 64 91 60 44 178 81 25 1 29 4 94 0 78 202 84 65 38 51 69 91 68 4 74 21 62 28 20 5 99 80 12 44 61 68 72 21 31 90 24 16 17 22 61 47 95 11 9 85 90 16 40 81 28 262 2 27 31 153 82 99 0 6 30 31 17 46 56 23 80 94 13 242 36 97 41 279 59 54 45 96 89 69 28 95 87 30 60 90 24\n", "100\n3 43 79 29 23 78 24 93 85 4 16 73 80 7 53 13 63 1 98 43 11 25 33 99 23 0 42 19 31 13 1 88 77 8 75 173 77 13 87 85 37 44 79 64 27 22 6 88 80 12 81 108 12 96 121 44 29 89 161 55 28 93 41 40 51 0 47 17 6 30 99 89 42 186 29 0 32 219 53 58 24 1 51 256 22 29 13 23 82 73 96 262 10 71 99 48 54 58 67 11\n", "3\n101 1 199\n", "1\n4654\n", "1\n4653\n", "2\n1 103\n", "1\n4658\n", "1\n4668\n", "2\n300 0\n", "1\n4663\n", "100\n75 163 55 76 211 11 15 43 57 235 53 2 208 49 87 95 60 296 62 151 36 55 14 64 16 30 74 92 81 287 19 41 16 14 7 29 94 87 84 93 70 23 47 66 82 93 76 53 23 94 0 96 82 23 52 9 17 98 88 74 62 33 12 55 78 94 6 70 59 7 126 98 51 97 3 273 75 53 78 10 89 13 198 33 94 283 34 10 75 88 73 67 41 19 75 60 38 24 94 2\n", "1\n4671\n", "2\n1 91\n", "1\n4677\n", "1\n4670\n", "2\n200 200\n", "1\n4667\n", "100\n214 96 67 98 4 61 1 82 1 31 98 49 32 60 4 33 80 95 78 33 20 13 35 82 25 240 85 42 239 74 19 17 22 83 14 99 169 223 52 90 32 62 19 50 86 86 31 74 25 3 85 36 71 188 77 4 42 256 34 67 81 91 11 94 58 77 21 26 80 25 65 78 37 40 62 97 29 48 77 45 18 19 151 80 123 43 94 63 279 50 182 27 83 53 91 48 230 91 141 162\n", "1\n4666\n", "1\n4674\n", "10\n155 9 196 23 79 89 25 194 86 57\n", "1\n4656\n", "1\n4655\n", "1\n9135\n", "1\n001\n", "40\n81 303 69 50 73 51 78 94 17 69 17 54 13 59 44 291 3 67 293 32 7 155 29 49 170 69 72 56 62 94 34 194 58 32 42 27 46 56 8 46\n", "100\n87 56 98 29 1 51 101 7 56 65 76 31 7 24 42 42 49 43 7 94 40 19 90 36 37 83 3 13 16 0 80 61 8 12 68 261 28 61 30 57 74 13 47 38 22 71 19 7 6 19 81 9 35 8 42 80 34 6 57 21 120 36 20 85 11 2 39 72 36 210 44 72 58 97 155 71 110 89 86 83 54 82 65 55 75 95 15 84 3 48 28 98 39 83 58 270 193 13 99 65\n", "10\n33 202 11 64 5 295 34 31 89 50\n", "10\n58 10 43 61 64 6 39 199 2 29\n", "100\n23 92 34 28 215 18 48 18 72 20 118 62 32 26 20 138 32 78 31 8 30 75 18 16 25 22 56 44 97 36 89 1 61 156 296 56 7 98 51 72 38 74 19 15 75 77 239 72 95 15 62 7 27 93 48 299 25 79 33 52 103 12 71 14 24 25 83 74 46 80 151 61 33 270 2 281 28 56 92 7 46 47 227 34 89 77 85 29 63 62 292 21 59 82 35 19 27 43 81 8\n", "3\n150 1 178\n", "100\n70 111 5 73 69 22 79 62 101 99 249 88 75 31 27 49 7 36 37 62 61 77 75 38 203 61 81 43 98 224 114 48 98 8 67 46 80 83 81 64 15 72 95 39 79 93 79 140 27 65 67 44 294 170 89 97 73 48 18 53 31 49 47 13 88 70 5 46 256 81 26 9 89 38 43 28 219 30 4 71 96 95 241 96 98 96 82 29 219 85 52 34 54 74 86 66 71 10 224 48\n", "100\n50 56 71 73 46 29 46 77 3 59 85 14 13 9 44 33 186 56 17 51 95 39 91 83 48 33 40 94 30 4 91 36 68 64 6 45 84 87 98 90 34 29 25 74 52 54 17 35 41 177 92 53 31 26 94 89 94 94 98 56 68 11 24 53 81 59 52 36 49 14 89 56 6 132 14 71 49 201 97 75 86 20 61 24 2 14 15 56 69 10 88 38 91 258 35 38 90 57 51 142\n", "100\n84 48 28 34 51 82 90 98 52 207 68 64 91 60 44 178 81 25 1 29 4 94 0 78 202 84 65 38 51 69 91 68 4 74 21 62 28 20 5 99 80 12 44 61 68 72 21 31 90 24 11 17 22 61 47 95 11 9 85 90 16 40 81 28 262 2 27 31 153 82 99 0 6 30 31 17 46 56 23 80 94 13 242 36 97 41 279 59 54 45 96 89 69 28 95 87 30 60 90 24\n", "100\n75 163 55 76 211 11 15 43 57 235 53 2 208 49 87 95 60 296 62 151 36 55 14 64 16 30 74 92 81 287 19 41 16 14 7 29 94 87 84 93 70 23 47 66 82 93 76 53 23 94 0 96 82 23 52 9 17 98 88 74 62 33 12 55 78 94 6 70 59 7 126 98 51 97 3 273 75 53 78 10 89 13 198 33 94 283 34 10 75 88 73 67 41 19 75 46 38 24 94 2\n", "100\n70 111 5 73 69 22 79 62 101 99 249 88 75 31 27 49 7 36 37 62 61 77 75 38 203 61 81 43 98 224 114 48 98 8 67 46 80 83 81 64 15 72 95 39 79 93 79 140 27 65 67 44 294 170 89 97 73 48 18 53 31 49 47 13 88 70 5 46 256 81 26 9 89 38 43 28 219 30 4 71 96 95 241 96 98 96 82 29 219 165 52 34 54 74 86 66 71 10 224 48\n", "1\n1921\n", "1\n1323\n", "1\n8979\n", "1\n1072\n", "1\n8999\n", "1\n3480\n", "30\n67 3 99 36 53 9 17 55 63 7 42 3 42 10 67 97 65 266 65 17 52 76 17 47 372 159 24 12 64 40\n", "100\n102 0 87 79 84 62 74 66 0 16 24 67 11 42 33 67 61 81 31 79 105 87 23 13 27 51 90 93 81 70 96 34 74 28 9 41 241 79 11 41 182 68 78 55 19 52 30 33 66 41 5 94 204 67 24 78 80 178 41 266 8 242 65 2 38 28 16 78 150 97 87 87 65 55 11 37 85 62 55 36 94 68 41 86 53 84 66 60 37 8 43 87 182 5 76 97 51 27 53 37\n", "3\n101 83 101\n", "1\n4661\n", "1\n9310\n", "100\n46 46 59 0 207 29 58 56 35 43 80 26 20 199 51 200 59 73 83 62 78 37 81 44 12 193 20 55 188 34 22 59 122 80 60 47 265 42 8 49 63 2 220 283 73 3 69 30 30 23 41 47 95 58 9 79 74 65 21 61 90 11 96 21 80 242 84 9 43 90 69 108 241 21 80 148 7 76 66 6 79 99 25 71 89 80 58 17 154 84 38 29 74 257 193 39 95 91 8 23\n", "1\n75\n", "20\n46 291 21 20 60 47 47 43 243 78 75 44 41 54 11 79 47 108 268 3\n", "2\n5000 30\n", "100\n3 43 79 29 23 78 24 93 85 4 16 73 80 7 53 13 63 1 98 43 11 25 33 99 23 0 42 19 31 13 1 88 77 8 75 173 77 13 87 85 37 21 79 64 27 22 6 88 80 12 81 108 12 96 121 44 29 89 161 55 28 93 41 40 51 0 47 17 6 30 99 89 42 186 29 0 32 219 53 58 24 1 51 256 22 29 13 23 82 73 96 262 10 71 99 48 54 58 67 11\n", "3\n100 1 199\n", "1\n4729\n", "1\n1867\n", "2\n0 103\n", "1\n4145\n", "1\n6543\n", "2\n533 0\n", "1\n1283\n", "1\n2364\n", "2\n1 133\n", "1\n2323\n", "1\n2742\n", "2\n33 200\n", "1\n5312\n", "100\n214 96 67 98 4 61 1 82 1 31 98 49 32 60 4 33 80 95 78 33 20 13 52 82 25 240 85 42 239 74 19 17 22 83 14 99 169 223 52 90 32 62 19 50 86 86 31 74 25 3 85 36 71 188 77 4 42 256 34 67 81 91 11 94 58 77 21 26 80 25 65 78 37 40 62 97 29 48 77 45 18 19 151 80 123 43 94 63 279 50 182 27 83 53 91 48 230 91 141 162\n", "1\n6554\n", "1\n4059\n", "10\n155 9 196 23 79 89 25 194 63 57\n", "1\n3630\n", "1\n5677\n", "5\n100 200 1 1 2\n", "5\n1 2 3 4 0\n", "2\n101 96\n", "1\n16028\n", "1\n1427\n", "1\n1494\n", "1\n000\n", "1\n7811\n", "40\n81 303 69 50 73 51 95 94 17 69 17 54 13 59 44 291 3 67 293 32 7 155 29 49 170 69 72 56 62 94 34 194 58 32 42 27 46 56 8 46\n", "1\n2005\n", "100\n87 56 98 29 1 51 101 7 56 65 76 31 7 24 42 42 49 43 7 94 40 19 90 66 37 83 3 13 16 0 80 61 8 12 68 261 28 61 30 57 74 13 47 38 22 71 19 7 6 19 81 9 35 8 42 80 34 6 57 21 120 36 20 85 11 2 39 72 36 210 44 72 58 97 155 71 110 89 86 83 54 82 65 55 75 95 15 84 3 48 28 98 39 83 58 270 193 13 99 65\n", "10\n33 202 11 64 5 295 41 31 89 50\n", "10\n58 10 43 61 104 6 39 199 2 29\n", "100\n23 92 34 28 215 18 48 18 72 20 118 62 32 26 20 138 32 78 31 8 30 75 18 16 25 22 56 44 97 36 89 1 61 156 296 56 7 98 51 72 38 74 19 15 75 77 239 72 95 15 62 7 27 93 48 299 25 79 33 52 103 12 71 14 24 25 83 74 46 80 151 61 33 270 2 281 28 56 92 7 46 47 227 34 89 77 85 29 63 62 292 21 59 110 35 19 27 43 81 8\n", "1\n654\n", "1\n6845\n", "30\n67 3 153 36 53 9 17 55 63 7 42 3 42 10 67 97 65 266 65 17 52 76 17 47 372 159 24 12 64 40\n", "3\n150 0 178\n", "100\n102 0 87 79 84 62 74 66 0 16 24 67 11 42 33 67 61 81 31 79 105 87 23 13 27 51 90 93 81 70 96 34 74 28 9 41 241 79 11 41 182 68 78 55 19 52 30 33 66 41 5 94 204 67 24 78 80 178 41 266 8 242 65 2 38 28 16 78 150 97 87 87 65 55 11 37 85 62 55 36 94 35 41 86 53 84 66 60 37 8 43 87 182 5 76 97 51 27 53 37\n", "3\n001 83 101\n", "1\n8157\n", "100\n50 56 71 73 46 29 46 77 3 59 85 14 13 9 44 33 186 56 17 51 95 39 91 83 48 33 40 94 30 4 91 36 68 64 6 45 84 87 98 90 34 29 25 74 52 54 4 35 41 177 92 53 31 26 94 89 94 94 98 56 68 11 24 53 81 59 52 36 49 14 89 56 6 132 14 71 49 201 97 75 86 20 61 24 2 14 15 56 69 10 88 38 91 258 35 38 90 57 51 142\n", "1\n11459\n", "100\n46 46 59 0 207 29 58 56 35 43 80 26 20 199 51 200 59 73 83 62 78 37 81 44 12 193 20 55 188 34 22 59 122 80 60 47 265 42 8 49 63 2 220 283 73 3 69 30 30 23 41 47 95 58 9 79 74 65 21 61 90 11 96 21 80 242 84 9 43 90 69 108 241 35 80 148 7 76 66 6 79 99 25 71 89 80 58 17 154 84 38 29 74 257 193 39 95 91 8 23\n", "1\n126\n", "20\n46 291 21 20 60 47 47 40 243 78 75 44 41 54 11 79 47 108 268 3\n", "2\n6130 30\n", "100\n84 48 28 34 51 82 90 98 52 207 68 64 91 60 44 178 81 25 1 29 4 94 0 78 202 84 65 38 51 69 91 68 4 74 21 62 28 20 5 99 80 12 44 61 68 72 21 31 90 24 11 17 22 61 47 95 11 9 85 90 16 40 81 28 262 2 27 31 153 53 99 0 6 30 31 17 46 56 23 80 94 13 242 36 97 41 279 59 54 45 96 89 69 28 95 87 30 60 90 24\n", "100\n3 43 79 29 23 78 24 93 85 4 16 73 80 7 53 13 63 1 98 43 11 25 33 99 23 0 42 19 31 13 1 88 77 8 75 173 77 13 87 85 37 21 79 64 27 22 6 88 80 12 81 108 12 96 121 44 29 89 161 55 33 93 41 40 51 0 47 17 6 30 99 89 42 186 29 0 32 219 53 58 24 1 51 256 22 29 13 23 82 73 96 262 10 71 99 48 54 58 67 11\n", "3\n100 1 273\n", "1\n5748\n", "1\n2851\n", "2\n0 183\n", "1\n6831\n", "1\n7402\n", "2\n87 0\n", "1\n463\n", "100\n75 163 55 76 211 11 15 43 57 235 53 2 208 49 87 95 60 296 62 151 36 55 13 64 16 30 74 92 81 287 19 41 16 14 7 29 94 87 84 93 70 23 47 66 82 93 76 53 23 94 0 96 82 23 52 9 17 98 88 74 62 33 12 55 78 94 6 70 59 7 126 98 51 97 3 273 75 53 78 10 89 13 198 33 94 283 34 10 75 88 73 67 41 19 75 46 38 24 94 2\n", "1\n783\n", "2\n1 29\n", "1\n301\n", "1\n107\n", "2\n64 200\n", "1\n2918\n", "100\n214 96 67 98 4 61 1 82 1 31 98 49 32 60 7 33 80 95 78 33 20 13 52 82 25 240 85 42 239 74 19 17 22 83 14 99 169 223 52 90 32 62 19 50 86 86 31 74 25 3 85 36 71 188 77 4 42 256 34 67 81 91 11 94 58 77 21 26 80 25 65 78 37 40 62 97 29 48 77 45 18 19 151 80 123 43 94 63 279 50 182 27 83 53 91 48 230 91 141 162\n", "1\n3924\n", "1\n7810\n", "10\n155 9 196 23 79 35 25 194 63 57\n", "1\n6489\n", "1\n561\n", "5\n000 200 1 1 2\n"], "outputs": ["3\n", "0\n", "1\n", "1\n", "1\n", "1\n", "1\n", "1\n", "12\n", "1\n", "9\n", "6\n", "2\n", "13\n", "1\n", "1\n", "11\n", "3\n", "13\n", "3\n", "1\n", "15\n", "8\n", "1\n", "13\n", "0\n", "4\n", "2\n", "11\n", "6\n", "3\n", "1\n", "1\n", "1\n", "1\n", "1\n", "2\n", "1\n", "20\n", "1\n", "0\n", "1\n", "1\n", "2\n", "1\n", "20\n", "1\n", "1\n", "6\n", "1\n", "1\n", "1\n", "0\n", "12\n", "9\n", "6\n", "2\n", "13\n", "3\n", "15\n", "5\n", "11\n", "20\n", "16\n", "1\n", "1\n", "1\n", "1\n", "1\n", "1\n", "13\n", "13\n", "1\n", "1\n", "1\n", "13\n", "0\n", "5\n", "2\n", "6\n", "1\n", "1\n", "1\n", "1\n", "1\n", "1\n", "2\n", "1\n", "1\n", "1\n", "1\n", "1\n", "2\n", "1\n", "20\n", "1\n", "1\n", "6\n", "1\n", "1\n", "3\n", "0\n", "1\n", "1\n", "1\n", "1\n", "0\n", "1\n", "12\n", "1\n", "9\n", "6\n", "2\n", "13\n", "1\n", "1\n", "13\n", "3\n", "13\n", "1\n", "1\n", "5\n", "1\n", "13\n", "1\n", "5\n", "2\n", "11\n", "6\n", "3\n", "1\n", "1\n", "1\n", "1\n", "1\n", "0\n", "1\n", "20\n", "1\n", "0\n", "1\n", "1\n", "2\n", "1\n", "20\n", "1\n", "1\n", "3\n", "1\n", "1\n", "2\n"]}", "style": "rule"} | 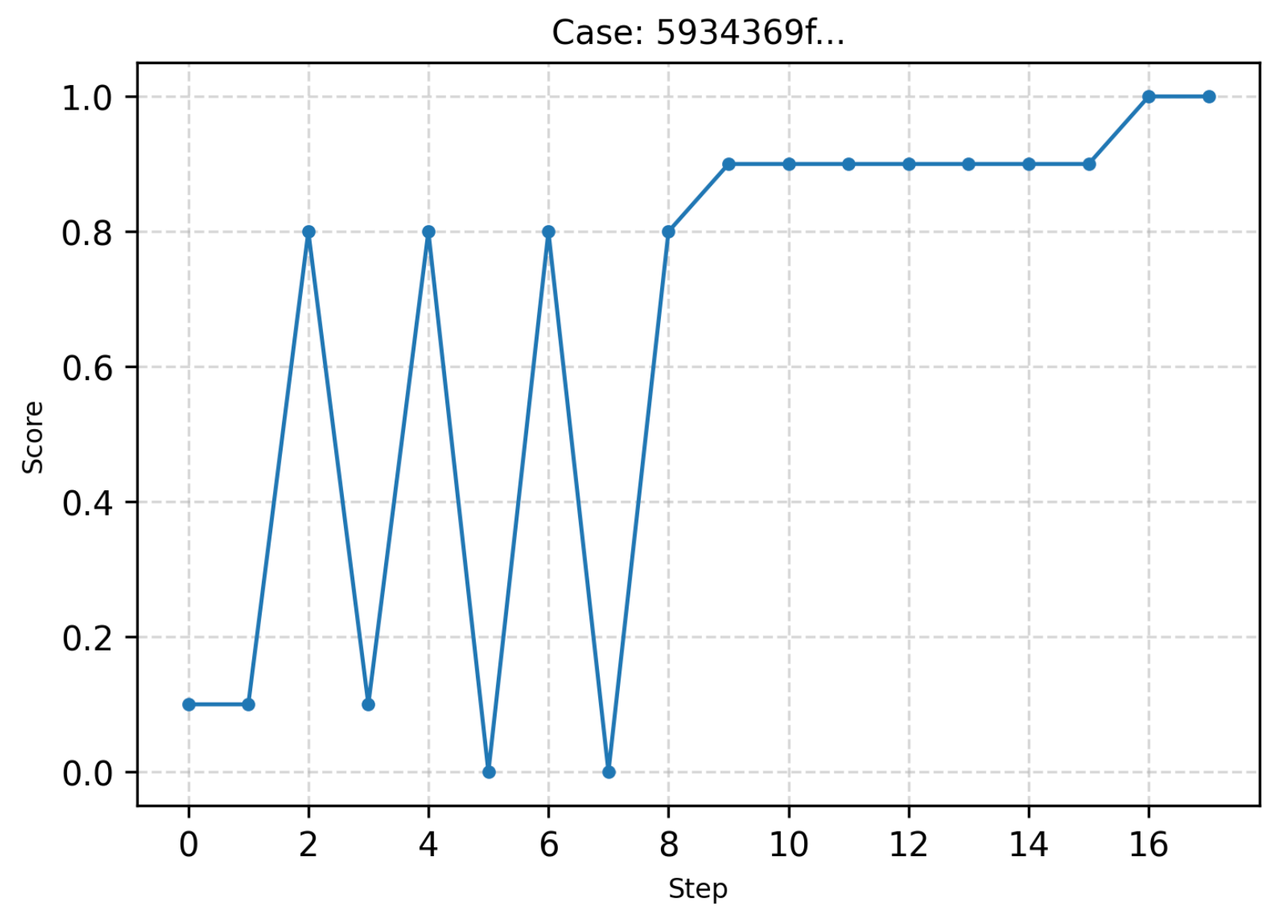 |
*困难题 *3
*
困难题 *3
考察点 | 题面 | 样例 | 训练过程score变化(轮数较少) |
考察点 | 题面 | 样例 | 训练过程score变化(轮数较少) |
图论+动态规划 | [{"content": " When tackling complex reasoning tasks, you have access to the following actions. Use them as needed to progress through your thought process. [ASSESS] [ADVANCE] [VERIFY] [SIMPLIFY] [SYNTHESIZE] [PIVOT] [OUTPUT] You should strictly follow the format below: [ACTION NAME] # Your action step 1 # Your action step 2 # Your action step 3 ... Next action: [NEXT ACTION NAME] ", "role": "system"},{"content": "Pashmak's homework is a problem about graphs. Although he always tries to do his homework completely, he can't solve this problem. As you know, he's really weak at graph theory; so try to help him in solving the problem. You are given a weighted directed graph with n vertices and m edges. You need to find a path (perhaps, non-simple) with maximum number of edges, such that the weights of the edges increase along the path. In other words, each edge of the path must have strictly greater weight than the previous edge in the path. Help Pashmak, print the number of edges in the required path. Input The first line contains two integers n, m (2 ≤ n ≤ 3·105; 1 ≤ m ≤ min(n·(n - 1), 3·105)). Then, m lines follows. The i-th line contains three space separated integers: ui, vi, wi (1 ≤ ui, vi ≤ n; 1 ≤ wi ≤ 105) which indicates that there's a directed edge with weight wi from vertex ui to vertex vi. It's guaranteed that the graph doesn't contain self-loops and multiple edges. Output Print a single integer — the answer to the problem. Examples Input 3 3 1 2 1 2 3 1 3 1 1 Output 1 Input 3 3 1 2 1 2 3 2 3 1 3 Output 3 Input 6 7 1 2 1 3 2 5 2 4 2 2 5 2 2 6 9 5 4 3 4 3 4 Output 6 Note In the first sample the maximum trail can be any of this trails: <image>. In the second sample the maximum trail is <image>. In the third sample the maximum trail is <image>. Write Python code to solve the problem. Present the code in ```python Your code ``` at the end.", "role": "user"}] | {"ground_truth": "{"inputs": ["6 7\n1 2 1\n3 2 5\n2 4 2\n2 5 2\n2 6 9\n5 4 3\n4 3 4\n", "3 3\n1 2 1\n2 3 1\n3 1 1\n", "3 3\n1 2 1\n2 3 2\n3 1 3\n", "6 7\n1 2 1\n1 5 1\n5 2 3\n2 3 3\n3 4 4\n1 6 1\n6 2 3\n", "3 6\n1 2 1\n2 3 1\n3 1 1\n2 1 2\n3 2 4\n1 3 3\n", "2 2\n1 2 1\n2 1 2\n", "4 3\n1 2 1\n2 3 1\n3 4 2\n", "4 3\n1 2 1\n3 4 1\n2 1 2\n", "5 5\n1 2 3\n1 3 3\n2 3 4\n3 4 4\n4 5 5\n", "4 12\n1 2 2\n2 1 2\n1 3 1\n3 1 1\n1 4 1\n4 1 1\n2 3 1\n3 2 1\n2 4 1\n4 2 1\n3 4 2\n4 3 2\n", "5 8\n1 2 1\n2 3 1\n3 4 1\n4 5 1\n1 5 1\n1 3 2\n2 4 2\n3 5 3\n", "3 4\n1 2 1\n2 1 2\n2 3 2\n3 1 3\n", "3 3\n1 2 1\n1 3 2\n3 2 3\n", "6 7\n1 2 1\n1 1 1\n5 2 3\n2 3 3\n3 4 4\n1 6 1\n6 2 3\n", "3 6\n1 2 1\n2 3 1\n3 1 2\n2 1 2\n3 2 4\n1 3 3\n", "2 2\n2 2 1\n2 1 2\n", "4 3\n1 3 1\n3 4 1\n2 1 2\n", "6 7\n1 2 1\n3 2 5\n2 4 0\n2 5 2\n2 6 9\n5 4 3\n4 3 4\n", "6 7\n1 2 2\n3 2 5\n2 4 0\n2 5 2\n2 6 9\n5 4 3\n4 3 4\n", "5 12\n1 2 2\n2 1 2\n1 3 1\n3 1 1\n1 4 1\n4 1 1\n2 3 1\n3 2 1\n2 4 1\n4 2 1\n3 4 2\n4 3 2\n", "8 8\n1 2 1\n2 3 1\n3 4 1\n4 5 1\n1 5 1\n1 3 2\n2 4 2\n3 5 3\n", "3 3\n1 2 0\n1 3 2\n3 2 3\n", "5 3\n1 2 1\n2 3 2\n3 1 3\n", "6 7\n1 2 1\n1 1 1\n5 2 3\n2 3 3\n3 4 5\n1 6 1\n6 2 3\n", "3 6\n1 2 1\n2 3 1\n3 1 2\n2 1 2\n3 2 7\n1 3 3\n", "4 3\n1 3 1\n3 4 1\n4 1 2\n", "5 12\n1 2 2\n2 1 2\n1 3 1\n3 1 1\n2 4 1\n4 1 1\n2 3 1\n3 2 1\n2 4 1\n4 2 1\n3 4 2\n4 3 2\n", "8 8\n1 2 1\n2 3 1\n3 4 1\n4 5 1\n1 5 1\n1 3 2\n2 4 3\n3 5 3\n", "3 3\n1 2 0\n1 3 2\n3 1 3\n", "5 3\n1 2 1\n1 3 2\n3 1 3\n", "4 3\n2 3 1\n3 4 1\n4 1 2\n", "5 3\n1 2 1\n1 3 2\n2 1 3\n", "5 3\n1 2 1\n2 3 2\n2 1 3\n", "5 3\n1 2 1\n2 3 4\n2 1 3\n", "5 3\n1 2 2\n2 3 4\n2 1 3\n", "5 3\n1 4 2\n2 3 4\n2 1 3\n", "5 3\n1 4 2\n2 3 4\n2 2 3\n", "5 3\n1 4 2\n2 3 3\n2 2 3\n", "6 7\n1 2 1\n1 5 1\n5 2 3\n2 3 3\n3 4 4\n1 6 1\n5 2 3\n", "4 3\n1 2 1\n2 3 1\n2 4 2\n", "4 3\n1 2 1\n3 4 1\n2 2 2\n", "5 5\n1 2 3\n1 3 3\n2 3 4\n3 4 4\n4 3 5\n", "4 12\n1 2 2\n2 1 2\n1 3 2\n3 1 1\n1 4 1\n4 1 1\n2 3 1\n3 2 1\n2 4 1\n4 2 1\n3 4 2\n4 3 2\n", "6 7\n1 2 1\n3 2 5\n2 4 2\n2 5 2\n2 6 3\n5 4 3\n4 3 4\n", "6 7\n1 2 1\n1 1 1\n5 2 3\n2 3 3\n3 4 4\n1 3 1\n6 2 3\n", "3 6\n1 2 1\n2 3 1\n3 1 2\n2 1 1\n3 2 4\n1 3 3\n", "10 12\n1 2 2\n2 1 2\n1 3 1\n3 1 1\n1 4 1\n4 1 1\n2 3 1\n3 2 1\n2 4 1\n4 2 1\n3 4 2\n4 3 2\n", "8 8\n1 2 1\n2 3 1\n3 4 1\n4 5 1\n1 5 1\n1 3 2\n2 6 2\n3 5 3\n", "3 3\n1 2 0\n1 3 2\n3 2 4\n", "6 7\n1 2 1\n3 2 5\n2 4 0\n2 5 2\n1 6 9\n5 4 3\n4 3 4\n", "6 7\n1 2 1\n1 1 1\n5 2 3\n2 3 1\n3 4 5\n1 6 1\n6 2 3\n", "5 12\n1 2 2\n2 1 2\n1 3 1\n3 1 1\n2 4 1\n4 1 1\n2 3 1\n3 3 1\n2 4 1\n4 2 1\n3 4 2\n4 3 2\n", "3 3\n1 2 0\n1 2 2\n3 2 3\n"], "outputs": ["6\n", "1\n", "3\n", "3\n", "4\n", "2\n", "2\n", "2\n", "3\n", "2\n", "2\n", "3\n", "2\n", "3\n", "4\n", "2\n", "1\n", "6\n", "5\n", "2\n", "2\n", "2\n", "3\n", "3\n", "4\n", "2\n", "2\n", "2\n", "2\n", "2\n", "2\n", "2\n", "2\n", "2\n", "2\n", "1\n", "2\n", "1\n", "3\n", "2\n", "2\n", "3\n", "2\n", "5\n", "3\n", "4\n", "2\n", "2\n", "2\n", "5\n", "2\n", "2\n", "1\n"]}", "style": "rule"} | 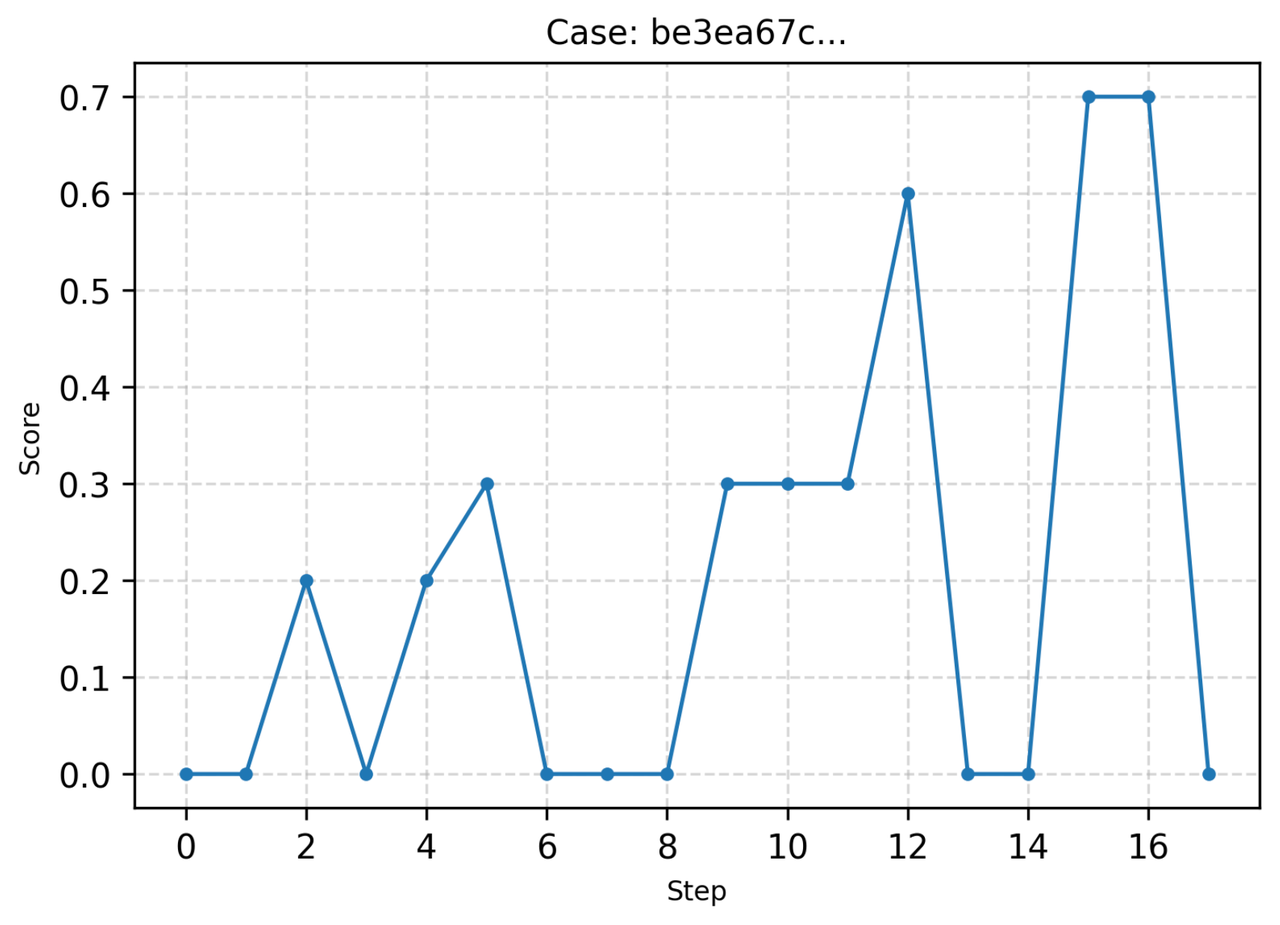 |
二维动态规划 | [{"content": " When tackling complex reasoning tasks, you have access to the following actions. Use them as needed to progress through your thought process. [ASSESS] [ADVANCE] [VERIFY] [SIMPLIFY] [SYNTHESIZE] [PIVOT] [OUTPUT] You should strictly follow the format below: [ACTION NAME] # Your action step 1 # Your action step 2 # Your action step 3 ... Next action: [NEXT ACTION NAME] ", "role": "system"},{"content": "Mirko has a chessboard with $N$ rows and just three columns. Slavica has written an integer on each field. Mirko has $K$ dominoes at his disposal, their dimensions being $2 \times 1$, and has to arrange all of them on the board without overlapping, in a way that each domino covers exactly two fields of the board. He can rotate the dominoes as he please Help Mirko cover the largest sum of numbers possible with the dominoes! -----Input----- The first line of input contains the integer $N$ ($1 \le N \le 1000$), the number of rows, and $K$ ($1 \le K \le 1000$), the number of dominoes available. Each of the following $N$ lines contains three integers written in the $i$’th row of the board. All numbers will be less than $10^6$ in absolute value. -----Output----- The first and only line of output must contain the maximal sum possible to cover with exactly $K$ dominoes. -----Examples----- Sample Input: 5 3 2 1 -1 1 3 2 0 2 3 2 1 1 3 3 0 Sample Output: 16 Write Python code to solve the problem. Present the code in ```python Your code ``` at the end.", "role": "user"}] | {"ground_truth": "{"inputs": ["5 3\n2 1 -1\n1 3 2\n0 2 3\n2 1 1\n3 3 0\n", "2 2\n0 4 1\n3 5 1\n"], "outputs": ["16\n", "13\n"]}", "style": "rule"} | 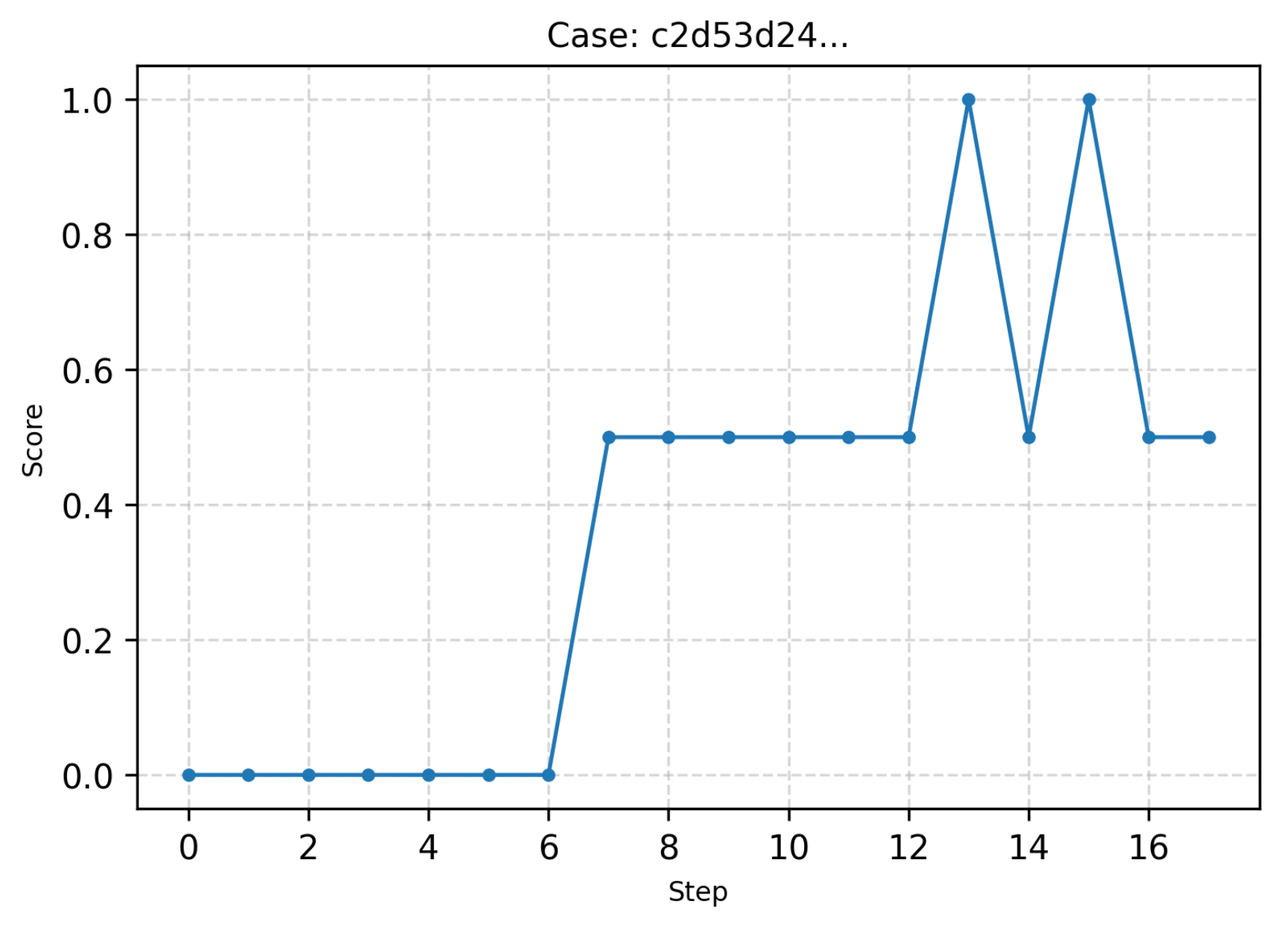 |
棋盘图论 | [{"content": " When tackling complex reasoning tasks, you have access to the following actions. Use them as needed to progress through your thought process. [ASSESS] [ADVANCE] [VERIFY] [SIMPLIFY] [SYNTHESIZE] [PIVOT] [OUTPUT] You should strictly follow the format below: [ACTION NAME] # Your action step 1 # Your action step 2 # Your action step 3 ... Next action: [NEXT ACTION NAME] ", "role": "system"},{"content": "One day Alice was cleaning up her basement when she noticed something very curious: an infinite set of wooden pieces! Each piece was made of five square tiles, with four tiles adjacent to the fifth center tile: <image> By the pieces lay a large square wooden board. The board is divided into n^2 cells arranged into n rows and n columns. Some of the cells are already occupied by single tiles stuck to it. The remaining cells are free. Alice started wondering whether she could fill the board completely using the pieces she had found. Of course, each piece has to cover exactly five distinct cells of the board, no two pieces can overlap and every piece should fit in the board entirely, without some parts laying outside the board borders. The board however was too large for Alice to do the tiling by hand. Can you help determine if it's possible to fully tile the board? Input The first line of the input contains a single integer n (3 ≤ n ≤ 50) — the size of the board. The following n lines describe the board. The i-th line (1 ≤ i ≤ n) contains a single string of length n. Its j-th character (1 ≤ j ≤ n) is equal to "." if the cell in the i-th row and the j-th column is free; it is equal to "#" if it's occupied. You can assume that the board contains at least one free cell. Output Output YES if the board can be tiled by Alice's pieces, or NO otherwise. You can print each letter in any case (upper or lower). Examples Input 3 #.# ... #.# Output YES Input 4 ##.# #... #### ##.# Output NO Input 5 #.### ....# #.... ###.# ##### Output YES Input 5 #.### ....# #.... ....# #..## Output NO Note The following sketches show the example boards and their tilings if such tilings exist: <image> Write Python code to solve the problem. Present the code in ```python Your code ``` at the end.", "role": "user"}] | {"ground_truth": "{"inputs": ["3\n#.#\n...\n#.#\n", "5\n#.###\n....#\n#....\n....#\n#..##\n", "4\n##.#\n#...\n####\n##.#\n", "5\n#.###\n....#\n#....\n###.#\n#####\n", "20\n#.##.##.##.##.##.###\n...................#\n#..#..#..#..#..#....\n#................#.#\n#..#..#..#..#......#\n....................\n#..#..#..#..#......#\n#.............#....#\n#..#..#..#......#..#\n....................\n#..#..#..#......#..#\n#..........#.......#\n#..#..#......#..#..#\n....................\n#..#..#......#..#..#\n#.......#..........#\n#..#......#..#..#..#\n....................\n#.##....#.##.##.##.#\n######.#############\n", "7\n#.....#\n.......\n.......\n.......\n.......\n.......\n#.....#\n", "21\n#########.###.#####.#\n#.####.#........##...\n....#............#..#\n#....#....#..##.#...#\n#.#..##..#....####..#\n.............###.#...\n#.##.##..#.###......#\n###.##.....##.......#\n##...........#..##.##\n#...##.###.#......###\n#....###.##..##.....#\n##....#.......##.....\n#.##.##..##.........#\n....##....###.#.....#\n#....##....##......##\n##..#.###.#........##\n#......#.#.....##..##\n##..#.....#.#...#...#\n#........#.##..##..##\n....##.##......#...##\n#.########.##.###.###\n", "3\n###\n#.#\n###\n", "3\n###\n##.\n#..\n", "3\n###\n#.#\n...\n", "5\n#####\n.####\n..###\n.####\n#####\n", "6\n#.##.#\n......\n#.##.#\n......\n##.###\n#...##\n", "3\n##.\n#..\n.#.\n", "5\n#####\n#####\n#####\n####.\n###..\n", "5\n#.#.#\n##...\n###.#\n#####\n#####\n", "3\n.##\n###\n###\n", "5\n#####\n#####\n#####\n#####\n.....\n", "21\n##.######.###.#####.#\n#...##.#.......#.#...\n##..#...#.....#.....#\n#....#..###.###.....#\n....#....####....#.##\n#..#....##.#....#.###\n#...#.###...#.##....#\n#..#.##.##.##.##.....\n..........##......#.#\n#.##.#......#.#..##.#\n#.##.............#...\n..........#.....##..#\n#.#..###..###.##....#\n#....##....##.#.....#\n....#......#...#.#...\n#.#.........#..##.#.#\n#..........##.......#\n....#....#.##..##....\n#.#.##.#.......##.#.#\n##...##....##.##...##\n###.####.########.###\n", "5\n.....\n.....\n.....\n.....\n.....\n", "3\n.#.\n..#\n.##\n", "3\n...\n#.#\n###\n", "3\n.##\n..#\n.##\n", "3\n..#\n...\n#.#\n", "3\n##.\n#..\n##.\n", "17\n#################\n#################\n#################\n#################\n#################\n#################\n#################\n#################\n#################\n#################\n#################\n#################\n#################\n#################\n#################\n#################\n##.##.##.##.##.##\n", "4\n#..#\n....\n#..#\n####\n", "3\n##.\n###\n###\n", "16\n#####.####.#####\n##.##...##...###\n##....#....#...#\n#..#....#....#..\n#....#....#....#\n#.#....#....#..#\n##..#....#....##\n##....#....#...#\n#..#....#....#..\n#....#....#....#\n#.#....#....#..#\n##..#....#....##\n##....#....#..##\n##.#..#.#..#.###\n####.####.######\n################\n", "3\n..#\n.##\n###\n", "3\n...\n...\n...\n", "4\n####\n####\n##.#\n#...\n", "20\n#####.####.####.####\n##.#....#....#....##\n#....#....#....#...#\n#.#....#....#....###\n....#....#....#....#\n##....#....#....#...\n##.#....#....#....##\n#....#....#....#...#\n#.#....#....#....###\n....#....#....#....#\n##....#....#....#...\n##.#....#....#....##\n#....#....#....#...#\n#.#....#....#....###\n....#....#....#....#\n##....#....#....#...\n##.#....#....#...###\n#...##...##...######\n####################\n####################\n", "4\n####\n####\n####\n##.#\n", "3\n###\n###\n##.\n", "3\n###\n###\n#.#\n", "4\n####\n###.\n##..\n.##.\n", "3\n###\n##.\n.#.\n", "5\n###..\n##...\n###.#\n#####\n#####\n", "21\n##.######.###.#####.#\n#...##.#.......#.#...\n##..#...#.....#.....#\n#....#..###.###.....#\n....#....####....#.##\n#..#....##.#....#.###\n#...#.###...#.##....#\n#..#.##.##.##.##.....\n..........##......#.#\n#.##.#......###..#..#\n#.##.............#...\n..........#.....##..#\n#.#..###..###.##....#\n#....##....##.#.....#\n....#......#...#.#...\n#.#.........#..##.#.#\n#..........##.......#\n....#....#.##..##....\n#.#.##.#.......##.#.#\n##...##....##.##...##\n###.####.########.###\n", "3\n.##\n..#\n##.\n", "3\n.##\n#..\n##.\n", "16\n#####.####.#####\n##.##...##...###\n##....#....#...#\n#..#....#....#..\n#....#....#....#\n#.#....#....#..#\n##..#....#....##\n##....#....#...#\n#..#....#....#..\n#....#....#....#\n#.#....#....#..#\n##..#....#....##\n##....#....#..##\n##.#..#.#..#.###\n######.####.####\n################\n", "4\n####\n####\n##.#\n...#\n", "20\n#####.####.####.####\n##.#....#....#....##\n#.........#....#..##\n#.#....#....#....###\n....#....#....#....#\n##....#....#....#...\n##.#....#....#....##\n#....#....#....#...#\n#.#....#....#....###\n....#....#....#....#\n##....#....#....#...\n##.#....#....#....##\n#....#....#....#...#\n#.#....#....#....###\n....#....#....#....#\n##....#....#....#...\n##.#....#....#...###\n#...##...##...######\n####################\n####################\n", "3\n.##\n...\n#.#\n", "4\n#.##\n#...\n####\n##.#\n", "16\n#####.####.#####\n##.##...##...###\n##....#....#...#\n#..#....#....#..\n#....#....#....#\n#.#....#....#..#\n##..#....#....##\n##....#....#...#\n#..#....#....#..\n#....#....#....#\n#.#....#....#..#\n##..#....#....##\n##..#....#....##\n##.#..#.#..#.###\n######.####.####\n################\n", "20\n#.##.##.##.##.##.###\n...................#\n#..#..#..#..#..#....\n#................#.#\n#..#..#..#..#......#\n....................\n#..#..#..#..#......#\n#.............#....#\n#..#......#..#..#..#\n....................\n#..#..#..#......#..#\n#..........#.......#\n#..#..#......#..#..#\n....................\n#..#..#......#..#..#\n#.......#..........#\n#..#......#..#..#..#\n....................\n#.##....#.##.##.##.#\n######.#############\n", "3\n###\n##.\n###\n", "3\n###\n.##\n...\n", "5\n#####\n.####\n.#.##\n.####\n#####\n", "6\n#.##.#\n......\n#.##.#\n......\n##.###\n#.#.#.\n", "21\n##.######.###.#####.#\n#...##.#.......#.#...\n#.....#.....#...#..##\n#....#..###.###.....#\n....#....####....#.##\n#..#....##.#....#.###\n#...#.###...#.##....#\n#..#.##.##.##.##.....\n..........##......#.#\n#.##.#......#.#..##.#\n#.##.............#...\n..........#.....##..#\n#.#..###..###.##....#\n#....##....##.#.....#\n....#......#...#.#...\n#.#.........#..##.#.#\n#..........##.......#\n....#....#.##..##....\n#.#.##.#.......##.#.#\n##...##....##.##...##\n###.####.########.###\n", "16\n#####.####.#####\n##.##...##...###\n##....#....#...#\n#..#....#....#..\n#....#....#....#\n#.#....#....#..#\n##..#....#....##\n##....#....#...#\n#..#....#....#..\n#....#....#....#\n#.#....#....#..#\n##..#....#....##\n##....#....#..##\n###.#..#.#..#.##\n####.####.######\n################\n", "20\n#####.####.####.####\n##.#....#....#....##\n#....#....#....#...#\n#.#....#....#....###\n....#....#....#....#\n##....#....#....#...\n##.#....#....#....##\n#....#....#....#...#\n#.#....#....#....###\n....#....#....#....#\n##....#....#....#...\n##.#....#....#....##\n#....#....#....#...#\n#.#....#....#....###\n....#....#....#....#\n##....#....#....#...\n##.#....#....#...###\n######...##...##...#\n####################\n####################\n", "5\n#.###\n#....\n#....\n....#\n#..##\n", "5\n###..\n...##\n###.#\n#####\n#####\n", "21\n##.######.###.#####.#\n#...##.#.......#.#...\n##..#...#.....#.....#\n#....#..###.###.....#\n....#....####....#.##\n#..#....##.#....#.###\n#...#.###...#.##....#\n#..#.##.##.##.##.....\n..........##......#.#\n#..#..###......#.##.#\n#.##.............#...\n..........#.....##..#\n#.#..###..###.##....#\n#....##....##.#.....#\n....#......#...#.#...\n#.#.........#..##.#.#\n#..........##.......#\n....#....#.##..##....\n#.#.##.#.......##.#.#\n##...##....##.##...##\n###.####.########.###\n", "3\n##.\n..#\n##.\n", "3\n##.\n#..\n.##\n", "4\n####\n####\n#.##\n...#\n", "20\n#####.####.####.####\n##.#....#....#....##\n#.........#....#..##\n#.#....#....#....###\n....#....#....#....#\n...#....#....#....##\n##.#....#....#....##\n#....#....#....#...#\n#.#....#....#....###\n....#....#....#....#\n##....#....#....#...\n##.#....#....#....##\n#....#....#....#...#\n#.#....#....#....###\n....#....#....#....#\n##....#....#....#...\n##.#....#....#...###\n#...##...##...######\n####################\n####################\n", "21\n#########.###.#####.#\n#.####.#........##...\n....#............#..#\n#....#....#..##.#...#\n#.#..##..#....####..#\n.............###.#...\n#.##.##..#.###......#\n###.##.....##.......#\n##...........#..##.##\n#...##.###.#......###\n#....###.##..##.....#\n##....#.......##.....\n#.##.##..##.........#\n#.....#.###....##....\n#....##....##......##\n##..#.###.#........##\n#......#.#.....##..##\n##..#.....#.#...#...#\n#........#.##..##..##\n....##.##......#...##\n#.########.##.###.###\n", "3\n##.\n.#.\n.#.\n", "5\n#####\n#####\n#####\n.####\n###..\n", "3\n##.\n..#\n.##\n", "3\n#..\n...\n#.#\n", "4\n####\n####\n#.##\n#...\n", "3\n#.#\n...\n##.\n", "5\n#.###\n....#\n#....\n....#\n.#.##\n", "21\n##.######.###.#####.#\n#...##.#.......#.#...\n##..#...#.....#.....#\n#....#..###.###.....#\n....#....####....#.##\n###.#....#.##....#..#\n#...#.###...#.##....#\n#..#.##.##.##.##.....\n..........##......#.#\n#.##.#......###..#..#\n#.##.............#...\n..........#.....##..#\n#.#..###..###.##....#\n#....##....##.#.....#\n....#......#...#.#...\n#.#.........#..##.#.#\n#..........##.......#\n....#....#.##..##....\n#.#.##.#.......##.#.#\n##...##....##.##...##\n###.####.########.###\n", "3\n##.\n..#\n#.#\n", "20\n#####.####.####.####\n##.#....#....#....##\n#.........#....#..##\n#.#....#....#....###\n....#....#....#....#\n##....#....#....#...\n##.#....#....#....##\n#....#....#....#...#\n#.#....#....#....###\n....#....#....#....#\n##....#....#....#...\n##.#.#..#....#....#.\n#....#....#....#...#\n#.#....#....#....###\n....#....#....#....#\n##....#....#....#...\n##.#....#....#...###\n#...##...##...######\n####################\n####################\n", "5\n#####\n.####\n##.#.\n.####\n#####\n", "20\n#####.####.####.####\n##.#....#....#....##\n#....#....#....#...#\n#.#....#....#....###\n....#....#....#....#\n##....#....#....#...\n##....#....#....#.##\n#....#....#....#...#\n#.#....#....#....###\n....#....#....#....#\n##....#....#....#...\n##.#....#....#....##\n#....#....#....#...#\n#.#....#....#....###\n....#....#....#....#\n##....#....#....#...\n##.#....#....#...###\n######...##...##...#\n####################\n####################\n", "5\n#.###\n#....\n#....\n#....\n#..##\n", "3\n.#.\n...\n#.#\n", "5\n#.###\n....#\n#....\n....#\n##.#.\n", "3\n.##\n..#\n#.#\n", "5\n###.#\n#....\n#....\n#....\n#..##\n", "5\n#.###\n....#\n....#\n....#\n##.#.\n", "5\n###.#\n#....\n#....\n....#\n#..##\n", "5\n#.###\n...#.\n....#\n....#\n##.#.\n", "5\n#####\n.####\n..###\n####.\n#####\n", "21\n##.######.###.#####.#\n#...##.#.......#.#...\n##..#...#.....#.....#\n#....#..###.###.....#\n....#....####....#.##\n#..#....##.#....#.###\n#...#.###...#.##....#\n#..#.##.##.##.##.....\n..........##......#.#\n#.##.#......#.#..##.#\n#.##.............#...\n..........#.....##..#\n#.#..###..###.##....#\n#....##....##.#.....#\n....#......#...#.#...\n#.#.........#..##.#.#\n#..........##.......#\n....#....#.##..##....\n#.#.##.#.......##.#.#\n###..##....##.#....##\n###.####.########.###\n"], "outputs": ["YES\n", "NO\n", "NO\n", "YES\n", "YES\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "YES\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n", "NO\n"]}", "style": "rule"} | 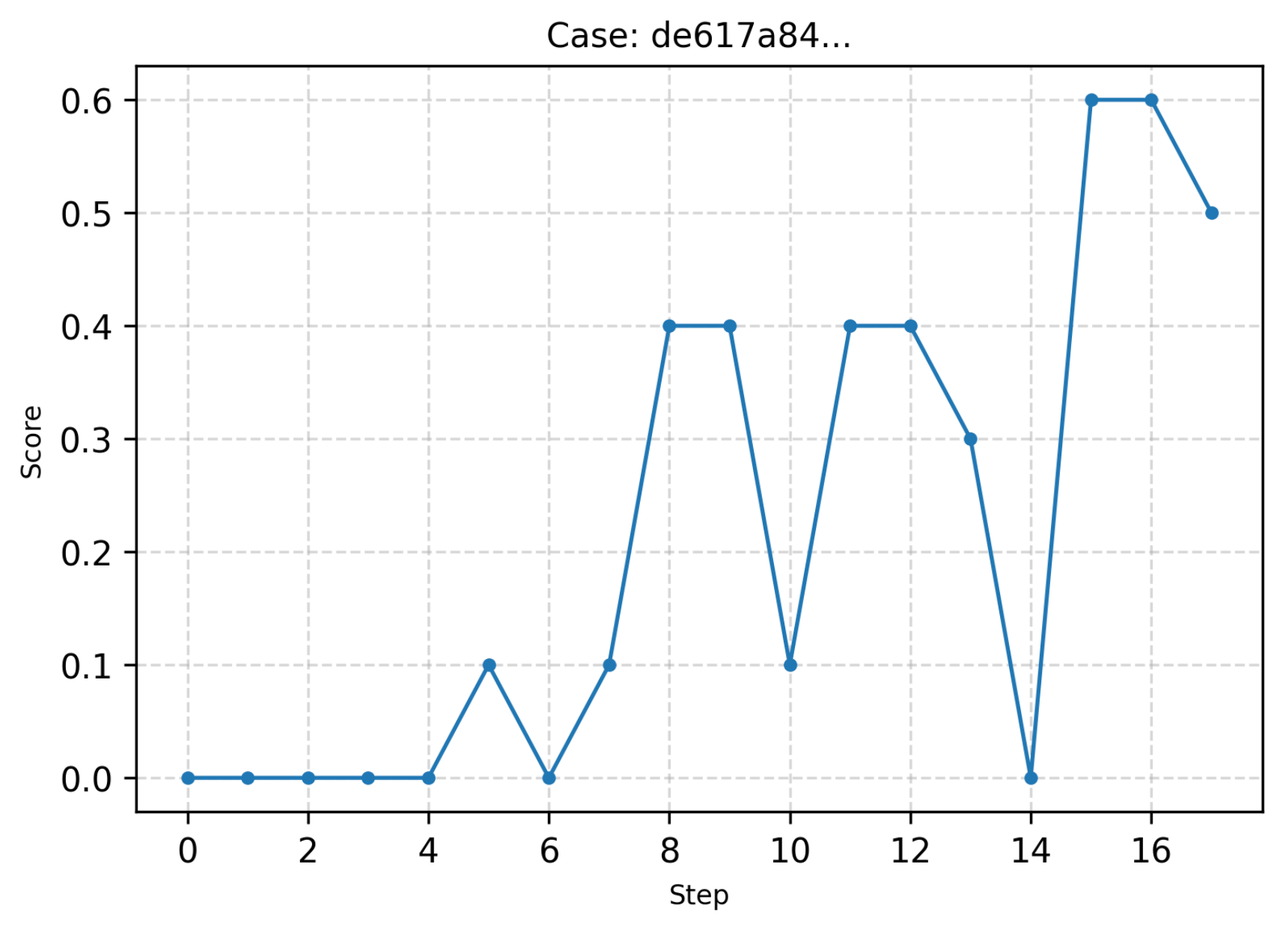 |
最近更新时间:2025.06.06 10:31:40
这个页面对您有帮助吗?
有用
有用
无用
无用