You need to enable JavaScript to run this app.
文档中心
GPU云服务器

GPU云服务器

复制全文
下载 pdf
MiniMax系列模型
GPU-部署MiniMax-M3模型
复制全文
下载 pdf
GPU-部署MiniMax-M3模型
本文以2台ecs.hpcpni3ln.45xlarge实例为例,介绍如何在GPU云服务器上部署MiniMax-M3模型。​
背景信息​
MiniMax-M3是稀宇科技(MiniMax)开源的原生多模态大模型,支持1 M上下文,模型总参数约428 B,推理激活参数23 B。该模型是一个面向长上下文、多模态、代码与Agent场景的超大规模开放模型。​
软件要求​
  • NVIDIA驱动:​
  • GPU驱动:用于驱动NVIDIA GPU的程序,本文使用535.261.03进行操作演示。​
  • 运行环境:​
  • SGLang框架:SGLang框架是一款专为大语言模型(LLMs)及视觉语言模型打造的高性能服务框架,通过协同设计前端结构化生成语言与后端运行时系统,实现与模型的高效交互,并保障了生成过程的可控性。本文使用 v0.5.13 版本进行操作演示。​
操作步骤​
步骤一:准备环境​
  1. 创建GPU计算型实例。​
  • ​
    配置项​
    推荐配置​
    基础配置​
    ​
    计算规格​
    ecs.hpcpni3ln.45xlarge​
    说明​
    ecs.hpcpni3ln.45xlarge规格实例正在邀测中,如需试用,请提交工单或联系客户经理申请。​
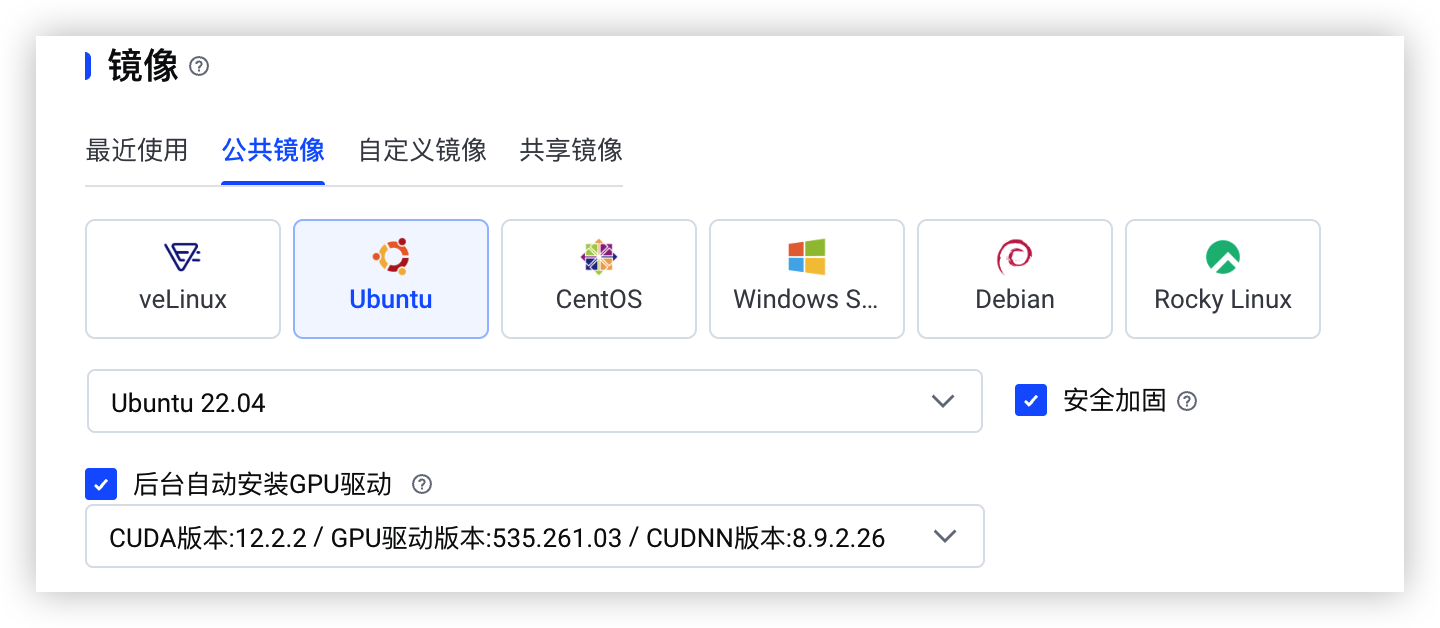
    镜像​
    ​
    Ubuntu 22.04 ,并勾选“后台自动安装GPU驱动”安装535.261.03版本GPU驱动。​
    ​​​
    说明​
    若您选用其他发行版本的镜像,需在创建实例后自行安装GPU驱动。​
    实例数量​
    2台​
    说明​
    本文创建的两台GPU实例,分别作为“Rank 0”、“Rank 1”。​
    存储​
    • 规格:吞吐型SSD TL0云盘​
    • 容量:不低于1024 GiB​
    说明​
    本文使用的MiniMax-M3模型参数量均为427 B,建议您配置云盘容量不低于1024 GiB。​
    网络配置​
    ​
    公网IP​
    勾选“分配弹性公网IP”。​
    ​
  1. 安装依赖的软件、工具。​
  1. 执行如下命令,安装、配置Docker。​
  • ​
    sudo apt update​
    sudo apt install ca-certificates curl gnupg lsb-release​
    sudo mkdir -p /etc/apt/keyrings​
    curl -fsSL https://mirrors.ivolces.com/docker/linux/ubuntu/gpg | sudo gpg --dearmor -o /etc/apt/keyrings/docker.gpg​
    echo "deb [arch=$(dpkg --print-architecture) signed-by=/etc/apt/keyrings/docker.gpg] https://mirrors.ivolces.com/docker/linux/ubuntu $(lsb_release -cs) stable" | sudo tee /etc/apt/sources.list.d/docker.list > /dev/null​
    sudo apt update​
    sudo apt install docker-ce docker-ce-cli containerd.io docker-compose-plugin -y​
    ​
  1. 执行如下命令,安装NVIDIA Container Toolkit。​
  • ​
    curl -s https://mirrors.ivolces.com/nvidia_all/ubuntu2204/x86_64/3bf863cc.pub | sudo apt-key add -​
    cat <<EOF >/etc/apt/sources.list.d/nvidia.list​
    deb http://mirrors.ivolces.com/nvidia_all/ubuntu2204/x86_64/ /​
    EOF​
    apt update​
    apt install nvidia-container-toolkit -y​
    ​
  1. 执行如下命令配置Docker,使容器可以使用实例的GPU资源。​
  • ​
    sudo nvidia-ctk runtime configure --runtime=docker​
    sudo systemctl restart docker​
    ​
  1. (可选)初始化本地盘。​
  • 若您选用的实例规格搭配有本地盘,建议您执行如下命令将本地盘挂载到存储模型的目录/data00,以提升模型加载速度。​
  • ​
    mkfs -t ext4 /dev/nvme0n1​
    mount -t ext4 /dev/nvme0n1 /data00​
    ​
说明​
  • 请将/dev/nvme0n1替换为实际本地盘名称。​
  • 请将ext4替换为您期望使用的文件系统。​
步骤二:部署、运行模型​
  1. 登录购买的2台GPU实例。了解更多。​
  1. 分别在两台实例中下载模型文件。​
  1. 执行如下命令,安装配置onion。​
  • ​
    curl -fsSL https://mirrors.ivolces.com/extra-tools/ubuntu/GPG-KEY-system | sudo gpg --dearmor -o /etc/apt/trusted.gpg.d/volc-extra-tools.gpg​
    echo "deb [arch=$(dpkg --print-architecture) signed-by=/etc/apt/trusted.gpg.d/volc-extra-tools.gpg] http://mirrors.ivolces.com/extra-tools/ubuntu jammy main" > /etc/apt/sources.list.d/volctools.list && apt update && apt install -y onion-ai-data​
    ​
  1. 执行如下命令,进入存放模型的目录。​
  • ​
    cd /data00​
    ​
  1. 执行如下命令,下载MiniMax-M3模型。​
  • ​
    oniond download model MiniMax-M3​
    ​
说明​
您也可以执行oniond list model命令,查看支持模型列表。​
  1. 请根据实例所在地域,分别在2台GPU实例中执行如下命令,下载Docker镜像。​
  • 华北2(北京)​
  • ​
    docker pull ai-containers-cn-beijing.cr.volces.com/deeplearning/sglang:v0.5.13.byted.202606170000​
    ​
  • 华东2(上海)​
  • ​
    docker pull ai-containers-cn-shanghai.cr.volces.com/deeplearning/sglang:v0.5.13.byted.202606170000​
    ​
  1. 请根据实例所在地域,分别在2台GPU实例中执行如下命令,启动Docker容器。​
  • 华北2(北京)​
  • ​
    docker run --gpus all -itd --net=host --shm-size=100g --ulimit memlock=-1 --ulimit stack=67108864 --privileged --ipc=host --security-opt seccomp=unconfined --cap-add=ALL -v /data00/:/data00/ -v /var/run/nvidia-topologyd/:/var/run/nvidia-topologyd/ --entrypoint /bin/bash ai-containers-cn-beijing.cr.volces.com/deeplearning/sglang:v0.5.13.byted.202606170000​
    ​
  • 华东2(上海)​
  • ​
    docker run --gpus all -itd --net=host --shm-size=100g --ulimit memlock=-1 --ulimit stack=67108864 --privileged --ipc=host --security-opt seccomp=unconfined --cap-add=ALL -v /data00/:/data00/ -v /var/run/nvidia-topologyd/:/var/run/nvidia-topologyd/ --entrypoint /bin/bash ai-containers-cn-shanghai.cr.volces.com/deeplearning/sglang:v0.5.13.byted.202606170000​
    ​
说明​
请将命令中的/data00替换为模型实际存放的目录路径。​
  1. 通过Docker日志确认容器及模型是否成功启动。​
  1. 执行如下命令,查看容器ID。​
  • ​
    docker ps​
    ​
  1. 执行如下命令,查看对应容器的运行日志。​
  • ​
    docker logs -f <CONTAINER_ID>​
    ​
说明​
请将<CONTAINER_ID>替换为实际容器ID。​
  1. 启动模型服务。 ​
  1. 执行如下命令,进入Docker容器。​
说明​
请将命令中的<CONTAINER_ID>替换为实际容器ID。 ​
  • ​
    docker exec -it <CONTAINER_ID> bash​
    ​
  1. 在两台实例中分别执行以下命令启动MiniMax-M3模型服务。​
注意​
  • 请将命令中的${NODE0_IP}替换为Rank 0节点实例的实际私网IP。​
  • 将命令中的${Port}替换为两台实例的模型服务连通端口号,可任意指定(例如10240)。​
  • ​
    Rank 0(Master 节点)
    Rank 1
    ​
    ​
    GLOO_SOCKET_IFNAME=eth0 \​
    NCCL_SOCKET_IFNAME=eth0 \​
    NCCL_MIN_NCHANNELS=24 \​
    NCCL_IB_QPS_PER_CONNECTION=8 \​
    sglang serve \​
    --trust-remote-code \​
    --model-path /data00/MiniMax-M3 \​
    --reasoning-parser auto \​
    --tool-call-parser auto \​
    --tp 16 \​
    --nnodes 2 \​
    --node-rank 0 \​
    --dist-init-addr ${NODE0_IP}:62001 \​
    --mem-fraction-static 0.75 \​
    --chunked-prefill-size 8192 \​
    --disable-custom-all-reduce \​
    --watchdog-timeout 3600 \​
    --host 0.0.0.0 \​
    --port ${Port}​
    ​
    ​
    ​
  • 参数说明​
  • 如上命令以部署、启动MiniMax-M3模型为例,如需部署、启动其他模型,可根据下表说明替换对应环境变量和参数值。​
  • ​
    参数名称​
    参数类型​
    说明​
    取值示例​
    sglang serve​
    启动指令​
    命令入口,表示通过Python模块方式启动SGLang的模型服务端。​
    -​
    --model-path​
    路径 / 模型 ID​
    指定加载的LLM模型,取值:​
    • Hugging Face模型ID。​
    • 本地模型路径。​
    /data00/MiniMax-M3​
    --tp-size​
    整数​
    配置张量并行度(Tensor Parallelism)。​
    16​
    --nnodes​
    整数​
    分布式节点数,双机部署时为 2。​
    2​
    --node-rank​
    整数​
    指定当前节点在集群中的序号,从0开始计数。​
    0​
    --dist-init-addr​
    字符串​
    分布式初始化地址。格式为 <rank0_ip>:<port>,所有节点必须填写相同值。​
    127.0.0.1:62001​
    --mem-fraction-static​
    比例​
    用于静态分配(模型权重和KV缓存内存池)的内存比例。​
    0.8​
    --host​
    IP地址​
    指定服务绑定的主机地址。​
    0.0.0.0​
    --port​
    整数​
    指定服务监听的端口号,用于客户端连接。​
    30000​
    ​
步骤三:调用模型​
  1. 执行如下命令,进入Docker容器。​
说明​
请将命令中的<CONTAINER_ID>替换为实际容器ID。 ​
  • ​
    docker exec -it <CONTAINER_ID> bash​
    ​
  1. 在容器中执行如下命令调用模型,确保部署的模型可以正常进行推理。​
  • ​
    curl -X POST http://127.0.0.1:8000/v1/chat/completions -H "Content-Type: application/json" -d '{​
    "model": "MiniMax-M3",​
    "messages": [​
    {​
    "role": "user",​
    "content": "介绍一下北京故宫"​
    }​
    ],​
    "max_tokens": 500,​
    "temperature": 0.7​
    }'​
    ​
  • 参数说明​
  • 本文仅说明验证使用到的参数信息。​
  • ​
    参数名​
    说明​
    取值样例​
    model​
    使用的实际模型。​
    MiniMax-M3​
    messages​
    对话的消息列表。​
    • role:该消息的发起角色。​
    • content:消息的内容。​
    -​
    max_tokens​
    指定一次请求中模型生成Completion的最大Token数。​
    取值:​
    • 介于1 到 8192 间的整数。​
    • 默认值为 4096。​
    100​
    temperature​
    采样温度。​
    • 取值范围:介于 0 ~ 2 之间。​
    • 值越高(例如1)会使输出更随机。​
    • 值越低(例如0.2)会使输出更加集中和确定。​
    0.7​
    ​
  • ​
最近更新时间:2026.06.23 16:25:17
这个页面对您有帮助吗?
有用
有用
无用
无用