GPU云服务器
GPU云服务器


文档指南

请输入


- 文档首页
 GPU云服务器GPU云服务器常见问题GPU实例硬件相关FAQ
 复制全文
 下载 pdf
GPU实例硬件相关FAQ
 文档反馈
 问问助手
如何判断和处理硬件相关故障?
GPU实例相比普通云服务器实例,增加了较多的外设,包括GPU、RDMA网络直通网卡、本地盘等。因此,除普通云服务器可能发生的常见问题外,还有如GPU、直通网卡以及PCIe链路上发生的亚健康或故障。针对GPU实例的常见故障和处理建议具体如图1所示。
图1 常见故障及处理建议
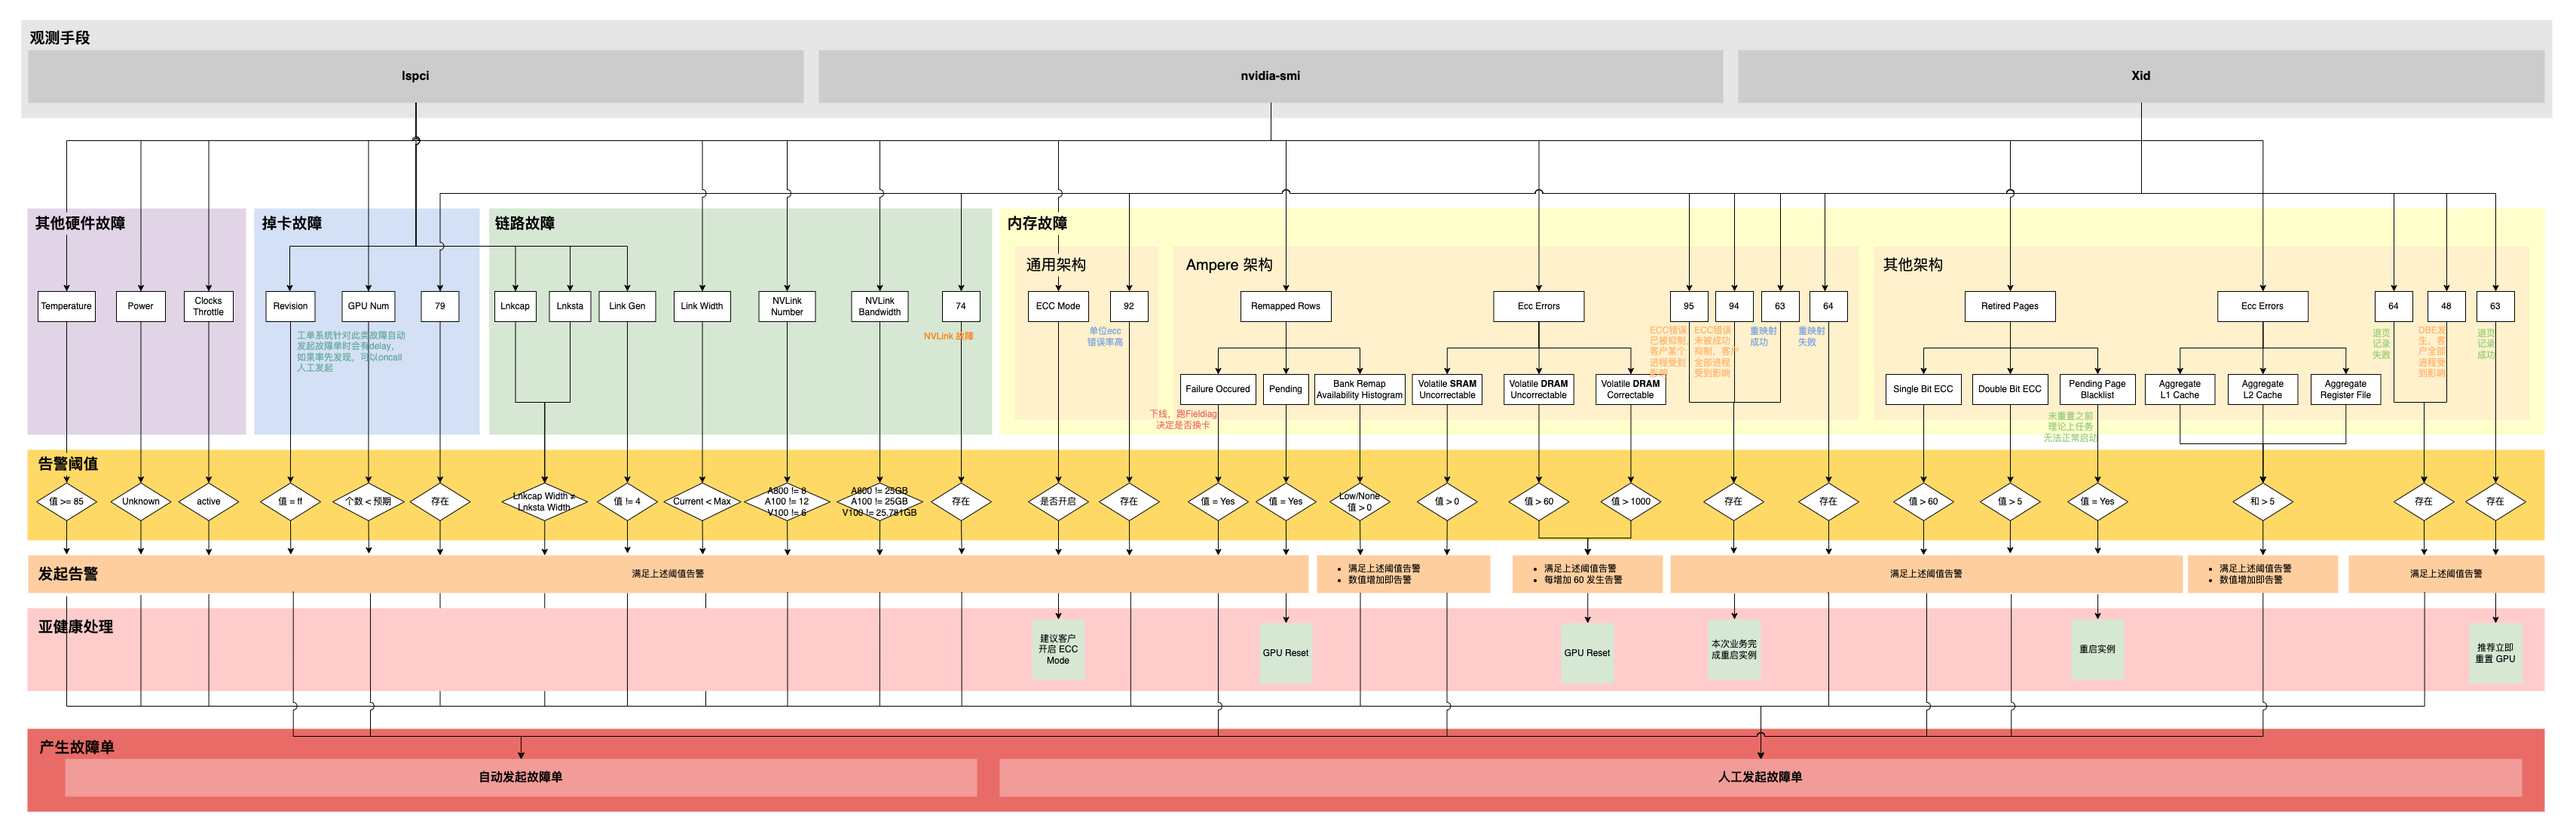
图2 故障处理流程
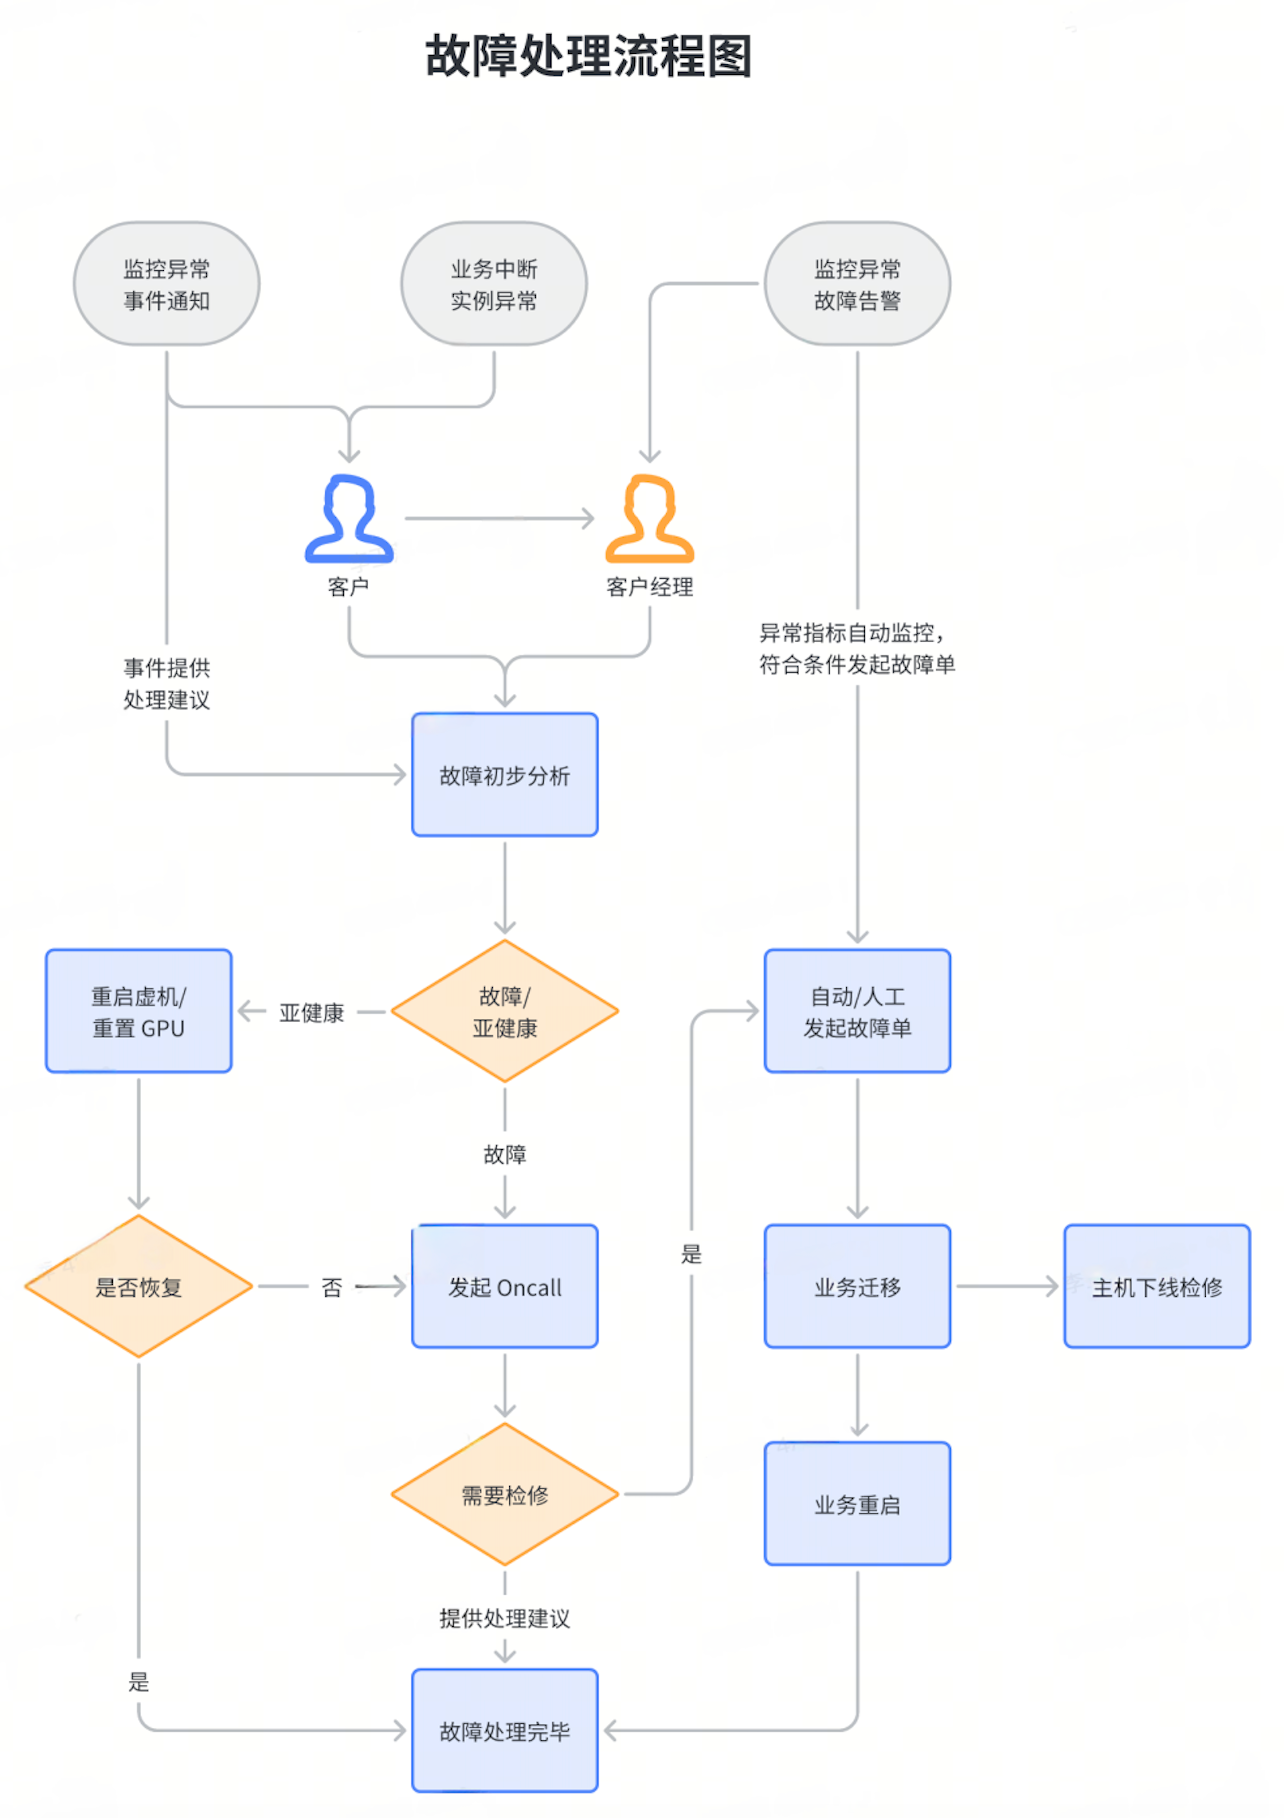
GPU亚健康或故障处理流程如图2所示,以下重点介绍亚健康现象的处理流程。
- 当发生“监控异常事件通知”、“业务中断实例异常”情况时,需要分析是否为亚健康现象(参考图1)。
- 若不是,则为故障,请发起Oncall或提交工单处理。
- 查看亚健康现象是否恢复。
- 未恢复,发起Oncall或提交工单处理。
- 已恢复,处理完毕。
常见问题列表
相关文档 | |
掉卡故障 | |
链路故障 | |
内存故障 | |
| |
| |
- | |
- |
如何查看GPU是否掉卡?
- 方式一
- 登录实例。
- 执行如下命令,若回显结尾为(rev ff),表明GPU识别异常。
- lspci | grep -i nvidia
-
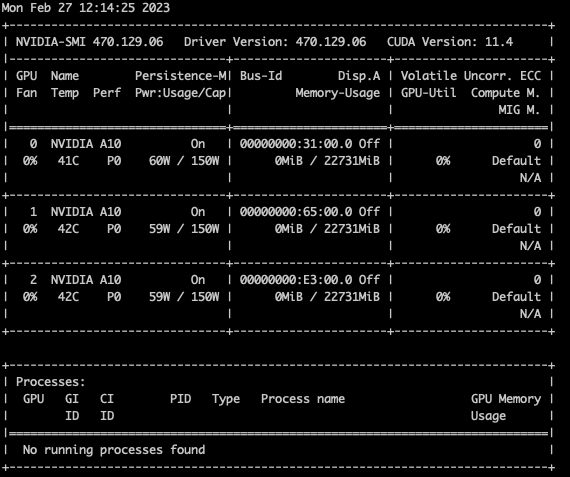
- 执行如下命令查看GPU卡数量,如下图,查询的是4卡规格,丢失1张。
- nvidia-smi
-
- 方式二
- 登录实例。
- 执行如下命令查看系统日志。
- cat /var/log/kern.log | grep -i xid
- 回显如下,表明GPU卡丢失。
-

如何查看带宽/链路是否正常?
- 方式一:Lspci带宽检测
- 登录实例。
- 执行如下命令。
- lspci -vvd 10de: | grep -i "Lnkcap:\|Lnksta:"
- 回显如下,其中Lnkcap为额定带宽,Lnksta为当前带宽,两者一致则表明带宽/链路未发生异常。
-
- 方式二:Nvidia-smi检查
- 登录实例。
- 执行如下命令。
- nvidia-smi -q | grep -i -A 2 'Link width'
- 回显如下,Max和Current的值保持一致,表明带宽/链路未发生异常。
-
如何判断GPU实例是否为Ampere架构?
根据GPU显卡判断架构类型,具体如下表所示。
如何查看Remapped Rows相关指标(仅Ampere架构)?
Remapped Rows是NVIDIA Ampere架构新增的一种硬件机制,用于提高GPU上帧缓冲存储器的可靠性,GPU检测到内存错误时,会尝试重新映射到GPU设备内存行,当一行被重新映射时,NVIDIA驱动程序会将错误的行重新映射到保留行,后续对该行的所有访问都将访问保留行而不是错误行。
您可以通过以下操作查看Remapped Rows相关指标:
- 登录实例。
- 执行如下命令。
- nvidia-smi -q -d ECC,ROW_REMAPPER
- 正常返回如下图所示。
-
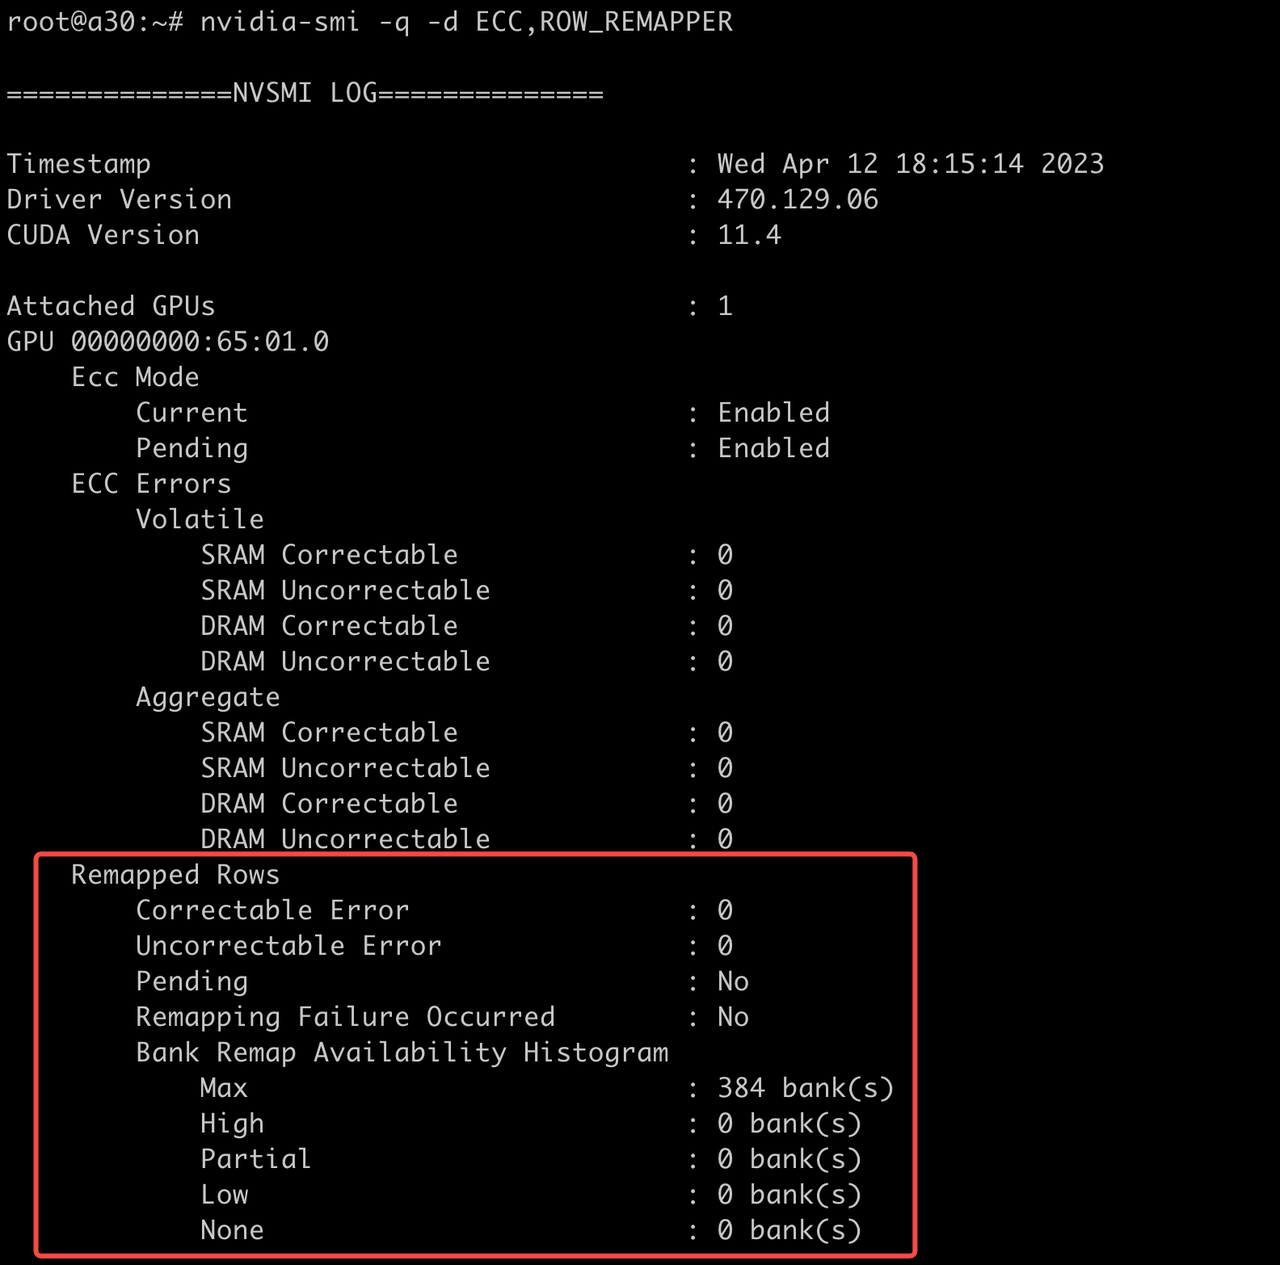
- 如果Pending指标为YES,表示当前发生行重映射,需要重启实例。
- 如果Remapping Failure Occurred指标为YES,表示当前行重映射发生异常,主机需要下线检修。
- 如果Bank Remap Availability Histogram指标的Low/None值 > 0,表示可用的重映射保留行不足,主机需要下线检修。
如何查看Retired Pages相关指标(除Ampere外的其它架构)?
当发生Double Bit ECC错误或多个Single Bit ECC错误时,可能会淘汰GPU设备内存页面。当页面被淘汰时,NVIDIA驱动程序会将其隐藏,这样任何驱动程序或应用程序内存分配都无法访问该页面。
ECC:Error Correcting Code,错误检查和纠正技术。
您可以通过以下操作查看Retired Pages相关指标:
- 登录实例。
- 执行如下命令。
- nvidia-smi -q -d ECC,PAGE_RETIREMENT
- 正常返回如下图所示。
-
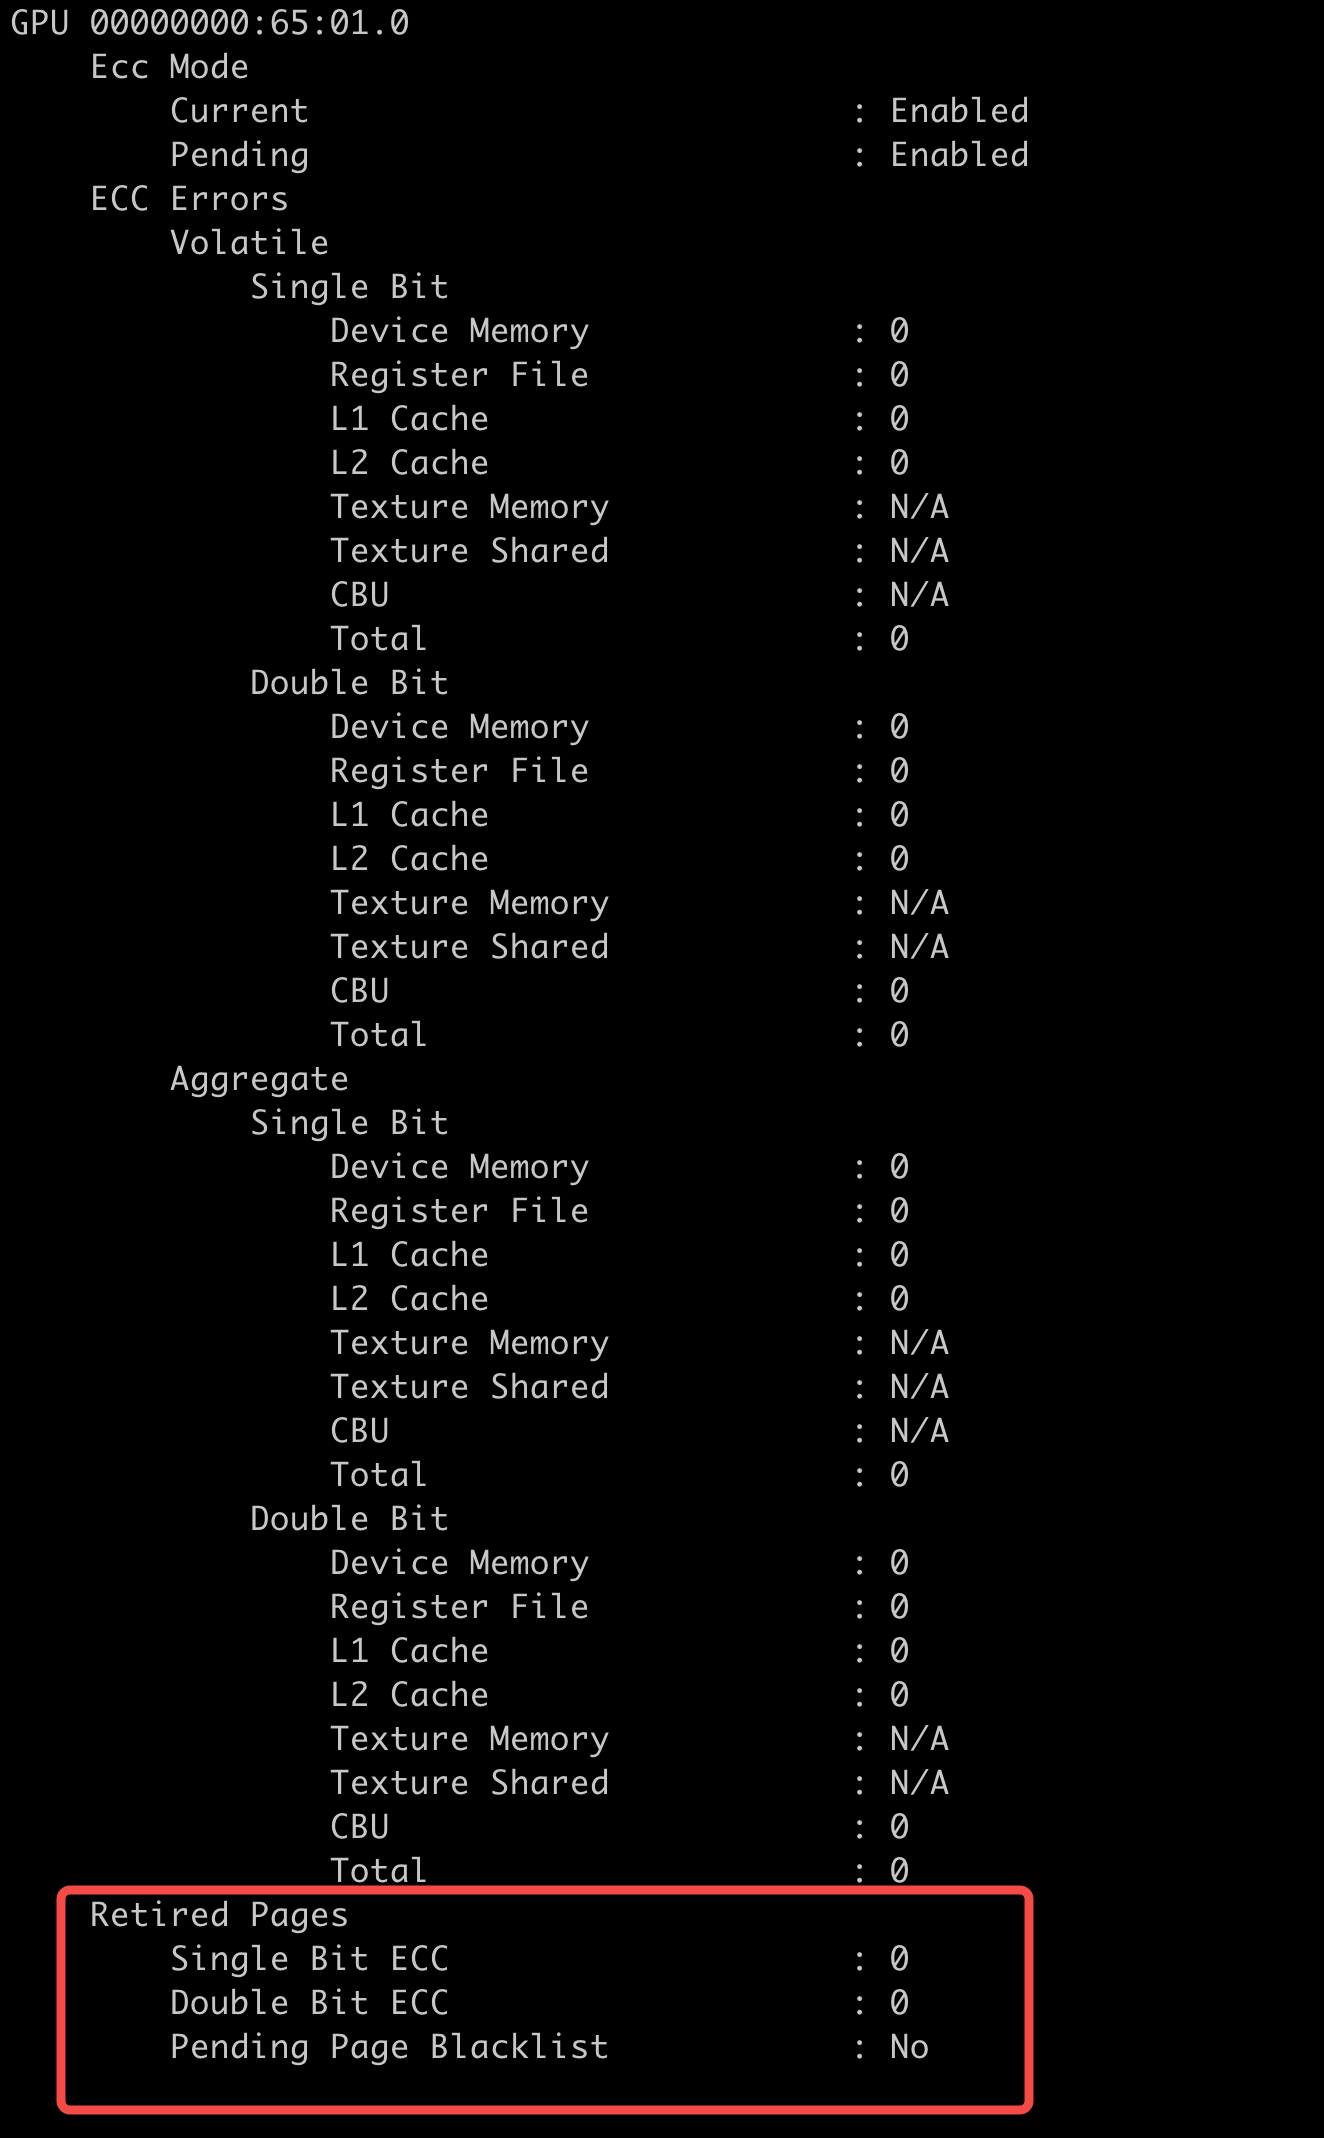
- 如果Pending Page Blacklist指标为YES,需要重启实例。
- Single Bit ECC错误淘汰的内存页数超过60或者Double Bit ECC错误淘汰的内存页数超过5(见图1),需要下线检修物理机。
如何查看XID信息?
- 登录实例。
- 执行如下命令。
-
- 结果如下图所示。
-

- 若检查到GPU节点存在XID错误信息,可根据XID错误代码对应的处理建议进行处理,详情请参见常见XID处理方法。
如何收集NVIDIA日志?
虚拟机场景
- 登录实例。
- 执行如下命令。
-
- 收集到的文件如下图所示。
-
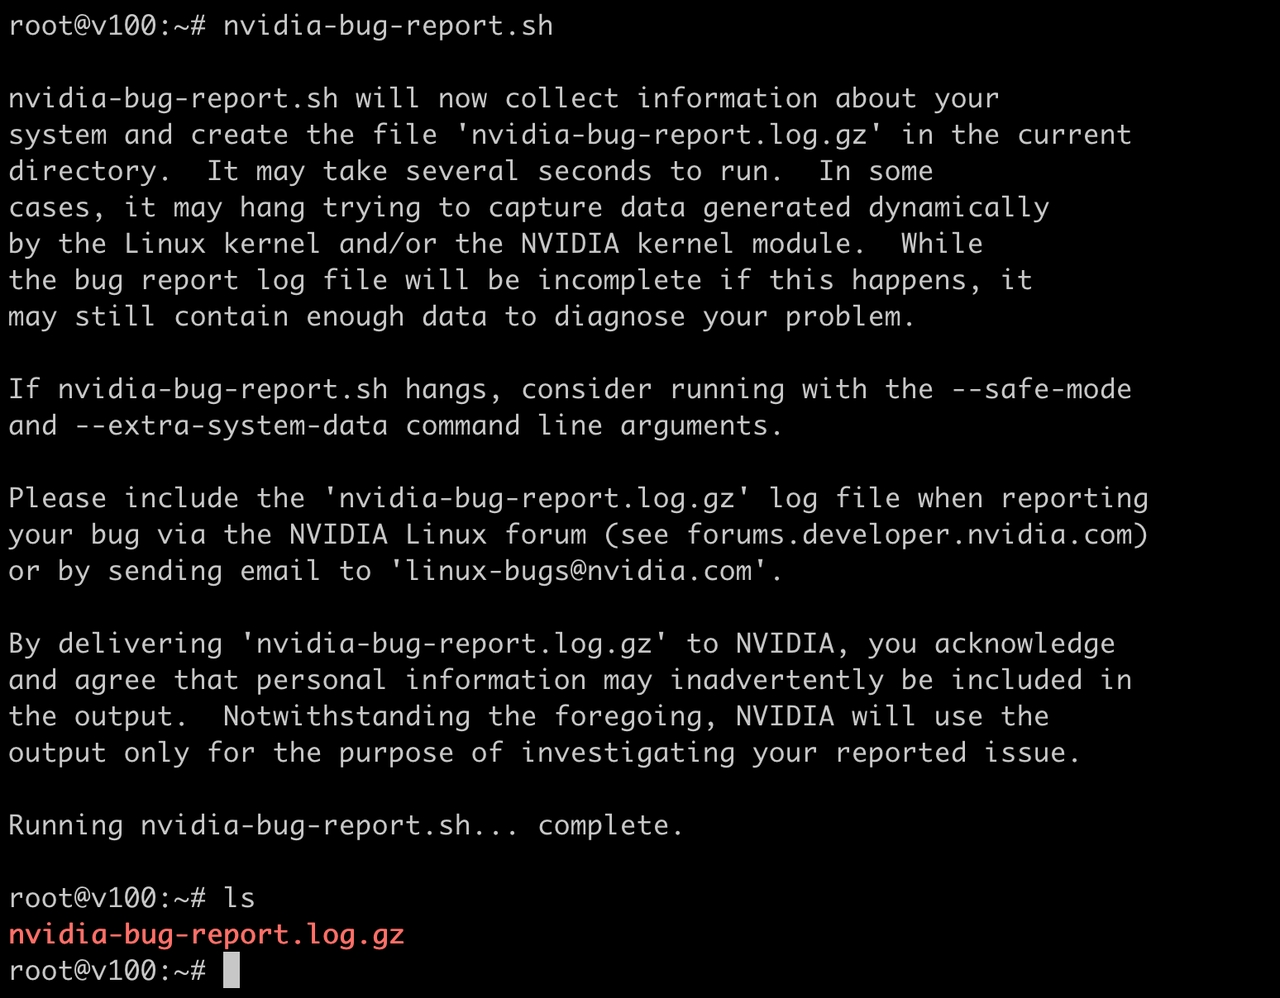
- nvidia-bug-report.sh脚本会自动收集系统内核日志、NVIDIA驱动日志等调试信息,生成压缩文件nvidia-bug-report.log.gz。
在提工单时可附上此文件。
- nvidia-bug-report.sh通常能快速完成执行。
- 若运行缓慢,预留最长一小时等待时间。
- 若命令出现卡死现象,可通过附加参数方式以安全模式收集替代日志,规避卡死风险。
-
VKE场景
- 登录实例。
- 执行如下命令获取日志下载链接
-
- 结果如下图所示。
-

- 执行上面生成的wget命令获取日志文件。
最近更新时间:2025.11.10 14:38:51
这个页面对您有帮助吗?
有用
有用
无用
无用