GPU云服务器
GPU云服务器
GPU云服务器


文档指南
请输入


GPU云服务器
图说GPU云服务器
用户指南
安装NVIDIA驱动
安装NVIDIA GRID驱动
安装veCCL
最佳实践
AIGC实践
DeepSeek系列模型
搭建应用
性能测试/调优
故障处理
- 文档首页
 GPU云服务器GPU云服务器最佳实践AIGC实践Qwen系列模型GPU-部署Qwen3.8模型
 复制全文
 下载 pdf
GPU-部署Qwen3.8模型
 文档反馈
 问问助手
本文以4台ecs.hpcpni3ln.45xlarge实例为例,介绍如何在GPU云服务器上部署Qwen 3.8模型。
背景信息
Qwen 3.8是通义千问首个开源权重的Max级模型。该模型基于Qwen 3.5架构底座,采用Gated DeltaNet + Gated Attention混合注意力 + 稀疏MoE,总参数量达2.4T,单次推理激活约95B,兼顾规模与推理效率;原生262K Token上下文,可外推至约1M Token。相比前代显著强化了自主规划、环境反馈处理与长周期任务执行能力,适用于复杂编码、专业知识工作、研究分析与长周期智能体任务等场景。了解更多
软件要求
- NVIDIA驱动:
- GPU驱动:用来驱动NVIDIA GPU的程序,本文以535.261.03为例。
- 运行环境:
- SGLang框架:SGLang框架是一款专为大语言模型(LLMs)及视觉语言模型打造的高性能服务框架,通过协同设计前端结构化生成语言与后端运行时系统,实现与模型的高效交互,并保障了生成过程的可控性。本文以火山引擎提供的SGLang容器镜像为例。
操作步骤
步骤一:准备环境
- 创建GPU计算型实例。
- 请根据通过向导购买实例指引,创建4台符合如下条件的实例:
- 配置项推荐配置配置项推荐配置基础配置计算规格ecs.hpcpni3ln.45xlarge注意镜像实例数量4说明本文创建的4台GPU实例,分别作为“Rank 0”、“Rank 1”、“Rank 2”、“Rank 3”。存储
- 规格:吞吐型SSD TL0云盘
- 容量:不低于 3072 GiB
注意由于Qwen 3.8模型文件较大,建议您配置的云盘或本地盘容量不低于 3072 GiB。网络配置私有网络4台实例需处于同一私有网络。公网IP勾选“分配弹性公网IP”。
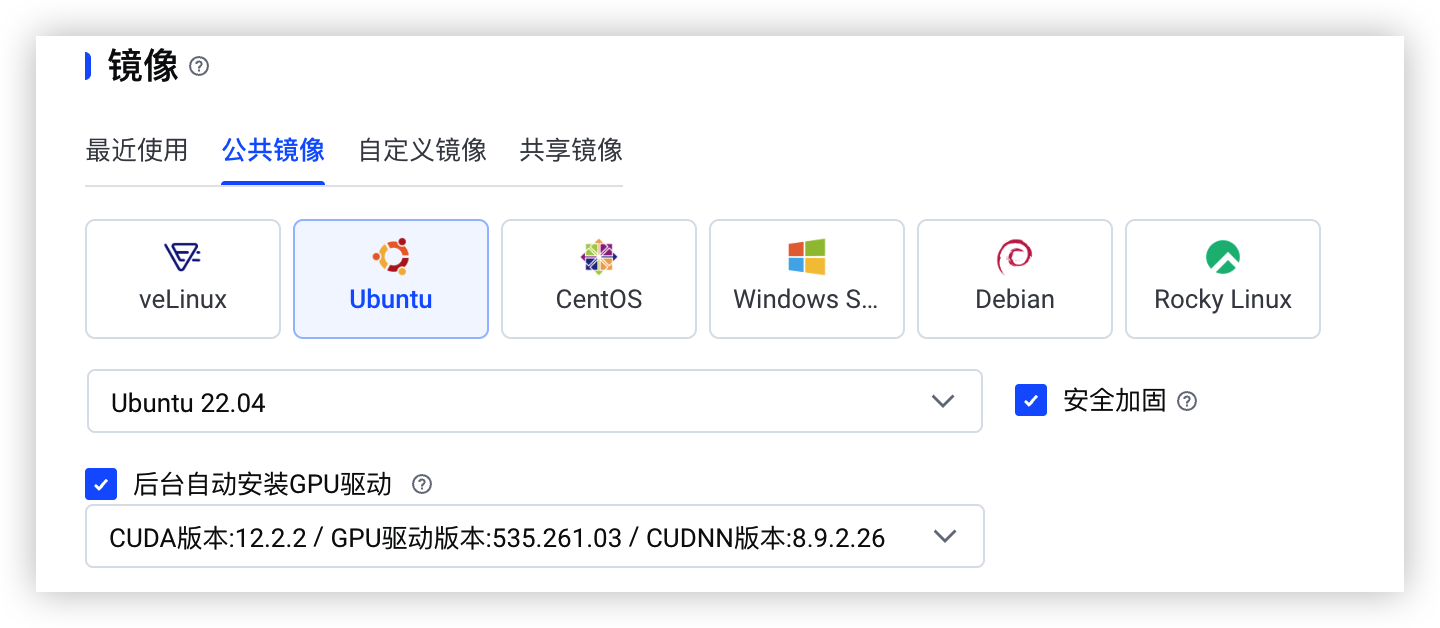
- 安装依赖的软件、工具。
- 分别登录购买的4台实例。了解更多
- 执行如下命令,安装、配置Docker。
- sudo apt updatesudo apt install ca-certificates curl gnupg lsb-releasesudo mkdir -p /etc/apt/keyringscurl -fsSL https://mirrors.ivolces.com/docker/linux/ubuntu/gpg | sudo gpg --dearmor -o /etc/apt/keyrings/docker.gpgecho "deb [arch=$(dpkg --print-architecture) signed-by=/etc/apt/keyrings/docker.gpg] https://mirrors.ivolces.com/docker/linux/ubuntu $(lsb_release -cs) stable" | sudo tee /etc/apt/sources.list.d/docker.list > /dev/nullsudo apt updatesudo apt install docker-ce docker-ce-cli containerd.io docker-compose-plugin -y
- 执行如下命令,安装NVIDIA Container Toolkit。
- curl -s https://mirrors.ivolces.com/nvidia_all/ubuntu2204/x86_64/3bf863cc.pub | sudo apt-key add -cat <<EOF >/etc/apt/sources.list.d/nvidia.listdeb http://mirrors.ivolces.com/nvidia_all/ubuntu2204/x86_64/ /EOFsudo apt updatesudo apt install -y nvidia-container-toolkit
- 执行如下命令配置Docker,使容器可以使用实例的GPU资源。
- sudo nvidia-ctk runtime configure --runtime=dockersudo systemctl restart docker
- (可选)初始化本地盘。
- 若您选用的实例规格搭配有本地盘,建议您执行如下命令将本地盘挂载到存储模型的目录“/data00”,提升模型加载速度。
- mkfs -t ext4 /dev/nvme0n1mount -t ext4 /dev/nvme0n1 /data00
说明
- 请将/dev/nvme0n1替换为实际本地盘名称。
- 请将ext4替换为您期望使用的文件系统。
步骤二:部署、运行模型
- 分别登录购买的4台实例。了解更多
- 根据实例所在地域,在4台实例中分别执行如下命令,下载SGLang Docker镜像与Qwen3.8-2.4T-A95B-FP8模型文件。
- 华北2(北京)华东2(上海)
- 下载SGLang Docker镜像。
- docker pull ai-containers-cn-beijing.cr.volces.com/deeplearning/sglang:v0.5.17.iaas.dev.202608130000-qwen3.8-cu130
- 下载Qwen3.8-2.4T-A95B-FP8模型文件。
- docker run --rm \-v /data00/:/data00 \--workdir /data00 \--entrypoint bash \ai-containers-cn-beijing.cr.volces.com/deeplearning/sglang:v0.5.17.iaas.dev.202608130000-qwen3.8-cu130 \-lc 'set -eif ! command -v oniond >/dev/null 2>&1; thenapt updateapt install -y ca-certificates curl gnupg gpgcurl -fsSL https://mirrors.ivolces.com/extra-tools/ubuntu/GPG-KEY-system | gpg --dearmor -o /etc/apt/trusted.gpg.d/volc-extra-tools.gpgecho "deb [arch=$(dpkg --print-architecture) signed-by=/etc/apt/trusted.gpg.d/volc-extra-tools.gpg] http://mirrors.ivolces.com/extra-tools/ubuntu jammy main" > /etc/apt/sources.list.d/volctools.listapt updateapt install -y onion-ai-datafiexport BUCKET=ai-infraoniond download model Qwen3.8-2.4T-A95B-FP8 --turbo --dir /data00'
- 下载SGLang Docker镜像。
- docker pull ai-containers-cn-shanghai.cr.volces.com/deeplearning/sglang:v0.5.17.iaas.dev.202608130000-qwen3.8-cu130
- 下载Qwen3.8-2.4T-A95B-FP8模型文件。
- docker run --rm \-v /data00/:/data00 \--workdir /data00 \--entrypoint bash \ai-containers-cn-shanghai.cr.volces.com/deeplearning/sglang:v0.5.17.iaas.dev.202608130000-qwen3.8-cu130 \-lc 'set -eif ! command -v oniond >/dev/null 2>&1; thenapt updateapt install -y ca-certificates curl gnupg gpgcurl -fsSL https://mirrors.ivolces.com/extra-tools/ubuntu/GPG-KEY-system | gpg --dearmor -o /etc/apt/trusted.gpg.d/volc-extra-tools.gpgecho "deb [arch=$(dpkg --print-architecture) signed-by=/etc/apt/trusted.gpg.d/volc-extra-tools.gpg] http://mirrors.ivolces.com/extra-tools/ubuntu jammy main" > /etc/apt/sources.list.d/volctools.listapt updateapt install -y onion-ai-datafiexport BUCKET=ai-infraoniond download model Qwen3.8-2.4T-A95B-FP8 --turbo --dir /data00'
- 请根据实例所在地域,在实例中执行对应命令,启动Docker容器。
注意
- 请将/data00替换为模型实际存放目录路径。
- 请将<rank0_private_ip>替换为“Rank 0”实例私网IP地址。
- 华北2(北京)华东2(上海)请根据您为实例指定的节点名称,执行对应命令。“Rank 0”实例“Rank 1”实例“Rank 2”实例“Rank 3”实例docker run -d --name qwen38-serve \--gpus all \--shm-size 32g \--network host \--ipc=host \-v /data00:/data00 \--env GLOO_SOCKET_IFNAME=eth0 \--env NCCL_SOCKET_IFNAME=eth0 \--env NCCL_MIN_NCHANNELS=24 \--env NCCL_IB_QPS_PER_CONNECTION=8 \--env SGLANG_ALLOW_OVERWRITE_LONGER_CONTEXT_LEN=1 \ai-containers-cn-beijing.cr.volces.com/deeplearning/sglang:v0.5.17.iaas.dev.202608130000-qwen3.8-cu130 \sglang serve \--trust-remote-code \--model-path /data00/Qwen3.8-2.4T-A95B-FP8 \--tp-size 8 \--nnodes 4 \--node-rank 0 \--dist-init-addr "<rank0_private_ip>:20000" \--pp-size 4 \--dist-timeout 1800 \--linear-attn-prefill-backend flashinfer \--linear-attn-decode-backend flashinfer \--mamba-full-memory-ratio 0.95 \--mamba-radix-cache-strategy extra_buffer \--mamba-ssm-dtype bfloat16 \--max-prefill-tokens 8192 \--page-size 64 \--reasoning-parser qwen3 \--tool-call-parser qwen3_coder \--context-length 1010000 \--json-model-override-args '{"rope_parameters":{"rope_type":"yarn","rope_theta":10000000,"partial_rotary_factor":0.25,"factor":4.0,"original_max_position_embeddings":262144}}' \--host 0.0.0.0 \--port 30000docker run -d --name qwen38-serve \--gpus all \--shm-size 32g \--network host \--ipc=host \-v /data00:/data00 \--env GLOO_SOCKET_IFNAME=eth0 \--env NCCL_SOCKET_IFNAME=eth0 \--env NCCL_MIN_NCHANNELS=24 \--env NCCL_IB_QPS_PER_CONNECTION=8 \--env SGLANG_ALLOW_OVERWRITE_LONGER_CONTEXT_LEN=1 \ai-containers-cn-beijing.cr.volces.com/deeplearning/sglang:v0.5.17.iaas.dev.202608130000-qwen3.8-cu130 \sglang serve \--trust-remote-code \--model-path /data00/Qwen3.8-2.4T-A95B-FP8 \--tp-size 8 \--nnodes 4 \--node-rank 1 \--dist-init-addr "<rank0_private_ip>:20000" \--pp-size 4 \--dist-timeout 1800 \--linear-attn-prefill-backend flashinfer \--linear-attn-decode-backend flashinfer \--mamba-full-memory-ratio 0.95 \--mamba-radix-cache-strategy extra_buffer \--mamba-ssm-dtype bfloat16 \--max-prefill-tokens 8192 \--page-size 64 \--reasoning-parser qwen3 \--tool-call-parser qwen3_coder \--context-length 1010000 \--json-model-override-args '{"rope_parameters":{"rope_type":"yarn","rope_theta":10000000,"partial_rotary_factor":0.25,"factor":4.0,"original_max_position_embeddings":262144}}' \--host 0.0.0.0 \--port 30000docker run -d --name qwen38-serve \--gpus all \--shm-size 32g \--network host \--ipc=host \-v /data00:/data00 \--env GLOO_SOCKET_IFNAME=eth0 \--env NCCL_SOCKET_IFNAME=eth0 \--env NCCL_MIN_NCHANNELS=24 \--env NCCL_IB_QPS_PER_CONNECTION=8 \--env SGLANG_ALLOW_OVERWRITE_LONGER_CONTEXT_LEN=1 \ai-containers-cn-beijing.cr.volces.com/deeplearning/sglang:v0.5.17.iaas.dev.202608130000-qwen3.8-cu130 \sglang serve \--trust-remote-code \--model-path /data00/Qwen3.8-2.4T-A95B-FP8 \--tp-size 8 \--nnodes 4 \--node-rank 2 \--dist-init-addr "<rank0_private_ip>:20000" \--pp-size 4 \--dist-timeout 1800 \--linear-attn-prefill-backend flashinfer \--linear-attn-decode-backend flashinfer \--mamba-full-memory-ratio 0.95 \--mamba-radix-cache-strategy extra_buffer \--mamba-ssm-dtype bfloat16 \--max-prefill-tokens 8192 \--page-size 64 \--reasoning-parser qwen3 \--tool-call-parser qwen3_coder \--context-length 1010000 \--json-model-override-args '{"rope_parameters":{"rope_type":"yarn","rope_theta":10000000,"partial_rotary_factor":0.25,"factor":4.0,"original_max_position_embeddings":262144}}' \--host 0.0.0.0 \--port 30000docker run -d --name qwen38-serve \--gpus all \--shm-size 32g \--network host \--ipc=host \-v /data00:/data00 \--env GLOO_SOCKET_IFNAME=eth0 \--env NCCL_SOCKET_IFNAME=eth0 \--env NCCL_MIN_NCHANNELS=24 \--env NCCL_IB_QPS_PER_CONNECTION=8 \--env SGLANG_ALLOW_OVERWRITE_LONGER_CONTEXT_LEN=1 \ai-containers-cn-beijing.cr.volces.com/deeplearning/sglang:v0.5.17.iaas.dev.202608130000-qwen3.8-cu130 \sglang serve \--trust-remote-code \--model-path /data00/Qwen3.8-2.4T-A95B-FP8 \--tp-size 8 \--nnodes 4 \--node-rank 3 \--dist-init-addr "<rank0_private_ip>:20000" \--pp-size 4 \--dist-timeout 1800 \--linear-attn-prefill-backend flashinfer \--linear-attn-decode-backend flashinfer \--mamba-full-memory-ratio 0.95 \--mamba-radix-cache-strategy extra_buffer \--mamba-ssm-dtype bfloat16 \--max-prefill-tokens 8192 \--page-size 64 \--reasoning-parser qwen3 \--tool-call-parser qwen3_coder \--context-length 1010000 \--json-model-override-args '{"rope_parameters":{"rope_type":"yarn","rope_theta":10000000,"partial_rotary_factor":0.25,"factor":4.0,"original_max_position_embeddings":262144}}' \--host 0.0.0.0 \--port 30000请根据您为实例指定的节点名称,执行对应命令。“Rank 0”实例“Rank 1”实例“Rank 2”实例“Rank 3”实例docker run -d --name qwen38-serve \--gpus all \--shm-size 32g \--network host \--ipc=host \-v /data00:/data00 \--env GLOO_SOCKET_IFNAME=eth0 \--env NCCL_SOCKET_IFNAME=eth0 \--env NCCL_MIN_NCHANNELS=24 \--env NCCL_IB_QPS_PER_CONNECTION=8 \--env SGLANG_ALLOW_OVERWRITE_LONGER_CONTEXT_LEN=1 \ai-containers-cn-shanghai.cr.volces.com/deeplearning/sglang:v0.5.17.iaas.dev.202608130000-qwen3.8-cu130 \sglang serve \--trust-remote-code \--model-path /data00/Qwen3.8-2.4T-A95B-FP8 \--tp-size 8 \--nnodes 4 \--node-rank 0 \--dist-init-addr "<rank0_private_ip>:20000" \--pp-size 4 \--dist-timeout 1800 \--linear-attn-prefill-backend flashinfer \--linear-attn-decode-backend flashinfer \--mamba-full-memory-ratio 0.95 \--mamba-radix-cache-strategy extra_buffer \--mamba-ssm-dtype bfloat16 \--max-prefill-tokens 8192 \--page-size 64 \--reasoning-parser qwen3 \--tool-call-parser qwen3_coder \--context-length 1010000 \--json-model-override-args '{"rope_parameters":{"rope_type":"yarn","rope_theta":10000000,"partial_rotary_factor":0.25,"factor":4.0,"original_max_position_embeddings":262144}}' \--host 0.0.0.0 \--port 30000docker run -d --name qwen38-serve \--gpus all \--shm-size 32g \--network host \--ipc=host \-v /data00:/data00 \--env GLOO_SOCKET_IFNAME=eth0 \--env NCCL_SOCKET_IFNAME=eth0 \--env NCCL_MIN_NCHANNELS=24 \--env NCCL_IB_QPS_PER_CONNECTION=8 \--env SGLANG_ALLOW_OVERWRITE_LONGER_CONTEXT_LEN=1 \ai-containers-cn-shanghai.cr.volces.com/deeplearning/sglang:v0.5.17.iaas.dev.202608130000-qwen3.8-cu130 \sglang serve \--trust-remote-code \--model-path /data00/Qwen3.8-2.4T-A95B-FP8 \--tp-size 8 \--nnodes 4 \--node-rank 1 \--dist-init-addr "<rank0_private_ip>:20000" \--pp-size 4 \--dist-timeout 1800 \--linear-attn-prefill-backend flashinfer \--linear-attn-decode-backend flashinfer \--mamba-full-memory-ratio 0.95 \--mamba-radix-cache-strategy extra_buffer \--mamba-ssm-dtype bfloat16 \--max-prefill-tokens 8192 \--page-size 64 \--reasoning-parser qwen3 \--tool-call-parser qwen3_coder \--context-length 1010000 \--json-model-override-args '{"rope_parameters":{"rope_type":"yarn","rope_theta":10000000,"partial_rotary_factor":0.25,"factor":4.0,"original_max_position_embeddings":262144}}' \--host 0.0.0.0 \--port 30000docker run -d --name qwen38-serve \--gpus all \--shm-size 32g \--network host \--ipc=host \-v /data00:/data00 \--env GLOO_SOCKET_IFNAME=eth0 \--env NCCL_SOCKET_IFNAME=eth0 \--env NCCL_MIN_NCHANNELS=24 \--env NCCL_IB_QPS_PER_CONNECTION=8 \--env SGLANG_ALLOW_OVERWRITE_LONGER_CONTEXT_LEN=1 \ai-containers-cn-shanghai.cr.volces.com/deeplearning/sglang:v0.5.17.iaas.dev.202608130000-qwen3.8-cu130 \sglang serve \--trust-remote-code \--model-path /data00/Qwen3.8-2.4T-A95B-FP8 \--tp-size 8 \--nnodes 4 \--node-rank 2 \--dist-init-addr "<rank0_private_ip>:20000" \--pp-size 4 \--dist-timeout 1800 \--linear-attn-prefill-backend flashinfer \--linear-attn-decode-backend flashinfer \--mamba-full-memory-ratio 0.95 \--mamba-radix-cache-strategy extra_buffer \--mamba-ssm-dtype bfloat16 \--max-prefill-tokens 8192 \--page-size 64 \--reasoning-parser qwen3 \--tool-call-parser qwen3_coder \--context-length 1010000 \--json-model-override-args '{"rope_parameters":{"rope_type":"yarn","rope_theta":10000000,"partial_rotary_factor":0.25,"factor":4.0,"original_max_position_embeddings":262144}}' \--host 0.0.0.0 \--port 30000docker run -d --name qwen38-serve \--gpus all \--shm-size 32g \--network host \--ipc=host \-v /data00:/data00 \--env GLOO_SOCKET_IFNAME=eth0 \--env NCCL_SOCKET_IFNAME=eth0 \--env NCCL_MIN_NCHANNELS=24 \--env NCCL_IB_QPS_PER_CONNECTION=8 \--env SGLANG_ALLOW_OVERWRITE_LONGER_CONTEXT_LEN=1 \ai-containers-cn-shanghai.cr.volces.com/deeplearning/sglang:v0.5.17.iaas.dev.202608130000-qwen3.8-cu130 \sglang serve \--trust-remote-code \--model-path /data00/Qwen3.8-2.4T-A95B-FP8 \--tp-size 8 \--nnodes 4 \--node-rank 3 \--dist-init-addr "<rank0_private_ip>:20000" \--pp-size 4 \--dist-timeout 1800 \--linear-attn-prefill-backend flashinfer \--linear-attn-decode-backend flashinfer \--mamba-full-memory-ratio 0.95 \--mamba-radix-cache-strategy extra_buffer \--mamba-ssm-dtype bfloat16 \--max-prefill-tokens 8192 \--page-size 64 \--reasoning-parser qwen3 \--tool-call-parser qwen3_coder \--context-length 1010000 \--json-model-override-args '{"rope_parameters":{"rope_type":"yarn","rope_theta":10000000,"partial_rotary_factor":0.25,"factor":4.0,"original_max_position_embeddings":262144}}' \--host 0.0.0.0 \--port 30000
- 参数说明:
- 如上命令以部署、启动Qwen 3.8模型为例,如需部署、启动其他模型,可根据如下说明替换对应环境变量和参数值。
- 参数名称参数类型说明取值示例参数名称参数类型说明取值示例服务入口与分布式参数sglang serve启动指令通过SGLang CLI启动模型服务端。说明该内容是命令入口,而非参数。---model-path路径 / 模型 ID指定加载的LLM模型,支持Hugging Face模型ID或本地模型路径。/data00/Qwen3.8-2.4T-A95B-FP8--trust-remote-code布尔开关允许加载并执行模型仓库中的自定义代码。---tp-size整数张量并行度(Tensor Parallelism),等于单节点GPU卡数。8--pp-size整数流水线并行度(Pipeline Parallelism),等于节点数。4--nnodes整数指定分布式集群总节点数。4--node-rank整数指定当前节点在集群中的序号,从0开始。0--dist-init-addrIP:端口 / DNS:端口分布式集群初始化地址,用于多节点通信同步。实际部署中使用“Rank 0”实例的私网IP地址。192.0.0.1:20000--dist-timeout整数分布式初始化超时时间,单位 秒。1800--hostIP 地址指定服务绑定的主机地址。0.0.0.0--port整数指定服务监听端口,用于客户端连接。8080模型与推理配置如下参数为Qwen 3.8模型特有参数。--linear-attn-prefill-backend字符串线性注意力(Gated DeltaNet)层在Prefill阶段的算子后端。flashinfer--linear-attn-decode-backend字符串线性注意力层在Decode阶段的算子后端。flashinfer--mamba-full-memory-ratio浮点数mamba(线性注意力)状态缓存占总缓存显存预算的比例。0.95--mamba-radix-cache-strategy字符串mamba radix缓存策略。注意本实践中该参数必须配置为 extra_buffer,否则会与 --page-size 64 冲突,触发 MambaComponent requires page_size=1 报错。extra_buffer--mamba-ssm-dtype字符串mamba SSM状态的数据精度。bfloat16--max-prefill-tokens整数单次prefill chunk的最大 token 数。8192--page-size整数KV缓存页大小(token数)。64--reasoning-parser字符串解析模型思考内容(reasoning_content)的解析器。qwen3--tool-call-parser字符串解析模型工具调用输出的解析器。qwen3_coderLM 上下文扩展Qwen 3.8默认按约256K Token上下文启动,本文在启动命令中通过如下参数显式配置上下文长度和RoPE外推参数,启用约1M Token的长上下文能力。SGLANG_ALLOW_OVERWRITE_LONGER_CONTEXT_LEN环境变量是否允许context-length超过模型原生最大长度(262144),通过 docker run --env 命令配置。取值:
- 1:允许。启用1M Token的长上下文能力时需配置该值。
- 0:不允许。
1--context-length整数上下文窗口长度,默认值为262144。本文启用1M Token的长上下文能力,需配置为1010000。1010000--json-model-override-argsJSON 字符串覆盖模型配置。本文启用 1M 上下文能力,可通过本参数注入YaRN位置编码缩放参数factor 4.0,factor 4.0 = 262144 × 4 = 1048576,覆盖101万目标长度。{"rope_parameters":{"rope_type":"yarn","rope_theta":10000000,"partial_rotary_factor":0.25,"factor":4.0,"original_max_position_embeddings":262144}}
- 执行如下命令,通过Docker日志确认容器及模型是否成功启动。
- 查看容器ID。
- docker ps
- 查看对应容器的运行日志。
- docker logs -f <CONTAINER_ID>
说明
请将<CONTAINER_ID>替换为实际容器ID。
步骤三:调用模型
- 执行如下命令调用模型,确保部署的模型可以正常进行推理。
- curl -X POST http://127.0.0.1:30000/v1/chat/completions -H "Content-Type: application/json" -d '{"model": "/data00/Qwen3.8-2.4T-A95B-FP8","messages": [{"role": "user","content": "请直接回答:1+1等于几?"}],"max_tokens": 2048,"temperature": 0}'
-
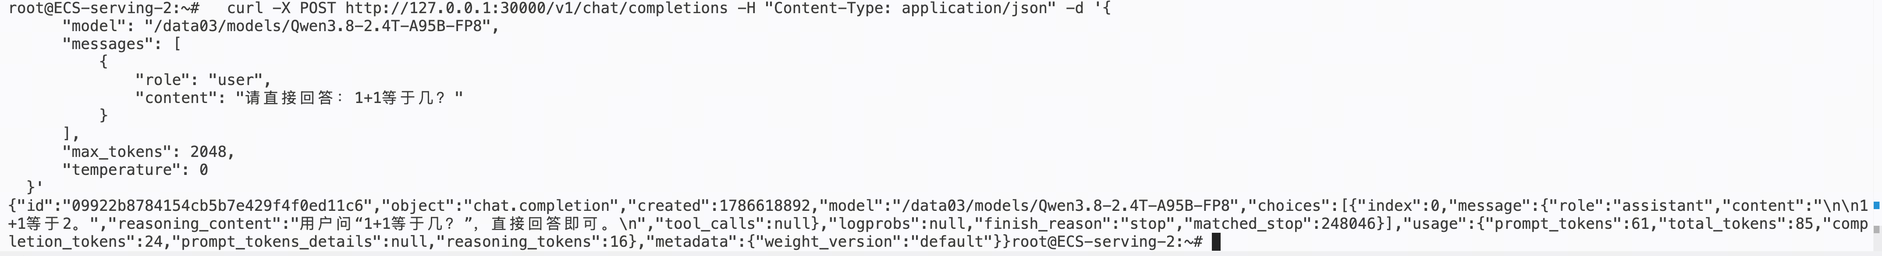
- 参数说明:
- 本文仅说明验证使用到的参数信息。
- 参数名说明取值样例参数名说明取值样例model使用的实际模型。/data00/Qwen3.8-2.4T-A95B-FP8messages对话的消息列表。
- role:该消息的发起角色。
- content:消息的内容。
-max_tokens指定一次请求中模型生成Completion的最大Token数。取值:- 介于1 到 8192 间的整数。
- 默认值为 4096。
2048temperature采样温度,值越高(例如1)会使输出更随机,而值越低(例如0.2)会使其更加集中和确定。取值:介于 0 和 2 之间。0
最近更新时间:2026.09.16 10:17:27
这个页面对您有帮助吗?
有用
有用
无用
无用