GPU云服务器
GPU云服务器


文档指南

请输入


- 文档首页
 GPU云服务器GPU云服务器最佳实践AIGC实践DeepSeek系列模型GPU-部署DeepSeek-V4-Pro模型
 复制全文
 下载 pdf
GPU-部署DeepSeek-V4-Pro模型
 文档反馈
 问问助手
本文以2台ecs.hpcpni3ln.45xlarge实例为例,介绍如何在GPU云服务器上部署DeepSeek-V4-Pro模型。
背景信息
DeepSeek-V4-Pro是DeepSeek-V4预览版系列中的旗舰级大语言模型,采用稀疏混合专家(Mixture-of-Experts, MoE)架构,总参数量达1.6万亿(1.6 T),每次前向推理动态激活约49 B参数,在保持高性能的同时显著降低单Token推理成本。其最大推理强度模式DeepSeek-V4-Pro-Max在数学、STEM、竞赛级编程等评测上超越此前全部公开的开源模型,并与主流闭源前沿模型处于同一性能区间,适用于复杂推理、长文档深度分析、多步Agent编排等前沿任务。
软件要求
- NVIDIA驱动:
- GPU驱动:用来驱动NVIDIA GPU的程序,本文以535.161.08为例。
- 运行环境:
- SGLang框架:SGLang框架是一款专为大语言模型(Large Language Models,LLMs)及视觉语言模型打造的高性能服务框架,通过协同设计前端结构化生成语言与后端运行时系统,实现与模型的高效交互,并保障了生成过程的可控性。
操作步骤
步骤一:准备环境
- 创建GPU计算型实例。
- 请根据通过向导购买实例指引,创建2台符合如下条件的实例:
-
- 安装依赖的软件、工具。
- 依次登录2台GPU实例。了解更多。
- 在2台GPU实例中,均执行如下命令,安装、配置Docker。
-
- 在2台GPU实例中,均执行如下命令,安装NVIDIA Container Toolkit。
-
- 在2台GPU实例中,均执行如下命令配置Docker,使容器可以使用实例的GPU资源。
-
- (可选)初始化本地盘。
- 若您选用的实例规格搭配有本地盘,建议您执行如下命令将本地盘挂载到存储模型的目录“/data00”,提升模型加载速度。
-
说明
- 请将/dev/nvme0n1替换为实际本地盘名称。
- 请将ext4替换为您期望使用的文件系统。
步骤二:部署、运行模型
- 依次登录2台GPU实例。了解更多。
- 下载模型文件。
- 在2台GPU实例中,均执行如下命令,安装配置onion。
-
- 在2台GPU实例中,均执行如下命令,下载DeepSeek-V4-Pro-0813模型并将其存放至目标目录。
说明
- 请将/data00替换为实际存放模型的目录。
- 您也可以执行oniond list model命令,查看支持模型列表。
-
- 请根据实例所在地域,在2台GPU实例中均执行如下命令,下载Docker镜像。
-
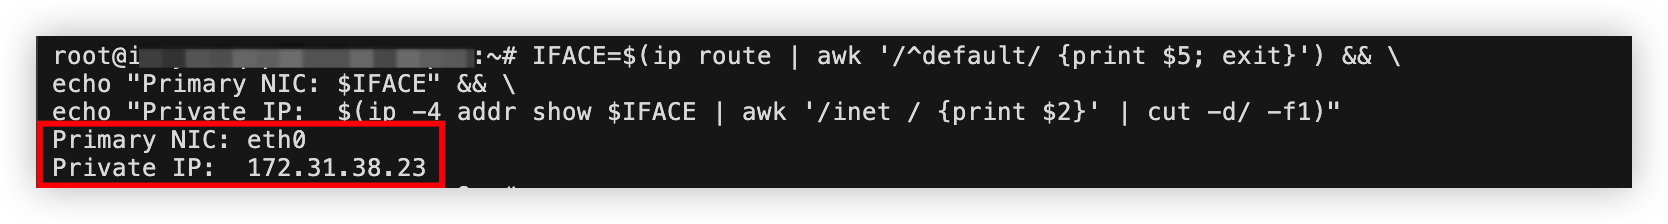
- 请在“节点0”实例中执行如下命令,查看其主网卡名称与对应的私网IP地址,用于后续配置多节点间的分布式通信与网络互通。
说明
本文以主网卡名称eth0,对应私网IP地址172.31.38.23为例。
-
- 回显如下所示时,表示“节点0”实例的主网卡名称为eth0,对应私网IP地址为172.31.38.23。
-
- 请根据实例所在地域,依次在2台GPU实例中执行对应命令,启动Docker容器与DeepSeek-V4-Pro模型服务。
说明
- 请将/data00替换为模型实际存放目录路径。
- 请将eth0替换为“节点0”实例实际主网卡名称。
- 请将172.31.38.23替换为“节点0”实例实际主网卡私网IP地址。
-
- “节点0”实例
-
- “节点1”实例
-
- “节点0”实例
-
- “节点1”实例
-
- 参数说明:
- 如上命令以部署、启动DeepSeek-V4-Pro模型为例,如需部署、启动其他模型,可根据如下说明替换对应环境变量和参数值。
-
- 在2台GPU实例中,均执行如下命令,通过Docker日志确认容器及模型是否成功启动。
- 查看容器ID。
-
- 查看对应容器的运行日志。
-
说明
请将<CONTAINER_ID>替换为实际容器ID。
步骤三:调用模型
- 登录“节点0”实例,进入其Docker容器。
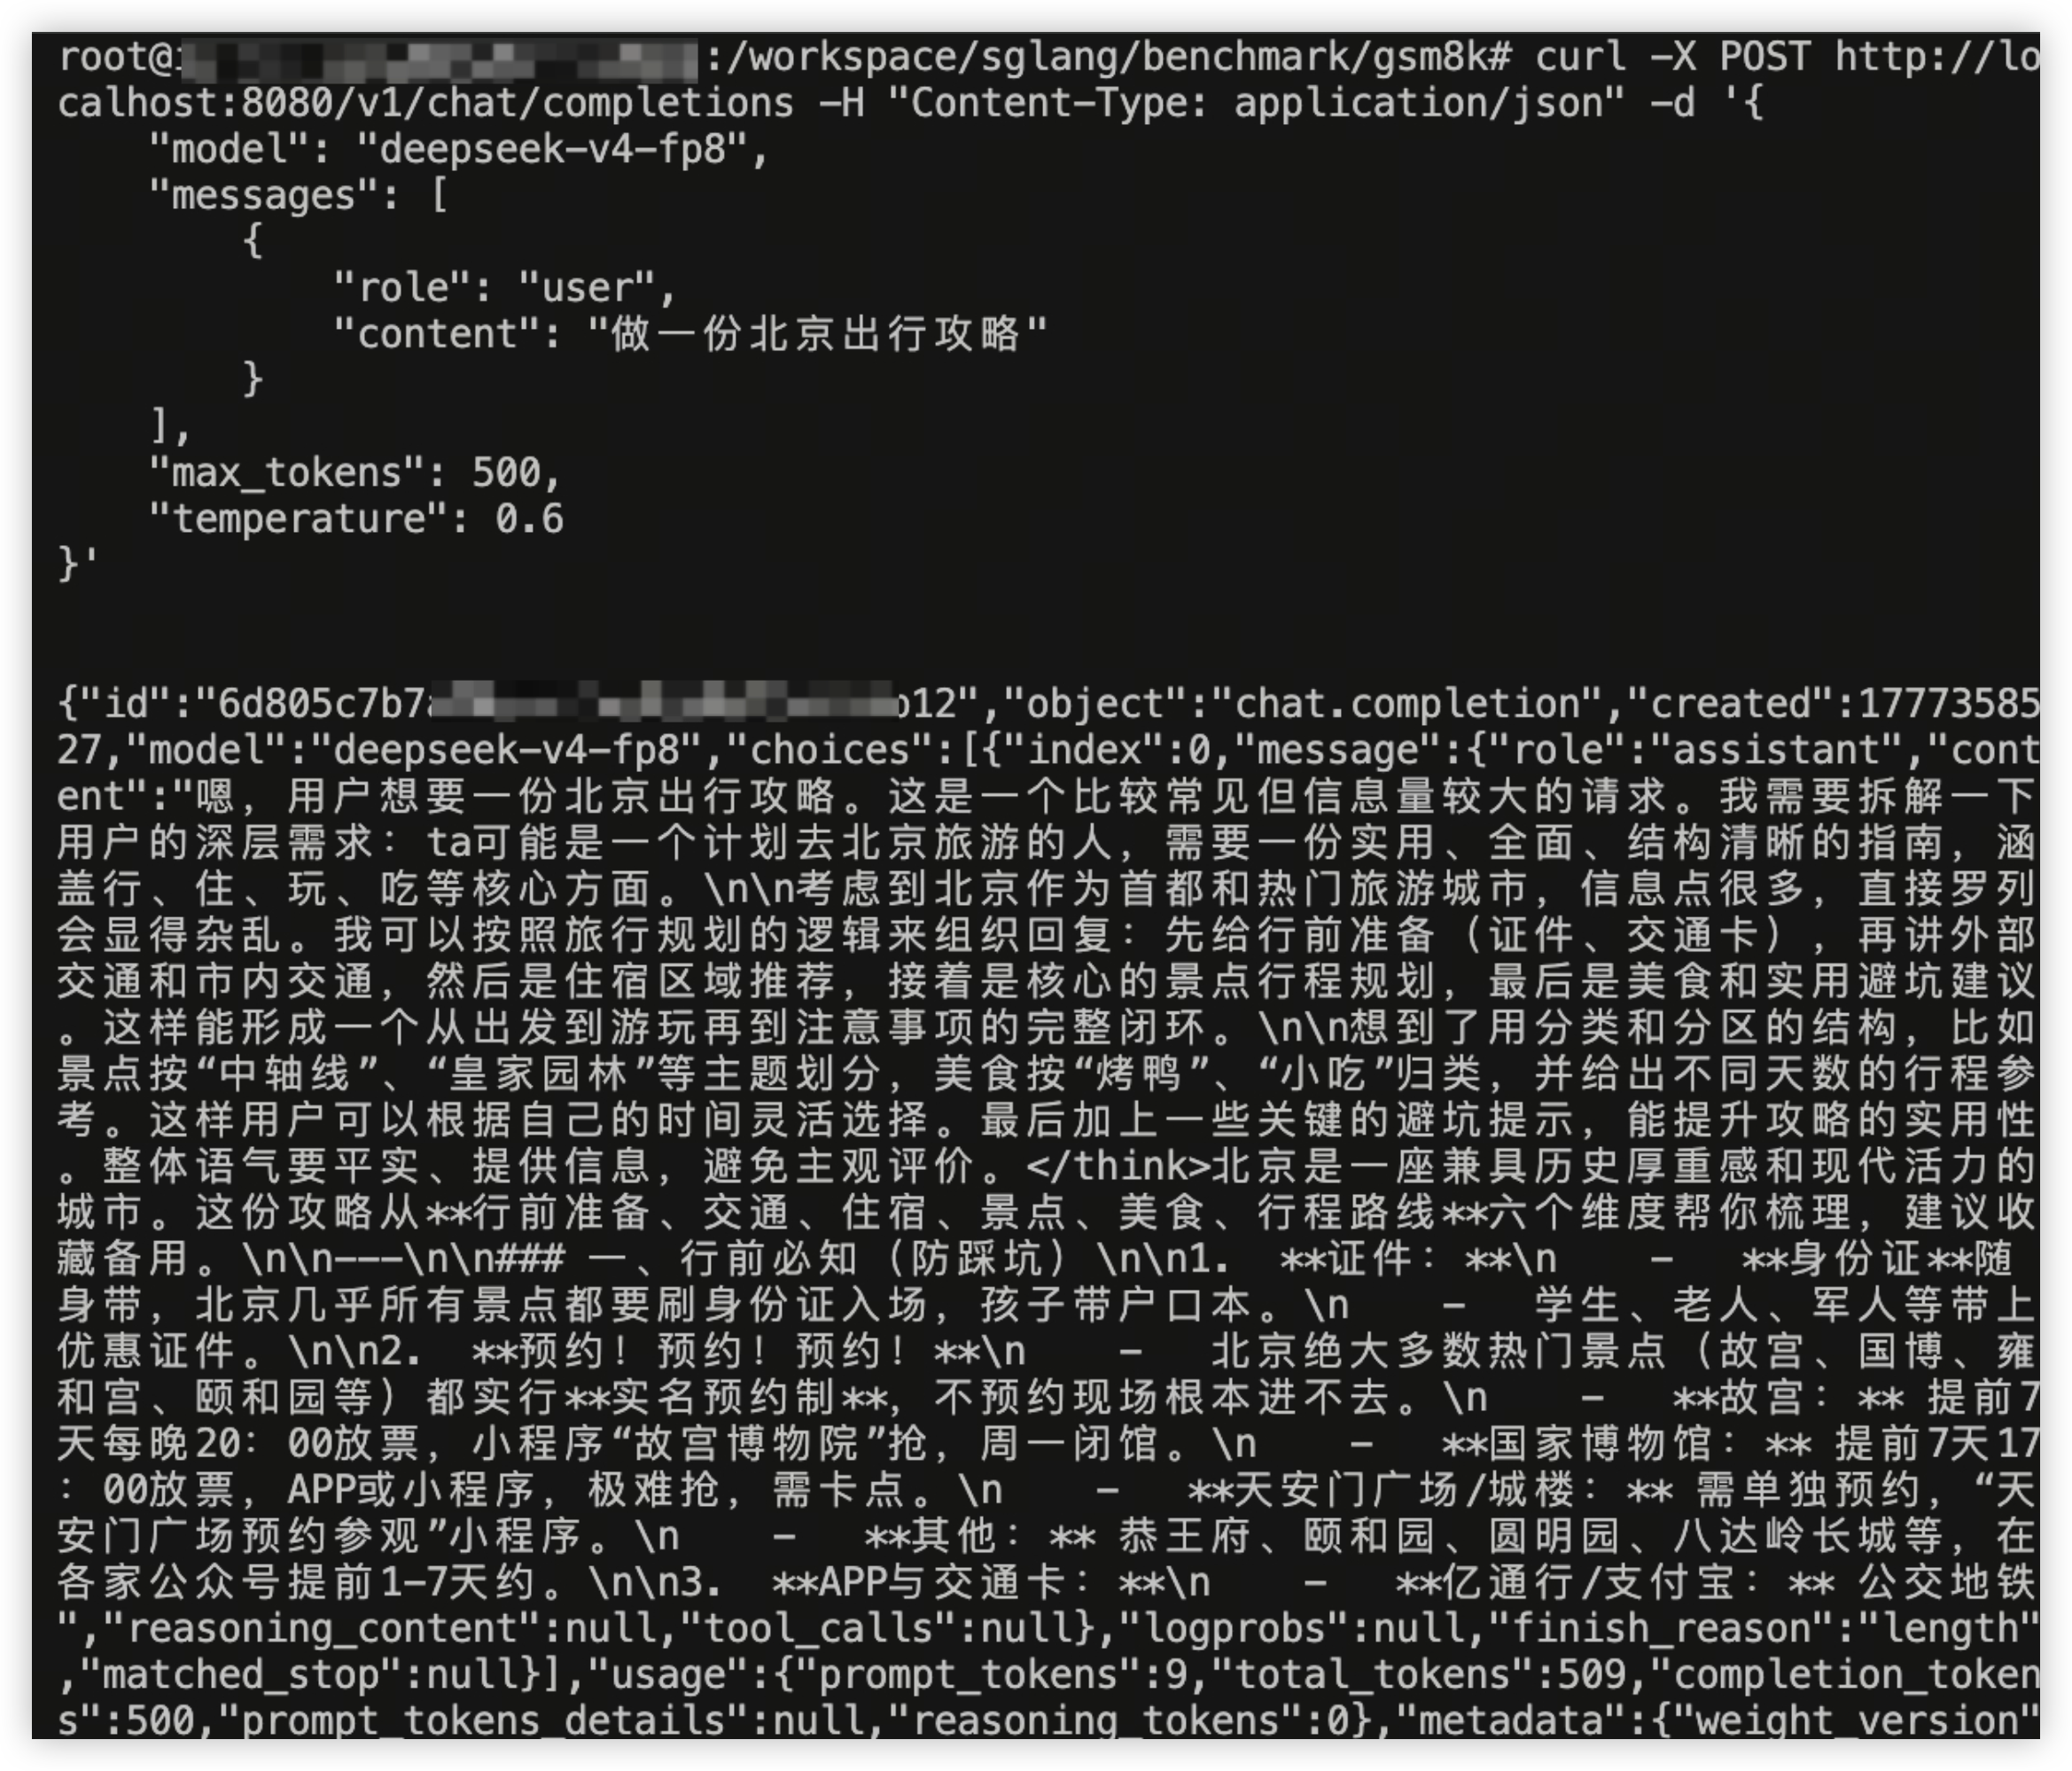
- 执行如下命令调用模型,确保部署的模型可以正常进行推理。
-
- 若展示如下信息,则服务正常运行。
-
- 参数说明:
- 本文仅说明验证使用到的参数信息。
-
最近更新时间:2026.08.26 21:05:52
这个页面对您有帮助吗?
有用
有用
无用
无用