You need to enable JavaScript to run this app.
文档中心
日志服务

日志服务

复制全文
下载 pdf
最佳实践
基于日志的 JuiceFS 可观测最佳实践
复制全文
下载 pdf
基于日志的 JuiceFS 可观测最佳实践
方案介绍​
JuiceFS 是一款基于 Apache 2.0 开源协议,面向云原生设计的高性能分布式文件系统。提供完备的 POSIX 兼容性,可将几乎所有对象存储接入本地作为海量本地磁盘使用,也可同时在跨平台、跨地区的不同主机上挂载读写。​
每个 JuiceFS 客户端都有访问日志,其中详细记录了文件系统上的所有操作,如操作类型、用户 ID、用户组 ID、文件 inode 及其花费的时间。​
JuiceFS 的访问日志用途广泛,如性能分析、审计、故障诊断。但日志分布在多个客户端和服务器,收集和分析都比较困难,难以建立完整的监控和告警机制。​
火山引擎日志服务(TLS)是一站式日志管理平台,提供日志采集、存储、查询、分析、可视化和告警等功能。日志服务 TLS 可对 JuiceFS 的访问日志分析提供以下帮助:​
​
日志服务 TLS 功能​
说明​
解决日志分散问题​
统一采集和管理分布在各个客户端和服务器的 JuiceFS 访问日志。​
解决日志结构不统一问题​
采集时进行解析处理,将不同格式的日志统一成便于分析的日志结构。​
支持复杂查询分析​
利用 TLS 的 SQL 分析能力,实现对日志的深度挖掘。​
提供即开即用的分析大盘​
针对 JuiceFS 日志分析常见场景预设分析模板,提供即开即用的分析大盘。​
提供实时监控告警能力​
配置监控规则,实时监控日志,及时发现并响应异常。​
​
本文介绍如何从日志服务 TLS 采集 JuiceFS 的访问日志,并实现各种分析大盘和实时监控告警。​
分析流程​
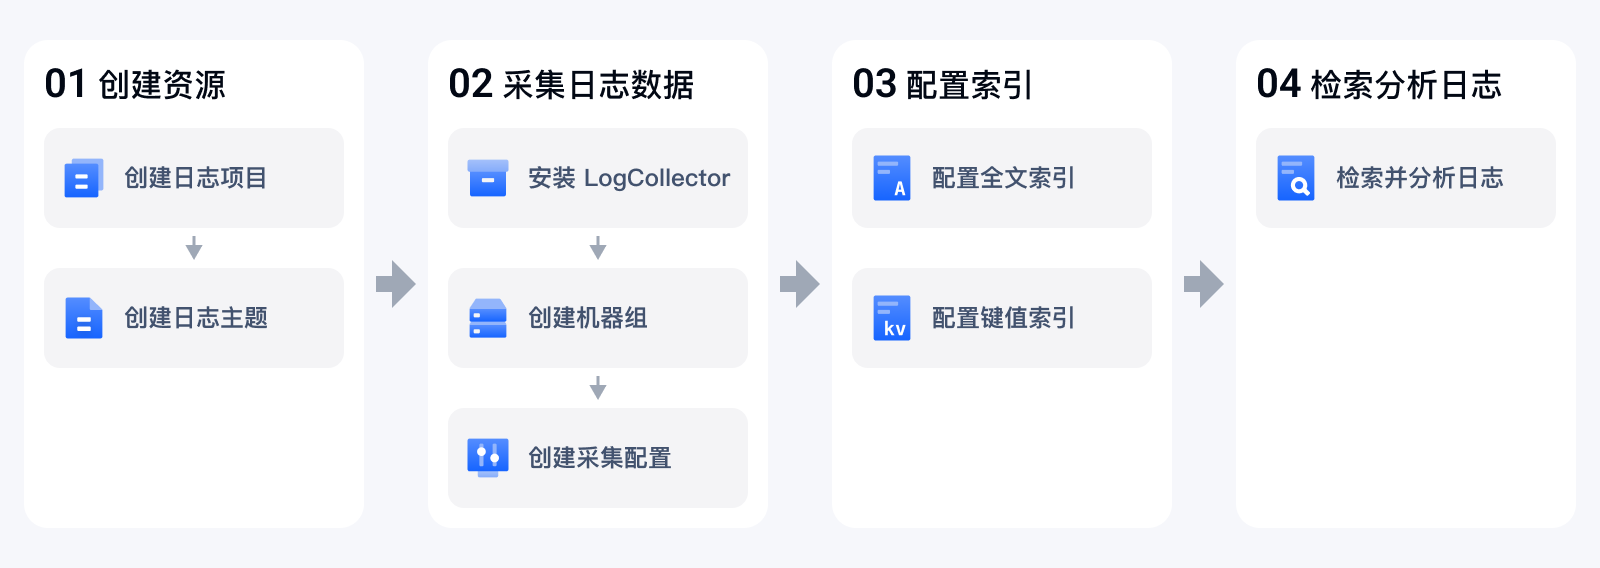
日志分析流程为日志采集、日志分析大盘和实时监控告警。流程如下:​
​​​
采集 JuiceFS 日志​
JuiceFS 访问日志格式​
JuiceFS 访问日志保存在 JuiceFS 客户端内,输出的日志字段在同一行,无法直接进行统计,需要进行提取解析。​
  • 日志格式​
  • ​
    2021.01.15 08:26:11.003330 [uid:0,gid:0,pid:4403] write (17669,8666,4993160): OK <0.000010>​
    ​
  • 字段解释​
  • ​
    日志字段​
    说明​
    2021.01.15 08:26:11.003330​
    记录操作的时间。​
    [uid:0,gid:0,pid:4403]​
    记录操作的用户 ID、用户组 ID、进程 ID。​
    write (17669,8666,4993160)​
    记录的操作类型,及对应的输入参数(不同操作的输入参数不同)。​
    write 输入参数:写入文件的 inode、写入数据的大小、写入文件的偏移。​
    OK <0.000010>​
    记录操作是否执行成功,及对应的耗时(单位:秒)。​
    如果不成功会输出具体的失败信息。​
    ​
日志采集​
日志服务 TLS 自研的日志采集器 Logcollector 提供多种采集模式和丰富的日志处理插件,特点是兼容性好、性能高,可适配多家云厂商和 idc 环境,单 core 性能最高可达 100MB/s。同等性能要求下,对资源的消耗更少,可节省更多资源成本。​
在服务器中安装 LogCollector(宿主机)后,通过控制台即可下发采集规则、快速接入日志服务。还可以根据不同的性能要求,参考设置 LogCollector 启动参数设置不同的初始参数调整 CPU 阈值和内存阈值。​
通过在日志服务控制台中依次创建机器组、日志项目、日志主题及采集规则等资源,即可上报服务器的日志数据到日志服务。​
​​​
日志解析​
由于 JuiceFS 客户端的访问日志详细记录了文件系统的所有操作,且每个文件系统操作对应的访问日志结构有所差异,所以需要使用fullregex 插件进行链式结构化处理。​
fullregex 插件配置​
  • ​
    {​
    "processors": [​
    {​
    "fullregex": {​
    "field": "__content__",​
    "keys": [​
    "time",​
    "uid",​
    "gid",​
    "pid",​
    "op",​
    "result"​
    ],​
    "pattern": "(\\d{4}\\.\\d{2}\\.\\d{2} \\d{2}:\\d{2}:\\d{2}\\.\\d+) \\[uid:(\\d+),gid:(\\d+),pid:(\\d+)\\] (\\w+) (.*)"​
    }​
    },​
    {​
    "fullregex": {​
    "field": "result",​
    "keys": [​
    "inode",​
    "length",​
    "offset",​
    "filehandle",​
    "status",​
    "delay"​
    ],​
    "pattern": "\\((\\d+),(\\d+),(\\d+),(\\d+)\\): (\\w+) \\<(.*)\\>",​
    "when": {​
    "equals": {​
    "op": "write"​
    }​
    }​
    }​
    },​
    {​
    "fullregex": {​
    "field": "result",​
    "keys": [​
    "inode",​
    "length",​
    "offset",​
    "status",​
    "unknown",​
    "delay"​
    ],​
    "pattern": "\\((\\d+),(\\d+),(\\d+)\\): (\\w+) \\((\\d+)\\) \\<(.*)\\>",​
    "when": {​
    "equals": {​
    "op": "read"​
    }​
    }​
    }​
    },​
    {​
    "fullregex": {​
    "field": "result",​
    "keys": [​
    "inode",​
    "filename",​
    "status",​
    "delay"​
    ],​
    "pattern": "\\((\\d+),(.*)\\): (\\w+) \\<(.*)\\>",​
    "when": {​
    "equals": {​
    "op": "unlink"​
    }​
    }​
    }​
    },​
    {​
    "fullregex": {​
    "field": "result",​
    "keys": [​
    "parent_inode",​
    "filename",​
    "mode",​
    "status",​
    "inode",​
    "others",​
    "filehandle",​
    "delay"​
    ],​
    "pattern": "\\((\\d+),(.*),(.*)\\): (\\w+) \\((\\d+),(.*)\\) \\[fh:(\\d+)\\] \\<(.*)\\>",​
    "when": {​
    "equals": {​
    "op": "create"​
    }​
    }​
    }​
    },​
    {​
    "fullregex": {​
    "field": "result",​
    "keys": [​
    "inode",​
    "status",​
    "filehandle",​
    "delay"​
    ],​
    "pattern": "\\((.*)\\): (\\w+) \\[fh:(\\d+)\\] \\<(.*)\\>",​
    "when": {​
    "equals": {​
    "op": "open"​
    }​
    }​
    }​
    },​
    {​
    "fullregex": {​
    "field": "result",​
    "keys": [​
    "parent_inode",​
    "filename",​
    "status",​
    "inode",​
    "mode",​
    "delay"​
    ],​
    "pattern": "\\((\\w+),(\\w+)\\): (\\w+) \\((\\d+),(.*)\\) \\<(.*)\\>",​
    "when": {​
    "equals": {​
    "op": "lookup"​
    }​
    }​
    }​
    },​
    {​
    "fullregex": {​
    "field": "result",​
    "keys": [​
    "inode",​
    "filehandle",​
    "status",​
    "delay"​
    ],​
    "pattern": "\\((\\w+),(\\w+)\\): (\\w+) \\<(.*)\\>",​
    "when": {​
    "equals": {​
    "op": "flush"​
    }​
    }​
    }​
    }​
    ]​
    }​
    ​
fullregex 插件流程​
  1. 通用解析。​
  • 针对 JuiceFS 客户端访问日志的原始内容字段__content__,使用正则表达式提取基础字段。​
  • ​
    字段​
    说明​
    time​
    操作时间,格式如2024.06.30 12:34:56.789。​
    uid​
    用户 ID。​
    gid​
    组 ID。​
    pid​
    进程 ID。​
    op​
    操作类型,如 write、read、open 等。​
    result​
    操作结果,根据操作类型进一步详细解析​
    ​
  1. 操作结果result解析。​
  • 针对不同操作类型op,选择对应的正则表达式,对操作结果result进行详细解析,提取具体的操作参数和状态。​
  • ​
    操作类型​
    正则表达式​
    操作结果的提取字段​
    write​
    (\d+),(\d+),(\d+),(\d+)\): (\w+) <(.*)>​
    inode、length、offset、filehandle、status、delay​
    read​
    (\d+),(\d+),(\d+)\): (\w+) \((\d+)\) <(.*)>​
    inode、length、offset、status、unknown、delay​
    unlink​
    (\d+),(.*)\): (\w+) <(.*)>​
    inode、filename、status、delay​
    create​
    (\d+),(.*),(.*)\): (\w+) \((\d+),(.*)\) \[fh:(\d+)\] <(.*)>​
    parent_inode、filename、mode、status、inode、others、filehandle、delay​
    open​
    (.*): (\w+) \[fh:(\d+)\] <(.*)>​
    inode、status、filehandle、delay​
    lookup​
    (\w+),(\w+)\): (\w+) \((\d+),(.*)\) <(.*)>​
    parent_inode、filename、status、inode、mode、delay​
    flush​
    (\w+),(\w+)\): (\w+) <(.*)>​
    inode、filehandle、status、delay​
    ​
日志索引设计​
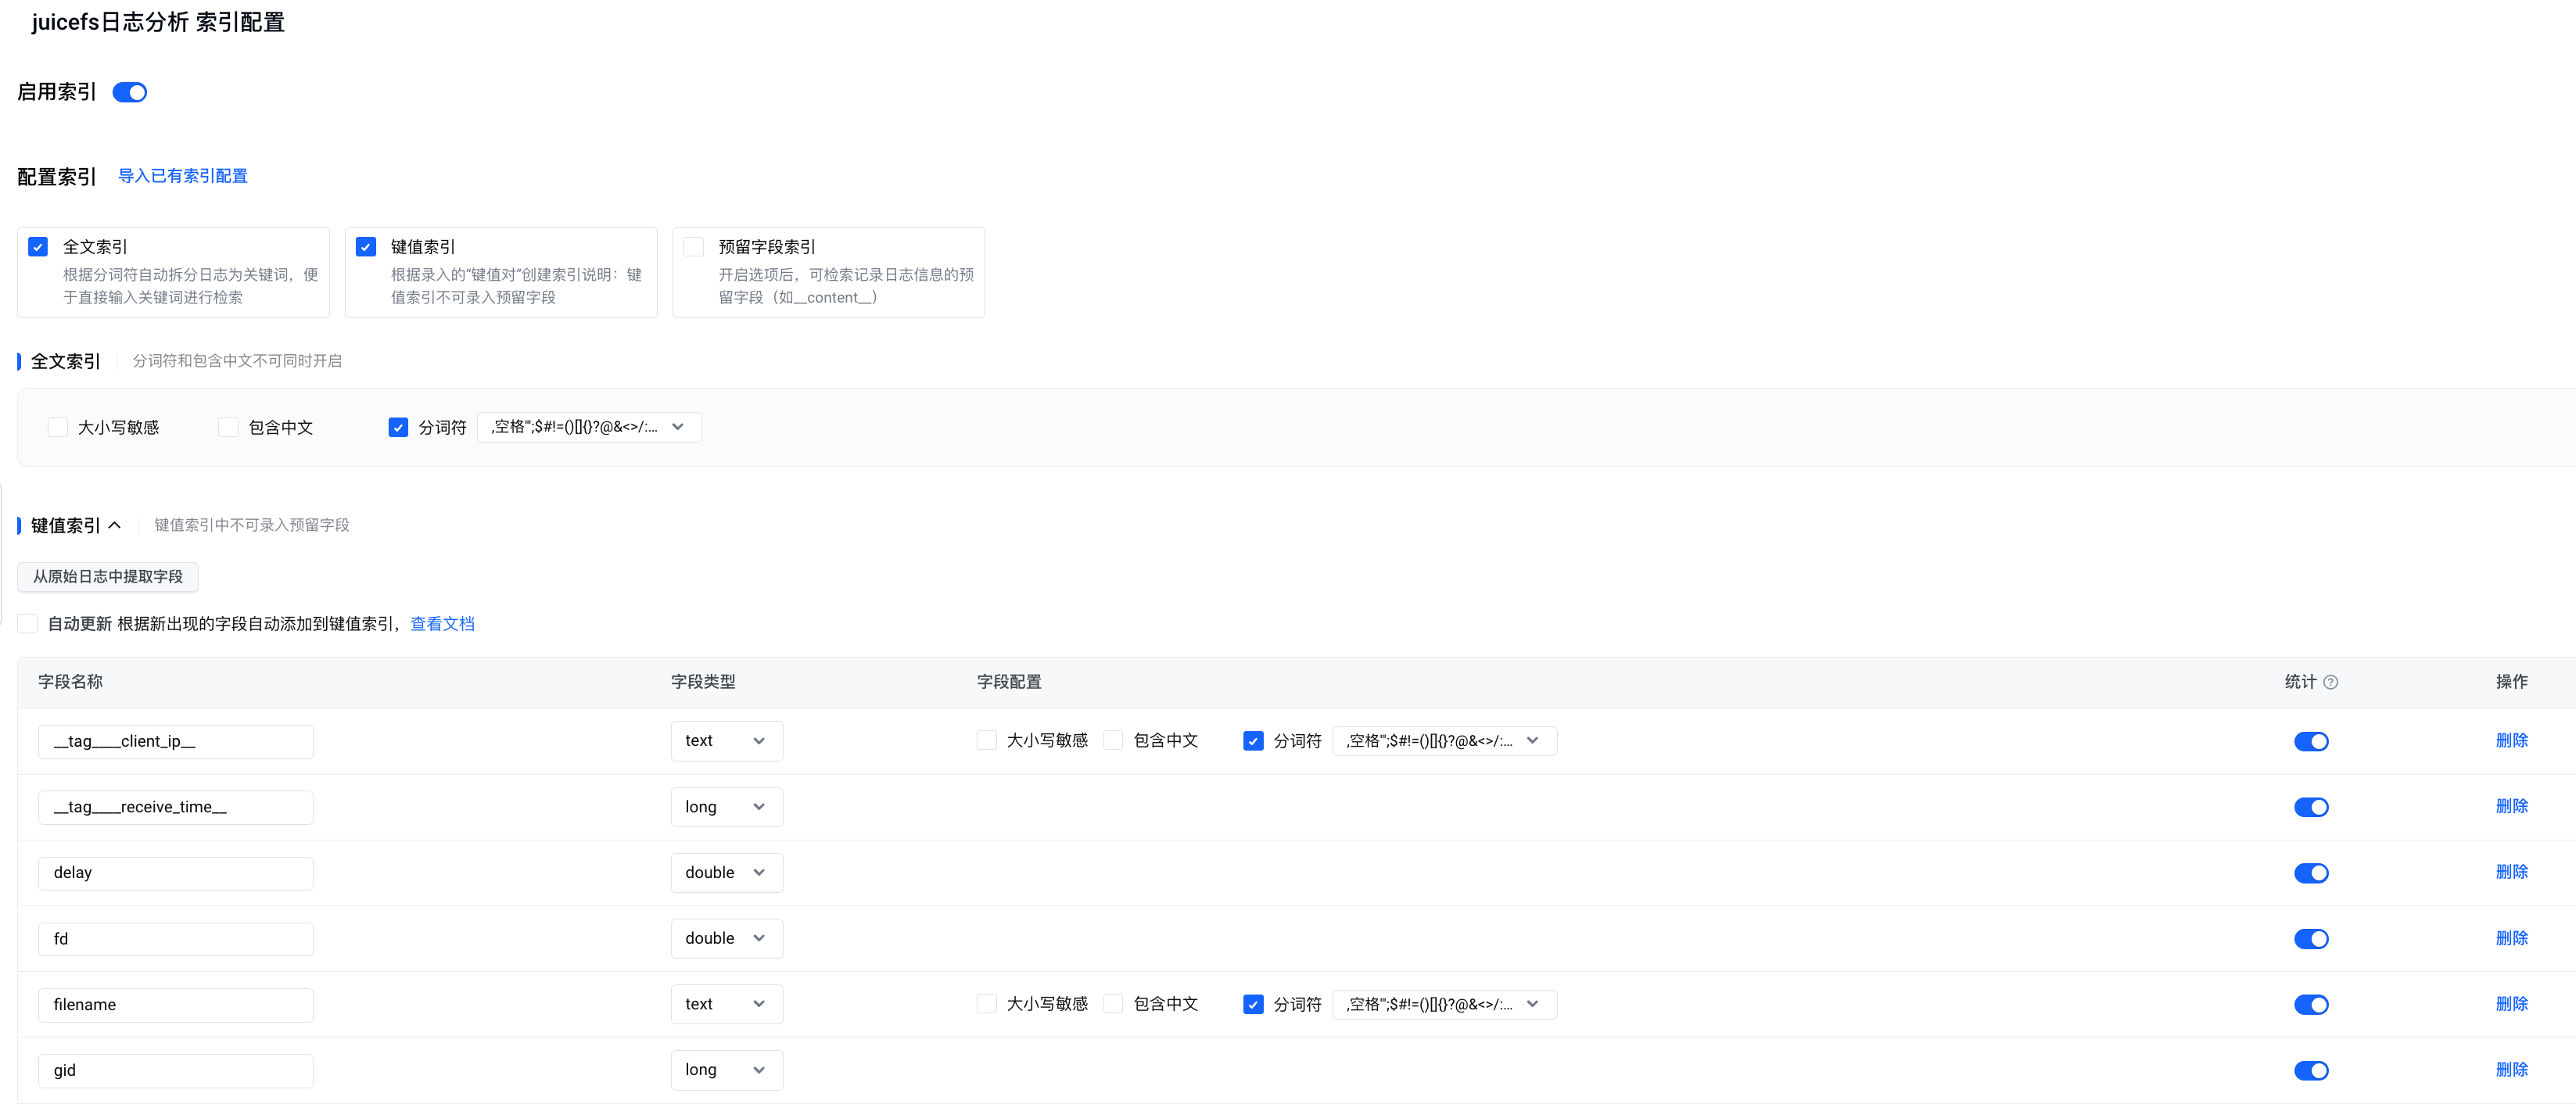
对于采集到的日志,配置索引后才能进行日志检索和分析操作。​
在日志服务控制台的常用功能 > 检索分析中,选择日志项目 > 日志主题,单击索引配置,即可配置具体的索引类型及其详细字段。详情可参考配置索引。​
​​​
为 JuiceFS 访问日志配置的键值索引字段解释如下:​
​
字段名称​
字类型​
字段说明​
uid​
long​
用户 ID(User ID),执行该操作的用户身份标识。​
gid​
long​
组 ID(Group ID),执行该操作的用户所属的用户组标识。​
pid​
long​
进程 ID(Process ID),执行该操作的进程编号,便于追踪具体进程。​
op​
text​
操作类型(Operation),日志中记录的文件系统操作。​
如 write、read、open、create、unlink 等。​
delay​
double​
操作延迟,通常表示此次操作耗时,可能是毫秒或微秒级别。​
inode​
long​
文件的索引节点号(inode),唯一标识文件系统中的一个文件。​
length​
long​
写入的数据长度(字节数),表示此次写操作写了多少字节。​
offset​
long​
写入偏移量,表示从文件的哪个位置开始写入数据。​
filename​
text​
查找的文件名。​
filehandle​
long​
文件句柄,系统内部用于标识打开的文件实例。​
status​
text​
操作状态,例如OK表示写操作成功,其他值可能表示错误类型。​
mode​
text​
文件权限和类型信息。​
parent_inode​
long​
查找操作的父目录索引节点号。​
time​
text​
日志时间。​
others​
text​
其他信息,可能包含额外的元数据或标志。​
unknown​
text​
未知字段,可能是某种内部状态码或额外信息,需结合具体日志格式确认。​
​
创建 JuiceFS 日志仪表盘​
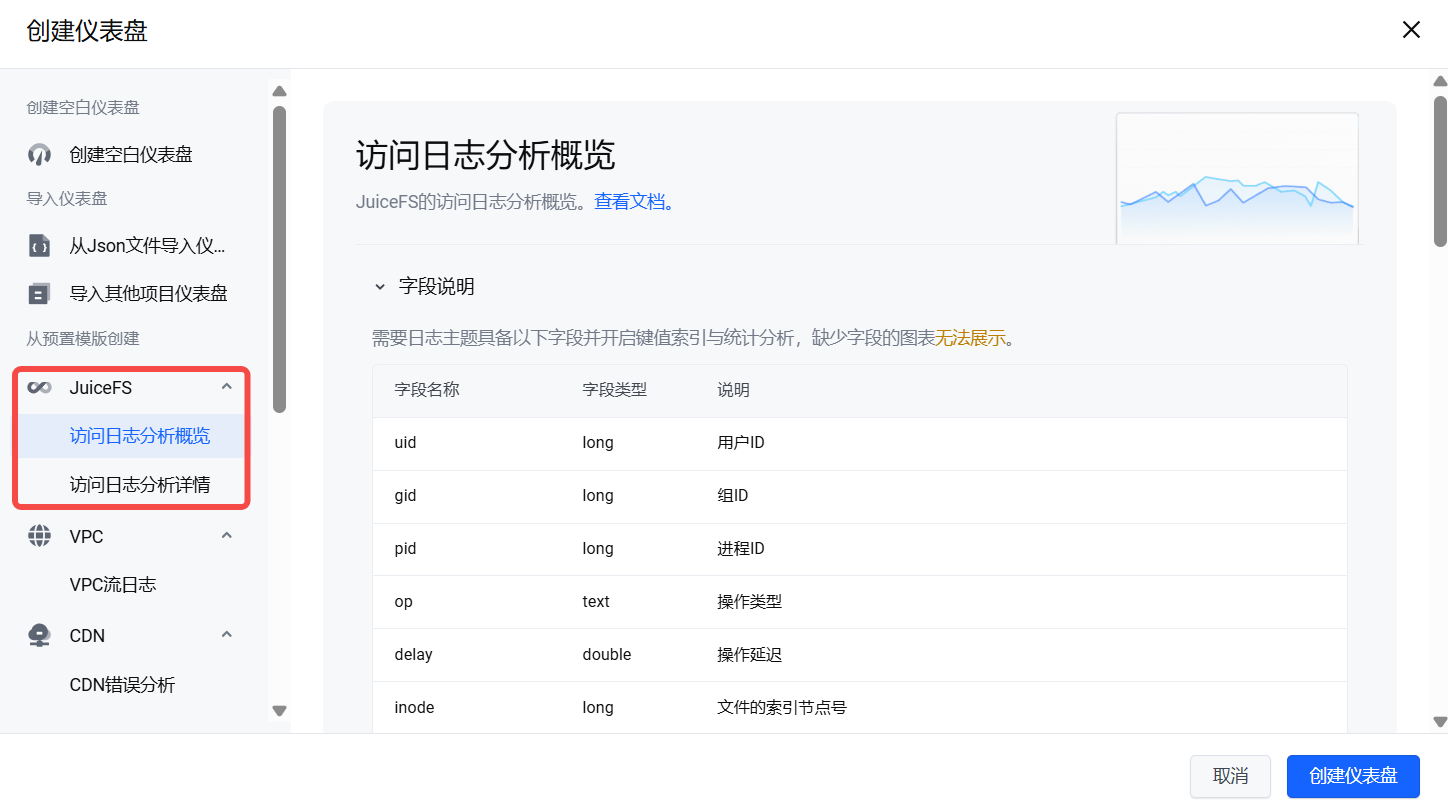
在 JuiceFS 的使用场景中,有许多关键指标需要重点关注,例如读、写、删除等操作的次数与数据量统计、IO 大小与执行耗时的分布,以及顺序读占比、覆盖写情况等。​
日志服务 TLS 支持自定义仪表盘,同时针对核心的分析场景,TLS 已将其提炼为仪表盘模板,可基于模板一键快速创建出分析大盘。详情可参考创建空白仪表盘。​
通过介绍写 IO 大小分布、顺序读占比分布、覆盖写分析、文件生命周期分布示例展示了从简单的操作统计,到复杂的顺序读检测、覆盖写检测、生命周期分析,均可以通过 SQL + TLS 可视化仪表盘轻松实现,为 JuiceFS 用户提供了灵活且深入的访问日志洞察能力。​
​​​
使用仪表盘过滤器​
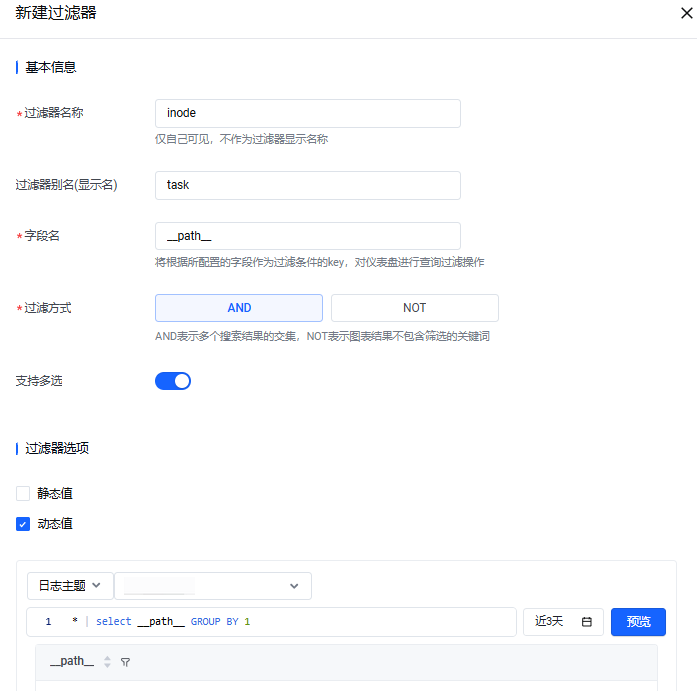
在实际日志分析中,经常需要对特定文件或路径进行筛选。TLS 仪表盘提供了过滤器功能,用户可在控制台添加过滤器,并配置过滤条件。​
例如,访问日志时,不同任务的日志存储路径不同,可基于字段__path__创建名为task的过滤器,取值来源于实际日志的 SQL 运行结果。​
​​​
配置完成后,即可在控制台上勾选需要分析的日志文件,实现针对性分析。​
​​​
  • 原始 SQL(分析所有写操作)示例:​
  • ​
    op:"write"​
    |SELECT ​
    COUNT(*) AS "总次数", ​
    AVG(length) AS "平均大小",​
    AVG(delay)*1000 AS "平均执行时间/ms", ​
    MAX(delay)*1000 AS "最大执行时间/ms", ​
    MIN(delay)*1000 AS "最小执行时间/ms"​
    ​
  • 应用过滤器后,系统自动向 SQL 中添加了 __path__ 过滤条件:​
  • ​
    op:"write" ​
    AND (__path__:"/Users/xxxx/foo/bar/accesslog/extract.log" ​
    OR ​
    __path__:"/Users/xxxx/foo/bar/accesslog/bev_cpu.log"​
    )​
    |SELECT ​
    COUNT(*) AS "总次数", ​
    AVG(length) AS "平均大小",​
    AVG(delay)*1000 AS "平均执行时间/ms", ​
    MAX(delay)*1000 AS "最大执行时间/ms", ​
    MIN(delay)*1000 AS "最小执行时间/ms"​
    ​
通过设置过滤器,可以快速筛选出关注的日志范围并生成统计结果。​
从上述示例 SQL 中可以获取到 __path__ 为 extract.log、bev_cpu.log 的 write 操作对应的总次数、写入数据的平均大小、平均执行时间、最大执行时间、最小执行时间,对应如下表格:​
​​​
写 IO 大小分布​
写操作的 IO 大小分布能反映业务负载特征。​
写 IO 大小分布示例 SQL:​
​
op: "write" ​
|SELECT​
length,​
COUNT(*) AS cnt ​
FROM​
(SELECT​
CASE ​
WHEN length < 4 * 1024 THEN '0~4K' ​
WHEN length < 8 * 1024 THEN '4K~8K' ​
WHEN length < 16 * 1024 THEN '8K~16K'​
WHEN length < 32 * 1024 THEN '16K~32K' ​
WHEN length < 64 * 1024 THEN '32K~64K' ​
WHEN length < 128 * 1024 THEN '64K~128K'​
WHEN length < 256 * 1024 THEN '128K~256K'​
ELSE '>256K' ​
END AS length ​
) ​
GROUP BY​
length​
​
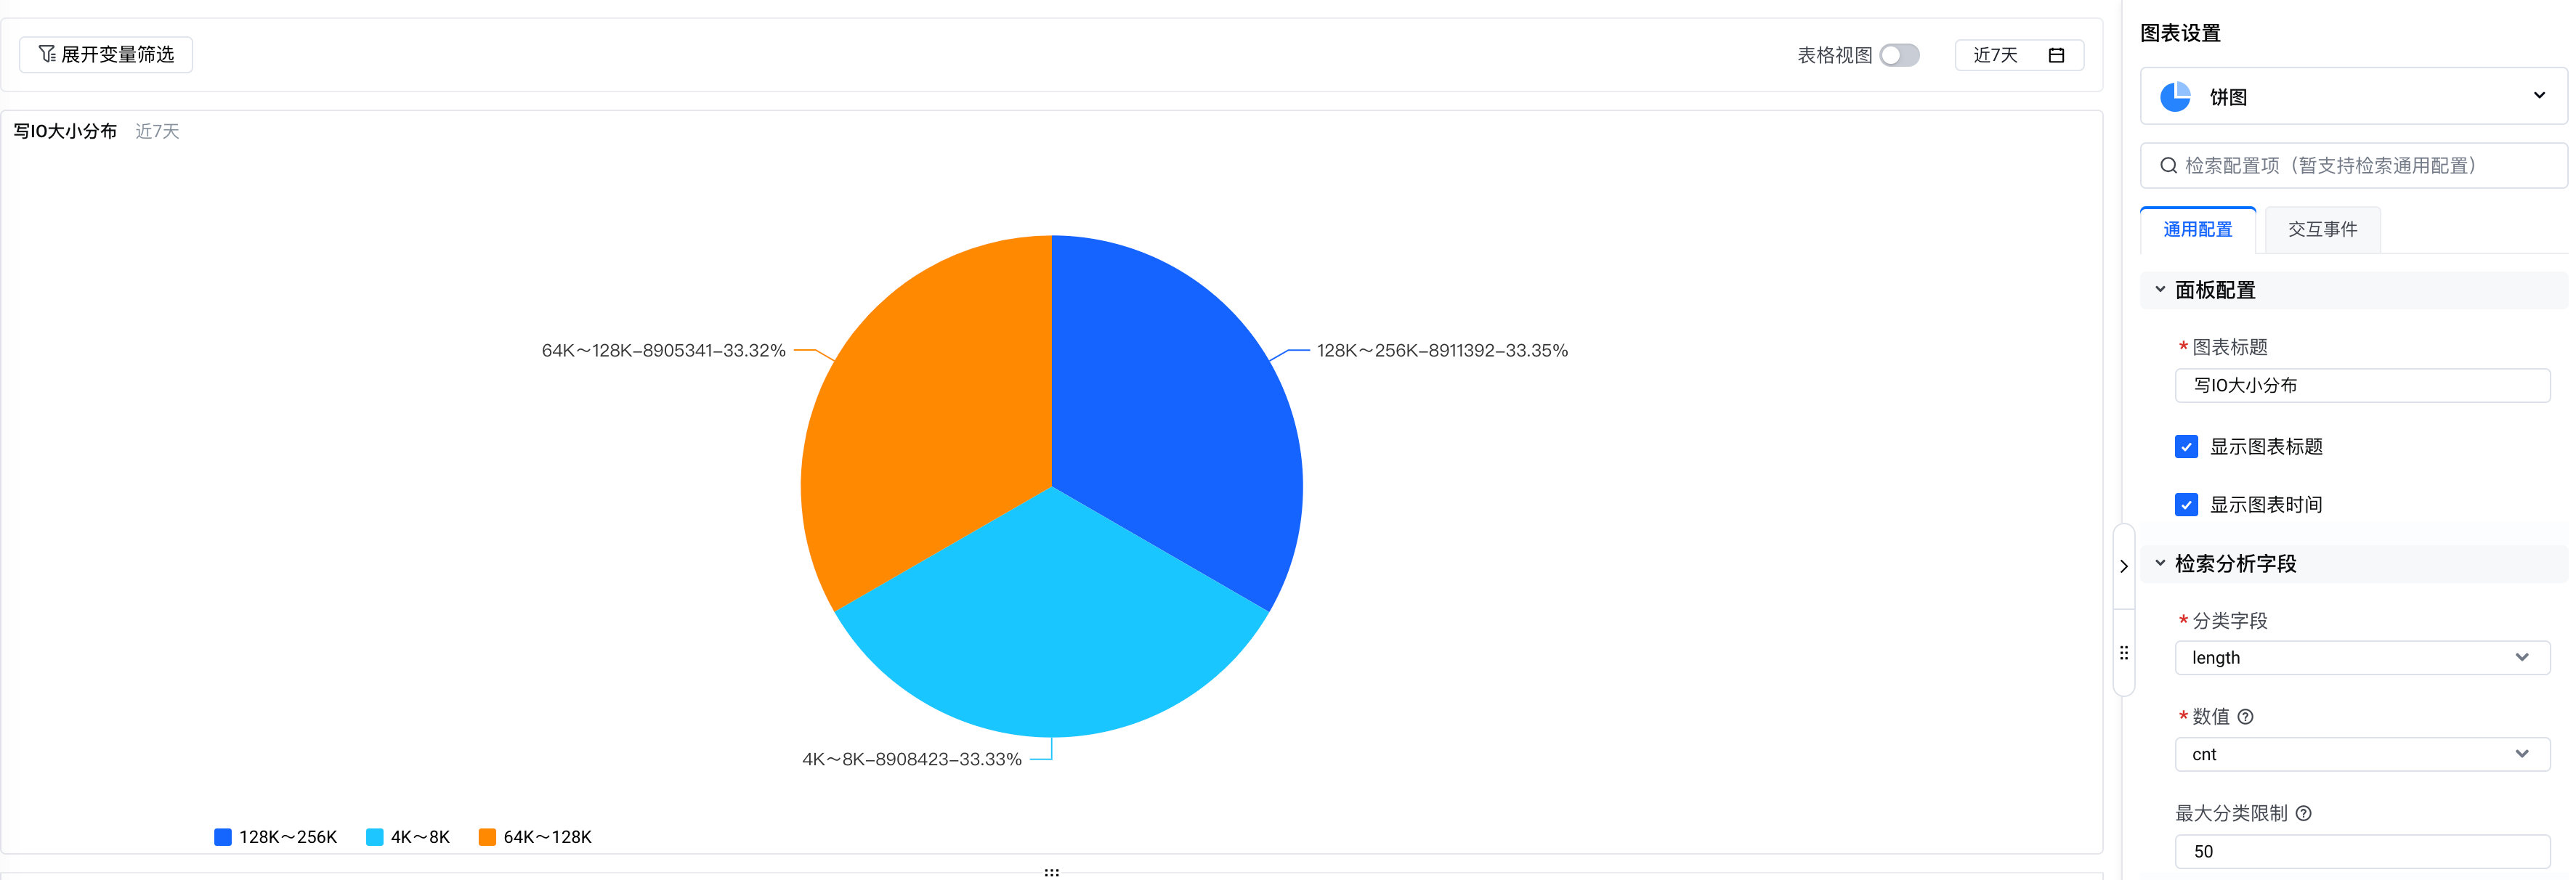
通过 CASE WHEN 把写操作长度分为不同区间,并统计每个区间的次数。​
在 TLS 仪表盘中可将结果以饼图形式展示,更直观地反映不同写 IO 大小的占比,例如 128K~256K 区间的写操作次数最多,占比 33.35%。​
​​​
顺序读占比分布​
顺序读是指当前读操作与上一次读操作的偏移范围连续(即上次读的结束位置 = 当前读的起始位置)。​
顺序读占比分布示例 SQL:​
​
op: "read"​
|WITH flagged AS (​
SELECT​
__path__, inode, length,​
CASE​
WHEN offset = LAG(offset) OVER (PARTITION BY __path__, inode ORDER BY time)​
+ LAG(length) OVER (PARTITION BY __path__, inode ORDER BY time)​
THEN length​
ELSE 0​
END AS sequentialReadSize​
)​
SELECT ​
CASE ​
WHEN ratio < 0.2 THEN '0~20%' ​
WHEN ratio < 0.4 THEN '20%~40%' ​
WHEN ratio < 0.6 THEN '40%~60%' ​
WHEN ratio < 0.8 THEN '60%~80%' ​
ELSE '80%~100%' ​
END AS "scope", ​
COUNT(*) AS cnt ​
FROM ​
(SELECT ​
__path__, inode, SUM(sequentialReadSize) * 1.00 / SUM(length) AS ratio ​
FROM ​
flagged ​
GROUP BY ​
__path__, inode ​
) ​
GROUP BY 1​
​
通过 WITH ... AS ... 子句定义了一个临时表 flagged,可以复用在其他 SQL 中以简化 SQL 的书写。​
  • 临时表flagged句式分析:​
  • 临时表包含句式:LAG(...) OVER(PARTITION BY ... ORDER BY ...)​
  • 临时表句式 SQL 示例:LAG(offset) OVER (PARTITION BY __path__, inode ORDER BY time )​
  • __path__, inode:根据这两个字段联合分区。​
  • time:在每个分区内按照该字段排序。​
  • LAG(offset):取排序后位于当前数据上一行的 offset 值。​
  • 临时表句式结果示例:​
  • ​
    行号​
    __path__​
    inode​
    time(分区内升序)​
    offset​
    结果 offset(上次写操作对应的 offset)​
    1​
    extract.log​
    303​
    1751351462000​
    32​
    NULL​
    2​
    extract.log​
    303​
    1751351463000​
    512​
    32​
    3​
    extract.log​
    303​
    1751351464000​
    1024​
    512​
    4​
    extract.log​
    303​
    1751351465000​
    2048​
    1024​
    5​
    extract.log​
    306​
    1751351462000​
    64​
    NULL​
    6​
    bev_cpu.log​
    210​
    1751351463000​
    830​
    NULL​
    7​
    bev_cpu.log​
    210​
    1751351462000​
    912​
    830​
    8​
    bev_cpu.log​
    222​
    1751351463000​
    11​
    NULL​
    ​
  • 表格中相同的__path__、 inode, 属于同一个分区,在各自的分区内按time进行升序排列。​
  • 共存在 3 个分区:第 1 行~第 5 行为第 1 个分区;第 6 行~第 7 行为第 2 个分区;第 8 行为第 3 个分区。​
  • 对于第1行,不存在上一行,因此结果 offset为 NULL。​
  • 对于第2行,上一行是第1行,因此结果 offset取第1行的 offset,也就是 32。​
  • 对于第5行,由于其所在分区只有1行,不存在上一行,因此结果 offset也是 NULL。​
  • 临时表中CASE WHEN子句分析:​
  • 如果当前读操作起始位置 offset 等于紧挨着的上一次读操作的 offset + length(也就是上次读的结束位置),那么当前读操作就是一次顺序读,此时返回当前读操作的长度 length,否则返回 0。这就是一次顺序读操作的 IO 大小,也就是 sequentialReadSize。​
  • ​
    CASE​
    WHEN offset = LAG(offset) OVER (PARTITION BY __path__, inode ORDER BY time)​
    + LAG(length) OVER (PARTITION BY __path__, inode ORDER BY time)​
    THEN length​
    ELSE 0​
    END AS sequentialReadSize​
    ​
  • 然后按 __path__、 inode 分组,求每个文件的顺序读总大小sum(sequentialReadSize)与读总大小sum(length)的占比 ratio,再按ratio分组求文件个数。​
  • ​
    SELECT ​
    CASE ​
    WHEN ratio < 0.2 THEN '0~20%' ​
    WHEN ratio < 0.4 THEN '20%~40%' ​
    WHEN ratio < 0.6 THEN '40%~60%' ​
    WHEN ratio < 0.8 THEN '60%~80%' ​
    ELSE '80%~100%' ​
    END AS "scope", ​
    COUNT(*) AS cnt ​
    FROM ​
    (SELECT ​
    __path__, inode, SUM(sequentialReadSize) * 1.00 / SUM(length) as ratio ​
    FROM ​
    flagged ​
    GROUP BY ​
    __path__, inode ​
    ) ​
    GROUP BY 1​
    ​
说明​
其中GROUP BY 1为 SQL 简写,1 代表 SELECT 子句中的第一个字段,即重命名后的 scope。​
  • 得到类似以下的饼状图,即顺序读 IO 占比在 0~20% 的文件数量有 3139 个,占比为 48.73%。​
  • ​​​
覆盖写分析​
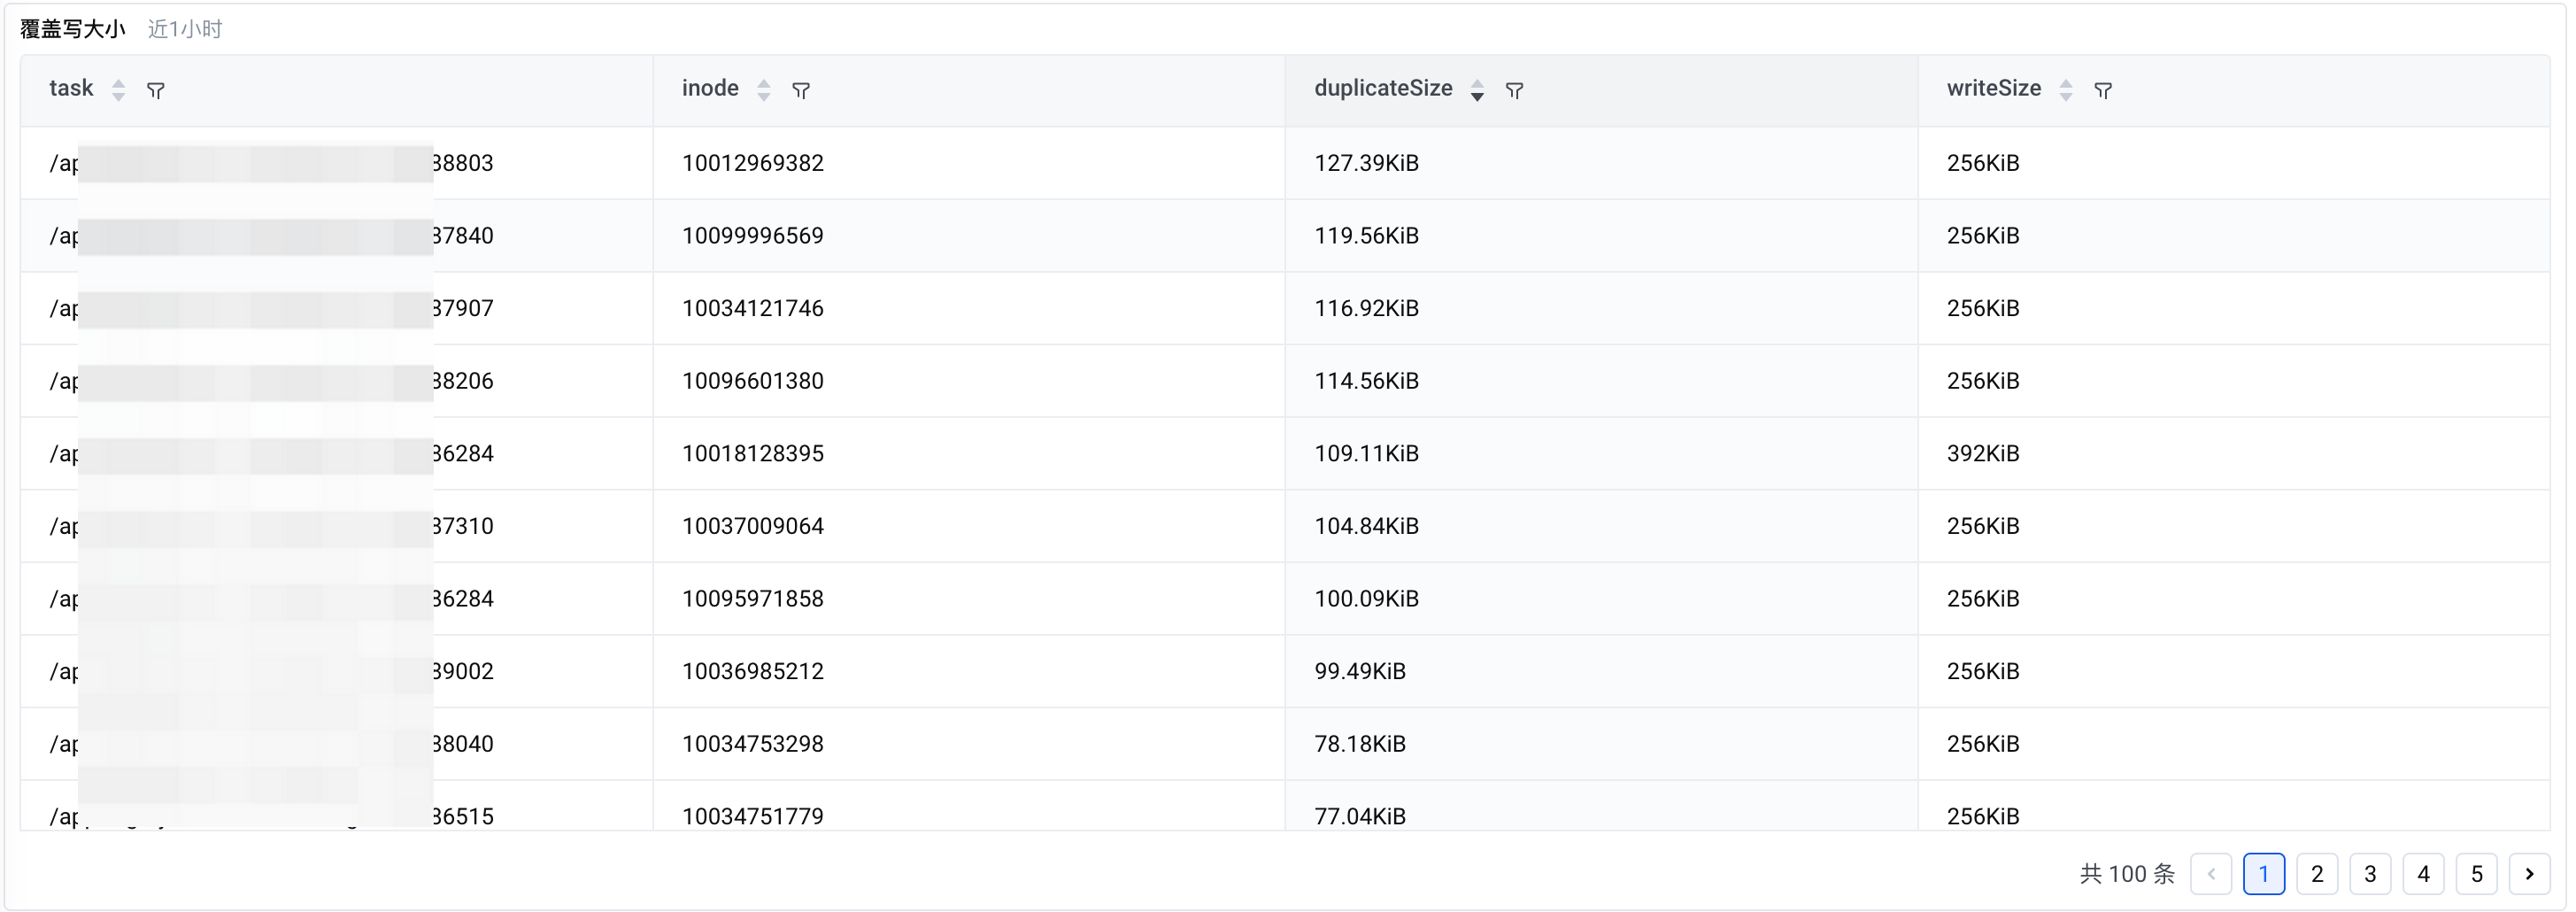
覆盖写指当前写操作与上一次写操作的偏移范围有重叠。​
例如,当前写范围 [32, 1024) 与上次写范围 [512, 2048) 有交集。​
覆盖写分析示例 SQL:​
​
op: "write" ​
|WITH flagged AS (​
SELECT​
__path__, ​
inode,​
offset,​
length,​
----------- 第一个 CASE WHEN 子句 -------------​
CASE ​
WHEN LAG(offset) OVER (PARTITION BY __path__, inode ORDER BY offset, time ) IS NULL ​
THEN -1 ​
ELSE LAG( offset ) OVER ( PARTITION BY __path__, inode ORDER BY offset,time ) ​
END AS lastOffset,​
----------- 第二个 CASE WHEN 子句 -------------​
CASE ​
WHEN LAG( length ) OVER ( PARTITION BY __path__, inode ORDER BY offset,time ) IS NULL ​
THEN -1 ​
ELSE LAG( length ) OVER ( PARTITION BY __path__, inode ORDER BY offset,time ) ​
END AS lastLength ​
) SELECT​
SUM(​
MAX(0, MIN(offset + length, lastOffset + lastLength) - MAX(offset, lastOffset))​
)/1024.0000/1024/1024 AS duplicateSize ​
FROM​
flagged​
WHERE​
lastOffset != -1 AND lastLength != -1​
​
第一个和第二个CASE WHEN 子句计算的分别是同一个日志文件(__path__)、同一个操作对象(inode),每次写操作紧挨着的上一次写操作对应的 offset、length。​
然后在每一行写操作的数据中加入了其紧挨着的上次写对应的 offset 和 length,并重命名为 lastOffset 和 lastLength。​
即对于每一行数据,都有两个数值范围 [offset, offset + length),[lastOffset, lastOffset + lastLength),这两个左闭右开的数值范围的交集是:​
​
MAX(0, MIN(offset + length, lastOffset + lastLength) - MAX(offset, lastOffset))​
​
于是上述覆盖写 SQL 的思路是:​
  1. 通过 LAG(...) OVER(PARTITION BY ... ORDER BY...) 获取每次写操作紧挨着的上次写操作对应的 offset 和 length。​
  1. 通过 CASE ... WHEN ... THEN ... ELSE ... END将不存在上次写操作的 lastOffset 和 lastLength 赋值为 -1。​
  1. 去除 lastOffset 和 lastLength 为-1的写操作,然后计算与上次写操作的重叠大小,也就是覆盖写的大小。​
​​​
文件生命周期分布​
文件生命周期定义为从创建到删除的时间长度。​
文件生命周期分布示例 SQL:​
​
op:"unlink" OR op:"create" ​
|SELECT ​
lifeTime,​
COUNT(*) AS cnt ​
FROM ​
(SELECT​
CASE ​
WHEN DATE_DIFF ('MINUTE', createTime, unlinkTime) < 10 THEN '0~10min'​
WHEN DATE_DIFF ('MINUTE', createTime, unlinkTime) < 30 THEN '10~30min'​
WHEN DATE_DIFF ('MINUTE', createTime, unlinkTime) < 60 THEN '30~60min'​
ELSE '大于60min' END AS lifeTime​
FROM​
(SELECT​
__path__, inode, filename, DATE_PARSE(time, '%Y.%m.%d %H:%i:%s.%f') AS unlinkTime​
FROM log WHERE op = 'unlink' ​
) AS unlinkTable​
JOIN ​
(SELECT ​
__path__, parent_inode,filename,inode,DATE_PARSE(time, '%Y.%m.%d %H:%i:%s.%f') AS createTime ​
FROM log WHERE op = 'create' ​
) AS createTable​
ON createTable.inode = unlinkTable.inode ​
AND createTable.filename = unlinkTable.filename ​
AND createTable.__path__ = unlinkTable.__path__​
)​
GROUP BY​
lifeTime​
ORDER BY ​
cnt​
​
  • SQL 中的 JOIN 解析:​
  • 通过关联创建和删除两个操作,可以获取到同一个文件的创建时间和删除时间。​
  • unlinkTable LEFT JOIN createTable:用创建文件时记录的 inode 与删除文件时记录的 inode 进行关联。​
  • filename 和 __path__:标识文件的唯一性。​
  • DATE_PARSE :将毫秒时间戳转换为格式化的日期类型。​
  • SQL 中的 CASE WHEN 解析:​
  • ​
    CASE ​
    WHEN DATE_DIFF ('MINUTE', createTime, unlinkTime) < 10 THEN '0~10min'​
    WHEN DATE_DIFF ('MINUTE', createTime, unlinkTime) < 30 THEN '10~30min'​
    WHEN DATE_DIFF ('MINUTE', createTime, unlinkTime) < 60 THEN '30~60min'​
    ELSE '大于60min' END AS lifeTime​
    ​
  • DATE_DIFF计算文件的 删除时间(unlinkTime)减去创建时间(createTime)得到的分钟数,然后将其划分为四个范围,即:'0~10min'、'10~30min'、'30~60min'、'大于60min'。​
  • 最后按上面的四个范围统计文件数量就可以画出以下的饼状统计图:​
  • ​​​
创建实时监控​
日志服务提供强大的告警能力,设置监控规则,实时监控日志,及时发现并响应异常。​
通过“监控各个文件的写耗时是否有耗时异常过长”这一典型场景,介绍如何通过火山引擎日志服务(TLS)的日志告警功能,来实现监控告警能力。操作详情可参考快速设置日志告警。​
  1. 创建内容模板。​
  • 内容模板是一种预定义的文本模板,日志服务会按照内容模板中定义的内容向指定的通知渠道发送告警通知。​
  • 本案例基于日志服务提供的默认模板 default-template 创建自定义内容模板。​
  • ​​​
  • ​
    内容模板示例​
    尊敬的用户,您好!\n您的账号(主账户ID:{{AccountID}} )的日志服务{%if NotifyType==1%}触发告警{%else%}告警恢复{%endif%}\n​
    告警策略:{{Alarm}}\n​
    告警日志主题:{{AlarmTopicName}}\n​
    触发时间:{{StartTime}}\n​
    触发条件:{{Condition}}\n​
    当前查询结果:[{%-for x in TriggerParams-%}{{-x-}} {%-endfor-%}];\n​
    免登链接:{{SignInUrl}}​
    ​
  1. 创建 Webhook 集成配置。​
  • Webhook 集成配置用于管理您的飞书机器人 Webhook 地址。​
  • ​​​
  1. 创建通知组。​
  • 通知组用于管理告警通知的行动策略与通知对象。创建通知组时,需选择前两步创建的 webhook 和内容模板。​
  • ​​​
  1. 创建告警策略。​
  • 告警策略中需要设置基本信息、监控任务和告警通知等配置。日志服务会基于告警策略定期分析日志,并定期将符合触发条件的告警发送给指定的通知对象。​
  • ​​​
  • 执行任务:监控对象选择对应的日志主题,输入分析语句,每个任务会定期通过该语句进行检索与分析。​
  • ​
    op: "write" | select __path__ as task, inode,sum(length) as writeSize, sum(delay) as consumedTime group by __path__, inode order by writeSize desc limit 1000​
    ​
  • 触发条件:检索分析结果中存在数据满足条件表达式时,触发告警。​
  • 图中案例表示如果 consumedTime 大于 2 则触发告警,级别为警告。每隔10分钟执行一次检查。​
  • 通知组:选择前一步所创建的通知组。​
  • 附加通知内容:添加内容变量 FireResults,可以将触发告警的数据通知出来。​
  1. 查看告警。​
  • 监控任务会周期性执行,当告警触发时,便会通过所配置的通知组进行通知。​
  • 本案例会通过配置的 Webhook 飞书机器人,将告警信息发送至指定的飞书。​
结语​
借助火山引擎日志服务 TLS 的一站式日志采集、存储、查询、分析、可视化、监控告警能力,能够帮助 JuiceFS 的用户高效解决日志分散、结构复杂等问题,实现从日志采集解析到多维分析、实时监控的全链路可观测能力。​
无论是基础的操作统计,还是复杂的顺序读检测、覆盖写分析,TLS 的 SQL 查询与可视化功能均能轻松应对,并通过预设仪表盘模板可一键创建出同款仪表盘。​
上述所提到的日志采集配置和日志分析大盘均已发布 TLS Demo 体验中心,欢迎前往体验(点击前往)。​
最近更新时间:2026.09.07 18:11:38
这个页面对您有帮助吗?
有用
有用
无用
无用