You need to enable JavaScript to run this app.
文档中心
日志服务

日志服务

复制全文
下载 pdf
检索分析
检索分析 Nginx 访问日志
复制全文
下载 pdf
检索分析 Nginx 访问日志
您可以通过 Nginx 访问日志监控网站运行状况以及快速定位网站异常问题。本文介绍 Nginx 访问日志的常见分析场景及示例。​
背景信息​
Nginx 是一款主流的网站服务器,其日志在运维过程中是不可或缺的重要信息来源。您可以将 Nginx 访问日志上传到日志服务,然后通过日志实时检索分析功能,更好地了解网站运行状况,及时发现并解决问题,提高用户体验和服务质量。例如:​
  • 通过分析客户端 IP 地址,可以获取客户端分布情况,了解用户来源地域,从而优化网站的地域针对性服务。​
  • 通过分析请求状态码,获取不同状态码的请求比例,了解网站健康情况,及时发现及解决潜在问题。​
  • 通过统计页面访问量(PV)和独立访客数(UV),可以评估网站流量和用户活跃度,为市场推广和运营决策提供数据支持。​
  • 通过统计访问来源,了解流量最多的渠道,从而优化营销策略。​
  • 通过分析请求的响应时间,及时发现性能瓶颈,优化服务器性能。​
  • 通过计算每秒系统能处理的查询数量(QPS),了解服务器的负载情况,及时调整资源。​
前提条件​
  • 已创建日志项目和日志主题。具体操作,请参考创建资源。​
  • 已根据日志字段创建索引。具体操作,请参考配置索引。​
日志样例​
下述表格罗列了 Nginx 访问日志的重要字段样例。​
​
字段​
说明​
__time__​
日志记录的时间戳。​
app_id​
应用的唯一标识符。​
host​
请求的目标主机。​
hostname​
服务器的主机名。​
referer​
请求的来源页面地址(HTTP Referer 头)。​
remote_addr​
客户端的 IP 地址。​
request_method​
HTTP 请求方法(如 GET、POST 等)。​
request_time​
请求处理的时间。​
request_uri​
请求的 URI(统一资源标识符)。​
server_protocol​
服务器使用的协议(如 HTTP/1.1、HTTP/2 等)。​
status​
HTTP 响应状态码。​
time_local​
本地时间戳。​
upstream​
上游服务器的信息,通常用于反向代理场景。​
upstream_response_time​
上游服务器响应的时间。​
upstream_status​
上游服务器的响应状态码。​
user_agent​
客户端的用户代理字符串,用于识别客户端的浏览器和操作系统信息。​
x_forwarded_for​
HTTP 头,用于识别经过代理服务器的客户端 IP 地址。​
x_real_ip​
客户端的真实 IP 地址,通常在经过代理时使用。​
​
索引配置示例​
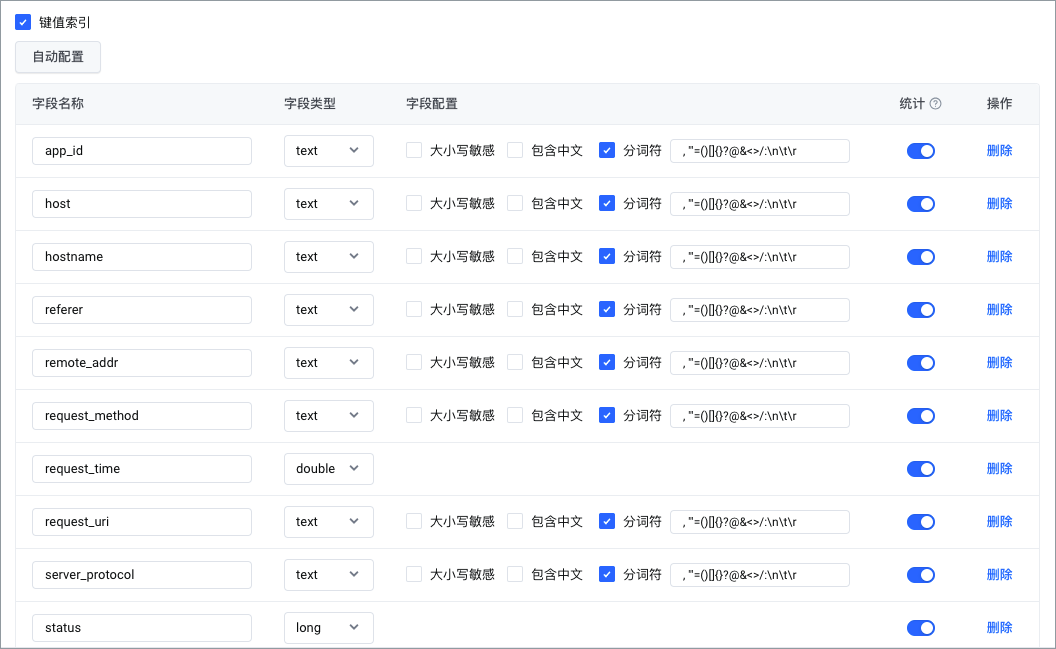
本案例基于上述日志样例创建了如下索引配置。索引配置的具体操作及注意事项,请参考配置索引。​
​​​
典型检索分析场景​
Nginx 访问日志的典型分析场景主要覆盖业务监控、性能调优、监控告警等方面。​
业务监控​
场景 1:统计每天的 PV、UV​
  • 场景:统计最近一天内每 5 分钟的网站 PV、UV以及变化趋势。​
  • 检索分析语句:​
  • ​
    *| SELECT DATE_FORMAT(__time__ - __time__ % 300000, 'Y-M-d HH:mm') AS time, APPROX_DISTINCT(remote_addr) AS UV ,count(1) AS PV GROUP BY time ORDER BY time LIMIT 1000​
    ​
  • 检索分析结果:​
  • 通过折线图展示最近一天内每 5 分钟网站 PV、UV 以及变化趋势。更多信息,请参考折线图。​
  • ​​​
场景 2:统计 QPS​
  • 场景:统计最近一天的 QPS 变化趋势。​
  • 检索分析语句:​
  • ​
    * | SELECT __time__-__time__%60000 AS time, COUNT(*)/60 AS qps GROUP BY time ORDER BY time LIMIT 10000​
    ​
  • 检索分析结果:​
  • 通过折线图(开启时序模式)展示最近一天的 QPS 变化趋势。更多信息,请参考折线图。​
  • ​​​
场景 3:统计请求方法分布​
  • 场景:计算请求方法分布情况。​
  • 检索分析语句:​
  • ​
    * | SELECT COUNT(*) AS count, "request_method" GROUP BY "request_method"​
    ​
  • 检索分析结果:​
  • 通过饼图展示请求方法分布情况。更多信息,请参考饼图。​
  • ​​​
场景 4:统计请求失败率​
  • 场景:统计每分钟请求的总失败率、404 错误率、 4xx 错误率以及 5xx 错误率。 ​
  • 检索分析语句:​
  • ​
    * | SELECT DATE_TRUNC('minute', __time__) AS time, ROUND(SUM(CASE WHEN status = 404 THEN 1.00 ELSE 0.00 END)/ CAST(COUNT(*) AS DOUBLE)*100,3) AS "404比例(%)", ROUND(SUM(CASE WHEN status >= 500 THEN 1.00 ELSE 0.00 END)/cast(count(*) AS DOUBLE)*100,3) AS "5XX比例(%)", ROUND(SUM(CASE WHEN status >= 400 AND status < 500 THEN 1.00 ELSE 0.00 END)/CAST(COUNT(*) AS DOUBLE)*100,3) AS "4XX比例(%)", round(sum(CASE WHEN status >= 400 THEN 1.00 ELSE 0.00 END)/CAST(COUNT(*) AS DOUBLE)*100,3) AS "总失败率(%)" GROUP BY time ORDER BY time LIMIT 10000​
    ​
  • 检索分析结果:​
  • 通过折线图展示总失败率、各个错误的失败率以及变化趋势。更多信息,请参考折线图。​
  • ​​​
场景 5:统计 Top 100请求的应用​
  • 场景:统计 Top 100 请求数量的应用以及其对应的具体请求数量、请求成功率以及 QPS。​
  • 检索分析语句:​
  • ​
    * | SELECT app_id, COUNT(*) AS PV, COUNT(DISTINCT(remote_addr)) AS UV, ROUND(SUM(CASE WHEN status < 400 THEN 1.00 ELSE 0.00 END)/CAST(COUNT(*) AS double)*100,3) AS "请求成功率", ROUND(COUNT(*)/60 , 2) AS QPS GROUP BY app_id ORDER BY PV DESC LIMIT 100​
    ​
  • 检索分析结果:​
  • ​​​
场景 6:统计 Top 10 请求数量​
  • 场景:统计 Top 10 请求数量以及其对应的请求页面​
  • 检索分析语句:​
  • ​
    * | SELECT SPLIT_PART(request_uri,'?',1) AS path, COUNT(1) AS pv GROUP BY path ORDER BY pv DESC LIMIT 10​
    ​
  • 检索分析结果:​
  • ​​​
性能调优​
通过分析Nginx 访问日志掌握请求延时等信息,及时识别网站瓶颈,从而优化网站性能。​
场景 1:统计平均时延和最大时延​
  • 场景:统计最近一天内每小时的请求平均时延和最大时延。​
  • 检索分析语句:​
  • ​
    * | SELECT DATE_TRUNC('hour', __time__) AS time, AVG(request_time) as avg_latency, MAX(request_time) AS max_latency GROUP BY time ORDER BY time​
    ​
  • 检索分析结果:​
  • 通过折线图展示最近一天内每小时的请求平均时延、最大时延以及变化趋势。更多信息,请参考折线图。​
  • ​​​
场景 2:统计最大时延及其对应的请求页面​
  • 场景:统计最近一天内每小时的最大请求时延以及其对应的请求页面。​
  • 检索分析语句:​
  • ​
    * | SELECT DATE_TRUNC('hour', __time__) AS time, MAX(request_time) AS max_latency, MAX_BY(request_uri,request_time) AS uri GROUP BY time ORDER BY time​
    ​
  • 检索分析结果:​
  • ​​​
场景 3:统计 Top 3 请求时间​
  • 场景:统计最近一天内最大的三个请求时间。​
  • 检索分析语句:​
  • ​
    * | SELECT MAX(request_time,3) AS "TOP 3"​
    ​
  • 检索分析结果:​
  • ​​​
场景 4:查询请求的平均延时、P50 延时和 P99 延时​
  • 场景:统计请求的平均延时、P50 延时和 P99 延时。​
  • 检索分析语句:​
  • ​
    * | SELECT DATE_TRUNC('minute', __time__) AS time, AVG(request_time) AS latency, APPROX_PERCENTILE(request_time, 0.5) as p50, APPROX_PERCENTILE(request_time, 0.99) as p99 GROUP BY time ORDER BY time ​
    ​
  • 检索分析结果:​
  • 通过折线图展示请求的平均延时、P50 延时和 P99 延时以及变化趋势。更多信息,请参考折线图。​
  • ​​​
场景 5:统计请求时长直方图​
  • 场景:统计请求时长直方图。​
  • 检索分析语句:​
  • ​
    * |SELECT NUMERIC_HISTOGRAM(10,request_time)​
    ​
  • 检索分析结果:​
  • ​​​
场景 6:页面调优​
  • 场景:通过计算目标页面(healthz 页面)的访问 PV、UV、各个请求方法的请求次数、各个请求状态的请求次数、各个浏览器的请求次数、平均延时和最大延时等数据,来调优页面性能。​
  • 检索分析语句:​
  • ​
    request_uri:"healthz" | SELECT COUNT(1) AS PV,​
    APPROX_DISTINCT(remote_addr) AS UV,​
    HISTOGRAM(request_method) AS method_c,​
    HISTOGRAM(status) AS status_c,​
    HISTOGRAM(user_agent) AS user_agent_c,​
    AVG(request_time) AS avg_l,​
    MAX(request_time) AS max_l​
    ​
  • 检索分析结果:​
  • ​​​
监控告警​
针对请求错误等问题,您可以通过告警功能实时监控网站,及时感知并处理异常情况。​
场景 1:请求错误告警​
  • 场景:统计每小时的错误数,发生错误时触发告警。​
  • 检索分析语句:​
  • ​
    status >= 400 | SELECT COUNT(*) as count​
    ​
  • 检索分析结果:​
  • ​​​
  • 告警策略配置:​
  • ​​​
场景 2:请求平均延迟告警​
  • 场景:基于 healthz 页面的平均请求延时创建告警,监控 healthz 页面相关请求的基本延时情况。​
  • 检索分析语句:​
  • ​
    request_uri:"healthz" | SELECT AVG(request_time) AS avg​
    ​
  • 检索分析结果:​
  • ​​​
  • 告警策略配置:​
  • ​​​
场景 3:请求时延 P99 告警​
  • 场景:使用平均延时无法有效反映个别较高延迟的请求,不足以展示网站真实的运行情。而通过统计时延的百分数(例如 P99 延时)来创建告警,可以更及时感知处于较高延迟的请求。​
  • 检索分析语句:​
  • ​
    request_uri:"healthz" | SELECT APPROX_PERCENTILE(request_time, 0.99) AS p99​
    ​
  • 检索分析结果:​
  • ​​​
  • 告警策略配置:​
  • ​​​
​
最近更新时间:2026.10.16 15:52:03
这个页面对您有帮助吗?
有用
有用
无用
无用