日志服务
日志服务


文档指南

请输入


- 文档首页
 日志服务用户指南数据采集LogCollector 采集采集容器日志采集容器文本日志(DaemonSet-控制台方式)
 复制全文
 下载 pdf
采集容器文本日志(DaemonSet-控制台方式)
 文档反馈
 问问助手
日志服务支持通过 DaemonSet 方式采集 Kubernetes 集群的容器文本日志,本文档演示控制台创建采集配置的相关操作步骤。
背景信息
在容器中安装日志服务提供的采集插件 LogCollector、并创建采集配置之后,LogCollector 会根据容器中的 Label 和环境变量确定待采集的容器,持续采集指定容器路径内产生的文本日志,并将文本日志和容器名等容器相关的元数据信息一起上传至服务端。LogCollector 还支持断点续传,checkpoint 文件中会留存采集相关的位点信息,即使 LogCollector 停止后重新启动,也会从上一次保存的位点继续采集。
在 Kubernetes 集群中,各个 Pod 之间的资源相互隔离,因此 LogCollector 容器不能直接访问其他 Pod 中容器的文件。但是 Kubernetes 集群中容器的文件系统一般是基于宿主机的文件系统挂载形成,即您可以在宿主机上直接访问容器的 rootfs。因此,将宿主机根目录所在的文件系统挂载到 LogCollector 容器后,LogCollector 就可以访问宿主机上的相关文件目录进而实现业务容器文件系统中的文件采集。例如某个日志文件在业务容器中的路径为 /var/log/app.log,假设映射到宿主机的路径是 /var/lib/kubelet/pods/<pod-id>/xxx/var/log/app.log,LogCollector 会默认将宿主机根目录所在的文件系统挂载到自身的 /logcollector_host 目录下,因此 LogCollector 实际采集的文件路径为 /logcollector_host/var/lib/kubelet/pods/<pod-id>/xxx/var/log/app.log。
此外,LogCollector 采集容器文本日志时,支持单行、多行等多种采集配置,除各种采集配置默认附加的预留字段之外,日志服务还会对 LogCollector 采集到的容器文本日志添加以下预留字段,并默认为其创建索引。
预留字段 | 说明 |
__image_name__ | 镜像名称。 |
__container_name__ | 容器名称。 |
__container_ip__ | 容器或 Pod 的 IP 地址。 |
__pod_name__ | Pod 名称。 |
__pod_uid__ | Pod 的唯一标识。 |
__namespace__ | Pod 所属的 Namespace。 |
限制说明
- 采集容器标准输出时:
- Docker 容器引擎仅支持 JSON 类型的日志驱动。
- 如果某些容器匹配了多个采集配置,那么在该容器上仅最新的采集配置生效。
- 采集容器内日志文件时:
- 容器内日志文件的采集路径目前仅支持不挂载、emptyDir 挂载和 hostPath 挂载 3 种方式。
- 采集路径不支持设置为软链接,因为 LogCollector 无法访问容器内日志文件的软链接,请按照容器内日志文件的真实路径配置采集路径。
- 在容器停止之后,LogCollector 会收到该容器的 stop 事件,并随即停止采集该容器的日志。如果 LogCollector 采集该容器的日志有一定延迟,则容器停止之前产生的部分日志可能未被采集。
- LogCollector 支持的容器引擎包括 Docker 和 Containerd。不同类型容器引擎的访问路径限制如下:
- Docker:LogCollector 通过宿主机的 /run/docker.sock 访问 Docker 容器引擎,请确保该路径存在且 LogCollector 具备访问权限。
- Containerd:LogCollector 通过宿主机的 /run/containerd/containerd.sock 访问 Containerd 容器引擎,请确保该路径存在且 LogCollector 具备访问权限。
创建 LogCollector 采集配置
前提条件
- 已在待采集的 Kubernetes 集群中安装了 LogCollector。相关操作步骤请参考 Kubernetes 集群安装 LogCollector。
- 已创建了机器组,并在机器组中添加了容器所在的宿主机。
- 推荐使用机器标识类型的机器组,机器标识可配置为您在安装 LogCollector 时配置的用户自定义标识,即需与 ConfigMap 中设置的 ${your_labels} 的值一致,例如 nginx-log。
说明
如果采集火山引擎容器服务 VKE 的标准容器日志,请确保容器服务对应集群的网络正常,在对应集群中安装 LogCollector 后,默认会自动在该集群所在地域、所属同一个项目的日志服务中,创建一个名为k8s-vke-容器服务集群ID的机器标识类型的机器组。
步骤一 选择日志空间
- 登录日志服务控制台。
- 在顶部导航栏中,选择日志服务所在的地域。
- 在左侧导航栏中,选择常用功能 > 日志接入。
- 在日志接入页面的 LogCollector日志采集页签中,单击创建采集配置。
说明
以下地域需在 LogCollector日志采集页签中,手动选择日志采集模式。
地域:中国香港、亚太东南(柔佛)、亚太东南(雅加达)。
- 选择日志项目和日志主题,单击下一步:选择机器组。
- 采集到的日志数据将被存储到该日志主题中。
步骤二 选择机器组
- 在全部机器组区域中,选择需要被采集日志的机器组。
- 如果列表中无可用的机器组,您需要先创建机器组。具体操作,请参考创建机器组(机器标识)、创建机器组(IP 地址)
- 在已选机器组区域中确认机器组无误后,单击下一步:采集规则。
步骤三 配置采集规则
配置基础信息
- 填写基本规则配置。
- 配置说明规则名称规则名称即 LogCollector 采集配置的名称。您也可以单击导入其他采集配置,选择日志Region、日志项目和采集配置,将已创建的采集配置导入到当前配置中,您只需要指定采集规则名称即可。容器日志采集选择启用。采集类型选择 K8s 容器文本日志。
- (可选)启用通用容器采集规则。
- 通用容器采集规则通过容器的通用信息指定待采集的内容,也可以同时排除不采集的内容。
说明
未启用通用容器采集规则和K8s 采集规则时,表示采集范围为全部容器。同时配置两种采集规则时,两种规则的逻辑关系为与,即必须同时满足两种规则才能成功采集。
-
- (可选)启用K8s 采集规则。
- K8s 采集规则用通过 Kubernetes 容器的信息指定待采集的内容,也可以同时排除不采集的内容。
说明
未启用通用容器采集规则和K8s 采集规则时,表示采集范围为全部容器。同时配置两种采集规则时,两种规则的逻辑关系为与,即必须同时满足两种规则才能成功采集。
-
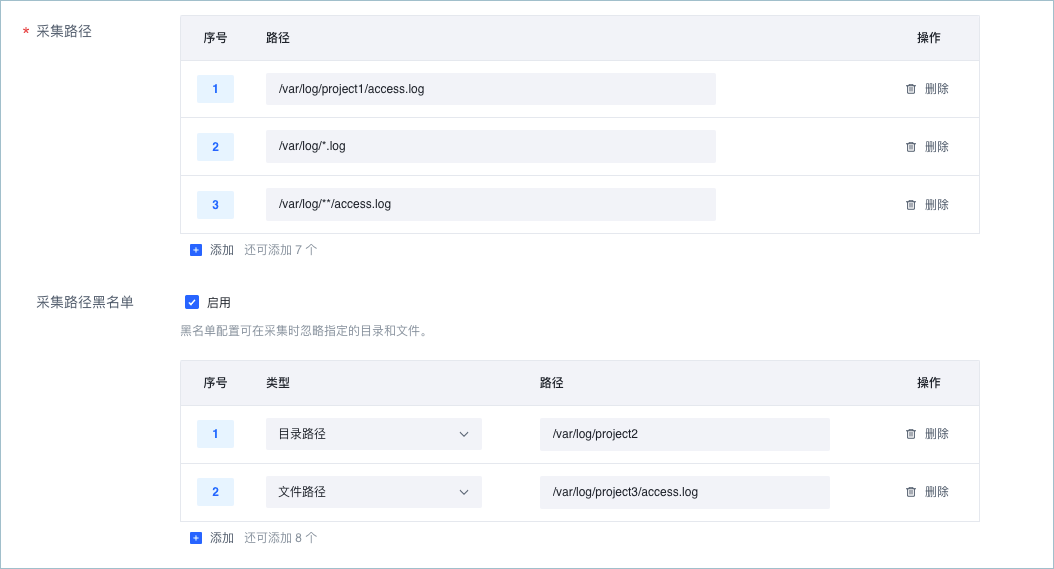
- 填写采集路径。
- 采集路径即日志所在的目录和文件名,LogCollector 会按照采集路径中的目录部分匹配符合规则的目录,监听这些目录下符合规则的日志文件。最多设置 10 个不同的采集路径。
- 采集路径可以指定完整的目录和文件名,也可以通过通配符模糊匹配。
说明
- 默认情况下,一个日志文件只能被采集到一个日志主题中,且只能匹配一个采集配置,如果多个采集配置重复采集同一个文件,则以最新的采集配置规则为准。
- 日志服务目前支持的通配符包括星号(*)、双星号(**)和半角问号(?)。双星号(**)最多只能配置一个。
- 常见的采集路径的配置方式及示例如下。
-
- 例如预留字段中包括字段 __pod_name__,则采集路径可配置为 /var/log/basic_log/POD_{__pod_name__}/tlsapi/access.log,其中{__pod_name__}为占位符,LogCollector 采集日志时会使用实际的 Pod 名称自动替换该占位符。
- 设置采集配置生效策略。
- 当同一采集路径中的日志文件被多个采集配置匹配时,可设置如下策略:
- 配置说明可被新配置覆盖存在更新的采集配置时,日志文件不会按当前配置采集,将会按最新的采集配置采集。永久生效即使存在更新的采集配置,日志文件也将按当前配置重复采集。
- 设置采集路径黑名单。
- 配置采集路径黑名单之后,日志服务通过 LogCollector 采集日志时,会忽略指定的目录和文件。选择启用后,请根据页面提示设置黑名单目录和文件。
说明
- 每个采集配置中最多设置 10 条采集路径黑名单。
- 如果您在配置日志路径时使用了通配符,但又需要过滤掉其中部分目录或文件时,需要在黑名单中填写对应的完整路径或文件名来保证过滤生效。例如采集路径为/var/log/project/*.log,需要过滤其中/var/log/project目录下的所有子目录,则采集路径黑名单应设置为目录路径,配置路径为/var/log/project/**。
- 采集路径黑名单中的路径类型支持设置为目录路径和文件路径。
- 配置说明目录路径采集时忽略指定的目录。目录路径支持完整匹配和通配符模式匹配。
- 完整匹配:指定完整的目录名称,例如 /var/log/mydata/new。
- 通配符匹配:目录中包含通配符,支持的通配符包括星号(*)和半角问号(?)。例如 /var/log/mydata/n* 表示不采集目录 /var/log/mydata/ 下以 n 开头的目录。
文件路径采集时忽略指定的文件,需配置文件路径及文件名。文件路径支持完整匹配和通配符模式匹配。- 完整匹配:指定完整的路径及文件名称,例如 /var/log/mydata/access.log。
- 通配符匹配:路径及文件名中包含通配符,支持的通配符包括星号(*)半角问号(?)和双星号(**)。通配符中,双星号(**)最多只能配置一个。例如 /data/nginx/log/*/*/access.log 表示不采集目录 /data/nginx/log 及其一级和二级目录中名为 access.log 的日志文件。
-
配置日志格式
- 设置采集策略。
- 采集策略表示 LogCollector 采集增量日志还是全量日志。默认为增量日志。
- 配置说明全量
- 首次采集的日志文件:从每个文件的起始位置开始采集日志,包含历史日志数据。
- 非首次采集的日志文件:根据 Checkpoint 确定采集位置往后继续采集,不包含历史日志数据。
增量只采集文件内新增的内容。监控范围内的日志文件写入新的日志时,触发 LogCollector 日志采集行为。- 首次采集的日志文件:根据您输入的增量阈值,自动确认采集的位置。
- 如果新文件大小不超过您所指定的增量阈值,从新文件的起始位置开始首次采集。
- 如果新文件大小超过您所指定的增量阈值,从新文件的末尾减去增量阈值后的位置开始首次采集,即仅采集增量日志。
- 非首次采集的日志文件:根据 Checkpoint 确定采集位置往后继续采集。
说明
如果采集策略设置为增量,触发 LogCollector 日志采集行为后,不支持通过修改采集策略为全量,来采集该文件的历史日志数据。
- 指定采集模式。
- 采集模式决定了 LogCollector 解析日志文件的模式,您可以根据实际业务场景选择对应的采集模式,并配置指定模式下的日志解析规则。详细说明请参考各个采集模式文档中的指定采集模式部分。
- 设置时间字段。
- 采集时间点:将采集日志时 LogCollector 所在服务器的系统时间作为日志时间戳。
- 自定义时间:提取原始日志中自带的时间作为日志时间戳。相关配置如下:
- 配置说明时间键名称时间字段的名称。时间正则如果您只解析时间字段中的部分内容,可使用正则表达式进行提取。时间精度时间转换格式说明
- 如果时间转换格式填写错误导致无法正确解析时间,将以采集时间为准。
- 默认情况下,日志时间支持精确到毫秒,即配置时间转换格式时,支持配置到毫秒。如果时间转换格式中未指定毫秒级的解析方式,则毫秒部分会自动填充为 0。
- 在采集配置中勾选启用纳秒时间精度后,日志转换格式支持到纳秒级别。
- 如果您需要在日志时间中添加时区且原始日志时间包含时区,那么您可以在时间转换格式中添加时区格式(%z)以提取时区。另外,您也可以在时间转换格式中添加固定时区格式(+08:00),然后选择合适的时区属性。
- 例如时间为2024-03-03 15:00:00 +08:00,您可以设置时间转换格式为%Y-%m-%d %H:%M:%S %z,或者设置时间转换格式为%Y-%m-%d %H:%M:%S +08:00且选择对应的时区属性。
时区属性设置时区。- 机器时区:使用 LogCollector 所在服务器的系统时区。
- 自定义时区:包括 UTC 和 GMT。如果要支持夏令时或冬令时,请选择 UTC;否则,请选择 GMT。
时间字段样例输入原始日志中的时间内容,单击立即验证,日志服务将验证您所配置的时间转换格式是否正确。
- 选择是否忽略未更新的文件。
- 开启后,当日志文件更新时间不在您所指定的时间范围内时,LogCollector 会忽略该文件,不进行采集。
- 设置是否启用上传解析失败日志。
- 启用:启用后需同时配置失败日志键名称,默认为 LogParseFailed。所有解析失败的日志,均以配置的失败日志键名称字段作为键名称(Key),原始日志内容作为值(Value)上传到日志服务。
- 不启用:解析失败的日志不上传到日志服务。
配置插件
启用插件配置。
通过 LogCollector 采集文本日志时,如果业务日志结构复杂、格式不固定,无法通过 JSON 模式等常规的日志采集模式进行解析时,可以通过 LogCollector 插件进行采集后处理。详细说明请参考插件概述。
高级设置
- 启用高级设置。
- 请根据您的需求选择高级配置。如果没有特殊需求,建议保持默认配置。
- 过滤器是否开启日志字段过滤规则。默认为关闭状态。开启后,通过正则表达式配置过滤规则,完全匹配正则表达式的日志才会被采集上报,帮助您筛选出有价值的日志数据。例如,设置 Key 为response_code,过滤规则为400|500,表示只采集response_code为 400 或 500 类型的日志。
上传hostname字段是否上传 hostname 字段,默认为关闭状态。- 开启:在原始日志中增加一个字段,用于记录日志源的 hostname。字段名可以通过 hostname键名称指定,默认为 hostname。
- 关闭:不添加 hostname 字段。
解析采集路径通过正则表达式提取采集路径中的字段,并将其作为元数据添加到日志数据中。此功能默认为关闭状态。开启此功能后,您需要设置采集路径样例、提取正则表达式和提取结果。- 采集路径样例:实际场景的采集路径样例。
- 采集路径样例必须是一个绝对路径。
- 路径样例中不能包含通配符*、?、**。
- 提取正则表达式:用于提取路径字段的正则表达式。必须和采集路径样例匹配,否则无法成功提取。
- 提取结果:提取结果中展示日志服务根据正则表达式将路径样例解析并提取到的每个字段值(Value)。您需要为每个字段指定字段名称(Key)。
- 最多配置 100 个字段名。
- 字段名不可为空,且不可重复。
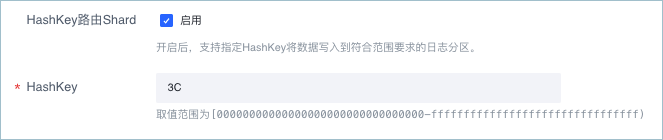
HashKey路由Shard指定 HashKey 将数据写入到符合范围要求的日志分区。此功能默认为关闭状态。- 开启此功能,表示使用 HashKey 路由 Shard 模式采集数据,将数据有序写入到指定 Shard 中。适用于数据写入和消费对有序性要求较高的场景。 此时需要设置 HashKey,日志服务会将数据写入到包含该 Key 值的 Shard 中。HashKey 的取值范围为 [00000000000000000000000000000000-ffffffffffffffffffffffffffffffff)。
- 关闭此功能,表示使用负载均衡模式采集数据,自动根据负载均衡原则将数据包写入当前可用的任一 Shard 中。该模式适用于写入和消费行为与 Shard 无关的场景,例如不保序。
 上传原始日志是否将原始日志作为一个字段上传到日志服务,默认为关闭状态。
- 开启:原始的日志数据将被封装在指定字段中,和解析后的日志数据一起上传到日志服务中。字段名可以通过原始日志键名称指定,默认值为 raw,实际对应的日志字段为 __raw__。
- 关闭:不添加原始日志字段。
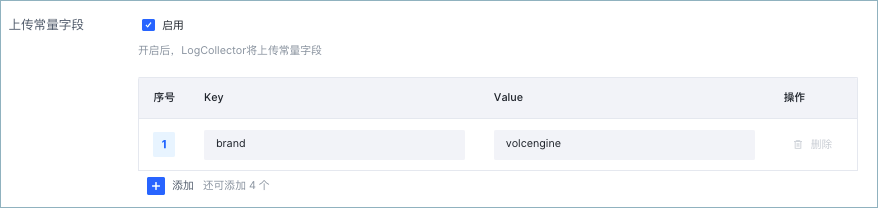
上传常量字段开启后,LogCollector 会将指定字段的 Key 和 Value 封装到每一条日志中。常量字段需遵循以下限制:- 支持上传最多 5 个常量字段。
- 字段名(Key)不可重复,不可为空。长度限制为 1~128 字符,包括英文字母、数字、和特殊字符(-_./),且不能以下划线开头。
- 字段值(Value)不可为空,长度最大为 512 KiB。
 上传机器组 Label是否将机器组的 Label 信息上传到日志服务,默认为关闭状态。
- 开启:LogCollector 会将机器组的 Label 信息上传到指定字段中。您可以在机器组Label键名称中指定字段名称,默认值为host_group_label。
- 关闭:不上传机器组 Label 信息。
扩展配置LogCollector 扩展配置,JSON 对象格式。目前支持的参数包括 CloseInactive、CloseRemoved、CloseRenamed、CloseEOF 和 CloseTimeout。详细的参数说明请参考CreateRule中的数据结构Advanced。例如填写以下配置,表示日志文件持续 10 秒没有新日志写入、日志文件被移除或重命名、LogCollector 读取至文件末尾、日志文件监控时长超过 30 分钟后,释放文件句柄。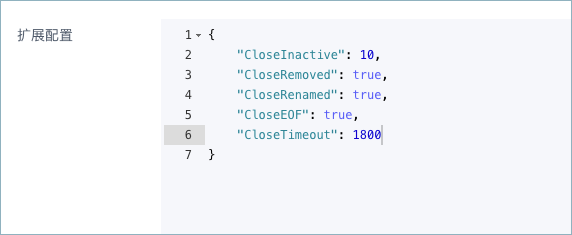
- 确认采集配置,并单击下一步:检查索引配置。
步骤四 检查索引配置
- 检查索引配置。
- 根据页面提示,按需设置或更新索引,您也可以单击导入已有索引配置,导入其他日志主题的索引。
- 若此日志主题未设置索引,可以参考配置索引进行设置。
- 若此日志主题已设置索引,可以根据采集规则中解析的日志字段判断是否需要更新索引。
- 单击提交。
后续步骤
最近更新时间:2026.08.26 16:00:46
这个页面对您有帮助吗?
有用
有用
无用
无用