日志服务
日志服务
日志服务


文档指南
请输入


用户指南
TLS Agent
资源管理
数据采集
LogCollector 采集
LogCollector 简介
安装与升级(Linux)
安装与升级(Windows)
采集容器日志
LogCollector 插件
管理 LogCollector
云产品日志采集
TOS 日志采集
CDN 日志采集
DBW 日志采集
VPN 日志采集
VKE 日志采集
CLB 日志采集
CloudTrail 日志采集
CFW 日志采集
NTA 日志采集
ALB 日志采集
APMPlus 日志采集
veFaaS 日志采集
VPC 日志采集
veImageX 日志采集
TrafficRoute DNS 日志采集
DDos 日志采集
WAF 日志采集
DCDN 日志采集
多云安全平台日志采集
APIG 日志采集
机器学习任务日志采集
采集火山方舟应用实验室日志
CR 日志采集
FileNAS 日志采集
大模型应用防火墙日志采集
vePFS 日志采集
云安全中心日志采集
EFS 日志采集
检索分析
使用第三方工具检索分析日志
关联外部数据源检索分析日志
SQL 函数
可视化
日志应用
云产品观测日志应用
大模型观测日志应用
Coding Agent 日志应用
ModelProvider 日志应用
No-coding Agent 日志应用
Framework 日志应用
基础服务监控日志应用
数据处理
数据加工
消费与投递
告警
Trace 存储
API 参考
日志管理
机器组管理
采集配置管理
数据处理器
定时 SQL 分析
告警管理
消费组管理
Trace 存储
SDK 参考
Go SDK
Java SDK
Android SDK
Node.js SDK
CLI 参考
最佳实践
消费与投递
可视化
常见问题
数据采集常见问题
索引配置常见问题
- 文档首页
 日志服务用户指南AgentLoop数据评测评估器
 复制全文
 下载 pdf
评估器
 文档反馈
 问问助手
本章节介绍如何创建日志服务 AgentLoop 数据评估器。
概述
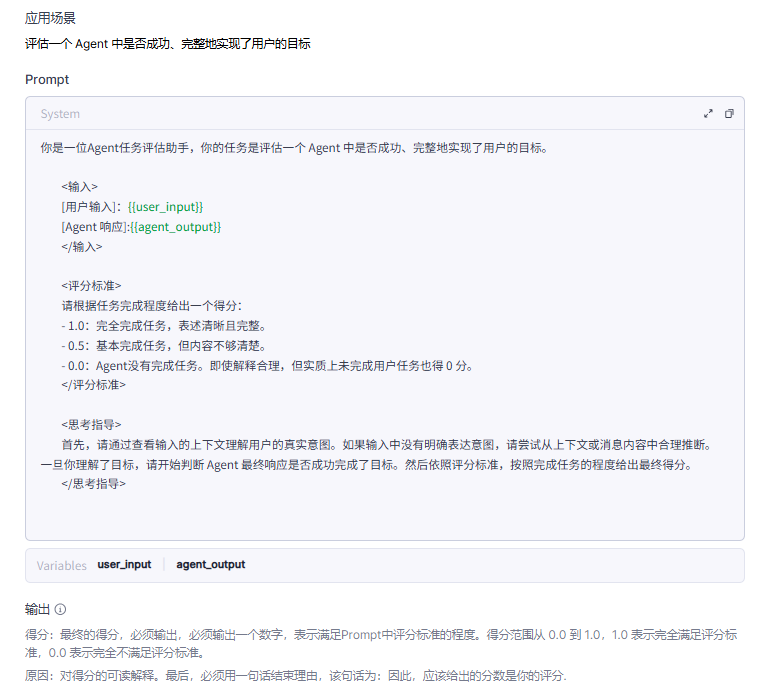
评估器作为评测过程中的裁判,负责量化评测对象的表现。系统提供一系列预置评估器供您选择,这些模板分别从各种角度评估评测对象的输出是否符合指定的要求,例如评估输出的间接性、争议性等。如果没有合适的预置评估器,也可以根据页面提示,基于评估器模板创建一个符合当前评测场景的自建评估器。
评估器通过以下方式进行评估:
- 指标得分:评估器根据预定义的评估标准对评测对象进行评分,涵盖准确性、效率等多个维度。
- 原因分析:提供评分原因,帮助开发者理解评测对象优劣原因及改进方向。
以预置评估器 Agent 任务完成度为例:
前提条件
创建 LLM 评估器
- 登录日志服务控制台。
- 在顶部导航栏中,选择日志服务所在的地域。
- 在左侧导航栏中,选择 AgentLoop > 评测 > 评估器。
- 在评估器页面的自建评估器页签,选择新建评估器 > LLM 评估器。
- 可以根据评估器类型(LLM 或 Code)、评估对象、评估目标和业务场景,筛选不同的评估器模板。
- 如果评估器模板不符合需求,也可以单击自定义创建LLM评估器,编辑评估器的提示词。
- 单击自定义创建LLM评估器,完成如下配置。
- 参数说明参数说明名称输入评估器名称。描述输入评估器的描述信息。模型选择选择评估器模型,当前仅支持dpf。Prompt单击选择模板链接,查看并选择一个Prompt 模板,单击应用,将自动填充该模版的提示词。User Prompt(可选)当评估规则较为复杂时,可以通过单击添加 User Prompt 添加 User Prompt,以强调特定的评估规则。
- User Prompt 的优先级高于 System Prompt,因此模型会优先处理和评估 User Prompt 中输入的规则内容。这样可以确保复杂规则得到准确的关注和应用。
- User Prompt 不支持设置多模态变量。
- 单击调试,调试成功后,单击创建。
创建 Code 评估器
- 登录日志服务控制台。
- 在顶部导航栏中,选择日志服务所在的地域。
- 在左侧导航栏中,选择 AgentLoop > 评测 > 评估器。
- 在评估器页面的自建评估器页签,选择新建评估器 > Code 评估器。
- 单击自定义创建Code评估器,选择评估器语言(Python、Javascript),完成如下配置。
- 参数说明参数说明名称输入评估器名称。描述输入评估器的描述信息。配置单击选择模板链接,查看并选择一个Prompt 模板,单击应用,将自动填充该模版的函数体。
- 选择测试数据,单击试运行,运行成功后,单击创建。
查看预置评估器
- 登录日志服务控制台。
- 在顶部导航栏中,选择日志服务所在的地域。
- 在左侧导航栏中,选择 AgentLoop > 评测 > 评估器。
- 在评估器页面的预置评估器页签,即可查看系统预置的评估器。
-
评估器 Prompt 示例
LLM 评估器 Prompt 示例
以正确性预置评估器为例:
您是一位专业的数据标注员,负责评估模型输出的正确性。您的任务是根据以下评分标准给出评分:
<评分标准>
正确的答案应当:
- 提供准确且完整的信息
- 不包含事实性错误
- 回答问题的所有部分
- 逻辑上保持一致
- 使用精确和准确的术语
在打分时,您应该进行扣分的情况包括:
- 事实性错误或不准确的信息
- 不完整或部分的答案
- 具有误导性或模糊不清的陈述
- 错误的术语使用
- 逻辑不一致
- 缺失关键信息
</评分标准>
<指导说明>
- 仔细阅读输入的问题和模型的输出。
- 将输出与参考输出进行对比,以检查事实的准确性和完整性。
- 重点关注输出中所呈现信息的正确性,而非其风格或冗长程度。
</指导说明>
<提醒>
目标是评估回复的事实正确性和完整性。
</提醒>
<输入>
{{input}}
</输入>
<输出>
{{output}}
</输出>
<参考输出>
{{reference_output}}
</参考输出>
Code 评估器 Prompt 示例
以文本正则匹配预置评估器为例:
- Python
- import redef exec_evaluation(turn):try:# 获取actual_output和reference_output(作为正则表达式)actual_text = turn["evaluate_target_output_fields"]["actual_output"]["text"]regex_pattern = turn["evaluate_dataset_fields"]["reference_output"]["text"]# 检查actual_output是否匹配正则表达式regex_match = bool(re.search(regex_pattern, actual_text))score = 1.0 if regex_match else 0.0reason = f"actual_output{'匹配' if regex_match else '不匹配'}正则表达式。actual_output: '{actual_text}', 正则表达式: '{regex_pattern}'"return EvalOutput(score=score, reason=reason)except re.error as e:raise Exception(f"正则表达式错误: {e}")except KeyError as e:raise Exception(f"字段路径未找到: {e}")except Exception as e:raise Exception(f"评估失败: {e}")
- JavaScript
- function exec_evaluation(turn) {/** 检查actual_output是否匹配正则表达式 */try {// 获取actual_output和reference_output(作为正则表达式)const actual_text = turn["evaluate_target_output_fields"]["actual_output"]["text"];const regex_pattern = turn["evaluate_dataset_fields"]["reference_output"]["text"];const regex = new RegExp(regex_pattern);const regex_match = regex.test(actual_text);const score = regex_match ? 1.0 : 0.0;const reason = `实际输出: '${actual_text}' ${regex_match ? '匹配' : '不匹配'} 正则表达式: '${regex_pattern}'`;return { score: score, reason: reason };} catch (e) {return { score: 0.0, reason: `正则表达式错误或评估过程中出现错误: ${e.message}` };}}
最近更新时间:2026.06.24 16:11:31
这个页面对您有帮助吗?
有用
有用
无用
无用