GPU云服务器
GPU云服务器


文档指南

请输入


- 文档首页
 GPU云服务器GPU云服务器最佳实践性能测试/调优HPC-单机/多机NCCL测试(Easy_NCCL)
 复制全文
 下载 pdf
HPC-单机/多机NCCL测试(Easy_NCCL)
 文档反馈
 问问助手
本文主要介绍如何简便验证高性能计算GPU实例的NCCL性能,节省了依赖安装、编译、配置端口、免密等繁琐步骤。
- NCCL(Nvidia Collective multi-GPU Communication Library,读作 "Nickel")是一个提供GPU间通信基元的库,它具有拓扑感知能力,可以轻松集成到应用程序中。NCCL做了很多优化,以在PCIe、Nvlink、InfiniBand上实现较高的通信速度。NCCL支持安装在单个节点或多个节点上的大量GPU卡上,并可用于单进程或多进程(如MPI)应用。
- 如需查看高性能计算GPU实例的GPU、RDMA等配置信息,请参见实例规格介绍。其中,ebmhpcpni3l、hpcpni3h实例正在邀测中,如需使用,请联系客户经理申请。
性能指标
评估NCCL性能的关键指标之一是带宽(测试输出中的“busbw”),带宽又分为算法带宽和总线带宽。对于集体操作(如allreduce、reduce-scatter等),算法带宽会因节点数量的不同而发生改变,而总线带宽相对稳定,不受节点数量影响,它指的是在单位时间内总线能够传输的数据总量,这为对比硬件能力提供了更为稳定一致的参照。
本文以测试NCCL的总线带宽为例,帮助了解NCCL在不同场景下的通信效率和硬件利用情况,以便在实际应用中进行针对性的调整和优化。
准备环境
- 您已拥有一台或多台高性能计算GPU实例。本文以两台实例为例,分别命名为node1、node2,每台实例的基本配置如下:
- 已绑定公网IP,使其具备访问公网的能力。
- 本文GPU实例的镜像以Ubuntu 20.04为例,您也可以任选其它镜像。
- 参考登录Linux实例登录各节点,并完成下述操作。
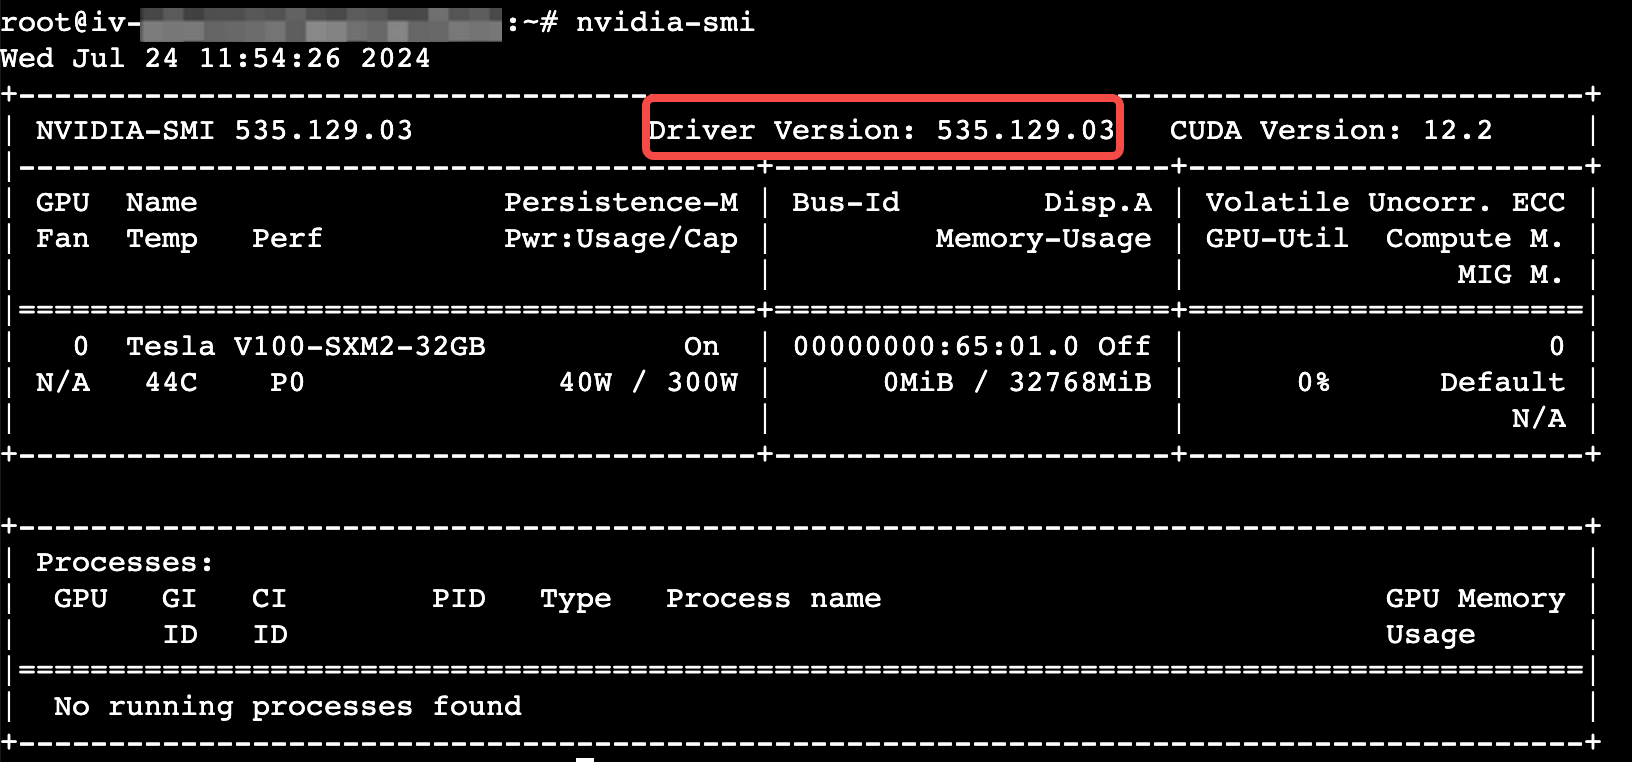
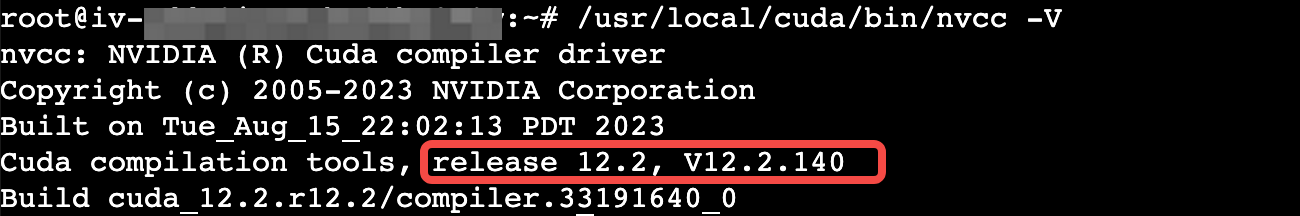
- 已安装GPU驱动和CUDA工具包。
- nvidia-smi/usr/local/cuda/bin/nvcc -V
- 回显如下,表示已成功安装。
-
-
- 已安装NVIDIA Container Toolkit,具体操作请参见Nvidia官方指导。
- 确定资源占用。
- 运行mpirun程序时必须占用22223端口,依次执行如下命令,查询使用该端口的进程信息,并结束相关进程(如有)。
- lsof -i:22223 # 查看占用目标端口的进程信息kill <PID> # 将<PID>替换为占用目标端口的实际进程ID
操作步骤
步骤一:启动并进入容器
- 在各节点上,分别执行以下命令,启动容器。
- node1上执行:
- docker run -itd \--gpus all --net=host \--shm-size=100g \--ulimit memlock=-1 \--ulimit stack=67108864 \--privileged --ipc=host \--security-opt seccomp=unconfined \--cap-add=ALL \-v /var/run/nvidia-topologyd/:/var/run/nvidia-topologyd/ \iaas-gpu-cn-beijing.cr.volces.com/iaas_health/easy_nccl:ubuntu2204_cuda121_python310_nccl221_p22223 bash
- node2上执行:
- docker run -itd \--gpus all --net=host \--shm-size=100g \--ulimit memlock=-1 \--ulimit stack=67108864 \--privileged --ipc=host \--security-opt seccomp=unconfined \--cap-add=ALL \-v /var/run/nvidia-topologyd/:/var/run/nvidia-topologyd/ \iaas-gpu-cn-beijing.cr.volces.com/iaas_health/easy_nccl:ubuntu2204_cuda121_python310_nccl221_p22223 bash
- 在node1和node2上,执行以下命令,进入容器的bash环境。
- docker exec -it <container_id> bash
- 其中,container_id可通过执行docker ps命令获取。
步骤二:运行NCCL测试
根据机型执行下表中对应的命令进行NCCL测试。
说明
- 在多机测试前您也可以参考HPC-NCCL多机测试优化方案之实例亲和性排序文档,对RDMA网络亲和性进行排序,能够提升大规模集群任务的性能。
- 命令中的NCCL相关参数介绍如下:
-
- 请将-H后的IP替换为每台实例主网卡的私网IP地址。格式为:<node1的IP>:8,<node2的IP>:8,顺序可以互换。如何查看私网IP地址,请参考查看实例信息。
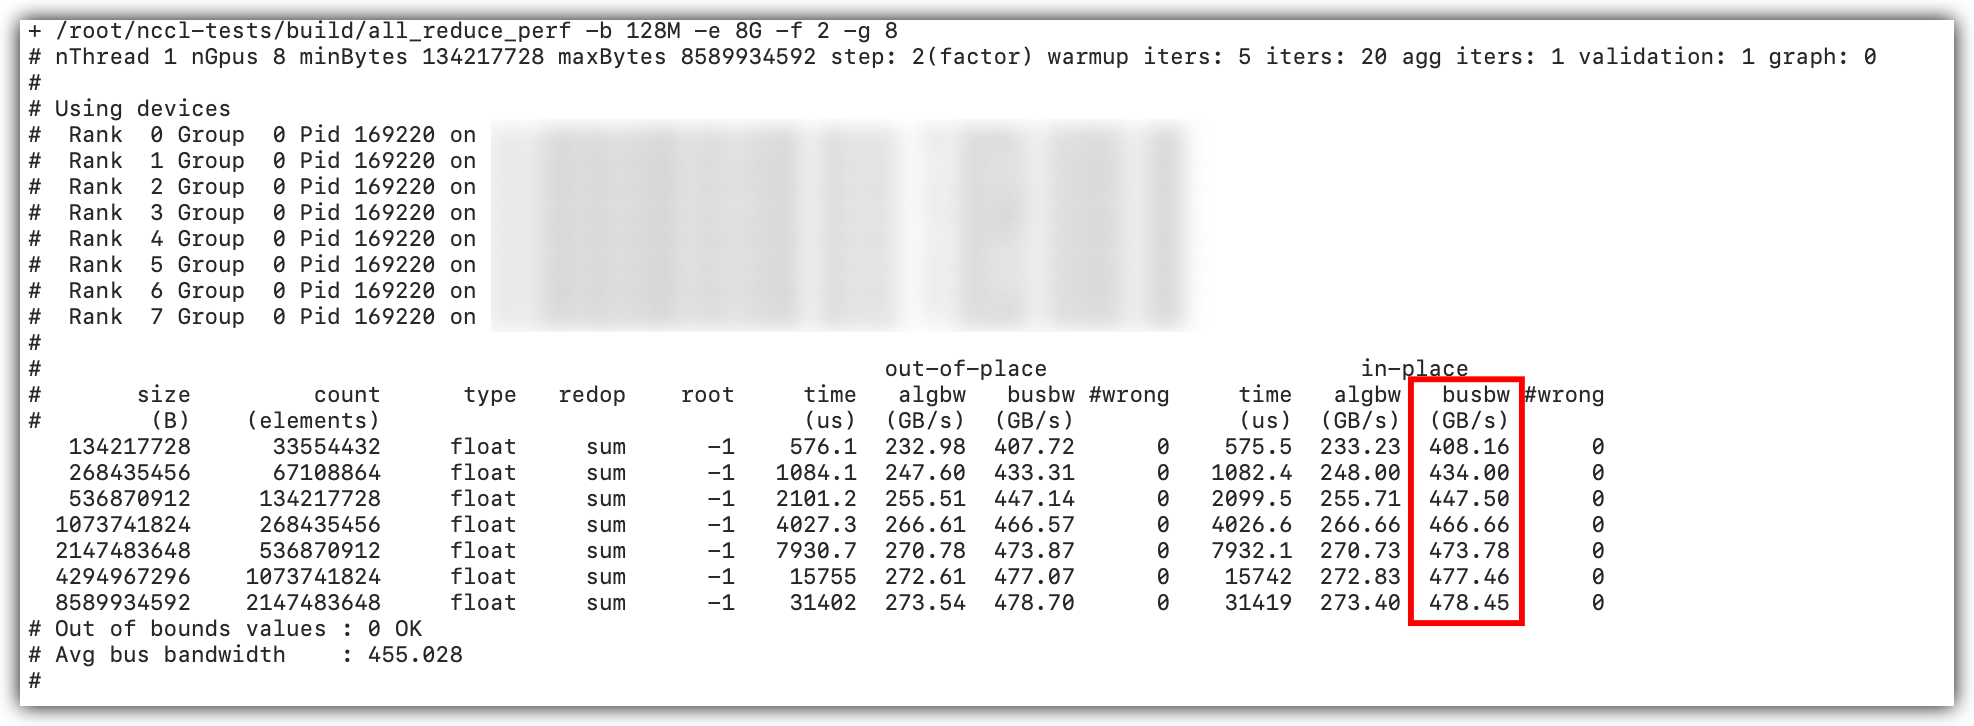
结果示例如下图。
示例基线
注意
本文所述的示例基线仅供参考,实际的总线带宽数值会因硬件规格、系统设置和应用场景的不同而有所变化。
实例数量 | 操作类型 | 总线带宽busbw(GB/s) |
2 | allreduce | 97.42 |
| alltoall | 22.77 |
| reduce_scatter | 97.44 |
| all_gather | 96.96 |
1 | allreduce | 233.59 |
| alltoall | 219.25 |
| reduce_scatter | 229.07 |
| all_gather | 222.43 |
| sendrecv | 149.83 |
最近更新时间:2026.01.30 19:38:26
这个页面对您有帮助吗?
有用
有用
无用
无用