GPU云服务器
GPU云服务器


文档指南

请输入


- 文档首页
 GPU云服务器GPU云服务器最佳实践AIGC实践HPC-弹性预约实例(时段型)适配veRL
 复制全文
 下载 pdf
HPC-弹性预约实例(时段型)适配veRL
 文档反馈
 问问助手
本文介绍在深度学习训练任务场景下,如何有效化解计算资源成本与稳定性之间的矛盾,实现节省成本与保障稳定性的最优平衡。
背景信息
在深度学习训练任务中,计算资源成本往往是最大开销。平台提供的弹性预约实例-时段型,相比常规按量计费实例可节省60%+的成本,但是它存在不稳定性,可能因市场价格波动或资源紧张面临随时被收回的风险,这无疑给训练工作带来了一定的挑战:
- 训练中断:正在运行的训练任务被迫停止,不仅导致当前任务失败,已消耗的算力资源也成为浪费;
- 检查点丢失:若未及时保存训练 “检查点”(即训练进度快照),中断后需从头开始训练,进一步增加额外的算力成本和时间成本。
鉴于上述问题,在 verl 框架中,引入了 MR#2192 这一新特性。当弹性预约实例-时段型即将到期或者面临回收时,系统会自动触发保存检查点的操作,以此确保训练任务能够安全地恢复运行。结合弹性预约实例-时段型提前锁定实例使用时长的特点,能够在成本节省与稳定性保障之间达成最优的平衡状态。
能力介绍
veRL结合ESI功能介绍
- 核心函数:should_save_ckpt_esi
- 判断实例是否即将过期。
- 在过期前冗余时间窗口内强制保存 checkpoint。
- 参数配置
- esi_redundant_time 默认 120 秒。
- save_ckpt_duration 默认 60 秒,用于估算保存耗时。
触发逻辑
正常保存条件满足时,或者ESI临近到期时间时,会强制执行一次 checkpoint 保存。
Texpiration - Tnow ≤ Tmax_steps + Tsave + Tredundant
说明
- Texpiration:实例的过期时间戳。
- Tnow:当前时间。
- Tmax_steps:单个训练 step 的最长耗时(动态估算)。
- Tsave:保存 checkpoint 的耗时(默认 60 秒)。
- Tredundant:冗余时间(配置项 esi_redundant_time,默认 120 秒)。
假设:
- 实例还有 200 秒过期;
- 单步训练最长 80 秒;
- 保存 checkpoint 预计 60 秒;
- 冗余时间配置 120 秒。
则计算:
80 + 60 + 120 = 260 > 200
说明剩余时间不足,触发提前保存 checkpoint。
部署指引
步骤一:购买ESI时段型实例
步骤二:获取实例释放时间
- 登录目标实例。
- 执行以下命令,安装volcengine-python-sdk。
- pip install volcengine-python-sdk
- 将以下ecs_scheduled_instance_auto_release_time.py文件、install.sh文件上传至实例。如何上传文件至云服务器实例?
- 添加执行权限并运行。
- chmod +x install.sh./install.sh
步骤三:启动训练任务
- 执行以下命令,进入训练容器。
- docker exec -it ecs-esi-container bash
- 确认实例到期时间戳是否植入。
- echo $MLP_CURRENT_CAPACITY_BLOCK_EXPIRATION_TIMESTAMP
-

- 启动训练任务。
- 方式一:运行内置demo。
- 进入/root/verl-esi目录,执行bash examples/grpo_trainer/run_qwen2-7b.sh命令。
- 方式二:自定义启动脚本。
- set -xpython3 -m verl.trainer.main_ppo \algorithm.adv_estimator=grpo \data.train_files=$HOME/data/gsm8k/train.parquet \data.val_files=$HOME/data/gsm8k/test.parquet \data.train_batch_size=1024 \data.max_prompt_length=512 \data.max_response_length=1024 \data.filter_overlong_prompts=True \data.truncation='error' \actor_rollout_ref.model.path=/data1/llm/Qwen2-7B-Instruct \actor_rollout_ref.actor.optim.lr=1e-6 \actor_rollout_ref.model.use_remove_padding=True \actor_rollout_ref.actor.ppo_mini_batch_size=256 \actor_rollout_ref.actor.ppo_micro_batch_size_per_gpu=40 \actor_rollout_ref.actor.use_kl_loss=True \actor_rollout_ref.actor.kl_loss_coef=0.001 \actor_rollout_ref.actor.kl_loss_type=low_var_kl \actor_rollout_ref.actor.entropy_coeff=0 \actor_rollout_ref.model.enable_gradient_checkpointing=True \actor_rollout_ref.actor.fsdp_config.param_offload=False \actor_rollout_ref.actor.fsdp_config.optimizer_offload=False \actor_rollout_ref.rollout.log_prob_micro_batch_size_per_gpu=40 \actor_rollout_ref.rollout.tensor_model_parallel_size=2 \actor_rollout_ref.rollout.name=vllm \actor_rollout_ref.rollout.gpu_memory_utilization=0.6 \actor_rollout_ref.rollout.n=5 \actor_rollout_ref.ref.log_prob_micro_batch_size_per_gpu=40 \actor_rollout_ref.ref.fsdp_config.param_offload=True \algorithm.use_kl_in_reward=False \trainer.critic_warmup=0 \trainer.logger='["console","swanlab"]' \trainer.project_name='verl_grpo_example_gsm8k' \trainer.experiment_name='qwen2_7b_function_rm' \trainer.n_gpus_per_node=8 \trainer.nnodes=1 \trainer.save_freq=20 \trainer.test_freq=5 \trainer.total_epochs=15 $@
步骤四:验证预约时间到期checkpoint
每一步推演,会看到如下日志输出:
[DEBUG] should_save_ckpt_esi - Input params: max_steps_duration=193.8472616119543, save_ckpt_duration=60, redundant_time=0
[DEBUG] should_save_ckpt_esi - Environment variables: MLP timestamp=1757853000, AWS timestamp=None
[DEBUG] should_save_ckpt_esi - VEMLP platform: remaining_time=273525.75s
[DEBUG] should_save_ckpt_esi - VEMLP: Should save checkpoint? False
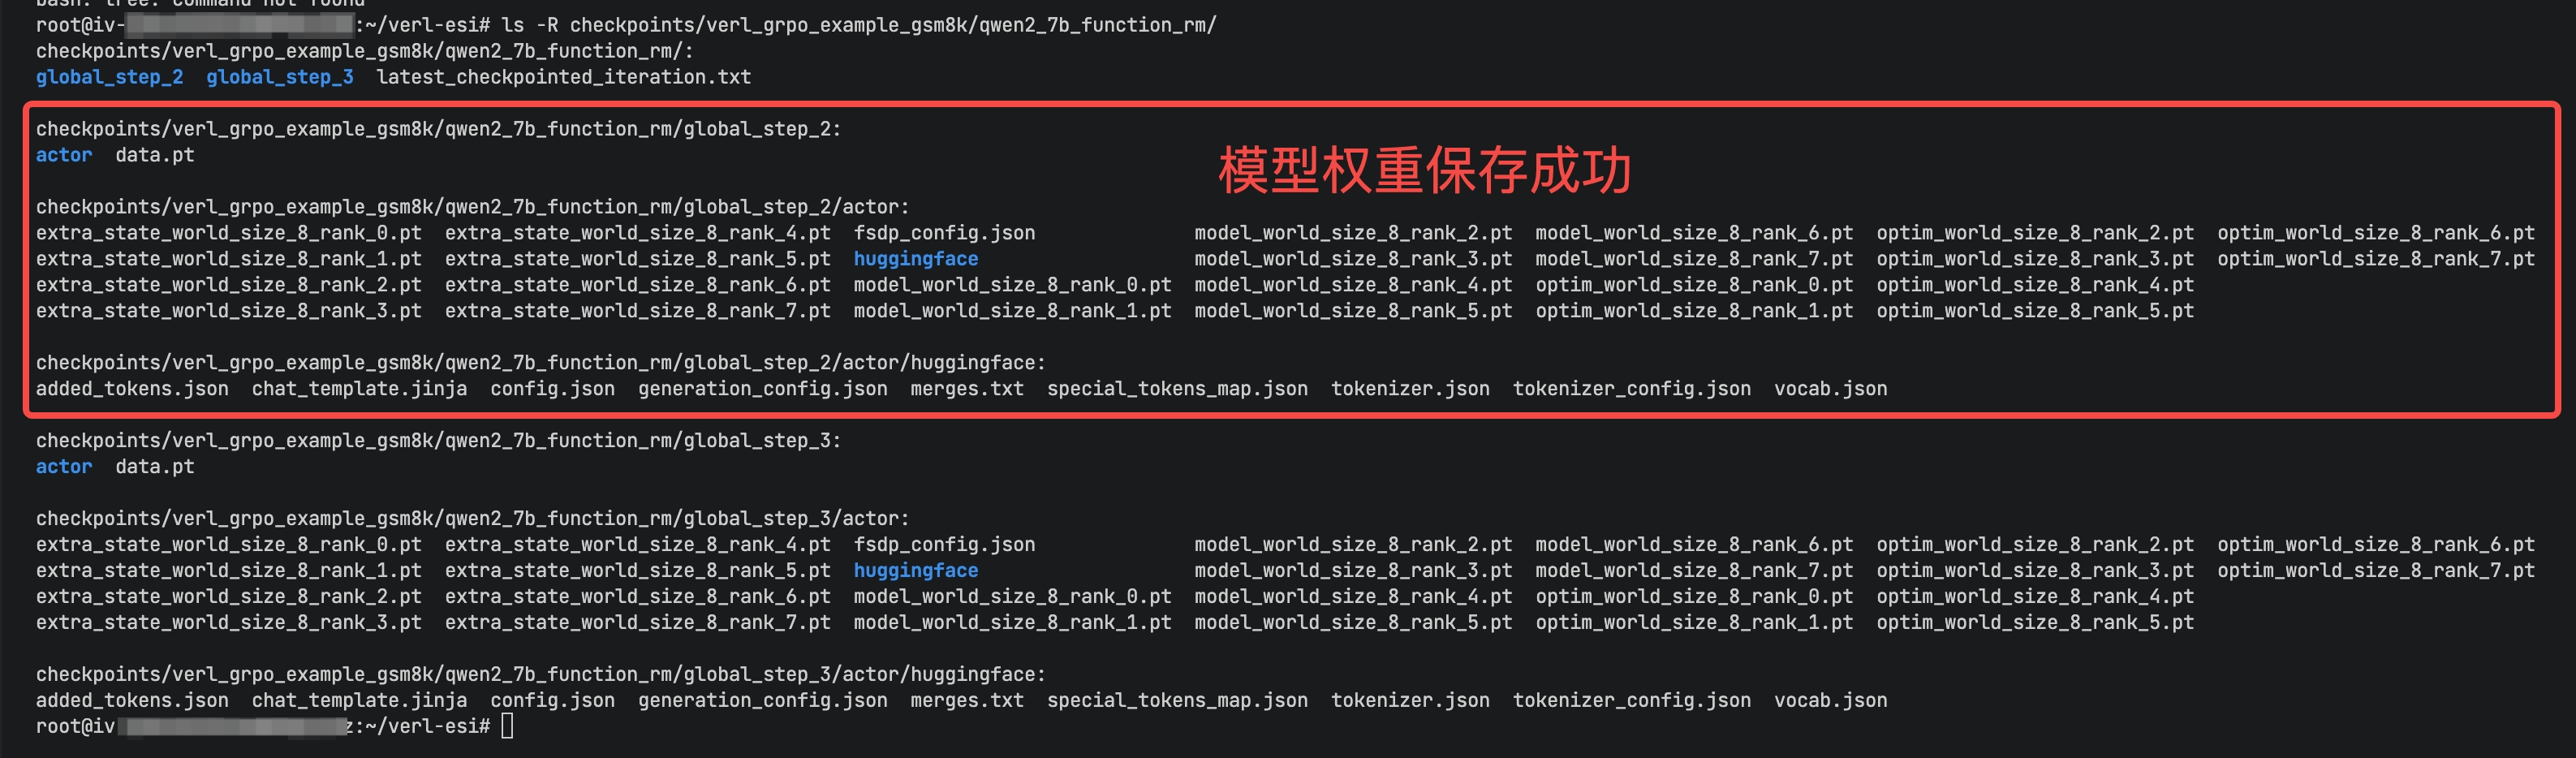
当Should save checkpoint == True的情况下,即可在checkpoints/${trainer.project_name}/${trainer.experiment_name}目录下dump模型ckpt。
工程建议与调优要点
- 测量保存耗时 (T_save):用一次真实的 save_checkpoint() 测试,记录耗时并更新 save_ckpt_duration。保存时间受 checkpoint 大小、磁盘 I/O、网络挂载延迟影响。
- 设置 T_max_steps 策略:推荐使用滑动窗口(例如最近 100 步)取最大值或 P95/P99,避免仅用平均值导致低估峰值。
- 冗余时间 esi_redundant_time:建议 ≥ 网络/系统抖动的上界(例如 1 ~ 30分钟),对关键训练可适当增加。
- 保存策略:在 I/O 成本可控情况下,降低单次 checkpoint 大小(更多小频次保存)可以降低丢失后重训的损失,但会增加 I/O 开销;需在成本与恢复速度间折中。
常见问题排查
- 没有拿到预约实例信息 / auto_release_at 字段为空:确认实例确为弹性预约(scheduled)实例,或检查权限/凭证是否有 DescribeScheduledInstances 权限。
- 时间格式解析失败:观察 API 返回的时间字符串格式,必要时使用 dateutil.parser.parse() 兼容解析。
- 保存超时或失败:检查磁盘空间、目标路径权限、网络挂载(NFS/S3)延迟;将 save_ckpt_duration 调高并重试。
- 环境变量未注入容器:确认 docker run -e 中已传入,或容器入口脚本已导出该变量。
最近更新时间:2025.09.25 14:05:10
这个页面对您有帮助吗?
有用
有用
无用
无用