GPU云服务器
GPU云服务器


文档指南

请输入


- 文档首页
 GPU云服务器GPU云服务器最佳实践性能测试/调优自研高性能集合通信库veCCL
 复制全文
 下载 pdf
自研高性能集合通信库veCCL
 文档反馈
 问问助手
本文为您介绍veCCL的主要特性与在hpcpni3ln实例中使用veCCL的方法。
背景信息
veCCL简介
veCCL是云平台基于NCCL(Nvidia Collective Communication Library)自研开发的高性能集合通信库,支持安装在单节点或多节点的多张GPU卡上,结合云平台自身的网络特点及丰富的大模型任务通信调优经验,实现多GPU之间的高性能通信。
veCCL提供了一系列高度优化的通信原语,能够在特定拓扑或集合操作中显著优化通信效率,帮助并行计算任务在多个GPU间高效地同步和交换数据。作为NCCL的增强版,veCCL对用户完全透明,只需正确加载动态库,无需更改应用程序调用NCCL集合操作的方式即可使用。相比NCCL的默认实现,veCCL能自动加载并运行为特定拓扑和通信场景优化的算法,显著减少通信延迟并提高数据吞吐量。而在遇到veCCL不支持的场景时,它会智能回退到NCCL的默认实现方式。
增强特性介绍
- 高性能:veCCL能够依据特定机型、特定拓扑结构以及特定通信模式,提供最优算法。
- 快速定位故障:在分布式集群协作任务中,能够实现对故障点的迅速识别与精准界定。
- 稳定性:具备应对简单和较为复杂异常情况的能力,例如提供了Softbond能力,当网卡故障时可实现自动切换,从而维持业务稳定运行不中断。关于Softbond能力的使用介绍,请参考使用NCCL Softbond Plugin保障单网卡故障下训练流量恢复。
准备环境
- 已创建高性能计算GPU型实例,本文所示配置如下:
- 规格:ecs.hpcpni3ln.45xlarge
- 镜像:Ubuntu 22.04 with GPU Driver 535.161.08 and doca
- GPU驱动版本:535.161.08
- 执行nvcc -V命令查看CUDA版本。若未安装,请安装CUDA。
- 执行python3 --version命令查看Python版本。若未安装,请安装Python。
操作步骤
步骤一:安装veCCL
- 登录实例。
- 执行以下命令,安装veCCL。
- pip install veccl -i https://private.ivolces.com/pypi/simple
- 执行以下命令检查安装是否成功
- ls `python3 -c "import veccl; print(veccl.ld_library_path())"`
- 回显如下,表示已成功安装veCCL。
-

步骤二:配置veCCL通信环境
本文提供Shell Script与Python Script两种方式配置veCCL通信环境。主要确保运行前:
- LD_PRELOAD包含veCCL库。
- NCCL_NET_PLUGIN=soft-bonding以及LD_LIBRARY_PATH中包含soft-bonding路径。
- 执行以下命令,创建shell脚本文件。
- vim veccl_config.sh
- 将以下代码粘贴到文件中。
- # 预加载veCCL库,确保veCCL的通信优化优先生效。export LD_PRELOAD=$(python3 -c "import veccl; print(veccl.lib_paths())"):${LD_PRELOAD}# 指定使用Softbond插件,提升网络可靠性。export NCCL_NET_PLUGIN=soft-bondingexport NCCL_IB_TIMEOUT=18# 将veCCL库的依赖路径添加到动态链接库搜索路径中。export LD_LIBRARY_PATH=$(python3 -c "import veccl; print(veccl.ld_library_path())"):$LD_LIBRARY_PATHexport NCCL_DEBUG=INFO
- 按Esc退出编辑模式,输入:wq并按Enter键,保存并退出文件。
- 依次执行以下命令,赋予脚本可执行权限并运行脚本。
- chmod +x veccl_config.sh./veccl_config.sh
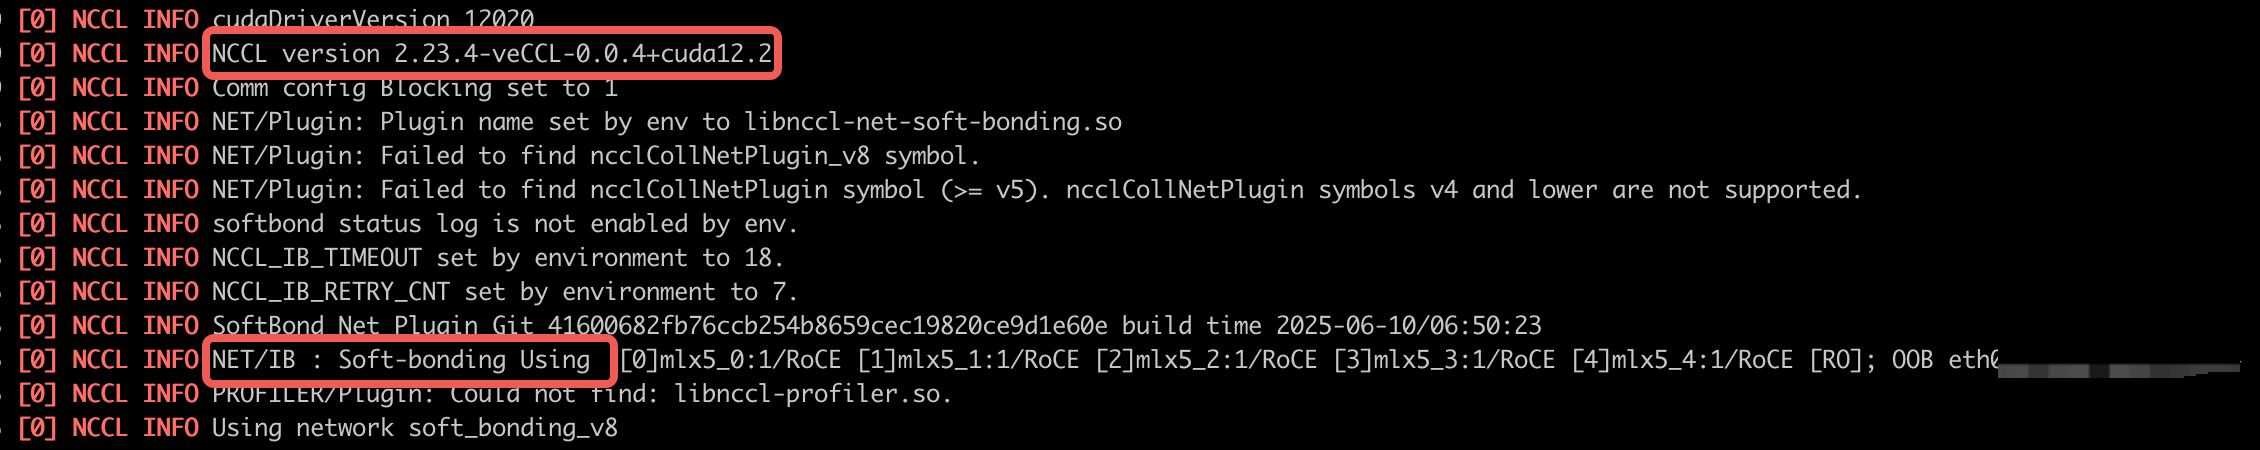
- 可以根据红框部分日志信息确定veCCL的使能情况。
- NCCL version 2.23.4-veCCL-x.x.x+cuda12.2表示成功使能veCCL。
- NET/IB : Soft-bonding Using表示成功使能Softbond。
-
- 执行以下命令,创建python脚本文件。
- vim veccl_config.py
- 将以下代码粘贴到文件中。
- import vecclimport osimport subprocess# 设置关键环境变量并启用veCCL高性能通信优化。veccl.enable() # 配置LD_PRELOAD, NCCL_NET_PLUGIN与LD_LIBRARY_PATH。os.environ['NCCL_DEBUG'] = 'INFO'os.environ['NCCL_IB_TIMEOUT'] = '18'
- 依次执行以下命令,赋予脚本可执行权限并运行脚本。
- chmod +x veccl_config.pypython3 veccl_config.py
- 脚本运行成功后,veccl.enable()的设置情况会有如下打印,表示关键环境变量配置成功。
-

步骤三:验证veCCL运行效果
以下示例提供了一个脚本test.py,用于展示在单机8卡的实例中,基于PyTorch分布式训练框架采用allreduce通信算法进行加速的效果。
- 执行以下命令查看PyTorch版本。若未安装,请安装Pytorch。
- python3 -c "import torch; print(torch.__version__)"
- 执行以下命令,创建测试脚本文件。
- vim test.py
- 将以下代码粘贴到文件中。
- import osimport torchimport torch.distributed as distdef main():# 环境变量解析rank = int(os.environ["RANK"])local_rank = int(os.environ["LOCAL_RANK"])world_size = int(os.environ["WORLD_SIZE"])# 设备与通信初始化torch.cuda.set_device(local_rank)dist.init_process_group(backend="nccl")# 在每个GPU上生成随机张量,并进行all_reduce操作tensor = torch.randn(1024, device=f"cuda:{local_rank}")print(f"Rank {rank}: before allreduce tensor sum = {tensor.sum().item()}")dist.all_reduce(tensor, op=dist.ReduceOp.SUM)# all_reduce结果验证与资源释放print(f"Rank {rank}: after allreduce tensor sum = {tensor.sum().item()}")dist.destroy_process_group()if __name__ == "__main__":main()
- 按Esc退出编辑模式,输入:wq并按Enter键,保存并退出文件。
- 赋予脚本可执行权限。
- chmod +x test.py
- 执行如下脚本运行test.py。
- Shell:
- NCCL_DEBUG=INFO torchrun --nproc_per_node=8 test.py
- Python:
- 执行python3命令进入Python交互模式。
- 显示>>>提示符后,输入import subprocess,用于执行外部命令。
- 继续执行以下命令。
- # 执行test.py脚本启动单机8卡分布式训练任务。torchrun_command = ["torchrun","--nproc_per_node=8","test.py"] # 注意:如果提示找不到torchrun,请填写绝对路径try:subprocess.run(torchrun_command, check=True) # 注意:修改LD_PRELOAD仅对子进程生效,因此需要subprocess.run# 捕获并打印torchrun命令执行失败的信息。except subprocess.CalledProcessError as e:print(f"torchrun failed with error: {e}")
- 查看基于veCCL通信库的allreduce运算结果。
-

关键环境变量说明
最近更新时间:2025.06.18 10:30:25
这个页面对您有帮助吗?
有用
有用
无用
无用