You need to enable JavaScript to run this app.
文档中心
全栈可观测平台

全栈可观测平台

复制全文
下载 pdf
通用 AI 应用监控
LLM 监控看板
复制全文
下载 pdf
LLM 监控看板
AI 应用监控针支持对大模型(Large Language Model,LLM) 应用进行观测,为 LLM 应用安装自研的 Python 探针后,可从模型和服务视角直观观测模型调用、Token 消耗、TTFT 等性能指标。本文为您详细介绍如何查看大模型相关监控信息。
前提条件
已经将 LLM 应用接入应用性能监控并开启自动埋点,具体操作参见:Python 应用接入
操作步骤
查看 LLM 监控看板
  1. 登录 AI 应用监控,并在顶部导航栏选择项目和地域。
  1. 在左侧导航栏选择 LLM 监控看板
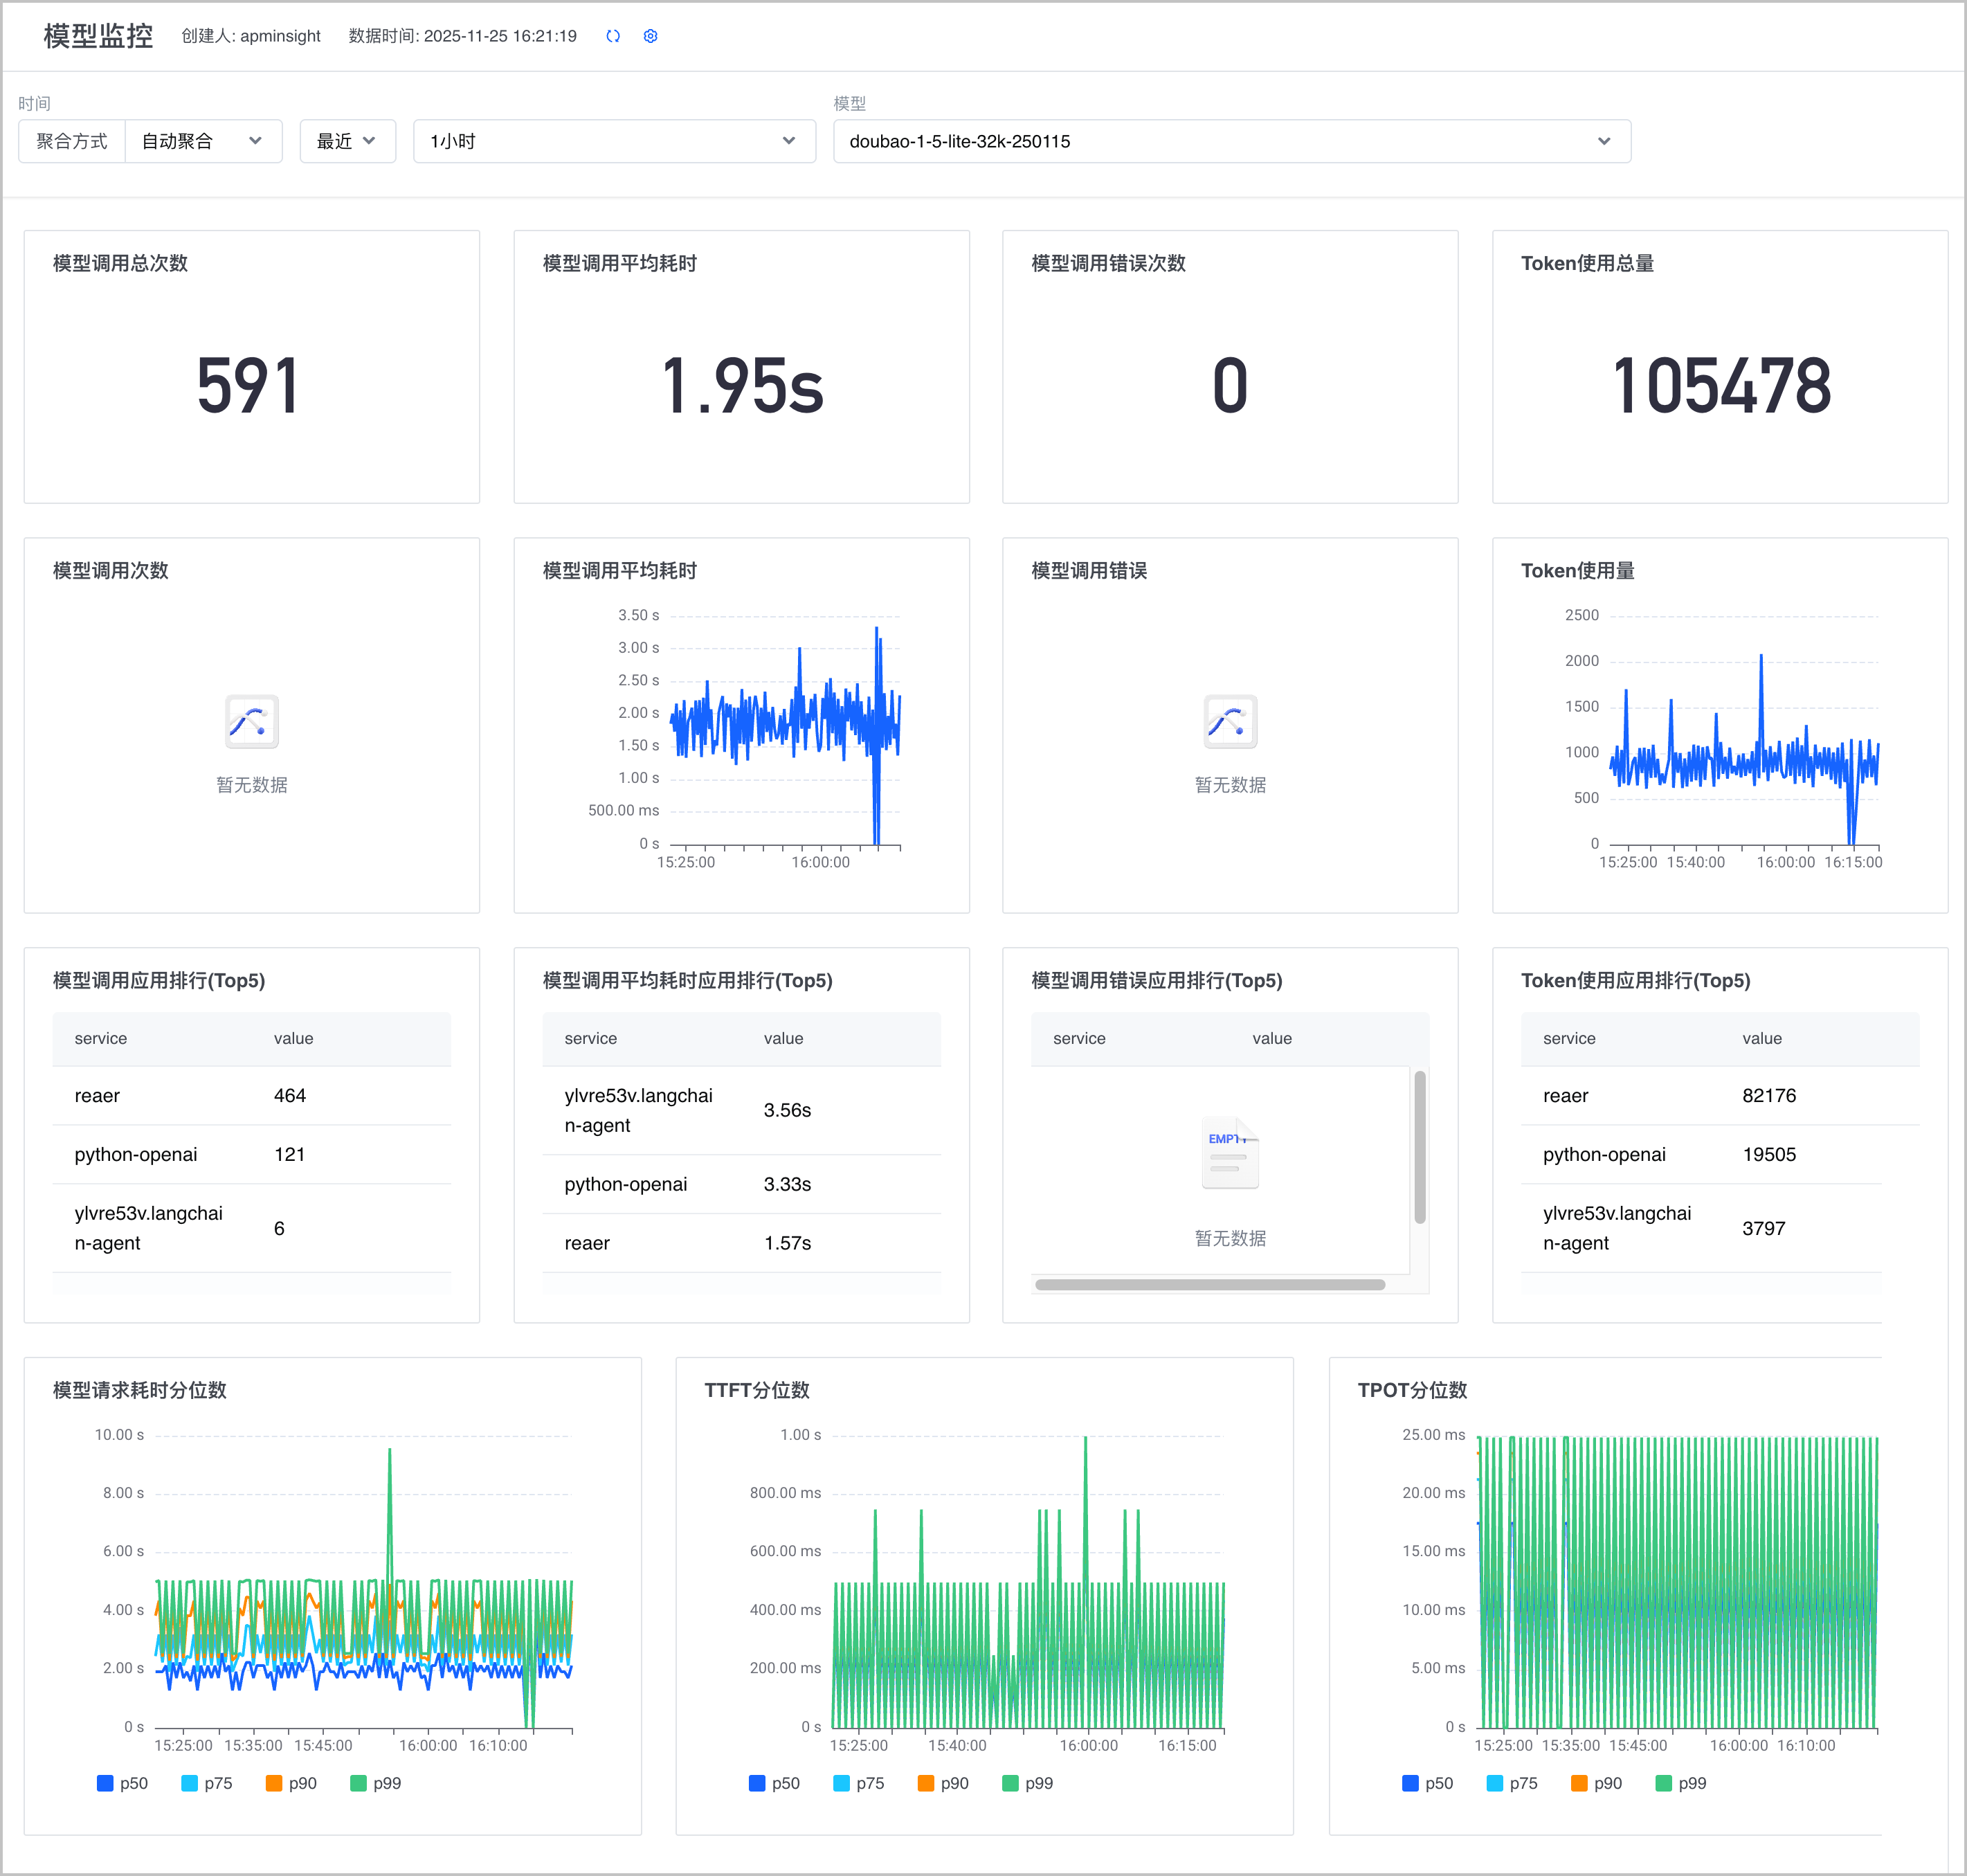
  1. 选择时间范围和模型,查看指定模型在固定时间段内的监控信息。
看板名称
说明
模型调用总次数
调用指定 LLM 的总次数。
模型调用平均耗时
调用指定 LLM 的平均耗时。
模型调用错误次数
调用指定 LLM 失败的次数。
Token 使用总量
指定 LLM Token 消耗总量(input + output)。
模型调用次数
调用指定 LLM 的次数趋势。
模型调用平均耗时
调用指定 LLM 的平均耗时趋势。
模型调用错误
调用指定 LLM 失败的次数趋势。
Token 使用量
指定 LLM Token 消耗总量(input + output)趋势。
模型调用应用排行(TOP5)
调用指定 LLM 的次数最多的前 5 的应用列表。
模型调用平均耗时应用排行(TOP5)
调用指定 LLM 的平均耗时最多的前 5 的应用列表。
模型调用错误应用排行(TOP5)
调用指定 LLM 的错误次数最多的前 5 的应用列表。
Token 使用应用排行(TOP5)
调用指定 LLM 的消耗Token最多的前 5 的应用列表。
模型请求耗时分位数
调用指定 LLM 耗时分位数 P99/P90/P75/P50。
TTFT 分位数
调用指定 LLM 返回首包数据的平均耗时分位数 P99/P90/P75/P50。
TPOT 分位数
调用 LLM 在首个 Token 输出后,后续输出每个 Token 所需的时间分位数。
查看 LLM 应用性能
  1. 登录 应用性能监控,并在顶部导航栏选择项目和地域。
  1. 在左侧导航栏选择 服务监控 > 服务列表
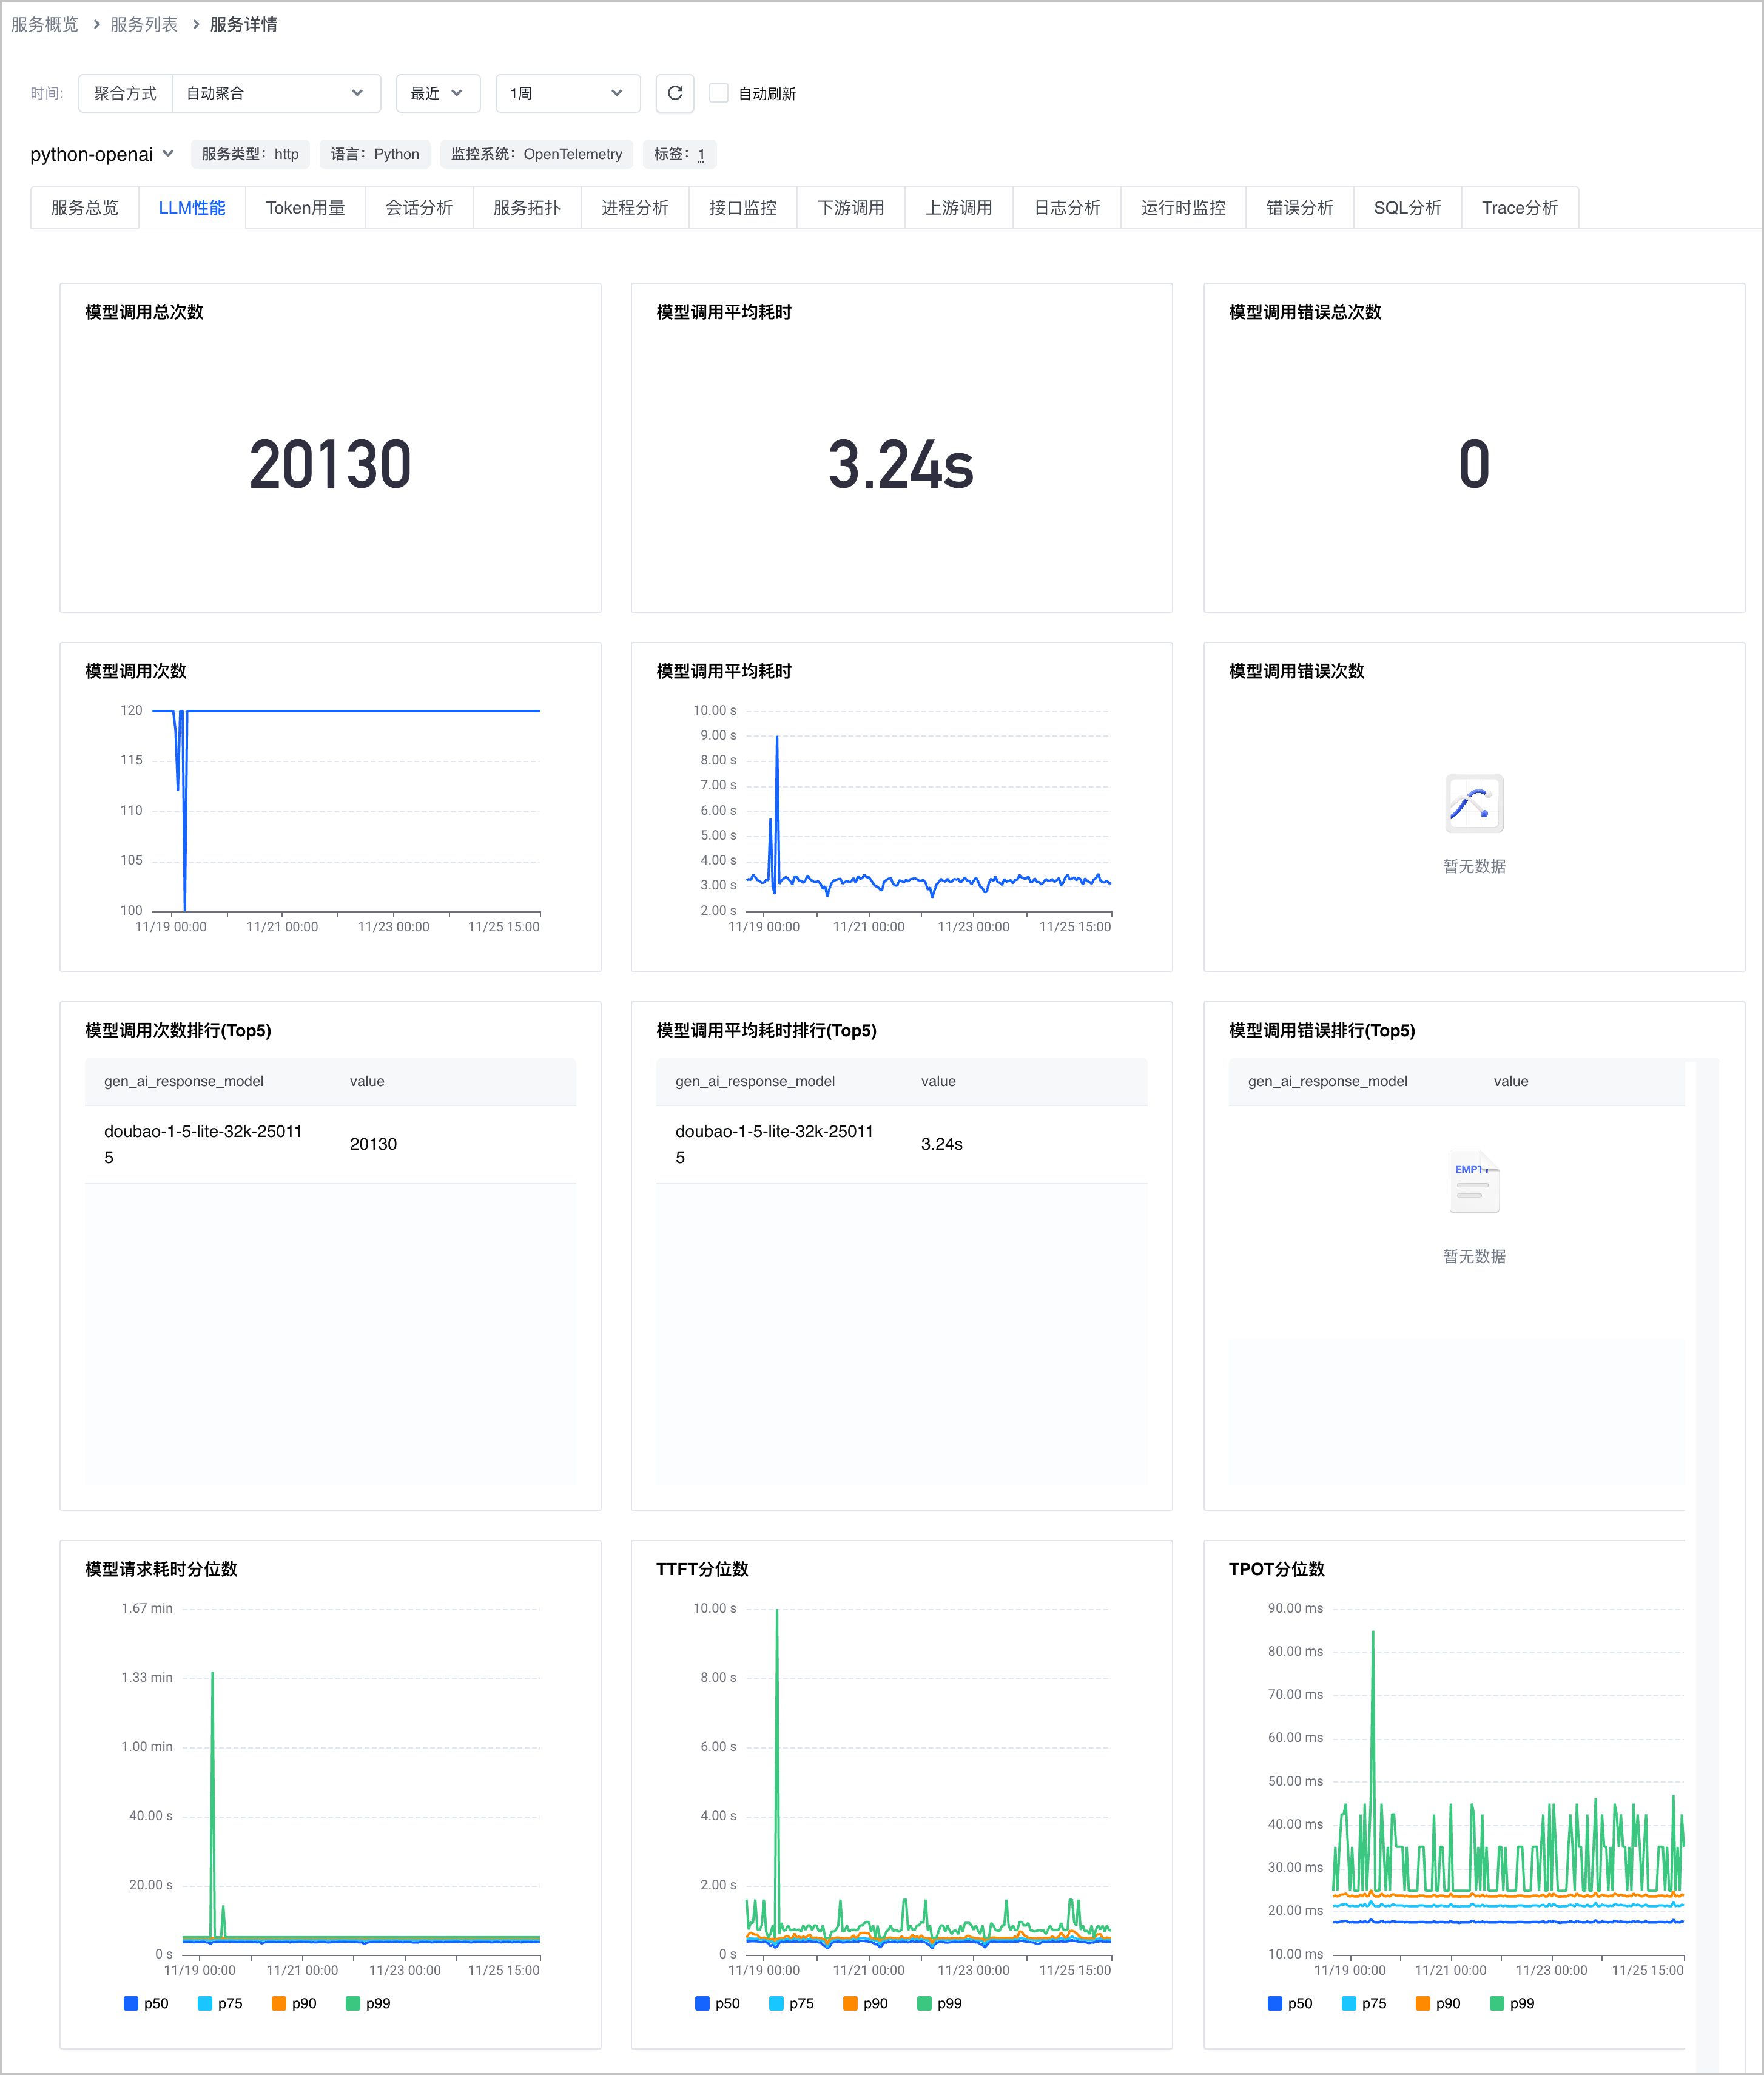
  1. 单击目标 AI 应用名称,前往服务详情页面,选择 LLM 性能 页签,查看 LLM 应用性能相关监控看板。
看板名称
说明
模型调用总次数
当前应用调用 LLM 的总次数。
模型调用平均耗时
当前应用调用 LLM 的平均耗时。
模型调用错误次数
当前应用调用 LLM 失败的次数。
模型调用次数
当前应用调用 LLM 的次数趋势。
模型调用平均耗时
当前应用调用 LLM 的平均耗时趋势。
模型调用错误
当前应用调用 LLM 失败的次数趋势。
模型调用次数排行(TOP5)
当前应用调用 LLM 的次数最多的前 5 的模型列表。
模型调用平均耗时排行(TOP5)
当前应用调用 LLM 的平均耗时最多的前 5 的模型列表。
模型调用错误排行(TOP5)
当前应用调用 LLM 的错误次数最多的前 5 的模型列表。
模型请求耗时分位数
当前应用调用 LLM 耗时分位数 P99/P90/P75/P50。
TTFT 分位数
当前应用调用 LLM 返回首包数据的平均耗时分位数 P99/P90/P75/P50。
TPOT 分位数
当前应用调用 LLM 在首个 Token 输出后,后续输出每个 Token 所需的时间分位数。
查看 LLM 应用 Token 用量
  1. 登录 应用性能监控,并在顶部导航栏选择项目和地域。
  1. 在左侧导航栏选择 服务监控 > 服务列表
  1. 单击目标 AI 应用名称,前往服务详情页面,选择 Token 用量 页签,查看 LLM 应用的 Token 用量相关监控看板。
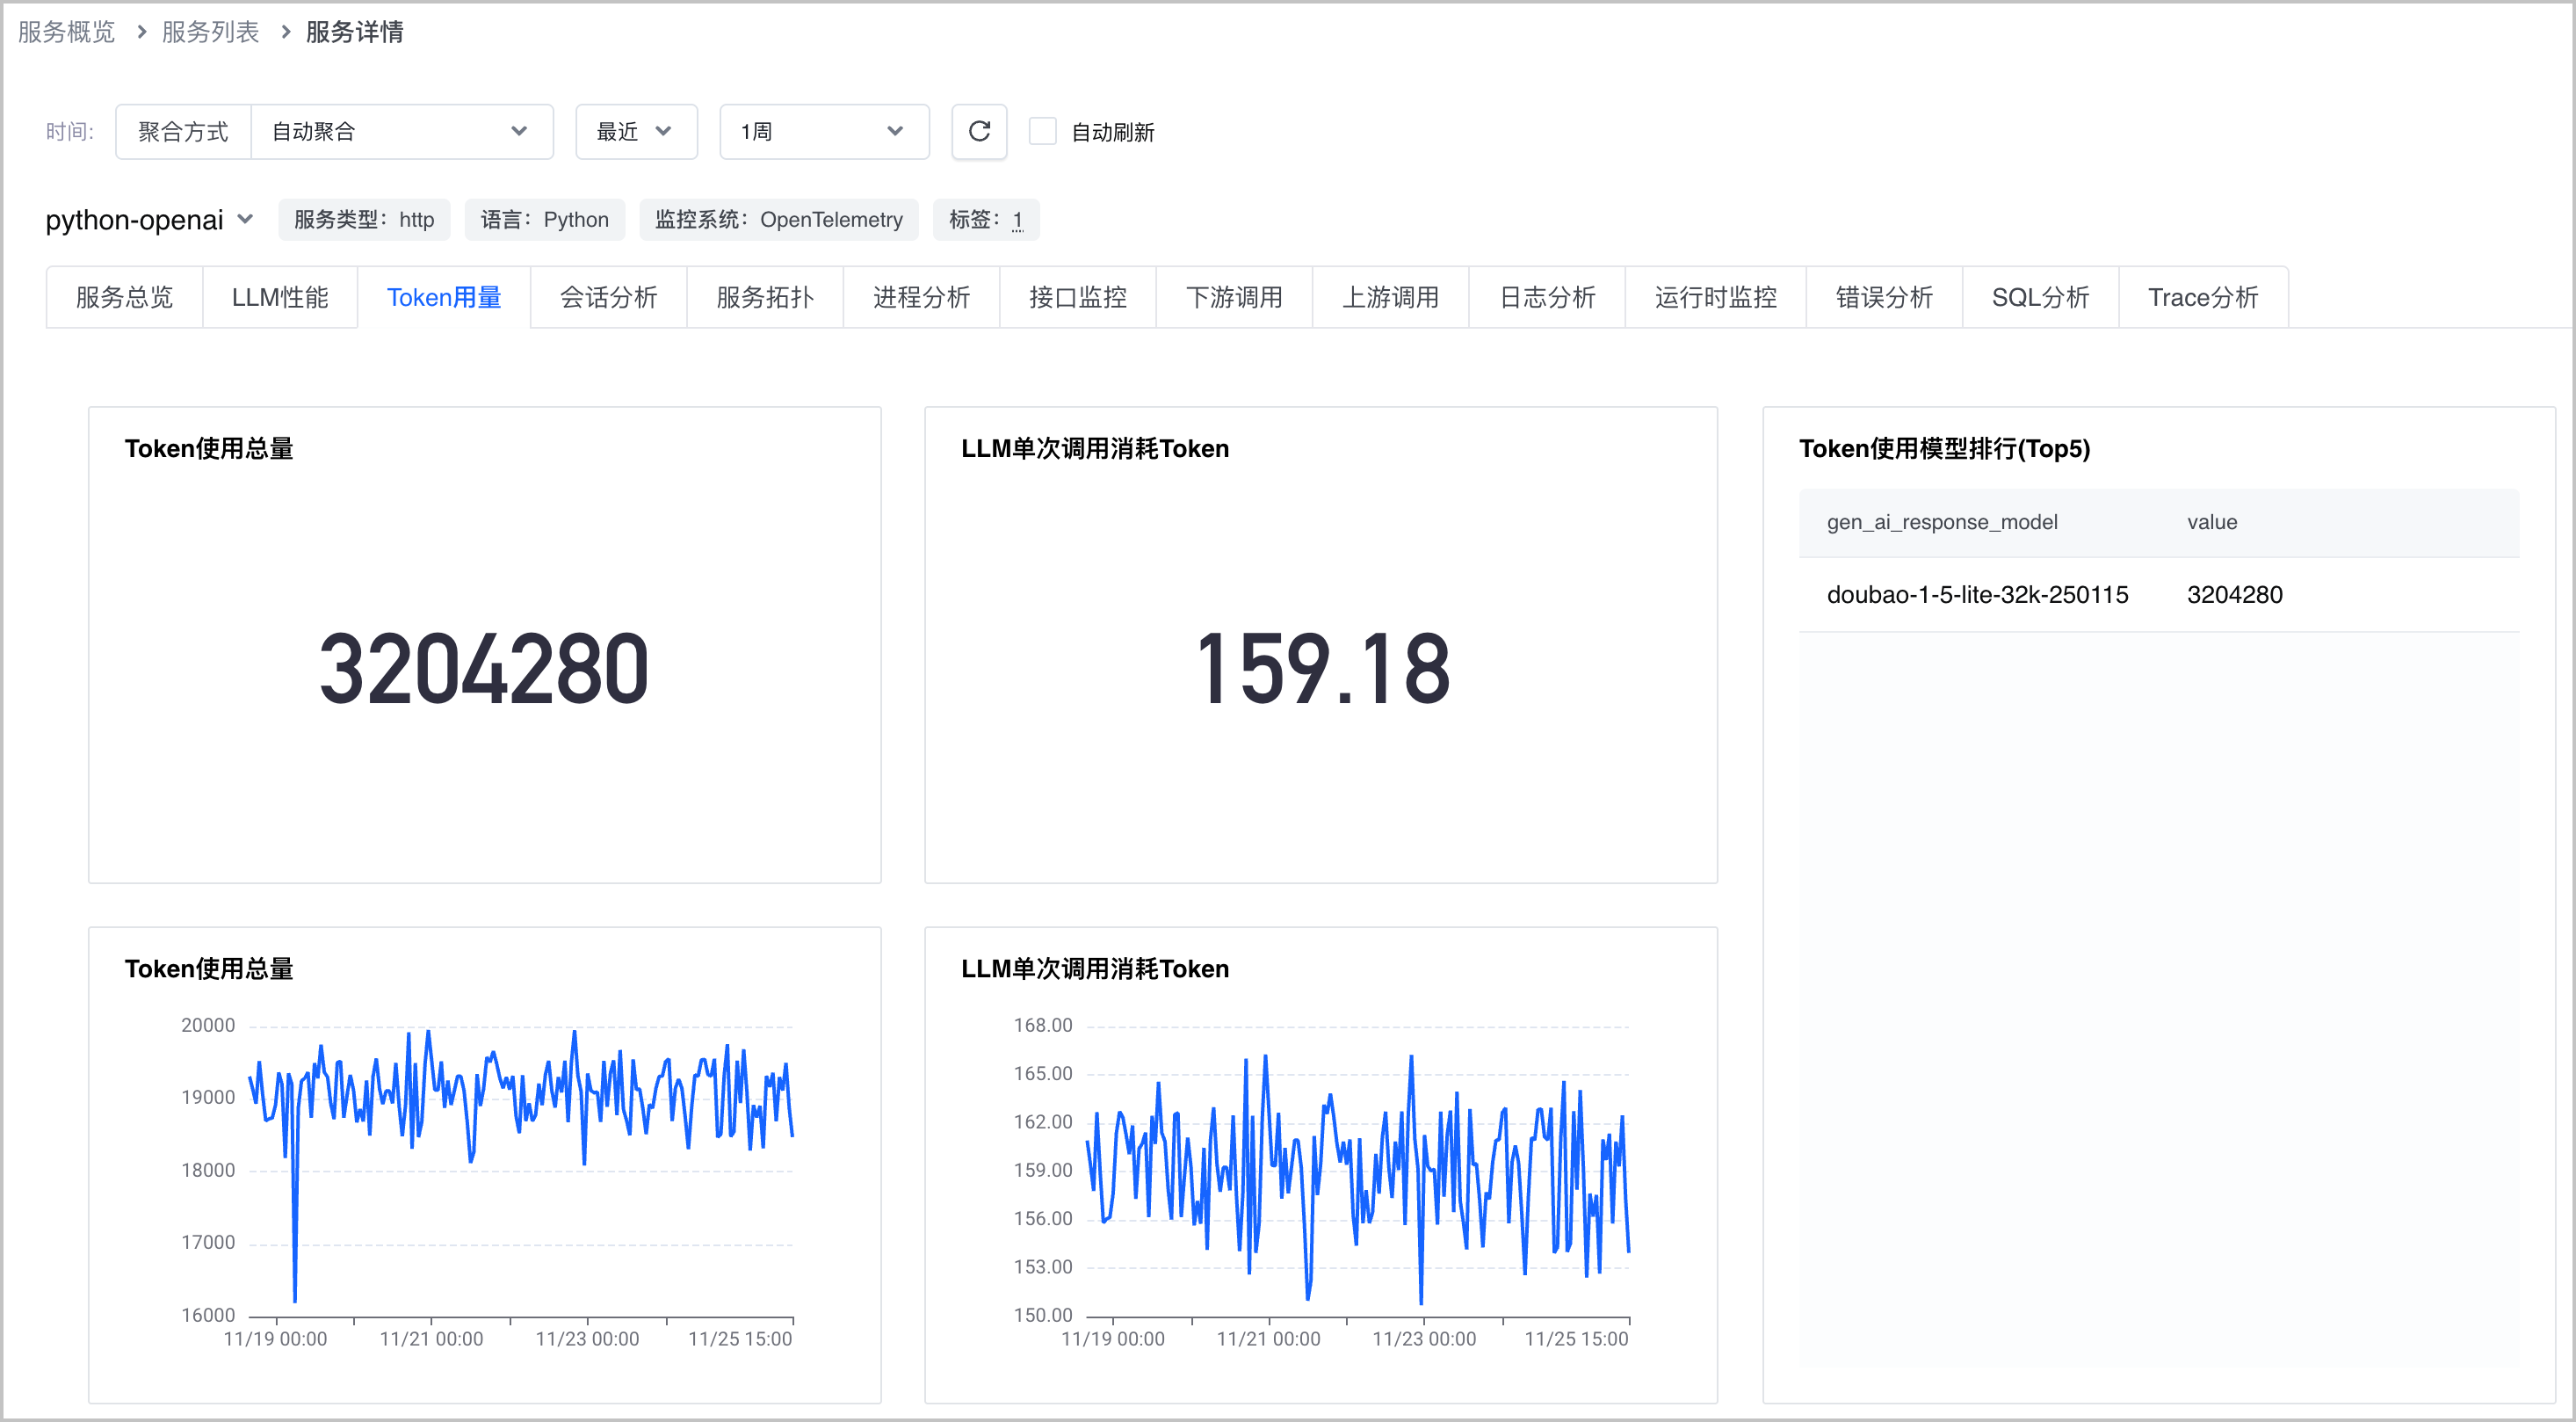
看板名称
说明
Token 使用总量
当前应用调用所有 LLM 的 Token 使用总量。
LLM 单次调用消耗 Token
当前应用每次调用 LLM 的 Token 用量。
Token 使用模型排行(Top5)
当前应用调用所有 LLM 的 Token 使用总量排名前 5 的模型列表。
Token 使用总量
当前应用调用所有 LLM 的 Token 使用总量趋势。
LLM 单次调用消耗 Token
当前应用每次调用 LLM 的消耗 Token 用量趋势。
最近更新时间:2026.01.27 20:57:33
这个页面对您有帮助吗?
有用
有用
无用
无用