全栈可观测平台
全栈可观测平台


文档指南

请输入


- 文档首页
 全栈可观测平台智能运维VeOps CLI 可观测排障助手
 复制全文
 下载 pdf
VeOps CLI 可观测排障助手
 文档反馈
 问问助手
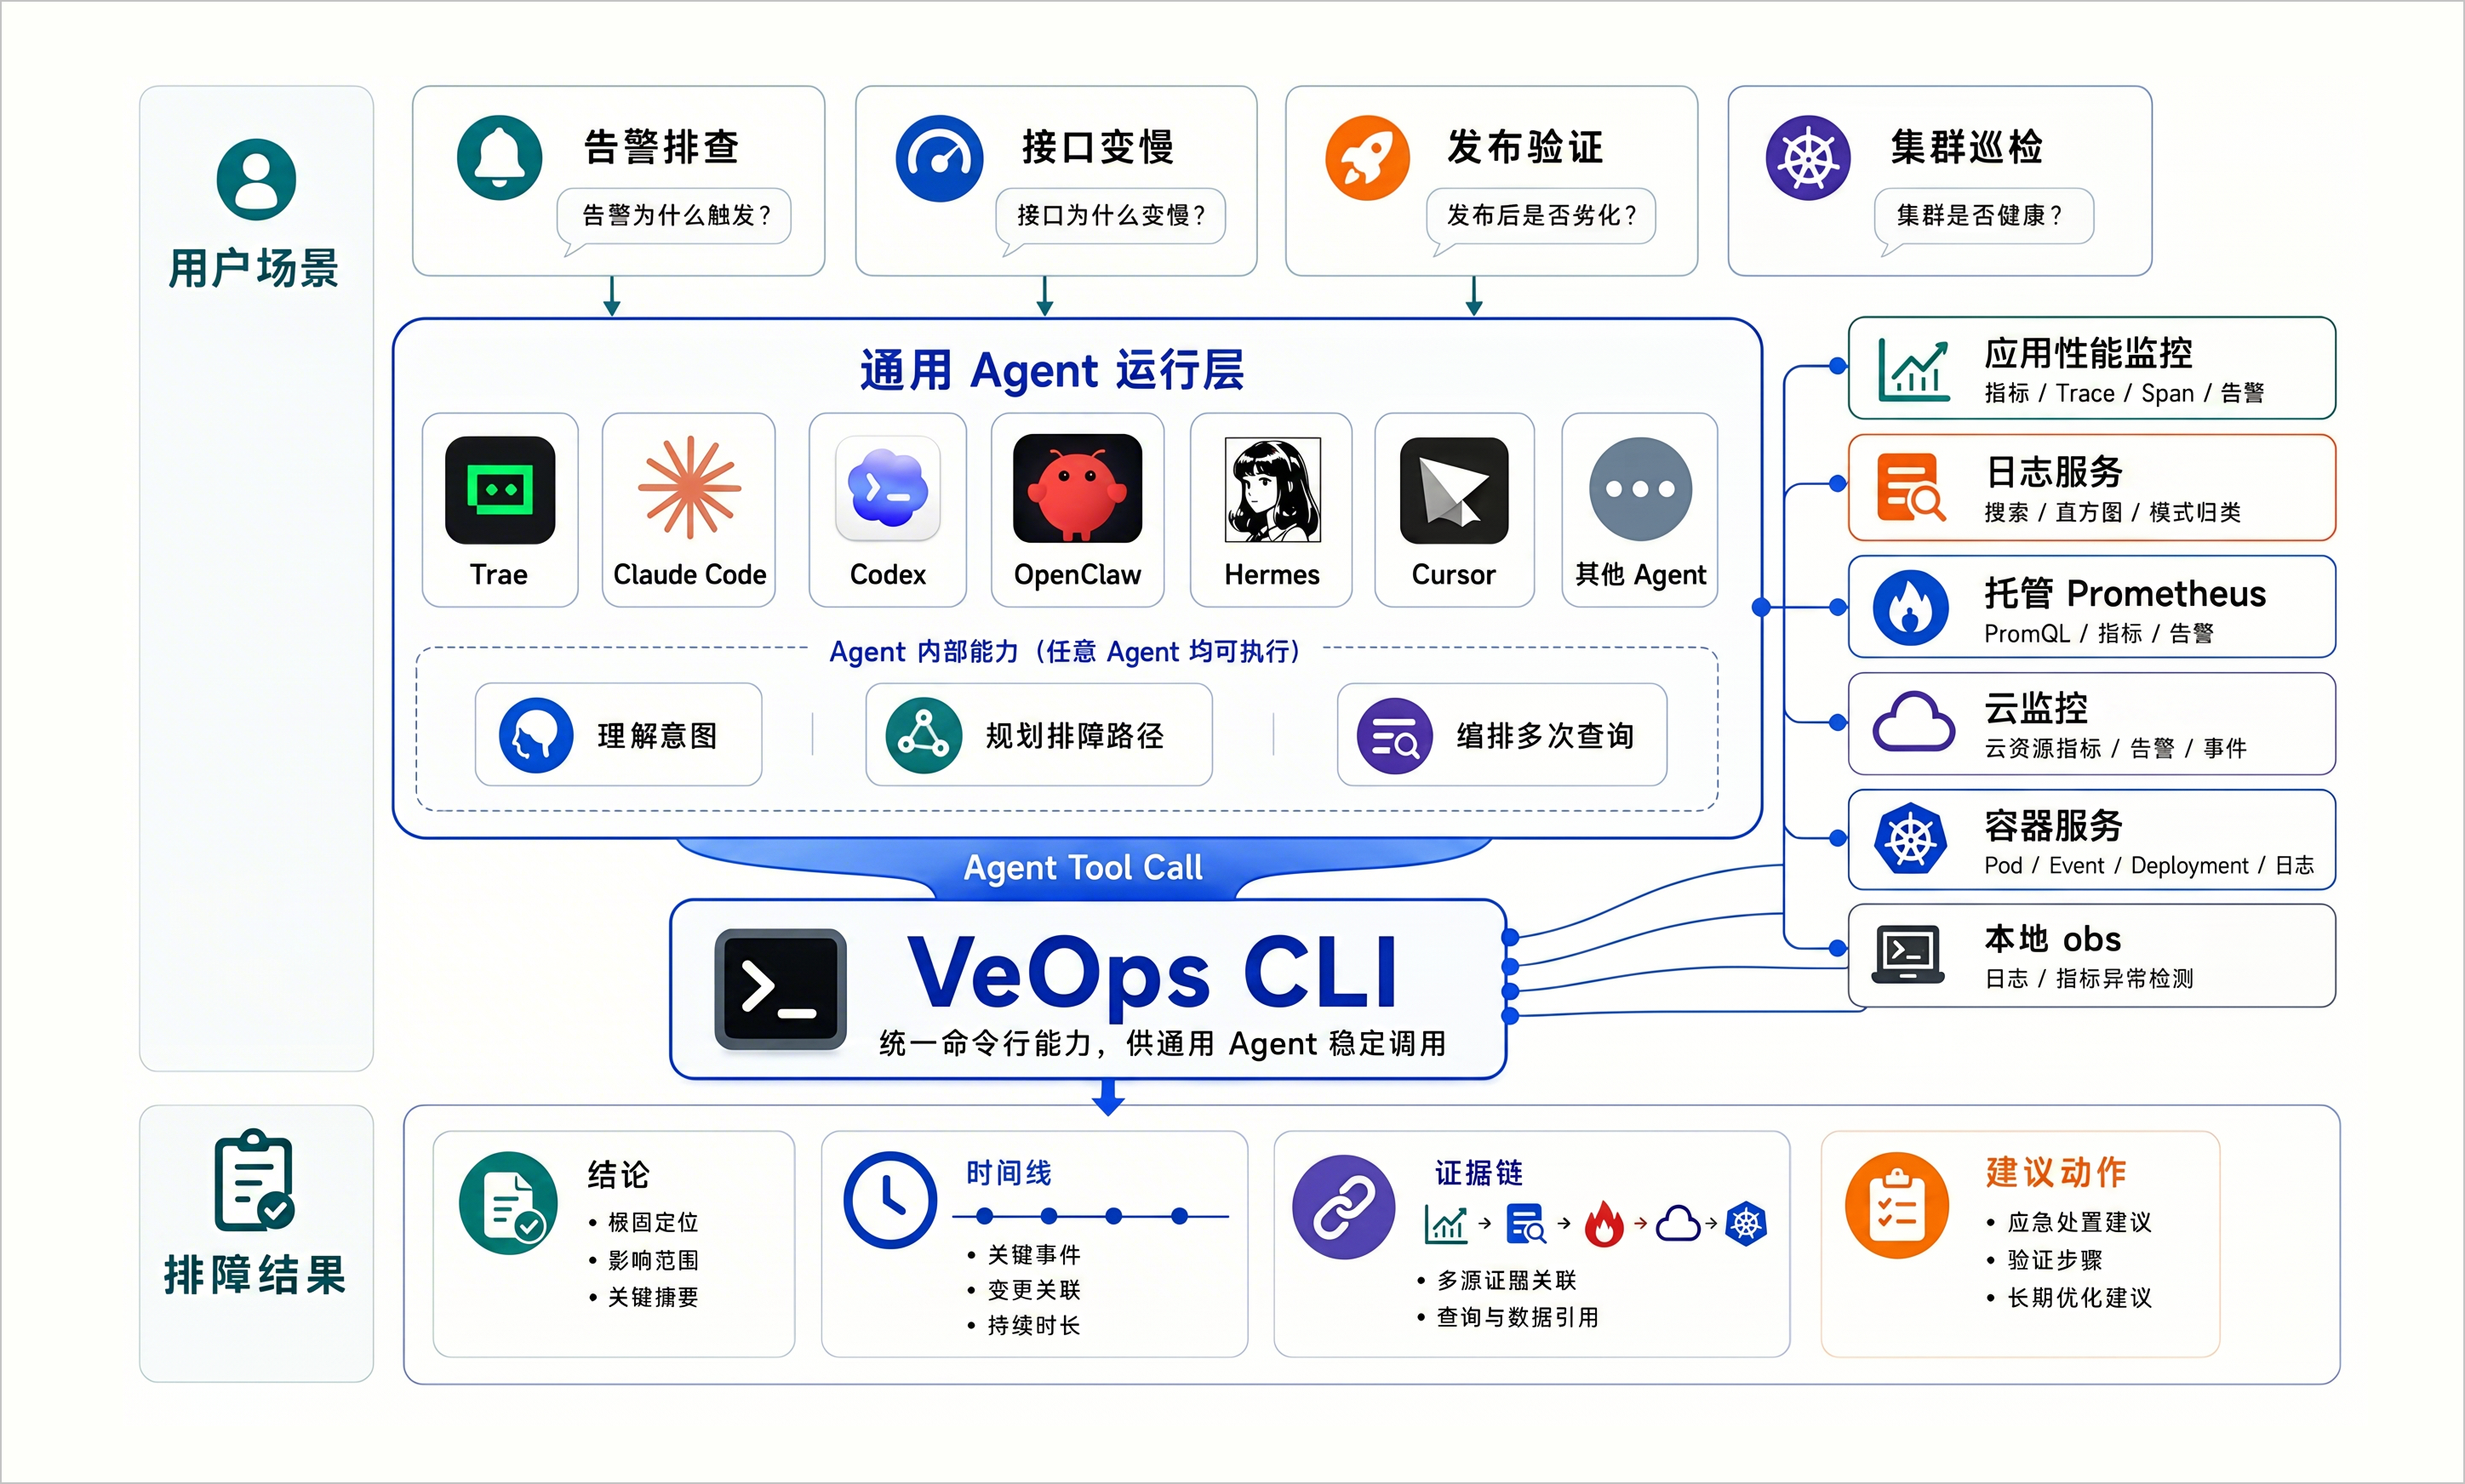
VeOps CLI 是一套面向 AI Agent 的可观测排障工具,将应用性能监控、托管 Prometheus、云监控、日志服务、容器服务,以及本地日志、指标分析功能整理成通用 Agent 可以稳定调用的命令行。安装完成后,可以将排障过程中大量重复查询和证据整理工作直接交给 AI 处理,提升排障效率。例如:通过对话方式,使用 Claude Code、Codex、Cursor、Trae、OpenClaw、Hermes 等 Agent 查询指标、日志、Trace,以及排查告警、巡检集群。
背景信息
覆盖数据源
VeOps CLI 目前覆盖可观测排障中最常用的几类数据源,包括:应用性能监控、托管 Prometheus、云监控、日志服务、容器服务,以及本地日志/指标异常检测。
数据源 | 覆盖能力 | 适合解决的问题 |
应用性能监控 | 服务、指标、Trace、Span、日志、告警、通知组、GenAI 会话 | 服务错误率升高、接口变慢、下游依赖异常、AI 应用调用链分析 |
托管 Prometheus | 即时查询、范围查询、指标名、标签、series、告警、workspace | PromQL 查询、自定义指标分析、Prometheus 告警排查 |
云监控 | namespace、metric、resource、alarm、event | ECS、CLB、RDS 等云资源指标和云监控告警排查 |
日志服务 | project、topic、index、日志搜索、日志直方图 | 错误日志检索、日志趋势分析、高频报错归类 |
容器服务 | Cluster、NodePool、Node、Add-on、Kubeconfig、Namespace、Pod、Deployment、StatefulSet、Service、Event、Pod logs | 集群巡检、Pod 异常、调度失败、镜像拉取失败、容器日志查看 |
工具价值
VeOps CLI 可以提高不同角色的工作效率:
角色 | 原来的痛点 | 使用 VeOps CLI 后 |
值班工程师 | 告警后需要在多个系统之间切换,手动拼证据 | 直接描述告警或现象,让 AI 输出时间线、证据和建议动作 |
应用研发 | 定位慢请求和错误链路需要翻指标、日志、Trace | AI 自动把指标、日志、Span、拓扑串起来,缩短定位路径 |
SRE / 运维 | 巡检集群、云资源和告警需要大量重复查询 | 用自然语言触发巡检,生成结构化报告和风险项 |
平台团队 | 用户不熟悉各产品查询入口,排障效率依赖经验 | 把可观测能力统一暴露给通用 Agent,降低使用门槛 |
新同学 | 不知道先查哪个产品、用什么过滤条件 | 通过 Agent 的查询路径学习排障方法,减少上手成本 |
VeOps CLI 与基础 AI 工具对比:不是简单地为 AI 接一个可观测后端,它的价值在于解决 Agent 排障中的实际工程问题,例如:数据怎么稳定获取、结果超出预期怎么处理、跨产品怎么关联、结论怎么审计。
对比维度 | 截图 / 复制粘贴给 AI | VeOps CLI |
数据获取 | 依靠截图和网页文本,字段和格式不可控 | 结构化 JSON envelope,Schema 保证字段名和类型稳定 |
大规模结果 | 上下文窗口溢出,信息被截断或遗漏 | --save-as 落盘,再用 jq 或 python 按字段定向提取,不因上下文溢出丢失关键证据 |
跨产品关联 | 人工在应用性能监控、日志服务、托管 Prometheus 等页面间切换,证据分散 | 统一 operation id 接口,跨 5+ 产品调用,按时间线串联 |
安全性 | Agent 可能误操作或误改云资源配置 | 只读模式,Agent 只能查询,不能修改任何云资源 |
排障质量 | 依赖个人经验和 Agent 的不稳定性 | 固定 Schema 约束查询路径,结果可预期、可复现 |
使用指南
安装配置
推荐与 Agent 对话方式,快速安装、更新或卸载 VeOps CLI。
将以下内容发送给 Agent。
帮我安装 veops-cli:https://veops-cli.tos-cn-beijing.volces.com/public/install.md
收到指令后,Agent 依次完成以下工作,并完成 VeOps CLI 安装。
配置步骤 | Agent 执行动作 |
| 自动识别操作系统和架构,将二进制文件下载到 PATH 内的可写目录中,例如 /usr/local/bin 或 ~/.local/bin。 |
| 探测本地已经安装的 Agent,并向每个 skills 目录中写入 veops-cli Skill。 |
| 提示您使用 veops-cli login 登录,或配置 AK/SK 环境变量。具体操作如下:
说明 其中,凭证存放在 ~/.volcengine/config.json 中,~/.veops-cli/config.yaml 只存放业务偏好。 |
| 自动执行 veops-cli version、veops-cli schema、veops-cli doctor,确认安装结果。 |
将以下内容发送给 Agent。Agent 将下载最新二进制并替换当前版本,同时把最新 Skill 覆盖到已安装目录,最后自动执行 veops-cli version、veops-cli schema、veops-cli doctor,确认更新结果。
注意
- 更新操作不会删除登录状态和本地配置。
- 更新 Skill 后需要手动重启 Agent。不同 Agent 的重启方式和重启命令各不相同,以 OpenClaw 为例,重启命令为 openclaw gateway restart。
帮我更新 veops-cli
将以下内容发送给 Agent。Agent 将删除二进制、清理各 Agent skills 目录中的 veops-cli Skill。
注意
- 默认不删除 ~/.volcengine/config.json,因为该文件可能被其他工具复用。
- 默认不删除 ~/.veops-cli 本地配置,可以按需手动删除。
- 卸载后需要手动重启 Agent。不同 Agent 的重启方式和重启命令各不相同,以 OpenClaw 为例,重启命令为 openclaw gateway restart。
帮我卸载 veops-cli
使用方式
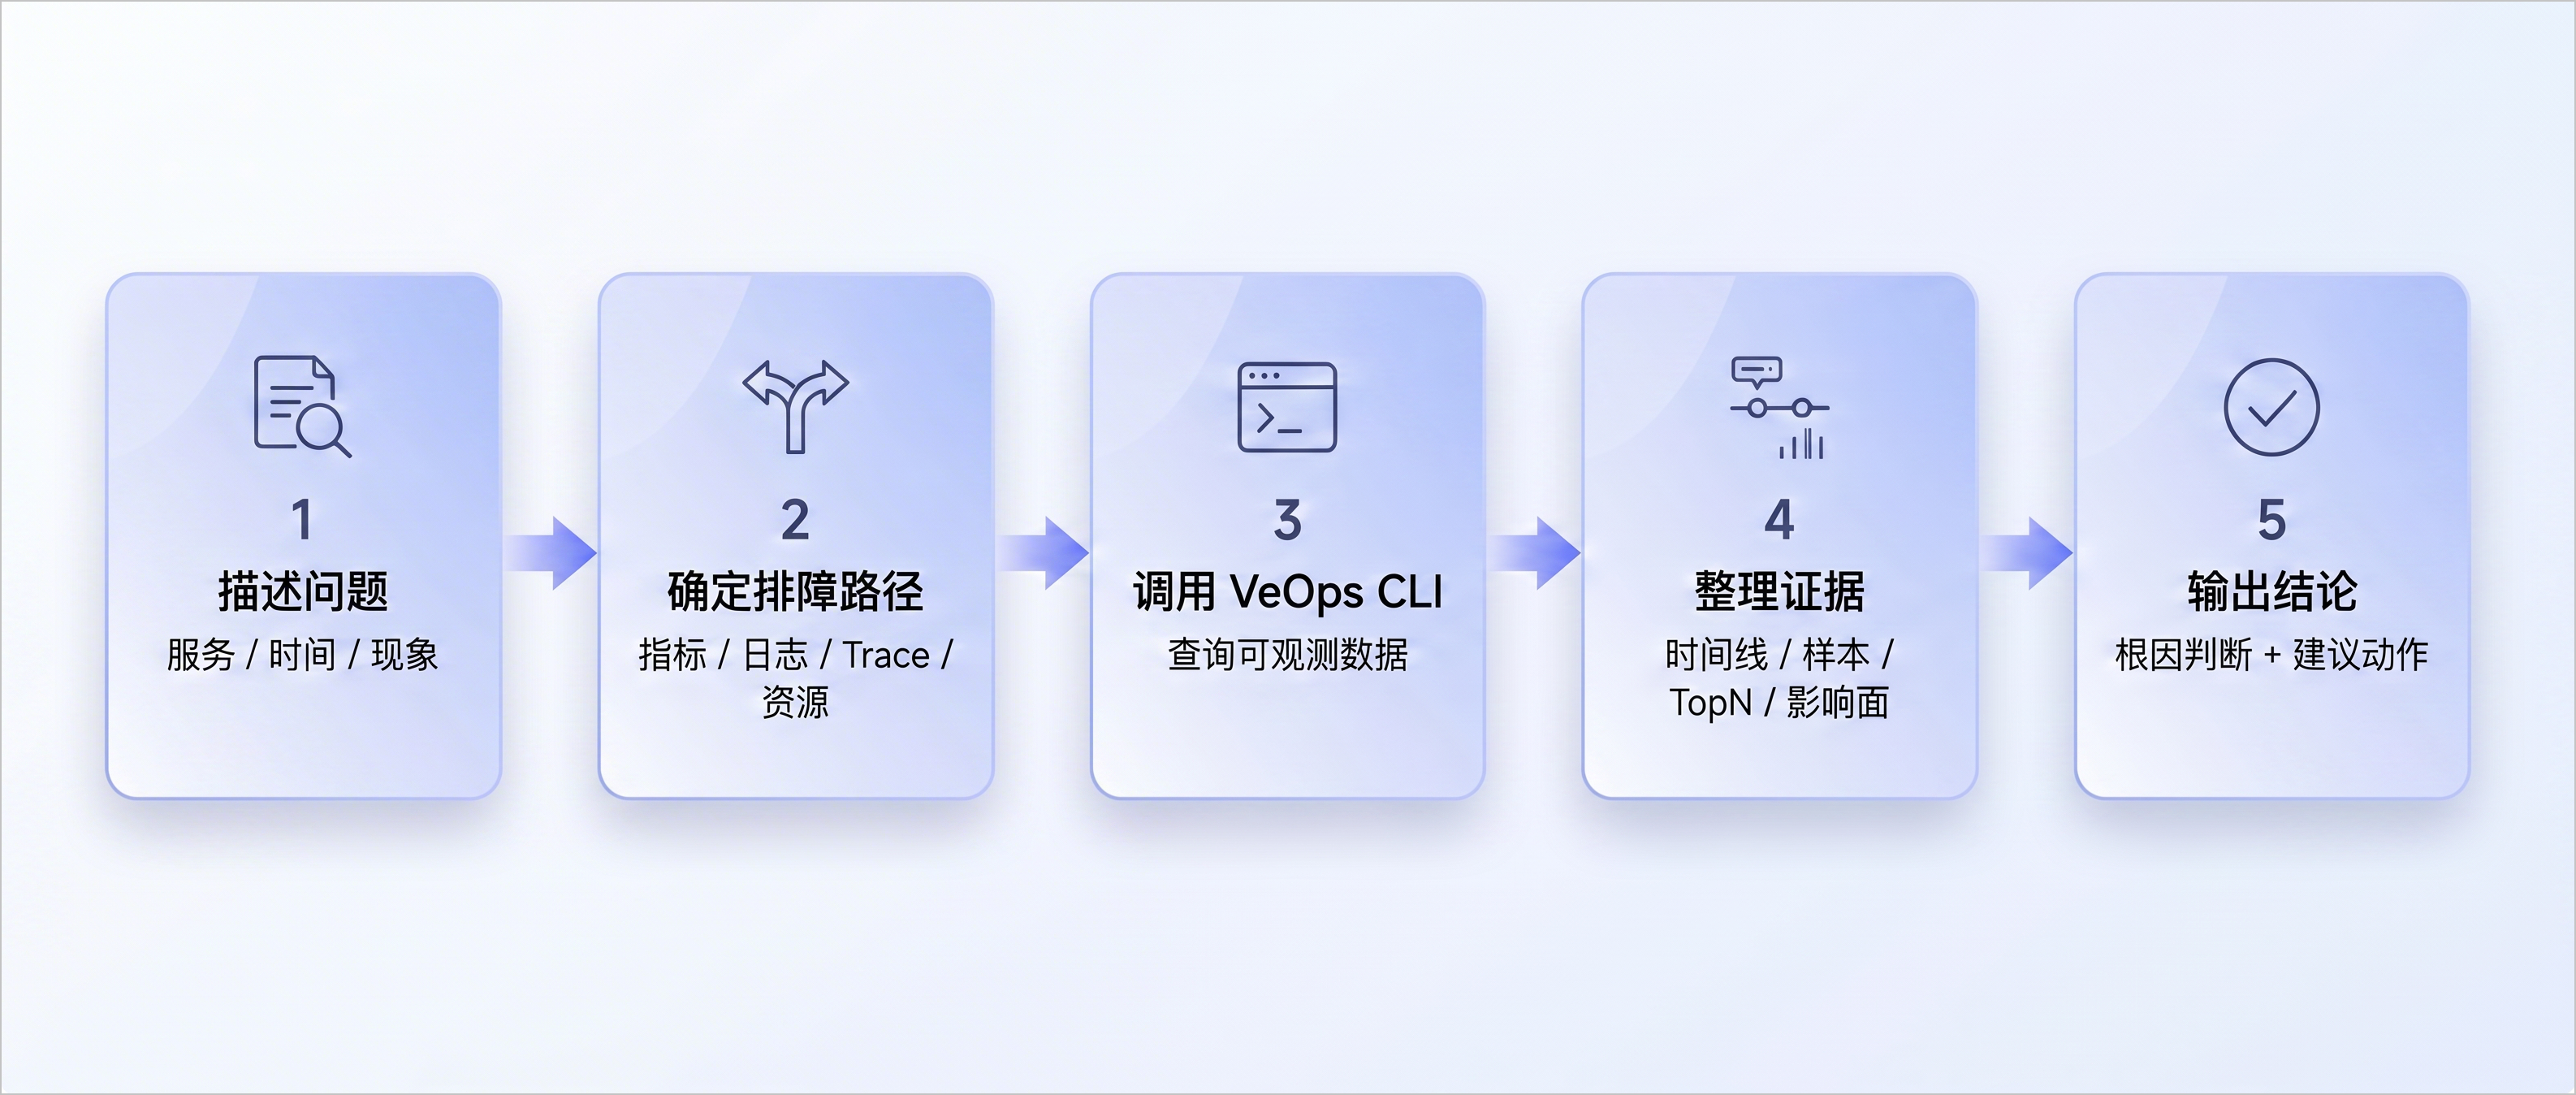
成功安装 VeOps CLI 后,可直接在 Agent 中通过对话方式查询指标、日志、Trace,以及排查告警、巡检集群。使用 VeOps CLI 时,您无需记住命令,通过自然语言把问题描述清楚即可,Agent 替您直接调用,并完成故障分析。如下图所示:
注意
- VeOps CLI 目前只有查询能力,不会对云资源做任何修改。
- 权限跟随火山引擎账号,不会查看权限范围以外的数据。
- VeOps CLI 面向 Agent 设计,如果遇到问题,直接描述现象让 AI 排查即可。
帮我看一下 order-api 最近 1 小时为什么错误率升高。
收到问题后,AI 并非只跑一条命令,而是先判断应该查哪些数据线,然后按排障路径逐步收集证据。例如:
- 先查看应用性能监控指标,确认错误率是否真的升高。
- 然后查找慢 Span 和错误 Span,查询错误日志看具体报错,判断报错是否集中在某个下游。
- 最后结合服务拓扑确认依赖关系,若服务运行在容器服务中,还会继续查看 Pod 重启、事件和容器日志。
命令清单
veops-cli 当前支持的命令如下,该命令列表主要帮助您理解 veops-cli 的能力边界。
说明
- 您无需记住这些 veops-cli 命令,Agent 将替您直接调用。
- 版本升级后,支持的命令可能存在出入,最终以运行时 schema --index 和 schema <product> 输出的命令清单为准。
针对托管 Prometheus 产品提供以下命令:
命令 | 功能 |
vmp.query | 即时 PromQL 查询 |
vmp.query-range | 区间 PromQL 查询 |
vmp.metric-names | 查询指标名 |
vmp.metric-labels | 查询指标标签 |
vmp.series | 查询时序 |
vmp.alert.rule-list | 查询告警规则列表 |
vmp.alert.rule-get | 查询告警规则详情 |
vmp.alert.history-list | 查询告警历史 |
vmp.workspace.list | 查询工作区列表 |
vmp.workspace.get | 查询工作区详情 |
vmp.workspace.instance-types | 查询工作区规格 |
针对应用性能监控产品提供以下命令:
命令 | 功能 |
apmplus-server.metrics.query-semantic | 查询语义指标 |
apmplus-server.metrics.list | 查询可用指标 |
apmplus-server.metrics.category-list | 查询指标分类 |
apmplus-server.metrics.filter-keys / apmplus-server.metrics.filter-values | 查询指标过滤维度和值 |
apmplus-server.trace.detail | 查询 Trace 详情 |
apmplus-server.trace.log | 查询 Trace 相关日志 |
apmplus-server.span.list | 查询 Span 列表 |
apmplus-server.log.list | 查询应用性能监控的日志 |
apmplus-server.service.list | 查询服务列表 |
apmplus-server.service.topo | 查询服务拓扑 |
apmplus-server.alert.rule-list | 查询告警规则 |
apmplus-server.alert.history-list | 查询告警历史明细 |
apmplus-server.alert.aggregated-history-list | 查询聚合告警历史 |
apmplus-server.notify-group.list | 查询通知组 |
apmplus-server.genai.session-list | 查询 GenAI 会话 |
针对云监控产品提供以下命令:
命令 | 功能 |
cm.namespace.list | 查询云监控命名空间 |
cm.metric.query | 查询云产品指标 |
cm.metric.docs-list | 查询指标文档 |
cm.resource.list | 查询资源元数据 |
cm.resource.filter-fields | 查询资源过滤字段 |
cm.alarm.list | 查询告警规则列表 |
cm.alarm.get | 按 ID 查询告警规则 |
cm.alarm.history-list | 查询告警历史 |
cm.event.list | 查询事件历史 |
cm.event.types-list | 查询事件类型和来源 |
针对日志服务产品提供以下命令:
命令 | 功能 |
tls.project.list | 查询日志项目 |
tls.topic.list | 查询日志主题 |
tls.topic.get | 查询 Topic 详情 |
tls.index.get | 查询索引配置 |
tls.search | 搜索日志 |
tls.histogram | 查询日志量直方图 |
针对容器服务产品提供以下命令:
命令 | 功能 |
vke.cluster.list | 查询集群列表 |
vke.cluster.get | 查询集群详情 |
vke.nodepool.list | 查询节点池列表 |
vke.nodepool.get | 查询节点池详情 |
vke.node.list | 查询节点列表 |
vke.addon.list | 查询集群插件 |
vke.addon.supported-list | 查询支持的插件列表 |
vke.kubeconfig.list | 查询 kubeconfig |
vke.ns.list | 查询 Kubernetes namespace |
vke.pod.list / vke.pod.get / vke.pod.logs | 查询 Pod 列表、详情和日志 |
vke.deployment.list / vke.deployment.get | 查询 Deployment |
vke.statefulset.list / vke.statefulset.get | 查询 StatefulSet |
vke.service.list / vke.service.get | 查询 Service |
vke.event.list | 查询 Kubernetes 事件 |
其他平台与辅助命令:
命令 | 功能 |
login | 控制台 OAuth 登录(写入临时 STS profile) |
login start / login finish | 两步式远程登录。Agent / SSH / 容器场景首选 |
logout | 清理登录状态 |
doctor | 体检凭证、配置和网络 |
schema --index | 查看全产品 operation 摘要 |
schema <product> | 查看产品级 JSON Schema bundle |
list [product] | 查看 read-only operation 清单 |
config show | 查看本地偏好配置 |
config set | 设置本地偏好配置 |
version | 查看 CLI 版本 |
update --check --json / update --yes | 检查和应用内置发布源更新 |
completion | 生成 Shell 补全脚本 |
能力说明
以下按排障中常用的能力维度展开,每个能力允许跨多个数据源协同使用。
Agent 支持通过 veops-cli 查询托管 Prometheus、应用性能监控和云监控的指标。
- 托管 Prometheus 和应用性能监控适合自定义业务和基础设施指标,Agent 可以先列举工作区,再根据指标名和标签构造 PromQL 做即时或范围查询。
- 云监控适合把应用层异常和 ECS、CLB、RDS、网络等云资源指标结合起来看,例如:ECS CPU 打满、磁盘 IO 抖动、CLB 后端异常都可能是接口变慢的表现。
目标 | 你能看到什么 |
判断服务是否异常 | 错误率、延迟、吞吐、可用性 |
分析资源瓶颈 | CPU、内存、磁盘、网络、实例维度指标 |
对比发布前后 | 指标是否突增、突降或趋势变差 |
定位异常时间点 | 开始异常的具体时间点(精确到分钟)、是否已经恢复 |
提问示例:
帮我看一下 service-a 最近 1 小时 P99 延迟有没有明显升高。
查一下 workspace xxx 中 service-a 最近 1 小时的 request_error_total 增速。
帮我查 i-xxx 这台 ECS 最近 2 小时 CPU、内存、网络是否异常。
Agent 支持查询日志服务和应用性能监控的日志,也能够查看日志上下文和日志量分布。
日志服务排查时,Agent 先确认 Project 和 Topic,再根据关键词或结构化条件检索,最后把大量日志归类成少量错误模式。
目标 | 你能看到什么 |
搜索错误日志 | error、exception、timeout、panic 等关键词 |
找代表样本 | 高频错误模式、典型堆栈、请求 ID |
看错误趋势 | 某类日志在时间上的分布(日志直方图) |
看上下文 | 某条错误日志前后的请求过程 |
提问示例:
搜 checkout-api 最近 30 分钟的 timeout、exception 日志,按错误类型归类。
看一下 topic xxx 最近 6 小时 error 日志的时间分布。
这个 request_id 帮我查一下前后文日志。
Agent 支持查询托管 Prometheus、应用性能监控和云监控的告警规则、告警历史和当前活跃告警。
目标 | 你能看到什么 |
了解告警为什么触发 | 规则表达式、阈值、级别、触发对象 |
还原告警时间线 | 开始时间、恢复时间、当前状态 |
查询影响范围 | 关联服务、实例、workspace 或云资源 |
辅助判断严重度 | P0/P1、是否持续触发、是否恢复 |
提问示例:
帮我排查这个 VMP 告警 rule-xxx,看看触发原因和是否已经恢复。
帮我列一下当前 P0 活跃告警,并按影响范围排序。
查一下这个 CLB 相关资源最近有没有云监控告警。
应用性能监控是应用排障的主线,Agent 可以查询服务列表、服务指标、Trace 详情、Span 列表和服务拓扑。
- 对于普通服务问题,通常先查错误率、延迟、QPS,再下钻到 Trace 和 Span。
- 应用性能监控还支持覆盖 GenAI 会话场景,对接入大模型能力的业务分析很有帮助,例如:某个 AI 助手响应变慢或失败率升高时,Agent 可以通过会话和链路数据判断是模型调用慢、下游工具慢,还是业务服务本身异常。
目标 | 你能看到什么 |
定位慢请求 | 慢 Span、耗时最高的调用环节 |
分析错误链路 | 哪个节点报错、错误是否来自下游 |
查看依赖关系 | 上游、下游、调用方向和影响范围 |
分析 AI 应用链路 | GenAI 会话失败原因,模型调用、工具调用还是业务异常 |
验证根因 | 指标、日志和链路是否指向同一个依赖 |
提问示例:
这个 trace-id 帮我看一下慢在哪里,是否是下游依赖导致的。
把 service-a 最近 30 分钟的错误 Span 按下游服务归类。
帮我看最近 1 小时智能助手的失败 session,分析是模型、工具还是业务异常。
排查容器问题时,Agent 可以从集群健康逐层下钻到具体 Pod 日志。容器服务覆盖两层能力:
- 一层是 VKE OpenAPI 原生信息,例如:集群、节点池、节点、插件、Kubeconfig 元信息,
- 另一层是只读 Kubernetes API 透传,例如:Namespace、Pod、Deployment、StatefulSet、Service、Event 和 Pod 日志。
说明
- 容器服务集群内查询时使用只读透传通道,不需要把 Kubernetes API Server 暴露到公网,也不需要本地配置 kubeconfig。
- 权限跟随账号,若返回 403,通常意味着当前账号缺少对应集群的 Kubernetes 访问权限,并非网络不通。
目标 | 你能看到什么 |
集群巡检 | 集群状态、节点池状态、插件状态 |
节点排查 | 节点和实例关系、节点池归属 |
工作负载与事件 | Pod / Deployment / StatefulSet / Service 状态、重启、Warning Event |
容器日志 | 异常 Pod 的容器日志 |
提问示例:
帮我检查 ccvke-xxx 集群的节点池、节点和插件状态。
列出 default namespace 下最近重启过的 Pod,并查看相关事件。
看一下 kube-system 中异常 Pod 的日志和最近事件。
典型场景
VeOps CLI 的使用方式并非“查一个接口返回一段 JSON”,而是围绕排障任务组织多次查询。典型场景如下:
场景一:告警排查
触发告警时,最重要的是快速搞清楚三个问题:为什么触发、影响多大、目前是否已经恢复。
使用 VeOps CLI 后,直接把告警规则 ID、告警名称或大致时间告诉 AI。AI 会查询告警规则、告警历史、相关指标、日志和服务信息,还原完整时间线。
说明
排障路径对比:
- 以前:打开告警页看规则,再打开指标页看曲线,再去日志平台找报错,最后手动写结论。
- 现在:AI 直接输出触发原因、指标变化、日志样本、影响对象和建议动作。
帮我排查这个告警 rule-xxx:
- 时间范围:今天 10:00 到 11:00
- 关联服务:order-api
请说明触发原因、影响范围、是否恢复,以及下一步建议。
场景二:接口变慢
接口变慢通常并非单点问题,可能是自身代码慢、下游依赖慢、数据库慢、资源不足,也可能是某次发布引入了新逻辑。单看指标只能知道“慢了”,很难知道“慢在哪”。
使用 VeOps CLI 后,VeOps CLI 可以让 AI 同时使用应用性能监控指标、Trace、Span、服务拓扑和日志,先确认延迟升高的时间窗口,再找慢 Trace,按 Span 耗时排序,最后判断慢点是否集中在某个下游。
checkout-api 最近 2 小时 P99 明显升高。
请帮我定位慢在哪一层,是否和下游服务或发布有关。
场景三:发布后验证
发布后最常见的问题是“看起来没报错,但到底有没有变差”。人工验证时,工程师通常会对比发布前后的错误率、延迟、QPS、资源指标和日志。
使用 VeOps CLI 后,AI 可以把发布前后的关键指标放到一起比较,如果发现错误率升高或延迟变差,再继续下钻日志和 Trace。最终输出不只是“有变化”,而是“哪些指标变差、幅度多大、是否有代表性错误、建议继续观察还是回滚”。
帮我做一次发布复盘:
- 服务:payment-api
- 发布时间:20:00
- 对比窗口:发布前后各 30 分钟
- 关注:错误率、P99、QPS、CPU、错误日志
请判断发布后是否有劣化。
场景四:云资源异常定位
很多应用问题最终会落到资源层,CPU 突然打满、磁盘空间不足、网络包量异常、CLB 后端不健康,都可能表现为业务接口超时。
使用 VeOps CLI 后,可以通过云监控查询云资源指标、云监控告警和事件,再和应用性能监控的服务异常合并在一起分析。
order-api 从 14:00 开始超时增多。
帮我同时看 APMPlus 指标、错误日志,以及关联 ECS 的 CPU、内存、网络指标。
场景五:VKE 集群巡检
集群巡检通常涉及很多对象,例如:集群、节点池、节点、插件、namespace、Pod、Deployment、Event、Pod 日志,人工逐个检查很耗时,也容易遗漏。
使用 VeOps CLI 后,可以输出一份结构化巡检报告,包括:哪些节点 NotReady,哪些 Pod CrashLoopBackOff,哪些事件集中在镜像拉取失败,哪些 Deployment 副本数不满足预期。
帮我巡检 ccvke-xxx 集群:
- 看节点池、节点、插件状态
- 找出异常 Pod 和最近重启的 Pod
- 汇总 namespace 下的 Warning Event
- 对异常项给出处理建议
场景六:AI 应用可观测排查
如果业务已经接入大模型或 Agent 能力,排障对象不再只是普通 HTTP 接口,还可能包括模型调用、工具调用、长链路会话和多轮对话。应用性能监控的 GenAI 会话能力可以帮助分析 AI 应用链路,让 VeOps CLI 不只适合传统微服务,也适合正在接入 AI 能力的业务系统。
帮我看最近 1 小时智能助手的失败 session。
请分析是模型调用失败、工具调用失败,还是业务服务返回异常。
最近更新时间:2026.07.08 11:25:02
这个页面对您有帮助吗?
有用
有用
无用
无用