全栈可观测平台
全栈可观测平台


文档指南

请输入


- 文档首页
 全栈可观测平台实践与教程解决方案重新定义 AI 时代的全景全栈观测
 复制全文
 下载 pdf
重新定义 AI 时代的全景全栈观测
 文档反馈
 问问助手
AI 原生时代面临应用逻辑从确定性转向概率性、系统架构从单体演进为“智能体+推理引擎”的分布式协作等共性难题,传统应用监控方法论已然力不从心。如何让 AI 应用的运行状态透明化?如何快速定位智能应用的性能瓶颈?全栈可观测平台推出的 AI 场景监控,提供从代码到模型的全链路监控,为 AI 时代的观测挑战给出了答案。本文为您详细介绍全栈可观测平台的 AI 场景监控服务如何重新定义 AI 时代的全景全栈观测。
观测挑战
人工智能浪潮席卷千行百业的今天,大语言模型(LLM)正以前所未有的深度重塑应用架构,然而,这种技术变革也带来了新的运维挑战。现代 AI 应用,尤其是基于 LLM 的应用,其内部结构日益复杂,往往由多个业务服务、AI 框架和模型调用链交织而成,形成了一个难以捉摸的“黑盒”。开发者和运维团队面临着前所未有的观测挑战:
智能应用的“不可预测性”
- 大模型推理结果的随机性让传统的确定性监控失效。
- Token 消耗波动、推理延迟抖动、会话上下文丢失等问题频发。
- 智能体决策链路复杂,问题溯源如同在迷宫中寻路。
多层架构的“可见性盲区”
- 从用户输入到智能体决策,再到模型推理,链路跨越多个系统边界。
- LangChain、OpenAI SDK、MCP 协议等框架调用深度嵌套,调用关系错综复杂。
- 推理引擎(SGLang、vLLM、Dynamo)内部状态不透明,性能瓶颈难以定位。
运维成本的“指数级增长”
- 传统 APM 工具无法理解 AI 应用的语义,只能提供基础的 HTTP/RPC 监控。
- 手动埋点成本高昂,且难以覆盖快速迭代的 AI 框架。
- 问题排查需要跨越业务逻辑、框架调用、模型推理三个层面,效率低下。
解决方案
全栈可观测平台推出的 AI 场景监控,将 Metrics、Trace、Log 三大监控指标进行深度整合,聚焦破解 AI 应用“黑盒”难题,提供从代码到模型的全链路监控。不仅能够监控 QPS、延迟、错误率等传统指标,而且更聚焦 Token 消耗、TPOT、TTFT 等 AI 特有指标,实现一体化监控,重塑 AI 应用观测体验:
AI 监控看板
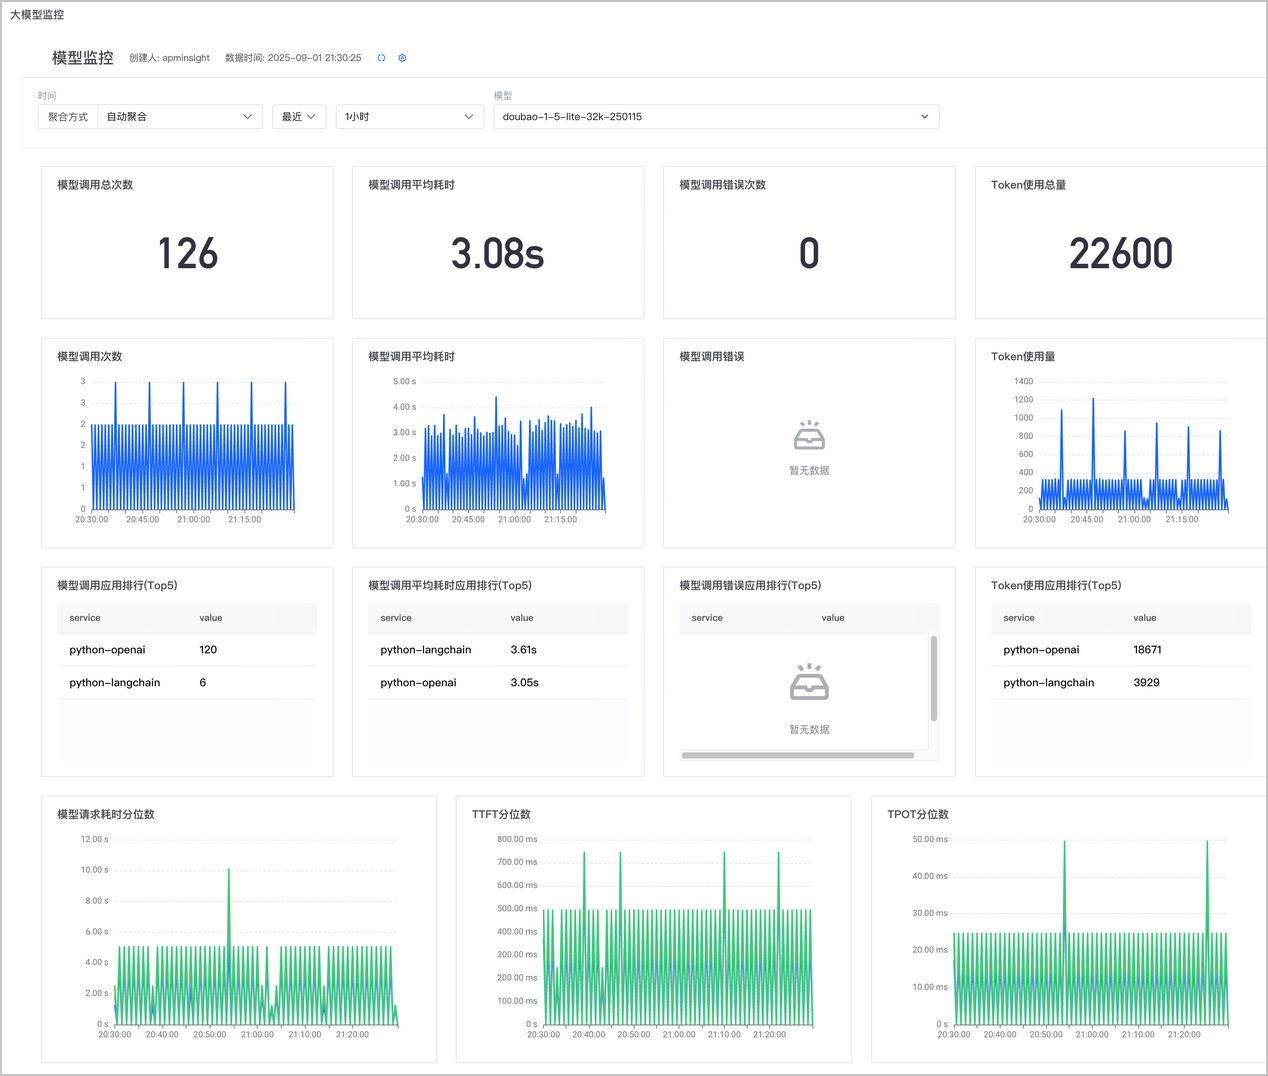
- 模型视角:前往 AI 场景监控的监控看板页面,选择查询时间和模型信息,即可查看当前模型的监控信息,例如:监控模型调用次数、耗时、Token 使用排行等信息,方便对该模型进行性能监控。
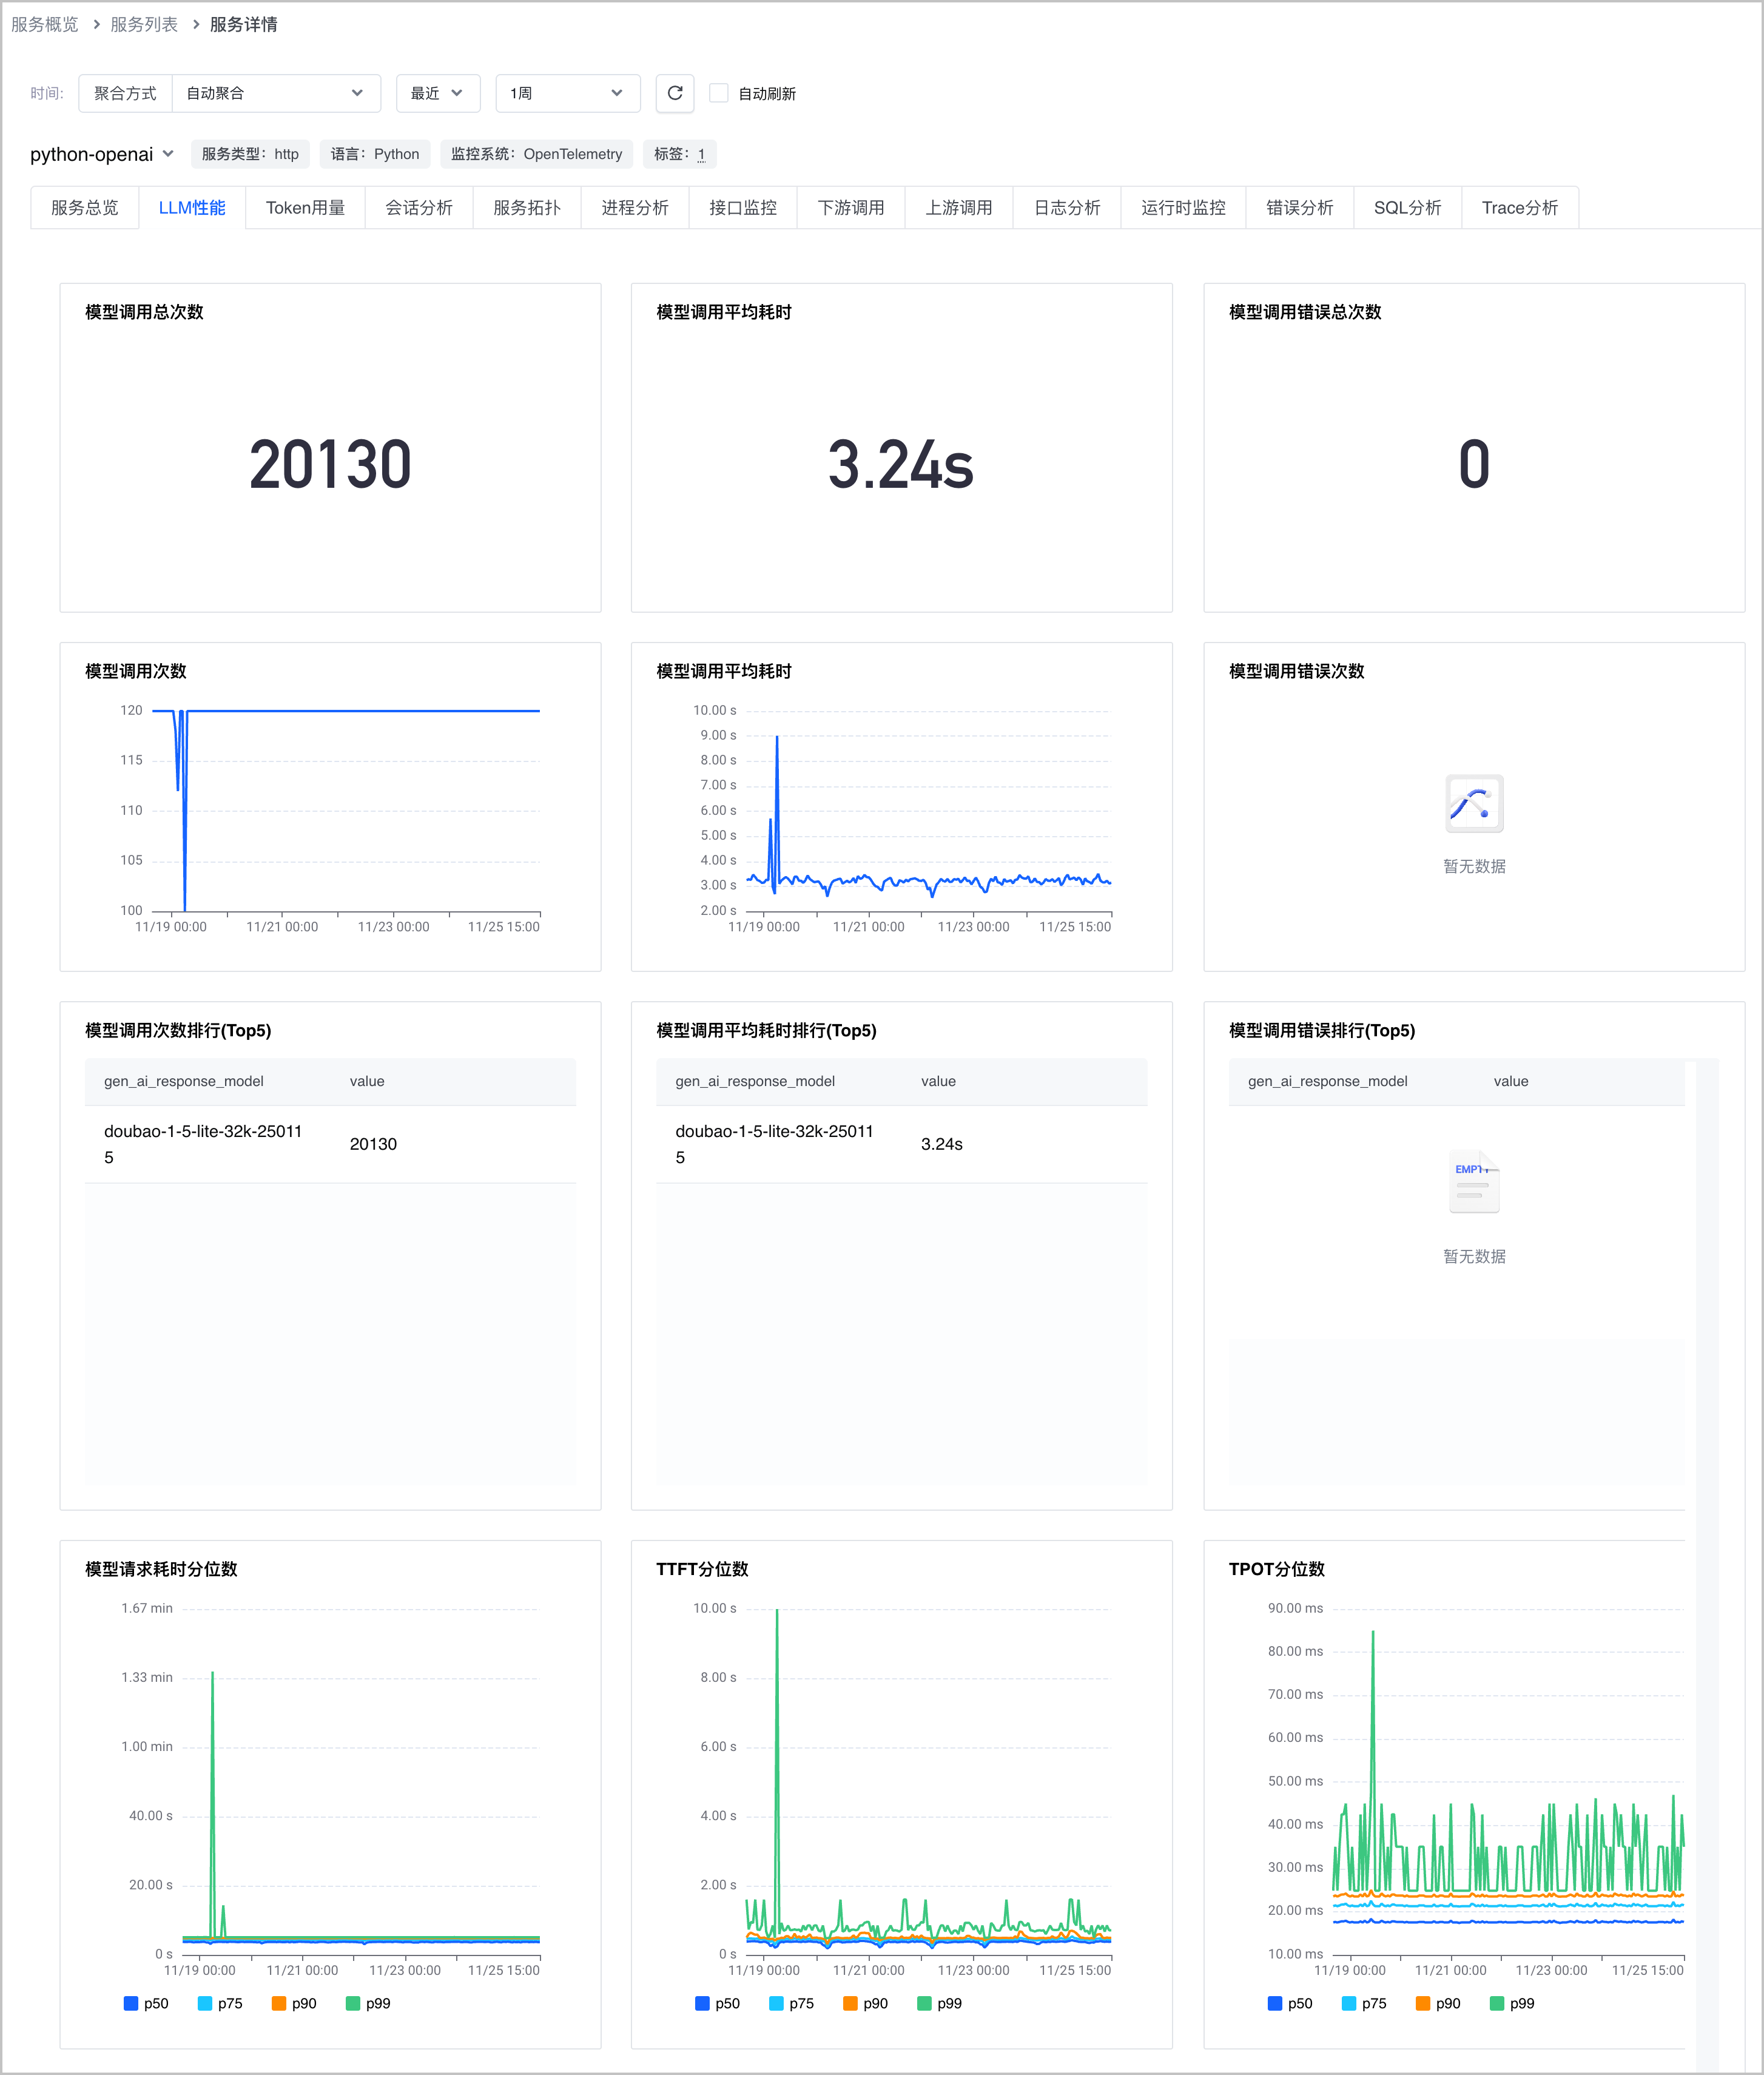
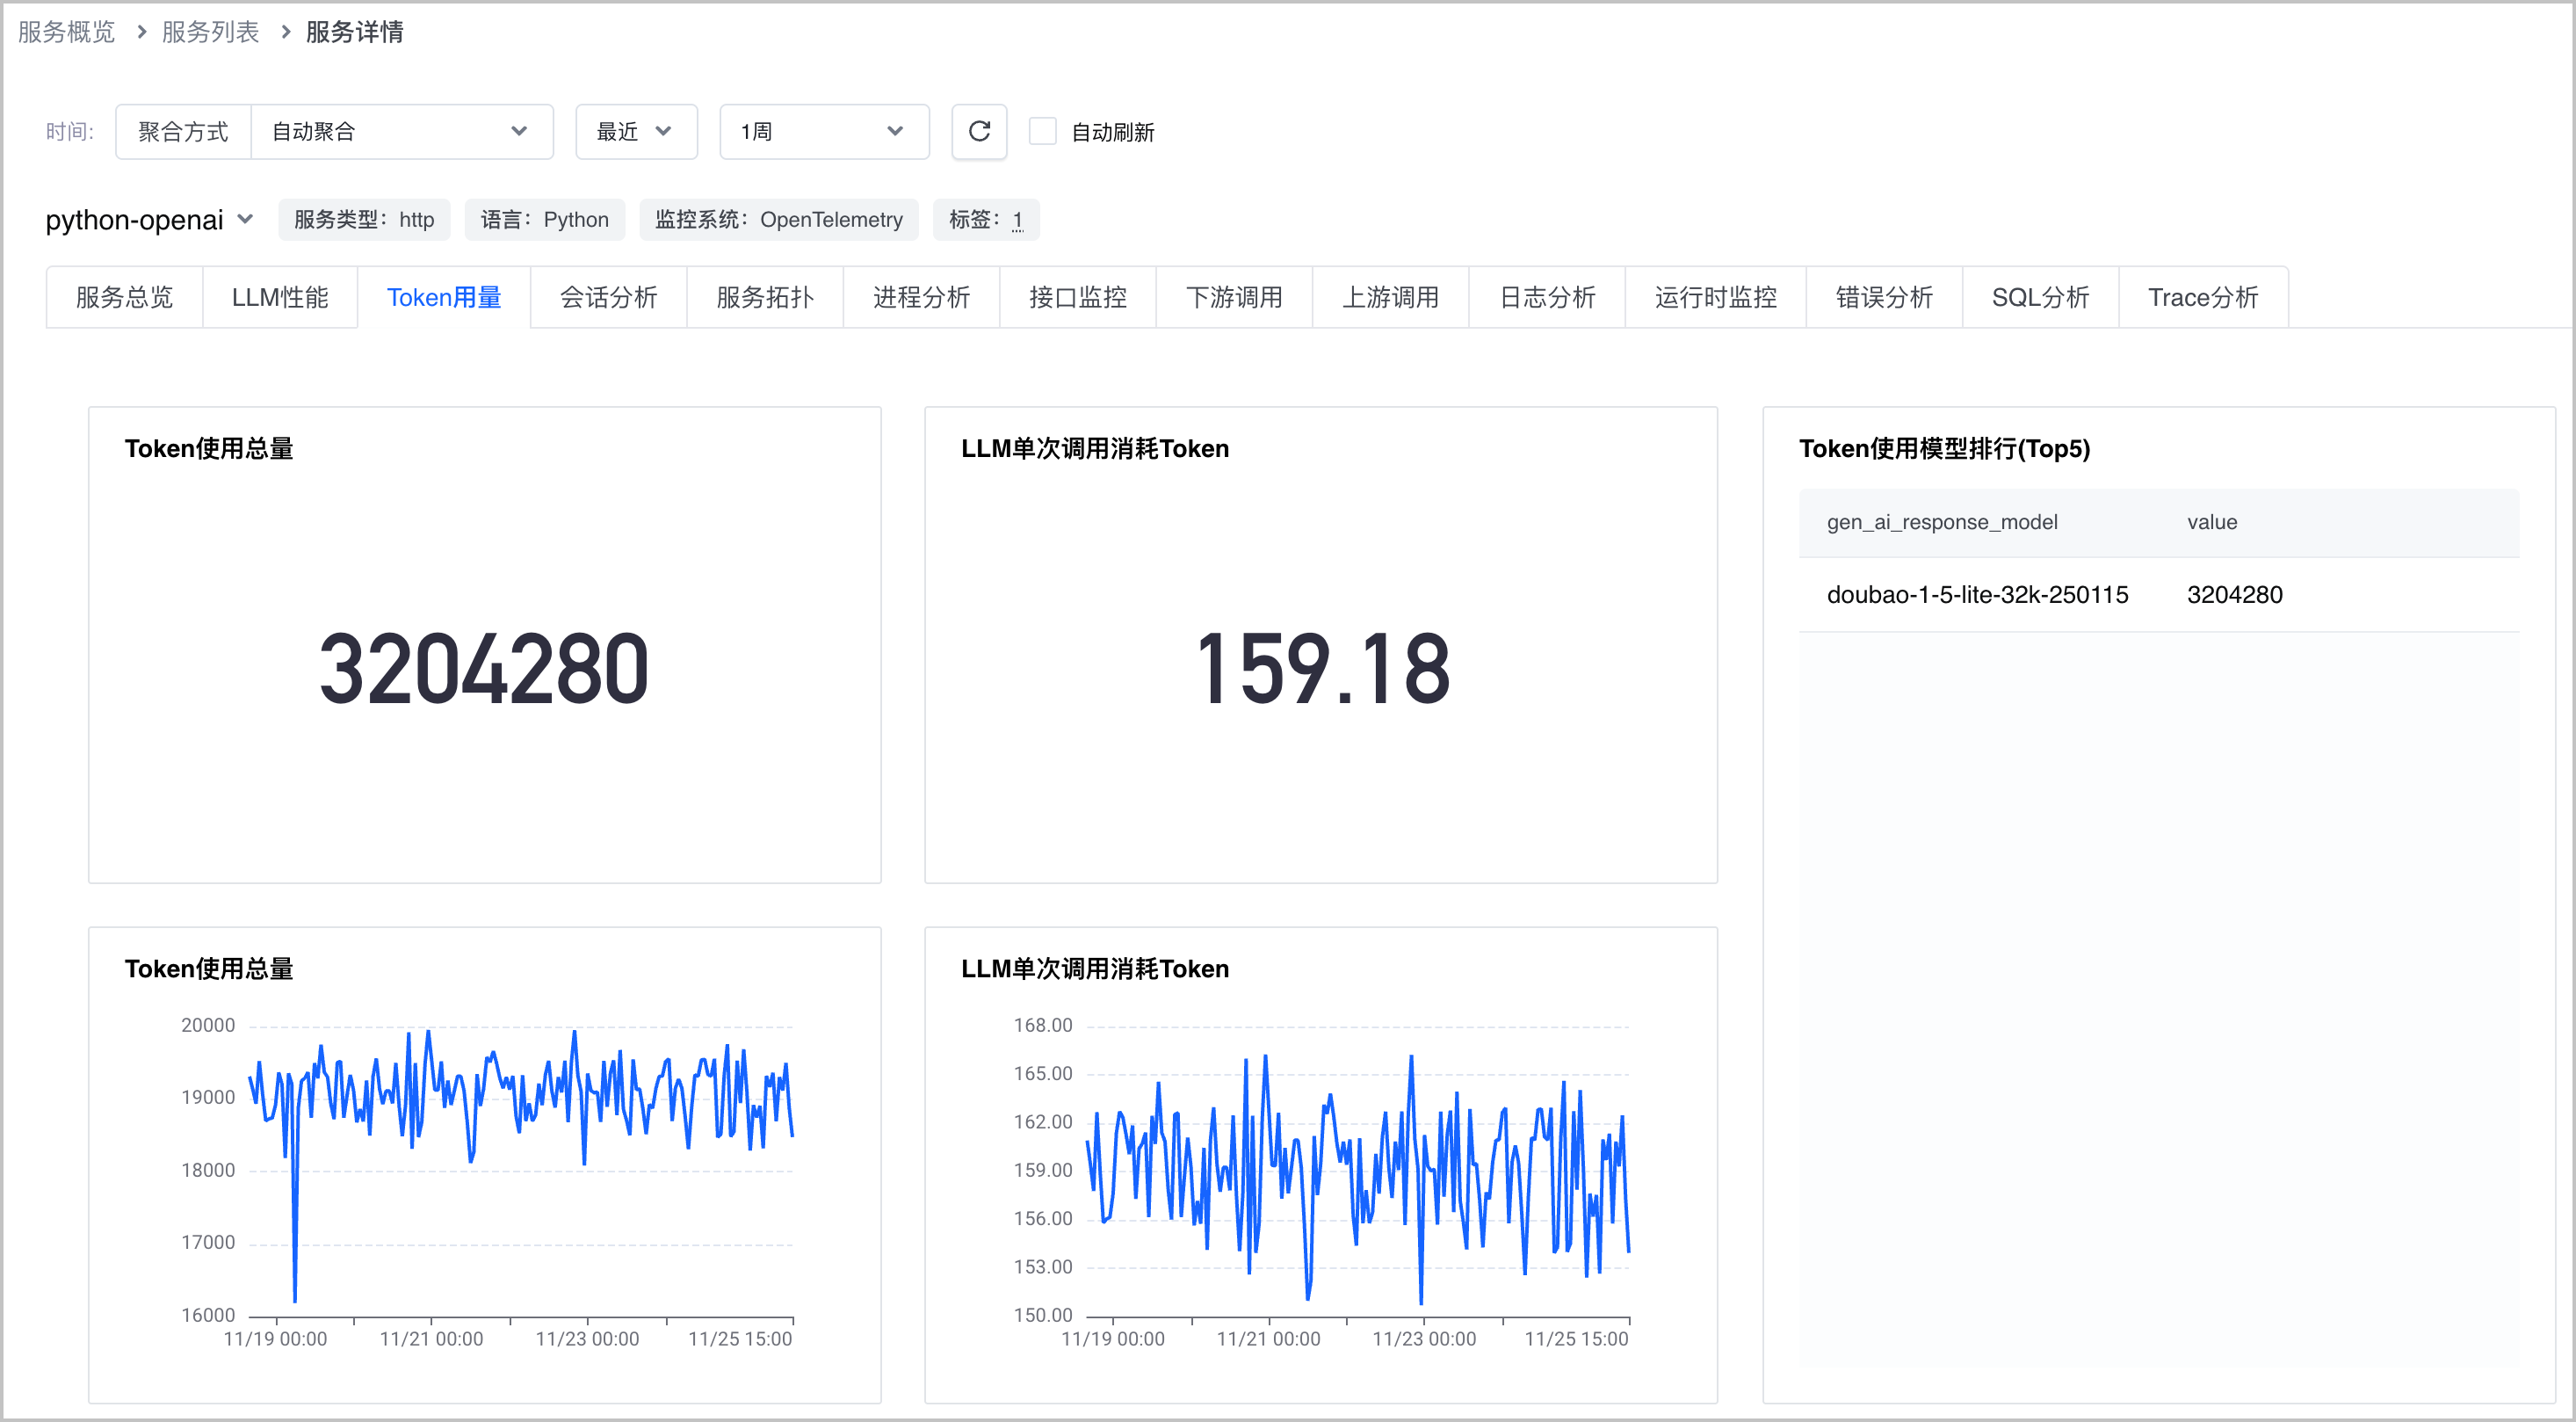
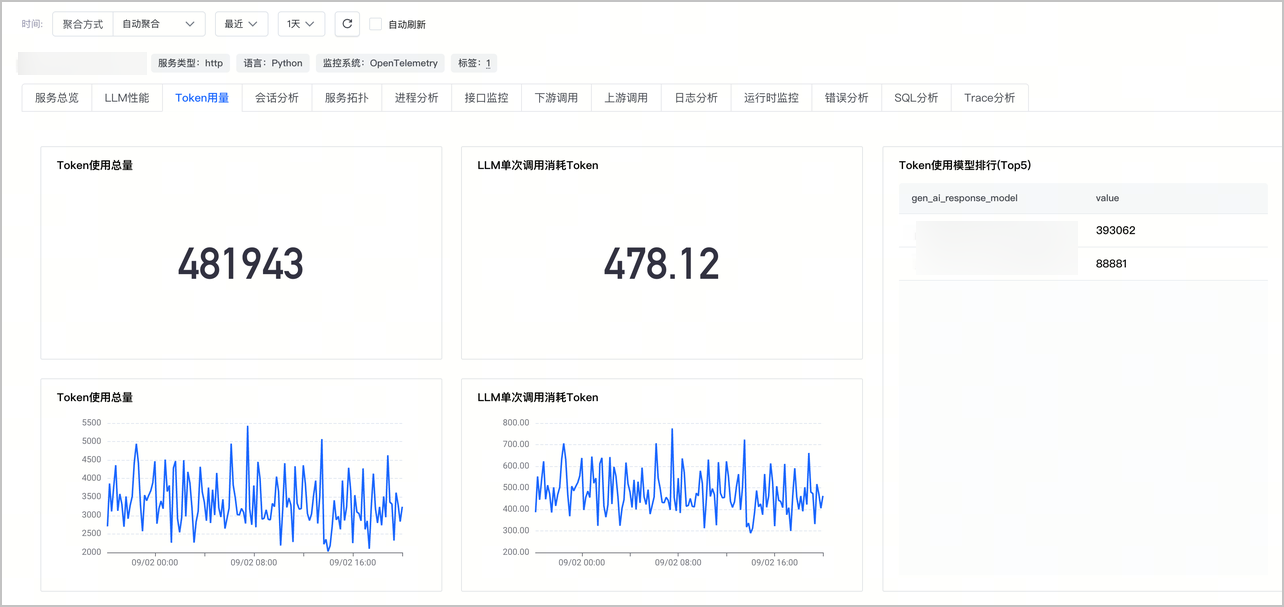
- 服务视角:前往指定 AI 服务详情页面,可查看 LLM 性能和 Token 用量看板。其中,LLM 性能看板主要用于展示该服务使用的所有的模型的整体性能信息,例如:模型调用耗时、TTFT、TPOT、模型调用次数排行等信息。Token 用量看板用于展示当前服务的 Token 消耗量,例如:Token 使用总量、单次模型调用Token 消耗量等信息。
AI Trace 分析
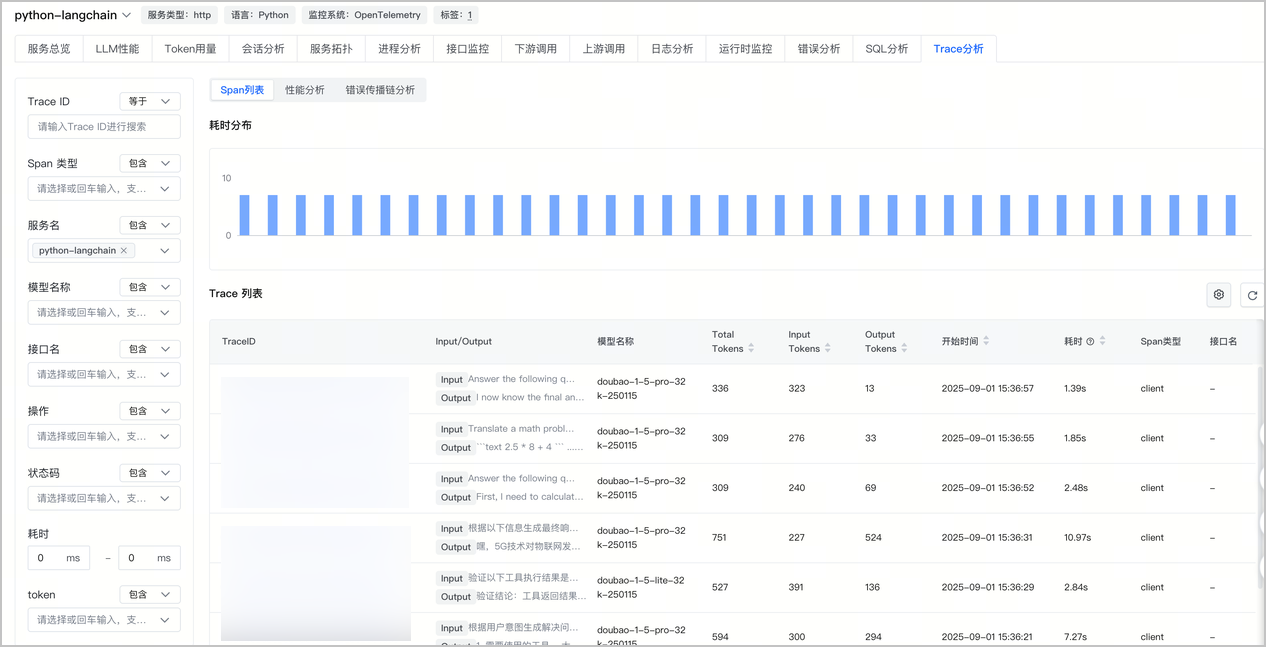
- AI Trace 列表查询:前往 Trace 分析页面,可直观查看调用 Trace 和 Span 信息,包括:使用的模型、输入输出、Token 消耗等信息。同时,支持针对这些信息进行筛选和排序。
- 查看单链路详情:单击目标 Trace ID,可深入查看对应链路的详细信息,包括:调用列表、服务拓扑图、火焰图、Span 详情,精准定位性能瓶颈。
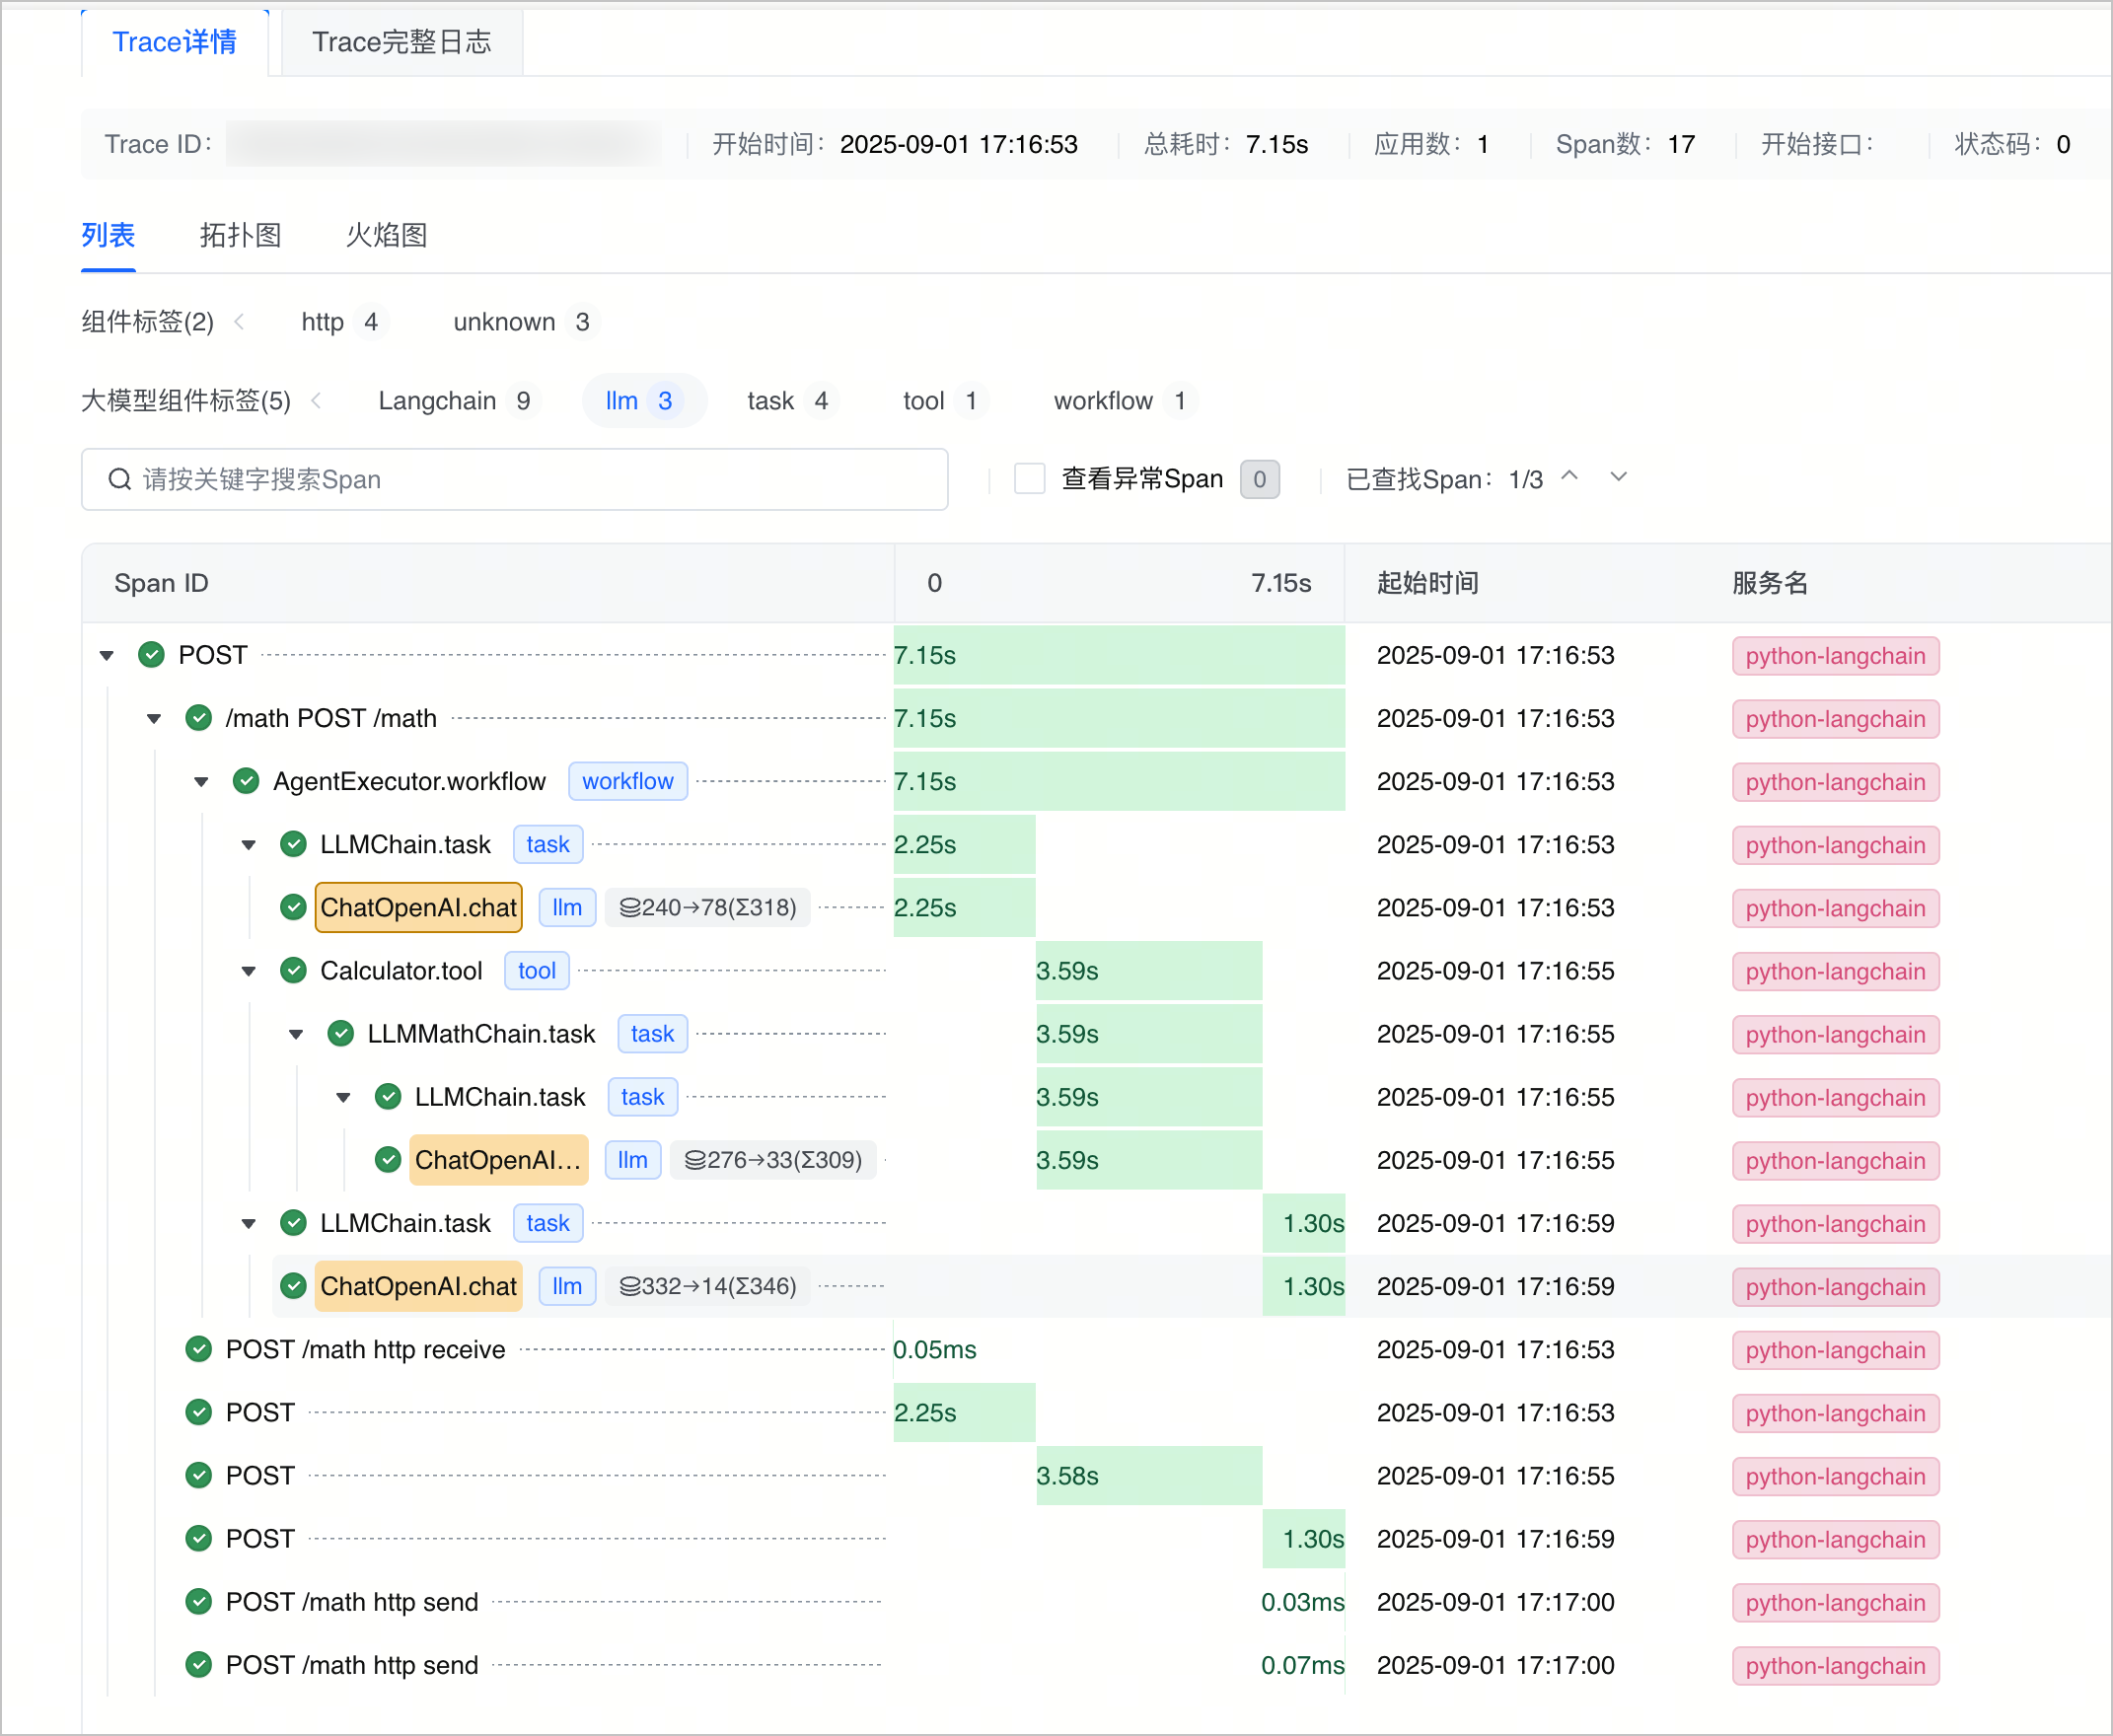
- 调用列表以列表形式呈现链路的调用详情,同时支持根据组件标签等筛选并高亮 Span,便于逐步分析。除此之外,能够标记 AI Trace 和 Span 的调用类型(例如:tool, task, llm 等),展示大模型调用的 Token 消耗等信息。
-
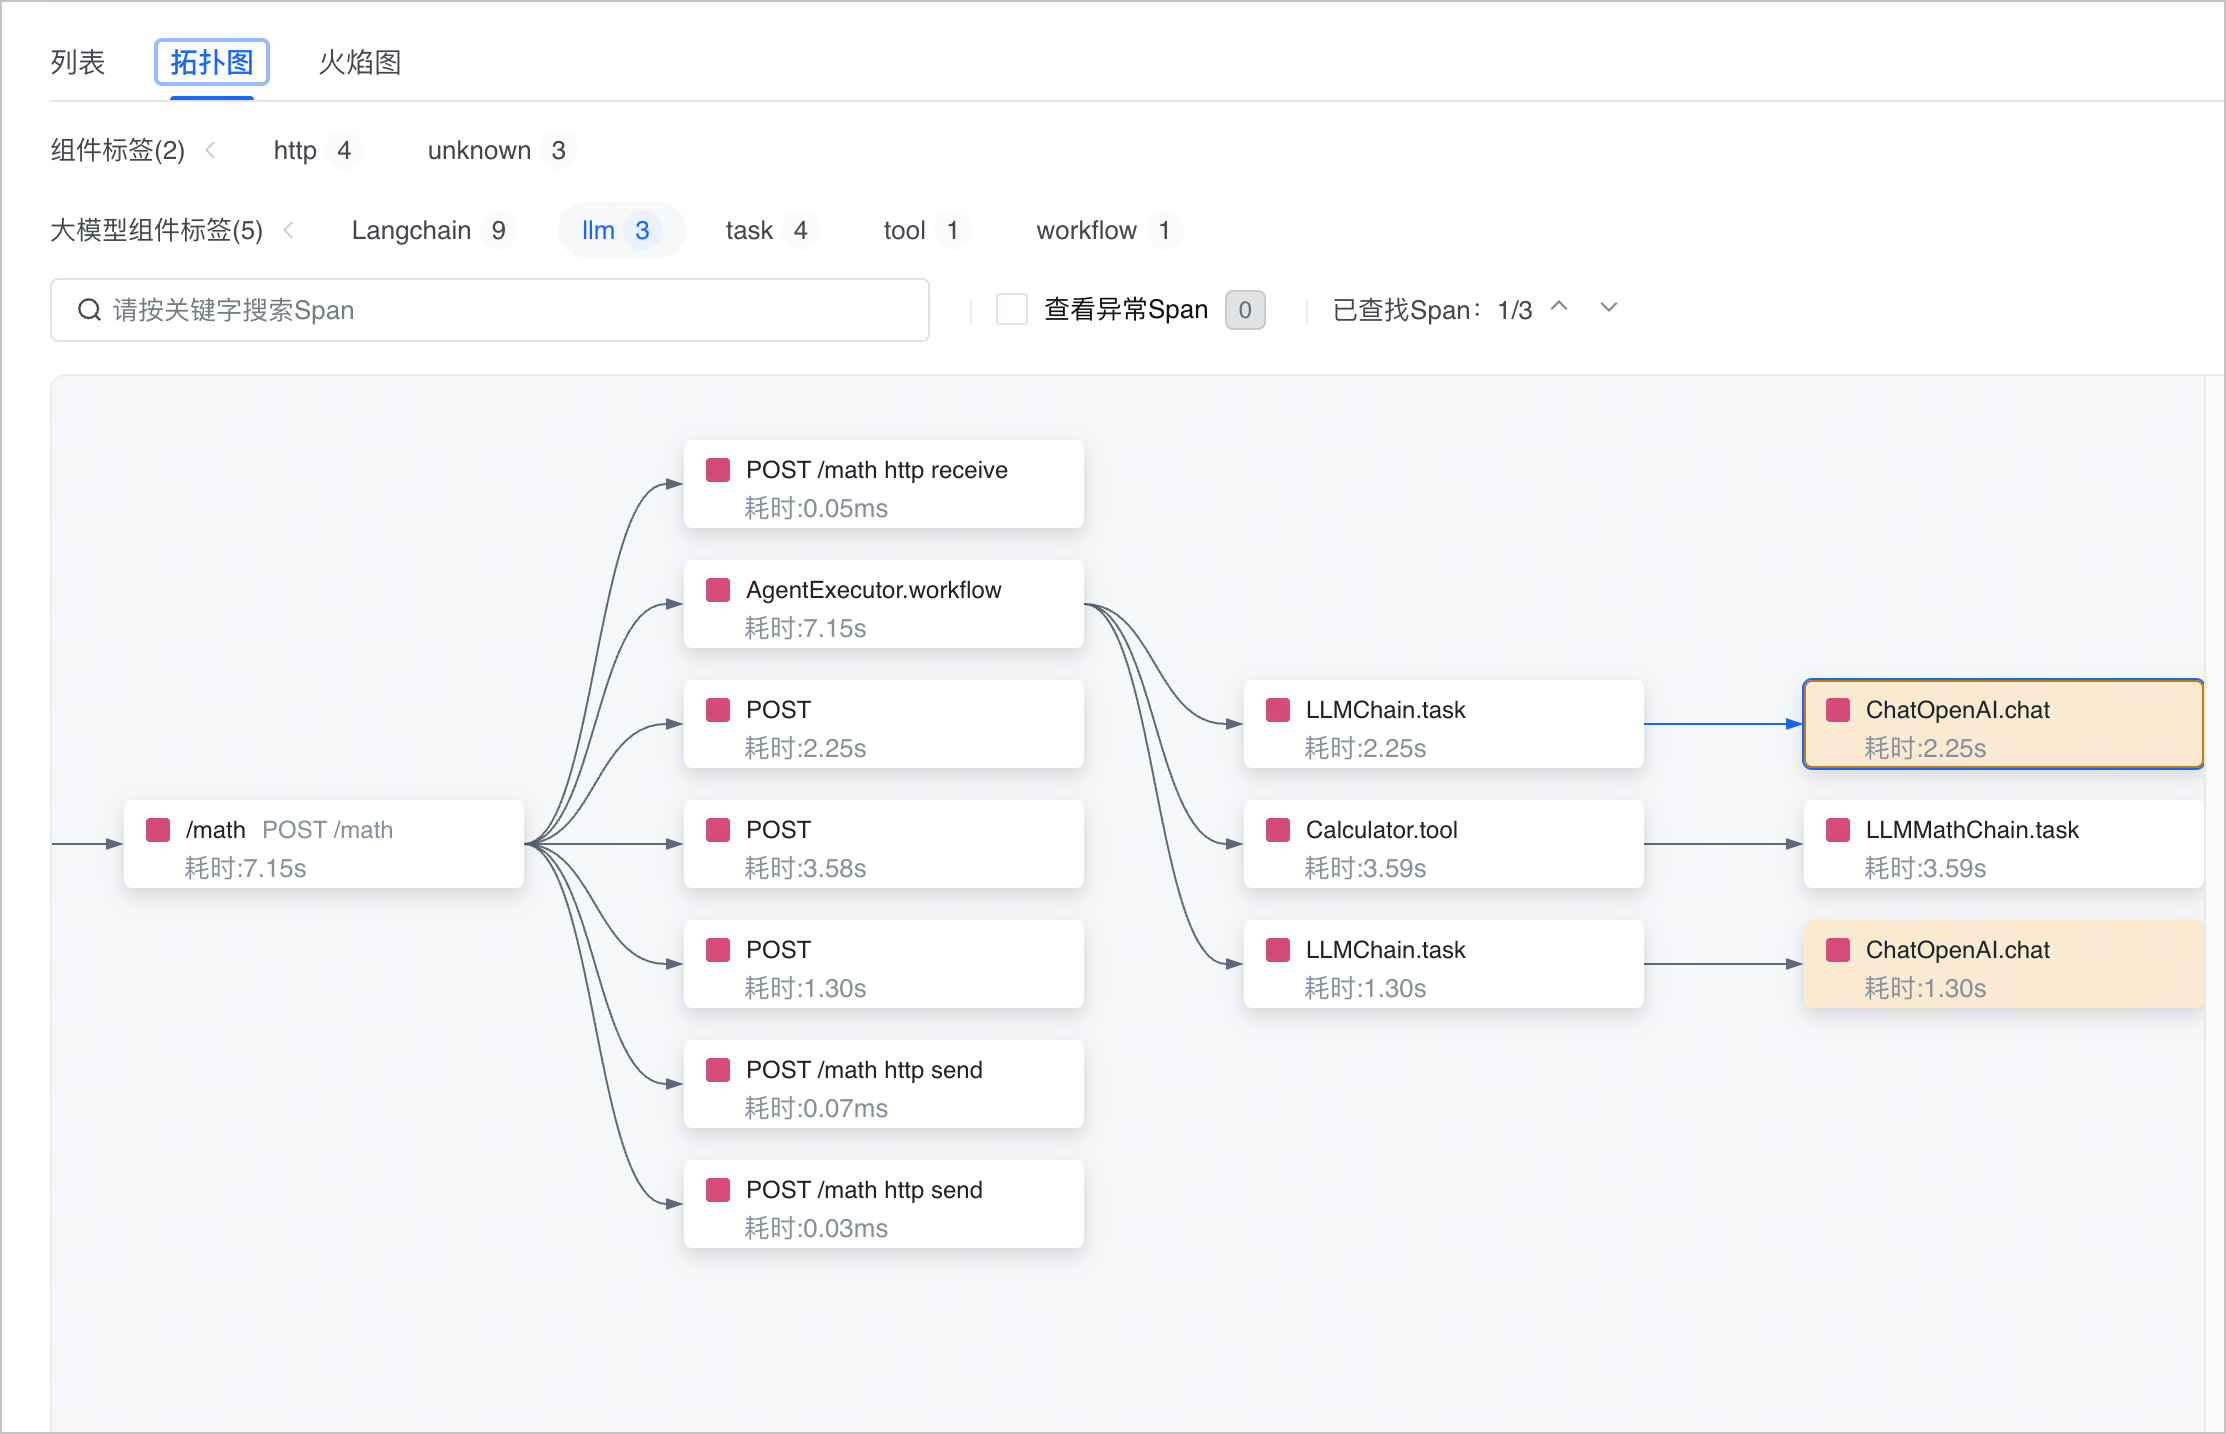
- 服务拓扑图支持清晰展示链路上下游调用关系和执行流程,帮助理解 AI 规划的执行。
-
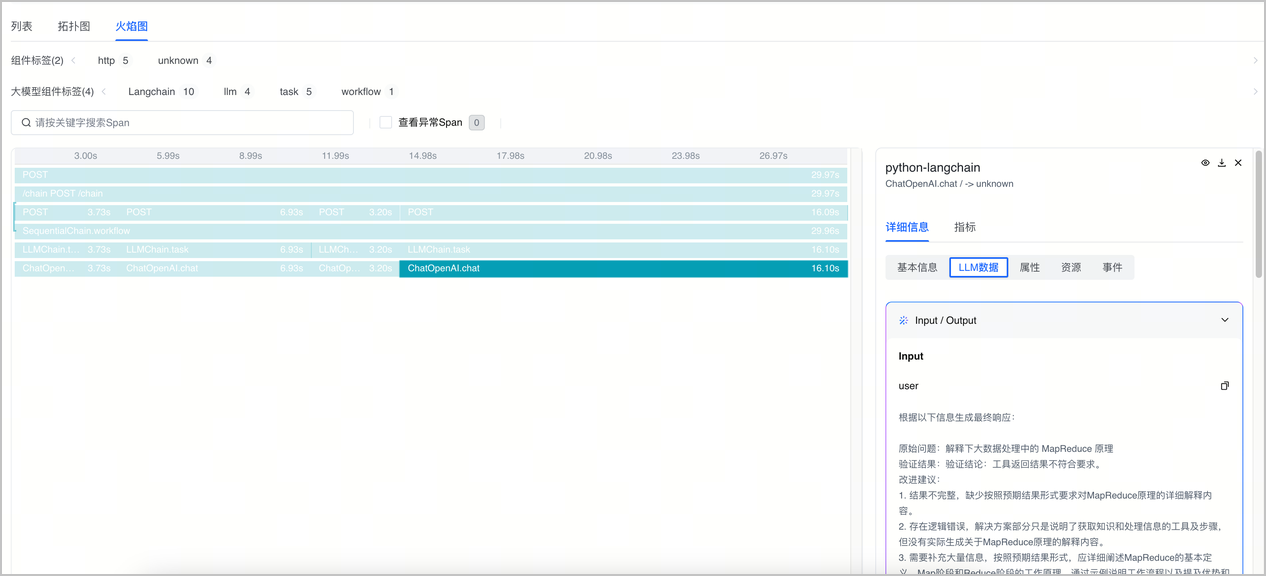
- 火焰图直观展示链路的性能热点,帮助快速定位耗时流程,判断应用性能瓶颈。
-
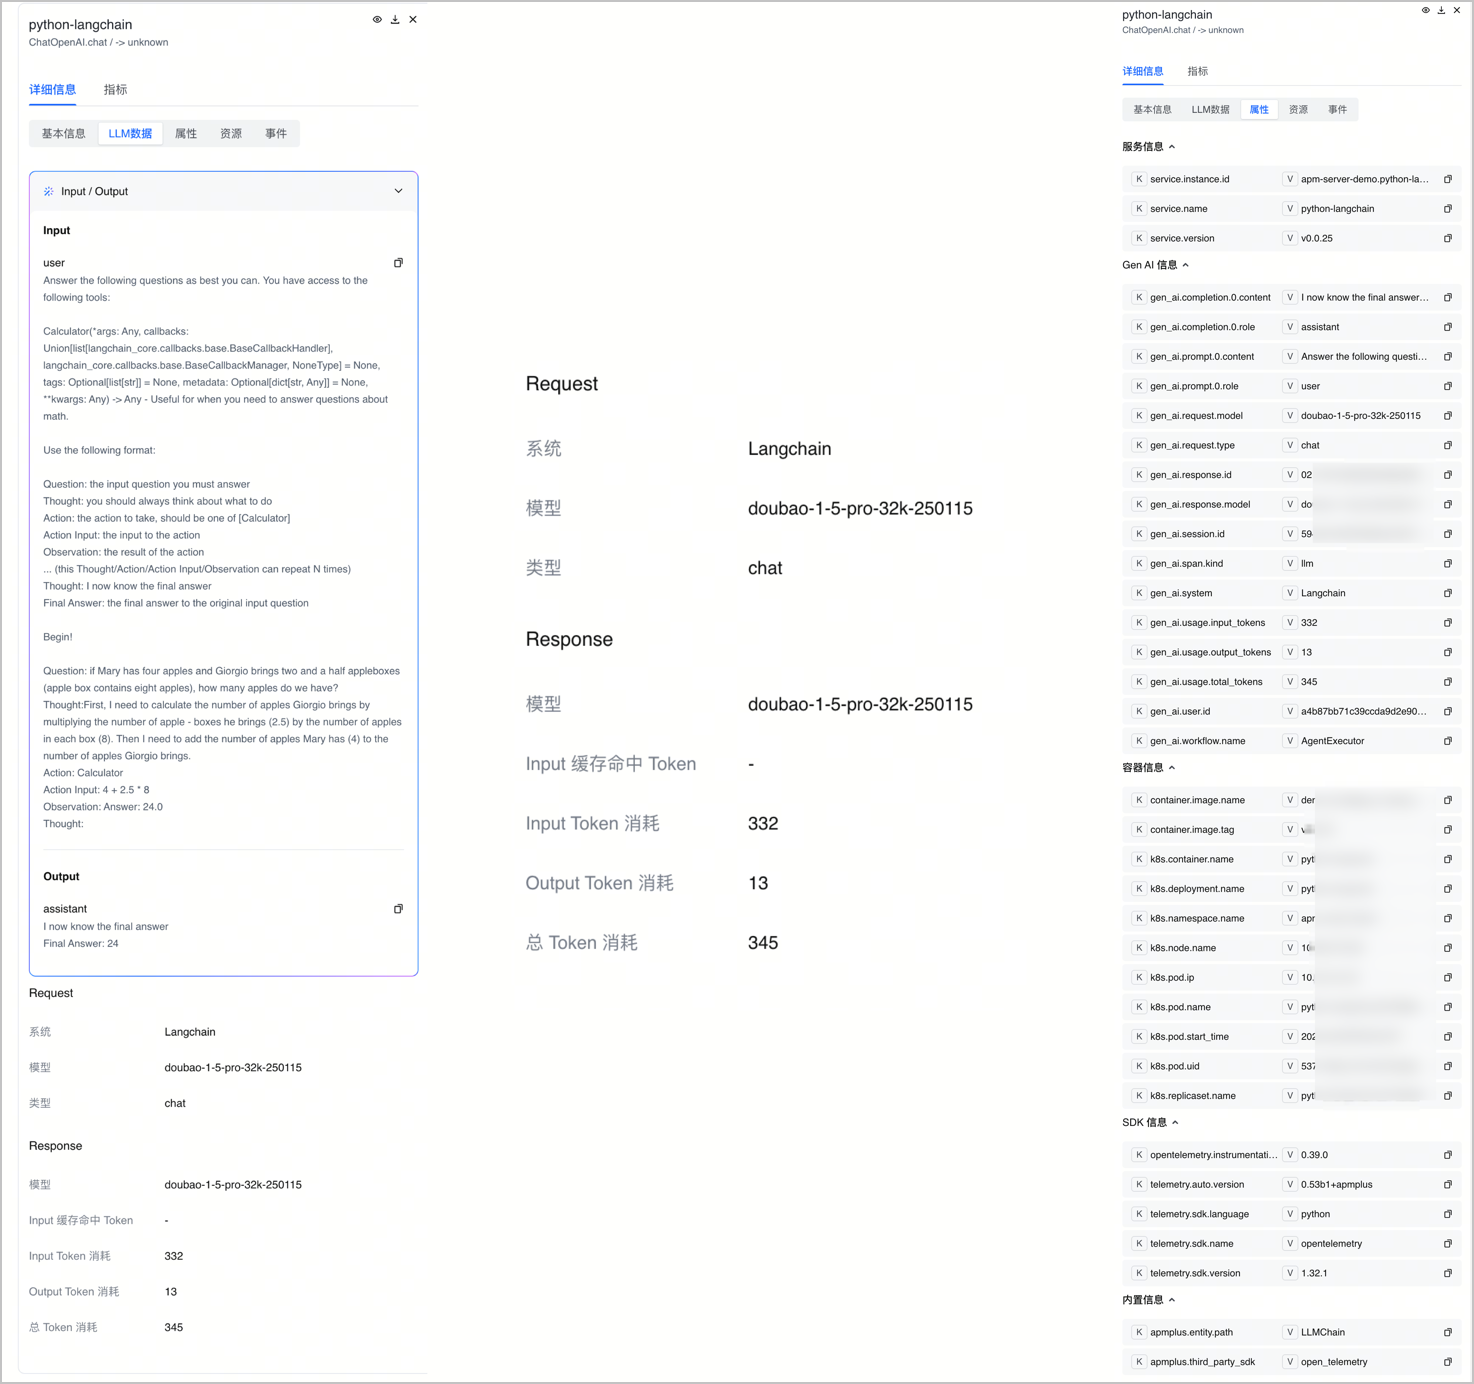
- Span 详情支持查看具体 Span 的详细信息,例如:AI 流程的输入输出、调用的 model、消耗 Token 数等。
-
MTL 一体化关联
打破数据孤岛,实现 Metrics、Trace、Log 联动查询。例如:日志关联 TraceID、Trace 反向查询日志、Span 关联实时指标。
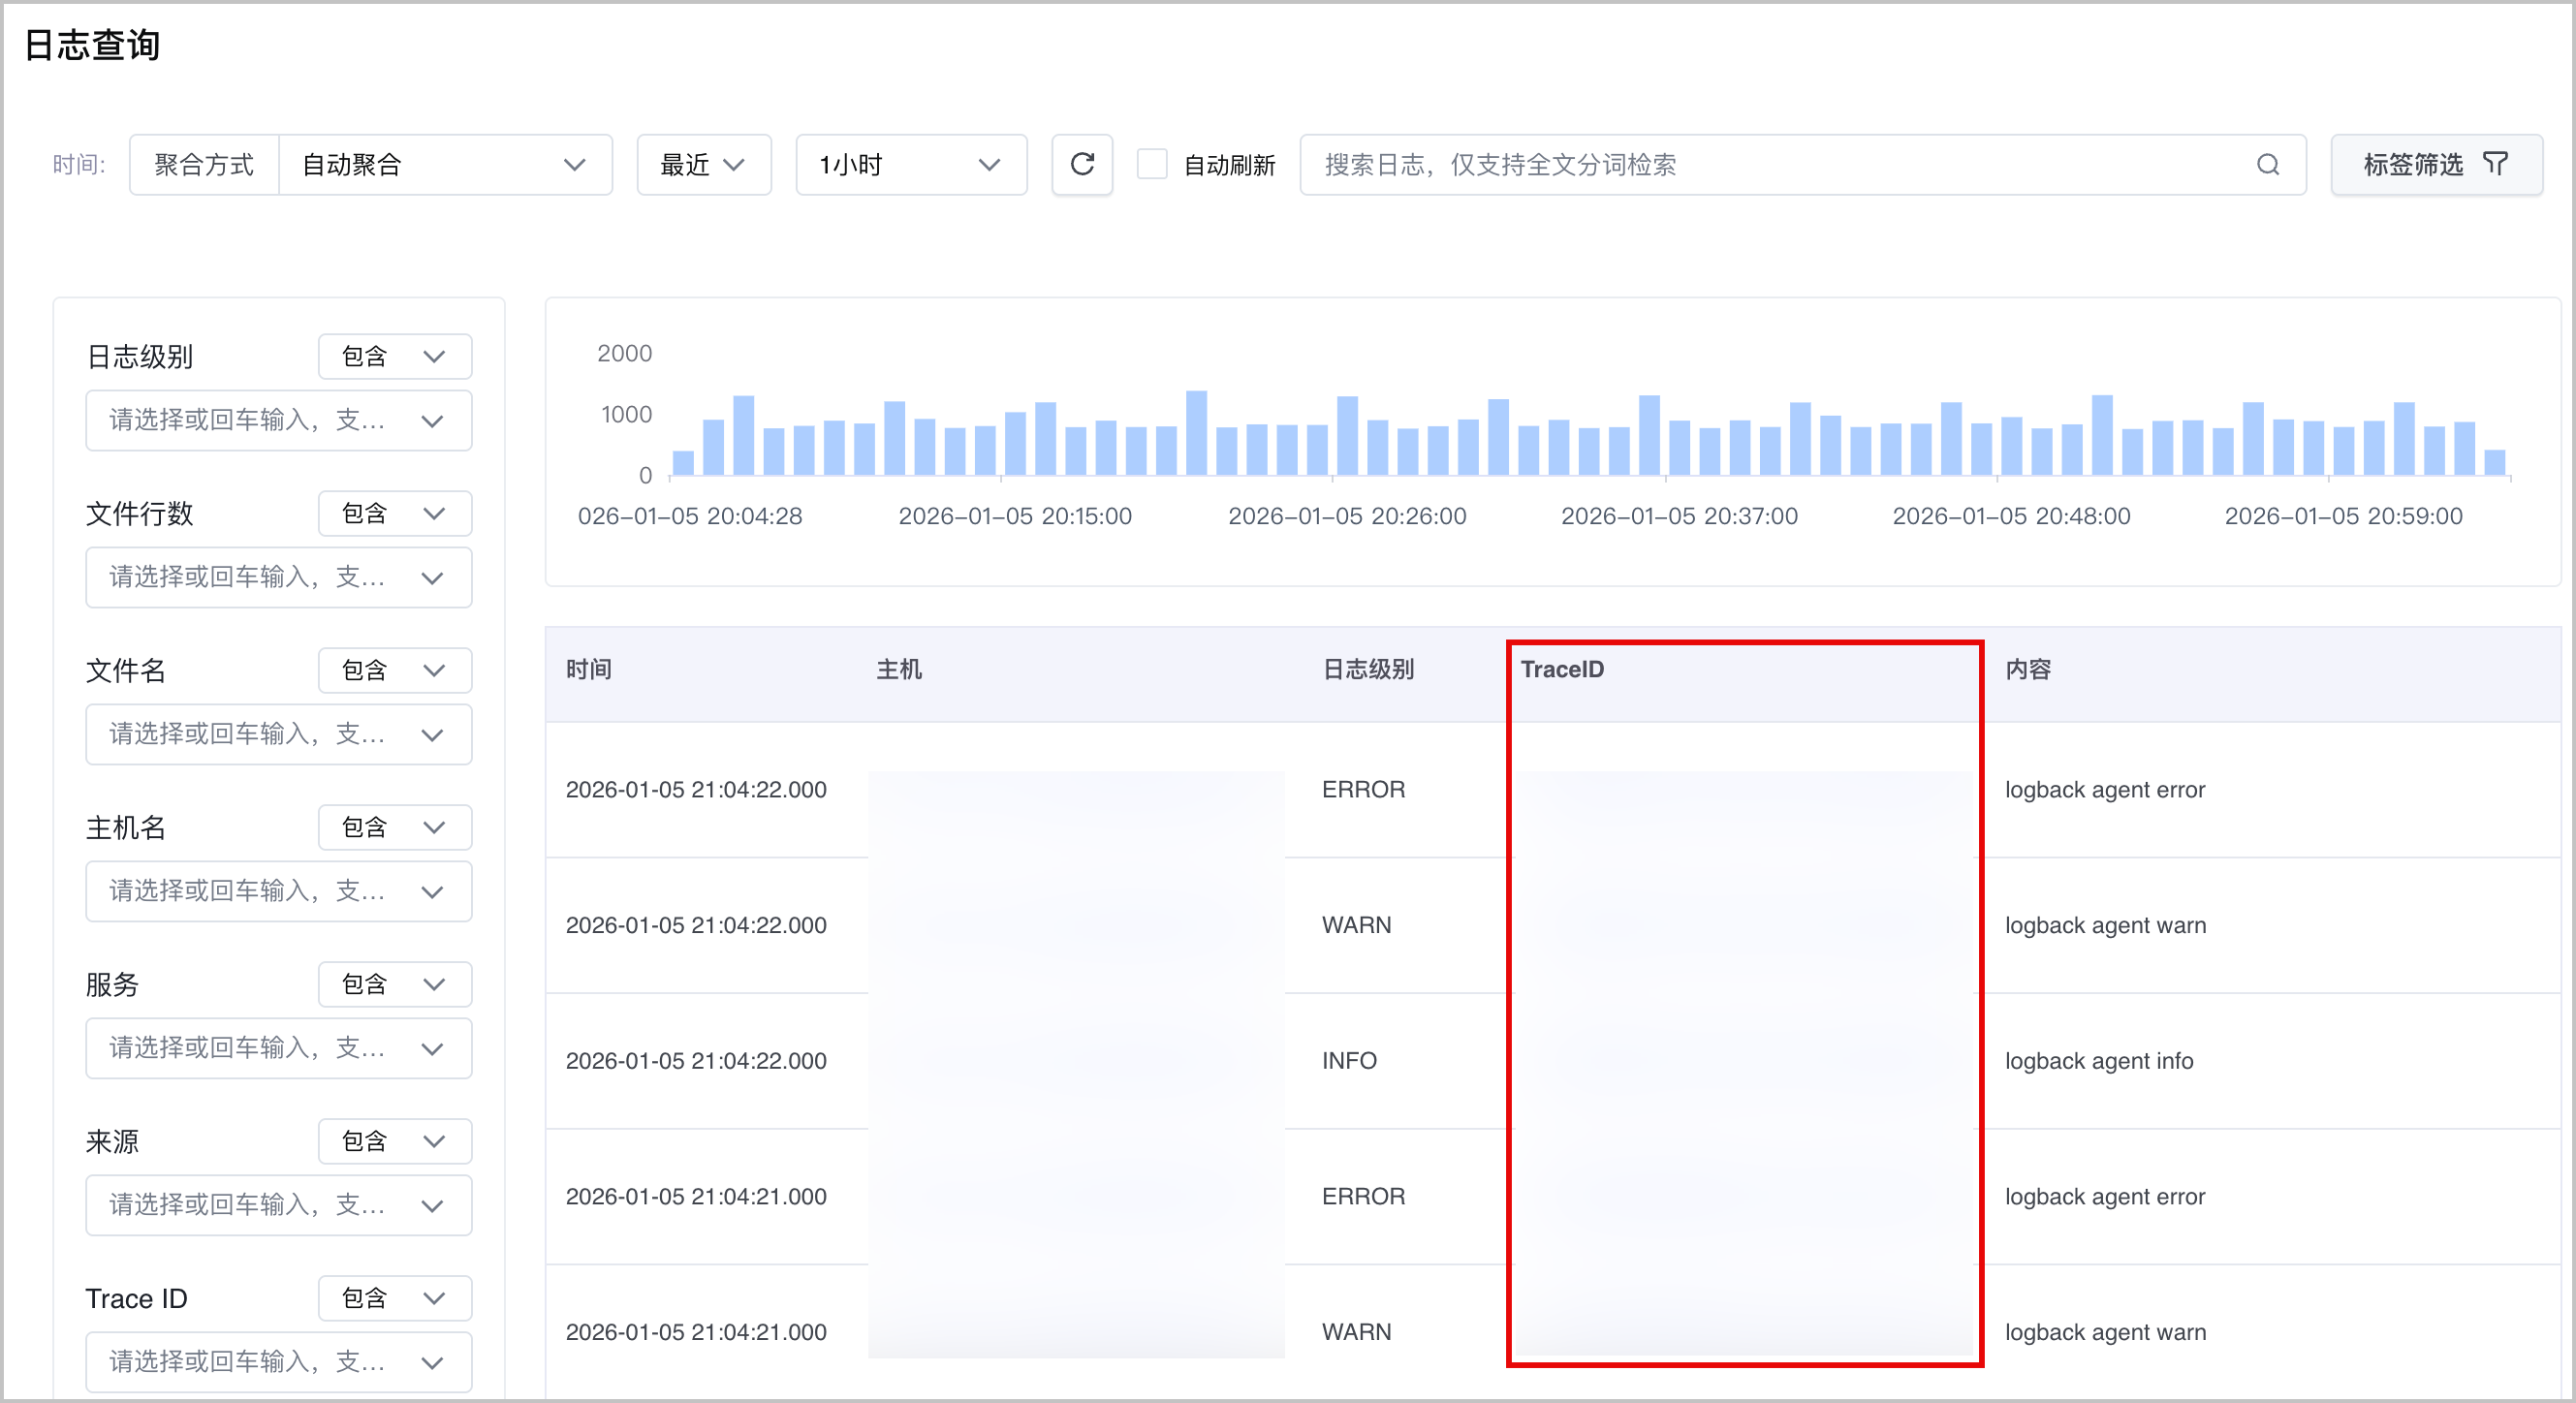
- 前往日志查询页面,查看日志信息的同时,能展示当前日志所关联的 Trace ID,并支持单击跳转查看 Trace 详情。
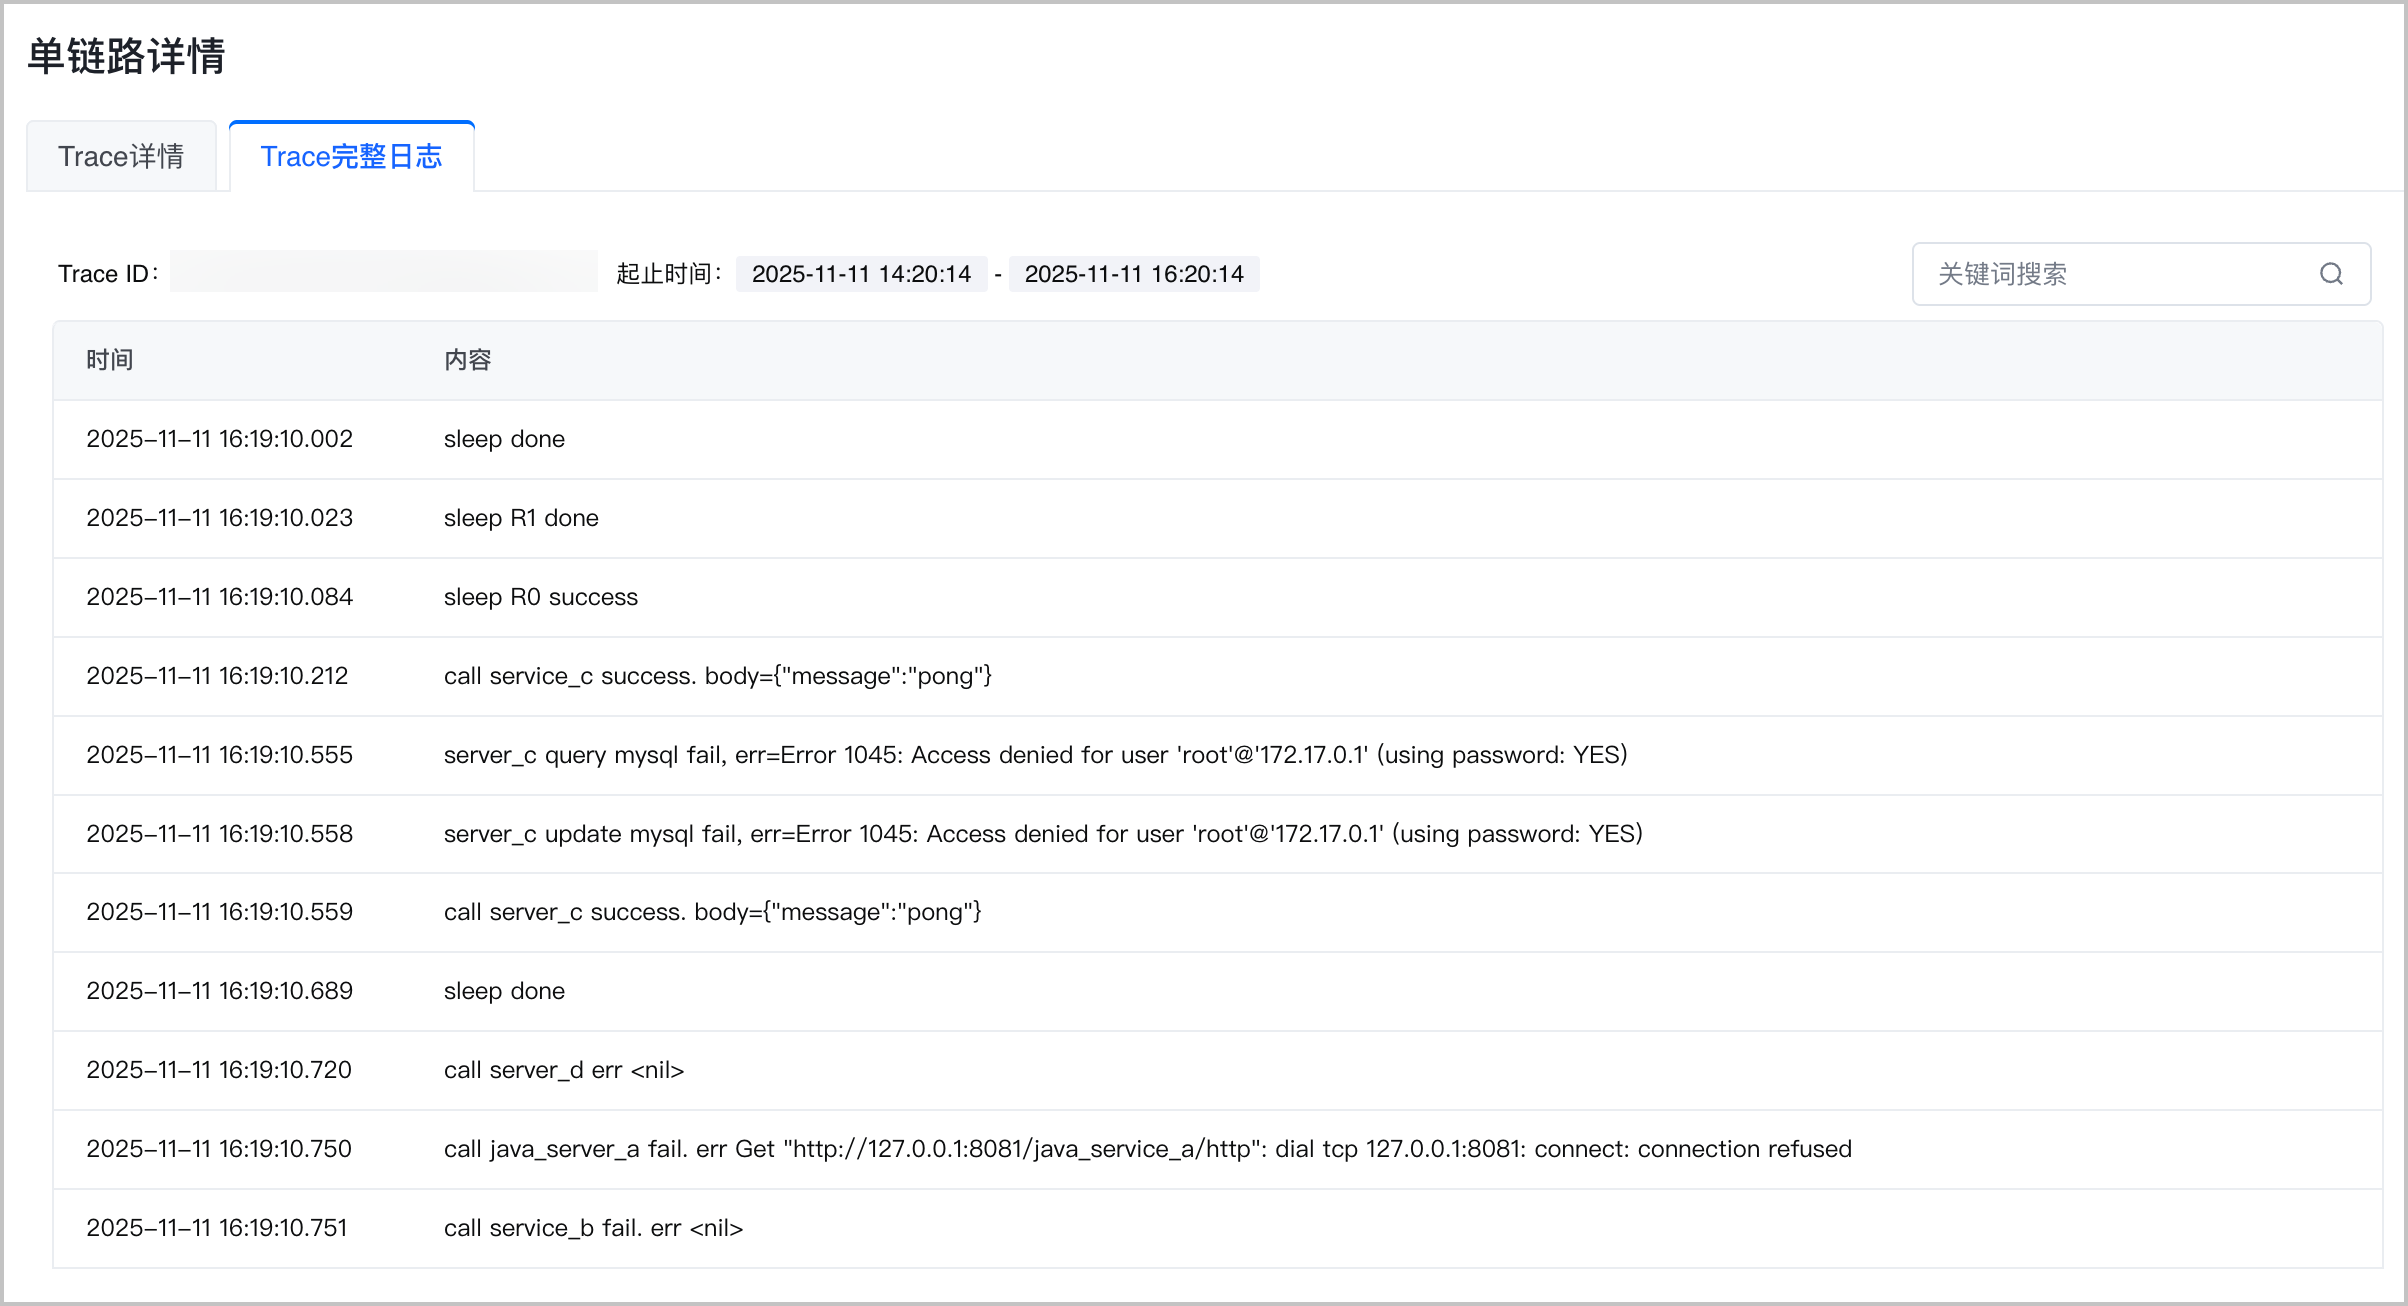
- 前往 Trace 分析页面,亦可直接查询当前 Trace 执行期间产生的日志。
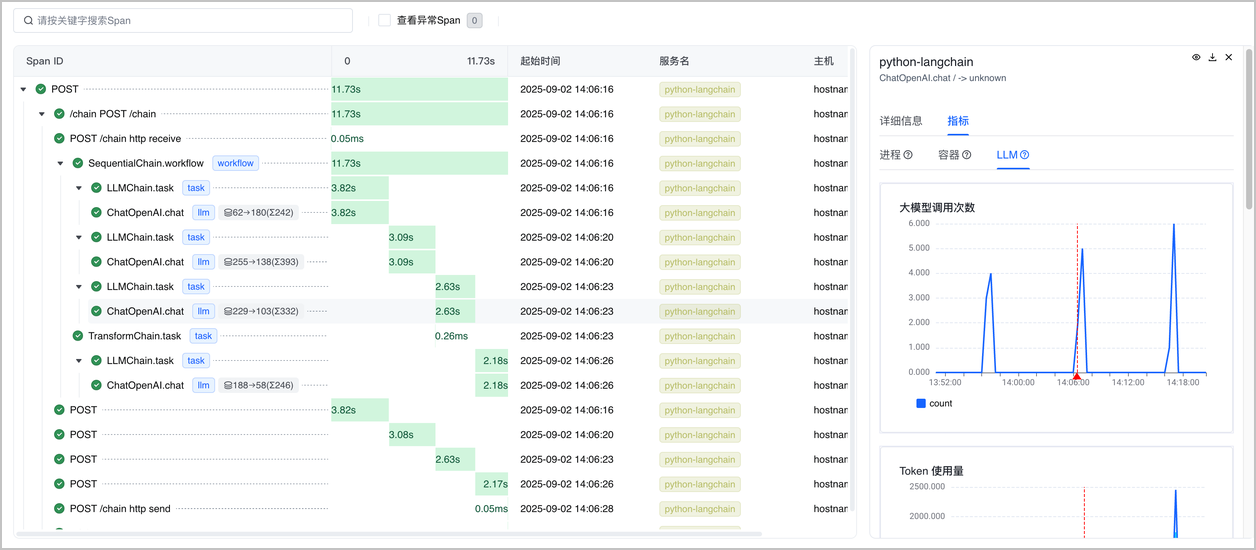
- 前往 AI Trace 分析的 Span 详情,能够定位到当前请求关联的大模型指标,并使用虚线标记相对应的时间。
AI 端到端全链路观测
完整支持从用户终端到 AI&中间件的端到端全链路打通,完整链路包括:用户终端(例如:Android/iOS/Web/小程序) -> 接入网关(例如:API 网关/Ingress/Nginx 等) -> 后端服务(例如:Java/Go/Python 等) -> 智能体(例如:LangChain、OpenAI、Eino 等)-> 大模型推理引擎(例如:SGlang, vLLM 等),实现真正的端到端可观测性。
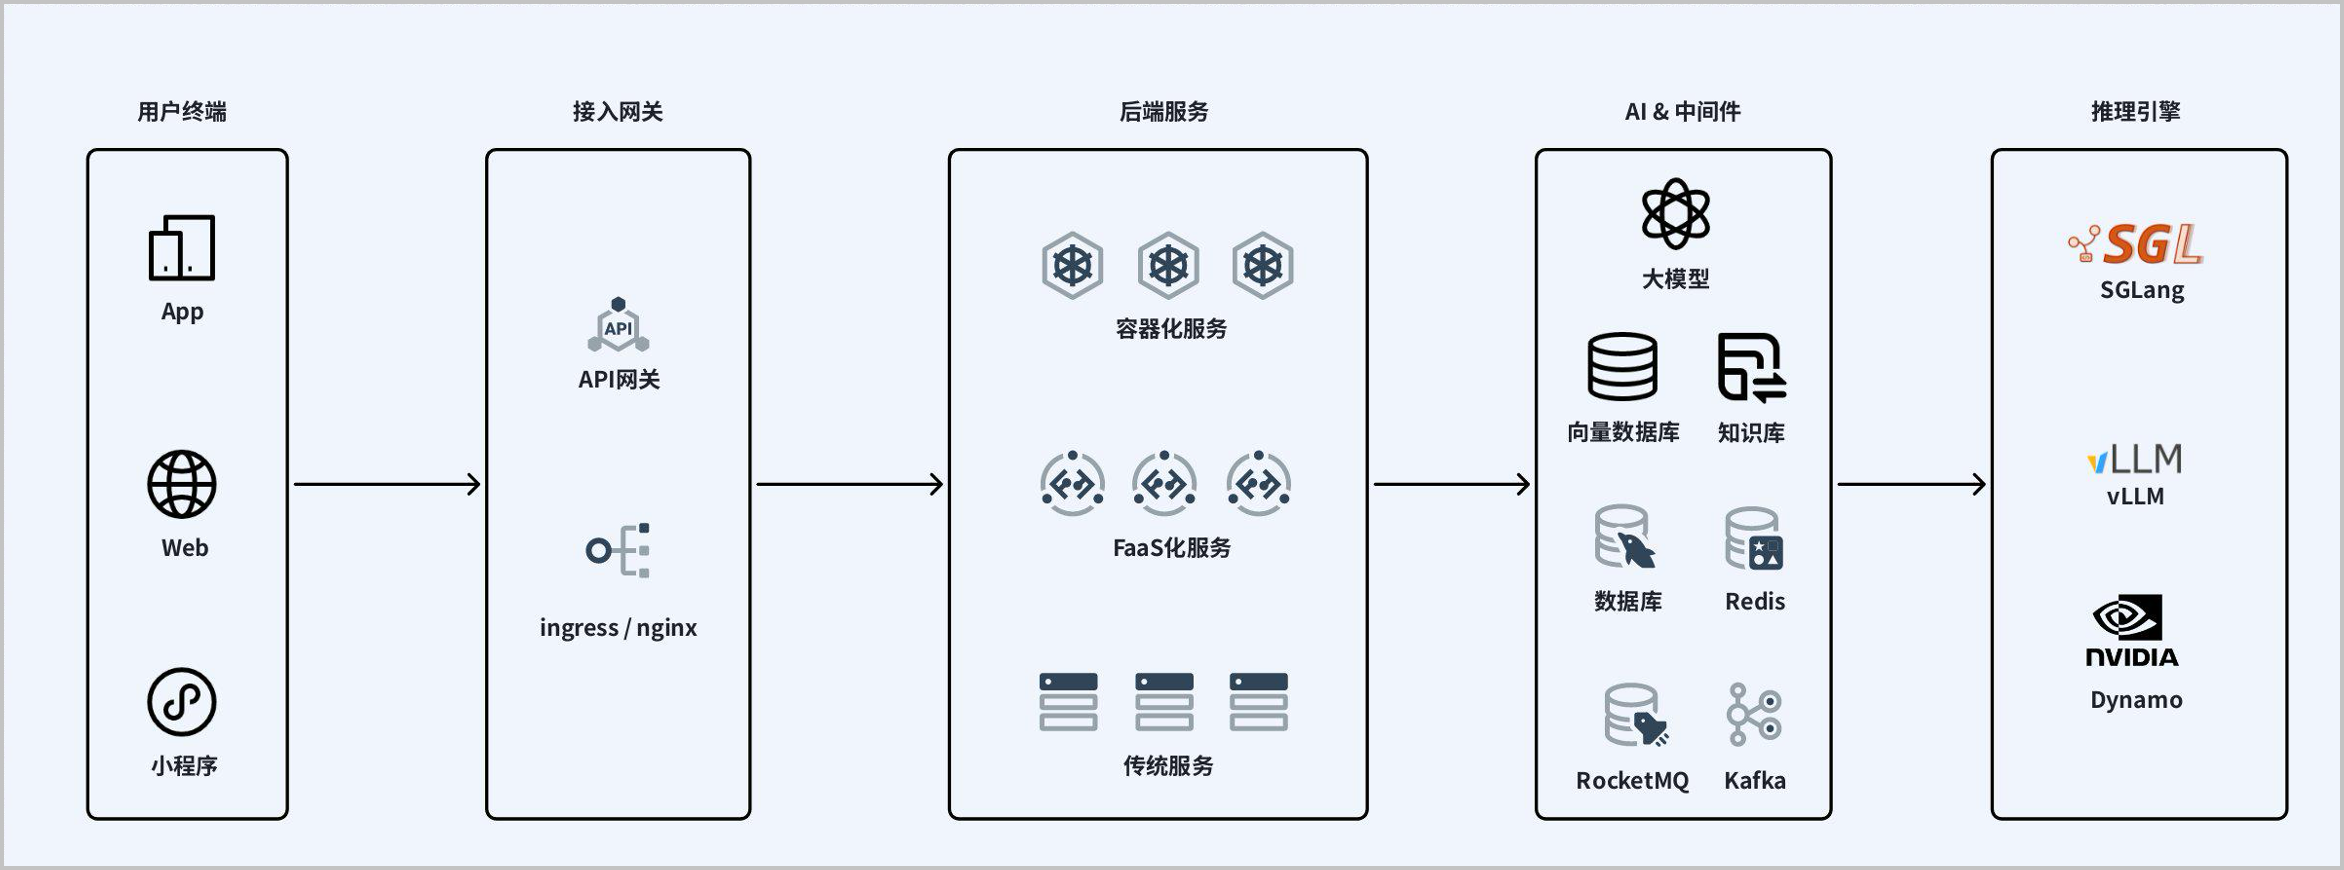
此核心能力整合了端上埋点、AI 框架支持、推理引擎监控等多个维度,形成完整的监控生态。从用户请求到最终响应,精确监控每个关键节点。
- 全链路覆盖:支持 Android/iOS/Web/小程序 → API 网关/Ingress/Nginx → Java/Go/Python 应用 → AI 服务/数据库/缓存/消息队列 → 大模型推理引擎的端到端追踪。
- 自动化注入:基于字节码增强、编译时处理和运行时代理的多层次自动注入机制。
- 标准化处理:基于 OpenTelemetry 标准,建立统一的数据埋点规范和追踪上下文传播协议,端到端全链路追踪已经完整支持从用户终端(例如:Android/iOS/Web/小程序)-> 接入网关(例如:API 网关/Ingress/Nginx 等)-> 后端应用(例如:Java/Go/Python 等)-> AI & 中间件(例如:数据库、缓存、消息队列等)-> 大模型推理引擎(例如:SGlang, vLLM 等)的端到端全链路打通。
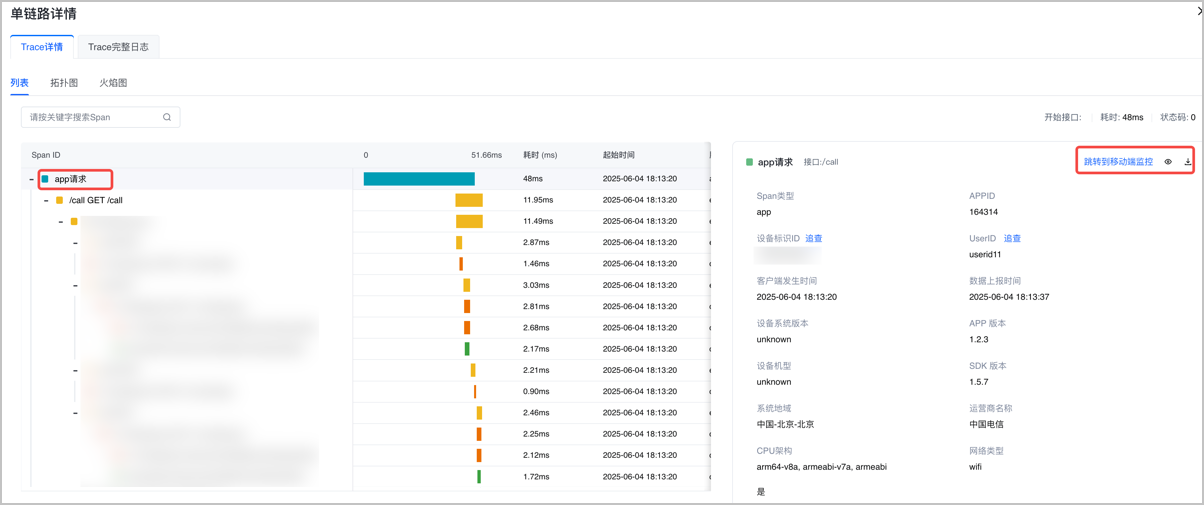
App 端应用和服务端应用正确接入后,从 App 端发起的请求将发送到服务端应用,可前往服务端监控 Trace 详情页查看 App 请求的 Span。前往 Trace 列表能够看到 App 请求的 Span,单击目标 App 请求中的跳转到移动端按钮,支持跳转到客户端监控的 App 页面查看更多信息。
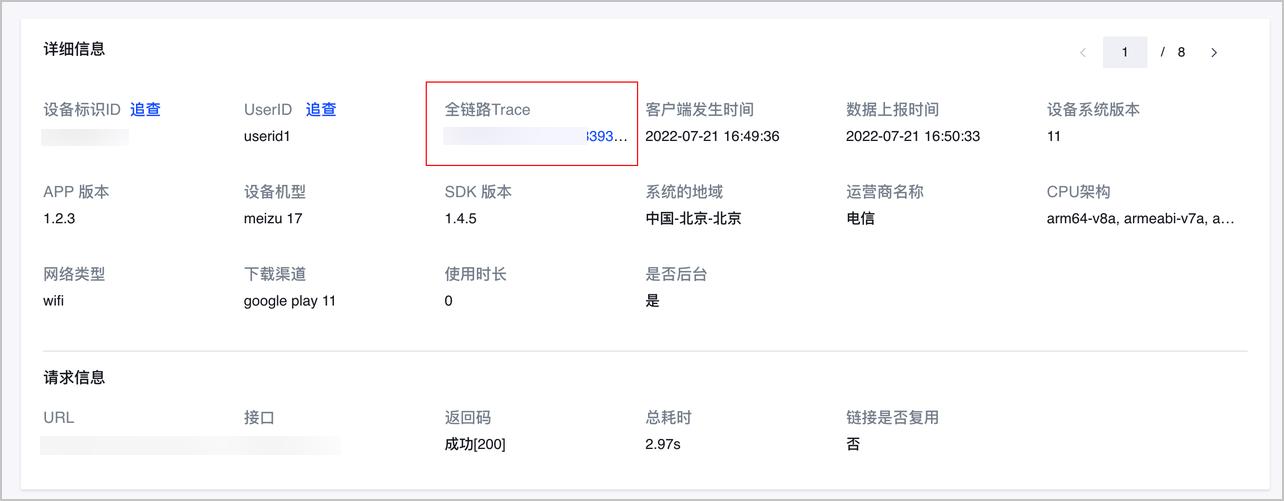
同时,前往客户端监控的 App 页面,也支持跳转到服务端监控的 Trace 详情页。在日志检索页面的详细信息栏,单击全链路 Trace 下方的链接,可跳转到服务端的单链路查询页面,查看更多信息。更多详细说明参见:APMPlus 端到端全链路追踪。
AI 框架与推理引擎深度支持
- AI 框架深度支持:AI 生态框架繁荣但碎片化严重,APMPlus通过智能探针技术,实现对主流AI框架的深度支持。所有监控能力均采用零代码侵入设计,开发者无需修改业务逻辑,仅需简单配置即可获得完整的观测能力。框架支持能力包括:
- Python、Nodejs、Java 等多个语言的埋点探针,全面支持多语言探针。
- LangChain、OpenAI 等 AI 框架覆盖,自动识别 Chain、Agent、Tool 调用,提供细粒度的执行路径分析。
- MCP 协议深度集成,对 Model Context Protocol 的服务发现、工具调用、上下文管理进行全面监控。
- Eino 框架集成,针对字节跳动内部 AI 框架提高监控埋点能力。
- 推理引擎深度监控:将可观测能力下沉至 AI 推理引擎层,支持对 SGlang、Dynamo、vLLM 等高性能推理框架的监控。可以获取推理引擎内部的关键性能指标,例如:模型调用 QPS、模型调用耗时、Token 生成速率(TPOT)、首包耗时(TTFT)等,帮助用户识别并优化推理层的性能瓶颈。
- 使用推理引擎镜像部署完成后,即可自动采集推理引擎底层执行的 Trace、Metrics、 Log 到 AI 场景监控。前往 Trace 详情界面即可查看到推理引擎埋的 Trace 和 Span。
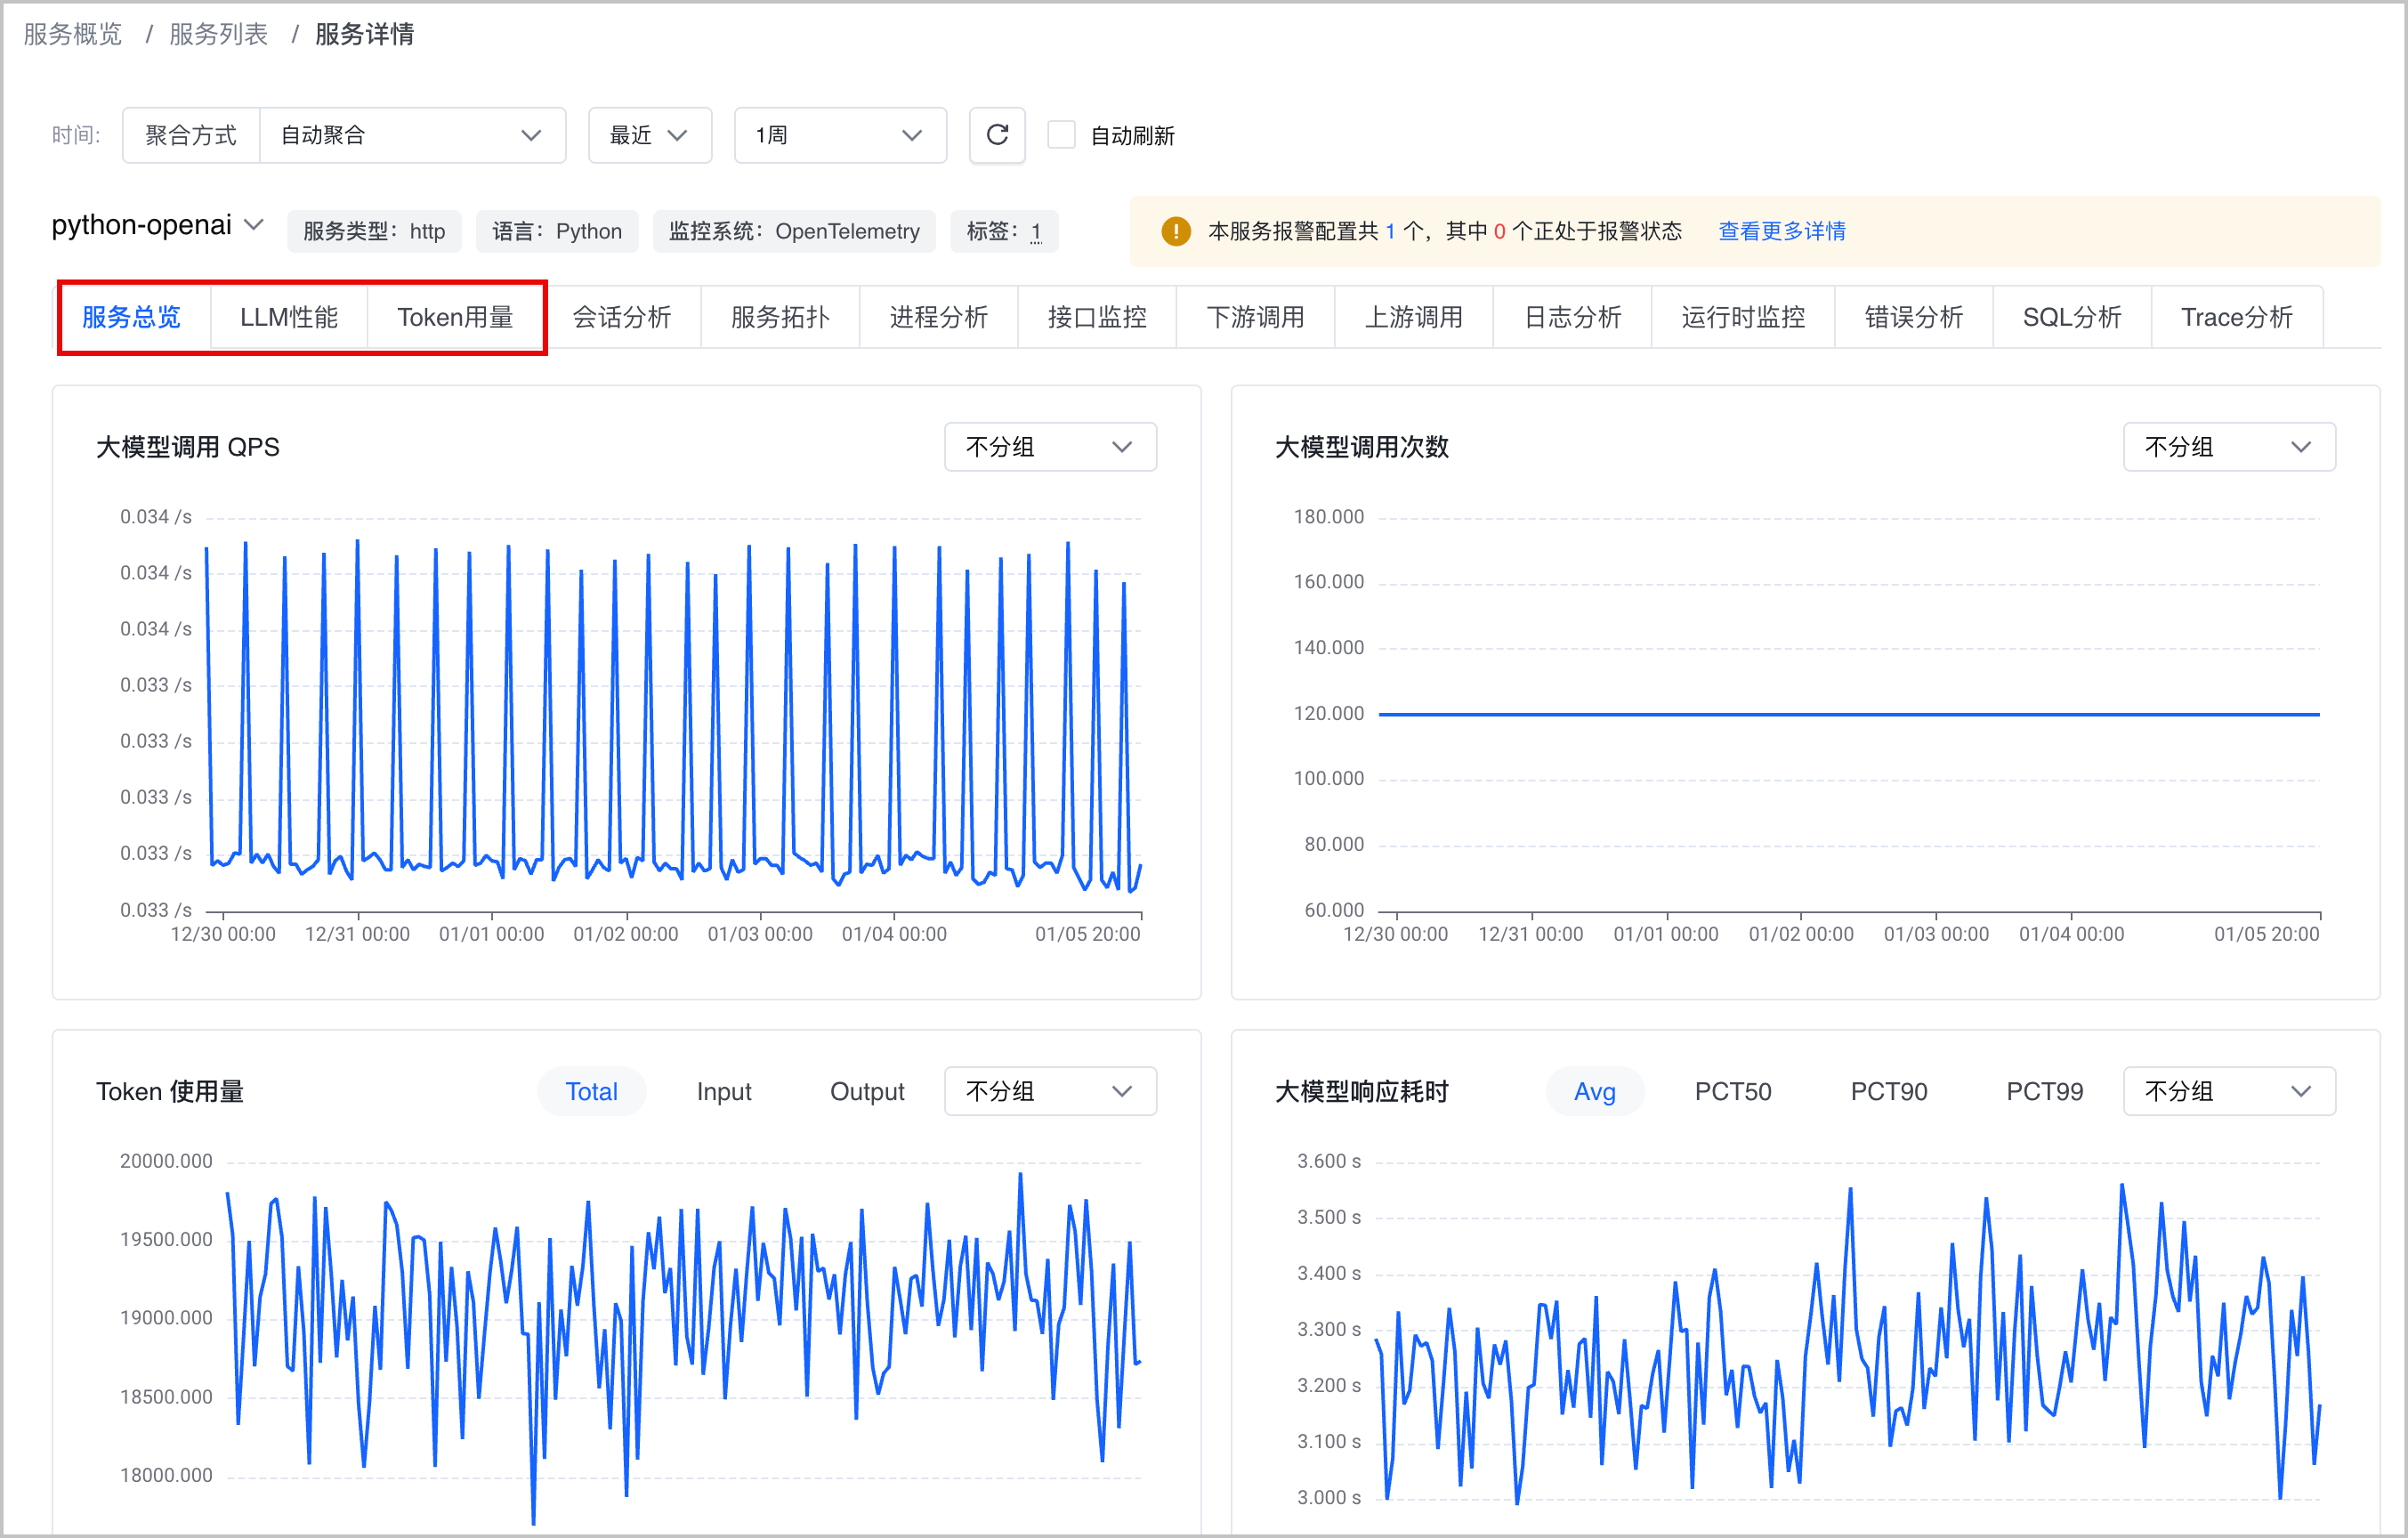
- 前往服务总览、LLM性能、Token 用量等页面,可查看大模型核心指标与服务黄金指标,例如:大模型调用次数、Token使用量、响应耗时、TTFT、TPOT、QPS、请求错误率等。
-
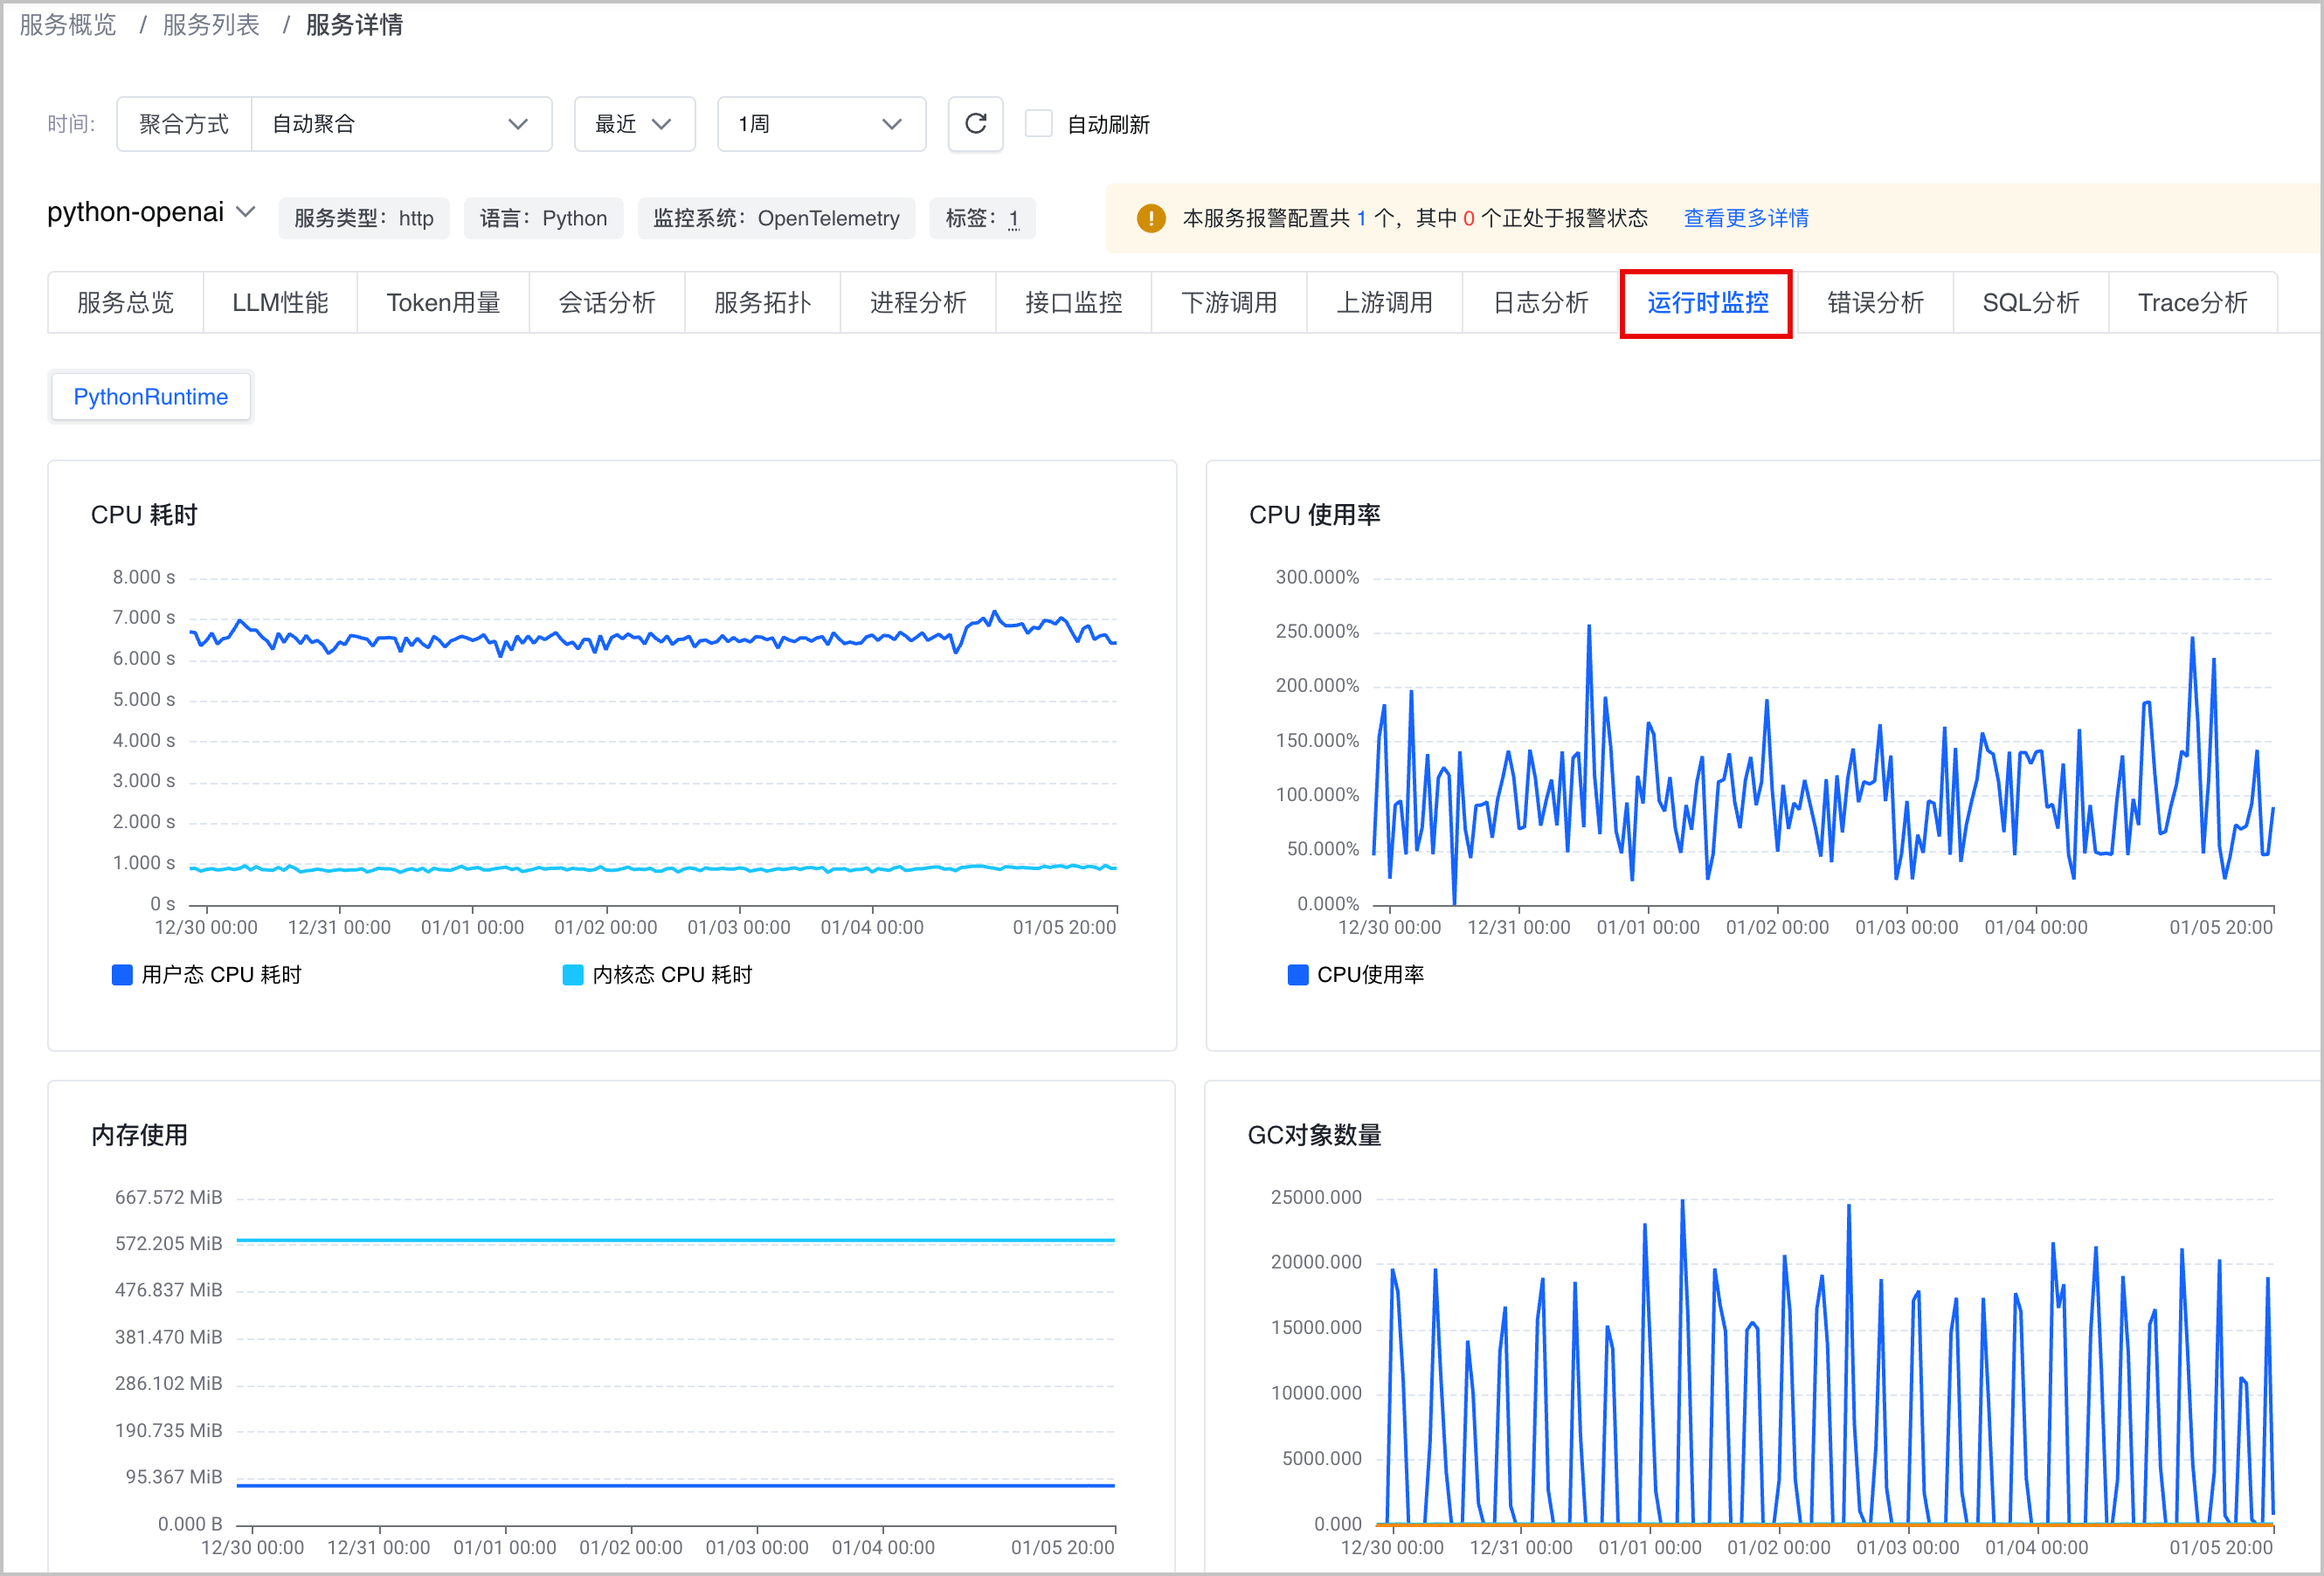
- 前往运行时监控页签,可查看推理引擎运行时相关监控信息,例如:CPU 耗时、CPU 使用率、内存使用、GC 对象数量、线程数量、上下文切换数量等。
-
- 前往推理引擎服务的 Trace 分析页签,单击具体某次请求的 Trace 详情,可以查看到推理引擎内部的 Trace 和 Span 信息,同时能够与其他的 Trace 信息进行上下文关联。
-
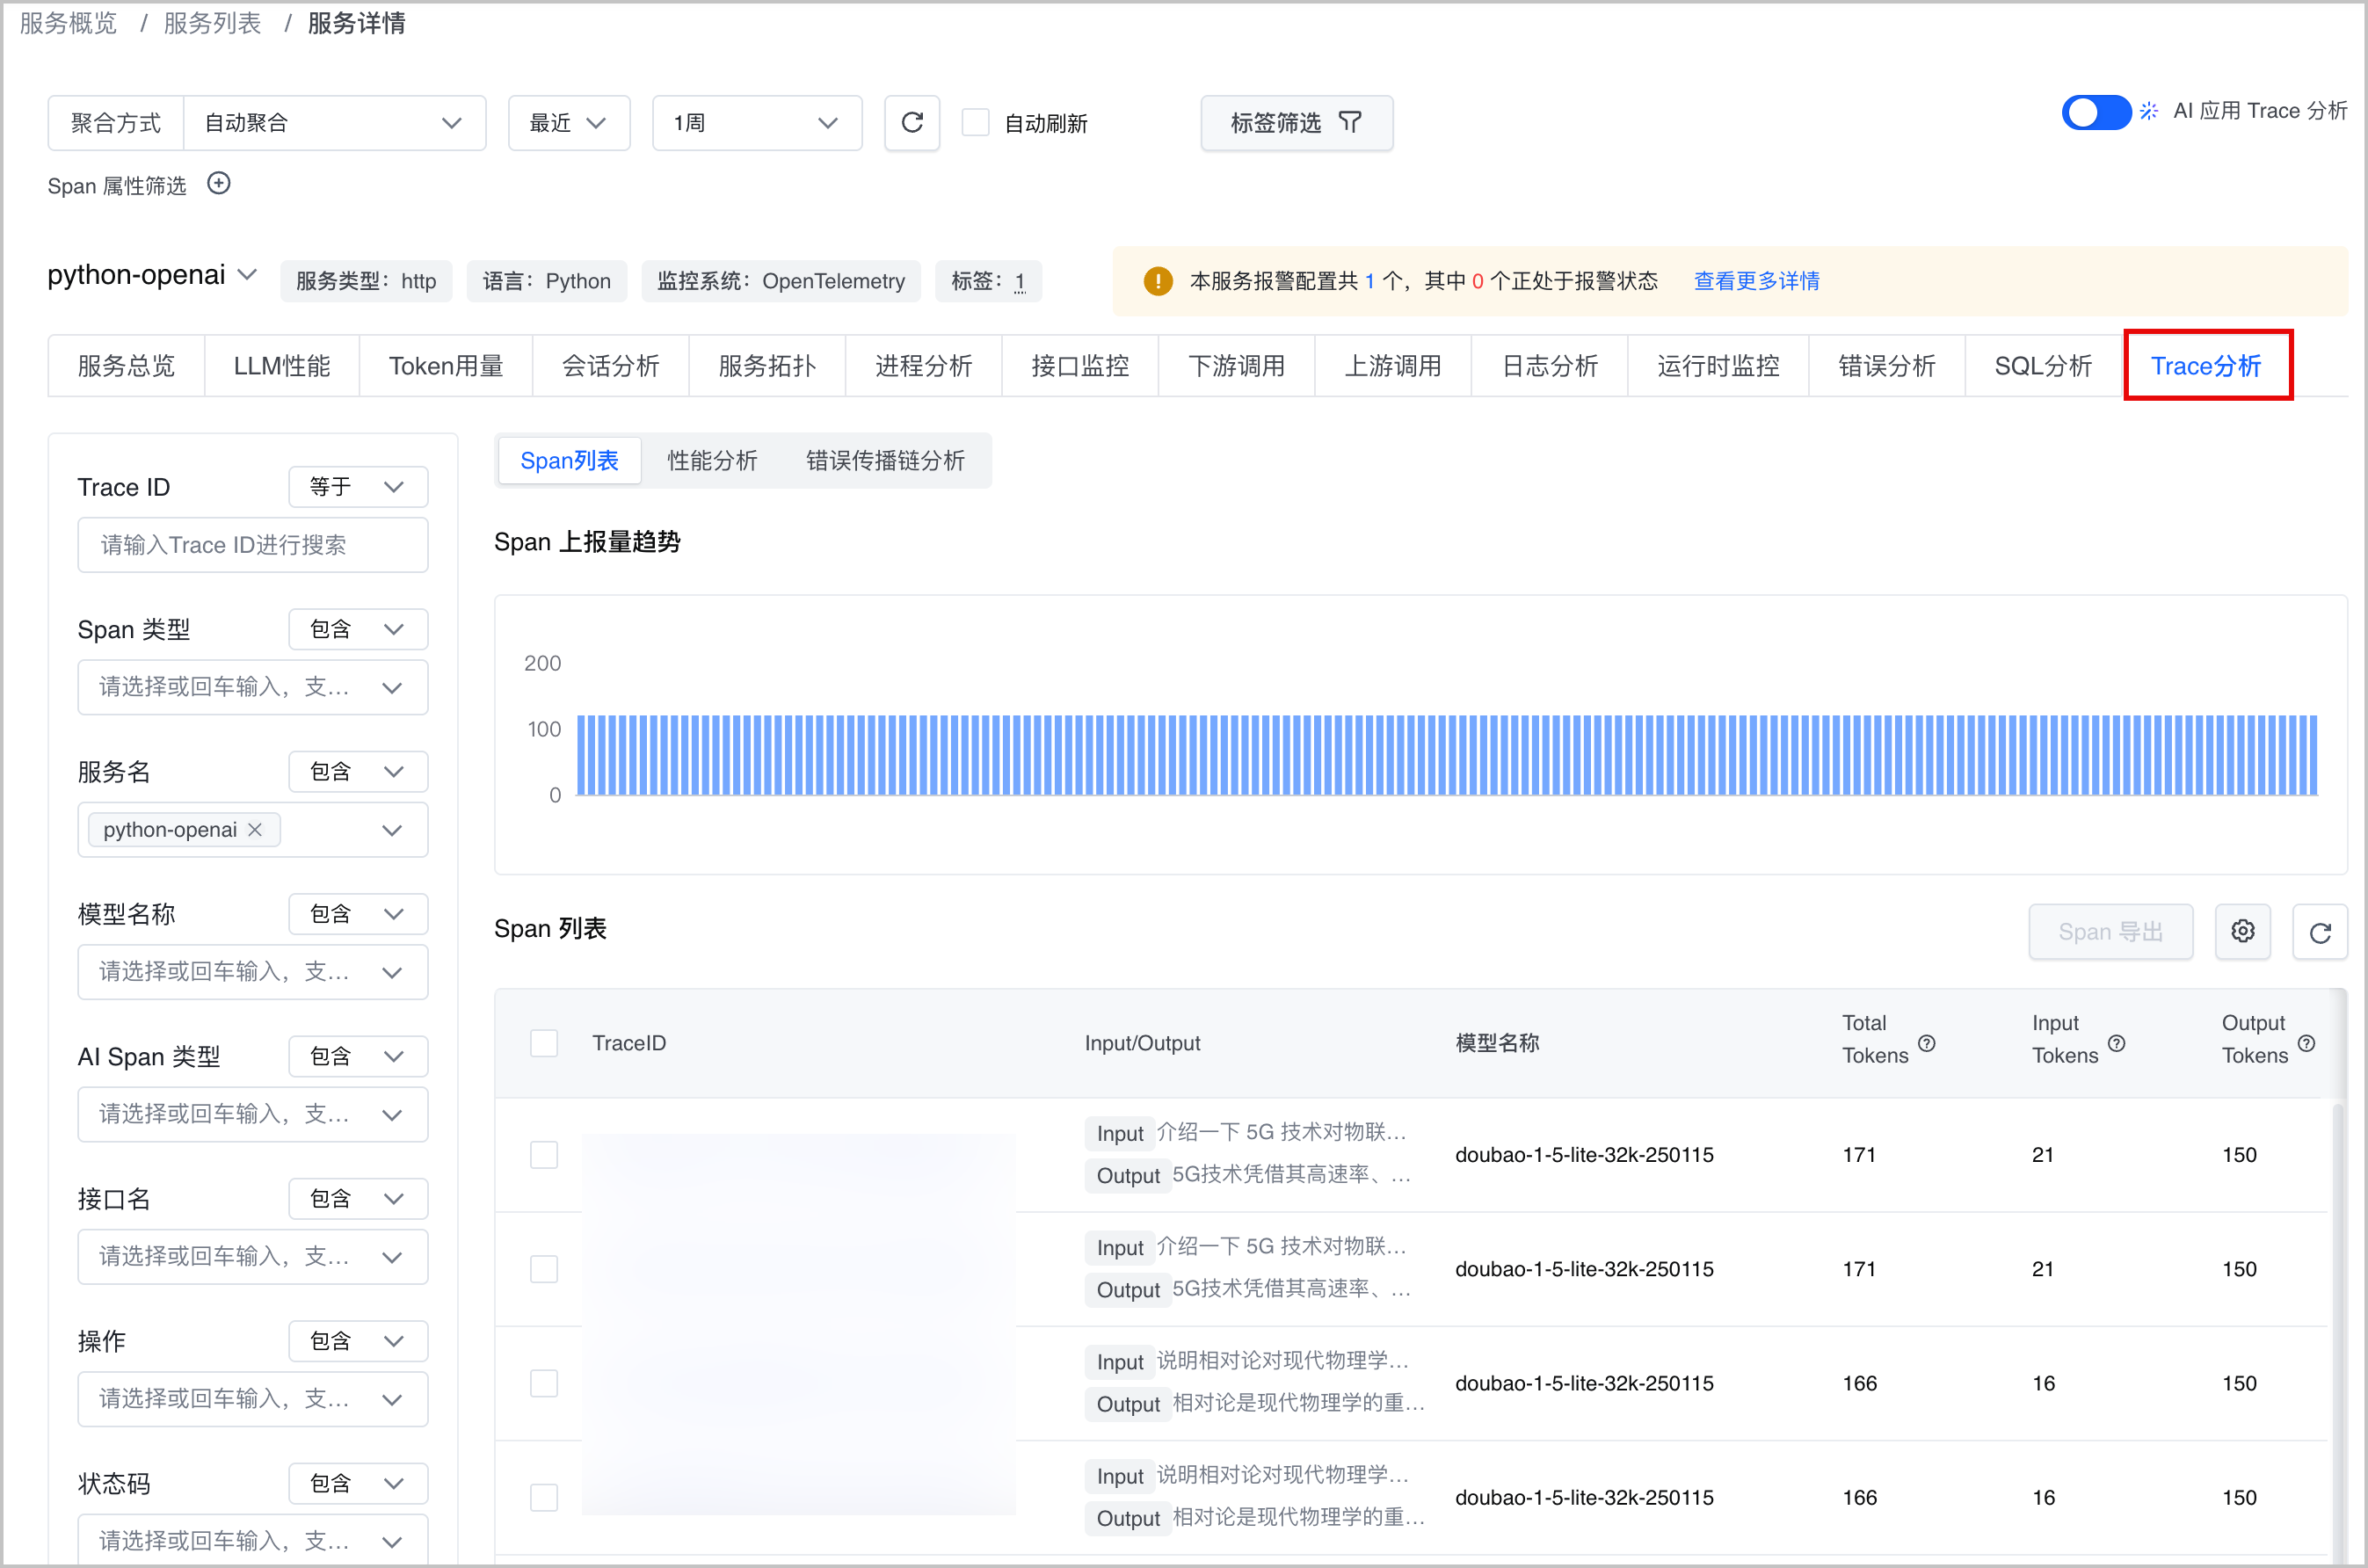
LLM 会话观测
- 多维度会话检索:支持按会话时间,会话ID、用户、耗时、Token数等条件快速定位目标会话。在 LLM 会话分析界面输入筛选条件后,会展示出符合条件的会话列表并展示该会话耗时,消耗token 数,调用链数等信息。
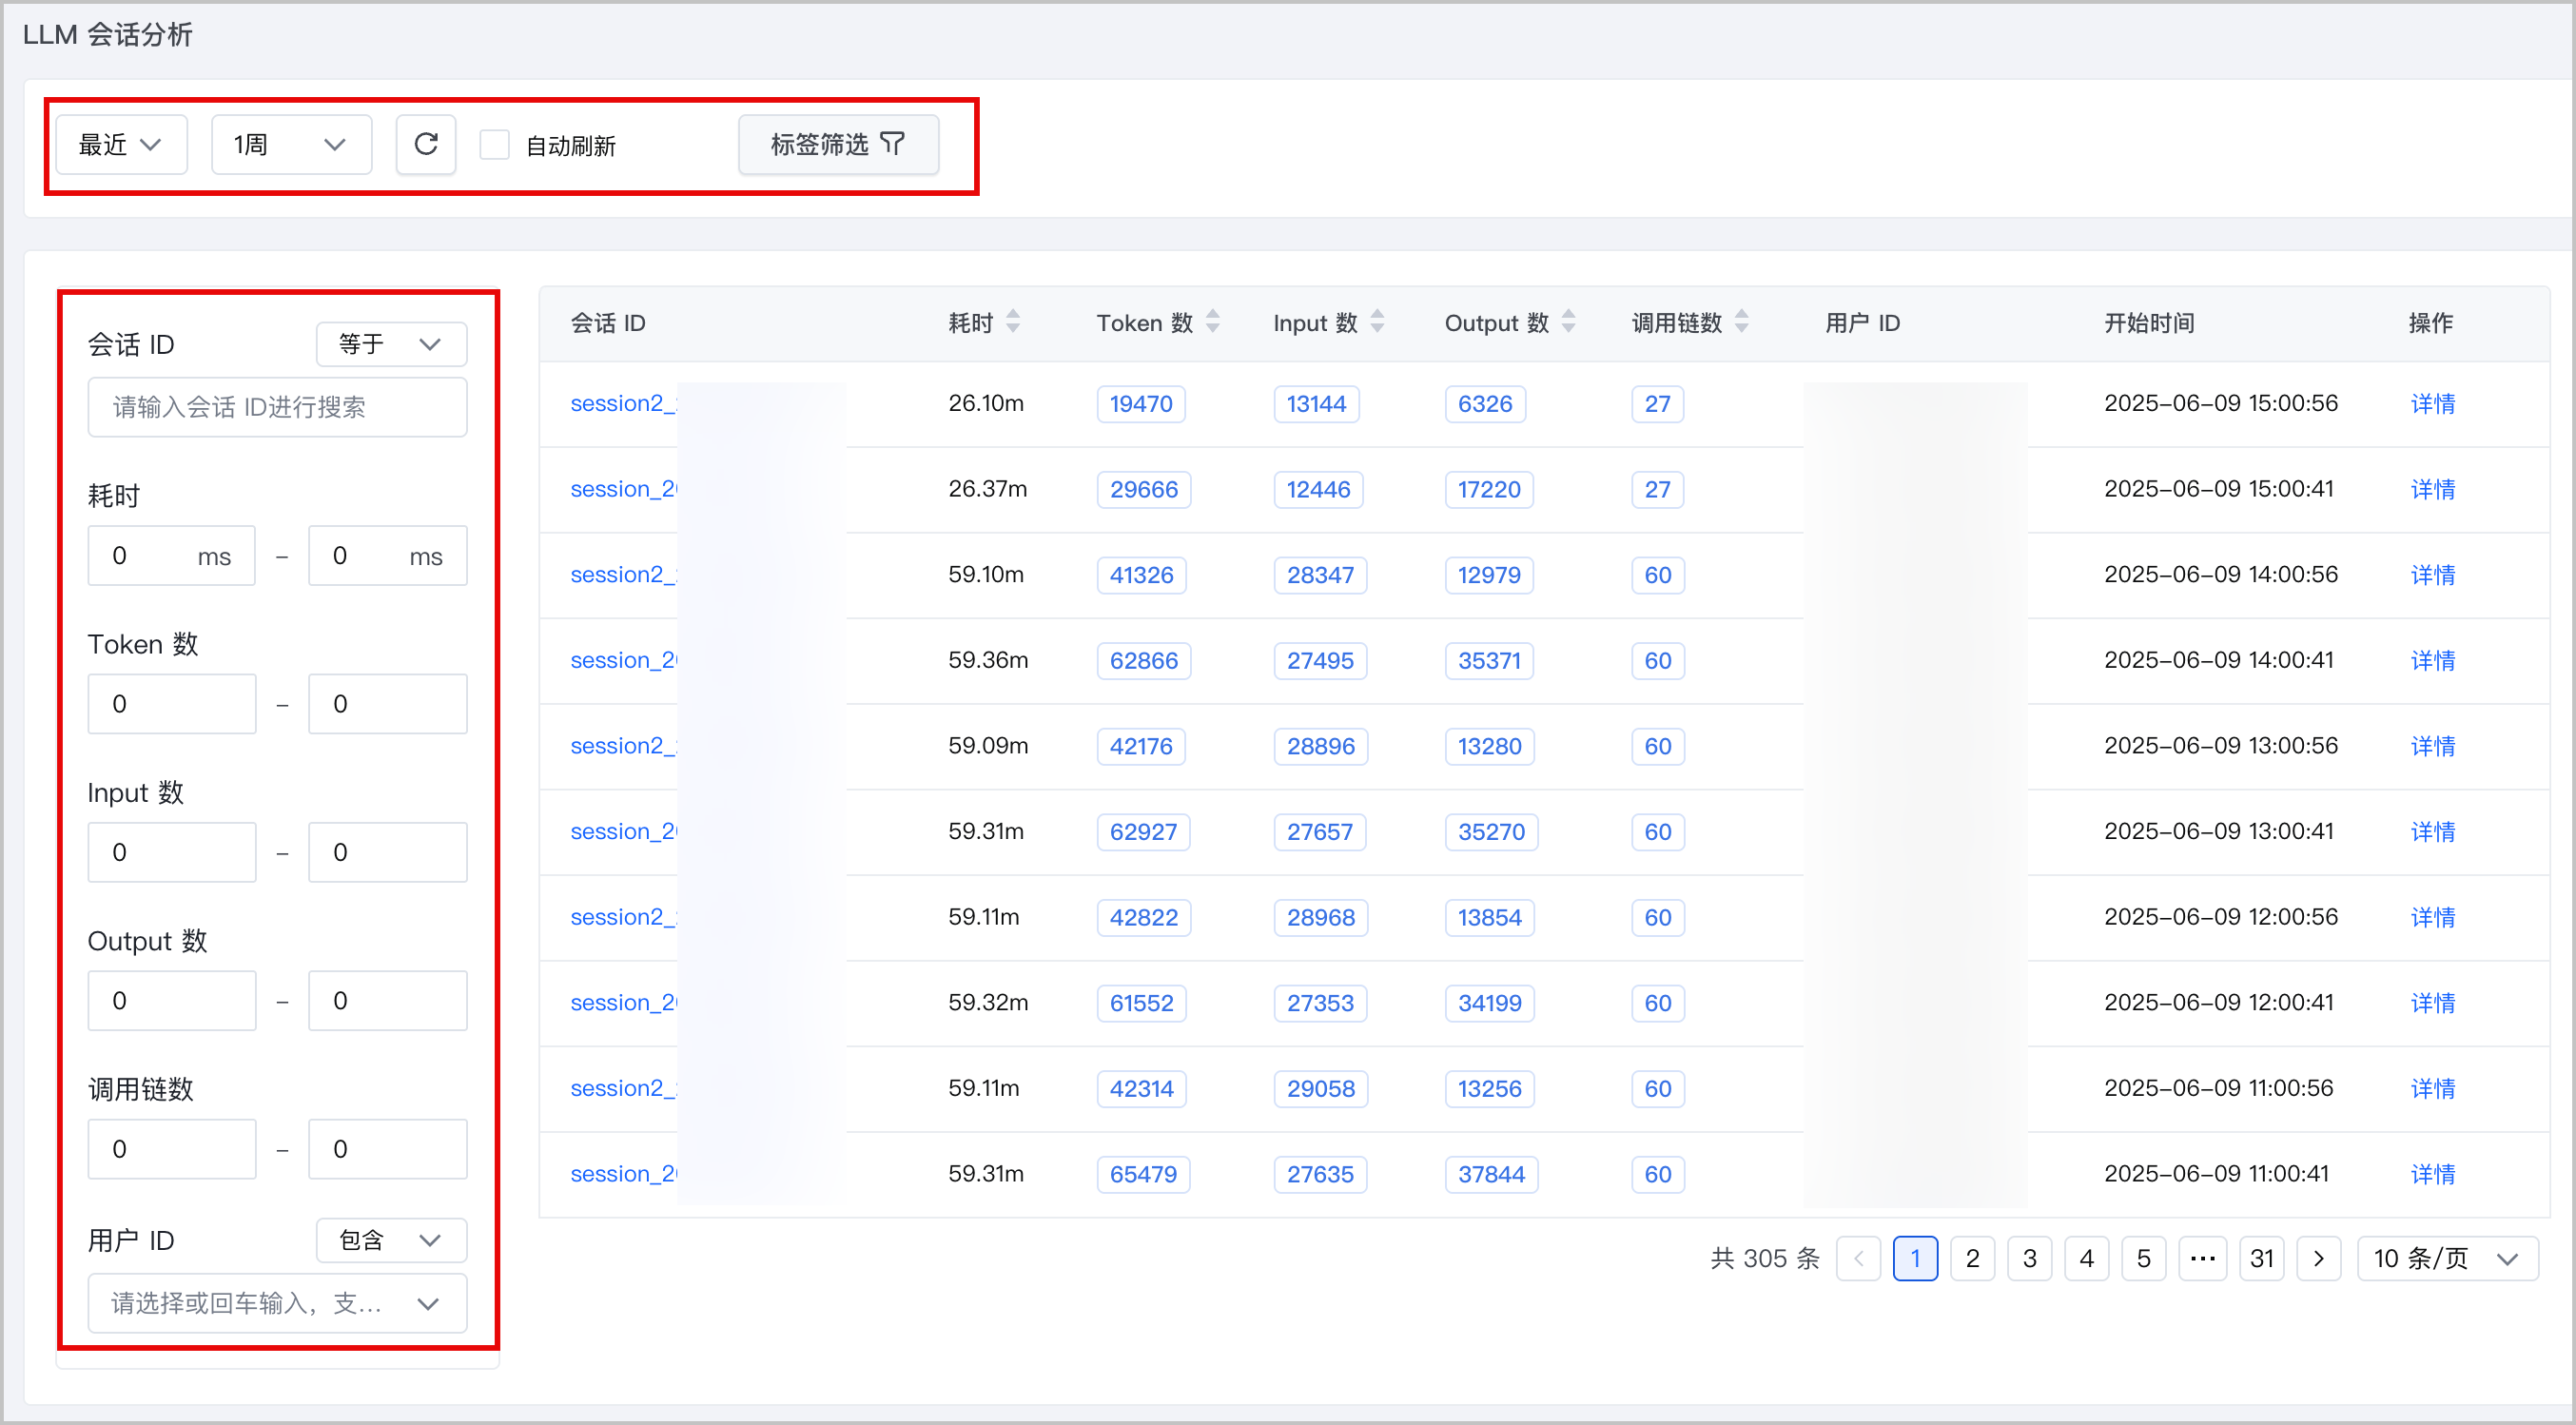
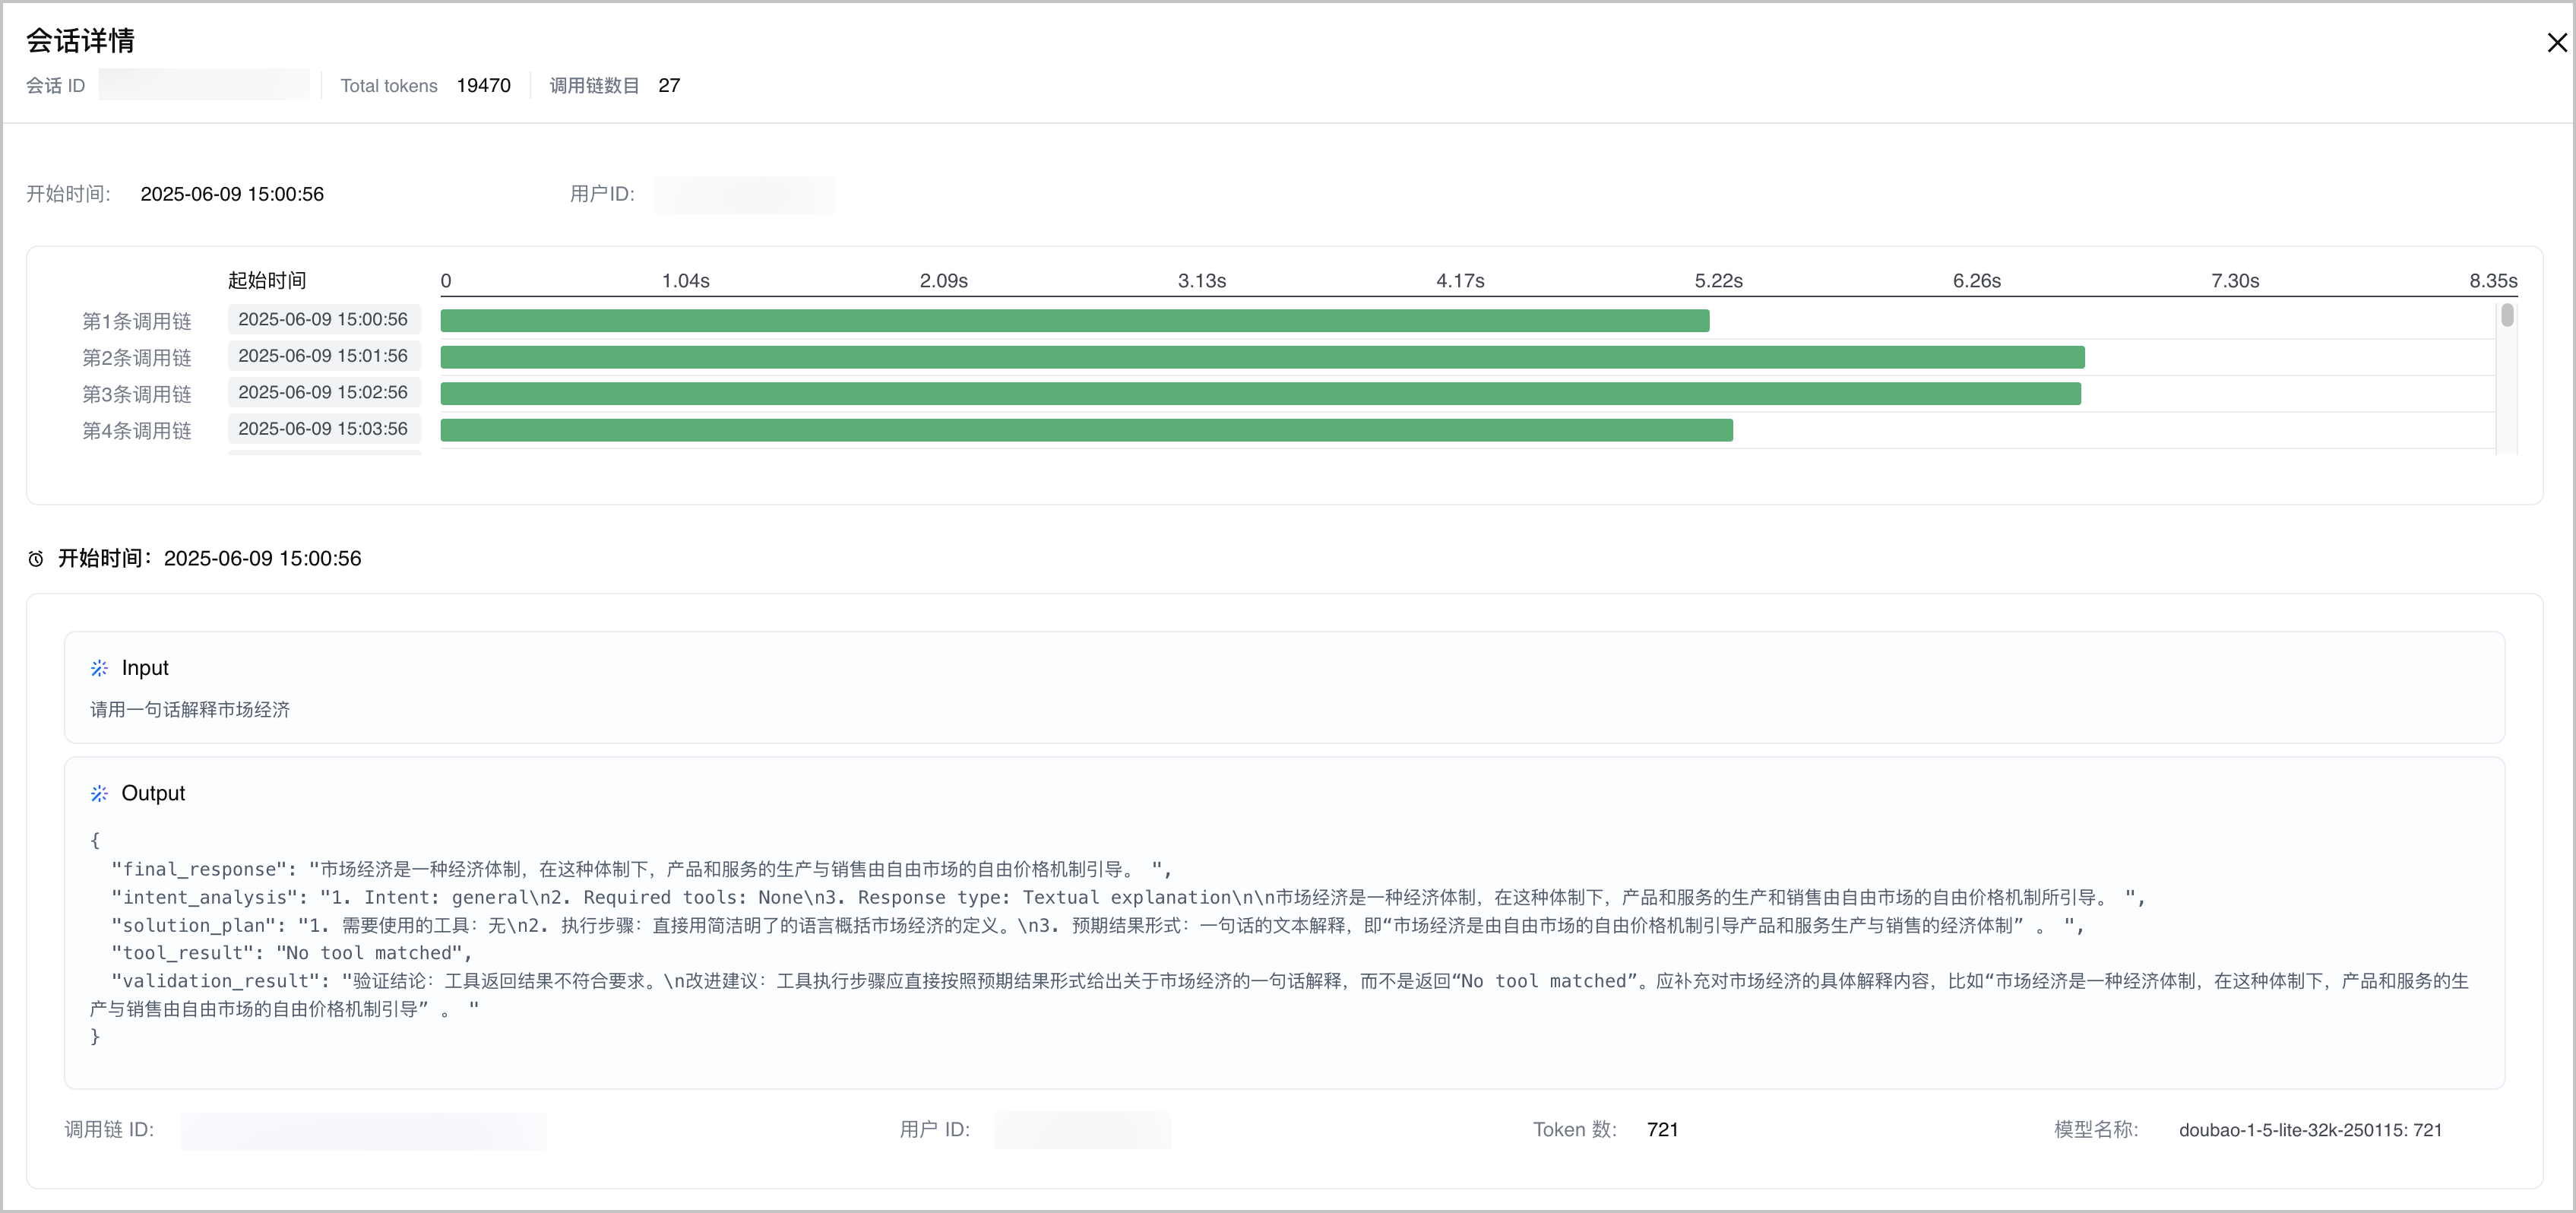
- 会话全生命周期追踪:从会话创建到结束,记录每轮对话的输入输出、Token消耗。单击目标会话名称或右侧操作列中的详情,可查看Total tokens、调用链数,以及每轮对话的开始时间、Input、Ouput、调用链 ID、用户 ID、Token 数、模型名称等详细信息。
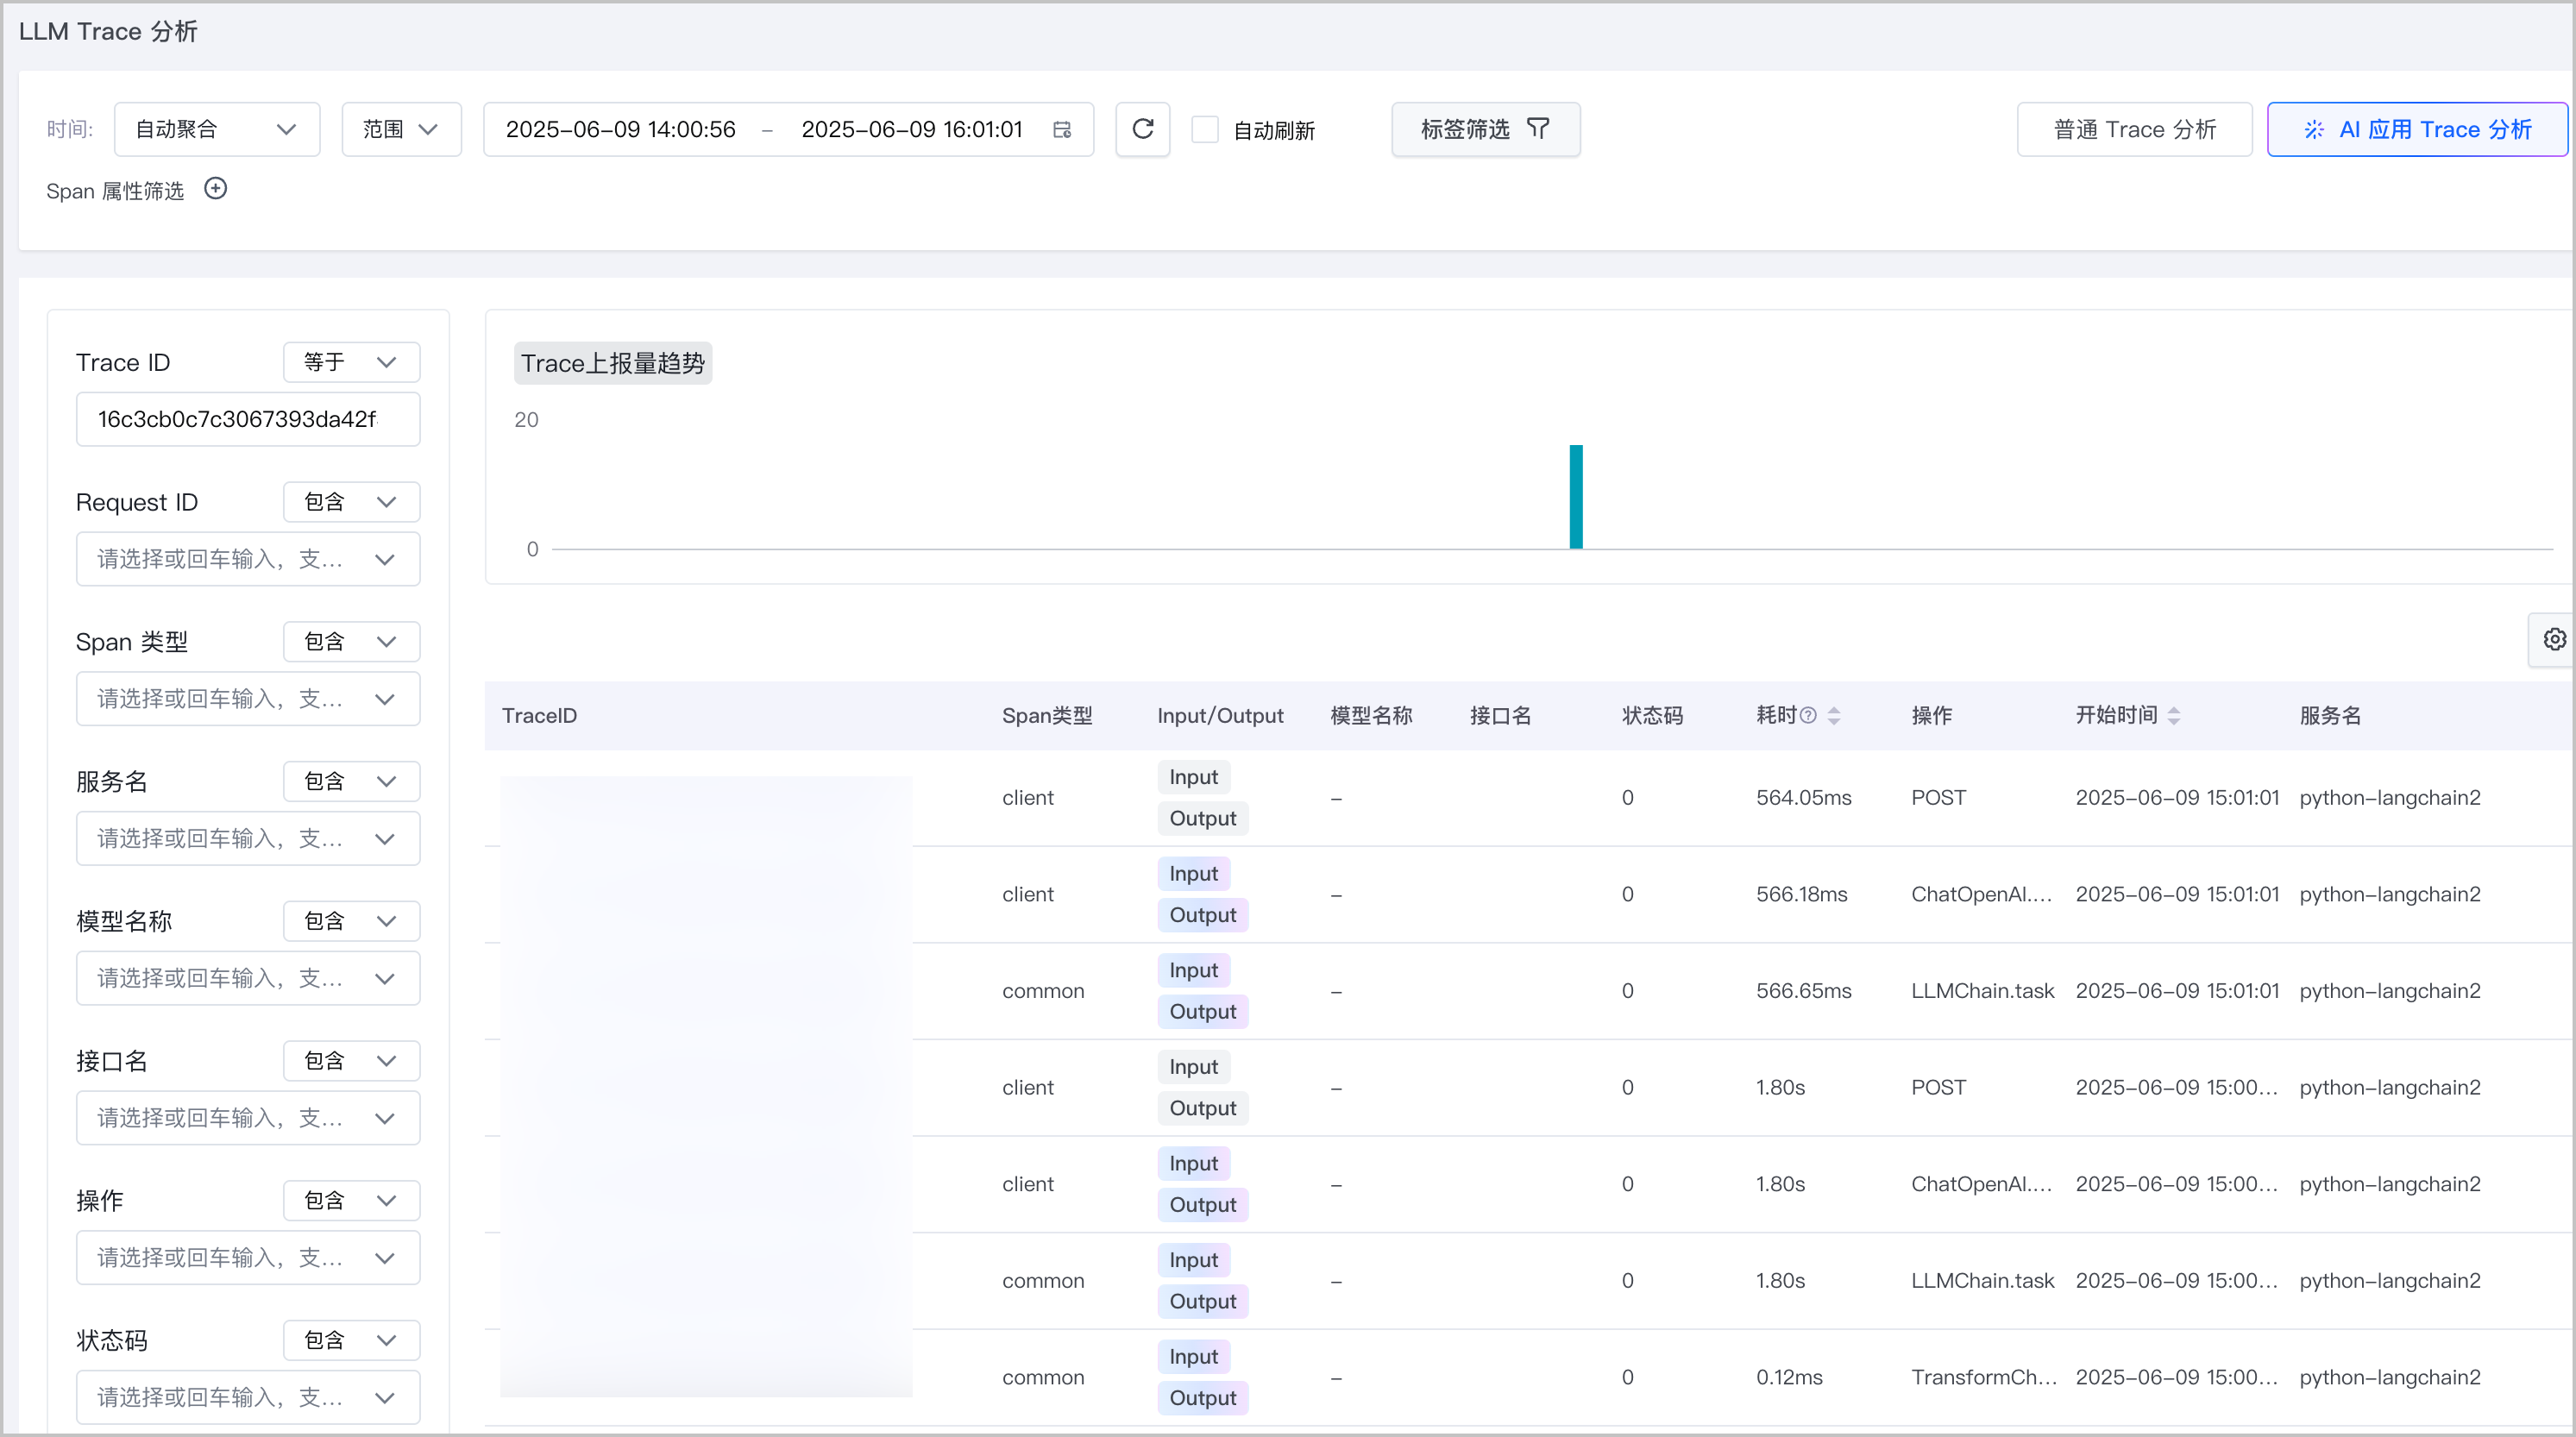
- 单轮对话下钻分析:单击会话中某一轮对话的调用链 ID,可跳转到 Trace 分析页面,查看大模型链路分析详细信息。链路分析相关详细介绍参见:链路分析。
应用场景
AI 场景监控通过全链路、多维度、低侵入的监控能力,无缝串联 Metrics、Traces、Logs ,并将复杂、跨领域的 AI 应用问题转化为清晰、直观、可追溯的数据洞察,引导开发者完成从“发现”到“定位”再到“解决”的全过程,助力用户精准洞察 AI 应用性能,优化资源消耗与用户体验,极大地降低了故障排查和性能监控的门槛和时间成本。典型应用场景如下:
场景一:Agent 应用性能问题诊断与优化
某客户在 veFaaS 中部署智能体应用,开启应用监控和全栈可观测平台中的 AI 场景监控服务,并使用平台提供的推理引擎镜像,自带埋点信息,客户无需做任何改造即可实现零开发成本接入。
发现问题 - 告警洞察,即时响应
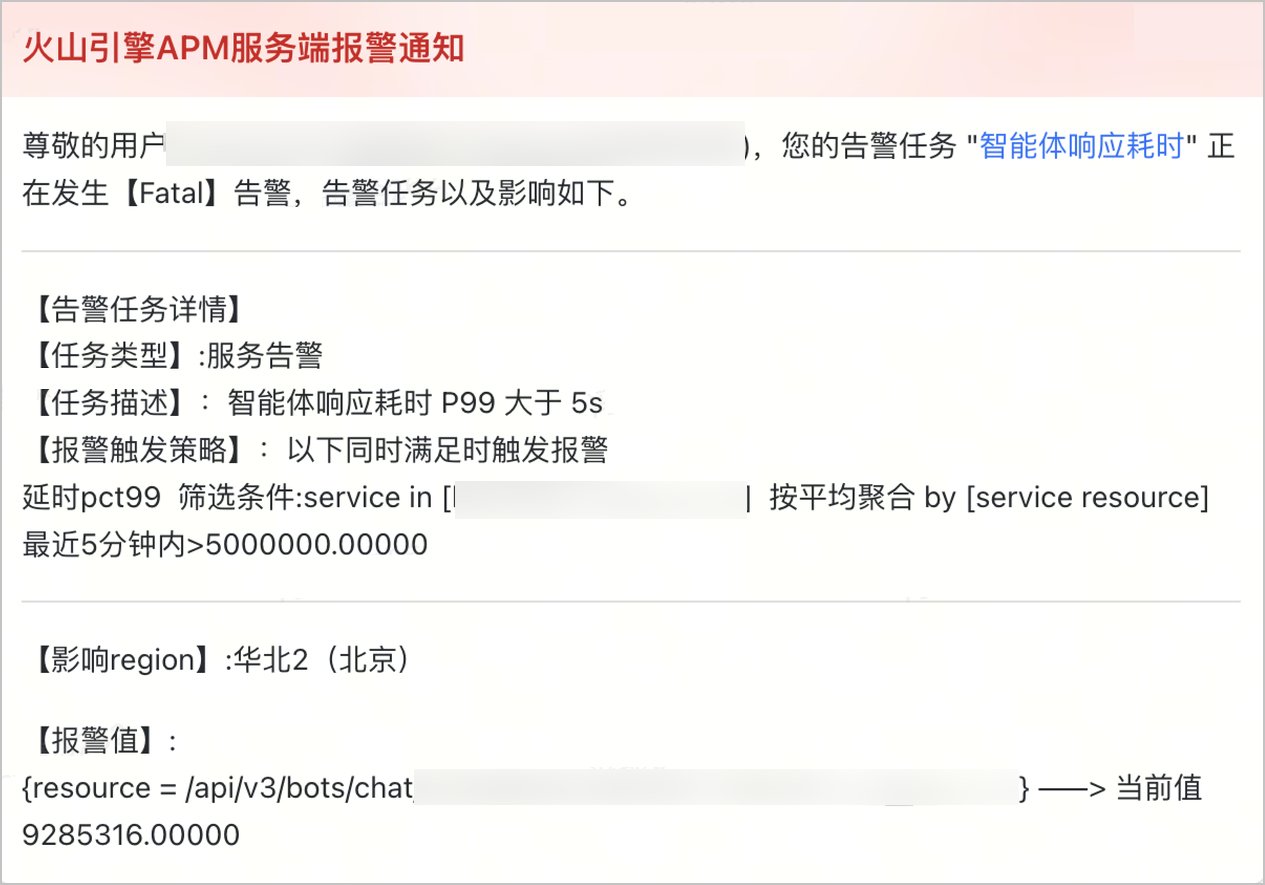
晚高峰时段,客户突然收到 AI 场景监控通过飞书发出的告警,发现该智能体应用耗时 P99 大于 5 秒。告警信息不仅清晰地指出了问题服务和异常指标,还附带了直达监控面板的链接,客户无需任何手工查找,第一时间进入了“战场”。
定位问题 - 层层下钻,直抵根因
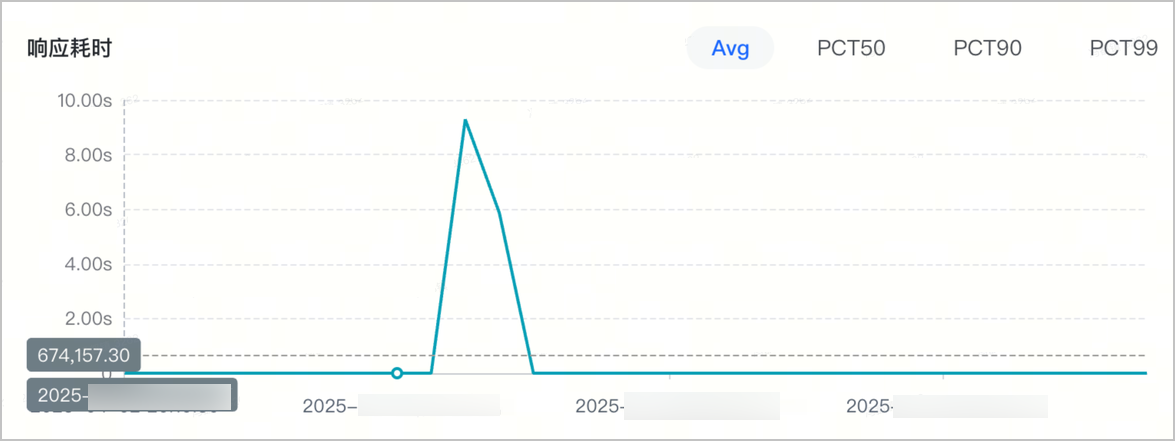
- 通过报警卡片信息,可以定位到耗时增加的服务,前往 AI 场景监控对应服务的详情页,可以查看响应耗时的详细情况。
- 通过 Trace 分析界面,查找对应 Trace 的单链路详情,提供火焰图、列表、拓扑图三种视图。此时可以发现,llm_request Span 存在感叹号标识,说明此 Span 存在报错。
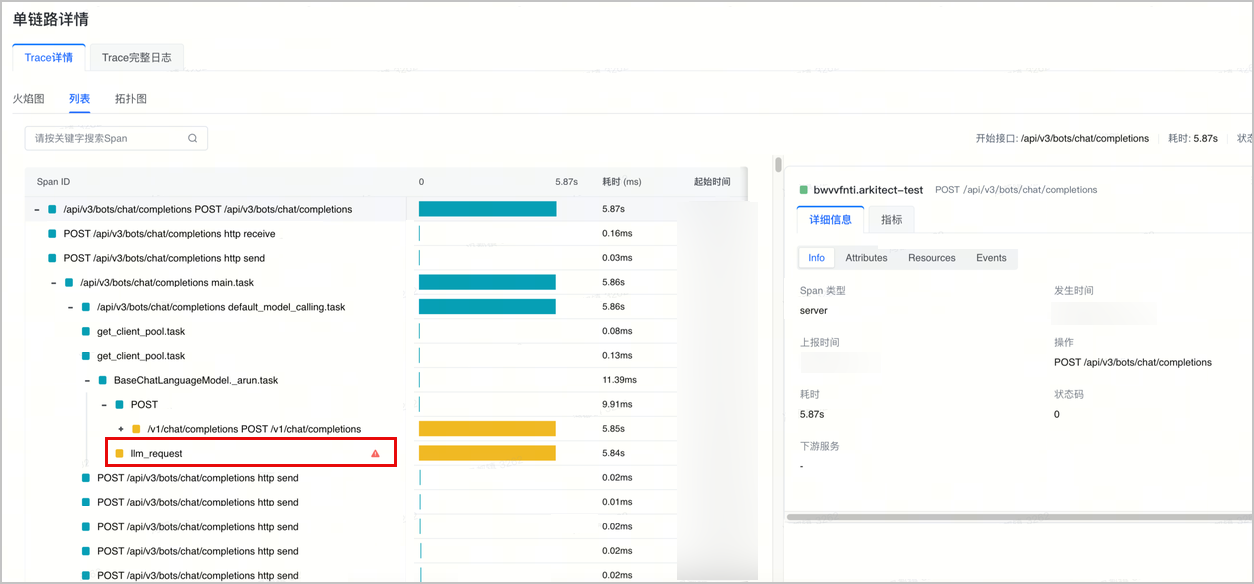
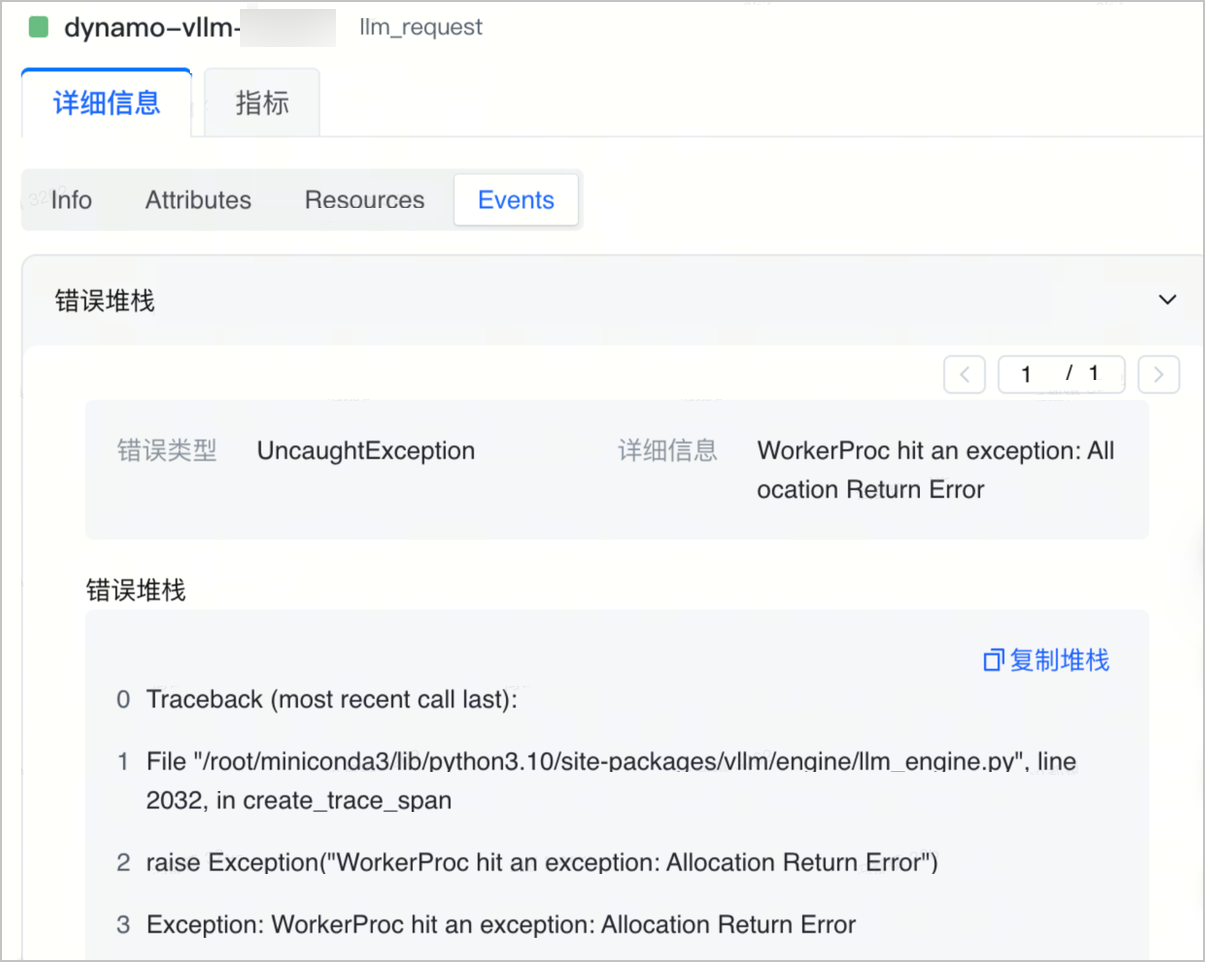
- 单击 llm_request Span,右侧可以查看当前 Span 的详细信息,此时,发现 llm_request Span 属于 Dynamo 推理引擎服务,切换到 Events 列,能够查看当前 Span 发生错误的详细堆栈信息。
根据错误堆栈信息,可以发现错误原因是 vLLM 引擎内存分配出现故障,从而可以确定根因是推理侧引擎故障导致智能体响应耗时增加。至此,问题定位结束。
解决问题 - 对症下药,闭环验证
根因明确,解决路径也变得清晰,客户立即联系开发团队,优化推理引擎内存分配。部署更新后,回到 AI 场景监控的服务监控大盘观察效果。观测大盘数据显示,服务响应的 P99 延迟迅速回落到 2s 以内,问题得到圆满解决。
最终成果
- 通过报警系统,及时发现异常。
- 通过快速筛选异常的推理 Span,5 分钟内发现问题,治理问题能力大幅提升。
- 客户自助解决问题,节约 3 人力排查问题,排查时间大大缩短。
场景二:Token 消耗监控,成本优化
业务背景
某企业部署了一款 AI 写作助手,该应用需要处理大量文本生成任务,Token 消耗量巨大。随着业务规模扩大,如何实现精准的成本控制成为客户面临的核心挑战。
解决方案
通过 AI 场景监控提供的 Token 监控能力,建立了完整的成本管理体系。
- 实时监控:基于 AI 场景监控记录的 Token 消耗指标,设置精细化报警规则,实现对 Token 使用的实时监控。
- 对比分析:利用 Token 用量看板,从模型类型、使用场景等维度进行多角度对比分析。
- 数据驱动:通过 Token 使用量排行功能,清晰识别不同模型在消耗量上的显著差异。
实施效果
通过数据对比和成本分析,发现部分模型的 Token 消耗与成本效益存在明显差异。基于 AI 应用监控提供的精准数据支撑,最终选择了成本更优的模型方案。此案例表明,AI 场景监控服务不仅提供基础监控能力,而且能够通过深度数据洞察助力企业实现精细化的成本管控,为 AI 应用的大规模商业化落地提供了重要支撑。
- 成本显著降低:整体 Token 消耗成本下降 30%。
- 监控体系完善:建立实时监控和预测机制,实现成本可控。
- 决策效率提升:数据驱动的决策模式取代经验判断,优化效率大幅提高。
未来展望
人工智能正在深刻改变世界,而这一变革的实现,离不开可观测、可预测、可控制的技术环境作为支撑。在此背景下,AI 场景监控提供的 AI 观测解决方案应运而生。它不仅是一套监控工具,更是 AI 时代不可或缺的技术基础设施,让每一个 Token 的消耗有据可查,每一次推理的延迟有迹可循,每一个智能决策有根可溯。
面向未来,我们将持续深耕 AI 观测领域,致力于成为 AI 原生时代的观测标准,让智能系统的运行更透明、更可靠,真正推动人工智能在业务中创造价值。具体从以下三个方向持续进化:
构建更深层的 AI 理解能力
- 持续扩展对 Dify、ADK 等主流及新兴 AI 框架的兼容支持
- 深化多模态 AI 应用的监控能力,实现对视觉、语音、文本等模态的统一观测
- 增强对 AI Agent 协作模式的监控,支持多 Agent 系统中复杂交互行为的分析与追溯
打造更智能的排障流程
- 提供覆盖典型 AI 场景的预置看板与报警规则,大幅降低用户使用门槛
- 基于实时可观测数据,在故障发生时自动进行根因分析,并主动推送诊断结论,辅助用户快速定位问题
推动更开放的生态建设
- 提供标准化的 AI 观测 API,支持与各类第三方工具和平台无缝集成
- 建立行业通用的 AI 观测数据标准格式,促进不同系统之间的互操作与数据共享
最近更新时间:2026.01.08 16:36:48
这个页面对您有帮助吗?
有用
有用
无用
无用