Viking AI 搜索
Viking AI 搜索


文档指南

请输入


- 文档首页
 Viking AI 搜索AI搜索引擎用户手册用户指南数据集导入物品数据批量导入物品数据
 复制全文
 下载 pdf
批量导入物品数据
 文档反馈
 问问助手
说明
Viking AI 搜索是一款基于生成式 AI 的企业级 AI 搜索产品,基于大模型的多模态语义表征和理解能力,结合字节跳动信息检索领域多年最佳实践,为客户提供开箱即用的 AI 搜索搭建平台服务,帮助客户轻松搭建和集成端到端的多模态图文搜索和推荐能力。
- 想要体验更多 Viking AI 搜索能力,点击前往:Viking AI 搜索引擎,企业搜推问一体化智能引擎
使用场景
在创建完成物品数据集后,您可能在以下场景下可能会遇到大批量导入数据的场景:
- 首次构建完整的测试/生产数据集,一次性批量导入全部商品、内容数据
- 定期更新数据中的某个字段,如大批量(超过10W条数据)的批量上/下架状态变更
- 新增数据集字段,批量写入全量商品、内容数据的新增字段值
在此类场景下,如果每次要更新的数据量级过万级,实时写入接口可能无法满足您的需求,您可以使用批量导入物品数据的接口流程来实现这个操作。
当前批式导入数据仅支持物品数据集,支持以下数据操作:
- 批量导入新数据:适用于创建数据集后,批量导入全量候选数据。物品数据使用JSON Object列表形式上传。上传的数据 schema 必须遵循您在控制台创建数据集时定义的 schema。
- 批量更新数据:通过重复上传物品数据(传入的数据唯一标识已存在于数据集中)则触发数据更新,最新上传的数据将覆盖已有的数据。如果您只需要更新一批数据中的某几个字段,则每条数据仅需要上传物品数据的id和待更新字段。
适用数据集类型
数据集类型 | 是否支持批量导入 |
图文物品数据集 | ✅ |
视频物品数据集 | ✅ |
文档数据集 | ❌ 暂不支持 |
批量导入流程介绍
使用以下接口组来完成批量导入的操作,按照下文中的步骤执行:
- 接口鉴权:API鉴权机制说明
- 创建批量导入任务:CreateBatchImport - 创建批量导入任务
- 批量导入数据:BatchImport - 批量导入数据
- 完成批量导入任务:CompleteBatchImportTask - 结束批量导入
- 查询批量导入任务状态;GetBatchImportStatus - 查询导入状态
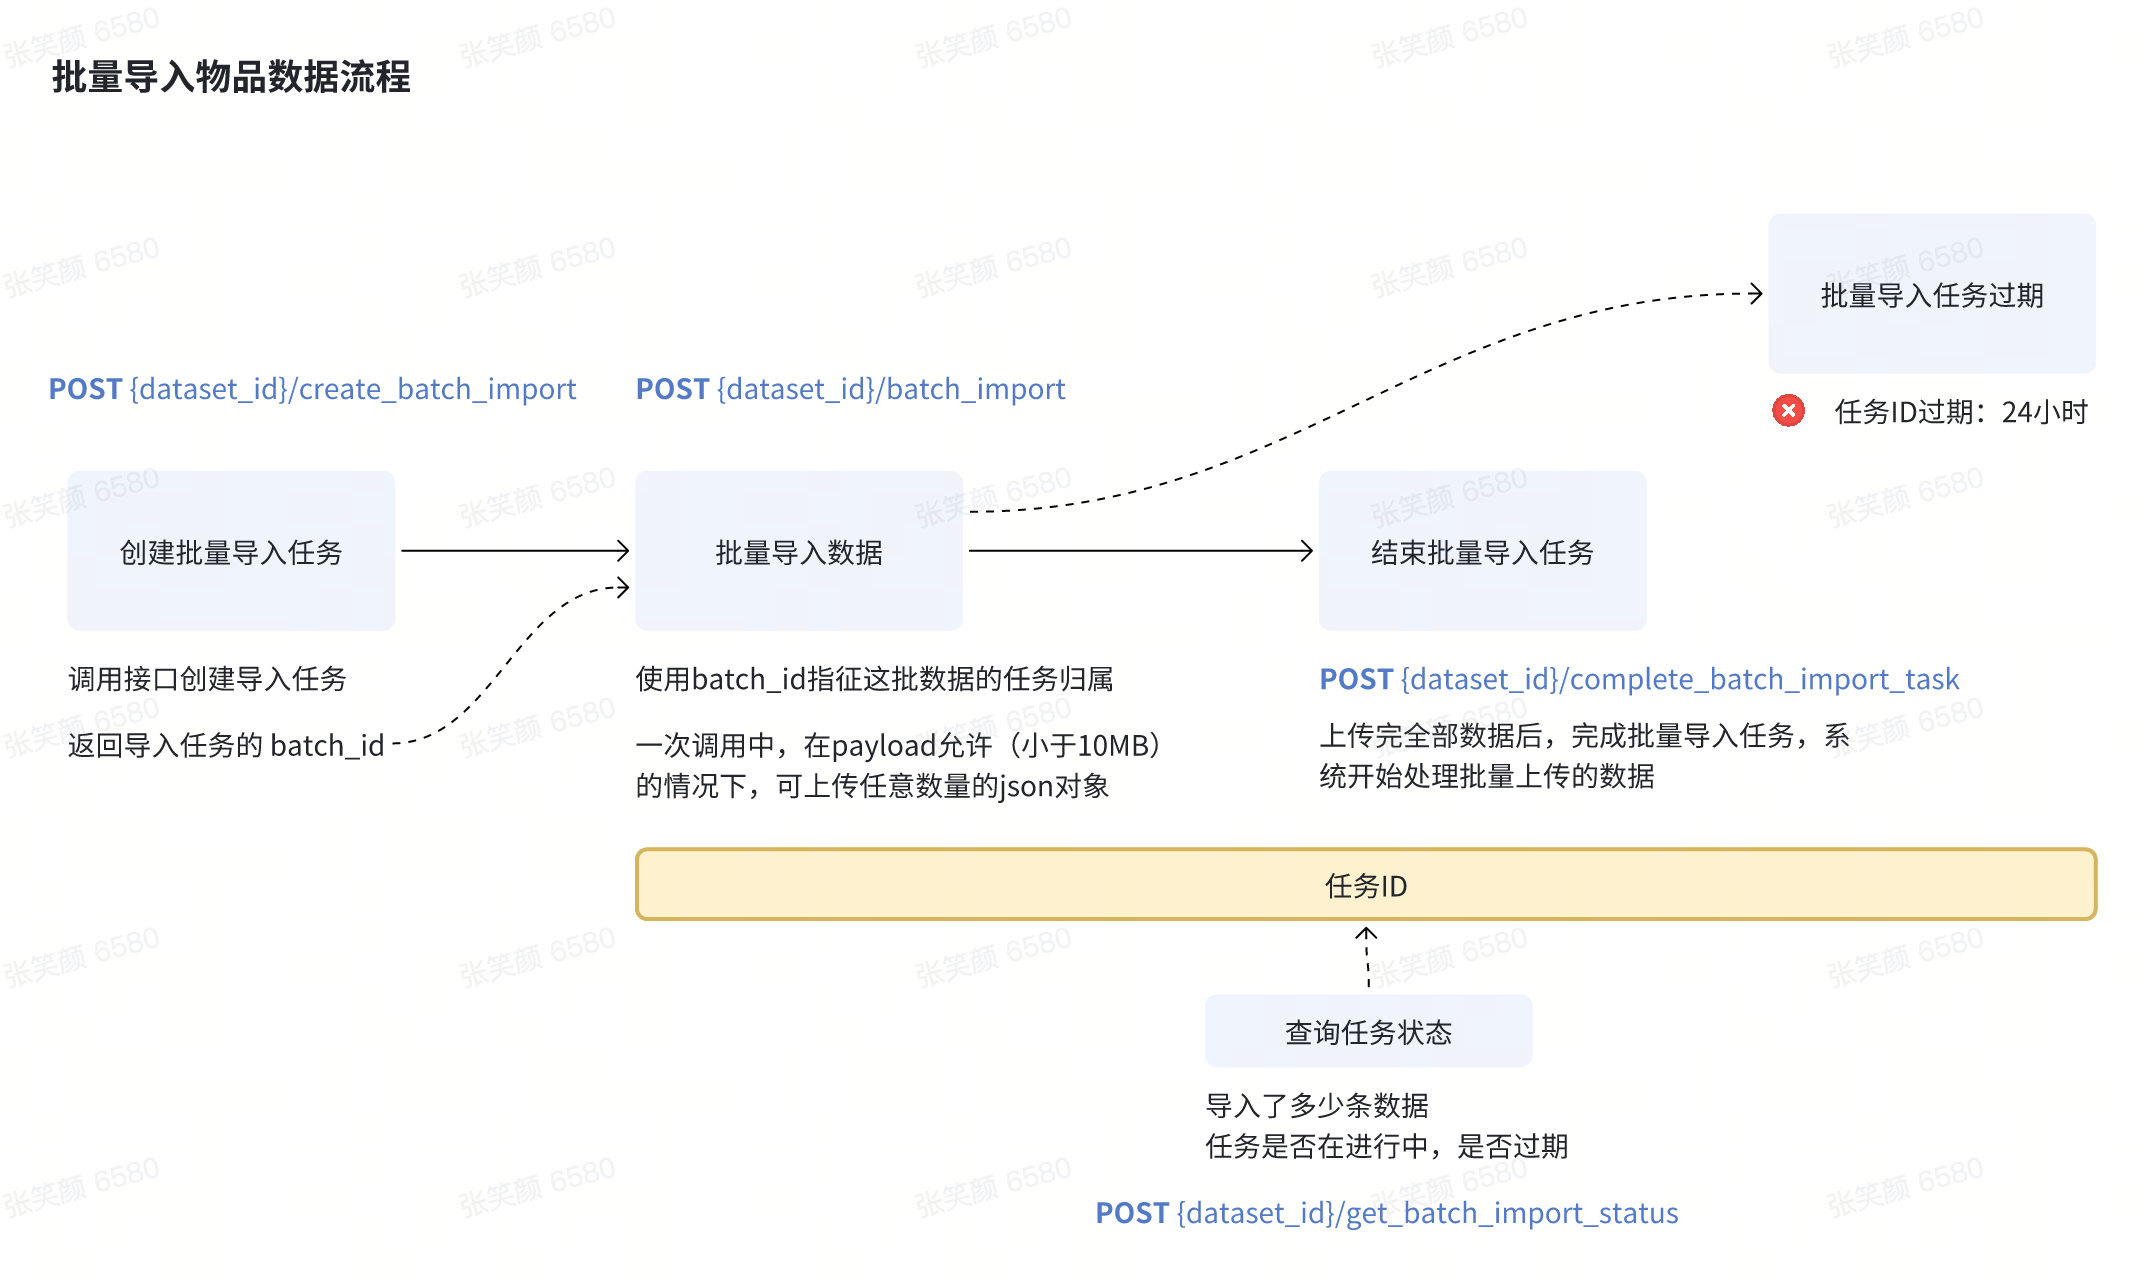
Step 1:创建批量导入任务
可上传estimated_count 传入预计导入的数据量,可在查询状态时返回用于对照:
- dataset_id:其中路径中需要传入目标导入的数据集ID
- API Key:您可以根据 鉴权机制说明 的操作流程创建一个可用的API Key
接口将返回这个导入任务对应的batch_id,可以使用batch_id继续调用后续的批量上传和状态查询。
注意
batch_id有有效时间,在获取batch_id后24小时内没有导入,且调用 CompleteBatchImportTask 完成一次批量上传任务,则此batch_id则会失效。调用接口上传、查询 或完成任务时将报错。
返回示例:
Step 2:上传批量数据
图文数据集批量上传示例:
视频数据集批量上传示例:
每次接口请求可以在接口请求体大小不超过10MB的限制前提下,使用Array of Object传入多个物品数据对象。上传的所有对象将在同一个批量上传任务中完成导入。例如您可以使用同一个batch_id在同一个物品数据集下,每次上传5000条物品数据对象,调用接口100次直到50W条数据上传完毕。
每次接口调用将返回本次上传的数据条数和当前批次下累积上传的数据条数:
Step 3:确认批量上传完成
在完成上传全量数据后,调用complete_batch_import_task接口指示上传完成,系统将启动这批数据的入库和解析、处理。接口详情请查看CompleteBatchImportTask - 结束批量导入。
注意
在不调用complete接口的情况下,系统将不会启动数据的入库和解析处理流程,上传的数据将保持上传中(processing)状态。任务超时后这批数据将会被丢弃,不会进行入库和处理。
接口将返回上传任务的最终状态 "complete"
查询批量上传的任务状态
接口将返回任务的当前状态和累积导入的数据条数:
说明
最近更新时间:2026.08.09 01:06:24
这个页面对您有帮助吗?
有用
有用
无用
无用