Viking AI 搜索
Viking AI 搜索
Viking AI 搜索


文档指南
请输入


产品动态
AI搜索引擎用户手册
产品简介
用户指南
配置 AI 搜索
配置个性化推荐
去除重复推荐物品(去重)
干预推荐物品多样性
配置智能对话搜索(Agentic Search)
数据集
应用监控
最佳实践
API参考
数据API
OpenAPI
vaka 用户手册
快速入门
- 文档首页
 Viking AI 搜索AI搜索引擎用户手册API参考搜索接口Search - 搜索
 复制全文
 下载 pdf
Search - 搜索
 文档反馈
 问问助手
说明
Viking AI 搜索是一款基于生成式 AI 的企业级 AI 搜索产品,基于大模型的多模态语义表征和理解能力,结合字节跳动信息检索领域多年最佳实践,为客户提供开箱即用的 AI 搜索搭建平台服务,帮助客户轻松搭建和集成端到端的多模态图文搜索和推荐能力。
- 想要体验更多 Viking AI 搜索能力,点击前往:Viking AI 搜索引擎,企业搜推问一体化智能引擎
根据用户输入的查询词或图片,在应用所绑定的物品数据源中搜索与用户输入相关联的内容。
请求说明
- 请求方式:POST
- 请求地址:
- 服务区域URL服务区域URL火山引擎华北(北京)https://aisearch.cn-beijing.volces.com/api/v1/application/{application_id}/search/{scene_id}火山引擎东南亚(柔佛)https://aisearch.ap-southeast-1.volces.com/api/v1/application/{application_id}/search/{scene_id}BytePlus东南亚(柔佛)https://aisearch.ap-southeast-1.bytepluses.com/api/v1/application/{application_id}/search/{scene_id}
注意事项
- 使用范围:
- 仅可用于【物品数据集】类型的数据集,文档数据集和用户行为数据集不支持搜索
- 请求体限制:
- 受到HTTP Body大小限制,单次请求的包体大小最大不超过10MB。
接口限流
每租户调用限流:20QPS。
超过接口限流的调用频率,将返回 429 状态码。
鉴权方式
请求参数
Path 参数
参数 | 类型 | 是否必选 | 示例 | 描述 |
参数 | 类型 | 是否必选 | 示例 | 描述 |
application_id | String | 必选 | 76414365027 | 您的应用唯一标识符。 |
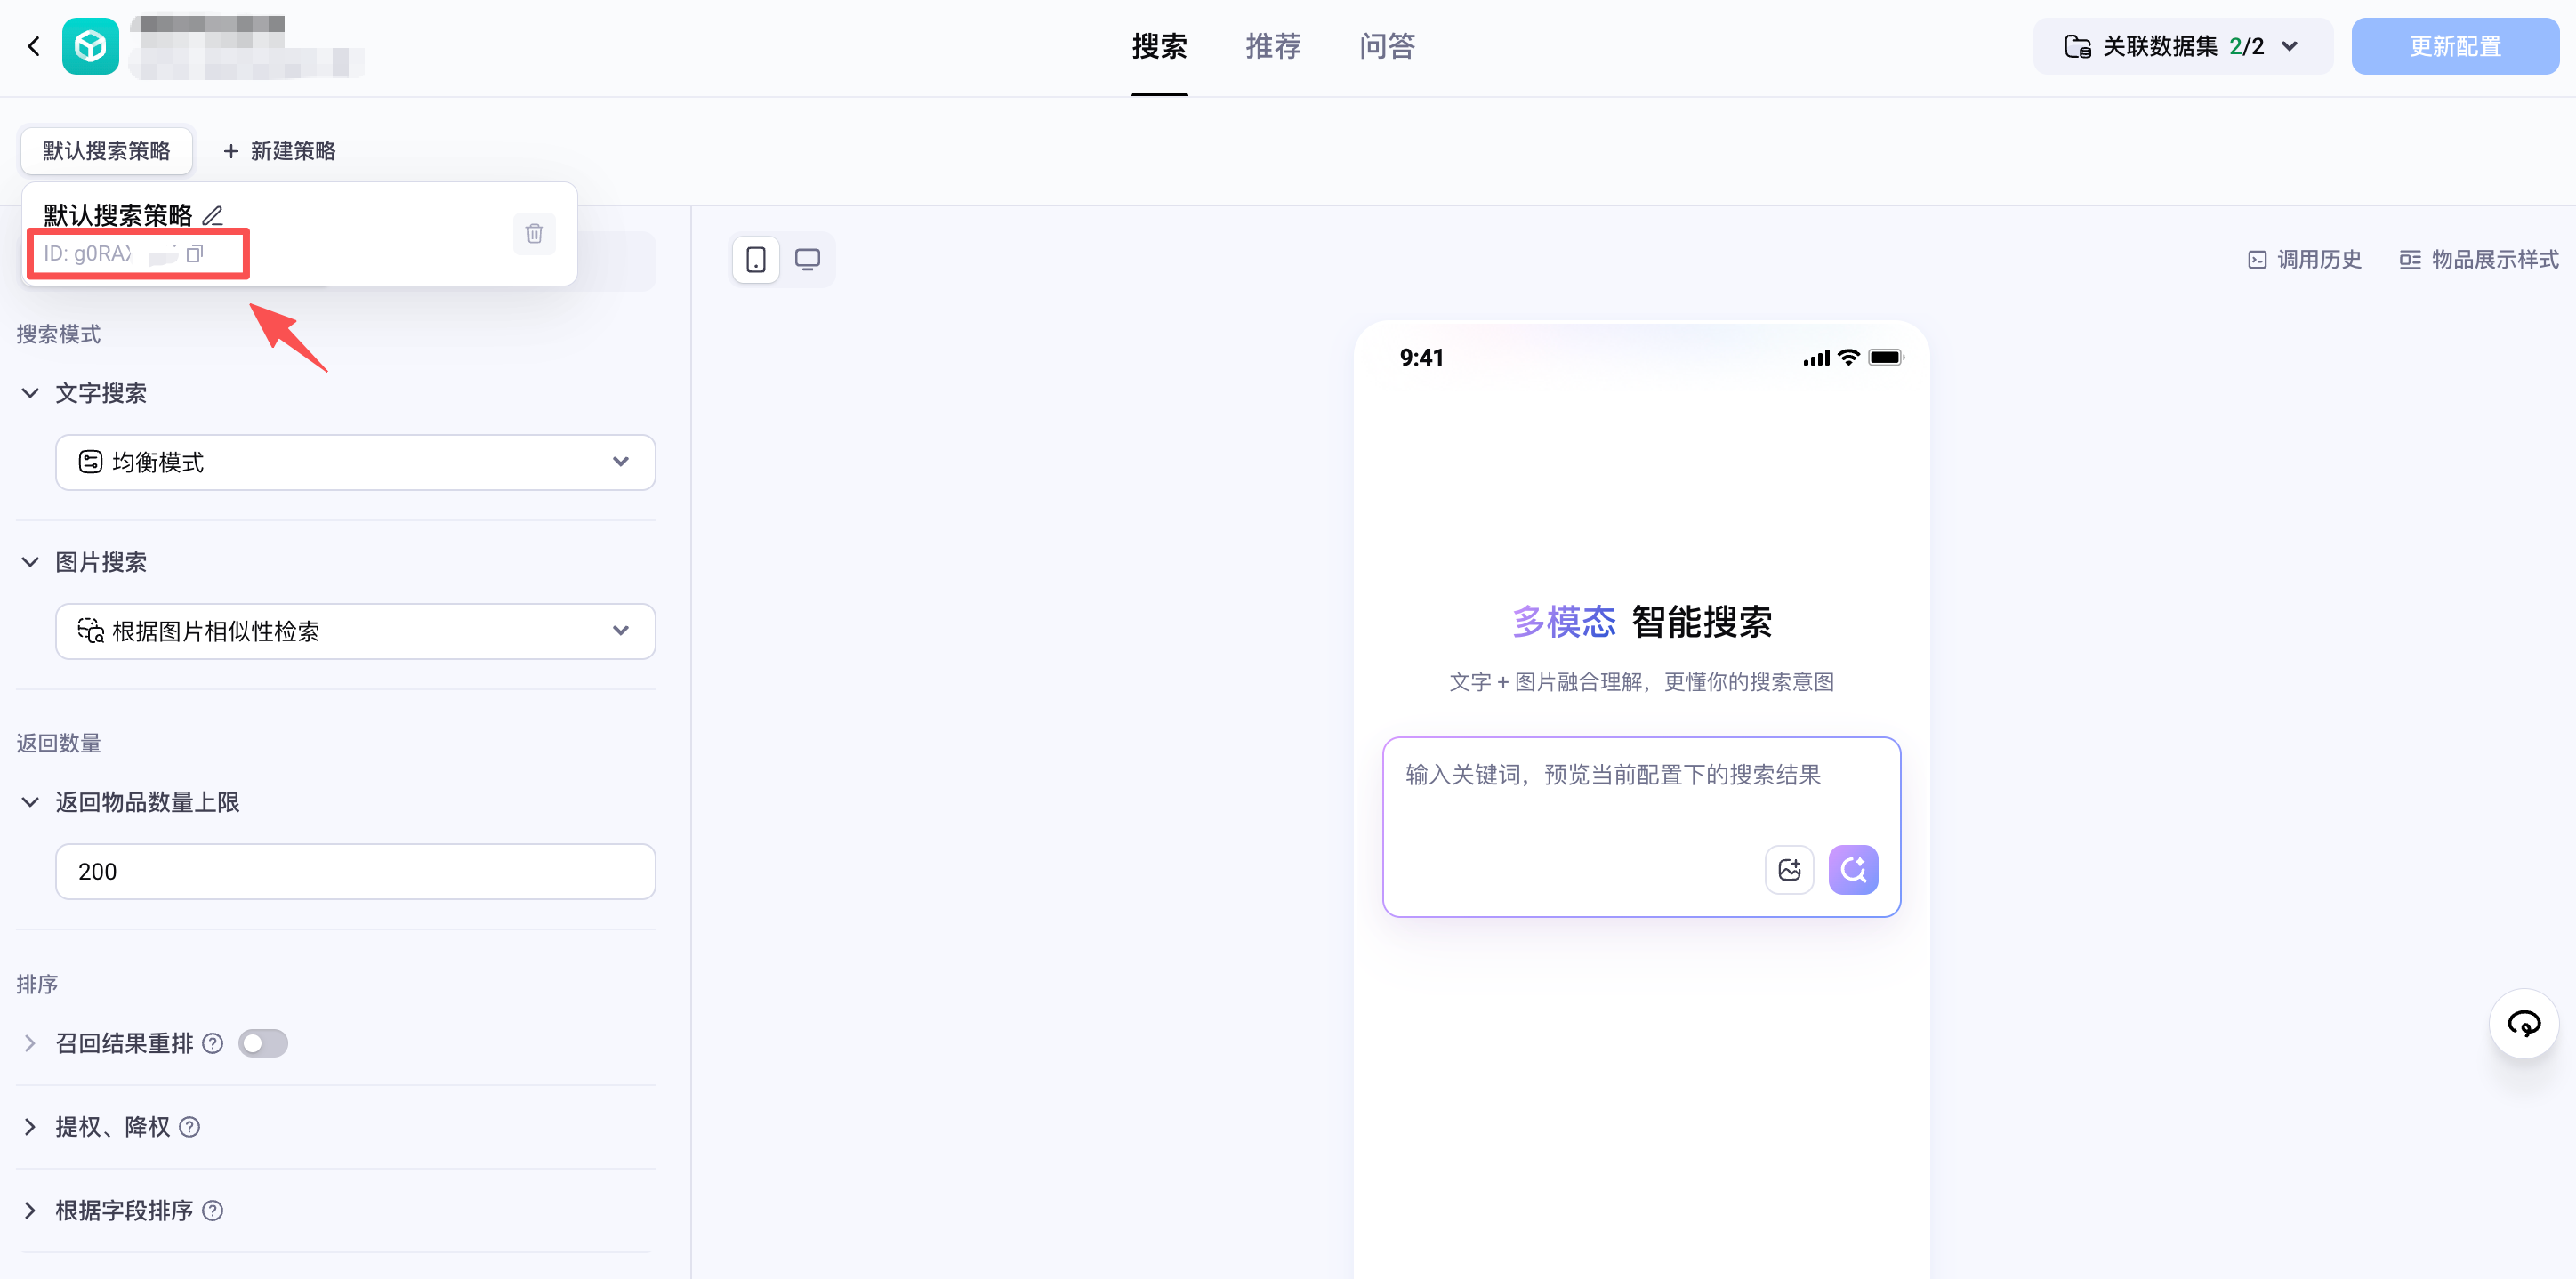
scene_id | String | 必选 | sceneIda | 在控制台体验配置页面新建搜索策略后,系统指定的策略唯一标识,用户可在控制台「搜索体验」— 鼠标悬停策略名称 — 复制策略 ID。 |
Body 参数
参数 | 类型 | 是否必选 | 示例值 | 描述 |
参数 | 类型 | 是否必选 | 示例值 | 描述 |
query | 必选 | { "text":"同款鞋", "image_url":{base64图片文件} } | ||
dataset_id | string | 必选 | "106265704" | 数据集 id,可在数据集列表或数据集详情页中查看。调用直接搜索功能时,必须在每次请求中明确指定所要搜索的数据集 ID。 |
page_number | int | 必选 | 1 | 搜索页码,可用于列表分页功能,从 1 开始。例如:"page_number": 1,即返回第一页的搜索结果。 |
page_size | int | 必选 | 20 | 每页搜索结果的数量,可以传入1~您在控制台设置的最大返回数量。 为了保障端侧加载数据展示的性能和耗时,建议您设置每页大小不超过 100,通过翻页加载更多数据 默认设置:10 |
user | User | 可选 | { "_user_id":"U90E89FF8045" } | 传入User对象输入搜索的用户信息,可上传用户pseudo ID,用于明确是哪一位具体的用户触发了本次 API 调用。 |
filter | 可选 | 搜索过滤条件对象,可根据应用数据源配置中支持过滤的字段对检索内容进行过滤。
| ||
sort_by | string | 可选 | "create_at" | 用于排序的字段名称。该字段必须存在于数据集中,且在应用中已勾选“用于过滤”,支持支持以下类型:
|
sort_order | string | 可选 | "desc" | 排序顺序,支持枚举值:"desc"|"asc":
|
output_fields | array(string) | 可选 | ["title", "price", "category"] | 指定搜索列表的'display_fields'返回中,选择物品数据集数据中的哪些字段来返回展示,如果不传则返回所有字段。 如果数据集中存在嵌套的对象(object或array<object>),则只支持传入上层的字段名。 传入不存在的字段或object内层的字段会被忽略。 |
context | object(context) | 可选 | 支持配置请求环境上下文(context),当前可支持传入发起搜索用户所处的地理位置信息。 | |
conditional_boost | array(conds) | 可选 | ||
disable_personalize | Boolean | 可选 | false | 是否关闭搜索「个性化」能力 默认为 false。 入参true时,搜索只会根据以下两方面对搜索结果进行排序:
入参false时,在上述基础上,还支持根据以下方面对搜索结果进行干预:
|
query_keyword_match_percent | float | 可选 | 0.8 | 用于指定 query 关键词在 ES 检索召回时的匹配度阈值,取值范围为 [0,1] ,示例说明如下:
该参数不传时,默认为 1 。 |
facet | 可选 | 用于指定搜索结果的分类统计字段,以及搜索分类筛选的条件,可根据指定的字段条件对搜索结果进行分类筛选过滤。
| ||
sort_rules | 可选 | "sort_rules": { "mode": "merge", "rules": [ { "field": "updated_at", "order": "desc" } ] } | 在搜索相关性相近的结果中,用该参数定义的排序规则进行排序。 该参数与 sort_by 、sort_order 的主要区别在于: sort_by 不考虑搜索结果的相关性,直接全局按字段排序,如果您想在保障搜索结果相关性的前提下,又能在一定程度上干预搜索结果排序,可以使用sort_rules。 使用sort_rules时,搜索结果会先按相关性排列,再对相同相关性档位的结果按规则排序,可以保障低相关物品不会因排序规则排到高相关物品前。 |
数据结构
Query
参数 | 类型 | 是否必选 | 示例值 | 描述 |
参数 | 类型 | 是否必选 | 示例值 | 描述 |
text | string | 至少一个必选 | "女鞋 春夏" "三体" | 文本查询词 |
image_url | string | | "data:image/jpeg;base64,iVBUAAAA..." "www.example.com/image.png" | 图片搜索 关联视频数据集的应用暂不支持图片搜索。 |
image_query_instruction | string | 传入image_url字段时可选 | “基于图片的整体内容召回相似的图片,而不是仅关注图片中的局部信息“ | 图片搜索指令,该字段用于以图搜图场景下增强搜图效果 |
Query 中上传图片
在query.image_url 中传入的图片,我们支持传入图片链接(建议)或 base64格式的图片文件
限制
传入图片需要满足以下条件:
支持格式:jpeg、png、 webp、bmp、tiff、icns。其中,tiff 、icns 格式图片,需要保证和元数据对齐,如在对象存储中正确设置文件元数据,否则会解析失败。
宽高比(宽/高):在范围[1/100, 100] 。
边长: [10, 6000] px,即短边像素需大于 10 px,长边像素需小于6000 px。
方案 1: 图片链接(建议)
请确保图片链接公网可读取,并且在访问图片链接时,触发图片预览而不是图片下载。
方案 2: base64格式
请确保Base64编码符合标准格式,包含数据头(Data URI Scheme)与 Base64 编码正文两部分:
data:[<MIME类型>];base64,<Base64编码字符串>
组成部分 | 格式要求 | 说明 | 示例 |
组成部分 | 格式要求 | 说明 | 示例 |
数据头前缀 | 固定为 data: | 标识该字符串为 Data URI 格式,不可省略或修改 | - |
MIME 类型 | 需与图片实际格式严格匹配 | 用于服务端识别图片类型,禁止随意填写(如 JPG 图填 PNG 的 MIME) | JPG/JPEG:image/jpeg;PNG:image/png;WebP:image/webp |
分隔符 | 固定为 ;base64, | 连接 MIME 类型与 Base64 编码正文,分号、“base64”、逗号均不可省略或替换 | - |
Base64 编码正文 | 符合 RFC 4648 标准的 Base64 编码字符串 | 由图片文件二进制数据直接编码生成,禁止包含空格、换行符、特殊字符,需为连续的 ASCII 字符串 | |
User
参数 | 类型 | 是否必选 | 示例值 | 描述 |
参数 | 类型 | 是否必选 | 示例值 | 描述 |
_user_id | string | 可选 | "ldy_199432" | 代表最终用户的唯一标识符。 该字段用于明确是哪一位具体的用户触发了本次 API 调用,对于区分来自同一组织下的不同使用者至关重要。 例如,它可以帮助您记录详细的操作日志、进行个性化推荐或分析不同用户的行为模式。建议为每个不同的最终用户分配并传递一个唯一的 ID。 |
Filter
参数 | 类型 | 是否必选 | 示例值 | 描述 |
参数 | 类型 | 是否必选 | 示例值 | 描述 |
op | string | 必选 | "must" | 算子类型,支持: "must"、"must_not"、"range"、"and"、"or" |
field | string | 条件必选 | "status" | 需要应用过滤条件的字段。
|
gte | Float | 可选 | 100.0 | "range" 算子的过滤范围,语义为过滤"field"字段值大于等于指定值的数据。 |
gt | Float | 可选 | 100.0 | "range" 算子的过滤范围,语义为过滤"field"字段值大于指定值的数据。 |
lte | Float | 可选 | 500.0 | "range" 算子的过滤范围,语义为过滤"field"字段值小于等于指定值的数据。 |
lt | Float | 可选 | 500.0 | "range" 算子的过滤范围,语义为过滤"field"字段值小于指定值的数据。 |
conds | array | 条件必选 | 见下方示例 | 除 "range" 算子之外,其余算子均需指定conds条件。
|
Filter各算子(op)示例
算子 | 被过滤字段(field)类型 | 算子含义说明 | 示例 |
算子 | 被过滤字段(field)类型 | 算子含义说明 | 示例 |
must |
| 条件表达式参数写法:
当field为整数、字符串的单个元素,含义为“属于”,即“字段中的值属于传入的过滤列表”。 当field为整数、字符串列表,含义为“有交集”,即“目标字段和过滤列表中的元素有重叠” | 示例一:地区必须属于"cn"或"sg"其中之一 { "op": "must", "field": "region", "conds": ["cn", "sg"] } 示例二:status值必须属于1,2,3其中之一 { "op": "must", "field": "status", "conds": [1, 2, 3] } |
must_not |
| 条件表达式参数写法:
当field为整数、字符串的单个元素,含义为“不属于”,即“目标字段值不在过滤列表中” 当field为整数、字符串列表,其含义为“没有交集”,即“目标字段和过滤列表中的元素不重叠” | status值必须不能为1,2,3其中任何一个 { "op": "must_not", "field": "status", "conds": [1, 2, 3] } |
range |
| 条件表达式参数写法:
含义为目标数值字段值必须在指定范围内。 配置使用gte(大于等于), gt(大于), lte(小于等于), lt(小于),用以圈选数值范围。 | price >= 100.0 { "op": "range", "field": "price", "gte": 100.0 } price 在100.0到500.0之间 { "op": "range", "field": "price", "gte": 100.0, "lt": 500.0 } |
time_range | 被过滤字段需要上传标注为“上新时间”属性的字段,支持:
| 条件表达式参数写法:
目标过滤字段必须满足在一个时间段内。gt 和 lt 传入值支持:
| 发布时间在2026年之后 { "op": "time_range", "field": "publish_time", "gt": 1767196800000, } 发布时间在最近前一个月内 { "op": "time_range", "field": "publish_time", "gt": "now-30d", } |
geo_distance | 该字段在你的物品数据集中必须是 对象(Object) 类型,且必须包含名为 latitude(纬度)和 longitude(经度)的两个子字段。不支持对象列表(List of Object)。 | 条件表达式参数写法:
| 示例一:使用用户当前位置作为基准点 此示例筛选出 store_location 字段距离用户当前位置(通过 context.location 传入)5 公里以内的所有物品。 { "query": { "text": "附近的湘菜馆" }, "context": { "location": { "longitude": "116.412138", "latitude": "39.914912" } }, "filter": { "op": "geo_distance", "field": "store_location", "radius": "5km" } } 示例二:使用指定经纬度作为基准点 此示例筛选出 store_location 字段距离特定经纬度坐标(121.4737,31.2304)10000 米以内的所有物品。 { "query": { "text": "上海人民广场附近的酒店" }, "filter": { "op": "geo_distance", "field": "store_location", "center": "121.4737,31.2304", "radius": "10000m" } } |
and | 不涉及 | 逻辑算子,针对逻辑查询需求,对多个条件取交集。 | { "op": "and", "conds": [ // 条件列表,支持嵌套and/or/must/must_not/range 算子 { "op": "must", "field": "status", "conds": [1, 2, 3] }, { ... // 支持>=1的任意数量的条件进行组合 } ] } |
or | 不涉及 | 逻辑算子,针对逻辑查询需求,对多个条件取并集。 | { "op": "or", "conds": [ // 条件列表,支持嵌套and/or/must/must_not/range 算子 { "op": "must", "field": "status", "conds": [1, 2, 3] }, { ... // 支持>=1的任意数量的条件进行组合 } ] } |
Context
参数 | 示例值 | 描述 |
参数 | 示例值 | 描述 |
location | { "latitude": "12.12", "longitude": "-13.43" } |
|
Facet
参数 | 类型 | 是否必选 | 示例值 | 描述 |
参数 | 类型 | 是否必选 | 示例值 | 描述 |
facets | Array <facets> | 否 | "facets": [ { "field": "tags", // 指定字符串类型字段用于分类聚合统计 "max_facet_buckets": 10 // 取统计值最大的N个,默认10,[1, 50] }, { "field": "price", // 指定数值类型字段用于分类聚合统计 "number_ranges": [ {"gte": 0, "lt": 19}, {"gte": 10, "lt": 100}, {"gte": 200, "lt": 999} // 可自定义数值区间 ] } ] | 传入 facets 对象,指定针对搜索结果聚合统计的维度字段、数值区间、最多返回多少个枚举值。 未传入时,默认使用 控制台 - 体验配置 - 搜索结果分类统计 功能中已配置好的字段进行聚合统计 |
facet_filter | facet_filter | 否 | "facet_filter":[ { "op": "must", "field": "region", "conds": ["cn", "sg"] }, { "op": "must_not", "field": "status", "conds": [1, 2, 3] } ] |
facets
参数 | 类型 | 是否必选 | 示例值 | 描述 |
参数 | 类型 | 是否必选 | 示例值 | 描述 |
field | String | 必选 | "brand" | 用于聚合统计的字段名 |
number_ranges | Array<NumberRange> 其中 NumberRange 为 OBJECT 类型 | 非必选 默认为空 | { "gte": 0, "lt": 19} | 如果指定了数值类型(int、float、Array<int>、Array<float>)的字段作为分类统计字段,建议预设数值区间,基于数值区间对搜索结果进行聚合统计。 目前支持 4 种定义数值区间的操作符:
如果未传入参数,则默认按字段原值进行聚合统计。 |
max_facet_buckets | Int | 非必选 默认值为10 | 10 | 用于设置每个字段最多返回多少个枚举值的聚合统计结果,默认是 10 ,上限是 50 。 如果未传入,则按默认值 10 处理。 |
SortRules
参数 | 类型 | 是否必选 | 示例值 | 描述 |
参数 | 类型 | 是否必选 | 示例值 | 描述 |
mode | String | 可选 | merge | 字符串枚举:merge / override。
|
rules | repeated SortRule | 必选 | 详情可见下方说明 | 即通过 API 指定的排序规则列表。 参数详情见下方说明。 |
repeated SortRule
参数 | 类型 | 是否必选 | 示例值 | 描述 |
参数 | 类型 | 是否必选 | 示例值 | 描述 |
field | String | 必选 | "price" | 指定排序规则需要用的字段,支持以下类型:
|
order | String | 必选 | "desc" | 排序顺序,支持枚举值:"desc"|"asc":
|
响应参数
请求响应
参数 | 类型 | 示例值 | 描述 |
参数 | 类型 | 示例值 | 描述 |
request_id | string | 25ee998a-5462-9385-9f18-035f1da7a6e5 | 用于唯一标识一次请求,可根据request_id快速定位一次请求的执行。 |
spell_correction | SpellCorrection | | 触发搜索词纠正时,返回搜索纠正的模式配置和纠正后的搜索词建议。 |
result | Result | | 搜索结果。 |
total_items | int | 200 | 返回的搜索结果总数 |
facet_results | | 针对搜索结果进行分类统计的结果 |
数据结构
SpellCorrection
参数 | 类型 | 示例值 | 描述 |
参数 | 类型 | 示例值 | 描述 |
mode | string | "suggestion_only" | 在控制台配置的纠错模式,返回2个枚举值:
|
corrected_query | string | "4K显示屏电视" | 纠正后的搜索query,返回空时代表没有需要纠错的搜索词 |
Result
参数 | 类型 | 示例值 | 描述 |
参数 | 类型 | 示例值 | 描述 |
search_results | | 搜索结果列表。 | |
total_items | int | 300 | 搜索结果总量,即候选数量。可在应用配置中调整最大召回物品量,但最终的数量取决于数据源中相关数据的总量。 |
SearchResult
参数 | 类型 | 示例值 | 描述 |
参数 | 类型 | 示例值 | 描述 |
_id | string | "WSHOE001" "video_900026" | 该数据在数据存储中的主键,源于您上传内容中字段属性为唯一标识的字段的值。 |
display_fields | object | 图文数据: { "item_id": "WSHOE001", "title": "舒适通勤 尖头浅口高跟鞋 - 黑色", "category": "女士高跟鞋", "status": 1 } 视频数据: { "_video_generated_summary":"叶文洁为防止发射信号的事被雷志成上报,制造故障引其和杨卫宁下悬崖并锯断绳子将二人杀害,史强因核辐射住院,叶文洁回忆起在齐家屯感受到人间温暖及后续经历,同时作战中心截获三体信息,汪淼和史强进入三体游戏遇到 1379 号监听员。", "video_generated_title":"叶文洁承认杀害雷志成", "content_id":"video_900026", "content_type":"video", "parent_content_id":"collection_342534", "sequence_index":26, "video_url":["http://xxxx.mp4"], "my_title":"三体第二十六集" } | 数据集其他字段,与数据导入时的字段一致。 |
score | Float | 0.852 | 多路召回合并后的分数 |
recall_info | array<object> | [ { "recall_reason": "es_recall", "recall_score": 14.698571, "recall_rank": 2 }, { "recall_reason": "text'", "recall_score": 0.7 }, { "recall_reason": "vlm'", "recall_score": 0.5 } ] | 记录每一路召回的信息。 recall_reason 指召回方式,目前支持两种“text-文本召回;vlm-图片召回 recall_score 指在该路召回时的相关性分数 recall_rank 指在该路召回时的相对顺序 |
rerank_info | object | { "is_reranked": true, "rerank_score":0.993242 } | 召回数据重排信息,表示该数据是否是否重排以及重排得分;未重排的数据不存在rerank_score字段。 |
FacetResult
参数 | 类型 | 示例值 | 描述 |
参数 | 类型 | 示例值 | 描述 |
field | string | "category" | 分类字段 |
buckets | Array<buckets> | [ {"value": "iphone", "count": 2345}, {"value": "vivo", "count":230}, {"value": "xiaomi", "count": 100} ] | 基于字段值进行分类聚合统计的结果 |
接口示例
关联图文数据集的应用
请求示例
curl -X POST 'https://aisearch.cn-beijing.volces.com/api/v1/application/${application_id}/search/${scene_id}' \
-H 'Content-Type: application/json' \
-H 'Authorization: Bearer <API Key>' \
-d '{
"query": {
"text": "女鞋 春夏"
},
"page_number": 1,
"page_size": 5,
"user": {
"_user_id": "ldy_199432"
},
"filter": {
"op": "must",
"field": "status",
"conds": [1, 2]
},
"dataset_id": "106265704",
"context": {
"location":{
"latitude": "12.12",
"longitude": "-13.43"
}
}
}'
响应示例
{
"request_id": "25ee998a-5462-9385-9f18-035f1da7a6e5",
"result": {
"search_results": [
{
"_id": "WSHOE001",
"display_fields": {
"item_id": "WSHOE001",
"title": "舒适通勤 尖头浅口高跟鞋 - 黑色",
"category": "女士高跟鞋",
"status": 1,
"images": [
]
}
},
{
"_id": "WSHOE002",
"display_fields": {
"item_id": "WSHOE002",
"title": "轻便网面 跑步运动鞋 - 粉色拼灰色",
"category": "女士运动鞋",
"status": 1,
"images": [
]
}
},
{
"_id": "WSHOE003",
"display_fields": {
"item_id": "WSHOE003",
"title": "波西米亚风格 坡跟凉鞋 - 米色",
"category": "女士凉鞋",
"status": 2,
"images": [
]
}
}
],
"spell_correction": {
"mode":"off"
},
"total_items": 300
}
}
关联视频数据集的应用
请求示例
curl -X POST 'https://aisearch.cn-beijing.volces.com/api/v1/application/${application_id}/search/${scene_id}' \
-H 'Content-Type: application/json' \
-H 'Authorization: <火山鉴权的一系列相关header>' \
-d '{
"query": {
"text": "科幻片"
},
"page_number": 1,
"page_size": 5,
"user": {
"_user_id": "ldy_199432"
},
"filter": {
"op": "must",
"field": "director",
"conds": ["郭帆"]
},
"dataset_id": "106265704",
"context": {
"location":{
"latitude": "12.12",
"longitude": "-13.43"
}
}
}'
响应示例
{
"request_id": "25ee998a-5462-9385-9f18-035f1da7a6e5",
"result": {
"search_results": [
{
"_id": "video_900026",
"display_fields": {
"content_id": "video_900026",
"content_type": "video",
"parent_content_id": "collection_342534",
"sequence_index": 26,
"video_url": [
],
"my_title": "三体第二十六集"
}
},
{
"_id": "video_900027",
"display_fields": {
"content_id": "video_900027",
"content_type": "video",
"parent_content_id": "collection_342534",
"sequence_index": 27,
"video_url": [
],
"my_title": "三体第二十七集"
}
},
{
"_id": "video_900028",
"display_fields": {
"content_id": "video_900028",
"content_type": "video",
"parent_content_id": "collection_342534",
"sequence_index": 28,
"video_url": [
],
"my_title": "三体第二十八集"
}
}
],
"spell_correction": {
"mode":"auto",
"corrected_query":"三体电视剧集"
},
"total_items": 300
}
}
错误处理
错误码
HTTP 状态码 | 错误码 | 错误信息 | 含义 |
HTTP 状态码 | 错误码 | 错误信息 | 含义 |
400 | MissingParameter | The request is missing the following parameter: {parameters} | 请求参数缺失错误,如未传入必填参数。 |
400 | InvalidParameter | A parameter in the request is not valid: {parameters} | 参数不合法,如参数类型错误、长度不合法、枚举值不合法、不满足正则规则等。 |
400 | InvalidRequestFormat | The request cannot be parsed in JSON format. | 请求体解析失败,通常是请求体格式异常,是非法的 json 格式或与请求定义的结构不符。请参考对应的 API 文档检查请求结构。 |
400 | InvalidAction | The specified action is invalid: {Action} | 当请求路径中的 Action 不存在或暂时无法请求:
|
说明
最近更新时间:2026.08.09 18:18:18
这个页面对您有帮助吗?
有用
有用
无用
无用