AgentKit
AgentKit
AgentKit


文档指南
请输入


AgentKit
产品动态
快速入门
用户指南
智能体运行时
沙箱模板
沙箱模板管理
技能
A2A 中心
会话与记忆管理
知识库
网关
MCP 接入
身份与权限
快速入门
观测
开发者指南
API参考
Runtime
Sandbox Tool
Skill
A2A
SessionStore
Memory
Knowledge
MCP
DeliveryAI
产品动态
产品计费
开始使用
步骤一:企业管理员-开通并配置服务
- 文档首页
 AgentKitAgentKit用户指南知识库使用知识库知识问答
 复制全文
 下载 pdf
知识问答
 文档反馈
 问问助手
适合用知识库进行大模型多轮问答的场景,基于历史对话信息和参考知识,进行专业回答。
操作步骤
- 登录AgentKit控制台。
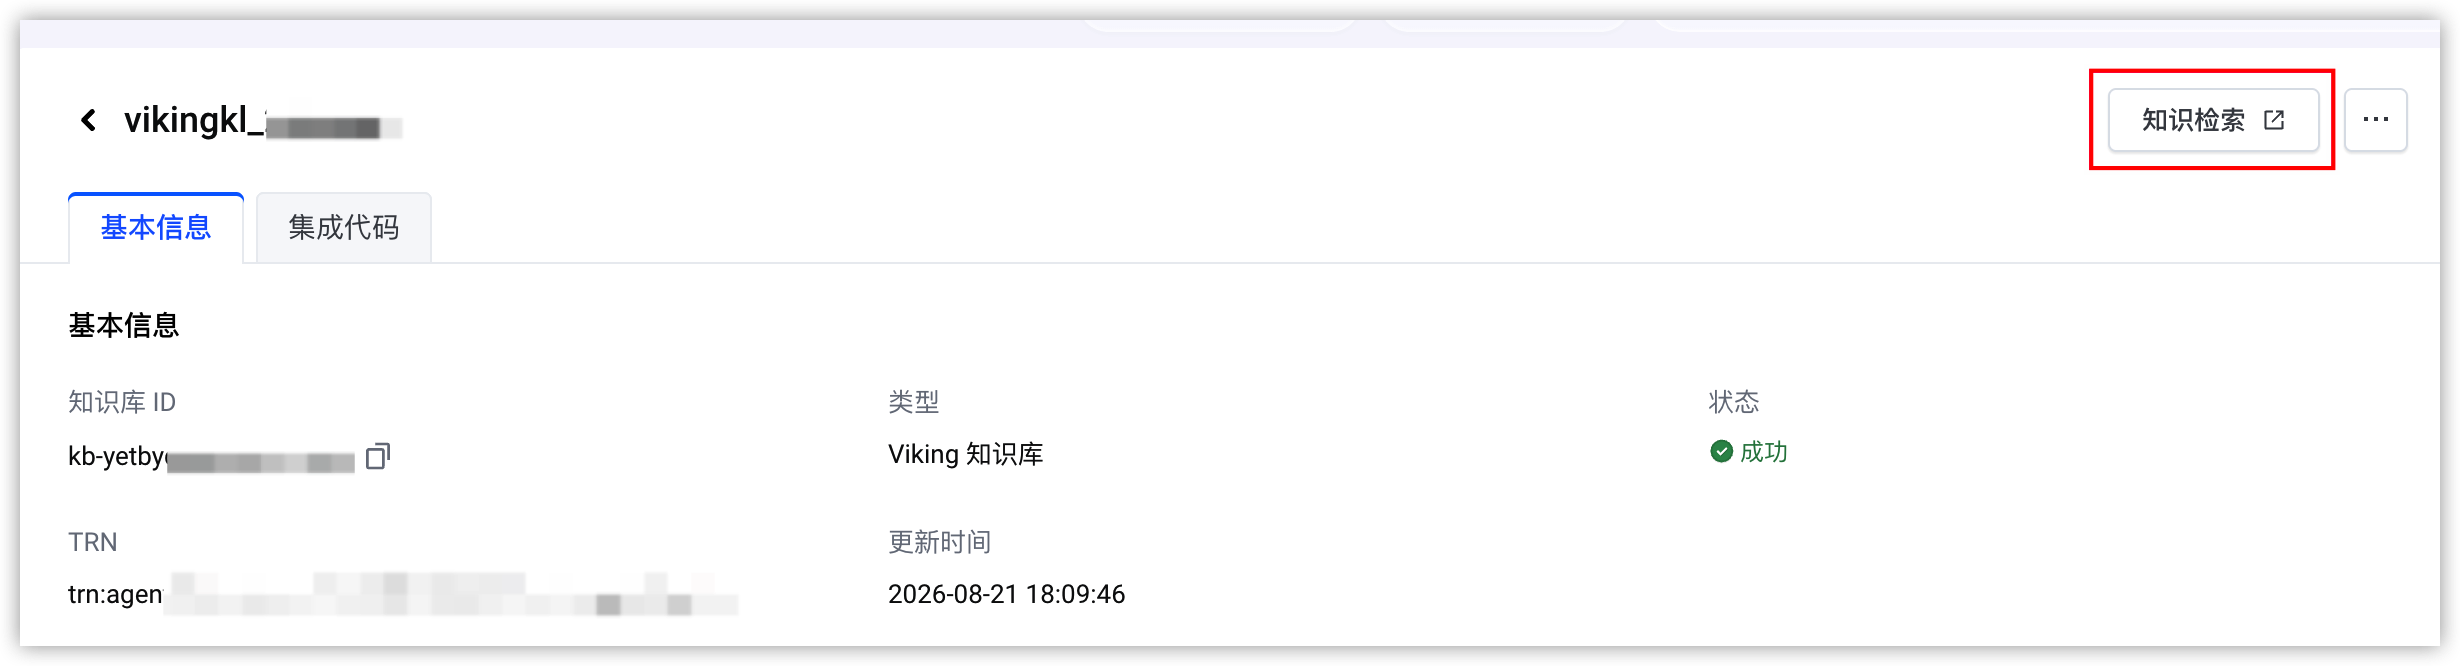
- 在左侧导航树中,选择“知识库”。
- 单击目标知识库名称,进入知识库详情页面。
- 单击页面右上角“知识检索”按钮。
-
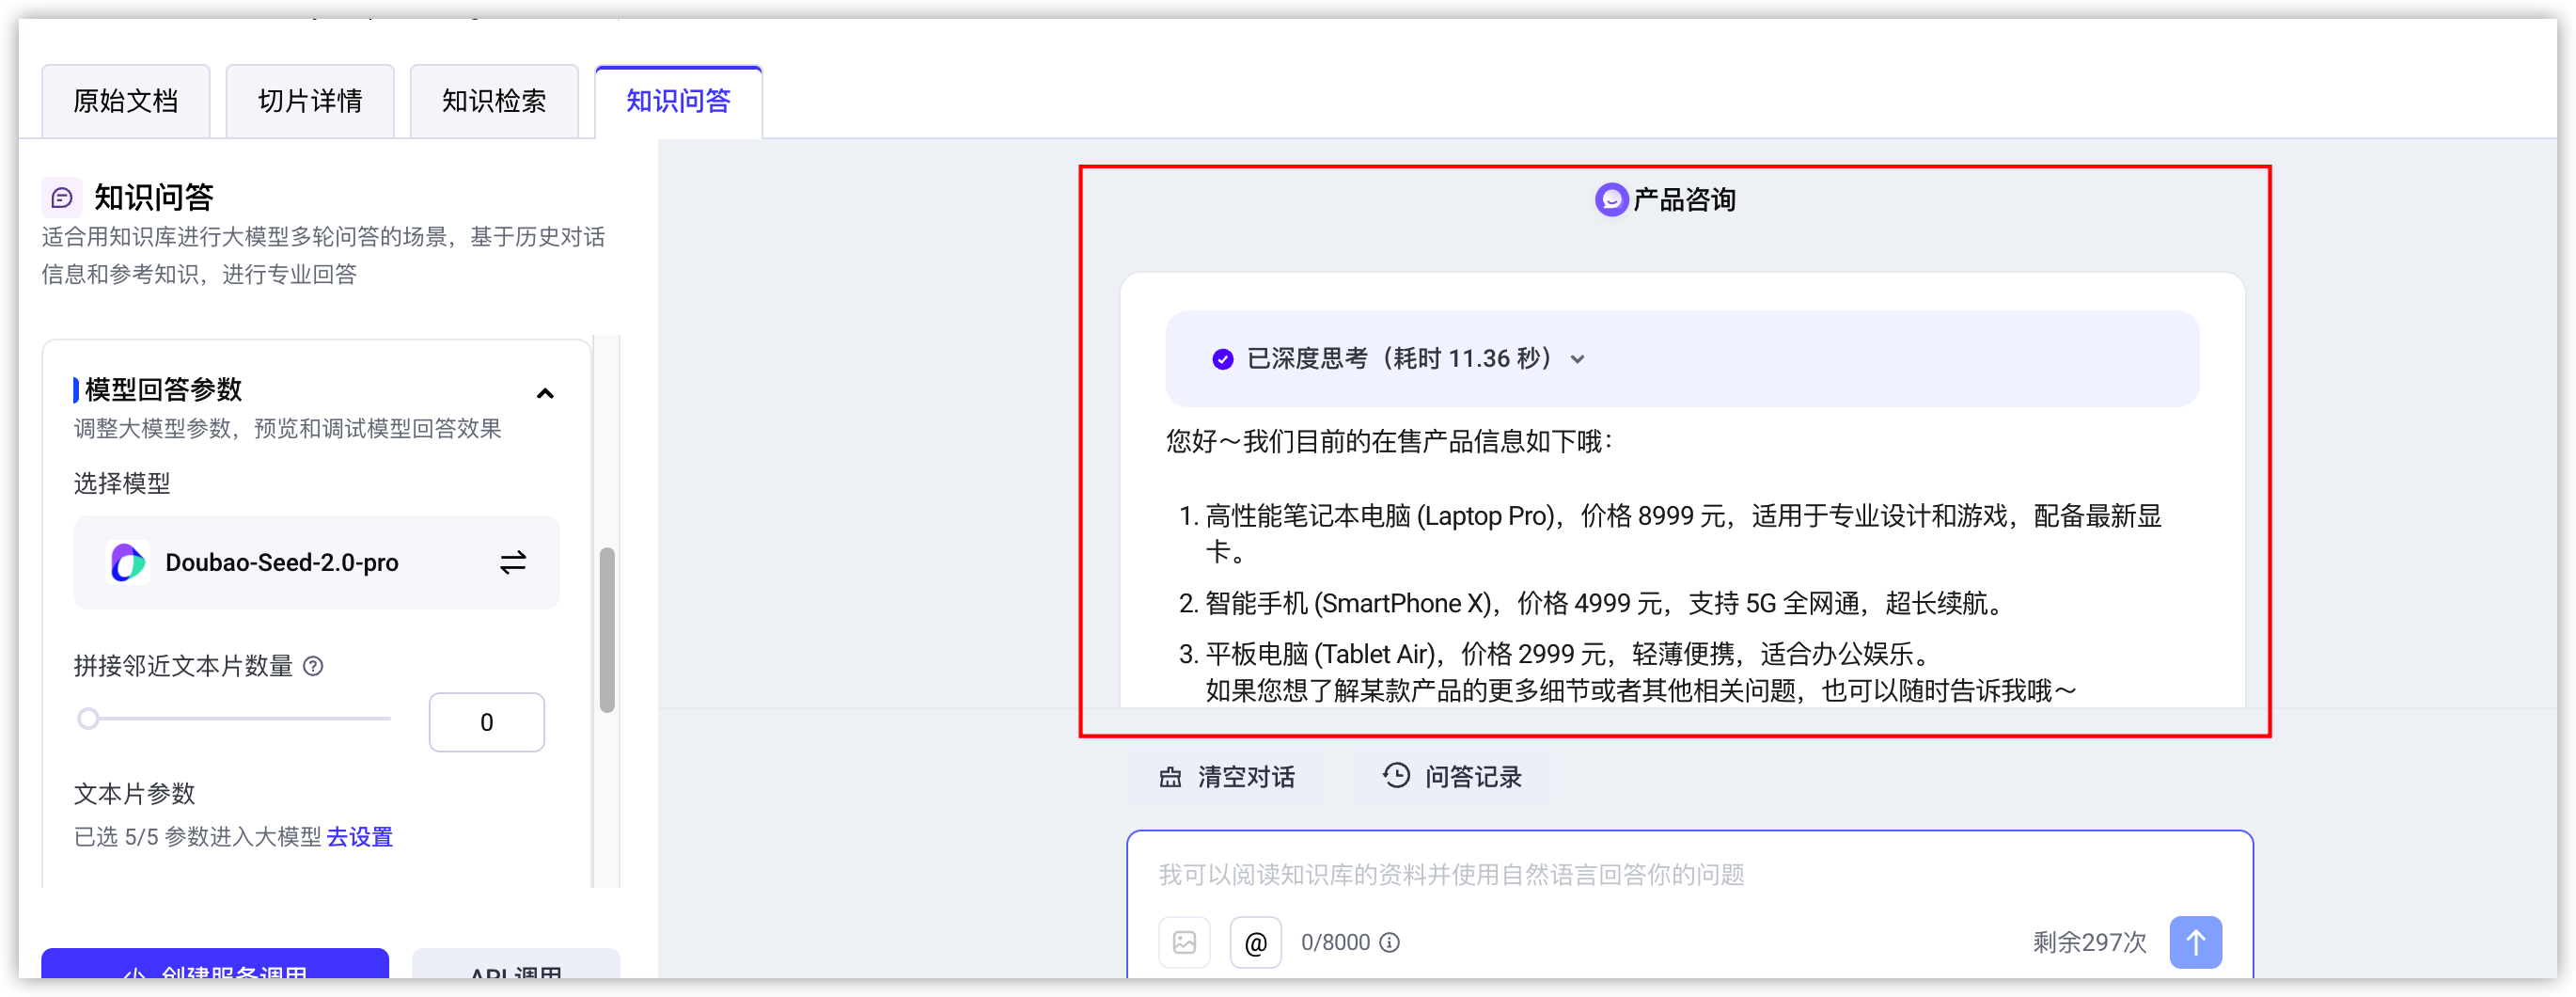
- 单击“知识问答”页签,配置检索参数和模型回答参数。
- 参数作用取值范围检索参数结果返回数量配置最终检索返回的结果数量。
- 如果没有若打开重排模型,则表示检索返回重排后的 TopN 结果数量。
- 如果打开了重排模型,则表示模型排序后的结果的前 K 个文本片,K 为返回的结果数量。
- 如果没有打开重排模型:[1, 1000]
- 如果打开了重排模型:[1, Top K]
问题改写启用后,将基于历史对话对本轮问题进行改写,使其具备更完整的语义信息,检索更准确。说明改写问题会增加检索时长和额外的 Tokens 消耗。默认关闭重排模型配置是否使用重排模型对检索到的文本片进行重新排序。打开重排模型则会获得更准确的问题-文本片相似性的评分,提升检索效果。说明打开后检索的时间会略有增长,且与召回文本数量成正比,建议合理设置召回文本数量。- Doubao-Seed-1.6-rerank(默认):Doubao-Seed-1.6-Rerank 是字节自研的多模态重排序模型,面向文本、图片、视频等多模态内容检索召回得到的 Top-K 候选进行更精细的语义匹配与相关性打分,输出更优的排序结果,可选阈值过滤与instruction设置。
- base-multilingual-rerank:速度快、长文本、支持70+种语言。
- m3-v2-rerank:常规文本、支持100+种语言。
进入重排数量开启“重排模型”后,需配置本参数。用于控制召回的文本片数量,即进入重排模型的文本片数量。说明建议召回数量稍大于结果返回数量,可提升检索效果。25更多参数-Dense Weight在创建知识库时,如果选择的向量化模型和索引算法支持混合检索,则检索时系统会同时考虑问题与候选文本片的语义相关性和字面上的匹配程度,获得更准确的检索结果。Dense Weight 参数用于控制检索时语义相似程度的重要性权重,越偏向 1 表示越倾向于语义检索,越偏向 0 则表示越偏向于关键词匹配检索。[0.2, 1]更多参数-文档聚合排序启用后,将按照原始文档顺序,对召回的切片进行排序聚合,以保证语序和语义正确。说明对于参考资料原文语序敏感的场景建议开启;对于切片内容逻辑独立的场景建议关闭。默认开启模型回答参数选择模型配置知识库问答时使用的大模型,以及版本、推理接入点、思考深度等。--拼接邻近文本片数量取该值作为召回重排后拼接邻近文本片的数量,若召回重排后文本片数为k,该值为p,则最终返回数量范围为[k,k+2kp][0, 5]文本片参数选择进入大模型的参数和顺序,选择后参数将按顺序拼接 Prompt 进入大模型。Prompt 配置当打开使用大模型模型生成回答时可设置。- prompt 编排允许您设置传入大模型模型时如何组装用户问题和检索到的文本片,以及其他的回复要求。
- prompt 编排必须包含两个变量,使用方括号+变量名作为占位符。
- 在组织 prompt 时,您可以给大模型模型一些指示。以贴合您的使用场景。例如,让大模型模型使用检索到的文本作为背景信息回答问题,并在检索到的信息不能回答用户问题时转接人工客服,等等。
说明平台也提供了几个核心场景的 Prompt 模板(客服场景、营销索联、思考阐述、模仿回复),您可以根据需要进行选择。--引用开源开启后,回答末尾将展示引用的知识切片来源。--图文混排开启后,若大模型的参考包含图片,则图片与文本同步显示在回复中。--API 调用保存设置后,您可以单击“API 调用”按钮获得 API 调用的请求体,便于您将调试好的设置嵌入您的应用当中。--
- 提出您要提问的问题。
- 模型将检索到的文本片组装到prompt编排区域的prompt中,再输入大模型模型,由大模型模型根据检索到的背景信息回答问题。更多关于问答测试详情,请参见问答测试。
-
最近更新时间:2026.08.28 10:22:37
这个页面对您有帮助吗?
有用
有用
无用
无用