应用性能监控全链路版
应用性能监控全链路版


文档指南

请输入


- 文档首页
 应用性能监控全链路版用户指南应用性能监控使用指南服务监控
 复制全文
 下载 pdf
服务监控
 文档反馈
 问问助手
服务监控整合了Trace、Metrics、日志、基础监控等和服务有关联的信息,提供了服务列表、全局服务拓扑、服务总览、实例分析等便捷的监控能力。
前提条件
全局服务拓扑
全局拓扑可以帮助您快速梳理整体服务架构、上下游调用关系,并且可以实时看到各个服务间调用的成功率,快速发现问题服务。
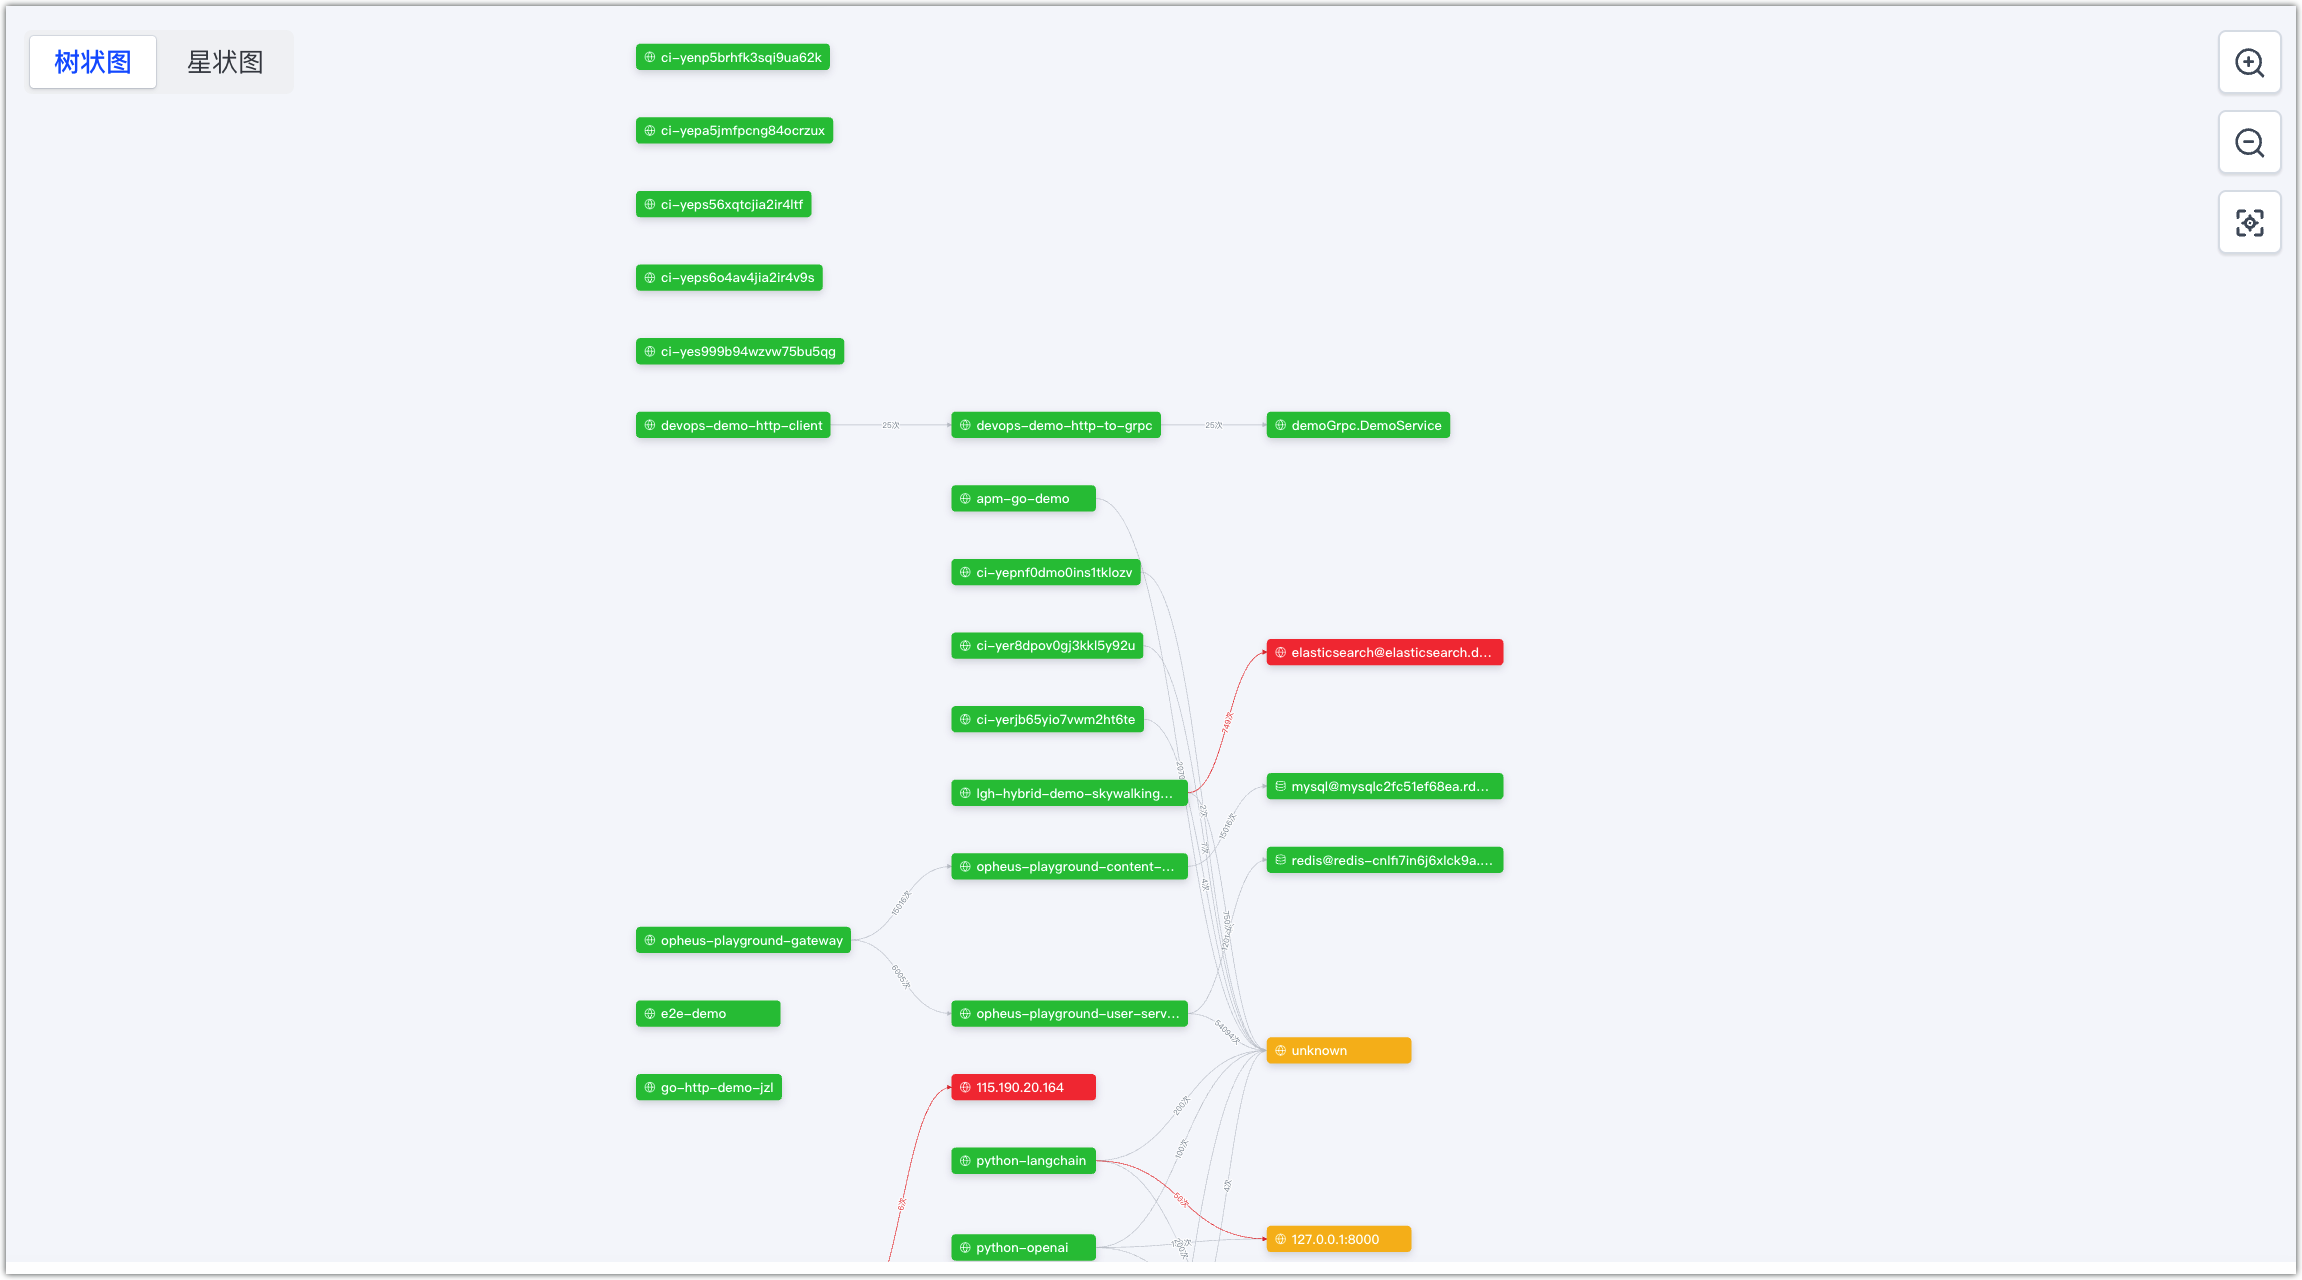
服务拓扑页面说明:
- 服务拓扑默认展示树状图,您可以根据需求切换为星状图。
- 树状图:展示层级的关系,更清晰的查看服务之间的调用顺序和链路。
- 星状图:展示分组的关系,更直观的了解有几条服务链路。
- 服务用点
- 点的大小:服务被调用次数关联,次数越多越大。
- 点的颜色:服务成功率关联,根据用户在配置中配置的阈值,分别展示为:
- 绿色:满意
- 黄色:一般
- 红色:较差
- 调用关系用线
- 红色(较差):用于标记失败率高于50%的调用
- 单击拓扑图中的节点,右侧将弹出 服务指标详情 面板,展示了该节点的调用 QPS、错误率、延迟等核心指标,并提供以下快捷跳转入口:
- 中间件节点:中间件详情
服务列表
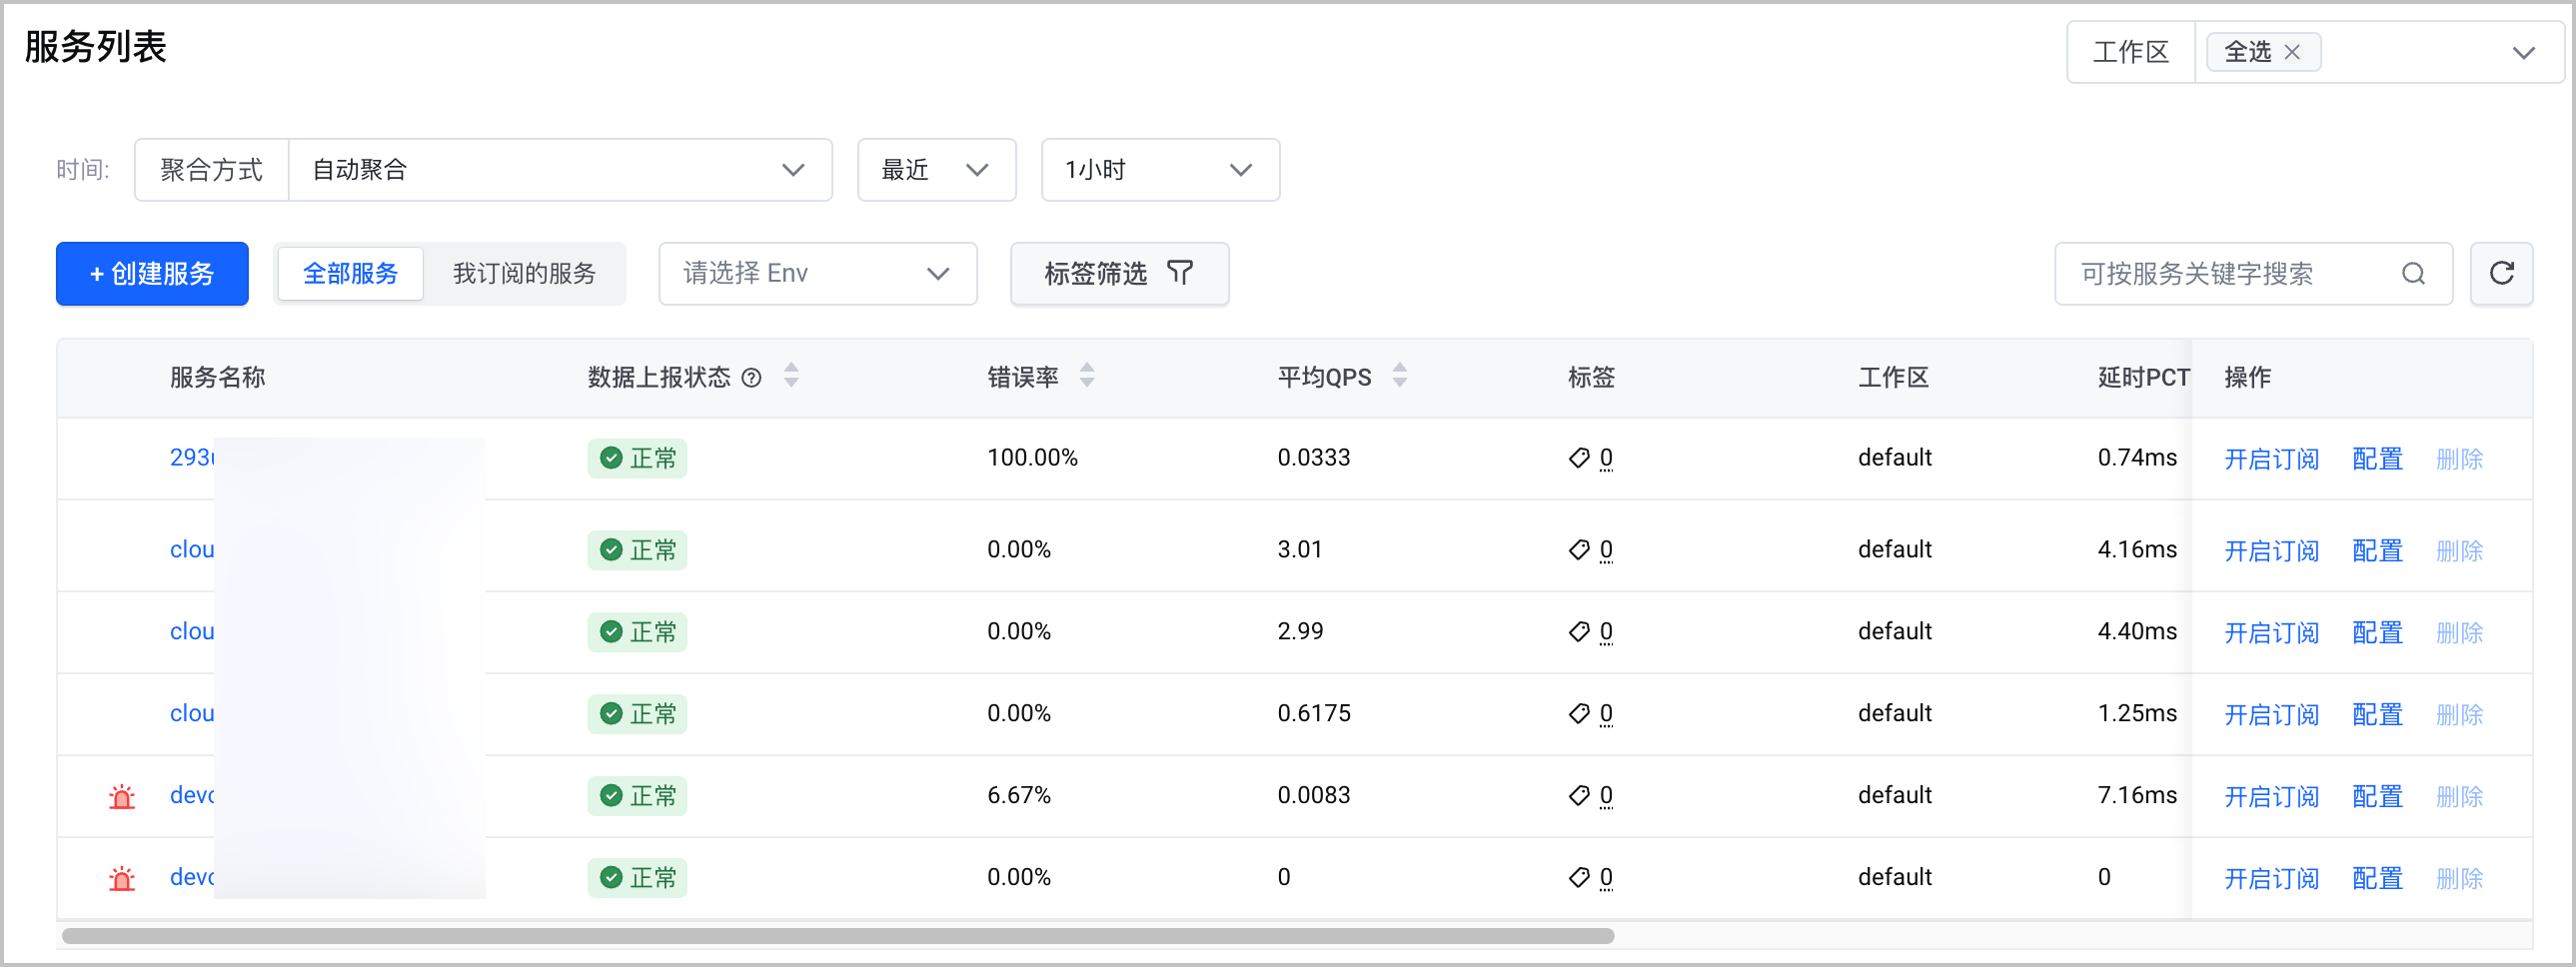
- 接入监控的服务,启动后会自动添加到服务列表,也可以在服务启动前手动创建服务信息。
- 列表展示服务名称、服务类型、运行状态、错误率、QPS、延时、CPU使用率、内存使用率、最近查看时间等信息。所有指标均支持排序。
- 支持根据服务名称进行关键字搜索。
- 支持订阅、配置和删除服务。通过配置服务,可以修改采样配置和接口配置,配置相关详细说明参见:参数管理。
注意
- 服务自定义配置的优先级高于参数管理中工作区维度的参数配置,例如:参数管理和服务均配置采样规则时,实际以服务自定义配置的采样规则为准。
- 服务级别的采样配置仅对当前服务所生成的根跨度(root span)有效。
服务详情
服务详情页面涉及的指标说明:
服务总览
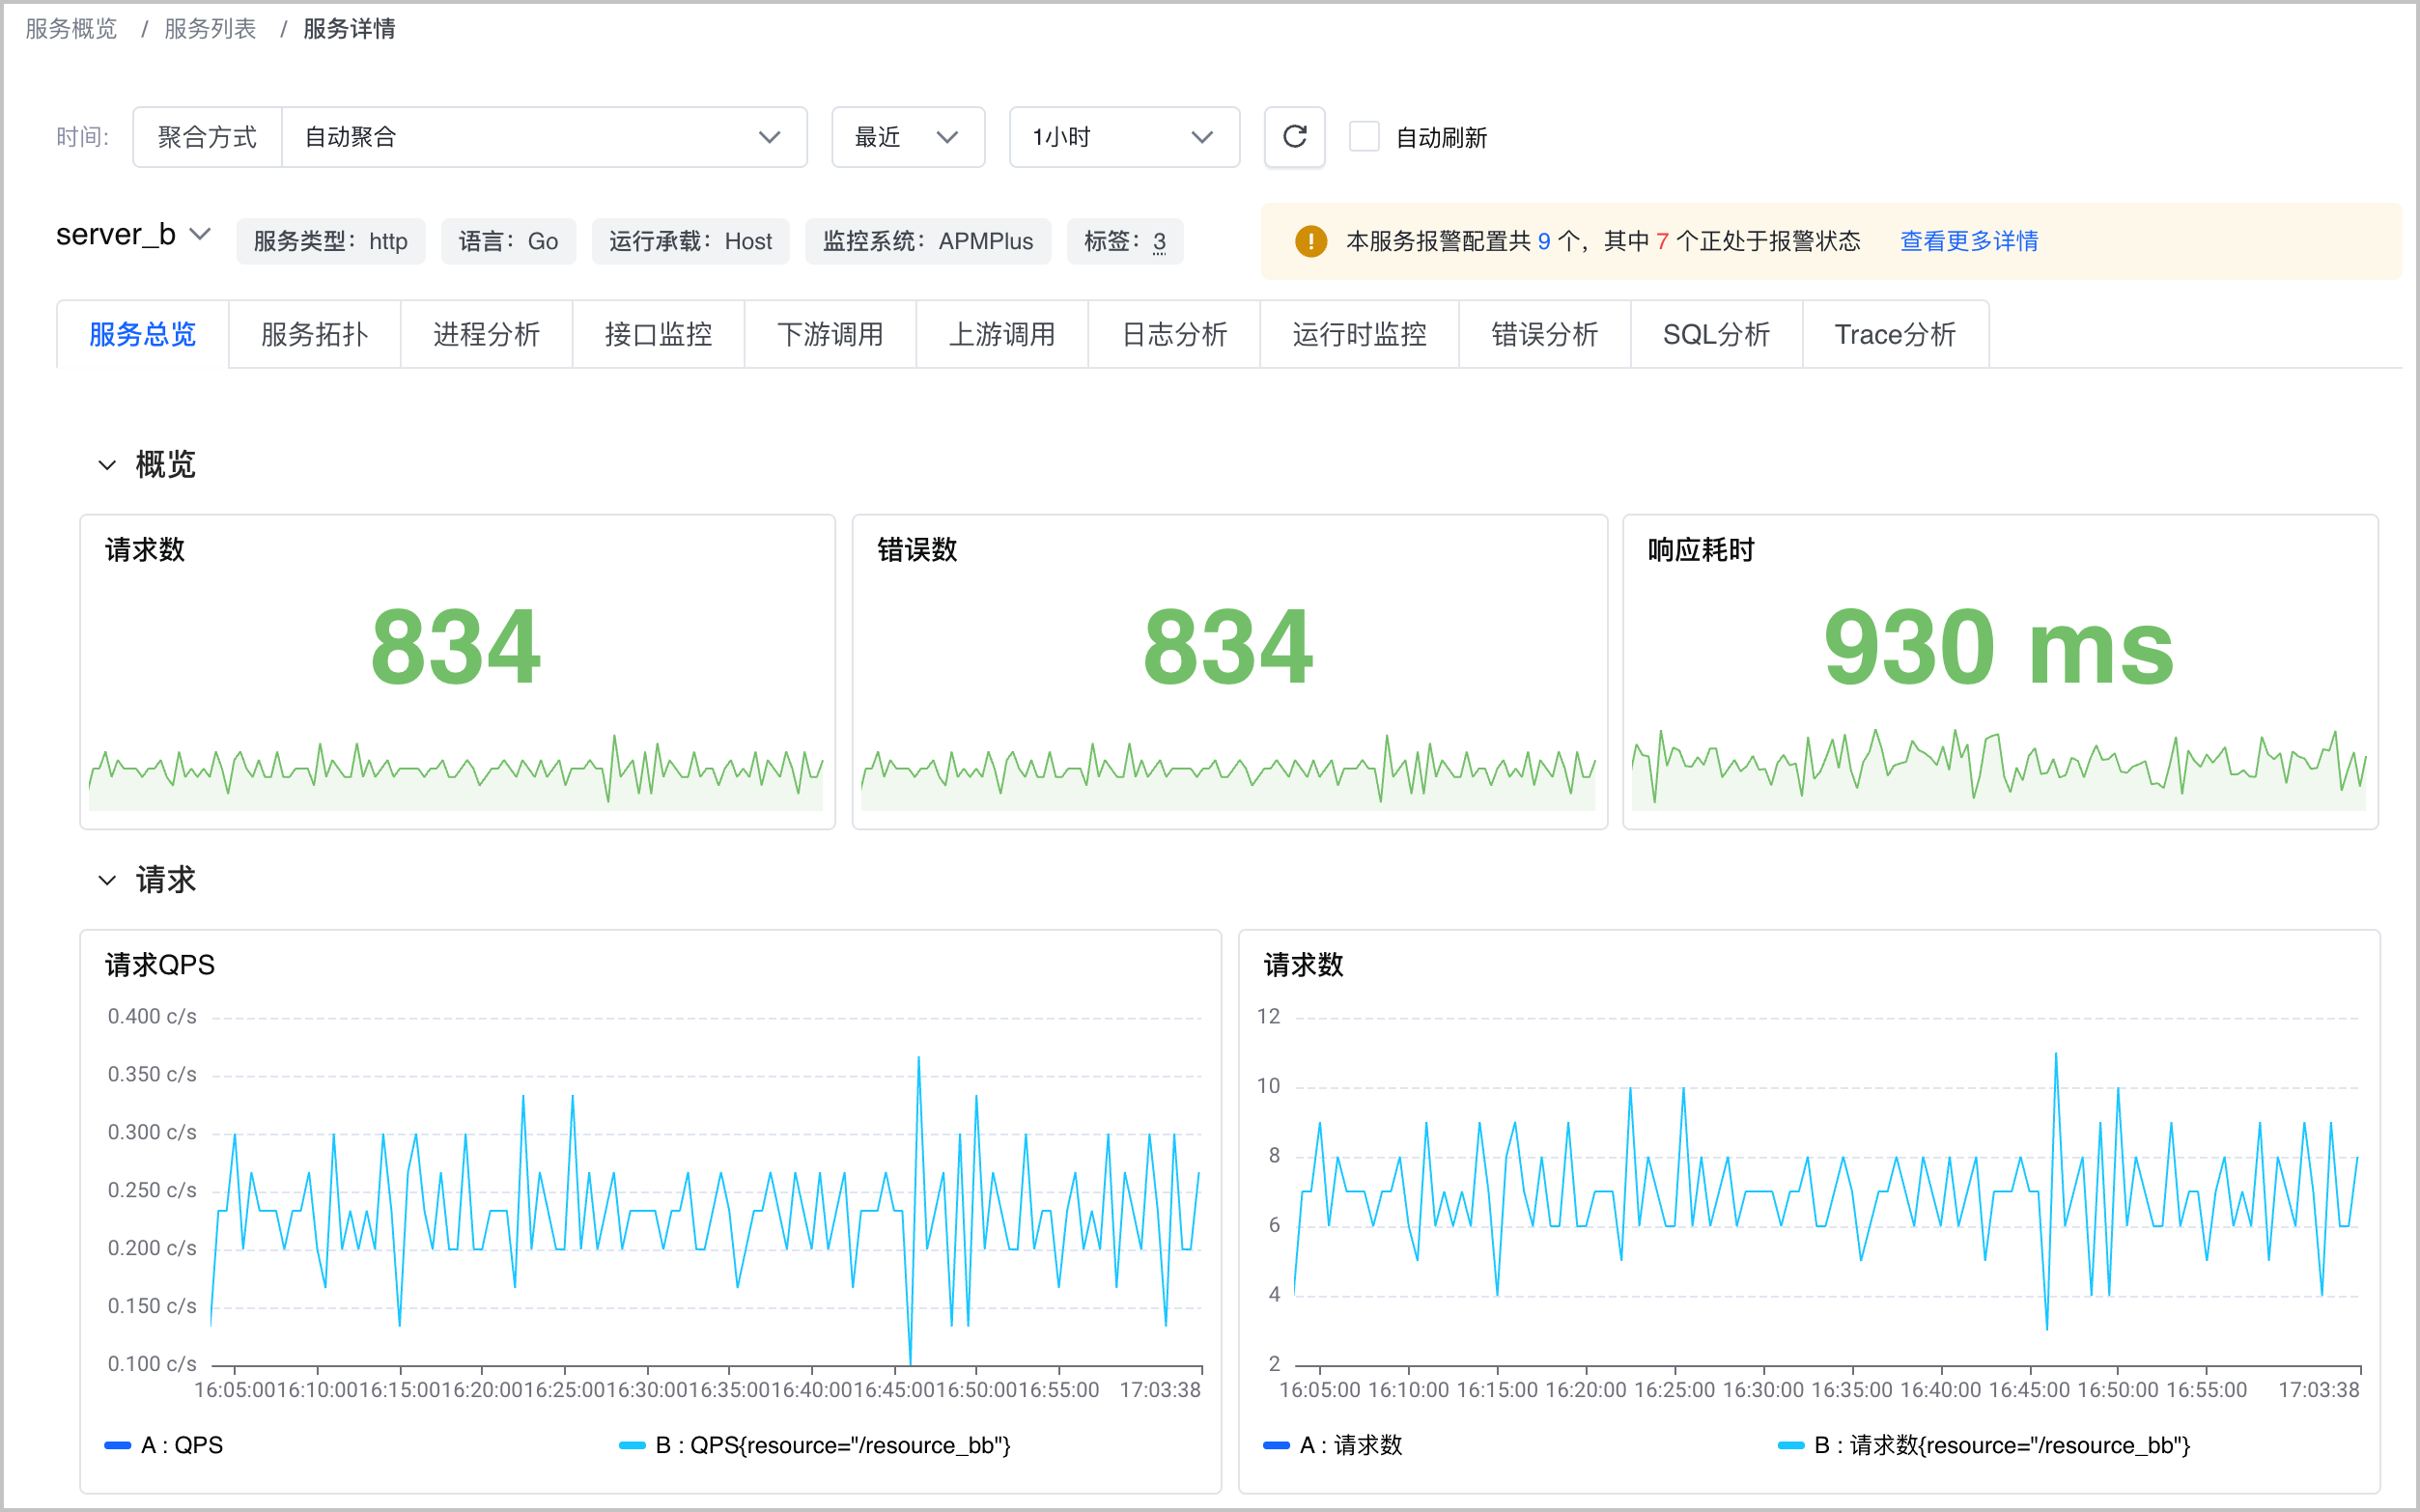
通过服务总览可以快速获取当前服务最关键的监控指标,帮助您确定是否存在调用过多、失败率过高、延迟过高等问题。包括如下指标:
说明
大模型相关指标仅在 AI 应用的服务总览中展示。
- 调用概览:请求数、错误数、响应耗时、大模型调用次数、Token 消耗总数、大模型调用平均延时。其中,单击图表左上角跳转按钮,支持跳转到当前服务相关 Trace 分析页面,时间范围与当前看板范围一致。
- 大模型指标:大模型调用 QPS、大模型调用次数、Token 数、大模型调用延时、TTFT、TPOT。
- 请求指标:请求 QPS、请求数、HTTP 状态码分布、HTTP 状态码请求数。其中,单击图表中的数据链接,支持跳转到当前服务相关 Trace 分析页面,时间范围与当前看板范围一致。
- 延迟指标:平均延时、延时 PCT50、延时 PCT90、延时 PCT99。其中,单击图表中的数据链接,支持跳转到当前服务相关 Trace 分析页面,时间范围与当前看板范围一致。
- 错误指标:错误数、错误率、每秒错误数。其中,单击图表中的数据链接,支持跳转到当前服务相关 Trace 分析页面,时间范围与当前看板范围一致。
- 日志指标:错误日志数、每秒错误日志数。其中,单击图表左上角跳转按钮,支持跳转到当前服务相关 Trace 分析页面,时间范围与当前看板范围一致。
- 容器指标:服务 CPU 使用比例、CPU 使用量、服务内存使用比例、内存使用量。
- 接口排行:接口请求 Top5、接口错误数 Top5、接口耗时 Top5。
拓扑分析
通过服务拓扑可以查看当前服务的全链路调用情况,支持按全拓扑(默认)、上游拓扑、下游拓扑或固定层级方式查看。
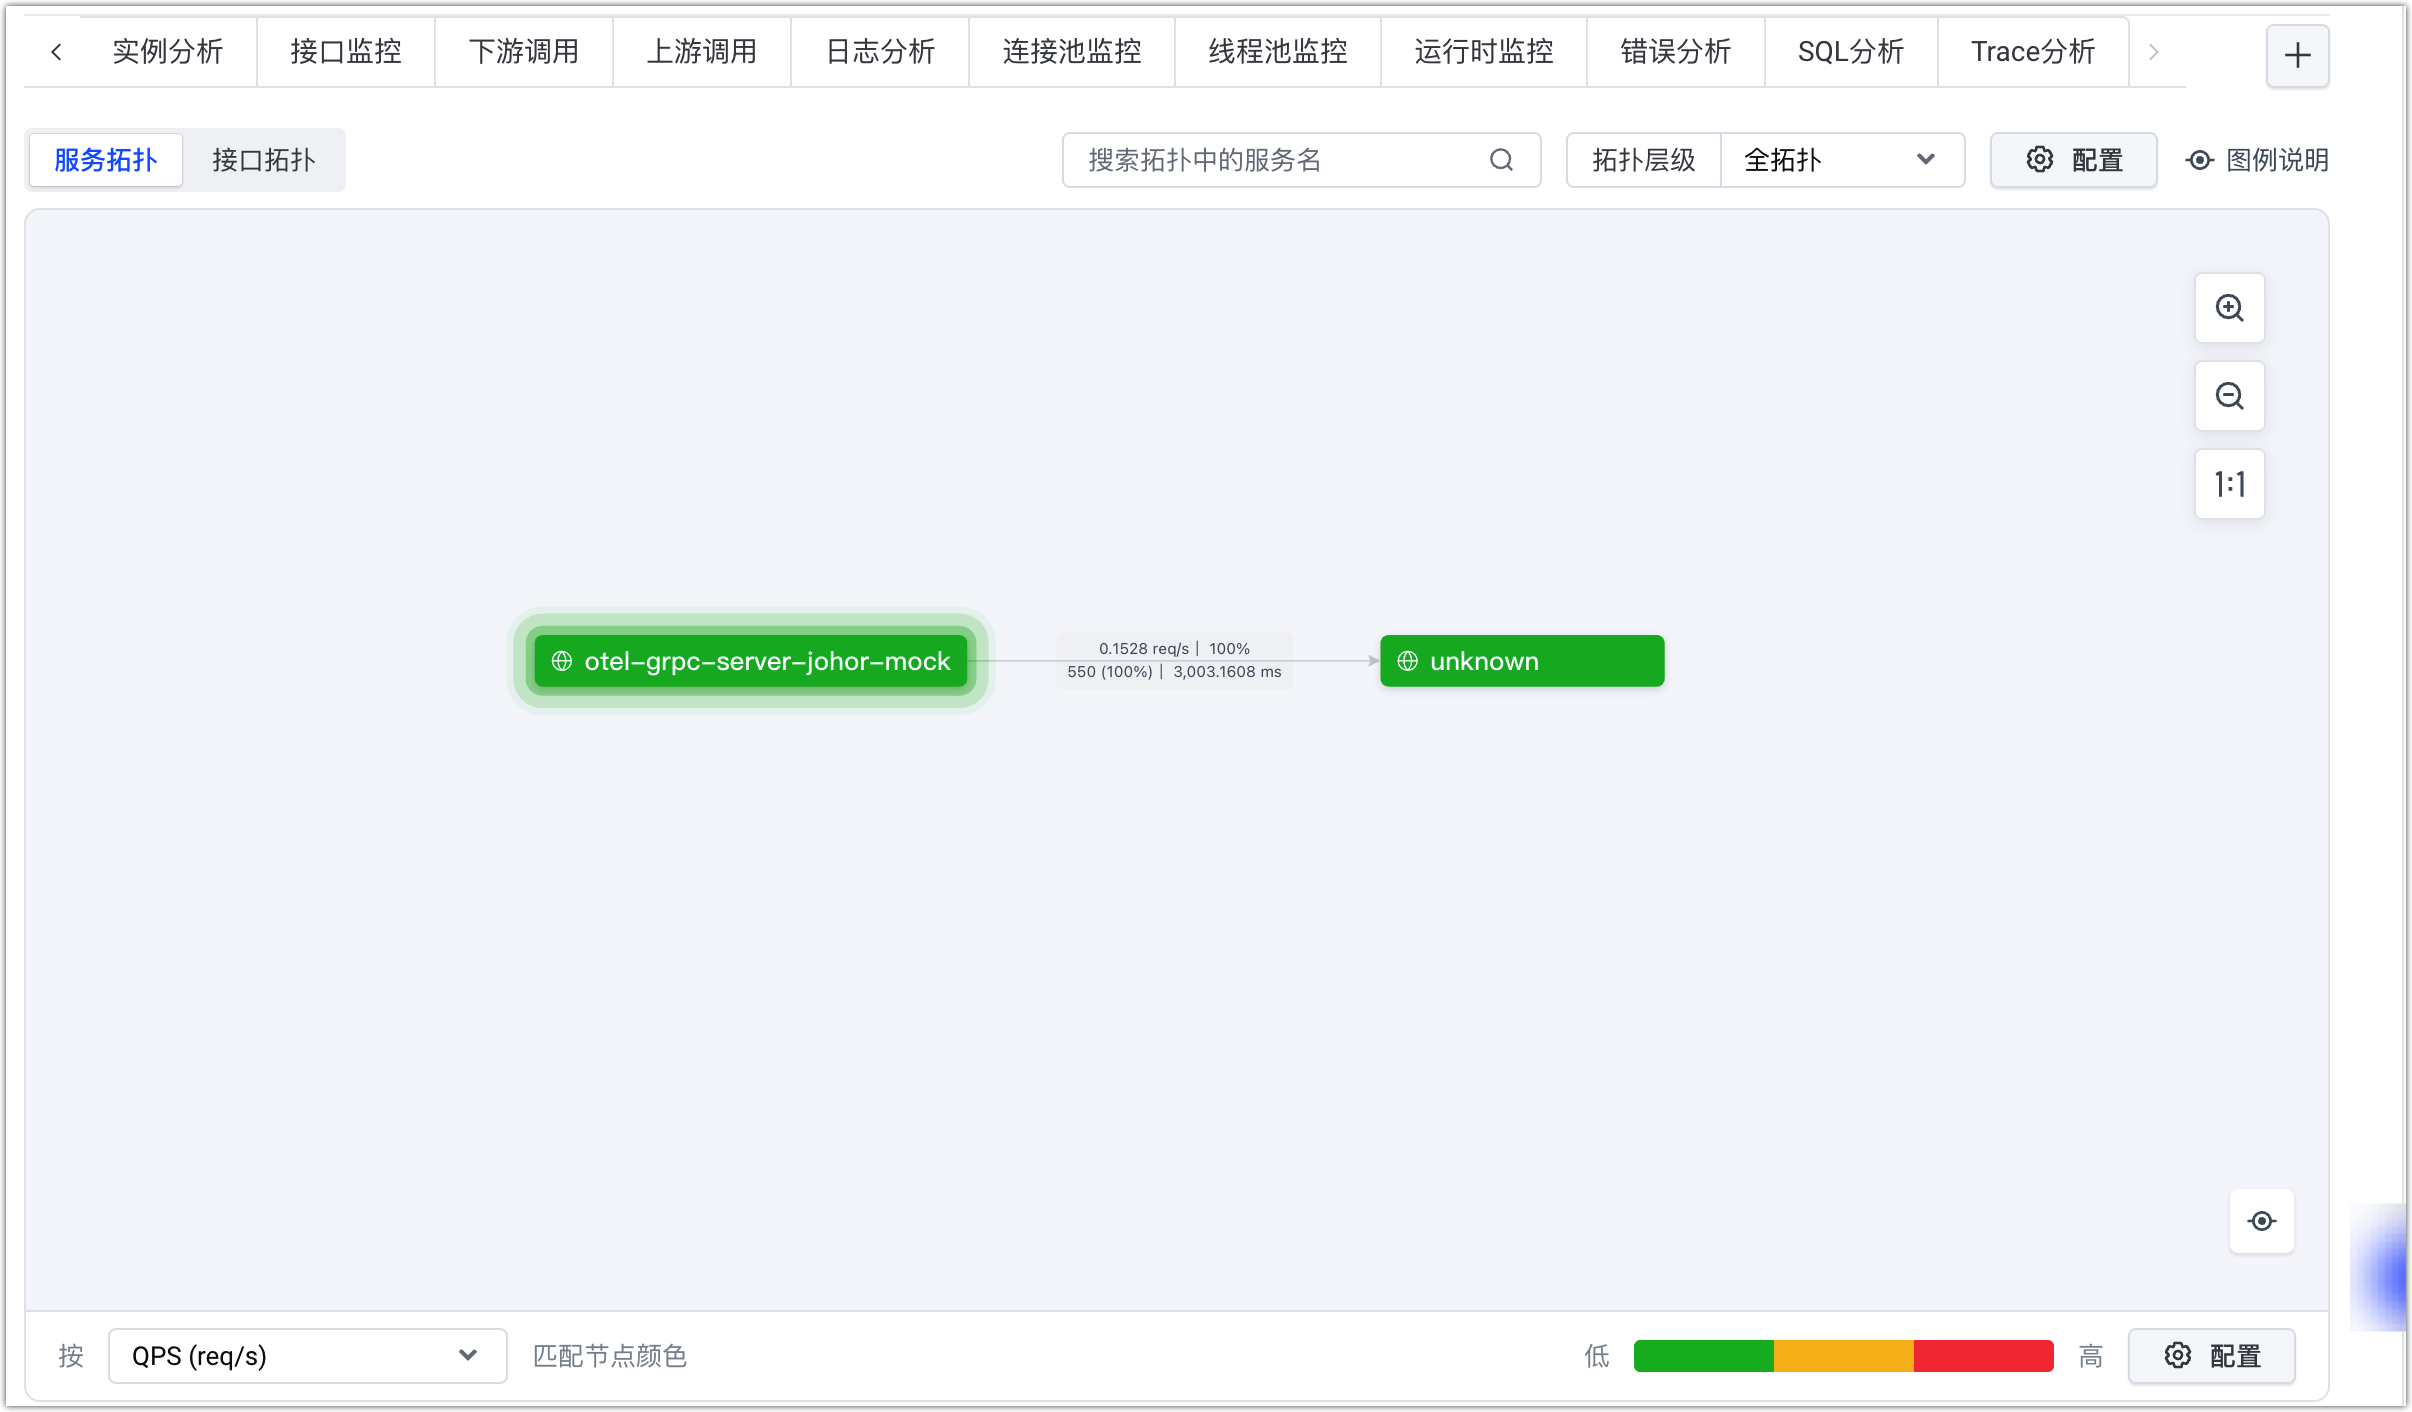
- 单击拓扑图中的节点,右侧将弹出 服务指标详情 面板,展示了该节点的调用 QPS、错误率、延迟等核心指标,并提供以下快捷跳转入口:
- 中间件节点:中间件详情
- 支持根据节点错误率展示对应颜色,帮助快速识别服务健康状态。颜色与错误率阈值的对应关系如下:
- 颜色健康状态错误率区间(默认)绿色满意小于 10%黄色一般10%~50%红色红色大于 50%
- 支持自定义调整,配置步骤如下:
- 单击右上角的 配置 > 修改设置 。
- 拖动阈值控制项,调整不同错误率区间对应的颜色范围。
- 保存配置后,查看节点颜色和图例是否同步更新。
说明
- 支持按指标配置节点的颜色映射规则,帮助快速识别异常节点,缩短服务巡检与故障定位路径。配置项主要包括展示指标、区间模式、阈值区间和颜色样式。
- 配置项说明展示指标支持选择 QPS、错误率、平均延迟、PCT50 延迟、PCT90 延迟、PCT9 延迟等指标。拓扑节点颜色按当前所选指标计算。区间模式支持 自动 和 自定义 两种模式。自动模式由系统划分区间,自定义模式由用户手动输入临界值。阈值区间定义不同颜色对应的数值范围。各区间须保持连续且递增,系统会进行校验。颜色设置支持单击区间色块修改颜色,也可以通过 HEX 值输入精确配置。
- 配置步骤如下:
- 在页面左下角选择指标。
- 单击页面右下角的 配置。
- 选择区间模式为 自定义,输入各区间临界值,并按需调整对应颜色。
通过接口拓扑可以查看当前服务所有接口的调用情况,支持按全拓扑(默认)、上游拓扑、下游拓扑或固定层级方式查看。
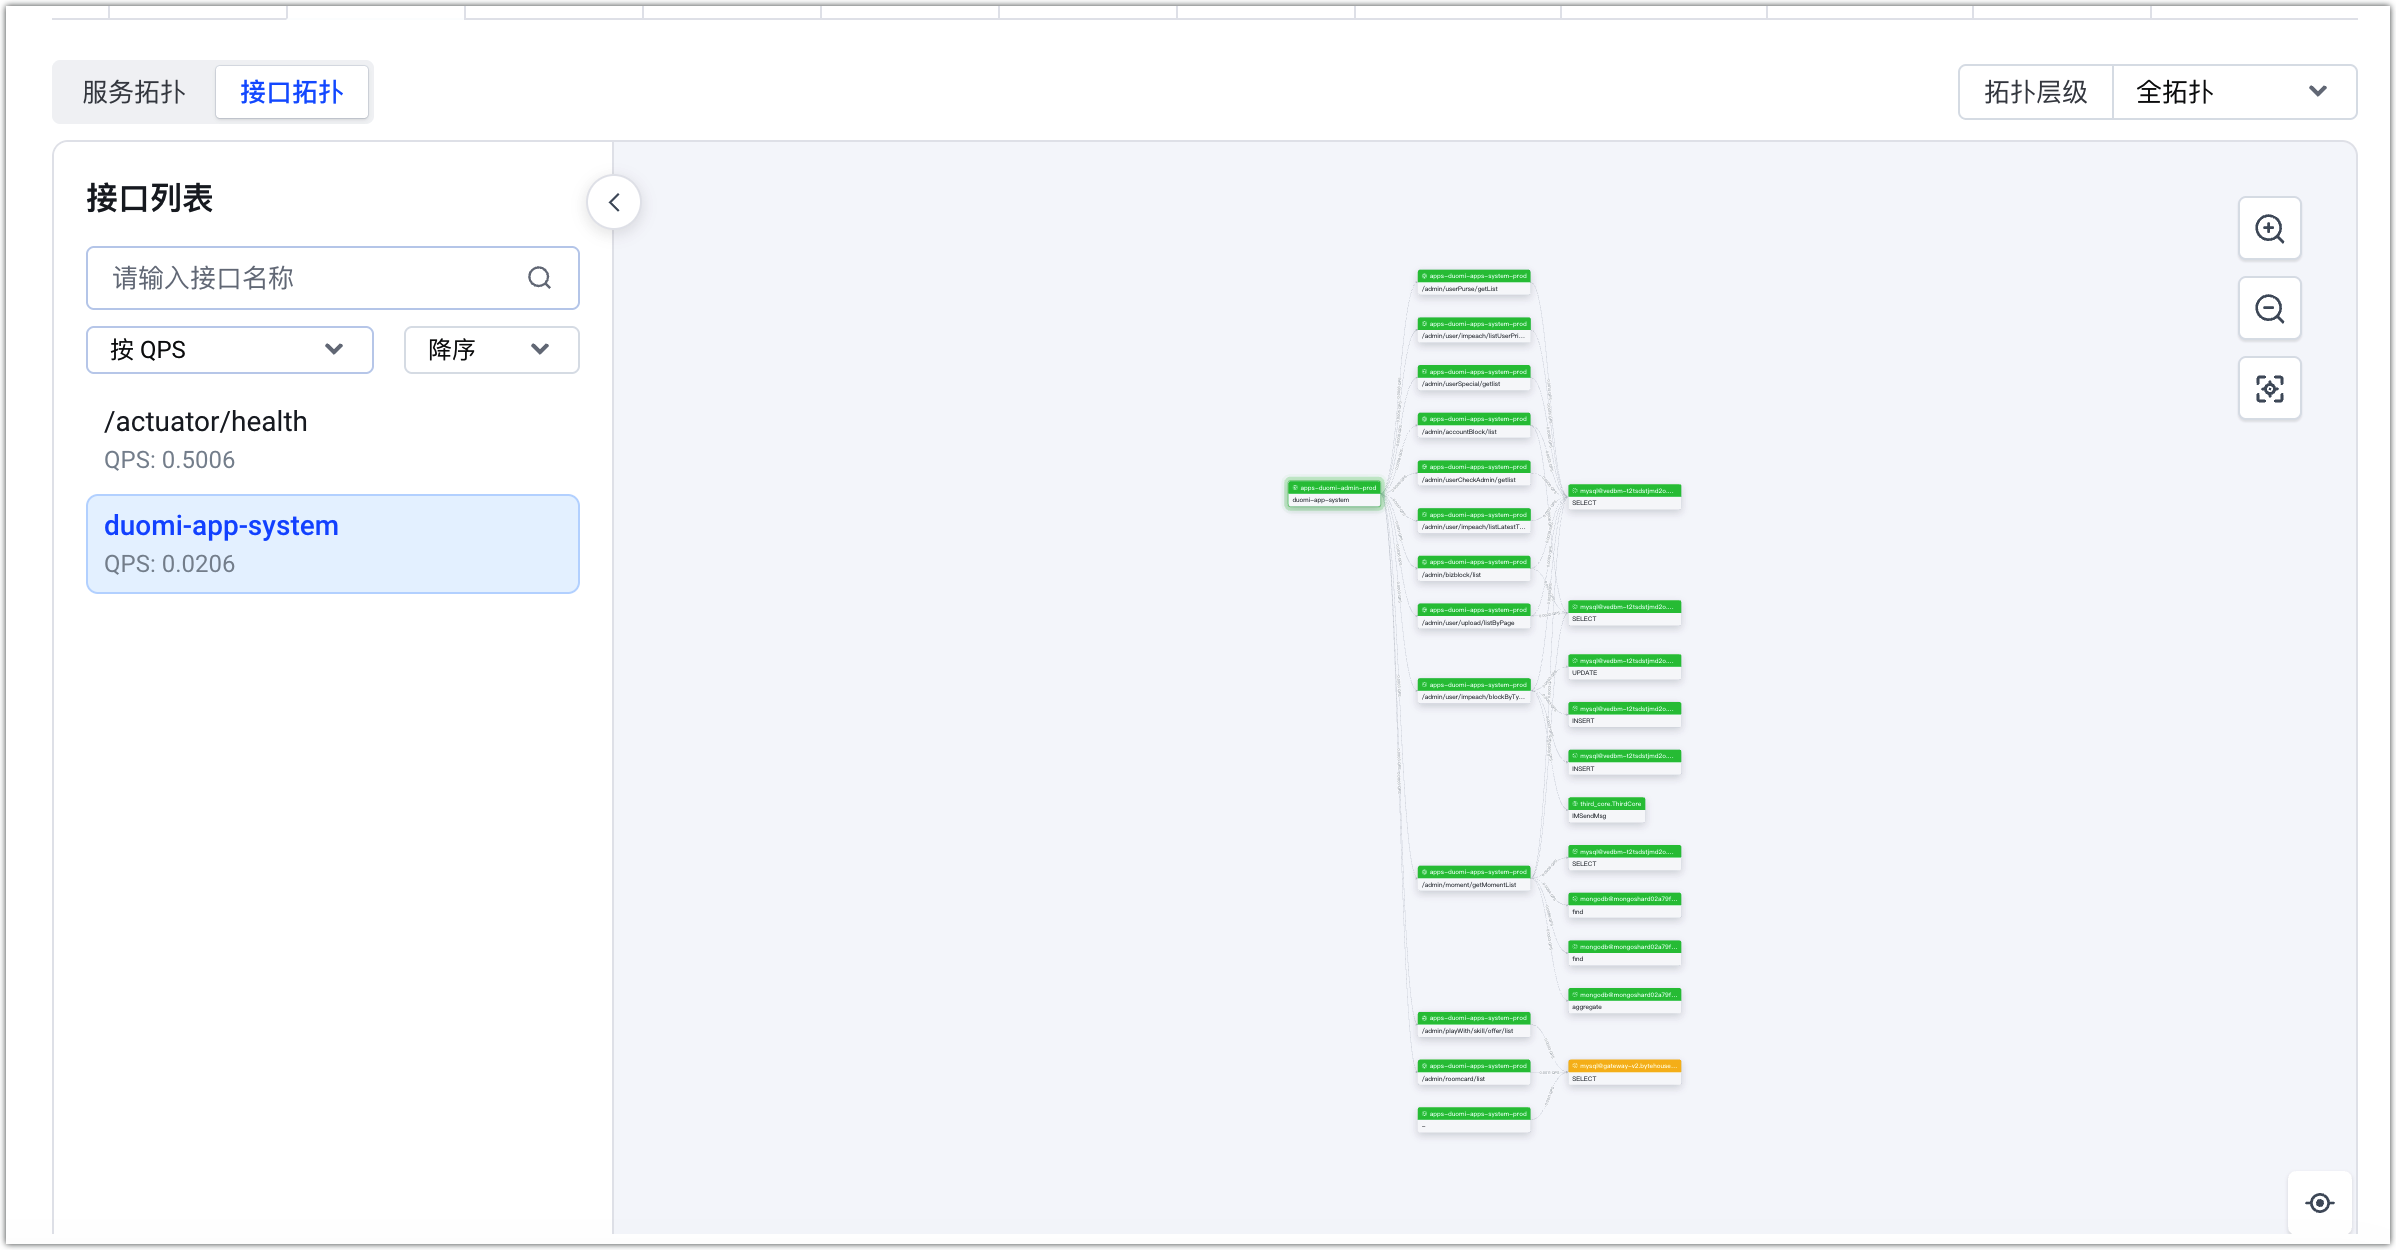
单击拓扑图中的接口可查看该接口的调用 QPS、错误率、延迟等核心指标,单击 上游调用、下游调用、Trace 分析 可跳转至对应页面查看接口具体情况。
实例分析
说明
若未采集到进程启动时间,将显示为 -。
实例分析统计实例所归属的服务 Pod、主机、容器等信息并进行监控。资源排行展示 实例 CPU 资源 Top 5 以及 实例内存资源 Top 5;实例列表支持查看当前运行中的实例,提供实例所属主机、实例状态、实例错误率、实例平均 QPS、实例延迟 PCT90 等核心指标。
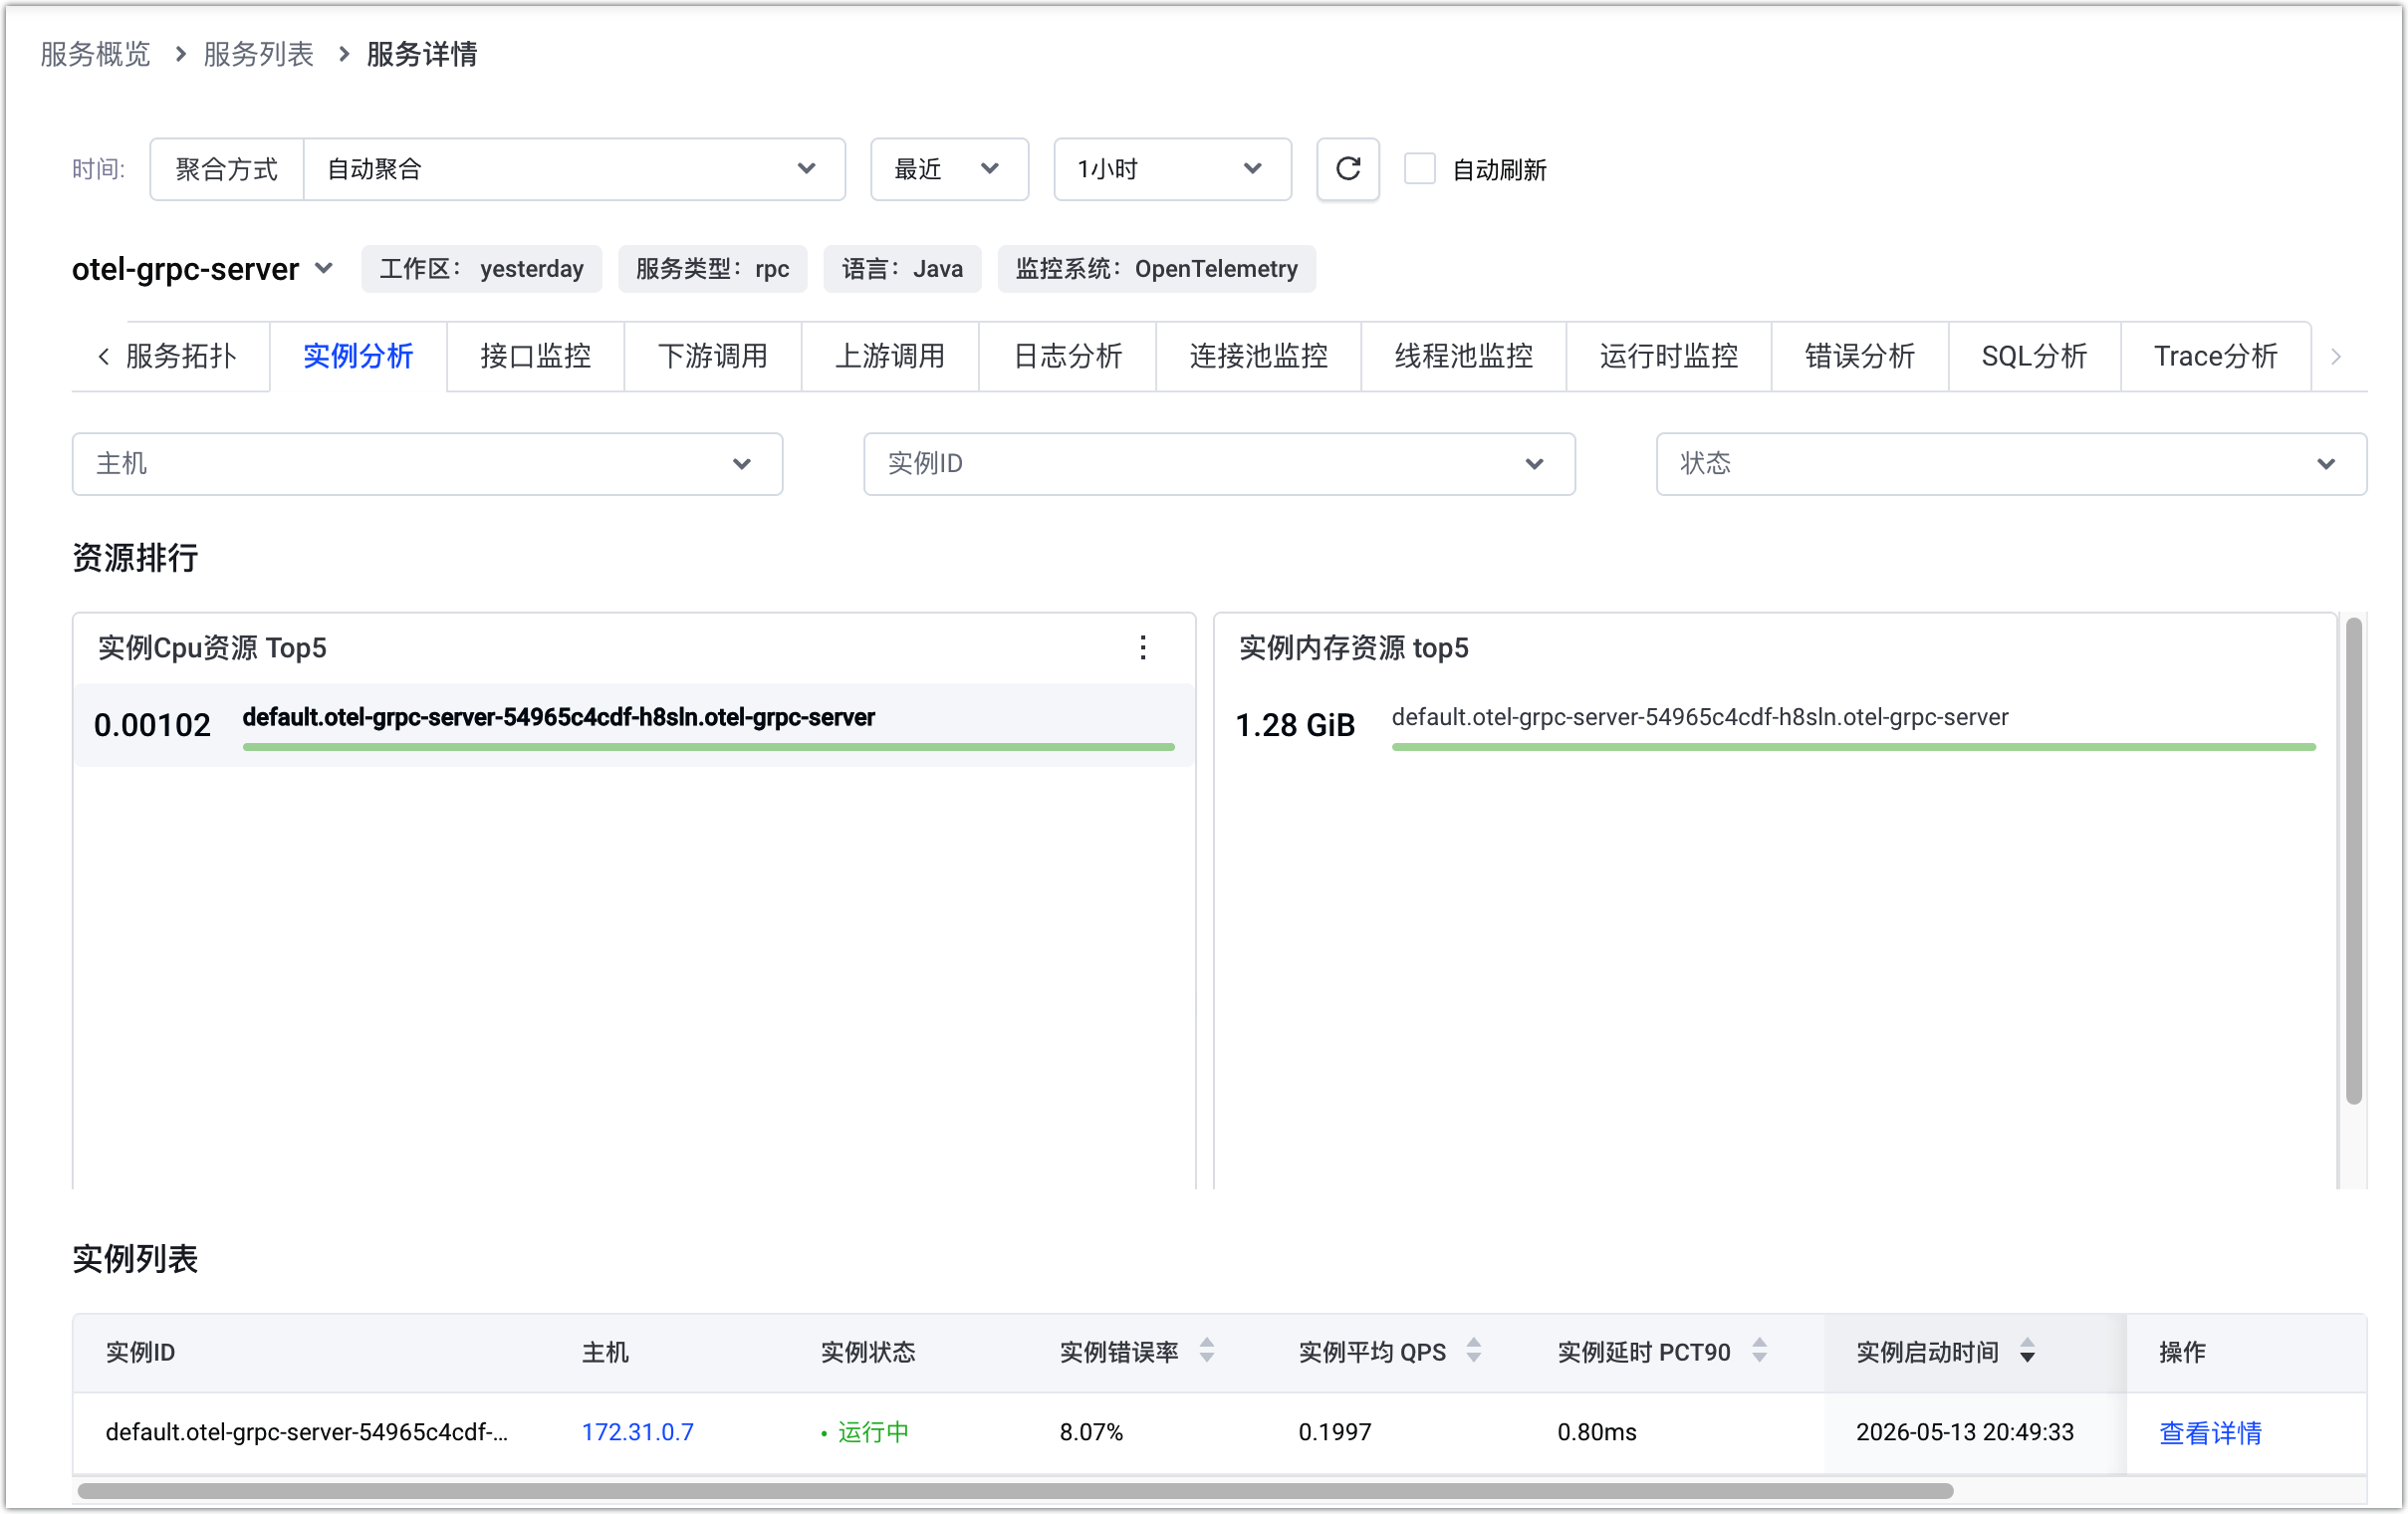
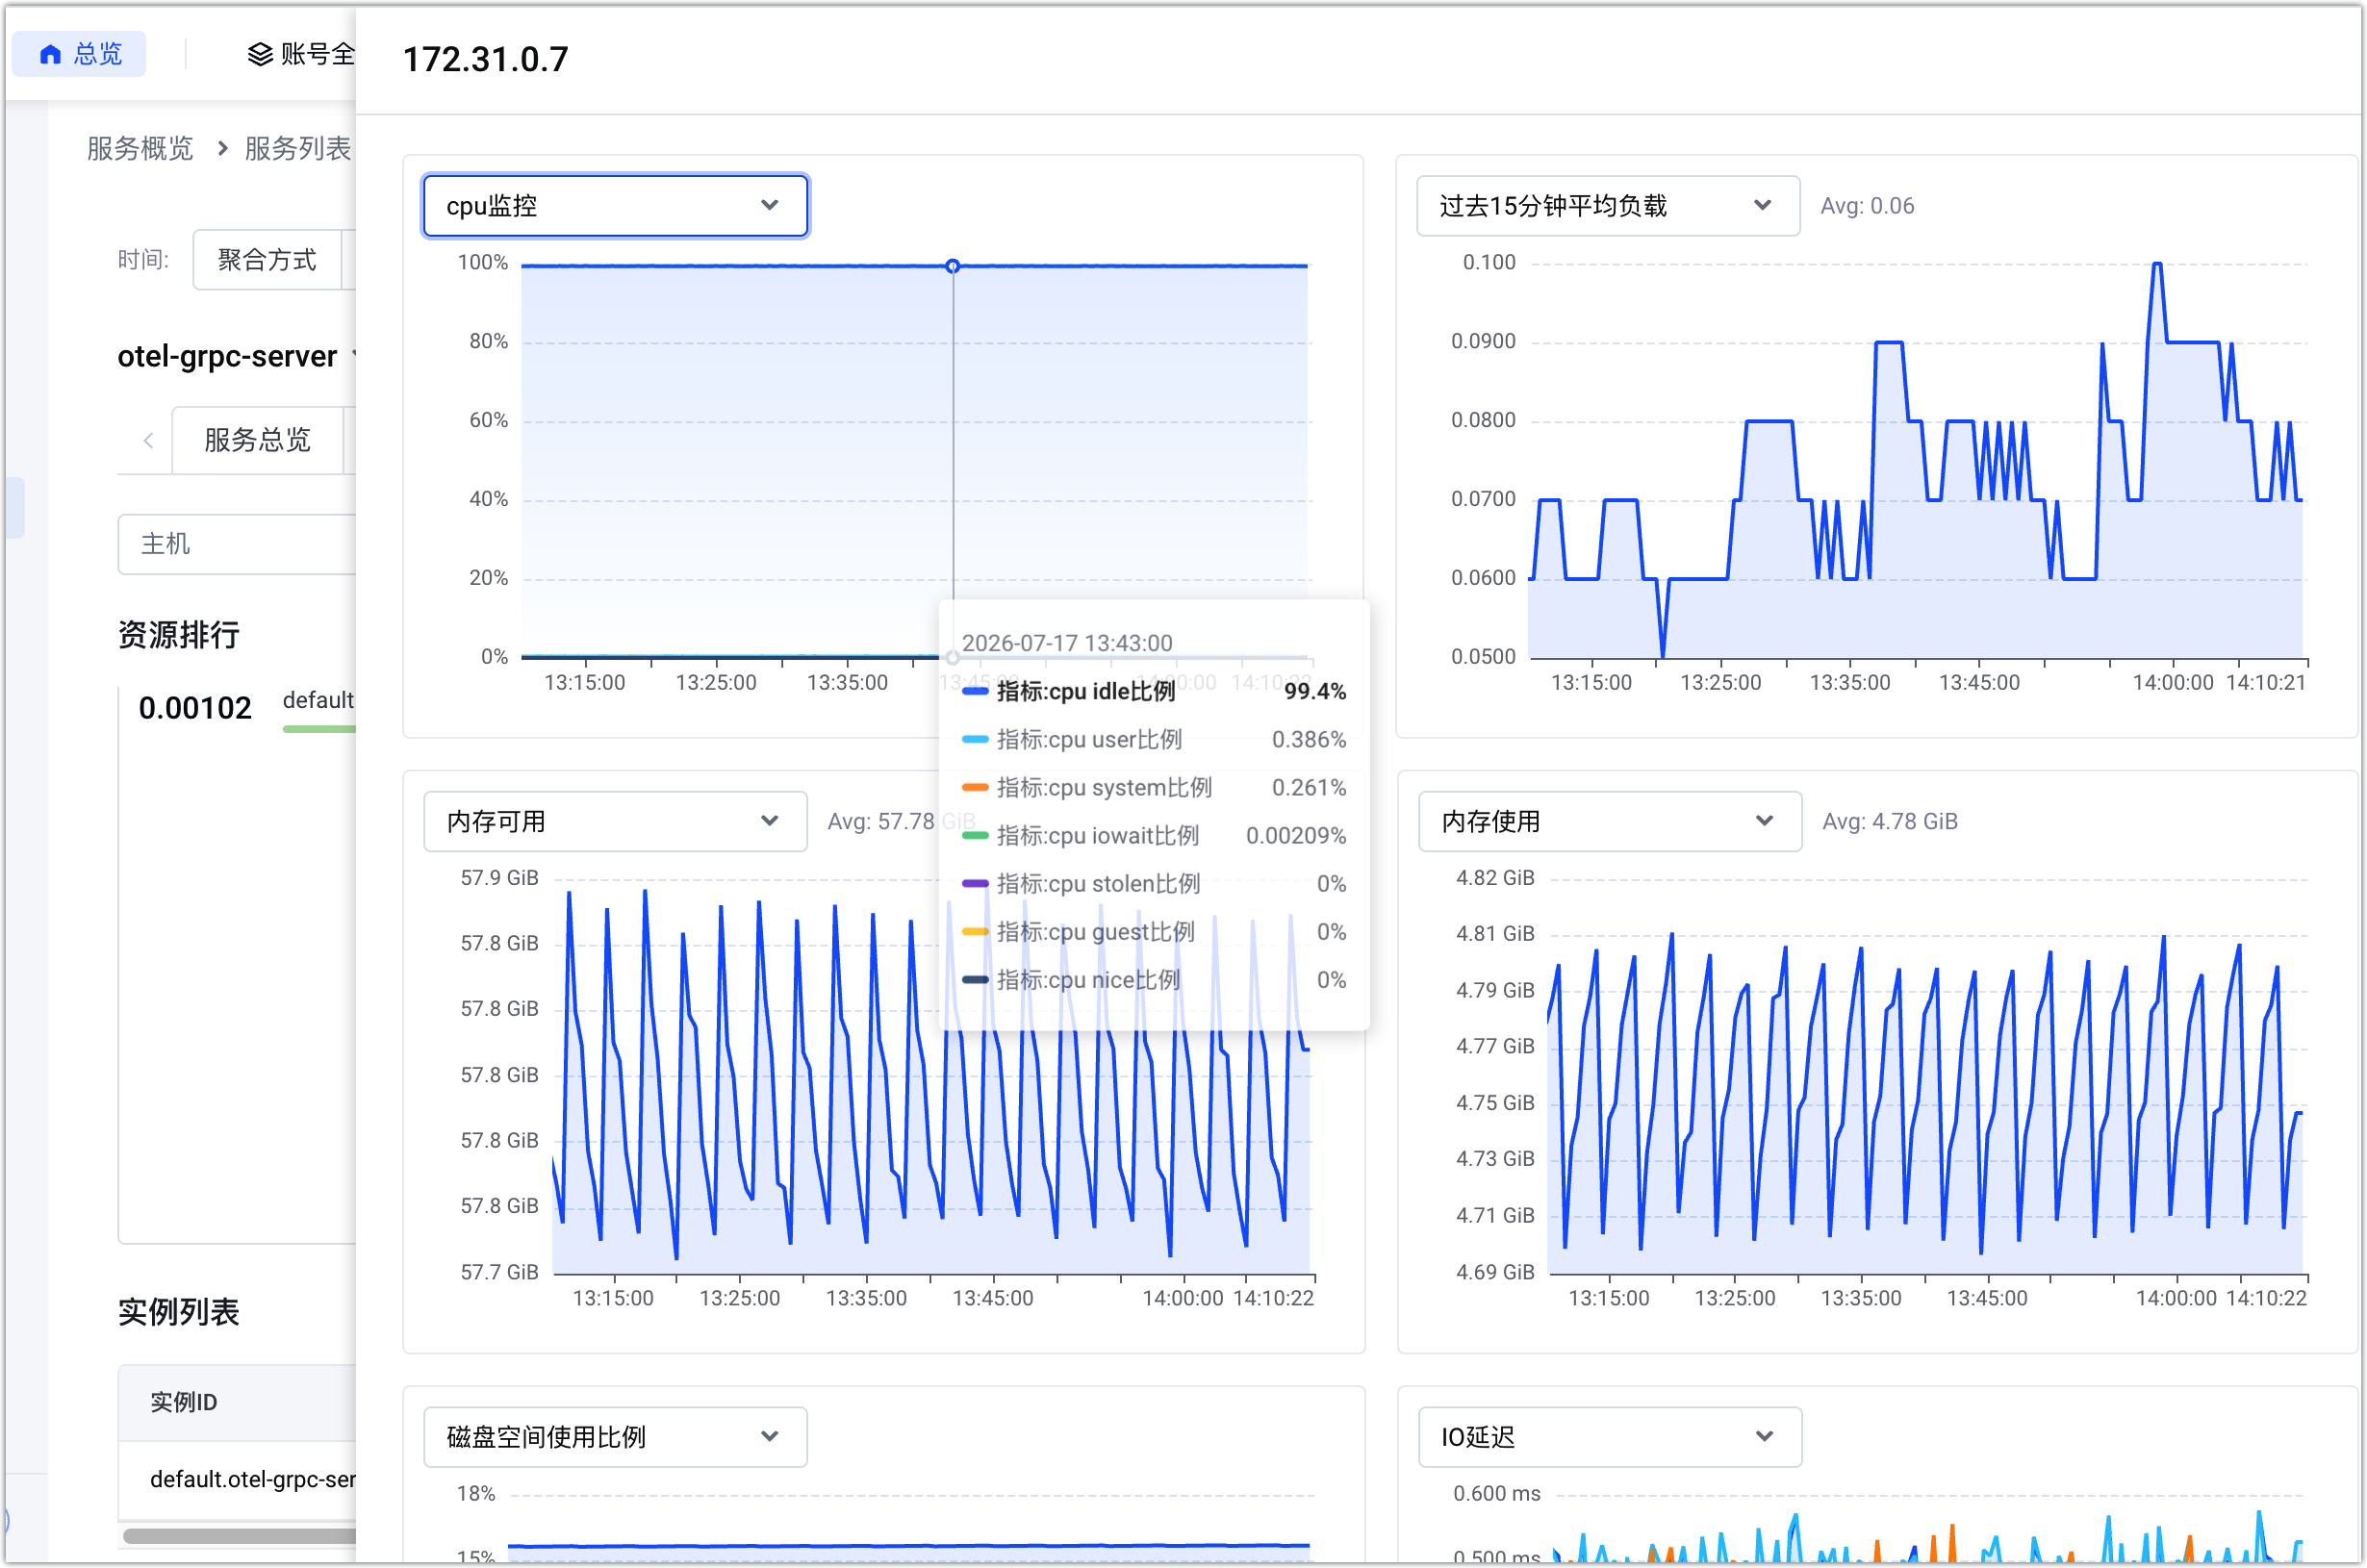
- 单击主机名称,可查看详细的主机监控看板,提供 CPU、内存、磁盘、负载等多个监控指标,例如:CPU 使用率、CPU 监控、过去 15 分钟平均负载、内存可用、内存使用、磁盘空间使用比例、IO 延迟、进程内存占用分布等。
-
- 单击目标实例操作列中的 查看详情,可查看实例的基础信息以及监控指标。包含概览、容器指标、进程指标、RED 指标、运行时监控、连接池监控、线程池监控。
-
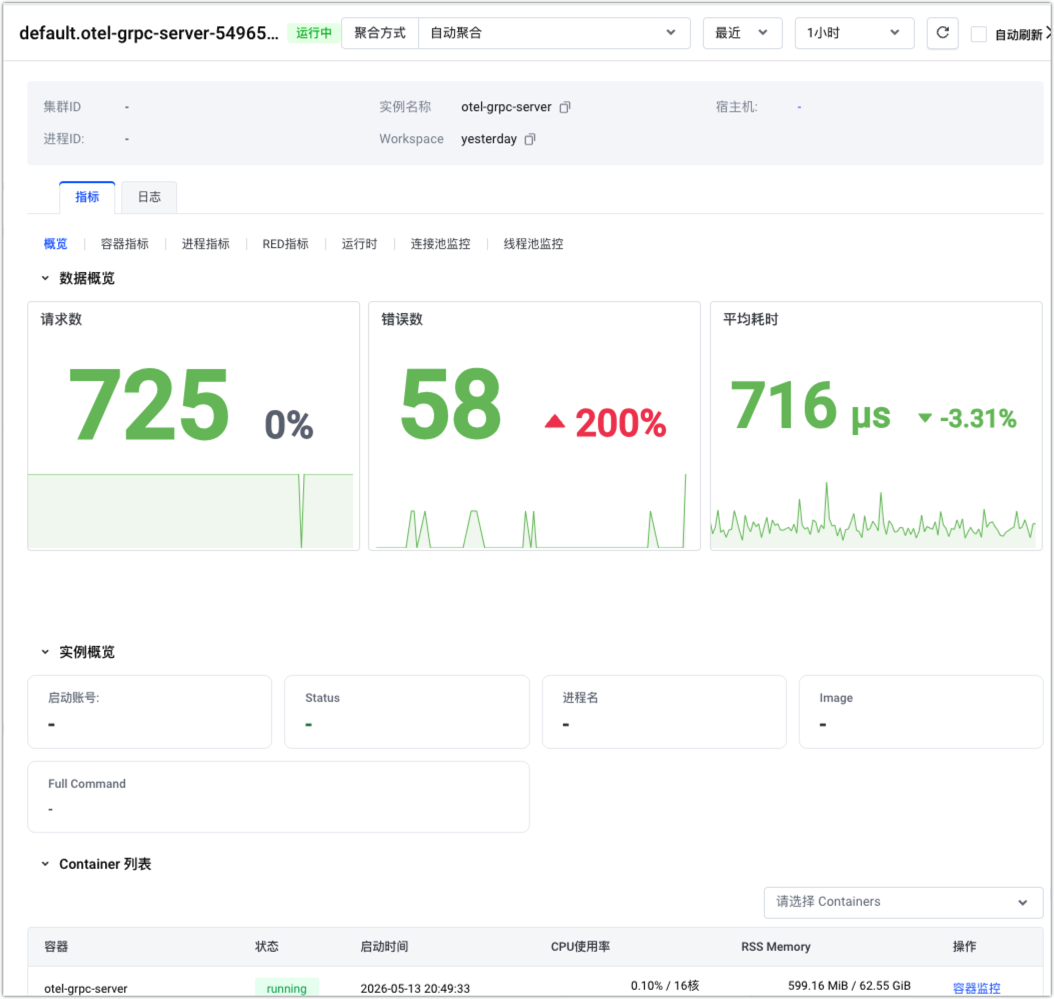
- 概览:包含数据概览、实例概览以及 Container 列表,数据概览展示请求数、错误数、平均耗时等指标。单击 Container 列表操作列的 容器监控,可进入 容器指标 页查看该实例所属容器的指标数据。
- 容器指标:包含数据概览、Container 列表以及容器看板。容器看板展示容器的 CPU 使用率、内存使用率、写 IO 吞吐量、写 IO QPS 以及 FD 线程数量等指标。
- 进程指标:展示 CPU、内存、文件数、上下文切换等指标。
- RED 指标:展示请求数、响应耗时、请求 QPS、状态码分布、错误数、错误率、平均延时、延时PCT90、接口请求 TOP5、接口耗时 TOP5 等指标。
- 运行时监控:展示 JVM 监控指标、Go Runtime 监控指标、Python Runtime 监控相关指标,例如:GC 次数、GC 耗时、内存使用率、堆内存使用详情、堆内存提交详情、缓冲区使用详情、cgo 调用次数、HeapAlloc等。
- 连接池监控:展示最大连接数、活跃连接数、空闲连接数、最小空闲连接数、最大空闲连接数、阻塞连接数等指标。
- 线程池监控:展示最大线程数、核心线程数、活跃线程数、线程池大小、线程池任务数、拒绝任务数等指标。
接口监控

通过接口监控,可以看到服务所有接口列表,并支持在所选时间段内根据QPS、总体错误率、时延PCT90进行排序,并且可以看到所选接口核心指标趋势图。
- 调用指标:QPS、请求数
- 错误指标:错误率、错误数、每秒错误数
- 耗时指标:响应耗时均值和分位值
单击接口列表中的接口,可以快速下钻到接口调用详情检索页面,同时可以针对耗时进行排序过滤快速定位慢查询,针对状态码进行过滤快速定位错误查询。

单击TraceID可以查看Trace详情,并高亮显示所选Span信息。

上下游调用

通过上下游监控,可以看到服务所有上下游调用服务和接口列表,并展示所选时间段内平均QPS、总体错误率、时延PCT90,并且可以看到所选调用核心指标趋势图。
- 调用指标:QPS、请求数
- 错误指标:错误率、错误数、每秒错误数
- 耗时指标:响应耗时均值和分位值
单击调用接口和调用服务,可以快速下钻到接口调用详情检索页面。
日志分析

日志分析为服务日志提供了聚类和列表两种分析方式查找相应的日志。通过日志过滤和搜索日志功能,可以更好的查询日志。
运行时监控
Java 运行时指标
针对Java应用服务提供了服务视角的运行时核心指标监控,包括指标:已使用堆内存、已使用非堆内存、已使用堆内存-Top10进程、已使用非堆内存-Top10进程、NewGen Size、NewGen Size Top10进程、OldGen Size、OldGenSize-Top10进程、GC次数、GC时间、类加载数量、线程数量、线程数量Top10进程。

Java线程池的指标说明:
JVM的指标说明:
Golang 运行时指标
针对Go应用服务提供了指标:goRoutine数量、goRoutine数量-Top10进程、GC次数、GC次数-Top10进程、GC总耗时、GC总耗时-Top10进程、单次GC耗时-MAX/AVG/MIN、单次耗时-PCT、cgo调用次数、cgo调用次数-Top10进程、HeapAlloc、HeapAlloc-Top10进程、HeapSys、HeapSys-Top10进程、HeapIdle、HeapIdle-Top10进程、HeapInuse、HeapInuse-Top10进程、HeapReleased、HeapReleased-Top10进程、HeapObject、HeapObject-Top10进程。

goruntime的指标说明:
Python 运行时指标
针对 Python 应用服务提供了指标:CPU耗时、CPU使用率、内存使用、GC对象数量、线程数量、上下文切换数量。
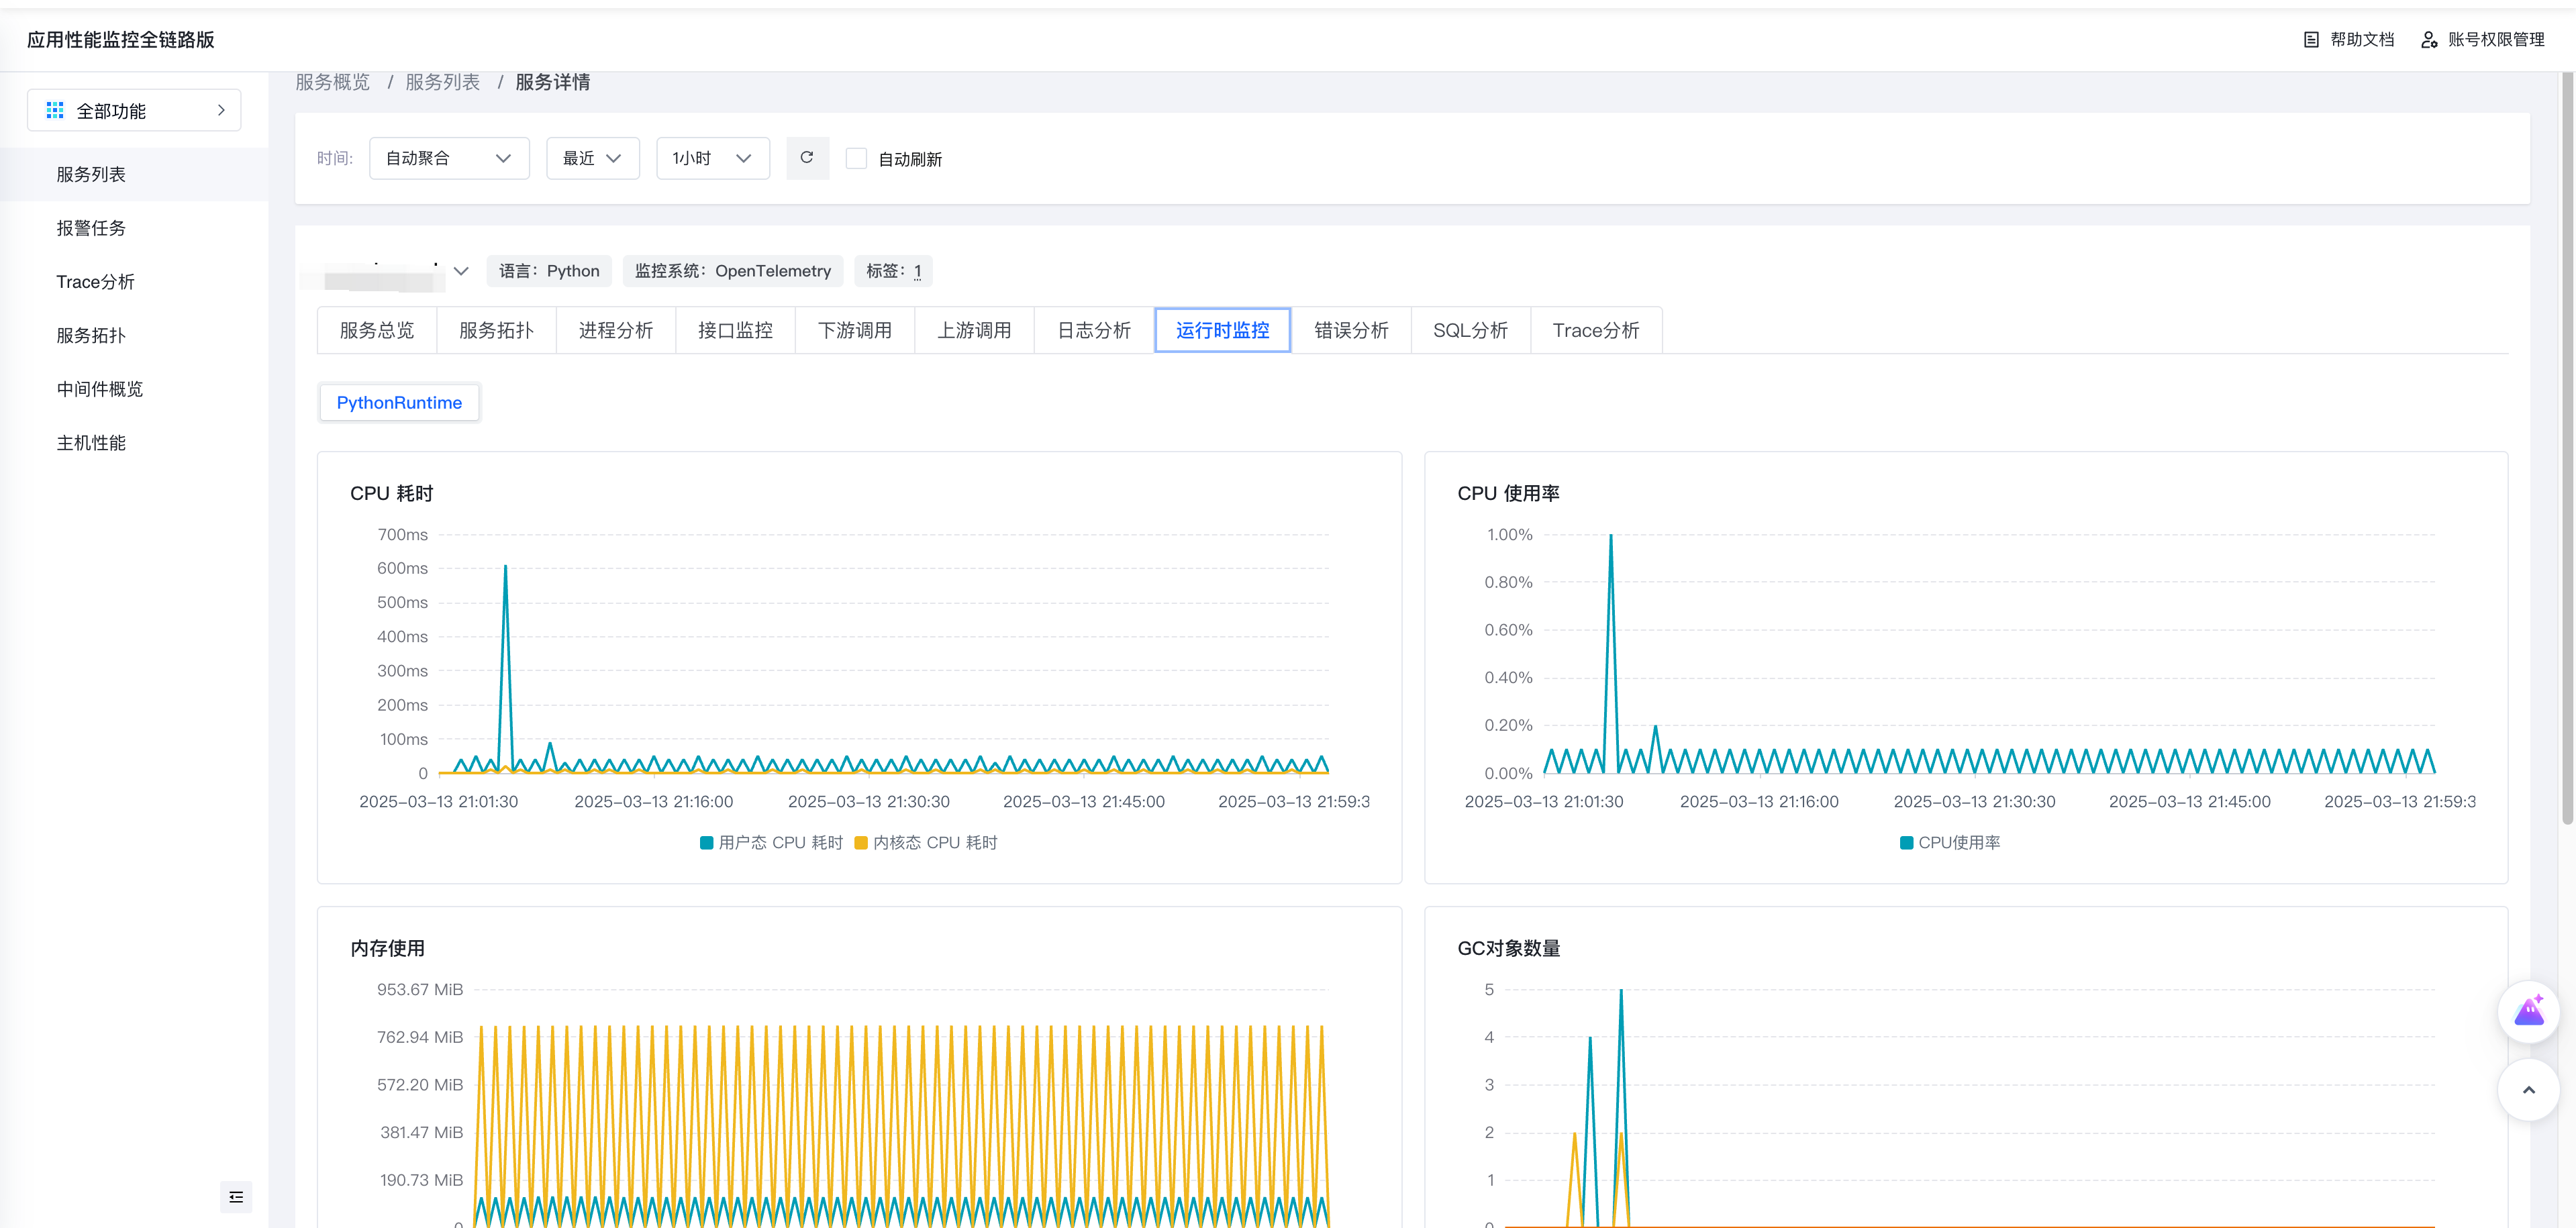
Python runtime的指标说明:
错误分析
通过错误分析,可以直观的看出系统中存在的各类型的接口错误及其在各维度的分布,同时也可以查看系统中存在的各类异常,并且数据与Trace链路数据打通,便于查看错误和异常的上下文,分析、解决系统中存在的接口错误和异常。
SQL分析

SQL分析展示该服务产生的所有SQL查询,可以查看SQL请求趋势,去掉参数后的SQLPattern列表,以及每种pattern的上报量、失败占比和平均响应耗时。
单击SQLPattern可以查看所有符合该pattern的经过脱敏的原始sql。
最近更新时间:2026.09.15 11:34:48
这个页面对您有帮助吗?
有用
有用
无用
无用