托管 Prometheus
托管 Prometheus


文档指南

请输入


- 文档首页
 托管 Prometheus最佳实践资源与业务监控监控容器服务中的 AI 训练任务
 复制全文
 下载 pdf
监控容器服务中的 AI 训练任务
 文档反馈
 问问助手
在 AI 训练模型处理业务用例时,监控训练任务状态和底层资源负载至关重要。本文为您介绍在容器服务集群中监控 AI 训练任务的方法。
前提条件
- 容器服务
- 已开启云原生观测,并同步安装了 node-exporter 组件。详情请参见 开启云原生观测。
说明
- 已安装 rdma-device-plugin 组件,详情请参见 安装组件。
- 已安装 nvidia-device-plugin 组件,并同步安装了 dcgm-exporter。详情请参见 安装组件。
- 托管 Prometheus
- 已传遍工作区,详情请参见 创建工作区。
- 已创建告警通知策略,详情请参见 创建告警通知策略。
- 已创建告警聚合策略,详情请参见 创建告警聚合策略。
操作步骤
步骤一:配置 AI 训练任务
为了能够在大盘中查看到训练任务的相关信息,您需要在训练任务中增加ai.vke.volcengine.com/task、ai.vke.volcengine.com/job、ai.vke.volcengine.com/team和ai.vke.volcengine.com/user标签,示例如下。
apiVersion: apps/v1
kind: Deployment
metadata:
name: ai-demo # 训练任务的名称
namespace: default # 训练任务所在的命名空间
spec:
replicas: 1 # 训练任务的副本数
selector:
matchLabels:
app: ai-demo
template:
metadata:
labels:
app: ai-demo
ai.vke.volcengine.com/task: master # 训练任务的角色,例如 master、chief、worker
ai.vke.volcengine.com/job: ai-name # 训练任务的名称
ai.vke.volcengine.com/team: team-a # 训练任务的归属团队
ai.vke.volcengine.com/user: user-a # 训练任务的归属成员
spec:
containers:
- name: ai # 容器名称
image: doc-cn-beijing.cr.volces.com/vke/gpu-burn:1.0 # 训练任务的镜像和版本
command: [ "/bin/bash", "-c", "--" ]
args: [ "while true; do sleep 3600; done;" ]
resources:
limits:
nvidia.com/gpu: "1" # 按需配置 GPU 显卡数量
步骤二:搭建 Grafana 并导入监控大盘
当需要对集群中运行的 AI 训练任务以及底层资源进行监控时,您可以下载本文中提供的监控大盘,并导入到 Grafana 系统中使用。
操作步骤如下:
- 在 VKE 集群中部署 Grafana 并接入工作区。详情请参见 在容器服务集群中部署 Grafana 并接入工作区。
- 在本地环境中使用 kubectl 连接集群,并执行以下命令,配置 Grafana 服务的端口映射。
kubectl port-forward service/grafana 3000:3000 -n volcano-metrics
- 在本地环境中打开浏览器,在地址栏中输入 localhost:3000,进入 Grafana 登录界面,使用默认用户名admin和密码admin登录。
- 在左侧导航栏中,选择 Dashboards,进入监控大盘配置页面。
-
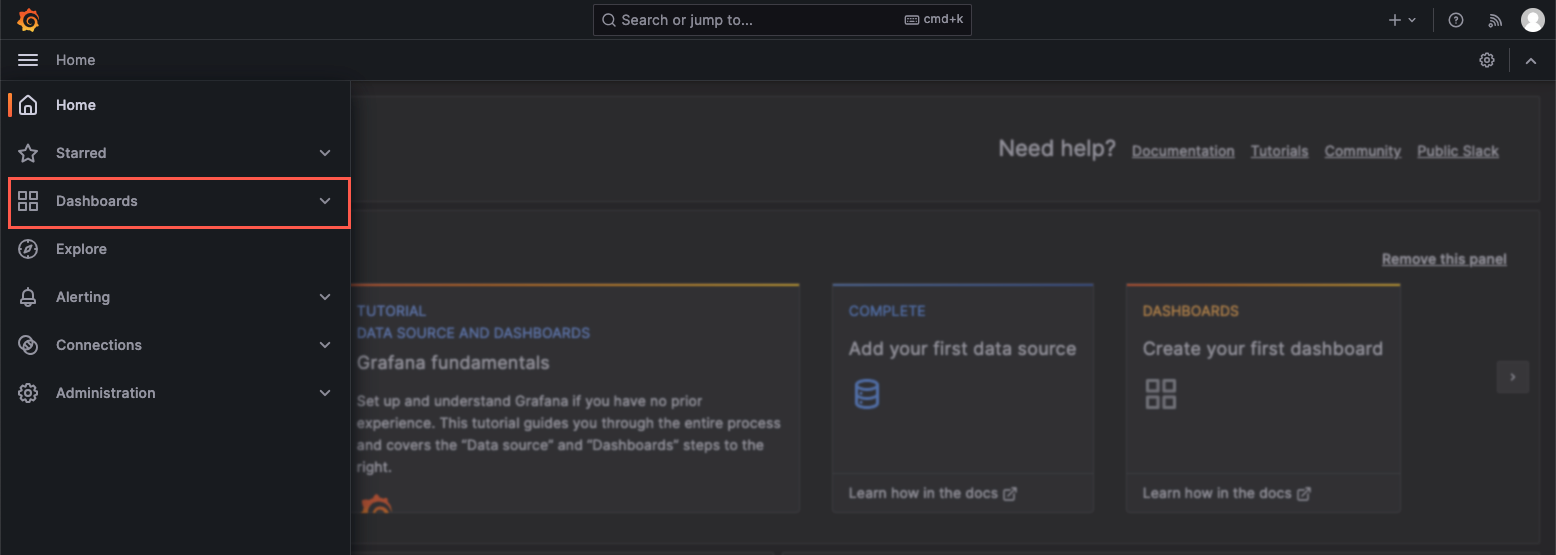
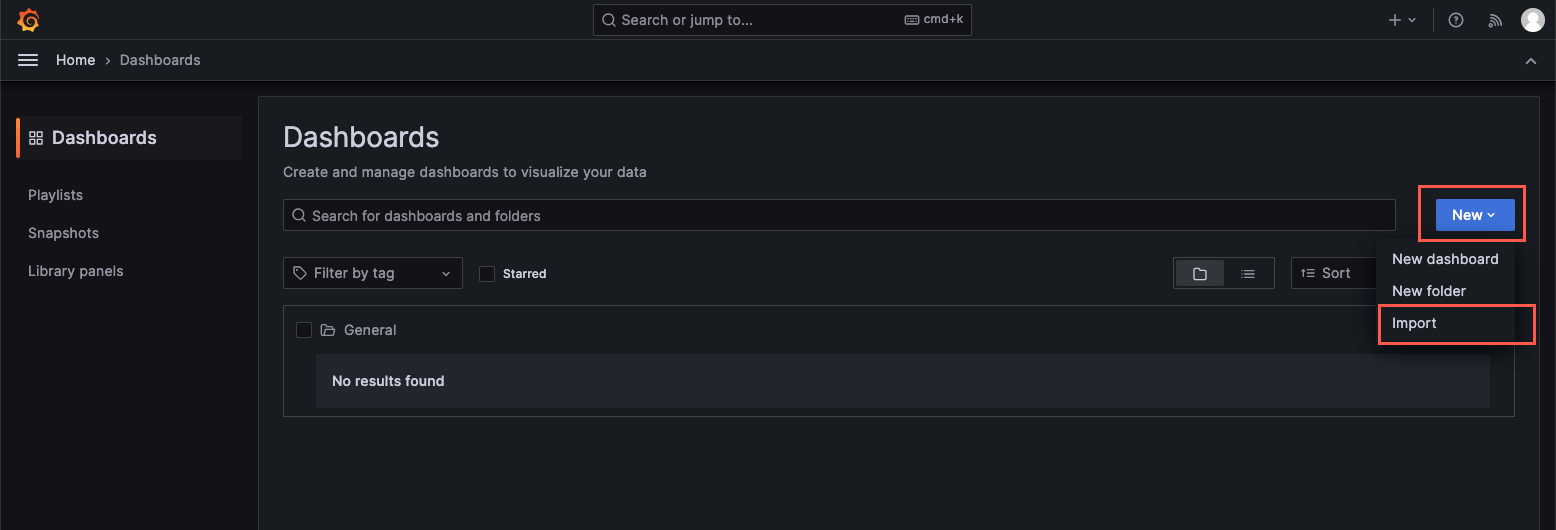
- 单击 New ,在下拉菜单中选择 import,进入导入大盘页面。
-
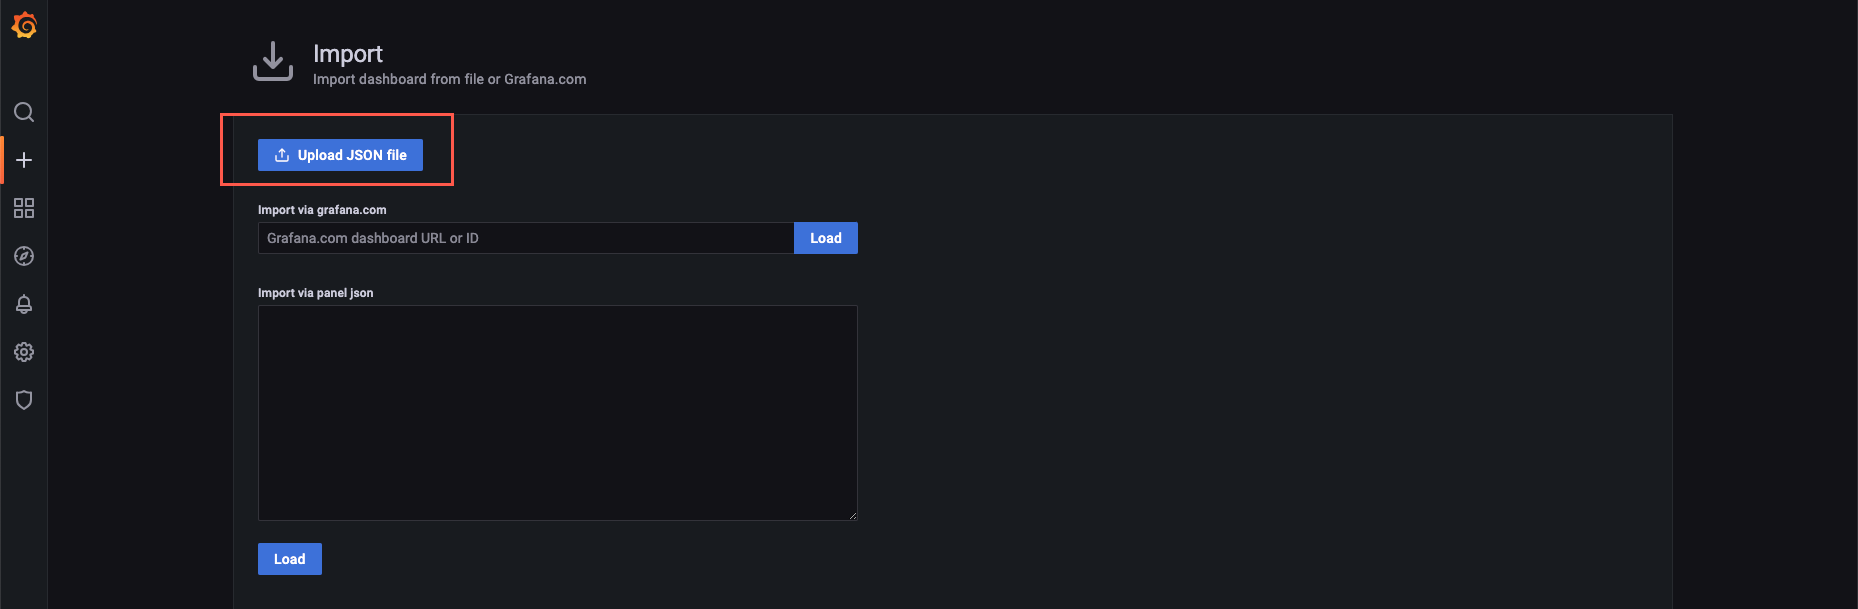
- 单击 Upload JSON file,并选择保存在本地的监控大盘 JSON 文件。
-
- 配置监控大盘的基本信息。
-
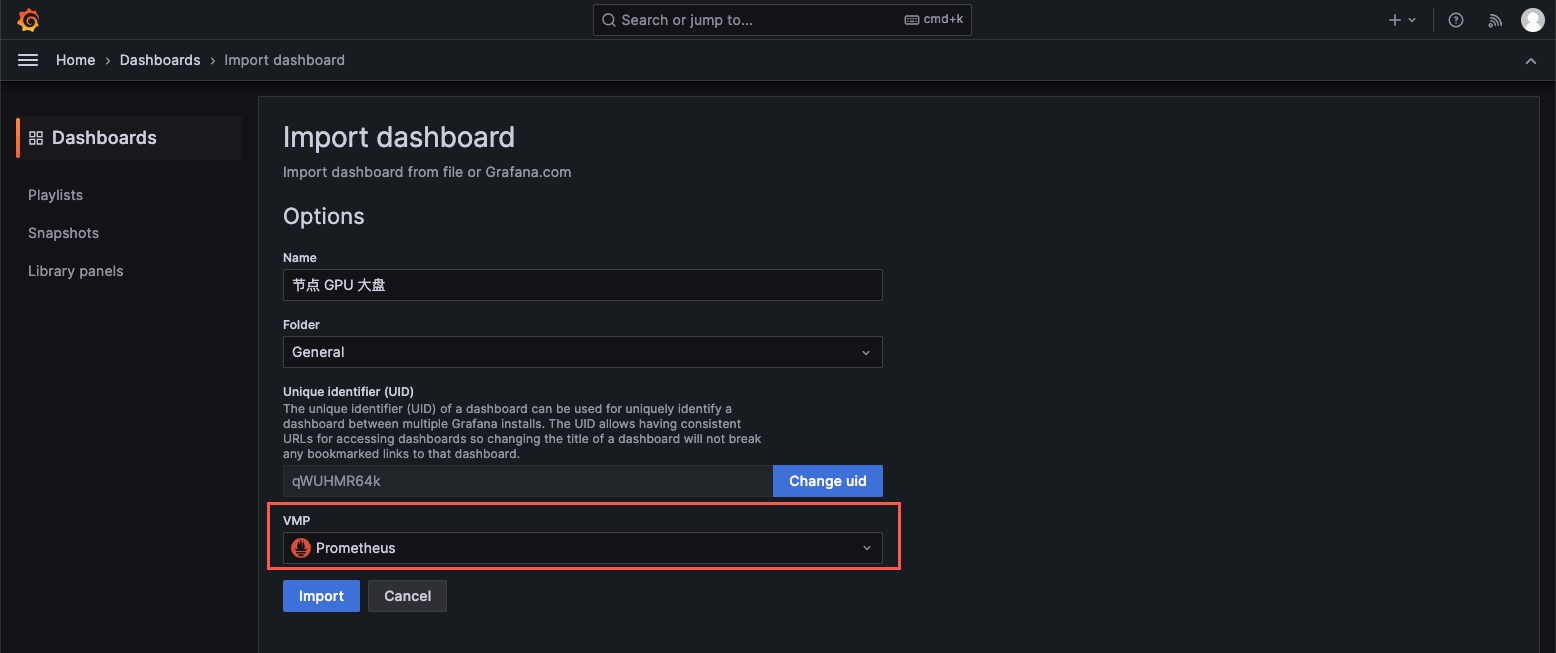
- 配置项说明Name(可选)根据需要修改监控大盘的名称。Folder(可选)选择大盘保存的文件夹,不修改则默认保存在 General 文件夹。VMP选择数据源,您需要在下拉菜单中选择与目标集群绑定的托管 Prometheus 工作区。
- 单击 import,完成导入,即可查看监控大盘。
-
步骤三:开启 AI 资源观测
- 登录 容器服务控制台。
- 单击左侧导航栏中的 集群。
- 在集群列表页面,单击需要查看事件的目标集群。
- 在集群管理页面的左侧导航栏中,单击 观测配置。
- 选择 AI 资源 卡片,单击 启用,开启 AI 资源观测。
-

- 系统自动检查开启集群观测所需的必要条件。包括:工作区配置、组件状态等。
-

- 单击 开启,开启 AI 资源观测。
步骤四:配置告警
- 在集群管理页面的左侧导航栏中,单击 观测配置。
- 选择 AI 资源 卡片,单击 编辑配置 并选择 告警 页签,配置告警的相关参数。
-

-
- 单击 确定,完成配置。
结果验证
查看监控大盘
- 在本地环境中使用 kubectl 连接集群,并执行以下命令,配置 Grafana 服务的端口映射。
kubectl port-forward service/grafana 3000:3000 -n volcano-metrics
- 在本地环境中打开浏览器,在地址栏中输入 localhost:3000,进入 Grafana 登录界面,使用默认用户名admin和密码admin登录。
- 在左侧导航栏中,选择 Dashboards,即可查看 AI 训练任务的监控大盘。
-
查看告警配置
- 登录 VMP 服务控制台。
- 单击左侧导航栏的 告警中心 > 告警规则,选择 告警规则组 页签。在告警规则组列表中,查看生成的告警规则组。
-

-

AI 常用监控大盘
集群 AI 监控大盘
该大盘主要展示了 集群维度 的 AI 训练任务信息和资源使用信息。
信息分类 | 说明 |
集群训练任务概览 | 展示了集群 AI 训练任务信息,包括:AI 训练任务数、GPU Worker 数和训练任务 GPU 利用率。 |
集群 GPU 资源概览 | 展示了集群 GPU 资源信息,包括:GPU 总数、已分配 GPU 数、已使用 GPU 数、故障 GPU 数、GPU 节点数等。 |
资源使用详情 | 展示了集群资源使用信息,包括:训练任务数、GPU Worker 数、训练任务 GPU 利用率、集群 GPU 使用率、集群 GPU 故障率等。 |
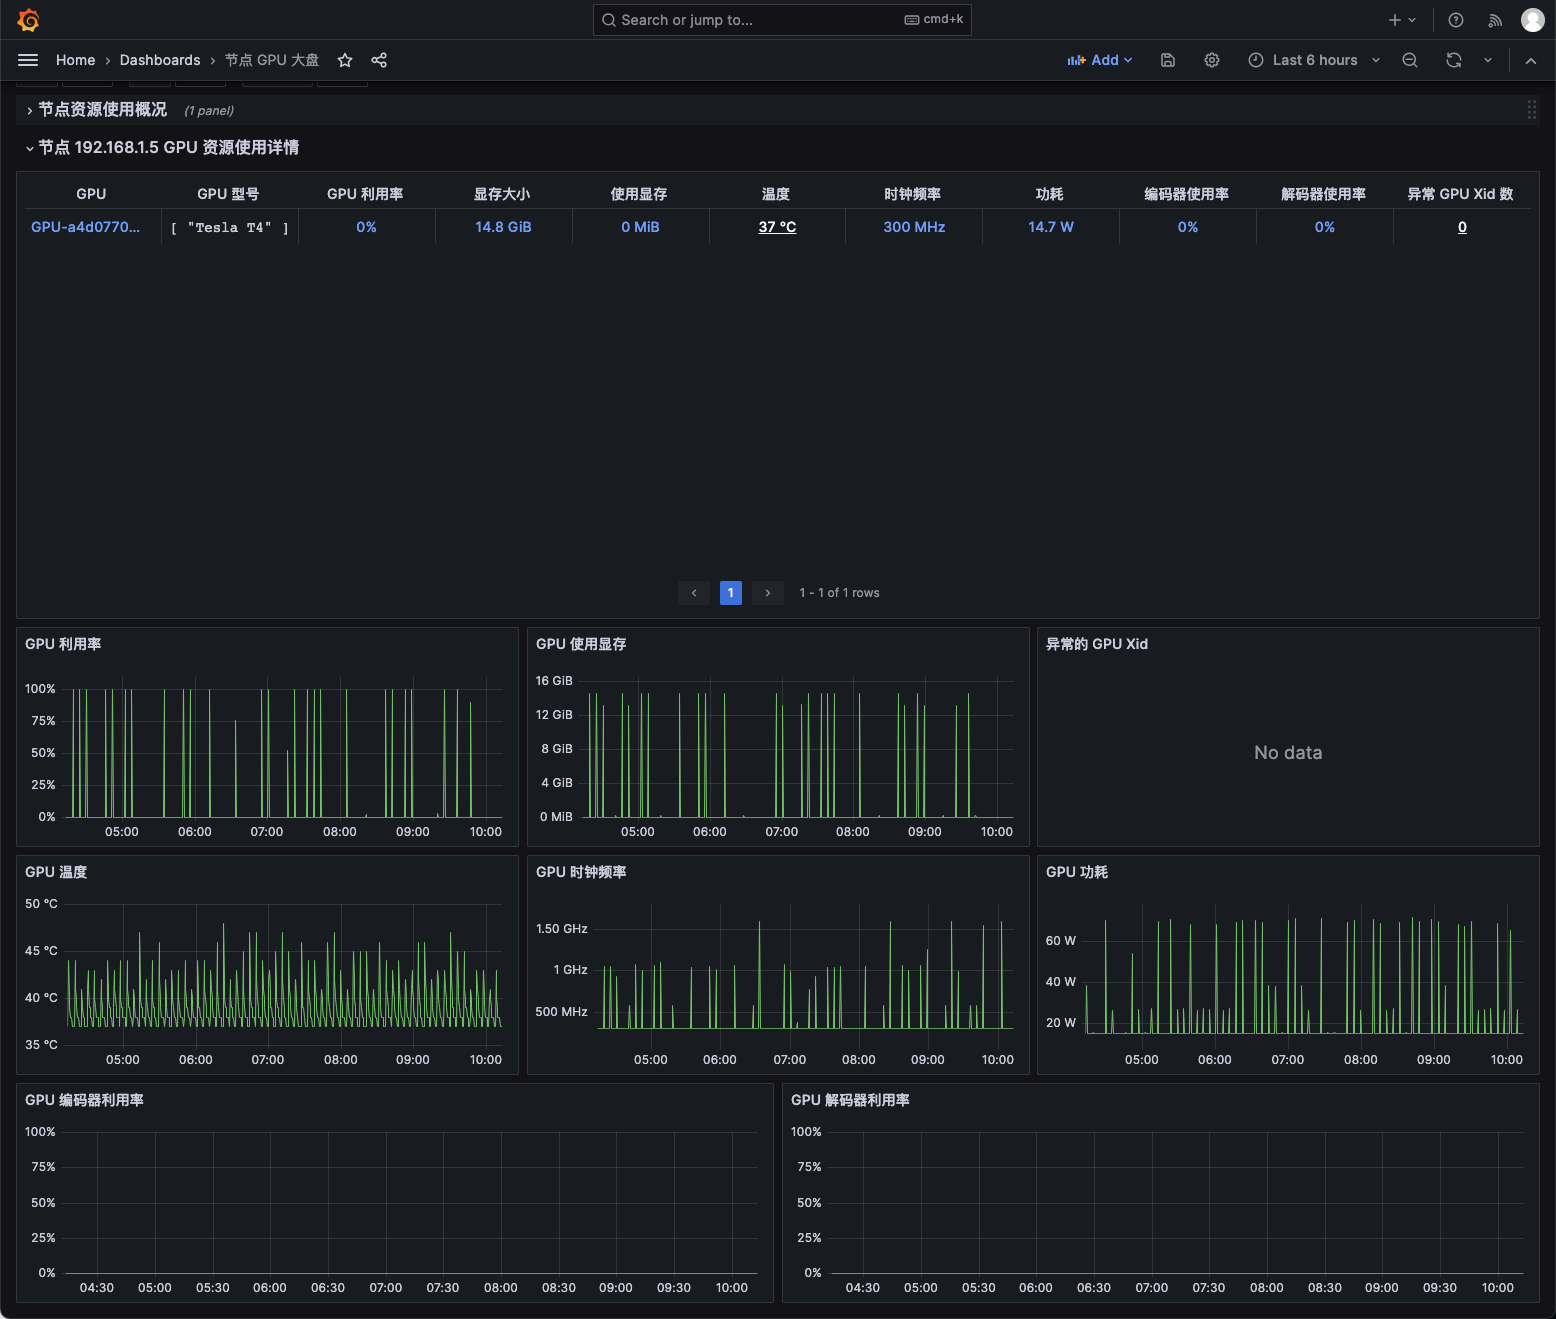
节点 GPU 大盘
该大盘主要展示了 节点维度 的监控信息,包括 GPU 节点监控信息和 GPU 卡监控信息。
信息分类 | 说明 |
节点资源使用情况 | 展示了 GPU 节点的监控信息,包括:节点 IP、GPU 型号、节点状态、CPU 核数、内存、GPU 数等。 |
节点资源使用详情 | 展示了 GPU 卡的监控信息,包括:GPU 利用率、GPU 使用显存、异常的 GPU Xid、GPU 编码器利用率、GPU 时钟频率、GPU 功耗等。 |
训练任务大盘(rdma-device-plugin)
该大盘展示了 任务维度 的 AI 训练任务监控信息和基础资源(GPU、RDMA)监控信息。
说明
信息分类 | 说明 |
训练任务概况 | 展示了训练任务概况,包括:训练任务、训练任务 Worke、GPU 利用率过低的训练任务、GPU 利用率过低的训练任务 Worker。 |
训练任务 None Worker 列表 | 展示了训练任务 None Worker 列表。 |
GPU | 展示了 GPU 监控信息,包括:GPU 利用率、异常的 GPU Xid、GPU 使用显存、GPU 温度、GPU 功耗等。 |
RDMA | 展示了 RDMA 监控信息,包括:包括入方向流量、出方向流量、入方向包数、出方向包数、入方向 Pause 时长、出方向 Pause 时长等。 |
训练任务大盘(node-exporter)
该大盘展示了 任务维度 的 AI 训练任务监控信息和基础资源(GPU、RDMA)监控信息。
说明
信息分类 | 说明 |
训练任务概况 | 展示了训练任务概况,包括:训练任务、训练任务 Worke、GPU 利用率过低的训练任务、GPU 利用率过低的训练任务 Worker。 |
训练任务 None Worker 列表 | 展示了训练任务 None Worker 列表。 |
GPU | 展示了 GPU 监控信息,包括:GPU 利用率、异常的 GPU Xid、GPU 使用显存、GPU 温度、GPU 功耗等。 |
RDMA | 展示了 RDMA 监控信息,包括:入方向流量、出方向流量、入方向报文、出方向报文、Link Down、Error Recovery 等。 |
最近更新时间:2025.09.03 15:52:55
这个页面对您有帮助吗?
有用
有用
无用
无用