AgentKit
AgentKit


文档指南

请输入


- 文档首页
 AgentKitAgentKit用户指南观测基础排障:基于观测体系的统一排障方案
 复制全文
 下载 pdf
基础排障:基于观测体系的统一排障方案
 文档反馈
 问问助手
本文用于指导 AgentKit 智能体运行过程中的故障排查与问题定位,覆盖 Runtime、Tool、Memory、Knowledge、MCP 服务和 MCP 工具集等关键组件。
主要围绕观测体系开展统一排障与结果验证,重点介绍基于告警、基础监控、应用观测和日志的完整排查路径。通过告警及时发现异常并快速分拨排查入口,结合监控指标判断资源健康度,通过应用观测梳理端到端链路行为,依托日志获取报错细节与请求上下文。配套标准化排障步骤与典型故障处理方法,帮助运维、开发人员快速定位组件根因,高效完成问题确认与验证。
注意
执行回滚、重发请求、修改鉴权配置、调整索引、扩容实例等操作前,建议先评估并确认变更的影响范围,同时留存原始错误信息、关键请求样本及变更记录,便于后续问题追溯与回查。
适用场景
适用于请求失败、响应变慢、错误率升高、链路中断、召回异常、工具调用异常、网关返回及后端调用异常等故障场景。
基本概念与使用说明
前提条件
开展故障排查前,请确认已备好故障样本、所需资源、操作权限。
故障样本信息准备
收集如下故障关键信息,用于过滤日志、监控,支撑跨模块定位。
资源准备
- 已为关键资源和关键指标创建告警任务,详情请参见 创建告警任务。
权限准备
- 基础监控
- 部分基础监控项默认开启,部分需手动开启观测服务后才可使用。使用其开展故障排查前,建议确认目标监控项的启用状态:
-
说明
未列入本表格的监控项均为默认开启,无需手动开启。
- 应用观测
- 部分应用观测(可观测)监控项默认开启,部分需手动开启观测服务后才可使用。使用其开展故障排查前,建议确认目标监控项的启用状态:
说明
未列入本表格的监控项均为默认开启,无需手动开启。
-
- 日志
- 需使用日志开展故障排查时,建议确认目标监控项的启用状态,若未开启,请 开启日志。
说明
开启日志功能后,可实时查询智能体 Runtime、Tool、MCP 服务的运行日志,获取请求全流程的错误码、报错详情、入参出参、请求上下文等信息,用于定位异常请求、分析故障根因,辅助问题排查验证。
排障流程总览
建议按照发现异常 → 初步定位 → 逐层排查 → 根因分析 → 解决与验证的流程开展排障。
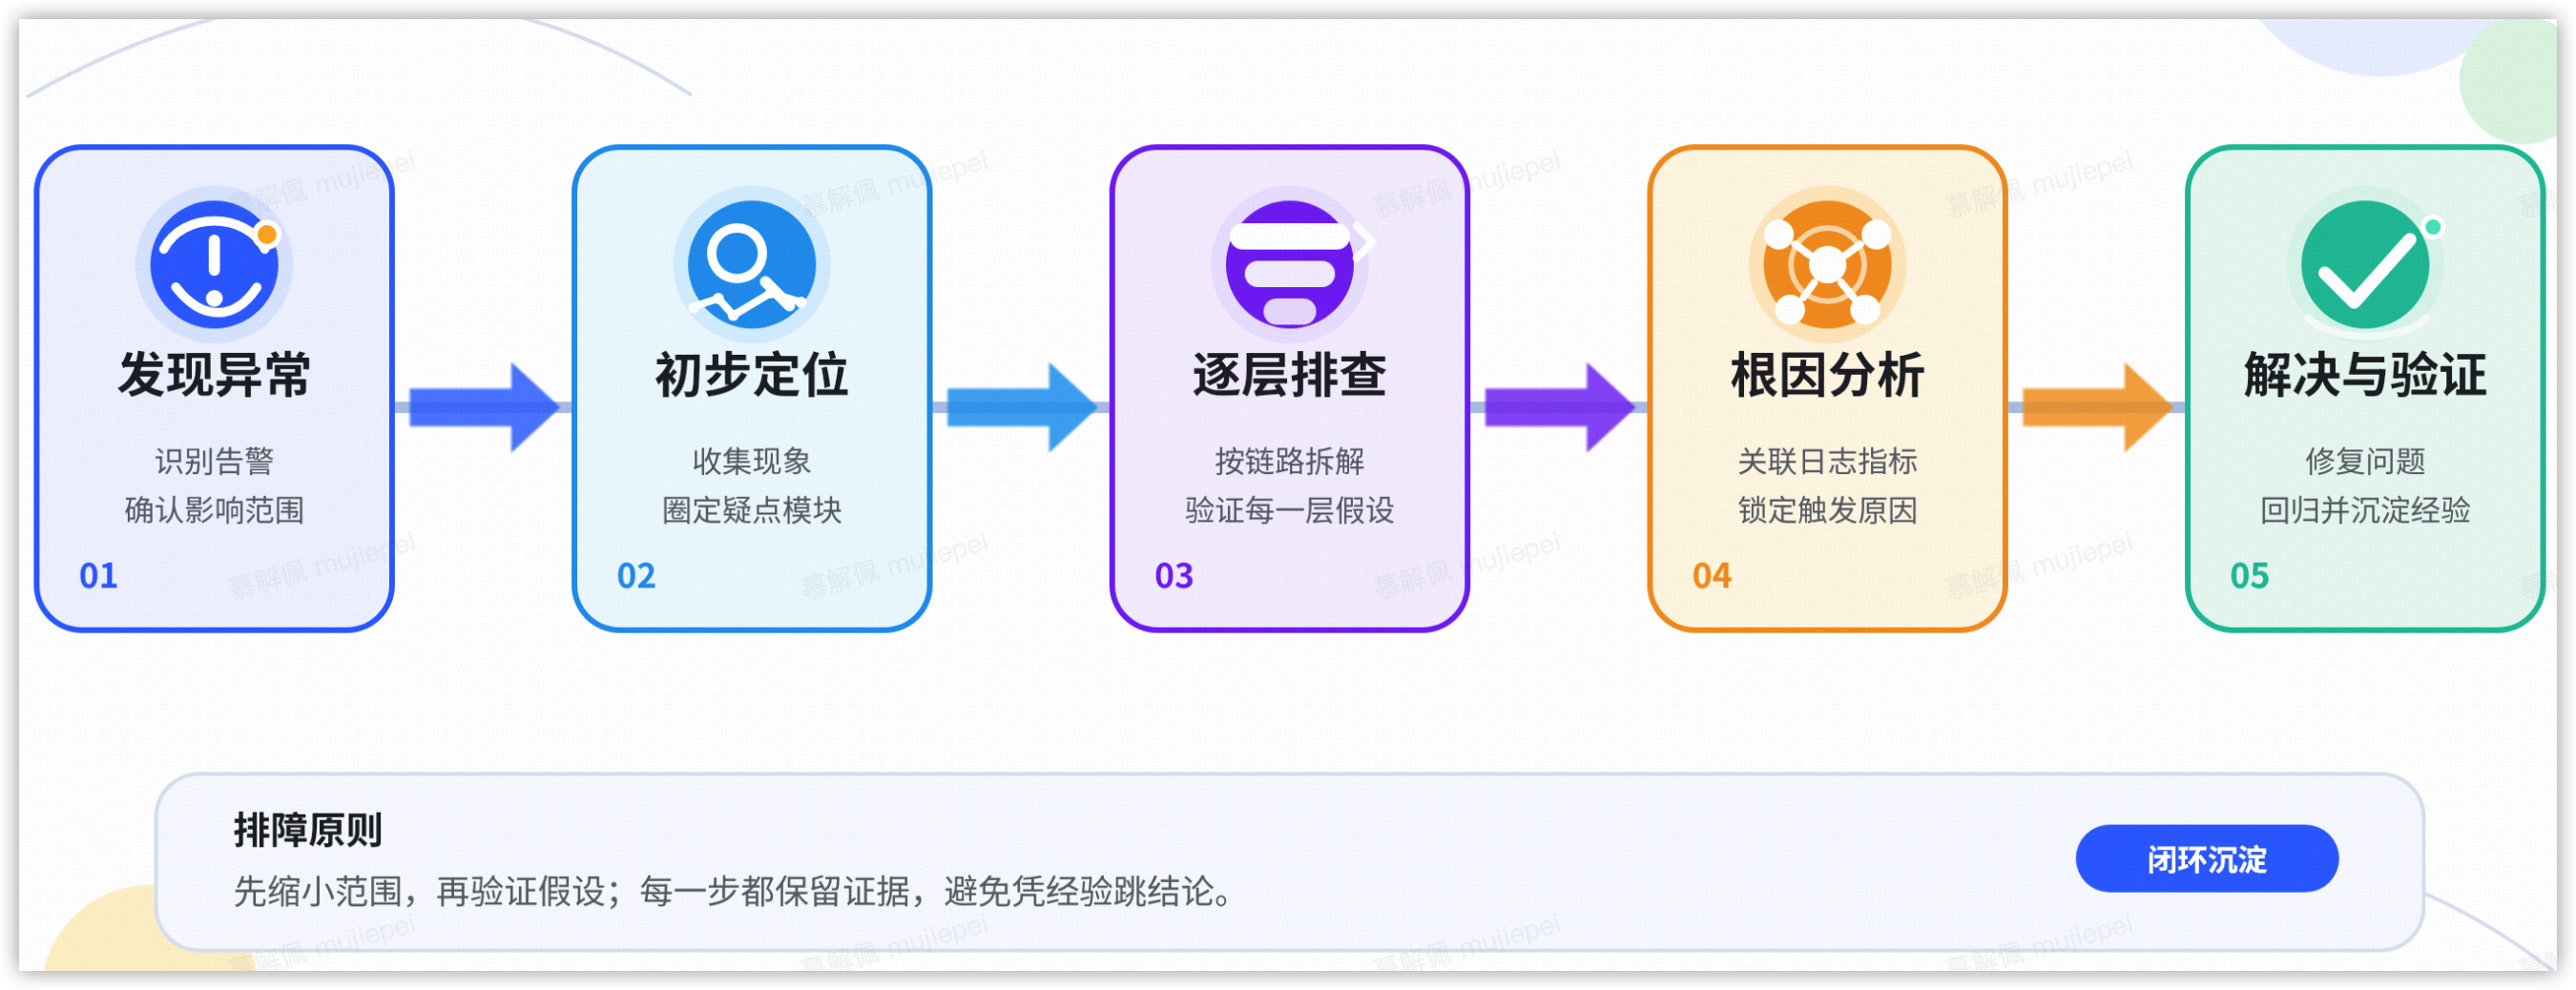
说明
如果异常发生在发布、配置调整、扩缩容或认证变更等之后,优先围绕变更时间点回看监控曲线和日志。变更时间通常是识别异常起点和影响范围的关键线索。
排障步骤
步骤一:发现并定位异常
故障发现阶段建议从告警、基础监控、应用观测、日志四个入口建立初步判断。不同入口适合识别的问题不同,应根据现象选择入口,而不是从所有页面逐项查看。
步骤二:按基础监控逐层排查
当异常根因尚不明确时,建议按照 Runtime → Tool → Memory / Knowledge → MCP 服务 → MCP 工具集 的顺序开展逐层排查。该顺序可先验证主执行链路是否稳定,再向下核查各依赖组件与数据链路,逐步收敛到具体异常模块。
步骤三:按故障类型处理
完成异常初步定位之后,结合告警、监控、链路、日志输出的信息,根据实际故障表现,进入对应的专项排查处理路径。
下文归纳 5 大类故障,覆盖智能体(Agent)生产运行过程中的典型异常场景,可对照故障现象开展定向排查。
认证失败
现象
请求未进入 Runtime 执行阶段即返回权限相关错误,常见 HTTP 状态码为 401 MissingAuthenticationToken。
可能原因
该错误发生在 Runtime 接收请求之前,属于接入鉴权层面失败,并非 Agent 业务逻辑、Tool 或 Memory 内部报错。
- 缺少身份认证的必要信息,例如 API Key 或 Token 已过期、被撤销、或未包含目标 Agent / 模型 / 工具的调用权限。
- MCP 服务侧独立配置了鉴权,Agent 未在调用时携带对应凭据。
排查步骤
- 检查请求是否携带 Auth 认证信息
- 核对 HTTP 请求 Header,确认存在 Authorization 字段。
- 校验 Token 本身有效性
- 确认 Token 没有过期。
- 确认 Token 完整,没有截断、多余空格、换行字符。
- 如果是签名模式,核对 AppKey/AppSecret,确认签名算法、时间戳、参数组装逻辑正确。
- 确认账号 / Token 的调用权限
- 该 Token 对应的账号是否拥有目标智能体的调用权限。
- 是否受租户、空间、API 调用白名单限制。
- 查看网关 / 接入层日志
- 使用响应返回的 request_id,检索接入网关日志,不要检索 Agent Runtime 日志。
Tool 失败
现象
Runtime 执行至 Tool 调用节点报错,Tool 监控页面的请求分布中出现非 2xx 状态码占比升高,或平均延迟显著抬升。
可能原因
- Tool 入参格式或类型与工具 Schema 不匹配,如缺失必填字段、类型错误、枚举取值越界。
- 模型生成的工具调用 JSON 存在截断或转义错误,导致解析失败。
- 工具依赖的外部 API 返回异常(超时、5xx、限流),被工具透传为调用失败。
- 工具实例 CPU / 内存水位过高,出现响应队列积压。
排查步骤
- 进入Tool 监控,按 tool name 定位异常调用记录,确认失败发生的具体工具与时间。
- 展开该请求的执行详情,查看入参与出参字段。若入参存在缺失或类型错误,需回到模型 Prompt / Function Schema 层修正约束。
- 查看工具返回的错误码与错误信息:
- 若为工具自身校验错误(如 4xx),修正入参或工具实现逻辑;
- 若为工具透传的后端错误(如 5xx、timeout),进入后端失败排查路径。
- 观察工具的实例资源指标。若 CPU 使用率长期高于 80 % 或内存使用率接近上限,扩容工具实例或优化工具处理逻辑。
- 修复后使用相同入参构造回归请求,确认工具监控中该 tool name 的错误率回落。
模型失败
现象
模型节点未返回有效响应,或响应格式异常、内容被截断,Runtime 监控的请求分布中出现 5xx 或超时占比升高。
可能原因
- 模型服务端限流、扩容不足或临时不可用,导致响应超时。
- Runtime 侧 timeout 配置低于模型实际响应时长,尤其在长上下文或推理密集场景。
- max_tokens、temperature、top_p 等生成参数配置不合理,输出被提前截断或触发生成异常。
- 模型 model id、endpoint 或 API 版本被误改,指向了不存在或不匹配的资源。
排查步骤
- 在 Runtime 监控 中定位对应请求,展开模型调用节点,查看状态码、耗时与返回内容。
- 在 Runtime 详情页 > 配置信息中,核对 model id 是否为预期模型资源,确认当前模型处于运行中状态。
- 若为超时错误,将 Runtime 侧的调用 timeout 调整至不低于模型 P99 响应时长的 1.5 倍,并同步评估上游客户端的超时策略。
- 若响应内容异常或截断,检查 max_tokens 是否覆盖预期输出长度,必要时调低 temperature、top_p 以降低生成不稳定性。
- 关注模型服务侧的容量与限流公告;如遇平台级故障,可在观测页面通过错误率同比确认影响范围。
检索失败
现象
可能原因
- Memory 或 Knowledge中缺少与当前 Query 语义相近的数据,写入延迟或索引未完成也会造成检索空命中。
- 检索参数(如相似度阈值、top_k、过滤条件)配置过严,导致召回被过度收敛。
- 向量化模型与写入时使用的 Embedding 模型不一致,导致相似度计算不生效。
- 检索服务与向量库之间网络异常,或对应资源处于不可用状态。
排查步骤
- 在 Memory 监控中定位对应请求的检索记录,确认调用是否成功、耗时是否异常。
- 进入Memory 列表,确认目标 Memory 状态为可用,并在目标 Memory 详情中查看创建事件指标以确认写入操作已完成。
- 使用相同 Query 在 Memory 调试入口进行离线检索,若离线检索命中而线上未命中,需检查线上调用侧的 top_k、相似度阈值、租户 / 标签过滤条件是否配置合理。
- 核对写入侧与检索侧使用的 Embedding 模型与版本,二者需保持一致,避免向量空间错配。
- 若检索服务本身报错(如 5xx、超时),在 Memory 监控中查看总错误率指标趋势,判断是否为平台侧异常。
后端失败
现象
Tool 或 MCP 调用返回后端错误,常见 HTTP 状态码为 500 Internal Server Error、502 Bad Gateway、503 Service Unavailable、504 Gateway Timeout;MCP 集监控中请求分布的失败区间占比升高。
可能原因
- 后端 API 服务本身不可用、部署异常或版本回滚。
- 请求参数不符合后端接口规范,触发服务端异常。
- 后端服务存在频率限制(Rate Limit),近期调用频次超出配额。
- 网关到后端的网络链路异常,或 DNS、TLS 握手失败。
- MCP 工具集的语义检索或标签检索命中了错误的后端路由。
排查步骤
- 通过 trace id 展开子调用链,识别是网关侧失败、还是后端服务侧失败:
- 若失败在网关侧,检查 MCP 服务的服务运行指标(CPU / 内存 / 实例数量)与网关健康检查配置;
- 若失败在后端侧,联系对应服务责任人核查服务状态或运维日志。
- 对比后端接口 Schema 与实际请求参数,确认字段名、类型、必填项与枚举值符合规范。
- 观察调用频次曲线:若在报错时间窗口出现请求量骤增,需评估是否触发后端限流,必要时扩容或申请提升配额。
- 若为 MCP 工具集的路由问题,在 MCP 工具集监控中查看语义检索请求次数与语义检索工具索引数,确认索引是否完整、路由目标是否正确。
步骤四:解决与验证
完成原因判断后,建议将处置动作与验证动作配对执行,避免“已处理但未验证”的情况。无论采用哪种处置方式,均建议在处置后立即进入验证阶段。
验证标准
验证通过通常至少满足三个条件:一是核心监控指标恢复到正常区间;二是同类请求验证通过且不再复现;三是对应日志与链路中不再出现同类型异常。仅恢复其中一项,通常不足以说明问题已完全解决。
处置建议
- 若问题由发布或配置变更引起,优先回滚或修正对应变更。
- 若问题由实例负载或资源不足引起,优先恢复实例健康状态并观察容量指标。
- 若问题由Tool、Memory、Knowledge、MCP 服务和 MCP 工具集依赖异常引起,优先恢复对应依赖服务,再回看主链路是否恢复。
- 若问题由埋点或字段口径异常引起,优先修正接入方式,并重新核对指标与字段定义。
- 若问题尚未彻底定位,可保留 trace id、错误信息与时间窗口,便于进一步升级排查。
验证方式
最近更新时间:2026.08.11 18:44:30
这个页面对您有帮助吗?
有用
有用
无用
无用