ArkClaw 企业版
ArkClaw 企业版


文档指南

请输入


- 文档首页
 ArkClaw 企业版ArkClaw 企业版管理员观测ArkClaw查看ArkClaw用量分析
 复制全文
 下载 pdf
查看ArkClaw用量分析
 文档反馈
 问问助手
平台针对 ArkClaw 实例提供用量分析监控看板,方便全局监控 ArkClaw 的资源消耗情况,本文为您介绍如何查看用量分析监控看板。
说明
员工 Claw 与企业服务智能体提供的看板指标和数据筛选条件存在差异,具体以控制台展示为准。
背景信息
ArkClaw 用量分析提供以下几种数据来源,可根据实际场景选择合适的数据来源:
- ArkClaw 网关:新版用量分析看板默认使用的 Token 用量数据源,直接从 ArkClaw 网关获取 Token 用量数据,与 ArkClaw 的数据限流口径保持一致,数据统计的准确性更高。
- 自建网关:新版用量分析提供的自定义 Token 用量数据源,将自建网关数据上报到应用性能监控,获取 Token 用量数据,精准呈现真实的业务用量与访问趋势,便于直观掌握资源消耗情况。接入自建网关用量数据的详细说明参见:自建网关用量数据上报。
- 观测插件:旧版用量分析看板使用的 Token 用量数据源,通过观测插件获取到的 Token 用量数据,数据统计粒度较粗,仅供参考。
说明
为持续提升 Token 用量数据统计的准确性,通过观测插件统计的数据将于2026年08月31日正式下线,推荐使用 ArkClaw 网关或自建网关的数据查看用量分析。
前提条件
- 管理员已经完成企业系统权限和回调信息等基础配置,并成功开通 ArkClaw 企业版。更多详细说明参见:空间开通快速入门。
- 企业员工已经申请和创建 ArkClaw,并与 ArkClaw 发起对话,进行任务处理。更多详细说明参见:企业员工使用 ArkClaw。
查看看板
- 登录 ArkClaw 企业版控制台。
- 在左侧导航栏选择 运维管理 > 可观测。
- 选择观测看板和数据分析的数据来源。其中,Claw 实例页面展示员工 Claw 相关观测看板和数据分析;企业服务智能体页面展示企业服务智能体相关观测看板和数据分析。
- 单击 用量分析 页签,查看 ArkClaw 用量分析监控看板。
说明
用量分析中的指标仅供参考,实际费用请以对应模型服务的计费数据为准。新版 Token 用量的统计口径如下:
- ArkClaw 网关:经网关流转的请求数据将自动纳入统计并展示。
- 第三方自建网关:需接入 ArkClaw 提供的埋点上报方案,完成指标上报后方可查看。
- 大模型直连 Endpoint:暂不纳入统计与展示,请前往模型服务商控制台查看实际消耗。
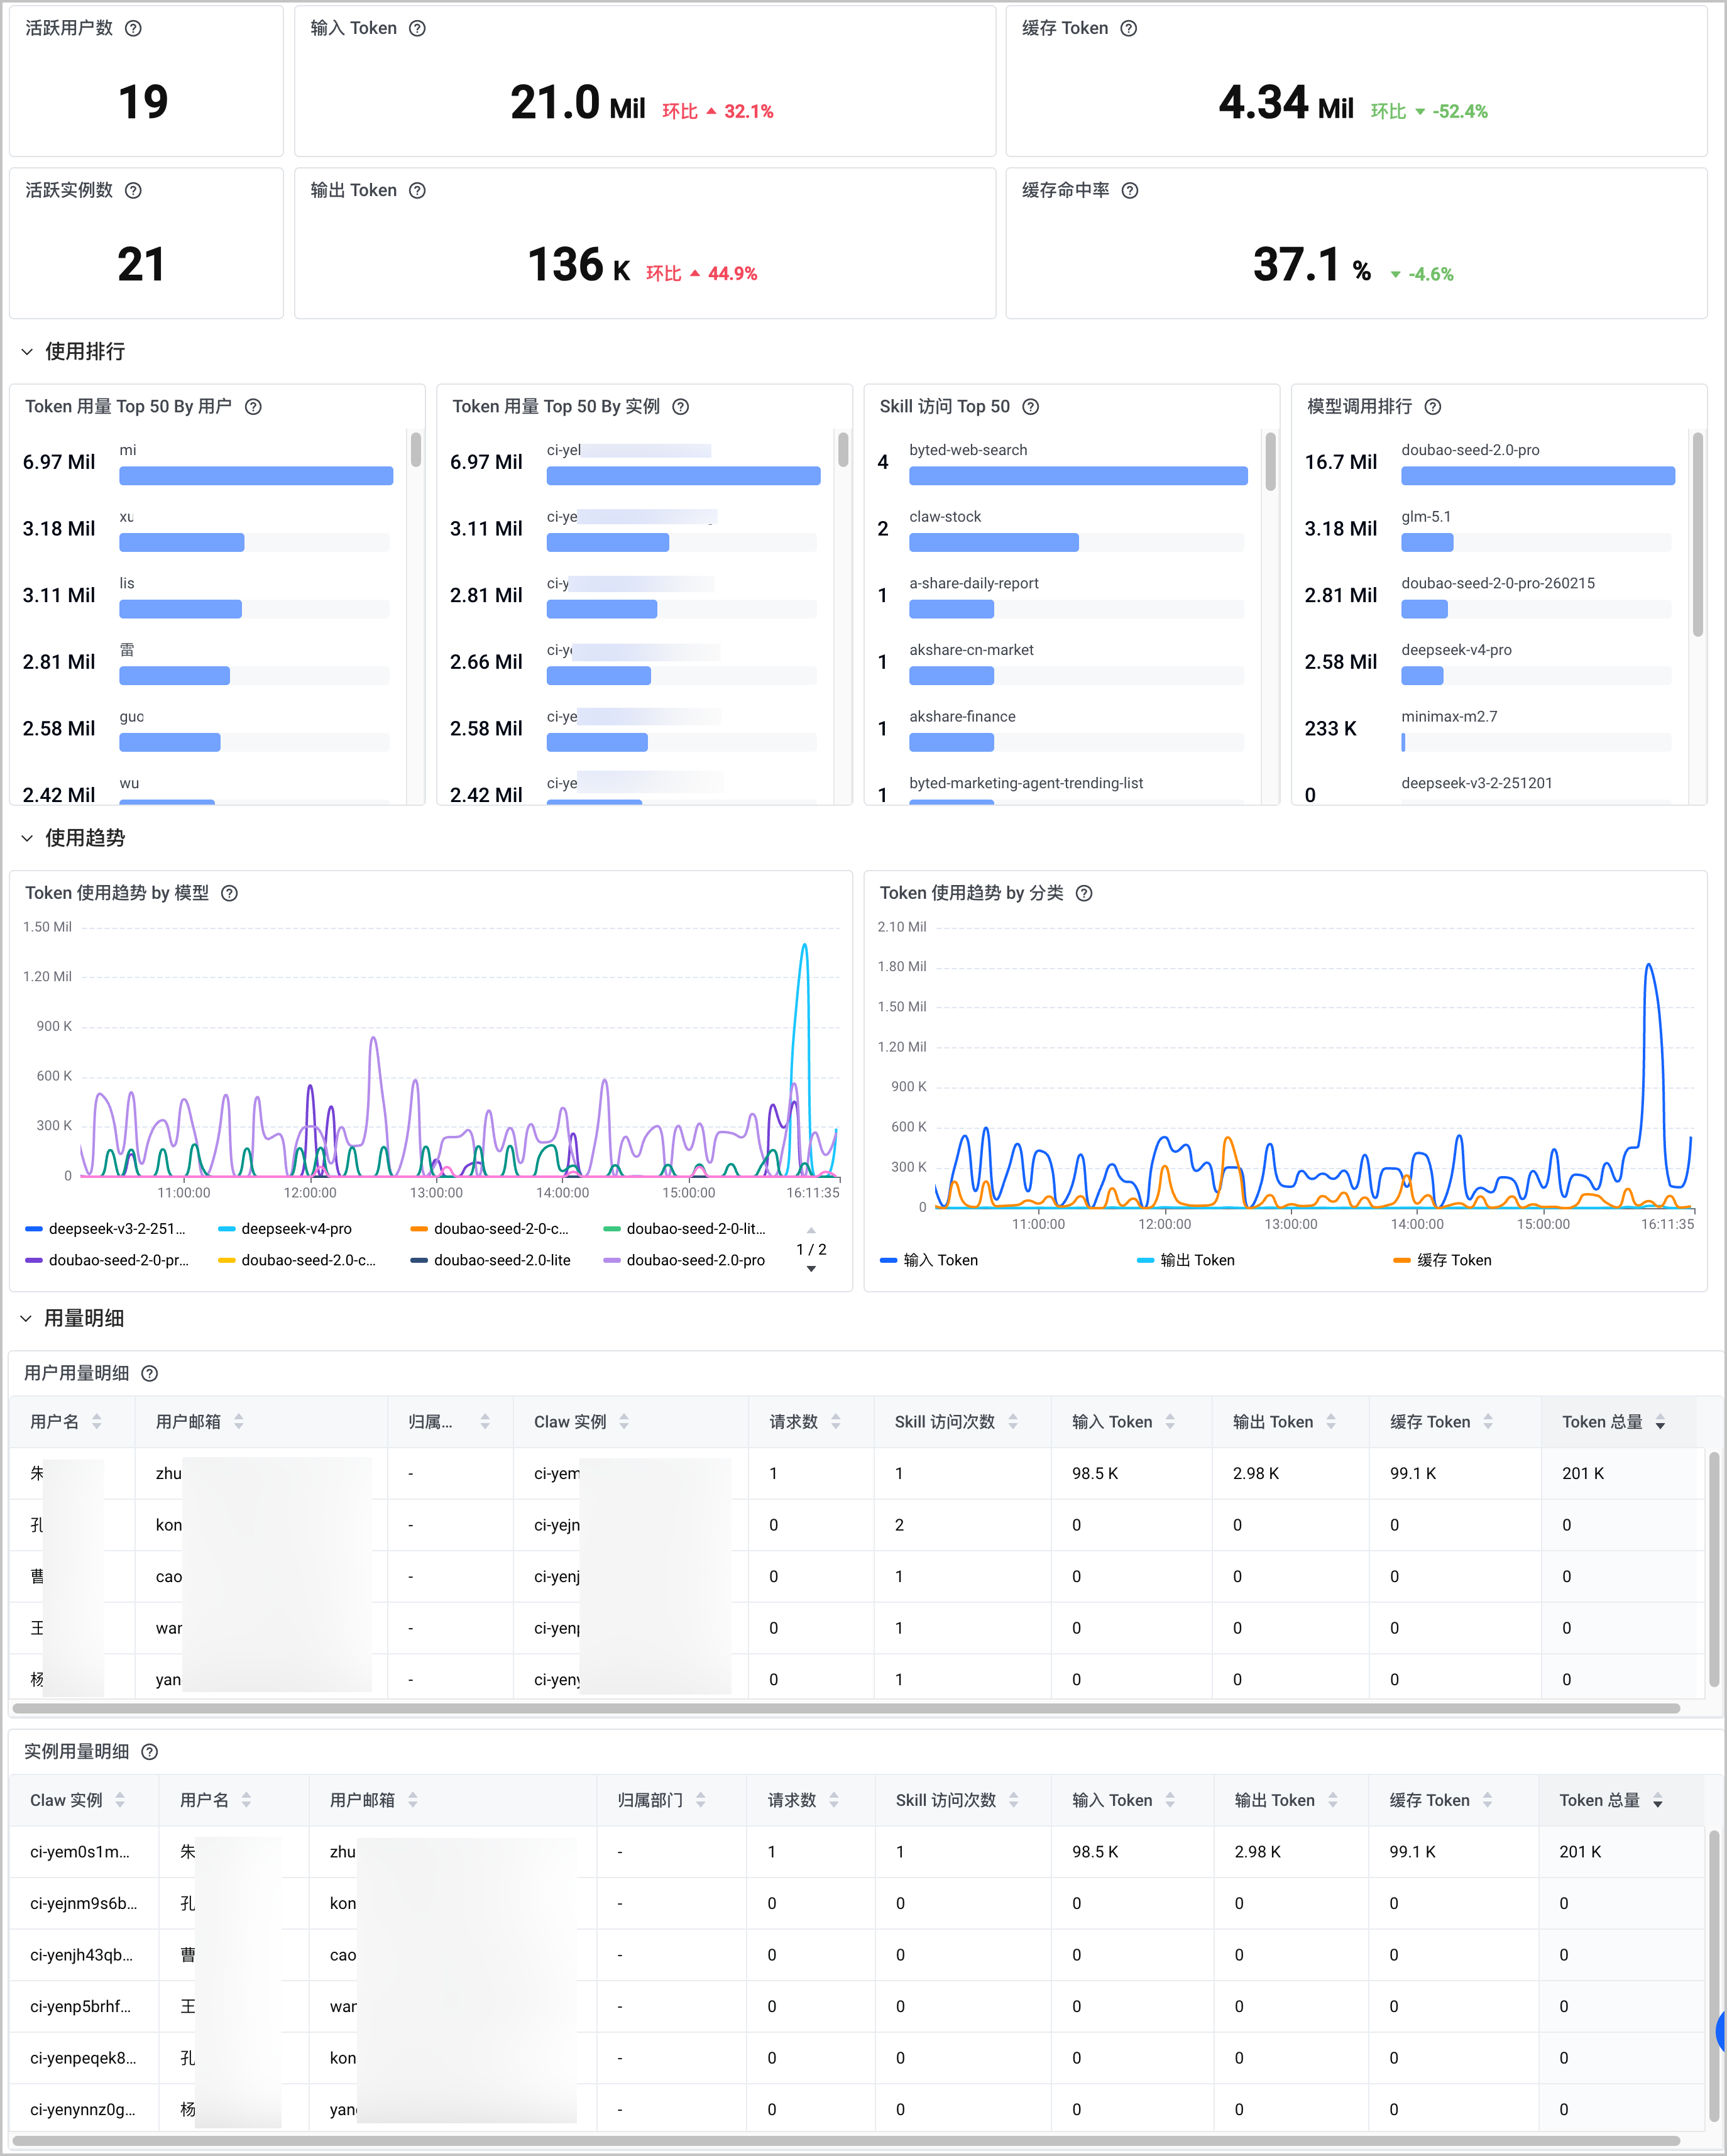
分类 | 指标 | 说明 |
基础数据 | 活跃用户数 | 指定时间范围内存在请求调用或 Token 使用数量不为 0 的用户数量。 |
| 活跃实例数 | 指定时间范围内存在请求调用或 Token 使用数量不为 0 的 ArkClaw 实例数量。 |
| 输入 Token | 指定时间范围内输入的 Token 数量总和,用于衡量输入文本量,是模型计算与计费的核心输入项。 |
| 输出 Token | 指定时间范围内输出的 Token 数量总和,用于衡量模型生成内容长度,是模型计算与计费的核心输出项。 |
| 缓存 Token | 指定时间范围内从缓存中读取的 Token 数量,用于衡量缓存复用效率,反映缓存命中带来的资源节省。 |
| 缓存命中率 | 指定时间范围内中输入 Token 的缓存命中率,通过缓存命中率,能够判断缓存策略有效性。其中,缓存命中率 = 缓存 Token / (输入 Token + 缓存 Token)。 |
使用排行 | Token 用量 Top 50 By 用户 | 指定时间范围内 Token 调用总量排行前 50 的用户,用于快速定位 Token 消耗最高的用户,识别成本与性能热点。其中,Token 调用总量 = 输入 Token + 输出 Token + 缓存 Token。 |
| Token 用量 Top 50 By 实例 Token 用量 Top 50 By 共享 Agent | 指定时间范围内 Token 调用总量排行前 50 的 ArkClaw 实例列表,用于快速定位 Token 消耗最高的实例,识别成本与性能热点。其中,Token 调用总量 = 输入 Token + 输出 Token + 缓存 Token。 |
| Skill 访问 Top 50 | 指定时间范围内被读取并加载进上下文总次数排名前 50 的 Skill 文件列表,用于直观呈现技能层的访问热度,是技能资产活跃度、业务依赖度的核心量化依据。 |
| 模型调用排行 | 基于 Token 调用总量展示模型调用排行,直观呈现不同模型的使用占比,可用于识别核心依赖与高成本模型,为成本管控、模型选型提供量化数据支撑。其中,Token 调用总量 = 输入 Token + 输出 Token + 缓存 Token。 |
使用趋势 | Token 使用趋势 by 模型 | 指定时间范围内不同模型的 Token 调用总量使用趋势。用于识别高消耗模型与流量分配结构,支撑模型成本核算、选型优化、路由调度与配额规划,保障系统稳定并提升资源使用效率。 |
| Token 使用趋势 by 分类 | 指定时间范围内不同类型的 Token 使用趋势,可视化展示输入/输出/缓存 Token 随时间的变化规律,可用于成本预测、业务周期分析等,是长期成本与性能分析的基础。 |
用量明细 | 用户用量明细 共享 Agent 用量明细 | 基于用户维度展示指定时间范围内的实例总请求数和 Token 消耗情况,关键指标包括:用户名、归属部门、Claw 实例、请求数、Skill 访问次数、输入 Token、输出 Token、缓存 Token 和 Token 总量。 注意 Claw 实例并非实际开通的实例,仅代表指定时间范围内存在数据交互的 Claw 实例。 |
| 实例用量明细 | 基于实例维度展示指定时间范围内的实例总请求数和 Token 消耗情况,关键指标包括:Claw 实例、用户名、归属部门、请求数、Skill 访问次数、输入 Token、输出 Token、缓存 Token 和 Token 总量。 |
更多操作
监控看板支持以下基础操作:
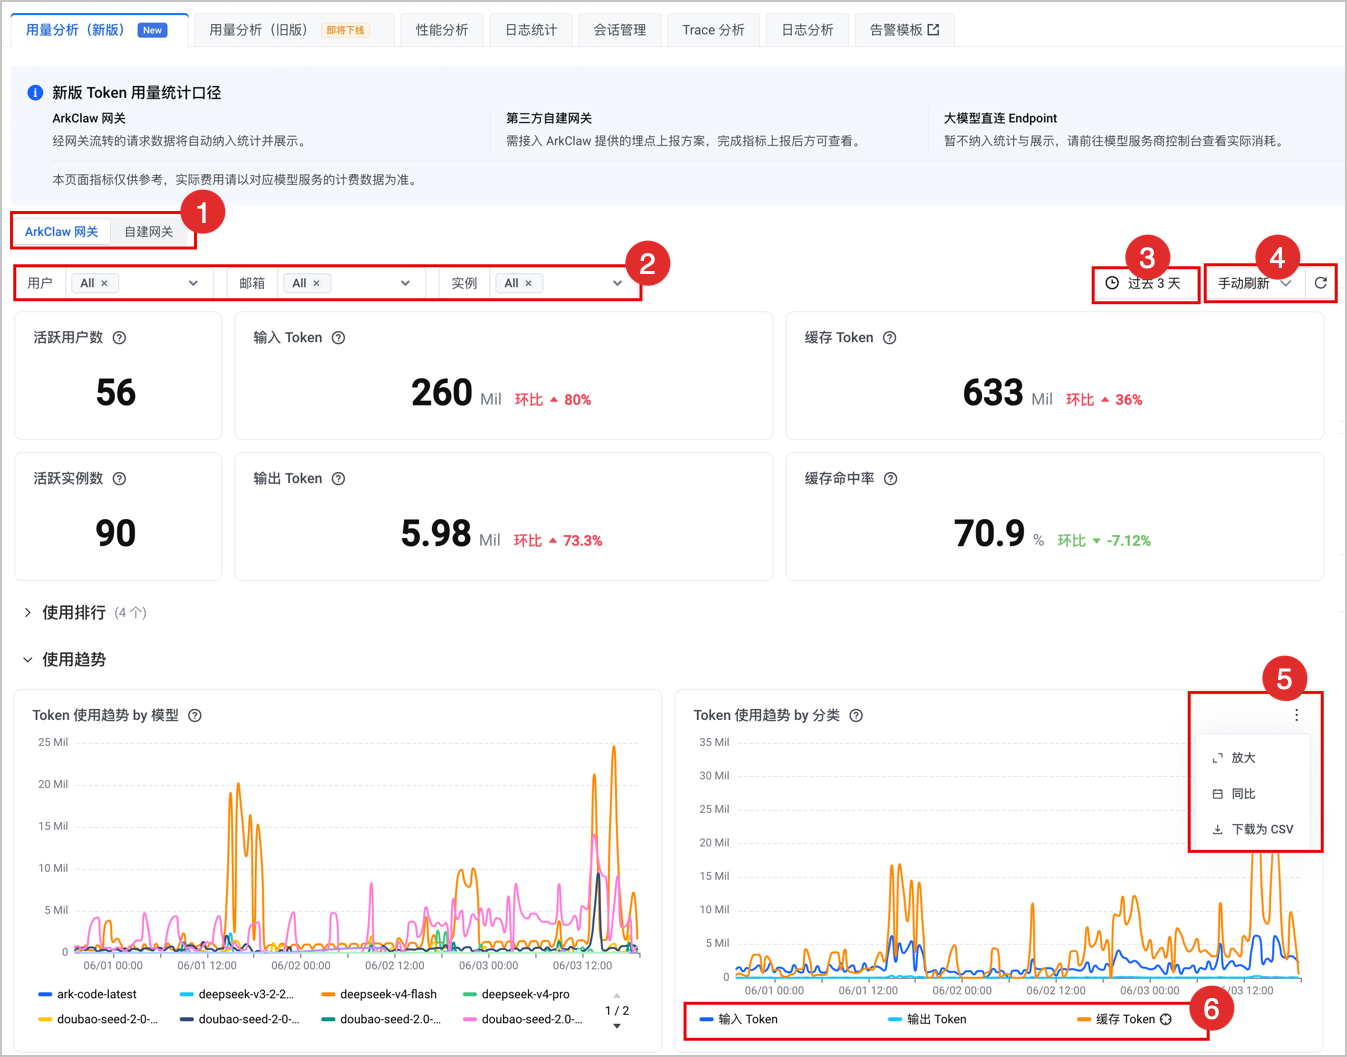
序号 | 操作 | 说明 |
1 | 数据源 | 说明 为持续提升 Token 用量数据统计的准确性,通过观测插件统计的数据将于2026年08月31日正式下线,推荐使用 ArkClaw 网关或自建网关的数据查看用量分析。 |
2 | 资源筛选 | 根据用户、邮箱、实例进行数据筛选,默认为 All。 |
3 | 时间范围 | 指定时间范围进行数据筛选,支持通过相对时间范围或绝对时间范围方式进行数据筛选。 |
4 | 刷新频率 | 数据刷新频率,支持手动刷新或根据指定时间自动刷新。 |
5 | 图表操作 | 针对单个图表提供的操作,例如:放大、同比、下载为 CSV。 说明 不同图表支持的操作存在差异,以实际显示为准。
|
6 | 图表数据筛选 | 单击图表底部的图例,筛选图表中的数据源。
|
7 | 实例详情快捷跳转 | 单击计量条上方的实例 ID,支持快速跳转到当前实例的详情页面,查看详细信息。 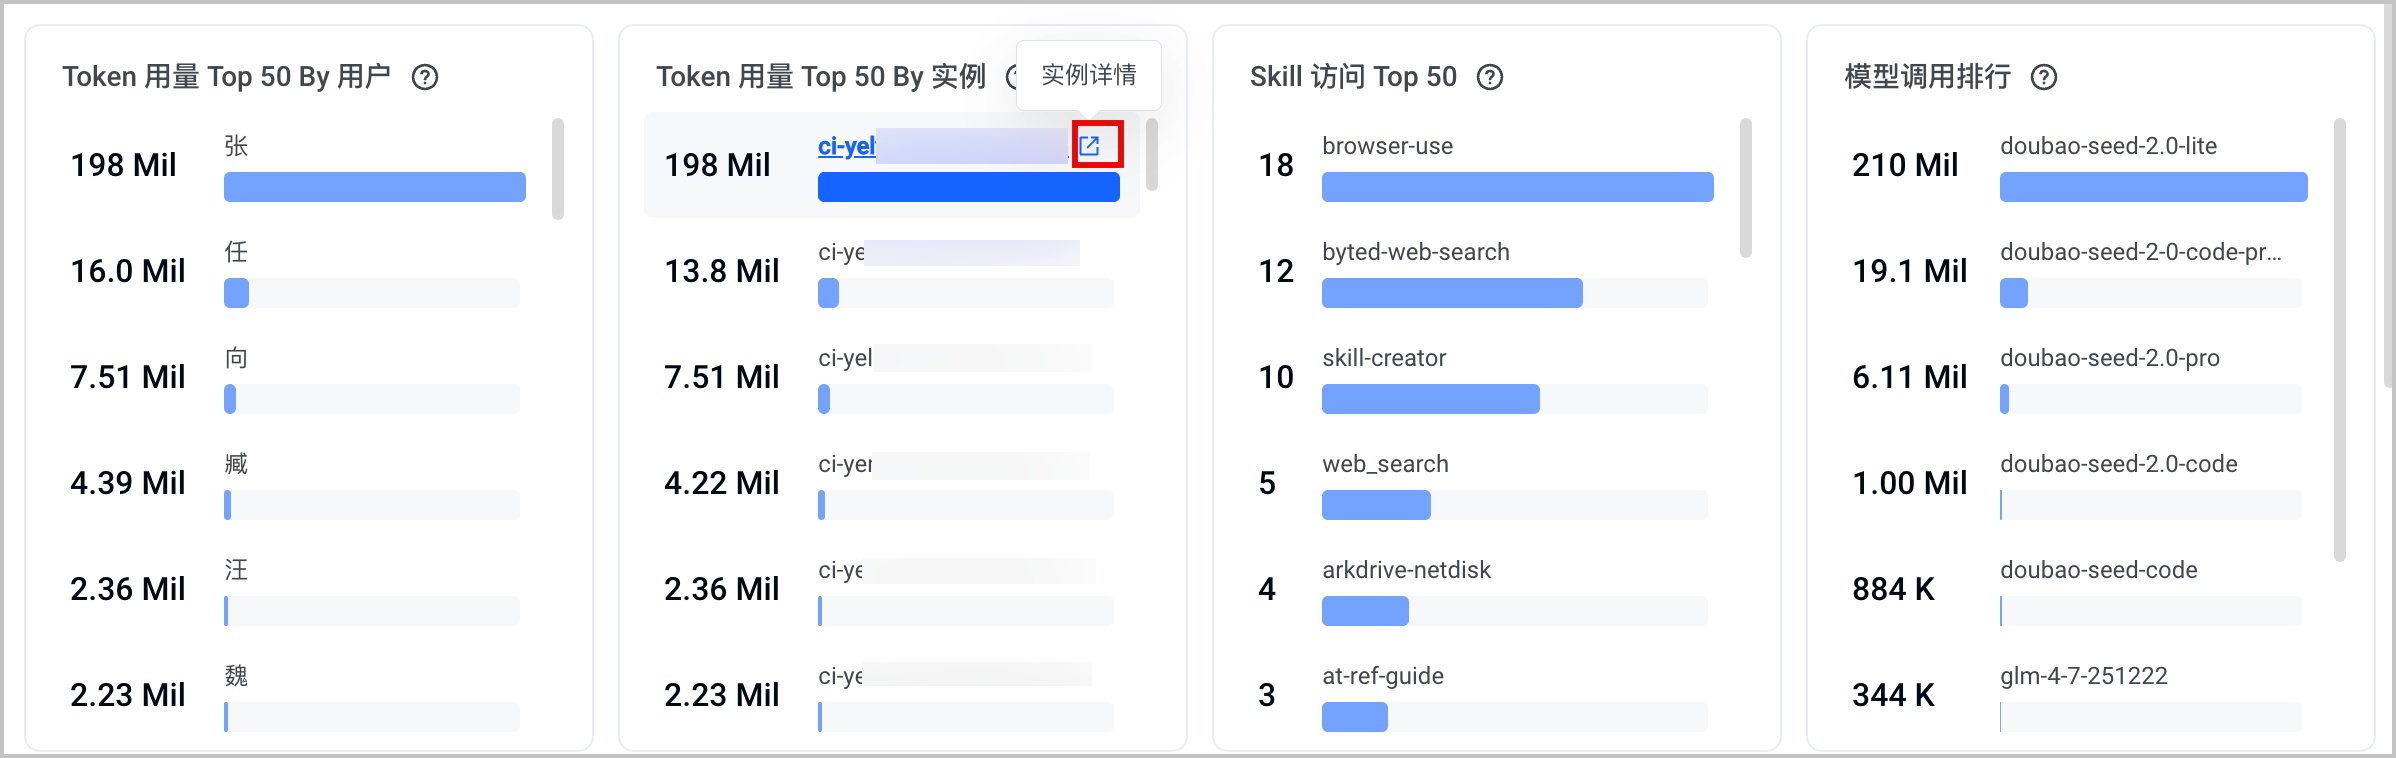 |
8 | 表格数据排序 | 单击表格图表标题右侧的排序按钮,支持按升序或降序对数据进行排序。 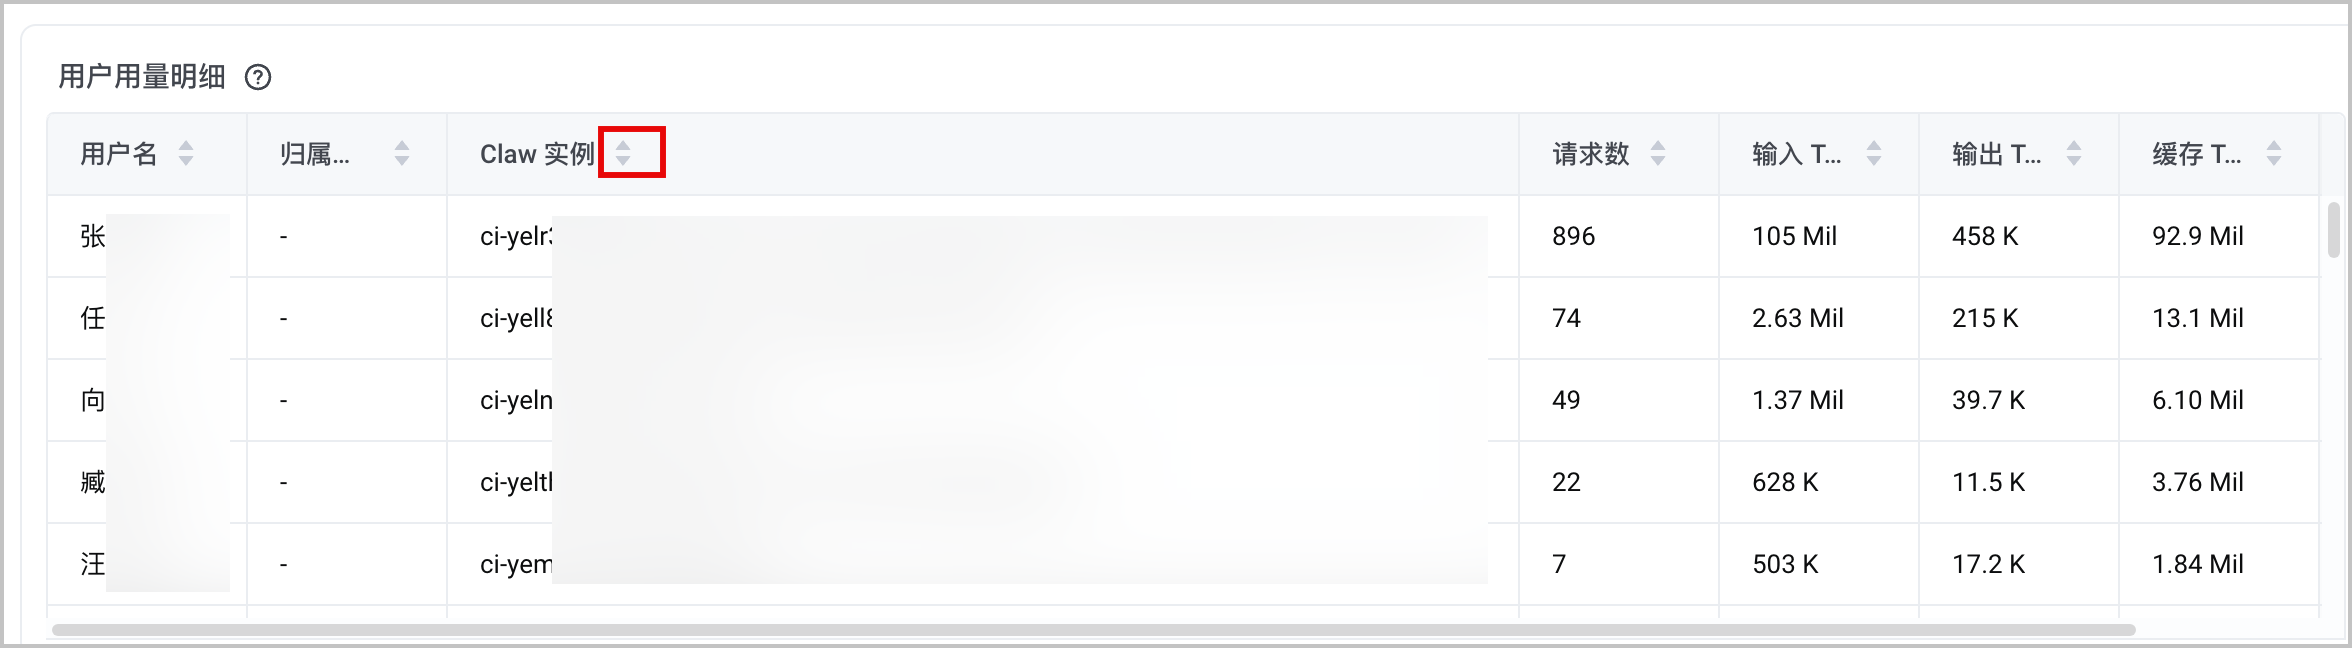 |

最近更新时间:2026.08.25 20:31:16
这个页面对您有帮助吗?
有用
有用
无用
无用