实时音视频
实时音视频


文档指南

请输入


- 文档首页
 实时音视频AI 音视频互动方案开发指南接入端到端实时语音大模型
 复制全文
 下载 pdf
接入端到端实时语音大模型
 文档反馈
 问问助手
除了标准的 ASR+LLM+TTS 模块化方案,AI 音视频互动还支持直接接入豆包端到端语音模型。端到端模型将听、想、说集成在同一个模型中,可以减少模块间的处理和传输延迟,使实时对话更加自然。
新旧模型差异
准备工作
- 前往豆包语音控制台,开通所需的端到端实时语音模型服务。
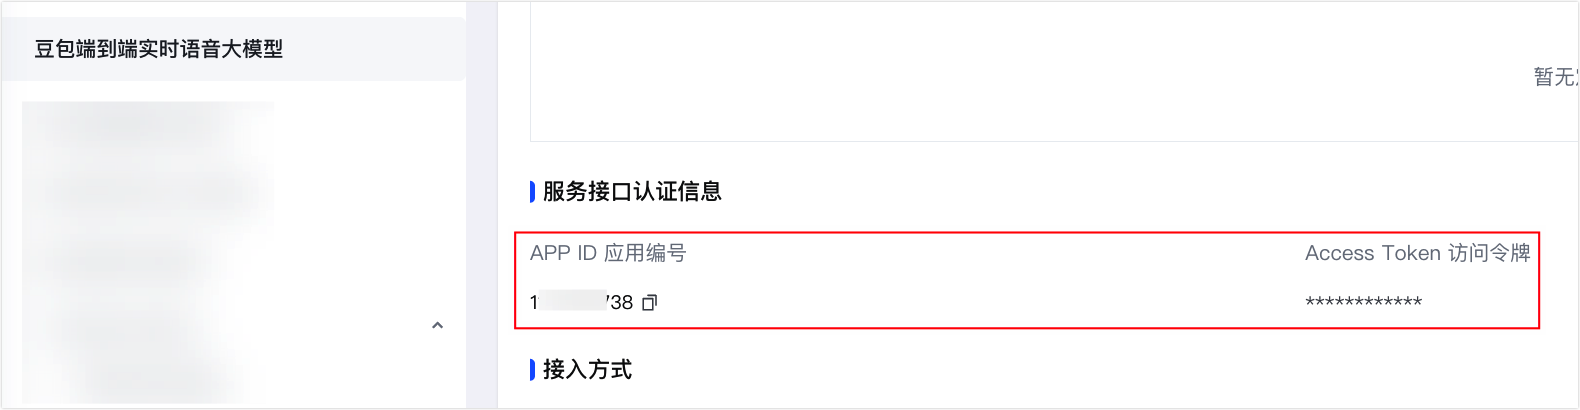
- 获取模型服务的 APP ID 和 Access Token。
- 准备 RTC 应用、房间和智能体所需的 AppId、RoomId、TaskId 及用户 ID。
接入豆包实时语音模型 3.0(Seeduplex)
使用限制
- 对于 ASR、TTS、LLM 配置:
- 纯端到端模式下:无需配置 ASRConfig、TTSConfig 和 LLMConfig,系统会忽略这些配置。
- 混合编排模式下:无需配置 ASRConfig 和 TTSConfig,系统会忽略这些配置。
- 对于字幕:在使用字幕功能时,必须将 SubtitleConfig.SubtitleMode 设置为 1(快速字幕)。
纯端到端和混合编排的差异
快速接入
进阶功能
设置人设、音色和声音效果
- 系统提示词:通过参数 ProviderParams.session.instructions。
- 音色:通过参数 ProviderParams.session.audio.output.voice。
- 语速和音量:通过参数 ProviderParams.session.audio.output.speed 和 loudness 设置。
使用 Function Calling
基本实现跟 LLMConfig 相同,有以下差异:
- 需在 S2SConfig.ProviderParams.session.tools 中声明工具。
- 不支持配置安抚语。
在 LLMConfig.Tools 中声明工具,并通过 FunctionCallingConfig 配置回调。S2SConfig.ProviderParams.session.tools 在该模式下不生效。完整实现参见函数调用 Function Calling。
接入 MCP
在 S2SConfig.MCP 中配置 MCP Server:
- 通过 S2SConfig.MCP[].InterestedTools 限制加载的工具。
- 通过 S2SConfig.MCP[].ComfortWords 配置工具调用期间的等待提示。
- 通过 S2SConfig.ExtraHeader 向 MCP Server 透传鉴权 Header。
实现视觉理解
注意
仅混合编排模式支持视觉理解。
实现方式(如客户端采集、视频抽帧等)与普通 LLM 模式基本一致,但存在以下差异:
使用 Seeduplex 混合编排开启实时视觉理解或图片理解时,必须在 LLMConfig.SystemMessages 中加入 <NOVISION> 规则。不需要结合画面回答时,LLM 只能输出 <NOVISION>;需要结合画面回答、处理输入图片或调用工具时,不得输出该标识。系统检测到 <NOVISION> 后采用 Seeduplex 的回答,否则采用LLMConfig 接入的模型的回答。未配置该规则时,视觉理解可能无法正常生效,系统也可能选错回答来源。
实现联网搜索
- 前置准备。
- 前往联网搜索 API 控制台,开通联网搜索 API 服务。支持以下版本:
- web搜索:满足多样的常规搜索需求,用户可获取所需的高质量内容。
- web搜索总结版:在此基础上提供大模型内容总结,以获得提炼总结后的一段式内容,提升信息获取效率。
- 创建一个 API Key,并记录下 API Key 值。具体操作,请参见智能体API认证方式。
- 在 S2SConfig.ProviderParams 中增加以下配置:
提升语音识别准确性
纯端到端和混合编排使用相同的 ASR 配置。在 ProviderParams.asr.extra 中配置二遍识别、热词和替换词:
管理上下文
- 通过 ProviderParams.dialog.dialog_context 按 user、assistant 成对初始化历史问答。
- 通过 S2SConfig.HistoryLength 设置 RTC 为当前 S2S 会话保留的历史轮数。
- 通过 UpdateVoiceChat 的 ReplaceUserPrompts 修正保留范围内的历史问答。
接入旧版豆包端到端实时语音模型
旧版模型适用于需要继续使用 O2.0、SC2.0、声音复刻和旧版角色控制能力的业务。
使用限制
- 对于 ASR、TTS、LLM 配置:
- 纯端到端模式下:无需配置 ASRConfig、TTSConfig 和 LLMConfig,系统会忽略这些配置。
- 混合编排模式下:无需配置 ASRConfig 和 TTSConfig,系统会忽略这些配置。
- 对于字幕:在使用字幕功能时,必须将 SubtitleConfig.SubtitleMode 设置为 1(快速字幕)。
- 对于控制指令:通过服务端 API UpdateVoiceChat 或 客户端 API sendUserBinaryMessage 发送的 ExternalPromptsForLLM 和 ExternalTextToLLM 指令不生效。
- 暂时不支持视觉理解能力。
纯端到端和混合编排的差异
对比项 | 纯端到端 | 混合编排 |
配置 | OutputMode=0 | OutputMode=1,同时配置 LLMConfig |
回答生成 | 旧版端到端模型直接回答 | 端到端模型和外挂 LLM 同时处理,系统根据外挂 LLM 是否触发 Function Calling 选择回答 |
Function Calling | 不支持 | 由外挂 LLM 处理 |
MCP | 不支持 | 由外挂 LLM 处理 |
视觉理解 | 不支持 | 不支持 Seeduplex 视觉编排 |
适用场景 | 旧版低时延对话、角色演绎、声音复刻 | 在保留旧版语音能力的同时接入外部工具 |
快速接入
将 OutputMode 设置为 0。以下示例使用 O2.0 模型:
将 OutputMode 设置为 1 并配置外挂 LLM。以下示例使用 SC2.0 模型,只启用基础语音对话;如需 Function Calling 或 MCP,再按“进阶功能”中的对应章节增加配置。
进阶功能
- 选择模型并设置声音
-
- 通过 ProviderParams.dialog.extra.model 选择模型。O2.0 使用 1.2.1.1,支持精品音色和唱歌能力;SC2.0 使用 2.2.0.0,支持声音复刻、角色演绎和角色控制。
- O 系列通过 bot_name、system_role 和 speaking_style 设置角色与表达风格。
- SC 系列通过 character_manifest 描述角色,通过 tts.speaker 设置音色。
- 通过 ProviderParams.tts.audio_config.speech_rate 和 loudness_rate 调整语速和音量。该能力仅支持 2.0 版本模型。
旧版模型版本、音色和声音效果仍通过 S2SConfig.ProviderParams 配置。外挂 LLM 的人设和业务规则通过 LLMConfig.SystemMessages 配置。两处人设应保持一致,避免端到端回答与外挂 LLM 回答风格不同。
- 提升语音识别准确性
- 纯端到端和混合编排使用相同的 ASR 配置。在 ProviderParams.asr.extra 中配置二遍识别、热词和替换词:
-
- 开启联网搜索
- 若需让 AI 能够查询实时信息(如天气、新闻、股价),可启用火山联网搜索 API。
- 前置准备。
- 前往联网搜索 API 控制台,开通联网搜索 API 服务。支持以下版本:
- web搜索:满足多样的常规搜索需求,用户可获取所需的高质量内容。
- web搜索总结版:在此基础上提供大模型内容总结,以获得提炼总结后的一段式内容,提升信息获取效率。
- 创建一个 API Key,并记录下 API Key 值。具体操作,请参见智能体API认证方式。
- 在 S2SConfig.ProviderParams 中增加以下配置:
-
- 防抢话
- 在端到端混合编排模式下,若遇到智能体过早打断用户(即“抢话”),可通过配置内部 VAD 参数来延长判停等待时间。以下参数需写入 S2SConfig.ProviderParams.asr.extra 中:
- * end_smooth_window_ms:判停平滑窗口,默认值较短。建议将其调高(例如 800 ~ 1200 毫秒),强制模型在用户停止说话更长时间后才判定为一句话结束。
- * SilenceTime:静音超时阈值,配合调节可进一步防打断。
- 管理上下文
- 通过 S2SConfig.HistoryLength 设置保留轮数,通过 UpdateVoiceChat.ReplaceUserPrompts 修正保留范围内的历史问答。
最近更新时间:2026.10.21 10:51:36
这个页面对您有帮助吗?
有用
有用
无用
无用