实时音视频
实时音视频


文档指南
请输入


实时音视频
快速入门
场景方案
开发指南
Token 鉴权
音频管理
视频管理
屏幕共享
SDK 升级指南
客户端 API 参考
服务端 API 参考
房间管理
转推直播
输入在线媒体流
WTN 流(原公共流)
实时数据监控
历史数据查询
业务标识管理
实时消息通信
历史版本(文档停止维护)
2023-08-01
2023-06-01
转推直播
2022-06-01
2020-12-01
转推直播
输入在线媒体流
获取数据指标
常见问题
集成相关
质量相关
AI 音视频互动方案
开发指南
配置 ASR/LLM/TTS 服务
API 参考
硬件对话智能体
用户指南
服务端 API
智能体
实时信令
互动白板
客户端 API 参考
服务端 API 参考
- 文档首页
 实时音视频AI 音视频互动方案开发指南实时字幕(对话记录)
 复制全文
 下载 pdf
实时字幕(对话记录)
 文档反馈
 问问助手
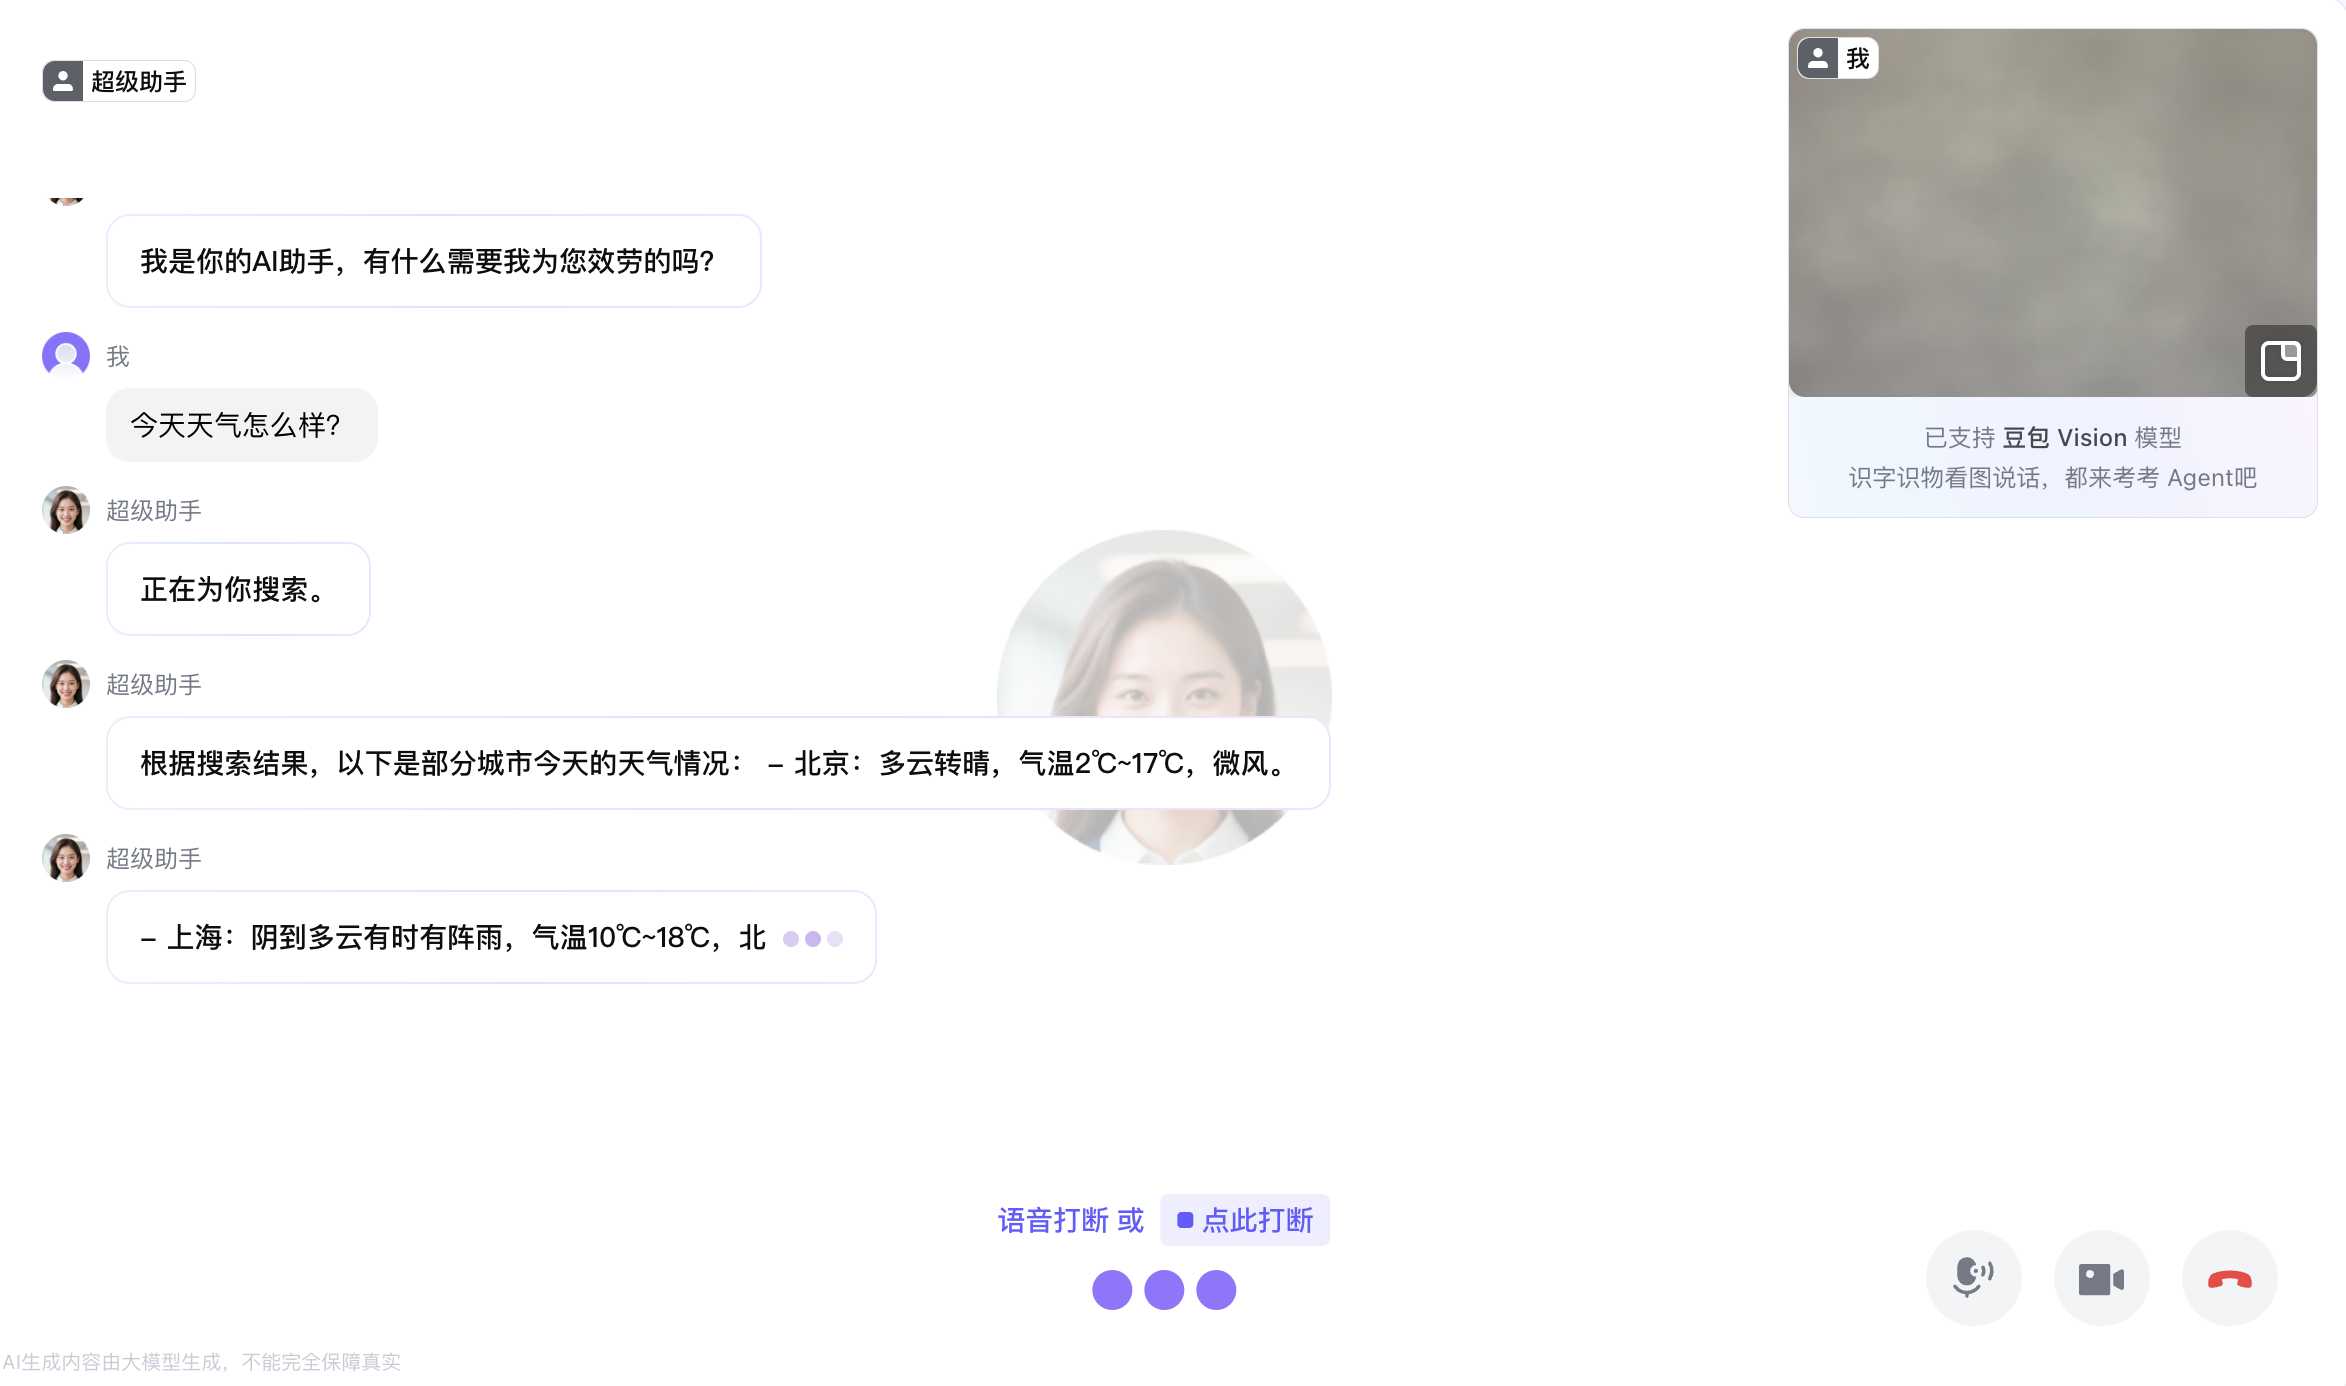
在与 AI 对话过程中,系统会自动生成用户和 AI 的对话文本。您可通过客户端或服务端实时获取该数据,用于实时 UI 展示、存储等。
- 实时字幕展示:将真人用户和 AI 的语音实时转为文字,并在应用终端界面上展示。
- 业务存储分析:记录并存储对话文本,用于后续的业务数据分析、服务质量监控或模型优化。
字幕类型与使用限制
我们提供了多种字幕类型满足不同的业务场景诉求,可在调用 StartVoiceChat 时通过 SubtitleConfig.SubtitleMode 配置。不同字幕类型适用场景和限制有区别。
- 当使用 数字人服务 或 端到端实时语音大模型 时,SubtitleMode 仅支持设置为 1,即快速字幕。
- 其他限制:
说明
字幕回调速度:3 >1 > 0 = 2。
- 字幕类型说明与限制字幕类型说明与限制对齐时间戳字幕SubtitleMode:0字幕来源于 TTS,与 AI 实际播报的音频进行时间戳对齐。但字幕生成稍慢,部分特殊符号可能被转义而无法显示。该模式下,支持暂停和续播。使用限制:
- 直传 TTS 参数时:若使用 SubtitleMode: 0模式,必须关闭 enable_latex_tn(LaTeX 公式朗读)。
- 透传 TTS 参数时:若使用 SubtitleMode: 0模式,必须关闭 req_params.additions.cache_config和 req_params.additions.enable_latex_tn。
- 当 TTSConfig.AutoActive 为 false 时该模式不可用。
快速字幕SubtitleMode:1字幕为处理后的 LLM 回复文本(即会过滤空格回车等特殊字符)。返回时系统会将识别到的分句或整句一次性返回,字幕不对齐音频时间戳,可实现快速回调字幕信息。使用限制:当 TTSConfig.AutoActive 为 false 时该模式不可用。音频帧对齐字幕SubtitleMode:2字幕来源于 TTS。与 AI 实际播报的音频可精准对齐,实现类似卡拉 OK 的逐字高亮效果,并支持暂停和续播。相较于对齐时间戳字幕,抗网络波动效果更好。该模式下,系统会将字幕的位置信息直接嵌入到每个音频帧的附加信息(extraInfo)中。在客户端收到完整的句子文本后,再根据每个音频帧携带的字符索引,即可在播放音频的同时精准高亮对应的文字,从而实现音文的强同步。使用限制:启用该模式时,必须关闭音频快速发送(Burst)功能。极速字幕SubtitleMode:3字幕为 LLM 的原始输出,不会过滤任何字符,完整保留换行符等格式。适用于内容保真、需快速回调字幕的场景。
获取字幕数据
方式一:通过客户端获取
适用于需要在终端界面实时展示字幕的场景。数据通过客户端 SDK 回调获取,字幕是流式返回的。
步骤 1:开启配置
调用 StartVoiceChat 在启动 AI 时,添加 Config.SubtitleConfig 配置:
- DisableRTSSubtitle:设置为 false,开启客户端字幕回调。
- SubtitleMode:按需选择,具体区别参见字幕类型与使用限制。
// 仅展示字幕配置
"SubtitleConfig": {
"DisableRTSSubtitle": false,
"SubtitleMode": 0
}
步骤 2:接收并解析字幕
- 监听回调:通过 ByteRTC SDK 的 onRoomBinaryMessageReceived(嵌入式硬件场景使用on_message_received)接收字幕消息(二进制格式)。
- 解析数据:字幕以二进制消息格式 message(magic number 为 subv)回调给客户端,收到消息后需解析 message。
- message 格式:参见字幕数据格式。
- message 解析示例:
说明
- 以下示例为字幕数据的部分解析逻辑。在真实业务开发中,请注意根据您的实际应用场景(如仅做文本展示或需实现音文对齐高亮)按需提取和处理相关字段。
- 对于音频帧对齐字幕,您需要解析并存储 roundId、firstCharPos、lastCharPos 等信息,作为后续音频帧匹配的字幕库。
- C++JavaObjective-C//定义结构体struct SubtitleMsgData {bool definite;std::string language;bool paragraph;int sequence;std::string text;std::string userId;int roundId; int firstCharPos;int lastCharPos;};//回调事件void onRoomBinaryMessageReceived(const char* uid, int size, const uint8_t* message) {std::string subtitles;bool ret = Unpack(message, size, subtitles);if(ret) {ParseData(subtitles);}}//拆包校验bool Unpack(const uint8_t *message, int size, std::string& subtitles) {int kSubtitleHeaderSize = 8;if(size < kSubtitleHeaderSize) { return false;}// magic number "subv"if(static_cast<uint32_t>((static_cast<uint32_t>(message[0]) << 24) | (static_cast<uint32_t>(message[1]) << 16) | (static_cast<uint32_t>(message[2]) << 8) | static_cast<uint32_t>(message[3])) != 0x73756276U) {return false;}uint32_t length = static_cast<uint32_t>((static_cast<uint32_t>(message[4]) << 24) | (static_cast<uint32_t>(message[5]) << 16) | (static_cast<uint32_t>(message[6]) << 8) | static_cast<uint32_t>(message[7]));if(size - kSubtitleHeaderSize != length) {return false;}if(length) {subtitles.assign((char*)message + kSubtitleHeaderSize, length);} else {subtitles = "";}return true;}//解析void ParseData(const std::string& msg) {// 解析 JSON 字符串nlohmann::json json_data = nlohmann::json::parse(msg);// 存储解析后的数据std::vector<SubtitleMsgData> subtitles;// 遍历 JSON 数据并填充结构体for (const auto& item : json_data["data"]) {SubtitleMsgData subData;subData.definite = item["definite"];subData.language = item["language"];subData.paragraph = item["paragraph"];subData.sequence = item["sequence"];subData.text = item["text"];subData.userId = item["userId"];subData.roundId = item["roundId"];subData.firstCharPos = item["firstCharPos"];subData.lastCharPos = item["lastCharPos"];subtitles.push_back(subData);}}//数据格式public class SubtitleMsgData {public boolean definite;public String language;public boolean paragraph;public int sequence;public String text;public String userId;public int roundId;public int firstCharPos;public int lastCharPos;@Overridepublic String toString() {return "SubtitleMsgData{" +"definite=" + definite +", language='" + language + '\\'' +", paragraph=" + paragraph +", sequence=" + sequence +", text='" + text + '\\'' +", userId='" + userId + '\\'' +", roundId=" + roundId +", firstCharPos=" + firstCharPos +", lastCharPos=" + lastCharPos +'}';}}//回调public void onRoomBinaryMessageReceived(String uid, ByteBuffer buffer) {StringBuilder subtitles = new StringBuilder();boolean ret = unpack(buffer, subtitles); if (ret) {parseData(subtitles.toString());}}// 拆包校验public static boolean unpack(ByteBuffer message, StringBuilder subtitles) {final int kSubtitleHeaderSize = 8;if (message.remaining() < kSubtitleHeaderSize) {return false;}// 魔法数字 "subv"int magicNumber = (message.get() << 24) | (message.get() << 16) | (message.get() << 8) | (message.get());if (magicNumber != 0x73756276) {return false;}int length = message.getInt();if (message.remaining() != length) {return false;}// 读取字幕内容byte[] subtitleBytes = new byte[length];message.get(subtitleBytes);subtitles.append(new String(subtitleBytes, StandardCharsets.UTF_8));return true;}// 解析字幕消息public static void parseData(String msg) {try {// 解析 JSON 字符串ObjectMapper objectMapper = new ObjectMapper();JsonNode jsonData = objectMapper.readTree(msg);// 存储解析后的数据List<SubtitleMsgData> subtitles = new ArrayList<>();// 遍历 JSON 数据并填充结构体for (JsonNode item : jsonData.get("data")) {SubtitleMsgData subData = new SubtitleMsgData();subData.definite = item.get("definite").asBoolean();subData.language = item.get("language").asText();subData.paragraph = item.get("paragraph").asBoolean();subData.sequence = item.get("sequence").asInt();subData.text = item.get("text").asText();subData.userId = item.get("userId").asText();subData.roundId = item.get("roundId").asInt();subData.firstCharPos = item.get("firstCharPos").asInt();subData.lastCharPos = item.get("lastCharPos").asInt();subtitles.add(subData);}} catch (Exception e) {e.printStackTrace();}}//数据格式@interface SubtitleMsgData : NSObject@property (nonatomic, assign) BOOL definite;@property (nonatomic, copy) NSString *language;@property (nonatomic, assign) BOOL paragraph;@property (nonatomic, assign) NSInteger sequence;@property (nonatomic, copy) NSString *text;@property (nonatomic, copy) NSString *userId;@property (nonatomic, assign) NSInteger roundId;@property (nonatomic, assign) NSInteger firstCharPos;@property (nonatomic, assign) NSInteger lastCharPos;@end@implementation SubtitleMsgData@end//回调- (void)rtcRoom:( ByteRTCRoom *_Nonnull)rtcRoom onRoomBinaryMessageReceived:(NSString *_Nonnull)uid message:(NSData *_Nonnull)message {NSString *subtitles = unpack(message);if (subtitles) {parseData(subtitles);}}// 大端序转换uint32_t swapUInt32(uint32_t value) {return ((value & 0x000000FF) << 24) |((value & 0x0000FF00) << 8) |((value & 0x00FF0000) >> 8) |((value & 0xFF000000) >> 24);}// 拆包校验NSString *unpack(NSData *data) {const int kSubtitleHeaderSize = 8;NSUInteger size = data.length;if (size < kSubtitleHeaderSize) {return nil;}const uint8_t *message = data.bytes;// Check magic number "subv"uint32_t magic = (message[0] << 24) | (message[1] << 16) | (message[2] << 8) | message[3];if (magic != 0x73756276) {return nil;}// Get lengthuint32_t length = (message[4] << 24) | (message[5] << 16) | (message[6] << 8) | message[7];if (size - kSubtitleHeaderSize != length) {return nil;}// Get subtitlesNSString *subtitles = nil;if (length > 0) {subtitles = [[NSString alloc] initWithBytes:message + kSubtitleHeaderSize length:length encoding:NSUTF8StringEncoding];} else {subtitles = @"";}return subtitles;}//解析void parseData(NSString *msg) {NSError *error = nil;NSDictionary *json_data = [NSJSONSerialization JSONObjectWithData:[msg dataUsingEncoding:NSUTF8StringEncoding] options:0 error:&error];if (error) {NSLog(@"JSON Parse Error: %@", error);return;}NSMutableArray<SubtitleMsgData *> *subtitles = [NSMutableArray array];for (NSDictionary *item in json_data[@"data"]) {SubtitleMsgData *subData = [[SubtitleMsgData alloc] init];subData.definite = [item[@"definite"] boolValue];subData.language = item[@"language"];subData.paragraph = [item[@"paragraph"] boolValue];subData.sequence = [item[@"sequence"] integerValue];subData.text = item[@"text"];subData.userId = item[@"userId"];subData.roundId = [item[@"roundId"] integerValue];subData.firstCharPos = [item[@"firstCharPos"] integerValue];subData.lastCharPos = [item[@"lastCharPos"] integerValue];[subtitles addObject:subData];}}
方式二:通过服务端获取
适用于需要在服务端进行对话记录、存储和分析的场景。数据通过 HTTP(S) POST 请求推送到业务服务器。字幕仅在识别到完整分句后才返回。每个分句都作为一条独立的消息发送,新的分句不包含上一个已结束的分句。
步骤 1:开启配置
调用 StartVoiceChat 在启动 AI 时,添加以下配置:
参数 | 说明 |
参数 | 说明 |
AgentConfig.ServerMessageURLForRTS | 您的后端服务地址,用于接收字幕消息。必须是公网可访问的 URL,且能正确处理无 Content-Type 的 HTTP POST 请求。 |
AgentConfig.ServerMessageSignatureForRTS | 自定义认证密钥。此字符串会在回调请求中原样返回,用于校验请求合法性。 |
SubtitleConfig.SubtitleMode |
// StartVoiceChat 请求体(仅展示字幕相关配置)
{
"SubtitleConfig": {
"SubtitleMode": 0
},
"AgentConfig": {
"ServerMessageURLForRTS": "https://example-domain.com/vertc/callback",
"ServerMessageSignatureForRTS": "b46ab****ad6a"
}
// ... 其他参数
}
步骤 2:接收和解析字幕
字幕消息会通过 HTTP(S) POST 请求发送给您指定的 URL 地址。
- 回调内容:
- 参数名类型描述参数名类型描述messageStringsignatureString鉴权签名。可与StartVoiceChat接口中传入的AgentConfig.ServerMessageSignatureForRTS字段值进行对比以进行鉴权验证。
- message 解析示例:
说明
- 以下示例为字幕数据的全量解析逻辑。在真实业务开发中,请注意根据您的实际应用场景(如仅做文本展示或需实现音文对齐高亮)按需提取和处理相关字段。
- 对于音频帧对齐字幕,您需要解析并存储 roundId、firstCharPos、lastCharPos 等信息,作为后续音频帧匹配的字幕库。
- package mainimport ("encoding/base64""encoding/binary""encoding/json""fmt""github.com/gin-gonic/gin")const (subtitleHeader = "subv"exampleSignature = "example_signature")type RtsMessage struct {Message string `json:"message"`Signature string `json:"signature"`}type Subv struct {Type string `json:"type"`Data []Data `json:"data"`}type Data struct {Definite bool `json:"definite"`Paragraph bool `json:"paragraph"`Language string `json:"language"`Sequence int `json:"sequence"`Text string `json:"text"`UserID string `json:"userId"`RoundId int `json:"roundId"`CustomInfo map[string]interface{} `json:"customInfo"`FirstCharPos int `json:"firstCharPos"`LastCharPos int `json:"lastCharPos"`}func HandleSubtitle(c *gin.Context) {msg := &RtsMessage{}if err := c.BindJSON(&msg); err != nil {fmt.Printf("BindJson failed, err:%v\n", err)return}// 鉴权校验if msg.Signature != exampleSignature {fmt.Printf("Signature not match\n")return}// 拆包并解析subv, err := Unpack(msg.Message)if err != nil {fmt.Printf("Unpack failed, err:%v\n", err)return}// 打印解析后的全量数据fmt.Printf("解析成功: %+v\n", subv)// TODO: 业务逻辑处理 (如存储到数据库或发送给前端)c.String(200, "ok")}// Unpack 实现二进制拆包及 JSON 反序列化func Unpack(msg string) (*Subv, error) {// 1. Base64 解码data, err := base64.StdEncoding.DecodeString(msg)if err != nil {return nil, fmt.Errorf("DecodeString failed, err:%v", err)}// 2. 长度校验if len(data) < 8 {return nil, fmt.Errorf("Data invalid")}// 3. Magic Number 校验dataHeader := string(data[:4])if dataHeader != subtitleHeader {return nil, fmt.Errorf("Header not match")}// 4. 负载长度校验dataSize := binary.BigEndian.Uint32(data[4:8])if dataSize+8 != uint32(len(data)) {return nil, fmt.Errorf("Size not match")}// 5. 解析 JSON 负载subData := data[8:]subv := &Subv{}err = json.Unmarshal(subData, subv)if err != nil {return nil, fmt.Errorf("Unmarshal failed, err:%v\n", err)}return subv, nil}func main() {r := gin.Default()// 设置路由地址,需与 StartVoiceChat 接口中的 ServerMessageURLForRTS 一致r.POST("/example_domain/vertc/subtitle", HandleSubtitle)r.Run()}
进阶:使用字幕
实时 UI 展示
对于客户端流式展示,请根据 paragraph 和 definite 字段决定 UI 的刷新策略:
场景 | definite | paragraph | UI 处理建议 |
场景 | definite | paragraph | UI 处理建议 |
用户说话中 | false | false | 用序号大的字幕覆盖序号小的。 |
用户/AI 分句结束 | true | false | 重新开始新的一句话,覆盖前一句话。 |
常规对话整轮结束 | true | true | 此时如果继续解析显示字幕,字幕会重复显示。 |
说明
当业务服务端持续生成外部文本,并通过多次 ExternalTextToSpeech 请求依次传入 TTS 时,每段字幕的 paragraph 均为 true。此时,该字段只表示当前一次外部文本输入结束,不表示业务层面的整条回复结束。请由业务服务端通过 AdvanceConfig.CustomInfo 传入当前文本的状态标记(例如是否播报完毕),并由客户端从字幕的 customInfo 中判断业务状态。
存储字幕
仅在解析到 paragraph: true 时存储,减少存储的数据量,并确保保存的字幕是完整的。如仅需存储字面文本而不关心时间对齐,可选择快速字幕(SubtitleMode=1)。
说明
将字幕存储至火山 Viking 记忆库时,需将解析到的 text 按照 userId 映射为 user 或 assistant 角色,再通过 添加会话-AddSession 接口写入 Viking 记忆库。
处理多轮对话字幕
使用 roundId 字段对字幕进行分组,在复杂的对话流中,准确区分和关联每一轮对话的字幕。通过 UpdateVoiceChat 接口的 ExternalTextToSpeech 指令传入 AdvanceConfig.CustomInfo 后,可从相同 roundId 的字幕数据中读取 customInfo,将业务信息与对应播报关联。
音频和字幕同步(音频帧对齐字幕)
在传统的字幕方案中,音频流和字幕数据通过两个独立的通道下发,可能因网络抖动导致音画不同步。通过音频帧对齐字幕(SubtitleMode: 2)可实现将字幕的位置信息直接嵌入到每个音频帧的附加信息(extraInfo)中。在收到完整的句子文本后,再根据每个音频帧携带的字符索引,即可在播放音频的同时精准高亮对应的文字,从而实现音文的强同步。
说明
- 获取并缓存字幕(客户端或服务端均可)。具体操作可参见获取字幕数据。
- SubtitleMode:设置为 2。
- 解析字幕时,您需要字幕与 roundId、firstCharPos、lastCharPos 等信息一并存储,作为后续音频帧匹配的“字幕库”。
- 接收带索引的音频帧。
- 注册观察者:调用 registerAudioFrameObserver 注册一个 IAudioFrameObserver 的实现。
- 开启回调:调用 enableAudioFrameCallback 开启远端用户音频帧回调。
- 解析 extraInfo:在 onRemoteUserAudioFrame 回调中,从 IAudioFrame 对象获取 extraInfo。extraInfo 是一个 8 字节的数据,前 4 字节为 round_id,后 4 字节为 subtitle_index,均为大端序。extraInfo 数据格式如下:
- 0 1 2 30 1 2 3 4 5 6 7 8 9 0 1 2 3 4 5 6 7 8 9 0 1 2 3 4 5 6 7 8 9 0 1+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+| round_id (uint32_t) |+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+| subtitle_index (uint32_t) |+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+-+
- C++ 示例:
- class MyAudioFrameObserver : public bytertc::IAudioFrameObserver {public:void onRemoteUserAudioFrame(const char* stream_id, const bytertc::StreamInfo& stream_info, const bytertc::IAudioFrame& audio_frame) override {// 检查 extraInfo 是否为 8 字节if (audio_frame.extraInfoSize() == 8) {const uint8_t* info = audio_frame.extraInfo();// 解析 round_id (大端序)uint32_t round_id = (static_cast<uint32_t>(info[0]) << 24) |(static_cast<uint32_t>(info[1]) << 16) |(static_cast<uint32_t>(info[2]) << 8) |(static_cast<uint32_t>(info[3]));// 解析 subtitle_index (大端序)uint32_t subtitle_index = (static_cast<uint32_t>(info[4]) << 24) |(static_cast<uint32_t>(info[5]) << 16) |(static_cast<uint32_t>(info[6]) << 8) |(static_cast<uint32_t>(info[7]));// 调用渲染逻辑renderSubtitleHighlight(round_id, subtitle_index);}}// ... 其他回调方法};// 在初始化时注册MyAudioFrameObserver g_audio_observer;rtc_engine->registerAudioFrameObserver(&g_audio_observer);rtc_engine->enableAudioFrameCallback(bytertc::AudioFrameCallbackMethod::kRemoteUser, bytertc::AudioFormat());
- 实现字幕渲染和音频帧对齐。
- 在 onRemoteUserAudioFrame 回调中获取到 round_id 和 subtitle_index 后,您需要实现具体的 UI 渲染逻辑。
- 字幕索引通用打标规则:
- 字幕索引按绝对字符维度打标,包括空格、标点等都会独立占一个索引,且索引是当轮对话维度打标。
- 索引可能会出现跳变(如英文连读时),不一定绝对连续。
- 处理中文字符时,请注意 UTF-8 编码下一个中文字可能占用多个字节。
- 示例:
- 中文示例:(开心)今天天气不错!
- Extrainfo 字幕索引012345678910Extrainfo 字幕索引012345678910字幕(开心)今天天气不错!
- 英文示例:Hello! I'm Job.
- Extrainfo 字幕索引01234567891011121314Extrainfo 字幕索引01234567891011121314字幕Hello!I'mJob!
- UI 渲染逻辑参考:
- 根据 round_id 从您缓存的 “字幕库” 中找到对应的字幕文本,再利用 subtitle_index 定位到需要高亮的字符,然后根据相对位置,在 UI 上高亮对应的字符。
- 代码示例:
说明
以下 C++ 示例代码仅为逻辑示意,您需要根据实际情况(如使用的 UI 框架、线程安全)调整。
- // 辅助函数:将 UTF-8 字符串拆分为逻辑字符列表(每个元素是 1 个逻辑字符)std::vector<std::string> split_utf8_to_chars(const std::string& utf8_str) {std::vector<std::string> chars;size_t i = 0;while (i < utf8_str.size()) {// 判断 UTF-8 字符的字节长度unsigned char c = static_cast<unsigned char>(utf8_str[i]);int len = 0;if (c < 0x80) {len = 1; // ASCII 字符(英文/标点):1 字节} else if (c < 0xE0) {len = 2; // 2 字节 UTF-8(极少用,暂兼容)} else if (c < 0xF0) {len = 3; // 3 字节 UTF-8(中文核心)} else {len = 4; // 4 字节 UTF-8(生僻字,暂兼容)}// 截取当前逻辑字符(避免越界)size_t end = std::min(i + len, utf8_str.size());chars.push_back(utf8_str.substr(i, end - i));i = end;}return chars;}void print_sub_title_char(std::string text,int size,int char_pos){// 1. 合法性校验:处理负数参数if (char_pos <= 0 || size <= 0) {// std::cout << "" << std::endl; // 无字符可打印return;}// 2. 将 UTF-8 字符串拆分为逻辑字符列表(每个字符占 1 个 pos)std::vector<std::string> logic_chars = split_utf8_to_chars(text);// 3. 确定 char_pos 前的有效逻辑字符数(pos 从 1 开始,对应列表索引 0~char_pos-1)int available_chars = std::min(char_pos, static_cast<int>(logic_chars.size()));if (available_chars <= 0) {return;}// 4. 截取最多 size 个字符int take_chars = std::min(size, available_chars);std::string result;for (int i = available_chars - take_chars; i < available_chars; ++i) {result += logic_chars[i];}printf("print_sub_title_char %s \n", result.c_str());}void print_sub_title(int char_pos, int round_id){for (auto it = g_subTitle.begin(); it != g_subTitle.end(); ++it) {if (it->round_id == round_id) {if(char_pos >= it->firstCharPos && char_pos <= it->lastCharPos + 1) {print_sub_title_char(it->text,8,char_pos - it->firstCharPos);if(char_pos == it->lastCharPos) {it = g_subTitle.erase(it);}break;}else {// printf("current sub title: null char_pos %d it->firstCharPos %d it->lastCharPos %d \n",char_pos,it->firstCharPos,it->lastCharPos);}}}for (auto it = g_subTitle.begin(); it != g_subTitle.end();) { // 注意:此处无 ++itif (it->round_id < round_id) {// 删除元素,并用返回值更新迭代器(避免失效)it = g_subTitle.erase(it);} else {// 未删除时,正常移动迭代器++it;}}if(round_id == -1) {printf("current sub title: null \n");}}
- (可选)实现音频和字幕同步暂停和续播。
- 实现了音文同步渲染后,您可以通过服务端 API 或客户端发送指令,同时暂停或恢复音频播放与字幕渲染。例如,用户按下暂停按钮后,AI 停止播放,字幕也同步停止渲染;当恢复播放时,音频和字幕将从暂停处继续。指令发送方式,请参见暂停或恢复 AI 播报。
附录:字幕格式和特性说明
字幕数据格式

参数名 | 类型 | 描述 |
参数名 | 类型 | 描述 |
magic number | binary | 消息标识。固定为 subv,表示字幕数据。 |
length | binary | 字幕消息长度,单位为 bytes,大端序存储。 |
subtitle_message | binary | 字幕内容的 JSON 字符串,UTF-8 编码。 |
subtitle_message 内容:
参数名 | 类型 | 描述说明 |
参数名 | 类型 | 描述说明 |
type | String | 消息类型,固定为 subtitle。 |
data | Object[] | 字幕详细信息。包含以下子字段: |
├── text | String | 字幕文本内容。 |
├── language | String | 字幕语言(例如:"zh-CN")。 |
├── userId | String | 来源者 ID。若是真人则为用户 UserId;若是 AI 则为 AI 的 UserId。 |
├── sequence | Int | 字幕序号。在单轮对话中递增。 |
├── definite | Boolean | 是否为完整分句。true: 是;false: 否。 |
├── paragraph | Boolean | 当前一次字幕输入是否结束。true: 是;false: 否。对于常规对话,可理解为当前整句结束;对于通过多次 ExternalTextToSpeech 传入的持续文本播报,true 仅表示当前一次外部文本输入结束,不表示业务层面的整段回复结束。 |
├── roundId | Int | 对话轮次 ID。 |
├── customInfo | Object | 业务自定义信息。通过服务端 UpdateVoiceChat 或客户端 sendUserBinaryMessage 的 ExternalTextToSpeech 指令传入 AdvanceConfig.CustomInfo 时,该对象随对应 roundId 的字幕原样透传。RTC 不解析对象中的键和值。 customInfo 支持 SubtitleMode 为 0、1 或 3 的字幕模式。 |
├── firstCharPos | Int | 该 text 片段在完整对话中的起始字符索引。 |
├── lastCharPos | Int | 该 text 片段在完整对话中的结束字符索引。 |
├── voiceprintName | String | |
├── voiceprintId | String | 声纹 ID。 |
└── voiceprintScore | Int | 声纹相似度分数。 |
字幕返回示例:
字幕(包含业务自定义信息)
音频帧对齐字幕示例
字幕(包含声纹信息)
以下是同一段长文本被拆分后产生的两次字幕回调。虽然两段字幕的 paragraph 都为 true,但第一段的 customInfo.finish 为 false,客户端应继续等待;第二段为 true,客户端可将整段文本标记为结束。
// 第一段:当前外部文本输入结束,但整段长文本尚未结束
{
"type": "subtitle",
"data": [
{
"text": "北京三日游可以先游览故宫和景山。",
"language": "zh-CN",
"userId": "bot_id_123",
"sequence": 0,
"definite": true,
"paragraph": true,
"roundId": 11,
"customInfo": {
"finish": false
}
}
]
}
// 第二段:当前外部文本输入结束,且整段长文本分发完毕
{
"type": "subtitle",
"data": [
{
"text": "最后一天可以游览颐和园,祝您旅途愉快。",
"language": "zh-CN",
"userId": "bot_id_123",
"sequence": 1,
"definite": true,
"paragraph": true,
"roundId": 11,
"customInfo": {
"finish": true
}
}
]
}
以下展示的是两次连续收到的音频帧对齐字幕消息内容,用于说明 sequence、definite 和 text 字段的变化。
// message1: 第一轮对话的字幕
{
"type": "subtitle",
"data": [
{
"text": "春眠不觉晓,处处闻啼鸟。",
"language": "zh-CN",
"userId": "bot_id_123",
"sequence": 0,
"definite": true,
"paragraph": true,
"roundId": 1,
"firstCharPos": 0,
"lastCharPos": 11
}
]
}
// message2: 第二轮对话的字幕
{
"type": "subtitle",
"data": [
{
"text": "夜来风雨声,花落知多少。",
"language": "zh-CN",
"userId": "bot_id_123",
"sequence": 0,
"definite": true,
"paragraph": true,
"roundId": 2,
"firstCharPos": 12,
"lastCharPos": 23
}
]
}
以下是开启声纹功能后,真人用户字幕中携带声纹信息的示例。
// 匹配成功:返回命中的声纹 ID、声纹名称和最高比对分数
{
"type": "subtitle",
"data": [
{
"text": "我上次说喜欢恐龙故事,你还记得吗?",
"language": "zh-CN",
"userId": "user_id_123",
"sequence": 0,
"definite": true,
"paragraph": true,
"roundId": 12,
"voiceprintId": "vp_ubt_child_001",
"voiceprintName": "ubt_child_001",
"voiceprintScore": 62
}
]
}
// 存在比对结果但未达到匹配阈值:声纹 ID 和声纹名称为空,返回比对分数
{
"type": "subtitle",
"data": [
{
"text": "今天讲一个新的故事吧。",
"language": "zh-CN",
"userId": "user_id_123",
"sequence": 0,
"definite": true,
"paragraph": true,
"roundId": 13,
"voiceprintId": "",
"voiceprintName": "",
"voiceprintScore": 34
}
]
}
字幕来源与返回方式
字幕的来源和返回方式,会因其接收方式(客户端回调 vs. 服务端回调)和归属方(真人用户 vs. AI )的不同而有差异。
例外说明:若业务通过 ExternalTextToSpeech 传入外部文本,每次请求对应字幕的 paragraph 可能都为 true。此时可结合 roundId 和 customInfo 判断业务层面的完整状态,不要仅凭 paragraph 判断整段回复是否结束。
接收方式 | 用户字幕 | AI 字幕 |
接收方式 | 用户字幕 | AI 字幕 |
客户端接收 | 字幕来源:ASR 模块语音识别内容 返回方式:流式返回,新字幕是之前内容的累加。 示例:用户说 您好,查询一下上海天气。,您会依次收到 您好, 您好,查询 您好,查询一下上海天气。 字幕状态:
| 字幕来源:LLM 文本或 TTS 朗读内容(SubtitleMode决定) 返回方式:流式返回,且仅在识别到完整分句后才返回。每个分句都作为一条独立的消息发送,新的分句不包含上一个已结束的分句。 示例:AI 说 天气炎热,气温为 30 摄氏度。,则会依次返回两个独立分句 天气炎热, 气温为 30 摄氏度。。在常规对话中,可通过 paragraph: true 判断当前整句结束。 字幕状态:
|
服务端接收 | 字幕来源:ASR 模块语音识别内容 返回方式:仅在识别到完整分句后才返回。每个分句都作为一条独立的消息发送,新的分句不包含上一个已结束的分句。 示例:用户说 您好,查询一下上海天气。,您将依次收到字幕:您好, 和 查询一下上海天气。 字幕状态:
| 字幕来源:LLM 文本或 TTS 朗读内容(SubtitleMode决定) 返回方式:仅在识别到完整分句后才返回。每个分句都作为一条独立的消息发送,新的分句不包含上一个已结束的分句。 示例: AI 说 天气炎热,气温为 30 摄氏度。,您会依次收到分句:天气炎热,和气温为 30 摄氏度。 字幕状态:
|
FAQ
- Q1:是否支持在用户和 AI 说话之前就将字幕返回给业务端?
- 不支持。
- Q2:字幕是否支持接收图片?
- 不支持。
- Q3:微信小程序端是否支持字幕功能?
- 支持。
- Q4:收到的字幕与实际内容相比有很多错误同音字。
- 不同模型对于同音字的识别结果不同。您可以通过提升语音识别的准确性,来提升字幕准确度。具体操作,请参见提升语音识别准确性。
- Q5:字幕是否支持返回超链接内容?
- 不支持。
最近更新时间:2026.10.26 19:58:15
这个页面对您有帮助吗?
有用
有用
无用
无用