云服务器
云服务器
云服务器


文档指南
请输入


云服务器ECS
产品动态
产品公告
实例停售相关
OpenAPI相关
价格和配额相关
功能下线相关
产品计费
快速入门
用户指南
实例
实例规格清单
选择实例计费方式
登录实例
镜像
公共镜像
自定义镜像
镜像维护周期与EOL应对方案
弹性块存储
快照
网络
监控
运维
云助手
运维编排
管理常用运维任务
补丁管理
最佳实践
AI应用
ArkClaw
OpenClaw
通过应用模板快速部署OpenClaw
通过市场镜像快速部署OpenClaw
手动部署OpenClaw
自助建站
搭建环境
搭建应用
搭建网站
管理Linux实例软件源
性能测试
实例配置
搭建Windows操作系统AD域服务
Windows多用户登录
实例数据
监控
镜像
Linux内核调优
故障处理
远程登录问题
Linux操作系统问题
Windows操作系统问题
操作系统问题
veLinux操作系统问题
Linux操作系统问题
Windows操作系统问题
制作自定义镜像问题
实例无法启动问题
实例负载高问题
网络连接问题
存储类问题
云盘问题
第三方软件问题
API参考
实例
镜像
高性能计算集群
密钥对
标签
云盘
预留存储容量包
快照
自动快照策略
监控
部署集
启动模版
云助手
补丁管理
专有宿主机DDH
产品动态
图说专有宿主机
用户指南
API参考
专有宿主机
相关视频
- 文档首页
 云服务器云服务器ECS最佳实践自助建站AIGC实践搭建DeepSeek-R1-Distill模型进行文本生成推理
 复制全文
 下载 pdf
搭建DeepSeek-R1-Distill模型进行文本生成推理
 文档反馈
 问问助手
本文主要介绍如何在云服务器实例中部署不同参数量级的DeepSeek-R1-Distill模型并使用CPU进行推理,以及通过Intel xFasterTransformer实现推理过程加速的方案。
背景信息
DeepSeek-R1-Distill模型
DeepSeek-R1-Distill是一个基于DeepSeek-R1生成的800K个样本,对原开源模型进行微调得到的新模型,旨在以更小参数规模保留DeepSeek-R1发现的强大推理模型。您可以根据本文指引,按需部署不同参数量级的模型。
模型名称 | 参数量级 |
模型名称 | 参数量级 |
DeepSeek-R1-Distill-Qwen-1.5B | 1.5B |
DeepSeek-R1-Distill-Qwen-7B | 7B |
DeepSeek-R1-Distill-Llama-8B | 8B |
DeepSeek-R1-Distill-Qwen-32B | 32B |
xFasterTransformer
Intel xFasterTransformer 是Intel®开发的一个加速库,旨在为大语言模型(LLM)在CPU X86平台上的部署提供了一种深度优化的解决方案。支持多CPU节点之间的分布式部署方案,使得超大模型在CPU上的部署成为可能。此外,xFasterTransformer提供了C++和Python两种API接口,涵盖了从上层到底层的接口调用,易于用户使用并将xFasterTransformer集成到自有业务框架中。更多信息,可查看xFasterTransformer。
oneCCL
oneCCL(One Collective Communication Library)是Intel®推出的一种集体通信库,旨在为分布式深度学习训练提供高性能的通信支持。它提供了一组优化的通信算法和数据结构,可用于在分布式环境中实现高效的通信操作。
oneDNN
oneDNN(oneAPI Deep Neural Network Library)是Intel®开发的一个深度学习加速库,旨在优化和加速深度学习模型的推理和训练。它提供了一系列高效的算法和优化,用于在英特尔处理器(CPU)、图形处理器(GPU)和其他硬件加速器上执行深度学习任务。
使用场景
- 低成本体验
- 若您希望体验自行部署、运行DeepSeek模型,对AI性能要求较低,云服务器实例的CPU性能足以满足您的需求,且相较于选用GPU实例成本更低。
- 开发和调试
- 若您在进行DeepSeek模型的开发、调试,使用CPU实例可以避免GPU驱动、CUDA版本等兼容性问题,降低开发和管理成本。
- 轻量级模型需求
- 若您任务规模较小(低频调用、小批量数据处理),云服务器实例的多核CPU足以满足性能要求。
操作步骤
步骤一:准备环境
配置项 | 推荐配置 |
配置项 | 推荐配置 |
基础配置 | |
计算规格 | ecs.c3il.2xlarge 说明 若您期望部署不同参数规模的DeepSeek-R1-Distill模型,可参考如下推荐选用实例:
|
镜像 | Ubuntu 22.04 64 bit |
存储 |
说明 本文使用的DeepSeek-R1-Distill-Qwen-1.5B模型参数量为1.5B,您可以根据实际部署的模型参数量级调整云盘容量。推荐配置如下:
|
网络配置 | |
弹性公网IP | 勾选“分配弹性公网IP”。 |
步骤二:部署模型
方案 | 支持模型 | 说明 |
方案 | 支持模型 | 说明 |
通过Docker部署(推荐) |
|
|
手动部署 |
|
|
通过Docker部署
手动部署
- 登录目标实例。
- 执行如下命令,安装Docker。
- sudo apt updatesudo apt install -y docker.io
- 执行如下命令,启动Docker和模型服务。
- docker run -d --network host --privileged --shm-size 15g -v /data00/models:/data00/models -e MODEL_PATH=/data00/models -e PORT=8000 -e MODEL_NAME=DeepSeek-R1-Distill-Qwen-7B -e DTYPE=bf16 -e KV_CACHE_DTYPE=fp16 ai-containers-cn-beijing.cr.volces.com/deeplearning/xft-vllm:1.8.2.iaas bash /llama2/entrypoint.sh
- 参数说明:
- MODEL_PATH:模型存储路径,默认为/data/models。
- MODEL_NAME:待部署的模型名称,默认值为DeepSeek-R1-Distill-Qwen-7B。取值支持:DeepSeek-R1-Distill-Qwen-1.5B、DeepSeek-R1-Distill-Qwen-7B、DeepSeek-R1-Distill-Qwen-32B。
- PORT:服务监听的端口号,默认值8000。
- DTYPE:模型量化类型,默认值为bf16。取值支持:auto、half、float16、bfloat16、float、float32、fp16、bf16、int8、w8a8、int4、nf4、bf16_fp16、bf16_int8、bf16_w8a8、bf16_int4、bf16_nf4、w8a8_int8、w8a8_int4、w8a8_nf4。
- KV_CACHE_DTYPE:KV_CACHE量化类型,默认值为fp16。取值支持:auto、fp8、fp8_e5m2、fp8_e4m3、fp16、int8。
- 执行如下命令,通过Docker日志确认容器及模型是否成功启动。
- 查看容器ID。
- docker ps
- 查看对应容器的运行日志。
- docker logs --since 30m <CONTAINER_ID>
说明
请将<CONTAINER_ID>替换为实际容器ID。
- 执行如下命令,查看端口启动情况。
- netstat -lntp | grep 8000
- 回显示例:
- 回显如下所示时,表示8000端口已成功处于监听状态。
-

注意
本方案需要跨境下载依赖工具、软件,若您的实例无法访问Github,建议选择“通过Docker部署”方案。
- 登录目标实例。
- (可选)安装依赖工具及软件。
- 若您选用的实例分布在多个NUMA,请按本步骤安装所需工具及软件。否则,请跳过本步骤。
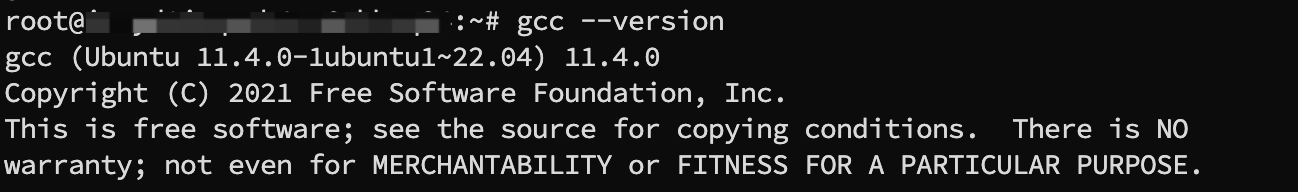
- 执行如下命令,确认GCC版本。
- gcc --version
- 若版本不低于10,请继续后续步骤。
-
- 若版本低于10,请执行如下命令,升级GCC版本。
注意
升级GCC可能会影响到系统中依赖于旧版本GCC的软件。确保在升级前备份重要数据,并确保新版本的GCC不会对系统的稳定性和已安装的软件产生不良影响。
- sudo apt updatesudo apt install -y gcc
- 执行如下命令,安装Git。
- sudo apt updatesudo apt install -y git
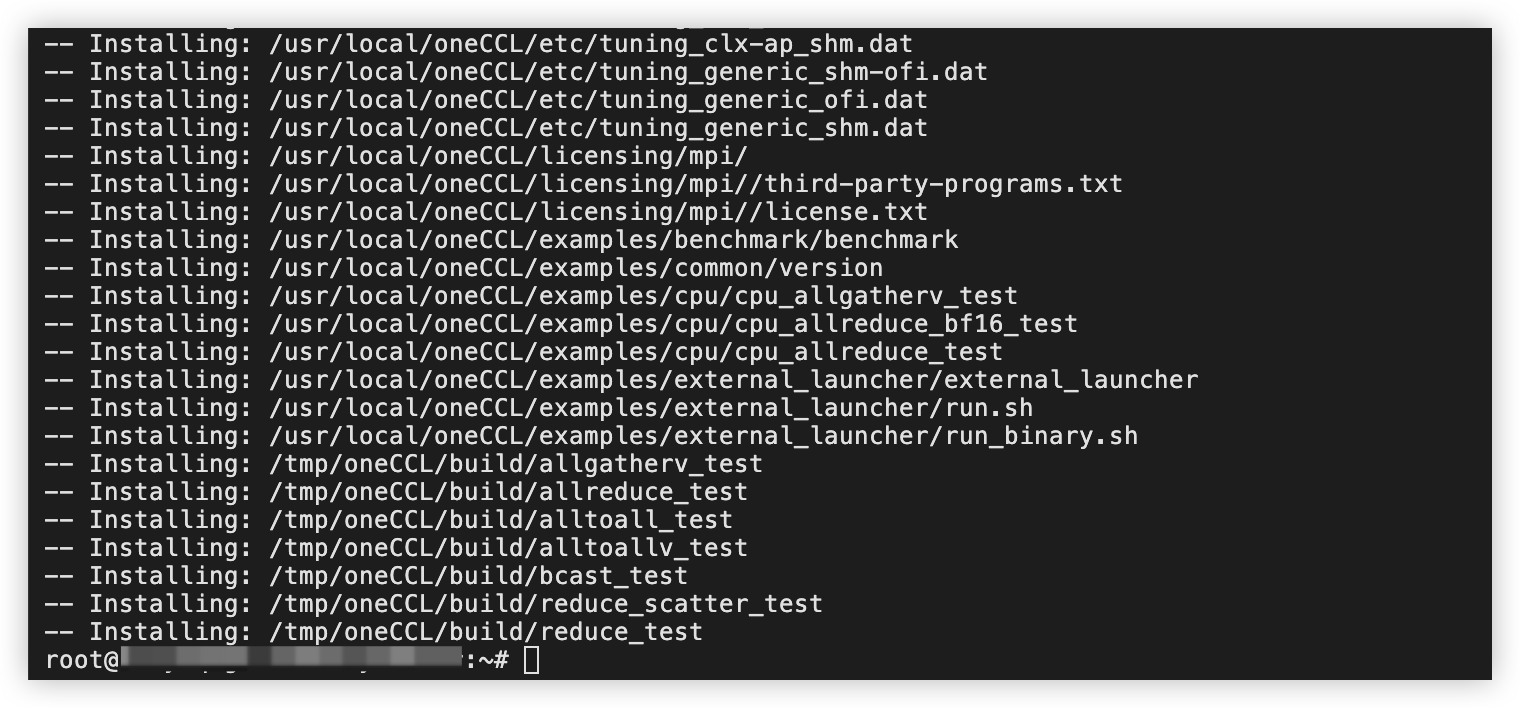
- 执行如下命令,安装oneCCL。
- git clone https://github.com/oneapi-src/oneCCL.git /tmp/oneCCL \&& cd /tmp/oneCCL \&& git checkout 2021.9 \&& sed -i 's/cpu_gpu_dpcpp/./g' cmake/templates/oneCCLConfig.cmake.in \&& mkdir build \&& cd build \&& cmake .. -DCMAKE_INSTALL_PREFIX=/usr/local/oneCCL \&& make -j install \&& cd ~ \&& rm -rf /tmp/oneCCL \&& echo "source /usr/local/oneCCL/env/setvars.sh" >> ~/.bashrc
- 回显示例:
- 如下图所示时,表示已成功安装oneCCL。
-
- 安装oneDNN。
- 执行如下命令,安装oneDNN。
- cd /usr/localwget https://github.com/oneapi-src/oneDNN/releases/download/v0.21/mklml_lnx_2019.0.5.20190502.tgz \&& tar -xzf mklml_lnx_2019.0.5.20190502.tgz \&& rm -f mklml_lnx_2019.0.5.20190502.tgz \&& echo 'export LD_LIBRARY_PATH=/usr/local/mklml_lnx_2019.0.5.20190502/lib:$LD_LIBRARY_PATH' >> ~/.bashrc
- 执行如下命令,验证安装结果。
- cat ~/.bashrc | grep '/usr/local/mklml_lnx_2019.0.5.20190502/lib:$LD_LIBRARY_PATH'
- 回显示例:
- 如下图所示时,表示已成功安装oneDNN。
-

- 若未成功安装,请重新执行安装命令进行安装。
- 安装xFasterTransformer。
- (可选)若您配置了加速代理,请执行如下命令移除代理。
- unset https_proxyunset http_proxy
- 执行如下命令,安装xFasterTransformer。
- apt updateapt install wget curl numactl -ypip install torch==2.0.1+cpu --index-url https://download.pytorch.org/whl/cpupip install cmake==3.26.1 sentencepiece==0.1.99 tokenizers==0.13.3 accelerate==0.23.0pip install xfastertransformerpip install gradio protobuf googlepip install transformers==4.44.0
- 执行如下命令,安装vllm-xft。
- pip install vllm-xft
- (可选)若您的实例使用Intel® Granite Rapids(GNR)处理器,请执行如下命令下载额外依赖。
- if lscpu | grep -q "6986P-C"; thenpip install xfastertransformer-gnrfi
- 下载模型文件。
- Qwen模型Llama模型
- 执行如下命令,配置密钥并安装依赖工具。
- wget -qO - https://mirrors.ivolces.com/extra-tools/debian/GPG-KEY-system | apt-key add -echo 'deb http://mirrors.ivolces.com/extra-tools/debian buster main' > /etc/apt/sources.list.d/volctools.listapt update && apt install -y onion-ai-data
- 执行如下命令,下载模型。
- region_id=`curl 100.96.0.96/latest/region_id`allowed_regions="cn-beijing cn-shanghai cn-guangzhou ap-southeast-1"if ! echo "$allowed_regions" | grep -wq "$region_id";thenregion_id="cn-beijing"fiexport REGION=${region_id}mkdir -p /data/modelscd /data/modelsexport BUCKET=iaas-public-model-${region_id}oniond download model DeepSeek-R1-Distill-Qwen-7Bexport BUCKET=iaas-public-xfast-${region_id}oniond download model DeepSeek-R1-Distill-Qwen-7B-xft
说明请将DeepSeek-R1-Distill-Qwen-7B替换为实际模型名称。取值支持:DeepSeek-R1-Distill-Qwen-1.5B、DeepSeek-R1-Distill-Qwen-7B、DeepSeek-R1-Distill-Qwen-32B。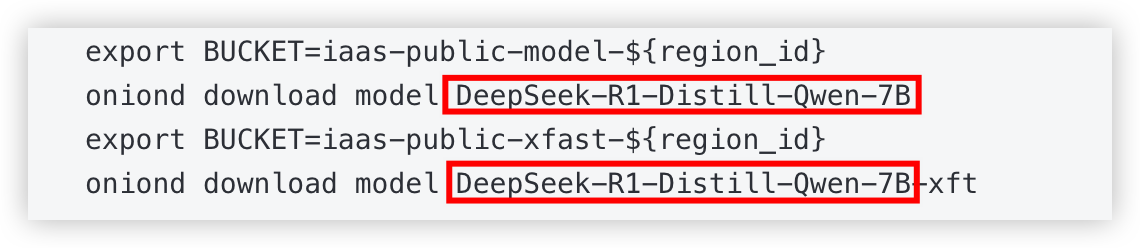
- 获取下载授权。
- 访问Huggingface官方meta-llama/Llama-3.1-8B模型页面。
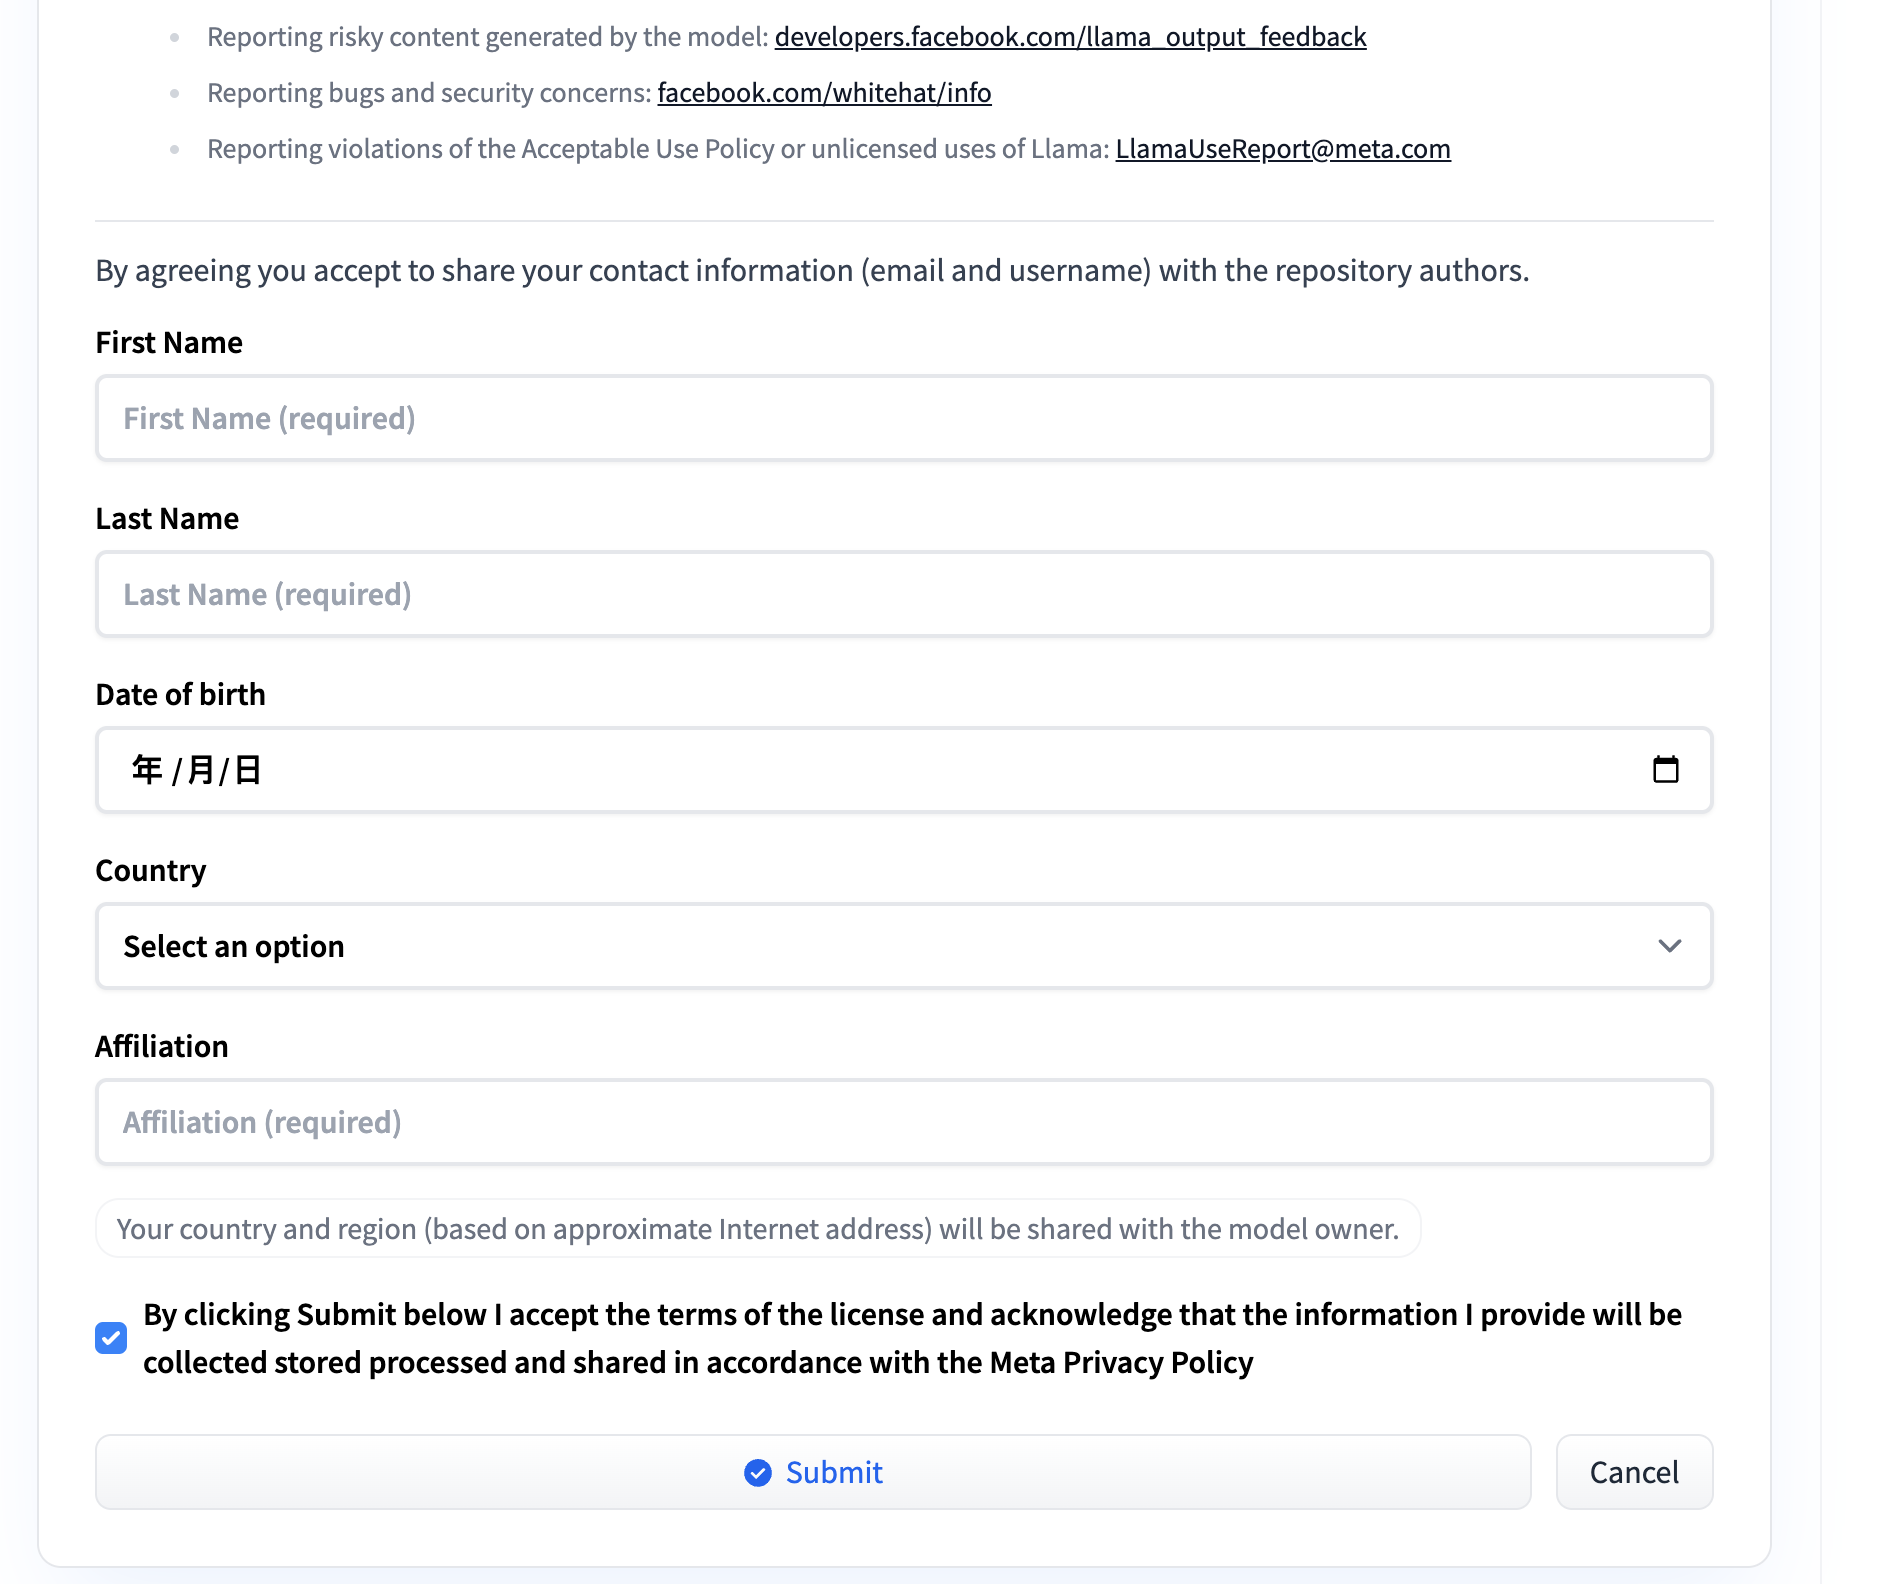
说明由于DeepSeek-R1-Distill-Llama-8B源自Llama3.1-8B-Base模型,您需要在llama3.1 license下获得许可才能下载DeepSeek-R1-Distill-Llama-8B模型。-
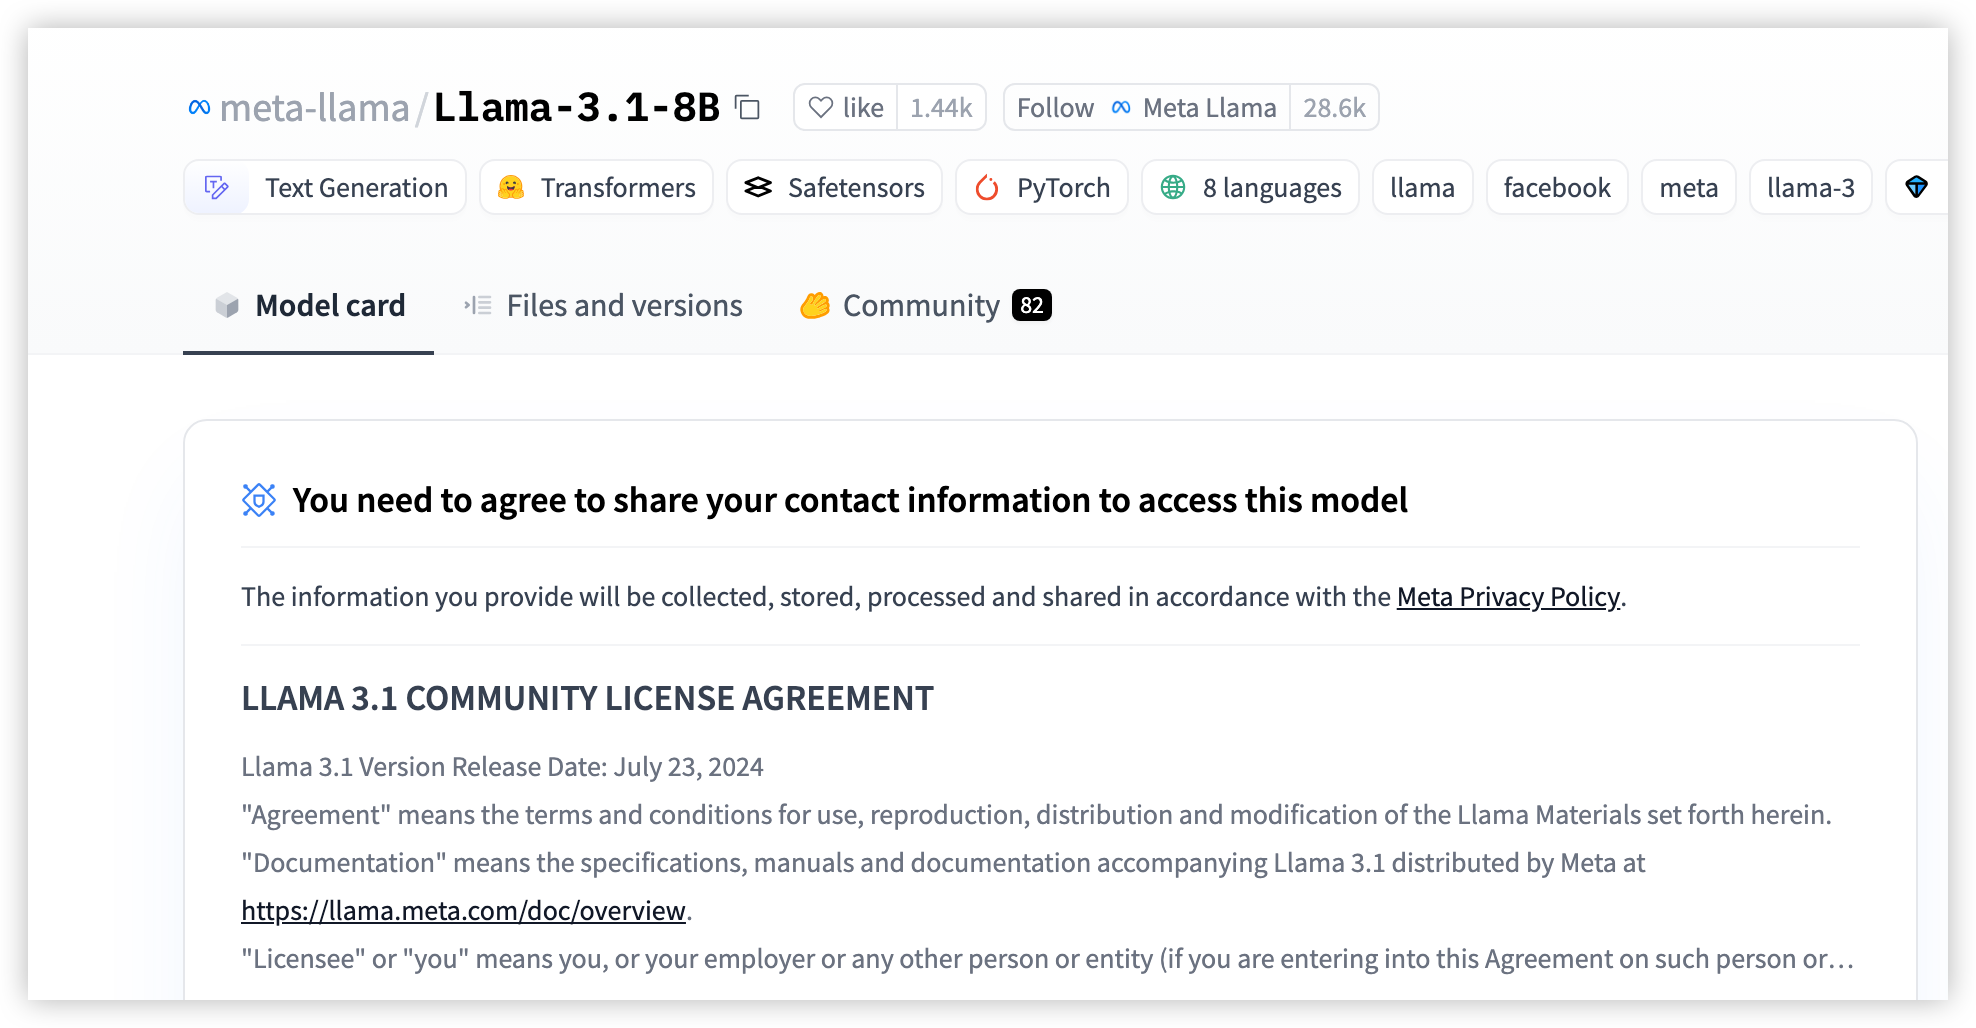
- 下划阅读模型使用许可协议,并填写所需信息,单击“Submit”按钮提交申请。
-
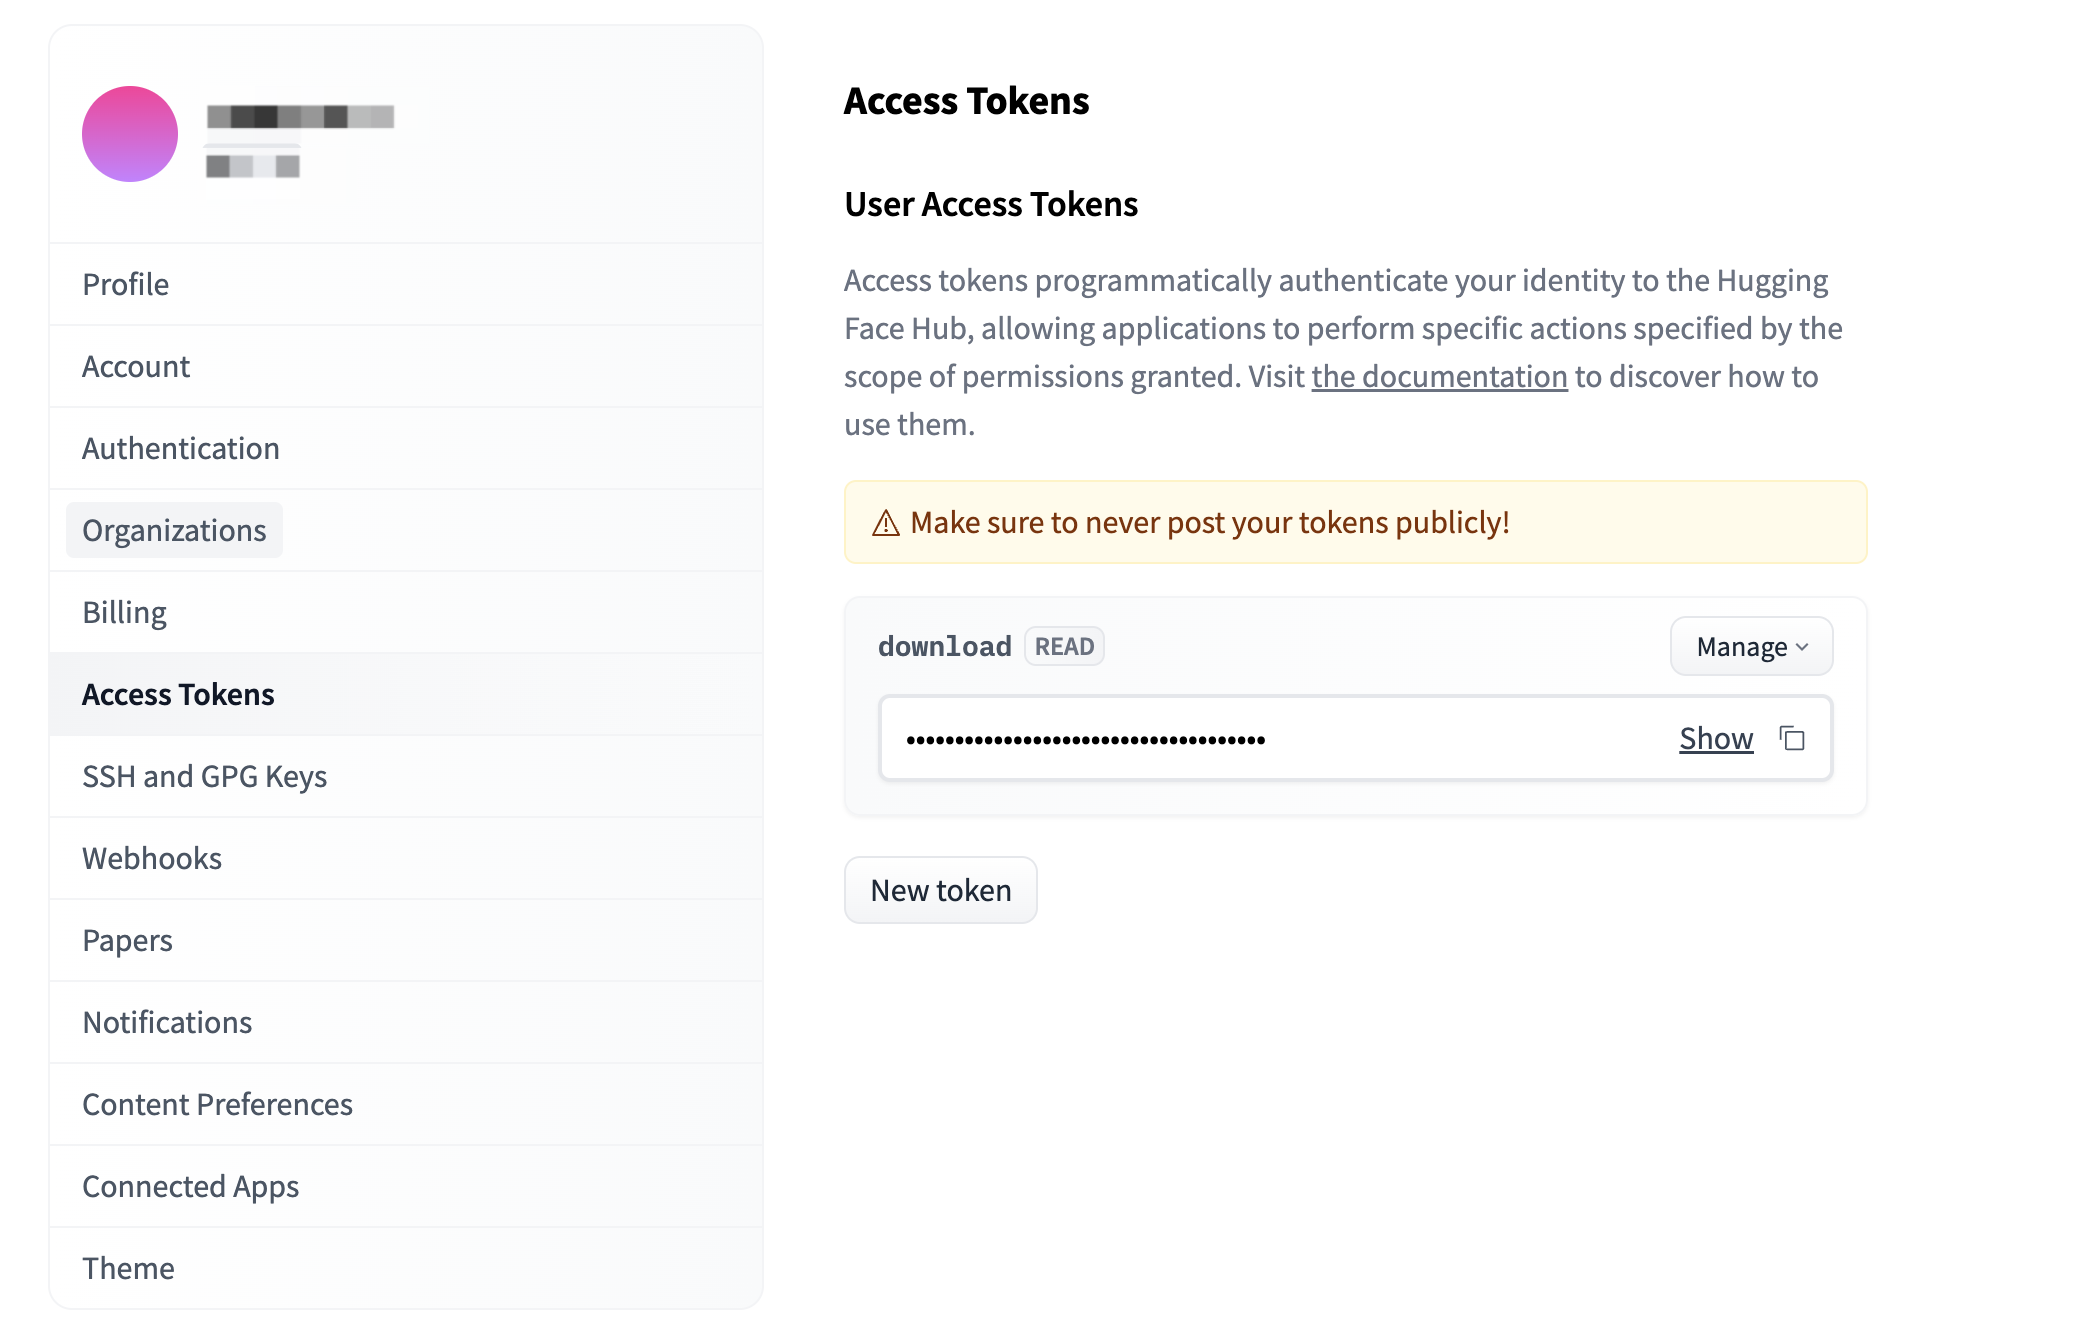
- 申请通过后,请登录HuggingFace Token页面,获取您有下载权限的Token。详情可查看User access tokens。
-
- 登录目标实例。
- 执行如下命令,安装HuggingFace下载工具。
- pip install -U huggingface_hub
- 执行如下命令,配置环境变量。
- export HF_ENDPOINT=https://hf-mirror.com
说明- 执行如下命令,下载DeepSeek-R1-Distill-Llama-8B模型文件。
- mkdir -p /data/modelscd /data/modelshuggingface-cli download --resume-download --local-dir-use-symlinks False deepseek-ai/DeepSeek-R1-Distill-Llama-8B --local-dir DeepSeek-R1-Distill-Llama-8B --token <your_token>
说明请将命令中<your_token>替换为上一步获取的Token。- 执行如下命令,转换模型文件。
- python3 -c 'import xfastertransformer as xft; xft.LlamaConvert().convert("/data/models/DeepSeek-R1-Distill-Llama-8B","/data/models/DeepSeek-R1-Distill-Llama-8B-xft")'
- 运行推理服务。
- 执行如下命令,创建startds.sh文件。
- vim /root/startds.sh
- 按i键进入编辑模式,将如下内容粘贴入文件中。
- #!/bin/bashMODEL_PATH=${MODEL_PATH:-"/data/models"}MODEL_NAME=${MODEL_NAME:-"DeepSeek-R1-Distill-Qwen-7B"}PORT=${PORT:-8000}DTYPE=${DTYPE:-"bf16"}KV_CACHE_DTYPE=${KV_CACHE_DTYPE:-"fp16"}declare -a groups#The server needs to be bound to physical cores when startingfunction get_bind_core{RUN_NODE=$(ls -d /sys/devices/system/node/node* | wc -l)BIND_CORENUM=`cat /proc/cpuinfo | grep -E 'processor|core id|physical id' | sed 'N;N;s/\n/ /g' | sort -k 7 -k 11 -u | wc -l`THREAD_PER_CORE=`lscpu | grep 'Thread(s) per core' | awk '{print $NF}'`if [ $THREAD_PER_CORE -gt 1 ]; thenif grep ',' /sys/devices/system/cpu/cpu0/topology/core_cpus_list &> /dev/null; thenBIND_CORE_JOINER=","elif grep '-' /sys/devices/system/cpu/cpu0/topology/core_cpus_list &> /dev/null; thenBIND_CORE_JOINER="-"elseecho ">>> Get unknown CPU topo: `cat /sys/devices/system/cpu/cpu0/topology/core_cpus_list`, please check" && exit 255fibind_cores=`cat /sys/devices/system/cpu/cpu*/topology/core_cpus_list | awk -F "$BIND_CORE_JOINER" '{print $1}' | sort -n | uniq | head -n ${BIND_CORENUM} | xargs`last_bind=""for c in $bind_cores; doif [ -z "$bind_core_set" ]; thenbind_core_set+="$c"last_bind=$celseif [ $((last_bind+1)) -eq $c ]; then((last_bind+=1))if [ $c == `echo $bind_cores | awk '{print $NF}'` ]; thenif [ $bind_core_set == `echo $bind_cores | awk '{print $1}'` ]; thenbind_core_set+="-$c"elsebind_core_set+="$c"fielsebind_core_set+="-"fielsebind_core_set+=",$c"last_bind=$cfifibind_core_set=`echo $bind_core_set | sed 's/-\+/-/g'`doneelsebind_core_set="0-$((BIND_CORENUM-1))"fiinput=$bind_core_setgroup_count=$RUN_NODEIFS=',' read -r -a array <<< "$input"if [[ $input == *-* ]]; thenIFS='-' read -r start end <<< "$input"range_size=$(( (end - start + 1) / group_count ))for ((i = 0; i < group_count; i++)); dogroup_start=$(( start + i * range_size ))group_end=$(( group_start + range_size - 1 ))if [[ $i -eq $((group_count - 1)) ]]; thengroup_end=$endfigroups[$i]="$group_start-$group_end"doneelsearray_length=${#array[@]}group_size=$(( (array_length + group_count - 1) / group_count )) for ((i = 0; i < group_count; i++)); dogroup_start=$(( i * group_size ))group_elements=("${array[@]:group_start:group_size}")if [ ${#group_elements[@]} -gt 0 ]; thengroups[$i]=$(IFS=,; echo "${group_elements[*]}")fidonefioutput="["for ((i = 0; i < ${#groups[@]}; i++)); doif [[ $input == *-* ]]; thenoutput+="${groups[$i]}"elseoutput+="'${groups[$i]}'"fiif [ $i -ne $(( ${#groups[@]} - 1 )) ]; thenoutput+=","fidoneoutput+="]"echo "core bind : $output"}get_bind_coreRUN_NODE=$(ls -d /sys/devices/system/node/node* | wc -l)BIND_CORENUM=`cat /proc/cpuinfo | grep -E 'processor|core id|physical id' | sed 'N;N;s/\n/ /g' | sort -k 7 -k 11 -u | wc -l`physical_core_count=$(($BIND_CORENUM/$RUN_NODE))#mpirun performances better on multi-numa instancenuma_count=$(ls -d /sys/devices/system/node/node* | wc -l)export $(python3 -c 'import xfastertransformer as xft; print(xft.get_env())')export MODEL_PATH_XFT="$MODEL_PATH/${MODEL_NAME}-xft"export TOKEN_PATH="$MODEL_PATH/$MODEL_NAME"if [ "$numa_count" -gt 1 ]; thenexport LD_PRELOAD=/usr/local/lib/python3.10/dist-packages/xfastertransformer/libiomp5.so && source /usr/local/oneCCL/env/setvars.shif [ "$numa_count" -eq 2 ]; thenOMP_NUM_THREADS=$physical_core_count mpirun \-n 1 numactl --all -C ${groups[0]} 0 -m 0 python3 -m vllm.entrypoints.openai.api_server --model $MODEL_PATH_XFT --tokenizer $TOKEN_PATH --dtype $DTYPE --kv-cache-dtype $KV_CACHE_DTYPE --served-model-name xft --port $PORT --trust-remote-code \: -n 1 numactl --all -C ${groups[1]} -m 1 python3 -m vllm.entrypoints.slave --dtype $DTYPE --model $MODEL_PATH_XFT --kv-cache-dtype $KV_CACHE_DTYPEelif [ "$numa_count" -eq 3 ]; thenOMP_NUM_THREADS=$physical_core_count mpirun \-n 1 numactl --all -C ${groups[0]} -m 0 python3 -m vllm.entrypoints.openai.api_server --model $MODEL_PATH_XFT --tokenizer $TOKEN_PATH --dtype $DTYPE --kv-cache-dtype $KV_CACHE_DTYPE --served-model-name xft --port $PORT --trust-remote-code \: -n 1 numactl --all -C ${groups[1]} -m 1 python3 -m vllm.entrypoints.slave --dtype $DTYPE --model $MODEL_PATH_XFT --kv-cache-dtype $KV_CACHE_DTYPE \: -n 1 numactl --all -C ${groups[2]} -m 2 python3 -m vllm.entrypoints.slave --dtype $DTYPE --model $MODEL_PATH_XFT --kv-cache-dtype $KV_CACHE_DTYPE fielseOMP_NUM_THREADS=$physical_core_count numactl -C ${groups[0]} -m 0 python3 -m vllm.entrypoints.openai.api_server --model $MODEL_PATH_XFT --tokenizer $TOKEN_PATH --dtype $DTYPE --kv-cache-dtype $KV_CACHE_DTYPE --served-model-name xft --port $PORT --trust-remote-codefi
- 根据实际情况,修改文首如下参数的参数值。
-
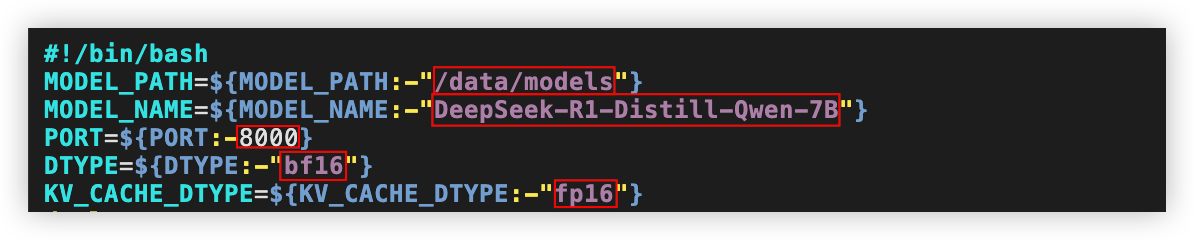
- MODEL_PATH:模型存储路径,默认为/data/models。
- MODEL_NAME:待部署的模型名称,默认值为DeepSeek-R1-Distill-Qwen-7B。取值支持:DeepSeek-R1-Distill-Qwen-1.5B、DeepSeek-R1-Distill-Qwen-7B、DeepSeek-R1-Distill-Llama-8B、DeepSeek-R1-Distill-Qwen-32B。
- PORT:服务监听的端口号,默认值8000。
- DTYPE:模型量化类型,默认值为bf16。取值支持:auto、half、float16、bfloat16、float、float32、fp16、bf16、int8、w8a8、int4、nf4、bf16_fp16、bf16_int8、bf16_w8a8、bf16_int4、bf16_nf4、w8a8_int8、w8a8_int4、w8a8_nf4。
- KV_CACHE_DTYPE:KV_CACHE量化类型,默认值为fp16。取值支持:auto、fp8、fp8_e5m2、fp8_e4m3、fp16、int8。
- 按esc键退出编辑,输入:wq按回车键,保存并退出文件。
- 执行如下命令,为startds.sh文件添加可执行权限。
- sudo chmod +x /root/startds.sh
- 执行如下命令,启动推理服务。
- sudo /root/startds.sh
- 成功启动回显示例:
-

步骤三:调用模型
注意
若您选用“手动部署”方案,调用模型时请勿关闭运行推理服务的终端,请在浏览器中新建页面再次登录目标实例。后续,您可以在新建的终端中调用模型。
- 登录目标实例。
- 执行如下命令安装jq,美化模型输出。
- sudo apt install -y jq
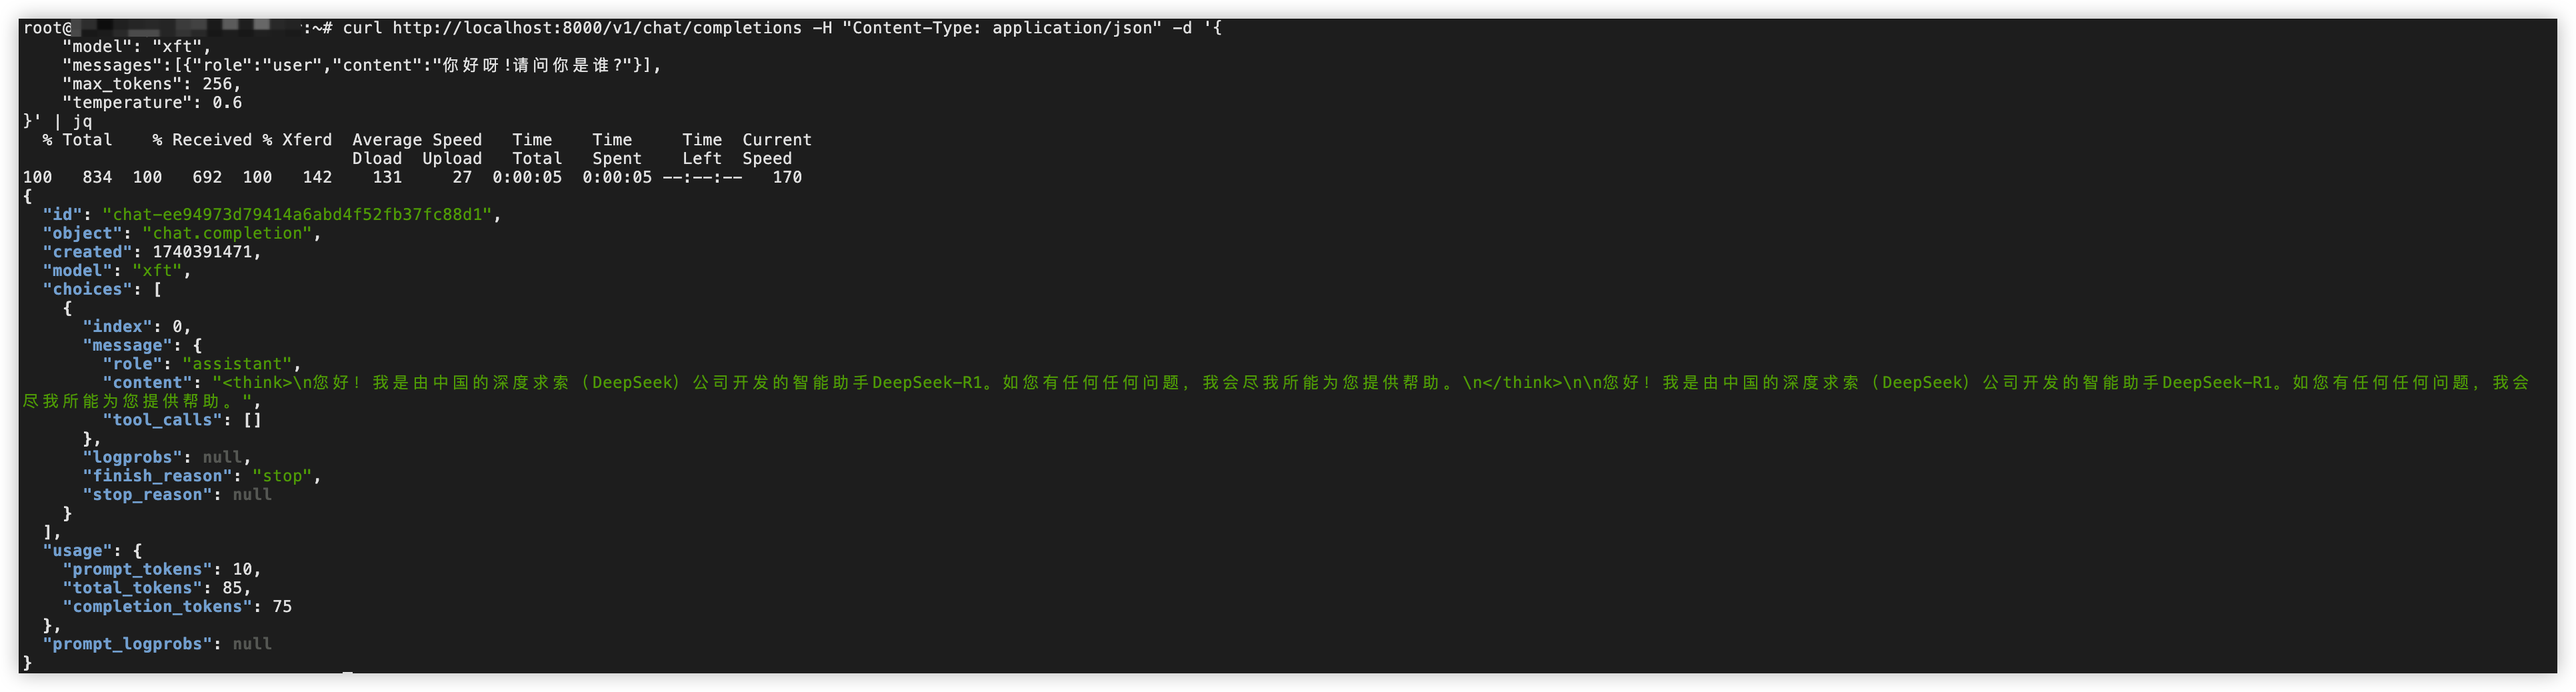
- 执行如下命令调用模型,确保部署的模型可以正常进行推理。
- curl http://localhost:8000/v1/chat/completions -H "Content-Type: application/json" -d '{"model": "xft","messages":[{"role":"user","content":"你好呀!请问你是谁?"}],"max_tokens": 256,"temperature": 0.6}' | jq
- 参数说明:
- 本文仅说明验证使用到的参数信息,更多参数详情可查看DeepSeek API文档。
- 参数名说明取值样例参数名说明取值样例model使用的模型名称。xftmessages对话的消息列表。
- role:该消息的发起角色。
- content:消息的内容。
-max_tokens指定一次请求中模型生成Completion的最大Token数。取值:- 介于1 到 8192 间的整数,如未指定 max_tokens参数。
- 默认值为 4096。
100temperature采样温度,值越高(例如1)会使输出更随机,而值越低(例如0.2)会使其更加集中和确定。取值:介于 0 和 2 之间。0.7
- 回显示例:
-
附录
资源 | | 地域 | 下载方式 |
资源 | | 地域 | 下载方式 |
推理引擎 | | 华北2(北京) | docker pull ai-containers-cn-beijing.cr.volces.com/deeplearning/xft-vllm:1.8.2.iaas |
模型文件 说明 | DeepSeek-R1-Distill-Qwen-1.5B | 华北2(北京) | https://iaas-public-model-cn-beijing.tos-cn-beijing.ivolces.com/models/DeepSeek-R1-Distill-Qwen-1.5B/ |
| | 华东2(上海) | https://iaas-public-model-cn-shanghai.tos-cn-shanghai.ivolces.com/models/DeepSeek-R1-Distill-Qwen-1.5B/ |
| DeepSeek-R1-Distill-Qwen-7B | 华北2(北京) | https://iaas-public-model-cn-beijing.tos-cn-beijing.ivolces.com/models/DeepSeek-R1-Distill-Qwen-7B/ |
| | 华东2(上海) | https://iaas-public-model-cn-shanghai.tos-cn-shanghai.ivolces.com/models/DeepSeek-R1-Distill-Qwen-7B/ |
| DeepSeek-R1-Distill-Qwen-32B | 华北2(北京) | https://iaas-public-model-cn-beijing.tos-cn-beijing.ivolces.com/models/DeepSeek-R1-Distill-Qwen-32B/ |
| | 华东2(上海) | https://iaas-public-model-cn-shanghai.tos-cn-shanghai.ivolces.com/models/DeepSeek-R1-Distill-Qwen-32B/ |
最近更新时间:2025.02.28 16:24:49
这个页面对您有帮助吗?
有用
有用
无用
无用