容器服务
容器服务
容器服务


文档指南
请输入


容器服务 VKE
产品动态
Kubernetes 版本发布记录
组件发布记录
监控组件
DNS 组件
GPU 组件
Sandbox 组件
安全公告
产品公告
历史公告
用户指南
集群
节点池
授权
网络
容器网络
服务(Service)
路由(Ingress)
APIG Ingress
ALB Ingress
自定义转发规则配置示例
CLB Ingress
Nginx Ingress
Gateway API
工作负载
存储
数据管理中心(DMC)
对象存储(TOS)
FSX 访问方式
文件存储(NAS)
FSX 访问方式
弹性文件存储(EFS)
文件存储(vePFS)
FSX 访问方式
vePFS Client 访问方式
NFS 访问方式
大数据文件存储(CloudFS)
弹性伸缩
工作负载弹性伸缩
事件驱动伸缩(KEDA)
组件管理
网络组件
监控组件
DNS 组件
GPU 组件
Sandbox 组件
异构计算
调度管理
可观测性
基础观测
诊断与巡检
最佳实践
网络
可观测性
安全合规
API 参考
集群管理
节点池管理
组件管理
机型镜像管理
云原生观测
巡检诊断
弹性容器实例
附录
开发指南
常见问题
通用 FAQ
集群 FAQ
集群管理
集群升级
节点与节点池 FAQ
授权 FAQ
工作负载 FAQ
服务与路由 FAQ
存储 FAQ
弹性伸缩 FAQ
可观测性 FAQ
配额 FAQ
组件 FAQ
容器镜像 FAQ
AI 云原生
推理套件
Helm 模板 AI 应用
Deepseek 实践
Qwen 实践
最佳实践
MiniMax 模型部署
Qwen 模型部署
弹性容器实例 VCI
最新动态
用户指南
虚拟节点
VKE 集群使用虚拟节点
自建/跨云集群使用虚拟节点
创建 VCI 实例
VCI Agent Sandbox
安全合规
- 文档首页
 容器服务容器服务 VKE用户指南异构计算NVIDIA GPU使用 DRA 实现 NVIDIA GPU 调度
 复制全文
 下载 pdf
使用 DRA 实现 NVIDIA GPU 调度
 文档反馈
 问问助手
DRA 是 Kubernetes 提供的一种声明式的资源管理机制,用于解决 GPU 等高性能硬件在细粒度分配、拓扑感知调度及跨节点共享等场景下的复杂资源管控问题。本文将详细阐述 DRA 的核心技术方案、与传统调度机制的差异以及配置方法。
背景信息
DRA 概述
DRA(Dynamic Resource Allocation,动态资源分配)是 Kubernetes 提供的一种资源管理框架。在容器服务中,它允许工作负载以声明式的方式申请和共享硬件资源(如 GPU、RDMA 网络接口等)。DRA 通过将硬件资源抽象为可编程的 API 对象,实现了资源管理逻辑从 kubelet 内置逻辑向第三方驱动(Driver)的解耦。DRA 显著提升了资源的分配精度和利用率,特别是在需要跨节点 GPU 内存统一寻址、GPU 共享以及高性能网络对齐等高阶场景下,提供了更高的调度灵活性。
说明
调度机制
DRA 与传统的 Device Plugin(设备插件)调度机制相比,在资源描述和调度逻辑上存在显著区别。如下表所示。
调度机制 | 资源描述 | 调度决策 |
Device Plugin | 采用“整数计数”模型(例如nvidia.com/gpu: 1),仅能描述资源的数量,无法表达硬件的显存容量、架构版本或拓扑连接关系。 | 调度器仅根据数量进行节点预选,具体的设备绑定在 kubelet 侧完成,容易导致调度决策与实际硬件拓扑不一致的问题。 |
DRA | 采用“属性化声明”模型。通过 ResourceSlice 发布设备的结构化属性,支持使用 CEL(Common Expression Language)表达式进行精准过滤,能够描述复杂的硬件特征。 | 调度器在预选阶段即可访问完整的硬件属性列表(ResourceSlice),直接参与具体的设备分配决策。这确保了 Pod 能够被精准分配到符合拓扑约束的硬件组合上。 |
资源对象
DRA 使用 ResourceClaim 等资源对象,对底层共享硬件资源进行探测、申请和分配。本文中涉及的资源对象说明,如下表所示。
资源对象 | 资源说明 |
ResourceSlice | 集群维度的资源对象,由各节点的 DRA 驱动根据底层硬件探测结果发布。它充当了硬件能力的“属性清单”,记录了节点上每个具体设备的元数据(如设备 ID、NUMA 归属、PCIe 拓扑位置等)。在调度阶段,ResourceSlice 为 kube-scheduler 提供全量的硬件状态视图,使其能够在全局范围内评估哪些设备符合工作负载的特定要求。 |
ResourceClaimTemplate | 用于描述资源需求的 API 对象。它定义了资源申请的期望规格,包括引用的设备类型(DeviceClass)以及分配模式(如全量分配或按需创建)。它并不代表实际的资源占用,而是作为生成具体 ResourceClaim 的指令模板。 您可以通过模板定义通用的硬件配置标准,供多个工作负载引用,确保存储和计算资源申请的一致性。 |
ResourceClaim | 记录资源分配状态的关键对象,是 Pod 与物理资源之间的逻辑纽带。它承载了从“需求声明”到“物理绑定”的转换状态。当 Pod 被创建时,系统会基于模板产生 ResourceClaim;一旦调度完成,分配到的具体设备信息(如 Device ID)会被写入 ResourceClaim 的状态中,锁定该资源。ResourceClaim 管理资源的整个生命周期,确保资源在 Pod 运行期间被正确持有,并在 Pod 销毁后根据策略触发资源释放或回收流程。 |
使用限制
- 暂不支持在集群中自动配置 DRA。如有需要,您可以遵循本文介绍的配置方法,手工配置。
- 当集群中的节点使用 DRA 时,无法同时使用以下 GPU 功能:
- NVIDIA GPU 调度。详情请参见 配置 NVIDIA GPU 调度。
- mGPU 调度。详情请参见 配置 mGPU 调度。
前提条件
- 已创建 VKE 集群,且集群 Kubernetes 版本需大于等于 v1.34。
- 已在本地环境中安装 kubectl 工具。详情请参见 安装和设置 kubectl。
操作步骤
步骤一:创建 GPU 节点池
- 登录 容器服务控制台。
- 在左侧导航栏中选择 集群,单击目标集群名称,进入集群控制台。
- 在左侧导航栏中,单击 节点池。
- 在节点池配置页面中,单击 创建节点池,根据您的实际需求,创建节点池。详细参数说明,请参见 创建节点池。其中:
- 在 计算规格 中,选择 GPU 计算型 规格,为集群添加包含 GPU 的节点。规格详细介绍,请参见 GPU 计算型。
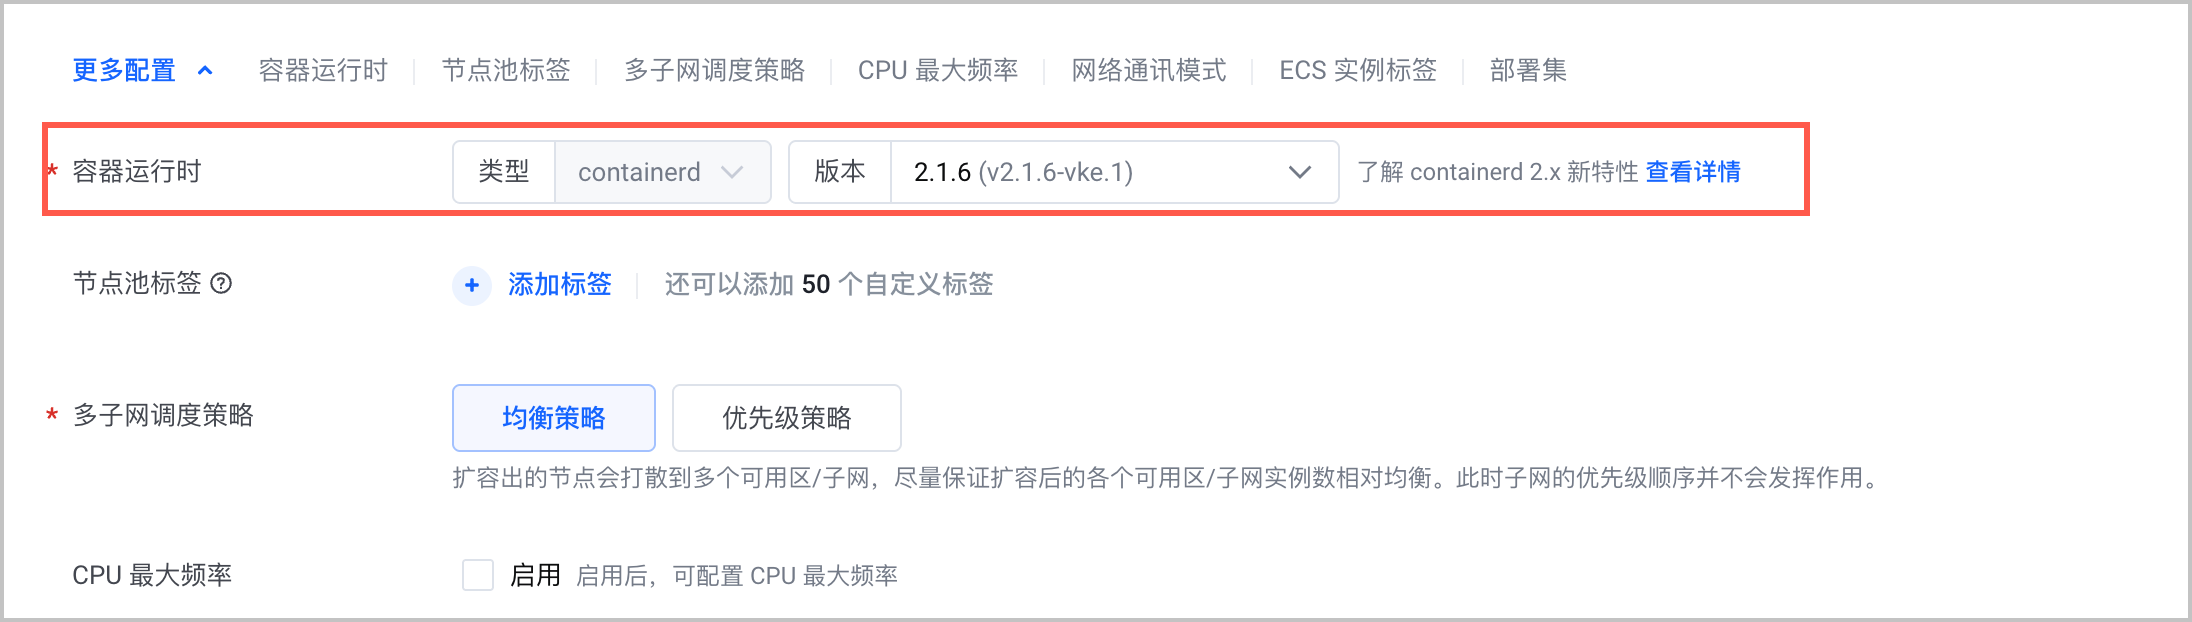
- 在 容器运行时 中,配置 Containerd 版本为 2.1 及以上版本。
-
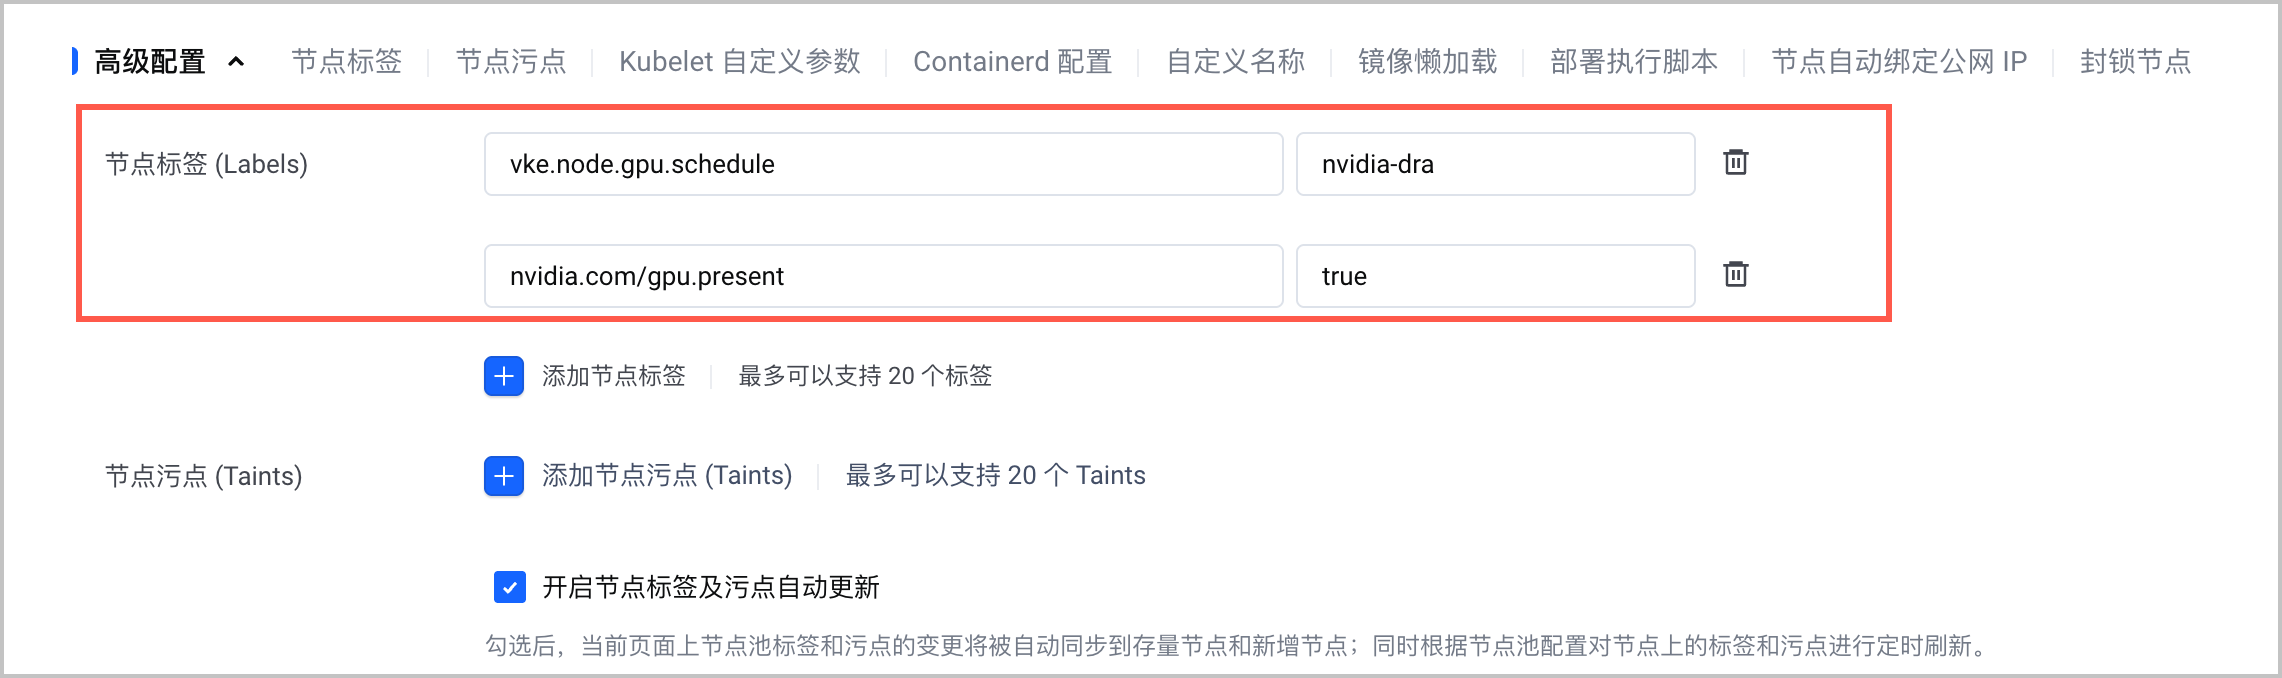
- 在 高级配置 中,单击 添加节点标签,为节点池添加如下标签。
- 配置标签键为vke.node.gpu.schedule,标签值为nvidia-dra。表示在该节点池中的节点上,开启 DRA GPU 调度能力。
- 配置标签键为nvidia.com/gpu.present,标签值为true。表示在该节点池中的节点上,运行 DRA 驱动。
-
- 完成其他参数配置后,单击 确定,创建节点池。
步骤二:安装 NVIDIA DRA 驱动
- 通过 kubectl 连接目标集群。详情请参见 连接集群。
- 执行以下命令,添加 NVIDIA Helm 仓库。
- helm repo add nvidia https://helm.ngc.nvidia.com/nvidiahelm repo update
- 执行以下命令,安装 NVIDIA DRA 驱动。本文以安装 25.8.1 版本驱动为例。
- helm install nvidia-dra-driver-gpu nvidia/nvidia-dra-driver-gpu \--version="25.8.1" \--create-namespace \--namespace nvidia-dra-driver-gpu \--set controller.affinity=null \--set gpuResourcesEnabledOverride=true \--set resources.computeDomains.enabled=false \--set "kubeletPlugin.affinity.nodeAffinity.requiredDuringSchedulingIgnoredDuringExecution.nodeSelectorTerms[0].matchExpressions[0].key=vke.node.gpu.schedule" \--set "kubeletPlugin.affinity.nodeAffinity.requiredDuringSchedulingIgnoredDuringExecution.nodeSelectorTerms[0].matchExpressions[0].operator=In" \--set "kubeletPlugin.affinity.nodeAffinity.requiredDuringSchedulingIgnoredDuringExecution.nodeSelectorTerms[0].matchExpressions[0].values[0]=nvidia-dra"
步骤三:确认 NVIDIA DRA 环境
DRA 安装完成后,您需要确认集群中的 NVIDIA DRA 驱动是否正常运行,同时 GPU 资源已成功上报到集群。
- 执行以下命令,检查集群中 DRA 相关的 API 资源。
- kubectl api-resources | grep resource.k8s.io
- 预期返回信息如下。
- deviceclasses resource.k8s.io/v1 false DeviceClassresourceclaims resource.k8s.io/v1 true ResourceClaimresourceclaimtemplates resource.k8s.io/v1 true ResourceClaimTemplateresourceslices resource.k8s.io/v1 false ResourceSlice
- 执行以下命令,检查 NVIDIA DRA 的 Pod 信息。
- kubectl get pods -n nvidia-dra-driver-gpu -o wide
- 预期返回信息如下,Pod 已完成部署,且状态为Running。
- NAME READY STATUS RESTARTS AGE IP NODE NOMINATED NODE READINESS GATESnvidia-dra-driver-gpu-kubelet-plugin-mq*** 1/1 Running 0 71s 192.168.2.253 192.168.2.8 <none> <none>
- 执行以下命令,检查集群中的 NVIDIA DRA 可用资源。
- kubectl get deviceclass,resourceslice
- 预期返回信息如下。
- NAME AGEdeviceclass.resource.k8s.io/gpu.nvidia.com 2m51sdeviceclass.resource.k8s.io/mig.nvidia.com 2m51sNAME NODE DRIVER POOL AGEresourceslice.resource.k8s.io/192.168.2.8-gpu.nvidia.com-tn*** 192.168.2.8 gpu.nvidia.com 192.168.2.8 2m31s
- 执行以下命令,查询 NVIDIA DRA 节点上报的资源。
- kubectl get resourceslice -o yaml
- 预期返回信息如下。
- apiVersion: v1items:- apiVersion: resource.k8s.io/v1kind: ResourceSlicemetadata:creationTimestamp: "2026-04-17T06:33:10Z"generateName: 192.168.2.8-gpu.nvidia.com-generation: 1name: 192.168.2.8-gpu.nvidia.com-t***ownerReferences:- apiVersion: v1controller: truekind: Nodename: 192.168.2.8uid: e62793a4-d8fe-4a11-bd56-60e***resourceVersion: "3880"uid: db0ea1ae-9f6d-43d5-8ee7-7f23f***spec:devices:- attributes:architecture:string: Amperebrand:string: NvidiacudaComputeCapability:version: 8.0.0cudaDriverVersion:version: 12.2.0driverVersion:version: 535.129.3pcieBusID:string: 0000:65:01.0productName:string: NVIDIA A30resource.kubernetes.io/pcieRoot:string: pci0000:64type:string: gpuuuid:string: GPU-c8133a35-9d03-a6b2-31dd-26***capacity:memory:value: 24Giname: gpu-0driver: gpu.nvidia.comnodeName: 192.168.2.8pool:generation: 1name: 192.168.2.8resourceSliceCount: 1kind: Listmetadata:resourceVersion: ""
- 执行以下命令,确认节点资源是否正确,不再出现nvidia.com/gpu资源。其中${dra-node-name}为节点名称,例如192.168.2.8。
- kubectl describe node ${dra-node-name} | grep -E 'nvidia\.com/gpu|Capacity|Allocatable'
- 预期返回信息如下,其中Capacity和Allocatable应该为空。
- nvidia.com/gpu.present=trueCapacity: # 若 Capacity 和 Allocatable 为空,符合预期Allocatable:Warning InvalidDiskCapacity 8m43s kubelet invalid capacity 0 on image filesystemNormal NodeAllocatableEnforced 8m43s kubelet Updated Node Allocatable limit across pods
结果验证
在集群中完成 NVIDIA DRA 安装后,您可以通过 ResourceClaimTemplate 资源创建资源声明(ResourceClaim),从而为工作负载申请并使用 DRA GPU 资源。
创建 ResourceClaimTemplate 资源
- 创建 ResourceClaimTemplate 的 YAML 文件。示例文件resource-claim-template-single-gpu.yaml代码如下:
- apiVersion: resource.k8s.io/v1kind: ResourceClaimTemplatemetadata:name: single-gpu # 资源名称,作为资源的全局唯一标识spec:spec:devices:requests:- name: gpu # 资源局部标识符。Pod 通过引用这个名称,最终将系统分配的物理 GPU 挂载到自身的运行环境中exactly:allocationMode: ExactCount # 资源分配模式。本例中表示调度器按照“固定数量”,在物理节点的资源池中锁定对应的硬件资源deviceClassName: gpu.nvidia.com # 指定处理该请求的底层驱动程序count: 1 # 物理资源的锁定指标。本例中表示系统需要为绑定的工作负载分配,在节点上独占 1 个完整的 GPU 显卡
- 执行以下命令,创建 ResourceClaimTemplate。
- kubectl apply -f resource-claim-template-single-gpu.yaml
- 执行以下命令,确认已创建的 ResourceClaimTemplate 资源状态。
- kubectl get resourceclaimtemplates
- 预期返回信息如下。
- NAME AGEsingle-gpu 12s
部署使用 DRA 的工作负载
- 创建工作负载,并使用 ResourceClaimTemplate 申请资源。本文以创建无状态负载为例,示例resource-claim-template-pod.yaml代码如下:
- apiVersion: apps/v1kind: Deploymentmetadata:name: gpu-testspec:replicas: 1selector:matchLabels:app: gpu-testtemplate:metadata:labels:app: gpu-testspec:containers:- image: doc-cn-beijing.cr.volces.com/vke/gpu-burn:1.0name: testargs:- -c- nvidia-smi -L; sleep 600command:- shresources:claims:- name: gputerminationGracePeriodSeconds: 3resourceClaims:- name: gpu # 已创建 ResourceClaimTemplate 中的资源局部标识符resourceClaimTemplateName: single-gpu # 已创建的 ResourceClaimTemplate 资源名称
- 执行以下命令,创建工作负载。
- kubectl apply -f resource-claim-template-pod.yaml
- 执行以下命令,查看工作负载的 Pod 状态。
- kubectl get pods -o wide
- 预期返回信息如下,工作负载已完成部署,Pod 状态为Running。
- NAME READY STATUS RESTARTS AGE IP NODE NOMINATED NODE READINESS GATESgpu-test-5c47d94*** 1/1 Running 0 96s 192.168.2.254 192.168.2.8 <none> <none>
- 执行以下命令,查看工作负载关联的 ResourceClaims 资源。
- kubectl get resourceclaims
- 预期返回信息如下。
- NAME STATE AGEgpu-test-5c47d94bf9-fb*** allocated,reserved 3m18s
-
- 执行以下命令,查看 ResourceClaim 资源详情。
- kubectl describe resourceclaims
- 预期返回信息如下,包括 Pod 被分配到的具体设备信息。
- Name: gpu-test-5c47d94***Namespace: defaultLabels: <none>Annotations: resource.kubernetes.io/pod-claim-name: gpuAPI Version: resource.k8s.io/v1Kind: ResourceClaimMetadata:Creation Timestamp: 2026-04-17T06:41:51ZFinalizers:resource.kubernetes.io/delete-protectionGenerate Name: gpu-test-5c47d94***Owner References:API Version: v1Block Owner Deletion: trueController: trueKind: PodName: gpu-test-5c47d94***UID: 691d19b1-5ca8-40c***Resource Version: 6101UID: 85fbff51-0247-43***Spec:Devices:Requests:Exactly:Allocation Mode: ExactCountCount: 1Device Class Name: gpu.nvidia.comName: gpuStatus:Allocation:Devices:Results:Device: gpu-0Driver: gpu.nvidia.comPool: 192.168.2.8Request: gpuNode Selector:Node Selector Terms:Match Fields:Key: metadata.nameOperator: InValues:192.168.2.8Reserved For:Name: gpu-test-5c47d94***Resource: podsUID: 691d19b1-5ca8-40c***Events: <none>
- 执行以下命令,查看工作负载的 Pod 日志。
- kubectl logs deployment/gpu-test --all-pods=true
- 预期返回信息如下。
- [pod/gpu-test-5c47d94***/test] GPU 0: NVIDIA A30 (UUID: GPU-c8133a35-9d0***)
最近更新时间:2026.04.21 19:41:38
这个页面对您有帮助吗?
有用
有用
无用
无用