容器服务
容器服务
容器服务


文档指南
请输入


容器服务 VKE
产品动态
Kubernetes 版本发布记录
组件发布记录
监控组件
DNS 组件
GPU 组件
Sandbox 组件
安全公告
产品公告
历史公告
用户指南
集群
节点池
授权
网络
容器网络
服务(Service)
路由(Ingress)
APIG Ingress
ALB Ingress
自定义转发规则配置示例
CLB Ingress
Nginx Ingress
Gateway API
工作负载
存储
数据管理中心(DMC)
对象存储(TOS)
FSX 访问方式
文件存储(NAS)
FSX 访问方式
弹性文件存储(EFS)
文件存储(vePFS)
FSX 访问方式
vePFS Client 访问方式
NFS 访问方式
大数据文件存储(CloudFS)
弹性伸缩
工作负载弹性伸缩
事件驱动伸缩(KEDA)
组件管理
网络组件
监控组件
DNS 组件
GPU 组件
Sandbox 组件
异构计算
调度管理
可观测性
基础观测
诊断与巡检
最佳实践
网络
可观测性
安全合规
API 参考
集群管理
节点池管理
组件管理
机型镜像管理
巡检诊断
弹性容器实例
附录
开发指南
常见问题
通用 FAQ
集群 FAQ
集群管理
集群升级
节点与节点池 FAQ
授权 FAQ
工作负载 FAQ
服务与路由 FAQ
存储 FAQ
弹性伸缩 FAQ
调度 FAQ
可观测性 FAQ
配额 FAQ
组件 FAQ
容器镜像 FAQ
AI 云原生
推理套件
Helm 模板 AI 应用
Deepseek 实践
Qwen 实践
最佳实践
MiniMax 模型部署
Qwen 模型部署
弹性容器实例 VCI
最新动态
用户指南
虚拟节点
VKE 集群使用虚拟节点
自建/跨云集群使用虚拟节点
创建 VCI 实例
VCI Agent Sandbox
安全合规
- 文档首页
 容器服务容器服务 VKE用户指南可观测性可观测性概述
 复制全文
 下载 pdf
可观测性概述
 文档反馈
 问问助手
随着 Kubernetes 的广泛使用,云原生架构给可观测性带来了新的挑战。在微服务和容器化的背景下,您需要充分了解应用程序以及 Kubernetes 基础设施的运行状态,快速定位并解决出现的问题,同时需要对应用以及集群运行状态数据的收集和分析,持续优化和改进,从而保证运行环境安全可靠。
本文为您介绍容器服务可观测性系统的组成,以及基于火山引擎云产品实现容器服务可观测系统构建的最佳实践。
Kubernetes 的可观测挑战
Kubernetes 系统对于可观测性方面的挑战包括:
- 架构复杂:Kubernetes 系统包括控制面和数据面,包含种类众多相互通信的组件,可观测性必须能够覆盖全面。
- 动态资源:Kubernetes 集群中动态创建 Pod、Service 等资源并为其分配 IP,重建 Pod 时为其分配新的资源和 IP,需要动态监控这些资源的创建、删除以及底层资源的水位。
- 微服务架构:在微服务和容器化的背景下,传统应用按照微服务架构分解成多个组件,每个组件副本数又可以根据需求,实现弹性扩缩容。这对问题的排查和故障处理提出了非常高的要求。
针对 Kubernetes 系统的可观测性挑战,尤其在集群规模快速增长的情况下,高效可靠的 Kubernetes 系统可观测性能力,是系统稳定性保障的基石。
可观测性架构
在云原生架构中,可观测性(Observability)一般是指三个具体的方向,分别为:日志事件(Logging)、链路追踪(Tracing) 和 聚合指标(Metrics)。
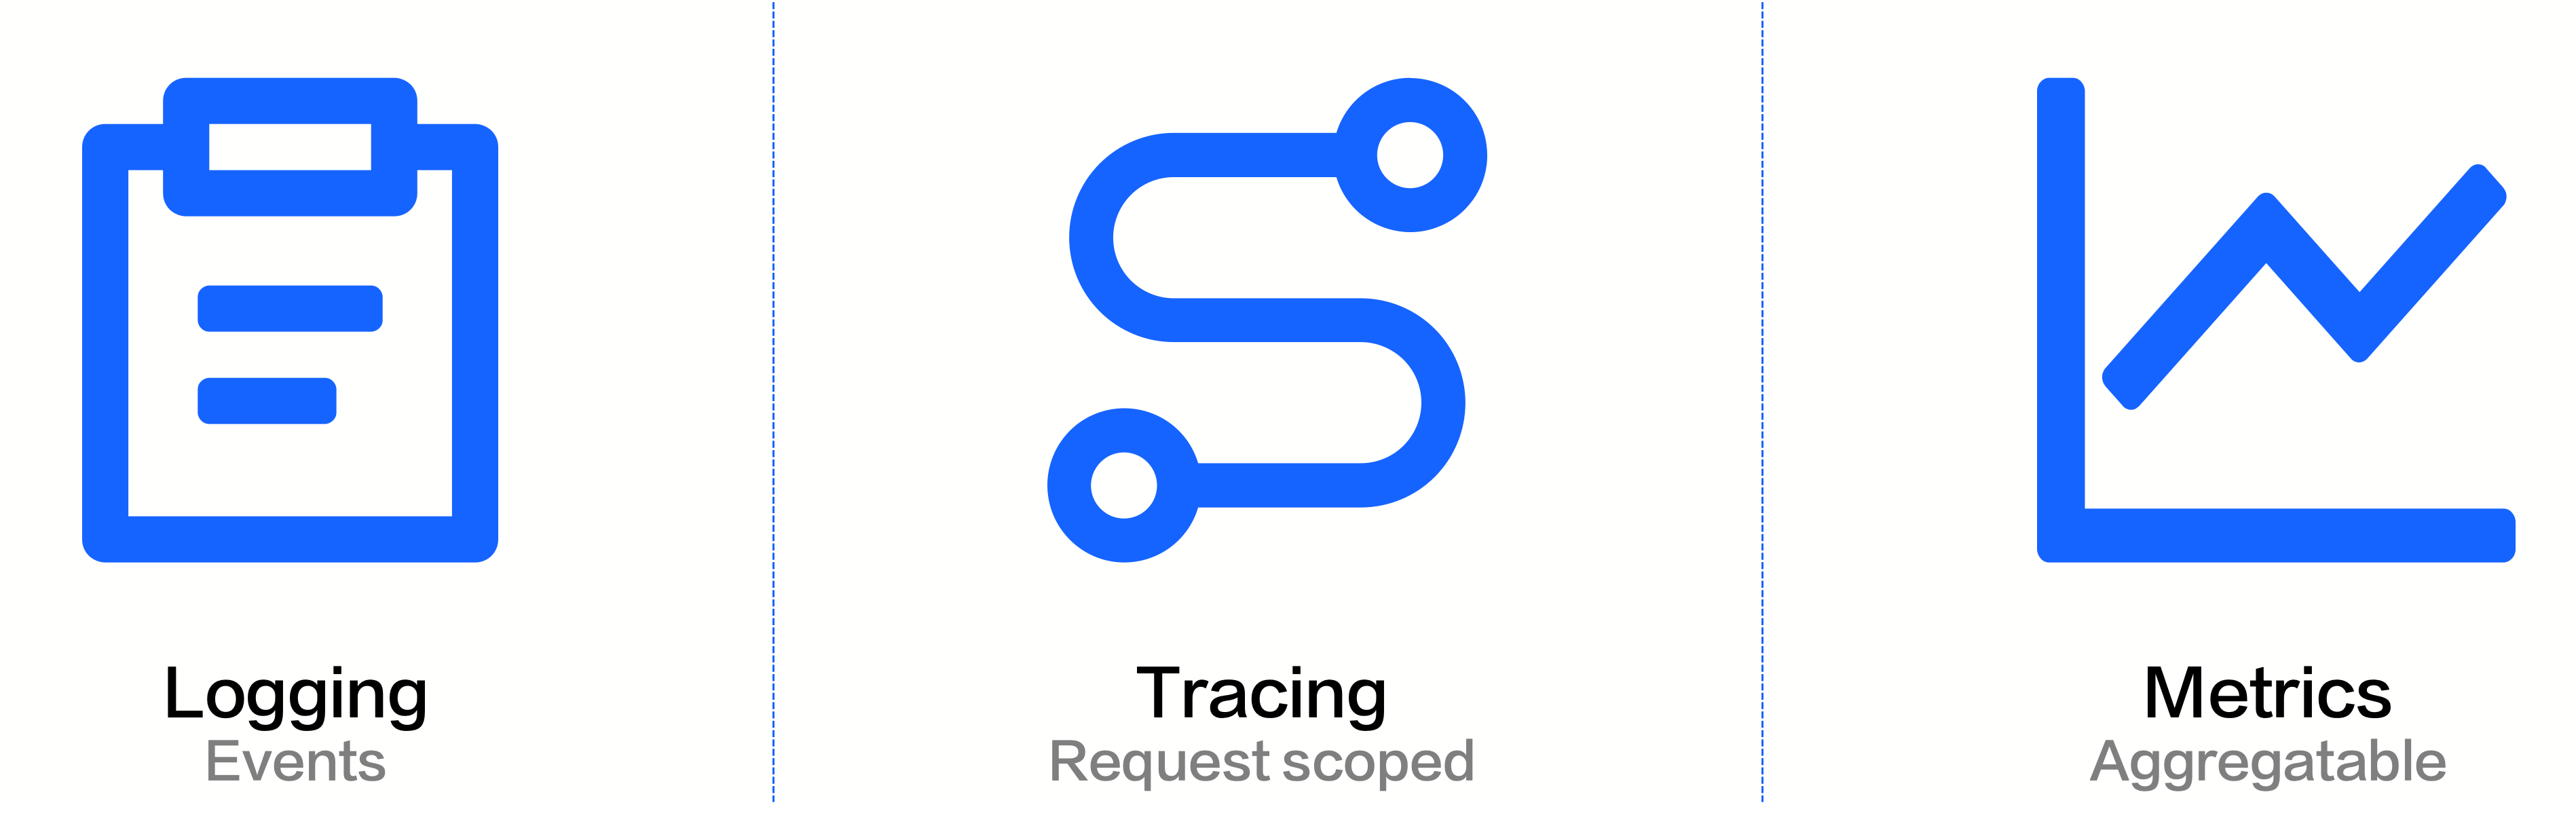
- 日志事件(Logging):日志和事件是系统离散行为和状态的记录,这些记录可以用来分析程序的行为。当程序出错时,能够通过日志和事件找到错误的原因并给予修复。应用程序输出日志很容易,但收集和分析日志却可能会很复杂,面对成千上万的集群节点、迅速滚动的事件信息和数以 TB 级的文本,传输与归集都并不简单。为此,需要对接专门的系统进行日志的搜集、存储、查看和检索。
- 链路追踪(Tracing):在云原生系统中,由于应用程序微服务化,链路追踪不只局限于调用栈。一个外部请求往往需要若干个内部服务的联动响应,这时候完整的调用轨迹将跨越集群内的多个服务。同时包括服务间的网络传输信息及各个服务内部的调用堆栈信息。因此,云原生系统中的链路追踪也被称为 全链路追踪。链路追踪的主要目的是排查故障,例如:调用链的哪一部分、哪个方法出现错误或阻塞,输入输出是否符合预期等等。
- 聚合指标(Metrics):聚合指标是指系统中某一类信息的统计聚合。例如:集群节点资源的使用量、水位、配额等。聚合指标的主要目的是监控(Monitoring)和告警(Alert),当某些指标达到风险阈值时触发告警,以便自动处理或者提醒管理员介入。
日志(Logging)
项目 | 说明 |
日志类型 | 支持集群、应用的多种类型日志,包括:
|
日志存储 | 支持海量数据的持久化存储,性能稳定、读写便捷。 |
检索分析 | 支持使用关键词检索日志,快速定位异常事件;同时支持使用 SQL 对日志进行实时统计与分析,快速获取关键数据。 |
可视化 | 查询与分析结果支持可视化展示,支持多维度的统计图表类型和自定义的交互式仪表盘,辅助数据的实时监控与运营。 |
说明
日志服务支持海量数据秒级查询分析,提供高效实时的日志处理工具,降低了日志类数据的使用门槛,有效提升运维能力及数据分析效率。当集群发生故障时,您可以从日志服务中查看过去的日志信息,进行故障排查。
事件(events)
Kubernetes 事件是一个对象,它显示集群、节点、Pod 或容器内发生的事情。这些对象通常是为了响应 Kubernetes 系统内部发生的变化而生成的。Kubernetes 事件能够帮助用户深入了解集群的健康和性能。事件一般分为 2 种:
- Warning 事件:表示产生这个事件的状态转换是在非预期的状态之间产生的。
- Normal 事件:表示期望到达的状态和目前达到的状态是一致。
指标(Metrics)
容器服务支持通过火山引擎云原生观测(基础观测、全栈观测)、应用性能观测、AI 观测等方案,实现集群、基础资源和应用指标(Metrics)的采集、监控和告警。
方案介绍 | 方案介绍 | 相关文档 |
基础观测 | 云原生基础观测基于火山引擎托管 Prometheus 服务,使用部署在集群内的高可用采集器,实现集群资源、控制面服务、网络、业务的监控。 支持使用 ServiceMonitor、PodMonitor 等服务发现方式,实现集群内自定义业务的发现和监控。 | |
全栈观测 | 云原生全栈观测基于 eBPF 实现的高性能、无侵入、全栈化的数据采集,全面支持内核级别的深度观测能力,并配合高性能的应用协议解析模块,自动解析 HTTP(S)、DNS、gRPC Unary/Streaming 等应用协议,集合 Kubernetes 的元数据,实现资源层、网络层、应用层代码零侵入的全栈观测体验。 | |
应用性能观测 | 应用性能观测基于火山引擎 APMPlus 服务,支持从基础层资源性能监控,到服务、代码层监控,再到线上应用运行健康度监控的全链路监控能力。通过自研 Agent、OpenTelemetry 等方式即可接入 Java、Go、Python 等应用(例如:大模型、LLM、智能体等)进行全链路监控,提供更丰富的异常现场还原能力。包括:服务监控、链路分析、错误分析、日志监控、自定义监控、报警任务等核心功能。 | |
AI 观测 | 当在容器服务集群中部署大语言模型(LLM)时,支持对指定容器进行 AI Profiling 分析,方便面向 LLM 全生命周期(训练、推理、优化)进行检测和调优。 |
最近更新时间:2025.11.27 17:38:38
这个页面对您有帮助吗?
有用
有用
无用
无用