容器服务
容器服务


文档指南

请输入


- 文档首页
 容器服务容器服务 VKE用户指南异构计算容器共享 mGPU通过 mGPU 实现算力分配策略
 复制全文
 下载 pdf
通过 mGPU 实现算力分配策略
 文档反馈
 问问助手
本文主要介绍配置 mGPU 算力分配策略的方法,以及在工作负载中使用该策略进行调度的操作。
使用须知
项目 | 要求 |
Kubernetes 版本 | 不低于 v1.20.15-vke.6 版本。 说明 |
mgpu 组件版本 |
算力分配策略说明
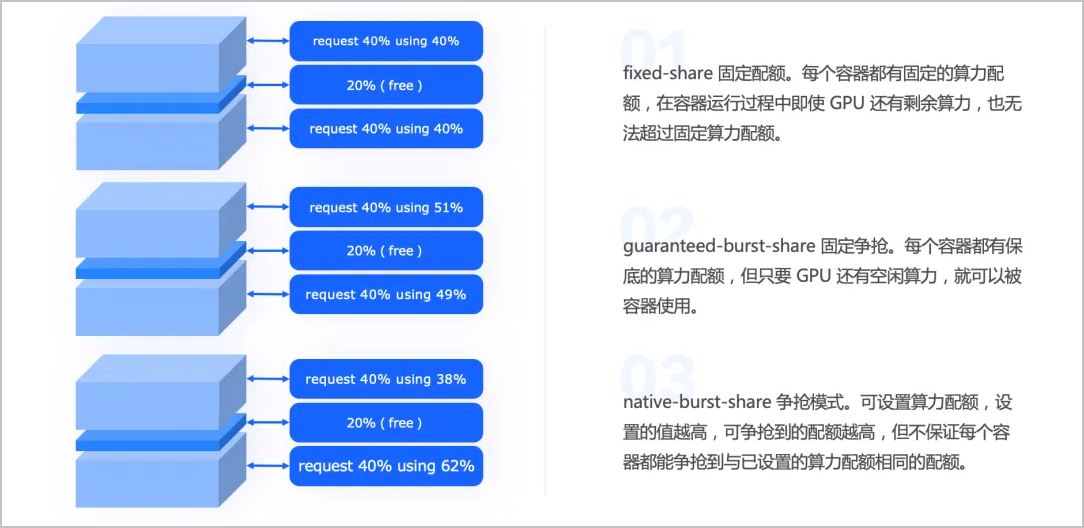
mGPU 支持如下三种算力分配策略。
Value 取值 | 说明 |
fixed-share(默认值) | 固定配额。每个容器都有固定的算力配额,在容器运行过程中即使 GPU 还有剩余算力,也无法超过固定算力配额。 |
guaranteed-burst-share | 固定争抢。每个容器都有保底的算力配额,但只要 GPU 还有空闲算力,就可以被容器使用。 |
native-burst-share | 争抢模式。可设置算力配额,设置的值越高,可争抢到的配额越高,但不保证每个容器都能争抢到与已设置的算力配额相同的配额。 |
前提条件
操作步骤
步骤一:配置节点算力分配策略
- 登录 容器服务控制台。
- 在左侧导航栏中选择 集群,单击目标集群名称,进入集群管理页面。
- 为 mGPU 相关的节点池或节点,配置算力分配策略。
-
- 在集群管理页面的左侧导航栏中,选择 节点管理 > 节点池。
- 在 节点池 页面,找到已完成 mGPU 相关配置的节点池,单击对应 操作 列下的 编辑。
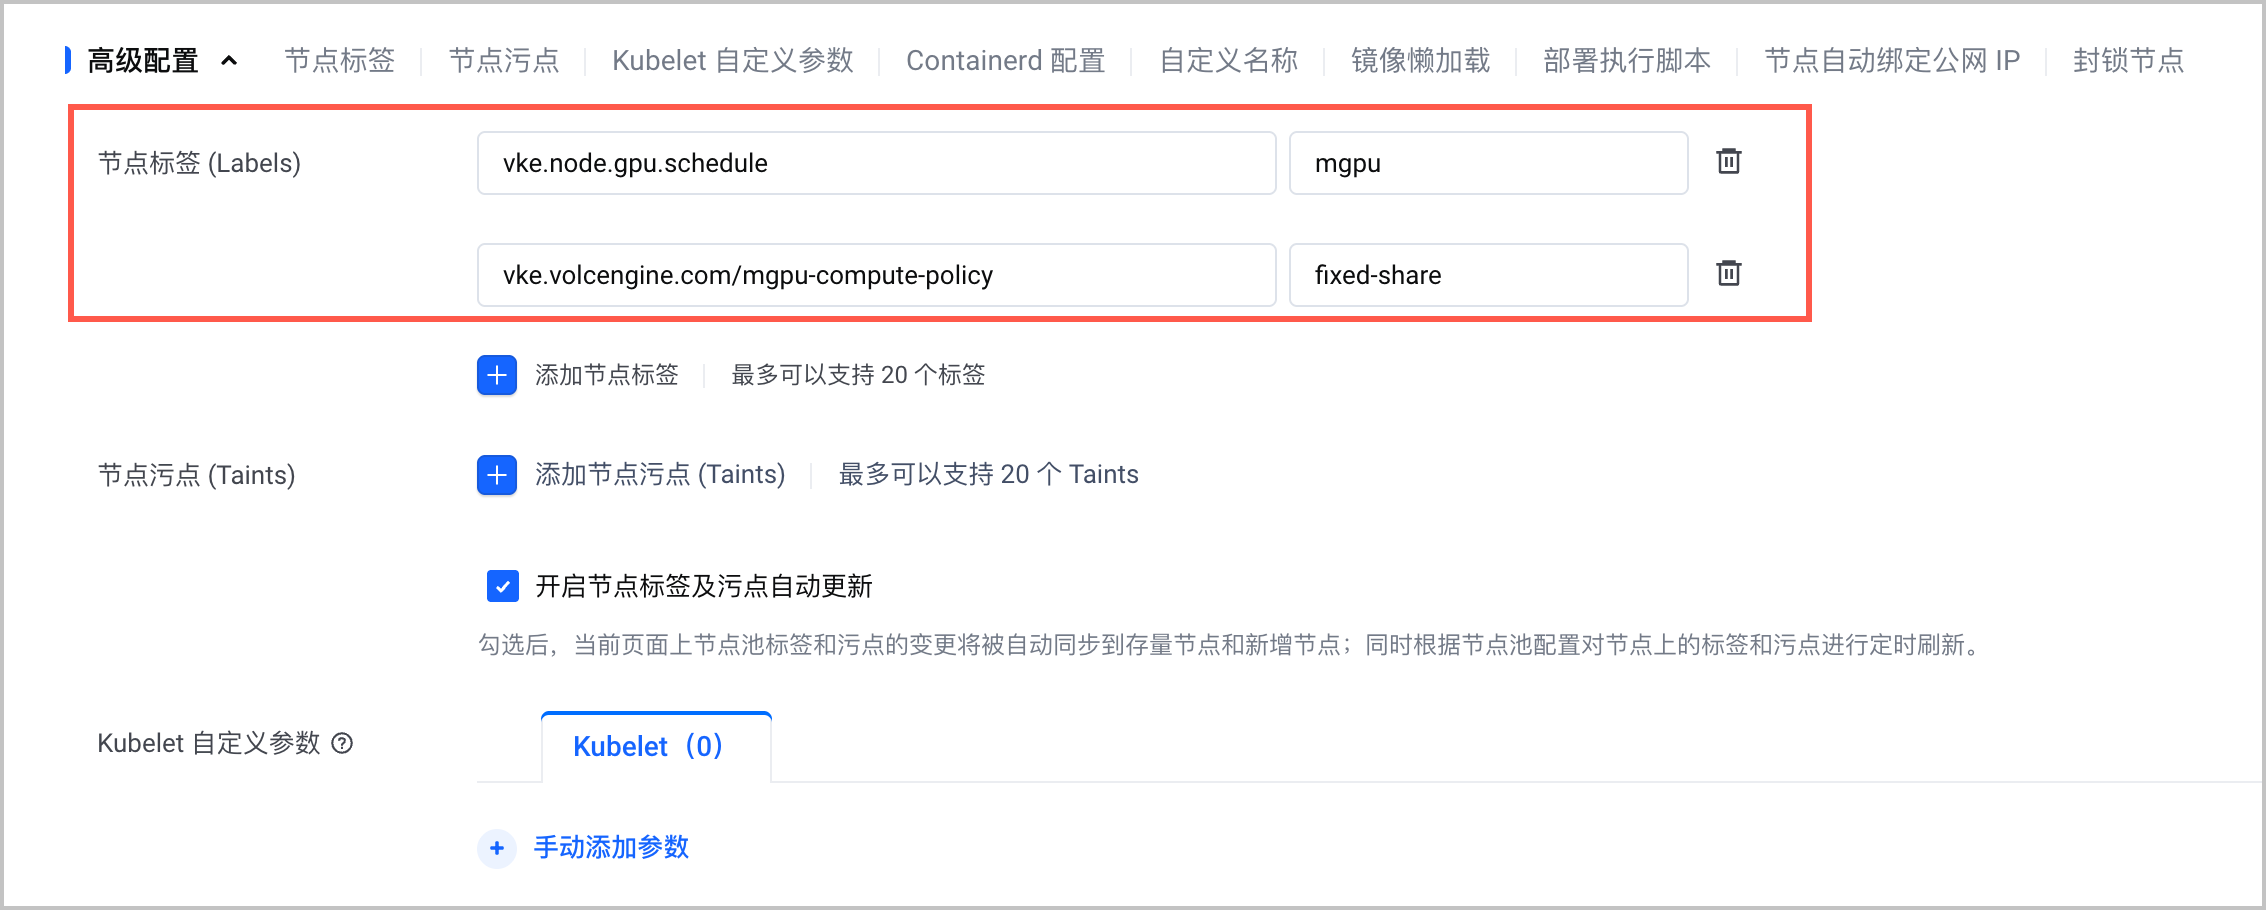
注意您也可以在满足配置 mGPU 算力分配策略环境要求(Kubernetes 版本、mgpu 组件版本等)的集群中,创建新的 mGPU 相关 GPU 计算型节点池,同时配置算力分配策略。此时无需重启节点。详细操作,请参见 mGPU 使用方法。- 在 高级配置 处,配置标签键为vke.volcengine.com/mgpu-compute-policy,标签值为fixed-share、guaranteed-burst-share或native-burst-share。表示在该节点池中的节点上,配置算力分配策略。
注意- 您可以通过开启或关闭节点池的 节点标签及污点自动更新 功能,控制是否同步标签到节点池中的存量节点中。关闭该功能时,可能导致存量节点上的 GPU 算力分配策略与预期不符,请谨慎配置。
- 更改节点池中节点的 mGPU 算力分配策略后,需要重启节点池中的所有 mGPU 相关节点使策略生效。
- 不设置算力分配策略时(即不设置vke.volcengine.com/mgpu-compute-policy节点标签),则默认按fixed-share策略分配算力。
-
- 在集群管理页面的左侧导航栏中,选择 节点管理 > 节点。
- 在 节点 页面,找到已完成 mGPU 相关配置的节点,选择对应 操作 列下的... > 标签管理。
- 在 标签 页签,单击 添加标签,在节点标签列表的最后,添加 key 为vke.volcengine.com/mgpu-compute-policy、Value 为fixed-share、guaranteed-burst-share或native-burst-share的标签,表示在该节点上,配置 Value 取值对应的算力分配策略。
-

注意- 更改节点的 mGPU 算力分配策略后,需要重启节点使策略生效。重启节点的操作,请参见 重启实例。
- vke.volcengine.com/mgpu-compute-policy属于系统标签,节点上添加系统标签后不允许修改 Value 值。
- 未配置算力分配策略时(即不设置vke.volcengine.com/mgpu-compute-policy节点标签),则默认按fixed-share策略分配算力。
步骤二:配置工作负载
通过控制台配置
- 在集群管理页面的左侧导航栏中,选择 工作负载 > 无状态负载。
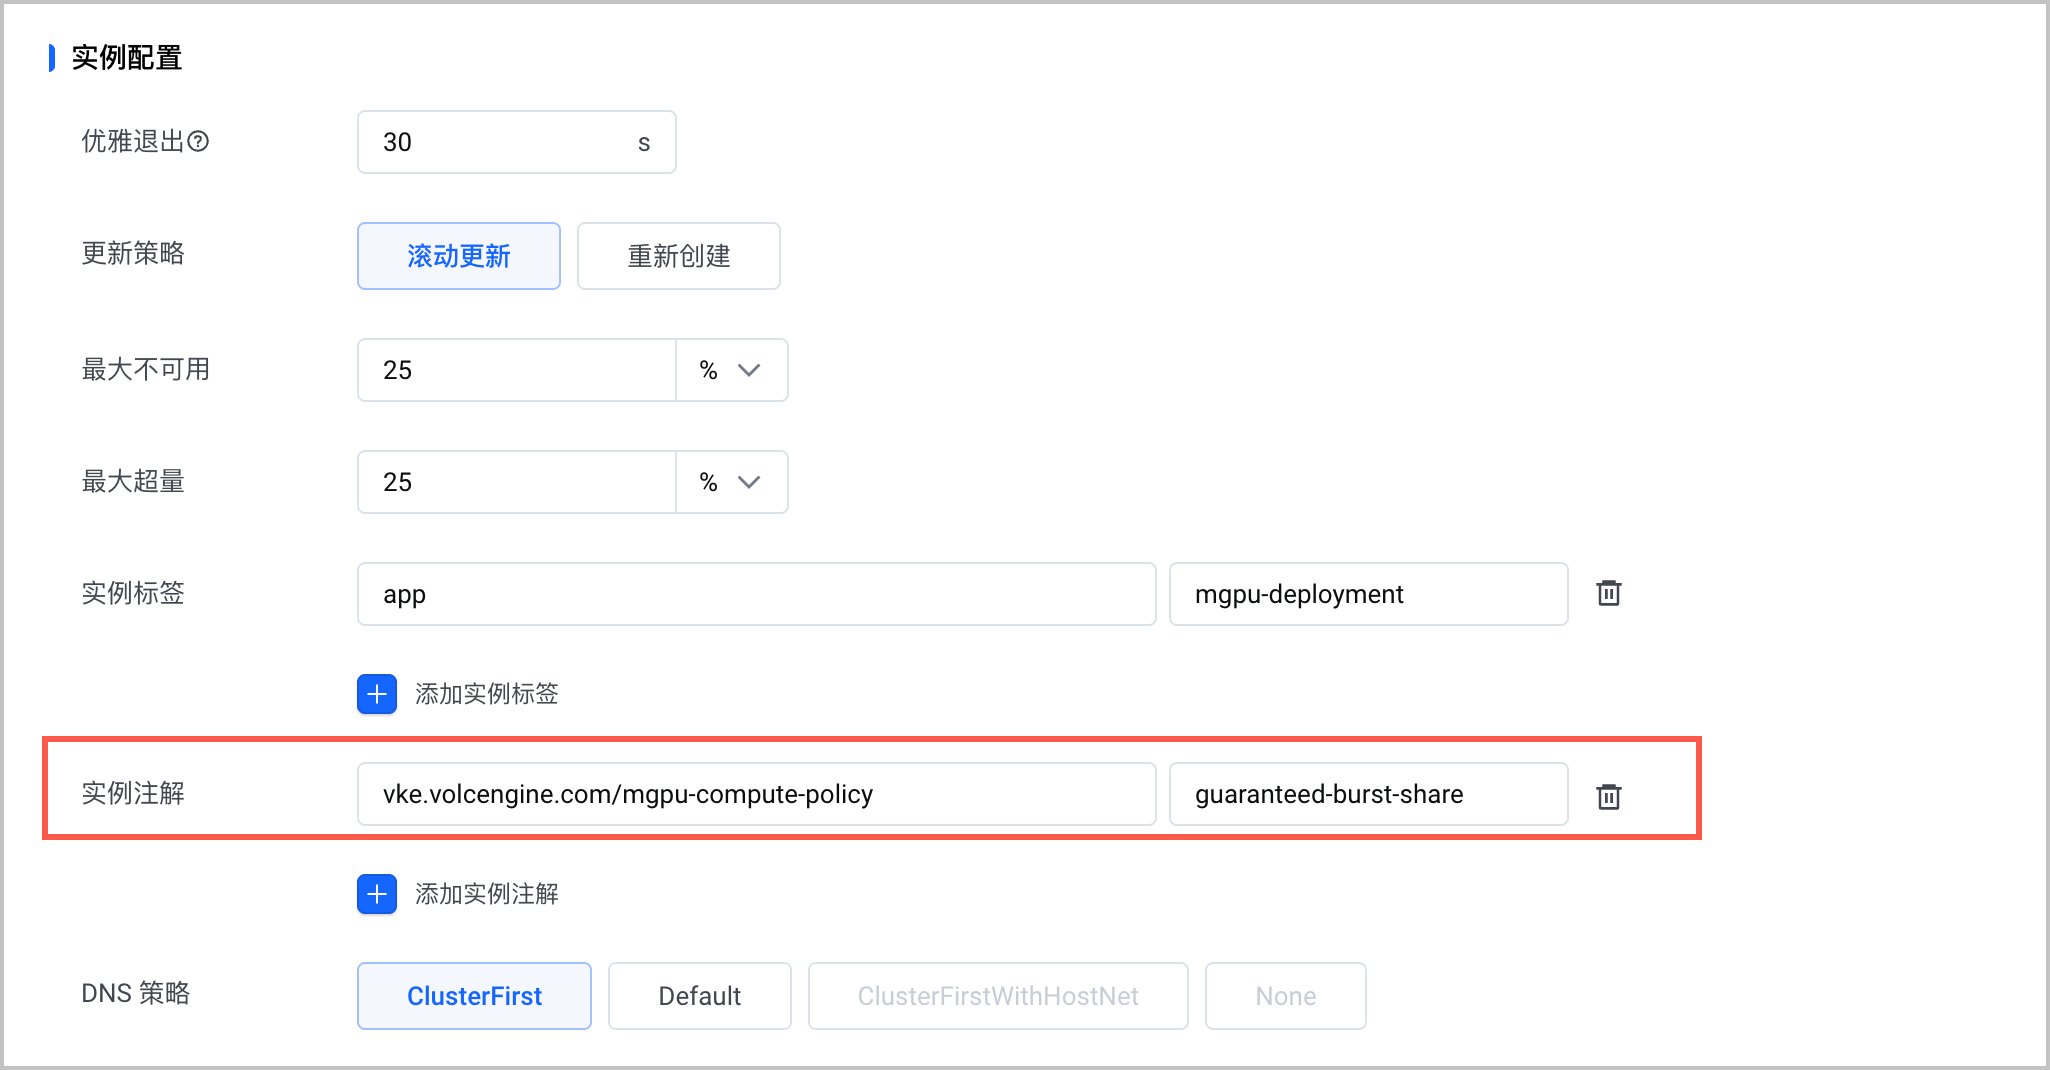
- 在 无状态负载 页面,创建无状态负载或更新已有的负载。其中,在 高级配置 步骤的 实例配置 处,使用注解配置 Pod 的算力分配策略。
- 配置 实例注解 的注解键为vke.volcengine.com/mgpu-compute-policy,注解值为fixed-share、guaranteed-burst-share或native-burst-share,表示该工作负载使用对应的算力分配策略。
-
注意
- 工作负载未配置算力分配策略的注解时,默认按fixed-share策略调度。
- 请确保集群中存在与工作负载具有相同策略的 GPU 计算型节点,例如工作负载的调度策略为fixed-share,那么集群中必须存在fixed-share策略的 GPU 计算型节点,否则会由于无合适调度的资源,导致工作负载调度失败。
通过 kubectl 命令行配置
说明
在spec.template.metadata字段下通过注解vke.volcengine.com/mgpu-compute-policy配置对应 Pod 的算力分配策略。
通过 YAML 创建工作负载,并实现算力分配策略的示例,如下所示:
apiVersion: apps/v1
kind: Deployment
metadata:
name: mgpu-demo
namespace: default
spec:
replicas: 1
selector:
matchLabels:
app: mgpu-deployment
template:
metadata:
labels:
app: mgpu-deployment
annotations:
vke.volcengine.com/mgpu-compute-policy: guaranteed-burst-share # 工作负载的算力分配策略,不配置时默认采用 fixed-share 策略
spec:
containers:
- name: mgpu-container
image: doc-cn-beijing.cr.volces.com/vke/gpu-burn:1.0
command: ["/bin/sh"]
args: ["-c", "sleep infinity"]
resources:
requests: # 与 limits 保持一致
vke.volcengine.com/mgpu-memory: 4096
vke.volcengine.com/mgpu-core: 30
limits:
vke.volcengine.com/mgpu-memory: 4096 # GPU 显存,单位为 MiB,此处表示 GPU 显存为 4 GiB
vke.volcengine.com/mgpu-core: 30 # GPU 算力百分比,此处表示配置 30% 的 GPU 算力
ports:
- containerPort: 80
注意
- 工作负载未配置算力分配策略的注解时,默认按fixed-share策略调度。
- 请确保集群中存在与工作负载具有相同策略的 GPU 计算型节点,例如工作负载的调度策略为fixed-share,那么集群中必须存在fixed-share策略的 GPU 计算型节点,否则会由于无合适调度的资源,导致工作负载调度失败。
结果验证
查看 GPU 显卡信息
mGPU 提供 mGPU Client(mgpu-cli),支持开发者在终端查看 mGPU 相关信息。
- 登录 Pod 所在节点。您可以通过 ECS Terminal 登录,详细操作,请参见 ECS Terminal。
- 执行如下命令,查看节点 GPU 物理显卡信息。
- mgpu-cli device info -a
- 系统返回如下,在本例中compute_policy显示为1,表示节点算力分配策略为guaranteed-burst-share。
- +-----------------------------------+-------------+| device_id | 0 |+-----------------------------------+-------------+| compute_free_weight | 100 |+-----------------------------------+-------------+| compute_free_weight_online | 70 |+-----------------------------------+-------------+| compute_load_balance_mode | 0 |+-----------------------------------+-------------+| compute_policy | 1 |+-----------------------------------+-------------+| compute_qos_enabled | 1 |+-----------------------------------+-------------+| compute_qos_enabled_native_burst | 1 |+-----------------------------------+-------------+| compute_timeslice | 200 |+-----------------------------------+-------------+| compute_timeslice_native_burst | 4096 |+-----------------------------------+-------------+| compute_total_weight_native_burst | 30 |+-----------------------------------+-------------+| device_major | 510 |+-----------------------------------+-------------+| instance_deploy_mode | 1 |+-----------------------------------+-------------+| instance_major | 509 |+-----------------------------------+-------------+| online_offline_switch | 2 |+-----------------------------------+-------------+| user_instance_major | 511 |+-----------------------------------+-------------+| vmem_free_bytes | 23359324160 |+-----------------------------------+-------------+| vmem_limit | 4096 MiB |+-----------------------------------+-------------+
- 指标名称指标含义compute_free_weight_online 设备未分配的算力百分比,本例中为 70%。compute_load_balance_mode容器使用该设备时的负载均衡模式。compute_policy算力调度策略:
- 0:表示fixed-share。
- 1:表示guaranteed-burst-share。
- 2:表示native-burst-share。
compute_timeslice算力时间片百分比。device_major/dev/mgpuX主设备号。instance_major/dev/mgpuXinstY、/dev/mgpuXctl-$(container_id)主设备号。vmem_free_bytes该设备剩余的显存容量,单位: byte。
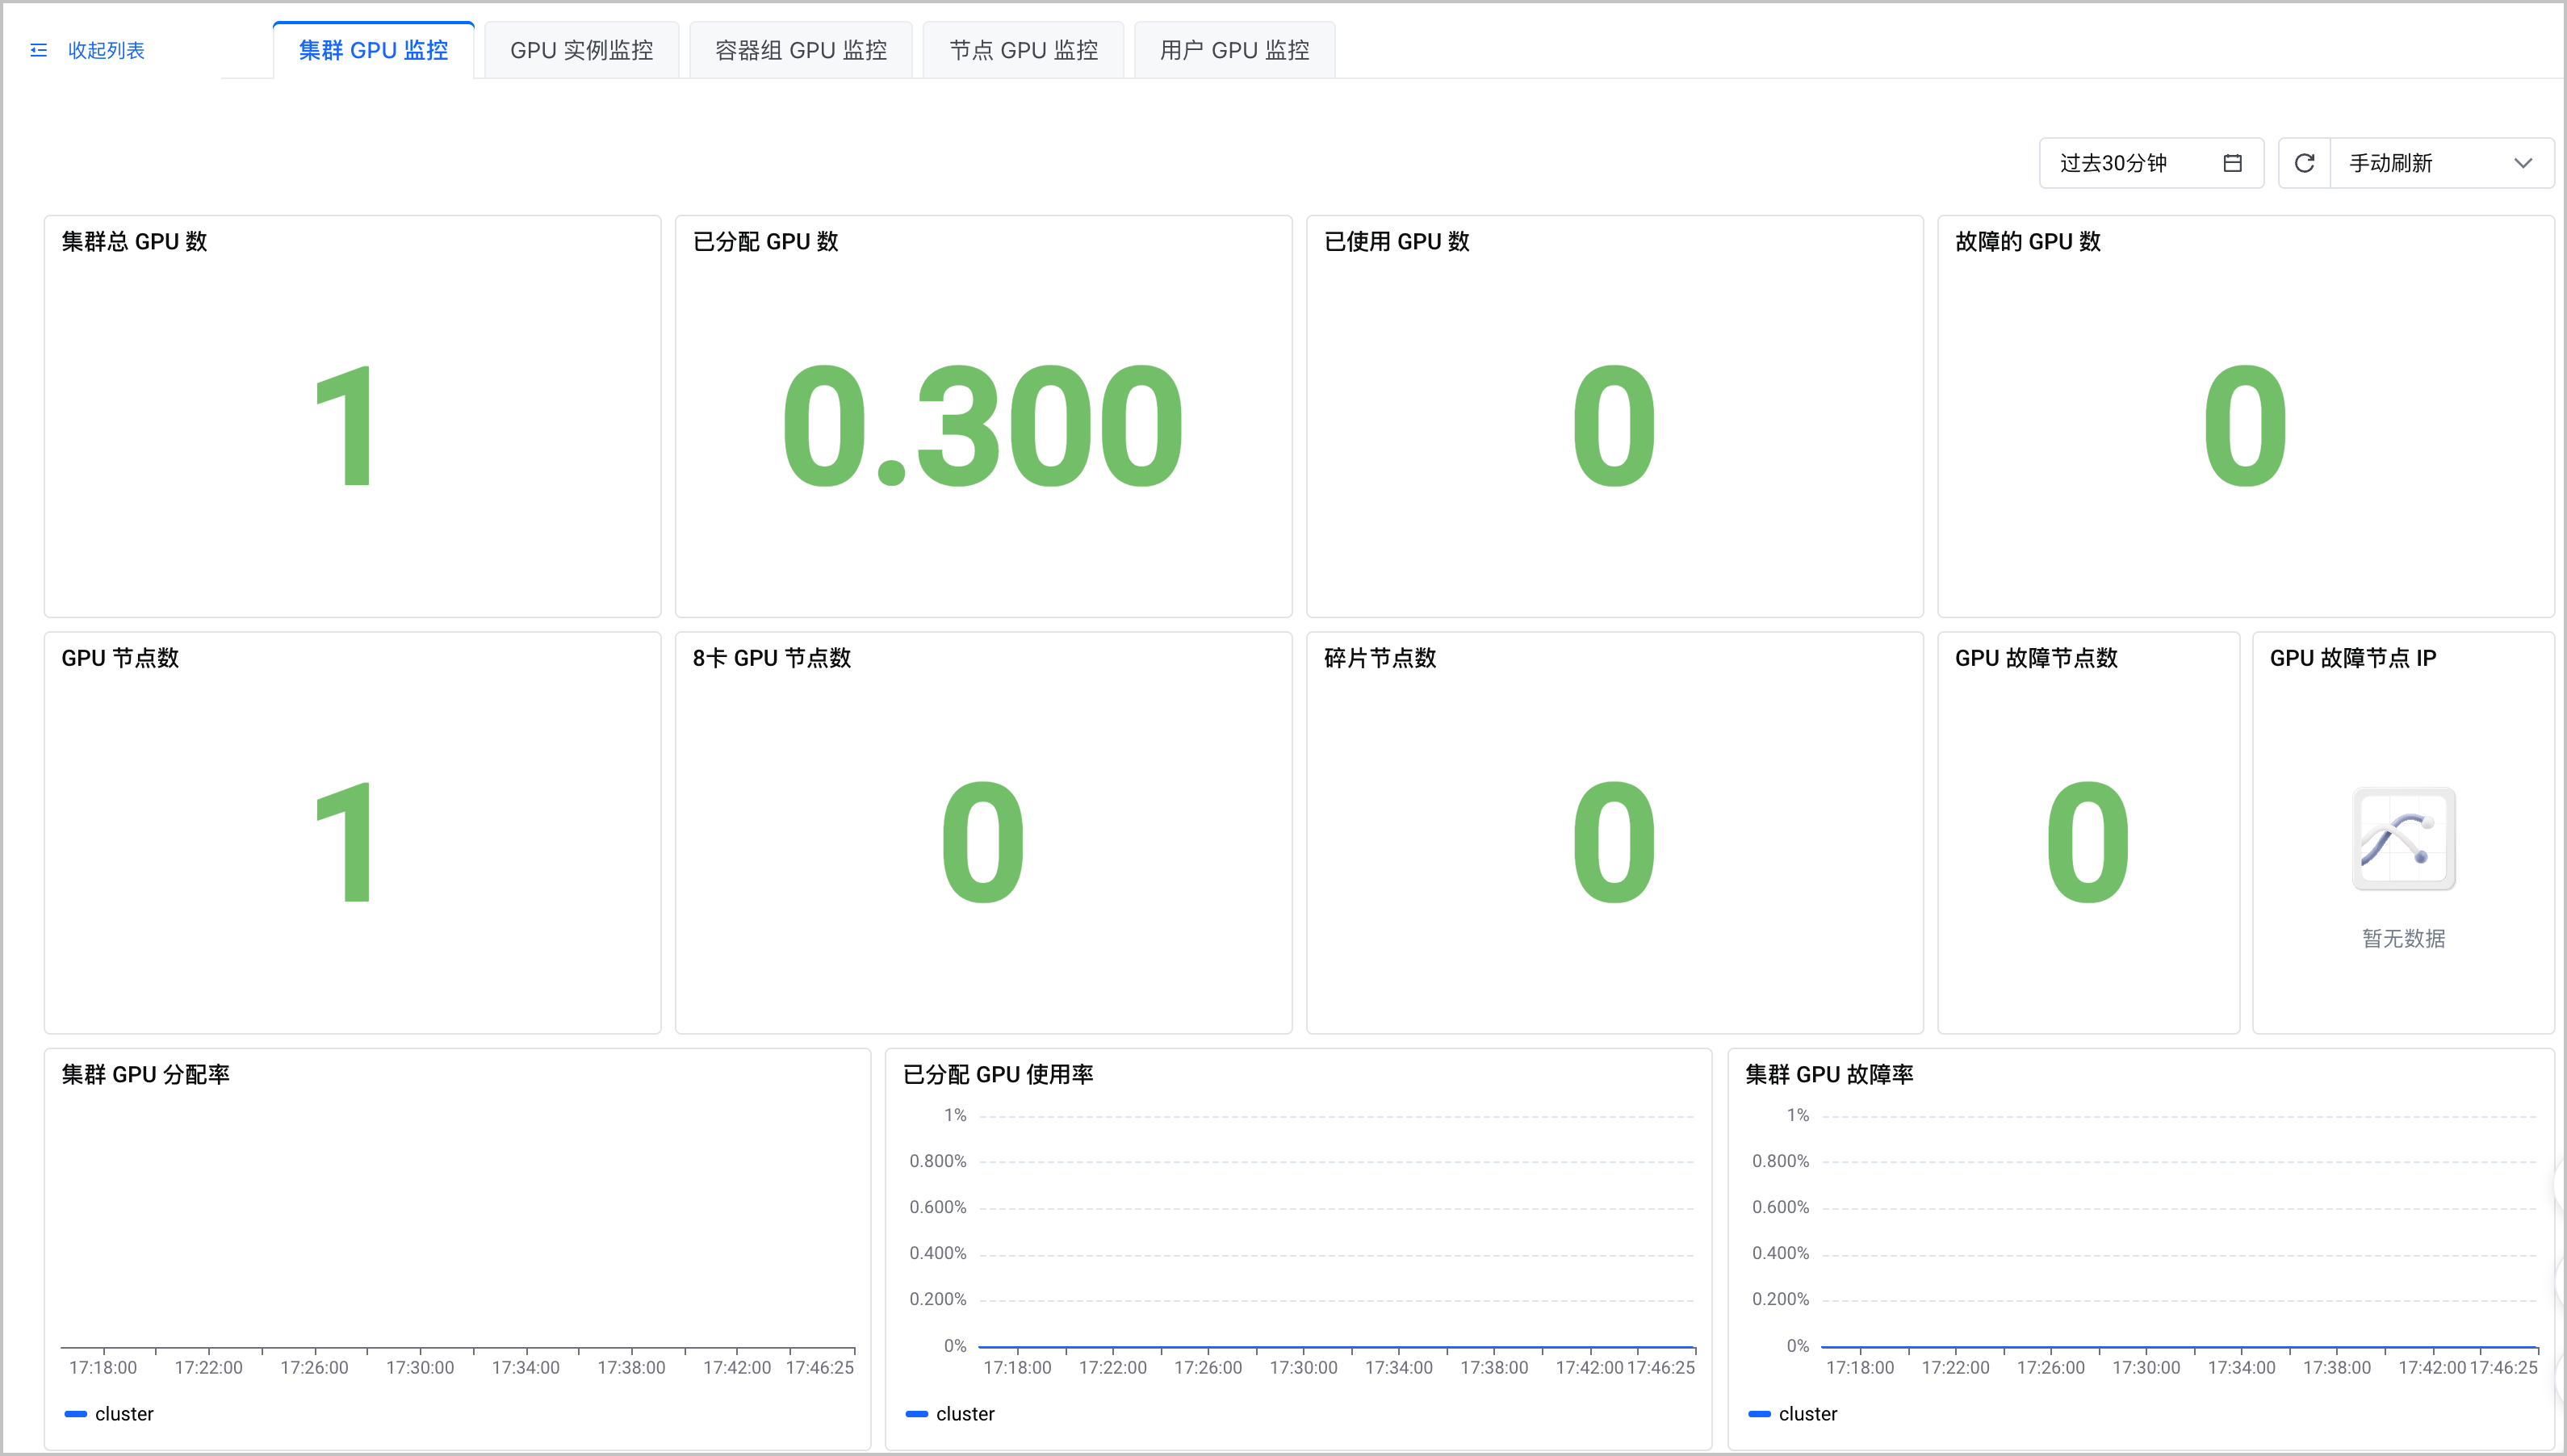
查看 mGPU 监控
最近更新时间:2026.07.07 19:29:03
这个页面对您有帮助吗?
有用
有用
无用
无用