容器服务
容器服务


文档指南

请输入


- 文档首页
 容器服务容器服务 VKE用户指南弹性伸缩工作负载弹性伸缩指标伸缩(HPA)使用 GPU 和网络指标实现弹性伸缩
 复制全文
 下载 pdf
使用 GPU 和网络指标实现弹性伸缩
 文档反馈
 问问助手
除 Kubernets 原生支持的 CPU 和内存指标外,容器服务还为您预置了 GPU 和网络指标映射规则,允许通过容器的 GPU 指标或网络指标实现弹性伸缩。本文介绍如何配置基于 GPU 或网络指标的弹性伸缩。
背景信息
基本概念
默认情况下,HPA (Horizontal Pod Autoscaler,水平 Pod 弹性伸缩)只支持基于 CPU 和内存的自动扩缩容,并不能满足复杂业务的诉求。在实际生产业务中,用户常常希望通过 Pod 的 GPU 负载或网络流量来触发扩容和缩容。
容器服务提供 prometheus-adapter 组件,支持将原生 Prometheus 指标转化成自定义指标 API 的格式,同时在组件中预置了 GPU 指标和网络指标的转化规则。当您在集群中开启 云原生观测 功能后,能够基于采集的容器 GPU 指标和网络指标,实现工作负载的自动扩缩容,使得业务负载可以更好地按需扩展,保证稳定性并平衡成本。
使用 GPU 和网络指标进行弹性伸缩,主要步骤如下:
- 在集群中安装 prometheus-adapter 组件。
- 配置 HPA,使用 GPU 或网络指标实现工作负载自动扩缩容。
指标说明
容器服务支持基于工作负载的 GPU 和网络指标实现弹性伸缩,预置指标如下表所示。
监控指标 | 指标名称 | 单位 |
GPU 使用率 | k8s_pod_rate_gpu_used | % |
GPU 显存使用率 | k8s_pod_rate_gpu_memory_used | % |
GPU 显存量 | k8s_pod_gpu_memory_used | MiB |
网络入吞吐率 | k8s_pod_network_receive_throughput | % |
网络出吞吐率 | k8s_pod_network_transmit_throughput | % |
说明
- 您可以在集群kube-system命名空间中,查看prometheus-adapter-config配置项,确认系统中的预置指标名称,以及该指标名称对应的 Prometheus 原始指标。
- 除系统预置的 GPU 和网络指标外,也支持基于自定义指标的弹性伸缩。详情请参见 使用自定义指标进行弹性伸缩。
使用限制
- HPA 配置多种指标时,会分别基于每种指标计算,并取最大值作为最终结果。
- 指标伸缩仅支持配置无状态负载(Deployment)、有状态负载(Statefulset)和自定义资源(CRD)。
- 使用 GPU 指标实现弹性伸缩时,目前仅支持普通 GPU Pod 的 HPA 能力,暂不支持 mGPU Pod。
前提条件
- 已开启云原生观测。详情请参见 开启观测。
- 使用 kubectl 连接目标集群。详情请参见 连接集群。
- 已安装 nvidia-device-plugin 组件,且 部署插件 必须勾选 安装 dcgm-exporter。详情请参见 nvidia-device-plugin。
- 已安装 prometheus-agent 组件,且 部署插件 必须勾选 安装 node-exporter。详情请参见 prometheus-agent。
- 已安装 prometheus-adapter 组件。详情请参见 prometheus-adapter。
通过控制台配置
- 登录 容器服务控制台。
- 单击左侧导航栏中的 集群。
- 在集群列表页面,单击需要配置的目标集群。
- 在集群管理页面的左侧导航栏中,选择 弹性伸缩 > 指标伸缩,单击 创建指标伸缩,配置指标伸缩。
- 基本信息
-
- 伸缩策略
-

-
- 伸缩规则
-

-
- 单击 确定,完成配置。
通过 kubectl 命令行配置
使用如下代码示例,创建与伸缩对象关联的 HPA,并指定按照 GPU 进行弹性伸缩。
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
name: gpu-hpa # 指标伸缩名称
spec:
scaleTargetRef:
apiVersion: apps/v1
kind: Deployment # 指标伸缩的对象类型,支持 Deployment、StatefulSet 和 CustomResourceDefinition
name: deployment-demo # 指定指标伸缩的具体对象实例
minReplicas: 1 # 配置 HPA 的最小实例数
maxReplicas: 10 # 配置 HPA 的最大实例数
metrics:
- type: Pods
pods:
metric:
name: k8s_pod_rate_gpu_used # 配置 HPA 的触发指标,本例中配置为 Pod 的 GPU 利用率
target:
averageValue: 20 # 当 GPU 利用率超过 20%,触发扩容
type: AverageValue
结果验证
查看配置
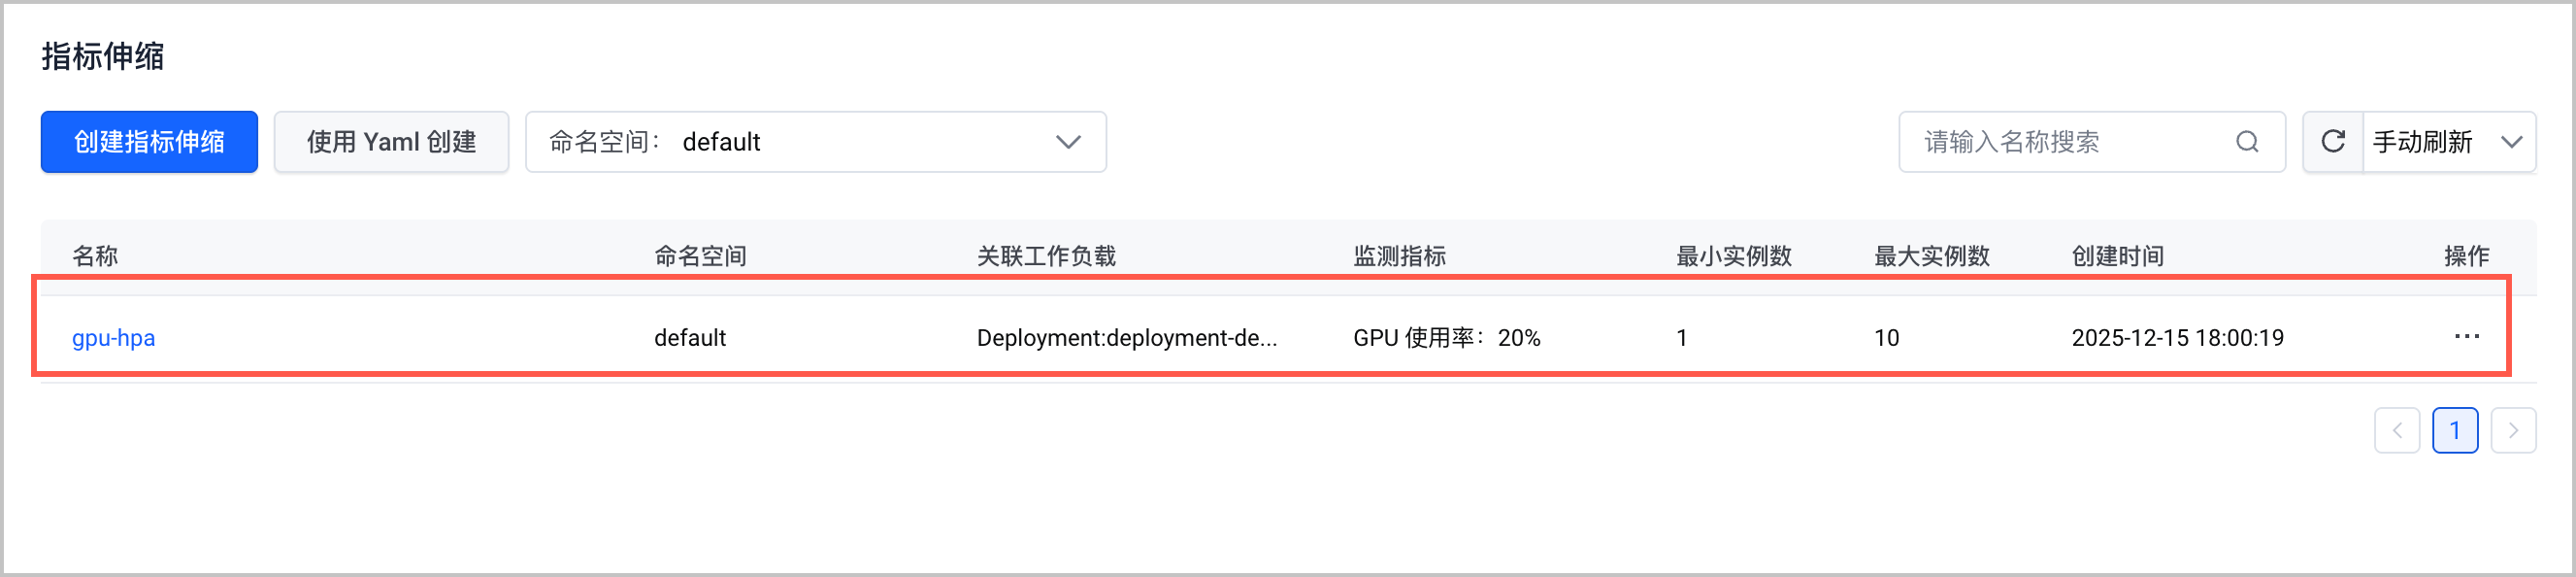
在集群管理页面的左侧导航栏中,选择 弹性伸缩 > 指标伸缩,查看已配置的弹性伸缩规则。
伸缩验证
- 当 Pod GPU 使用率增加后会触发扩容,此时可通过如下命令查看 HPA 信息。
- kubectl get hpa
- 预期返回结果如下,Deployment 的副本数扩容到 2。
- NAME REFERENCE TARGETS MINPODS MAXPODS REPLICAS AGEgpu-hpa Deployment/example-gpu-workload 23/20 1 10 2 62s
- 当 Pod GPU 使用率下降到指定值以下会触发缩容,此时可通过如下命令查看 HPA 信息。
- kubectl get hpa
- 预期返回结果如下,Deployment 的副本数缩容到 1。
- NAME REFERENCE TARGETS MINPODS MAXPODS REPLICAS AGEgpu-hpa Deployment/example-gpu-workload 0/20 1 10 1 15m
参考信息
您可参考官方文档,根据使用容器服务创建的集群 Kubernetes 版本,结合您自身业务使用弹性伸缩的期望,合理控制工作负载的弹性伸缩行为。
最近更新时间:2026.02.04 16:34:16
这个页面对您有帮助吗?
有用
有用
无用
无用