容器服务
容器服务


文档指南

请输入


- 文档首页
 容器服务容器服务 VKE用户指南网络域名解析(DNS)CoreDNS 最佳实践
 复制全文
 下载 pdf
CoreDNS 最佳实践
 文档反馈
 问问助手
CoreDNS 是 Kubernetes 集群中的默认 DNS 组件,负责集群内服务发现和域名解析。本文介绍 CoreDNS 的基础原理、关键配置方法,以及贴近生产环境的使用建议,尤其是客户端域名访问方式、NodeLocal DNS、CoreDNS 高可用部署,以及 IPVS 场景下的 DNS 超时风险说明。
DNS 原理和配置说明
集群 DNS 配置说明
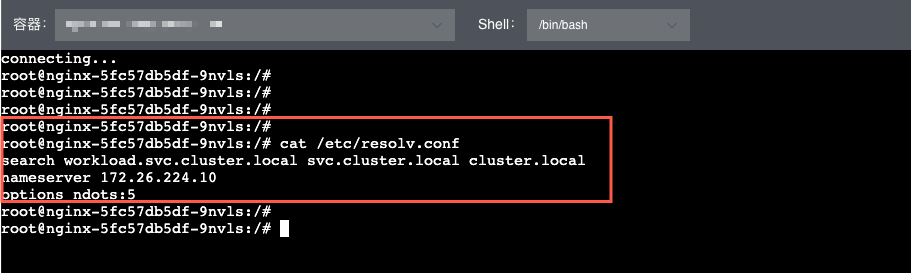
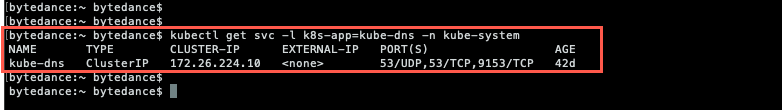
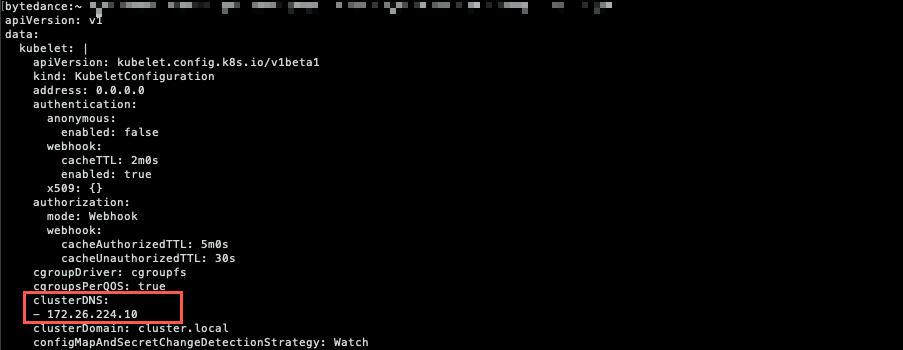
Kubernetes 集群中,DNS 配置相关的 kubelet 的启动参数包括:
- --cluster-dns=<dns-service-ip>:配置集群 DNS 服务器的 IP 地址。
- --cluster-domain=<default-local-domain>:配置集群主域名后缀。
Pod DNS 配置说明
Pod 内的 DNS 域名解析配置文件为 /etc/resolv.conf,Pod 会根据如下配置,进行域名的查询。
nameserver xx.xx.0.10 # 定义 DNS 服务器的 IP 地址
search <pod-namespace>.svc.cluster.local svc.cluster.local cluster.local
# 设置域名的查找后缀规则。查找配置越多,说明域名解析查找匹配次数越多。
# Kubernetes 集群通常包含 <pod-namespace>.svc.cluster.local、svc.cluster.local、cluster.local 3 个后缀,
# 最多可能进行 8 次查询才能得到正确解析结果。
options ndots:5
# 定义域名解析配置文件选项。
# 当访问的域名字符串中 "." 的数量大于等于 ndots 值时,客户端通常会先按绝对域名尝试解析;
# 如果不足 ndots 值,则通常会先追加 search 段中的后缀后再进行查询。
CoreDNS 配置说明
下面是一个典型的 Corefile 示例:
Corefile: |
.:53 {
errors # 错误信息输出到标准输出
log
health { # 健康检查配置
lameduck 15s # 关闭延迟时间
}
ready # 可读性检查,可通过 http://localhost:8181/ready 访问
kubernetes {{.ClusterDomain}} in-addr.arpa ip6.arpa { # 提供集群内服务解析能力
pods verified
fallthrough in-addr.arpa ip6.arpa
}
# 添加自定义 hosts
hosts {
192.168.11.241 www.testxx.com
192.168.11.240 harbor.testxx.com
fallthrough
}
prometheus :9153 # CoreDNS 自身 metrics 暴露端口
forward . /etc/resolv.conf { # 非 Kubernetes 域名请求转发到预定义解析器
max_concurrent 1000
}
cache 30 # DNS 查询缓存
loop # 环路检测,检测到环路时停止 CoreDNS
reload # 自动重载变更后的 Corefile;编辑 ConfigMap 后,通常需要等待两分钟生效
loadbalance # 循环 DNS 负载均衡,随机返回 A、AAAA、MX 记录顺序
}
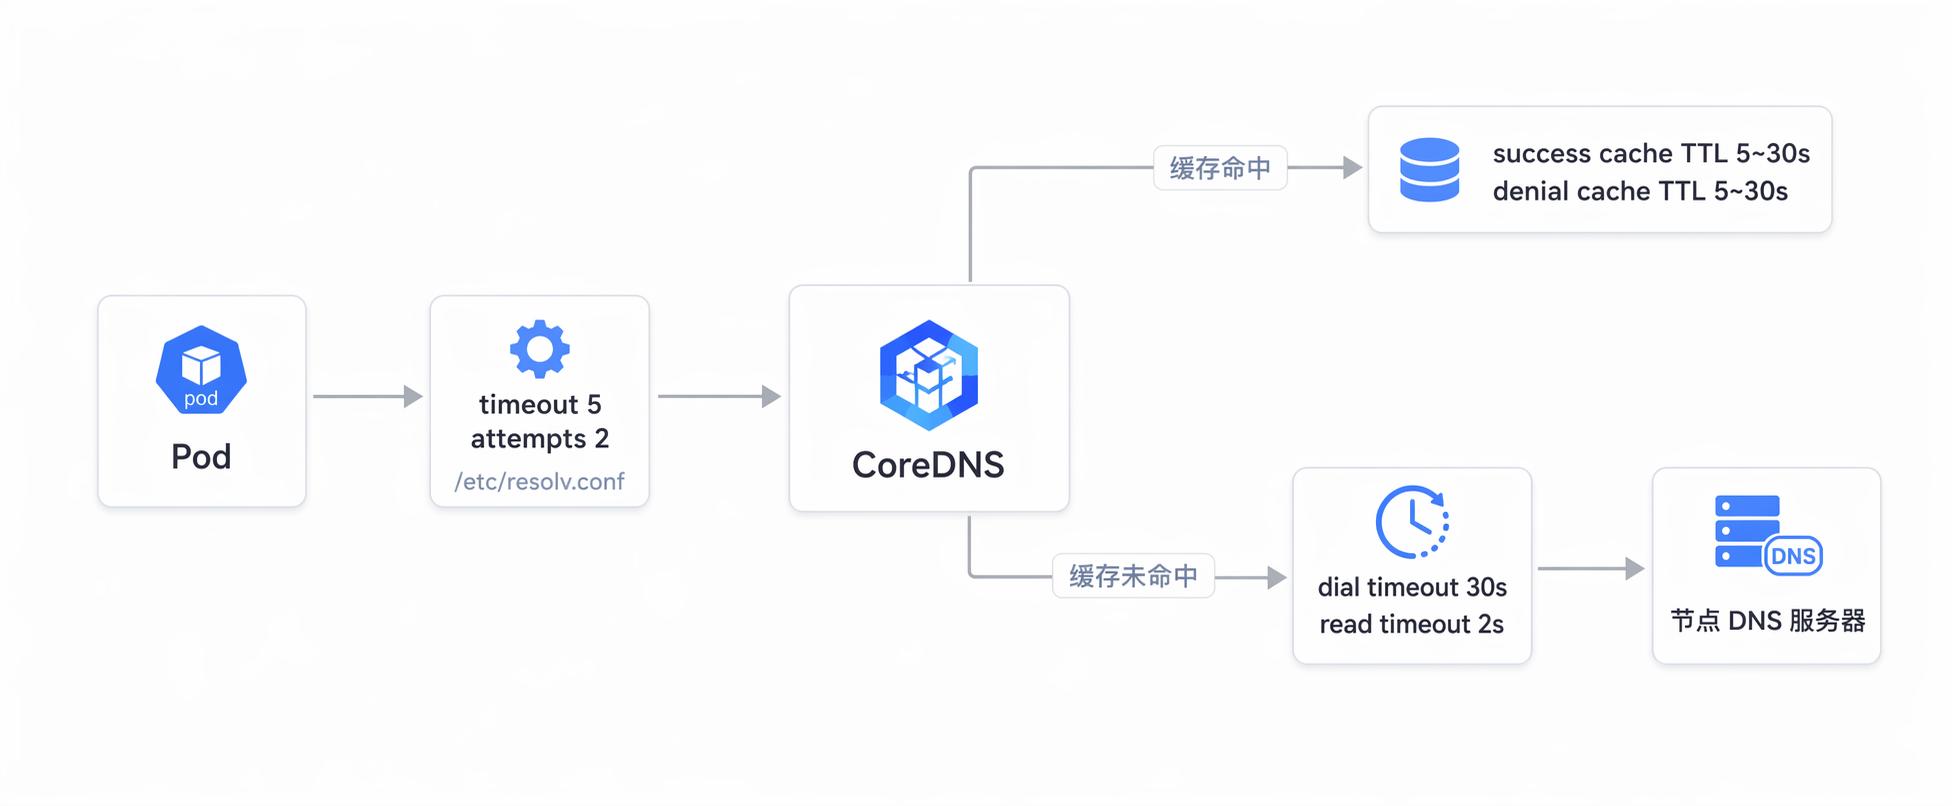
Pod DNS 请求解析流程
在 ClusterFirst 模式下,Pod 中的 DNS 请求解析流程,如下图所示。
客户端优化
优化域名写法,优先减少无效查询
DNS 查询是 Kubernetes 集群中最频繁的网络行为之一。很多 DNS 压力并不是 CoreDNS 本身性能不足,而是客户端请求方式不合理导致的。
- 同一命名空间内访问 Service 时,优先使用service-name。
- 跨命名空间访问 Service 时,优先使用service-name.namespace-name,避免依赖当前命名空间的隐式搜索规则。
- 访问集群外部域名时,优先使用完整域名。对于确认兼容的客户端,可使用带尾部 . 的 FQDN,例如api.example.com.,减少search拼接带来的多次无效查询。
关注 ndots / search 带来的放大效应
Kubernetes 默认ClusterFirst模式下通常会注入多个search后缀,并使用ndots:5。这意味着访问外部域名时,如果域名中.的数量不足 5,客户端通常会先拼接多个search后缀进行尝试,最后才查询真实域名。
例如访问api.example.com 时,往往会先尝试:
- api.example.com.<ns>.svc.cluster.local
- api.example.com.svc.cluster.local
- api.example.com.cluster.local
- api.example.com
在高并发场景下,这类额外查询会直接放大 CoreDNS 请求量和尾延迟。更稳妥的做法是:
- 优先调整业务侧域名写法,减少对search的依赖。
- 仅在明确评估影响后,再对特定工作负载通过dnsConfig局部调整ndots或search,避免集群级统一修改带来服务发现兼容性问题。
优先使用连接池和长连接
当应用需要频繁访问上游服务时,建议优先使用连接池、HTTP Keep-Alive、gRPC 长连接等机制,避免每次请求都触发新的域名解析和建连开销。
对于无法使用长连接的场景,再考虑通过本地缓存或其他方式降低 DNS 请求频率,而不是单纯依赖 CoreDNS 承接所有瞬时流量。
关注不同 Resolver 与基础镜像差异
不同语言运行时、基础镜像和 libc 实现的 DNS 解析行为并不完全一致,生产环境中需要特别关注以下差异:
- 基于glibc的容器通常遵循/etc/resolv.conf中的大部分配置。
- 基于musl的镜像(如部分 Alpine 镜像)在 search、并发请求多个 nameserver、A/AAAA 查询行为等方面与 glibc 存在差异,可能放大 DNS 请求量,或削弱 NodeLocal DNS 的收益。
- Go 应用还存在 pure Go resolver 与 cgo resolver 的差异,实际行为受镜像、构建方式和运行时环境影响。
因此,若业务对 DNS 延迟敏感,建议在压测或灰度环境中先验证所用镜像和语言运行时的 Resolver 行为,再决定是否需要更换基础镜像、调整dnsConfig或引入 NodeLocal DNS。
使用 NodeLocal DNS 提升稳定性
NodeLocal DNS 适合以下场景:
- 集群规模较大,DNS QPS 持续偏高。
- 外部域名访问较多,search扩展导致的无效查询明显。
- 节点侧存在较高的 UDP/conntrack 压力。
- 集群使用 IPVS,需要降低 CoreDNS 重启、滚动升级或缩容期间的 DNS 抖动风险。
启用后,Pod 会优先访问节点本地缓存,再回源到 CoreDNS。这样可以降低跨节点访问 CoreDNS 的开销,减少 CoreDNS 集中承压,并缓解部分 conntrack 压力。
落地时建议注意:
- 确认业务 Pod 实际注入后的nameserver已指向 NodeLocal DNS 地址。
- 先在高流量或对 DNS 敏感的业务上灰度启用,再扩大范围。
- NodeLocal DNS 是缓存与代理层,不是 CoreDNS 的替代品;CoreDNS 本身仍需保持健康和冗余。
避免 IPVS 缺陷导致 DNS 概率性解析超时
当集群使用 IPVS 作为kube-proxy转发模式时,CoreDNS 缩容、重启或滚动升级期间,DNS 请求可能因为 UDP 会话仍然命中已经退出的后端而出现概率性解析超时。
这类问题通常在 CoreDNS 后端集合变化时更明显,常见触发场景包括:
- CoreDNS 副本缩容;
- CoreDNS Pod 重启或滚动发布;
- 业务流量仍通过 Service 直接访问 CoreDNS。
更稳妥的处理方式是:
- 优先启用 NodeLocal DNS,减少业务 Pod 直接经过 CoreDNS Service 的请求比例;
- 结合集群运维规范,评估是否需要调整kube-proxy中 IPVS UDP 会话保持超时时间。
CoreDNS 服务端优化
合理调整 CoreDNS 副本数
CoreDNS 所能提供的域名解析 QPS 与 CPU 消耗成正相关,不同类型的业务对 CoreDNS 请求的 QPS 需求存在差异,所以对 CoreDNS 需要加强监控。根据 CoreDNS 负载和健康情况调整 CoreDNS 副本数。生产环境建议至少保持 2 个副本,并为业务高峰和发布期预留余量,避免在 CPU 刚达到阈值时才被动扩容。
注意
建议保持 CoreDNS 实例 UDP 请求 QPS 在 3K QPS 以下,避免触发 UDP buffer 溢出丢包问题。
手动调整 CoreDNS 副本数
执行以下命令,手动调整集群中的 CoreDNS 副本数,其中${target}为目标副本数。
kubectl scale --replicas=${target} deployment/coredns -n kube-system
谨慎使用 HPA 自动调整 CoreDNS 副本数
不建议将 HPA 作为 CoreDNS 副本调整的默认方案。CoreDNS 与普通无状态业务不同,仅根据 CPU 使用率做自动扩缩容,容易忽略以下风险:
- DNS 压力并不总是与 CPU 线性对应,请求模式、缓存命中率、上游解析质量都会影响实际表现。
- 扩容后的新副本需要经历缓存预热,短时间内不一定立即改善尾延迟。
- 缩容、重启或滚动发布会改变后端集合,在 IPVS + UDP 场景下可能放大概率性解析超时。
更稳妥的方式是:
- 基于监控结果手动扩容,并保留安全余量。
- 先优化客户端请求模式和连接复用,减少无效 DNS 查询。
- 在高 QPS 或高抖动场景下,建议优先评估是否适合启用 NodeLocal DNS,以减少直接打到 CoreDNS Service 的请求;如果 CoreDNS 仍存在明显容量瓶颈,再结合监控结果扩容 CoreDNS。
CoreDNS 高可用部署建议
除副本数外,还建议从以下几个方面保证 CoreDNS 高可用:
- 副本数不少于 2,并根据集群规模和峰值 QPS 保留冗余。
- 为 CoreDNS 设置稳定的 CPU、内存请求与限制,避免与业务 Pod 争抢资源。
- 尽量将 CoreDNS 副本分散到不同节点,条件允许时分散到不同可用区,避免单节点或单可用区故障影响全部 DNS 能力。
- 保持ready、health、lameduck等配置可用,保证滚动变更期间新旧副本切换更平滑。
CoreDNS 服务观测
建议使用容器服务提供的 DNS 服务观测能力配置监控和告警。该能力同时覆盖以下观测对象:
- core-dns:负责集群服务发现和域名解析。
- node-local-dns:负责节点本地 DNS 缓存和代理。
日常应重点关注请求量、解析延迟、错误码、缓存命中情况以及上游转发健康度等信号。
除 DNS 组件自身指标外,建议同时开启 node-exporter 的 conntrack 相关指标采集并配置告警,用于提前识别节点 conntrack 使用率过高或接近打满的风险。原因是节点 conntrack 表满不仅会影响业务 Pod 的 DNS 请求转发,也可能连带影响 CoreDNS 所在节点上的健康检查和网络连通性,最终放大为 DNS 解析超时或失败。
采集 CoreDNS 日志
日常排查 CoreDNS 问题时,分析 CoreDNS 解析日志是有效的方法,下面介绍在容器服务集群中,如何收集 CoreDNS 日志。
修改日志级别
排查 DNS 解析问题时,可以临时在 kube-system 命名空间下 coredns ConfigMap 的Corefile中增加 log 插件,用于输出 CoreDNS 查询日志:
Corefile: |
.:53 {
errors # 错误信息输出到标准输出
log # 临时输出 DNS 查询日志,排查结束后建议移除
reload # 允许自动重新加载已更改的 Corefile。编辑 ConfigMap 配置后,请等待两分钟以使更改生效
...
}
说明
log会为 DNS 请求输出访问日志。在高 QPS 集群中,长期开启会增加 CoreDNS CPU、标准输出写入、日志采集链路和日志存储成本。建议仅在故障排查窗口内短期开启,排查结束后及时从Corefile中移除,并等待reload自动生效或按集群变更流程滚动重启 CoreDNS。
配置日志采集
最近更新时间:2026.08.26 14:08:52
这个页面对您有帮助吗?
有用
有用
无用
无用