You need to enable JavaScript to run this app.
文档中心
容器服务

容器服务

复制全文
下载 pdf
其他观测
AI 资源观测
复制全文
下载 pdf
AI 资源观测
容器服务支持监控集群的 AI 资源,即 GPU 资源、RDMA 资源的状态。本文为您介绍如何配置 AI 资源观测。
使用限制
  • 当前 RDMA 指标采集仅支持 NVIDIA GPU 模式,不支持 mGPU 模式。
  • 共享(shared)模式下,仅上报节点的 RDMA 指标。
  • 独占(exclusive)模式下,仅上报 Pod 的 RDMA 指标。
前提条件
  • 已开启云原生观测,详情请参见 开启观测
  • 已安装对应的组件,包括:
  • GPU 观测:已安装 nvidia-device-plugin 组件,并同步安装了 dcgm-exporter 插件,详情请参见 nvidia-device-plugin
  • mGPU 观测:已安装 mgpu 组件,并同步安装了 mgpu-exporter 插件,详情请参见 mgpu
  • RDMA 观测:已安装 rdma-device-plugin 组件,详情请参见 rdma-device-plugin
  • prometheus-agent 组件已经升级到 v2.2.0 及以上版本。详情请参见 组件发布记录
操作步骤
步骤一:开启观测
  1. 在左侧导航栏单击 集群,找到目标集群,单击集群名称。
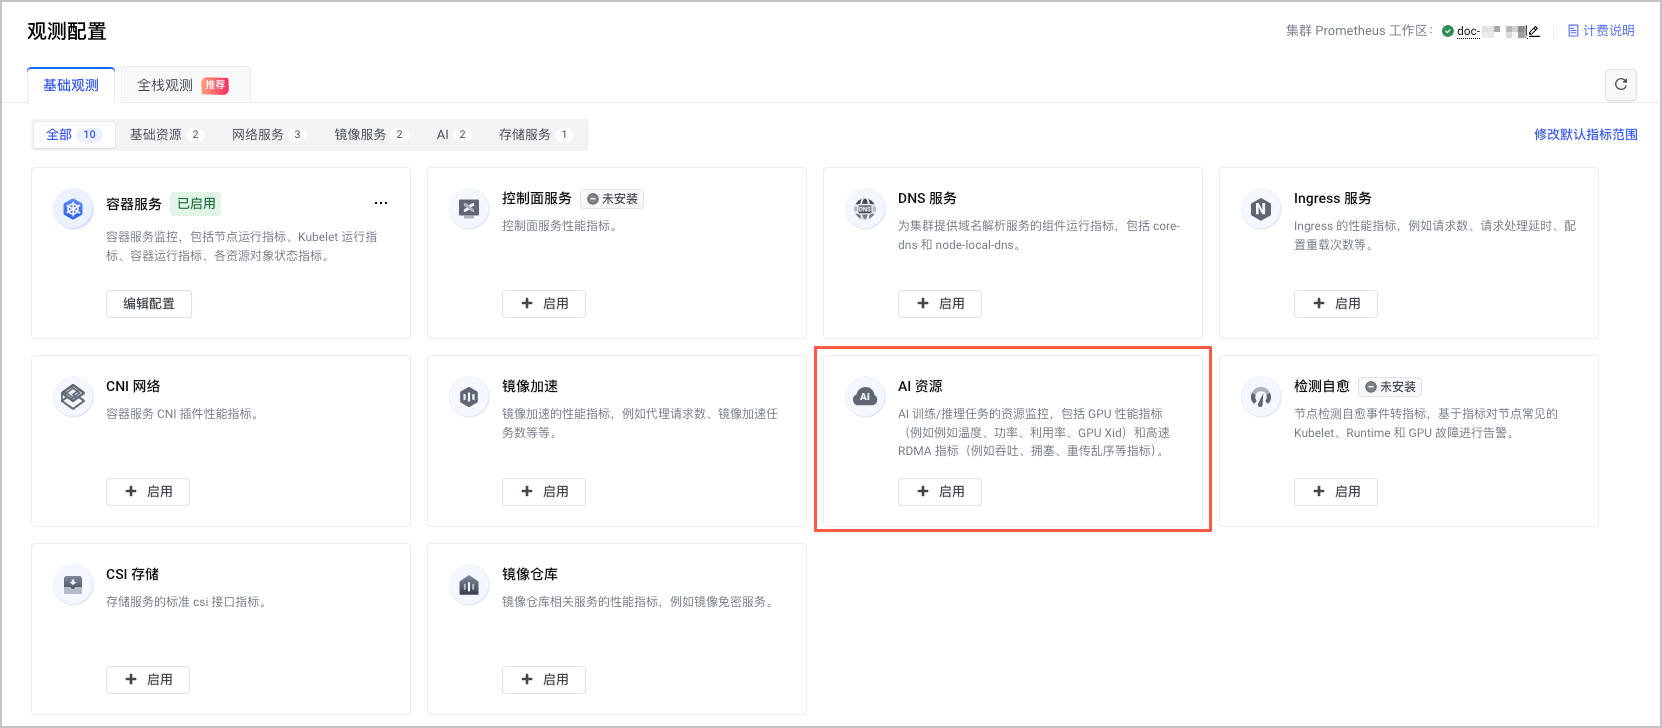
  1. 在集群管理页面的左侧导航栏中,单击 观测配置,并选择 基础观测 页签。
  1. 选择 AI 资源 卡片,单击 启用,开启集群 AI 资源观测。
  • alt
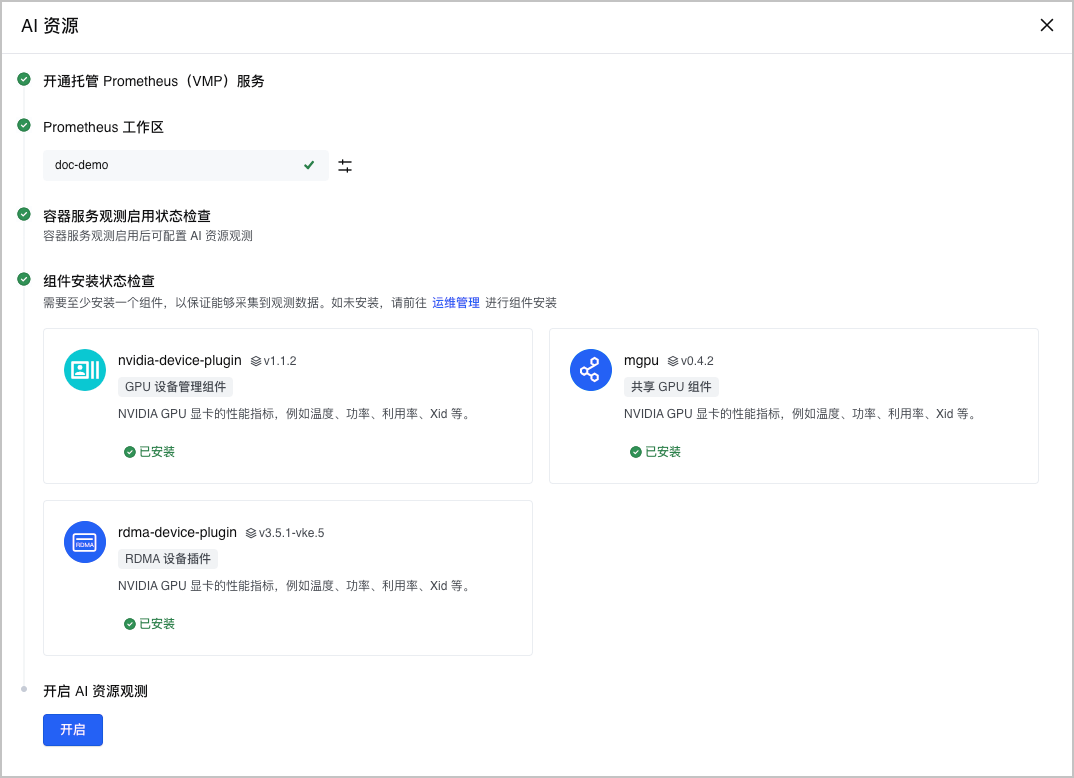
  1. 系统自动检查开启观测所需的必要条件。包括:工作区配置、组件状态等。
  • alt
  1. 单击 开启,开启 AI 资源观测。
步骤二:配置采集规则
观测功能开启后,您可以配置采集规则,选择需要采集的目标组件、具体指标项及采集间隔。可以根据实际需求丢弃一些不用的指标。
  1. 在集群管理页面的左侧导航栏中,单击 观测配置,并选择 基础观测 页签。
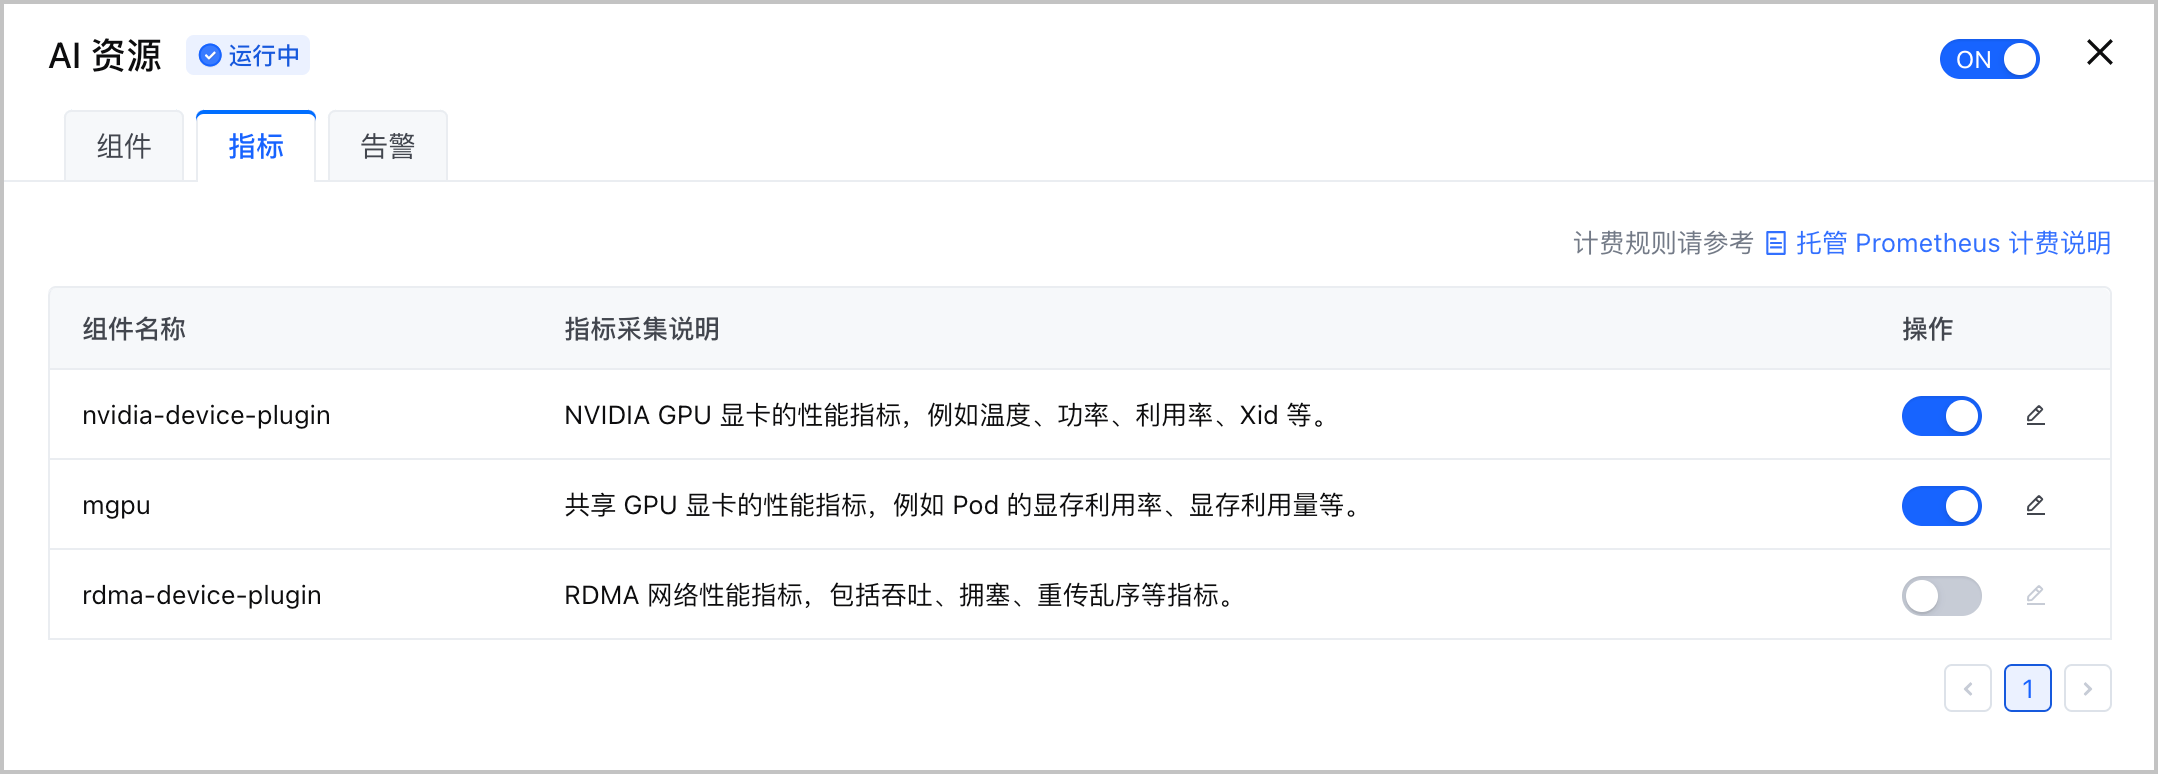
  1. 选择 AI 资源 卡片,单击 编辑配置 并选择 指标 页签,配置采集规则,并选择具体的采集指标。
  • 在组件列表 操作 列,单击开关,开启或关闭组件的采集规则。当关闭组件的采集规则时,系统不会采集该集组件的所有指标。
  • alt
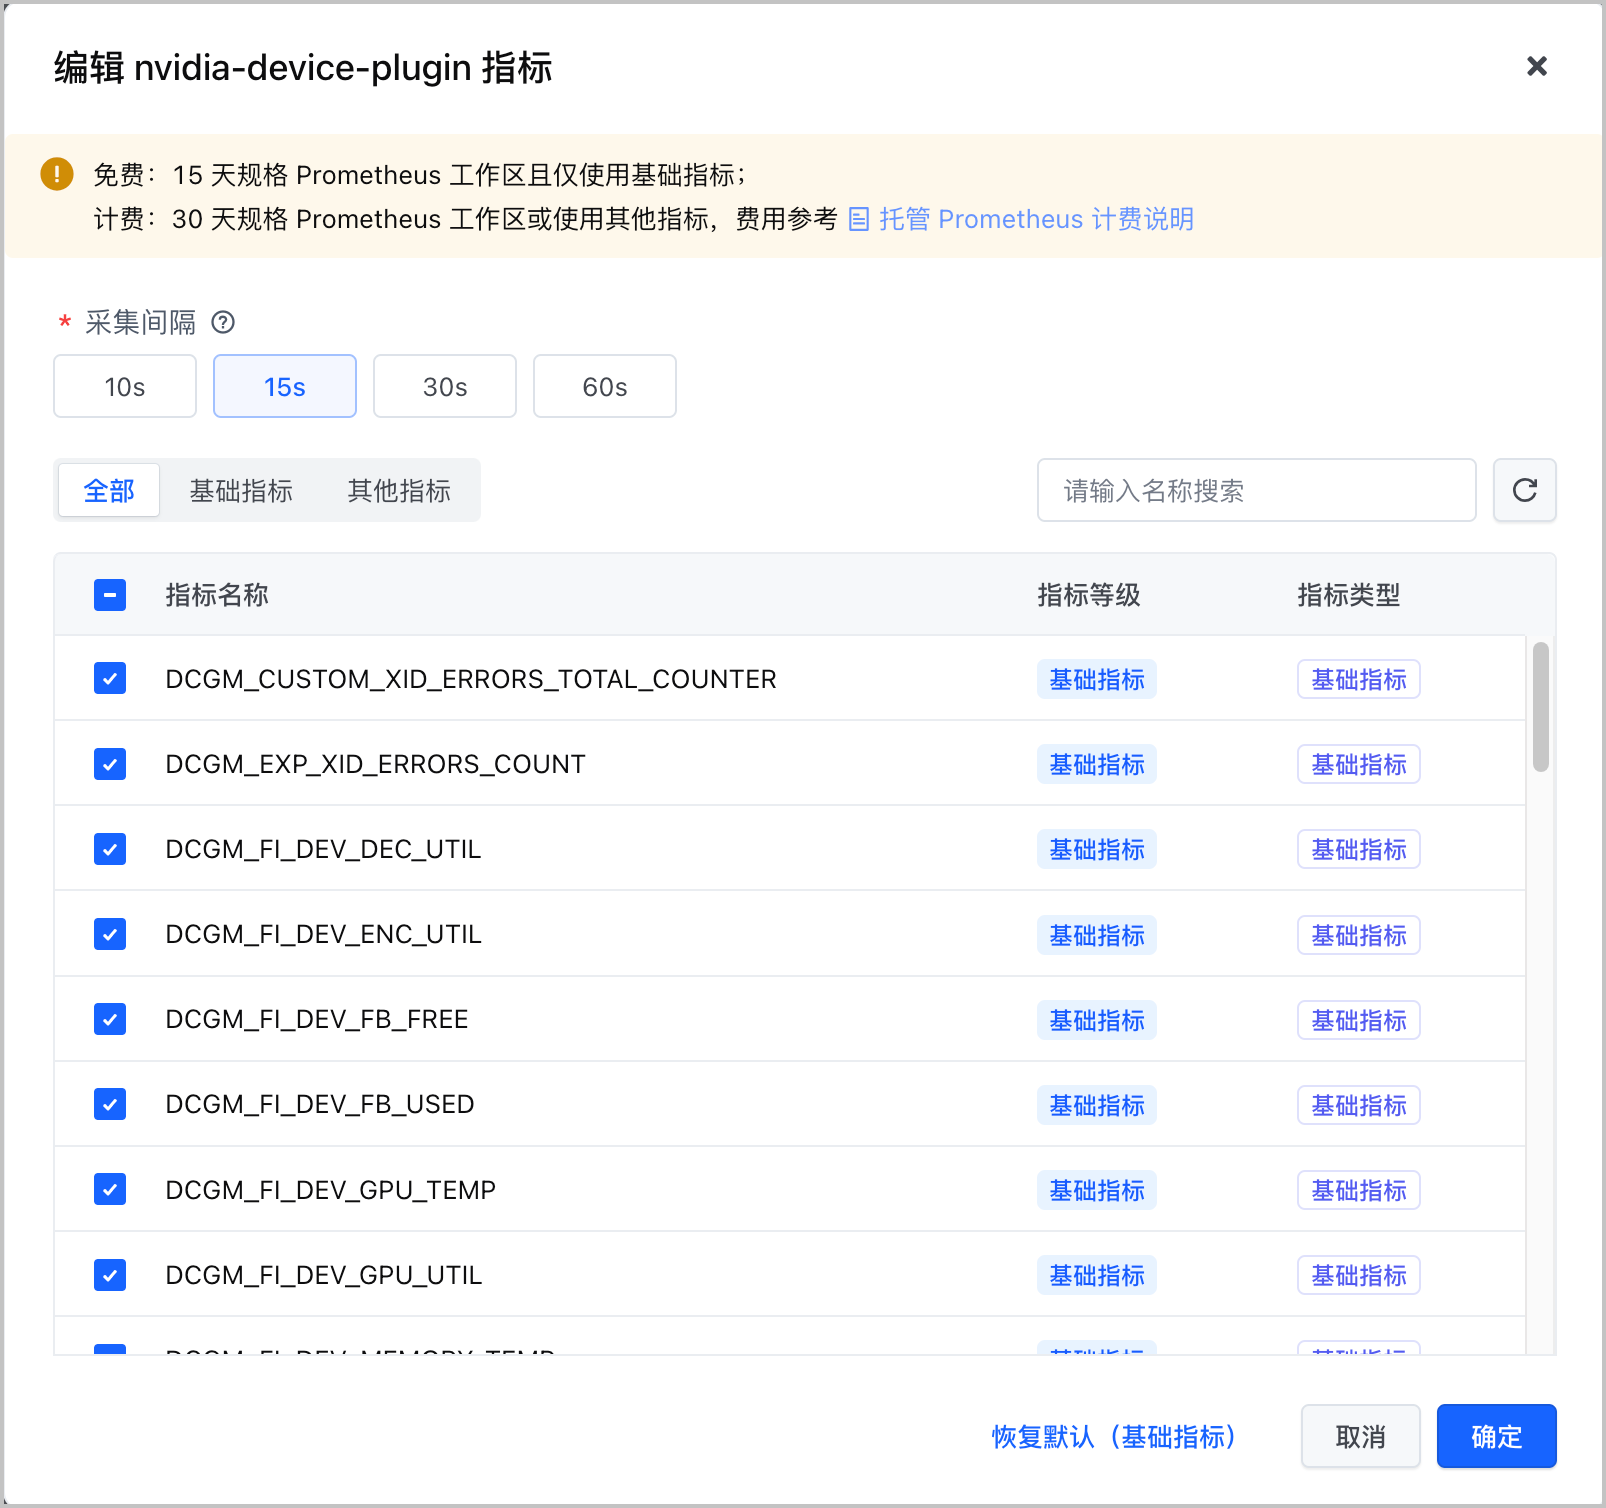
  • 单击组件列表 操作 栏中的 alt,支持选择或丢弃组件的具体指标、面向该组件的采集间隔和指标 Relabel。
  • 采集间隔 中,选择该组件指标的采集间隔。不同组件支持的采集间隔不同。
  • 指标列表 中,勾选指标,则采集该指标。取消勾选,则丢弃该指标。单击 全部基础指标其他指标 页签,允许基于指标类型对指标项进行筛选。
  • alt
说明
  • 减小指标采集间隔,会增加单位时间内上报的指标数量,可以提升监控精度。但会增加托管 Prometheus 工作区的费用。增加指标采集间隔,会减少单位时间内上报的指标数量,可以减少托管 Prometheus 工作区的费用,但会降低监控精度。请根据实际需要配置。
  • 云产品的指标类型分为 基础指标其他指标,不同类型指标的计费方式不同,详情请参见 托管 Prometheus 计费方式
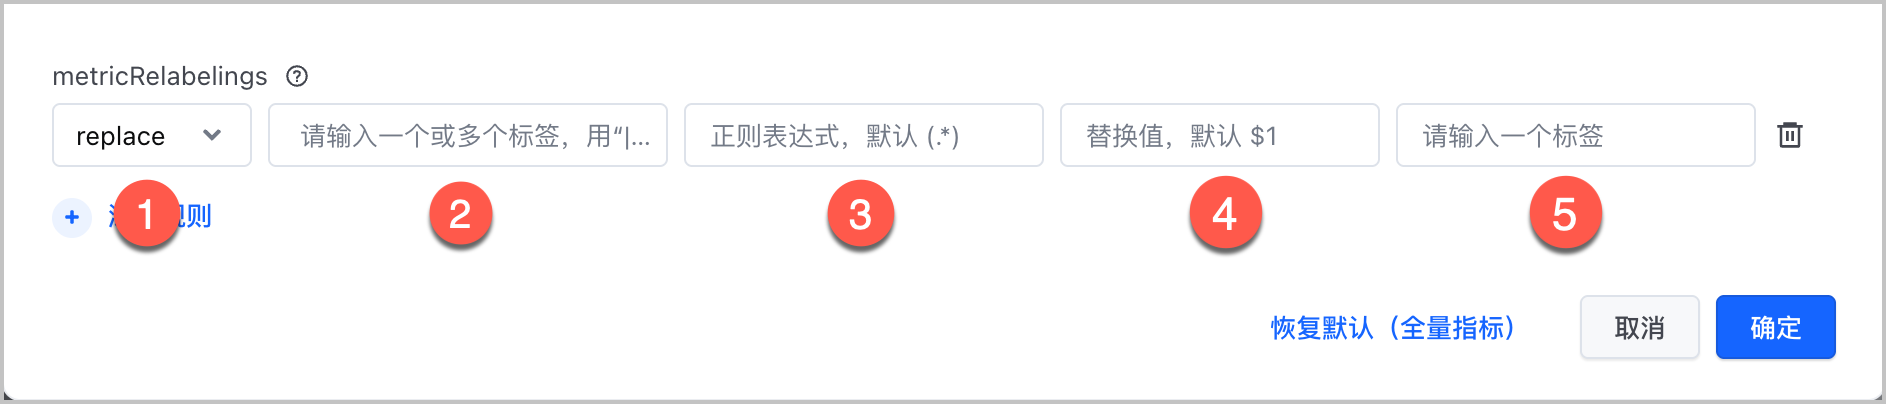
  • metricRelabelings 中,单击 添加规则,配置指标 Relabel 规则。允许在指标完成采集后、写入存储前,对每条指标的标签执行改写操作。常见用途包括修改标签值、新增标签或重命名标签,便于在查询时统一标签口径。更多详情介绍,请参见 指标 Relabel
  • 序号
    功能
    对应 YAML 字段
    说明
    操作类型
    action
    对指标执行的操作类型,当前仅支持 replace,字面意思为“替换”,实际生效逻辑如下:
    • 如果target_labelsource_labels的值一致,则表示覆盖source_label
    • 如果target_label定义的 key 不存在,则会默认创建新的 label。
    源标签
    sourceLabels
    指定一个或多个来源标签,多个标签之间用|分隔。系统将读取这些标签的值进行匹配或提取。
    正则表达式
    regex
    用于匹配源标签值的正则表达式。
    • 默认为(.*),表示匹配任意值。
    • 支持使用捕获组,如(.+)提取部分内容。
    替换值
    replacement
    匹配成功后写入目标标签的值。
    • 默认为$1,表示取正则第一个捕获组的内容。
    • 支持填入固定字符串。
    目标标签
    targetLabel
    将处理结果写入的目标标签名称。
    • 若目标标签已存在,则覆盖其原有值。
    • 若目标标签不存在,则新增该标签。
  1. 单击 确定,完成配置。
步骤三:配置告警
您可以基于预置的告警模板,快速完成 AI 资源观测的告警配置。
  1. 在集群管理页面的左侧导航栏中,单击 观测配置,并选择 基础观测 页签。
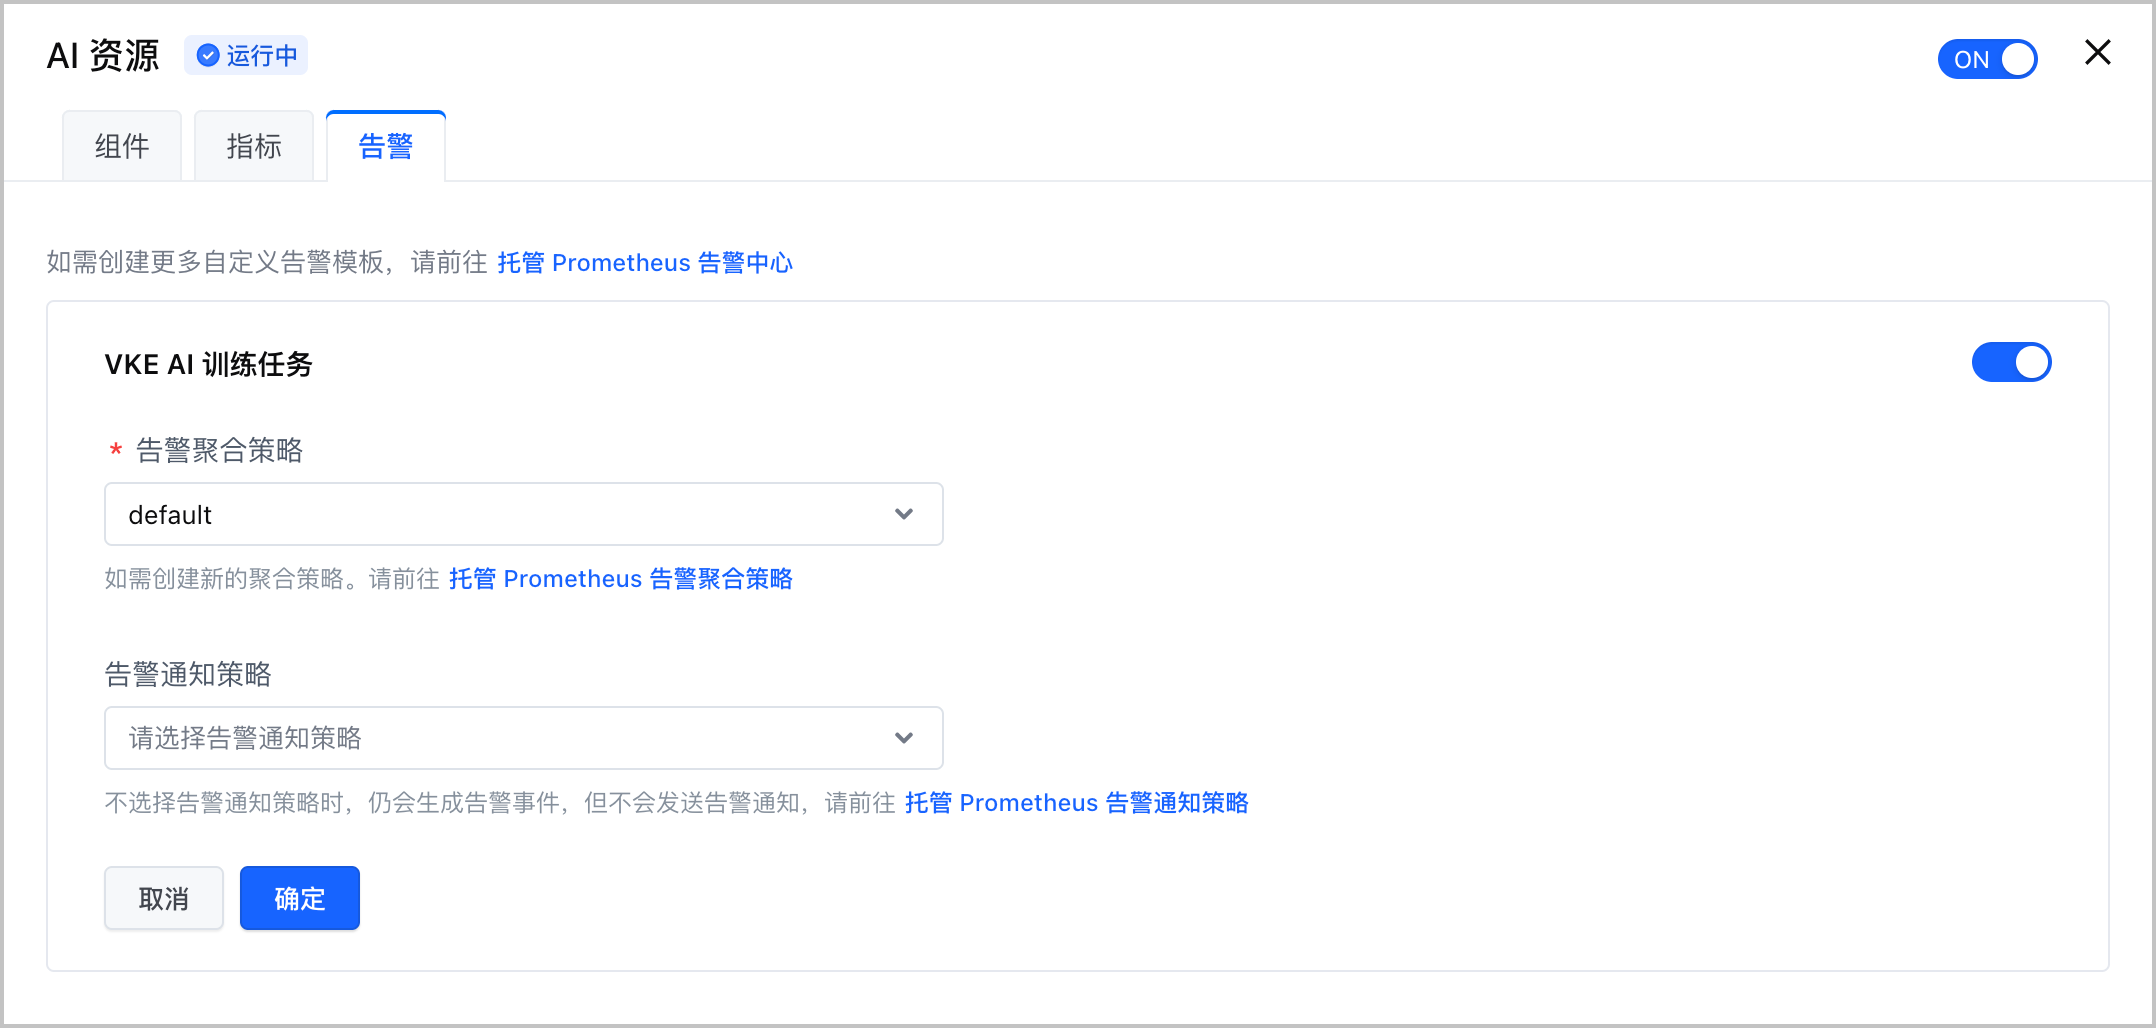
  1. 选择 AI 资源 卡片,单击 编辑配置 并选择 告警 页签,配置告警的相关参数。
  • alt
  • 配置项
    说明
    告警模板
    单击开启需要的告警模板,允许多选。
    告警聚合策略
    在下拉菜单中选择告警聚合策略。详情请参见 创建告警聚合策略
    告警通知策略
    在下拉菜单中选择告警通知策略。系统会使用通知策略中配置的告警等级和联系人组,将告警发送给指定的联系人。详情请参见 创建告警通知策略
说明
  • 除了直接使用预置告警模板配置告警规则,您可以自定义模板中的配置,或直接使用 PromQL 语句配置告警规则。详情请参见 告警配置概述
  • 预置告警规则模板的详情,包括规则说明、PromQL 配置和常见告警处理流程。请参见 预置告警模板
  1. 单击 确定,完成配置。
观测看板
说明
预置看板中为您提供监控数据同比对照、复制看板语句等功能,详情请参见 使用看板
集群 GPU 监控
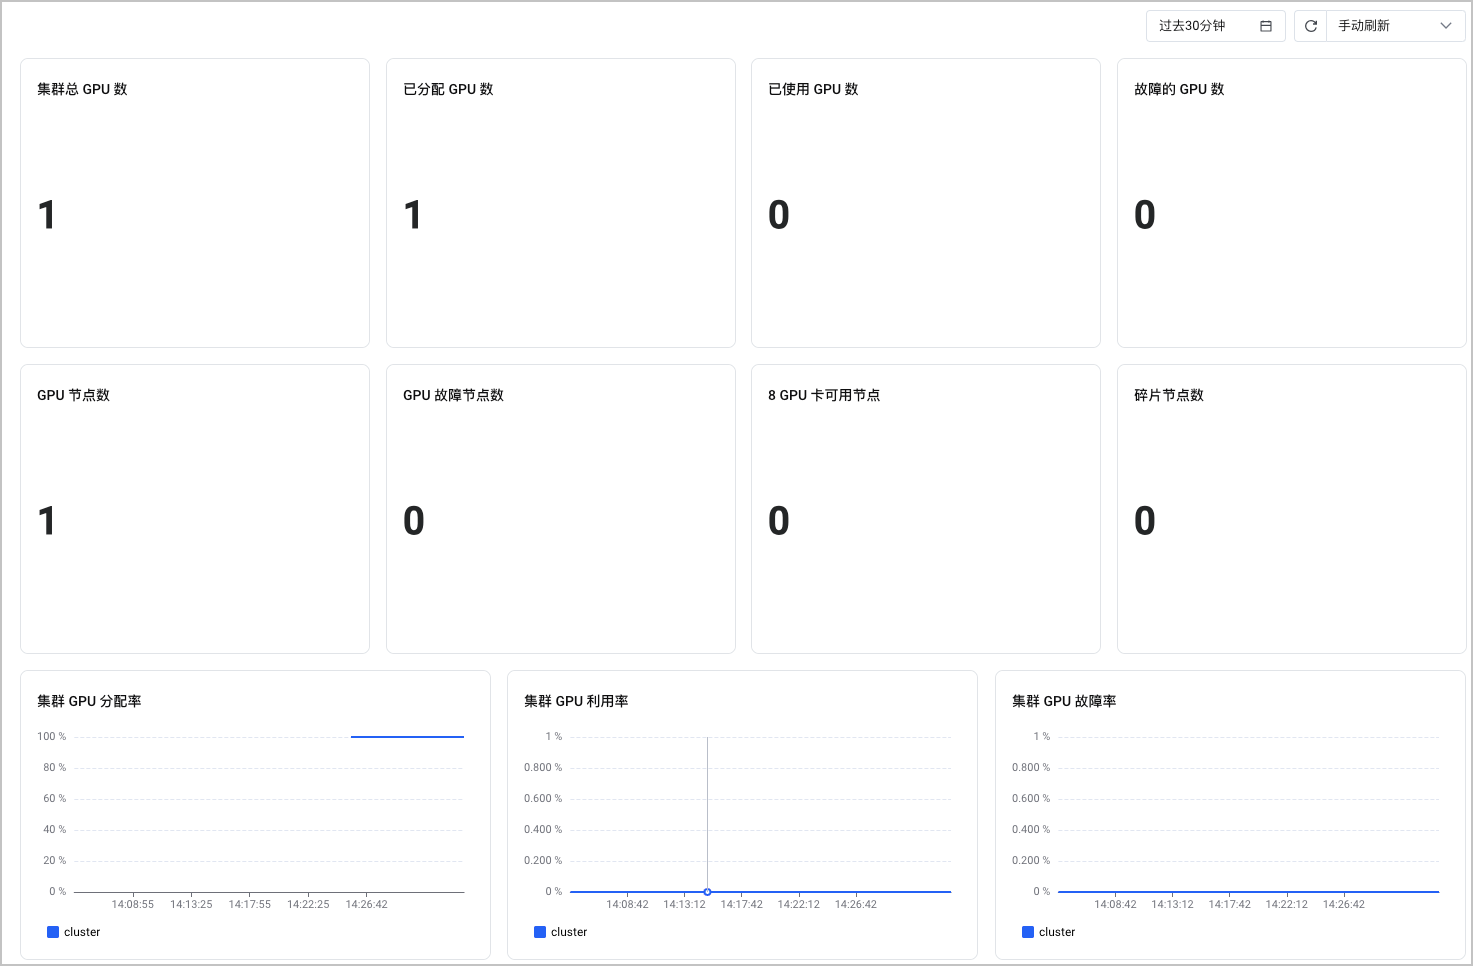
集群 GPU 监控看板展示了集群维度的 GPU 监控信息,包括:集群总 GPU 数、已分配 GPU 数、已使用 GPU 数等。您可以从该看板中了解整个集群的 GPU 监控信息。支持设置查询的时间段,并指定刷新方式(手动刷新、自动刷新)。
  1. 在集群管理页面的左侧导航栏中,选择 监控中心 > 监控看板
  1. 在左侧看板列表中选择 GPU 监控 > 集群 GPU 监控,即可查看监控看板。
alt
GPU 实例监控
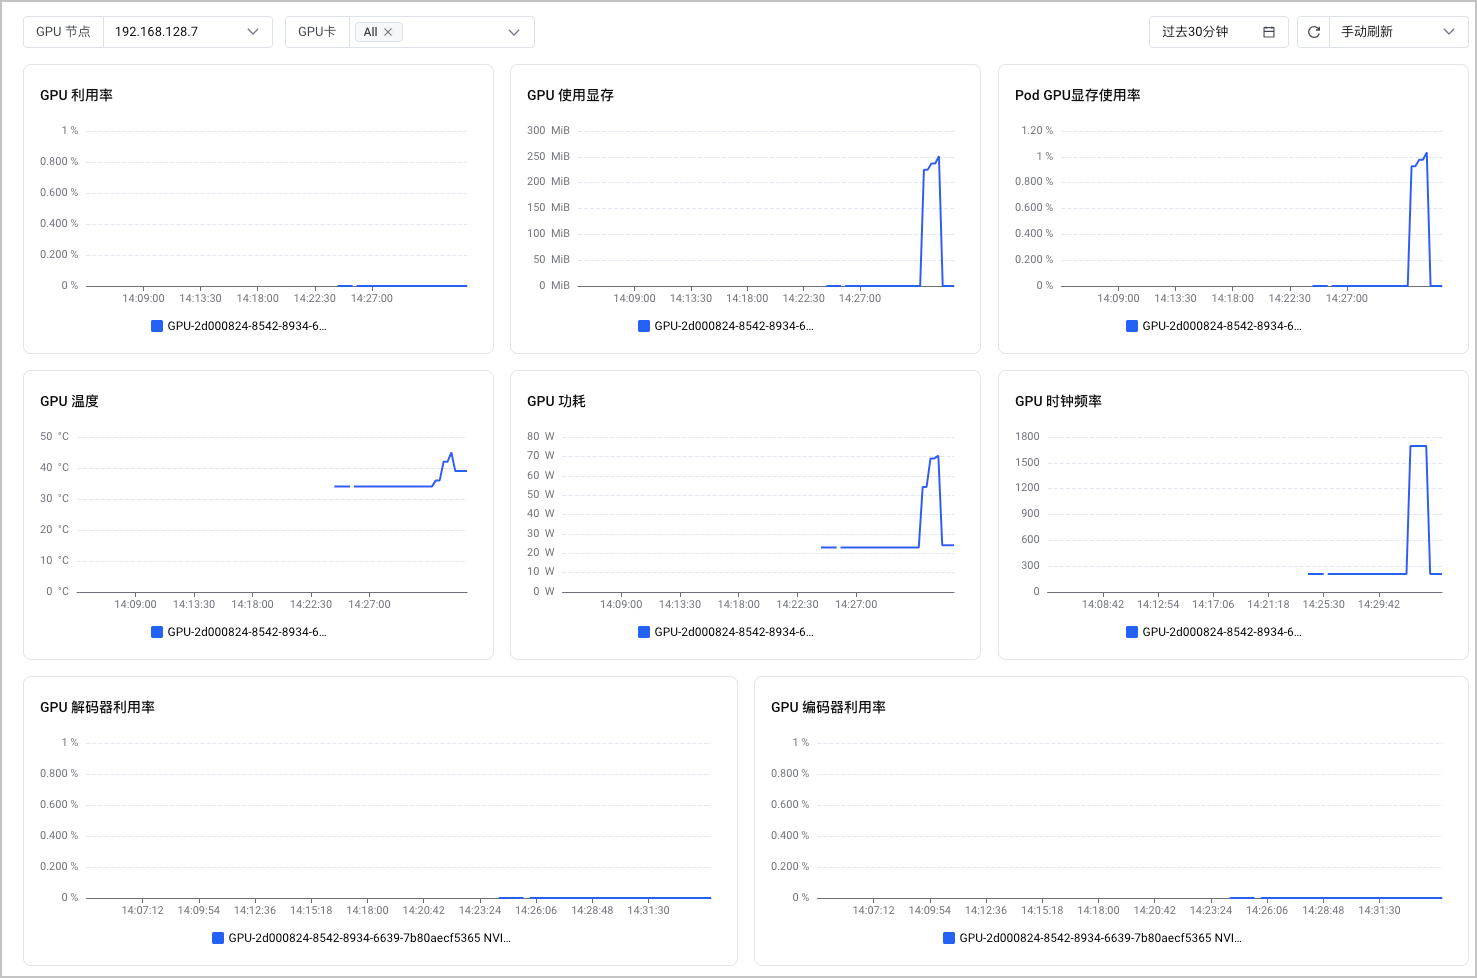
GPU 实例监控看板展示了 GPU 卡实例维度的 GPU 监控信息,包括:GPU 利用率、GPU 使用显存、GPU 温度、GPU 功耗等。您可以从该看板中了解指定 GPU 卡的监控信息。支持设置查询的时间段,并指定刷新方式(手动刷新、自动刷新)。
  1. 在集群管理页面的左侧导航栏中,选择 监控中心 > 监控看板
  1. 在左侧看板列表中选择 GPU 监控 > GPU 实例监控,即可查看监控看板。
alt
容器组 GPU 监控
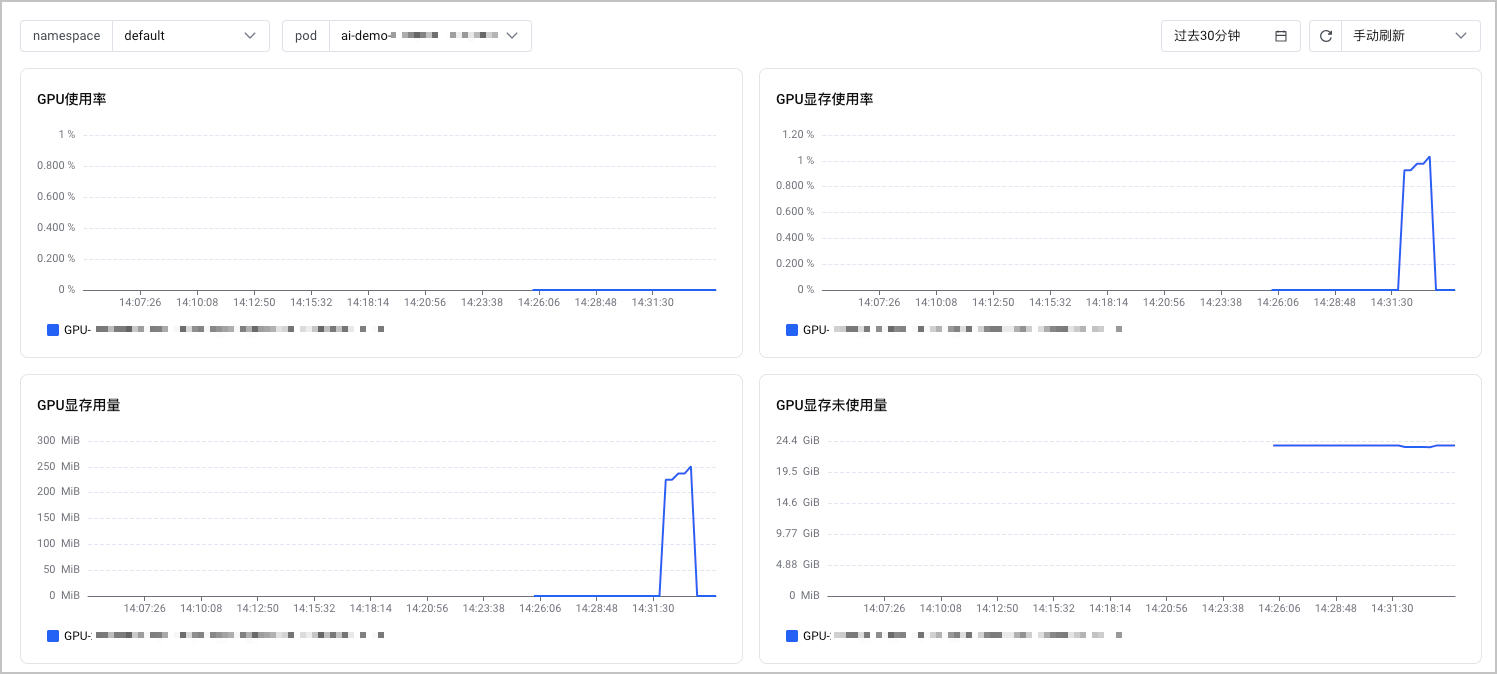
容器组 GPU 监控看板展示了容器组维度的 GPU 监控信息,包括:GPU 使用率、GPU 显存使用率、GPU 显存用量等。您可以从该看板中了解指定容器组的 GPU 监控信息。支持设置查询的时间段,并指定刷新方式(手动刷新、自动刷新)。
  1. 在集群管理页面的左侧导航栏中,选择 监控中心 > 监控看板
  1. 在左侧看板列表中选择 GPU 监控 > 容器组 GPU 监控,即可查看监控看板。
alt
节点 GPU 监控
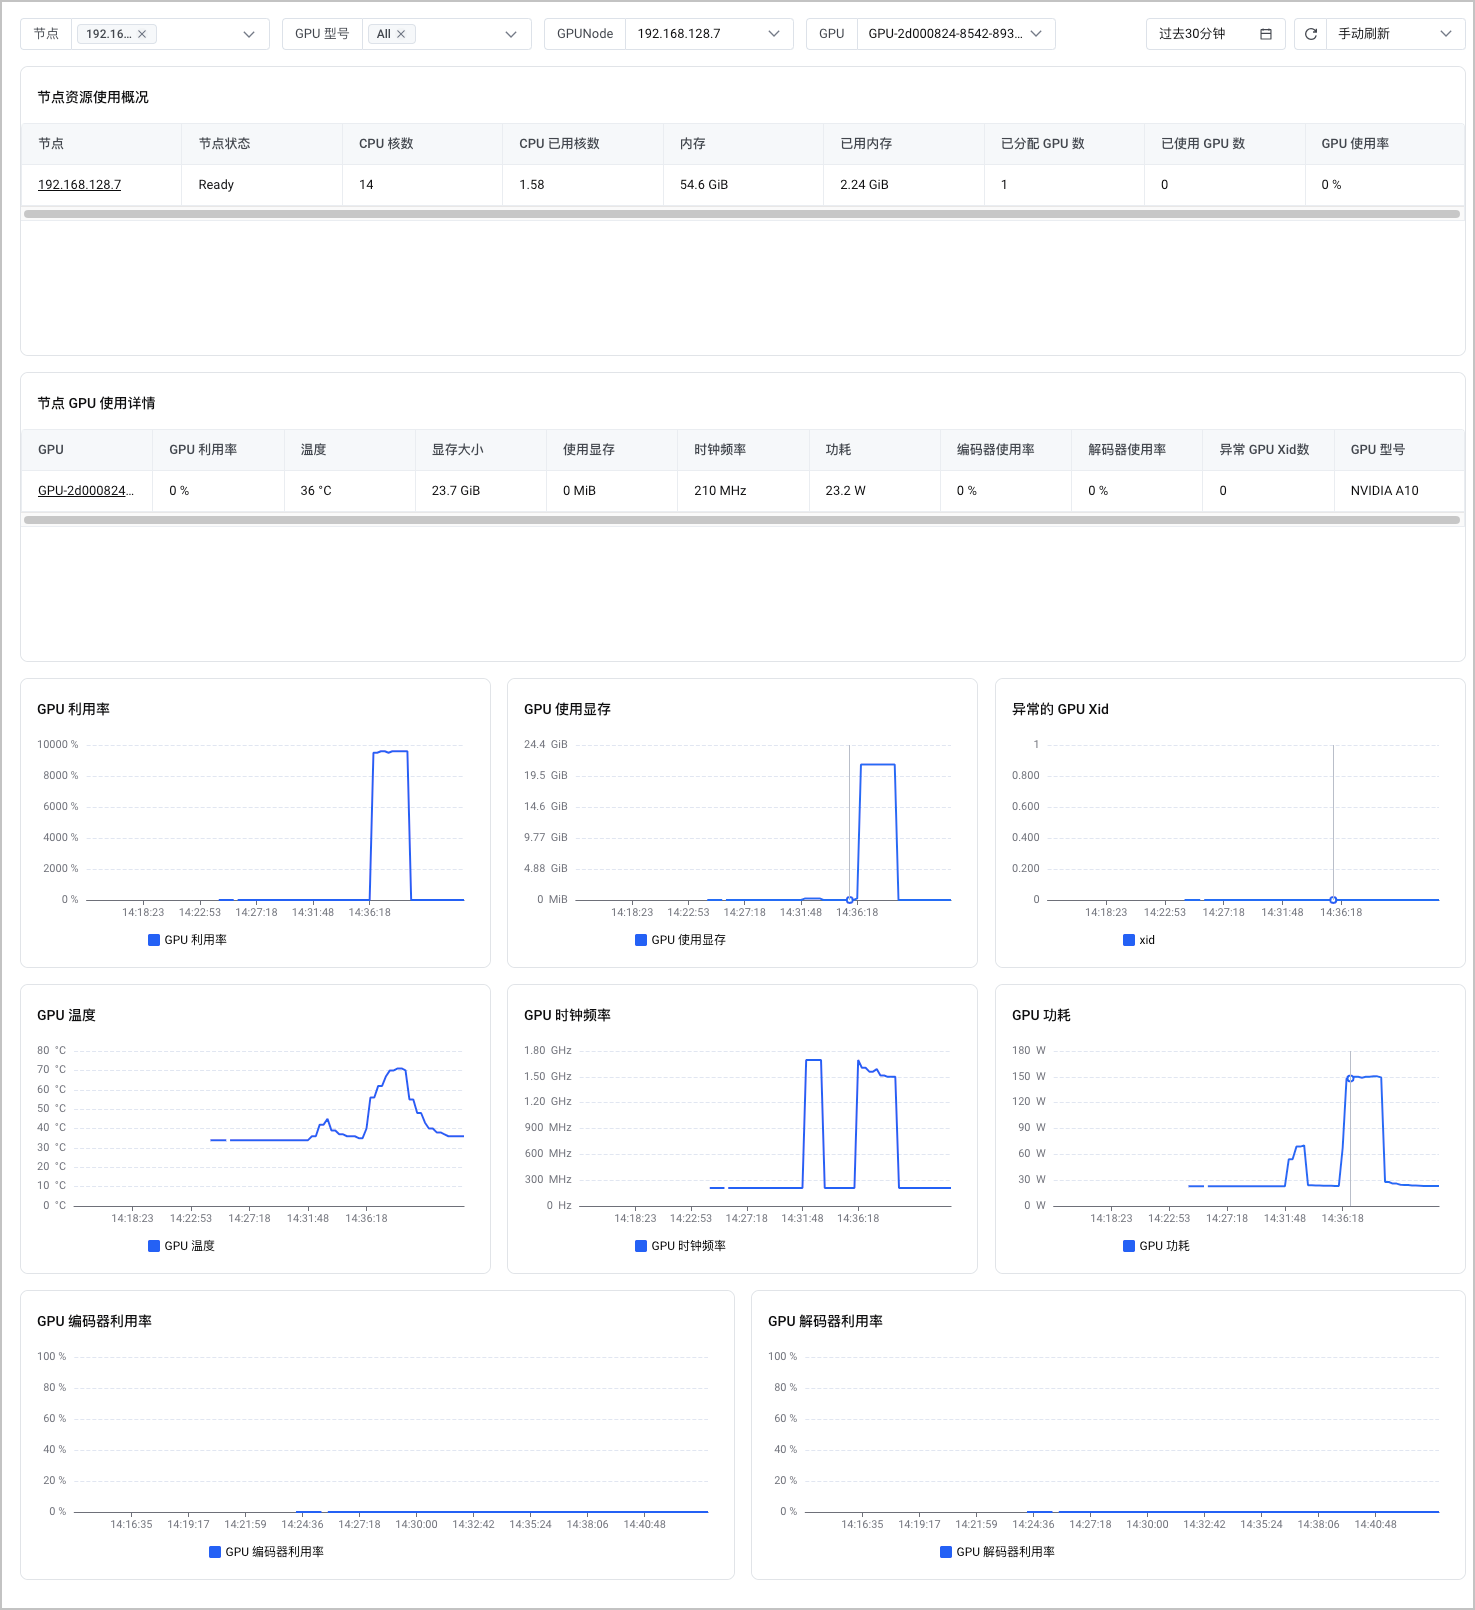
节点 GPU 监控看板展示了集群节点的 GPU 监控信息,包括:节点资源使用情况、节点 GPU 使用详情、GPU 利用率、GPU 使用显存等。您可以从该看板中了解指定节点的 GPU 监控信息。支持设置查询的时间段,并指定刷新方式(手动刷新、自动刷新)。
  1. 在集群管理页面的左侧导航栏中,选择 监控中心 > 监控看板
  1. 在左侧看板列表中选择 GPU 监控 > 节点 GPU 监控,即可查看监控看板。
  • 节点资源使用情况 列表中,单击选择具体的节点,可以查看指定节点的监控信息。
  • 节点 GPU 使用详情 列表中,单击选择具体的 GPU 卡,可以查看指定 GPU 卡的监控信息。
alt
用户 GPU 监控
用户 GPU 监控看板展示了团队维度的 AI 训练监控信息。包括:团队训练任务数、团队 GPU worker 数、团队训练任务 GPU 利用率、团队训练任务异常 Xid 等。您可以从该看板中了解整个团队的 GPU 监控信息。支持设置查询的时间段,并指定刷新方式(手动刷新、自动刷新)。
  1. 在集群管理页面的左侧导航栏中,选择 监控中心 > 监控看板
  1. 在左侧看板列表中选择 GPU 监控 > 用户 GPU 监控,即可查看监控看板。
  • 团队训练任务概况 列表中,单击选择具体的团队,可以查看指定团队的监控信息。
  • 团队成员训练任务概况 列表中,单击选择具体的团队成员,可以查看指定团队成员的监控信息。
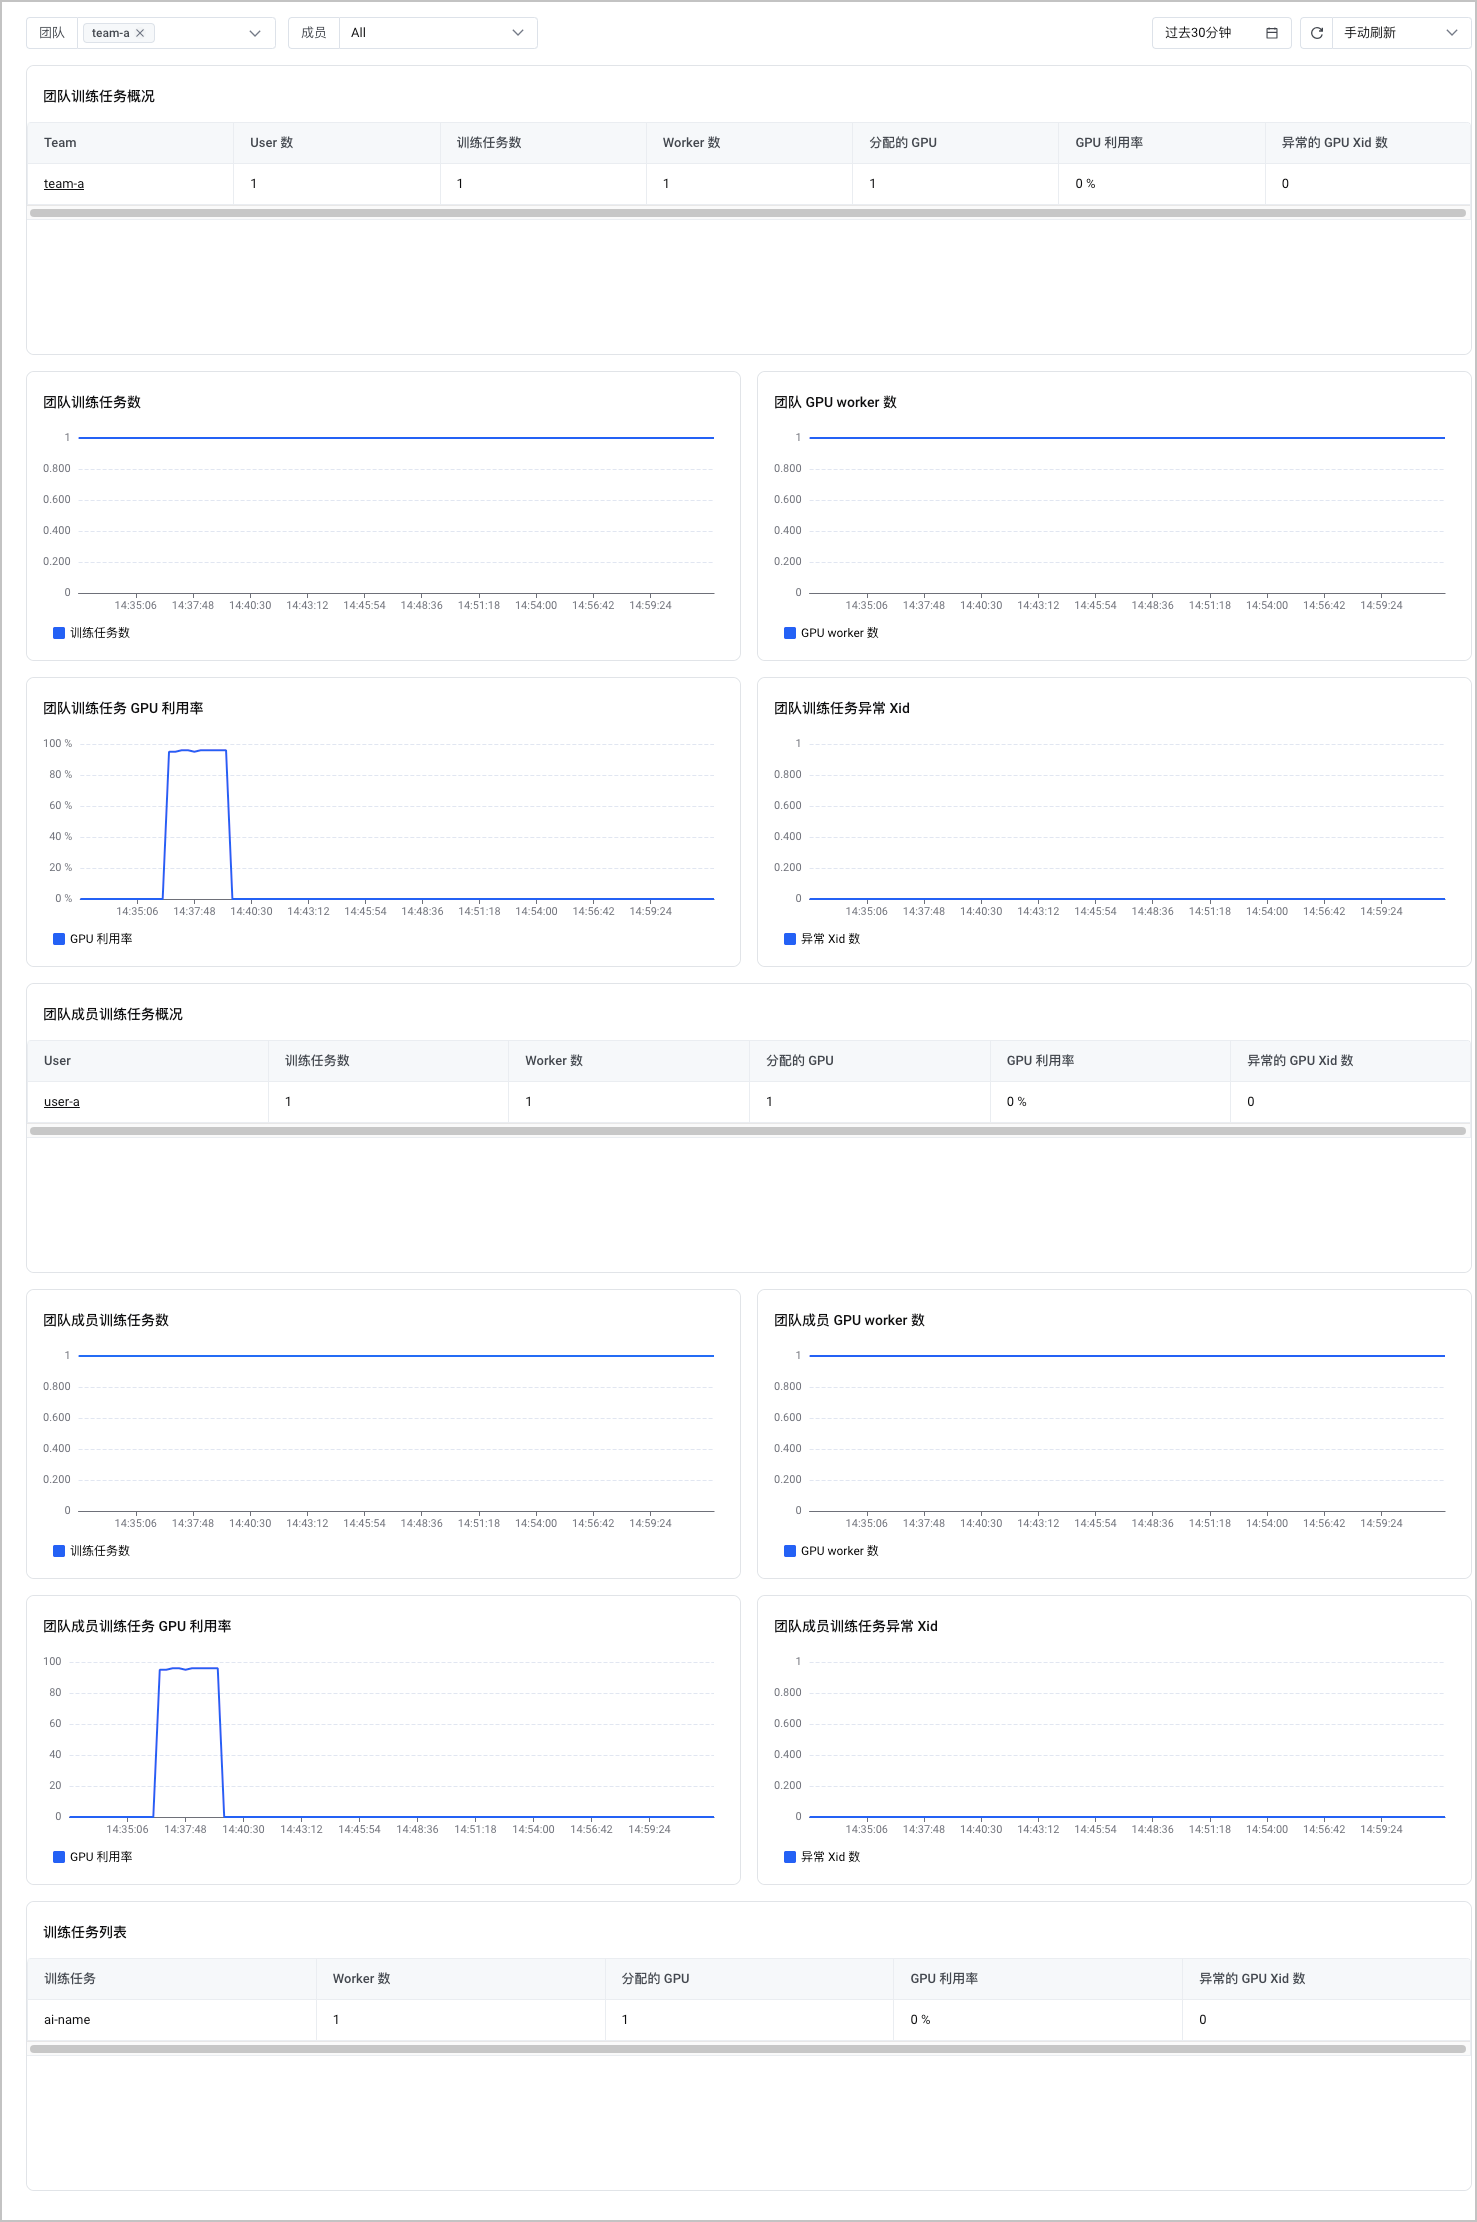
alt
说明
为了能够在大盘中查看到团队训练任务的监控信息,您需要在训练任务中增加ai.vke.volcengine.com/taskai.vke.volcengine.com/jobai.vke.volcengine.com/teamai.vke.volcengine.com/user标签。详情请参见 AI 训练任务监控
指标清单
rdma-device-plugin 监控
RDMA 网络性能指标暂未提供观测看板,您可以通过 rdma-device-plugin 组件的指标清单查看监控信息,如下表所示。
指标分类
指标名称
指标类型
指标含义
节点指标
rdma_exporter_node_infiniband_implied_nak_seq_err_total
Counter
Read response 乱序次数。
rdma_exporter_node_infiniband_local_ack_timeout_err_total
Counter
出方向超时次数。
rdma_exporter_node_infiniband_np_cnp_sent_total
Counter
方向采集周期内网卡发出的 CNP 报文数量。代表接收端路径上出现了拥塞,需要通知发送端减少发送。
rdma_exporter_node_infiniband_np_ecn_marked_roce_packets_total
Counter
入方向采集周期内网卡收到的 ECN mark 的报文数量。代表路径上出现了拥塞。
rdma_exporter_node_infiniband_out_of_sequence_total
Counter
入方向乱序次数。该指标增长可能是链路有问题。
rdma_exporter_node_infiniband_packet_seq_err_total
Counter
出方向乱序次数。
rdma_exporter_node_infiniband_port_data_received_bytes_total
Counter
驱动层面入方向流量,包括 TCP/IP 和 RDMA。
rdma_exporter_node_infiniband_port_data_transmitted_bytes_total
Counter
驱动层面出方向流量,包括 TCP/IP 和 RDMA。
rdma_exporter_node_infiniband_port_packets_received_total
Counter
驱动层面入方向包数量,包括 TCP/IP 和 RDMA。
rdma_exporter_node_infiniband_port_packets_transmitted_total
Counter
驱动层面出方向包数量,包括 TCP/IP 和 RDMA。
rdma_exporter_node_infiniband_rdma_data_received_bytes_total
Counter
RDMA 入方向流量。
rdma_exporter_node_infiniband_rdma_data_transmitted_bytes_total
Counter
RDMA 出方向流量。
rdma_exporter_node_infiniband_rdma_packets_received_total
Counter
RDMA 入方向包数量。
rdma_exporter_node_infiniband_rdma_packets_transmitted_total
Counter
RDMA 出方向包数量。
rdma_exporter_node_infiniband_rp_cnp_handled_total
Counter
入方向采集周期内网卡处理的 CNP 报文数量。需要降低发送频率。
rdma_exporter_node_infiniband_rp_cnp_ignored_total
Counter
入方向采集周期内网卡忽略的 CNP 报文数量。该指标不应该增长。如果增长要查看网卡的拥塞控制配置是否正常,是否使能 ECN/CNP。
rdma_exporter_node_infiniband_rx_pause_duration_seconds
Counter
入方向 pause 时长。该指标一般指向网络拥塞,代表网卡作为发送端收到的 PFC 包, 意味着接收端处于严重拥塞,接收端要求网卡停止发送。
rdma_exporter_node_infiniband_tx_pause_duration_seconds
Counter
出方向 pause 时长。该指标一般指向主机异常,网卡发出 PFC 包,意味着网卡作为接收端处于严重拥塞,网卡要求发送端停止发送。
rdma_exporter_node_infiniband_rx_pause_total
Counter
入方向接收到的 PFC pause 报文数量,当前都是使用了优先级 5。
rdma_exporter_node_infiniband_tx_pause_total
Counter
出方向发送的 PFC pause 报文数量。
Pod 指标
rdma_exporter_pod_infiniband_implied_nak_seq_err_total
Counter
Read response 乱序次数。
rdma_exporter_pod_infiniband_local_ack_timeout_err_total
Counter
出方向超时次数。
rdma_exporter_pod_infiniband_np_cnp_sent_total
Counter
方向采集周期内网卡发出的 CNP 报文数量。代表接收端路径上出现了拥塞,需要通知发送端减少发送。
rdma_exporter_pod_infiniband_np_ecn_marked_roce_packets_total
Counter
入方向采集周期内网卡收到的 ECN mark 的报文数量。代表路径上出现了拥塞。
rdma_exporter_pod_infiniband_out_of_sequence_total
Counter
入方向乱序次数。该指标增长可能是链路有问题。
rdma_exporter_pod_infiniband_packet_seq_err_total
Counter
出方向乱序次数。
rdma_exporter_pod_infiniband_port_data_received_bytes_total
Counter
驱动层面入方向流量,包括 TCP/IP 和 RDMA。
rdma_exporter_pod_infiniband_port_data_transmitted_bytes_total
Counter
驱动层面出方向流量,包括 TCP/IP 和 RDMA。
rdma_exporter_pod_infiniband_port_packets_received_total
Counter
驱动层面入方向包数量,包括 TCP/IP 和 RDMA。
rdma_exporter_pod_infiniband_port_packets_transmitted_total
Counter
驱动层面出方向包数量,包括 TCP/IP 和 RDMA。
rdma_exporter_pod_infiniband_rdma_data_received_bytes_total
Counter
RDMA 入方向流量。
rdma_exporter_pod_infiniband_rdma_data_transmitted_bytes_total
Counter
RDMA 出方向流量。
rdma_exporter_pod_infiniband_rdma_packets_received_total
Counter
RDMA 入方向包数量。
rdma_exporter_pod_infiniband_rdma_packets_transmitted_total
Counter
RDMA 出方向包数量。
rdma_exporter_pod_infiniband_rp_cnp_handled_total
Counter
入方向采集周期内网卡处理的 CNP 报文数量。需要降低发送频率。
rdma_exporter_pod_infiniband_rp_cnp_ignored_total
Counter
入方向采集周期内网卡忽略的 CNP 报文数量。该指标不应该增长。如果增长要查看网卡的拥塞控制配置是否正常,是否使能 ECN/CNP。
rdma_exporter_pod_infiniband_rx_pause_duration_seconds
Counter
入方向 pause 时长。该指标一般指向网络拥塞,代表网卡作为发送端收到的 PFC 包, 意味着接收端处于严重拥塞,接收端要求网卡停止发送。
rdma_exporter_pod_infiniband_tx_pause_duration_seconds
Counter
出方向 pause 时长。该指标一般指向主机异常,网卡发出 PFC 包,意味着网卡作为接收端处于严重拥塞,网卡要求发送端停止发送。
rdma_exporter_pod_infiniband_rx_pause_total
Counter
入方向接收到的 PFC pause 报文数量,当前都是使用了优先级 5。
rdma_exporter_pod_infiniband_tx_pause_total
Counter
出方向发送的 PFC pause 报文数量。
rdma-device-plugin 组件的指标中自定义了部分标签,您可以使用这些标签对指标进行筛选和查看。常用指标标签说明如下表所示。
标签名称
说明
Pod
使用 RDMA 设备的容器组 ID,例如pcji9mk1***
Namespace
使用 RDMA 设备的容器组所在命名空间。
RdmaMode
RDMA 网络模式,取值包括:
  • exclusive:独占模式。
  • shared:共享模式。
Container
使用 RDMA 设备的容器名称。
Device
RDMA 网络设备名称,例如mlx5_1
说明
Prometheus 通用标签,比如clusterinstance等,不再单独说明。
node-exporter 监控
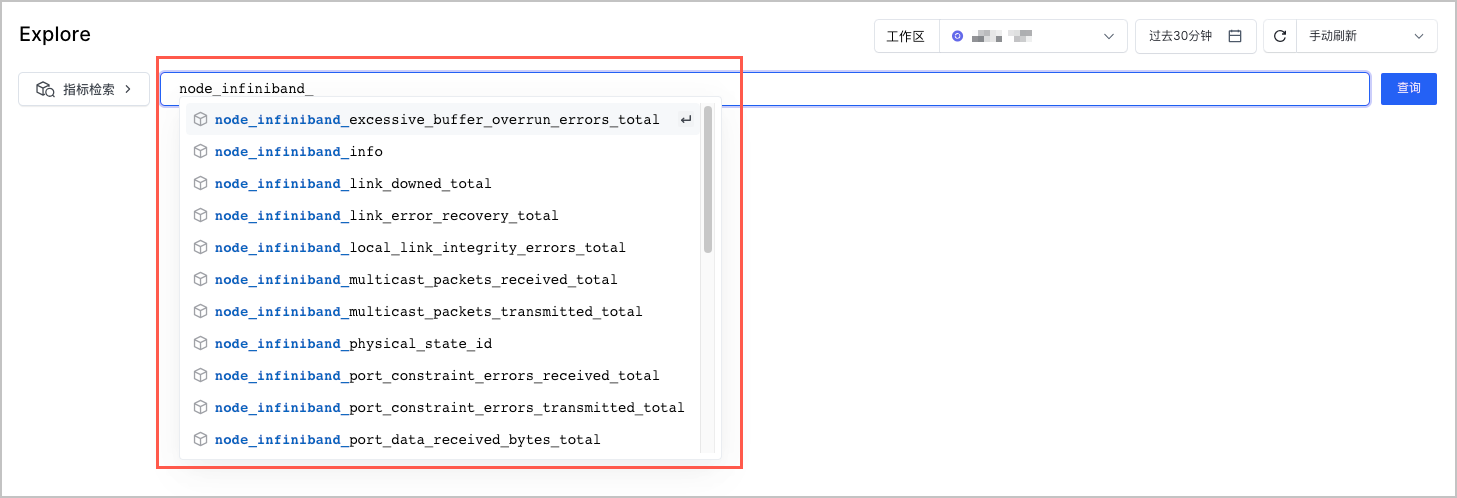
node-exporter 采集的 RDMA 指标清单,请参见 官方文档。您可以在 Explore 中,通过node_infiniband_前缀查询这些指标。
alt
查看指标
  • 如需查询集群中的已接入/未接入指标,或查询指标的具体含义,请参见 指标查询
  • 支持使用托管 Prometheus 的 Explore 功能来快速查询和展示指标数据。详情请参见 指标查询
GPU 监控和告警建议
在集群中配置 GPU 监控和告警时,建议额外关注以下几个问题:
监控
开启 GPU 观测后,支持在 VMP 控制台中使用 PromQL 语句查询相关指标。详情请参见 指标查询
  1. 登录 VMP 服务控制台
  1. 单击左侧导航栏的 Explore,进入 Explore 页面。
  1. 在右上角的配置项中,配置需要查询指标的 工作区查询时间段数据刷新方式
  1. 使用如下 PromQL 语句,查询相关指标。
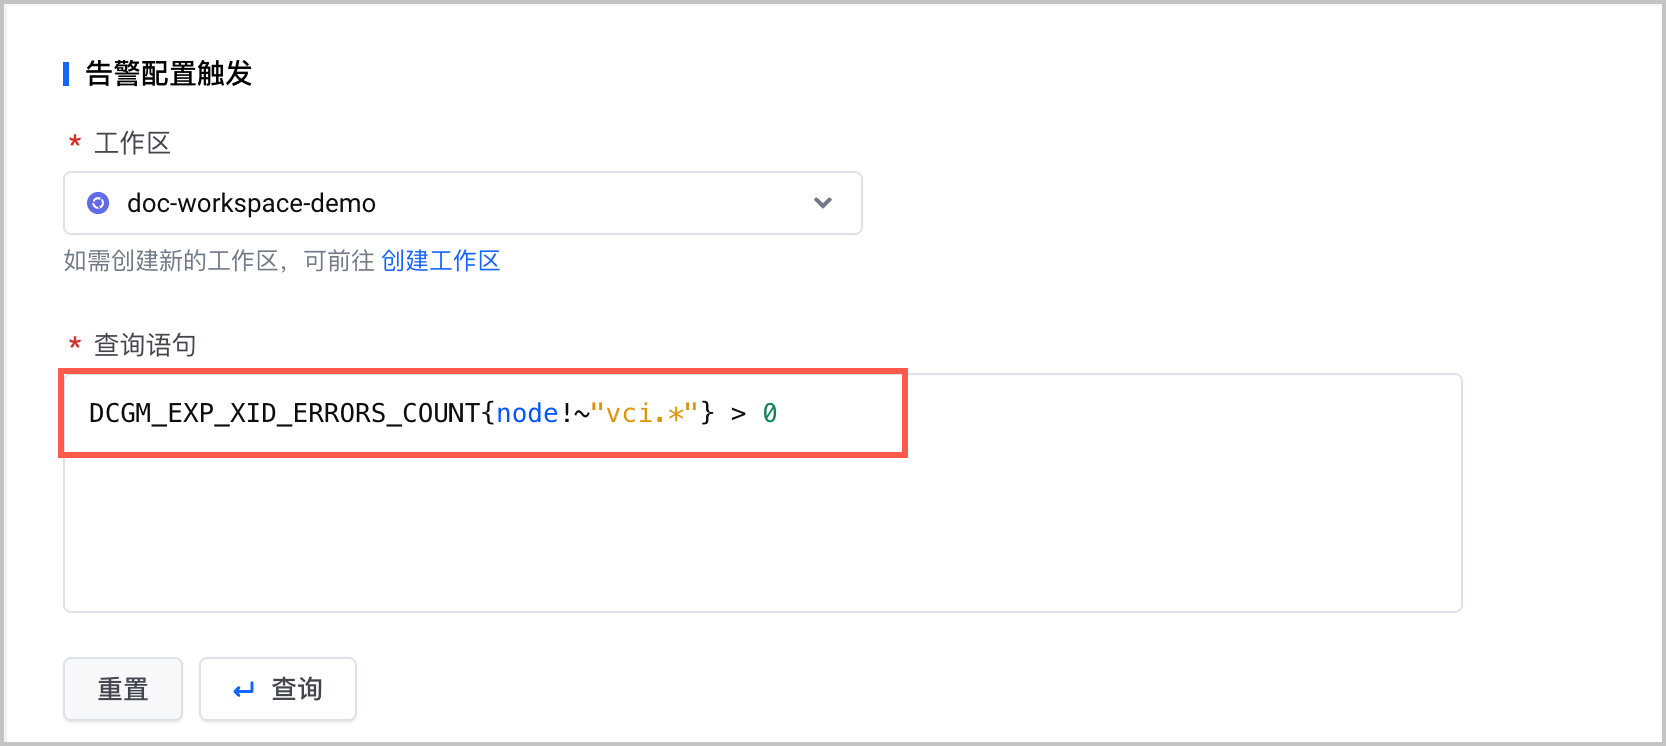
  • 查询 GPU XID 健康检查的相关指标
  • 方式一:查询 ECS GPU 资源禁止调度相关指标
    方式二:查询 GPU XID 错误相关指标
    kube_node_status_capacity{node!~"vci.*", resource=~"nvidia_com_gpu|vke_volcengine_com_mgpu_core"} - kube_node_status_allocatable{node!~"vci.*", resource=~"nvidia_com_gpu|vke_volcengine_com_mgpu_core"} > 0
  • 查询 GPU 资源上报为 0 的相关指标。
  • kube_node_status_capacity{node!~"vci.*", resource=~"nvidia_com_gpu|vke_volcengine_com_mgpu_core|vke_volcengine_com_mgpu_memory"} == 0
告警
开启 GPU 观测后,您可以在 VMP 控制台中配置相关告警。详情请参见 创建告警规则
  1. 在左侧导航栏选择 告警中心 > 告警规则
  1. 告警规则 页面,选择 创建 > 手动创建,并根据上述观测指标,配置关于 GPU XID 健康检查和 GPU 资源上报为 0 的告警。详细的配置说明,请参见 创建告警规则
最近更新时间:2026.08.31 15:13:06
这个页面对您有帮助吗?
有用
有用
无用
无用