容器服务
容器服务
容器服务


文档指南
请输入


容器服务 VKE
产品动态
Kubernetes 版本发布记录
组件发布记录
监控组件
DNS 组件
GPU 组件
Sandbox 组件
安全公告
产品公告
历史公告
用户指南
集群
节点池
授权
网络
容器网络
服务(Service)
路由(Ingress)
APIG Ingress
ALB Ingress
自定义转发规则配置示例
CLB Ingress
Nginx Ingress
Gateway API
工作负载
存储
数据管理中心(DMC)
对象存储(TOS)
FSX 访问方式
文件存储(NAS)
FSX 访问方式
弹性文件存储(EFS)
文件存储(vePFS)
FSX 访问方式
vePFS Client 访问方式
NFS 访问方式
大数据文件存储(CloudFS)
弹性伸缩
工作负载弹性伸缩
事件驱动伸缩(KEDA)
组件管理
网络组件
监控组件
DNS 组件
GPU 组件
Sandbox 组件
异构计算
调度管理
可观测性
基础观测
诊断与巡检
最佳实践
网络
可观测性
安全合规
API 参考
集群管理
节点池管理
组件管理
机型镜像管理
巡检诊断
弹性容器实例
附录
开发指南
常见问题
通用 FAQ
集群 FAQ
集群管理
集群升级
节点与节点池 FAQ
授权 FAQ
工作负载 FAQ
服务与路由 FAQ
存储 FAQ
弹性伸缩 FAQ
调度 FAQ
可观测性 FAQ
配额 FAQ
组件 FAQ
容器镜像 FAQ
AI 云原生
推理套件
Helm 模板 AI 应用
Deepseek 实践
Qwen 实践
最佳实践
MiniMax 模型部署
Qwen 模型部署
弹性容器实例 VCI
最新动态
用户指南
虚拟节点
VKE 集群使用虚拟节点
自建/跨云集群使用虚拟节点
创建 VCI 实例
VCI Agent Sandbox
安全合规
- 文档首页
 容器服务容器服务 VKE用户指南组件管理监控组件node-problem-detector
 复制全文
 下载 pdf
node-problem-detector
 文档反馈
 问问助手
node-problem-detector 组件为集群节点健康监测组件,用于监测和上报节点的异常状态。本文介绍该组件的作用、核心资源以及安装与升级说明。
组件概述
node-problem-detector(简称为 NPD)组件是容器服务提供的节点健康监测组件,其核心功能如下:
- 采集节点问题:持续监控节点自身的各种潜在问题,例如硬件故障、内核死锁、文件系统只读、容器运行时无响应等。
- 上报异常状态:将底层节点的异常状态暴露给 Kubernetes 上层控制平面,为自动化运维和问题诊断提供了关键的数据来源。包括:
- Node Condition(节点状态):对于影响较为严重的永久性或长期故障(如文件系统损坏),NPD 会更新节点的 Condition,这可能影响 Pod 的调度决策。
- Event(事件):对于临时性或信息性的问题(如内核 OOM),NPD 会创建 Kubernetes 事件,方便管理员追踪问题,但通常不直接影响调度。
在集群中安装组件后,系统会在 kube-system 命名空间下创建如下 Kubernetes 资源。
资源名称 | 资源类型 | 资源说明 |
node-problem-detector | DaemonSet | 组件核心工作负载,负责采集和上报该节点的异常。 |
说明
上表中仅罗列出了该组件的主要资源,以及配置组件或对应功能时可能使用到的资源,方便您了解该组件的主要组成。其他的组件相关资源(例如 ConfigMap、Secret 等)不多做介绍,请以集群中的实际为准。
组件版本
安装组件
- 登录 容器服务控制台。
- 在左侧导航栏中,选择 集群,单击目标集群名称,进入集群管理页面。
- 在左侧导航栏中,选择 组件管理,并选择 监控 页签。
- 将鼠标移动到组件卡片上,单击 部署,配置组件相关参数。
-
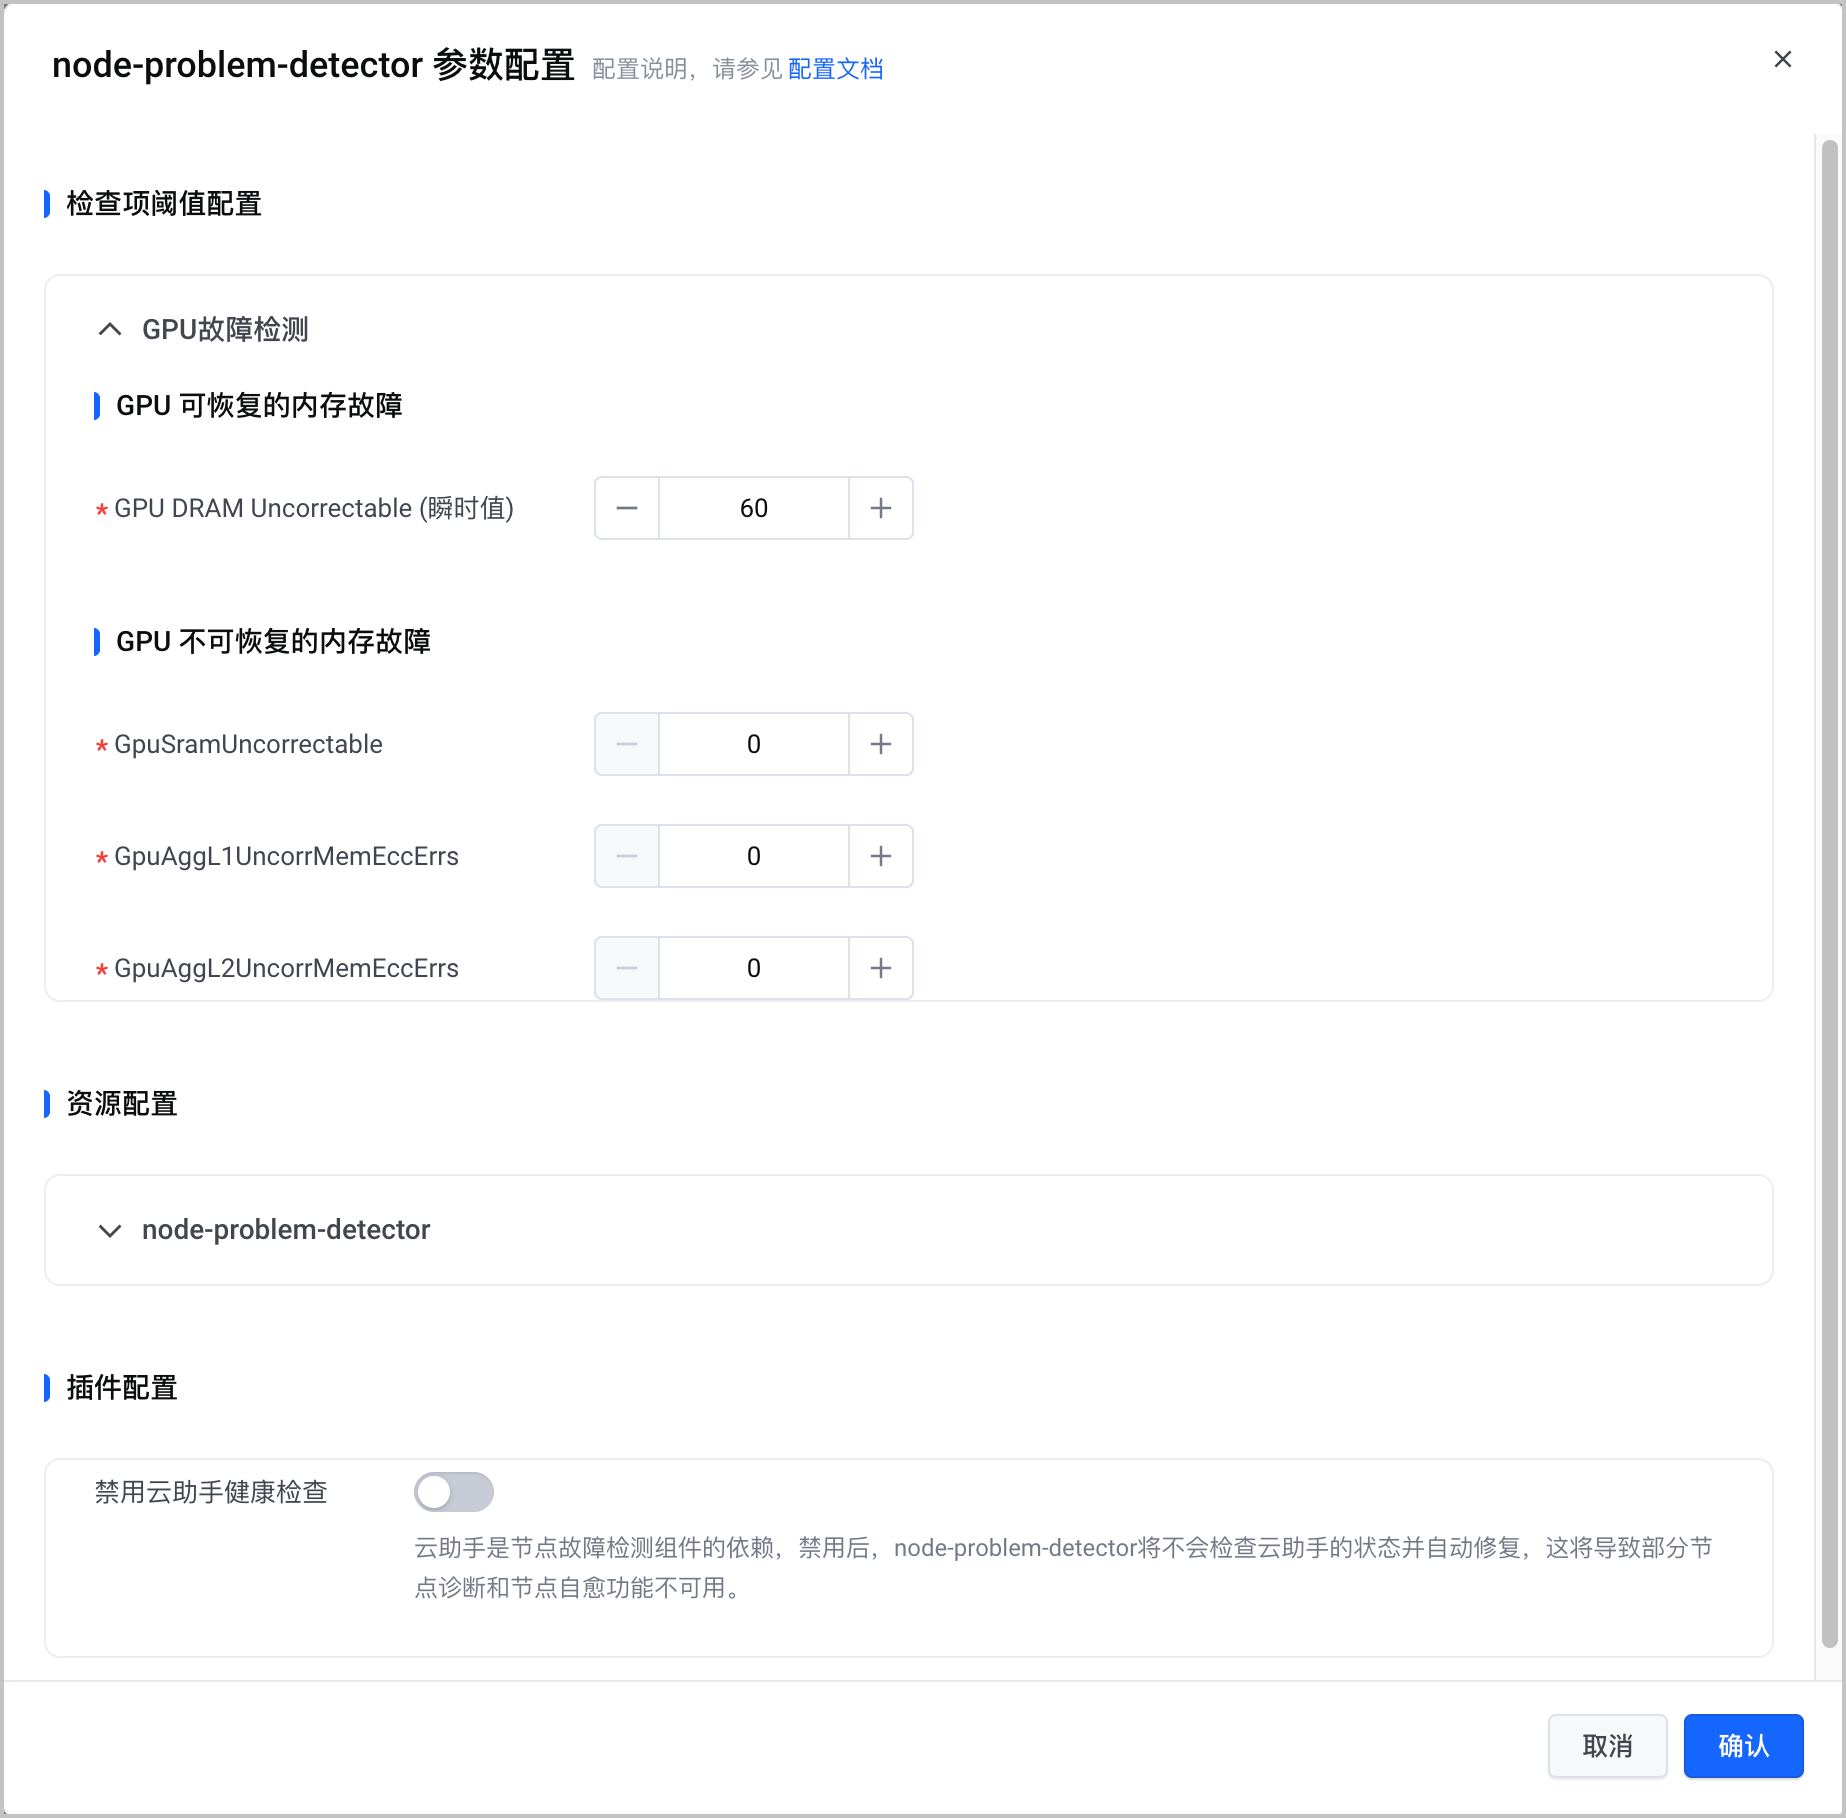
- 参数描述检查项阈值配置配置 GPU 故障检测的阈值,包括 GPU 可恢复的内存 故障 和 GPU 不可恢复的内存故障 相关检查项的故障检测阈值。资源配置配置 node-problem-detector 组件的资源,包括:CPU 请求、CPU 上限、内存请求、内存上限。插件配置
- 单击 确认,完成配置。
升级组件
组件会不定期发布新版本以提供新特性或修复已知问题。当组件卡片提示有可用更新时,建议您及时进行升级。为确保业务平稳过渡,升级前请尽量安排在业务低峰期执行操作。关于升级的操作步骤和注意事项,请参见 升级组件。
观测与告警
组件观测
配置告警
容器服务基于 托管 Prometheus(VMP)提供完善的集群监控告警能力,您可以直接使用系统预置模板快速创建告警规则组,也可以基于业务实际需求自定义基于 PromQL 语句的告警规则,或在导出预置模板 YAML 后调整规则并沉淀为自定义告警模板,统一复用于多个集群。详情请参见:
相关文档
最近更新时间:2026.08.19 11:38:05
这个页面对您有帮助吗?
有用
有用
无用
无用