容器服务
容器服务
容器服务


文档指南
请输入


容器服务 VKE
产品动态
Kubernetes 版本发布记录
组件发布记录
监控组件
DNS 组件
GPU 组件
Sandbox 组件
安全公告
产品公告
历史公告
用户指南
集群
节点池
授权
网络
容器网络
服务(Service)
路由(Ingress)
APIG Ingress
ALB Ingress
自定义转发规则配置示例
CLB Ingress
Nginx Ingress
Gateway API
工作负载
存储
数据管理中心(DMC)
对象存储(TOS)
FSX 访问方式
文件存储(NAS)
FSX 访问方式
弹性文件存储(EFS)
文件存储(vePFS)
FSX 访问方式
vePFS Client 访问方式
NFS 访问方式
大数据文件存储(CloudFS)
弹性伸缩
工作负载弹性伸缩
事件驱动伸缩(KEDA)
组件管理
网络组件
监控组件
DNS 组件
GPU 组件
Sandbox 组件
异构计算
调度管理
可观测性
基础观测
诊断与巡检
最佳实践
网络
可观测性
安全合规
API 参考
集群管理
节点池管理
组件管理
机型镜像管理
巡检诊断
弹性容器实例
附录
开发指南
常见问题
通用 FAQ
集群 FAQ
集群管理
集群升级
节点与节点池 FAQ
授权 FAQ
工作负载 FAQ
服务与路由 FAQ
存储 FAQ
弹性伸缩 FAQ
调度 FAQ
可观测性 FAQ
配额 FAQ
组件 FAQ
容器镜像 FAQ
AI 云原生
推理套件
Helm 模板 AI 应用
Deepseek 实践
Qwen 实践
最佳实践
MiniMax 模型部署
Qwen 模型部署
弹性容器实例 VCI
最新动态
用户指南
虚拟节点
VKE 集群使用虚拟节点
自建/跨云集群使用虚拟节点
创建 VCI 实例
VCI Agent Sandbox
安全合规
- 文档首页
 容器服务容器服务 VKE用户指南可观测性基础观测集群观测控制面服务观测
 复制全文
 下载 pdf
控制面服务观测
 文档反馈
 问问助手
控制面服务观测允许您监控集群控制面核心组件的工作状态。本文为您介绍如何配置控制面服务观测功能。
前提条件
操作步骤
步骤一:开启观测
- 登录 容器服务控制台。
- 在左侧导航栏单击 集群,找到目标集群,单击集群名称。
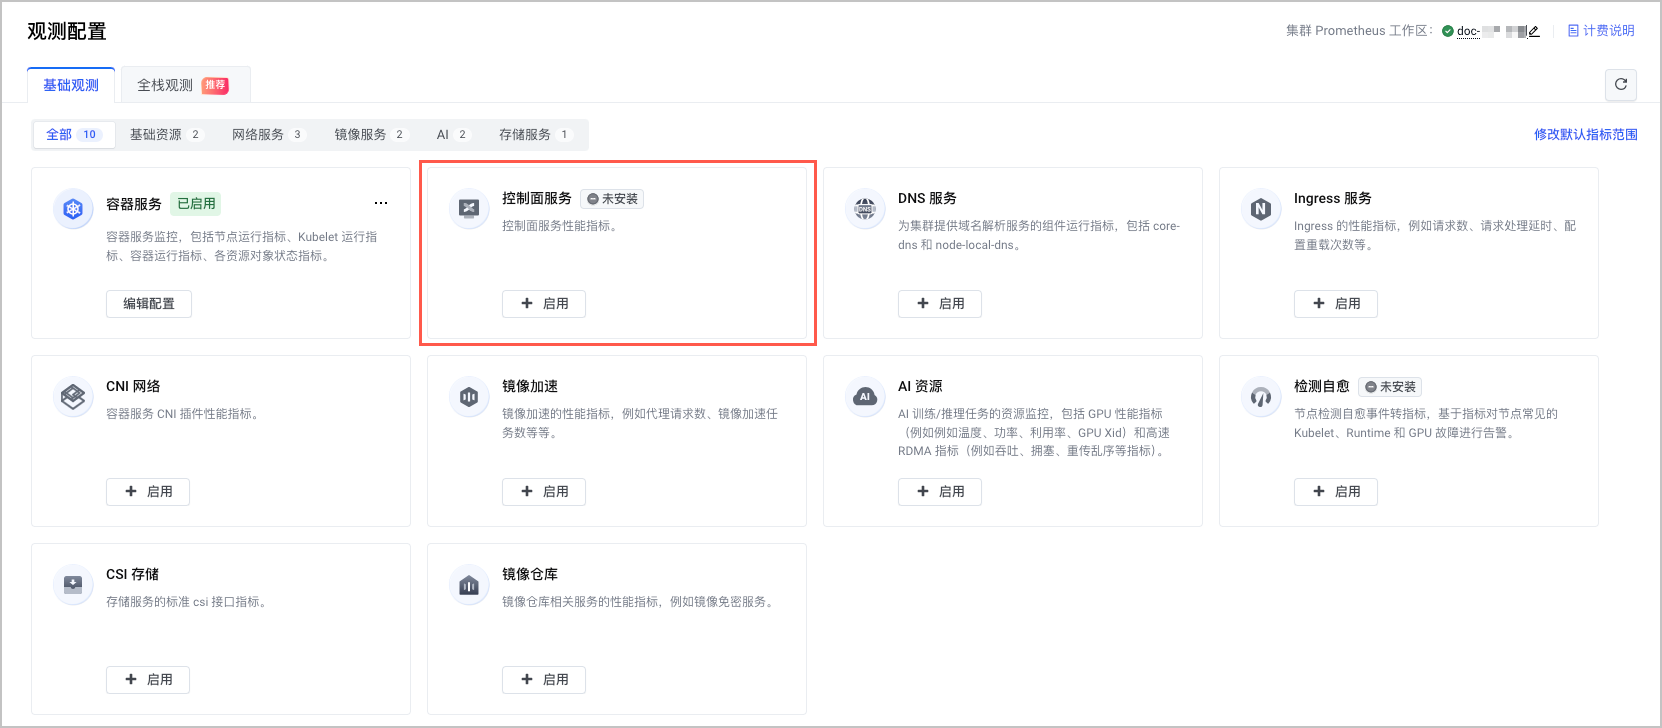
- 在集群管理页面的左侧导航栏中,单击 观测配置,并选择 基础观测 页签。
- 选择 控制面服务 卡片,单击 启用,开启控制面服务观测。
-
- 系统自动检查开启控制面服务观测所需的必要条件。
-
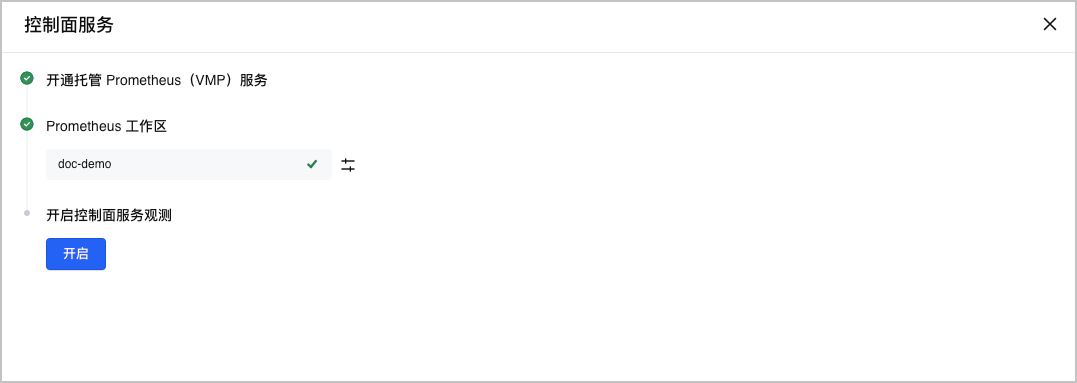
- 单击 开启,开启控制面服务观测。
步骤二:配置采集规则
控制面组件监控开启后,您可以配置采集规则,选择需要采集的目标组件、具体指标项及采集间隔。可以根据实际需求丢弃一些不用的指标。
- 在集群管理页面的左侧导航栏中,单击 观测配置,并选择 基础观测 页签。
- 选择 控制面服务 卡片,单击 编辑配置 并选择 指标 页签,在组件列表 操作 列,单击开关,开启或关闭组件的采集规则。当关闭组件的采集规则时,系统不会采集该组件的所有指标。
-
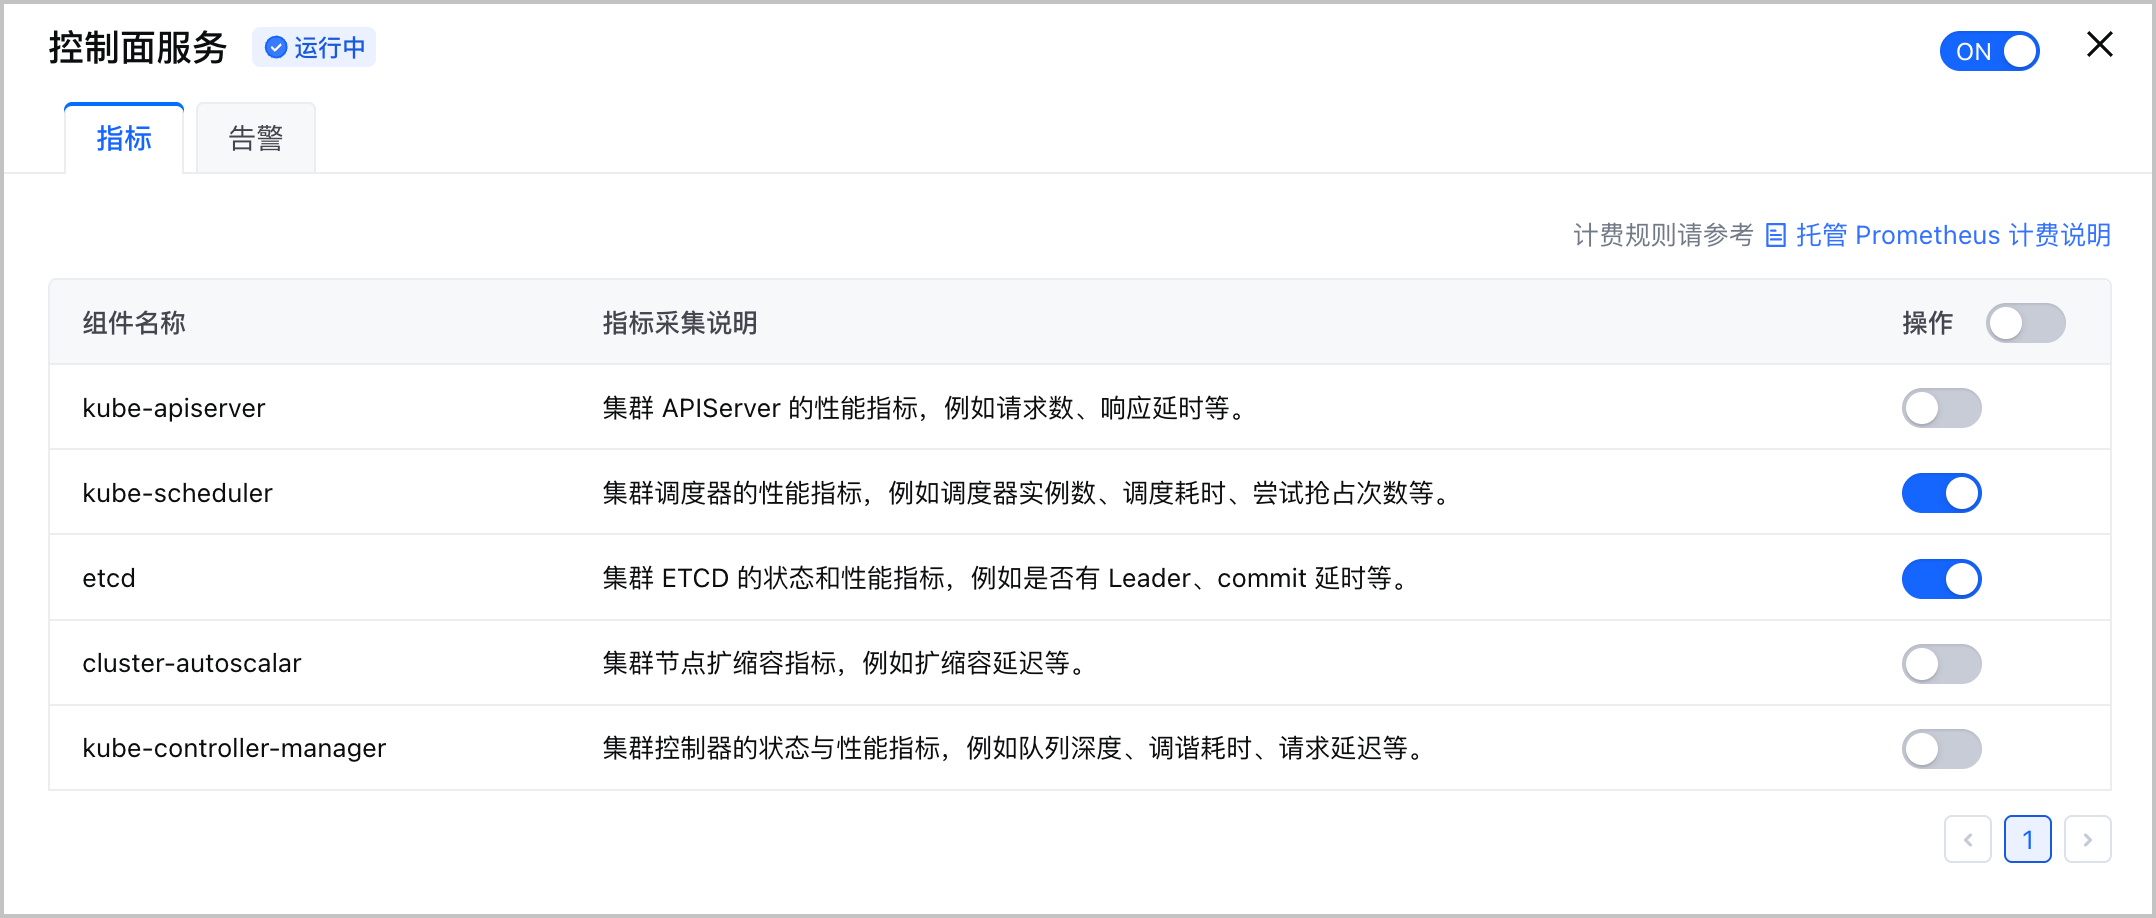
- 单击 确认,完成配置。
步骤三:配置告警
您可以基于预置的告警模板,快速完成控制面服务观测的告警配置。
- 在集群管理页面的左侧导航栏中,单击 观测配置,并选择 基础观测 页签。
- 选择 控制面服务 卡片,单击 编辑配置 并选择 告警 页签,配置告警的相关参数。
-
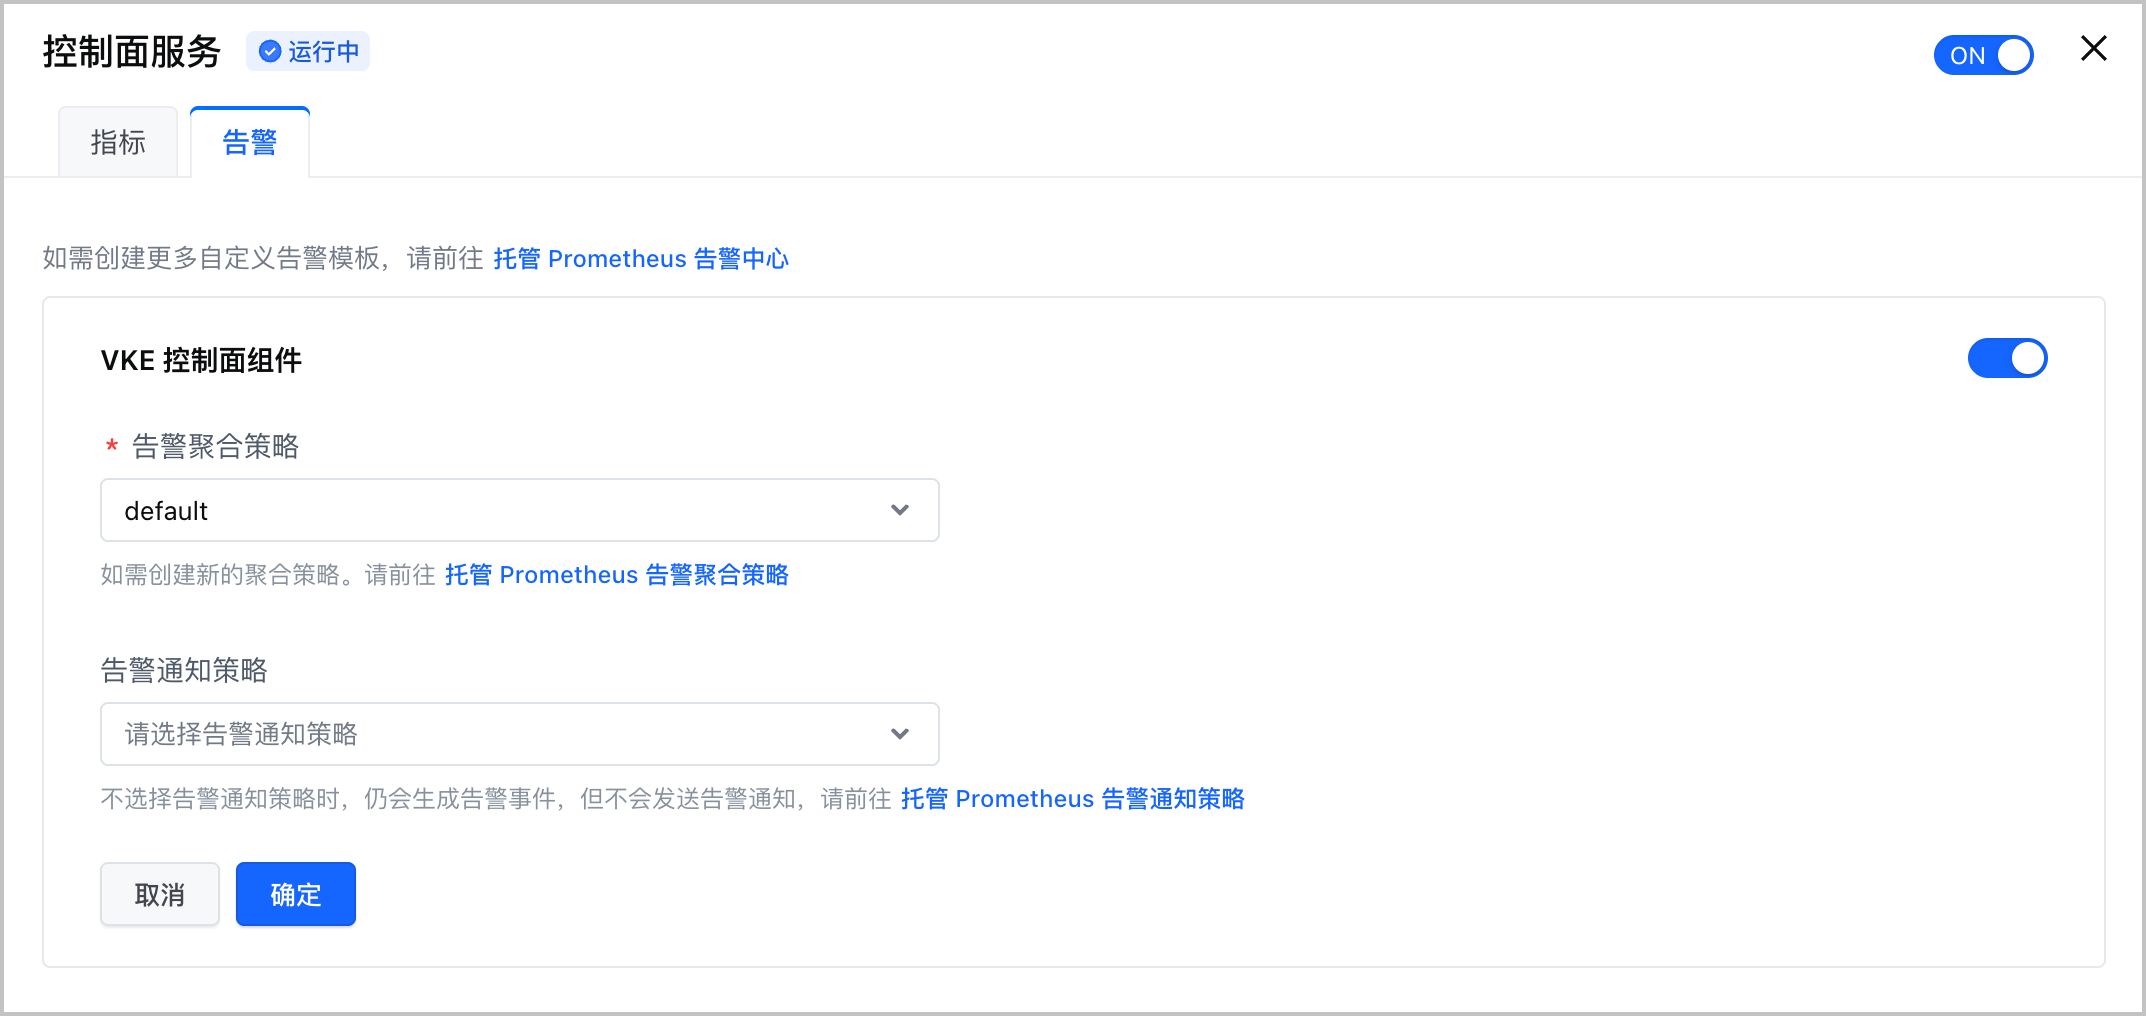
-
说明
- 除了直接使用预置告警模板配置告警规则,您可以自定义模板中的配置,或直接使用 PromQL 语句配置告警规则。详情请参见 配置告警。
- 预置告警规则模板的详情,包括规则说明、PromQL 配置和常见告警处理流程。请参见 预置告警模板。
- 单击 确定,完成配置。
观测看板
说明
kube-apiserver 监控
配置控制平面组件监控后,您可以查看控制面组件的指标大盘。设置查询的时间段,并指定刷新方式(手动刷新、自动刷新)。
- 在集群管理页面的左侧导航栏中,选择 监控中心 > 监控看板。
- 在左侧看板列表中选择 核心组件监控 > kube-apiserver 监控,即可查看监控看板。
-
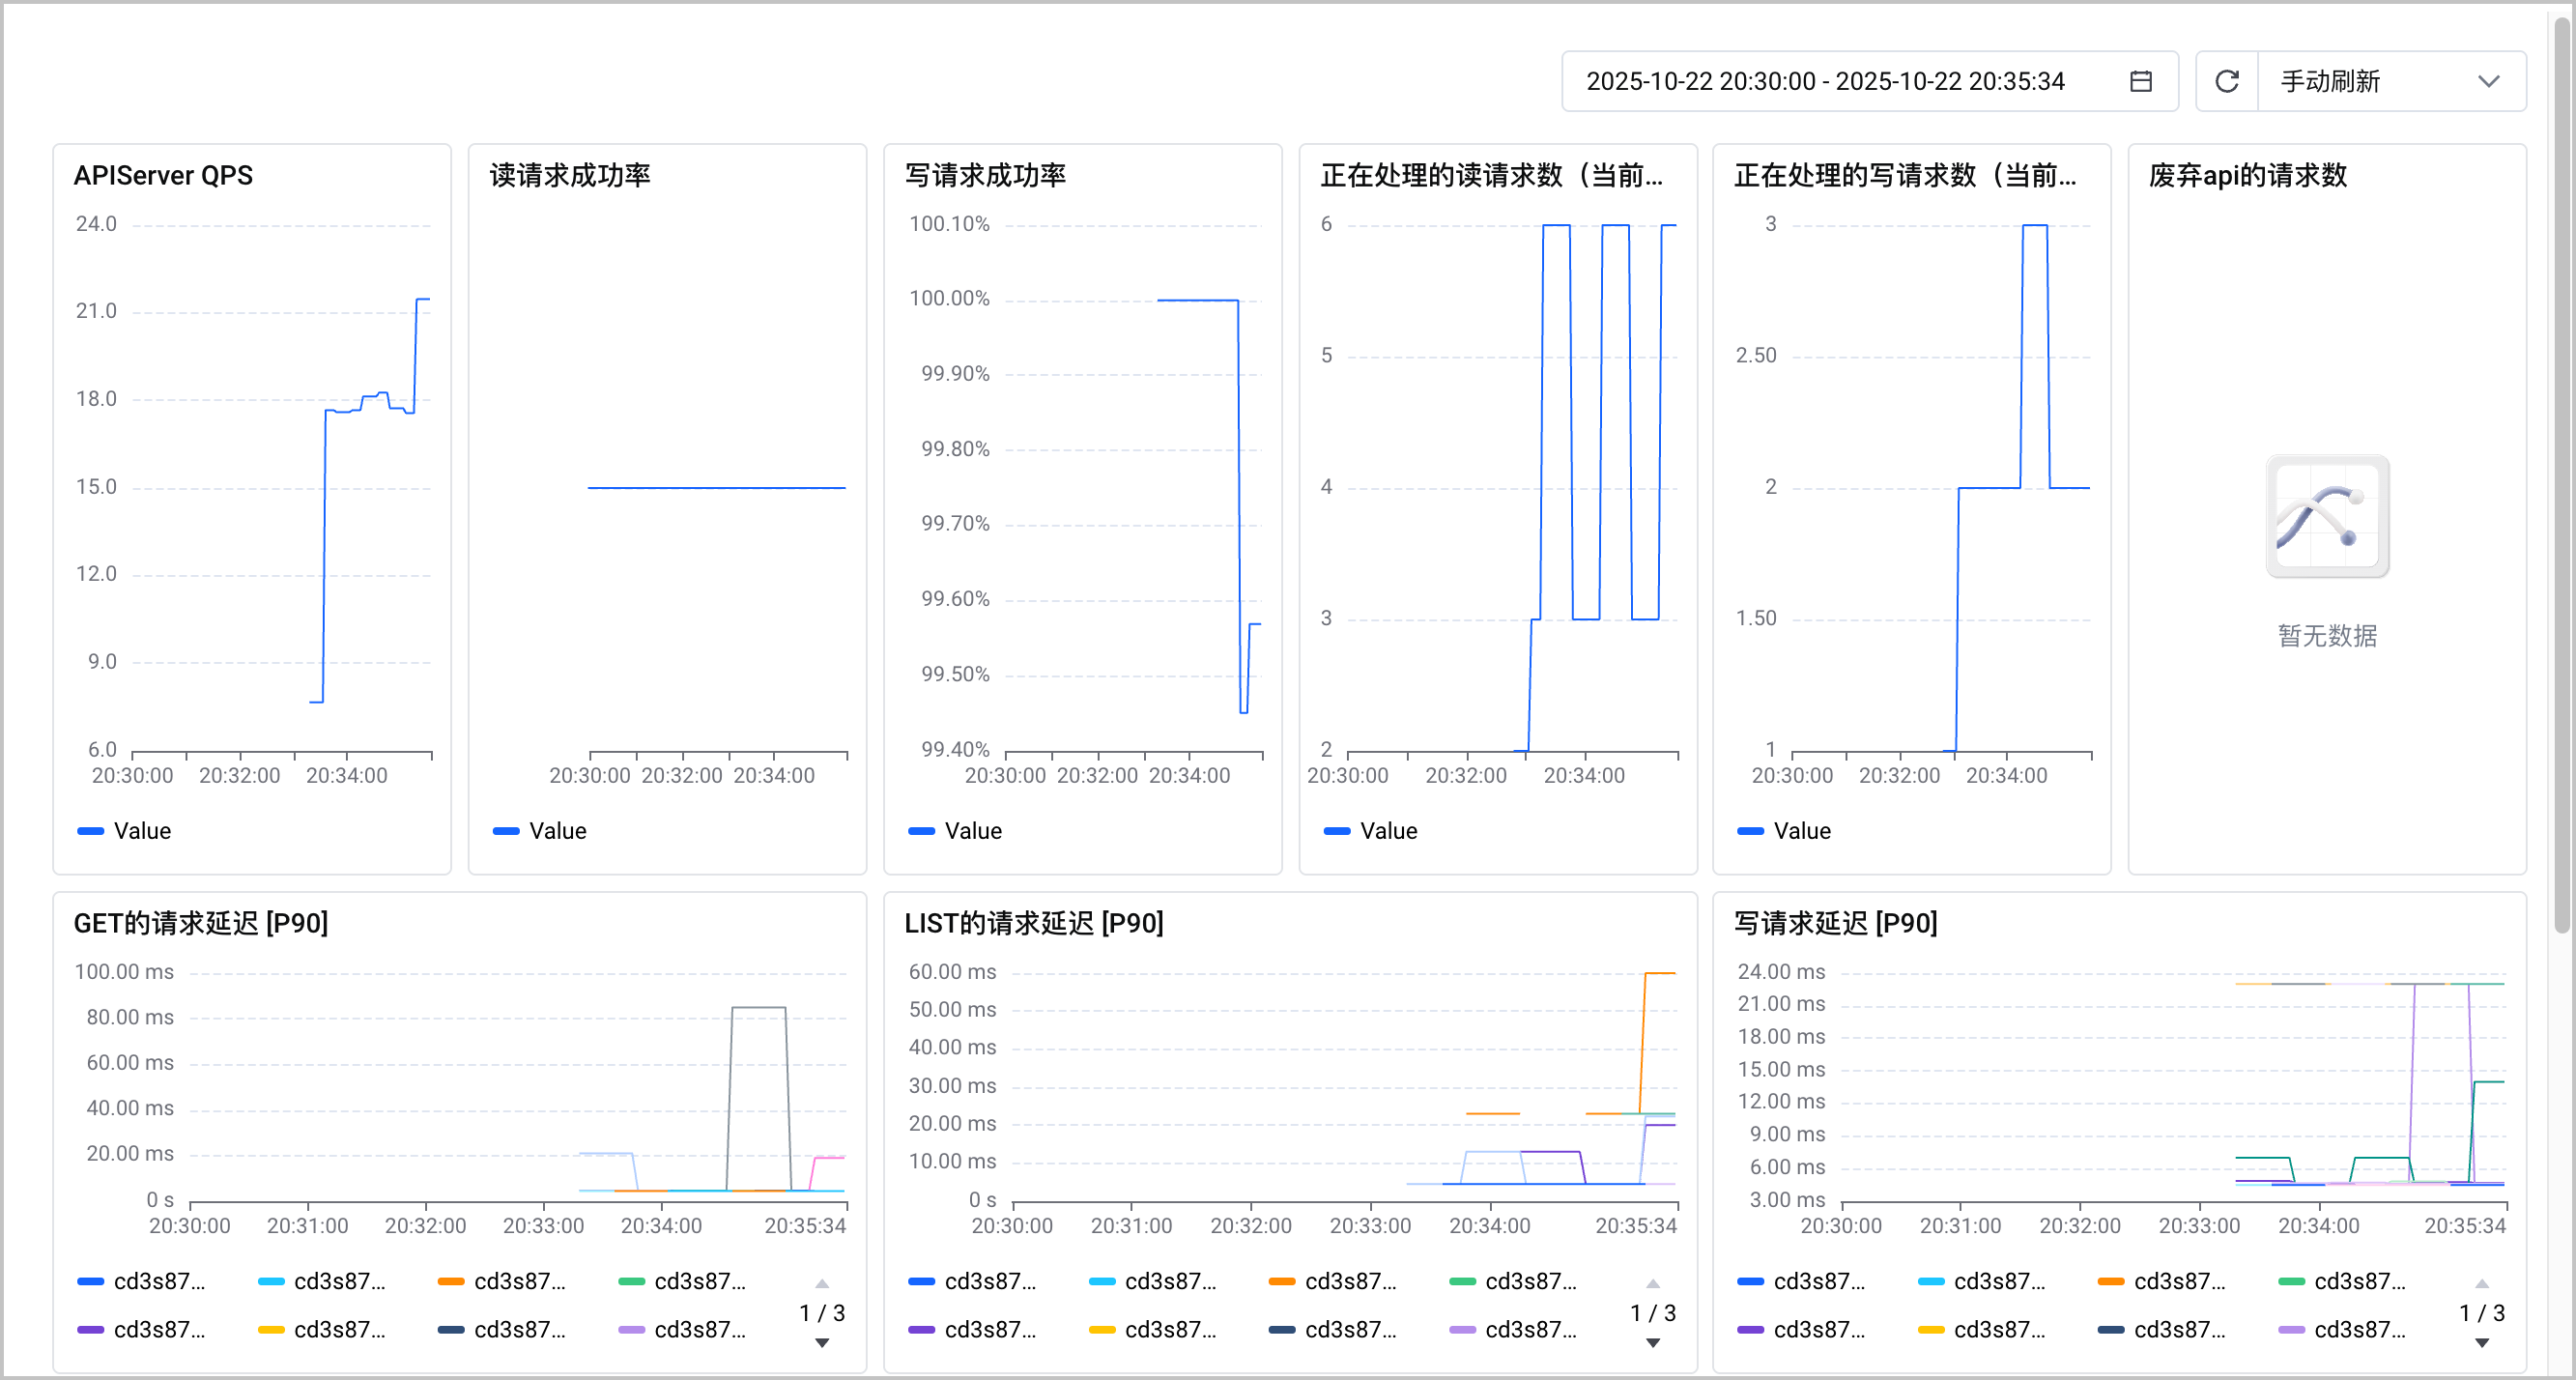
- kube-apiserver 监控看板中关于 APF 限流相关的图表说明,如下表所示。
说明
- 图表名称单位图表说明APF 当前执行请求数量(维度:FS + PL)个按 FlowSchema + PriorityLevelConfiguration 维度统计请求数量的相关指标。包括以下指标:
- 当前执行:不同 FlowSchema 在对应 PriorityLevelConfiguration 中当前正在执行的请求数量。
- 待处理:不同 FlowSchema 在对应 PriorityLevelConfiguration 中当前等待执行的请求数量。
APF 当前在队列中待处理请求数量(维度:FS + PL)个APF 名义并发限制席位数个按 PriorityLevelConfiguration 维度统计 APF 席位数量的相关指标。包括以下指标:- 名义并发限制:PriorityLevelConfiguration 的名义最大并发席位限制。
- 当前并发限制:不同 PriorityLevelConfiguration 中,在动态调整(借出借入)后实际允许的最大并发席位数量。
- 当前在执行:不同 PriorityLevelConfiguration 中当前正在执行的请求数对应的席位数量。
- 当前在排队:不同 PriorityLevelConfiguration 中排队中的请求数对应的席位数量。
APF 当前并发限制席位数个APF 当前在执行的席位数量个APF 当前在排队的席位数量个APF 请求执行时间 [P90]秒每个 FlowSchema 以及对应 PriorityLevelConfiguration 的请求从开始执行到最终完成所花费的时间 90 分位数。APF 请求等待时间 [P90]秒每个 FlowSchema 以及对应 PriorityLevelConfiguration 的请求从进入队列到开始执行之间的等待时间 90 分位数。APF 成功调度并处理的请求 QPSreq/s每个 FlowSchema 以及对应 PriorityLevelConfiguration 成功调度并处理的请求QPS。APF 拒绝请求 QPSreq/s每个 FlowSchema 以及对应 PriorityLevelConfiguration 中因超出并发限制或队列容量而被拒绝的请求QPS。
etcd 监控
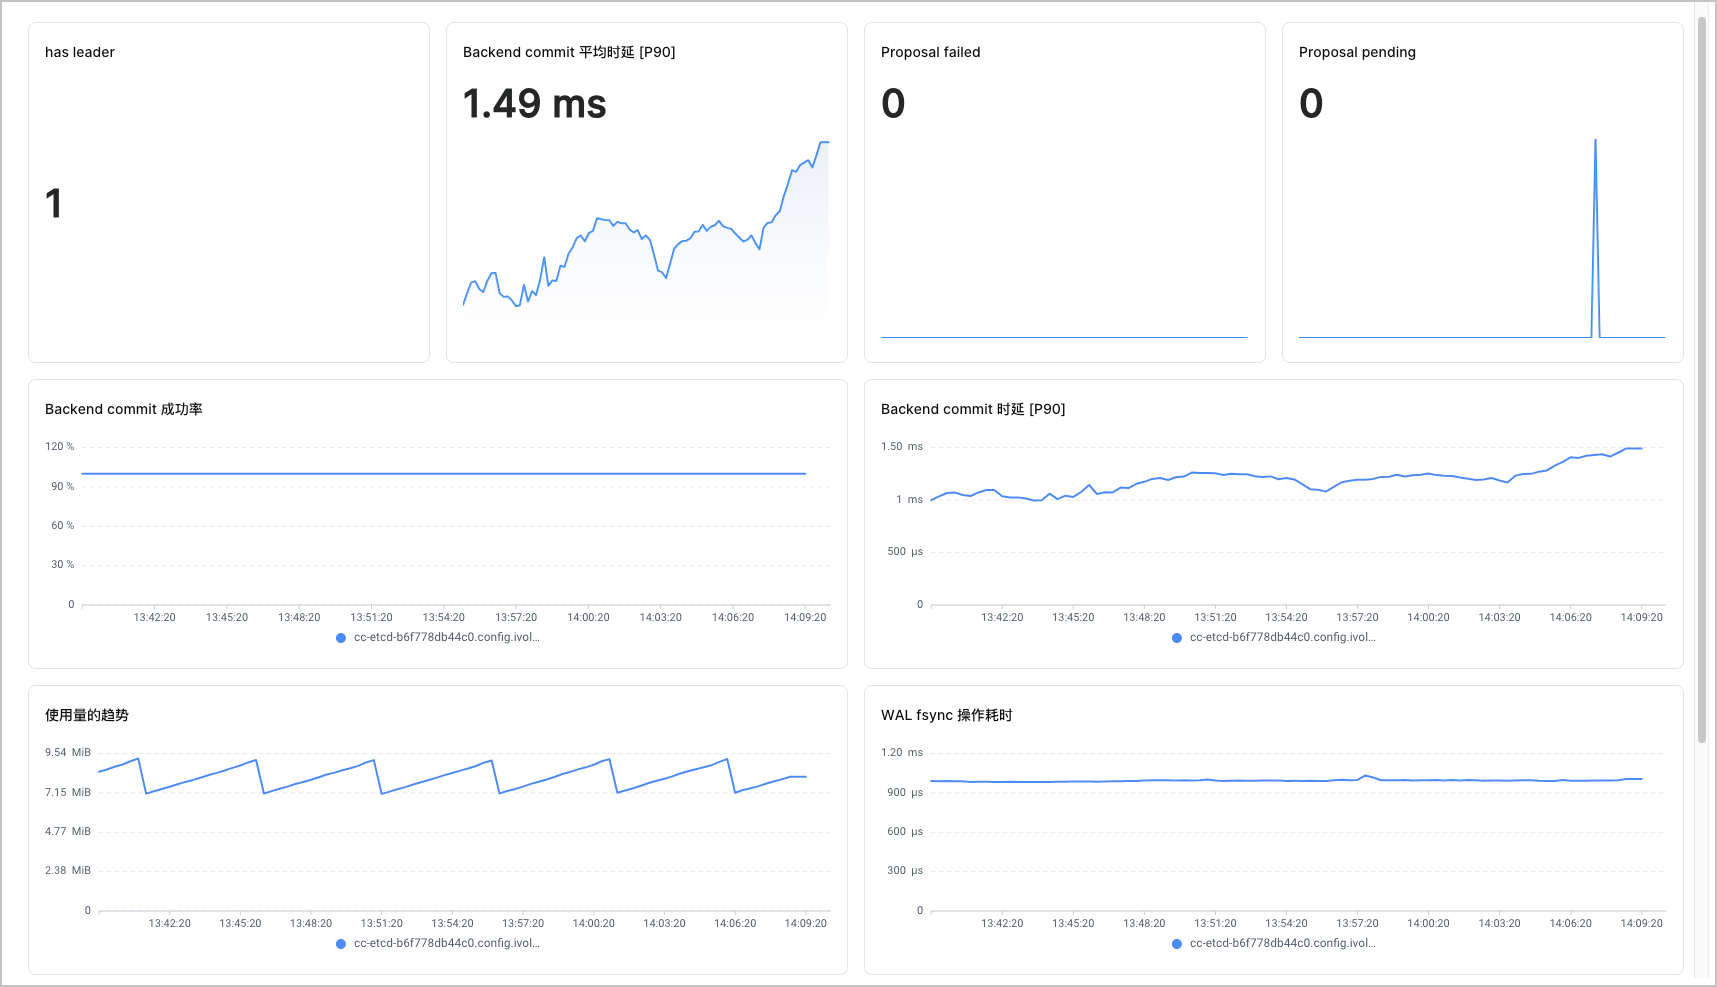
配置控制平面组件监控后,您可以查看控制面组件的指标大盘。设置查询的时间段,并指定刷新方式(手动刷新、自动刷新)。
- 在集群管理页面的左侧导航栏中,选择 监控中心 > 监控看板。
- 在左侧看板列表中选择 核心组件监控 > etcd 监控,即可查看监控看板。
-
kube-scheduler 监控
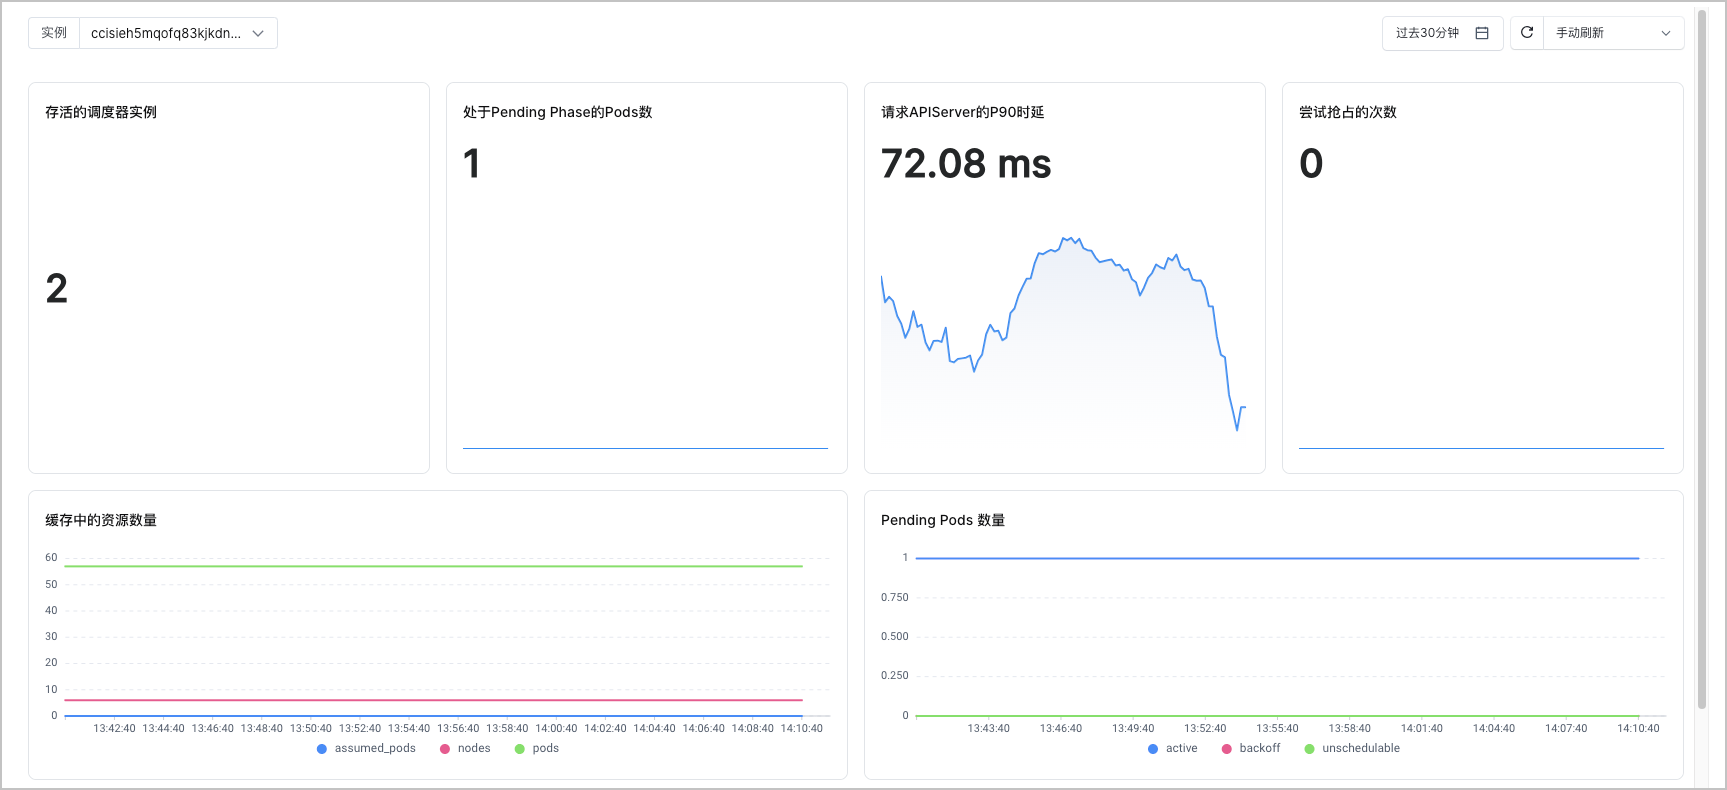
配置控制平面组件监控后,您可以查看控制面组件的指标大盘。设置查询的时间段,选择查询的实例,并指定刷新方式(手动刷新、自动刷新)。
- 在集群管理页面的左侧导航栏中,选择 监控中心 > 监控看板。
- 在左侧看板列表中选择 核心组件监控 > kube-scheduler 监控,即可查看监控看板。
-
cluster-autoscaler 监控
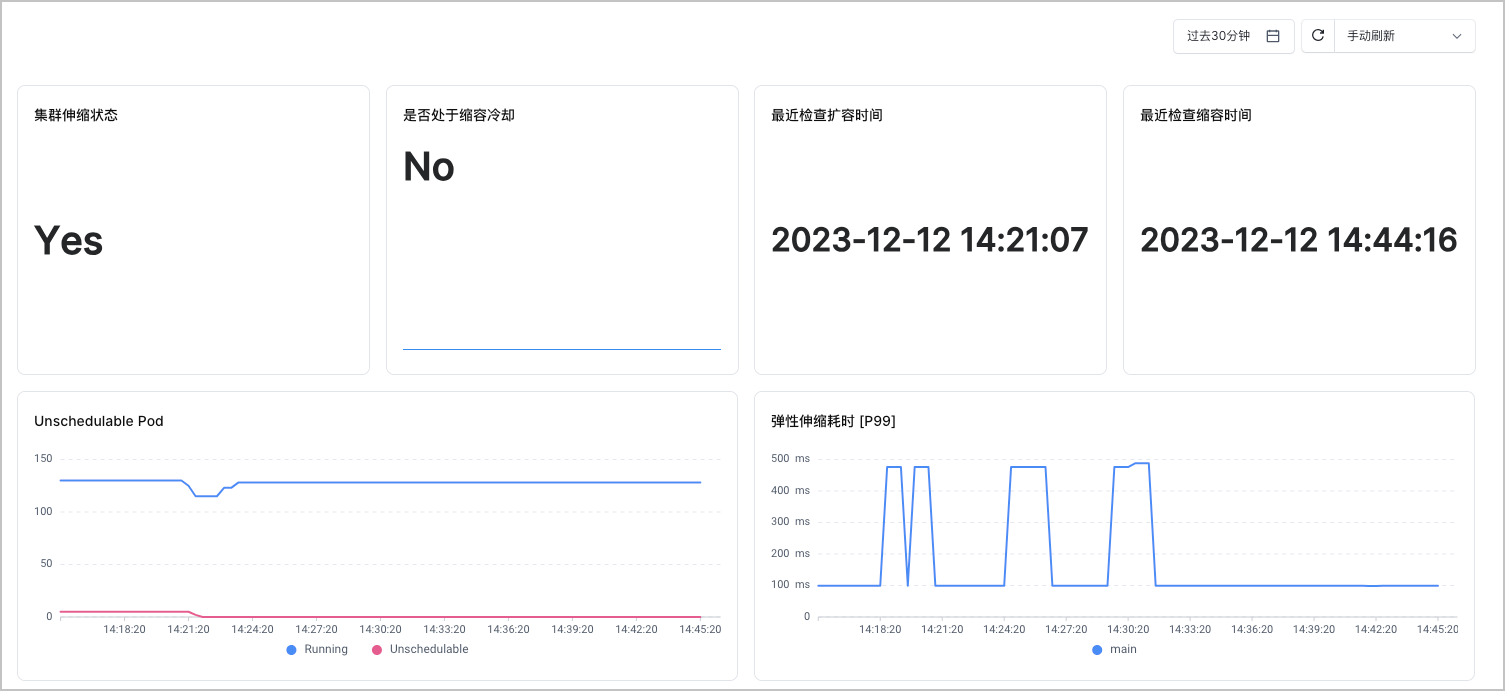
配置控制平面组件监控后,您可以查看控制面组件的指标大盘。设置查询的时间段,选择查询的实例,并指定刷新方式(手动刷新、自动刷新)。
- 在集群管理页面的左侧导航栏中,选择 监控中心 > 监控看板。
- 在左侧看板列表中选择 核心组件监控 > cluster-autoscaler 监控,即可查看监控看板。
-
kube-controller-manager 监控
配置控制平面组件监控后,您可以查看控制面组件的指标大盘。设置查询请求的分位数(quantile)、时间段,并指定刷新方式(手动刷新、自动刷新)。
- 在集群管理页面的左侧导航栏中,选择 监控中心 > 监控看板。
- 在左侧看板列表中选择 核心组件监控 > kube-controller-manager 监控,即可查看监控看板。
-
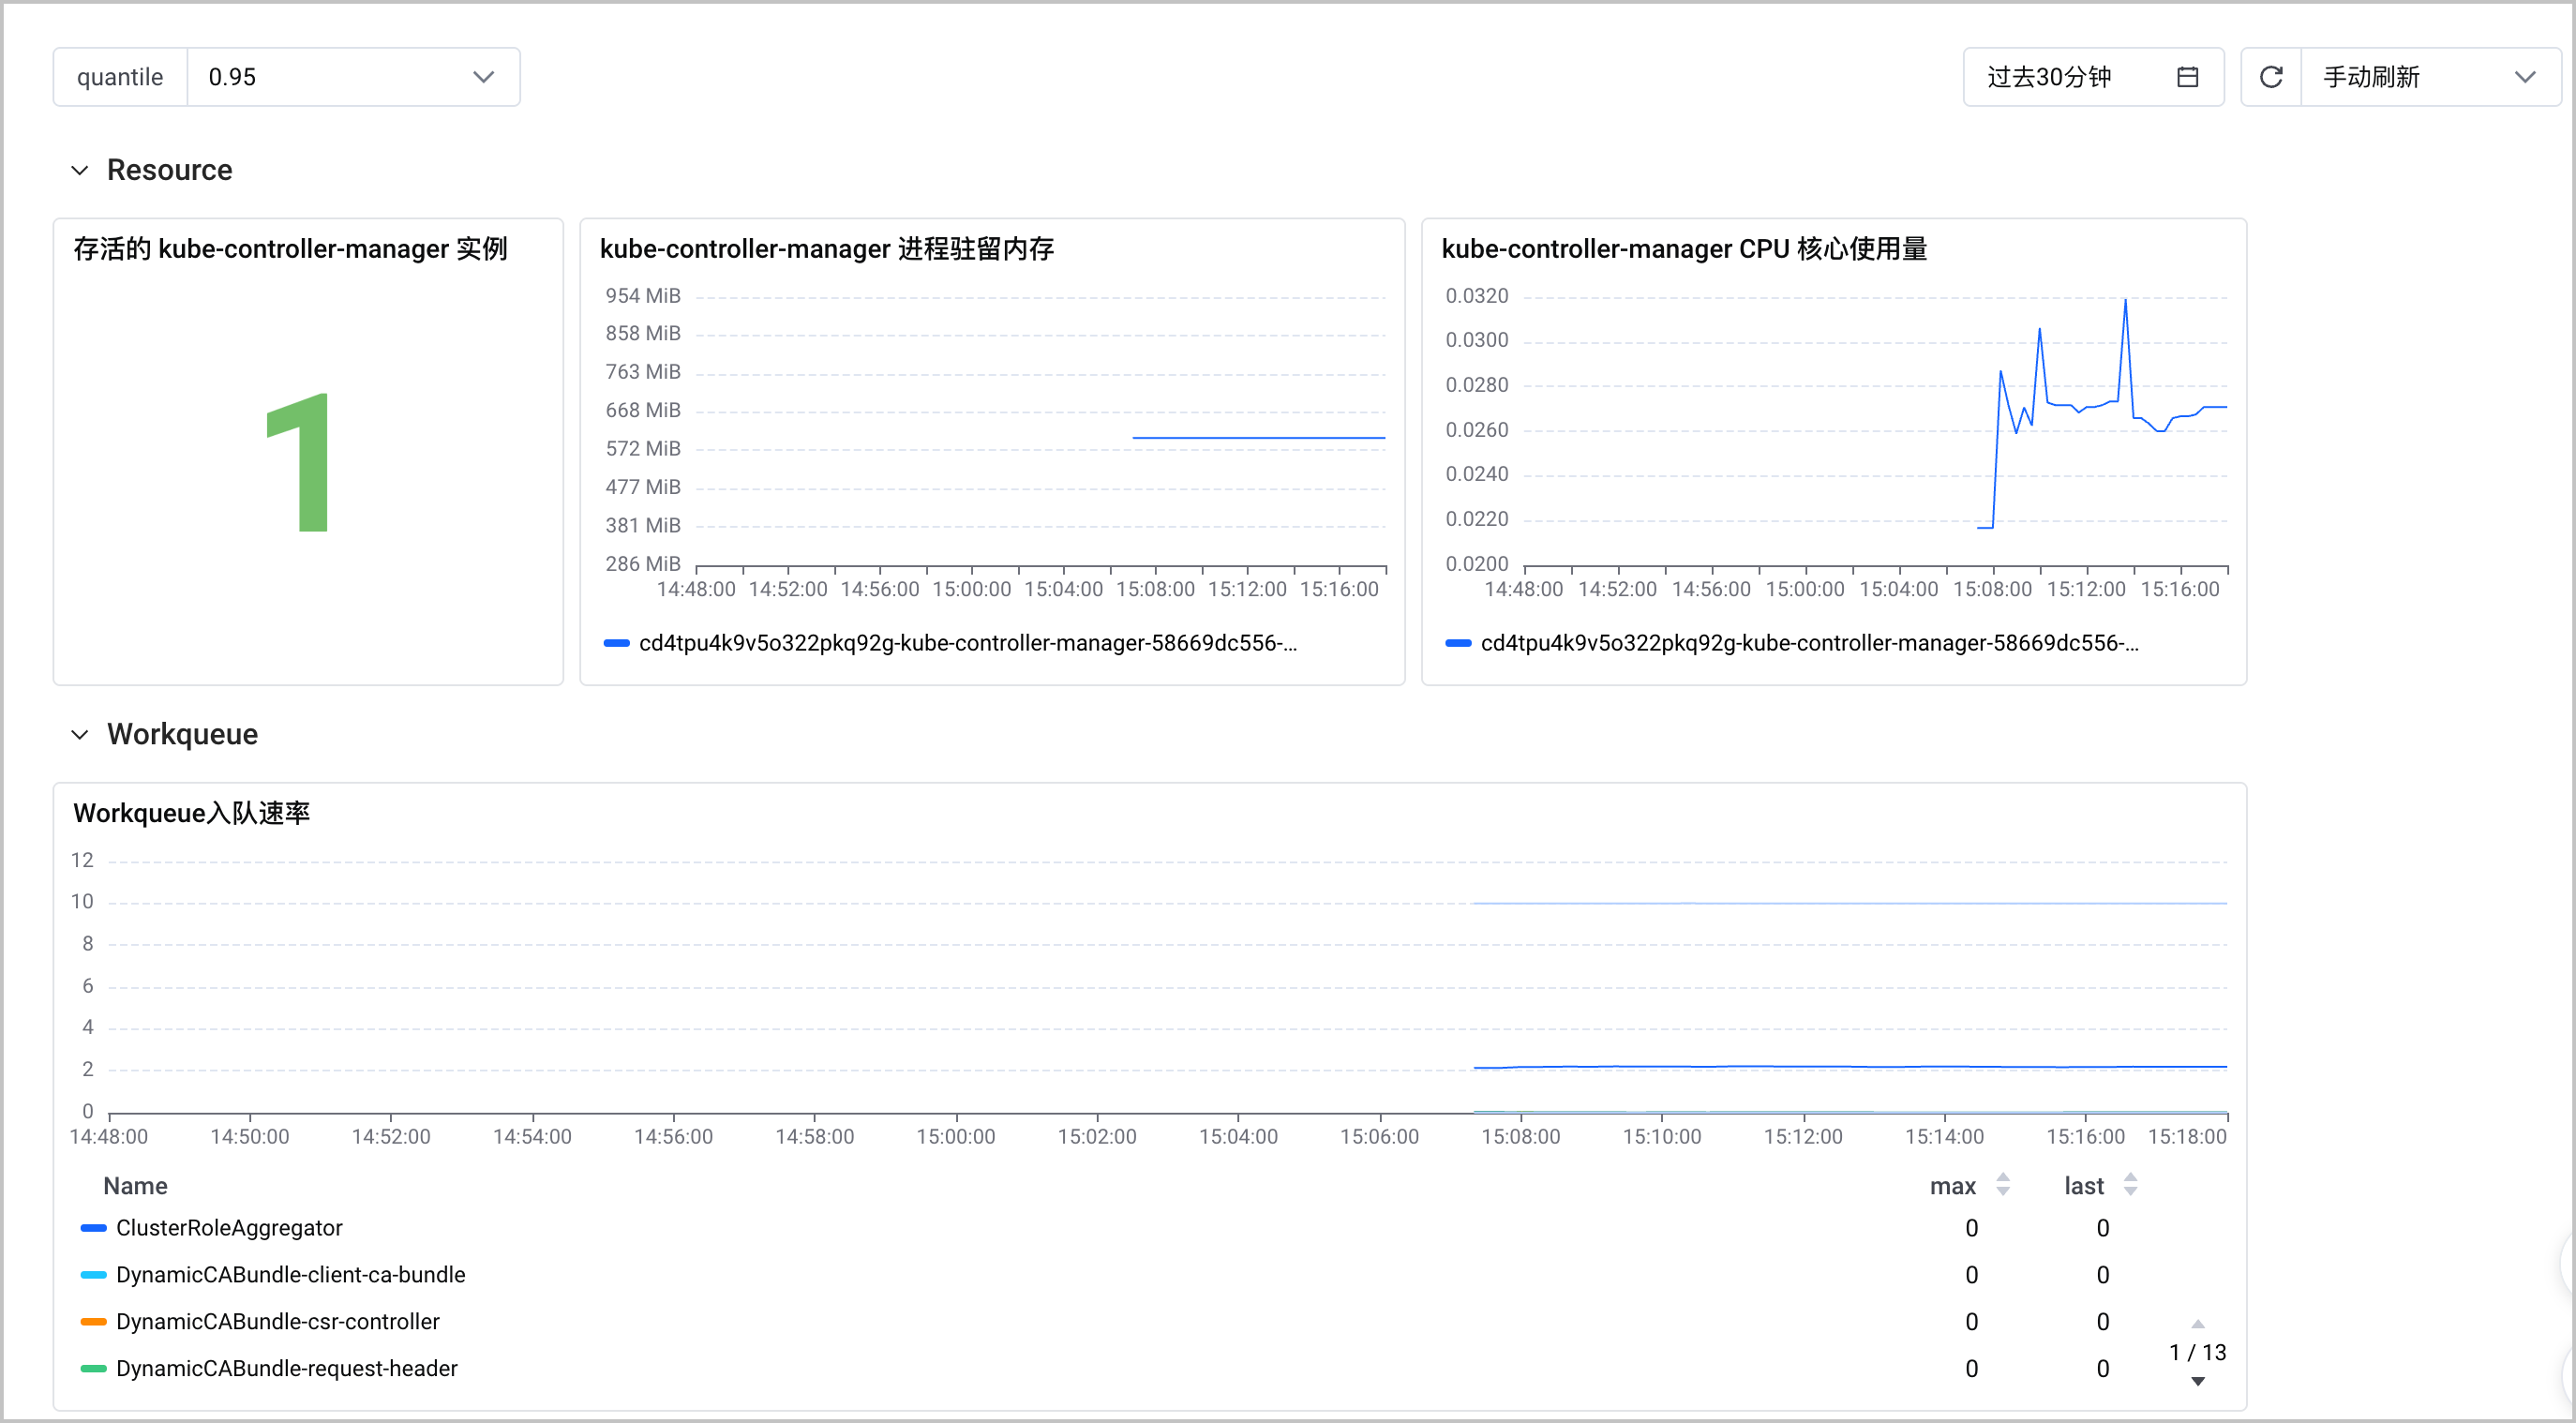
- kube-controller-manager 监控看板主要分为 3 个部分,分别面向 Resource(资源用量)、Workqueue(队列)和 Kube API。详细的图表说明,如下表所示。
说明
- 图表名称单位图表说明Resource(资源用量)存活的 kube-controller-manager 实例个kube-controller-manager 组件的健康实例数量。
- 正常情况下,集群中 kube-controller-manager 组件的实例数应该为 1 个,少数大规模的集群拥有 2 个实例。
- 如果实例数异常(不为 1 或 2,或实例数为 0),代表集群中 kube-controller-manager 实例异常。
说明kube-controller-manager 进程驻留内存MiBkube-controller-manager 组件的常驻内存使用量。- 正常情况下,该值仅会围绕一个 “基线值” 小幅波动,无持续上涨或突发峰值。仅在集群大规模操作(如批量创建 Pod/Service、节点扩缩容)时短暂上升,操作结束后回落至基线。
- 如果出现内存持续上涨或突发峰值等,代表 kube-controller-manager 实例异常。
kube-controller-manager CPU 核心使用量毫核kube-controller-manager 组件的 CPU 使用率。- 正常情况下,该值仅会围绕一个 “基线值” 小幅波动,无持续高占用或突发峰值。仅在集群大规模操作(如批量创建 Pod/Service、节点扩缩容)时短暂上升,操作结束后回落至基线。
- 如果出现 CPU 持续高占用(> 基线 2 倍且不回落)或 CPU 使用率突发尖刺等,代表 kube-controller-manager 实例异常。
Workqueue(队列)Workqueue 入队速率个kube-controller-manager 组件每个控制器(如节点、Service、端点控制器)在单位时间内的新增任务数量。- 正常情况下,所有队列的速率值应围绕基线波动,仅在集群操作(如批量创建 Pod/Service、节点扩缩容)时短暂上升,操作结束后回落至基线。
- 如果出现单一队列速率持续冲高、多队列速率同时飙升或某核心队列速率长期为 0 等,代表 kube-controller-manager 实例异常。
Workqueue 深度个kube-controller-manager 组件每个控制器(如节点、Service、端点控制器)各工作队列的平均深度(即队列中待处理的任务数)。- 正常情况下,所有队列的均值应较为稳定,且在较低水平。仅在集群操作(如批量创建 Pod/Service、节点扩缩容)时短暂上升,操作结束后回落至稳定均值。
- 如果出现队列深度长时间保持在较高水平,表明 Controller 不能及时处理队列中的任务,导致任务堆积。
Workqueue 处理时延秒kube-controller-manager 组件每个控制器(如节点、Service、端点控制器)各工作队列中,任务在队列中等待时长的分位数(例如配置quantile为0.9时,代表 90% 任务的等待时长)。说明- Workqueue 深度 异常通常伴随 Workqueue 处理时延 分位值升高(任务积压,导致等待时长变长)。两个指标可以进行关联分析。
- 建议关注 0.9 分位(反映 90% 任务的等待时长)和 0.99 分位(暴露长尾延迟问题)。
Kube API请求 APIServer 的 QPS个kube-controller-manager 组件在单位时间内向 API Server 发起的 HTTP 请求数量。基于请求方法(Method)和响应码(Code)进行分析。- 正常情况下,GET 请求方法的占比应该大于 80%,且响应码中 99% 以上为 2xx(如 200/201),不存在 5xx 错误。
- 如果出现 4xx 错误或 5xx 错误,表示 kube-controller-manager 组件的资源消耗增加或控制器逻辑异常。
请求 APIServer 的延迟分布秒kube-controller-manager 组件调用 API Server 的请求耗时分位数(例如配置quantile为0.9时,代表 90% 请求的耗时)。说明建议关注 0.9 分位(反映 90% 任务的请求的耗时)和 0.99 分位(暴露极端慢请求问题)。
查看指标
- 如需查询集群中的已接入/未接入指标,或查询指标的具体含义,请参见 指标查询。
- 支持使用托管 Prometheus 的 Explore 功能来快速查询和展示指标数据。详情请参见 指标查询。
最近更新时间:2026.08.19 11:38:05
这个页面对您有帮助吗?
有用
有用
无用
无用