容器服务
容器服务
容器服务


文档指南
请输入


容器服务 VKE
产品动态
Kubernetes 版本发布记录
组件发布记录
监控组件
DNS 组件
GPU 组件
Sandbox 组件
安全公告
产品公告
历史公告
用户指南
集群
节点池
授权
网络
容器网络
服务(Service)
路由(Ingress)
APIG Ingress
ALB Ingress
自定义转发规则配置示例
CLB Ingress
Nginx Ingress
Gateway API
工作负载
存储
数据管理中心(DMC)
对象存储(TOS)
FSX 访问方式
文件存储(NAS)
FSX 访问方式
弹性文件存储(EFS)
文件存储(vePFS)
FSX 访问方式
vePFS Client 访问方式
NFS 访问方式
大数据文件存储(CloudFS)
弹性伸缩
工作负载弹性伸缩
事件驱动伸缩(KEDA)
组件管理
网络组件
监控组件
DNS 组件
GPU 组件
Sandbox 组件
异构计算
调度管理
可观测性
基础观测
诊断与巡检
最佳实践
网络
可观测性
安全合规
API 参考
集群管理
节点池管理
组件管理
机型镜像管理
巡检诊断
弹性容器实例
附录
开发指南
常见问题
通用 FAQ
集群 FAQ
集群管理
集群升级
节点与节点池 FAQ
授权 FAQ
工作负载 FAQ
服务与路由 FAQ
存储 FAQ
弹性伸缩 FAQ
调度 FAQ
可观测性 FAQ
配额 FAQ
组件 FAQ
容器镜像 FAQ
AI 云原生
推理套件
Helm 模板 AI 应用
Deepseek 实践
Qwen 实践
最佳实践
MiniMax 模型部署
Qwen 模型部署
弹性容器实例 VCI
最新动态
用户指南
虚拟节点
VKE 集群使用虚拟节点
自建/跨云集群使用虚拟节点
创建 VCI 实例
VCI Agent Sandbox
安全合规
- 文档首页
 容器服务容器服务 VKE用户指南可观测性基础观测其他观测镜像加速观测
 复制全文
 下载 pdf
镜像加速观测
 文档反馈
 问问助手
容器服务支持 P2P 镜像加速和镜像懒加载(Nydus)功能,大幅提升镜像拉取速度,缩短应用部署时间。同时,支持对镜像加速功能进行监控。本文为您介绍如何配置镜像加速功能观测。
背景信息
容器服务中的镜像加速功能,主要包括:
- P2P 镜像加速:利用节点的内网带宽资源,在节点之间分发镜像,减少对镜像仓库的压力,大幅提升镜像拉取速度,缩短应用部署时间。方案详情,请参见 P2P 镜像加速概述。
- 镜像懒加载(Nydus):集群通过 Nydus 实现镜像懒加载,提升创建 Pod 过程的镜像拉取速度。方案详情,请参见 容器镜像懒加载方案。
前提条件
- 已开启云原生观测功能,详情请参见 开启观测。
- 已开启容器服务观测功能,详情请参见 容器服务观测。
- 监控 P2P 镜像加速功能时,需要:
- 已开启 P2P 镜像加速功能,并安装 p2p-accelerator 组件,详情请参见 配置 P2P 镜像加速。
- prometheus-agent 组件升级到 v2.2.0 及以上版本,详情请参见 组件发布记录。
- 监控镜像懒加载(Nydus)功能时,需要:
- 已安装 image-accelerator 组件,详情请参见 image-accelerator。
- prometheus-agent 组件升级到 v2.0.4 及以上版本,详情请参见 组件发布记录。
- 已开启懒加载功能,详情请参见 容器镜像懒加载方案。
- 如需观测 image-accelerator 组件的 Webhook 与 CPU/MEM 使用情况,请将 image-accelerator 组件升级到 v1.0.6 及以上版本。
操作步骤
步骤一:开启观测
- 登录 容器服务控制台。
- 在左侧导航栏单击 集群,找到目标集群,单击集群名称。
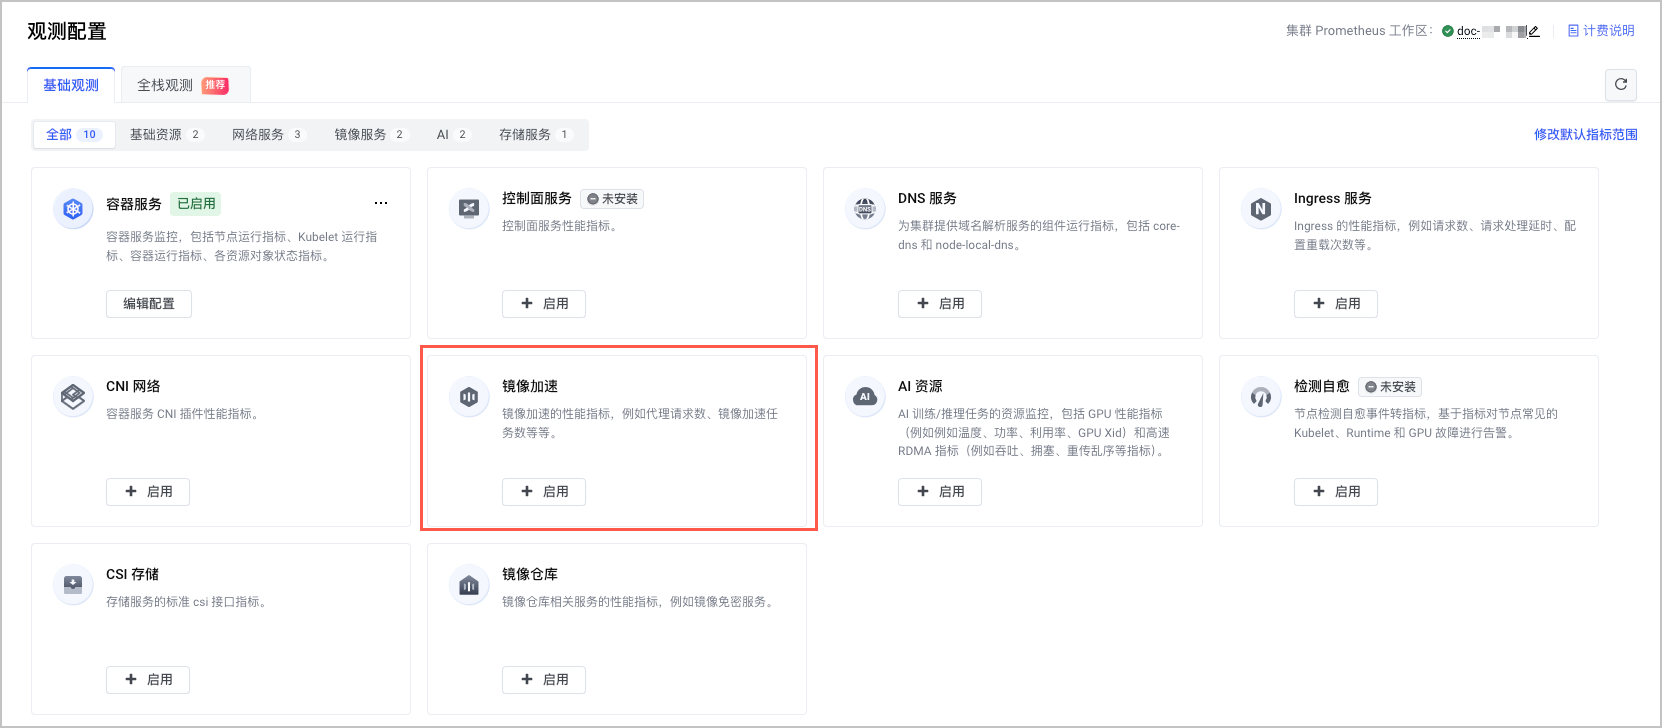
- 在集群管理页面的左侧导航栏中,单击 观测配置,并选择 基础观测 页签。
- 选择 镜像加速 卡片,单击 启用,开启集群镜像加速观测。
-
- 系统自动检查开启观测所需的条件。包括:工作区配置、组件状态等。
-
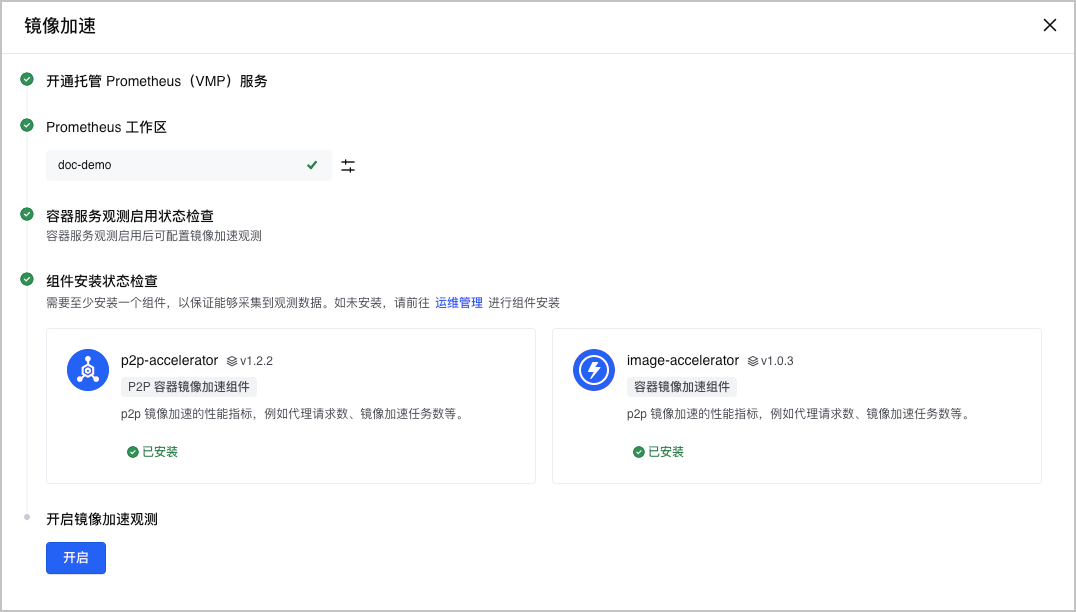
- 单击 开启,开启镜像加速观测。
步骤二:配置采集规则
镜像加速观测功能开启后,您可以配置采集规则,选择需要采集的目标组件、具体指标项及采集间隔。可以根据实际需求丢弃一些不用的指标。
- 在集群管理页面的左侧导航栏中,单击 观测配置,并选择 基础观测 页签。
- 选择 镜像加速 卡片,单击 编辑配置 并选择 指标 页签,配置采集规则,并选择具体的采集指标。
- 在组件列表 操作 列,单击开关,开启或关闭组件的采集规则。当关闭组件的采集规则时,系统不会采该集组件的所有指标。
-
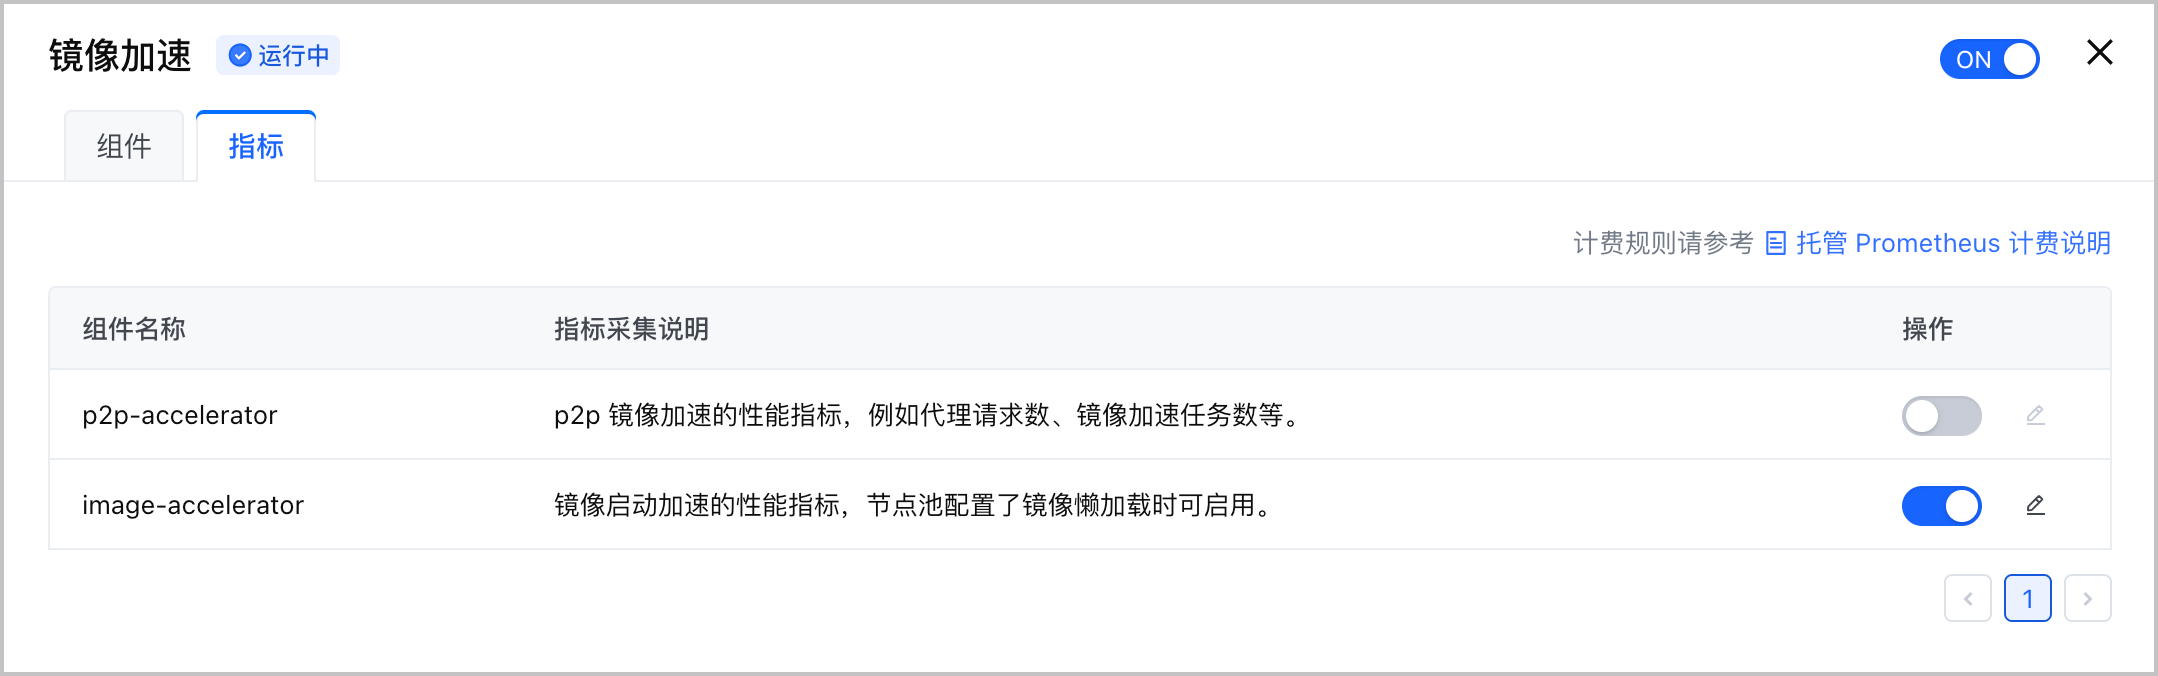
- 单击组件列表 操作 列中的
 ,支持选择或丢弃组件的具体指标、面向该组件的采集间隔和指标 Relabel。
- 在 采集间隔 中,选择该组件指标的采集间隔。不同组件支持的采集间隔不同。
- 在 指标列表 中,勾选指标,则采集该指标。取消勾选,则丢弃该指标。单击 全部、基础指标 或 其他指标 页签,允许基于指标类型对指标项进行筛选。
-
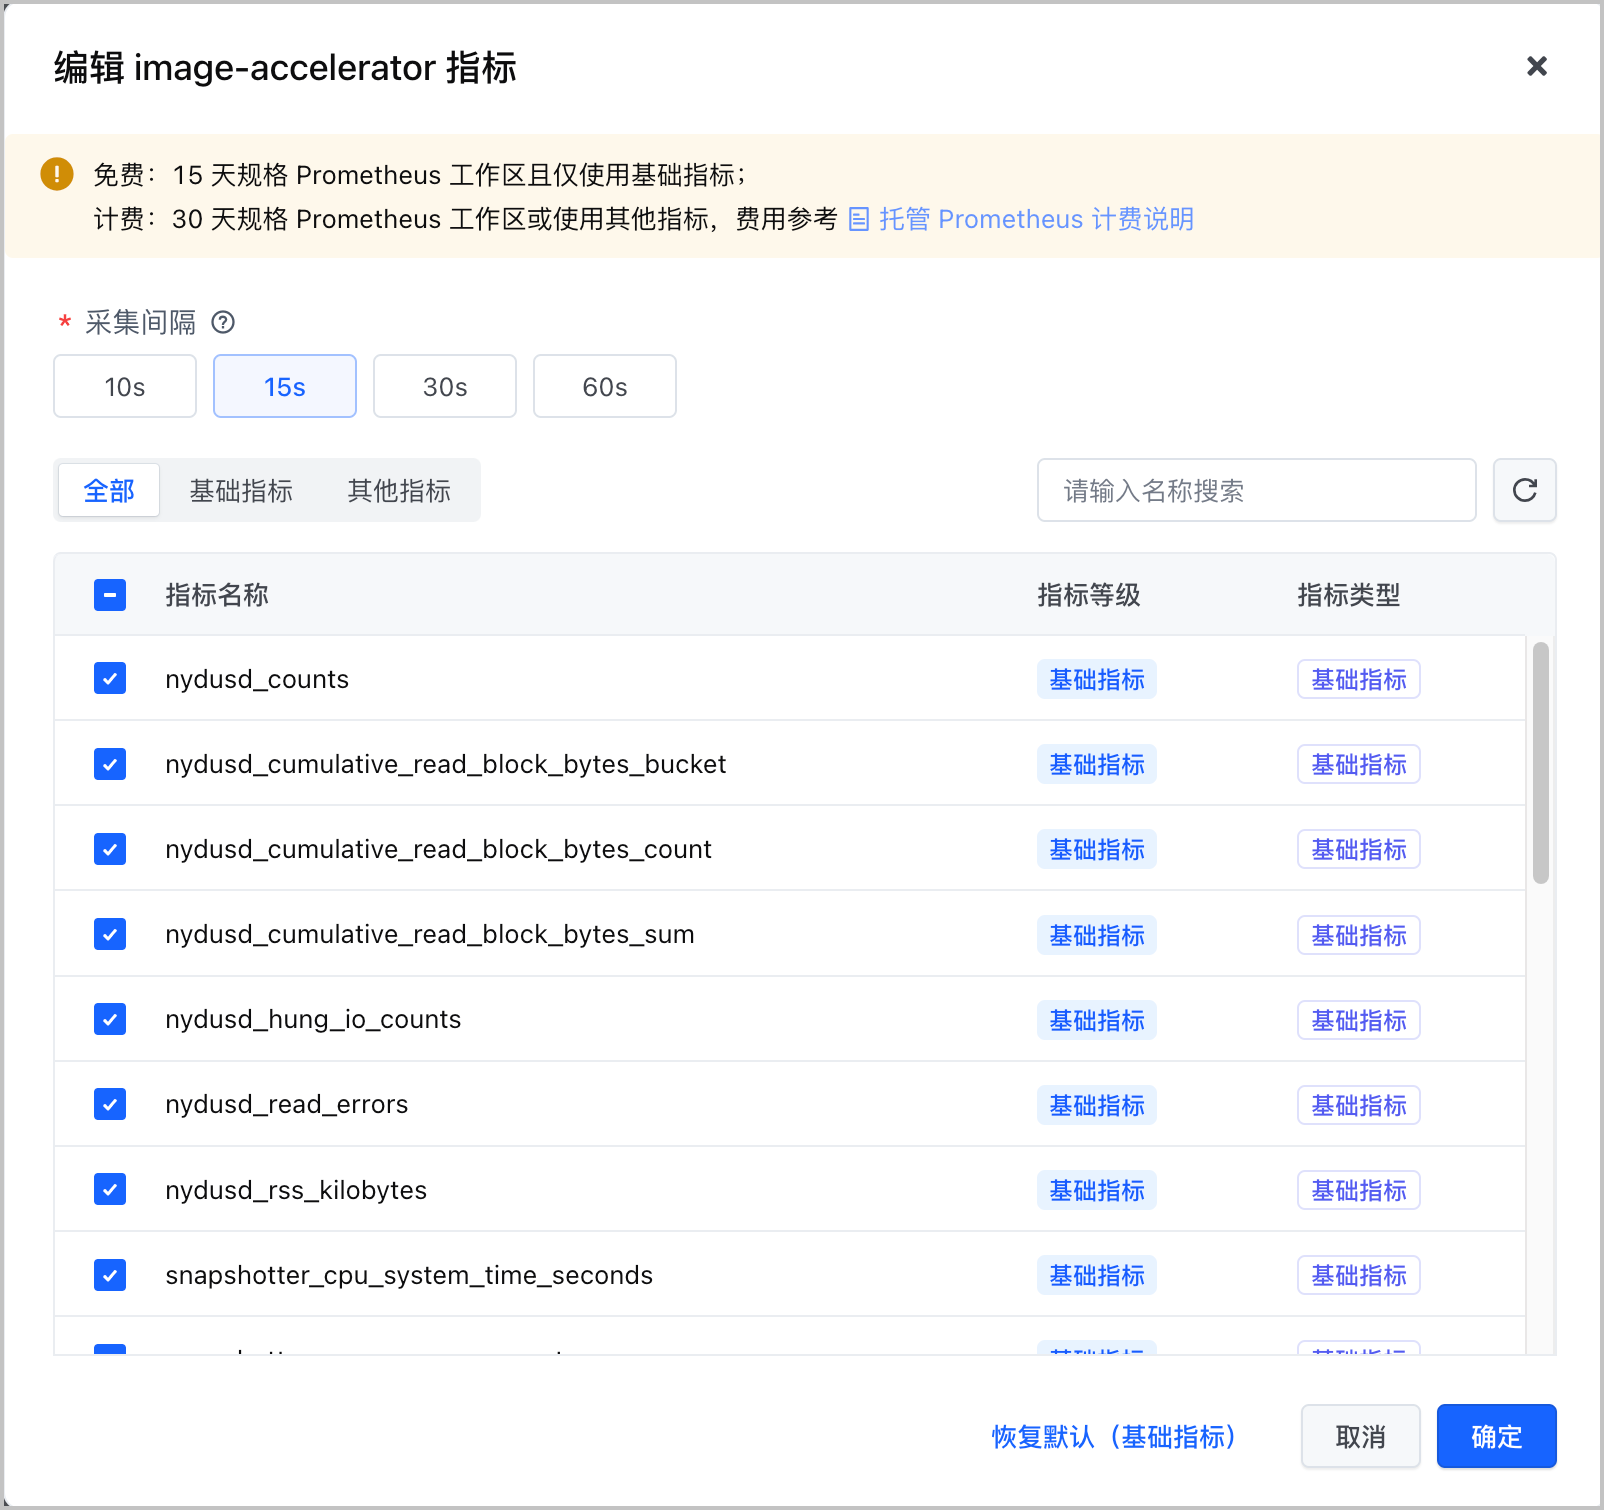
说明
- 调整指标采集间隔的影响如下,请按需调整:
- 减小采集间隔:增加单位时间内上报的指标数量,提升监控精度,但 VMP 标准版工作区的费用会增加。
- 增加采集间隔:减少单位时间内上报的指标数量,降低 VMP 标准版工作区的费用,但监控精度会降低。
- 云产品的指标类型分为 基础指标 和 其他指标,不同类型指标的计费方式不同,详情请参见 托管 Prometheus 计费方式。
- 在 metricRelabelings 中,单击 添加规则,配置指标 Relabel 规则。允许在指标完成采集后、写入存储前,对每条指标的标签执行改写操作。常见用途包括修改标签值、创建新标签或将源标签的值复制到其他标签,便于在查询时统一标签口径。更多详情介绍,请参见 指标 Relabel。
-
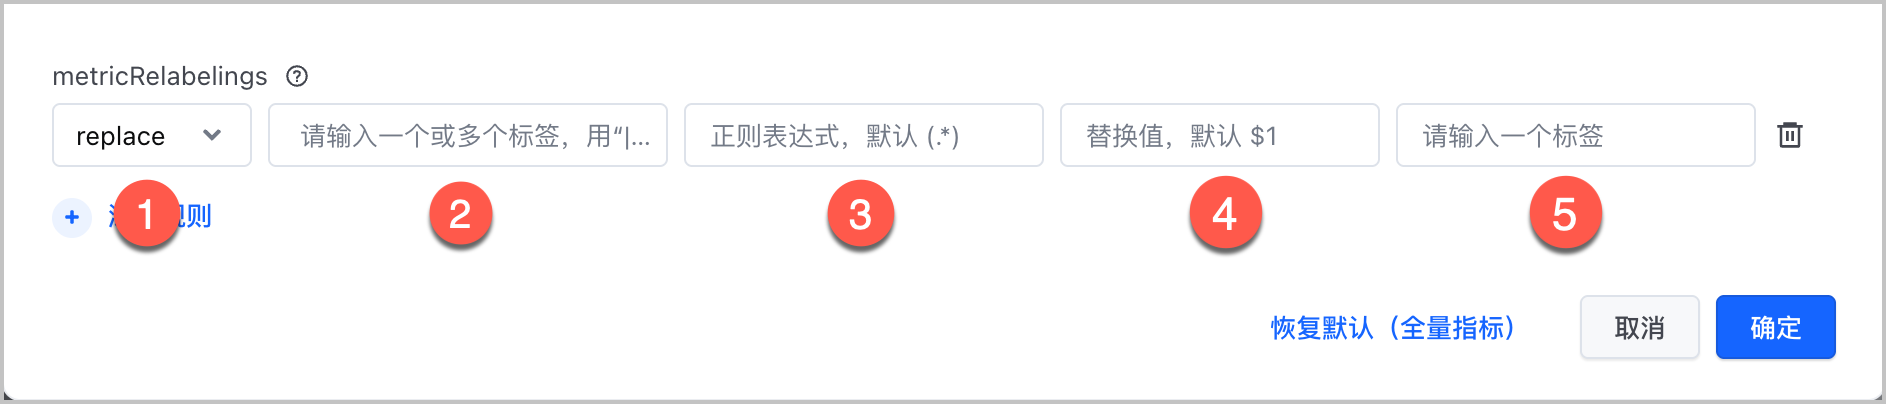
- 序号功能对应 YAML 字段说明①操作类型action对指标执行的操作类型,当前仅支持 replace。表示系统读取sourceLabels指定的源标签值,使用regex进行匹配,并将replacement生成的结果写入targetLabel。
- 如果targetLabel已存在,则覆盖其原有值。
- 如果targetLabel不存在,则创建该标签。
- 如果targetLabel与某个源标签名称相同,则直接更新该标签的值。
②源标签sourceLabels指定一个或多个来源标签,多个标签之间用|分隔。配置多个源标签时,系统按顺序组合各标签的值,并对组合结果应用正则表达式。③正则表达式regex用于匹配源标签值的正则表达式。- 默认为(.*),表示匹配任意值。
- 支持使用捕获组,如(.+)提取部分内容。
④替换值replacement匹配成功后写入目标标签的值。- 默认为$1,表示取正则第一个捕获组的内容。
- 支持填入固定字符串。
⑤目标标签targetLabel将处理结果写入的目标标签名称。- 若目标标签已存在,则覆盖其原有值。
- 若目标标签不存在,则新增该标签。
- 单击 确定,完成配置。
步骤三:配置告警
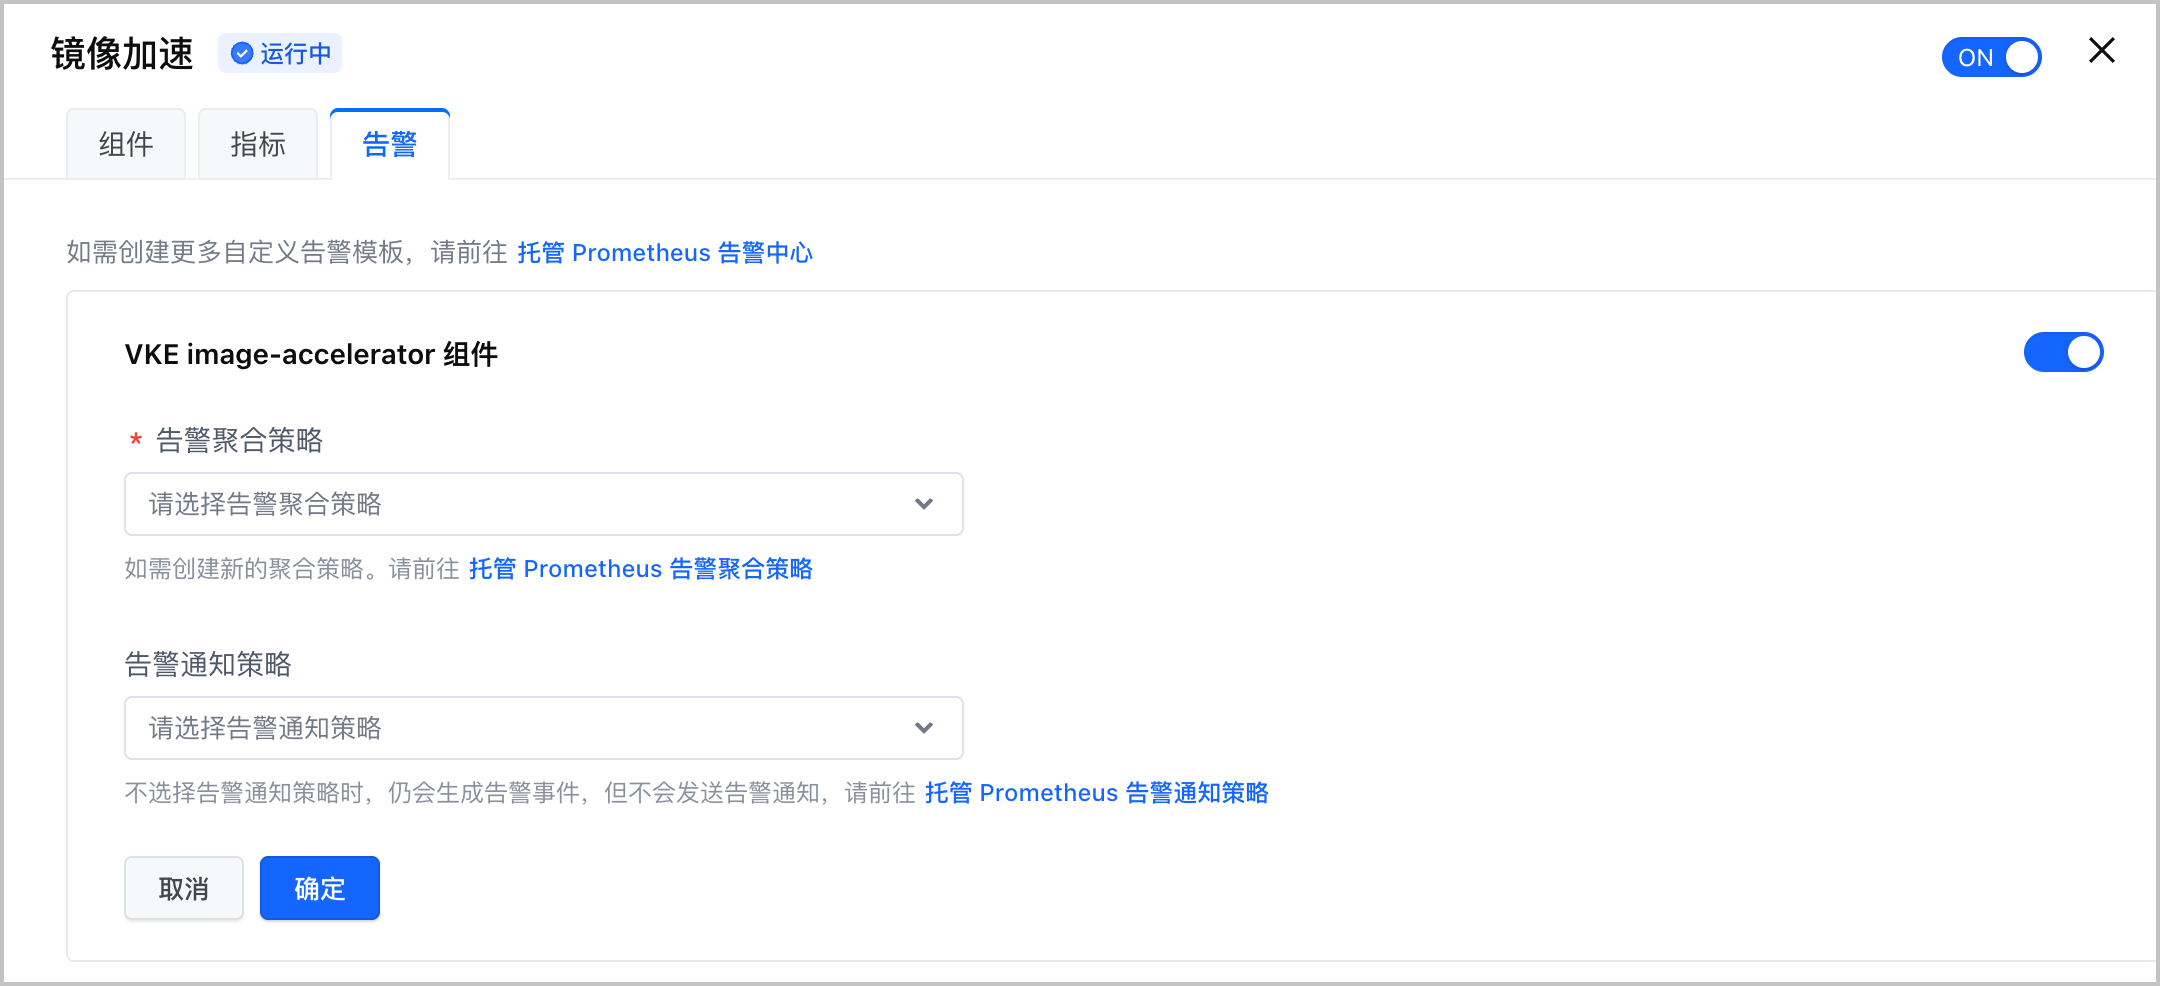
您可以基于预置的告警模板,快速完成镜像加速功能的告警配置。
- 在集群管理页面的左侧导航栏中,单击 观测配置。
- 选择 镜像加速 卡片,单击 编辑配置 并选择 告警 页签,配置告警的相关参数。
-
-
说明
- 除了直接使用预置告警模板配置告警规则,您可以自定义模板中的配置,或直接使用 PromQL 语句配置告警规则。详情请参见 告警配置概述。
- 预置告警规则模板的详情,包括规则说明、PromQL 配置和常见告警处理流程。请参见 预置告警模板。
观测看板
说明
镜像加速监控
您可以在容器服务控制台中,查看预置的监控大盘。
- 在集群管理页面的左侧导航栏中,选择 监控中心 > 监控看板。
- 在左侧看板列表中选择 镜像加速服务监控 > 镜像加速监控,即可查看监控看板。
-
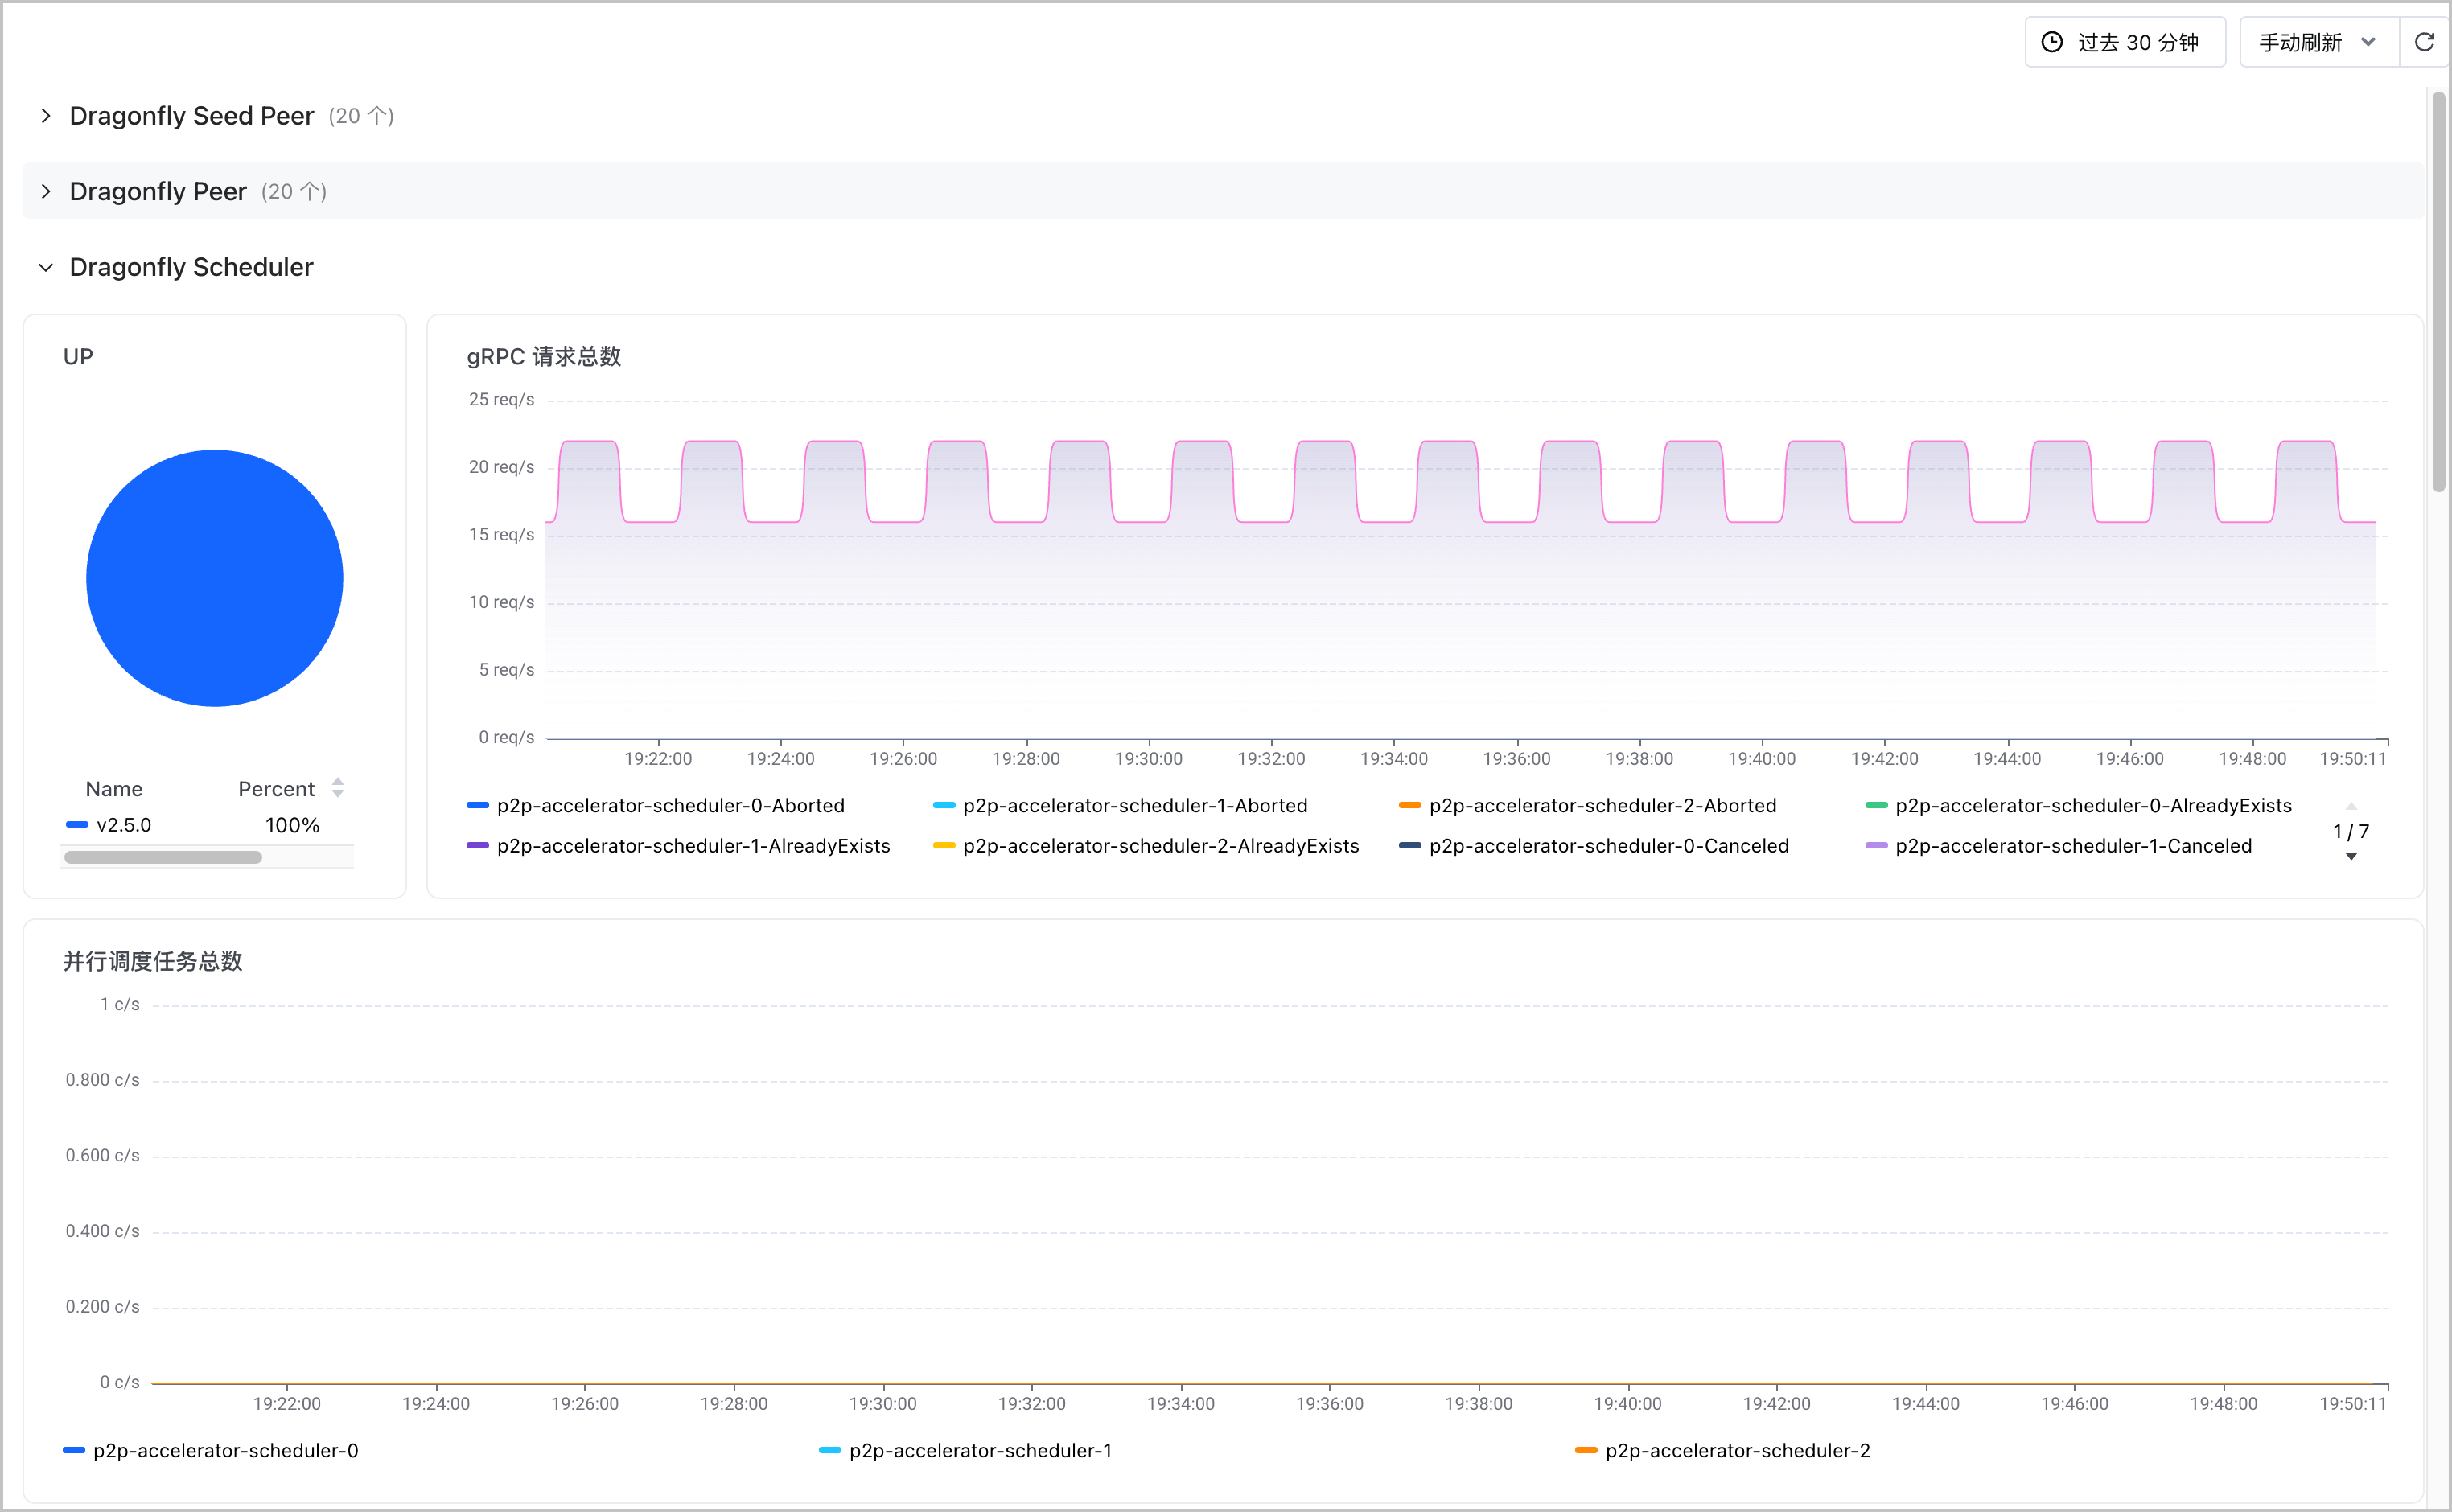
- 镜像加速监控看板详细的图表说明,如下表所示。
说明
- 图表名称单位图表说明Dragonfly Seed PeerUP个统计当前时刻按版本汇总的 Seed Peer 实例数量,反映各版本实例的存活与部署规模。
- 正常情况下,实例数量保持稳定,并与预期部署规模及版本分布一致。
- 如果实例数量异常降低或降为 0,通常代表部分或全部实例不可用,或监控采集异常;建议检查 Pod 运行状态、组件部署副本、版本变更和指标采集目标。
流量分布(1小时)字节统计 Seed Peer 在过去 1 小时按下载类型汇总的流量累计增量,反映不同来源或传输类型的流量分布。- 正常情况下,累计流量随实际下载负载平稳变化,各类型占比与业务访问模式相符。
- 如果累计流量或类型分布异常突增、突降或偏斜,通常代表下载负载突变、P2P 命中路径变化或回源流量异常;建议检查业务发布节奏、下载类型标签、P2P 链路和源站访问情况。
磁盘使用空间字节统计当前时刻按 Pod 汇总的 Seed Peer 磁盘总空间及由总空间减已用空间得到的可用空间,反映本地缓存存储容量与使用压力。- 正常情况下,磁盘总空间保持稳定,可用空间充足且随缓存写入和回收平稳变化。
- 如果可用空间异常降低或磁盘总空间异常变化,通常代表缓存持续增长、回收不及时或挂载容量发生变化;建议检查缓存目录占用、清理策略、磁盘挂载和 Pod 日志。
下载带宽bit/s基于过去 5 分钟采样计算 Seed Peer 按 Pod 和下载类型汇总的瞬时下载速率并换算为 bit/s,反映下载链路带宽负载。- 正常情况下,下载带宽随业务负载平稳变化,不同下载类型的变化与实际任务量相符。
- 如果下载带宽异常升高、降低或剧烈波动,通常代表下载负载突变、链路拥塞、P2P 传输异常或指标采集不连续;建议检查下载任务量、网络带宽、对端连接和组件日志。
上传带宽bit/s基于过去 5 分钟采样计算 Seed Peer 按 Pod 汇总的瞬时上传速率并换算为 bit/s,反映对外提供数据的带宽负载。- 正常情况下,上传带宽随下游请求量平稳变化,并与节点承担的分发任务相符。
- 如果上传带宽异常升高、降低或剧烈波动,通常代表下游请求突变、链路拥塞、数据分发异常或指标采集不连续;建议检查分发任务量、网络带宽、对端连接和组件日志。
并行下载任务总数个统计当前时刻按 Pod 汇总的 Seed Peer 并行下载任务数量,反映实时下载并发压力。- 正常情况下,并行任务数量随业务负载平稳变化,且不会持续累积。
- 如果并行任务数量异常升高或长时间不回落,通常代表请求突增、下载变慢或任务阻塞;建议检查下载队列、网络与磁盘性能、上游服务和组件日志。
小文件下载耗时(0-64MiB)ms基于过去 5 分钟采样,统计 Seed Peer 对 0~64 MiB 文件按任务大小分级的下载耗时 P50、P95 和 P99 分位值,反映小文件下载时延分布。- 正常情况下,各分位耗时保持平稳,高分位与中位数之间无持续扩大。
- 如果下载耗时异常升高或高分位持续恶化,通常代表网络拥塞、对端响应变慢、磁盘 I/O 瓶颈或任务排队;建议检查分位曲线、任务大小分级、网络与磁盘性能和组件日志。
回源小文件下载耗时(0-64MiB)ms基于过去 5 分钟采样,统计 Seed Peer 对 0~64 MiB 文件按任务大小分级的回源请求耗时 P50、P95 和 P99 分位值,反映源站下载时延分布。- 正常情况下,各分位回源耗时保持平稳,高分位与中位数之间无持续扩大。
- 如果回源耗时异常升高或高分位持续恶化,通常代表源站响应变慢、回源网络拥塞、磁盘 I/O 瓶颈或请求排队;建议检查源站健康状态、回源链路、任务大小分级和组件日志。
下载任务总数个统计 Seed Peer 在过去 1 分钟按 Pod 汇总的下载任务累计增量,反映短周期下载任务负载。- 正常情况下,任务增量随业务下载量平稳变化,并与实际镜像拉取活动相符。
- 如果任务增量异常升高、降低或中断,通常代表业务负载突变、下载入口异常或指标采集异常;建议检查镜像拉取事件、Pod 请求分布、组件状态和采集链路。
下载任务失败总数个统计 Seed Peer 在过去 1 分钟按 Pod 汇总的下载任务失败累计增量,反映短周期下载失败情况。- 正常情况下,失败增量保持为 0 或处于较低且稳定的水平。
- 如果失败增量异常升高,通常代表网络、源站、对端节点、磁盘或任务处理链路出现故障;建议检查失败任务日志、网络连通性、源站与对端健康状态和磁盘空间。
代理请求任务总数个统计 Seed Peer 在过去 1 分钟按 Pod 汇总的代理请求任务累计增量,反映短周期代理请求负载。- 正常情况下,请求增量随业务访问量平稳变化,并与实际代理流量相符。
- 如果请求增量异常升高、降低或中断,通常代表业务访问突变、代理入口异常或指标采集异常;建议检查代理请求日志、客户端访问、Pod 状态和采集链路。
代理请求任务失败总数个统计 Seed Peer 在过去 1 分钟按 Pod 汇总的代理请求任务失败累计增量,反映短周期代理请求失败情况。- 正常情况下,失败增量保持为 0 或处于较低且稳定的水平。
- 如果失败增量异常升高,通常代表代理链路、上游服务、鉴权配置或网络连接出现故障;建议检查失败请求日志、上游可用性、代理配置和网络连通性。
预取任务总数个统计 Seed Peer 在过去 1 分钟按 Pod 汇总的预取任务累计增量,反映短周期预取负载。- 正常情况下,任务增量随预取计划平稳变化,并与实际预取活动相符。
- 如果任务增量异常升高、降低或中断,通常代表预取计划突变、任务下发异常或指标采集异常;建议检查预取配置、任务下发记录、Pod 状态和采集链路。
回源下载请求总数个统计 Seed Peer 在过去 1 分钟按 Pod 汇总的回源下载请求累计增量,反映短周期源站访问负载。- 正常情况下,请求增量随业务负载平稳变化,且与 P2P 未命中及回源策略相符。
- 如果请求增量异常升高、降低或中断,通常代表 P2P 命中率变化、业务请求突变、回源策略异常或指标采集异常;建议检查 P2P 命中情况、回源配置、源站访问日志和采集链路。
回源下载请求失败总数个统计 Seed Peer 在过去 1 分钟按 Pod 汇总的回源下载请求失败累计增量,反映短周期源站访问失败情况。- 正常情况下,失败增量保持为 0 或处于较低且稳定的水平。
- 如果失败增量异常升高,通常代表源站不可用、回源网络故障、鉴权失败或请求超时;建议检查源站健康状态、网络连通性、鉴权配置和失败请求日志。
Threads个统计当前时刻 Seed Peer 各进程的线程数量,反映进程线程资源使用情况。- 正常情况下,线程数量保持稳定,并随并发负载在合理范围内平稳变化。
- 如果线程数量异常升高、降低或持续增长,通常代表并发压力突增、线程泄漏、任务阻塞或进程异常;建议检查进程状态、线程栈、任务队列和组件日志。
CPU%基于过去 1 分钟采样计算 Seed Peer 各 Pod 的平均 CPU 使用率,反映组件计算资源负载。- 正常情况下,CPU 使用率随业务负载平稳变化,无持续高位或无故突变。
- 如果CPU 使用率异常升高、降低或剧烈波动,通常代表请求突增、计算热点、进程阻塞或实例异常;建议检查 Pod 负载、CPU 限额与节流、热点操作和组件日志。
Memory字节统计当前时刻 Seed Peer 各进程的常驻内存用量,反映组件实际占用的物理内存规模。- 正常情况下,内存用量保持稳定,并随业务负载在可控范围内变化。
- 如果内存用量异常升高或持续增长,通常代表缓存堆积、内存泄漏、任务积压或负载突增;建议检查 Pod 内存限额、进程内存分析、缓存与任务队列和 OOM 事件。
Open File Descriptors个统计当前时刻 Seed Peer 各进程已打开的文件描述符数量,反映文件与网络连接资源占用情况。- 正常情况下,文件描述符数量保持稳定,并随连接和文件访问量平稳变化。
- 如果文件描述符数量异常升高或持续增长,通常代表连接泄漏、文件句柄未释放或请求积压;建议检查进程 FD 上限、网络连接、文件访问和组件日志。
Dragonfly PeerUP个统计当前时刻按版本汇总的 Peer 实例数量,反映各版本实例的存活与部署规模。- 正常情况下,实例数量保持稳定,并与预期部署规模及版本分布一致。
- 如果实例数量异常降低或降为 0,通常代表部分或全部实例不可用,或监控采集异常;建议检查 Pod 运行状态、组件部署副本、版本变更和指标采集目标。
流量分布(1小时)字节统计 Peer 在过去 1 小时按下载类型汇总的流量累计增量,反映不同来源或传输类型的流量分布。- 正常情况下,累计流量随实际下载负载平稳变化,各类型占比与业务访问模式相符。
- 如果累计流量或类型分布异常突增、突降或偏斜,通常代表下载负载突变、P2P 命中路径变化或回源流量异常;建议检查业务发布节奏、下载类型标签、P2P 链路和源站访问情况。
磁盘使用空间字节统计当前时刻按 Pod 汇总的 Peer 磁盘总空间及由总空间减已用空间得到的可用空间,反映本地缓存存储容量与使用压力。- 正常情况下,磁盘总空间保持稳定,可用空间充足且随缓存写入和回收平稳变化。
- 如果可用空间异常降低或磁盘总空间异常变化,通常代表缓存持续增长、回收不及时或挂载容量发生变化;建议检查缓存目录占用、清理策略、磁盘挂载和 Pod 日志。
下载带宽bit/s基于过去 5 分钟采样计算 Peer 按 Pod 和下载类型汇总的瞬时下载速率并换算为 bit/s,反映下载链路带宽负载。- 正常情况下,下载带宽随业务负载平稳变化,不同下载类型的变化与实际任务量相符。
- 如果下载带宽异常升高、降低或剧烈波动,通常代表下载负载突变、链路拥塞、P2P 传输异常或指标采集不连续;建议检查下载任务量、网络带宽、对端连接和组件日志。
上传带宽bit/s基于过去 5 分钟采样计算 Peer 按 Pod 汇总的瞬时上传速率并换算为 bit/s,反映对外提供数据的带宽负载。- 正常情况下,上传带宽随下游请求量平稳变化,并与节点承担的分发任务相符。
- 如果上传带宽异常升高、降低或剧烈波动,通常代表下游请求突变、链路拥塞、数据分发异常或指标采集不连续;建议检查分发任务量、网络带宽、对端连接和组件日志。
并行下载任务总数个统计当前时刻按 Pod 汇总的 Peer 并行下载任务数量,反映实时下载并发压力。- 正常情况下,并行任务数量随业务负载平稳变化,且不会持续累积。
- 如果并行任务数量异常升高或长时间不回落,通常代表请求突增、下载变慢或任务阻塞;建议检查下载队列、网络与磁盘性能、上游服务和组件日志。
小文件下载耗时(0-64MiB)ms基于过去 5 分钟采样,统计 Peer 对 0~64 MiB 文件按任务大小分级的下载耗时 P50、P95 和 P99 分位值,反映小文件下载时延分布。- 正常情况下,各分位耗时保持平稳,高分位与中位数之间无持续扩大。
- 如果下载耗时异常升高或高分位持续恶化,通常代表网络拥塞、对端响应变慢、磁盘 I/O 瓶颈或任务排队;建议检查分位曲线、任务大小分级、网络与磁盘性能和组件日志。
回源小文件下载耗时(0-64MiB)ms基于过去 5 分钟采样,统计 Peer 对 0~64 MiB 文件按任务大小分级的回源请求耗时 P50、P95 和 P99 分位值,反映源站下载时延分布。- 正常情况下,各分位回源耗时保持平稳,高分位与中位数之间无持续扩大。
- 如果回源耗时异常升高或高分位持续恶化,通常代表源站响应变慢、回源网络拥塞、磁盘 I/O 瓶颈或请求排队;建议检查源站健康状态、回源链路、任务大小分级和组件日志。
下载任务总数个统计 Peer 在过去 1 分钟按 Pod 汇总的下载任务累计增量,反映短周期下载任务负载。- 正常情况下,任务增量随业务下载量平稳变化,并与实际镜像拉取活动相符。
- 如果任务增量异常升高、降低或中断,通常代表业务负载突变、下载入口异常或指标采集异常;建议检查镜像拉取事件、Pod 请求分布、组件状态和采集链路。
下载任务失败总数个统计 Peer 在过去 1 分钟按 Pod 汇总的下载任务失败累计增量,反映短周期下载失败情况。- 正常情况下,失败增量保持为 0 或处于较低且稳定的水平。
- 如果失败增量异常升高,通常代表网络、源站、对端节点、磁盘或任务处理链路出现故障;建议检查失败任务日志、网络连通性、源站与对端健康状态和磁盘空间。
代理请求任务总数个统计 Peer 在过去 1 分钟按 Pod 汇总的代理请求任务累计增量,反映短周期代理请求负载。- 正常情况下,请求增量随业务访问量平稳变化,并与实际代理流量相符。
- 如果请求增量异常升高、降低或中断,通常代表业务访问突变、代理入口异常或指标采集异常;建议检查代理请求日志、客户端访问、Pod 状态和采集链路。
代理请求任务失败总数个统计 Peer 在过去 1 分钟按 Pod 汇总的代理请求任务失败累计增量,反映短周期代理请求失败情况。- 正常情况下,失败增量保持为 0 或处于较低且稳定的水平。
- 如果失败增量异常升高,通常代表代理链路、上游服务、鉴权配置或网络连接出现故障;建议检查失败请求日志、上游可用性、代理配置和网络连通性。
预取任务总数个统计 Peer 在过去 1 分钟按 Pod 汇总的预取任务累计增量,反映短周期预取负载。- 正常情况下,任务增量随预取计划平稳变化,并与实际预取活动相符。
- 如果任务增量异常升高、降低或中断,通常代表预取计划突变、任务下发异常或指标采集异常;建议检查预取配置、任务下发记录、Pod 状态和采集链路。
预取任务失败总数个统计 Peer 在过去 1 分钟按 Pod 汇总的预取任务失败累计增量,反映短周期预取失败情况。- 正常情况下,失败增量保持为 0 或处于较低且稳定的水平。
- 如果失败增量异常升高,通常代表预取源不可用、网络或磁盘异常、任务参数错误或处理链路故障;建议检查预取任务日志、源站与网络连通性、磁盘空间和预取配置。
回源下载请求总数个统计 Peer 在过去 1 分钟按 Pod 汇总的回源下载请求累计增量,反映短周期源站访问负载。- 正常情况下,请求增量随业务负载平稳变化,且与 P2P 未命中及回源策略相符。
- 如果请求增量异常升高、降低或中断,通常代表 P2P 命中率变化、业务请求突变、回源策略异常或指标采集异常;建议检查 P2P 命中情况、回源配置、源站访问日志和采集链路。
回源下载请求失败总数个统计 Peer 在过去 1 分钟按 Pod 汇总的回源下载请求失败累计增量,反映短周期源站访问失败情况。- 正常情况下,失败增量保持为 0 或处于较低且稳定的水平。
- 如果失败增量异常升高,通常代表源站不可用、回源网络故障、鉴权失败或请求超时;建议检查源站健康状态、网络连通性、鉴权配置和失败请求日志。
Threads个统计当前时刻 Peer 各进程的线程数量,反映进程线程资源使用情况。- 正常情况下,线程数量保持稳定,并随并发负载在合理范围内平稳变化。
- 如果线程数量异常升高、降低或持续增长,通常代表并发压力突增、线程泄漏、任务阻塞或进程异常;建议检查进程状态、线程栈、任务队列和组件日志。
CPU%基于过去 1 分钟采样计算 Peer 各 Pod 的平均 CPU 使用率,反映组件计算资源负载。- 正常情况下,CPU 使用率随业务负载平稳变化,无持续高位或无故突变。
- 如果CPU 使用率异常升高、降低或剧烈波动,通常代表请求突增、计算热点、进程阻塞或实例异常;建议检查 Pod 负载、CPU 限额与节流、热点操作和组件日志。
Memory字节统计当前时刻 Peer 各进程的常驻内存用量,反映组件实际占用的物理内存规模。- 正常情况下,内存用量保持稳定,并随业务负载在可控范围内变化。
- 如果内存用量异常升高或持续增长,通常代表缓存堆积、内存泄漏、任务积压或负载突增;建议检查 Pod 内存限额、进程内存分析、缓存与任务队列和 OOM 事件。
Open File Descriptors个统计当前时刻 Peer 各进程已打开的文件描述符数量,反映文件与网络连接资源占用情况。- 正常情况下,文件描述符数量保持稳定,并随连接和文件访问量平稳变化。
- 如果文件描述符数量异常升高或持续增长,通常代表连接泄漏、文件句柄未释放或请求积压;建议检查进程 FD 上限、网络连接、文件访问和组件日志。
Dragonfly SchedulerUP个统计当前时刻按版本汇总的 Scheduler 实例数量,反映各版本实例的存活与部署规模。- 正常情况下,实例数量保持稳定,并与预期部署规模及版本分布一致。
- 如果实例数量异常降低或降为 0,通常代表部分或全部实例不可用,或监控采集异常;建议检查 Pod 运行状态、组件部署副本、版本变更和指标采集目标。
gRPC 请求总数个统计 Scheduler 在过去 1 分钟按 Pod 和 gRPC 状态码汇总的已处理请求累计增量,反映短周期 gRPC 请求负载与结果分布。- 正常情况下,请求增量随调度负载平稳变化,成功状态码占主要部分。
- 如果请求增量或错误状态码数量异常升高,通常代表调用量突增、服务处理失败、超时或依赖异常;建议检查 gRPC 状态码分布、调用方请求、Scheduler 日志和依赖服务。
并行调度任务总数个统计当前时刻按 Pod 汇总的 Scheduler 并行调度任务数量,反映实时调度并发压力。- 正常情况下,并行任务数量随业务负载平稳变化,且不会持续累积。
- 如果并行任务数量异常升高或长时间不回落,通常代表调度请求突增、处理变慢或任务阻塞;建议检查调度队列、CPU 与内存资源、下游交互和 Scheduler 日志。
调度注册任务总数个统计 Scheduler 在过去 1 分钟按 Pod 汇总的调度注册任务累计增量,反映短周期节点注册负载。- 正常情况下,任务增量随节点注册活动平稳变化,并与实际节点上线或注册行为相符。
- 如果任务增量异常升高、降低或中断,通常代表节点注册活动突变、注册链路异常或指标采集异常;建议检查节点上线事件、注册请求日志、Scheduler 状态和采集链路。
调度注册任务失败总数个统计 Scheduler 在过去 1 分钟按 Pod 汇总的调度注册任务失败累计增量,反映短周期节点注册失败情况。- 正常情况下,失败增量保持为 0 或处于较低且稳定的水平。
- 如果失败增量异常升高,通常代表节点信息无效、网络异常、服务处理失败或依赖故障;建议检查注册失败日志、节点参数、网络连通性和依赖服务。
调度任务总数个统计 Scheduler 在过去 1 分钟按 Pod 汇总的调度任务累计增量,反映短周期任务调度负载。- 正常情况下,任务增量随下载请求平稳变化,并与实际调度活动相符。
- 如果任务增量异常升高、降低或中断,通常代表调度请求突变、服务处理异常或指标采集异常;建议检查调度请求日志、客户端活动、Scheduler 状态和采集链路。
调度任务失败总数个统计 Scheduler 在过去 1 分钟按 Pod 汇总的调度任务失败累计增量,反映短周期任务调度失败情况。- 正常情况下,失败增量保持为 0 或处于较低且稳定的水平。
- 如果失败增量异常升高,通常代表可用对端不足、调度策略异常、依赖故障或请求参数无效;建议检查调度失败日志、对端节点状态、调度配置和依赖服务。
节点上报信息总数个统计 Scheduler 在过去 1 分钟按 Pod 汇总的节点信息上报累计增量,反映短周期节点状态上报负载。- 正常情况下,上报增量随节点规模和上报周期平稳变化。
- 如果上报增量异常升高、降低或中断,通常代表节点规模突变、上报重试、网络异常或采集异常;建议检查节点状态、上报周期、网络连通性和 Scheduler 日志。
节点上报信息失败总数个统计 Scheduler 在过去 1 分钟按 Pod 汇总的节点信息上报失败累计增量,反映短周期节点状态上报失败情况。- 正常情况下,失败增量保持为 0 或处于较低且稳定的水平。
- 如果失败增量异常升高,通常代表节点信息无效、网络异常、服务处理失败或依赖故障;建议检查上报失败日志、节点状态、网络连通性和依赖服务。
节点释放信息总数个统计 Scheduler 在过去 1 分钟按 Pod 汇总的节点释放信息累计增量,反映短周期节点离开或释放事件负载。- 正常情况下,事件增量与实际节点下线或释放活动相符,不存在无故突增。
- 如果事件增量异常升高、降低或中断,通常代表节点频繁上下线、释放流程异常或指标采集异常;建议检查节点生命周期事件、释放请求日志、Scheduler 状态和采集链路。
节点释放信息失败总数个统计 Scheduler 在过去 1 分钟按 Pod 汇总的节点释放信息失败累计增量,反映短周期节点离开或释放失败情况。- 正常情况下,失败增量保持为 0 或处于较低且稳定的水平。
- 如果失败增量异常升高,通常代表节点状态不一致、网络异常、服务处理失败或依赖故障;建议检查释放失败日志、节点状态、网络连通性和依赖服务。
Goroutines个统计当前时刻 Scheduler 各进程的 Goroutine 数量,反映 Go 运行时并发任务规模。- 正常情况下,Goroutine 数量保持稳定,并随调度负载在合理范围内平稳变化。
- 如果Goroutine 数量异常升高、降低或持续增长,通常代表并发压力突增、Goroutine 泄漏、任务阻塞或进程异常;建议检查 Goroutine 堆栈、任务队列、依赖调用和 Scheduler 日志。
CPU%基于过去 1 分钟采样计算 Scheduler 各 Pod 的平均 CPU 使用率,反映组件计算资源负载。- 正常情况下,CPU 使用率随调度负载平稳变化,无持续高位或无故突变。
- 如果CPU 使用率异常升高、降低或剧烈波动,通常代表调度请求突增、计算热点、进程阻塞或实例异常;建议检查 Pod 负载、CPU 限额与节流、热点操作和 Scheduler 日志。
Memory字节统计当前时刻 Scheduler 各进程的常驻内存用量,反映组件实际占用的物理内存规模。- 正常情况下,内存用量保持稳定,并随调度负载在可控范围内变化。
- 如果内存用量异常升高或持续增长,通常代表缓存堆积、内存泄漏、任务积压或负载突增;建议检查 Pod 内存限额、进程内存分析、缓存与任务队列和 OOM 事件。
Open File Descriptors个统计当前时刻 Scheduler 各进程已打开的文件描述符数量,反映文件与网络连接资源占用情况。- 正常情况下,文件描述符数量保持稳定,并随连接和文件访问量平稳变化。
- 如果文件描述符数量异常升高或持续增长,通常代表连接泄漏、文件句柄未释放或请求积压;建议检查进程 FD 上限、网络连接、文件访问和 Scheduler 日志。
P2P 镜像加速监控
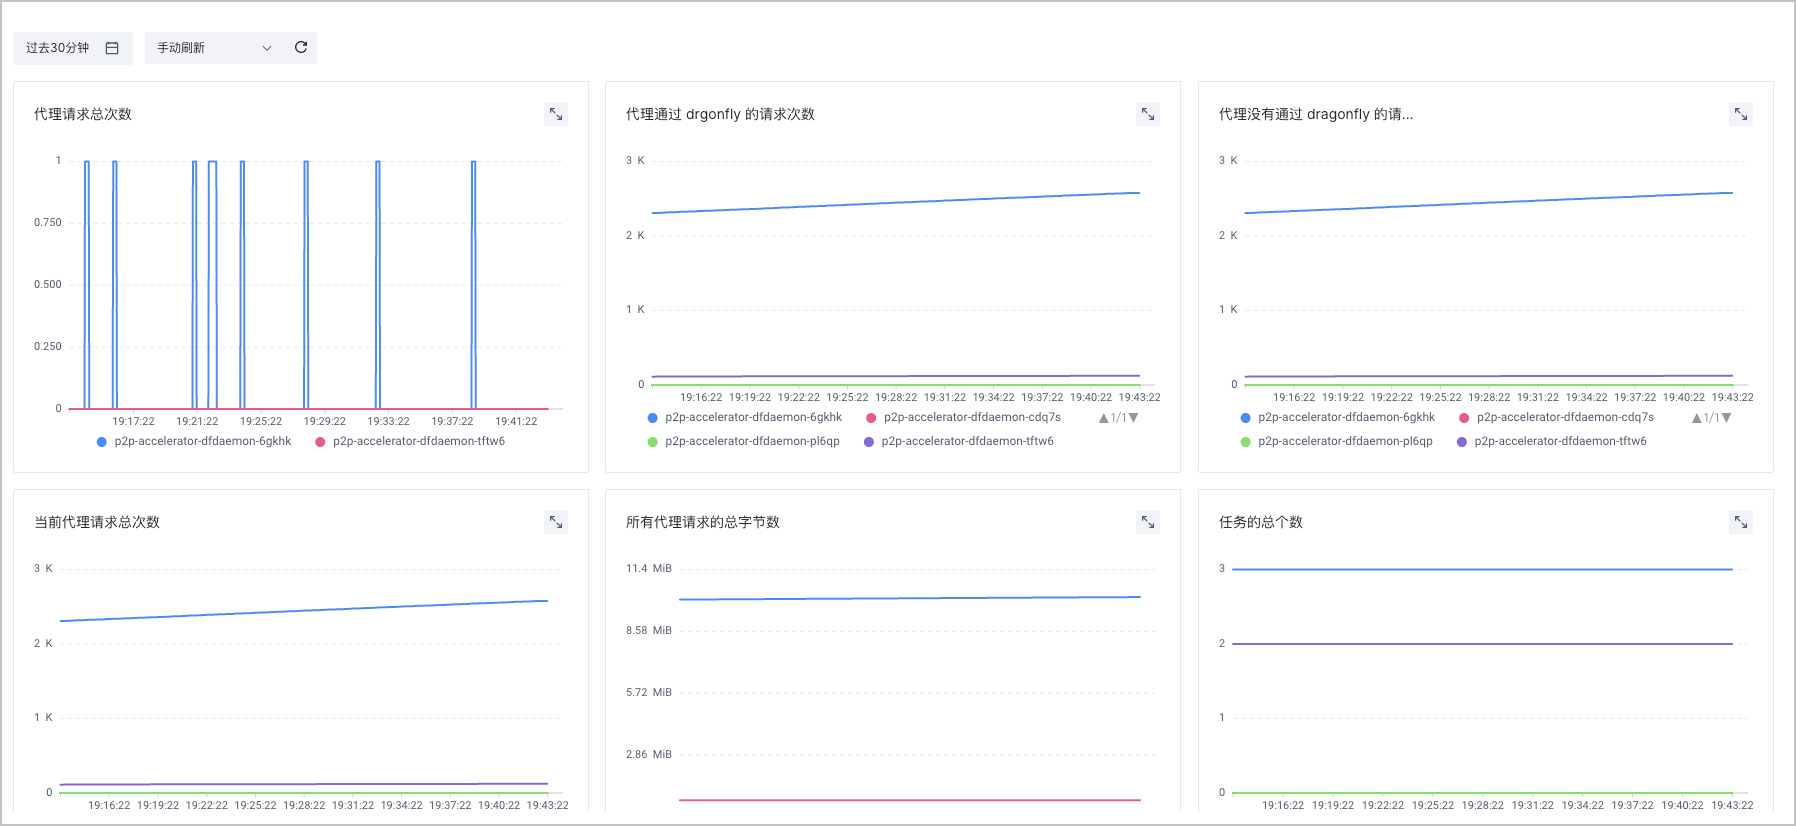
您可以在容器服务控制台中,查看预置的监控大盘。包括:代理请求总次数、当前代理请求总次数、任务总个数、失败的任务总个数、分片的总个数等。
- 在集群管理页面的左侧导航栏中,选择 监控中心 > 监控看板。
- 在左侧看板列表中选择 镜像加速服务监控 > p2p 镜像加速监控,即可查看监控看板。
-
说明
镜像懒加载(Nydus)监控
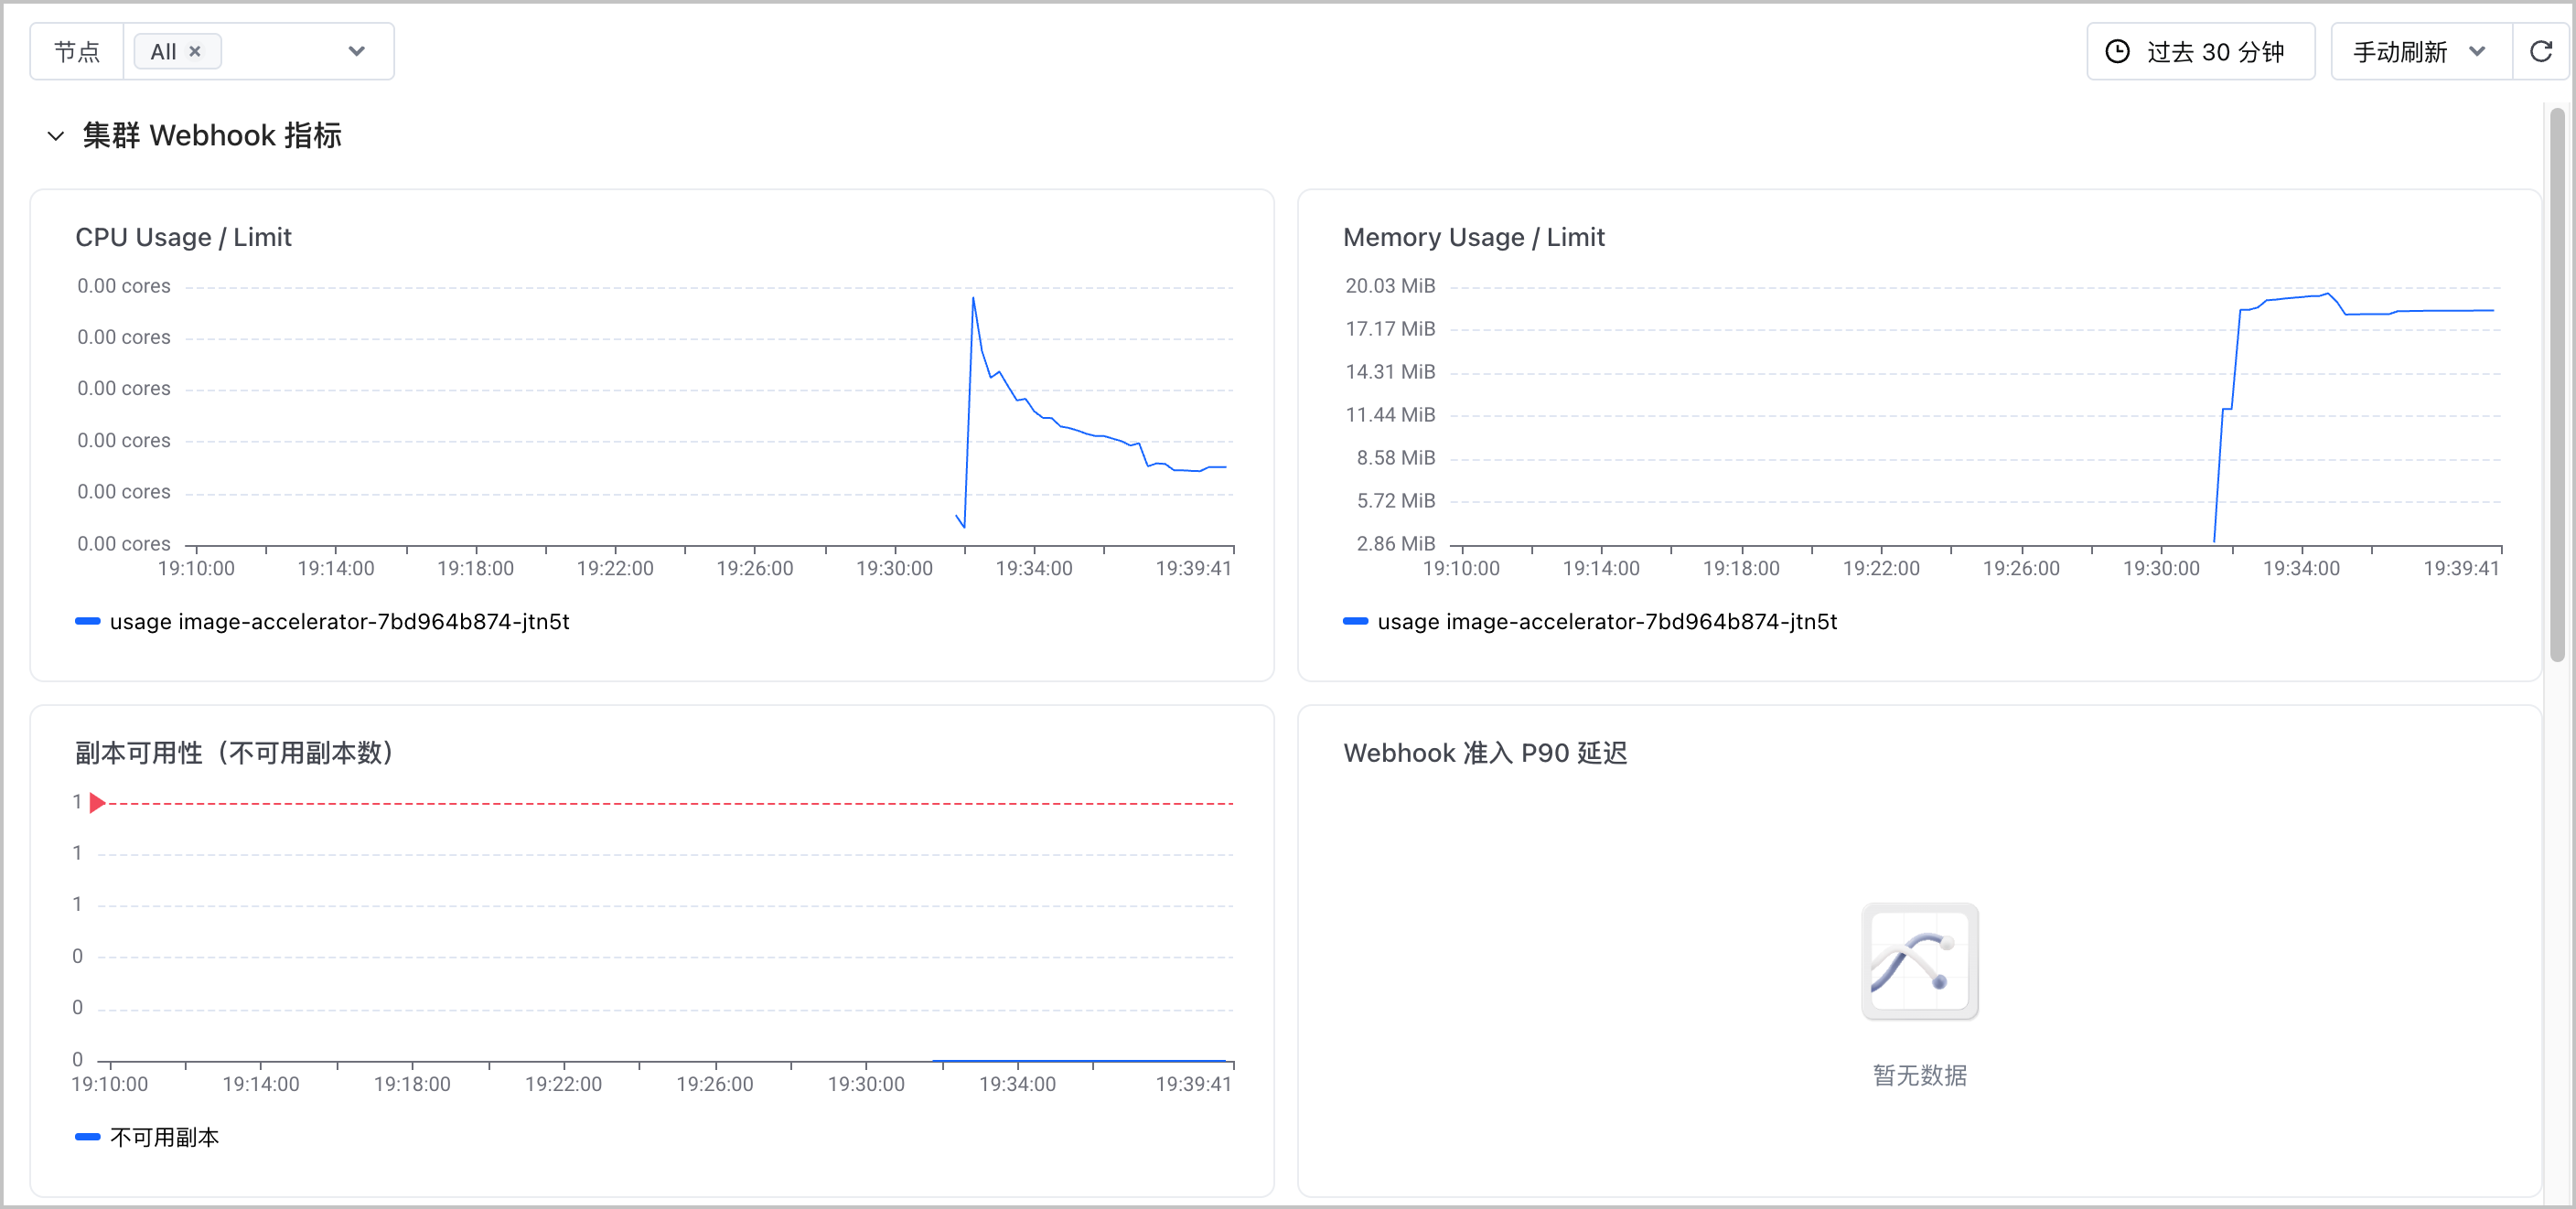
配置 Nydus 懒加载功能后,您可以在容器服务控制台中,查看预置的监控大盘。包括:Nydus Daemon 数量、Nydus Daemon 内存用量等。
- 在集群管理页面的左侧导航栏中,选择 监控中心 > 监控看板。
- 在左侧看板列表中选择 镜像加速服务监控 > 镜像懒加载(Nydus)监控,即可查看监控看板。
-
说明
查看指标
- 如需查询集群中的已接入/未接入指标,或查询指标的具体含义,请参见 指标查询。
- 支持使用托管 Prometheus 的 Explore 功能来快速查询和展示指标数据。详情请参见 指标查询。
最近更新时间:2026.09.18 11:09:55
这个页面对您有帮助吗?
有用
有用
无用
无用